

Groq 3 LPX es el acelerador de inferencia de baja latencia a escala de rack de NVIDIA para la plataforma Vera Rubin. Es realmente impresionante, pero la mayoría de los equipos no puede ir y comprarlo. Se entrega como parte de un despliegue de Vera Rubin, es infraestructura a escala de rack y, hasta ahora, solo nubes como Nebius lo tienen en producción. Así que, si buscaste alternativas, casi seguro te haces una de dos preguntas reales: qué opción de inferencia rápida puedo usar de verdad ahora mismo, o en qué silicio debería apostar mi plataforma.
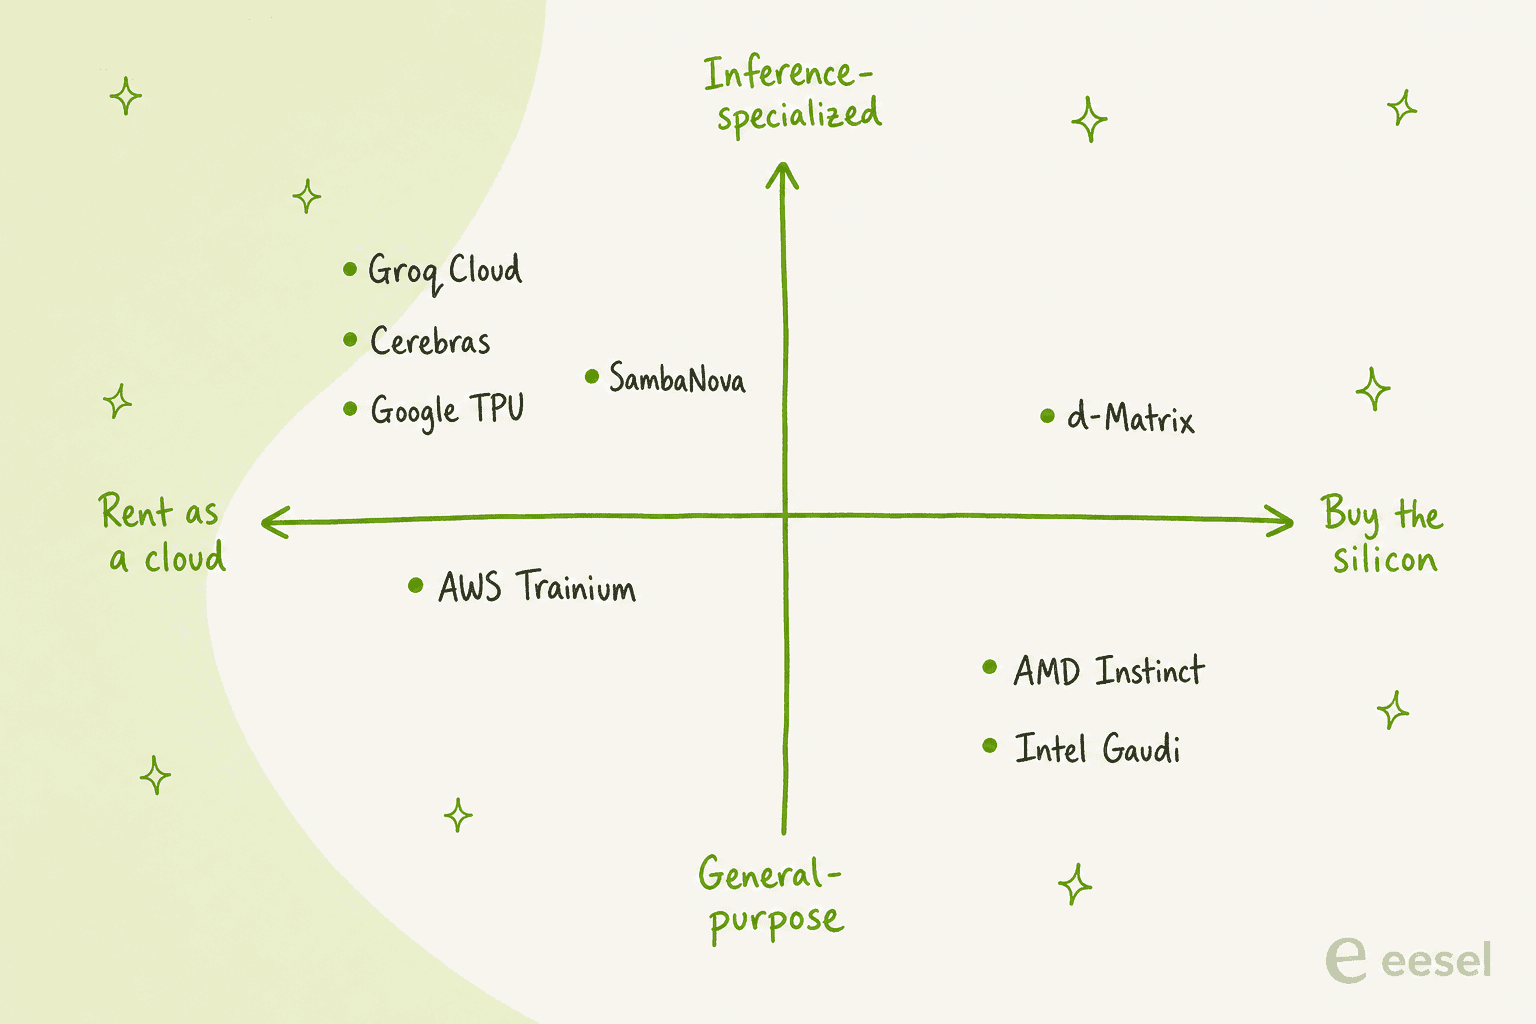
Estas son las ocho que miraría, agrupadas según cómo las consigues:
- Úsala hoy mediante una API: Cerebras (velocidad pura de un solo flujo), SambaNova (los modelos abiertos más grandes y cargas de trabajo de agentes) y la nube independiente de Groq (la LPU de Groq, sin esperar a los racks de NVIDIA).
- Alquila silicio de hiperescaladores: Google TPU Ironwood (Google Cloud, pensada para inferencia) y AWS Trainium (la mejor economía de tokens dentro de AWS).
- Ten el hardware en propiedad: AMD Instinct (más memoria por GPU, software abierto) e Intel Gaudi (valor y Ethernet estándar).
- Apuesta pronto por un especialista: d-Matrix Corsair (cómputo en memoria pensado para baja latencia).
El replanteamiento honesto, y lo que más quiero que te lleves: a menos que operes una nube, no comprarás ninguno de estos. Los notarás como tokens más rápidos y baratos en las APIs que ya usas, y lo que realmente despliegas es el trabajador que va encima, como un agente de IA para helpdesk. Ahí es donde está eesel.
Por qué mirarías más allá de Groq 3 LPX
Empecemos siendo justos con el actual líder, porque es una pieza seria de ingeniería. Groq 3 LPX es el acelerador de inferencia de NVIDIA para Vera Rubin, construido sobre el diseño LPU de Groq bajo una licencia no exclusiva. Cada rack reúne 256 chips LPU que trabajan junto a GPU Rubin, y NVIDIA cita un benchmark de 3.400 tokens por segundo en Gemma 4 31B con 100K de contexto. Es rápido y la arquitectura es ingeniosa.
Entonces, ¿por qué mirar otras opciones? Unas cuantas razones muy prácticas:
- No puedes simplemente comprarlo. LPX es una extensión a escala de rack de Vera Rubin NVL72, no una tarjeta que se mete en un servidor. Es un compromiso de centro de datos, no una decisión de compra para la mayoría de los equipos.
- La disponibilidad es escasa. NVIDIA anunció la producción completa en agosto de 2026, pero Nebius es solo la primera nube en desplegarlo. Si quieres capacidad hoy, la cola es corta y la lista de proveedores, más corta aún.
- Las cifras son de la propia NVIDIA. La cifra estrella de 35 veces más rendimiento por megavatio se mide frente a la generación anterior de NVIDIA. Es una afirmación coherente, pero es una afirmación del fabricante, y las pruebas independientes todavía están llegando.
- Dependencia del proveedor. LPX solo tiene sentido dentro de una instalación Vera Rubin. Si tu stack, tu nube o tu presupuesto apuntan a otro lado, es una dependencia dura.
Nada de eso hace que LPX sea malo. Solo significa que "¿debería usar Groq 3 LPX?" es la pregunta equivocada para la mayoría. La mejor es "¿de dónde saco inferencia rápida?", y tiene muchas buenas respuestas.
Cómo elegí y cómo leer esta lista
Trabajo del lado de producto, así que mi sesgo va hacia lo que realmente puedes adoptar, no hacia lo que mejor queda en una diapositiva. Leí la documentación, los precios y las fichas técnicas de cada proveedor, y donde existe una cifra de velocidad he usado la del proveedor y lo he indicado. Tres cosas marcaron el orden:
- ¿Puedes usarlo ya? Una API a la que puedes llamar esta tarde gana a un rack por el que harás cola. La accesibilidad pesa mucho.
- ¿Cuál es la carga de trabajo real? Chat rápido de un solo flujo, modelos abiertos enormes o servicio por lotes barato son trabajos distintos que premian chips distintos.
- ¿Cuánto cuesta convivir con él? Alquilar frente a comprar, el software al que te atas y el coste total de propiedad importan más que los FLOPS máximos.
Una advertencia que conviene decir claramente: la opinión de la comunidad sobre esta generación exacta de hardware aún es escasa, porque casi nada lleva mucho tiempo en uso. Así que lo que sigue se apoya en especificaciones primarias y en los pocos benchmarks reales que existen, no en años de reseñas de usuarios. Donde hay una voz real, la he citado.
Aquí tienes todo el panorama de un vistazo antes de entrar en detalle.
| Alternativa | Tipo | Cómo se accede | Cifra de inferencia destacada (según el fabricante) | Señal de coste aproximada | Ideal para |
|---|---|---|---|---|---|
| Groq (GroqCloud) | Nube de inferencia LPU + chips | API hoy, por token | La más rápida en modelos pequeños/medianos | Por token, publicado | Velocidad de la LPU de Groq sin esperar a los racks de NVIDIA |
| Cerebras | Escala de oblea (WSE-3) | API + compra de CS-4/CS-3 | ~3.000 tok/s (GPT OSS 120B) | 0,35 $ ent. / 0,75 $ sal. por M | Velocidad pura de un solo flujo |
| SambaNova | RDU, memoria de tres niveles | API + racks on-prem | ~850 tok/s (MiniMax M2.7) | 0,22 $ ent. / 0,59 $ sal. por M (gpt-oss-120b) | Modelos abiertos más grandes, agentes, on-prem |
| Google TPU (Ironwood) | ASIC propio | Alquiler solo en Google Cloud | 4.614 FP8 TFLOPs/chip | Desde 12,00 $/chip-hora | Equipos ya en GCP, servicio a hiperescala |
| AWS Trainium | ASIC propio | Alquiler solo en AWS | Trn2: 30-40 % mejor precio-rendimiento vs. H200 | Inf2 desde 0,76 $/h | Tokens más baratos dentro de AWS |
| AMD Instinct | GPU (CDNA) | Compra, o vía socios de nube | MI355X: 288 GB HBM3E, 8 TB/s | Compra de capital / presupuesto | Silicio propio, modelos que consumen memoria, sin dependencia |
| Intel Gaudi 3 | Acelerador de IA | Compra, o vía IBM Cloud | 128 GB HBM, 1.200 GB/s Ethernet | Posicionamiento de "mitad de coste" | Compradores de valor, entornos nativos Ethernet |
| d-Matrix Corsair | Cómputo en memoria (DIMC) | Solo compra de hardware | 60.000 tok/s (Llama3 8B, servidor) | Compra de capital | Obsesionados con la latencia que apuestan pronto |
| Groq 3 LPX (el actual líder) | Rack LPU + GPU | Vía nubes (Nebius) | 3.400 tok/s (Gemma 4 31B) | Escala de centro de datos | Inferencia agéntica a hiperescala |
¿No sabes cuál es tu fila? Este selector te lleva a una lista corta con un clic.
1. Groq (GroqCloud): la LPU de Groq que sí puedes usar hoy
Ideal para: equipos que quieren la velocidad de baja latencia de la LPU de Groq mediante una API ahora mismo, sin esperar a que los racks de NVIDIA lleguen a su nube.
Aquí está el giro que confunde a mucha gente. La empresa Groq sigue existiendo, sigue operando GroqCloud y sigue vendiendo la misma velocidad de LPU que la hizo famosa. Cuando NVIDIA licenció la tecnología de Groq, fue un acuerdo no exclusivo más un traspaso de equipo, no un cierre. Groq siguió siendo independiente bajo un nuevo CEO, y GroqCloud siguió funcionando sin interrupción. Una reacción en X captó la confusión a la perfección:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Así que, si lo que te atrajo de LPX fue la velocidad de la LPU, la "alternativa" más directa suele ser simplemente el original: GroqCloud. Obtienes una API compatible con OpenAI, generación de tokens determinista y de baja latencia, y puedes empezar hoy en lugar de esperar a un despliegue de Vera Rubin cerca de ti. En Hacker News, uno de los comentarios más agudos leyó el benchmark de LPX como una continuación de la fortaleza conocida de Groq:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Ventajas: disponible hoy, API conocida, fuerte en modelos pequeños y medianos, y el mismo linaje de LPU que NVIDIA licenció. Inconvenientes: la confusión de marca es real y los modelos más grandes se sirven mejor en otro sitio. Si quieres ver el panorama completo de costes, desglosamos por separado los precios de Groq y el conjunto más amplio de alternativas a Groq.
Precios y acceso: autoservicio, pago por token mediante GroqCloud. Veredicto: si "Groq 3 LPX" te llamó la atención por la LPU, empieza aquí antes que por cualquier otra. Es el camino más corto hacia lo auténtico.
2. Cerebras: lo más parecido a un rival de velocidad pura
Ideal para: velocidad pura de tokens en un solo flujo con modelos pequeños y medianos, ya sea por API o con tu propio sistema.
Cerebras es el otro nombre que siempre sale en la conversación sobre "la inferencia más rápida", y con razón. Su Wafer-Scale Engine es un único chip del tamaño de un plato llano: 4 billones de transistores, 900.000 núcleos y 125 petaflops en una sola pieza de silicio. Cerebras lo describe como 19 veces más transistores que una NVIDIA B200. Toda la filosofía de diseño es lo contrario de un clúster de chips pequeños que se comunican por una red.
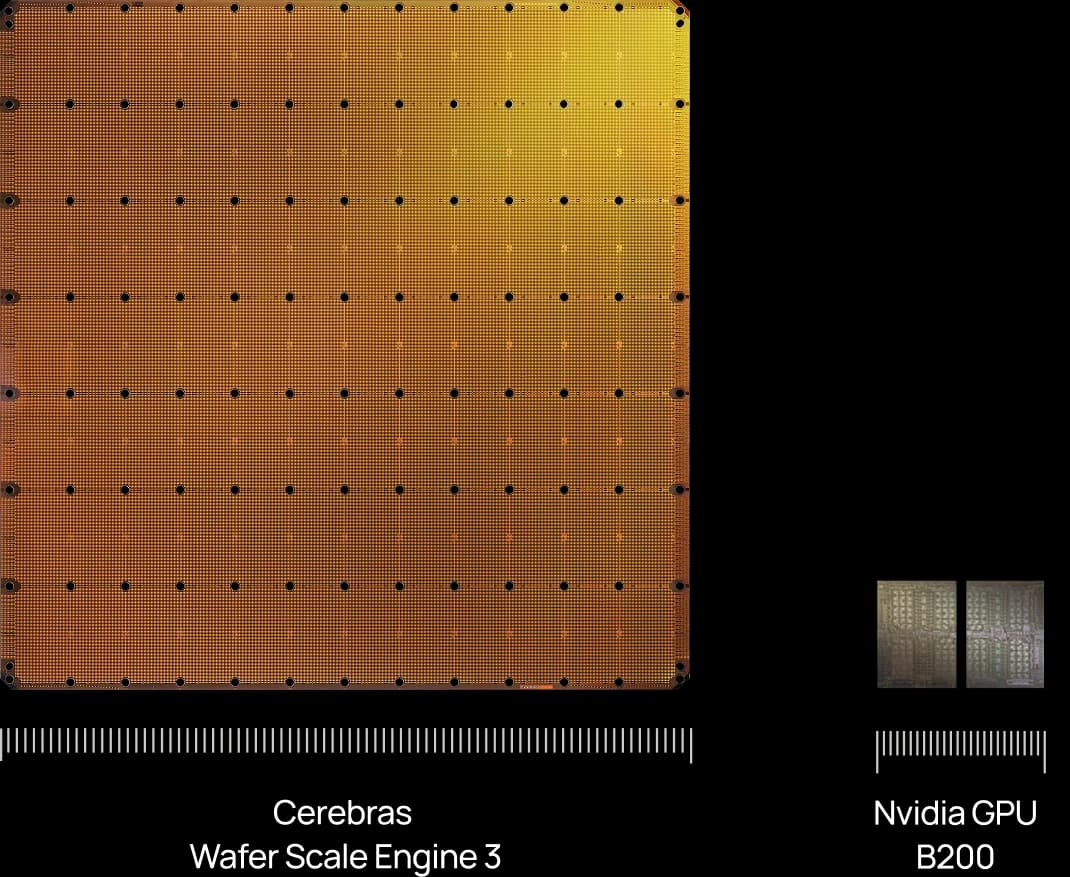
La parte que realmente usas es Cerebras Inference, una nube compatible con OpenAI que apuesta fuerte por la velocidad: la página de precios afirma que es 20 veces más rápida que OpenAI y Anthropic, y el nuevo sistema CS-4 promete "hasta 30 veces más rápida la inferencia en comparación con las GPU". En concreto, Cerebras cita alrededor de 3.000 tokens por segundo en GPT OSS 120B y unos 1.800 en Gemma 4 31B.
Ventajas: velocidad de un solo flujo realmente líder en su categoría, una API limpia de pago por token y usuarios conocidos como OpenAI, Meta y Perplexity. Inconvenientes: los sistemas a escala de oblea son una compra pesada si vas on-prem, y la tarifa pública solo lista un par de modelos, así que presupuestar una carga concreta requiere una conversación comercial.
Precios y acceso: 5 $ en créditos gratuitos para empezar, luego un nivel Developer desde 10 $ con tarifas por token publicadas (GPT OSS 120B a 0,35 $ de entrada / 0,75 $ de salida por millón de tokens), además de Enterprise y sistemas CS-4/CS-3 a la venta. Veredicto: si lo único que te importa son los tokens por segundo en un modelo que sirve Cerebras, es la alternativa más fuerte de esta lista y compite directamente con Groq.
3. SambaNova: hecha para modelos abiertos grandes y agentes
Ideal para: ejecutar rápido los modelos abiertos más grandes, mantener muchos modelos residentes para cargas de agentes o servir inferencia dentro de tu propio centro de datos.
Todo el discurso de SambaNova para 2026 es la "inferencia premium", y su diferenciador es la memoria. Mientras el diseño de Groq apuesta por un enorme ancho de banda de SRAM con una capacidad diminuta por chip, la SN50 RDU usa tres niveles: 432 MB de SRAM en el chip, 64 GB de HBM2E y hasta 512 GB de DDR5. Eso permite que varios modelos grandes permanezcan cargados y cambien con latencia mínima, lo que el cofundador Kunle Olukotun llama la "zona Ricitos de Oro" para los agentes.
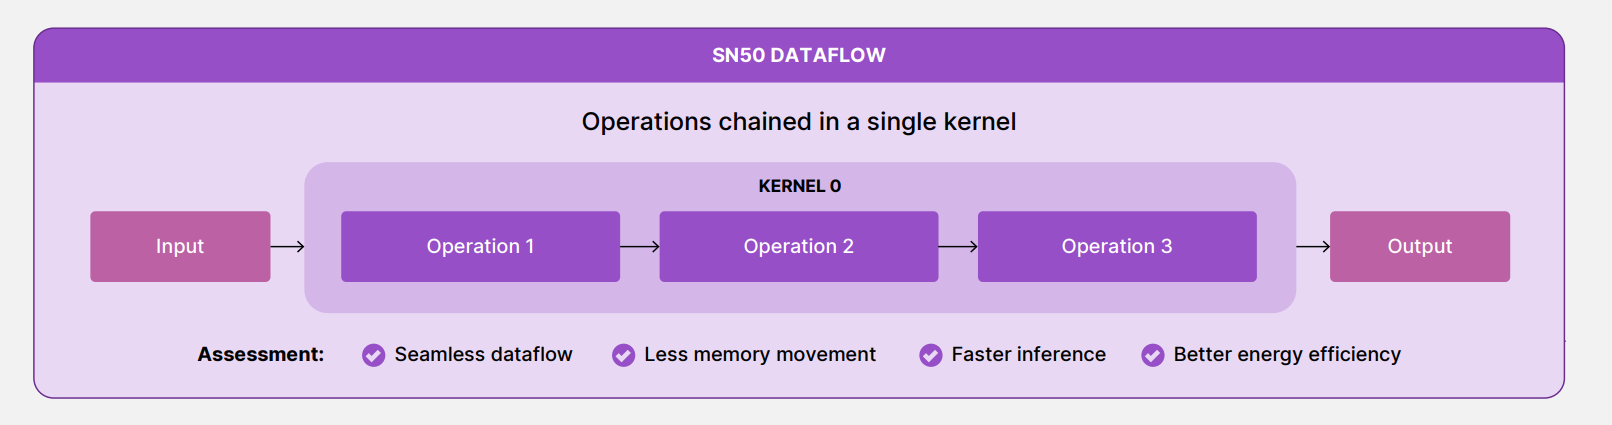
La prueba de velocidad en la que más confío es de terceros: Artificial Analysis midió el SN50 ejecutando MiniMax M2.7 a hasta 850 tokens por segundo con contexto corto y más de 450 con contexto largo, y lo calificó como el MiniMax más rápido del mundo. También hay un matiz inteligente: SambaNova se combina cada vez más con NVIDIA en lugar de enfrentarse a él, usando GPU para la fase de prefill, intensiva en cómputo, y RDU para la fase de decode, limitada por memoria.
Ventajas: la memoria de tres niveles se adapta a modelos enormes y cargas de agentes multimodelo, tarifas publicadas para modelos abiertos, una historia on-prem real para despliegues soberanos y empresariales, y una reciente ronda de 1.000 millones de dólares con una valoración de 11.000 millones. Inconvenientes: es menos una propuesta pura de "el modelo pequeño más rápido" que Groq o Cerebras, y los despliegues más grandes son bajo contacto con ventas.
Precios y acceso: SambaNova Cloud es una API de pago por token (gpt-oss-120b a 0,22 $ de entrada / 0,59 $ de salida por millón de tokens; DeepSeek-V3.1 a 3,00 $ / 4,50 $), con sistemas SambaRack para on-prem. Veredicto: la elección cuando tu carga son modelos abiertos grandes o un agente que maneja varios modelos a la vez, y más aún si lo necesitas en tu propio centro de datos.
4. Google TPU (Ironwood): la respuesta de los hiperescaladores
Ideal para: equipos que ya están en Google Cloud y cualquiera que necesite capacidad de servicio a hiperescala en lugar de una sola caja de baja latencia.
Si Groq 3 LPX representa "el chip de NVIDIA pensado primero para inferencia", Ironwood es la versión de Google de la misma idea. Google llama a Ironwood su TPU de séptima generación y "la primera diseñada específicamente para inferencia", creada para la "era de la inferencia" y los modelos de razonamiento. Cada chip ofrece 4.614 TFLOPs FP8 y 192 GB de HBM a unos 7,37 TB/s, y un superpod completo enlaza 9.216 chips refrigerados por líquido en 42,5 ExaFLOPs que comparten 1,77 petabytes de HBM.
El contraste más marcado con Groq es el modelo de compra: no puedes comprar una TPU. Solo se alquila, solo en Google Cloud, facturada por chip-hora. La historia de escala es real, eso sí. El cliente estrella de Google es Anthropic, que planea acceder a hasta 1 millón de TPU para entrenar y servir Claude.
Ventajas: diseño pensado para inferencia, escala enorme de pods, buen precio-rendimiento a escala y una vía de portabilidad (vLLM en TPU permite moverse entre GPU y TPU con cambios menores de configuración). Inconvenientes: dependencia total de Google Cloud, ninguna tarjeta que comprar, y Ironwood bajo demanda no es barata.
Precios y acceso: alquilada por chip-hora, desde 12,00 $ bajo demanda en us-central1, bajando a 5,40 $ con compromiso de tres años. Veredicto: si ya vives en Google Cloud o necesitas una flota de servicio en lugar de una sola caja rápida, Ironwood es la alternativa natural. Si quieres silicio que controles, es lo contrario.
5. AWS Trainium: la mejor economía de tokens dentro de AWS
Ideal para: equipos en AWS que quieren tokens más baratos y están contentos sirviendo a través de Bedrock o EC2 en lugar de perseguir la velocidad máxima.
El argumento de AWS no es "la más rápida", es "la más barata por token", y ese es un eje realmente distinto. Trainium se posiciona ahora tanto para inferencia como para entrenamiento: AWS afirma que las instancias Trn2 ofrecen entre un 30 y un 40 % más de precio-rendimiento que sus instancias P5e y P5en basadas en NVIDIA H200, y el anunciado Trainium3 (su primer chip de IA de 3 nm) promete hasta 4,4 veces el rendimiento de los UltraServers Trn2. La línea más antigua Inferentia2 afirma un 40 % más de precio-rendimiento y un 50 % más de rendimiento por vatio en instancias Inf2.
La prueba estrella es Anthropic, citada directamente en la página de Trainium: un Claude 3.5 Haiku optimizado para latencia que funciona un 60 % más rápido en Trainium2 mediante Bedrock, y Project Rainier, un clúster de cientos de miles de chips Trainium2.
Ventajas: ahorro real de costes dentro de AWS, integración profunda con Bedrock y SageMaker, y UltraServers a escala de rack (64 chips en Trn2, 144 en Trn3) para los trabajos más grandes. Inconvenientes: solo AWS y solo alquiler, y funciona sobre el Neuron SDK en lugar de CUDA, de modo que las cargas habituales de PyTorch y vLLM se migran con facilidad, pero los kernels CUDA escritos a mano hay que portarlos.
Precios y acceso: alquiler vía EC2 o consumo a través de Bedrock. Inf2 tiene tarifas por hora publicadas de 0,76 $ a 12,98 $ bajo demanda; los UltraServers Trn2 y Trn3 son bajo presupuesto. Veredicto: si tu infraestructura ya vive en AWS, esta es la opción de precio-rendimiento, especialmente para un servicio estable donde el coste por token importa más que los últimos milisegundos.
6. AMD Instinct: tener el silicio y quedarte con más memoria
Ideal para: equipos que quieren comprar silicio comercial, mantener modelos grandes residentes en memoria y evitar un stack solo de NVIDIA.
Si quieres una GPU real que puedas tener en propiedad, AMD es la principal alternativa a NVIDIA, y todo su argumento para inferencia es la memoria. La MI355X que ya se vende lleva 288 GB de HBM3E a 8 TB/s y 10,1 PFLOPs de MXFP4, y la serie MI400 anunciada llega a 432 GB de HBM4 a 23,3 TB/s. AMD afirma que sus MI455X y MI430X ofrecen un 50 % más de capacidad de memoria que la GPU Vera Rubin de NVIDIA, lo cual importa cuando un modelo más grande o una caché KV más larga caben en un solo chip en lugar de repartirse.
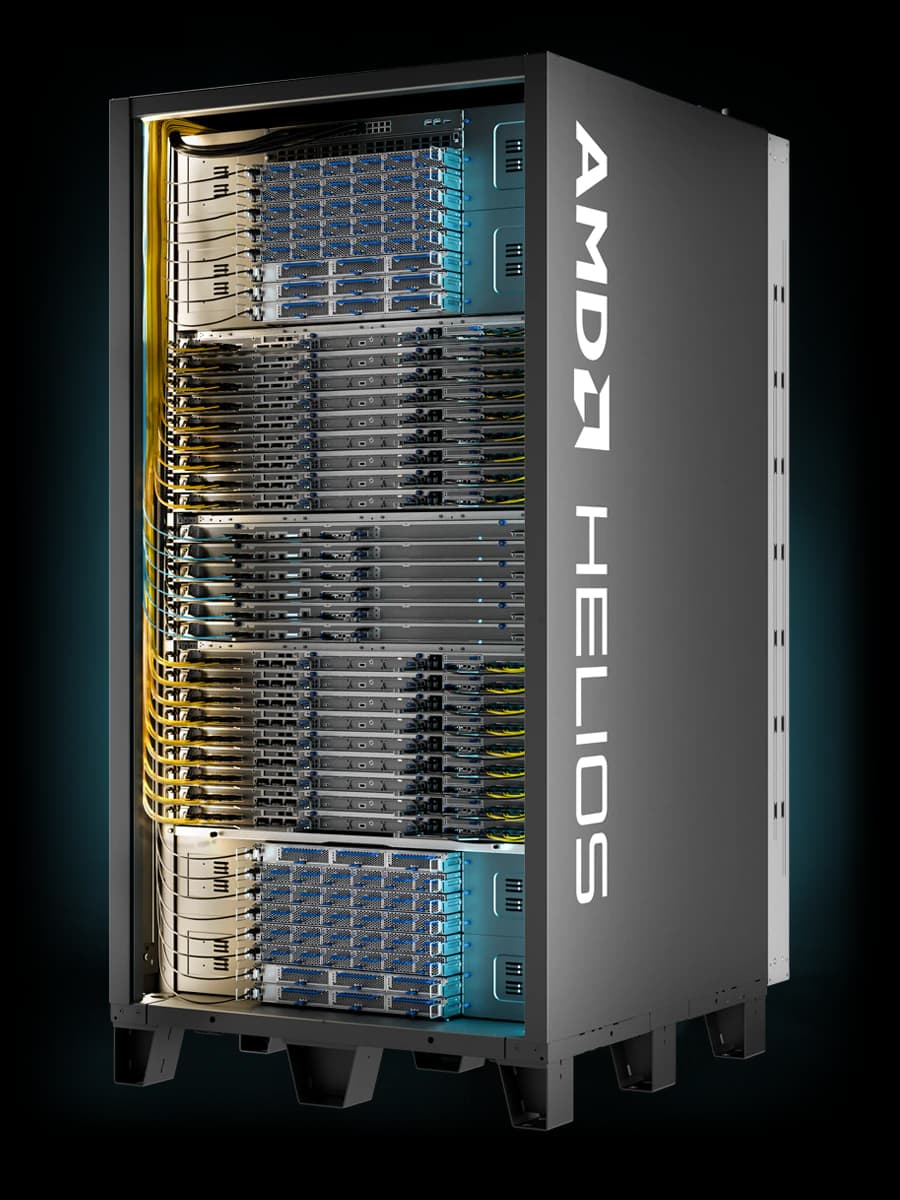
A escala de rack, el sistema AMD Helios reúne 72 GPU MI455X para hasta 2,9 exaFLOPS de MXFP4 y 31 TB de HBM4. El software corre sobre la pila abierta ROCm, ya en ROCm 10.0, con vLLM y SGLang para el servicio.
Ventajas: más HBM por GPU que el equivalente de NVIDIA, una pila de software abierta, opciones reales a escala de rack y ninguna dependencia de una red propietaria. Inconvenientes: ROCm ha recuperado mucho terreno, pero la crítica honesta sigue siendo la madurez del ecosistema frente a CUDA, y algunas de las mejores especificaciones corresponden a la generación MI400, que aún no se vende.
Precios y acceso: compra a través de OEM, o prueba MI300X en AMD Developer Cloud mediante socios como DigitalOcean y Vultr. Veredicto: la elección por defecto si quieres tener silicio de inferencia en propiedad, ejecutar modelos hambrientos de memoria y mantener abiertas tus opciones de software. Compite en capacidad y apertura, no en ser el flujo único más rápido.
7. Intel Gaudi 3: valor y Ethernet estándar
Ideal para: compradores sensibles al coste que quieren un acelerador capaz y prefieren escalar sobre Ethernet estándar en lugar de una red propietaria.
El Gaudi 3 de Intel juega la carta del valor, y su apuesta distintiva es la red. Cada acelerador Gaudi 3 tiene 24 puertos de 200 GbE RoCE integrados en la tarjeta, para 1.200 GB/s de ancho de banda bidireccional sobre Ethernet estándar. El planteamiento de Intel es directo sobre el intercambio que quiere que hagas: evitar "tecnologías propietarias y cerradas como NVLink, NVSwitch e InfiniBand" y usar el equipamiento de red que ya tienes. En cómputo, aporta 128 GB de HBM a 3,7 TB/s y 1,8 PFLOPS de FP8.
Conviene saber de cara a la hoja de ruta: Gaudi 3 está en la parte final de su línea. El chip de inferencia que Intel declara como futuro es una nueva GPU, "Crescent Island", construida sobre la arquitectura Xe3P con 160 GB de LPDDR5X y refrigeración por aire, con muestras para clientes previstas en la segunda mitad de 2026. Así que, si compras Gaudi 3 hoy, cómpralo por su valor ahora y no por una hoja de ruta larga.
Ventajas: posicionamiento de precio agresivo, mucha HBM por tarjeta y Ethernet estándar que evita la dependencia de una interconexión propietaria. Inconvenientes: compite en coste y no en velocidad pura, y la hoja de ruta se mueve claramente a otra línea de chips, así que es una compra de valor, no una apuesta a largo plazo.
Precios y acceso: compra a través de OEM como Dell, HPE y Supermicro, o úsalo en IBM Cloud, que lo promociona con el lema de "la mitad del coste". Veredicto: una elección sensata si el presupuesto es ajustado y tu centro de datos es nativo Ethernet. Solo ten presente que Crescent Island es el verdadero futuro de inferencia de Intel.
8. d-Matrix Corsair: el especialista que apuesta por la memoria
Ideal para: equipos obsesionados con la latencia que pueden desplegar su propio hardware y quieren apostar pronto por una arquitectura de inferencia hecha a medida.
d-Matrix es el comodín, y apunta exactamente al problema que ataca LPX: generación de tokens de latencia ultrabaja y lotes pequeños para cargas agénticas y de razonamiento. Su tarjeta Corsair usa Digital In-Memory Compute, colocando el cómputo junto a la SRAM del chip para esquivar el muro de la memoria. Las cifras destacadas llaman la atención: 60.000 tokens por segundo a 1 ms por token para Llama3 8B en un solo servidor, y 30.000 tokens por segundo a 2 ms para Llama3 70B en un rack, con d-Matrix afirmando aproximadamente 10 veces la velocidad interactiva y hasta 5 veces la eficiencia energética de una H100 (proyecciones propias).
Corsair entró en producción completa en junio de 2026, y la empresa levantó una Serie C de 275 millones de dólares en noviembre de 2025 (con una valoración reportada de unos 2.000 millones), con inversores como M12 de Microsoft y Temasek.
Ventajas: una arquitectura diseñada desde cero para inferencia de baja latencia, fuertes afirmaciones de eficiencia y financiación seria detrás. Inconvenientes: es solo hardware sin API pública, sus cifras son proyecciones del fabricante y no pruebas independientes, y apostar por el silicio de una startup es un riesgo distinto a alquilar a un hiperescalador.
Precios y acceso: compra de tarjetas, servidores o sistemas SquadRack; no hay un endpoint de nube de autoservicio. Veredicto: la apuesta arriesgada más interesante de esta lista. Si tienes el equipo para montar silicio y quieres llegar pronto al cómputo en memoria, merece una mirada seria. Para todos los demás, es una a seguir de cerca.
La verdadera diferencia entre estos chips es la apuesta por la memoria
Si te alejas del marketing, las ocho alternativas se ordenan en tres bandos según una sola decisión: cómo manejan la memoria. Esa única elección explica la mayoría de las diferencias en las fichas técnicas que acabas de leer.
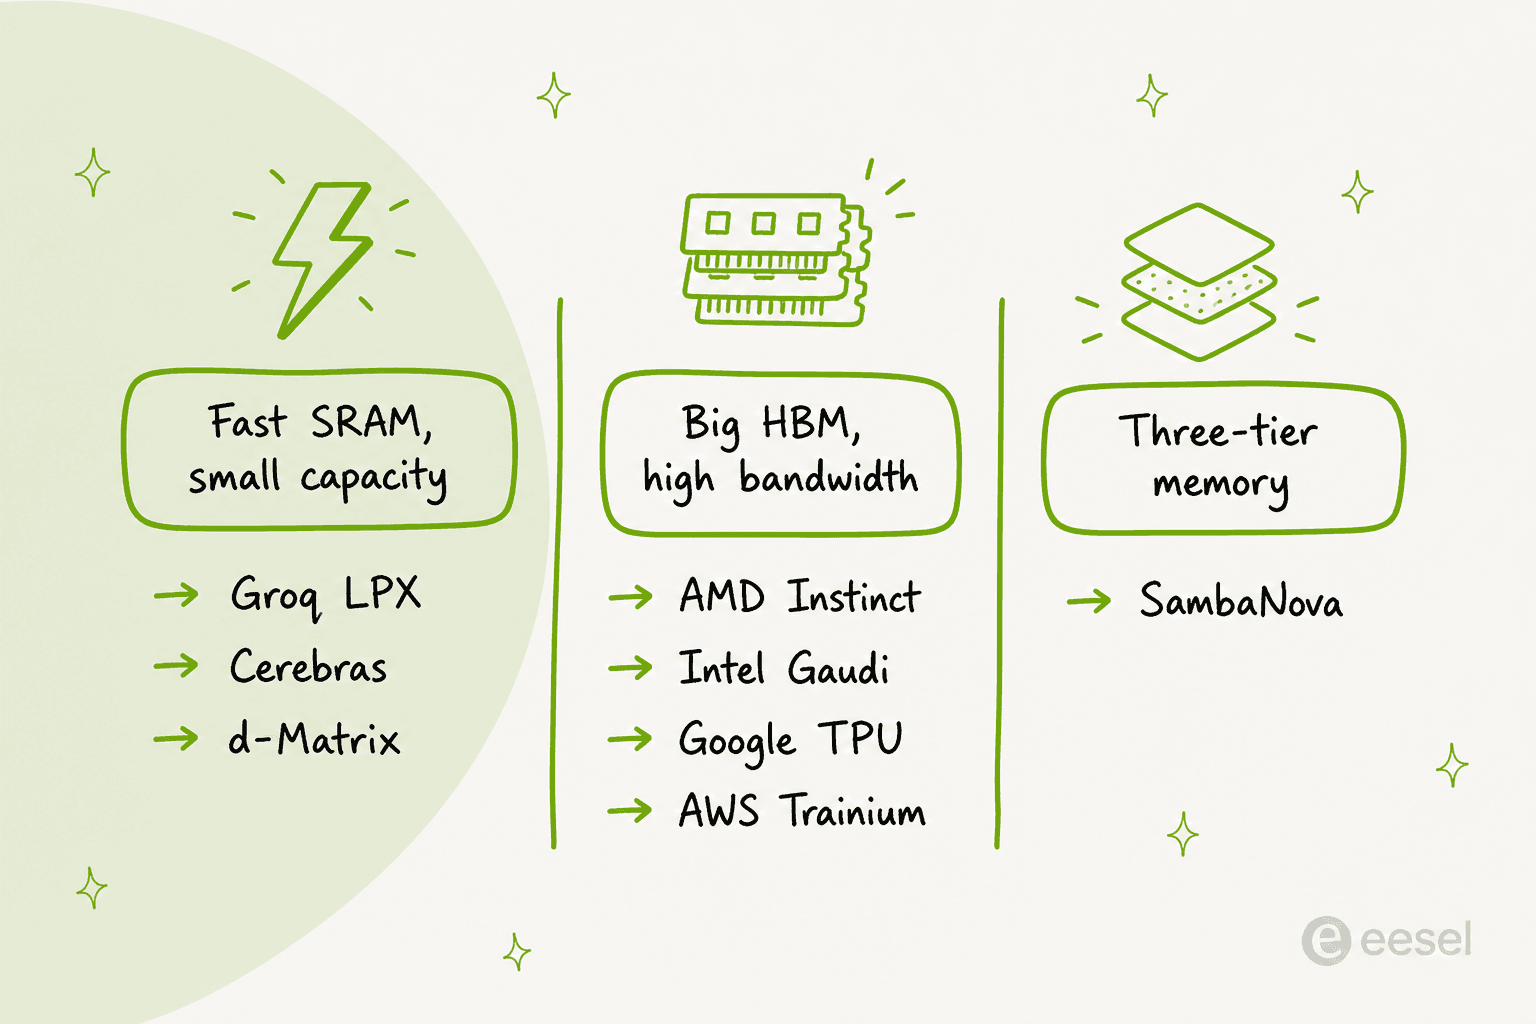
- SRAM rápida, poca capacidad. Groq, Cerebras y d-Matrix mantienen los datos de trabajo en SRAM ultrarrápida dentro del chip. Eso hace que la generación de tokens parezca instantánea, pero cada chip guarda muy poco, así que necesitas muchos para un modelo grande.
- HBM grande, alto ancho de banda. AMD, Intel, Google y AWS cargan mucha memoria de alto ancho de banda por acelerador. Eso permite que un modelo grande y una caché KV larga quepan en menos chips, razón por la que AMD insiste tanto en su ventaja de memoria por GPU.
- Memoria de tres niveles. SambaNova toma un punto medio con SRAM, HBM y DDR5, así que puede mantener residentes muchos modelos grandes y cambiar entre ellos rápido, una propiedad que premian las cargas de agentes.
No hay una respuesta universalmente correcta. Si tu carga es chat rápido en un modelo pequeño, gana el bando de la SRAM. Si es un modelo gigante o un agente multimodelo, gana la capacidad. Saber en qué bando estás te dice qué ocho preseleccionar más rápido que cualquier benchmark.
La pregunta más grande: probablemente no vas a comprar un rack
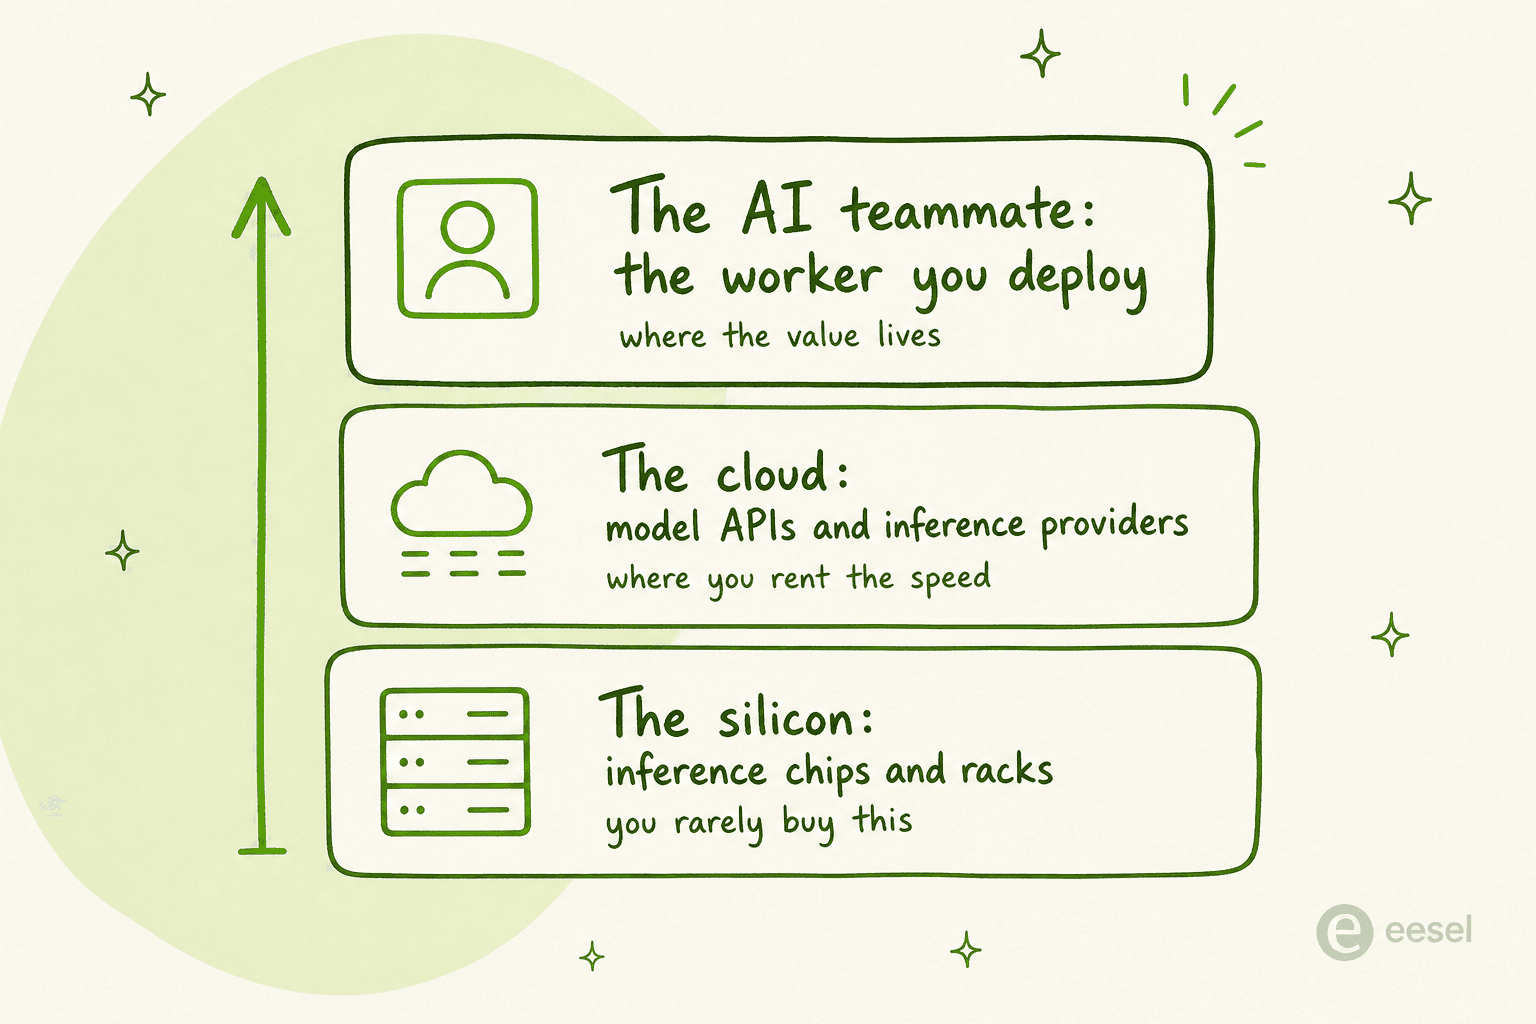
Esta es la parte en la que más quiero ser franco, porque es fácil perderse entre petaflops. A menos que operes una nube o una plataforma de IA muy grande, no vas a comprar Groq 3 LPX ni la mayoría de sus alternativas. Esto es infraestructura que está varias capas por debajo de donde ocurre realmente el trabajo. La notarás como tokens más rápidos y baratos en las APIs de modelos y nubes que ya usas, igual que nunca compraste una GPU para usar un agente de IA.
Y ese cambio en las cargas de trabajo es exactamente la razón por la que existe todo este silicio. Como lo expresó un analista en X:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
El replanteamiento útil es que el chip es el motor, y lo que realmente despliegas es el trabajador que va encima. Una inferencia más rápida hace que los agentes sean más ágiles y baratos de ejecutar, lo que baja la barrera para llevar automatización real a producción y desplaza las cuentas de costes en contra de hacer el trabajo a mano, ya sea un agente de programación, un agente de investigación o un agente de IA para helpdesk que atiende tu cola de soporte. La carrera del hardware consiste en hacer viable esa capa a escala. El valor sigue estando en la capa. Si quieres entender por qué la latencia es tan sensible, analizamos aparte los costes de inferencia de LLM.
Dónde encaja eesel, y por qué no le importa qué chip elegiste
Todos los chips de esta lista son fontanería. eesel es lo que contratas para hacer el trabajo encima. eesel es una plataforma de compañeros de IA: en lugar de aprovisionar inferencia o montar un pipeline, incorporas un compañero listo para trabajar en un rol concreto y lo conectas a tus apps. La plantilla actual incluye un compañero de IA para helpdesk que se une a tu cola de soporte como mucho más que un simple chatbot de soporte, y un redactor de blog con IA que produce contenido como este artículo.

La razón por la que la elección de chip no te afecta realmente es que eesel funciona sobre cualquier inferencia que haya debajo, y lo que decide si es bueno no son los tokens por segundo. Es la precisión. Los años que llevamos ejecutando IA en colas de soporte reales nos enseñaron la mitad poco glamurosa: un compañero de soporte que responde en un segundo en lugar de en ocho es toda la experiencia para el cliente que espera, pero la velocidad solo ayuda si la respuesta es correcta. Esa es la diferencia entre un agente que realmente desvía tickets de nivel 1 y uno que solo frustra a la gente, y por eso eesel simula un despliegue con tus tickets pasados antes de responder a un cliente real. Todo el silicio del mundo no arregla una respuesta equivocada dicha con seguridad. Si prefieres desplegar el compañero en lugar de buscar un rack, puedes probar eesel gratis.