Un modelo que llegó antes que su propio comunicado
La mayoría de los lanzamientos son una entrada de blog, un gráfico de benchmarks y una ficha de modelo, todo a la vez. M3.1 Flash hizo lo contrario. Apareció en el selector de modelos de MiniMax Code, junto a M3 y M2.7, y la comunidad lo encontró ahí antes de que MiniMax dijera nada. El desarrollador que lo destapó notó de inmediato el nuevo menú de razonamiento:
"🚨重磅!MiniMax M3.1-Flash 预览版疑似已上线 MiniMax Code!推理等级单独成菜单:low / medium / high / xhigh / max。目前还没有官方公告,属于先露在产品里的灰度上线。" (Traducción: "¡Gran noticia! La preview de MiniMax M3.1-Flash parece estar activa en MiniMax Code. Los niveles de razonamiento tienen su propio menú: low / medium / high / xhigh / max. Todavía no hay anuncio oficial, es un despliegue gris/escalonado que se muestra primero en el producto.")
El despliegue también llegó con cierto suspiro. MiniMax ha estado lanzando modelos de vídeo y música a buen ritmo, la serie M (texto) se había quedado callada, y la respuesta con más likes bajo la publicación del lanzamiento se leyó como impaciencia cariñosa:
"You finally remembered the M series"
El bombo también tiene su trastienda. Durante días antes, los desarrolladores habían estado probando a fondo un modelo sigiloso gratuito llamado "Space Bunny" y adivinando qué era; la respuesta llegó pocos días antes del lanzamiento:
"Confirmed, Space Bunny Alpha is Minimax M3.1"
Así que la emoción es real, pero el "lanzamiento" es una preview escalonada y primero en el producto. Si estás decidiendo si construir sobre él, esa distinción importa más que el bombo: una preview de despliegue gris sin precio y sin pesos no es el mismo compromiso que un modelo GA.
Qué es realmente MiniMax M3.1 Flash
Quitando el teatro del lanzamiento, las docs de la plataforma son claras sobre lo esencial. En la tabla de modelos compatibles, M3.1 Flash se describe como un "frontier multimodal coding model with 1M context window and tunable thinking depth", pensado para razonamiento agéntico, uso de herramientas, programación y ejecución de tareas estructuradas. Acepta texto, imágenes y vídeo como entrada.
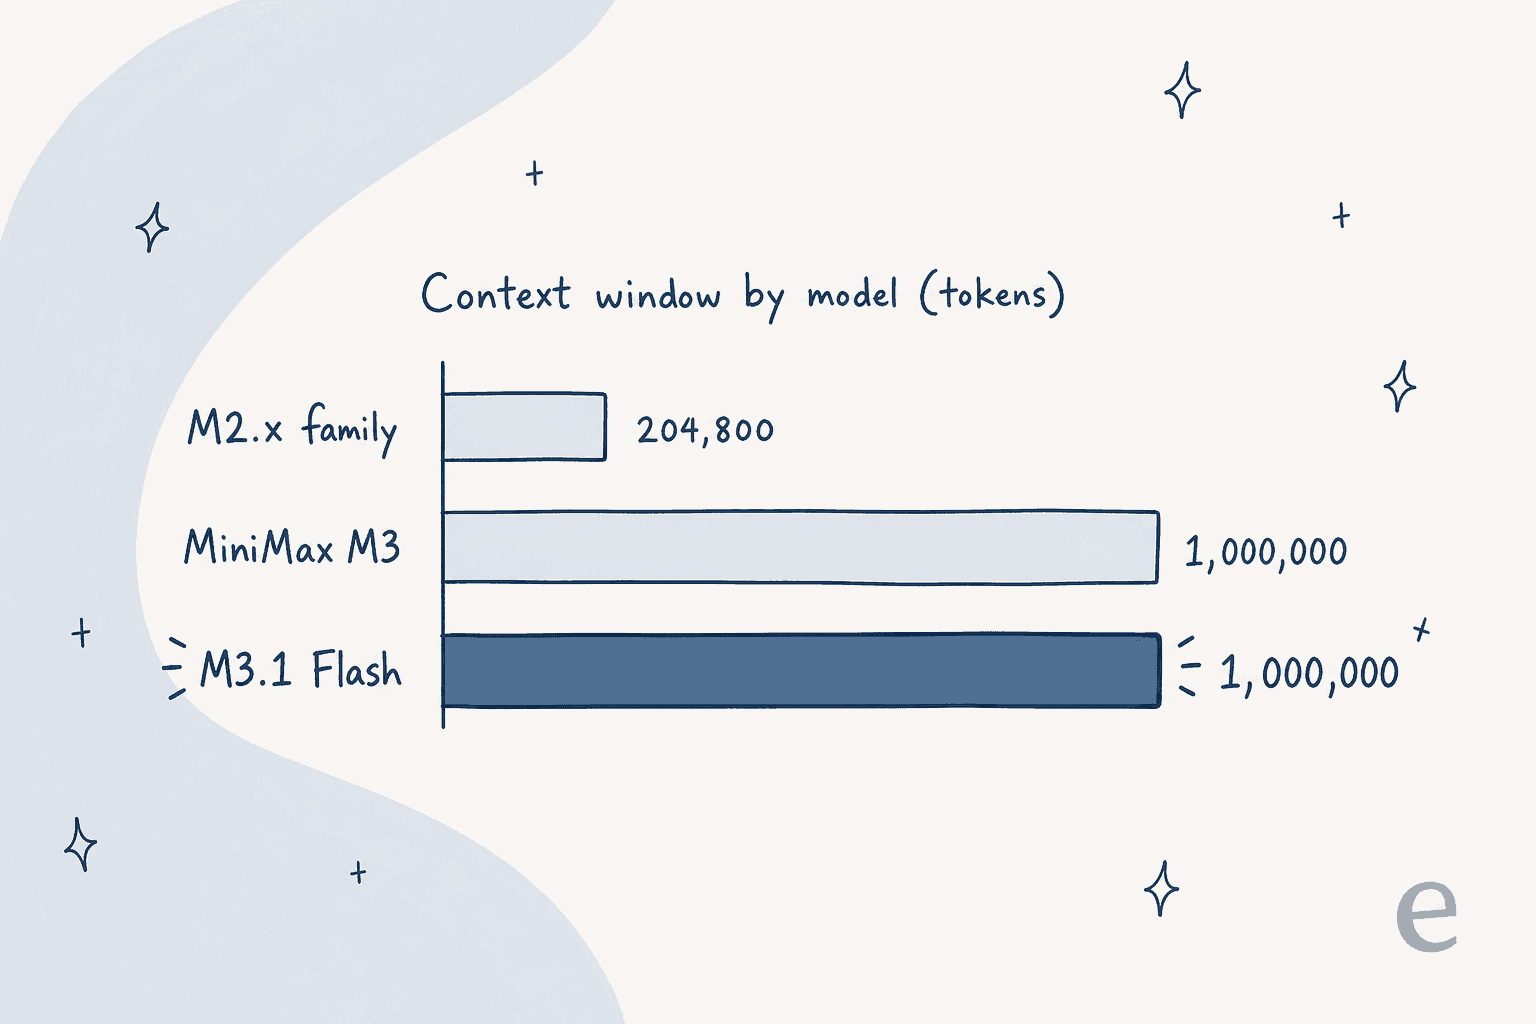
El contexto de 1M es la especificación estrella, y es un salto real dentro de la serie M, no un redondeo de marketing. Toda la familia M2 llegaba como máximo a 204.800 tokens; la generación M3, con M3.1 Flash incluido, es un salto limpio de cinco veces.
Esto es lo que las docs confirman y lo que no:
| Atributo | MiniMax M3.1 Flash |
|---|---|
| Id del modelo | MiniMax-M3.1-Flash-Preview |
| Ventana de contexto | 1.000.000 de tokens |
| Modalidades de entrada | Texto, imagen, vídeo |
| Razonamiento | Activado por defecto, ajustable con effort, no se puede desactivar |
| Disponibilidad | Solo Token Plan + MiniMax Code |
| Pesos abiertos | Ninguno (sin ficha en Hugging Face) |
| Número de parámetros | No indicado |
| Rendimiento (tps) | No indicado |
| Precio por token | No publicado |
Esa tabla es deliberadamente honesta con los huecos. No hay número de parámetros, ni cifra oficial de tokens por segundo, ni suite de benchmarks para M3.1 Flash en concreto. Si una página te dice que el modelo tiene "428B parámetros" o cita una puntuación de benchmark, la está tomando prestada del M3 original, no de M3.1 Flash. Prefiero señalar el vacío antes que maquillarlo.
El único control que lo define: effort
La única característica que las docs destacan para M3.1 Flash y no para M3 es la profundidad de razonamiento ajustable. El modelo siempre razona antes de responder, y tú controlas cuánto piensa con un ajuste effort que acepta low, medium, high, xhigh y max. Si lo omites, por defecto es max.
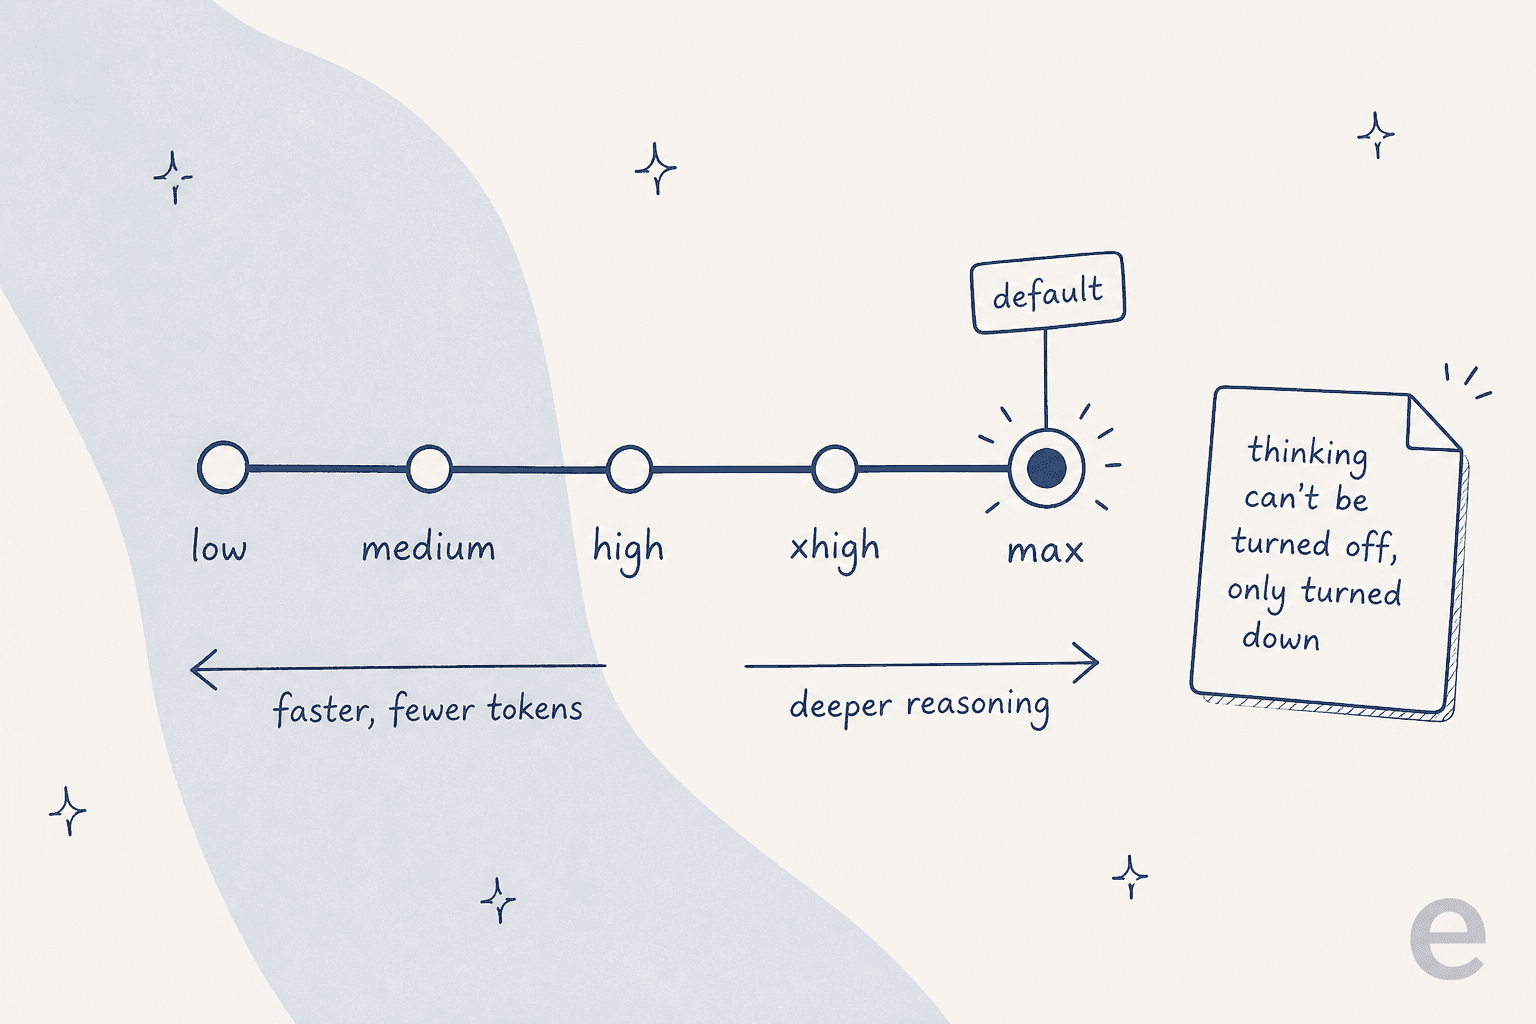
El detalle que suele sorprender: no puedes apagar el razonamiento. Si envías thinking: {"type": "disabled"} o effort: "none", la API devuelve un 400 con el mensaje requires adaptive thinking (docs). Si necesitas menor latencia o menos tokens de salida, bajas effort a low; no hay modo sin razonamiento. Es una opinión de diseño real y conviene conocerla antes de conectarlo a una ruta sensible a la latencia. Para un modelo "Flash", usar max por defecto es una elección algo sorprendente, y significa que el comportamiento barato y rápido que cabría esperar por el nombre hay que activarlo a propósito.
¿Es realmente rápido?
MiniMax no publicó una cifra de rendimiento, así que los únicos datos reales de velocidad vienen de desarrolladores que lo probaron el primer día. La medición más citada situó la velocidad de decodificación en un rango sólido, pero no líder de categoría:
"MiniMax-M3.1-flash-preview is hanging around 90 - 110 t/s range for decode. It's fast, love seeing it, def faster than MiMo-v2.6-flash but not as fast as deepseek-v4.1-flash"
Ese es el posicionamiento honesto: rápido, por delante de algunos rivales de nivel flash y por detrás de otros. Y no todos están convencidos de que la velocidad de decodificación pura sea lo que hay que celebrar:
"Decode speed is not equivalent to fast. The model is slow for the quality in my opinion, numbers dropping soon!"
Creo que ese escéptico tiene un punto que vale la pena retener. Un modelo que usa max de effort por defecto y no puede dejar de pensar se sentirá más lento en tareas reales de lo que sugiere una cifra de tokens por segundo, porque genera muchos tokens de razonamiento antes de la respuesta. La pregunta útil no es "cuántos tokens por segundo", sino "cuánto tarda en llegar una respuesta correcta que pueda publicar", y ese es un benchmark que nadie ha ejecutado aún con M3.1 Flash.
La arquitectura de fondo
Las docs no repiten los detalles internos de M3.1 Flash, así que lo justo es tratar la arquitectura como heredada de la generación M3 y no como una especificación confirmada de M3.1 Flash. La línea M3 introdujo MiniMax Sparse Attention (MSA), un diseño de atención dispersa que hace práctico un contexto de un millón de tokens en lugar de ruinosamente lento.
La propia comparación de MiniMax con la atención estándar de consulta agrupada (GQA) es la ilustración más clara de por qué la atención dispersa importa con esta longitud de contexto:
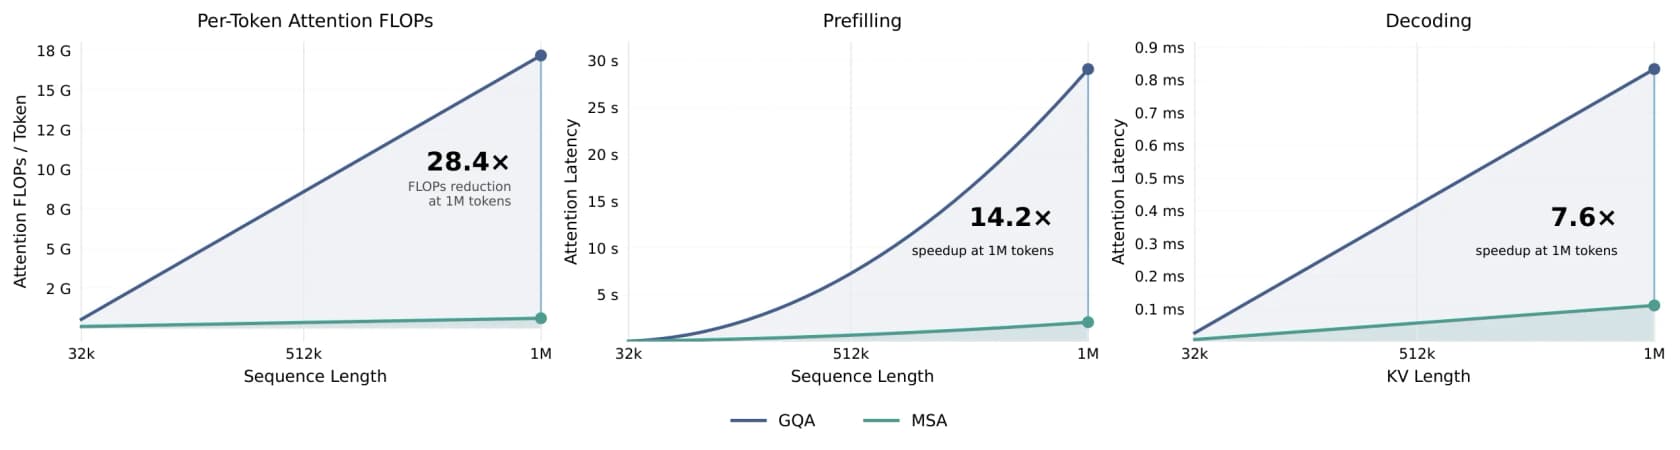
Con un millón de tokens, el gráfico de MiniMax muestra que MSA reduce el cómputo de atención por token en unas 28 veces y acelera la decodificación ~7,6 veces frente a la atención estándar. Son cifras de la generación M3; como M3.1 Flash tiene la misma ventana de 1M, casi seguro se apoya en la misma arquitectura, pero no las citaría como especificación medida de M3.1 Flash hasta que MiniMax publique una.
Cuánto cuesta
Aquí M3.1 Flash resulta realmente inusual: no hay precio por token en ninguna parte. No está en la tabla de pago por uso, y las propias docs de MiniMax dicen que por ahora solo está disponible mediante el Token Plan y MiniMax Code. Así que su coste real es tu suscripción dividida por cuánto lo uses.
Este es el Token Plan, una cuota compartida entre texto, imagen y voz:
| Plan | Mensual | Anual (2 meses gratis) | ~Tokens M3 / mes | Generación de vídeo |
|---|---|---|---|---|
| Plus | 20 $ | 220 $ | ~1,7B | Ninguna |
| Max | 50 $ | 550 $ | ~5,1B | 3 clips/día |
| Ultra | 120 $ | 1.320 $ | ~12,5B | 5 clips/día |
También hay una opción de Credits prepago (5 $ por 5.000, 25 $ por 25.000, 100 $ por 100.000, válidos un año) y ningún nivel gratuito de LLM. La cuota se reinicia en ventanas móviles de 5 horas y semanales, y la cuota mensual no usada no se acumula.
Si quieres una idea de lo que podría cobrar una API pública en el futuro, su hermano de 1M de contexto MiniMax M3 está en pago por uso. Son tarifas de M3, no de M3.1 Flash, pero la estructura probablemente anticipa lo que viene:
| MiniMax M3 (nivel estándar) | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| ≤ 512K de entrada | 0,30 $ /M | 1,20 $ /M | 0,06 $ /M |
| > 512K de entrada | 0,60 $ /M | 2,40 $ /M | 0,12 $ /M |
Dos cosas estructurales a tener en cuenta: un umbral de 512K de entrada que duplica la tarifa por encima, y un nivel de servicio Priority que cuesta 1,5x la tarifa estándar. Barato para su categoría, en otras palabras, pero con un recargo por contexto largo incorporado.
Cómo ejecutarlo de verdad
Para ser una preview, el acceso es sorprendentemente amigable para desarrolladores. M3.1 Flash habla dos protocolos: un endpoint compatible con Anthropic en https://api.minimax.io/anthropic (la vía recomendada por MiniMax, con bloques de thinking) y uno compatible con OpenAI en https://api.minimax.io/v1. El campo effort simplemente está en un lugar distinto según cuál uses: output_config.effort en la API de Anthropic, reasoning_effort en la de OpenAI.
Como es compatible con Anthropic y OpenAI, puedes apuntar herramientas agénticas de programación existentes directamente a él. MiniMax enumera Claude Code, Cursor, Codex CLI y otras como compatibles mediante el Token Plan, sin necesidad de otra API key. Ese es el caso de uso real que persigue la combinación "Flash + preview": un modelo por defecto barato y rápido para programación cotidiana y bucles de agentes, dentro de las herramientas en las que los desarrolladores ya viven.
Dónde encaja un modelo así
Lo que me devuelve al enfoque del principio. M3.1 Flash es un motor rápido con una ventana de contexto grande y un dial de razonamiento. Eso es infraestructura. Es la capacidad en bruto, expuesta como endpoint, y es genuinamente buena en lo que hace. Pero un endpoint no conoce tu empresa, no está dentro de tu helpdesk y no se hace cargo de un trabajo de principio a fin. Todo eso tienes que construirlo tú alrededor.
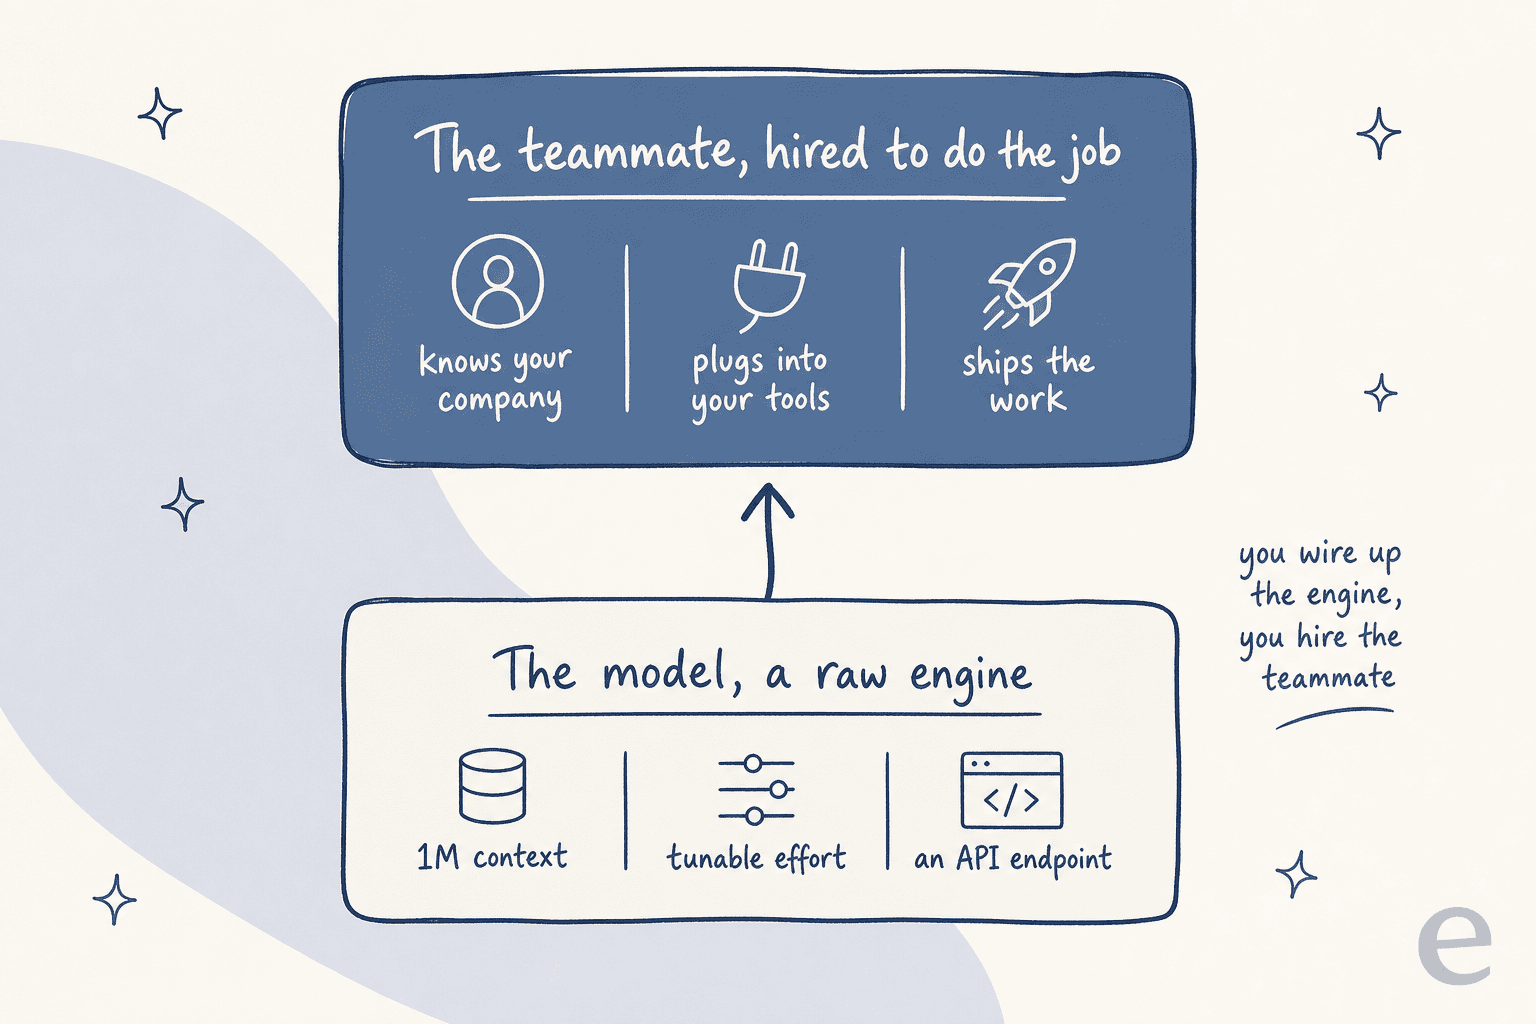
Esa brecha entre "un modelo capaz" y "trabajo que realmente se hace" es toda la razón de ser de eesel. eesel es una plataforma de compañeros de IA: en lugar de darte un modelo y un editor en blanco, contratas a un compañero listo para trabajar en una tarea concreta. La plantilla actual incluye un compañero de IA para helpdesk que se une a tu cola de soporte existente y un redactor de blog con IA que investiga y redacta publicaciones con tu voz. Cada uno llega sabiendo ya hacer su rol y se conecta a las herramientas que ya usas.
Si vives en una terminal, la eesel CLI es la parte que más familiar te resultará tras leer una página de docs como la de MiniMax. Es el mismo compañero que en el panel, manejado desde la línea de comandos: puedes conectar un helpdesk, subir conocimiento, configurar automatizaciones y aprobar acciones retenidas sin abrir nunca la interfaz. Cada comando imprime JSON, y los errores llegan como objetos estructurados {error, hint, retryable}, de modo que un agente de programación como Claude Code, Cursor o Codex puede llevar toda la configuración leyendo el campo hint y decidiendo qué ejecutar después. Además, cada workspace funciona como servidor MCP, así que el mismo agente que llama a M3.1 Flash puede llamar a eesel. El modelo mental es simple: el modelo es el motor que conectas; el compañero es a quien contratas.
Prueba eesel
Si M3.1 Flash te entusiasma porque quieres que la IA haga trabajo real y no solo responda llamadas a una API, esa última milla es lo que gestiona eesel. Apúntalo a tus tickets pasados y a tu centro de ayuda, y el compañero de IA para helpdesk empieza a redactar respuestas reales en minutos; o dale un tema al redactor de blog con IA y investiga, redacta e ilustra una publicación completa con tu voz, igual que se hizo esta.
Lo mejor es que puedes verlo trabajar antes de comprometerte, ya que eesel se ejecuta primero contra tu propio historial y ves la calidad en tus tickets reales, no en una demo. Es gratis para empezar, sin tarjeta de crédito, para que veas por ti mismo la diferencia entre alquilar un modelo y contratar a un compañero.
Preguntas frecuentes
¿Qué es MiniMax M3.1 Flash?
MiniMax-M3.1-Flash-Preview) es el último modelo de la serie M de MiniMax: un modelo multimodal de programación con una ventana de contexto de 1.000.000 de tokens y una profundidad de razonamiento ajustable. Llegó como preview dentro de MiniMax Code y del Token Plan el 27 de septiembre de 2026, y está pensado para trabajo rápido y cotidiano de programación y agentes. Si quieres que un modelo así haga un trabajo real en lugar de quedarse detrás de una API, un compañero de IA como eesel es la capa que lo convierte en trabajo.¿Cuánto cuesta MiniMax M3.1 Flash?
¿MiniMax M3.1 Flash es de código abierto o está en Hugging Face?
¿En qué se diferencia M3.1 Flash de MiniMax M3?
¿Se puede desactivar el razonamiento en MiniMax M3.1 Flash?
effort: "none" o thinking: disabled devuelve un error 400. Para reducir latencia y uso de tokens, bajas el nivel de effort en lugar de apagar el razonamiento.

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.