Las 7 mejores alternativas a Gemini 4 Neon en 2026, clasificadas por coste por tarea

Kira

Katelin Teen
Última edición 19 de noviembre de 2026
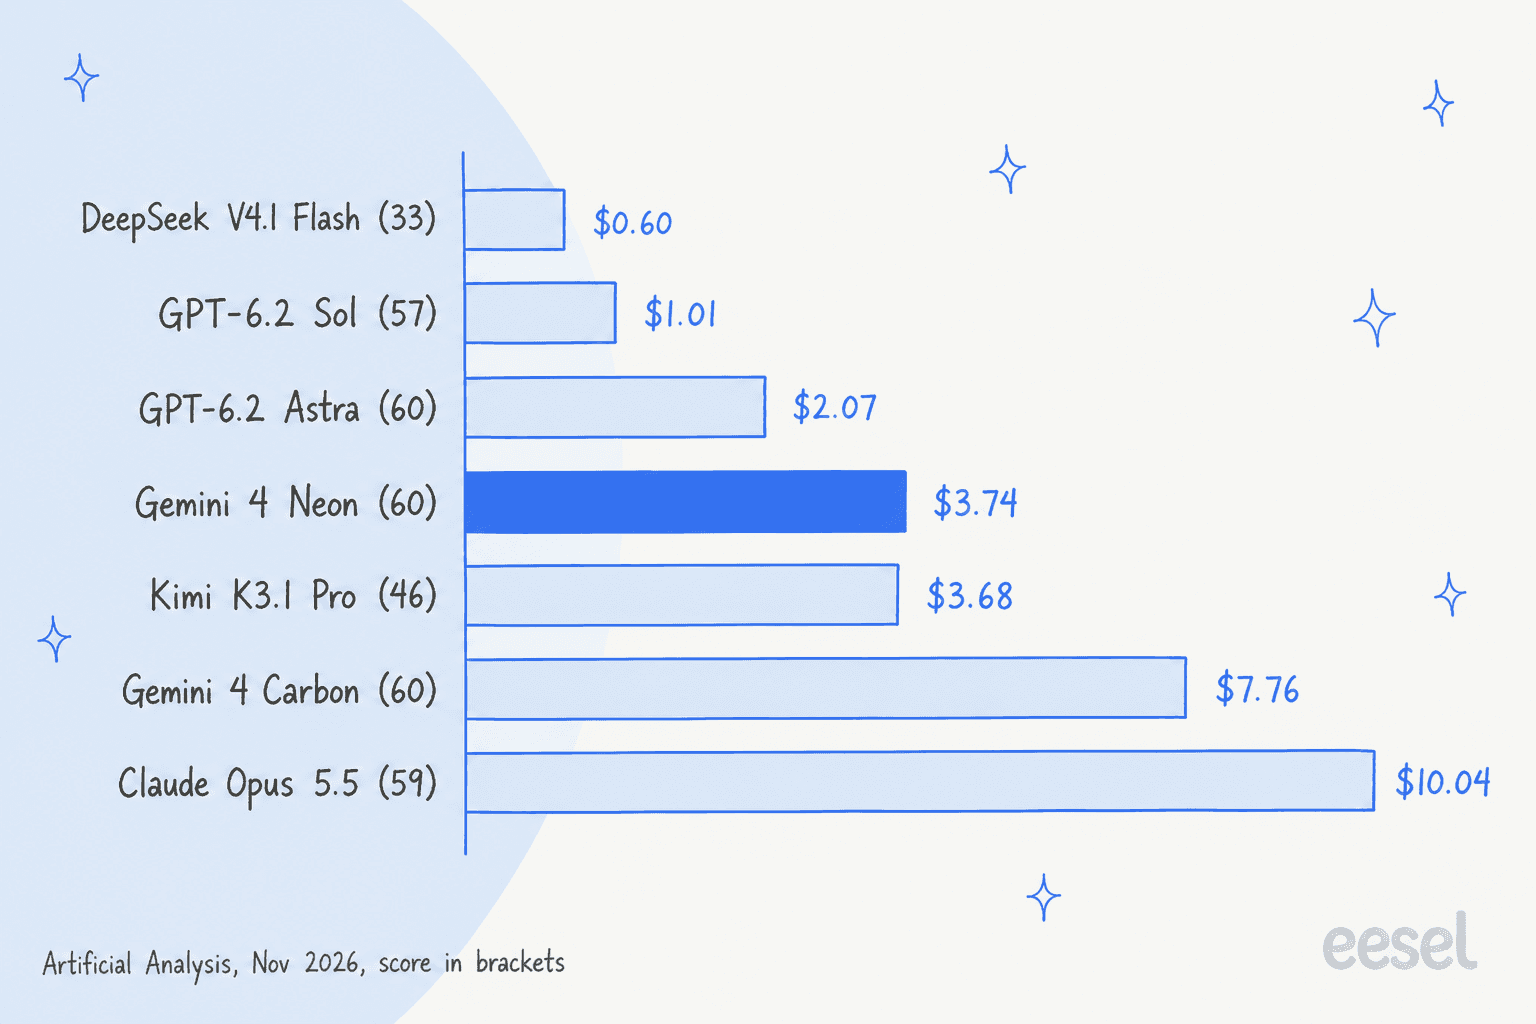
La mejor alternativa a Gemini 4 Neon es GPT-6.2 Sol: Artificial Analysis le da 57,3 por $1,01 por tarea, frente al 59,6 de Neon por $3,74. Astra iguala el puntaje de Neon por $2,07, Opus 5.5 cuesta $10,04, y Carbon, Kimi K3.1 Pro y DeepSeek ganan en honestidad, pesos abiertos o precio masivo. La ventaja de Neon es que falla el 14 % de las preguntas sin respuesta, no el 55 %. Para un bot de soporte, un compañero de equipo de helpdesk de eesel toma esta decisión por ti y la prueba con tus tickets anteriores.
¿Por qué la gente busca alternativas a Gemini 4 Neon?
Gemini 4 Neon es el modelo intermedio de la familia Gemini 4 de Google, lanzado el 18 de noviembre de 2026. Cuesta $3 de entrada y $15 de salida por millón de tokens, tiene una ventana de contexto de 1.048.576 tokens y no tiene capa gratuita. Mi análisis de Neon lo encontró un modelo sólido: cuesta alrededor de la mitad que Carbon por tarea, e inusualmente dispuesto a decir "no lo sé".
Los motivos para mirar otras opciones giran todos en torno a la factura y al stack. Neon escribe muchos tokens, así que cuesta más por tarea que los modelos de OpenAI, y un lector de Hacker News lo notó el día del lanzamiento:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."

Otros quieren un proveedor que no sea Google, pesos abiertos que puedan alojar ellos mismos, o un modelo más rápido en un chat en vivo. Son trabajos distintos, así que ordené las alternativas por trabajo y puse un número debajo de todas: el coste por tarea.
Si quieres probar cualquiera de estos modelos con preguntas de soporte sin montar tu propio arnés de pruebas, el CLI de eesel permite que un agente de código suba artículos de ayuda y macros aprobados a un compañero de equipo de helpdesk de eesel, haga preguntas de prueba y revise las respuestas antes de que nada salga en vivo. Conectar el propio helpdesk sigue necesitando la aprobación de un administrador.
Cómo elegí estas alternativas
Partí de lo que ve un comprador. Le pregunté a ChatGPT, en un chat nuevo, qué alternativas comparar frente a Gemini 4 Neon para una app. Nombró seis, en este orden: GPT-6.2 Astra, Claude Opus 5.5, GPT-6.2 Sol, Gemini 4 Carbon, Kimi K3 y DeepSeek V4.1 Flash. También le dijo a quien preguntaba que comparara "coste por tarea exitosa", llamadas a herramientas, validez del JSON, latencia y reintentos, no el precio por millón de tokens. Seguí ese enfoque y añadí Claude Sonnet 5.5, porque comparte el precio de Sol pero se comporta de forma muy distinta.
Para cada modelo usé tres fuentes, todas revisadas el 19 de noviembre de 2026:
- Las páginas propias del proveedor: precios, página del modelo, ventana de contexto y soporte de herramientas, enlazadas en cada sección más abajo. Todos los precios de este artículo vienen de esas páginas, no de terceros.
- Artificial Analysis: sus resultados por configuración de puntaje, coste por tarea, minutos por tarea y tasa de alucinación. Una "tarea" es una tarea de referencia de su Intelligence Index, no uno de tus tickets.
- Hacker News: los hilos de lanzamiento de Neon, Astra y Sol, donde los desarrolladores publicaron sus propios costes y tiempos.
No he probado Neon con mis propias pruebas, porque no tengo una clave de Google para él. Sí hice una prueba de 90 ejecuciones con Astra y Sol en soporte la semana pasada, y uso esos resultados donde aplican. Trata la clasificación como una preselección y luego usa la sección de pruebas para comprobarla con tu trabajo.
¿Qué dice el coste por tarea sobre las alternativas de Neon?
El precio por token es solo la mitad de la historia. La factura es el precio multiplicado por cuántos tokens escribe el modelo, y los tokens de pensamiento cuentan como salida. Artificial Analysis publica las dos mitades, así que esta es la tabla por la que yo empezaría:
| Modelo y configuración | Puntaje del índice | Coste por tarea | Minutos por tarea | Tokens de salida por tarea | Falla cuando no está seguro |
|---|---|---|---|---|---|
| Gemini 4 Neon high (predeterminado) | 59,6 | $3,74 | 14,8 | 90.188 | 14 % |
| Gemini 4 Neon medium | 54,9 | $1,90 | 8,3 | 50.000 | 16 % |
| GPT-6.2 Astra max | 62,1 | $4,00 | 13,7 | 41.029 | 59 % |
| GPT-6.2 Astra high | 60,1 | $2,07 | 5,9 | 17.828 | 58 % |
| GPT-6.2 Sol max | 57,3 | $1,01 | 8,5 | 40.360 | 55 % |
| GPT-6.2 Sol high | 54,9 | $0,56 | 4,6 | 20.160 | 60 % |
| Claude Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 | 50 % |
| Claude Opus 5.5 medium (predeterminado de la API) | 48,2 | $2,45 | 6,9 | 43.817 | 67 % |
| Claude Sonnet 5.5 max | 54,5 | $10,02 | 32,6 | 285.387 | 43 % |
| Claude Sonnet 5.5 high (predeterminado de la API) | 41,5 | $1,64 | 7,2 | 58.421 | 64 % |
| Gemini 4 Carbon high | 60,0 | $7,76 | 37,2 | 122.768 | 11 % |
| Kimi K3.1 Pro | 46,5 | $3,68 | 39,4 | 72.239 | 37 % |
| DeepSeek V4.1 Flash 1017 max | 32,6 | $0,60 | 13,7 | 138.962 | 64 % |
Todo en la tabla se leyó el 19 de noviembre de 2026 en Artificial Analysis. "Falla cuando no está seguro" es su tasa de alucinación AA-Omniscience, donde menos es mejor. Las páginas de los modelos:
- Gemini 4 Neon y Gemini 4 Carbon
- GPT-6.2 Astra
- Claude Opus 5.5
- Claude Sonnet 5.5
- Kimi K3.1 Pro
- DeepSeek V4.1 Flash 1017
Destacan cuatro cosas:
- Mismo puntaje, factura distinta. Astra en high llega a 60,1 por
$2,07, un45 %menos que el$3,74de Neon por 59,6. Opus 5.5 al máximo cuesta$10,04por 59,1, unas 2,7 veces más que Neon. - Sol en high iguala a Neon en medium. Ambos puntúan 54,9, pero Sol cuesta
$0,56y Neon$1,90. - DeepSeek no es barato por tarea. Su precio de entrada es 13 veces más bajo que el de Sol, pero una tarea cuesta
$0,60frente a los$0,56de Sol high, con un puntaje de 32,6 frente a 54,9. Escribe 138.962 tokens para lograrlo. - Neon es el honesto. Con
14 %, solo Carbon le gana entre los modelos de arriba que puntúan cerca de 60. Sol, Astra y Opus fallan entre el 50 % y el 59 % de las preguntas sin respuesta.
El motivo es la verbosidad, y es la parte del mecanismo que la gente se salta. Los tokens de salida son el lado caro de cualquier tarifa, y cada modelo tiene su propia costumbre de cuántos escribe antes de responder:
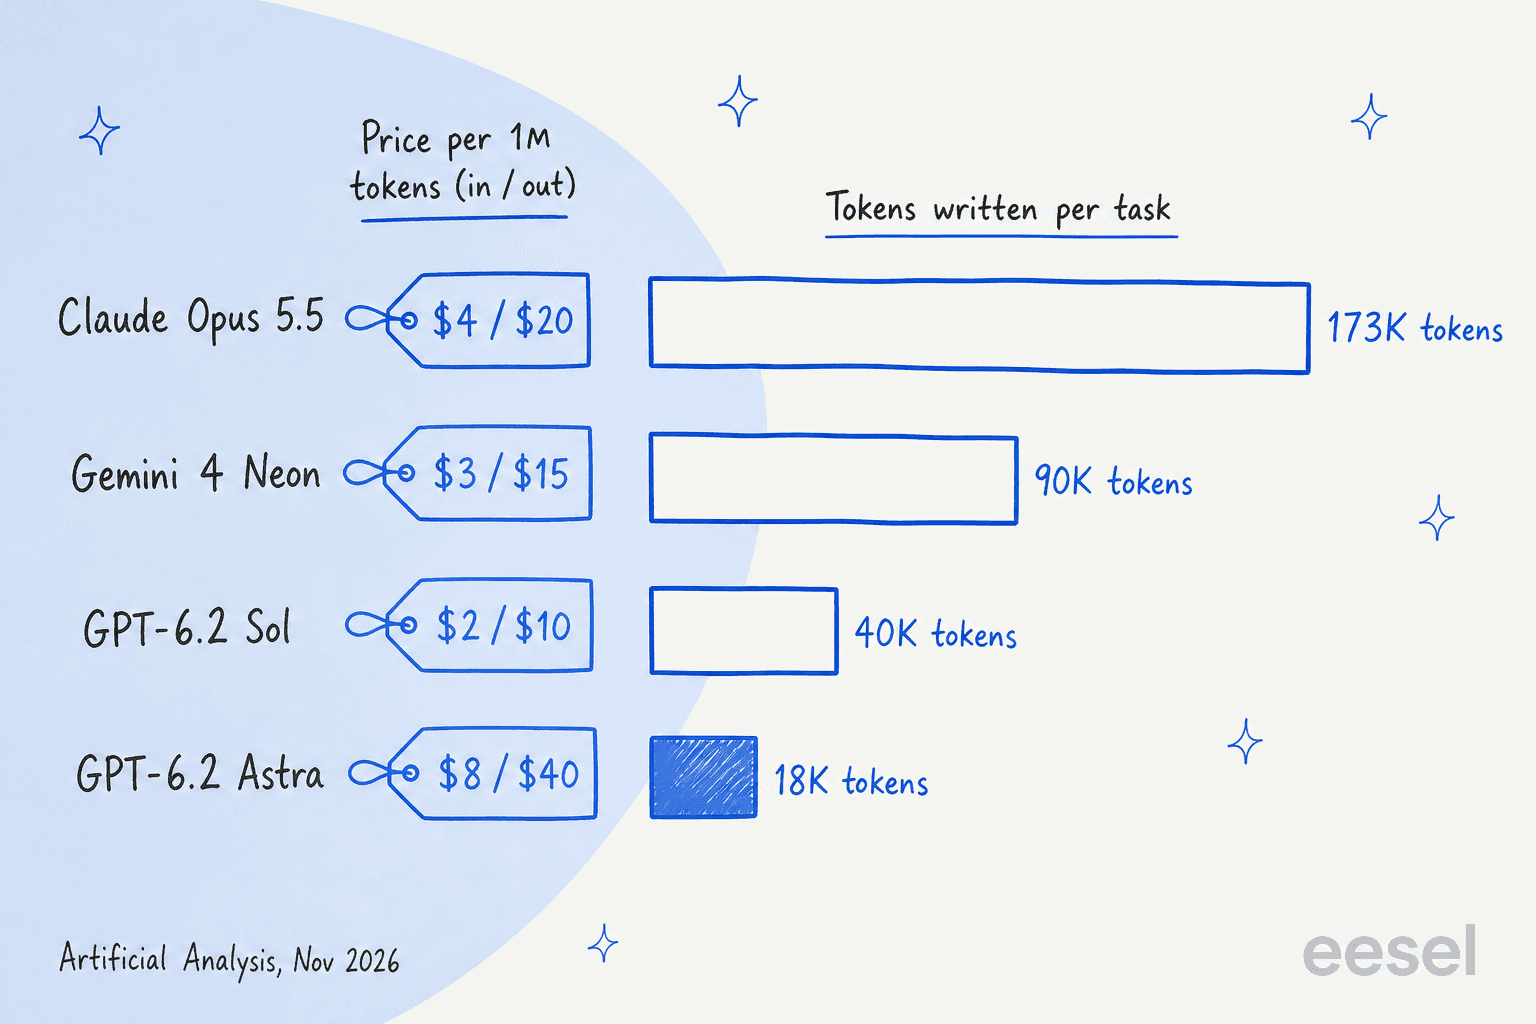
El gráfico usa la configuración de mayor puntaje de cada modelo para Opus y Sol, y la configuración predeterminada high para Neon y Astra. Astra tiene la etiqueta más cara de los cuatro y la costumbre más barata: escribe cerca de una quinta parte de lo que escribe Neon para el mismo puntaje. Por eso digo que no hay que comparar tarifas por token.
Alternativas a Gemini 4 Neon de un vistazo
Aquí está todo lo demás que pregunta un comprador, de los propios documentos de cada proveedor:
| Modelo | Precio por 1M (entrada/salida) | Entrada en caché | Contexto | Mejor puntaje (configuración) | Capa gratuita de API | Pesos abiertos | Opción de residencia de datos |
|---|---|---|---|---|---|---|---|
| Gemini 4 Neon (referencia) | $3 / $15 | $0,15, solo implícita | 1.048.576 | 61,4 (xhigh) | Ninguna | No | Región global, us o eu en la plataforma empresarial de Google |
| GPT-6.2 Astra | $8 / $40 | $0,40 | 1.050.000 | 62,1 (max) | Ninguna listada | No | Endpoints regionales, +10 % |
| GPT-6.2 Sol | $2 / $10 | $0,10 | 1.050.000 | 57,3 (max) | Ninguna listada | No | Endpoints regionales, +10 % |
| Claude Opus 5.5 | $4 / $20 | $0,20 | 1M | 59,1 (max) | Créditos de prueba gratis para usuarios nuevos | No | Inferencia solo en EE. UU., +10 % |
| Claude Sonnet 5.5 | $2 / $10 | $0,10 | 1M | 54,5 (max) | Créditos de prueba gratis para usuarios nuevos | No | Inferencia solo en EE. UU., +10 % |
| Gemini 4 Carbon | $2 / $10 hasta el 30 de nov., luego $4 / $20 | $0,10, luego $0,20, solo implícita | 1.048.576 | 60,0 (high) | Ninguna | No | No verificada para Carbon (la guía de Neon lista global, us, eu) |
| Kimi K3.1 Pro | $2 / $10 | $0,20 | 1.048.576 | 46,5 | Ninguna listada | Sí, bajo la propia licencia de Moonshot | No documentada en la página de precios |
| DeepSeek V4.1 Flash | $0,15 / $0,60 fuera de hora pico, $0,30 / $1,20 en hora pico | $0,003 fuera de hora pico, $0,006 en hora pico | 1M | 32,6 (max) | Ninguna listada | Sí, MIT | No documentada en la página de precios |
Dos notas. "Ninguna listada" significa que la página de precios del proveedor no menciona una capa gratuita de API, no que yo haya confirmado que no existe. Y el precio de Carbon se duplica el 1 de diciembre, lo cual importa porque Artificial Analysis calcula su coste por tarea al precio más alto de diciembre.
¿Cuánto costaría cada alternativa al mes?
El coste por tarea es una cifra de referencia, y tu tarea es más pequeña. Esta calculadora escala el coste por tarea de Artificial Analysis según cuán grande es tu tarea frente a una tarea de referencia, lo multiplica por tu volumen, y conserva solo las configuraciones que alcanzan el puntaje que necesitas. Es una estimación, así que úsala para ver la forma de la brecha y luego mide tu propio trabajo.
Con los valores predeterminados, 10.000 respuestas cortas de ticket al mes y un límite de puntaje de 55, Sol max cuesta unos $505 al mes y Neon high unos $1.870. Si mueves el límite de puntaje a 60, Sol queda fuera, lo que es el trato honesto: pagas por los últimos cinco puntos.
1. GPT-6.2 Astra
Mejor para: equipos que quieren el puntaje de Neon y están dispuestos a pagar una factura más baja por ello.
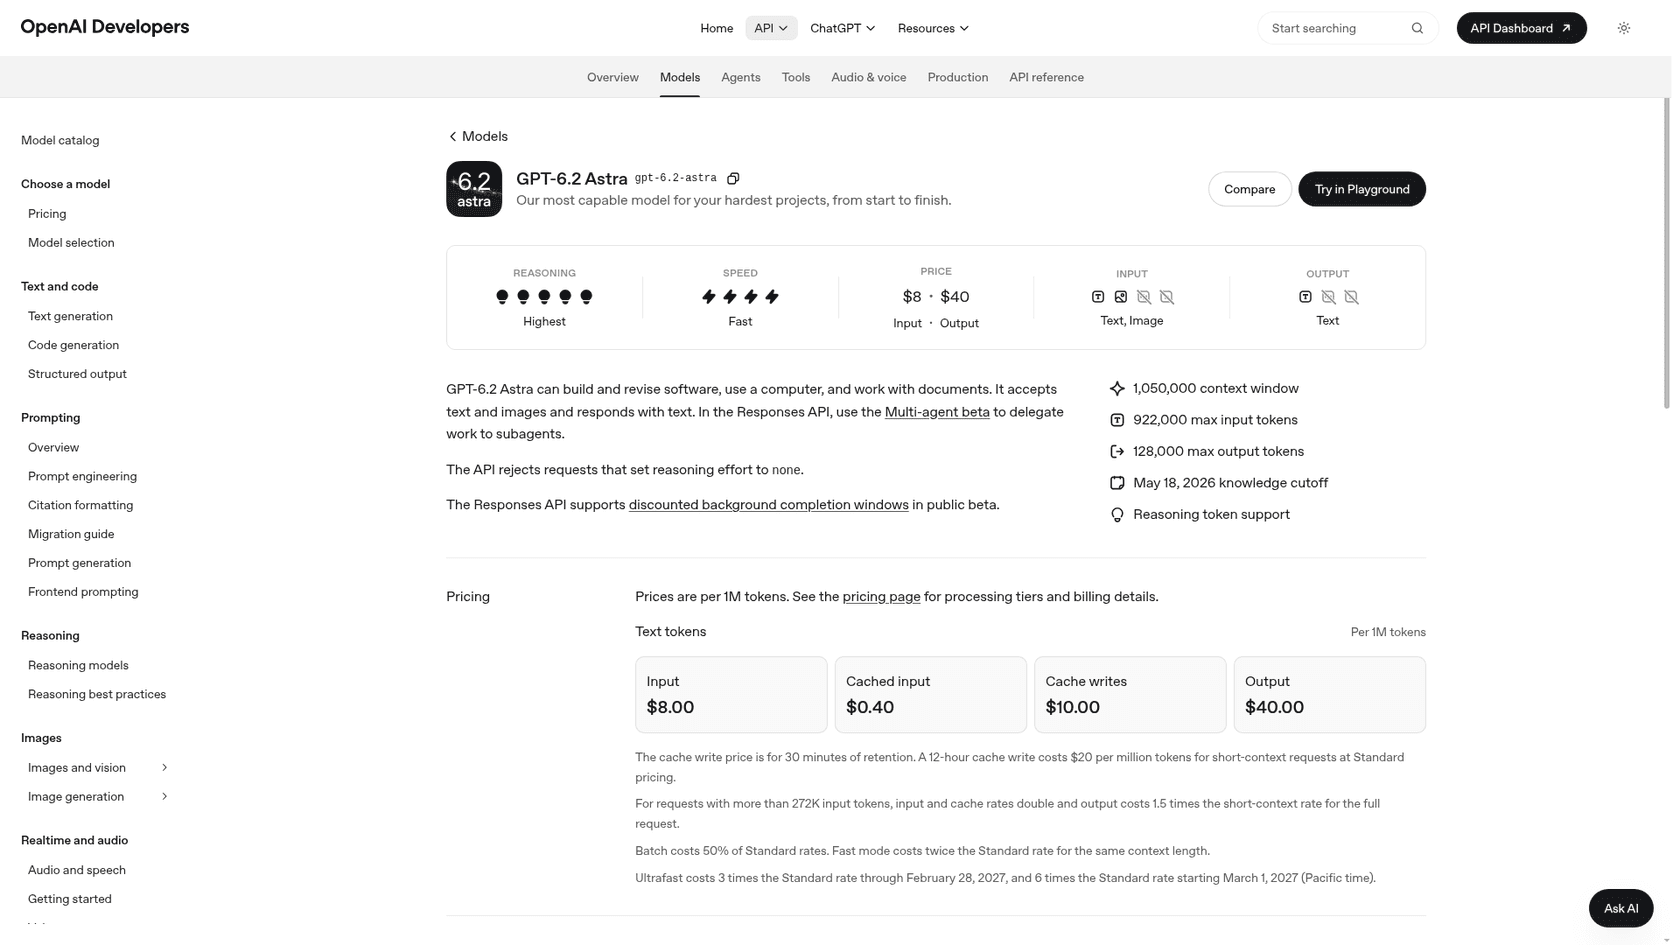
GPT-6.2 Astra es el modelo estrella de OpenAI, lanzado el 17 de noviembre de 2026, un día antes que Neon. Tiene una ventana de contexto de 1.050.000 tokens, 128.000 tokens máximos de salida y un corte de conocimiento de mayo de 2026, y la API rechaza el esfuerzo de razonamiento none. Su precio es alto, $8 de entrada y $40 de salida por millón de tokens, 2,7 veces la tarifa de entrada de Neon.
En la factura, sin embargo, Astra es el modelo que supera a Neon en su propio juego. Con esfuerzo alto puntúa 60,1 por $2,07 por tarea y termina en 5,9 minutos, frente a los 14,8 de Neon. Lo logra escribiendo 17.828 tokens donde Neon escribe 90.188. Al máximo sube a 62,1, apenas por encima del mejor valor de Neon de 61,4, por $4,00. Mi propia prueba de 90 ejecuciones de soporte en la guía de alternativas a Astra encontró la misma costumbre: el nivel de esfuerzo apenas movió el coste en tickets cortos, de $5,75 a $6,57 por 1.000 tickets de bajo a alto.
Un lector de Hacker News hizo una prueba casera que muestra cómo se traduce esto en la práctica:
"GPT-6.2 Astra scored 92 in 6.6 min for $2.04, vs Kimi K3.1 Pro (93 in 11.5 min for $0.68)"
Ventajas
- Igualba el puntaje de Neon por alrededor de un 45 % menos por tarea, y es más del doble de rápido
- La misma ventana de 1.050.000 tokens y la API de Responses que ya usan muchos equipos
- Entrada en caché a
$0,40, con lotes a la mitad de la tarifa estándar
Desventajas
- Falló el 58 % de las preguntas sin respuesta en AA-Omniscience, frente al 14 % de Neon, así que necesita una regla de traspaso que no dependa de que el propio modelo se niegue
- Las solicitudes de más de 272K tokens de entrada duplican la tarifa de entrada y elevan la de salida a 1,5 veces la tarifa estándar
- El precio de catálogo parece caro en cualquier hoja de cálculo que no mire los tokens por tarea
Precios: $8 de entrada, $0,40 en caché y $40 de salida por millón de tokens en el nivel estándar, según la página de precios de OpenAI. El procesamiento regional añade un 10 %. Consulta precios de GPT-6.2 Astra para ver los niveles.
Veredicto: el modelo que probaría primero si quieres puntajes de nivel Neon y tu factura importa. Sáltatelo si necesitas que el propio modelo se niegue cuando no está seguro, porque ahí es donde Neon es mejor.
2. GPT-6.2 Sol
Mejor para: la factura más baja que aún puntúa en los altos 50.
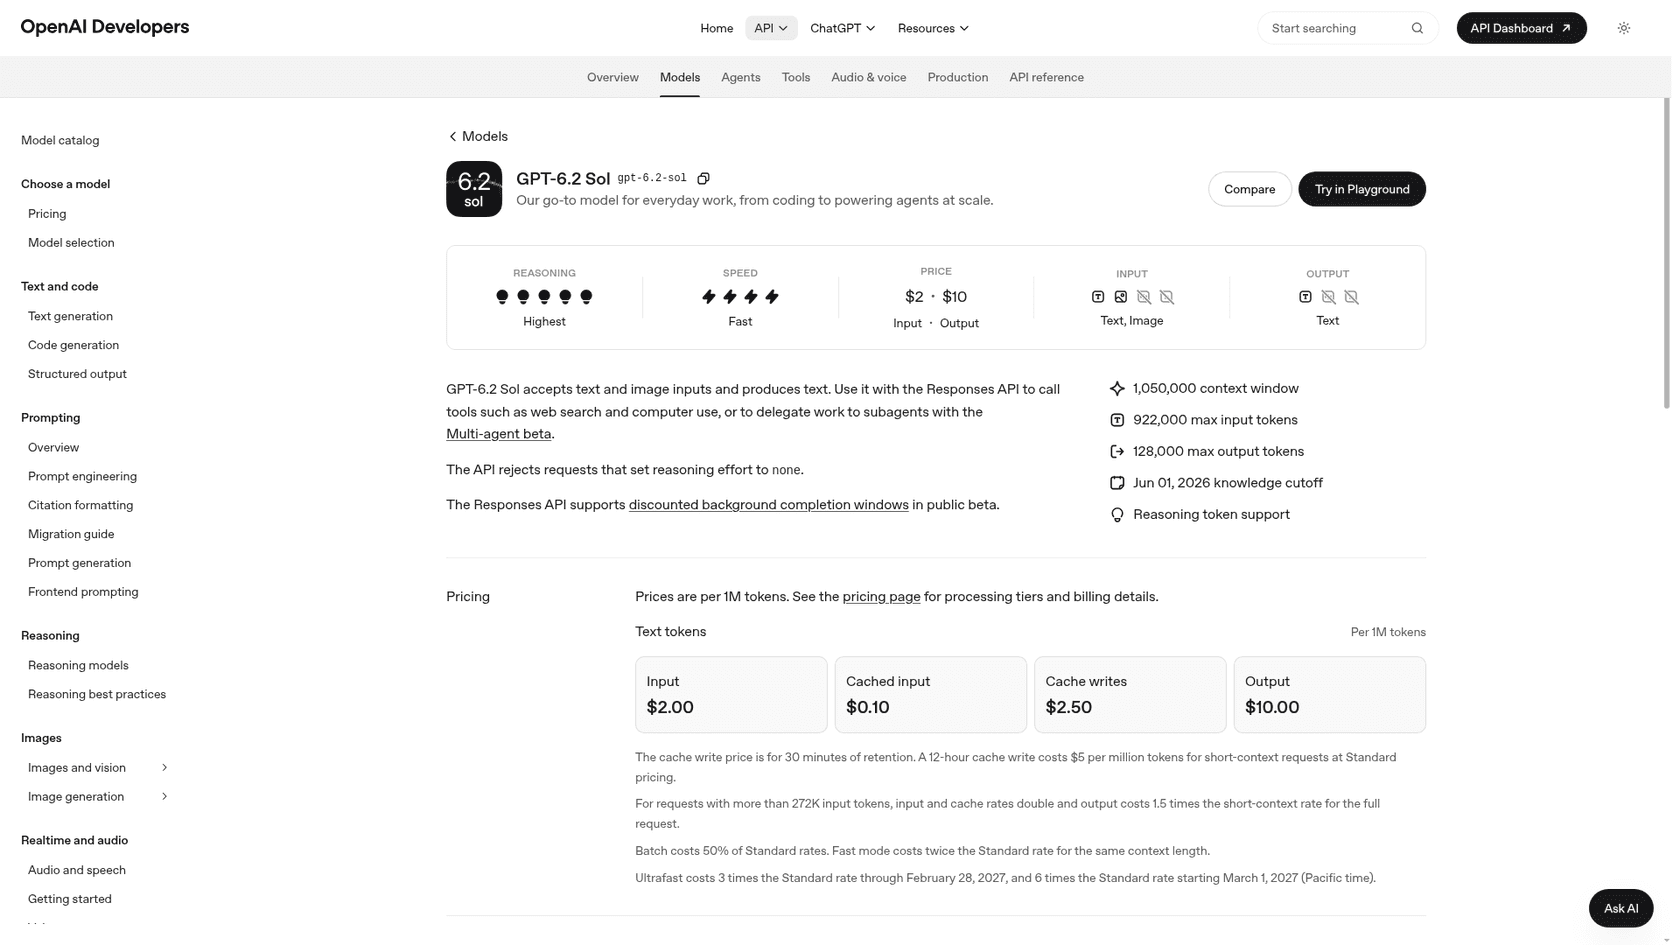
GPT-6.2 Sol es el modelo cotidiano de OpenAI, con la misma ventana de 1.050.000 tokens que Astra, un corte de conocimiento de junio de 2026, y $2 de entrada y $10 de salida por millón de tokens. Artificial Analysis lo puntúa en 57,3 al máximo esfuerzo por $1,01 por tarea, y 54,9 en alto por $0,56. Ese segundo número es al que vuelvo siempre: el mismo puntaje que Neon en medium, a menos de un tercio del coste.
En mi propia prueba, Sol respondió correctamente las 45 ejecuciones entre esfuerzo bajo, medio y alto, incluyendo un reembolso prorrateado que salió en $990 cada vez, una inyección de prompt que recibió un no educado, y tickets en español y alemán respondidos en el idioma del cliente. El coste fue $1,42, $1,40 y $1,54 por 1.000 tickets, alrededor de un cuarto del de Astra. La opinión sobre el terreno está dividida en los casos más difíciles:
"OpenAI's models require constant reprompting for me."
Ese lector prefería Sonnet 5.5, y es una advertencia justa de que un modelo barato le exige más a tu prompt.
Ventajas
- De
$0,56a$1,01por tarea, el modelo más barato aquí que puntúa por encima de 54 - Rápido: de 4,6 a 8,5 minutos por tarea en Artificial Analysis
- Misma superficie de API que Astra, así que puedes enrutar entre ambos
Desventajas
- Falla entre el 55 % y el 60 % de las preguntas sin respuesta, así que responderá cuando debería traspasar
- Las escrituras en caché se facturan por separado a
$2,50por millón de tokens para una retención de 30 minutos, así que la tarifa en caché no es dinero regalado - La API rechaza el esfuerzo de razonamiento
none
Precios: $2 de entrada, $0,10 en caché y $10 de salida por millón de tokens, según la página de precios de OpenAI. Los lotes lo reducen a la mitad. La guía de precios de Sol tiene el detalle.
Veredicto: mi opción predeterminada para la mayoría de las cargas de trabajo. Empieza aquí, y sube a Astra o cambia a Neon solo para las tareas en las que falla visiblemente.
3. Claude Opus 5.5
Mejor para: sesiones largas de código y agentes en un stack de Anthropic.
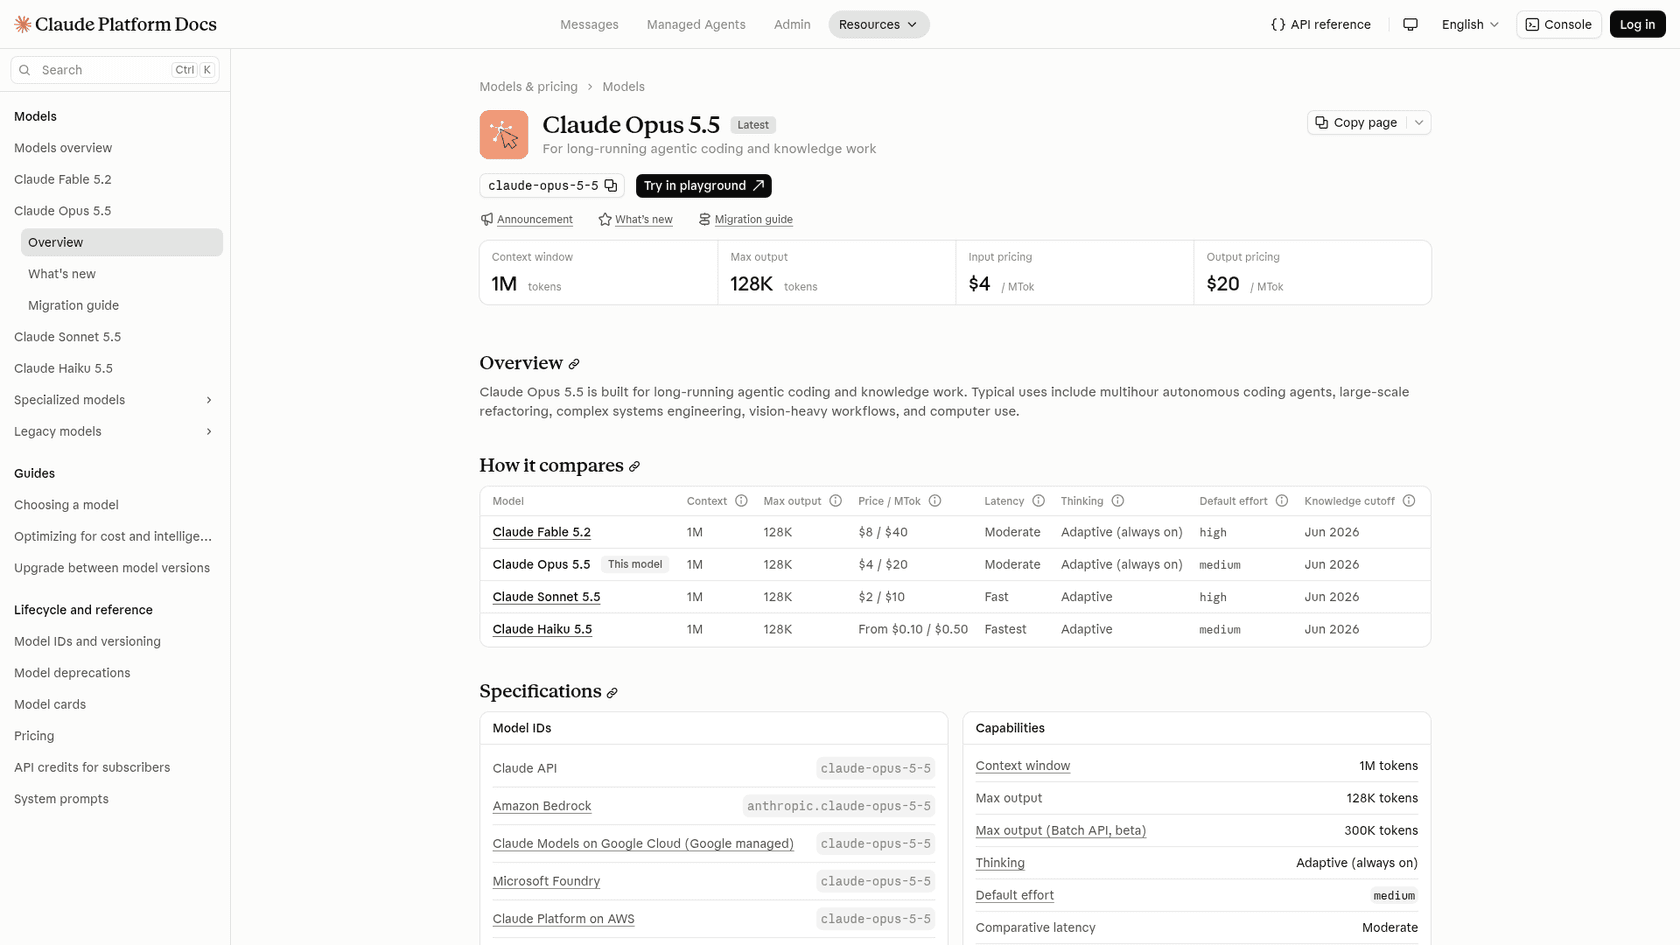
Claude Opus 5.5 salió el 22 de septiembre de 2026 a $4 de entrada y $20 de salida por millón de tokens, con una ventana de 1M de tokens, 128K de salida máxima, pensamiento adaptativo siempre activo y un esfuerzo predeterminado de medium. Funciona en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry. La propia tabla comparativa de Google en la ficha del modelo Neon pone a Opus ligeramente por delante de Neon en Terminal-Bench 4.1 y FrontierCode 2.0, así que este es el rival de código más fuerte de la lista.
La trampa es la costumbre que describí antes. Con esfuerzo máximo, Opus escribe 173.313 tokens por tarea, y eso convierte una etiqueta a mitad de precio en la fila más cara de la tabla: $10,04 por tarea por 59,1, frente al $3,74 de Neon por 59,6. En el predeterminado de la API, medium, son $2,45 por 48,2, un puntaje más débil que el 54,9 de Neon medium a un coste mayor. Un lector de Hacker News lo sigue poniendo por delante del grupo dos meses después:
"Every day I'm just more and more amazed at Opus 5.5 and how ahead it was."
Ventajas
- Entrada en caché a
$0,20, y lotes a mitad de precio - La página de precios de Anthropic solo lista inferencia en EE. UU. mediante
inference_geopor un recargo del 10 % - Fuerte en sesiones largas de código, donde la propia tabla de Google le da la ventaja
Desventajas
$10,04por tarea al máximo, unas 2,7 veces Neon por el mismo puntaje- La página de precios de Anthropic solo lista
autoynonecomo elección de herramienta para Opus 5.5, así que prueba cualquier agente que fuerce una herramienta concreta - Falla el 50 % de las preguntas sin respuesta al máximo, y el 67 % en medium
Precios: $4 de entrada, $0,20 de lectura en caché y $20 de salida por millón de tokens, según la página de precios de Anthropic. El modo rápido cuesta $8 y $40. Consulta precios de Opus 5.5.
Veredicto: elígelo si ya estás en Anthropic y tus trabajos son sesiones largas de código. Sáltatelo si el coste por tarea es tu limitación, y lee primero mi análisis de Opus 5.5.
4. Claude Sonnet 5.5
Mejor para: empresas en Anthropic que ejecutan turnos cortos de herramientas con poco esfuerzo.
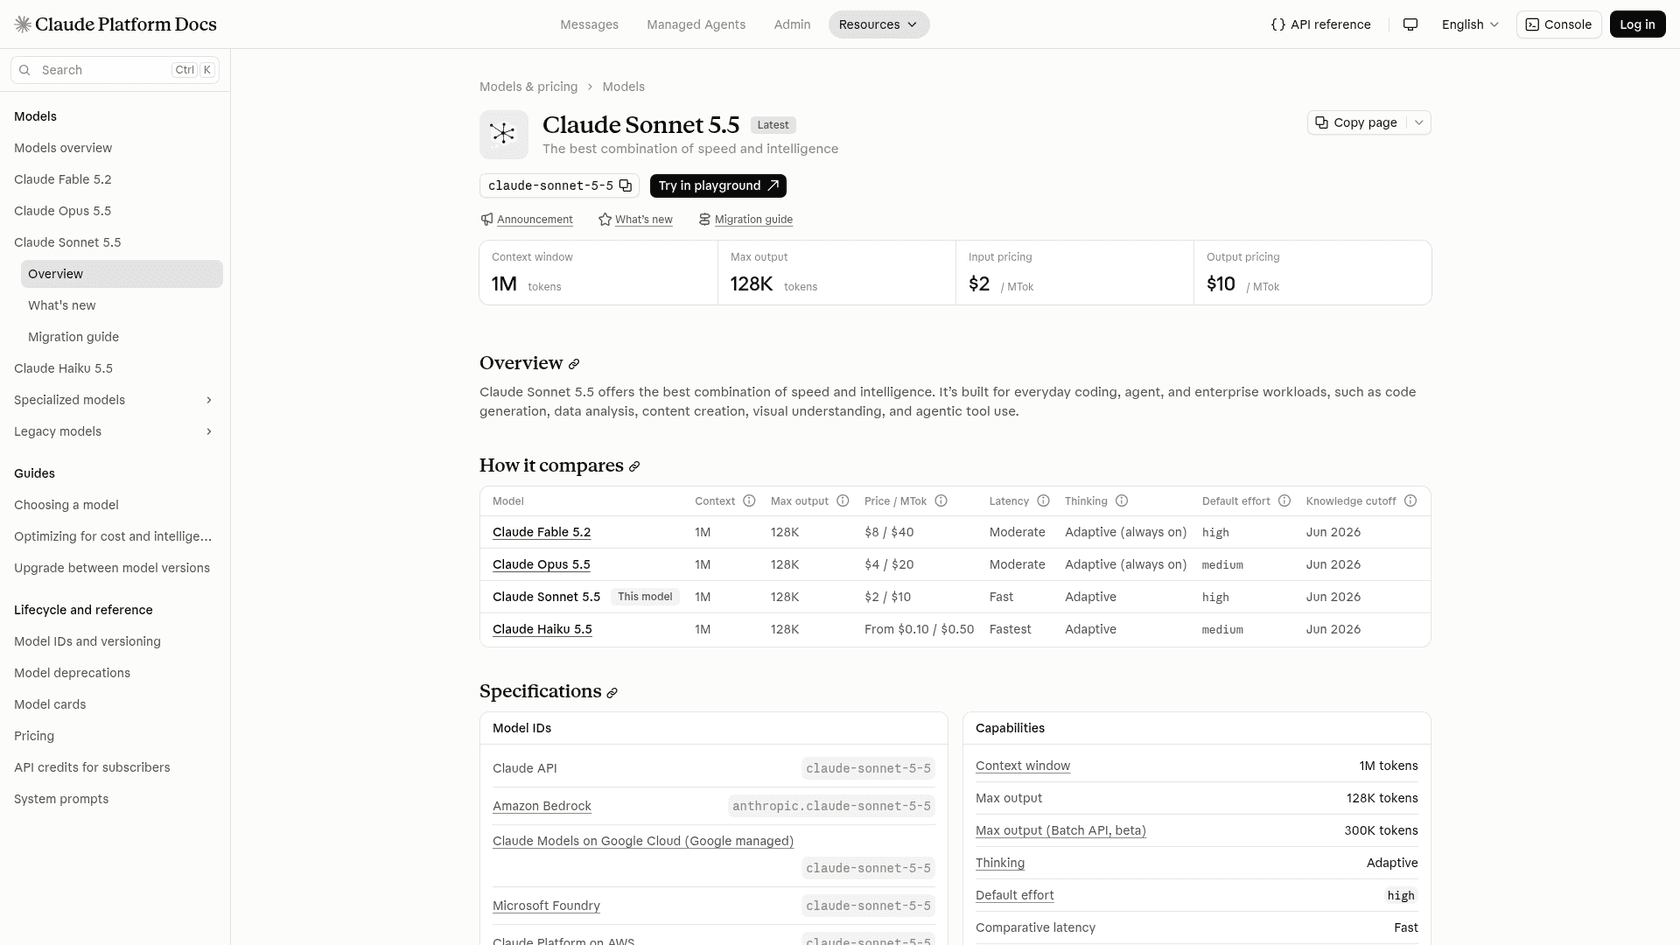
Claude Sonnet 5.5 tiene la misma etiqueta de $2 y $10 que Sol, una ventana de 1M de tokens, un corte de conocimiento de junio de 2026 y un esfuerzo predeterminado de high en la API. Esa es la trampa. En Artificial Analysis cuesta $10,02 por tarea al máximo por 54,5, diez veces Sol, porque escribe 285.387 tokens y tarda 32,6 minutos. En el predeterminado high cuesta $1,64 por 41,5, y Neon low le gana en ambos aspectos con $0,75 por 44,1.
Hay un punto brillante. Sonnet 5.5 falló el 43 % de las preguntas sin respuesta al máximo, mejor que Sol, Astra u Opus, aunque muy por detrás de Neon.
Ventajas
- Entrada en caché a
$0,10, y una tasa de alucinación más baja que el par de OpenAI - Contexto de 1M de tokens, 128K de salida máxima, y las mismas plataformas que Opus
- Encaja con equipos que ya han construido en torno a las herramientas de Anthropic
Desventajas
- El puntaje oscila de 41,5 en high a 54,5 en max, mientras el coste oscila de
$1,64a$10,02 - La misma lista de
autoynonecomo elección de herramienta que Opus en la página de precios de Anthropic - El más lento de los modelos principales al máximo, con 32,6 minutos por tarea
Precios: $2 de entrada, $0,10 de lectura en caché y $10 de salida por millón de tokens, según la página de precios de Anthropic. El lote cuesta $1 y $5. Consulta precios de Sonnet 5.5.
Veredicto: elígelo solo si Anthropic es un requisito fijo y lo vas a ejecutar con esfuerzo bajo o medio. De lo contrario, Sol hace el mismo trabajo por menos, y mi análisis de Sonnet 5.5 explica la trampa del esfuerzo.
5. Gemini 4 Carbon
Mejor para: equipos que quieren el menor número de respuestas inventadas y están dispuestos a pagarlo.
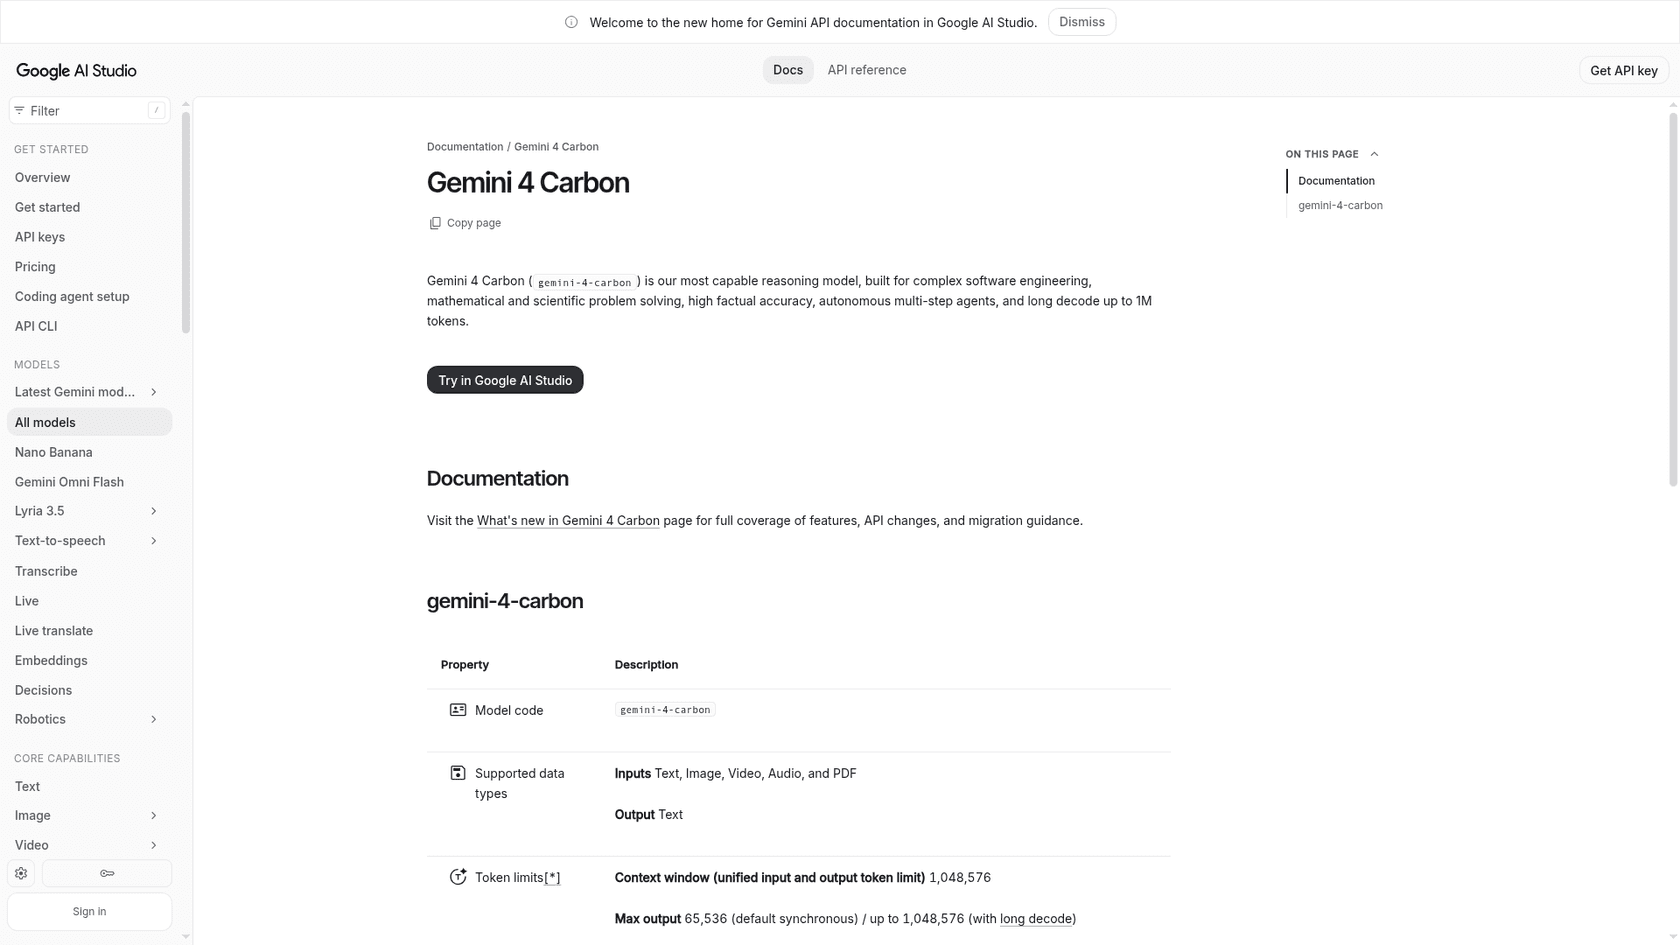
Gemini 4 Carbon es el modelo del que se adaptó Neon, y Google lo describe como su modelo de razonamiento más capaz, construido para ingeniería de software, ciencia y agentes largos de varios pasos. Ahora está en la API de Gemini con precios solo de pago: $2 de entrada y $10 de salida hasta el 30 de noviembre de 2026, luego $4 y $20 desde el 1 de diciembre, con entrada en caché a $0,10 que sube a $0,20.
El caso de Carbon es la honestidad. Con esfuerzo medio falló el 4 % de las preguntas sin respuesta, y con alto el 11 %, frente al 14 % de Neon. Su problema es el coste. En high puntúa 60,0 por $7,76 por tarea, más del doble que el $3,74 de Neon por el mismo puntaje, y tarda 37,2 minutos. Un probador de Hacker News midió la misma lentitud desde otro ángulo:
"I've tested 75 models so far, and Gemini 4 Carbon is 68th/75 in terms of slowness"
Ventajas
- La tasa de alucinación más baja de la lista: 4 % en medium, 11 % en high
- Ventana de 1.048.576 tokens y decodificación larga hasta cerca de 1M de tokens de salida
- Mismo stack de Google que Neon, así que migrar es solo cambiar el nombre del modelo
Desventajas
$7,76por tarea en high, el doble que Neon por el mismo puntaje, una vez acaba la promoción- Lento: de 29,6 a 37,2 minutos por tarea, con una cola larga que vio el probador de HN
- Sin capa gratuita
Precios: $2 de entrada y $10 de salida hasta el 30 de noviembre, luego $4 y $20, según la página de precios de Google. Compáralo con mi resumen de alternativas a Carbon.
Veredicto: elígelo si las respuestas incorrectas te cuestan más que el tiempo, y presupuesta con el precio de diciembre. De lo contrario, Neon te da el mismo puntaje por la mitad del dinero.
6. Kimi K3.1 Pro
Mejor para: equipos que quieren pesos abiertos de un proveedor que no sea de EE. UU.
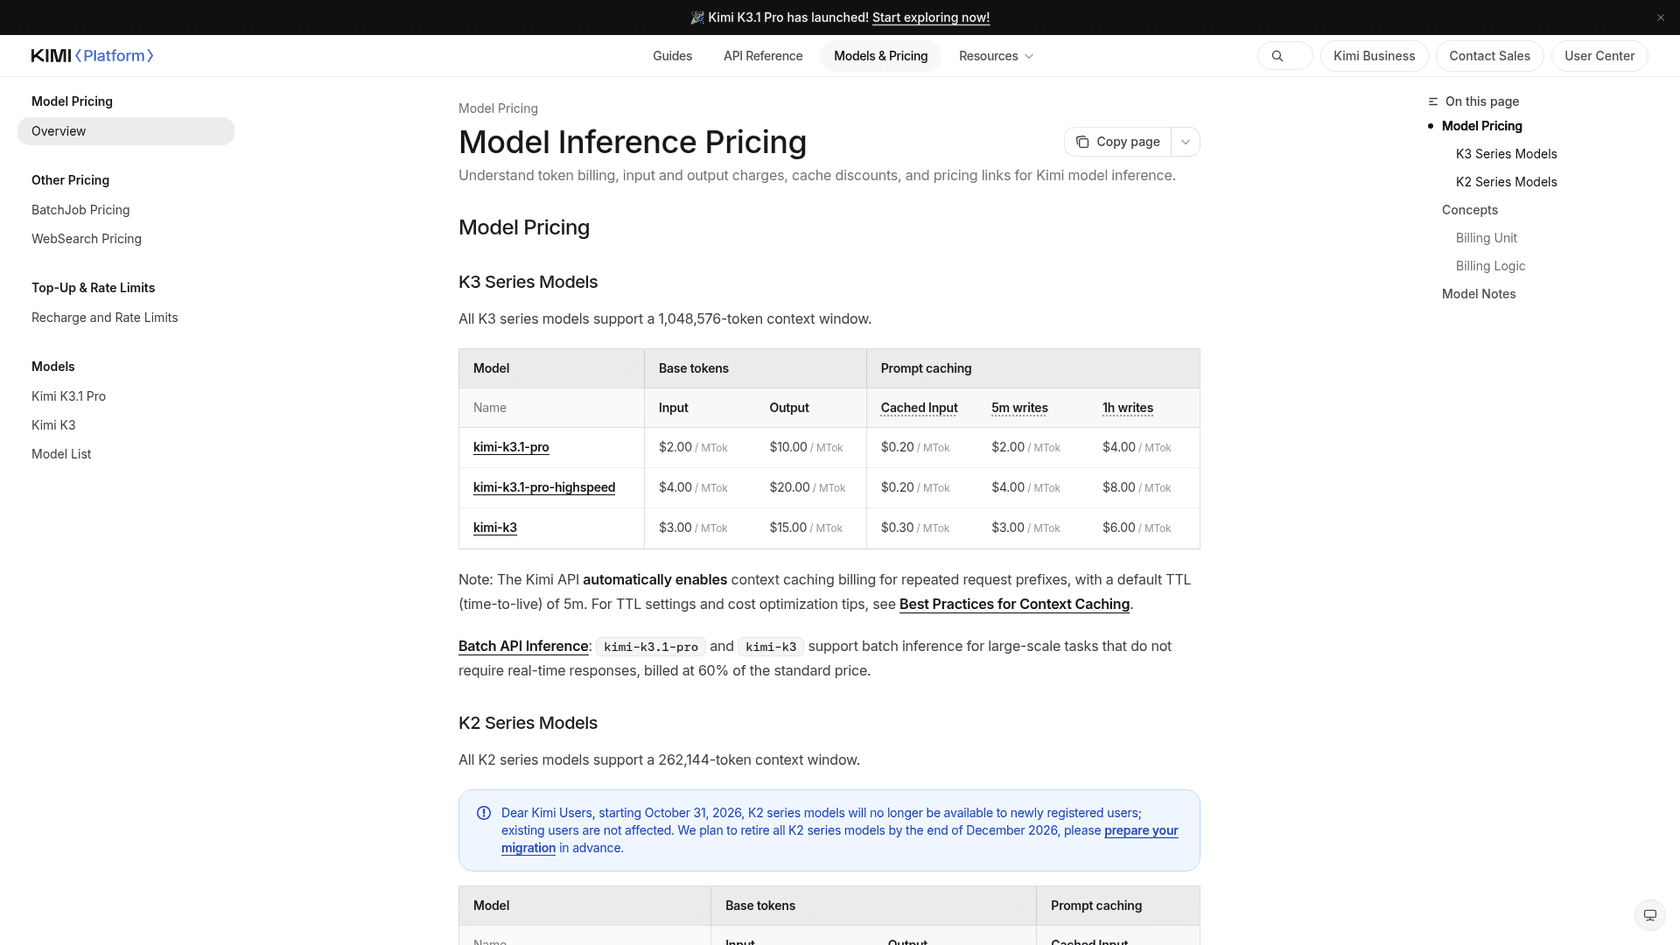
ChatGPT nombró a Kimi K3, pero el modelo que probaría hoy es Kimi K3.1 Pro, que cuesta menos que el Kimi K3 más antiguo, a $2 de entrada y $10 de salida por millón de tokens, con entrada en caché a $0,20. K3 sigue en $3 y $15. K3.1 Pro tiene una ventana de 1.048.576 tokens, y una versión highspeed a $4 y $20. Artificial Analysis lo lista como pesos abiertos con 2,8T de parámetros y 104B activos.
Donde se queda atrás es en el puntaje: 46,5, frente al 54,9 de Neon medium. También tarda 39,4 minutos por tarea y cuesta $3,68, así que Neon medium le gana en puntaje, coste y velocidad. El argumento del precio se apoya en otro tipo de tarea. El resultado de PacBench citado arriba tenía a Kimi a $0,68 frente a los $2,04 de Astra en una prueba de código casera, así que en trabajos concretos puede ser mucho más barato de lo que sugiere el ranking.
Ventajas
$2/$10por millón de tokens y pesos abiertos bajo la propia licencia de Moonshot- Inferencia por lotes al 60 % del precio estándar, según la página de precios de Kimi
- Falló el 37 % de las preguntas sin respuesta, mejor que Sol, Astra y Opus
Desventajas
- 46,5 en el índice, muy por debajo de Neon, Astra y Opus
- 39,4 minutos por tarea, el modelo más lento de mi tabla
- Ningún endpoint regional documentado en la página de precios
Precios: $2 de entrada, $0,20 en caché y $10 de salida por millón de tokens para kimi-k3.1-pro, según la página de precios de Kimi. Mi artículo de precios de Kimi K3.1 Pro cubre los planes.
Veredicto: elígelo si los pesos abiertos o la diversidad de proveedores son el punto. Sáltatelo para razonamiento difícil, y lee primero mi análisis de Kimi K3.1 Pro.
7. DeepSeek V4.1 Flash
Mejor para: clasificación y enrutamiento masivos al precio de catálogo más bajo.
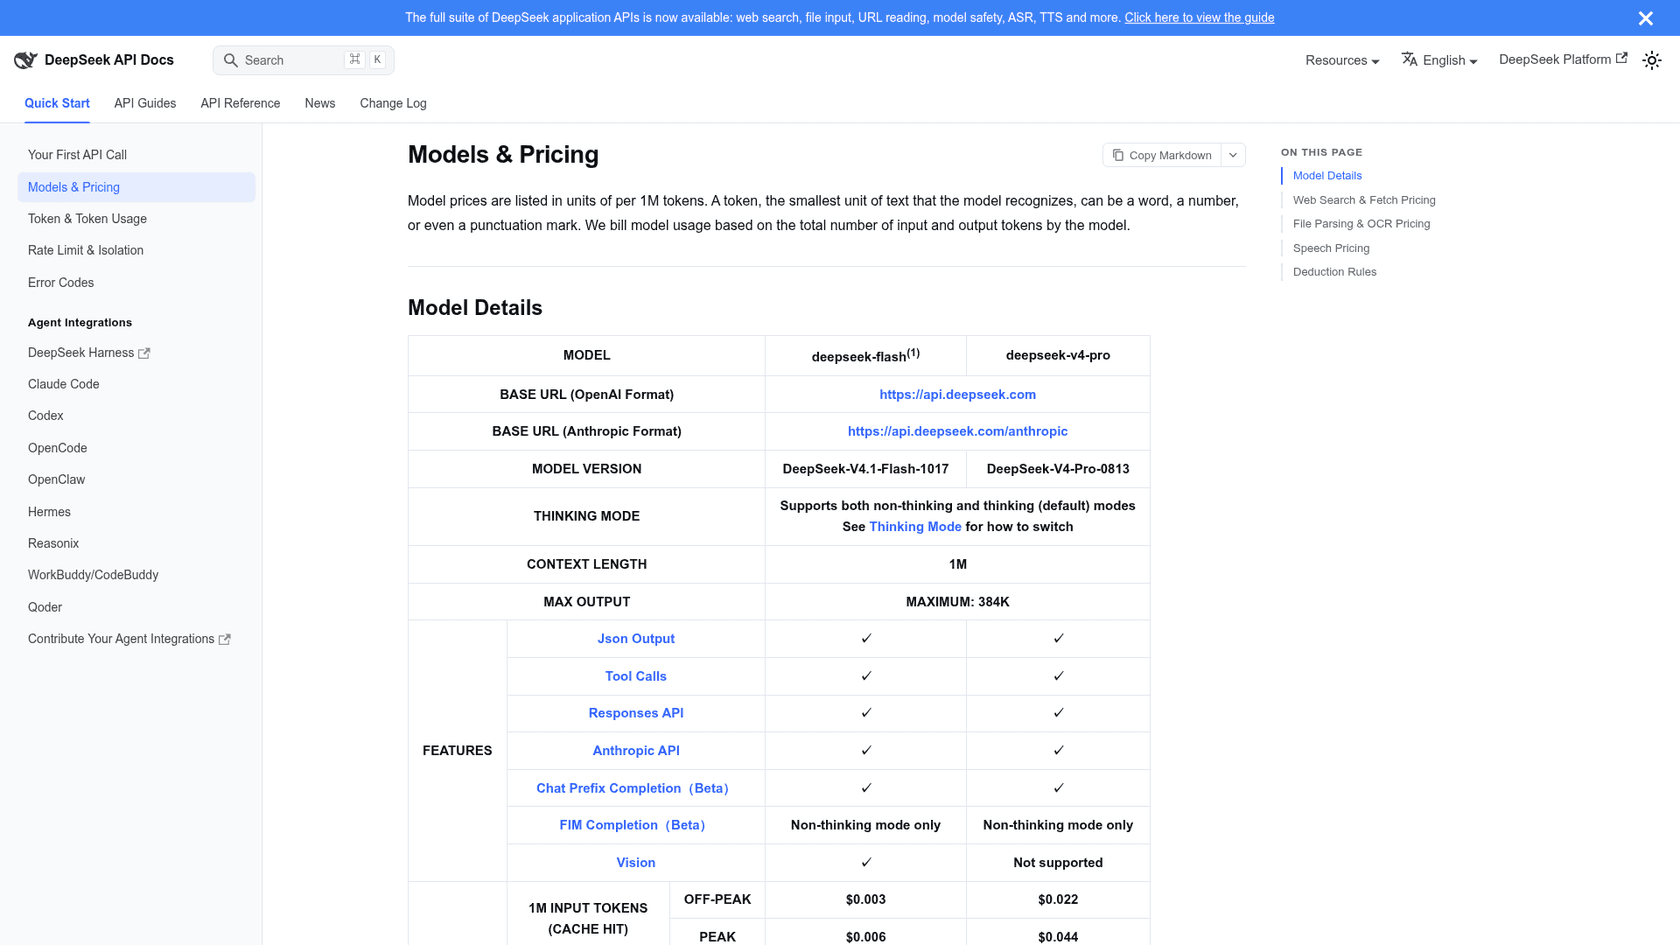
El modelo actual es DeepSeek V4.1 Flash, que la documentación de DeepSeek lista como deepseek-flash ejecutando DeepSeek-V4.1-Flash-1017. Cuesta $0,15 de entrada con fallo de caché y $0,60 de salida por millón de tokens fuera de hora pico, y el doble en hora pico (de 01:00 a 04:00 y de 06:00 a 10:00 UTC los días de semana). Los aciertos de caché cuestan $0,003. Tiene una ventana de 1M de tokens, 384K de salida máxima, salida en JSON, llamadas a herramientas, visión y un límite de concurrencia de 2.500.
Artificial Analysis lo puntúa en 33 al máximo por $0,60 por tarea, calculado a la tarifa pico, así que fuera de hora pico sería más o menos la mitad según mis cálculos. La sorpresa es que los tokens baratos no dieron una tarea barata: escribe 138.962 tokens, así que Sol high a 54,9 cuesta aproximadamente lo mismo. Un comentarista en el hilo de lanzamiento tenía otro presupuesto en mente:
"I don't think it beats Deepseek v4.1 Flash 1017 at cost per task."
Tiene razón en los precios por token y, para trabajo ligero, en las facturas. Los pesos tienen licencia MIT, así que puedes alojarlo tú mismo.
Ventajas
$0,15/$0,60fuera de hora pico, y aciertos de caché a$0,003- Pesos abiertos con licencia MIT, 552B en total y 16B activos según Artificial Analysis
- Salida en JSON y llamadas a herramientas listadas en su página de precios
Desventajas
- Puntaje del índice 32,6, así que es un modelo de triaje, no de razonamiento
- Falla el 64 % de las preguntas sin respuesta al máximo
- Ningún endpoint regional ni términos de procesamiento de datos en la página de precios, así que pregunta antes de enviar datos de clientes
Precios: $0,15 de entrada (fallo de caché), $0,003 por acierto de caché y $0,60 de salida fuera de hora pico, según la página de precios de DeepSeek. Consulta precios de DeepSeek V4.1 Flash para las cuentas de hora pico y fuera de ella.
Veredicto: elígelo para clasificación y enrutamiento, donde un 33 es de sobra. Sáltatelo para cualquier cosa de cara al cliente sin un humano en el bucle.
¿Qué alternativa a Gemini 4 Neon deberías elegir?
Aquí está la decisión tal como la tomaría yo, por tarea:
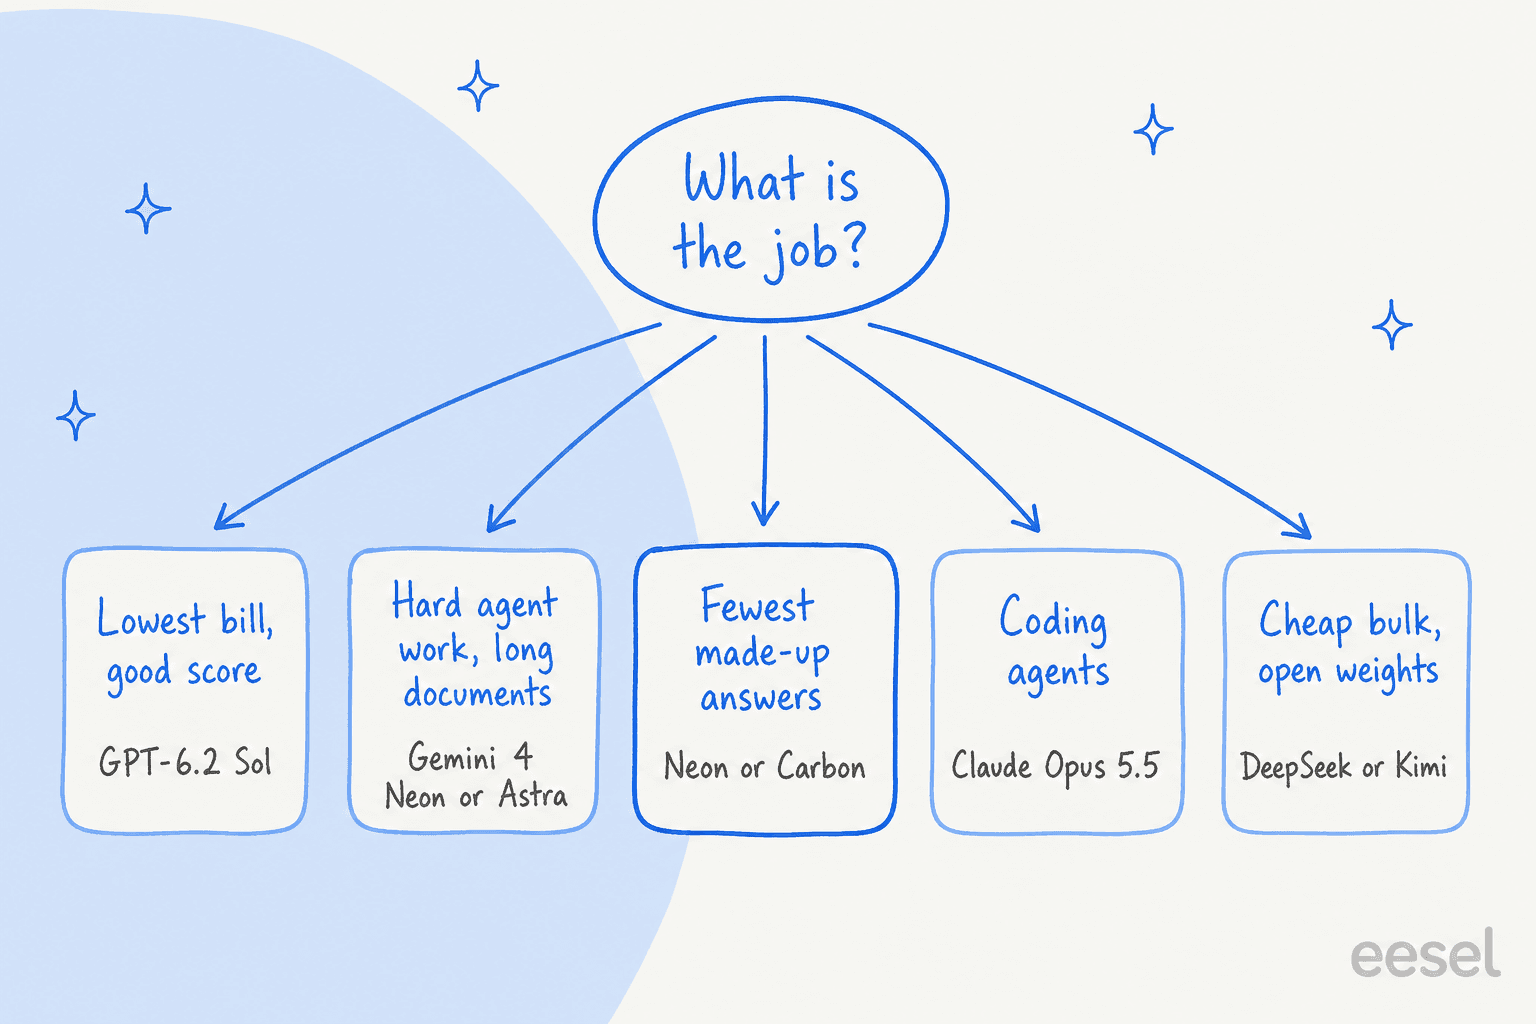
| Si tu tarea es... | Mi elección | Por qué |
|---|---|---|
| la factura más baja con un puntaje en los altos 50 | GPT-6.2 Sol | de $0,56 a $1,01 por tarea |
| el puntaje de Neon a menor coste | GPT-6.2 Astra high | 60,1 por $2,07 |
| agentes difíciles y documentos muy largos | Neon en high, o Astra | las filas de contexto largo de Neon lideran en la propia tabla de Google |
| un modelo que se niega cuando no está seguro | Neon o Carbon | 14 % y de 4 % a 11 % de fallos sin estar seguro |
| sesiones largas de código en Anthropic | Claude Opus 5.5 | código fuerte, pero $10,04 por tarea al máximo |
| pesos abiertos o un proveedor que no sea de EE. UU. | Kimi K3.1 Pro | $2/$10, puntaje 46,5 |
| triaje y enrutamiento a volumen | DeepSeek V4.1 Flash | $0,60 por tarea, pesos MIT |
| chat en vivo | Neon medium o Hydrogen | 8,3 minutos, no 14,8 |
Mi opinión general: enruta, no cambies. Envía la mayoría de las tareas a Sol, envía las que necesitan un modelo más fuerte a Astra o Neon, y mantén un nivel más bajo para el triaje. Si todavía estás sopesando familias, mi comparación ChatGPT frente a Gemini va más allá. El resumen de alternativas a Gemini cubre el resto de la línea de Google, y la guía API de OpenAI frente a API de Gemini cubre las plataformas.
¿Cómo pruebo las alternativas en mi propia carga de trabajo?
Una tarea de un ranking no es tu tarea. Estas son las cinco pruebas que haría antes de mover tráfico real, en el orden en que las haría:
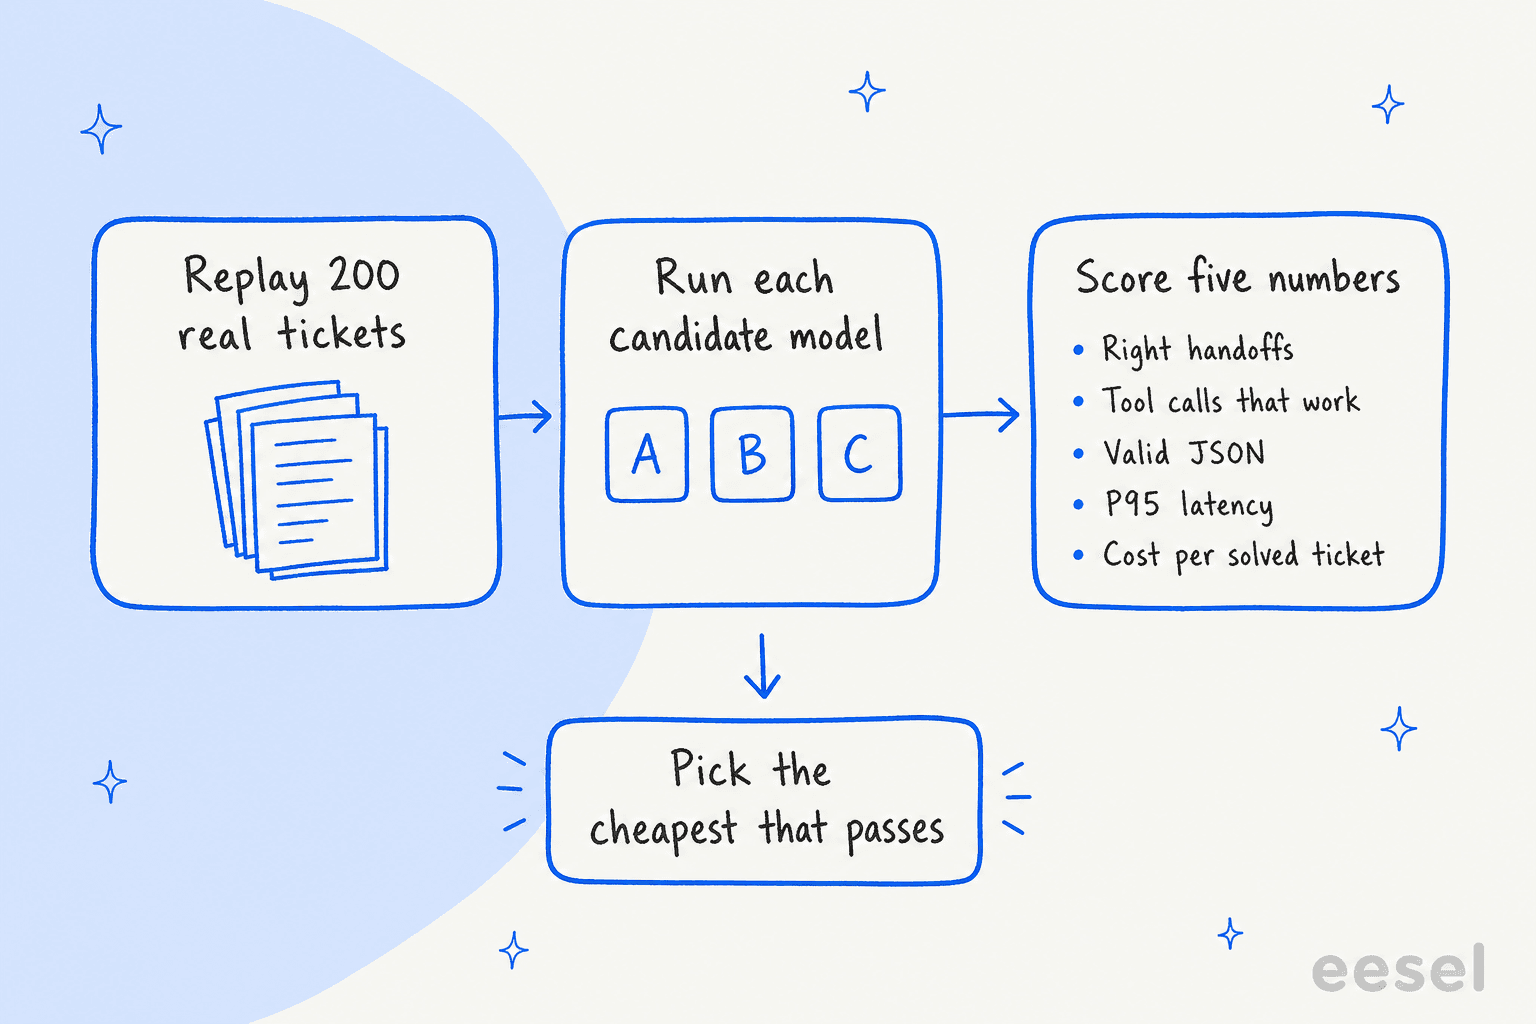
- Llamadas a herramientas. Reproduce tareas con tus definiciones de herramientas reales, y cuenta tres cosas: la herramienta correcta elegida, argumentos que validan, y ninguna llamada cuando no se necesita. Si tu agente fuerza una herramienta concreta, prueba primero ese modo. La página de precios de Anthropic solo lista
autoynonecomo elección de herramienta para Opus 5.5 y Sonnet 5.5, así que un diseño que depende de forzar una herramienta necesita una revisión antes de una migración. Mi guía sobre llamadas a funciones de OpenAI cubre el lado de OpenAI. - Salida estructurada. Mide la proporción de respuestas que se parsean contra tu esquema sin un paso de reparación. La página de precios de DeepSeek lista la salida en JSON como compatible, y el modo JSON de OpenAI tiene sus propias reglas, así que pasa el mismo esquema por cada candidato. Una respuesta inválida de cada cincuenta se convierte en un reintento y un coste.
- Latencia, en los extremos. Registra la mediana y el P95 del tiempo hasta el primer token y hasta terminar. El probador de HN mencionado arriba midió a Carbon con una mediana de 5 segundos para empezar, con una llamada en 50 segundos y un timeout. Las medianas esconden eso, y los clientes sienten el extremo. Artificial Analysis también midió 56,5 segundos hasta el primer token de respuesta para Neon en xhigh, así que mide cada nivel de esfuerzo que planeas usar.
- Reintentos. Cuenta timeouts, errores de límite de tasa y salidas mal formadas por cada 100 llamadas, y usa luego
coste por intento x (1 + tasa de reintentos)como tu coste real. Este es el número que conecta un modelo barato con uno caro. - Respuestas incorrectas frente a traspasos. Siembra unos 20 tickets cuya respuesta no está en tus documentos, y cuenta cuántas veces cada modelo responde igualmente. Es el mismo comportamiento que insinúan los números de AA-Omniscience, medido en tu contenido.
Luego pon todo en una línea: coste por ticket resuelto = gasto total / tickets resueltos correctamente sin edición humana. Esa es la cifra por la que clasificar, y es la versión a nivel de modelo del coste por ticket. Ejecuta cada candidato con los mismos 200 tickets, en dos niveles de esfuerzo, dos veces. Mi prueba de 90 ejecuciones en Astra y Sol mostró que el esfuerzo apenas movía el coste en tickets cortos, lo que cambió qué nivel de esfuerzo usaría en producción.
¿Qué significa esto para un agente de soporte?
Si tu objetivo es un bot de soporte, estos siete modelos son el motor, no el agente. Lo que sabe el agente, cuándo debe traspasar y si alguien lo probó antes de lanzarlo deciden cómo se comporta, y una respuesta segura pero incorrecta a una pregunta de reembolso cuesta más que un traspaso. eesel lleva años poniendo agentes de IA en colas de soporte en vivo, y la lección que quedó es simular cada lanzamiento con tickets históricos antes de que el agente responda a un cliente.
Así es como smava, una empresa alemana de comparación de préstamos, usa eesel en un solo Zendesk. Entre el 8 de agosto y el 8 de septiembre de 2026, tres agentes gestionaron unos 27.000 tickets: uno categorizó unos 14.600, otro redactó unas 15.300 respuestas a partir de 820 macros y artículos de ayuda, y agentes por marca prepararon respuestas listas para el cliente. Cada agente tiene un solo trabajo y una lista de cosas que nunca debe hacer, y una persona aprueba el borrador antes de que se envíe nada. SamCart divide el trabajo por canal: un agente para los tickets de Freshdesk y otro para el chat del sitio web, ambos respondiendo desde los mismos 280 artículos del centro de ayuda.
Ninguna de las dos historias trata de elegir el mejor modelo. Muestran que el modelo es una configuración dentro de un diseño, y el diseño incluye el conocimiento, las reglas de traspaso y las pruebas. Si quieres comparar modelos en tu propia cola, simula el agente con tickets pasados, y vigila la tasa de traspaso más de cerca que la precisión. Mi guía de benchmarking de agentes de soporte con IA lista las cifras que sigo, y coste del servicio al cliente con IA muestra lo que cuesta una cola en total.
Prueba eesel
Si estás eligiendo un modelo porque quieres mejores respuestas en tu cola, el compañero de equipo de helpdesk de IA de eesel es el empleado que se sienta sobre el modelo que elijas. Aprende de tus tickets anteriores y tu centro de ayuda, traspasa a una persona cuando tus documentos no tienen respuesta, y se puede probar con tu historial real de tickets antes de responder a nadie. Funciona dentro de Zendesk y Freshdesk, y por ahí empezaría si la pregunta real para un lanzamiento de soporte es "qué modelo".
El precio es un plan de créditos mensual fijo, con un plan gratuito de 100 créditos y sin tarjeta, así que un cambio de precio en un modelo no mueve tu factura. Prueba eesel en una parte de tu cola.