Las 9 mejores alternativas a Meta Muse Wonder en 2026, por tarea y precio

Kira

Katelin Teen
Última edición October 14, 2026
Por qué mirar más allá de Muse Wonder
Empiezo por lo que Meta hizo bien, porque es mucho. Muse Wonder es la primera familia de modelos de frontera de Meta Superintelligence Labs, lanzada el 12 de octubre, y la variante más grande, Wonder Full, quedó segunda en el índice de Artificial Analysis el día del lanzamiento. El modelo de la API tiene una ventana de contexto de 1.048.576 tokens, acepta texto, imagen, vídeo, audio y PDF, y viene con una tarifa clara: sin recargo por contexto largo y 3.000 solicitudes por minuto desde el primer día. La reseña de Muse Wonder de mi colega lo cubre todo en profundidad.
Los motivos para mirar en otra parte son concretos y los tres se pueden comprobar:
- El modelo que puedes comprar no es el modelo del gráfico. La propia tabla de benchmarks de Meta muestra a Wonder Full ganando 6 de 14 filas. El Wonder normal, el único en la API, gana 1 (MemoryBench).
- Cuesta dinero de frontera. Meta solía ser más barata que todos. A
$4/$20, Wonder ahora iguala a Opus 5.5 al centavo y cuesta el doble que GPT-6.1 Sol. - Es una vista previa. La documentación de modelos lo etiqueta como preview, el informe de seguridad está "disponible pronto", y un probador temprano señaló problemas de fiabilidad de la API.
"It's ok, intelligent, almost SOTA, but way too expensive [0], and some issues with API failing sometimes at the moment."

En eesel construyo funciones y agentes de IA, y el modelo de base es la parte del stack de eesel que espero que cambie con más frecuencia. No es una corazonada. En una llamada de ventas, un equipo de soporte de hardware B2B con unos 250 tickets al mes le dijo al equipo de ventas de eesel que tenía que reemplazar su herramienta de soporte con IA. Su motivo no tenía nada que ver con el precio: el proveedor había cambiado su modelo de negocio y el equipo se vio obligado a migrar. Un modelo en preview es justo donde ese tipo de cambio ocurre sin mucho aviso, así que trataría a Wonder como una opción para probar, no como una plataforma para cablear a fondo.
Mismo precio, distinta puntuación
Este es el gráfico que vale la pena guardar de este artículo. En precio de salida por millón de tokens, Muse Wonder está a la par con Opus 5.5. En el índice de Artificial Analysis, como se ve en el propio gráfico de lanzamiento de Meta, queda seis puntos por debajo.
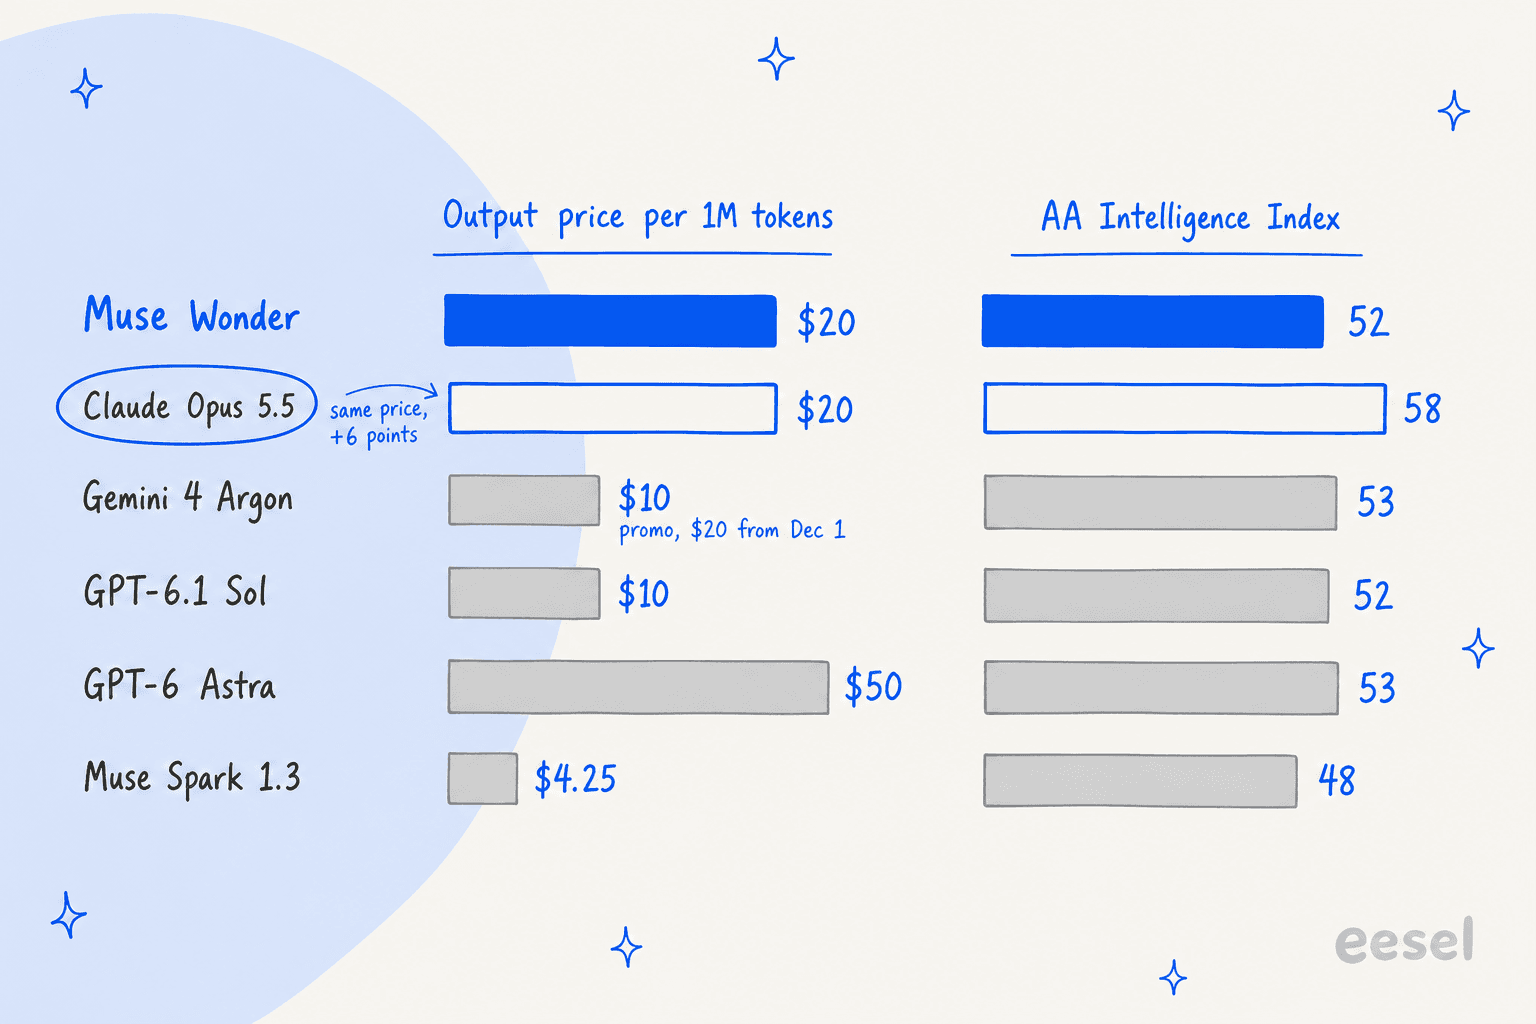
Al leer las filas destacan tres cosas. Opus 5.5 es la misma factura por 6 puntos más. GPT-6.1 Sol es la misma puntuación por la mitad del precio de salida. Y GPT-6 Astra cobra 2,5 veces el precio de Wonder por un punto extra. Los benchmarks no lo son todo (el resultado de Wonder en MemoryBench es real, y Meta lo diseñó para ejecuciones largas de agentes), pero a precios idénticos, la carga de la prueba recae en el modelo de menor puntuación.
Un comentarista de HN expresó la comparación con Sol sin rodeos:
"sol 6.1 is 50% cheaper than this. sol pricing$2.00 output $10.00 dont know why the f people downvote for saying sol pricing."
Las alternativas a Muse Wonder de un vistazo
Los precios son tarifas estándar de API por millón de tokens tomadas de la página de precios de cada proveedor, comprobadas el 14 de octubre de 2026. Las puntuaciones del índice vienen del gráfico de lanzamiento de Meta (12 de octubre) cuando el modelo aparece ahí, y de las páginas de modelos de Artificial Analysis en los demás casos.
| Modelo | Mejor para | Entrada / caché / salida por 1M | AA Intelligence Index | Contexto / salida máx. | Pesos abiertos | Entrena con tus datos por defecto | Nivel gratuito | Dónde conseguirlo |
|---|---|---|---|---|---|---|---|---|
| Muse Wonder (referencia) | Ejecuciones largas de agentes, memoria | $4 / $0.20 / $20 | 52 | 1M / no publicado | No | No (API) | No | Meta Model API, OpenRouter, Muse Code |
| Claude Opus 5.5 | Misma factura, mayor puntuación | $4 / $0.20 / $20 | 58 | 1M / 128K | No | No | No | Claude API, Bedrock, Vertex, Foundry |
| Gemini 4 Argon | Documentos largos, más barato hasta dic. | $2 / $0.10 / $10, luego $4 / $0.20 / $20 | 53 | 1M unificado / hasta 1M | No | No (de pago) | No | Gemini API, AI Studio |
| Muse Wonder Full | Lo mejor de Meta, programar en Muse Code | $50 o $200 al mes | 56 | 1M / no publicado | No | Sí (modo Contributor) | No | Solo Muse Code Power o Max |
| GPT-6.1 Sol | Puntuación de Wonder a mitad de precio | $2 / $0.10 / $10 | 52 | 1.05M / 128K | No | No | No | OpenAI API, ChatGPT Work, Codex |
| GPT-6 Astra | Nivel superior de OpenAI, Ultrafast | $10 / $1 / $50 | 53 | 1.05M / 128K | No | No | No | OpenAI API, planes de pago de ChatGPT |
| Claude Sonnet 5.5 | Programación a mitad de precio de Opus | $2 / $0.10 / $10 | 56 (max), 47 (high) | 1M / 128K | No | No | No | Claude API, nubes |
| Muse Spark 1.3 | Alto volumen, seguir con Meta | $1.25 / $0.15 / $4.25 | 48 | 1M / no publicado | No (prometido) | Solo en la variante contributor | No | Meta Model API, Muse Code |
| Gemini 3.8 Flash | Trabajo por lotes barato, nivel gratuito | $0.75 / $0.075 / $3.75 | 41 (high) | 1M / 64K | No | Solo el nivel gratuito | Sí | Gemini API, AI Studio |
| DeepSeek V4.1 Flash | Pesos abiertos, factura más baja | $0.15 / $0.003 / $0.60 fuera de horas punta | 39.5 (max) | 1M / 384K | Sí, MIT | Los términos no lo dicen | No | DeepSeek API, autoalojado |
¿No sabes cuál es tu fila? Elige el motivo más cercano a por qué mirabas Wonder.
¿Para qué querías Muse Wonder?
Elige el motivo más cercano al tuyo.
Cómo elegí estas alternativas
Partí de la lista corta que un asistente de IA le da a un comprador que pregunta con qué comparar Wonder, y luego comprobé cada nombre con fuentes primarias. Esa lista se apoyaba en GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, Wonder Full y un Gemini Flash barato. Dos de ellos necesitaban corrección. Gemini 4 Argon acababa de salir, y el Flash que sugería, Gemini 3.5 Flash, está obsoleto y las solicitudes ahora se redirigen a 3.6 Flash, así que usé el actual 3.8 Flash.
Luego añadí los modelos que un comprador de Wonder pesa de verdad por precio: GPT-6.1 Sol y Claude Sonnet 5.5 a $2/$10, el propio Muse Spark 1.3 de Meta y una opción de pesos abiertos. Cada precio de abajo viene de la página de precios del proveedor el 14 de octubre. Cada benchmark es del proveedor o de Artificial Analysis, y digo cuál.
Lo que no hice fue pasar nueve modelos por mi propio banco de pruebas para este artículo. Wonder tiene tres días, y una comparación justa necesita tus tareas, no las mías. Por eso la última sección te da la prueba de cinco tareas que yo ejecutaría, y cada apartado indica cuál de esas tareas debería ganar.
1. Claude Opus 5.5: la misma factura por una puntuación mayor
Mejor para: equipos que querían un modelo de frontera a $4/$20 y quieren el que puntúa más a ese precio.
Claude Opus 5.5 es el cambio más directo de esta lista porque nada de tu presupuesto cambia. La documentación de precios de Anthropic indica $4 de entrada, $20 de salida y $0.20 por acierto de caché, los mismos tres números que Wonder. La diferencia es la puntuación: 58 en el índice de Artificial Analysis frente a los 52 de Wonder, y el primer puesto en ese índice cuando salió Wonder.
La propia tabla de Meta defiende a Opus. Opus 5.5 gana 6 de las 14 filas, incluyendo uso del ordenador (OSWorld 81.8 frente a 72.6 de Wonder), programación en terminal (59.6 frente a 52.0) y programación desde cero. Esta última es la mayor brecha de toda la tabla: ProgramBench 70.5 para Opus 5.5, 50.0 para el Wonder normal. Donde Wonder aguanta es en memoria y programación de largo recorrido: supera a Opus 5.5 en DeepSWE (78.8 frente a 74.2) y SWE-Marathon (53.1 frente a 46.3).
Los extras prácticos también cuentan. Opus 5.5 funciona en la API de Claude más Bedrock, Vertex y Foundry, Batch reduce el precio a la mitad, $2/$10, y el esfuerzo por defecto de Anthropic ahora es medio, que puntúa 51 por $1.34 por tarea en Artificial Analysis. La reseña de Opus 5.5 profundiza en los niveles de esfuerzo.
Pros: precio idéntico al de Wonder; 6 puntos más en el índice; lidera la tabla de Meta en uso del ordenador, terminal y programación desde cero; disponible en tres nubes principales.
Contras: forzar tool_choice (any o una herramienta con nombre) devuelve un error, lo que importa si tu agente depende de ello; el esfuerzo máximo cuesta unos $5.98 por tarea en Artificial Analysis; sin pesos abiertos.
Precios: $4 de entrada, $0.20 por acierto de caché, $20 de salida por 1M de tokens; escritura de caché de 5 minutos $5, de 1 hora $8; Batch $2/$10; modo Fast $8/$40. Tabla completa en precios de Opus 5.5.
Mi opinión: si ibas a poner Wonder en producción a $4/$20, pon primero Opus 5.5 y haz que Wonder lo supere en tus propias tareas. Al mismo precio, el modelo de mayor puntuación se lleva el puesto por defecto.
2. Gemini 4 Argon: la mitad del precio de Wonder hasta diciembre
Mejor para: documentos largos, ejecuciones largas de agentes y equipos que quieren la menor tasa de respuestas inventadas del grupo de frontera.
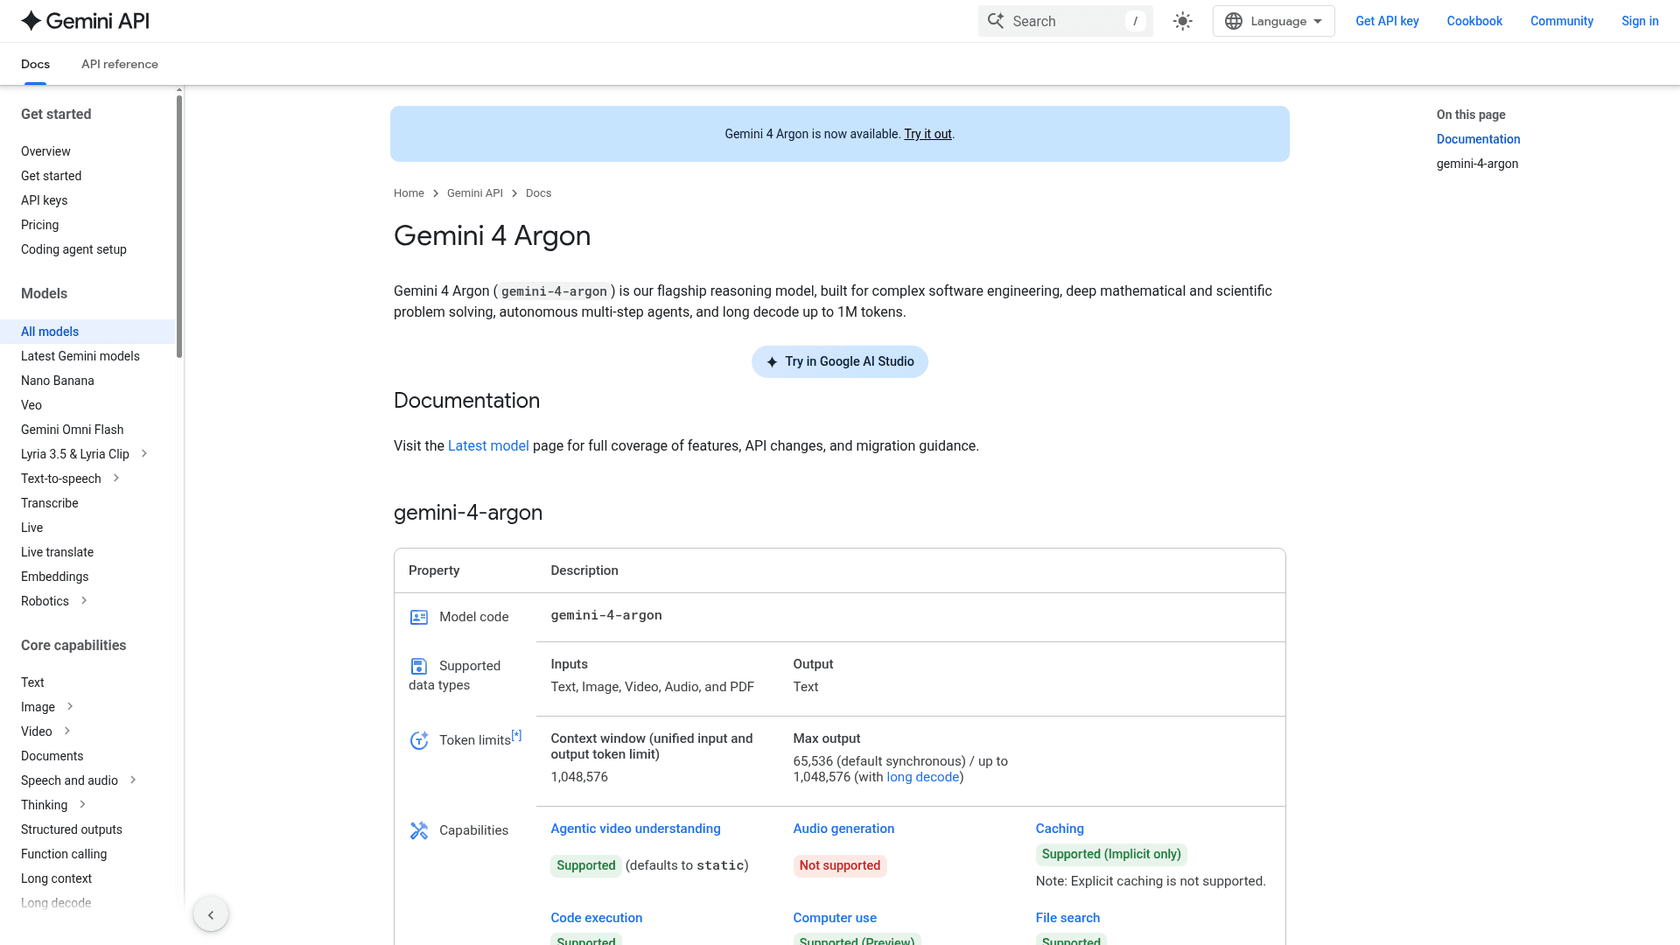
El día del lanzamiento de Wonder, un comentarista de HN elogió a Wonder por estar "available unlike Gemini 4 Argon". Duró un día. El changelog de Google muestra que gemini-4-argon pasó a estar generalmente disponible en la API de Gemini el 13 de octubre, y ya está también en AI Studio. La reseña de Gemini 4 Argon se escribió cuando aún era solo por invitación; los datos de abajo vienen de la documentación en vivo de Google.
Lo interesante es el precio. La página de precios de Google indica $2 de entrada, $0.10 en caché y $10 de salida hasta el 30 de noviembre, y luego $4, $0.20 y $20 desde el 1 de diciembre, que es exactamente la tarifa de Muse Wonder. Así que durante unas siete semanas tienes un modelo que puntúa 53 en el índice (un punto por encima de Wonder) a la mitad de precio, y después lo tienes al mismo precio.
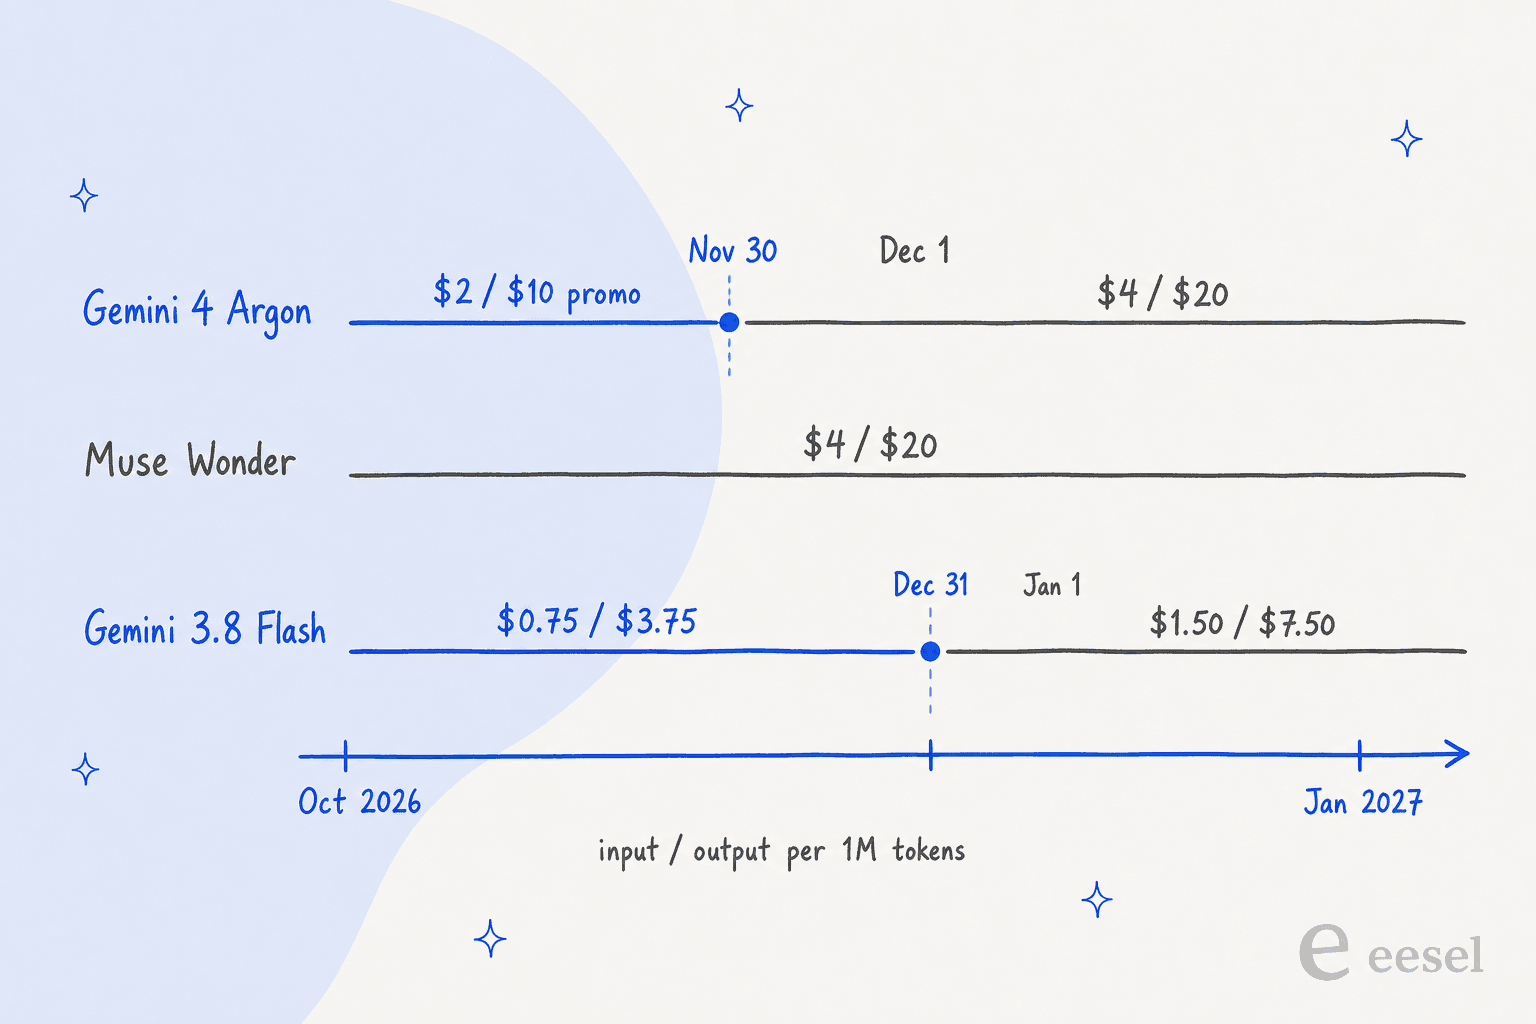
Lo que Argon hace mejor es el trabajo largo. La página del modelo indica una ventana unificada de 1.048.576 tokens, 65.536 tokens de salida por defecto y hasta 1.048.576 con decodificación larga, además de uso del ordenador en preview, ejecución de código, búsqueda de archivos y búsqueda como base de respuestas. En Artificial Analysis, su tasa de alucinación es del 15%, la más baja de cualquier modelo de frontera que he revisado. La tabla de benchmarks de Google lo muestra liderando en tareas de finanzas, legal y flujos de negocio, aunque son ejecuciones de Google, no las versiones de AA de la tabla de Meta.
Pros: la mitad del precio de Wonder hasta el 30 de noviembre; un punto más en el índice; la menor tasa de alucinación del grupo de frontera; decodificación larga hasta 1M de tokens de salida; Batch y Flex a mitad de precio.
Contras: la promoción termina el 1 de diciembre; no admite caché de contexto explícita (solo implícita); sin nivel gratuito; escribe mucho, unos $1.99 por tarea en Artificial Analysis al precio promocional.
Precios: $2 / $0.10 / $10 hasta el 30 de noviembre, luego $4 / $0.20 / $20; Batch y Flex $1 / $5 (luego $2 / $10); Priority $3.60 / $18. Mira precios de Gemini 4 Argon.
Mi opinión: si los documentos largos y la precisión son la razón por la que querías Wonder, prueba Argon ahora que está barato. Solo presupuesta el precio del 1 de diciembre, porque después es una pelea directa de $4/$20 con Wonder y Opus 5.5.
3. Muse Wonder Full: la mejora dentro de la familia
Mejor para: desarrolladores individuales y equipos pequeños con proyectos largos de programación, redacción legal o investigación financiera dentro del agente de programación de Meta.
Si te gustó Wonder por el gráfico de lanzamiento de Meta, Wonder Full es el modelo que se lo ganó. Puntúa 56 en el índice, segundo solo detrás de Opus 5.5 en el lanzamiento, y gana 6 de las 14 filas de Meta: el compuesto interno, legal (13.1 frente a 4.2 de Opus 5.5), finanzas, flujos de negocio, DeepSWE y SWE-Marathon (57.5 frente a 46.3). Ningún otro modelo de este artículo lidera en tantas tareas largas y cargadas de documentos.
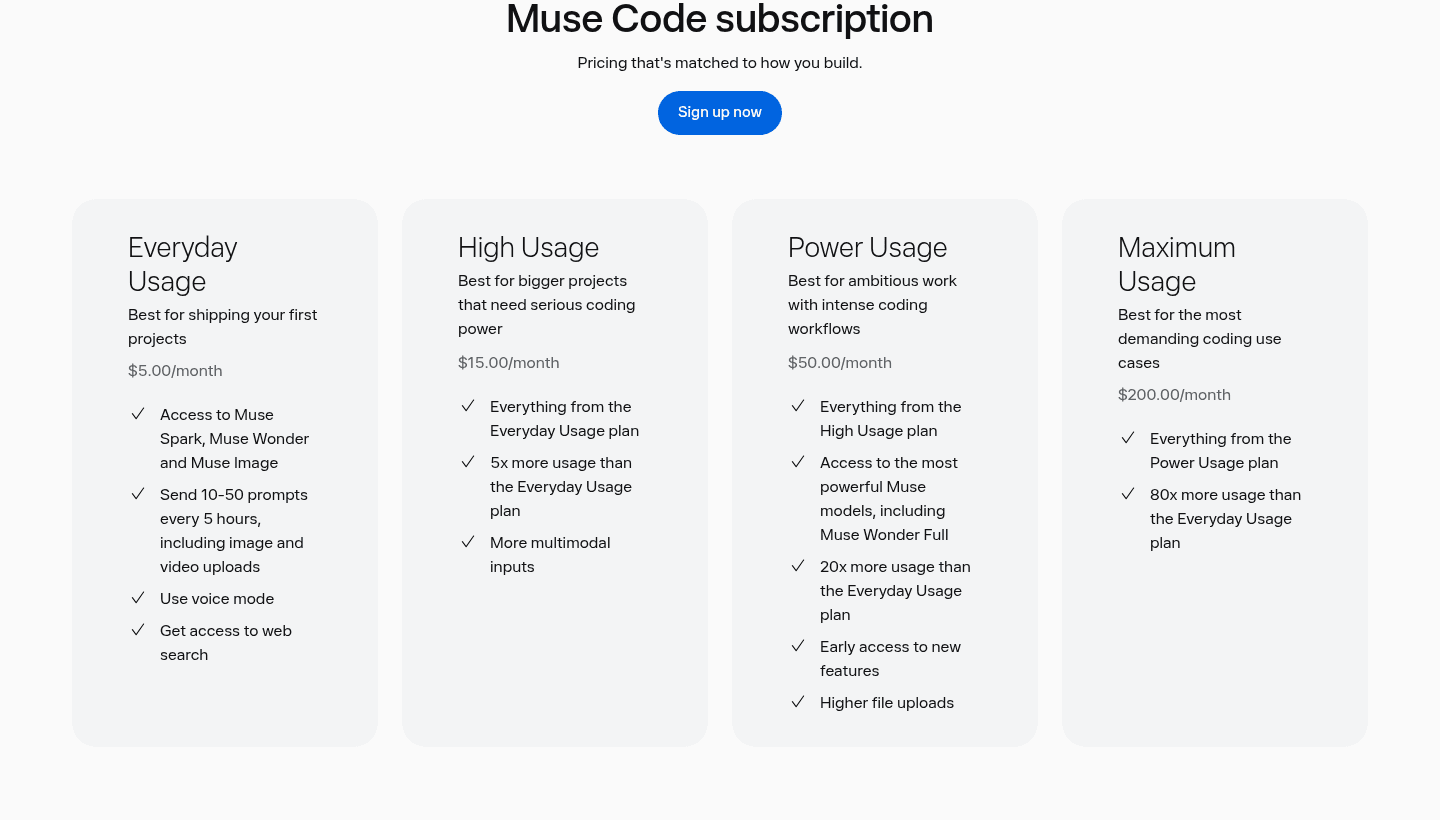
El problema es el acceso. Full solo está en el plan Power Usage de Muse Code a $50 al mes y en Maximum Usage a $200. No tiene precio por token, y la documentación de modelos de Meta dice que poner el esfuerzo en max en el Wonder normal no lo selecciona. Además, una clave de suscripción solo funciona dentro de la CLI de Muse Code, así que no puedes poner el tráfico de tu producto en ella.
"Super interesting that they're not even making Wonder Full available outside of their own coding harness, and thus not providing an API price to use in comparisons."
Dos cosas más antes de pagar. La documentación de suscripciones dice que los planes vienen por defecto en modo Contributor, que permite a Meta entrenar con tus prompts, código y archivos hasta que lo desactives. Y los planes son para mayores de 18, sin reembolsos y con disponibilidad que varía por región; un comentarista informó de que la suscripción es solo para Norteamérica por ahora.
Pros: el modelo más fuerte de Meta; lidera en legal, finanzas, flujos de trabajo y programación muy larga; precio mensual fijo en lugar de facturación por token.
Contras: solo por suscripción, solo dentro de Muse Code; modo Contributor activado por defecto; limitado por región; no sirve para alimentar una app.
Precios: Power Usage $50/mes (20x el uso de Everyday) o Maximum Usage $200/mes (80x). Los planes más baratos Everyday ($5) y High ($15) incluyen solo el Wonder normal. Más en precios de Muse Code.
Mi opinión: si querías Wonder para tu propia programación, olvida la API y paga $50 por Full, con el modo Contributor desactivado desde el primer día. Si querías Wonder dentro de un producto, Full no es una opción, así que mira los puntos 1 y 2. El artículo de alternativas a Muse Code cubre los otros agentes de programación con el mismo presupuesto.
4. GPT-6.1 Sol: la puntuación de Wonder a mitad de precio
Mejor para: apps en producción donde basta el nivel de calidad de Wonder y la factura importa.
GPT-6.1 Sol puntúa 52 en el propio gráfico de lanzamiento de Meta, igual que Wonder. La página de precios de OpenAI lo fija en $2 de entrada, $0.10 en caché y $10 de salida, exactamente la mitad de Wonder en cada línea. Para un equipo de producto, es el intercambio más limpio de esta lista: mismo nivel de benchmark, mitad de factura.
También es eficiente por tarea. Artificial Analysis midió 6.1 Sol con esfuerzo máximo en unos $0.72 por tarea, y el esfuerzo xhigh supera al max en su índice de agentes de programación. Tiene una ventana de contexto de 1.050.000 tokens, 128.000 tokens de salida máximos y residencia de datos en EE. UU. y la UE. La afirmación de OpenAI en DevDay fue que iguala a GPT-6 Astra en DeepSWE a aproximadamente una quinta parte del coste.
Donde difiere de Wonder es en la forma de la API. 6.1 Sol no tiene esfuerzo none ni minimal, y Chat Completions funciona solo sin llamadas a herramientas, así que los agentes deberían usar la Responses API. Los prompts de más de 272K tokens de entrada se facturan a una tarifa mayor.
Pros: misma puntuación de índice que Wonder a mitad de precio; barato por tarea; buenos resultados en agentes de programación; residencia de datos en la UE.
Contras: sin esfuerzo none; las llamadas a herramientas necesitan la Responses API; los prompts largos de más de 272K cuestan más; sin pesos abiertos.
Precios: $2 / $0.10 / $10 por 1M de tokens, escritura de caché $2.50; más de 272K de entrada $4 / $0.20 / $15; Batch y Flex $1 / $5. Desglose en precios de GPT-6.1 Sol.
Mi opinión: si ibas a usar Wonder como caballo de batalla sólido y no como escaparate, este es el modelo. Pasa tus tareas por ambos, y a menos que Wonder gane con claridad, gana la mitad del precio.
5. GPT-6 Astra: el nivel superior de OpenAI, a 2,5 veces el precio de Wonder
Mejor para: equipos que ya usan OpenAI y necesitan su modelo top o su nivel de velocidad Ultrafast.
GPT-6 Astra fue el primer nombre de la lista corta del asistente de IA, y es un modelo fuerte: una ventana de 1.050.000 tokens, shell alojada, apply-patch, uso del ordenador y MCP integrados, y la mejor puntuación en la fila GDP.pdf de trabajo profesional de Meta (34.2). También es el primer modelo que OpenAI califica como "Critical" en ciberseguridad, con el uso cibernético avanzado restringido.
Pero los números no lo favorecen como sustituto de Wonder. Puntúa 53 en el gráfico de Meta, un punto sobre Wonder, y cuesta $10 de entrada y $50 de salida por millón de tokens, 2,5 veces el precio de Wonder. Wonder Full lo supera en 11 de las 14 filas de la tabla de Meta. En Artificial Analysis, Astra con esfuerzo máximo cuesta unos $3.26 por tarea.
Lo único que solo Astra tiene ahora mismo es Ultrafast. La página de precios de OpenAI lista tarifas Ultrafast solo para Astra, a $60 de entrada y $300 de salida por millón de tokens. Si tu producto necesita ese nivel de velocidad este mes, es la única opción de la familia GPT-6.
Pros: el modelo más fuerte de OpenAI; herramientas de agente integradas; mejor puntuación en GDP.pdf de la tabla de Meta; la única opción Ultrafast.
Contras: 2,5 veces el precio de Wonder por un punto más de índice; los prompts largos de más de 272K se facturan a $20 / $75; Wonder Full lo supera en la mayoría de las filas de Meta.
Precios: $10 / $1 / $50 por 1M de tokens; Batch y Flex $5 / $25; Fast $20 / $100; Ultrafast $60 / $300. Mira precios de GPT-6 Astra.
Mi opinión: no pasaría de Wonder a Astra solo por calidad. Elígelo si estás estandarizando en OpenAI y necesitas Ultrafast, o si tus propias pruebas lo muestran ganando en documentos profesionales.
6. Claude Sonnet 5.5: la mitad de Opus, cerca en programación
Mejor para: agentes de programación y apps con muchas herramientas que quieren calidad de Anthropic a la mitad del precio de Opus.
Claude Sonnet 5.5 cuesta $2 de entrada y $10 de salida, la mitad de Wonder, y la documentación de precios de Anthropic ahora fija su acierto de caché en $0.10, la mitad de los $0.20 de Wonder. Puntúa 56 en Artificial Analysis con esfuerzo máximo, por encima del Wonder normal. En las cifras de lanzamiento de Anthropic incluso supera a Opus 5.5 en Terminal-Bench 4.0 (70.6 frente a 66.4).
La salvedad es el esfuerzo. Ese 56 llega con esfuerzo máximo, donde Artificial Analysis midió unos $7.60 por tarea, más que Opus 5.5. Con esfuerzo alto puntúa 47 por $1.08, y la propia Anthropic dice que el ahorro aparece con esfuerzo bajo y medio. Mi reseña de Sonnet 5.5 lo encontró excelente en medio y una trampa en max.
También llegó con cambios incompatibles: forzar tool_choice devuelve un error, thinking: disabled devuelve un error, y los bloques de pensamiento están ligados al modelo, así que el historial de la conversación debe ser solo de adición.
Pros: la mitad del precio por token de Wonder, con un acierto de caché más barato; buena programación en terminal; misma ventana de 1M y 128K de salida que Opus.
Contras: el esfuerzo máximo cuesta más por tarea que Opus 5.5; cambios incompatibles en la API desde Sonnet 5; sin uso de herramientas forzado.
Precios: $2 / $0.10 / $10 por 1M de tokens; escritura de caché de 5 minutos $2.50, de 1 hora $4; Batch $1 / $5. Desglose en precios de Sonnet 5.5.
Mi opinión: un buen reemplazo de Wonder para agentes de programación si lo mantienes en esfuerzo bajo o medio. Si te ves subiéndolo a max, pasa a Opus 5.5.
7. Muse Spark 1.3: la respuesta propia de Meta para volumen
Mejor para: trabajo de alto volumen y sensible a la latencia, para equipos que quieren quedarse con la API de Meta.
Esta es la alternativa que recomienda la propia Meta. Su documentación de modelos presenta Wonder para tareas largas y complejas y dirige el trabajo de alto volumen, sensible a latencia o a coste hacia Muse Spark. Muse Spark 1.3 cuesta $1.25 de entrada, $0.15 en caché y $4.25 de salida por millón de tokens, menos de una cuarta parte del precio de salida de Wonder, y puntúa 48 en el gráfico de Meta.
Los usuarios habituales lo valoran bien por su precio:
"I've been a regular user of muse spark 1.3 ... and I can tell you one thing for sure that this model, muse-spark-1.3 in xhigh mode, is between sol-6-medium and high."
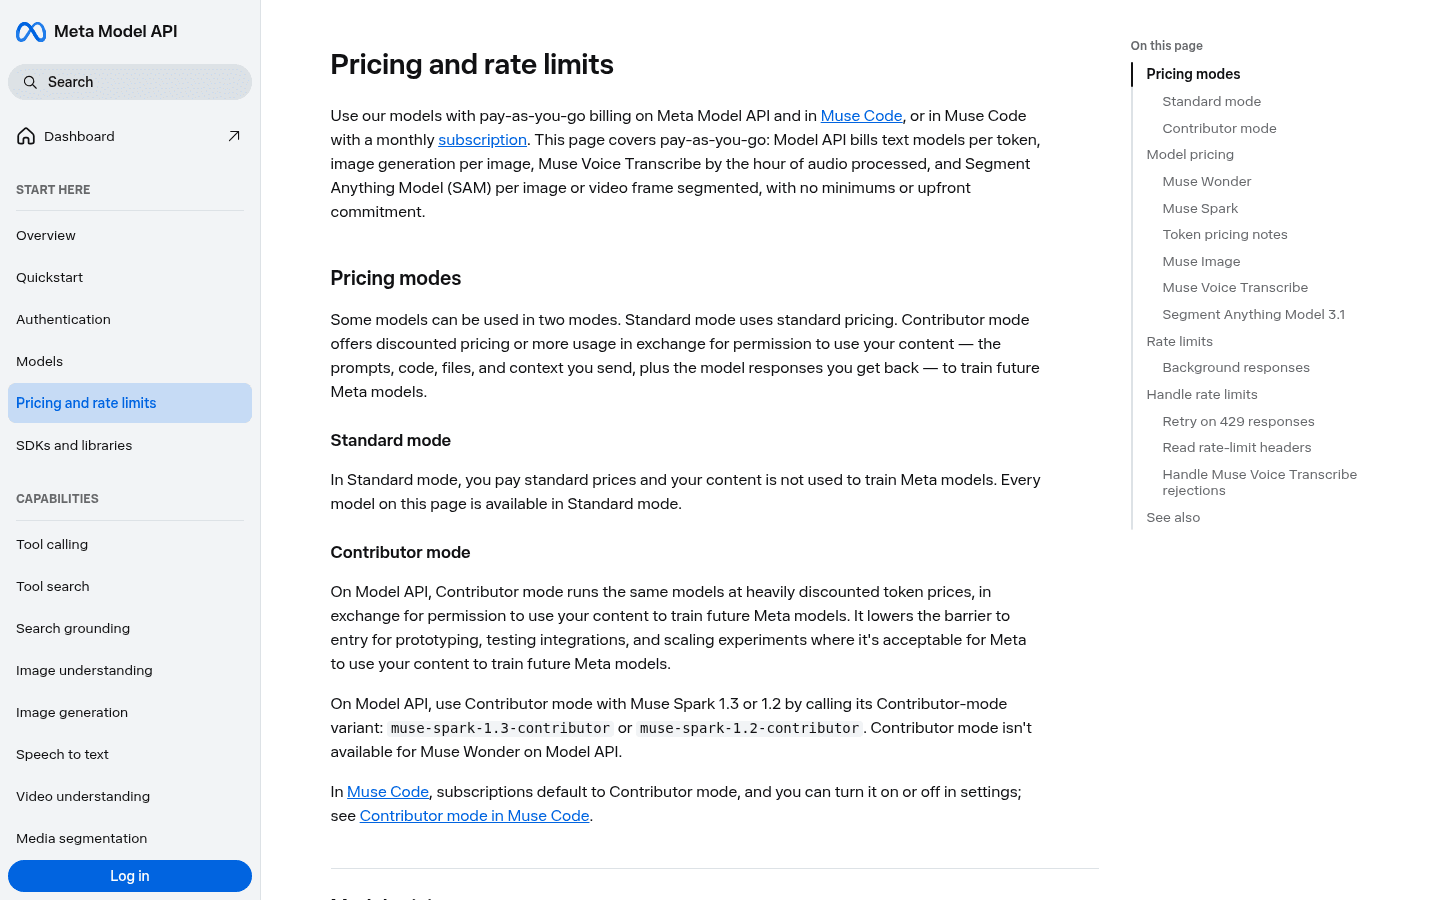
Spark también tiene algo que Wonder no tiene: una variante Contributor en la API. La página de precios de Meta explica que muse-spark-1.3-contributor funciona a precios muy rebajados (alrededor de $0.10/$0.20) a cambio de permitir que Meta entrene con tu contenido. El modo Contributor no está disponible para Wonder en la API. Es un buen trato para prototipos y uno malo para datos de clientes. Una cosa más: Spark 1.3 es verboso, y usa unos 120 millones de tokens de salida para completar el índice de Artificial Analysis frente a una mediana de 72 millones.
Pros: menos de una cuarta parte del precio de salida de Wonder; misma API, mismo proveedor, fácil de enrutar entre ambos; descuento Contributor opcional para trabajo no sensible.
Contras: 4 puntos por debajo de Wonder en el índice; verboso, lo que se come el ahorro; los pesos abiertos que Meta prometió para Spark no han llegado.
Precios: Standard $1.25 / $0.15 / $4.25 por 1M de tokens; variante Contributor aproximadamente $0.10 / $0.20 con entrenamiento sobre tus datos. Mira precios de Muse Spark 1.3.
Mi opinión: la configuración inteligente con Meta es enrutar, no elegir: Spark para la mayoría de las solicitudes, Wonder para las largas y difíciles. Si la mayor parte de tu tráfico es simple, eso solo recorta mucho la factura.
8. Gemini 3.8 Flash: la opción barata con nivel gratuito
Mejor para: trabajos por lotes, prototipos y pipelines donde importa el coste y nadie espera el primer token.
Este es el hueco de "velocidad y coste" que el asistente de IA ocupó con Gemini 3.5 Flash, que Google ha dejado obsoleto desde entonces. El modelo actual, Gemini 3.8 Flash, cuesta $0.75 de entrada y $3.75 de salida por millón de tokens, aproximadamente una quinta parte del precio de Wonder, y es el único modelo de esta lista con nivel gratuito. Google también dejó obsoleto 3.7 Flash el 8 de octubre y redirige sus solicitudes a 3.8.
Puntúa 41 en Artificial Analysis con esfuerzo alto, muy por debajo de Wonder, por unos $1.24 por tarea. Dos salvedades. Primero, el precio se duplica a $1.50/$7.50 el 1 de enero de 2027. Segundo, Artificial Analysis midió 13,30 segundos hasta el primer token, así que encaja mal en cualquier cosa que una persona espere, como un widget de chat.
Sobre el nivel gratuito, la página de precios de Google dice que tu contenido se usa para mejorar sus productos; en el nivel de pago no.
Pros: aproximadamente una quinta parte del precio de Wonder; nivel gratuito para probar; Batch y Flex a mitad de precio; ventana de 1M.
Contras: muy por debajo de Wonder en el índice; primer token lento; el precio se duplica el 1 de enero; el nivel gratuito entrena con tus datos.
Precios: $0.75 / $0.075 / $3.75 por 1M de tokens hasta el 31 de diciembre, luego $1.50 / $0.15 / $7.50; Batch y Flex con 50% de descuento. Mira precios de Gemini 3.8 Flash.
Mi opinión: bueno para el trabajo por lotes nocturno por el que ibas a pagar de más con Wonder. No sustituye las tareas difíciles de Wonder, ni sirve para nada en vivo.
9. DeepSeek V4.1 Flash: pesos abiertos y la factura más pequeña
Mejor para: equipos que necesitan pesos abiertos o el menor coste posible por token.
Muse Wonder no tiene pesos abiertos, y Meta todavía no ha publicado los pesos que prometió para Muse Spark. Si necesitas un modelo que puedas ejecutar tú mismo, DeepSeek V4.1 Flash es la opción más fuerte aquí: pesos con licencia MIT en Hugging Face, una ventana de contexto de 1M y hasta 384K tokens de salida.
La API alojada es muy barata. La página de precios de DeepSeek indica deepseek-flash a $0.15 de entrada y $0.60 de salida por millón de tokens fuera de horas punta, y $0.30/$1.20 en horas punta (mañanas entre semana en UTC). Eso es alrededor del 3% del precio de salida de Wonder fuera de horas punta. Artificial Analysis lo puntúa en 39.5 con esfuerzo máximo por unos $0.27 por tarea.
Los inconvenientes son reales. Su tasa de alucinación en Artificial Analysis es del 96%, la más alta que he visto en un modelo actual, así que necesita una base estricta en fuentes. La API alojada procesa datos en China, y los términos de pago no dicen si tus datos se usan para entrenar. Autoalojarlo resuelve la cuestión de los datos, pero requiere hardware serio para un modelo de 552B de parámetros.
Pros: pesos abiertos con licencia MIT; el precio más bajo de esta lista; buenos resultados usando herramientas para su coste; 384K de salida máxima.
Contras: 12,5 puntos por debajo de Wonder en el índice; tasa de alucinación muy alta; dudas sobre los datos en la API alojada; pesado de autoalojar.
Precios: fuera de horas punta $0.003 por acierto de caché, $0.15 de entrada, $0.60 de salida por 1M de tokens; en horas punta se duplica. Mira precios de DeepSeek V4.1 Flash. Kimi K3 es la otra opción de pesos abiertos, a $3/$15.
Mi opinión: elígelo por los pesos abiertos o para procesar en masa texto no sensible. Mantenlo lejos de cualquier cosa en la que una respuesta errónea y segura de sí misma sea cara.
Cómo probar tu lista corta: las mismas cinco tareas para cada finalista
Esta es la parte que las tablas de benchmarks no pueden hacer por ti. Elige dos o tres finalistas de arriba y ejecuta las mismas cinco tareas con cada uno, además del propio Wonder. Registra tres números por ejecución: aprobado o fallido, coste y segundos.
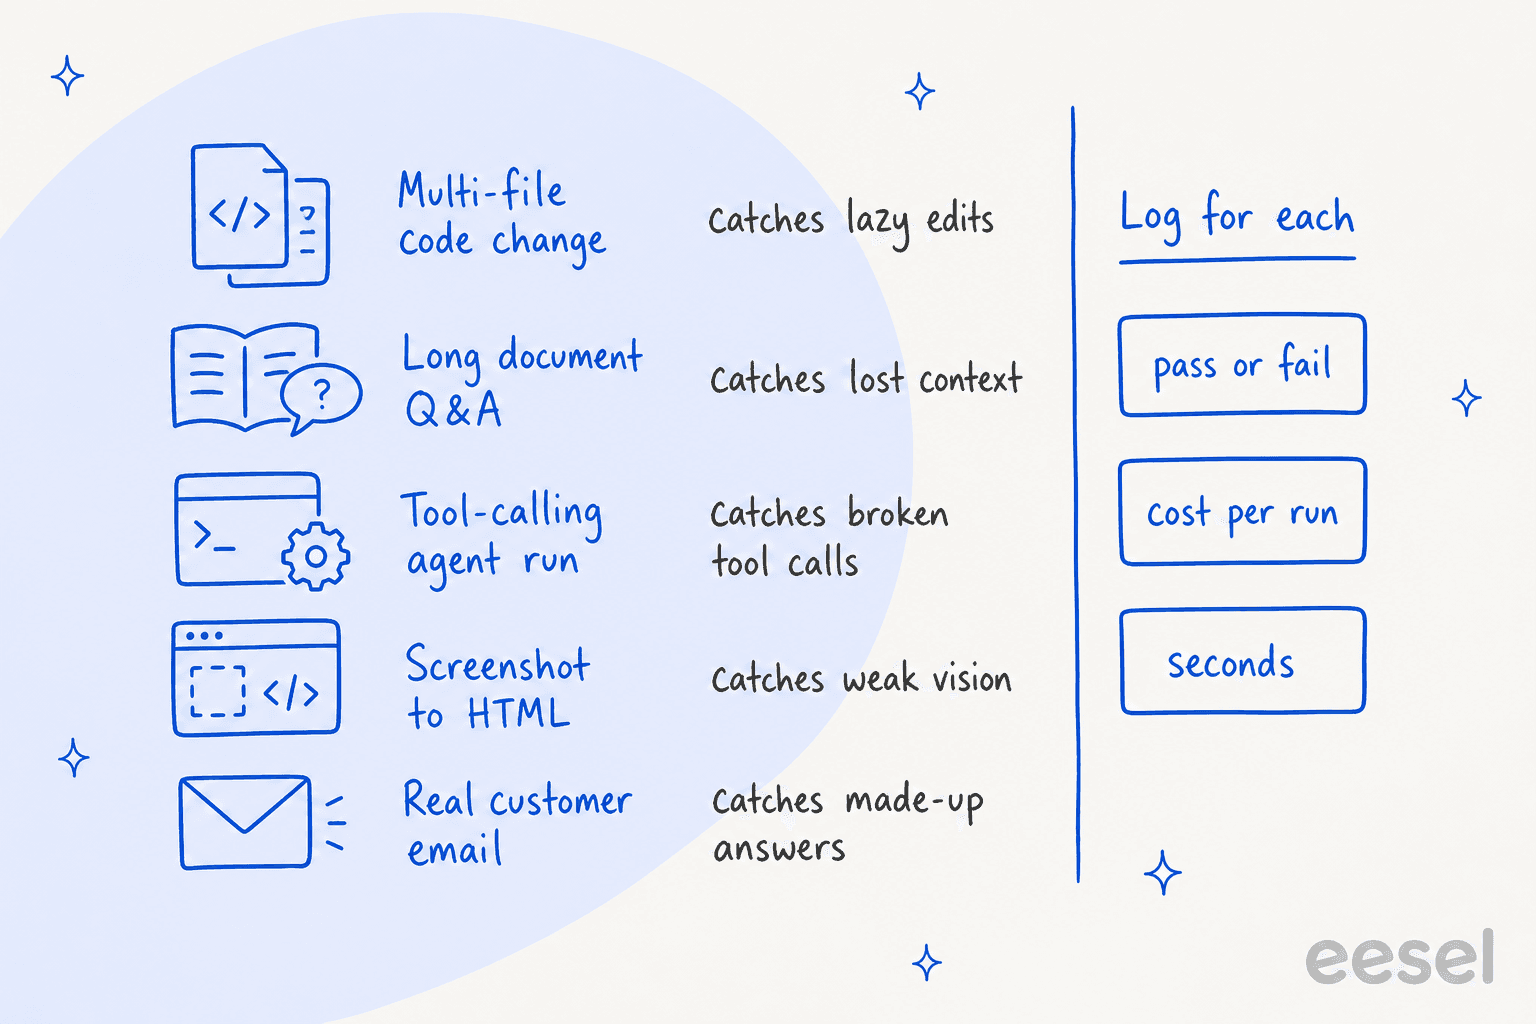
Cada tarea está ahí para detectar un fallo concreto. Y cada finalista tiene una tarea que debería ganar, si sus benchmarks son honestos:
| Finalista | Qué probaría primero | Pregunta principal |
|---|---|---|
| Claude Opus 5.5 | Captura de pantalla a HTML, cambio de código en varios archivos | ¿Gana Wonder en algo al mismo precio? |
| Gemini 4 Argon | Preguntas sobre un documento largo | ¿Se mantiene preciso con 500K tokens, y tendrá sentido el precio de diciembre? |
| Muse Wonder Full | Cambio de código en varios archivos en Muse Code | ¿Vale $50 al mes más que el Wonder normal? |
| GPT-6.1 Sol | Ejecución de un agente con llamadas a herramientas | ¿Basta la mitad del precio en calidad para producción? |
| Muse Spark 1.3 o Gemini 3.8 Flash | El 80% más fácil de tu tráfico real | ¿Puede el modelo barato asumir la mayoría de las solicitudes? |
La tarea de captura de pantalla a HTML está ahí por una razón. Un desarrollador la ejecutó el día del lanzamiento y encontró al Wonder normal mucho más débil que Opus 5.5, más cerca de Sonnet o Haiku. Esa es la clase de brecha que una prueba de una hora encuentra y una tabla de benchmarks esconde.
Mantén la prueba lo bastante pequeña para repetirla. Los precios y versiones de los modelos cambian cada pocas semanas (el de Argon el 1 de diciembre, el de Flash el 1 de enero), y la forma más barata de seguir con el modelo correcto es volver a ejecutar las mismas cinco tareas cada vez que sale algo nuevo.
Qué significa cambiar de modelo para un equipo de soporte
Si eres desarrollador, la prueba de arriba es tu siguiente paso. Si eres responsable de soporte y llegaste aquí desde la cobertura del lanzamiento de Wonder, la respuesta honesta es distinta: el modelo es la parte más pequeña de un agente de soporte con IA.
Elijas el modelo que elijas, alguien tiene que conectarlo a tu helpdesk, mantener sus respuestas dentro de tu conocimiento aprobado, decidir cuándo lo traspasa a una persona y demostrar que acierta antes de que lo vea un cliente. Esos son los trabajos a los que dedico la mayor parte de mi tiempo, y ninguno cambia cuando cambia el modelo. Las notas sobre Muse para atención al cliente y Muse para Zendesk muestran cuánto pegamento hace falta con un modelo en bruto.
También es la razón por la que las cifras de alucinación de DeepSeek y Gemini Flash de arriba importan más en soporte que en código. Una línea de código errónea falla una prueba. Una política de reembolsos errónea llega a un cliente. Si de todos modos lo vas a construir tú, la guía del mejor modelo para tickets de soporte compara modelos específicamente para ese trabajo, y la explicación de agentes de IA vs chatbots cubre lo que añade la capa de agente.
Prueba eesel
Muse Wonder y cada modelo de esta lista son infraestructura; eesel es el empleado. eesel es una plataforma de compañeros de equipo de IA donde contratas compañeros listos para trabajar en tareas concretas, y hoy son dos roles: un compañero de IA para helpdesk y un redactor de blog con IA. Cada uno funciona con modelos de frontera, así que te beneficias de las mejoras de modelo sin repetir una comparativa de modelos cada mes.
El compañero de helpdesk se conecta a Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y responde solo con lo que has aprobado. Antes de que responda a nadie, puedes ejecutarlo contra tus tickets históricos y ver qué habría dicho. Los planes son una tarifa mensual fija en la que un ticket equivale a un crédito, desde $299 al mes por 500 créditos, con 100 créditos gratis para empezar, según la página de precios de eesel.

Como probablemente eres desarrollador si has leído hasta aquí, vale la pena conocer la CLI de eesel. Es un paquete npm (@eesel/cli) que maneja el mismo compañero y espacio de trabajo que el panel, desde tu terminal, un script o un agente de programación como Claude Code. eesel activity lista lo que hizo el compañero y te deja leer cualquier ejecución al detalle, eesel approvals list muestra las acciones que esperan a una persona, y --dry-run imprime la llamada exacta que haría un cambio sin enviarla. Cada comando imprime JSON, y tu espacio de trabajo también funciona como servidor MCP, así que un agente puede gestionarlo igual que tú. La guía para gestionar agentes desde la terminal lo explica paso a paso.
Si Wonder te llamó la atención porque quieres IA trabajando tu cola de soporte, olvida la búsqueda de modelos y prueba eesel con tus propios tickets.