Las 8 mejores alternativas a Claude Sonnet 5.5 en 2026 (según por qué te vas)

Kurnia Kharisma

Katelin Teen
Última edición September 29, 2026
Por qué la gente mira más allá de Claude Sonnet 5.5
Primero lo justo. Sonnet 5.5 es un gran salto respecto a Claude Sonnet 5. La tabla de lanzamiento de Anthropic le da un 70,6 % en Terminal-Bench 4.0, por delante del 66,4 % de Opus 5.5, y Zendesk le dijo a Anthropic que los tickets se procesaban un 20 % más rápido con él. La reseña de Sonnet 5.5 repasa todo eso, y el veredicto de mi compañero sigue en pie: excelente con esfuerzo medio.
Llevo dos años en SEO, así que el comportamiento de búsqueda en torno a este modelo me dijo algo incluso antes que cualquier benchmark. "Alternativas a Sonnet 5.5" empezó a aparecer el día después del lanzamiento, demasiado pronto para que nadie se haya quedado corto con el modelo. La gente buscaba porque algo se rompió, o porque una factura la sorprendió. Son los cuatro motivos en torno a los que organizo el resto del artículo.
Motivo 1: cinco cambios incompatibles, y uno golpea sobre todo a los bots
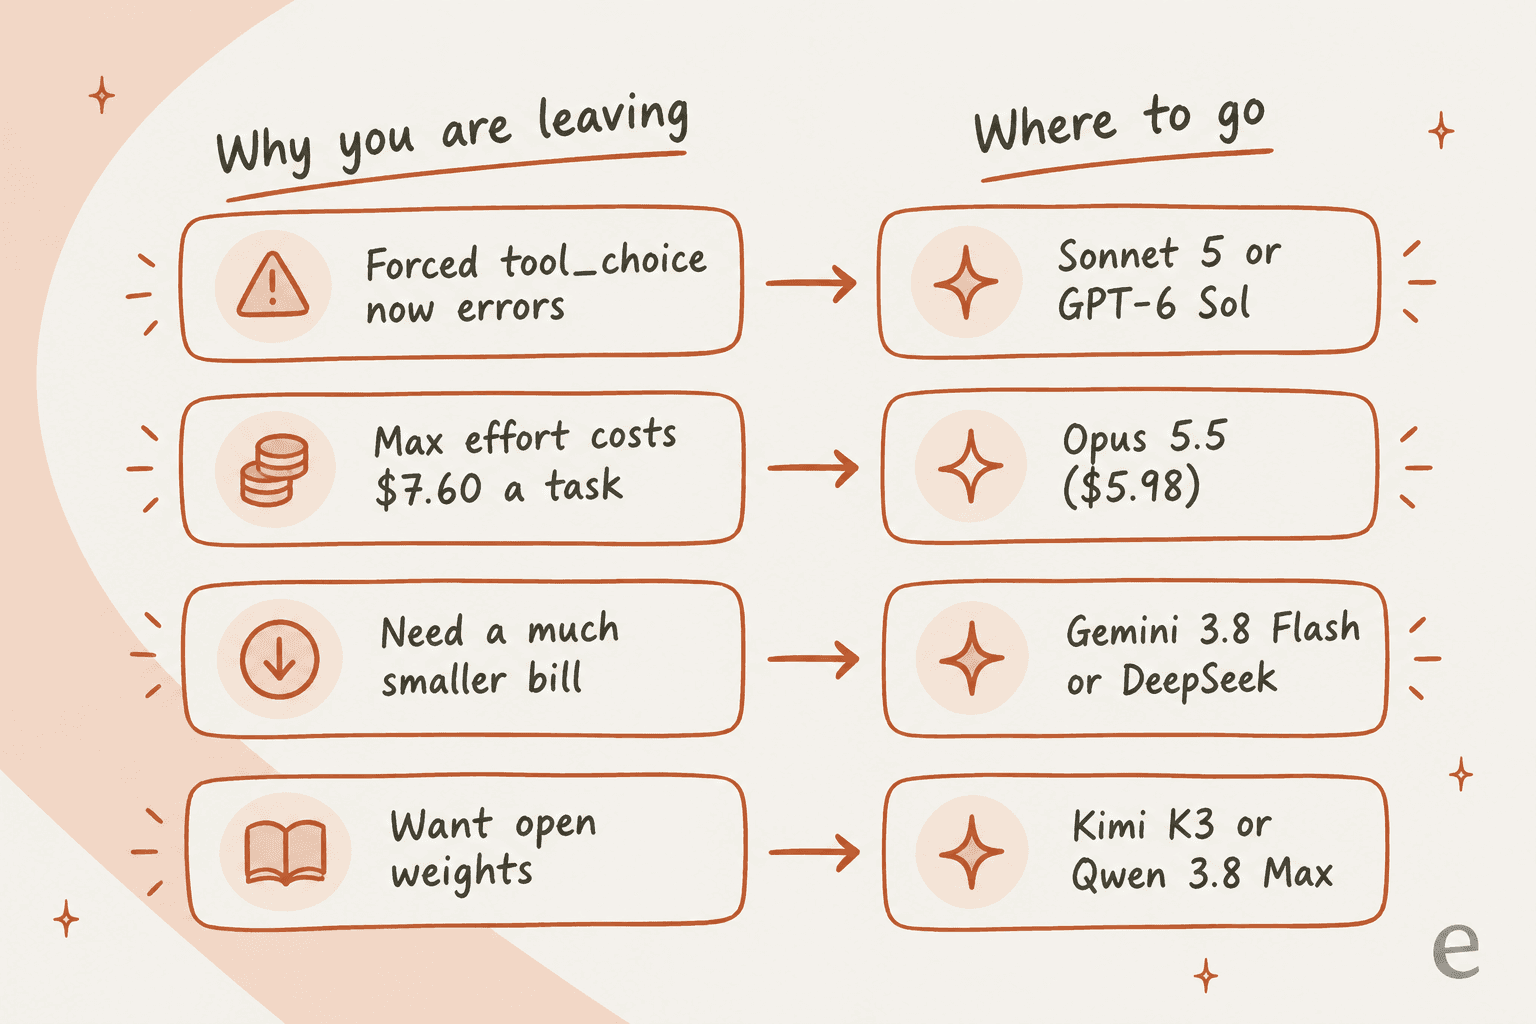
Anthropic enumera cinco cambios incompatibles para el código que funcionaba en Sonnet 5. thinking: disabled ahora devuelve un 400 y te remite a between_tools. La antigua herramienta computer_20251124 se rechaza en la API de Claude y en Google Cloud. Algunas combinaciones de la herramienta advisor también se rechazan.
El que rompe los bots en producción es el uso forzado de herramientas. tool_choice en any o en una herramienta concreta devuelve un invalid_request_error 400 en Sonnet 5.5. Anthropic sugiere mantener auto, poner strict: true o pasar a salidas estructuradas, y "decir en el prompt cuándo aplica la herramienta". Funciona, pero en el fondo cambia una garantía por una petición. Si tu paso de triaje de tickets o de extracción dependía de que el modelo llamara siempre a classify_ticket, ahora tienes un comportamiento que volver a probar y no una línea que cambiar. Y subir a Opus 5.5 aquí no ayuda: sus notas de migración recogen el mismo 400.
Motivo 2: el esfuerzo máximo cuesta más que Opus
El esfuerzo por defecto de la API de Sonnet 5.5 es high. En lo alto de la escalera se vuelve caro. En el Intelligence Index de Artificial Analysis, Sonnet 5.5 con max sacó 56 por $7.60 la tarea, mientras que Opus 5.5 con max sacó 58 por $5.98. Sonnet simplemente usó más tokens para llegar a esa puntuación.
"I'm a bit confused myself. On artificial analysis, sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98. Sonnet 5.5 max was using 193k tokens per task while opus 5.5 max was using 119k."

Simon Willison vio la misma forma, solo que con un único prompt. Su tabla de esfuerzo iba de 1,6 centavos en low a $1.28 en max, donde el modelo "burned through 128,000 thinking tokens" en unos 15 minutos y no llegó a terminar (simonw en Hacker News).
Motivo 3: las lecturas de caché cuestan lo mismo que en Opus
Sonnet 5.5 cuesta la mitad que Opus 5.5 en entrada, salida y escrituras de caché. Las lecturas de caché son la excepción, $0.20 por millón en ambos, porque Opus 5.5 factura las lecturas de caché a 0,05x. En un bucle largo de agente la mayoría de los tokens van a lecturas de caché, así que la diferencia se cierra. La página de precios de la API de Anthropic tiene los multiplicadores.
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Motivo 4: el mismo precio de lista compra trabajo muy distinto
Este es el gráfico que más me sorprendió mientras investigaba. Tres modelos comparten exactamente el mismo precio de $2 de entrada / $10 de salida. Con esfuerzo máximo, aun así producen facturas muy distintas por cada tarea terminada.
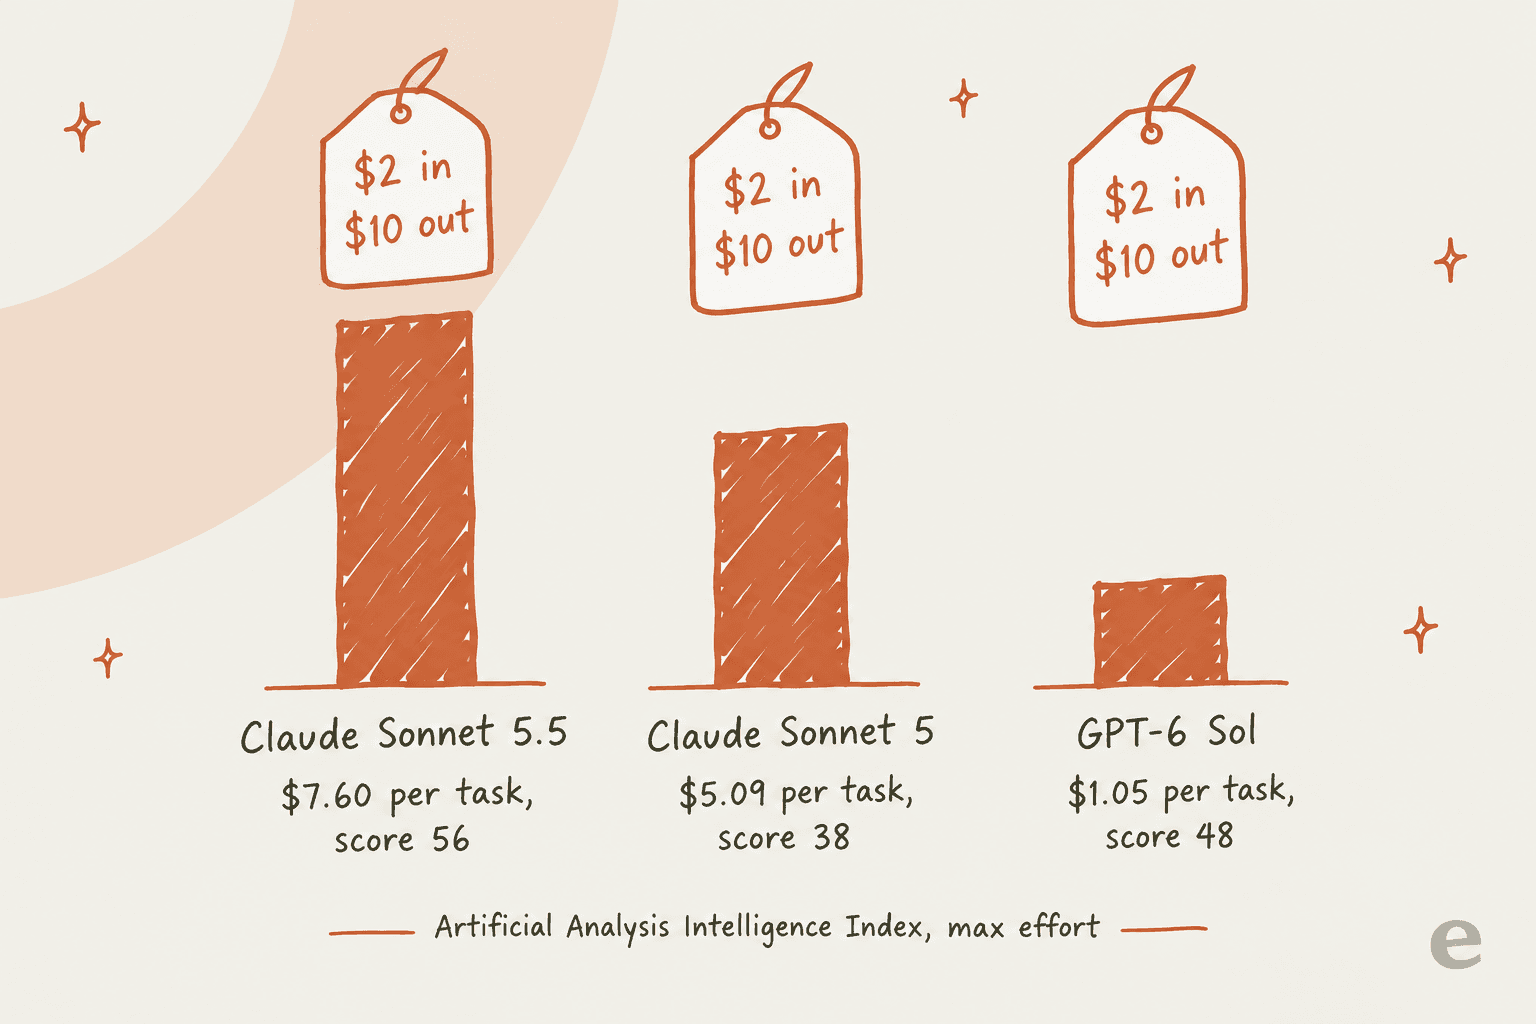
Sonnet 5.5 es el más listo de los tres. También es el más caro por tarea, por un margen amplio. El precio de lista por token dice casi nada sobre la factura. Lo que importa son los tokens por tarea, una propiedad del modelo que solo se descubre ejecutándolo.
Alternativas a Claude Sonnet 5.5 de un vistazo
Los precios son por millón de tokens según la página de precios de cada proveedor, consultados el 2026-09-29. La columna de Artificial Analysis usa la escala actual del Intelligence Index, con el ajuste de esfuerzo que probó AA entre paréntesis. Dejé una celda en blanco en lugar de mezclar una puntuación de la escala antigua.
| Modelo | Entrada / salida | Lectura de caché | Contexto | Puntuación AA, coste por tarea | Elección forzada de herramienta | Pesos abiertos | Ideal para |
|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 (referencia) | $2 / $10 | $0.20 | 1M | 56, $7.60 (max) | No, devuelve 400 | No | Programación rápida en Low/Medium |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 58, $5.98 (max) | No, devuelve 400 | No | Tareas difíciles con esfuerzo alto |
| Claude Sonnet 5 | $2 / $10 | $0.20 | 1M | 38, $5.09 (max) | Sí | No | Plan B sin reescribir |
| GPT-6 Sol | $2 / $10 | $0.20 | 1.05M | 48, $1.05 (max) | Sí (Responses API) | No | Mismo precio, factura menor |
| Gemini 3.8 Flash | $0.75 / $3.75 | $0.075 | 1M | 41, $1.24 (high) | Sí (modo any) | No | Trabajo por lotes multimodal barato |
| Grok 4.7 | $2 / $6 | $0.50 | 500K | 46, $3.74 (xhigh) | Sí (required o con nombre) | No | Bucles largos de agentes |
| Qwen 3.8 Max | $2 / $6 | $0.25 | 1M | - | Herramienta con nombre, solo sin thinking | Modelo base, licencia propia | Salida más barata, base abierta |
| Kimi K3 | $3 / $15 | $0.30 | 1M | - | Solo required | Sí, licencia propia | Pesos abiertos con visión |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fuera de hora punta | $0.003 | 1M | 39, $0.27 (max) | Solo modo sin thinking | Sí, MIT | El suelo de costes |
La columna de elección forzada de herramienta sale de la documentación de function calling de cada proveedor. Léela con cuidado, porque es la columna que más gente entiende mal. La documentación de definición de herramientas de Anthropic enumera juntos Opus 5.5, Sonnet 5.5 y Fable 5.1 como modelos donde any y tool devuelven un 400. DeepSeek y Qwen solo permiten herramientas forzadas con el thinking desactivado, y Kimi K3, que siempre piensa, acepta required pero no una herramienta con nombre. Solo Sonnet 5, GPT-6 Sol, Gemini 3.8 Flash y Grok 4.7 fuerzan una llamada a herramienta con el razonamiento activado.
Cómo elegí estas
Partí de los cuatro motivos anteriores y le hice una pregunta a cada candidato: ¿arregla este modelo un motivo concreto por el que alguien deja Sonnet 5.5, sin crear uno peor? Todos los precios salen de la página de precios del propio proveedor. Todas las cifras de coste por tarea salen de Artificial Analysis, que ejecuta el mismo Intelligence Index en cada modelo y publica lo que gastó. Las citas de la comunidad vienen de hilos de Hacker News y Reddit donde la gente probó los modelos por su cuenta.
Dejé fuera Claude Haiku 4.5 como opción principal. Es una opción real a $1/$5, pero Anthropic da como retirada más temprana el 15 de octubre de 2026, dentro de unas dos semanas, y yo no empezaría una migración hacia un modelo con esa fecha.
Encuentra tu alternativa en diez segundos
Toca el motivo que te trajo aquí.
¿Por qué te vas de Claude Sonnet 5.5?
Elige uno para ver adónde iría yo.
1. Claude Opus 5.5
Ideal para: equipos que usan Sonnet 5.5 con esfuerzo xhigh o max y lo están pagando.
Pongo primero la opción contraintuitiva. Claude Opus 5.5 cuesta el doble por token y aun así puede ser el modelo más barato. Con esfuerzo máximo en Artificial Analysis, Opus 5.5 sacó 58 por $5.98 la tarea y Sonnet 5.5 sacó 56 por $7.60. Opus salió como el primer Opus de Anthropic que se abarata, $4/$20 en lugar de $5/$25, y sus lecturas de caché se facturan a 0,05x, por eso igualan los $0.20 de Sonnet.
También premia bajar de nivel. El desglose de precios de Sonnet 5.5 encontró que Opus 5.5 en Medium sacaba 51 por $1.34 la tarea, frente a Sonnet 5.5 en Xhigh con 52 por $2.74. Casi la misma puntuación por la mitad del dinero.
Ventajas
- Techo más alto que Sonnet 5.5 en el Intelligence Index, 58 frente a 56 en max.
- Más barato por tarea que Sonnet 5.5 con esfuerzo máximo.
- La misma API de Claude, las mismas herramientas, los mismos flujos de Claude Code.
Inconvenientes
- El doble del precio por token de Sonnet en entrada, salida y escrituras de caché, así que en Low y Medium gana Sonnet 5.5.
- Más lento, algo que la gente del hilo de lanzamiento notó enseguida.
- Rechaza
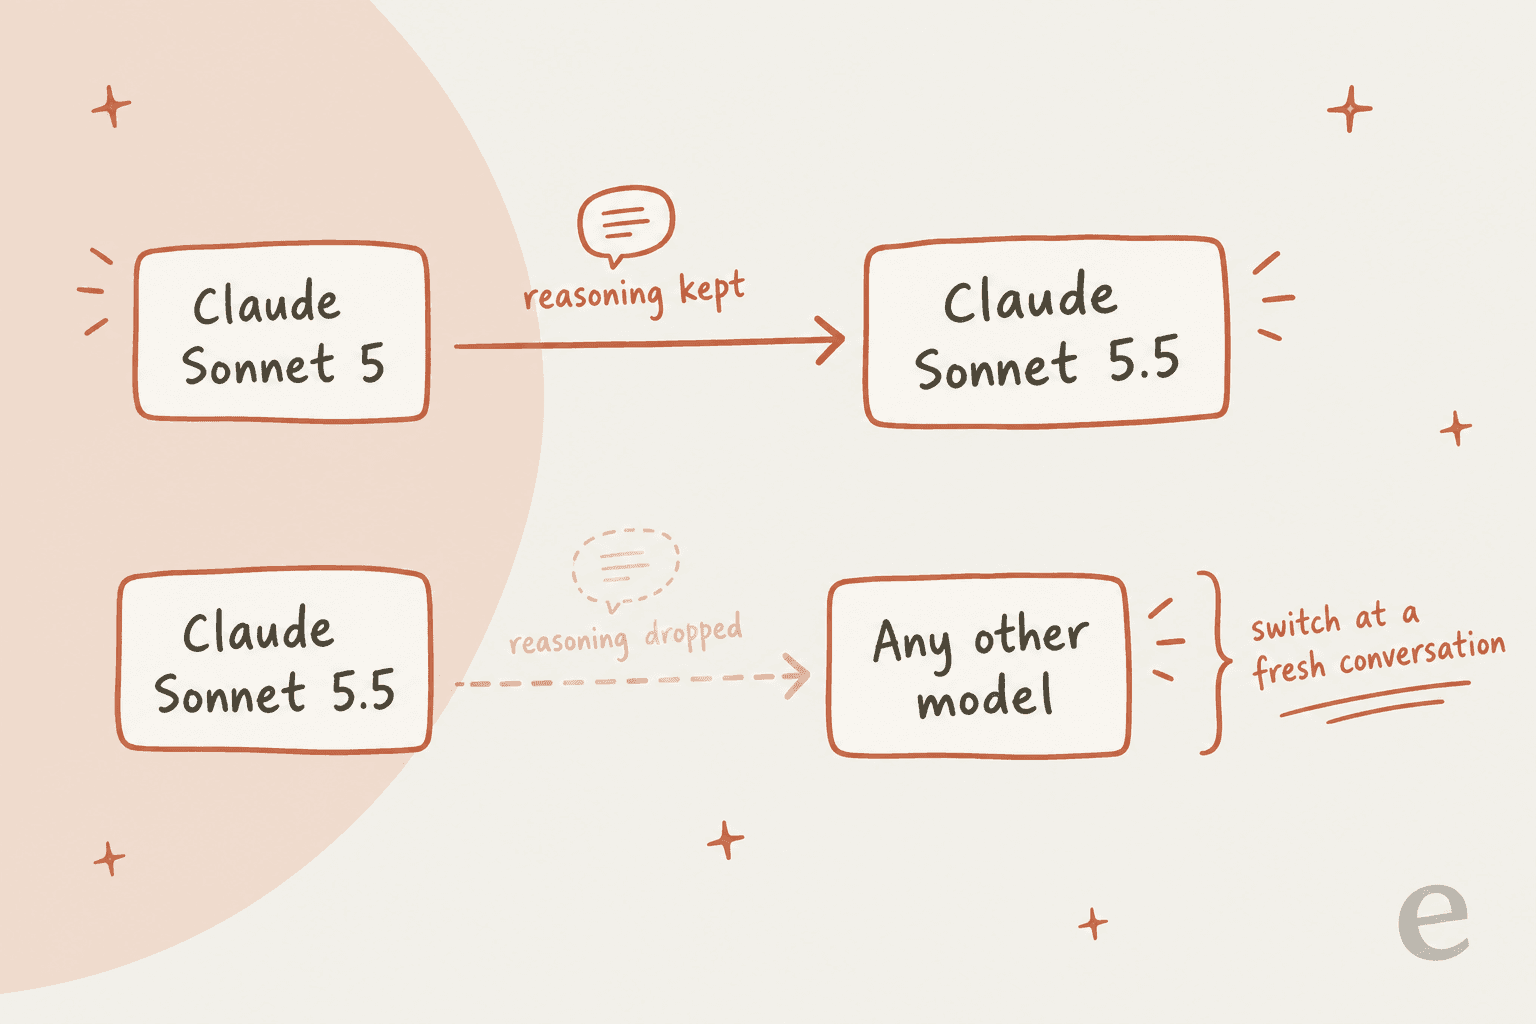
tool_choiceforzado igual que Sonnet 5.5, así que no arregla ese cambio incompatible. - Sonnet 5.5 no puede leer los bloques de razonamiento de Opus 5.5 ni viceversa, así que mezclarlos en una conversación descarta razonamiento.
Precios
$4 de entrada, $20 de salida, $0.20 de lectura de caché por millón de tokens, con Batch a mitad de precio. Consulta el artículo de precios de Claude Opus 5.5 para ver cada línea.
Mi opinión: Si tu carga vive en xhigh o max, pasa a Opus 5.5 y baja un nivel de esfuerzo. Probablemente pagarás menos y obtendrás mejor respuesta. Si trabajas en Low o Medium, quédate con Sonnet 5.5; esta opción no te aplica.
2. Claude Sonnet 5
Ideal para: quien tenga el código de producción roto por el uso forzado de herramientas de Sonnet 5.5 o por el cambio de thinking: disabled.
Es la respuesta aburrida, pero el día que tu pipeline empieza a lanzar 400 es la correcta. Claude Sonnet 5 es el modelo con el que se miden los cinco cambios incompatibles, así que por definición ninguno aplica. Tiene el mismo precio de $2/$10. La página de deprecaciones de Anthropic lo lista como activo, sin retirada antes del 30 de junio de 2027.
Hay un buen detalle en la documentación para quien planee una migración por etapas. Sonnet 5.5 puede leer los bloques de razonamiento de Sonnet 5, así que una conversación que empieza en Sonnet 5 y sube conserva su razonamiento. Al revés no funciona.
Ventajas
- Una vuelta atrás de una línea: cambia el ID del modelo, nada más.
- Conserva
tool_choiceforzado, los presupuestos manuales de thinking y la herramienta de computer use anterior. - Suelo de retirada a más de 20 meses.
Inconvenientes
- Claramente menos capaz. Terminal-Bench 4.0 es 10,3 % frente al 70,6 % de Sonnet 5.5 en la tabla de lanzamiento de Anthropic.
- Tampoco es más barato por tarea. Con max midió
$5.09para una puntuación de 38. - Ya no figura en la tabla de modelos actuales de Anthropic, así que las novedades llegarán primero a 5.5.
Precios
$2 de entrada, $10 de salida, $0.20 de lectura de caché por millón de tokens. El artículo de precios de Claude Sonnet 5 tiene los detalles de planes y Batch.
Mi opinión: Usa Sonnet 5 como aparcamiento, no como destino. Vuelve atrás hoy, arregla tus llamadas a herramientas en una rama contra Sonnet 5.5 o GPT-6 Sol, y luego avanza. La lista de alternativas a Claude Sonnet 5 merece una mirada si vas a estar aparcado más tiempo.
3. GPT-6 Sol
Ideal para: equipos que quieren precios de nivel Sonnet con llamadas forzadas a herramientas y una factura menor por tarea.
GPT-6 Sol tiene el mismo precio de lista que Sonnet 5.5: $2 de entrada, $0.20 en caché, $2.50 de escrituras de caché, $10 de salida (precios de OpenAI). La diferencia es cuántos tokens gasta. Con esfuerzo máximo en Artificial Analysis, GPT-6 Sol sacó 48 por $1.05 la tarea, cerca de un séptimo de la factura de Sonnet 5.5 con esfuerzo máximo. Es menos capaz en lo más alto: 48 frente a 56.
Para quienes necesitan uso forzado de herramientas, la guía de function calling de OpenAI documenta required y la elección de herramienta por nombre de función. Una pega en la página del modelo: con Chat Completions, GPT-6 Sol solo admite function calling con reasoning_effort en none. Usa la Responses API si quieres herramientas y razonamiento a la vez.
Ventajas
- Mismo precio por token que Sonnet 5.5, coste por tarea mucho menor en max.
- Elección forzada de herramienta documentada.
- Contexto de 1.050.000 tokens y un conjunto completo de herramientas de la Responses API.
Inconvenientes
- Techo más bajo: 48 en el Intelligence Index frente a 56 de Sonnet 5.5.
- Los prompts de más de 272K tokens de entrada se facturan a 2x en entrada y 1,5x en salida para toda la petición.
- Cambiar de proveedor implica código de SDK nuevo, ajuste de prompts nuevo y evals nuevos.
"Sonnet 5.5 is way better than GPT 6 Sol. Does that even make sense?"
Ese comentario es un contrapeso honesto a los números. En programación difícil, mucha gente prefiere Sonnet 5.5, y los benchmarks les dan la razón.
Precios
$2 de entrada, $0.20 en caché, $10 de salida, con Batch y Flex a la mitad. El artículo de precios de GPT-6 Sol y la lista de alternativas a GPT-6 Sol profundizan más.
Mi opinión: El mejor cambio directo para trabajo de alto volumen con muchas herramientas, donde "bueno y barato por tarea" pesa más que "el mejor". Para la máxima calidad en programación, quédate con Anthropic.
4. Gemini 3.8 Flash
Ideal para: trabajo por lotes y multimodal de alto volumen donde nadie espera el primer token.
Gemini 3.8 Flash cuesta $0.75 de entrada y $3.75 de salida por millón de tokens, tokens de thinking incluidos, hasta el 31 de diciembre de 2026 (precios de la API de Gemini). Es menos del 40 % de las tarifas de Sonnet 5.5. Acepta texto, imagen, audio, vídeo y PDF como entrada, algo que Sonnet no iguala en audio y vídeo. En Artificial Analysis con esfuerzo alto sacó 41 por $1.24 la tarea.
Hay dos cosas que tener en cuenta. El precio se duplica a $1.50/$7.50 el 1 de enero de 2027. Y Artificial Analysis midió su tiempo hasta el primer token en 13,3 segundos, muy por encima de la mediana de la clase, aunque su velocidad de salida está entre las mejores. Bien para un trabajo nocturno, mal para una respuesta de chat en directo.
Ventajas
- Mucho más barato por token, con Batch y Flex otra vez a la mitad.
- Los tipos de entrada más amplios de esta lista.
- Un nivel gratuito para prototipar.
Inconvenientes
- El precio se duplica en tres meses.
- El primer token lento lo descarta para cualquier cosa que una persona espere.
- Google dice que 3.8 "works harder" y usa más tokens, y aun así recomienda 3.7 Flash para trabajo centrado en eficiencia.
Precios
$0.75 de entrada, $3.75 de salida, $0.075 de lectura de caché hasta fin de año. Consulta los precios de Gemini 3.8 Flash y la reseña de Gemini 3.8 Flash.
Mi opinión: Una opción sólida para procesar documentos, transcripciones y cualquier cosa con vídeo. Presupuesta ya el cambio de precio de enero, no en diciembre.
5. Grok 4.7
Ideal para: bucles largos de agentes donde los tokens de salida más baratos se acumulan.
Grok 4.7 cuesta $2 de entrada y $6 de salida por millón por debajo de 200K tokens de prompt (precios de xAI). Es una salida un 40 % más barata que Sonnet 5.5, y la salida es donde gastan los modelos de razonamiento. xAI lo construyó sobre un modelo base más grande con un entrenamiento RL más largo orientado a tareas de varias horas, y casi duplicó a Grok 4.6 en Terminal-Bench 4.0, 37,6 frente a 20,3 en la propia tabla de xAI. En Artificial Analysis con xhigh sacó 46 por $3.74 la tarea.
Ventajas
- Salida a
$6, un 40 % por debajo de Sonnet 5.5. - Contexto de 500K y una API de Context Compaction para sesiones largas.
- Buenas puntuaciones agénticas en las cifras de EEBench y Briefcase de xAI.
Inconvenientes
- Si pasas de 200K tokens de prompt, toda la petición se factura a
$4/$12, no solo el exceso. - Terminal-Bench 4.0 a 37,6 queda muy por debajo del 70,6 de Sonnet 5.5.
- Las lecturas en caché a
$0.50cuestan más que los$0.20de Anthropic.
Precios
$2 de entrada, $0.50 en caché, $6 de salida por debajo de 200K. El artículo de precios de Grok 4.7 cubre los contadores de llamadas a herramientas.
Mi opinión: Vale la pena probarlo si tus agentes generan mucha salida y se mantienen por debajo de 200K de contexto. Mantén los prompts recortados, porque el precipicio del contexto largo es empinado.
6. Qwen 3.8 Max
Ideal para: equipos que quieren precio de entrada al nivel de Sonnet, salida más barata y un modelo base descargable.
Qwen 3.8 Max cuesta $2 de entrada y $6 de salida por millón en Qwen Cloud, con 1M de contexto, 131K de salida máxima y hasta 262K tokens de razonamiento. Es un modelo de mezcla de expertos de 2,4T parámetros con 95B activos. Los pesos base están en Hugging Face como Qwen3.8-2.4T-A95B, bajo una licencia propia de Qwen en lugar de Apache.
La licencia y la lista de funciones conviene leerlas juntas. El Max alojado añade entrada de visión, un modo sin thinking y herramientas integradas que la base abierta no incluye. "Abierto" aquí significa que puedes ejecutar el modelo base, no que obtengas el producto alojado.
Ventajas
- Mismo precio de entrada que Sonnet 5.5, salida un 40 % más barata.
- Buenos rankings de preferencia humana, incluido el puesto 5 en Texto de LMArena en agosto.
- Una vía de autoalojamiento si alguna vez la necesitas.
Inconvenientes
- La base abierta no es equivalente en funciones al modelo alojado.
- Licencia propia, así que consúltala con legal antes de lanzar con ella.
- Los datos van a la nube de Alibaba salvo que lo alojes tú.
Precios
$2 de entrada, $6 de salida, $0.25 de lectura de caché implícita. Consulta los precios de Qwen 3.8 Max y la reseña de Qwen 3.8 Max.
Mi opinión: Una buena opción intermedia si lo que duele es el precio de salida de Sonnet y quieres una salida futura de cualquier proveedor único.
7. Kimi K3
Ideal para: equipos que necesitan pesos abiertos con visión nativa y están listos para ejecutar hardware serio.
Kimi K3 es el modelo estrella de Moonshot AI: 2,8T parámetros con 104B activos, 1M de contexto y comprensión nativa de imagen y vídeo. Los pesos están en Hugging Face, algo que ninguno de los modelos occidentales de aquí ofrece. En la API cuesta $3 de entrada, $0.30 en caché y $15 de salida por millón (precios de Moonshot), con escrituras de caché facturadas aparte a $3 o $6 según el TTL.
Eso lo hace más caro que Sonnet 5.5 en la API. La razón para elegirlo es el control, no el coste.
Ventajas
- Pesos abiertos a escala de frontera, con visión integrada.
- 1M de contexto y salida configurable hasta 1M de tokens.
- Una vía de autoalojamiento para datos que no pueden salir de tu red.
Inconvenientes
- Más caro que Sonnet 5.5 por token en la API alojada.
- El razonamiento no se puede desactivar en ningún nivel de esfuerzo.
- El repositorio de pesos ocupa unos 1,5 TB, así que autoalojarlo es trabajo de clúster.
Precios
$3 de entrada, $0.30 en caché, $15 de salida. Consulta los precios de Kimi K3 y las alternativas a Kimi K3.
Mi opinión: Elige Kimi K3 solo si de verdad vas a autoalojar. Si igualmente vas a llamar a la API, Sonnet 5.5 en Medium es más barato y más fácil.
8. DeepSeek V4.1 Flash
Ideal para: la factura más baja posible, y la única licencia abierta permisiva de esta lista.
DeepSeek V4.1 Flash cuesta $0.15 de entrada y $0.60 de salida por millón fuera de hora punta, y $0.30/$1.20 en hora punta (precios de DeepSeek). El nombre en la API ahora es deepseek-flash. En Artificial Analysis con esfuerzo máximo, sacó 39 por $0.27 la tarea, calculado a tarifa de hora punta, así que fuera de hora punta ronda la mitad. Los pesos tienen licencia MIT.
Es también el modelo al que DeepSeek movió su tráfico de V4 Pro, lo que dice cuánta confianza le tienen. Admite llamadas a herramientas, el formato de la API de Anthropic y la Responses API, así que un código con el SDK de Anthropic a menudo puede apuntar a él cambiando la URL base.
Ventajas
- Unas 28 veces más barato por tarea que Sonnet 5.5 en max, según las cifras de AA.
- Pesos MIT y un endpoint compatible con Anthropic.
- Visión integrada en el modelo principal.
Inconvenientes
- Un techo mucho más bajo: 39 en el Intelligence Index.
- Los términos de la API de pago no publican un acuerdo de procesamiento de datos ni una opción de retención cero, y los datos se procesan en China.
- El precio de hora punta duplica la tarifa de 01:00-04:00 y 06:00-10:00 UTC en días laborables.
"I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it."
Precios
Fuera de hora punta $0.15 de entrada, $0.60 de salida, $0.003 por acierto de caché; en hora punta es el doble. Consulta los precios de DeepSeek V4.1 Flash.
Mi opinión: Excelente para herramientas internas, generación de código y trabajos por lotes. Para cualquier cosa que lleve datos de clientes, piénsatelo dos veces con las condiciones de datos antes que con el precio.
Qué dicen los desarrolladores sobre Sonnet 5.5 frente al resto
El hilo de lanzamiento en Hacker News llegó a 556 comentarios, y la división fue clara. A la gente le gustan la velocidad y el salto en benchmarks. No tienen claro dónde encaja junto a Opus 5.5.
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost. But Sonnet 5.5 at medium and below gives you a cheaper option at a performance worse than the lowest thinking Opus (low), which may be viable for "low intelligence" use cases."
El patrón en el que se asentaron varias personas no es "dejar Sonnet 5.5" en absoluto. Es repartir el trabajo: Opus planifica, Sonnet construye en Low o Medium, Opus remata. Un comentarista lo resumió como "80% Sonnet 5.5, Opus 5.5 to finish the last 20%" (vektormemory en Hacker News). Si encaja con tu configuración, la guía de subagentes de Claude Code muestra cómo montarlo.
También hay una regresión de calidad que conviene conocer. Un desarrollador que ejecutaba un benchmark adversarial vio a Sonnet 5.5 sacar 7,4 % frente al 17,8 % de Sonnet 5, porque "returns to ask the user questions whether to keep going" (dom96 en Hacker News). Para un agente desatendido es un cambio de comportamiento que conviene probar.
Cambiar es un problema de soporte, no solo de modelo
Todos los modelos de esta lista sacarán una versión nueva en unos meses, y algunas de esas versiones romperán algo. Sonnet 5.5 llegó con cinco cambios incompatibles. El precio de Gemini 3.8 Flash se duplica en enero. Haiku 4.5 tiene una fecha de retirada dentro de dos semanas. Elijas lo que elijas hoy, alguien de tu equipo se encarga de volver a probarlo el próximo trimestre.
Esta es la parte que los compradores subestiman. En una llamada de ventas de eesel que revisé, un comprador atento al presupuesto de una pequeña empresa de hardware dijo que se había quemado cuando el precio de un proveedor anterior "more than doubled", y que quería un precio fijado por contrato antes de firmar nada. La capa de modelos tiene el mismo riesgo, solo que con un reloj más rápido.
Para una cola de soporte en concreto, aquí es donde dejaría de elegir modelos. eesel ejecuta compañeros de IA en colas de helpdesk en vivo, y cada despliegue se simula con los tickets históricos del equipo antes de que responda a un cliente real. Cuando cambia el modelo de debajo, esa simulación es como encuentras la regresión en el estilo de llamadas forzadas a herramientas antes de que lo haga un cliente. El resumen del mejor modelo para tickets de soporte compara los modelos en esa tarea, y la guía del coste de un agente de soporte con IA cubre el lado del presupuesto.
Prueba eesel si el modelo va a tu helpdesk
Un modelo en bruto es infraestructura. Lo eliges, cableas sus llamadas a herramientas, escribes los evals y los vuelves a ejecutar cuando llega un cambio incompatible. eesel es el empleado que va encima: un compañero de IA para helpdesk que se incorpora a tu Zendesk u otro helpdesk, aprende de tus tickets pasados y tu centro de ayuda, y se prueba con tus tickets históricos antes de responder a nadie. Nunca configuras tool_choice, y el cambio incompatible de un modelo lo absorbe eesel en lugar de tu cola de soporte.
Si llegaste aquí desde una terminal, la CLI de eesel maneja el mismo compañero. Instálala con npm i -g @eesel/cli, conecta un helpdesk con eesel integrations connect, edita sus reglas permanentes con eesel instructions y lee cada ejecución como JSON con eesel activity. Las escrituras aceptan --dry-run, y cada workspace es también un servidor MCP, así que Claude Code, Codex o Cursor pueden operarlo por ti. Es el control programable que querrías de una API de modelos, apuntado a un compañero que ya hace el trabajo.

Los precios de eesel son un plan fijo mensual de créditos, con un nivel gratuito para probarlo con tus propios tickets. Prueba eesel y mira tu cola respondida sin elegir antes un modelo.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Claude Sonnet 5.5?
¿Hay alguna alternativa a Claude Sonnet 5.5 que admita el uso forzado de herramientas?
tool_choice con any o una herramienta concreta, y no se retira antes del 30 de junio de 2027. GPT-6 Sol, Gemini 3.8 Flash y Grok 4.7 también fuerzan llamadas a herramientas. Ojo: Claude Opus 5.5 también lo rechaza, así que subir en la gama de Claude no lo arregla. La guía de la API de helpdesk con IA explica dónde importan las llamadas forzadas en soporte.¿Es Claude Opus 5.5 más barato que Claude Sonnet 5.5?
¿Cuál es la alternativa más barata a Claude Sonnet 5.5?
¿Hay alternativas de código abierto a Claude Sonnet 5.5?
¿Puedo cambiar de Claude Sonnet 5.5 a otro modelo a mitad de una conversación?
¿Qué alternativa a Claude Sonnet 5.5 es mejor para un bot de atención al cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.