Las 8 mejores alternativas a Meta Muse Spark Open en 2026, comparadas en licencia, precio y hardware

Rama Adi

Katelin Teen
Última edición October 18, 2026
Resumen
La mejor alternativa a Muse Spark Open para la mayoría de los equipos es GLM 5.3: puntúa 45 en la tabla comparativa de Meta frente a 39 de Muse Spark Open, por 15 centavos más por millón de tokens. Su licencia pide un aviso de copyright y nada más, salvo que tengas un negocio de alojamiento de modelos con más de 10.000 millones de dólares de ingresos.
Si buscas por el costo, DeepSeek V4.1 Flash tiene licencia MIT y es unas 7 veces más barato en la salida (0,60 $ vs 4,25 $ por millón de tokens, en horario valle). Si buscas por el hardware, gpt-oss-120b funciona con una sola GPU de 80GB. Si necesitas las mejores puntuaciones en código y visión, Kimi K3 lidera, a 15 $ por millón de tokens de salida.
Quédate con Muse Spark Open si necesitas la mejor puntuación de uso de herramientas (89,2 en MCP-Atlas) y la mayor resistencia a jailbreaks de su clase. Y si el modelo es para una cola de soporte, el modelo es la decisión menor: el compañero de helpdesk con IA de eesel ya se encarga de la base en tus fuentes, las pruebas con tus tickets anteriores y los traspasos, algo que ningún modelo de pesos abiertos incluye.
Por qué la gente mira más allá de Muse Spark Open
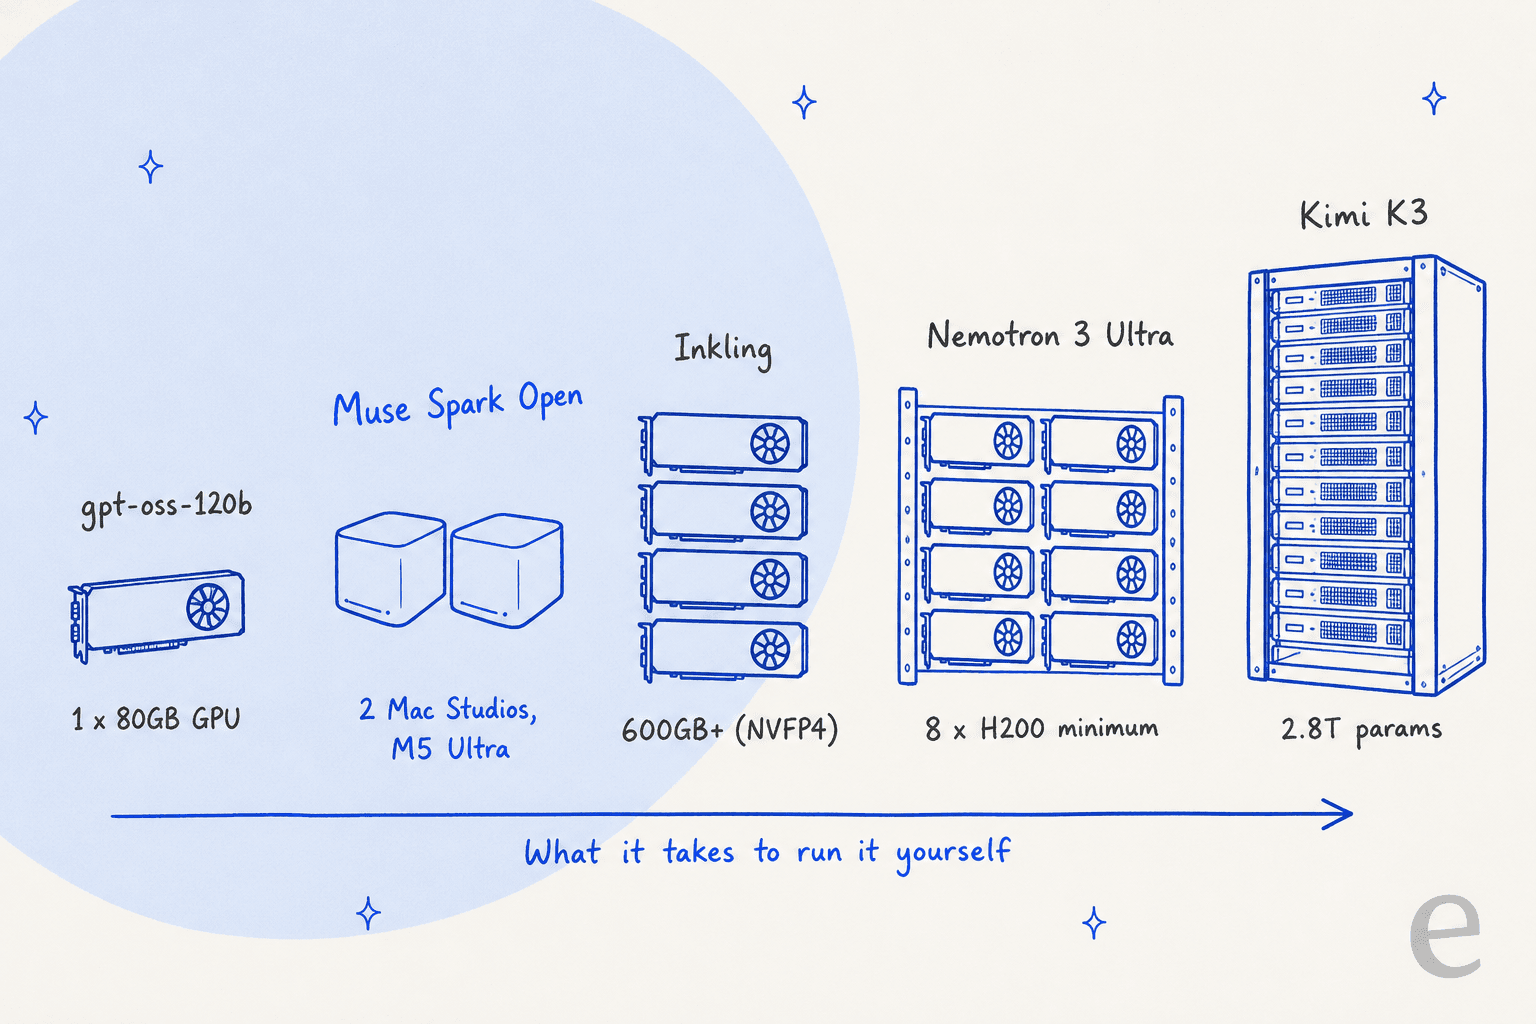
Meta lanzó Muse Spark Open el 15 de octubre de 2026, y es un modelo serio. Es una mezcla de expertos de 816B parámetros con 42B activos por token, una ventana de contexto de 1M de tokens y entrada nativa de texto, imagen, audio y video, según el blog de investigación de Meta. También es el primer modelo de su clase que funciona sobre un escritorio: dos Mac Studio M5 Ultra, usando MLX de Apple a 24,99 tokens por segundo.
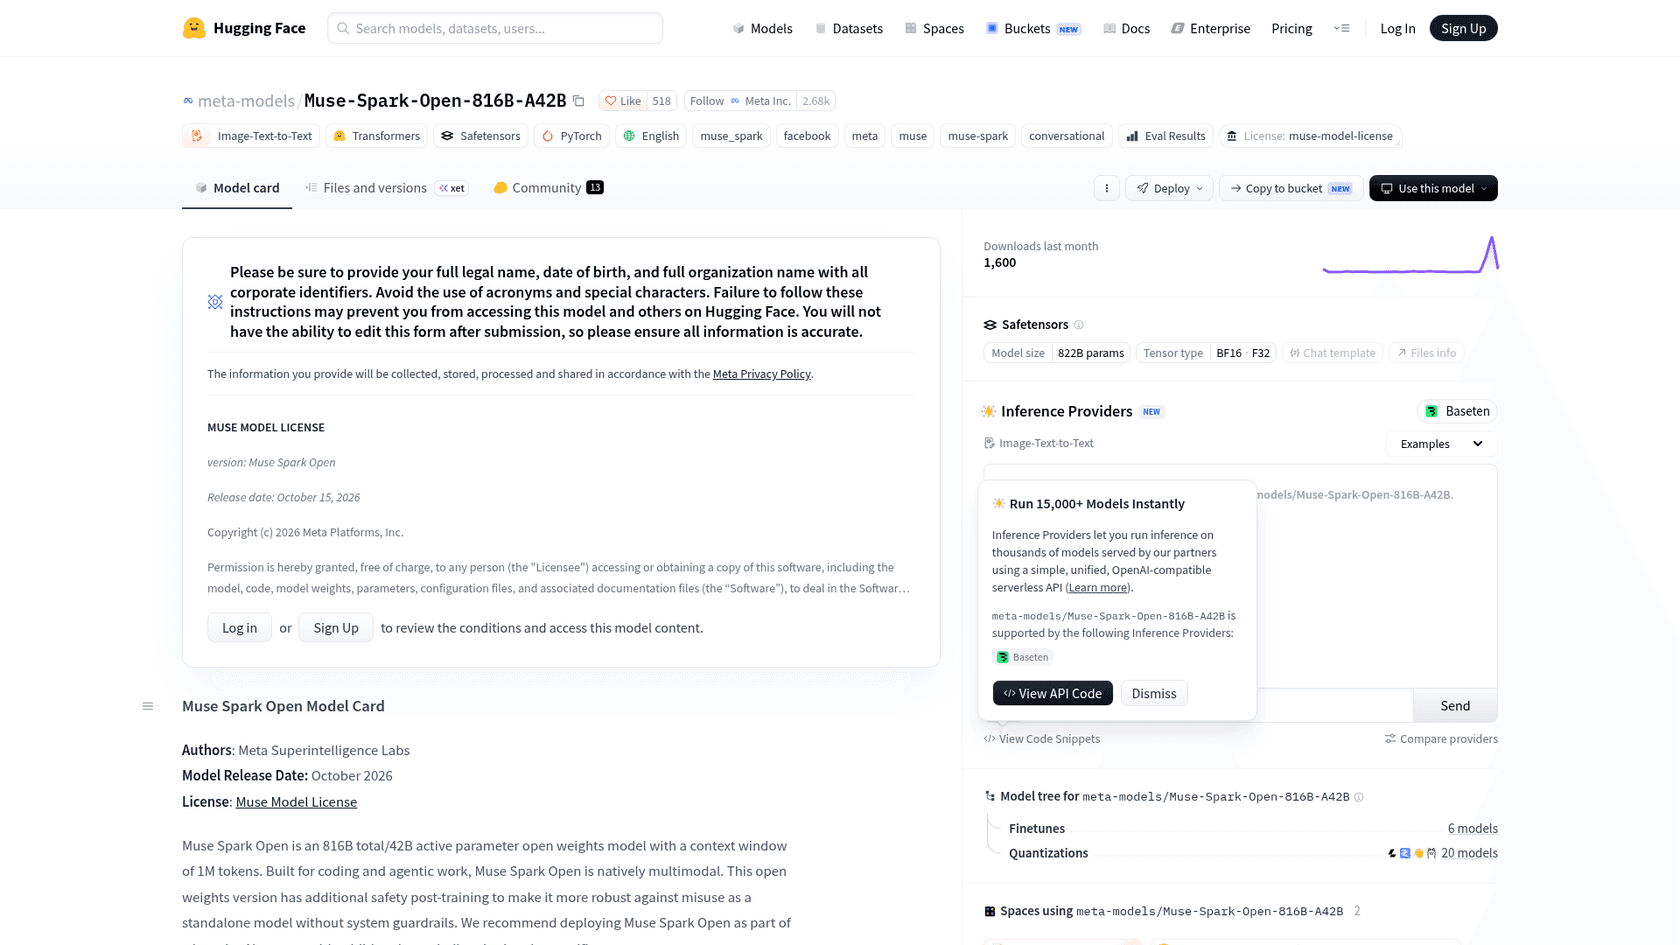
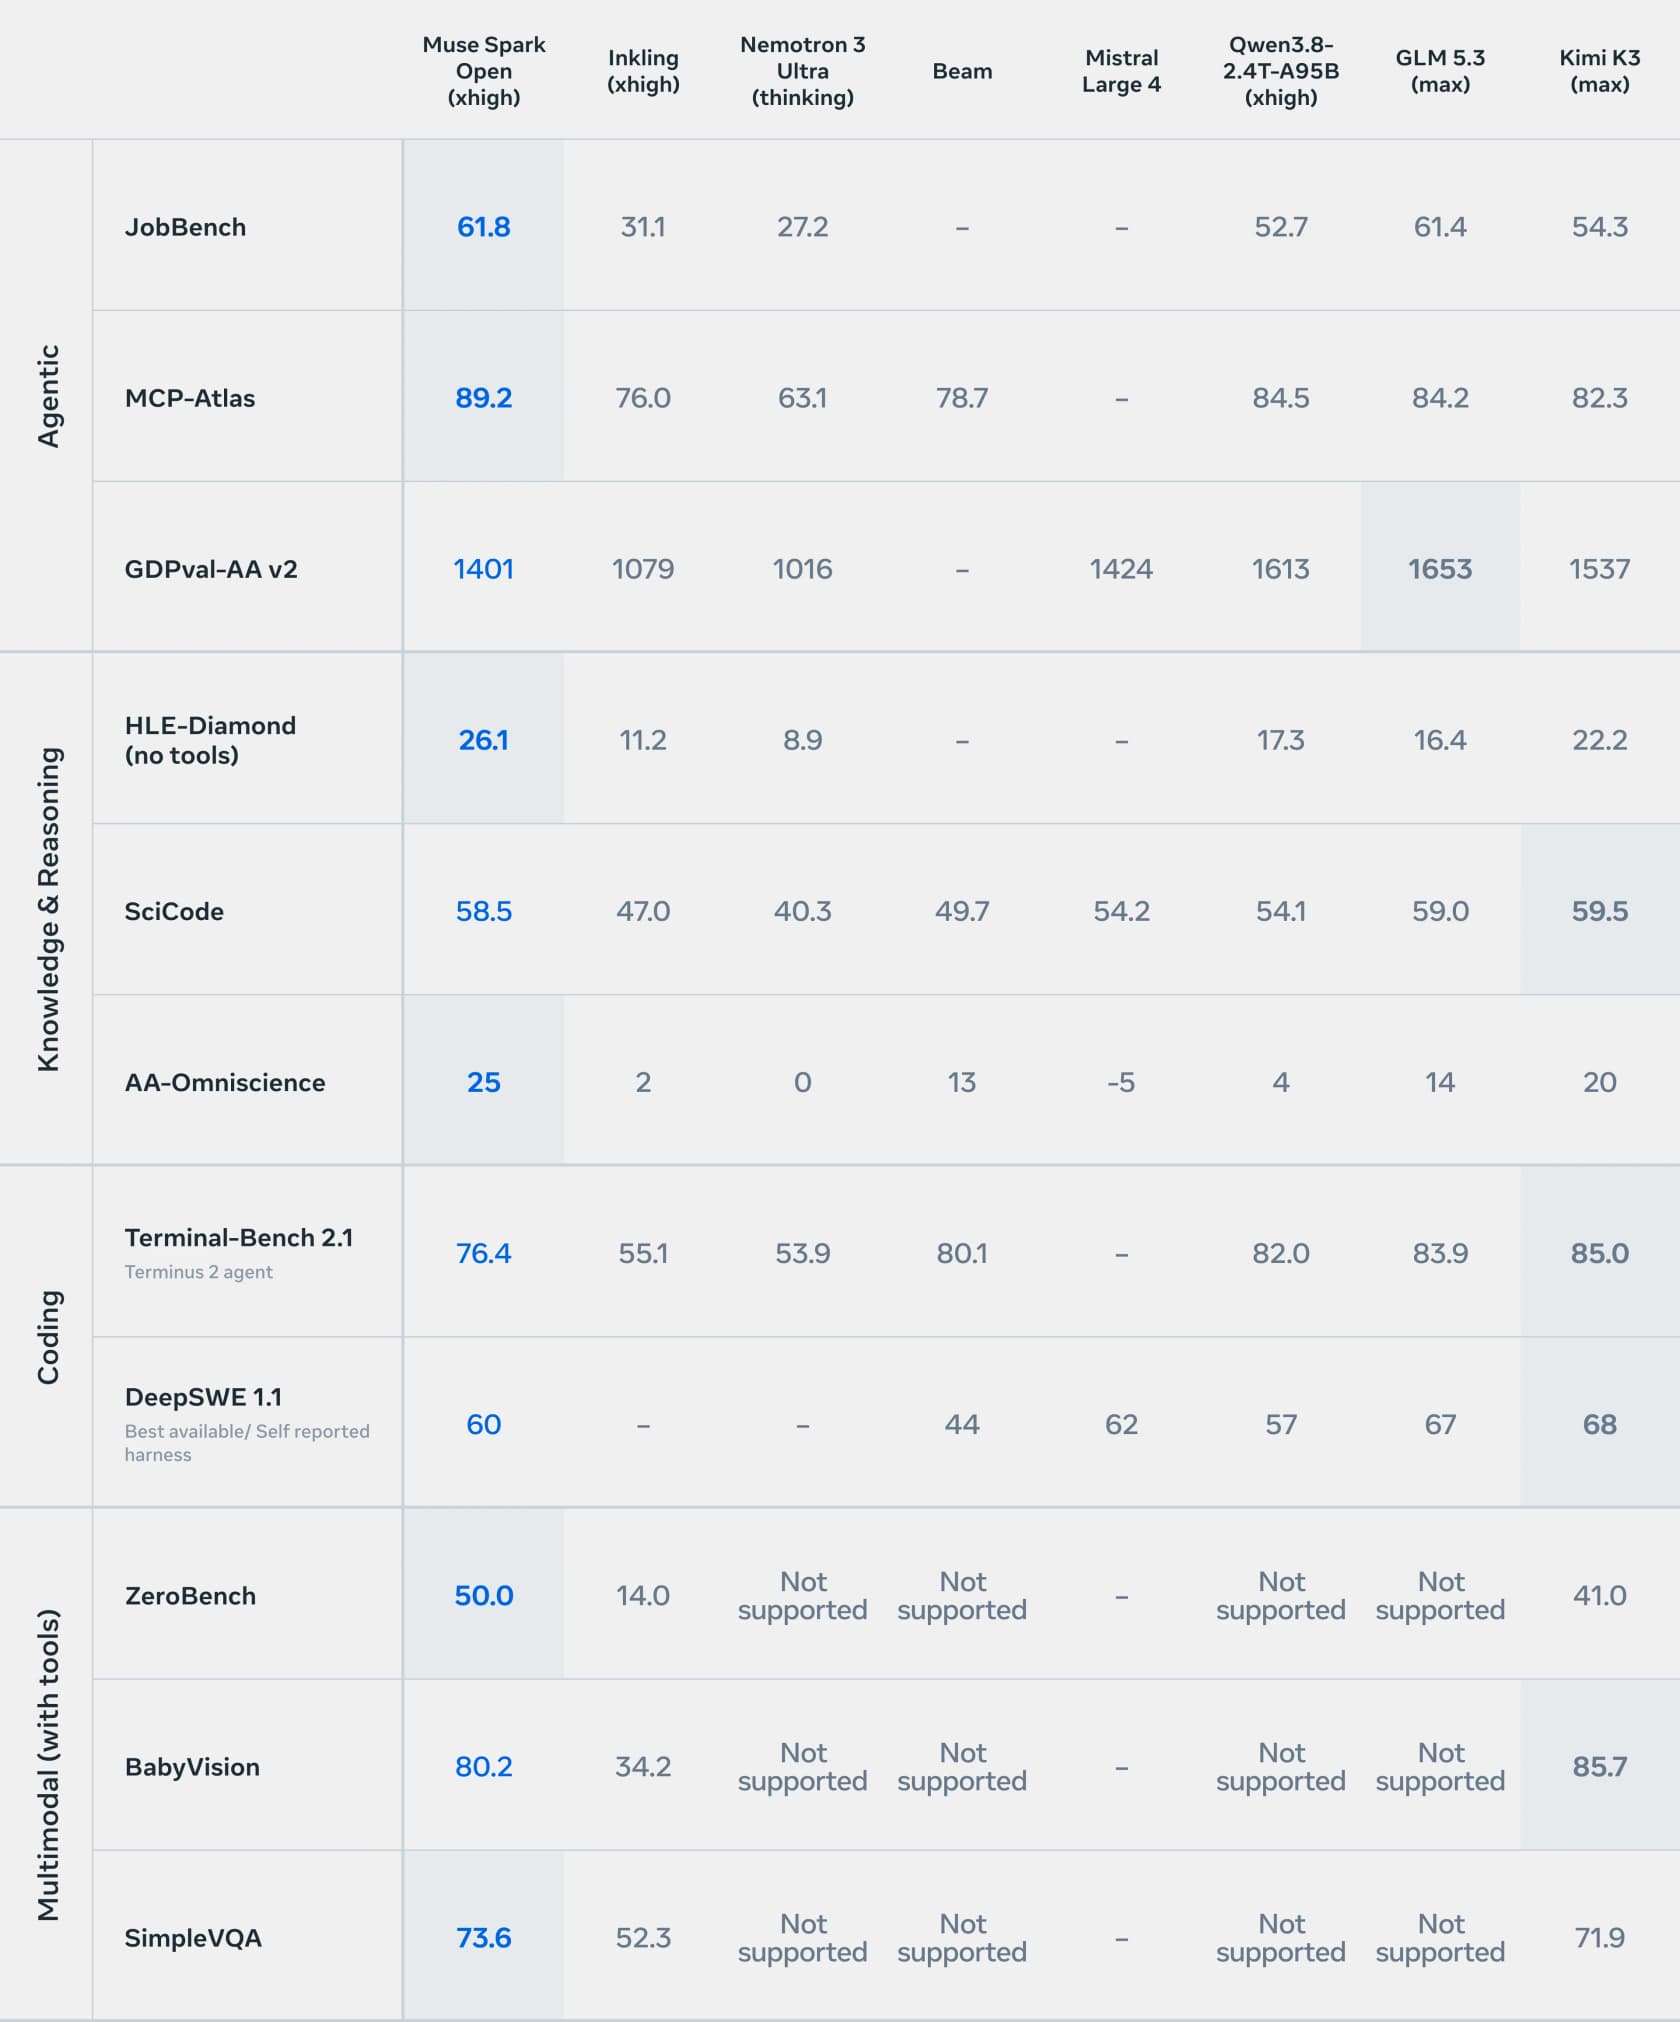
Yo construyo integraciones y APIs en eesel, así que lo primero que hago con cualquier modelo nuevo es leer la licencia y la tarifa antes que el gráfico de benchmarks. Muse Spark Open tiene fortalezas reales ahí. Lidera a sus pares en la ficha del modelo de Meta en MCP-Atlas (89,2), JobBench (61,8) y HLE-Diamond (26,1), y marca 0,5 en StrongREJECT, donde todos los demás modelos de la tabla están entre 62,9 y 86,4. Para un agente que llama herramientas todo el día y tiene que rechazar peticiones malas, esa es una ventaja significativa.
Pero cuatro cosas aparecen una y otra vez cuando la gente decide buscar otra opción:
- La puntuación. La tabla de Meta pone a Muse Spark Open en 39 en el Artificial Analysis Intelligence Index, por detrás de GLM 5.3 (45), Kimi K3 (44) y Qwen3.8 (40). También se queda atrás en código: 60 en DeepSWE frente a 68 de Kimi K3.
- La licencia. La Muse Model License exige que "prominently display 'Built with Muse Spark Open'" en cada producto que lo use, sin importar el tamaño. Las empresas que alojan modelos y superan los 20 millones de dólares de ingresos también necesitan un acuerdo aparte con Meta.
- El precio. Todos los proveedores en OpenRouter cobran 1,25 $ de entrada y 4,25 $ de salida por millón de tokens, la misma tarifa que el Muse Spark 1.3 cerrado. Los pesos abiertos suelen bajar los precios alojados. Estos no lo hicieron.
- Rechazos excesivos. En FORTRESS, la puntuación de rechazo excesivo de Muse Spark Open es 17,4, frente a 2,7 de Kimi K3 y 3,2 de GLM 5.3. El entrenamiento de seguridad que lo hace difícil de vulnerar también lo hace decir que no a más peticiones inofensivas.
El hilo de lanzamiento en Hacker News llegó a los mismos dos puntos:
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model. I know we've seen this before with other large models, but it's still a bit irritating. The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

"Well, this is much better than nothing -- we should be grateful that whatever the market conditions and corporate incentives, a major lab is releasing a capable open-weight model. But still very far behind DeepSeek and GLM. Even on consumer hardware, Qwen 3.8 27B is going to compare favorably to this."
Cómo elegí estas alternativas
Antes de escribir esto, le pregunté a ChatGPT con qué debería comparar un desarrollador a Muse Spark Open, y registré las búsquedas que hizo. Fue directo a "best open-weight language models 2026 Qwen DeepSeek Kimi GLM" y volvió con seis nombres: GLM 5.3, Kimi K3, Qwen3.8, DeepSeek V4, Mistral Large 4 y gpt-oss-120b. Me quedé con los seis y añadí los otros dos modelos abiertos de la tabla comparativa de Meta, Nemotron 3 Ultra e Inkling.
Cada alternativa tenía que cumplir tres reglas:
- Los pesos se pueden descargar hoy, o el proveedor tiene una promesa pública con fecha (solo Mistral Large 4 entra en esa categoría, y lo señalo).
- Los precios vienen de la página del propio proveedor, o de la página de precios de un proveedor de alojamiento con nombre cuando el laboratorio no vende el modelo directamente.
- Las puntuaciones vienen de un solo lugar siempre que es posible. Uso la tabla comparativa de Meta, porque pasó todos los modelos por el mismo banco de pruebas, y aviso cuando una cifra viene de otra parte.
Comparé cada uno con las mismas cuatro preguntas: en qué le gana a Muse Spark Open, dónde se queda corto, cuánto cuesta y qué te pide la licencia.
Alternativas a Muse Spark Open de un vistazo
| Modelo | Creador | Parámetros totales / activos | Contexto | Tipos de entrada | Licencia | Condiciones | Puntuación en la tabla de Meta | Precio alojado, entrada / salida por 1M | Mínimo para autoalojar | Se puede desactivar el razonamiento |
|---|---|---|---|---|---|---|---|---|---|---|
| Muse Spark Open (referencia) | Meta | 816B / 42B | 1M | Texto, imagen, audio, video | Muse Model License | Etiqueta "Built with" en cada producto; acuerdo para quienes alojan modelos con más de 20M de ingresos | 39 | $1.25 / $4.25 | 2 Mac Studio (M5 Ultra) | No |
| GLM 5.3 | Z.ai | 744B / 40B | 1M | Solo texto | GLM-5.3 License (estilo MIT) | Revisión de seguridad solo para quienes alojan modelos con más de 10.000M de ingresos | 45 | $1.40 / $4.40 | No indicado | No |
| Kimi K3 | Moonshot AI | 2.8T / 104B | 1M | Texto, imagen, video | Kimi K3 License (estilo MIT) | Mostrar "Kimi K3" a partir de 100M de usuarios o 20M$/mes; acuerdo para quienes alojan modelos con más de 20M | 44 | $3.00 / $15.00 | No indicado (2.8T parámetros) | No |
| Qwen3.8 2.4T | Alibaba | 2.4T / 95B | 262K nativo, hasta 1M | Solo texto (base abierta) | Qwen3.8 License | Mostrar el nombre a partir de 100M de usuarios o 20M$/mes; licencia para quienes alojan modelos con más de 50M | 40 | $2.00 / $6.00 (Qwen3.8 Max) | No indicado | No (base abierta) |
| DeepSeek V4.1 Flash | DeepSeek | 552B (8B / 16B activos) | 1M | Texto, imagen | MIT | Conservar el aviso de copyright | No está en la tabla | $0.15 / $0.60 en horario valle | No indicado | Sí |
| gpt-oss-120b | OpenAI | 117B / 5.1B | 128K | Solo texto | Apache 2.0 | Avisos al redistribuir | No está en la tabla | $0.15 / $0.60 (Together) | 1 GPU de 80GB | No (bajo / medio / alto) |
| Mistral Large 4 | Mistral AI | 1.05T / 52B | 1M | Texto, imagen | Aún sin nombre | Pesos previstos para finales de octubre | 38 | $0.68 / $2.09 (oferta) | No indicado | Modelo híbrido |
| Nemotron 3 Ultra | NVIDIA | 550B / 55B | Hasta 1M (262K en la configuración) | Solo texto | OpenMDW-1.1 | Avisos al redistribuir | 23 | $0.50 / $2.20 (DeepInfra) | 8 x H200 | Sí |
| Inkling | Thinking Machines Lab | 975B / 41B | 1M | Texto, imagen, audio | Apache 2.0 + política de uso | Política de uso (aviso de IA) | 26 | $1.00 / $4.05 | 600GB+ (NVFP4) | Control de esfuerzo |
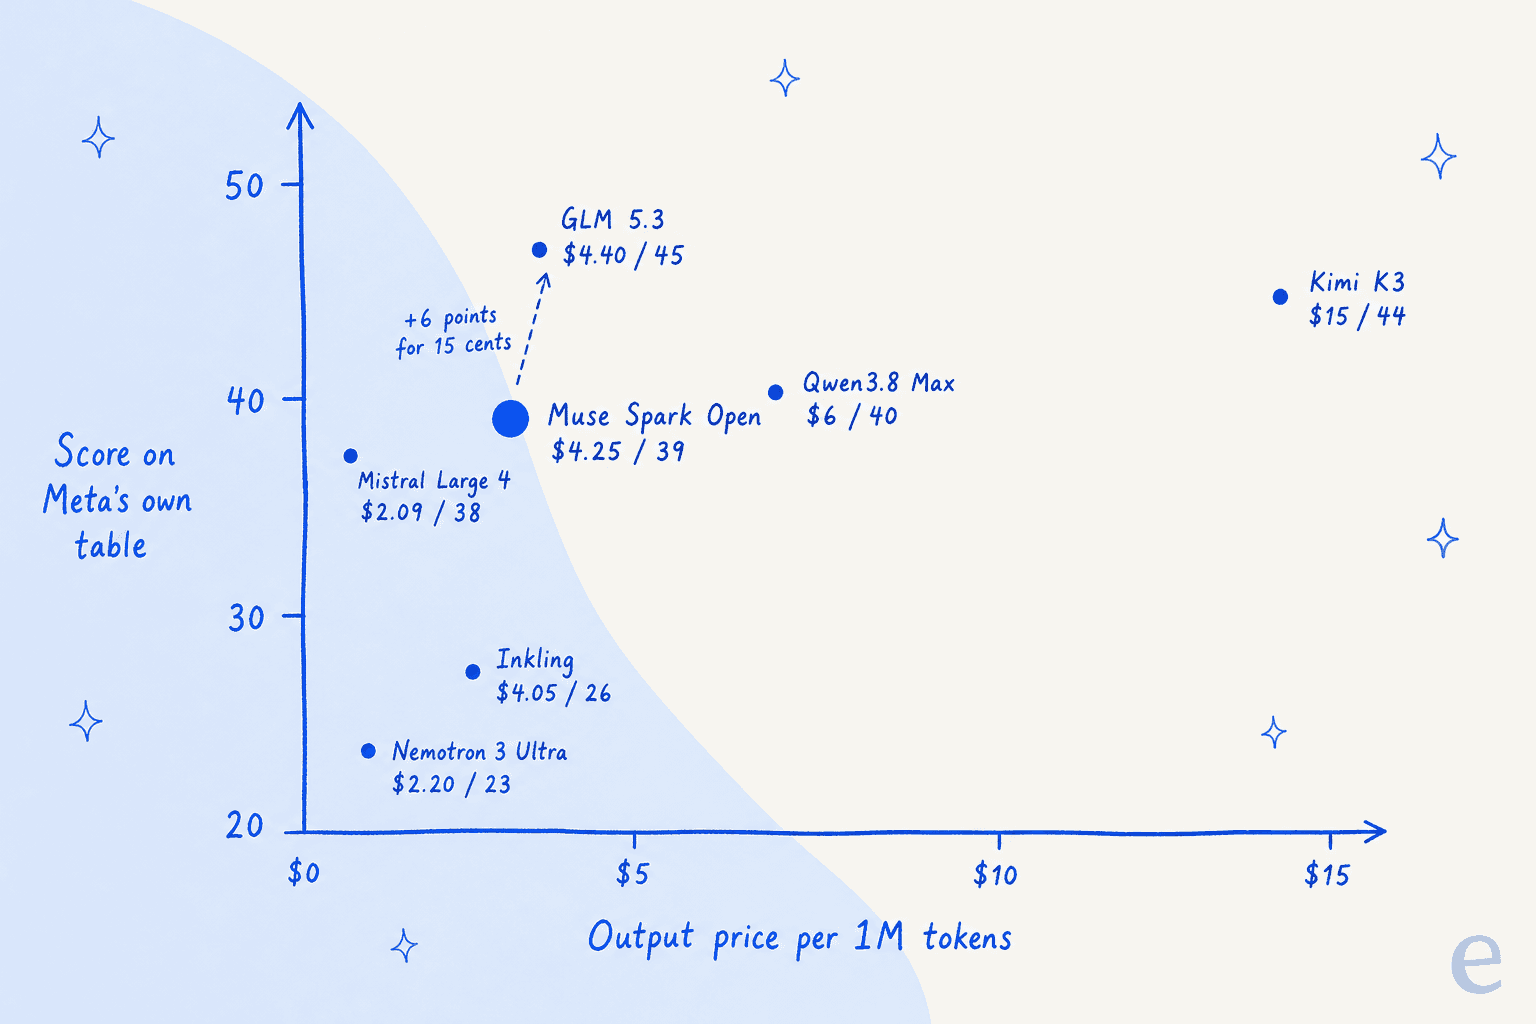
El gráfico es todo el argumento en una imagen. Muse Spark Open está en la mitad del grupo en precio y puntuación. GLM 5.3 está casi justo encima. Kimi K3 compra unos puntos con una factura mucho mayor, y Mistral Large 4 es más barato por una puntuación parecida, pero por ahora solo en una API de vista previa.
¿Qué alternativa encaja con tu motivo para irte?
La mayoría de la gente no deja Muse Spark Open por "un modelo mejor" en general. Se va por una razón concreta. Elige la tuya y abajo aparece la opción correspondiente.
Elige el motivo que te aleja de Muse Spark Open para ver la alternativa que probaría primero. Todas las cifras provienen de las páginas de los proveedores y de la tabla de Meta citadas abajo.
1. GLM 5.3
Ideal para: equipos que quieren una mejora directa sobre Muse Spark Open casi al mismo precio, con una licencia más ligera.
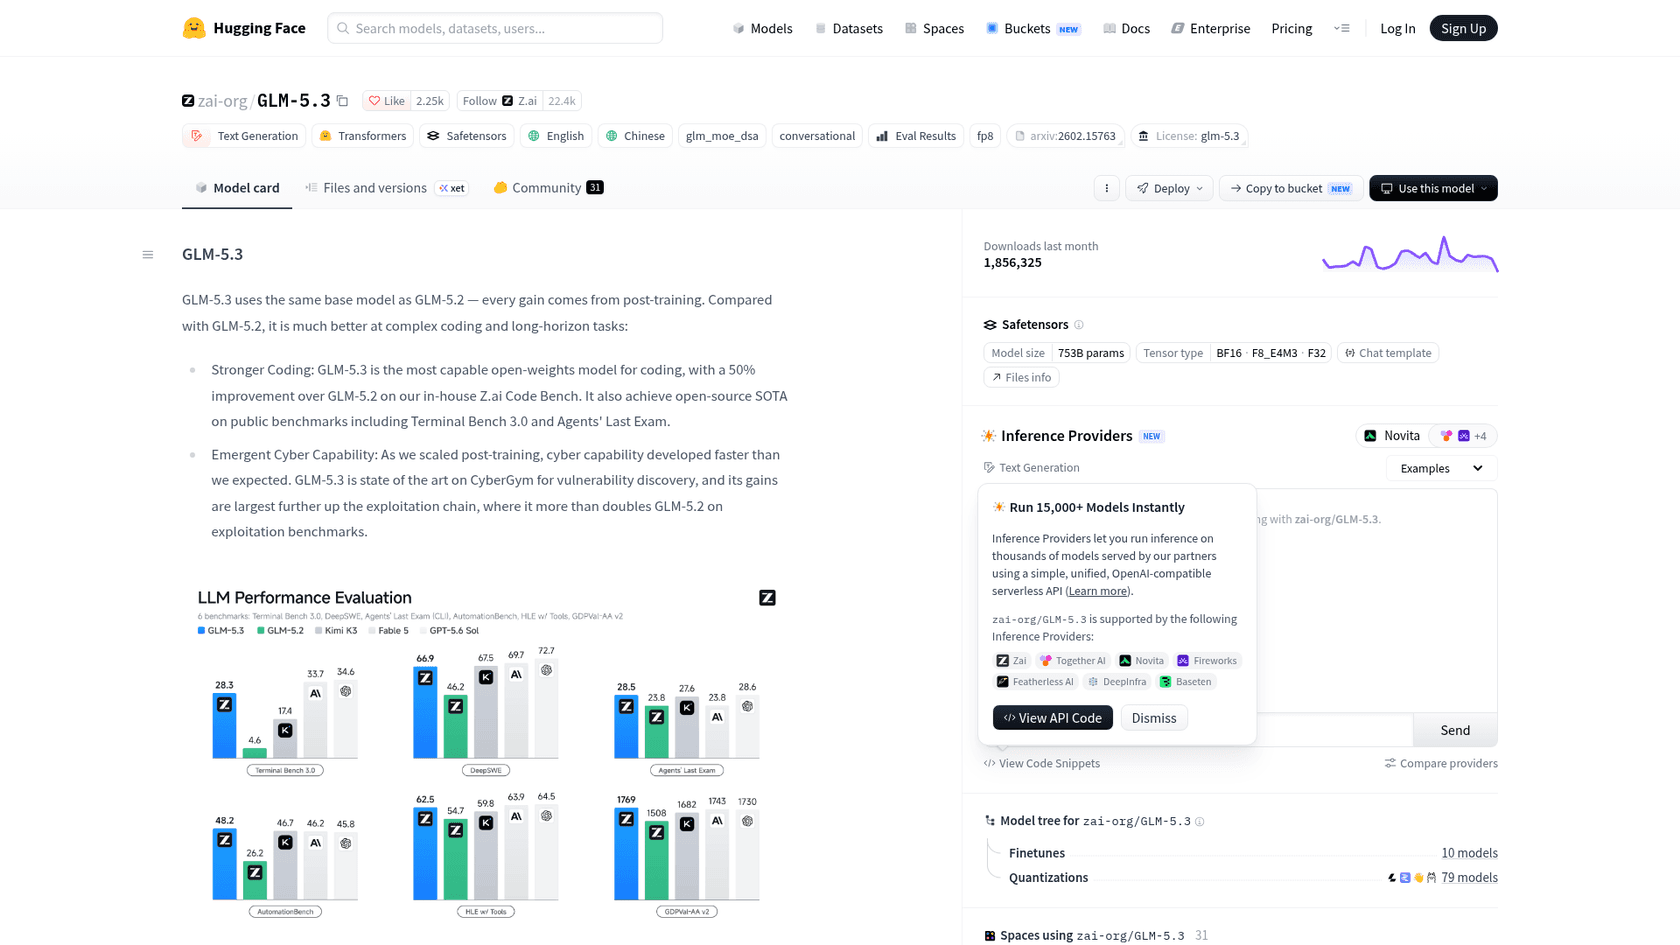
GLM 5.3 es el modelo estrella de Z.ai, lanzado el 14 de agosto de 2026. Es una mezcla de expertos de 744B parámetros con 40B activos, según la tabla de descarga de GLM-5 de Z.ai, con un contexto de 1M de tokens y hasta 128K tokens de salida. Es el mismo modelo base que GLM-5.2, y la ficha del modelo dice "every gain comes from post-training." No lo confundas con el más pequeño GLM 5.3 Flash, que es una base distinta de 320B.
En qué le gana a Muse Spark Open. En la propia tabla de Meta, GLM 5.3 tiene la puntuación más alta del Intelligence Index de cualquier modelo abierto (45 vs 39), la mejor puntuación en GDPVal-AA v2 (1653 vs 1401) y lidera en HLE con herramientas (62,5 vs 61,0), DeepSWE (67 vs 60) y Terminal-Bench 2.1 (83,9 vs 76,4). También rechaza muchas menos peticiones inofensivas (rechazo excesivo en FORTRESS 3,2 vs 17,4).
Dónde se queda corto. Es solo texto, así que no hay entrada de imagen, audio ni video. El razonamiento no se puede desactivar; los documentos de Z.ai dicen "disabling reasoning is no longer supported", y los niveles de esfuerzo son bajo, alto y máximo. Pierde frente a Muse Spark Open en MCP-Atlas (84,2 vs 89,2) y es mucho más fácil de vulnerar (StrongREJECT 62,9 vs 0,5).
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."
Precio y licencia. La página de precios de Z.ai lista GLM 5.3 a $1.40 por millón de tokens de entrada, $0.26 en caché y $4.40 de salida, sin cambios desde el lanzamiento. Son 15 centavos más que Muse Spark Open tanto en entrada como en salida. La GLM-5.3 License es de estilo MIT con una condición: una empresa que aloja modelos y cuyos ingresos de grupo superen los 10.000 millones de dólares debe pasar la revisión de seguridad de Z.ai. Los productos que incorporan el modelo como una función quedan excluidos de esa definición, y no hay regla de mostrar etiqueta.
| Plan | Entrada por 1M | Entrada en caché por 1M | Salida por 1M |
|---|---|---|---|
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 FlashX | $0.37 | $0.075 | $1.25 |
| GLM 5.3 Flash | $0.15 | $0.03 | $0.50 |
Veredicto: Esta es la alternativa que probaría primero. Si no necesitas entrada multimodal, GLM 5.3 te da una puntuación más alta, menos rechazos y una licencia más laxa por 15 centavos más por millón de tokens. Descártala solo si las imágenes, el audio o la precisión al llamar herramientas son el núcleo de tu carga de trabajo.
2. Kimi K3
Ideal para: agentes de código y trabajo multimodal donde la calidad importa más que la factura de tokens.
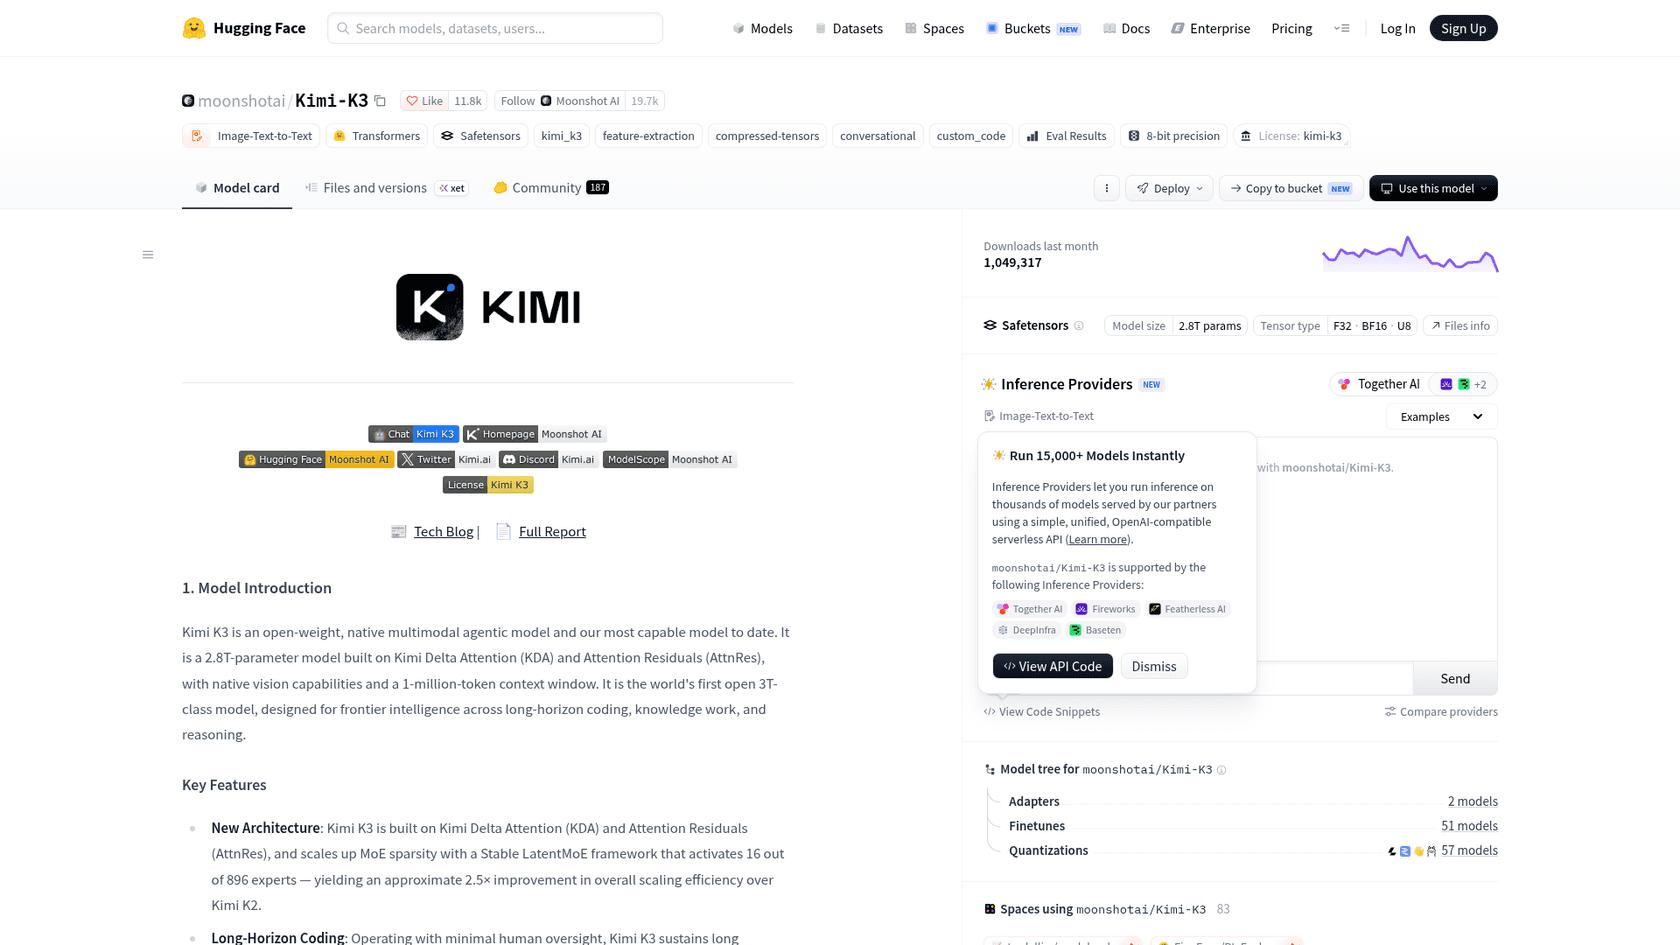
Kimi K3 es el modelo estrella de Moonshot AI, lanzado en julio de 2026 con pesos en Hugging Face. Es el modelo más grande de la lista: 2.8T parámetros totales, 104B activos, 896 expertos con 16 elegidos por token. Lee texto, imágenes y video de forma nativa y tiene 1M de tokens de contexto, con salida configurable hasta 1.048.576 tokens según la guía rápida de K3.
En qué le gana a Muse Spark Open. Kimi K3 es el líder en código de la tabla de Meta: DeepSWE 68 vs 60, SWE-Atlas-QnA 66 vs 58, Terminal-Bench 2.1 85,0 vs 76,4. También gana en OSWorld Verified (84,8 vs 80,4), Toolathlon (76,5 vs 72,8) y en el benchmark de video VideoMMEv2 (65,4 vs 61,5). Tiene la puntuación de rechazo excesivo más baja del conjunto, 2,7.
Dónde se queda corto. Muse Spark Open le gana en MCP-Atlas (89,2 vs 82,3), JobBench (61,8 vs 54,3) y seguridad. La ficha de Meta indica que Kimi K3 rechazó solo el 75,5% de los jailbreaks en el benchmark interno de ciberseguridad de Meta, frente al 99,2% de Muse Spark Open. El razonamiento no se puede desactivar, y la API no acepta URLs públicas de imágenes, solo base64 o IDs de archivos subidos.
Precio y licencia. La página de precios de Moonshot lista $3.00 por millón de tokens de entrada, $0.30 en caché y $15.00 de salida, tarifa plana en todo el contexto de 1M. Un detalle nuevo: las escrituras en caché ahora se facturan aparte, a $3.00 por millón para una caché de 5 minutos y $6.00 para una de 1 hora. La Kimi K3 License se parece a la de Muse Spark Open en el alojamiento (un acuerdo aparte para empresas que alojan modelos y superan los 20 millones de dólares al año), pero su regla de mostrar el nombre solo se activa por encima de 100 millones de usuarios mensuales o 20 millones de dólares de ingresos mensuales.
"I believe it's because they are below $20 Million revenue limit (which Kimi K3's license has) So we won't see any price decrease unless Kimi changes the license of K3"
Veredicto: Kimi K3 es la opción cuando las puntuaciones de código deciden el proyecto. Cuesta 3,5 veces el precio de salida de Muse Spark Open, así que solo lo usaría para los trabajos que lo necesiten y enrutaría todo lo demás a algo más barato. Mi desglose de precios de Kimi K3 tiene las cuentas.
3. Qwen3.8
Ideal para: equipos que quieren una sola familia de modelos que escale desde un único Mac hasta un modelo estrella alojado.
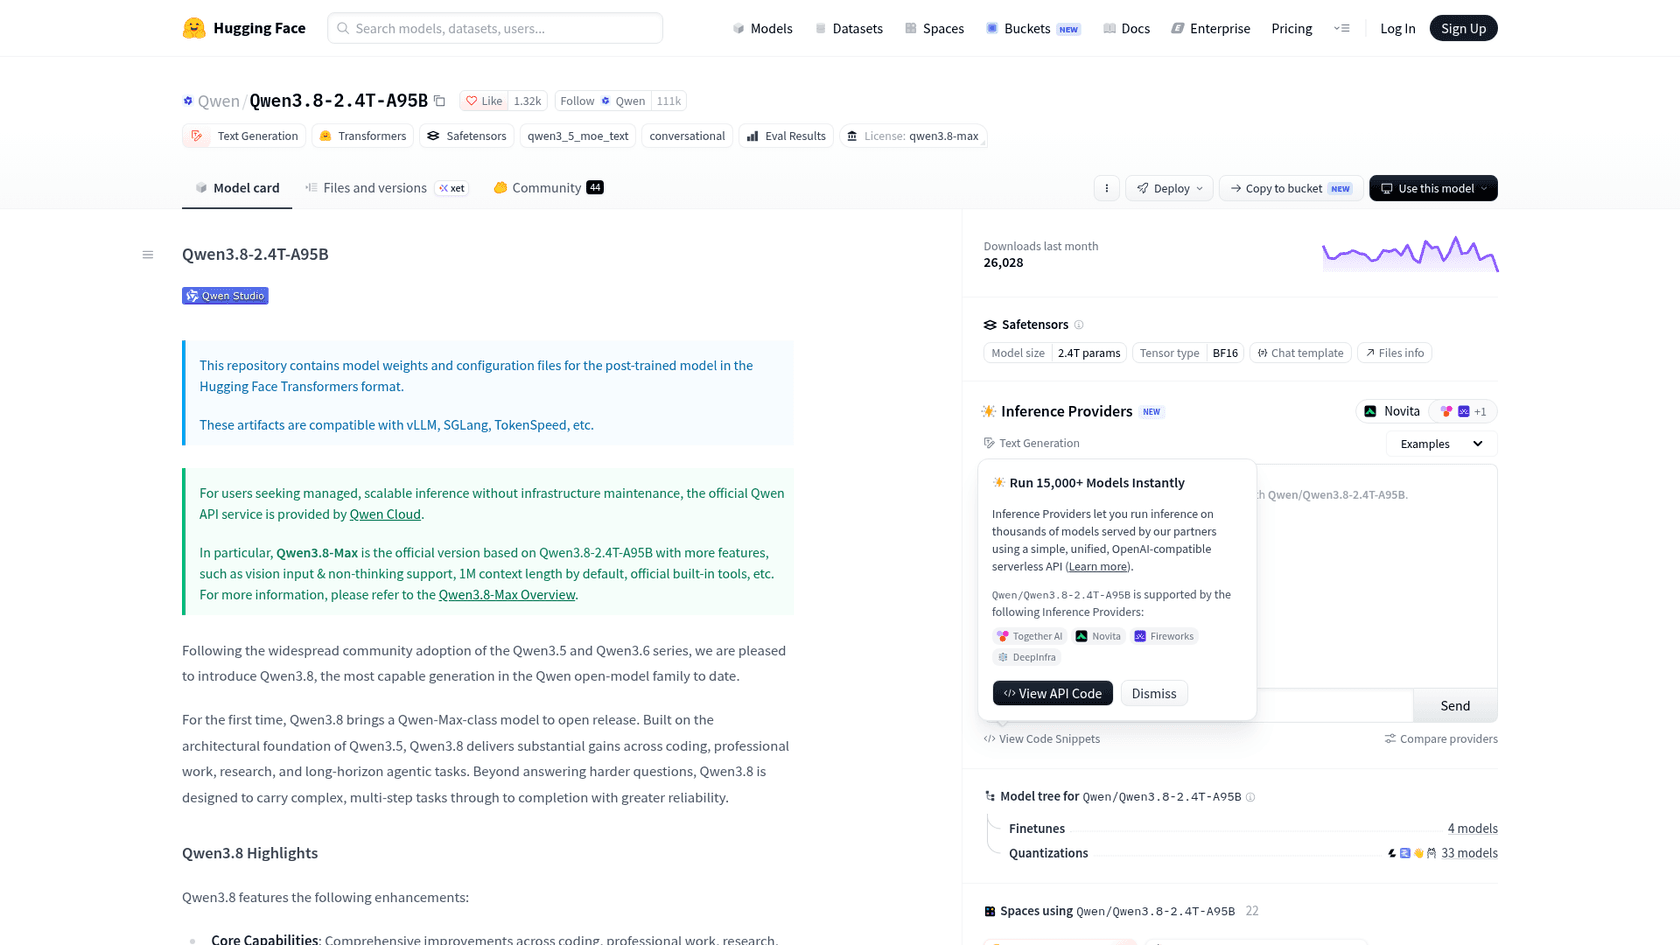
Qwen3.8 son en realidad dos lanzamientos abiertos. El grande, Qwen3.8-2.4T-A95B, es una mezcla de expertos de 2.4T parámetros con 95B activos. Su contexto es de 262.144 tokens de forma nativa, ampliable a cerca de 1M. El pequeño, Qwen3.8-27B, es un modelo denso de 27B que lee imágenes y video y te deja desactivar el razonamiento en cada petición. El Qwen3.8 Max alojado está construido sobre la base grande, con visión, un modo sin razonamiento y herramientas integradas añadidas.
En qué le gana a Muse Spark Open. En la tabla de Meta, la base abierta de 2.4T puntúa 40 en el Intelligence Index (un punto por delante), empata con Kimi K3 en la mejor puntuación de GPQA Diamond (93,5 vs 89,0) y le gana a Muse Spark Open en Terminal-Bench 2.1 (82,0 vs 76,4), SWE-Atlas-QnA (62 vs 58) y GDPVal-AA v2 (1613 vs 1401). El de 27B es la verdadera sorpresa: los benchmarks de MLX de Apple muestran que cabe en un Mac Studio usando hasta 68GB de memoria con un contexto de 65.536 tokens.
Dónde se queda corto. La base abierta de 2.4T es más limitada de lo que la gente espera. La ficha del modelo dice que "is a text-only model that requires thinking mode for all interactions", así que las funciones de visión y de modo sin razonamiento pertenecen solo al Max alojado. Se queda por detrás de Muse Spark Open en MCP-Atlas (84,5 vs 89,2), JobBench (52,7 vs 61,8) y HLE-Diamond (17,3 vs 26,1).
"From running small models like Qwen3.8-27B to large models like Qwen3.8-2.4T. I can tell you that small models will never be enough or match up. Everyone will want the smartest model, not just a good enough model."
Precio y licencia. Alibaba no vende directamente la base abierta. La vía alojada es Qwen3.8 Max en QwenCloud a $2 de entrada y $6 de salida por millón de tokens, con aciertos de caché implícita a $0.25. El de 27B ahora tiene su propia página alojada a $0.50 de entrada y $3 de salida. La base de 2.4T se distribuye bajo la Qwen3.8 License, con una regla de mostrar el nombre por encima de 100 millones de usuarios mensuales o 20 millones de dólares de ingresos mensuales, y una licencia aparte para empresas de alojamiento de modelos o de asistentes de trabajo con IA que superen los 50 millones. El de 27B es Apache 2.0 sin más.
| Modelo | Entrada por 1M | Entrada en caché por 1M | Salida por 1M | Licencia |
|---|---|---|---|---|
| Qwen3.8 Max (alojado) | $2.00 | $0.25 (implícita) | $6.00 | Solo alojado |
| Qwen3.8-27B (alojado) | $0.50 | $0.10 (implícita) | $3.00 | Apache 2.0 |
| Qwen3.8-2.4T-A95B | Autoalojado o de terceros | n/d | n/d | Qwen3.8 License |
Veredicto: Qwen3.8 es la opción de familia. Usa el de 27B donde habrías usado un modelo Muse pequeño en un portátil o un solo Mac, y el Max alojado cuando necesites el grande. Si quieres el de 2.4T por sus pesos abiertos, recuerda que es solo texto. Para enfrentamientos directos, mira Qwen3.8 Max vs Kimi K3.
4. DeepSeek V4.1 Flash
Ideal para: cargas de trabajo de alto volumen donde el costo de los tokens lo decide todo.
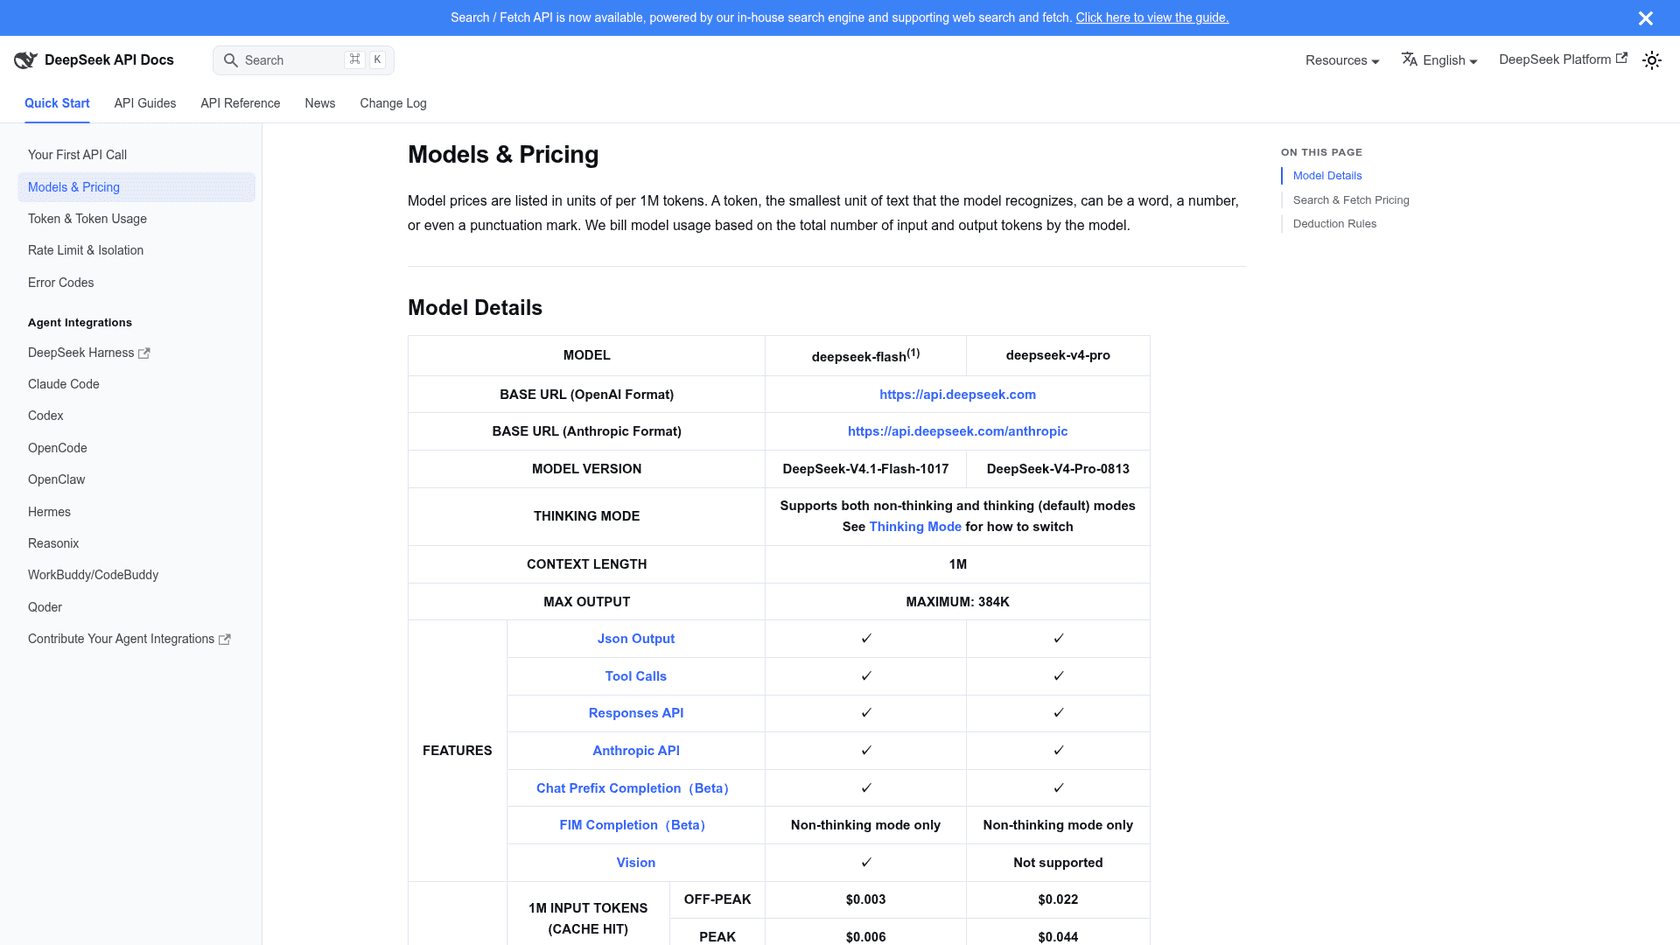
DeepSeek V4.1 Flash se lanzó el 10 de septiembre de 2026 y recibió una actualización el 17 de octubre: DeepSeek-V4.1-Flash-1017, que DeepSeek describe con "stronger benchmark performance, faster task completion, and shorter outputs than the previous version." Es una mezcla de expertos de 552B parámetros con un reparto poco habitual: 8B parámetros activos para leer la entrada y 16B para escribir la salida, según las notas de lanzamiento. Tiene 1M de contexto, hasta 384K tokens de salida y entrada de visión.
En qué le gana a Muse Spark Open. En precio, por mucho. Y en la propia ficha de DeepSeek para la versión 1017, DeepSWE v1.1 sube a 77,0, lo que superaría a todos los modelos de la tabla de Meta, aunque es una cifra del proveedor con un banco de pruebas distinto. DeepSeek no está en la comparación de Meta. Un comentarista del hilo de lanzamiento de Muse Spark Open señaló que Artificial Analysis pone a la versión anterior de V4.1 Flash con la misma puntuación que Muse Spark Open:
"Crucially, it's about the same as DeepSeek v4.1 Flash, and about 10x more expensive to run...
No thanks..."
Dónde se queda corto. Los tokens de razonamiento se facturan como salida, y el razonamiento viene activado por defecto, así que una tarifa barata aún puede convertirse en una factura grande con respuestas largas. Los términos de la API de pago no dicen nada sobre si DeepSeek entrena con tus entradas, sin opción publicada de retención cero, lo cual importa si planeas enviar datos de clientes a la API del propio proveedor. Alojar tú mismo los pesos MIT o hacerlo con un proveedor externo evita esa duda.
Precio y licencia. La página de precios de DeepSeek tiene dos tarifas. La hora punta es 01:00-04:00 y 06:00-10:00 UTC entre semana; todo lo demás es horario valle a mitad de precio.
| Tarifa | Entrada con acierto de caché por 1M | Entrada sin acierto de caché por 1M | Salida por 1M |
|---|---|---|---|
| Horario valle | $0.003 | $0.15 | $0.60 |
| Hora punta | $0.006 | $0.30 | $1.20 |
Los pesos son MIT: conserva el aviso de copyright y listo. Sin umbrales de ingresos, sin regla de mostrar etiqueta.
"I've been using DS v4.1 Flash daily for nearly a month now on Agent Swarm experiments. I've tested it against GLM-5.3-flash and Opus 5.5. DS 4.1 comes out tops for me. Opus 5.5 is still the smartest, but DS 4.1's speed and price more than make up for the "intelligence" gap."
Veredicto: Si ibas a llamar a Muse Spark Open millones de veces al día, ejecuta primero el mismo conjunto de pruebas en DeepSeek V4.1 Flash. A $0.60 por millón de tokens de salida en horario valle, es unas 7 veces más barato bajo la licencia más permisiva de esta lista. Mira precios de DeepSeek V4.1 Flash para las cuentas de la hora punta.
5. gpt-oss-120b
Ideal para: equipos que necesitan autoalojar en una sola GPU, y cualquiera que quiera una referencia barata contra la que probar modelos más grandes.
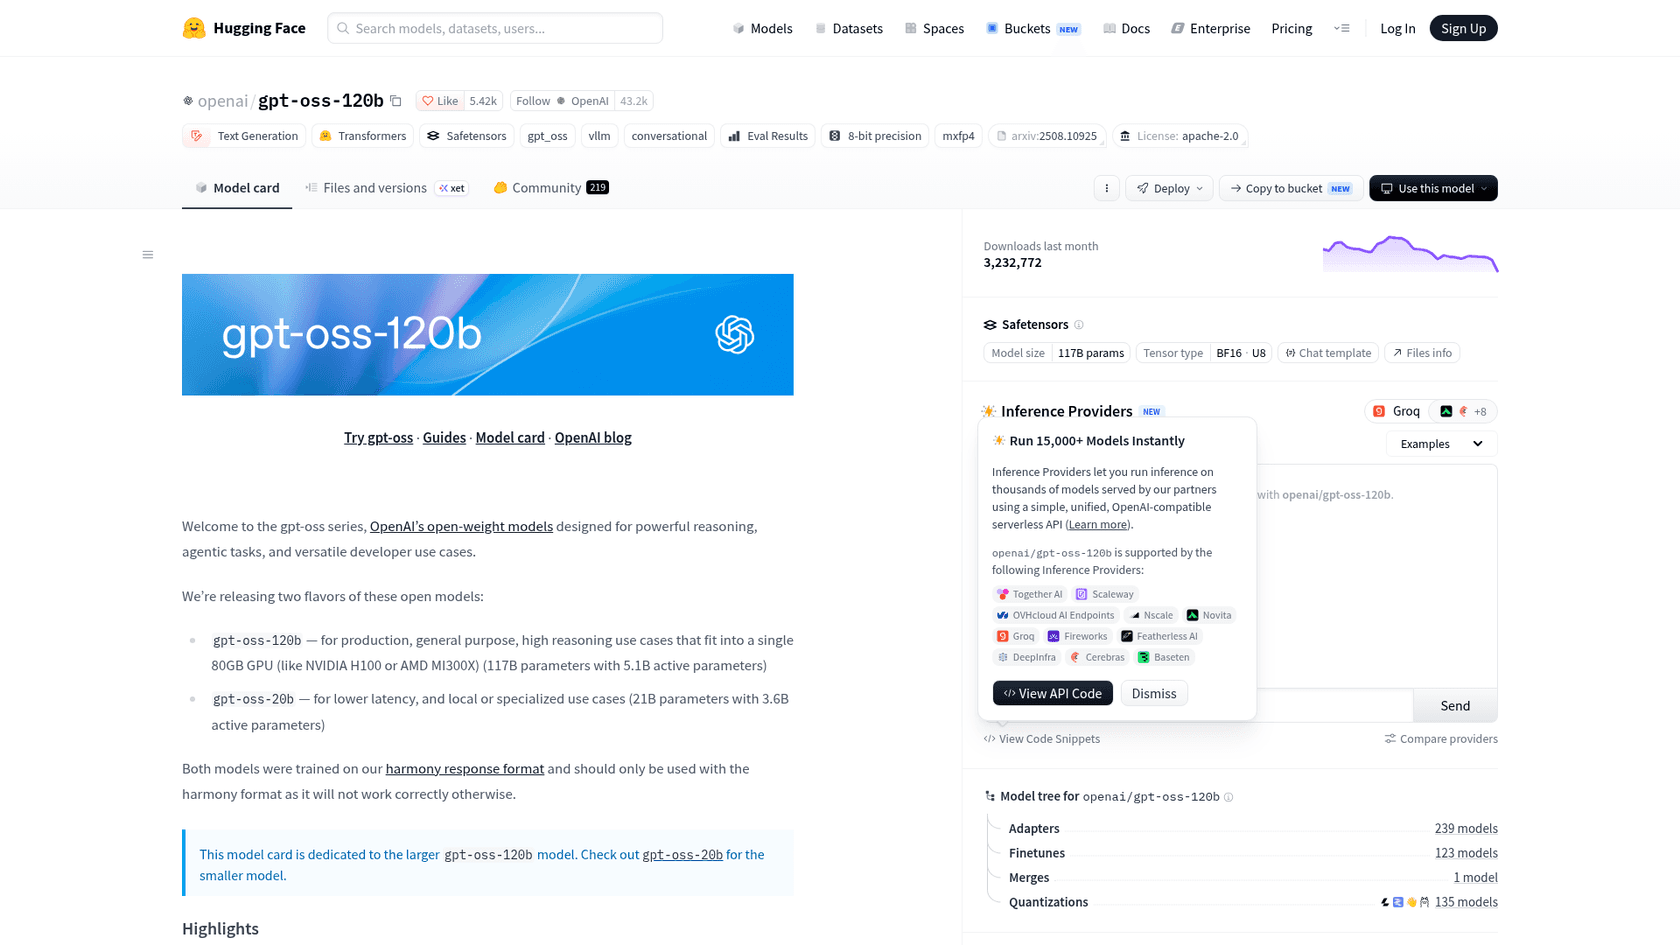
gpt-oss-120b es el modelo de pesos abiertos de OpenAI de agosto de 2025. Tiene 117B parámetros totales con solo 5,1B activos por token, cuantizado para funcionar "on a single 80GB GPU (like NVIDIA H100 or AMD MI300X)", según la ficha del modelo. Es solo texto, con 128K de contexto y tres niveles de razonamiento (bajo, medio, alto) que se definen en el prompt del sistema.
En qué le gana a Muse Spark Open. En hardware y costo. Muse Spark Open necesita dos Mac Studio con hasta 512GB de memoria cada uno, según Apple; gpt-oss-120b necesita una tarjeta. Eso lo convierte en la única alternativa de aquí que un equipo pequeño puede ejecutar de forma realista en su propio servidor o en una cuenta de nube privada.
Dónde se queda corto. Tiene 14 meses, y OpenAI no ha lanzado un modelo gpt-oss más nuevo desde entonces; los lanzamientos posteriores son clasificadores de seguridad. No está en la tabla comparativa de Meta, y el contexto de 128K es la octava parte del de Muse Spark Open. Además solo funciona bien con el formato de respuesta harmony de OpenAI; la ficha dice que "will not work correctly otherwise."
"The finding that flips the usual story is the sparse-MoE reversal: on gpt-oss-120b the A100 comes in cheaper per output token than the H100, because the workload is latency-tolerant and the MXFP4 experts fit in 80GB."
Precio y licencia. OpenAI no lo vende, así que los precios alojados vienen de proveedores. La página de precios de Together AI lista $0.15 de entrada y $0.60 de salida por millón de tokens, igual que la tarifa en horario valle de DeepSeek. La licencia es Apache 2.0, y la política de uso es una línea sobre cumplir la ley.
Veredicto: gpt-oss-120b no igualará a Muse Spark Open en tareas difíciles de agentes, y no voy a fingir lo contrario. Pero es el modelo de control correcto: ejecuta tu evaluación primero con él y sabrás cuánto del tamaño extra de Muse Spark Open estás usando realmente. Proveedores como Together AI y Groq lo sirven.
6. Mistral Large 4
Ideal para: equipos europeos que quieren un modelo entrenado y alojado en la UE y pueden esperar un par de semanas por los pesos.
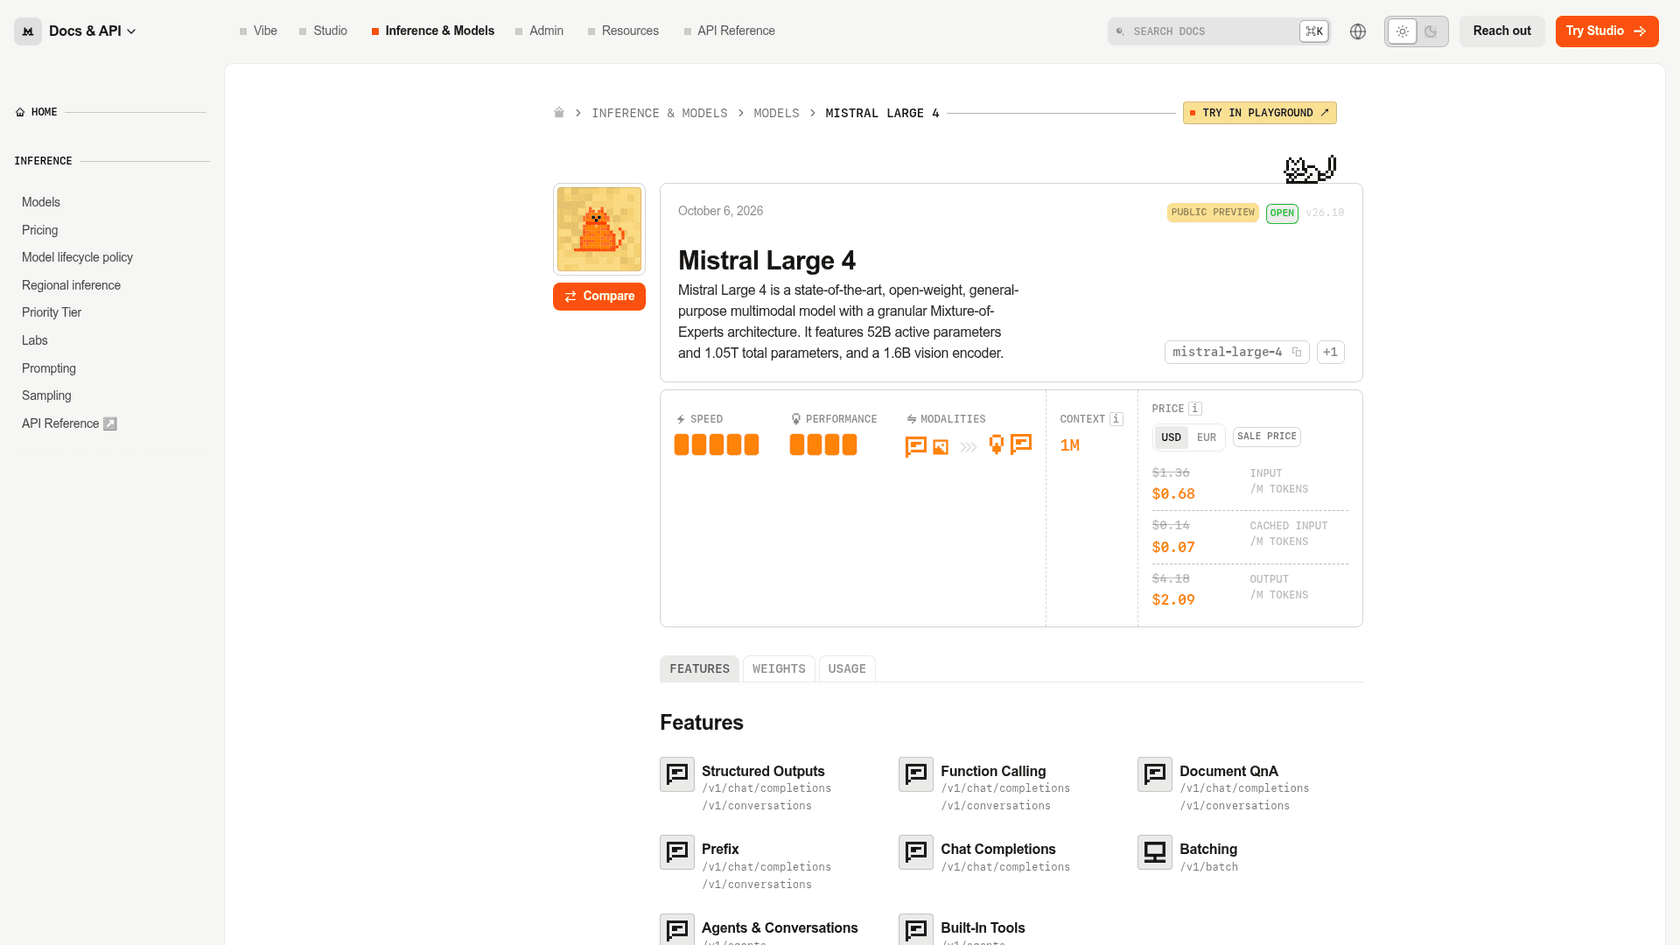
Mistral Large 4 pasó a vista previa pública el 6 de octubre de 2026. La ficha del modelo indica 1.05T parámetros totales, 52B activos y un codificador de visión de 1,6B, con 1M de contexto. Mistral lo entrenó en 3.800 GPU NVIDIA Grace Blackwell en sus propios centros de datos europeos, según la publicación de lanzamiento.
En qué le gana a Muse Spark Open. En precio y en el ángulo europeo. Puntúa 38 en la tabla de Meta, un punto por detrás de Muse Spark Open, a la mitad del precio de salida durante la oferta. También lo supera ligeramente en DeepSWE (62 vs 60), SWE-Atlas-QnA (59 vs 58) y GDPVal-AA v2 (1424 vs 1401).
Dónde se queda corto. Al 18 de octubre, los pesos no han salido. No hay un repositorio de Mistral Large 4 en Hugging Face, y la publicación de lanzamiento aún dice "we will release the weights by the end of the month." No se ha nombrado ninguna licencia, así que no daría por hecho Apache 2.0. Su puntuación de AA-Omniscience en la tabla de Meta es -5, la única negativa del conjunto, frente a 25 de Muse Spark Open.
"I created a brand new programming language to test LLM models on. It looks like Mistral Large 4 fares about as well as Kimi K3 and Claude Sonnet 5.5. Though it is much slower than Sonnet 5.5 and more expensive than both of those."
Precio y licencia. La página de precios de Mistral muestra una oferta del 50% sin fecha de fin: $0.68 de entrada, $0.07 en caché y $2.09 de salida por millón de tokens, frente a un precio de lista de $1.36, $0.14 y $4.18. La licencia no se ha anunciado.
Veredicto: Una opción razonable si el entrenamiento y el alojamiento en la UE son un requisito, y el precio de oferta supera hoy a Muse Spark Open. Pero todavía no es una alternativa de pesos abiertos. Vuelve a mirar después del 31 de octubre antes de construir un plan de autoalojamiento alrededor de ella. Mi publicación sobre precios de Mistral Large 4 sigue la oferta.
7. Nemotron 3 Ultra
Ideal para: equipos que necesitan los datos de entrenamiento y la receta, no solo los pesos, bajo una licencia estadounidense permisiva.
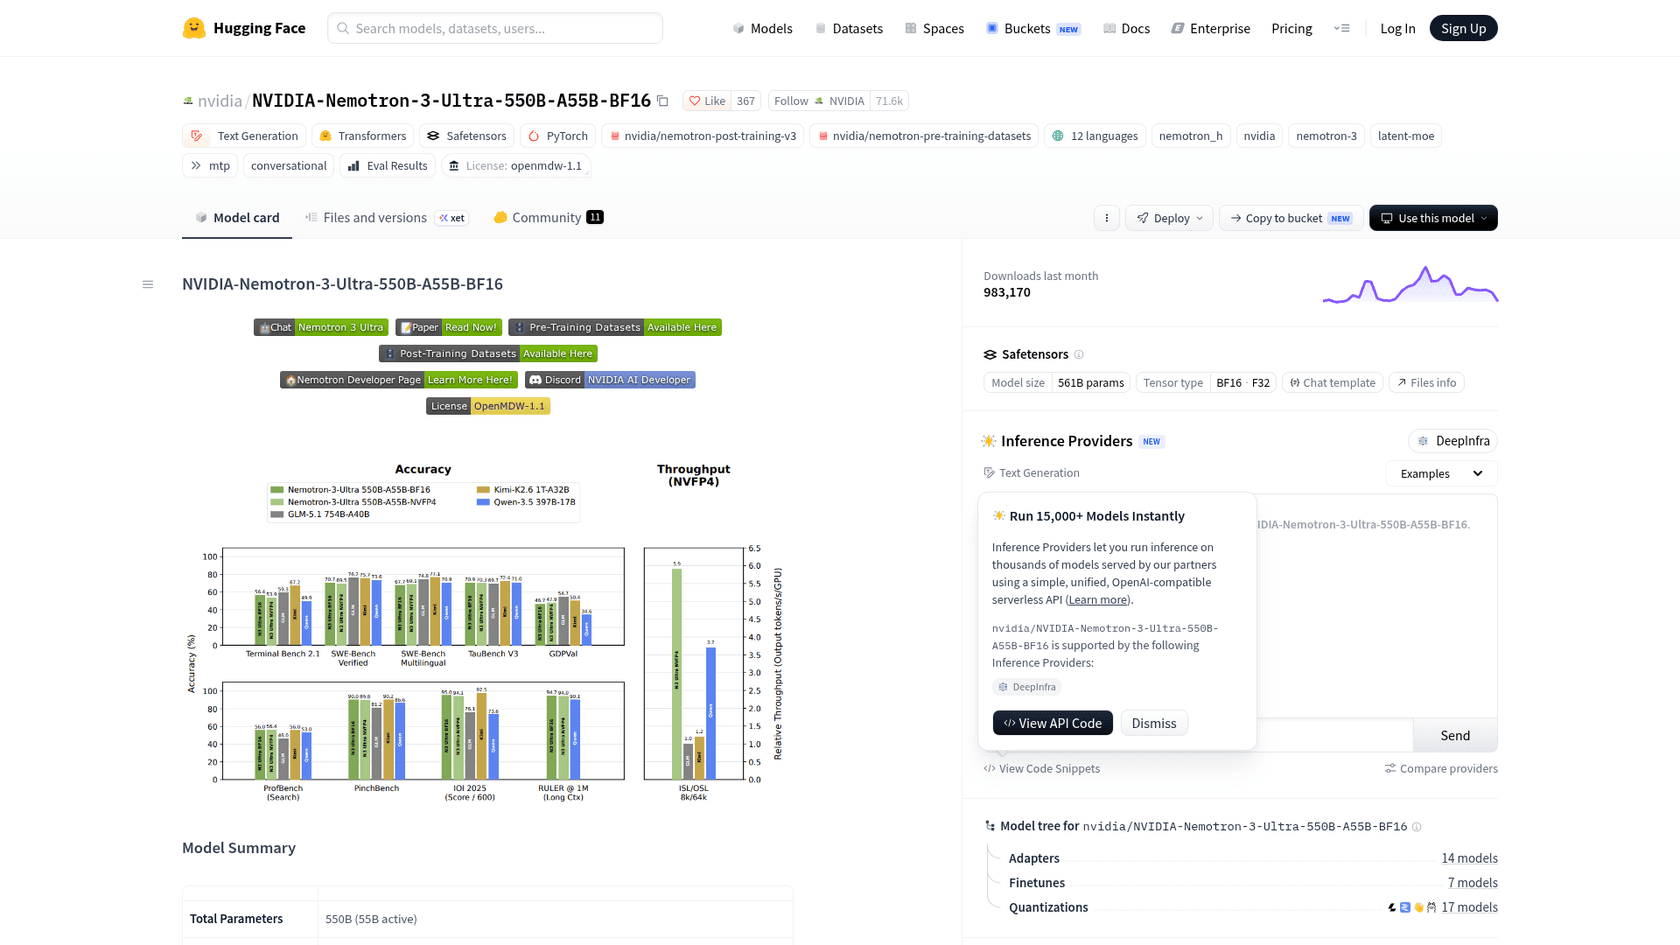
Nemotron 3 Ultra es el modelo abierto más grande de NVIDIA, lanzado el 4 de junio de 2026. Tiene 550B totales con 55B activos, un híbrido de capas Mamba-2, atención y mezcla de expertos. Es solo texto, y el razonamiento se activa o desactiva en la plantilla de chat.
En qué le gana a Muse Spark Open. En apertura. NVIDIA publica los conjuntos de datos de preentrenamiento y posentrenamiento, los entornos de RL y un informe técnico. Si necesitas explicarle a un auditor qué entró en un modelo, este es el único de la lista donde puedes hacerlo. La licencia también es más ligera.
Dónde se queda corto. En capacidad. Puntúa 23 en la tabla de Meta, la más baja de aquí, y queda por detrás de Muse Spark Open en todos los benchmarks donde ambos aparecen, incluidos MCP-Atlas (63,1 vs 89,2) y Terminal-Bench 2.1 (53,9 vs 76,4). La ficha dice "up to 1M tokens", pero la configuración distribuida está en 262.144. El hardware mínimo es 8x H200 o 16x H100.
"Each of the Nemotron 3 models were briefly competitive when they launched, but never exceptional, and less competitive with each scale up. The fact that it took so long for Nemotron 3 Ultra to launch really hampered its competitiveness. The Nemotron 3 series is extremely open about training recipes and training data, far more open than most open weight models, and that is valuable."
Precio y licencia. La página de build de NVIDIA ofrece un endpoint de prueba sin precio por token. DeepInfra lista $0.50 de entrada, $0.10 en caché y $2.20 de salida por millón de tokens. La licencia es OpenMDW-1.1: conserva la licencia y los avisos al redistribuir, y "does not impose any restrictions or obligations" sobre las salidas.
Veredicto: Elige Nemotron 3 Ultra por la transparencia, no por un modelo más inteligente. Si tu equipo legal o de investigación necesita conocer los datos de entrenamiento, es la opción clara. Si solo necesitas las mejores respuestas, no lo es.
8. Inkling
Ideal para: productos de audio más texto que quieren un modelo Apache 2.0 de un laboratorio estadounidense.
Inkling es el primer modelo de Thinking Machines Lab, lanzado el 15 de julio de 2026. Es una mezcla de expertos de 975B parámetros con 41B activos, 1M de contexto según la ficha del modelo, y entrada de texto, imágenes y audio a 16kHz. Un Inkling Small más pequeño (276B, 12B activos) llegó el 30 de julio.
En qué le gana a Muse Spark Open. En claridad de licencia: los pesos son Apache 2.0, sin etiqueta de producto y sin cláusula de ingresos. Thinking Machines también opera Tinker, una plataforma alojada de ajuste fino, así que ajustarlo con tus propios datos es un camino respaldado y no un proyecto de fin de semana.
Dónde se queda corto. Puntúa 26 en la tabla de Meta, y Muse Spark Open lo supera en todos los benchmarks compartidos, a menudo por un margen amplio (JobBench 61,8 vs 31,1, MCP-Atlas 89,2 vs 76,0). Y aunque los pesos son Apache 2.0, la ficha de Hugging Face enlaza una política de uso aceptable aparte que dice obligar a cualquiera que descargue. Exige avisar a los usuarios de que hablan con una IA cuando eso sea relevante, algo que la mayoría de los equipos de soporte ya hace.
"Very nice, multi modal, largest open weight model that supports audio. Would be interesting to see how good the audio capability is."
Precio y licencia. El precio bajó. La beta de inferencia sin servidor de Thinking Machines ahora lista Inkling a $1.00 de entrada, $0.17 en caché y $4.05 de salida por millón de tokens, al 14 de octubre, con una nota de que "not yet recommended for intensive production use." Together AI cobra lo mismo. Inkling Small cuesta $0.30 de entrada y $1.20 de salida.
Veredicto: Inkling es la opción si necesitas entrada de audio bajo Apache 2.0. Muse Spark Open también acepta audio y puntúa mucho más, así que el factor decisivo es si la etiqueta "Built with Muse Spark Open" funciona para tu producto. Para verlo más de cerca, mira mi reseña de Inkling.
La letra pequeña de las licencias, lado a lado
La mayoría de las comparativas se detienen en los benchmarks. En pesos abiertos, la licencia decide si puedes lanzar o no, así que aquí tienes cada obligación en una sola vista.
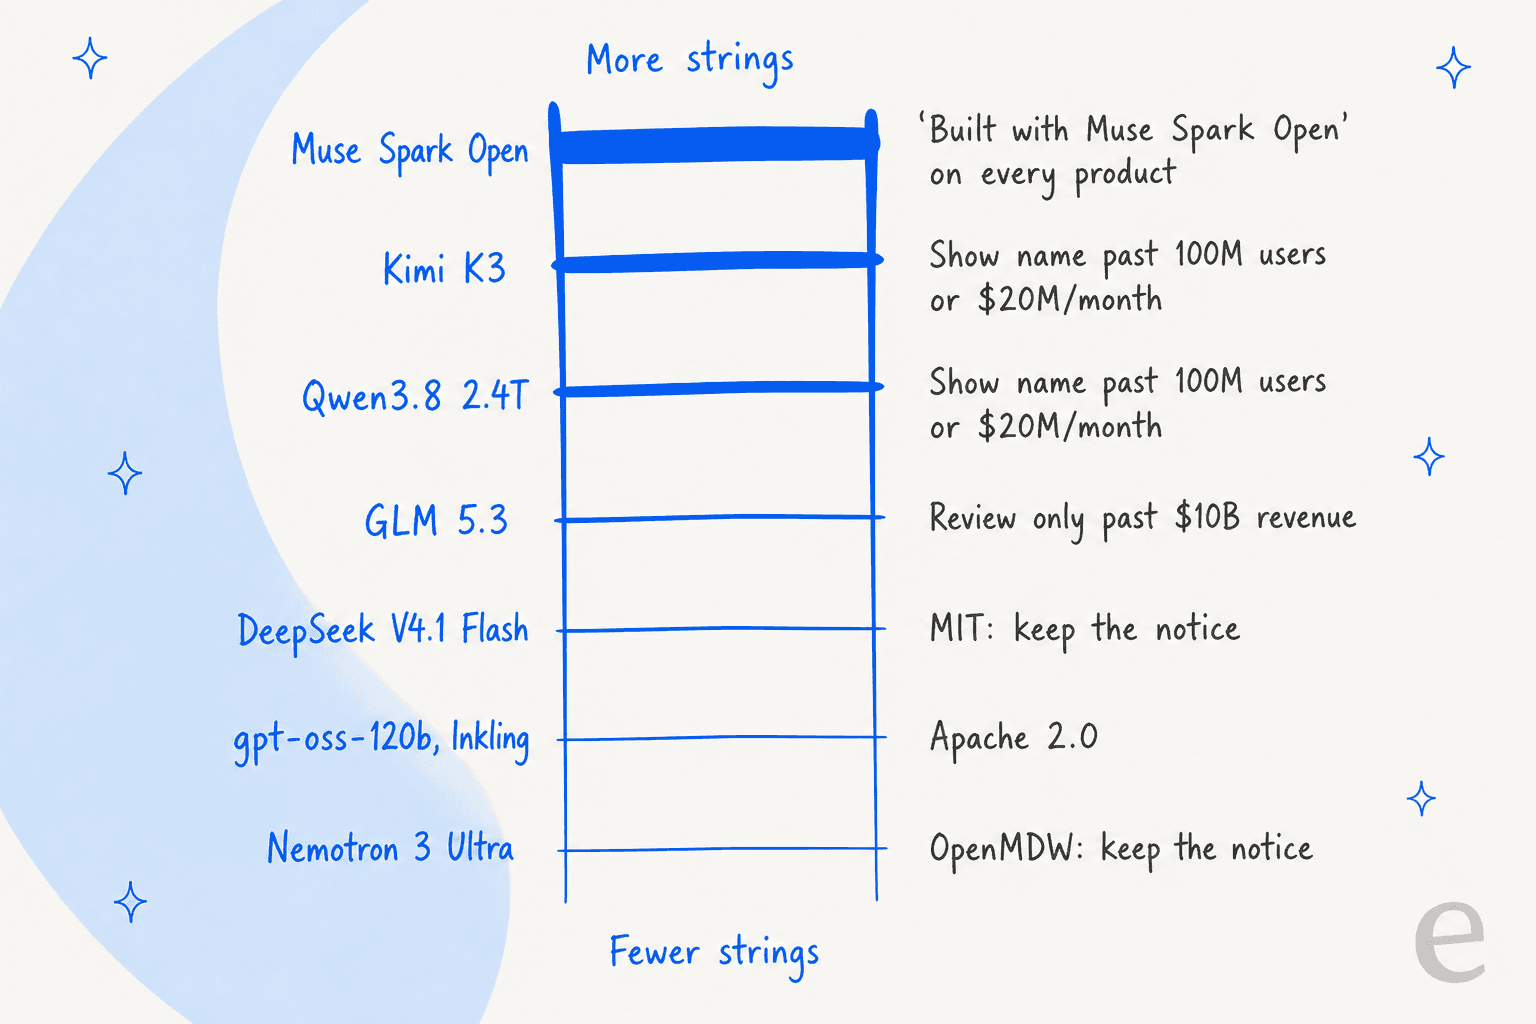
Lo que más me sorprendió fue lo inusual que es la regla de mostrar etiqueta de Meta. Kimi K3 y Qwen3.8 también piden mostrar el nombre del modelo, pero solo cuando superas los 100 millones de usuarios mensuales o los 20 millones de dólares de ingresos mensuales. Muse Spark Open es el único modelo de aquí que pide una etiqueta en cada producto, desde el primer día. Su cláusula de alojamiento se parece a la de Kimi K3 (20 millones de dólares al año), mientras que GLM 5.3 fija su umbral en 10.000 millones y solo pide una revisión de seguridad.
Nada de esto es un obstáculo para un producto típico. Una línea "Built with Muse Spark Open" en tu documentación o en el menú de ajustes cumple la cláusula de Meta. Pero si haces marca blanca para clientes o revendes inferencia, lee la cláusula con tu abogado antes de elegir.
Cómo elegir entre ellos
Después de trabajar con los ocho, este es el orden en que los probaría, para la mayoría de los equipos:
- Empieza con GLM 5.3 como reemplazo directo. Misma franja de precio, mayor puntuación, licencia más ligera.
- Añade DeepSeek V4.1 Flash como control de costo. Si pasa tu evaluación, acabas de recortar tu factura unas 7 veces.
- Añade gpt-oss-120b como piso. Si también pasa, probablemente no necesitas un modelo de más de 700B para ese trabajo.
- Incorpora Kimi K3 solo para las tareas de código o visión que los demás no resuelvan.
- Conserva Muse Spark Open para agentes con muchas herramientas donde importen su ventaja en MCP-Atlas y su resistencia a jailbreaks, sobre todo en cualquier cosa de cara al cliente que deba rechazar con limpieza.
El paso que la mayoría de los equipos se salta es la propia evaluación. Los benchmarks son promedios; tu carga de trabajo no. Pasa 100 de tus propias tareas reales por cada candidato en un proveedor como Fireworks AI o Baseten antes de comprometerte, y puntúalas todas igual.
Si el modelo es para atención al cliente, el modelo es la decisión menor
Mucha gente que evalúa pesos abiertos en 2026 lo hace para un bot de soporte. A todos les diría lo mismo: el modelo es infraestructura. El empleado es todo lo que se construye encima.
eesel lleva años ejecutando IA en colas de soporte reales, y el fallo que más dolió no tuvo nada que ver con la elección del modelo. A unos pocos clientes de pago les pasó que un bot, cuando no encontraba nada relevante en su base de conocimiento, rellenaba el hueco con los datos generales de entrenamiento del modelo y enviaba respuestas seguras y erróneas a clientes reales. Cambiar a un modelo de mayor puntuación no arregla eso. Lo arreglan una alternativa estricta, la base en tus propias fuentes y las pruebas con tickets reales antes del lanzamiento. Por eso cada despliegue de eesel ahora se simula con tickets históricos antes de responder a nadie.
Así que si estás eligiendo entre GLM 5.3 y Muse Spark Open para un helpdesk, hay un camino más corto. El compañero de helpdesk con IA de eesel se conecta a Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y te muestra cómo habría respondido a los tickets del mes pasado antes de salir en vivo. Un límite honesto: eesel funciona con modelos de frontera alojados de OpenAI, Anthropic y Google (listados en la página de seguridad), no con estos pesos abiertos, así que si autoalojar el modelo es un requisito imprescindible, eesel no es lo adecuado.
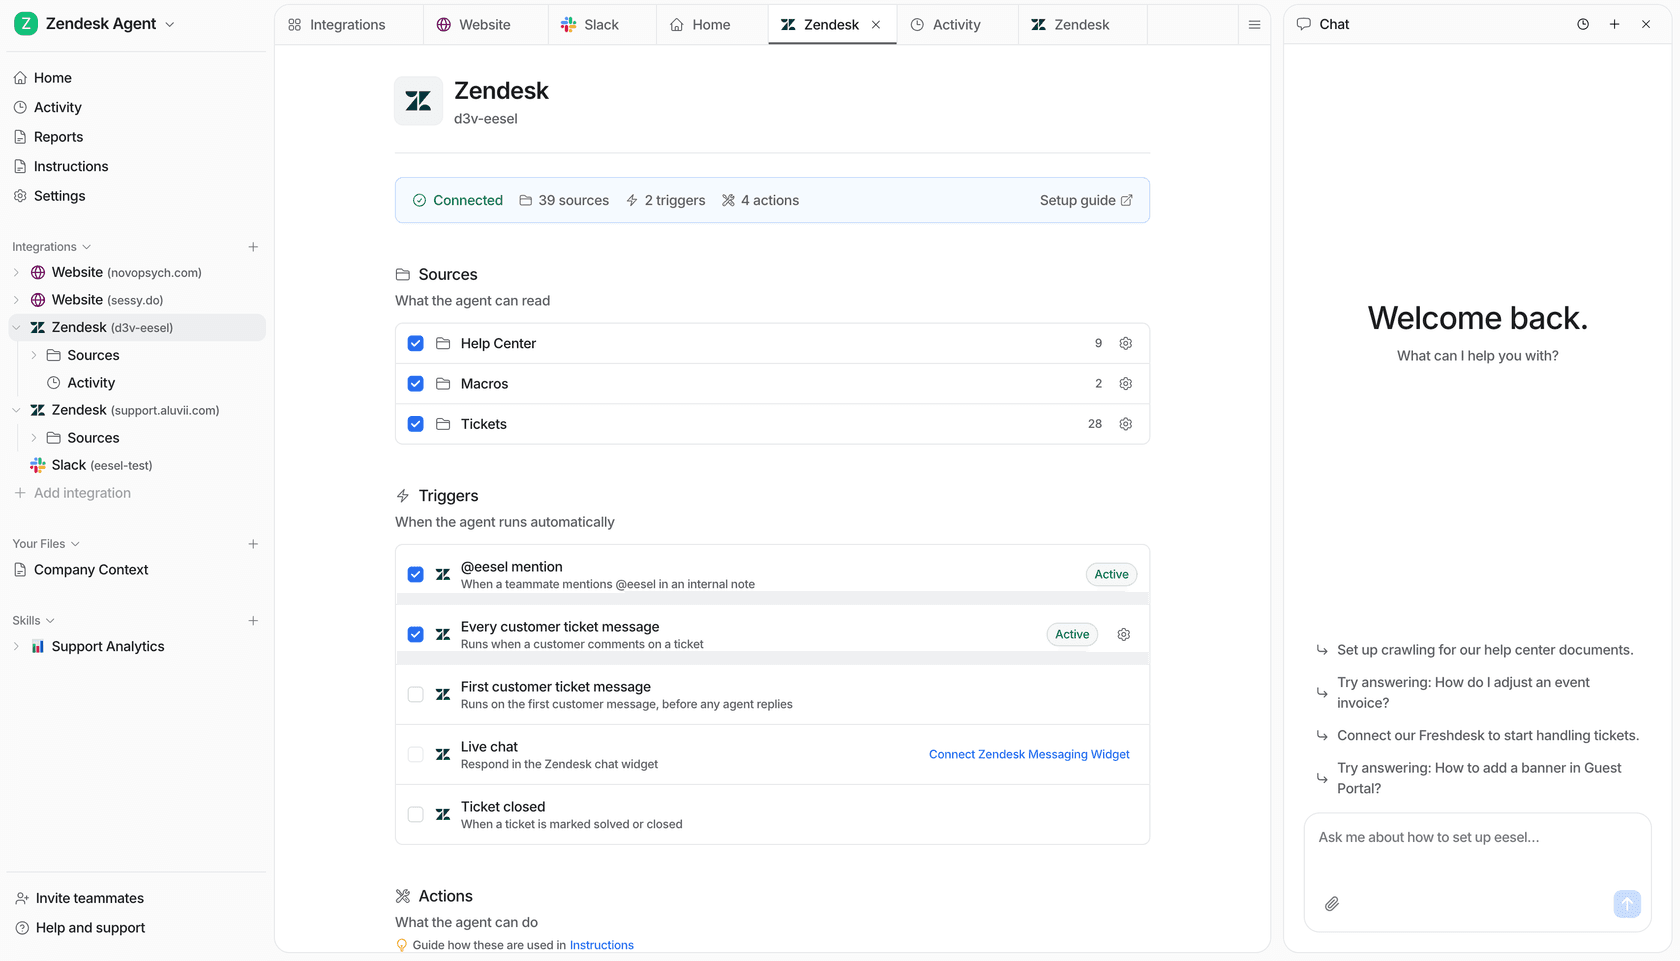
Si eres de los equipos que comparan licencias de modelos, probablemente también querrás manejarlo desde código. La CLI de eesel (@eesel/cli en npm) ejecuta el mismo compañero y espacio de trabajo desde una terminal: conecta un helpdesk con eesel integrations connect, lee y edita sus instrucciones permanentes con eesel instructions, aprueba o rechaza acciones pendientes con eesel approvals y revisa lo que hizo con eesel activity. Cada comando imprime JSON, los comandos de escritura admiten --dry-run y los tokens sin interfaz funcionan en CI, así que un script o un agente de código como Claude Code puede operarlo tan fácilmente como tú. Cada espacio de trabajo también es un servidor MCP, que cubro en MCP para atención al cliente.
Y si tu proyecto de pesos abiertos va de contenido y no de tickets, el otro compañero de eesel es un redactor de blog con IA que investiga, redacta e ilustra publicaciones como esta.
Prueba eesel
Muse Spark Open, GLM 5.3 y el resto son motores. Si lo que realmente necesitas es una IA que responda a tus clientes, eesel es un compañero de soporte que ya conoce tu centro de ayuda y tus tickets anteriores, se une a tu helpdesk actual en minutos y se pone a prueba con los tickets del mes pasado antes de tocar uno en vivo. Prueba eesel gratis, o mira cómo lo comparan otros equipos en mi comparativa de los mejores agentes de atención al cliente con IA.