9 mejores alternativas a llama.cpp en 2026, según hardware y carga

Rama Adi

Katelin Teen
Última edición 14 de noviembre de 2026
Las mejores alternativas a llama.cpp son vLLM o SGLang para muchos usuarios en un servidor GPU, MLX-LM en un Mac con Apple Silicon, y ExLlamaV3 para meter el máximo modelo en una sola tarjeta NVIDIA. Ollama, LM Studio, Jan y LocalAI son más amigables, pero siguen ejecutando llama.cpp por debajo, así que cambian la app, no el motor. Con llama.cpp en v1.0.0, una sola persona en una sola máquina suele estar mejor quedándose. Si el objetivo es IA en tickets de soporte, eesel hace eso con modelos alojados, y su CLI permite que un agente de código suba artículos de ayuda y pruebe respuestas primero.
¿Por qué la gente busca alternativas a llama.cpp?
Sobre todo porque superaron el trabajo para el que se construyó llama.cpp, no porque haya empeorado. llama.cpp es el motor en C/C++ que hizo normal ejecutar modelos en hardware corriente, y sigue siendo el más amplio: el README del proyecto lista backends para CUDA, Metal, HIP, Vulkan, SYCL, CPU pura y más de una docena más, con cuantización GGUF de 1,5 bits a 8 bits y descarga de CPU más GPU para modelos más grandes que tu VRAM. Tiene 135.056 estrellas en GitHub bajo licencia MIT, y el 13 de noviembre de 2026 lanzó v1.0.0, su primer release semver, con cachés KV FP8, una caché en memoria del host para modelos mixture-of-experts y una interfaz web rediseñada.
Trabajo en las integraciones y APIs de eesel, así que la mayor parte de mi tiempo con motores locales se va en las partes aburridas: la API que ofrecen, cómo se comportan con varias solicitudes a la vez, y qué se rompe cuando cambias el modelo. Eso da forma a esta lista. Leí la documentación, las notas de versión y los repositorios de cada proyecto, y recogí informes de la comunidad en Hacker News, pero no he hecho benchmarks de los nueve en una sola máquina, así que trata cualquier afirmación de velocidad de abajo como suya, no mía.
Las razones que da la gente para cambiar se agrupan en cuatro:
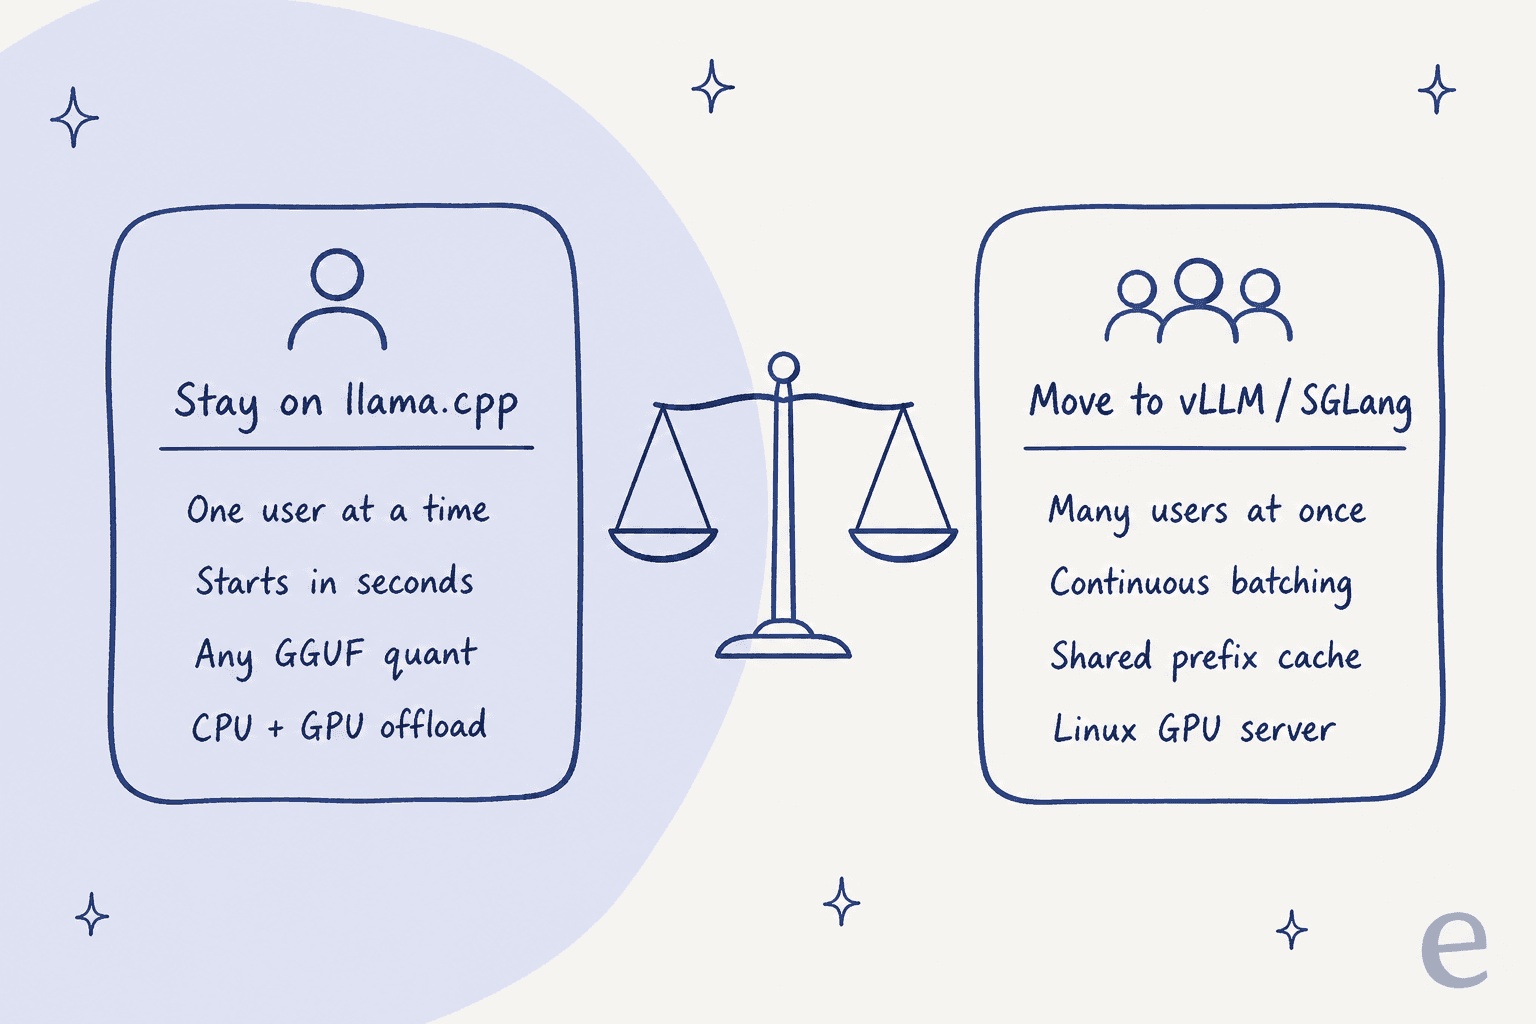
- Muchos usuarios a la vez. llama.cpp es genial para una persona y está bien para unas pocas. Un equipo que golpea el mismo servidor es donde los motores con batching toman la delantera.
- Velocidad en Mac. En Apple Silicon, el propio framework MLX de Apple suele ser el camino más rápido.
- Velocidad máxima en una GPU concreta. Los motores con kernels escritos para el hardware de un fabricante pueden superar a un motor portable en ese hardware.
- Una app en vez de una compilación. No todos quieren compilar con CMake y pasar flags.
Las primeras tres son cambios reales de motor. La cuarta normalmente no lo es, y es la parte que la mayoría de los posts comparativos se saltan.
"While I think that llama.cpp is an outstanding project - a one-stop-shop to get almost any model to run on almost any hardware, you get a lot more speed from specialised inference engines with kernels made for your hardware."

¿Es Ollama realmente una alternativa a llama.cpp?
No a nivel de motor. Ollama, LM Studio, Jan y LocalAI ejecutan todos llama.cpp por debajo para modelos GGUF, y varios de ellos añaden MLX en Macs. Cambian cómo instalas, descargas y gestionas modelos. No cambian cómo se generan los tokens.
La evidencia está en sus propias páginas. Las notas de la versión v0.40.16 de Ollama listan "Updated llama.cpp". La página de inicio de LM Studio dice que funciona "with MLX and llama.cpp under the hood." La documentación de la API de Jan describe "local models powered by llama.cpp or MLX." LocalAI lista llama.cpp como uno de sus más de 80 backends, junto a vLLM y MLX. Y el equipo de llama.cpp ahora ofrece su propia app de escritorio Llama, una descarga de 1 MB para Mac y Windows.
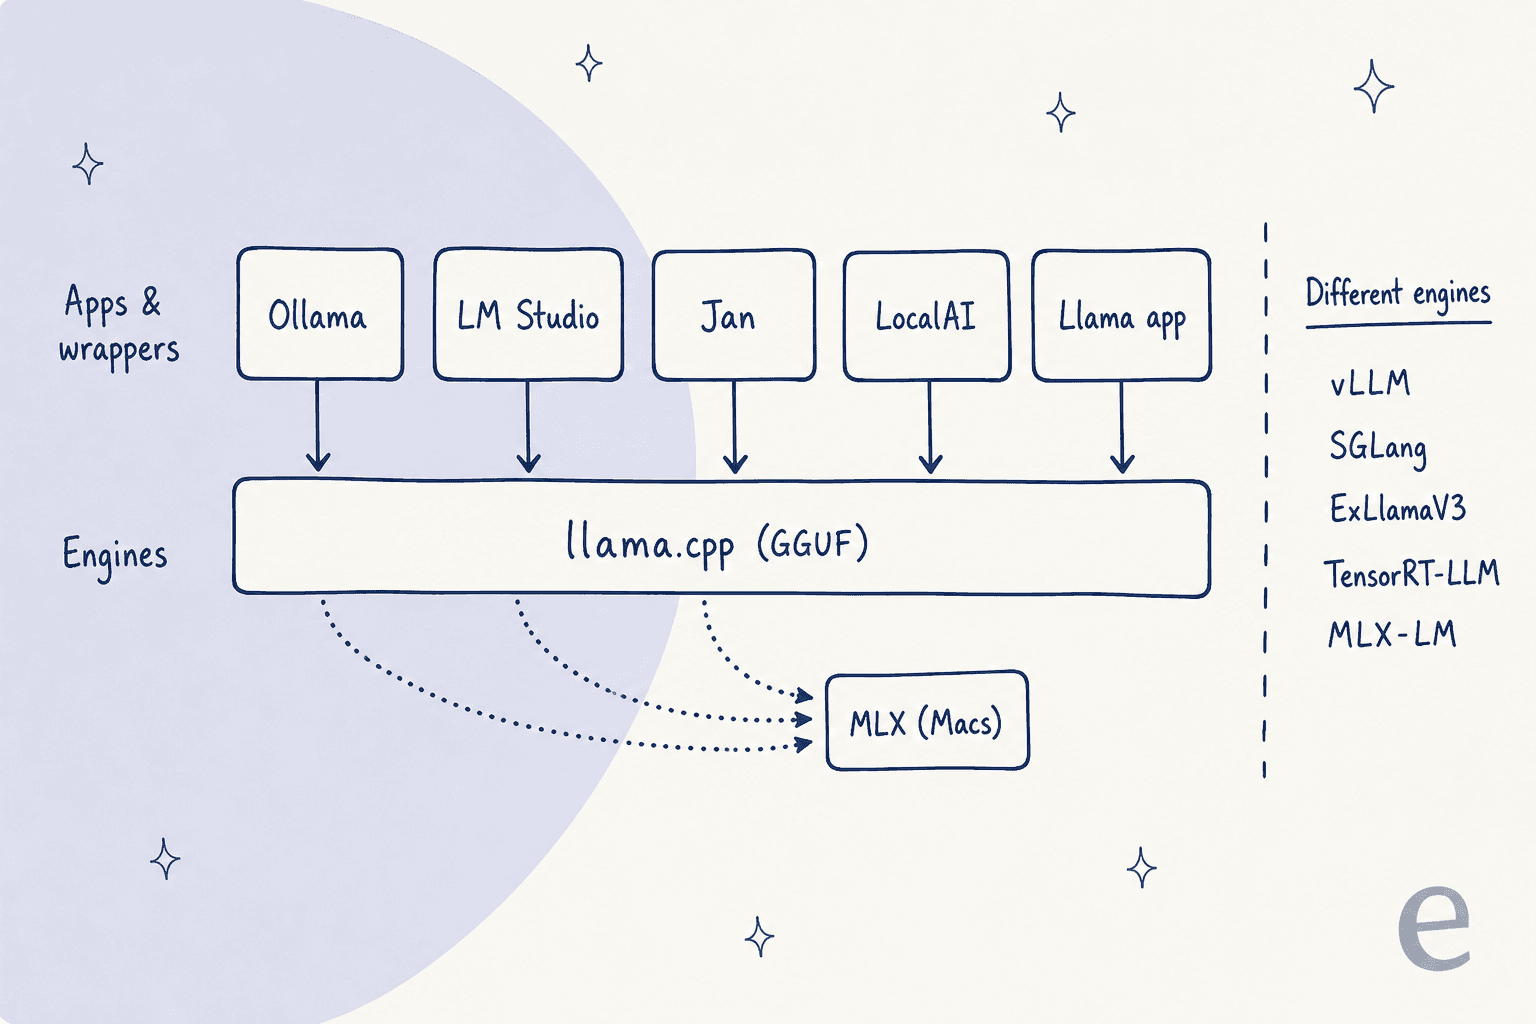
Esa división decide dónde deberías mirar. Si estás dejando llama.cpp porque las compilaciones y los flags te agotan, una app encima de él es la solución correcta, y conservas todo lo que ya funciona. Si te vas porque es demasiado lento para tu carga de trabajo, una app sobre el mismo motor no ayudará, y quieres uno de los cinco de la columna derecha.
"There's also been some controversy over not giving proper credit to llama.cpp which ollama is/was a wrapper around."
Cómo elegí estas alternativas
Empecé por lo que los compradores realmente preguntan. Cuando le puse "What are the best llama.cpp alternatives?" a ChatGPT en un chat nuevo, nombró nueve proyectos y los dividió en motores de inferencia y plataformas de LLM locales, así que los nueve están aquí. Luego comprobé cada uno contra cinco cosas:
- Motor o envoltorio. ¿Reemplaza la inferencia de llama.cpp, o la envuelve?
- Hardware y SO. NVIDIA, AMD, Apple Silicon, CPU; Linux, Windows, macOS.
- Formato de modelo. GGUF, pesos MLX, EXL3 o safetensors de Hugging Face.
- Servicio. Una API compatible con OpenAI, y si agrupa bien muchas solicitudes.
- Mantenimiento. Fecha del último release, licencia y estrellas del repositorio de GitHub de cada proyecto al 15 de noviembre de 2026.
Así se alinean:
| Herramienta | Tipo | ¿Ejecuta llama.cpp por dentro? | Hardware | SO | Formato de modelo principal | API compatible con OpenAI | Muchos usuarios a la vez | Licencia | Estrellas en GitHub | Último release | Nivel de pago |
|---|---|---|---|---|---|---|---|---|---|---|---|
| vLLM | Motor | No | NVIDIA, AMD, Intel, CPU, TPU vía plugin | Linux (WSL en Windows) | Safetensors; GGUF experimental | Sí, más API de Anthropic | Fuerte | Apache-2.0 | 96.936 | v0.33.0 | Ninguno |
| SGLang | Motor | No | NVIDIA, AMD, TPU, Intel, Ascend, Mac vía MLX | Mayormente Linux | Safetensors; GGUF en NVIDIA | Sí | Fuerte | Apache-2.0 | 38.874 | v0.5.23 | Ninguno |
| MLX-LM | Motor | No | Solo Apple Silicon | macOS | Pesos MLX | Similar a OpenAI, básico | Ligero | MIT | 7.656 | v0.32.2 | Ninguno |
| ExLlamaV3 | Motor | No | NVIDIA; AMD 7900 en adelante | Linux, Windows | EXL3 | Vía TabbyAPI | Batching dinámico | MIT (TabbyAPI AGPL) | 1.825 | v1.6.7 | Ninguno |
| TensorRT-LLM | Motor | No | GPUs NVIDIA de centro de datos | Linux | Safetensors, FP8/FP4 | Sí | Fuerte | Código abierto de NVIDIA | ~15.100 | v1.2.1 stable | Ninguno |
| Ollama | App + servidor | Sí, más MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Subconjunto, más API de Anthropic | Moderado | MIT | 186.973 | v0.40.16 | Nube desde 20 $/mes |
| LM Studio | App de escritorio | Sí, más MLX | NVIDIA, AMD, Apple Silicon | macOS (serie M), Windows, Linux | GGUF, MLX | Sí, más API de Anthropic | Moderado | App cerrada; herramientas MIT | 5.427 (CLI lms) | Bionic 1.2.0 | Nube desde 20 $/mes |
| Jan | App de escritorio | Sí, más MLX | NVIDIA, AMD, Apple | macOS, Windows, Linux | GGUF | Sí | Ligero | Apache 2.0 | ~45.700 | v0.8.8 | Ninguno |
| LocalAI | Servidor API | Sí, entre más de 80 backends | CPU, NVIDIA, AMD, Intel, Apple, Jetson | Linux, macOS, Docker, Kubernetes | GGUF y más | Sí, más API de Anthropic | Moderado | MIT | ~50.400 | v4.12.1 | Ninguno |
¿Qué alternativa a llama.cpp se ajusta a tu hardware?
Empieza por la máquina, luego por el número de personas que la usan. Un Mac apunta a MLX-LM. Una sola tarjeta NVIDIA apunta a ExLlamaV3 para ti solo o a vLLM para un equipo pequeño. Un servidor GPU apunta a SGLang para cargas de agentes con prompts compartidos, o a TensorRT-LLM si quieres el último punto de velocidad en hardware NVIDIA. Si lo que quieres es simplemente una app más agradable, elige LM Studio, Jan u Ollama y acepta que llama.cpp sigue haciendo el trabajo.
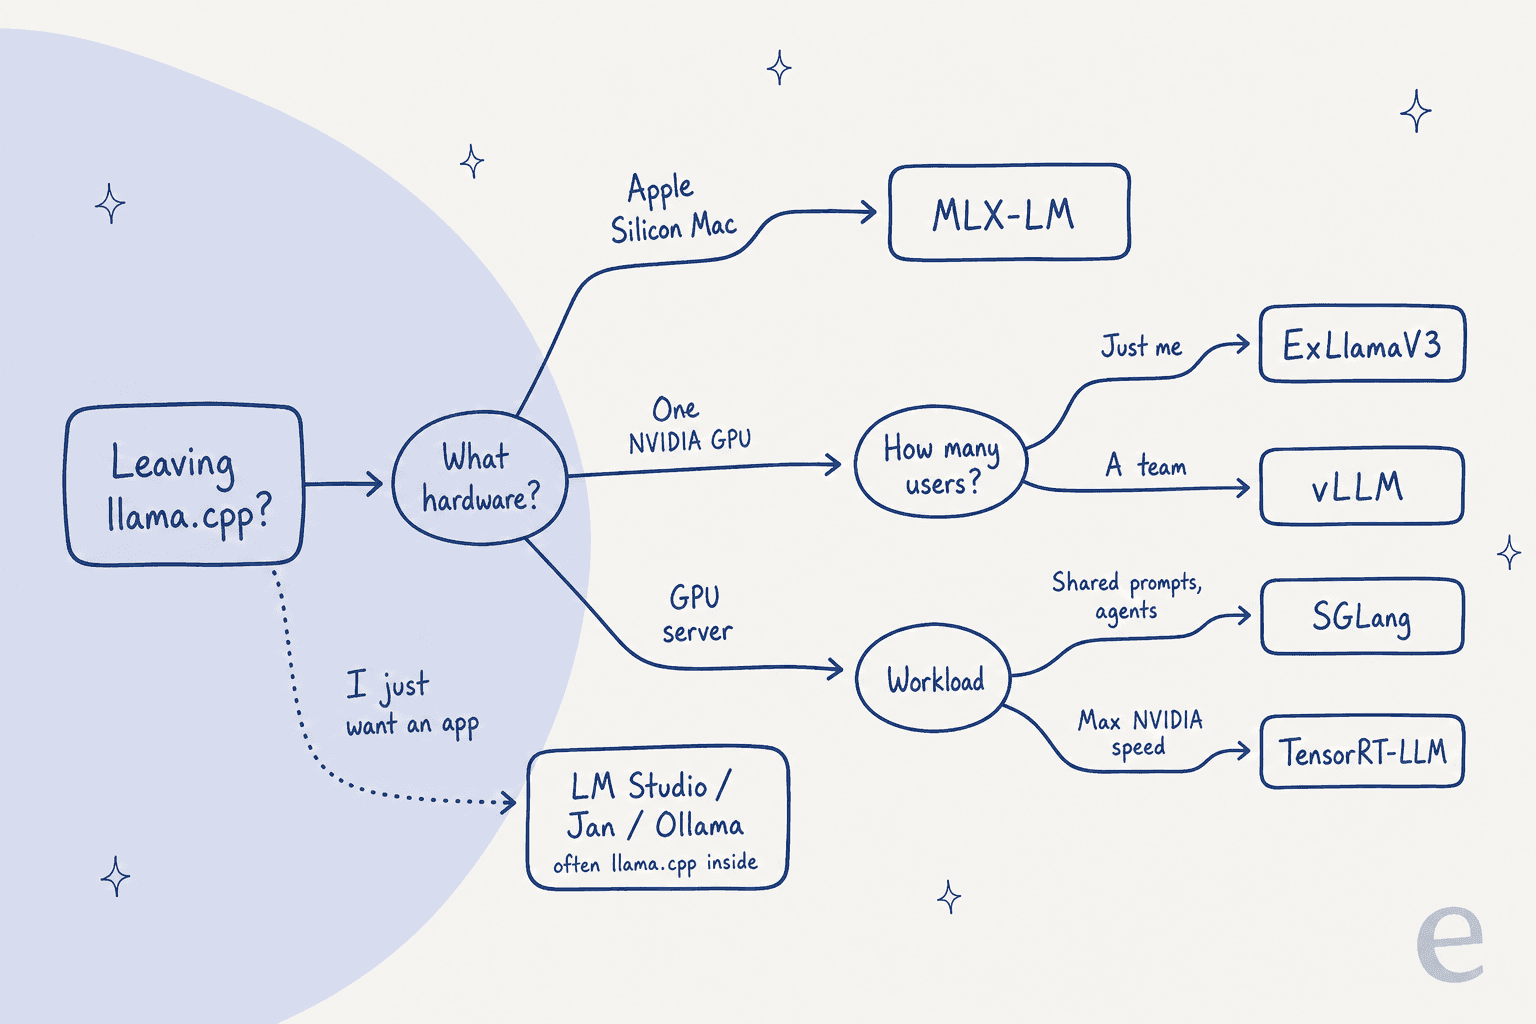
La pregunta más útil de todas es cuántas personas golpean el modelo a la vez. llama.cpp tiene slots paralelos y un llama-server compatible con OpenAI, pero los motores construidos alrededor del continuous batching mantienen el rendimiento cuando las solicitudes simultáneas se acumulan, a costa de un arranque más lento y menos flexibilidad con archivos cuantizados.
"IME vLLM is quite a bit faster than llama.cpp but where it really wipes the floor with it is in batching concurrent load. The downside is that it is dramatically less flexible in terms of tweaking. It gives you very few options for running quantized weights."
1. vLLM
Lo mejor para: servir un modelo a muchos usuarios desde un servidor GPU en Linux.
vLLM se describe a sí mismo como "a fast and easy-to-use library for LLM inference and serving." Empezó en el Sky Computing Lab de UC Berkeley y ahora acredita a más de 2.000 colaboradores. Si has oído un nombre en la conversación de "llama.cpp para servidores", es este.
Qué hace mejor que llama.cpp
- Tráfico simultáneo. PagedAttention, continuous batching, chunked prefill y prefix caching están todos construidos para muchas solicitudes a la vez.
- Despliegues grandes. Paralelismo de tensor, pipeline, datos, expertos y contexto para repartir un modelo entre GPUs y máquinas.
- Cobertura de API. Un servidor compatible con OpenAI, más una API de mensajes de Anthropic y gRPC, para que herramientas como Claude Code puedan apuntar a él.
- Rango de hardware para servidores. NVIDIA, AMD ROCm 6.3+, Intel XPU y CPU, con TPU, Gaudi y Ascend mediante plugins.
Dónde se queda corto
- Solo Linux. La guía de instalación en GPU dice "vLLM does not support Windows natively" y remite a WSL. Apple Silicon solo funciona mediante un plugin comunitario vLLM-Metal.
- GGUF es una puerta lateral. La documentación de GGUF lo califica de "highly experimental and under-optimized", y ahora necesita un plugin separado. Si tu biblioteca de modelos es de archivos GGUF, planea descargar versiones en safetensors.
- Arranque lento. Compila grafos CUDA optimizados al cargar, lo que perjudica si cambias de modelo a menudo.
"We use all kinds of different models other than Qwen3, and vLLM startup when switching models is prohibitively slow (several times slower than llama.cpp, which is already 5 sec)"
Coste
Gratis bajo Apache-2.0. Instala con uv pip install vllm y sirve con vllm serve <model>. El coste real es una máquina Linux con una GPU compatible y alguien que la opere.
Veredicto
Elige vLLM cuando un equipo, una app o una flota de agentes comparten un modelo y el rendimiento importa más que el tiempo de arranque. Sáltatelo si estás en Windows o en un Mac, o si cambias entre modelos GGUF todo el día.
2. SGLang
Lo mejor para: cargas de agentes que reenvían los mismos prompts largos.
SGLang es un framework de inferencia de código abierto "optimized for agentic workloads, large-scale serving, and RL rollouts," alojado por la organización sin fines de lucro LMSYS. Su documentación empieza con "low-latency, high-throughput inference with RadixAttention, prefix caching, and multi-GPU parallelism."
Qué hace mejor que llama.cpp
- Reutilización de prefijos compartidos. RadixAttention mantiene en caché los prefijos de prompt compartidos, lo cual rinde cuando un agente envía el mismo prompt de sistema y la misma lista de herramientas en cada llamada.
- Recetas de modelos del primer día. La documentación tiene páginas de cookbook para lanzamientos nuevos como Kimi K3.1 Pro, más una receta del primer día para Qwen3.8-Flash-Next.
- Amplia lista de aceleradores. NVIDIA desde tarjetas RTX 30 hasta GB300, AMD Instinct, Google TPU, Intel Arc y Xeon, Huawei Ascend, y Macs mediante MLX.
- Compatible con OpenAI. La documentación dice que es "compatible with Hugging Face and OpenAI APIs."
Dónde se queda corto
- Requiere CUDA 13. La página de instalación dice que los wheels de CUDA 12 se retiraron después de 0.5.19, así que los stacks de drivers más antiguos necesitan actualizarse.
- Linux primero. La guía principal de instalación apunta a Linux con GPUs NVIDIA; la vía de Mac necesita macOS 14+ y una variable de entorno.
- Descarga de memoria. Los usuarios reportan que descargar pesos y la caché KV a la RAM del sistema es más débil que en llama.cpp.
"My own experience shows that both weight and KV cache offload to ram on sglang and vllm is unavailable or unusable."
Coste
Gratis bajo Apache-2.0. uv pip install --prerelease=allow sglang o la imagen Docker lmsysorg/sglang.
Veredicto
Elige SGLang sobre vLLM cuando tu tráfico sea de agentes y pipelines de RAG con prefijos largos y repetidos. Si estás construyendo agentes de IA con MCP, eso es la mayor parte de tu tráfico. Sáltatelo para una sola GPU de escritorio donde el modelo no cabe sin descarga.
3. MLX-LM
Lo mejor para: ejecutar y ajustar modelos en un Mac con Apple Silicon.
MLX-LM es el "Python package for generating text and fine-tuning large language models on Apple silicon with MLX" de Apple. Se apoya en MLX, el framework de arrays de Apple construido alrededor de la memoria unificada.
Qué hace mejor que llama.cpp
- Velocidad en Mac para muchos modelos. Los usuarios de Hacker News tratan MLX como la base a superar en Apple Silicon. Un usuario midió unos 50 tokens por segundo con MLX frente a unos 41 con llama.cpp en el mismo modelo de 8B en LM Studio.
- Ajuste fino integrado. LoRA, QLoRA y fine-tuning completo, incluso en modelos cuantizados, más inferencia distribuida entre varios Macs.
- Una gran biblioteca ya hecha. Miles de modelos convertidos en la MLX Community de Hugging Face, y
mlx_lm.convert -qpara cuantizar los tuyos.
"On a Mac the baseline I'd want is MLX, not llama.cpp. llama.cpp isn't the fast path on Apple Silicon for most models people run locally, so a speedup over llama.cpp could still be slower than mlx_lm."
Dónde se queda corto
- Solo Mac. Sin vía de GPU para Linux o Windows en este paquete.
- Servidor básico.
mlx_lm.serverhabla una API similar a OpenAI, pero sus propias notas de servidor dicen que "is not recommended for production as it only implements basic security checks." - Sin GGUF. Usas pesos en formato MLX, así que tu carpeta GGUF existente no se traslada.
- No siempre más fiable. Un usuario volvió a llama.cpp después de que un setup de MLX se quedara repitiéndose.
Coste
Gratis bajo MIT. pip install mlx-lm, luego mlx_lm.chat.
Veredicto
Elige MLX-LM si estás en un Mac de serie M y quieres velocidad o fine-tuning local. Si quieres el mismo motor con una interfaz gráfica, LM Studio, Ollama y Jan usan todos MLX en Macs. Sáltatelo para cualquier cosa que tenga que correr en servidores Linux.
4. ExLlamaV3
Lo mejor para: meter el máximo modelo posible en una sola GPU de consumo NVIDIA.
ExLlamaV3 es "an inference library for running local LLMs on modern consumer GPUs, with flexible quantization and parallel inference." Reemplaza a ExLlamaV2, cuyo README ahora está marcado como archivado y remite a V3. TabbyAPI es el servidor oficial que corre encima.
Qué hace mejor que llama.cpp
- Calidad por gigabyte. Su formato EXL3, basado en QTIP, admite tasas de bits fraccionarias y cuantización de caché de 2 a 8 bits, así que puedes ajustar un modelo para llenar exactamente tu VRAM.
- Multi-GPU en casa. Paralelismo de tensor y de expertos entre tarjetas de consumo, más descarga a CPU para modelos grandes de mixture-of-experts.
- Activo. v1.6.7 se lanzó el 13 de noviembre de 2026, con commits casi todos los días.
"ExllamaV3 4.0bpw fits in 12.5G of VRAM and beats IQ4_XS according to the measurements here"
Dónde se queda corto
- NVIDIA primero. Necesita CUDA 12.4 o posterior. El soporte de AMD es nuevo y se centra en la serie Radeon RX 7900. No hay vía para Mac.
- Necesita conversión. Los modelos deben convertirse a EXL3; no carga GGUF.
- Escala de servidor de hobby. El README de TabbyAPI dice que "is not meant to run on production servers", y es AGPL-3.0.
Coste
Gratis. ExLlamaV3 es MIT, TabbyAPI es AGPL-3.0. Los wheels precompilados en la página de releases evitan necesitar el CUDA toolkit para pip install exllamav3.
Veredicto
Elige ExLlamaV3 si tienes una o dos tarjetas RTX y quieres el modelo más grande que quepa, para ti mismo. Sáltatelo para servicio de producción compartido o cualquier cosa que no sea NVIDIA.
5. TensorRT-LLM
Lo mejor para: máximo rendimiento en GPUs NVIDIA de centro de datos.
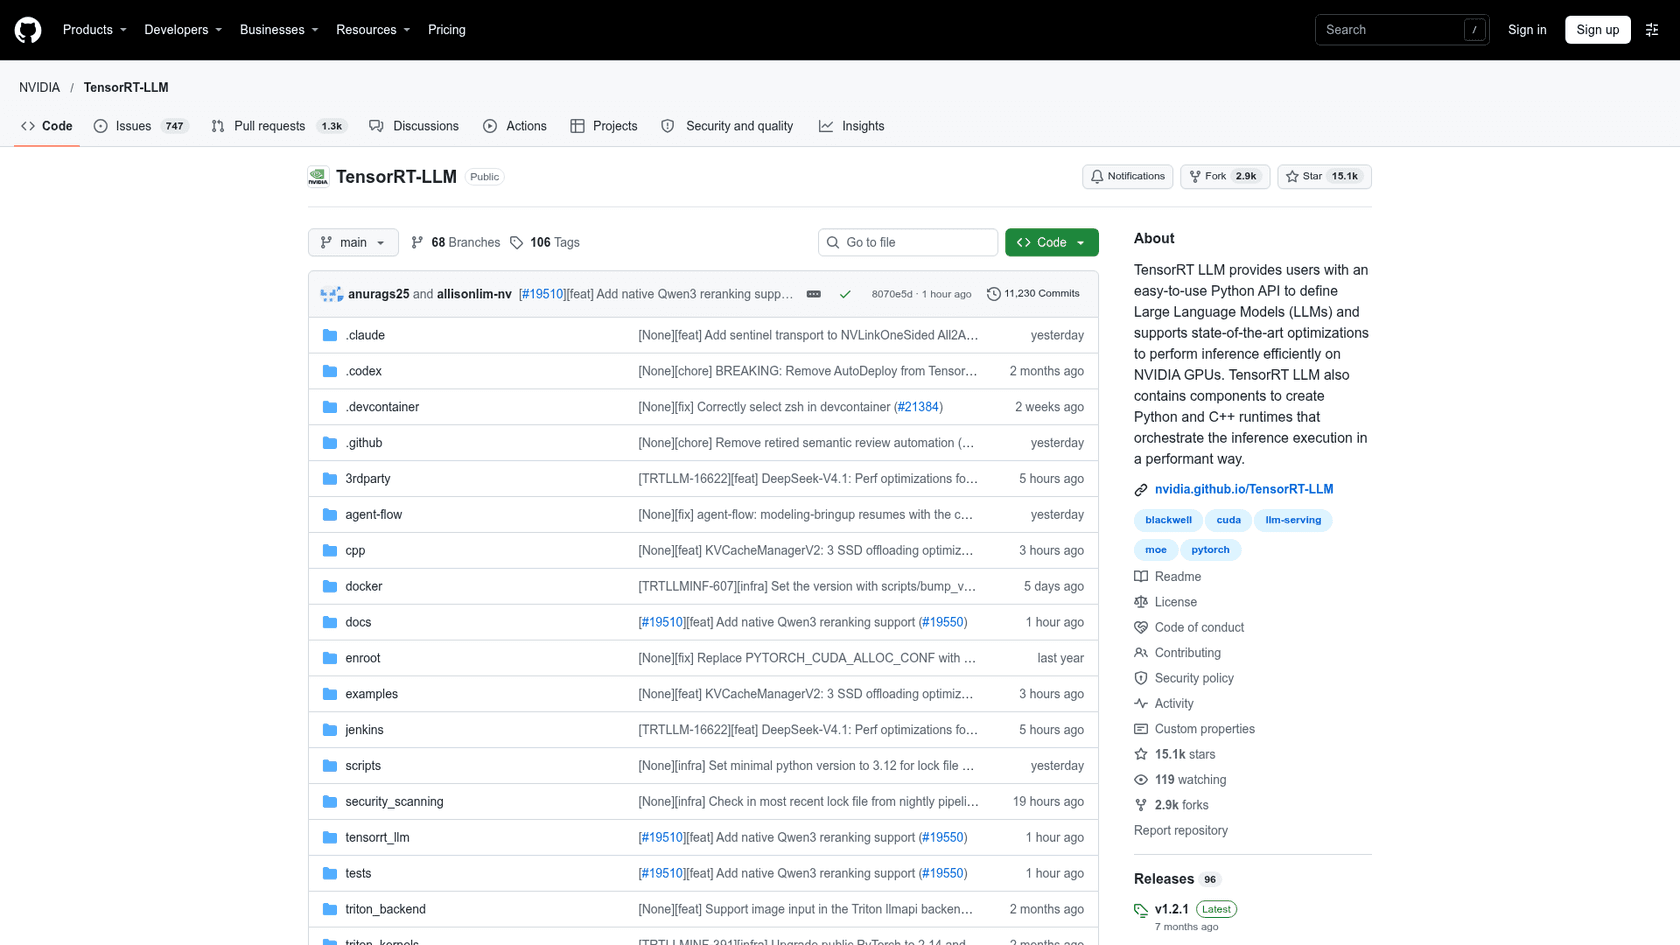
TensorRT-LLM es la biblioteca de código abierto de NVIDIA "for accelerating and optimizing inference performance of the latest large language models (LLMs) on NVIDIA GPUs", ahora construida sobre PyTorch con una API Python de LLM.
Qué hace mejor que llama.cpp
- Formatos de baja precisión en tarjetas nuevas. FP4 nativo en B200 y FP8 en H100 y posteriores, que según NVIDIA "can double performance and halve memory consumption compared to 16-bit floating point".
- Funciones de servicio. In-flight batching, caché KV paginada con reutilización de bloques, decodificación especulativa (EAGLE, MTP, NGram), LoRA y servicio desagregado en beta.
- El stack de NVIDIA. La documentación dice que se conecta a NVIDIA Dynamo y a Triton Inference Server, y
trtllm-serveexpone un endpoint compatible con OpenAI.
Dónde se queda corto
- Hardware de centro de datos NVIDIA. Las GPUs compatibles van de Ampere A100 a Hopper y Blackwell. No es una herramienta para portátiles.
- Ritmo de releases. El último release estable es v1.2.1 del 20 de abril de 2026, y la documentación ya está en candidatas de 1.4.0.
- Configuración más pesada. El camino más rápido es el contenedor NGC de NVIDIA.
"Some GPUs are still better than others like Nvidia GPUs are still the best for token throughput (via TensorRT-LLM), but AMD GPUs are competitive (via vLLM) and even CPUs can run LLMs at decent speeds (via Llama.cpp)."
Coste
Gratis, sin nivel de pago. El coste es el hardware de clase H100 o B200 para el que está construido, o las horas de nube. Los equipos que solo necesitan rendimiento a veces encuentran un motor alojado como Groq más barato que operar el suyo.
Veredicto
Elige TensorRT-LLM si tienes GPUs NVIDIA de centro de datos y el coste de servicio por token es tu número principal. Sáltatelo en hardware de consumo, donde vLLM o ExLlamaV3 son más sencillos.
6. Ollama
Lo mejor para: la instalación local más fácil, con modelos en la nube opcionales.
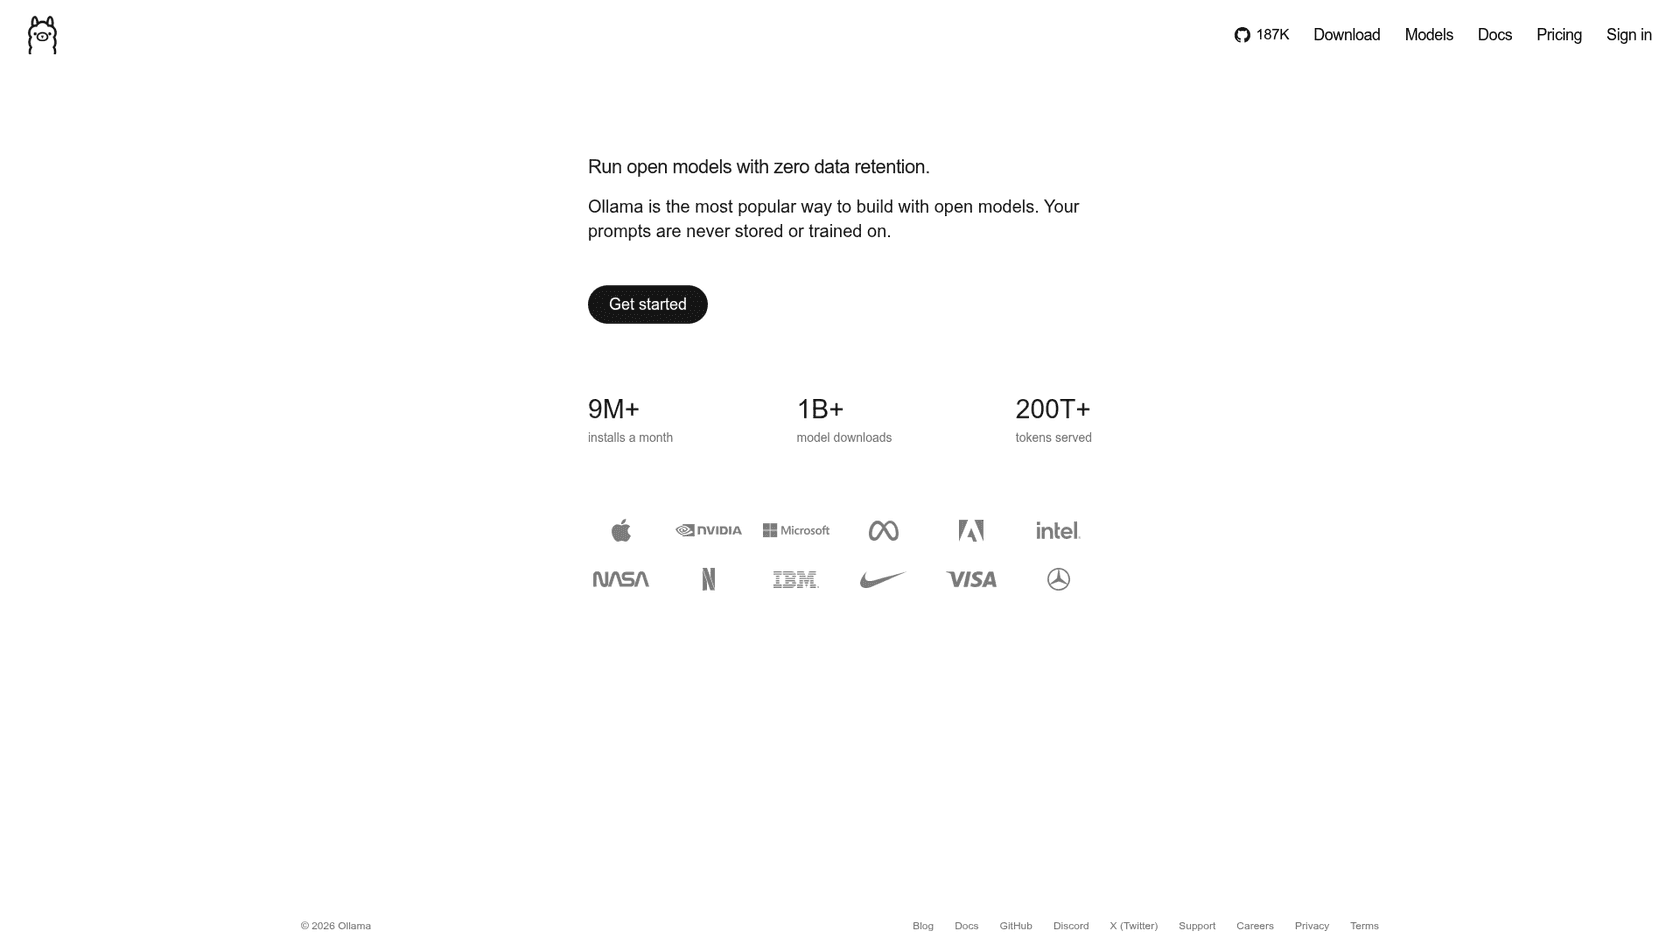
Ollama se llama a sí mismo "the most popular way to build with open models", y sus cifras respaldan la parte de la popularidad: 186.973 estrellas en GitHub y, según su propia página de inicio, más de 9 millones de instalaciones al mes.
Qué hace mejor que llama.cpp
- Cero compilación. Un script de instalación o instalador en macOS, Windows y Linux, más una imagen Docker.
- Biblioteca de modelos.
ollama rundescarga de ollama.com/library, con modelos como Kimi K3 y DeepSeek V4 Flash. - Conexión con agentes.
ollama launchconecta un modelo local con Claude Code, Codex, OpenCode y otros, y tiene endpoints compatibles con OpenAI y Anthropic. - MLX en Macs. Su repositorio ahora lleva un runner de MLX junto a llama.cpp.
"When I read the llama.cpp repo and see I have to build it, vs ollama where I just have to get it, the choice is already made."
Dónde se queda corto
- El mismo motor. Para modelos GGUF sigue siendo llama.cpp, así que no arreglará un problema de rendimiento.
- API de OpenAI parcial. La documentación de compatibilidad dice que "supports a subset of the OpenAI API."
- Menos controles. Algunos usuarios vuelven a llama.cpp una vez que quieren un control más fino, ahora que es más fácil instalar.
Coste
Gratis en local. Los planes en la nube de la página de precios de Ollama están abajo.
| Plan | Precio | Qué obtienes |
|---|---|---|
| Pago por uso | 0 $ de suscripción | Uso por token en la nube, 3 solicitudes simultáneas |
| Pro | 20 $/mes (200 $/año) | 60 $ de créditos de uso al mes, modelos Pro más grandes |
| Max | 100 $/mes | 300 $ de créditos de uso al mes, 10 solicitudes simultáneas |
| Team (acceso anticipado) | 500 $/mes | Usuarios ilimitados, 1.000 $ de créditos compartidos |
| Enterprise | A medida | Controles de acceso a modelos, presupuestos por usuario y clave |
Veredicto
Elige Ollama si quieres modelos locales funcionando en cinco minutos y planeas conectarlos a agentes de código. Sáltatelo si tu razón para dejar llama.cpp era la velocidad, porque mantendrías el mismo motor.
7. LM Studio
Lo mejor para: una app de escritorio pulida que también te deja elegir modelos por VRAM.
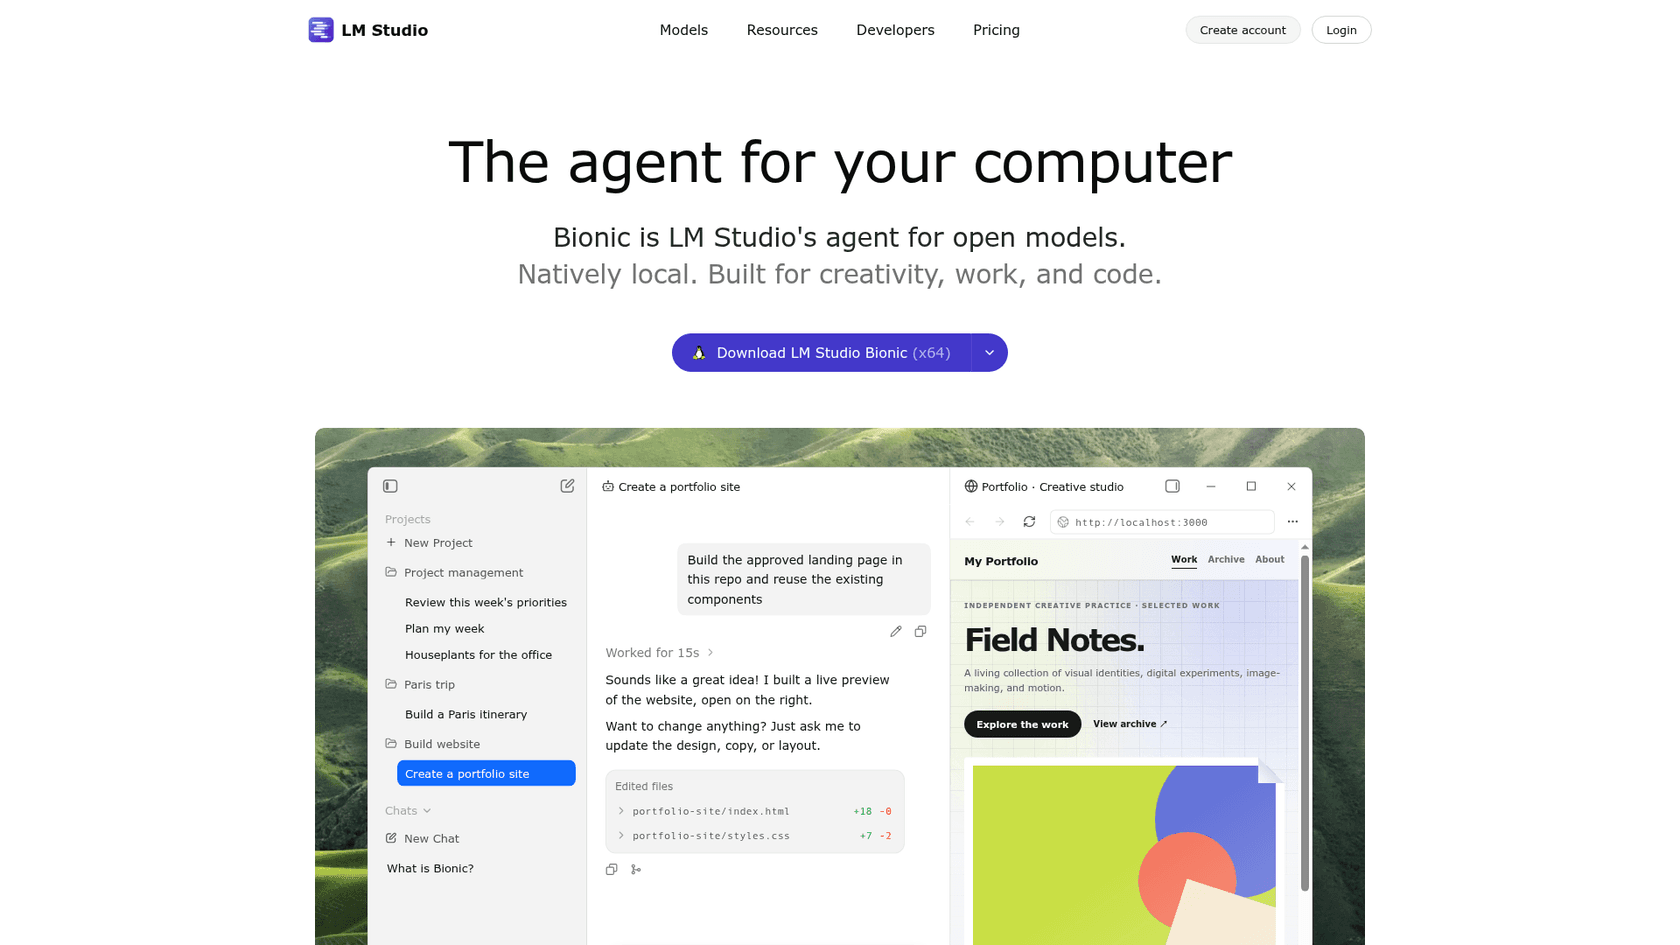
LM Studio ha crecido de una app de chat de modelos a "Bionic", que llama "LM Studio's agent for open models. Natively local." Por debajo, en sus propias palabras, funciona "with MLX and llama.cpp under the hood."
Qué hace mejor que llama.cpp
- Descubrimiento de modelos. La búsqueda muestra qué cabe en tu hardware antes de descargar.
- Ambos motores en un Mac. GGUF mediante paquetes de extensión de llama.cpp y MLX mediante su propio motor oMLX, elegido por modelo.
- Superficie para desarrolladores. Endpoints compatibles con OpenAI y Anthropic, SDKs de TypeScript y Python, la CLI
lms, yllmster, un daemon sin interfaz para servidores y CI que corre sin la GUI.
"LM Studio's model search is pretty good at showing what models will fit in your VRAM."
Dónde se queda corto
- App de código cerrado. La app de escritorio está bajo los términos propios de LM Studio; solo la CLI y los SDKs son MIT en GitHub.
- Va por detrás de llama.cpp. Empaqueta paquetes de motor precompilados, así que el soporte de modelos recién salidos puede llegar unos días después.
- Sin Macs Intel. macOS necesita Apple Silicon y macOS 14+.
Coste
Gratis en local. Según LM Studio Pricing, Bionic+ cuesta 20 $/mes por modelos abiertos alojados en EE. UU. y búsqueda web, Pro cuesta 100 $/mes por 5 veces los límites de uso, y la facturación de equipos no tiene precio publicado.
Veredicto
Elige LM Studio si quieres la mejor interfaz gráfica para modelos locales, especialmente en un Mac, donde alterna entre GGUF y MLX por ti. Sáltatelo si necesitas una app de código abierto o la última compilación de llama.cpp el mismo día.
8. Jan
Lo mejor para: una app de escritorio de código abierto al estilo ChatGPT que se queda en local.
Jan es una app de escritorio de código abierto para macOS, Windows y Linux. Su documentación dice "the llama.cpp engine is built into Jan and updates together with the app", con MLX usado en Apple Silicon.
Qué hace mejor que llama.cpp
- Código abierto y amigable. Apache 2.0, unas 45.700 estrellas, una interfaz de chat, y un hub de modelos que descarga un modelo por defecto en el primer inicio.
- Local más nube en una ventana. Añade claves de OpenAI, Anthropic o Google junto a modelos locales, más servidores MCP y búsqueda web.
- Una API local. Un servidor compatible con OpenAI en
127.0.0.1:1337/v1.
"its open source, has a simple chat interface, it uses llama.cpp, it lets you search for models and downloads them, and it supports .gguf so youre not locked in if you want to use the models with another program later on"
Dónde se queda corto
- El mismo motor. Como Ollama y LM Studio, no cambia la velocidad de inferencia.
- Macs Intel. Su motor llama.cpp empaquetado no carga modelos en Macs Intel desde la v0.8.5.
- Funciones nuevas en vista previa. Cowork, el modo de tareas autónomo, todavía está marcado como vista previa.
Coste
Gratis. Sin nivel de pago; su plataforma alojada aparece listada como próximamente.
Veredicto
Elige Jan si quieres la comodidad de LM Studio con una licencia de código abierto. Sáltatelo si necesitas servicio de nivel servidor.
9. LocalAI
Lo mejor para: una sola API autoalojada que cubre texto, imágenes, voz y más.
LocalAI es un motor autoalojado con licencia MIT para modelos de texto, visión, voz, imagen y video, con "more than 80 backends", entre ellos llama.cpp, vLLM, MLX y whisper.cpp.
Qué hace mejor que llama.cpp
- Una API para muchos tipos de modelo. Compatible con OpenAI, más formatos de Anthropic y ElevenLabs, una API en tiempo real y gramáticas restringidas.
- Backends conectables. Cada backend es su propia imagen que se descarga solo cuando un modelo la necesita, y el equipo construye algunos propios, como vllm.cpp.
- Amplitud de hardware. CPU, NVIDIA CUDA 12 y 13, AMD ROCm, Intel, Apple Metal, Vulkan y Jetson.
Dónde se queda corto
- Mayormente un router. Para modelos de texto GGUF, llama.cpp sigue siendo el motor que hace el trabajo.
- Funciones nuevas en builds de desarrollo. Agentes, archivos, sandbox y logins de equipo solo están en builds de desarrollo a partir de v4.12.1.
- Más piezas móviles. Un contenedor por backend es flexible, pero más pesado que un solo binario.
"And if you want to use WSL, then I'd suggest using something like LocalAI which gives you a lot more control and support for additional formats (GGML, GGUF, GPTQ, ONNX, etc)."
Coste
Gratis. Instala con un script, Docker, una app de macOS o Kubernetes.
Veredicto
Elige LocalAI si quieres un único endpoint tipo OpenAI para un home lab o una plataforma interna que sirva más que chat. Sáltatelo si todo lo que ejecutas son modelos de texto, donde el motor puro es más simple.
¿Cuándo deberías quedarte en llama.cpp?
Cuando eres una sola persona en una sola máquina, y especialmente en hardware mixto o poco común. Ninguna alternativa de esta lista cubre tantos backends, desde Vulkan en portátiles AMD hasta Snapdragon y Huawei Ascend. Las arquitecturas de modelos nuevas también tienden a llegar ahí primero: v1.0.0 añadió Kimi-K3.1-Pro y Ripple-65B el día del lanzamiento, y llama-server ya te da una API compatible con OpenAI, una interfaz web y herramientas MCP. La guía de llama.cpp de mi colega cubre la configuración de v1.0.0 en detalle.
Las dos quejas más grandes también son más pequeñas de lo que eran. Las compilaciones ahora son opcionales con la app Llama y las instalaciones con Homebrew o Winget, y la nueva caché MoE en v1.0.0 duplicó la velocidad en una prueba del release, de 24,2 a 47,6 tokens por segundo en Qwen3.8-Flash-Next, con la mayoría de los fallos de expertos gestionados en la CPU (PR #30966).
"I have been using llama.app, which is the desktop interface built on top of llama.cpp by the same people. It is an alternative to Ollama that might interest people who want to switch given Ollama's reputation and previous decisions."
Si ejecutas modelos principalmente para impulsar agentes de código, quédate a menos que hayas medido un cuello de botella. Un agente que espera llamadas a herramientas rara vez necesita el batching de un motor de servidor. Lo mismo vale para los agentes de código abierto que ejecutas en casa.
¿Cuánto cuesta realmente cambiar de llama.cpp?
Todos los motores de esta lista son software gratuito, así que el precio es hardware y horas. Algunas reglas generales de la documentación de arriba:
- vLLM, SGLang y TensorRT-LLM implican un servidor GPU en Linux y alguien que mantenga CUDA, drivers y contenedores actualizados. SGLang ya requiere CUDA 13.
- MLX-LM no cuesta nada extra si ya tienes un Mac de serie M con suficiente memoria unificada.
- ExLlamaV3 implica convertir modelos a EXL3 y mantener una carpeta de modelos separada de tus archivos GGUF.
- Ollama y LM Studio son gratis en local, y solo cobran por sus modelos en la nube, desde 20 $/mes.
Si prefieres no ser dueño de nada de eso, la inferencia alojada como Together AI convierte la factura de hardware en una factura por token. Rastréala de cualquier forma con una herramienta de seguimiento de LLM, porque los modelos locales solo son más baratos si la máquina se mantiene ocupada.
¿Dónde entra eesel si quieres IA en tickets de soporte?
Mucha gente llega a llama.cpp porque quiere una IA que responda a los clientes sin enviar datos a todas partes. Un motor de inferencia es la infraestructura para eso, no el trabajo terminado. Aun tendrías que construir la conexión al helpdesk, la sincronización de conocimiento, las pruebas, el traspaso a personas y los informes. Ese es el trabajo que hace eesel: un motor ejecuta un modelo; eesel es el compañero que hace el trabajo de soporte.
El compañero de IA para helpdesk de eesel se integra en tu cola existente en Zendesk o Freshdesk, responde desde tu centro de ayuda y tickets anteriores, y se prueba con conversaciones históricas antes de responder a un cliente real. SE Ranking opera un agente de eesel por producto en tres productos sobre Zendesk, gestionando 4.650 conversaciones al mes a partir de unas 16.800 páginas de conocimiento, con reembolsos y solicitudes de una persona traspasados al equipo. Orosoft, que construye software para la industria de metales preciosos, lo usa en cambio como copiloto: el personal de soporte menciona a eesel en un ticket de Freshdesk y recibe un borrador basado en unos 6.100 tickets anteriores.
Si ya te sientes cómodo en una terminal, la CLI de eesel es la parte que te va a gustar. Un agente de código como Claude Code o Codex puede usarla para subir conocimiento aprobado como artículos de ayuda y macros exportados, ajustar las instrucciones del agente y hacer preguntas de prueba para comprobar las respuestas antes de que nada salga en vivo. Conectar el helpdesk en sí todavía necesita a alguien con acceso de administrador que lo apruebe.
Prueba eesel
Si el modelo en tu escritorio estaba destinado a acabar respondiendo a clientes, eesel te lleva ahí sin elegir un motor ni comprar una GPU. Se conecta a tu helpdesk en minutos, aprende de tus tickets anteriores, y se prueba primero con conversaciones antiguas, de la misma forma que SE Ranking lo opera en tres productos. Mira los precios primero si quieres. Cuando estés listo, prueba eesel gratis.