

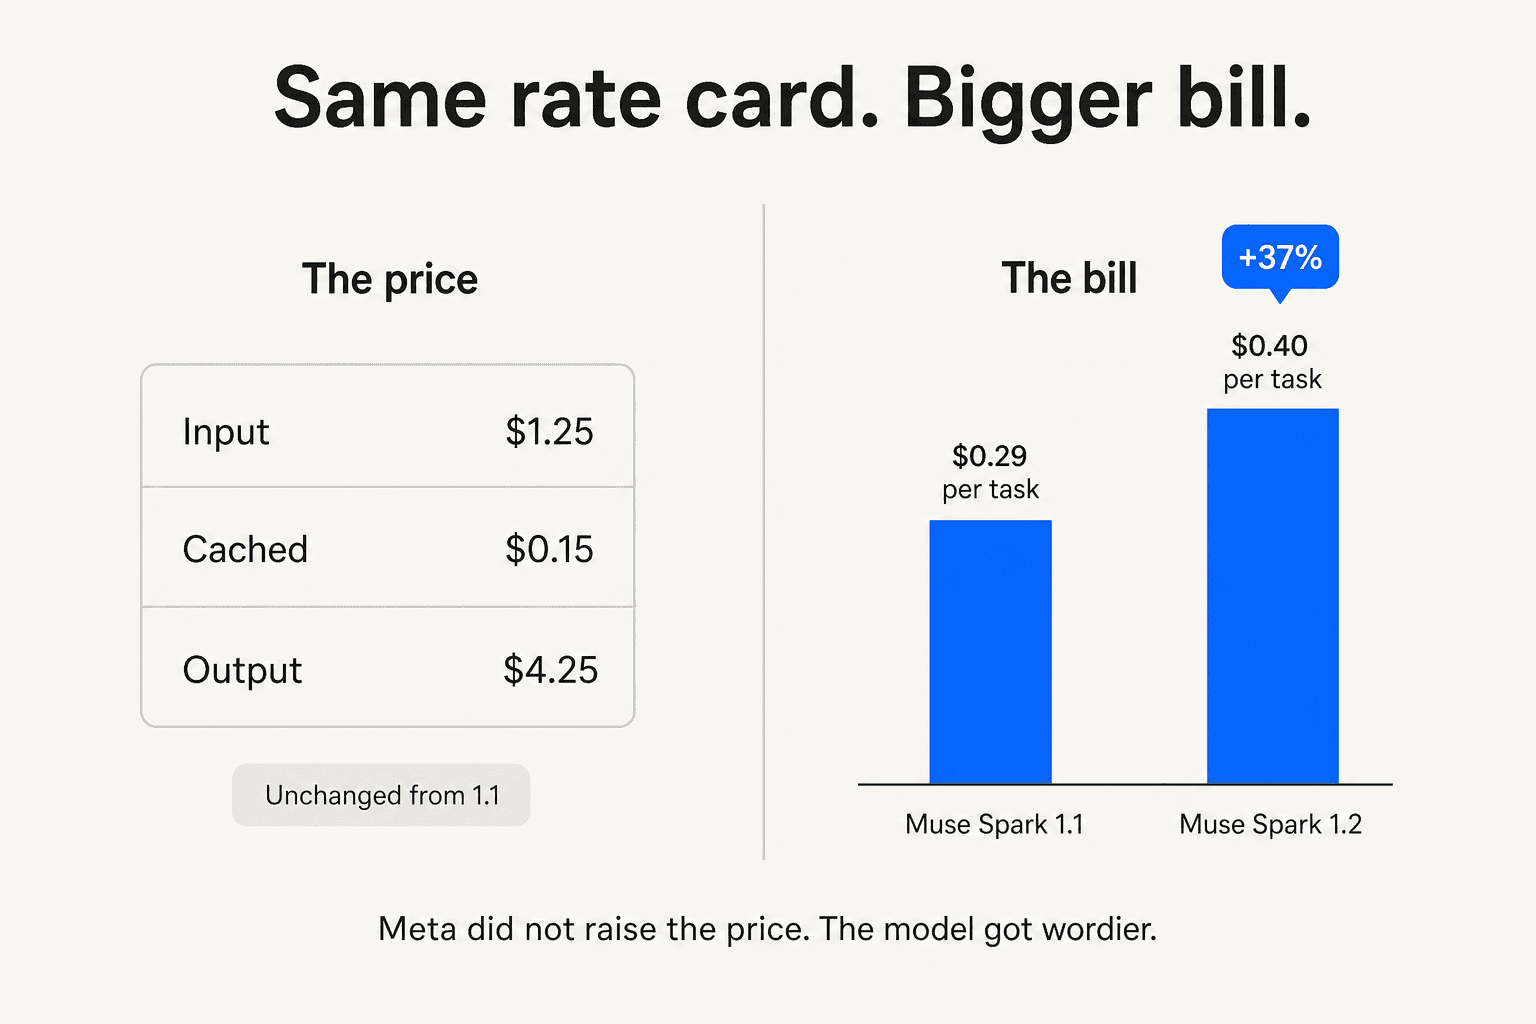
Meta no cambió ni un solo número de la tarifa de Muse Spark, y el modelo sigue costando un 37 % más de ejecutar. El nivel estándar cuesta $1.25 por millón de tokens de entrada, $0.15 en caché, $4.25 de salida, exactamente lo que costaba 1.1. El nivel contributor cuesta $0.10 / $0.002 / $0.20 si dejas que Meta entrene con tu tráfico. Pero Artificial Analysis midió que el costo por tarea de benchmark subió de $0.2923 en 1.1 a $0.3992 en 1.2, y la razón no es la que todos suponían.
El razonamiento se volvió más barato. El dinero extra se fue en lecturas de caché y en la propia respuesta, que creció un 78 % por tarea. Así que el número que vale la pena vigilar es cuántos tokens decide gastar el modelo en tu nombre, algo de lo que la tarifa de Meta no dice nada.
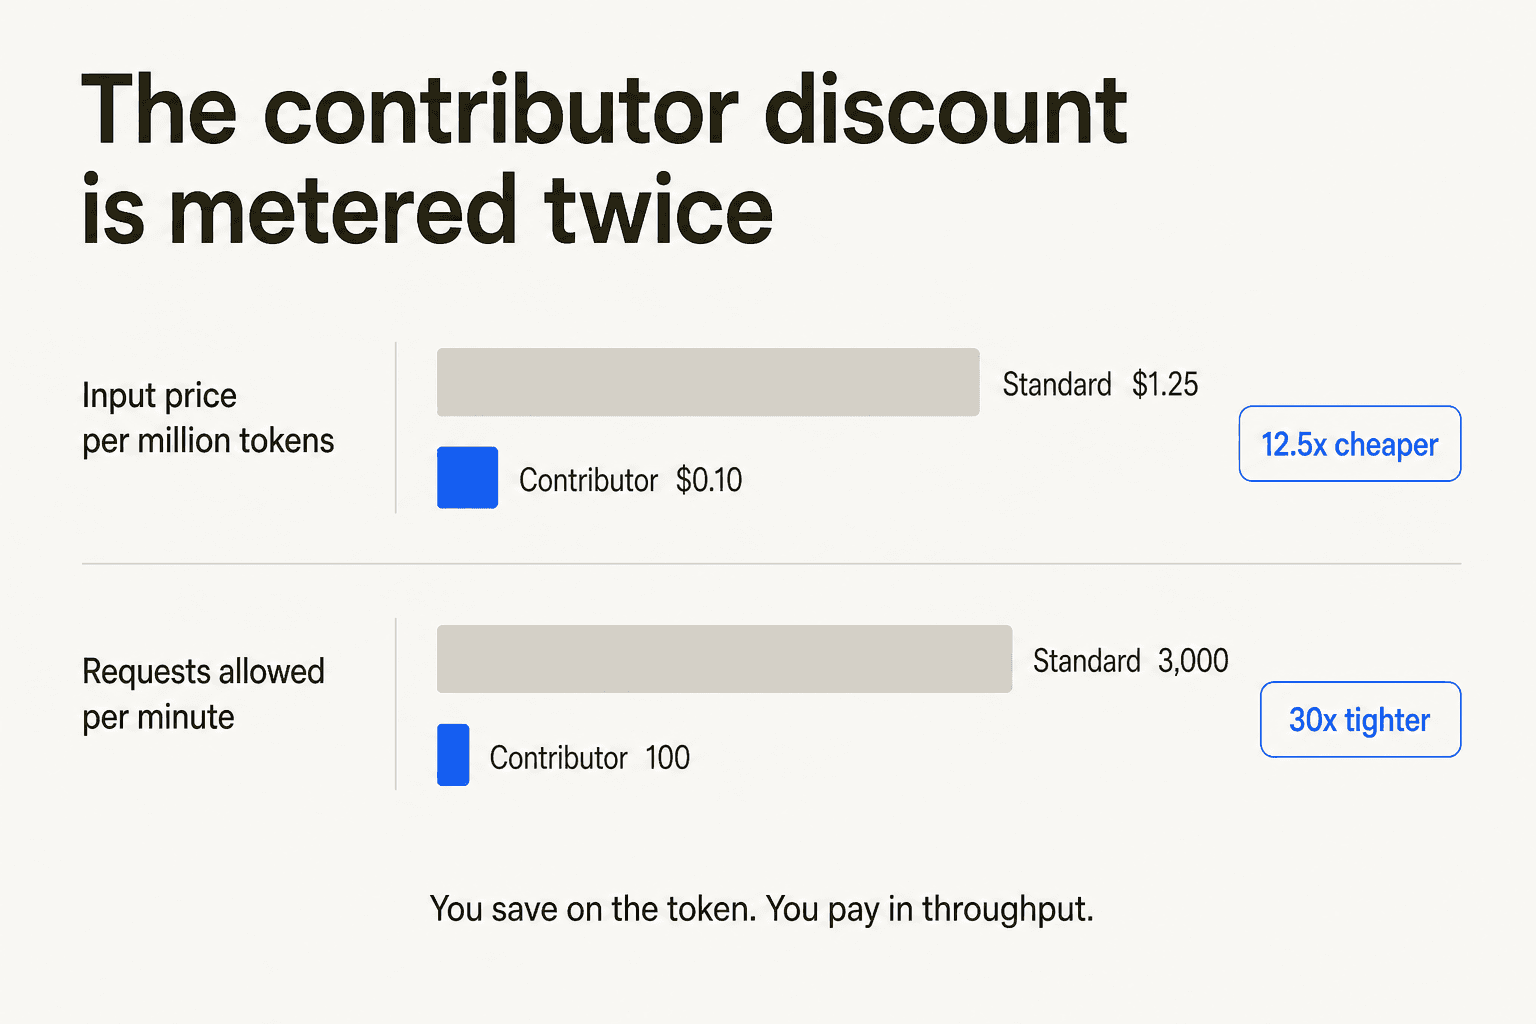
Dos cosas que revisar antes de elegir un nivel. El descuento contributor se mide dos veces: entrada 12.5 veces más barata y un tope 30 veces más ajustado de 100 solicitudes por minuto frente a 3,000. Y quedarte en 1.1 no te ahorra nada, porque Meta fija el mismo precio para ambos checkpoints.
Si estás calculando esto para una cola de soporte y no para un proyecto personal, la respuesta honesta es que ninguna tarifa por token puede prever esa factura. Un ticket resuelto son varias llamadas, recuperación y reintentos. Por eso eesel cobra 1 crédito por ticket, sin importar su duración, y te deja simular el costo con tu propio historial de tickets antes de que algo salga en vivo.
Precios de Meta Muse Spark 1.2, la tarifa completa
Aquí está cada cifra publicada, verificada en las páginas de Meta el 17 de agosto de 2026. Todos los precios son en dólares estadounidenses por millón de tokens.
| ID del modelo | Nivel | Contexto | Entrada | Entrada en caché | Salida | Redacción de la política de datos de Meta |
|---|---|---|---|---|---|---|
muse-spark-1.2-contributor | Contributor | 1,048,576 | $0.10 | $0.002 | $0.20 | "Used to improve our products." |
muse-spark-1.2 | Estándar | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
muse-spark-1.1 | Estándar | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
Esa tercera fila es la que la mayoría de las coberturas pasa por alto. La página de la Model API de Meta lista el checkpoint anterior exactamente al mismo precio, y el documento de precios confirma que ambos checkpoints comparten el precio estándar. No hay un nivel heredado barato al que retroceder. Si el comportamiento de 1.2 te cuesta más, volver a la versión anterior no recupera el dinero, lo cual cambia respecto a cómo se leían los precios de Muse Spark 1.1 en el lanzamiento, cuando era el único checkpoint de la tarifa.
Conviene decir con claridad algunas cosas antes de entrar en lo que oculta la tarifa.
No hay prima por contexto largo. Meta lo dice sin rodeos en la página de precios y límites: pagas lo mismo con la ventana casi vacía que casi llena. Varios proveedores suben el precio al pasar cierto umbral de contexto, y si metes un prefijo grande y estable en cada llamada, esa diferencia se acumula rápido.
El prompt caching es automático y gratuito. El prefix caching de Meta tiene "no flag or key to manage", no hay cargo por escritura de caché en la tarifa y los tokens en caché son un subconjunto con descuento de la entrada, no un recargo. Puedes pedir retención extendida con prompt_cache_retention: "24h", aunque Meta lo llama una sugerencia y no una garantía.
Y el andamiaje de Meta es gratis. La documentación señala que Meta inyecta una pequeña cantidad de contexto de orientación en cada prompt, y que esos tokens "are not billed and are excluded from the token counts reported in your usage." Es un detalle menor, pero es el tipo de cosa que aparece en silencio en otras facturas.
La tarifa no se movió. La factura subió un 37 %.
Esto es lo que hace tan extraño escribir sobre los precios de Muse Spark 1.2. Meta lanzó un modelo nuevo el 5 de agosto, mantuvo el precio, y el costo de hacer el mismo trabajo subió más de un tercio.
Artificial Analysis ejecuta la misma batería de nueve evaluaciones contra cada modelo de frontera, así que la comparación entre versiones es lo más controlada que pueden ser los datos públicos. Publica dos medidas de costo distintas, y conviene mantenerlas separadas porque no se mueven juntas.
El costo ponderado por tarea pasó de $0.2923 en 1.1 a $0.3992 en 1.2, una subida del 36.6 %. El total de ejecutar toda la batería una vez pasó de $547.32 a $639.27, una subida de $91.96 o del 16.8 %. La primera es la cifra que predice lo que te cuesta un trabajo concreto, y es con la que abro. La segunda es la que dice adónde fue el dinero, y la desgloso en la siguiente sección.
Quiero ser cuidadoso con lo que es y no es ese 37 %. Es una carga de benchmark, no tu carga. Pero es el mismo benchmark en ambas versiones, valorado con la misma tarifa, lo que da una lectura limpia de una pregunta: ¿cuánto más gasta este modelo por unidad de trabajo? Más de un tercio más, gratis, sin que nadie anuncie un cambio de precio.
Este es el modo de fallo en el que veo caer a los equipos una y otra vez, y no tiene que ver con Meta en particular. Una vez un prospecto estuvo conmigo en una llamada calculando sus propios números, llegó a unos $30,000 al mes para una empresa que crecía hacia los 150,000 tickets, y toda la confusión venía de la brecha entre la unidad que él contaba y la unidad con la que le facturaban. A otro le cotizaron una asignación mensual de 3,000 interacciones mientras manejaba unos 500 tickets al día con cuatro intercambios cada uno, lo que agota esa asignación en día y medio. Ninguno de los dos era malo con la aritmética. En ambos casos el multiplicador entre "lo que yo cuento" y "lo que tú facturas" fue invisible hasta que llegó la factura. La tarifa de Muse Spark tiene exactamente esa forma.
Adónde fueron realmente los $92 extra
Casi todos, incluida una versión anterior de mi propio análisis de Muse Spark 1.2, supusieron que el salto de costo era pensar más. Los modelos de razonamiento se encarecen razonando más fuerte, y 1.2 se presentó como el checkpoint más inteligente. Es una suposición razonable.
También es incorrecta, y el desglose de costos publicado lo dice.
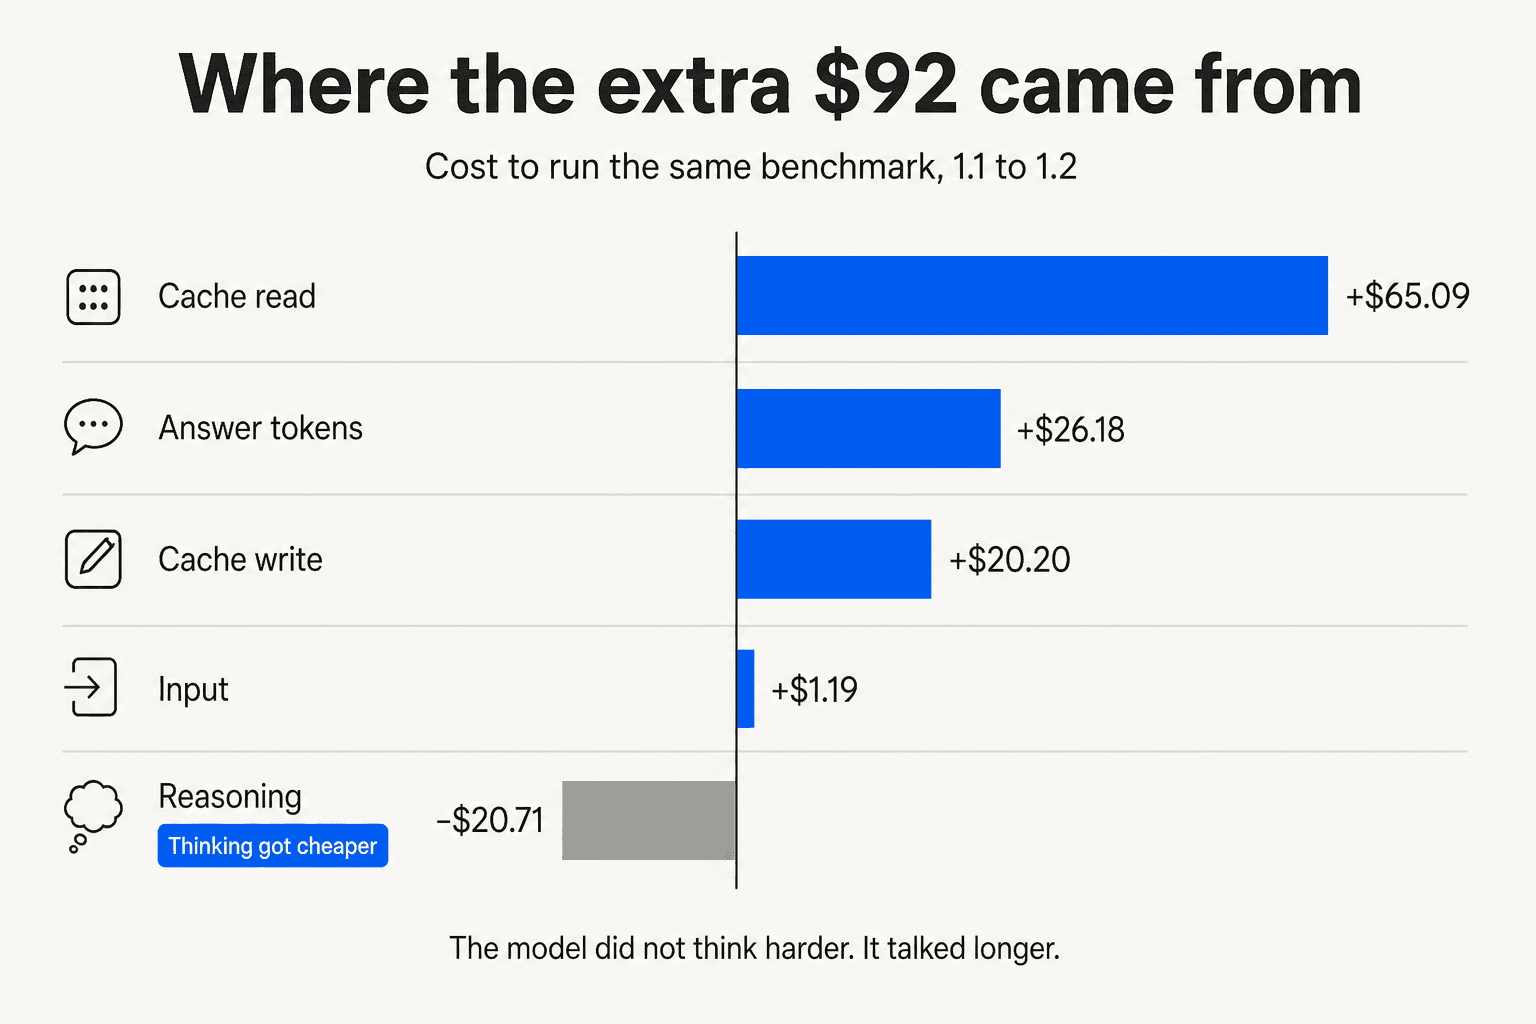
| Tipo de token | Muse Spark 1.2 | Muse Spark 1.1 | Cambio |
|---|---|---|---|
| Razonamiento | $339.82 | $360.53 | -$20.71 |
| Lectura de caché | $136.85 | $71.76 | +$65.09 |
| Escritura de caché | $82.21 | $62.01 | +$20.20 |
| Respuesta (salida) | $63.61 | $37.42 | +$26.18 |
| Entrada sin caché | $16.78 | $15.59 | +$1.19 |
| Total | $639.27 | $547.32 | +$91.96 |
El razonamiento es la única línea que se abarató. 1.2 gastó $20.71 menos en tokens de pensamiento oculto que 1.1. El aumento vino de todo lo demás, y la lectura de caché es el mayor factor, casi el doble.
Los conteos de tokens por tarea explican por qué. Los tokens de respuesta por tarea pasaron de 7,237 a 12,874, un salto del 78 %. Los tokens de razonamiento por tarea subieron solo un 16 %, de 15,158 a 17,557. Mientras tanto, todo el índice corrió con más o menos el mismo presupuesto total de salida en ambos casos, 95 M de tokens contra 94 M.
La traducción práctica es esta: Muse Spark 1.2 no piensa más fuerte que 1.1, escribe más largo. Si tu carga ejecuta agentes de IA en varios turnos, las respuestas más extensas vuelven directo al contexto de la siguiente llamada, que es justo el mecanismo que duplicó la línea de lectura de caché. La verbosidad se acumula de una manera en que el simple pensamiento no lo hace.
Eso es una palanca que sí puedes mover. Pide respuestas más cortas, limita los tokens de salida y recorta las partes de tu cadena de prompts que arrastran respuestas anteriores. Es optimización de LLM corriente, la misma disciplina que mantiene predecibles los precios de la API de Anthropic, y la misma razón por la que la API de OpenAI sorprende a quienes nunca miran la longitud de la salida.
El nivel contributor es 12.5 veces más barato y 30 veces más estrecho
La estructura de dos precios es lo que todos citan de Muse Spark, y suelen citarlo mal, porque el descuento es distinto en entrada y salida. La entrada baja 12.5 veces. La salida baja 21.25 veces. La entrada en caché baja 75 veces.
El planteamiento de Meta es inusualmente directo. La documentación describe contributor como "heavily discounted token pricing in exchange for permission" para entrenar futuros modelos con tus prompts y respuestas, pensado para "prototyping, testing integrations, and scaling experiments where training on your data is acceptable." Y el nivel no es un ajuste de cuenta que se activa. En palabras de Meta, "Tier is a model attribute". Para no participar en el entrenamiento llamas a otro ID de modelo.
El hilo de Hacker News del día del lanzamiento giró casi por completo en torno a si ese trato es justo, y la división fue marcada.
"What are you talking about? This is one of the most honest offers ever made by a corporation. "We'll use your data, and we'll compensate you for it." Where is the problem?"

No todos coincidieron en que la promesa del nivel estándar valga la prima. Cuando un comentarista argumentó que Meta entrena con todo sin importar la factura, Simon Willison respondió con un retrato sarcástico de lo que implica esa acusación: que una empresa imprimiría dos políticas de datos y violaría una a sabiendas. La diferencia contractual es el producto.
Pero el argumento que nadie estaba haciendo es el que más importa para un presupuesto de producción. Estos son los límites publicados:
| Nivel | Solicitudes por minuto | Tokens por minuto |
|---|---|---|
| Estándar | 3,000 | 4,000,000 |
| Contributor | 100 | 3,000,000 |
El nivel contributor cuesta 12.5 veces menos por token de entrada y permite 30 veces menos solicitudes por minuto. El tope de tokens solo baja un 25 %, así que la limitación es desigual a propósito. Meta apretó específicamente la vía de solicitudes. Contributor tiene precio de volumen y barrera de prototipo, una decisión de producto coherente y una mala sorpresa si la descubres después de construir sobre él.
Un usuario de X se topó con eso directamente y lo dijo en cinco palabras: las solicitudes por minuto "seem to be severely limited". Es el único informe concreto de límites que pude encontrar en una plataforma verificable, lo que indica lo pocos que han llevado contributor más allá de una carga de pasatiempo.
Dos mecánicas más que conviene conocer antes de planificar con estas cifras. Los límites se agrupan por equipo, no por clave de API, así que añadir claves no añade margen. Y las respuestas en segundo plano tienen un tope aparte de 600 envíos por minuto por equipo, además de RPM y TPM.
Averigua qué nivel puedes usar realmente
El precio es la segunda pregunta. El rendimiento es la primera, porque ningún descuento ayuda si el techo está por debajo de tu piso. Introduce aquí tus números y la respuesta sale sola.
Los medidores junto al medidor de tokens
Las tarifas de tokens son el titular, y no son toda la factura. Otras cuatro cosas cobran o te limitan.
El grounding con búsqueda web se mide aparte a $2.50 por cada 1,000 consultas de búsqueda, cobrado además de los tokens de la solicitud. Si tu agente fundamenta cada respuesta con búsqueda, es un segundo medidor corriendo en paralelo al primero, y es el que más probablemente falte en una hoja de cálculo hecha a partir de la página del modelo.
No hay API por lotes ni descuento por lotes. La navegación de la documentación no lista ninguna superficie de lotes. La única vía asíncrona son las respuestas en segundo plano, que son un modo de envío con su propio tope y no un nivel con descuento. Si planeabas con los descuentos por lotes que publican otros proveedores, ese ahorro no existe aquí.
No hay oferta de fine-tuning para Muse Spark. El documento de modelos lista tres IDs de modelo de inferencia y nada más. El fine-tuning en el sitio para desarrolladores de Meta es territorio de pesos de Llama, un producto distinto con otra estructura de costos.
No hay un tope de gasto estricto, y esa es la queja que realmente frenó los registros. Dos usuarios distintos de Hacker News dijeron lo mismo el mismo día.
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
Es una carencia de UX de facturación y no de precios, y se arregla en una tarde, pero vale la pena saber que en un modelo cuyo planteamiento entero son tokens baratos, lo que bloquea la conversión es la ausencia de un techo.
Cómo se comparan los precios de Muse Spark 1.2
Las tarifas de lista halagan y engañan en ambos sentidos, así que la columna que importa es el costo medido por tarea en un benchmark fijo. Aquí está Muse Spark frente a los modelos con los que realmente compite, usando las cifras del ranking de Artificial Analysis.
| Modelo | Intelligence Index | Costo por tarea | $/Mtok combinado | Entrada | Salida |
|---|---|---|---|---|---|
| Claude Opus 5 (max) | 63.05 | $2.34 | $3.85 | $5.00 | $25.00 |
| GPT-5.6 Sol (max) | 60.93 | $1.23 | $4.35 | n/a | n/a |
| Kimi K3 (max) | 59.70 | $0.84 | $2.31 | $3.00 | $15.00 |
| Qwen3.8 Max | 58.08 | $1.13 | $1.18 | $2.00 | $6.00 |
| Muse Spark 1.2 (xhigh) | 56.76 | $0.40 | $0.78 | $1.25 | $4.25 |
| GPT-5.6 Terra (max) | 56.58 | $0.51 | $1.74 | n/a | n/a |
| Gemini 3.7 Flash (high) | 56.03 | $0.40 | $0.58 | $0.75 | $3.75 |
| GPT-5.6 Luna (max) | 52.32 | $0.05 | $0.17 | n/a | n/a |
| DeepSeek V4 Flash (max) | 51.77 | $0.11 | $0.23 | $0.44 | $1.32 |
La lectura desde el lado del comprador es sencilla, y es una buena noticia para Meta. Muse Spark 1.2 es el modelo más barato de esa tabla con puntuación superior a 56. Todo lo más inteligente cuesta al menos 2.8 veces más por tarea. Opus 5 cuesta 5.9 veces más. La comparación más directa es GPT-5.6 Terra, que puntúa prácticamente igual y cuesta $0.51 frente a $0.40 de Muse Spark, así que Meta es un 22 % más barata con la misma inteligencia.
Una corrección que conviene señalar, porque confunde las comparaciones entre publicaciones. Artificial Analysis mezcla a razón de 7:2:1 de acierto de caché, entrada y salida en estas páginas, no la antigua proporción 3:1 de entrada a salida que circula ampliamente. La cuenta cuadra: (0.7 × $0.15) + (0.2 × $1.25) + (0.1 × $4.25) = $0.78. Si ves una cifra combinada calculada con un supuesto 3:1, no es comparable con esta tabla.
Y GPT-5.6 Luna es la fila que rompe cualquier relato simple de que barato significa débil: $0.05 por tarea, ocho veces más barato que Muse Spark, con 52.3 en el índice. Mi análisis de GPT-5.6 Luna explica a qué renuncia para llegar ahí.
Para las filas inmediatamente por encima de Muse Spark, los precios de Kimi K3 tienen la tarifa completa. La opción de pesos abiertos en el extremo barato de la tabla está en mi reseña de DeepSeek V4 Flash.
Lo que la tarifa deja fuera
Un artículo de precios debe ser tan claro con los huecos como con los números, porque en los huecos es donde un presupuesto sale mal.
La velocidad y la latencia no están publicadas para 1.2. Artificial Analysis no tiene medición de velocidad de salida, tiempo hasta el primer token ni respuesta de extremo a extremo para este checkpoint, y el ranking muestra un guion en las tres columnas. Muse Spark 1.1 sí las tiene, con 225.9 tokens por segundo y 1.38 segundos hasta el primer token, pero pertenecen al checkpoint antiguo y no deben atribuirse a 1.2. Si el tiempo de respuesta forma parte de tu caso de costos, estás esperando datos que todavía no existen.
No hay programa de retención cero de datos. Revisé toda la navegación de la documentación y no encontré ninguna página de retención de datos, privacidad o ZDR, ni de autoservicio ni con venta asistida. El control más cercano es un indicador de almacenamiento de respuestas: store: false en la Responses API impide que GET /v1/responses/{id} devuelva tu respuesta, y Meta aclara que "does not disable caching." El nivel es la única palanca de datos que existe.
La API sigue en vista previa pública. La página de producto de Meta ahora abre con "Public preview. Now available with expanded global access", que es mejor que el planteamiento con restricción geográfica del lanzamiento, pero una vista previa es una vista previa. Los precios y límites de una superficie en vista previa pueden cambiar de una forma en que no cambia una tarifa de disponibilidad general.
Y uno más pequeño que importa si pruebas el nivel barato: el acceso puede retirarse. Un desarrollador publicó un 403 en medio del trabajo, sin aviso previo, con el texto "Your access has been restricted due to repeated policy violations". Contributor tiene precio de promoción y barreras de promoción.
Lo que pagó realmente un desarrollador
Todo lo anterior son precios de lista y ejecuciones de benchmark. El dato más útil que encontré es alguien que informa del costo real de su sesión, algo más raro de lo que debería ser.
"even with this subsidized pricing, less than an hour of usage resulted in slightly over $1 of cost (fig. 1). if i do this all month it'll be more expensive than the highest Anthropic/OpenAI subscription"
Eso fue en el nivel contributor, el barato, el que la gente llamaba absurdamente subvalorado el día del lanzamiento. Una hora de trabajo de programación con agentes salió en más de un dólar a $0.10 por millón de tokens de entrada.
Lo mismo apareció en un profesional de LinkedIn al día siguiente del lanzamiento, planteado como una advertencia y no como un recibo.
"But token price isn't the full picture. What matters is cost per task. Different models burn different amounts of tokens to solve the same problem. We don't have that data yet for Muse Spark 1.2. Cheap tokens mean nothing if the model takes twice as many shots to get there."

Lo escribió antes de que existieran los datos de costo por tarea. Los datos llegaron y le dieron la razón, en una dirección que nadie predijo: 1.2 quema más tokens que su predecesor porque responde más largo, mientras que su razonamiento se abarató un poco.
Por qué los tokens son la unidad equivocada para una cola de soporte
He pasado tres años en eesel viendo cómo la IA atiende colas de soporte en vivo, y en todo ese tiempo nunca he visto a un equipo prever con éxito una factura de soporte a partir de una tarifa por token. La aritmética es bastante fácil. La unidad simplemente no sobrevive al contacto con un ticket real.
Un ticket resuelto no es un prompt. Es recuperación en un centro de ayuda y una biblioteca de macros, una pasada de clasificación de tickets, una pasada de redacción, normalmente un reintento cuando el primer borrador es incorrecto, a veces una llamada a una herramienta para consultar un pedido, y luego toda la conversación arrastrada como contexto cuando el cliente responde. Cada uno de esos pasos multiplica. Una tarifa baja por token multiplicada por un número desconocido de pasos no es un presupuesto, es una esperanza. Qué modelo elijas importa mucho menos que esa estructura, como argumenté al elegir el mejor modelo para tickets de soporte.
Y puedes ver cómo sale mal con números reales. Los equipos de soporte subestiman rutinariamente por un factor, y los que más se queman son los de mayor volumen, precisamente porque el multiplicador se acumula. Es la misma trampa estructural que la historia de Muse Spark 1.2: la tarifa se quedó quieta y el consumo se movió. Mi desglose del costo del servicio al cliente con IA tiene el panorama más completo de lo que los equipos acaban pagando.
Por eso eesel cobra 1 crédito por ticket, sin importar su duración, en lugar de por token o por asiento, y es lo primero que le digo a quien llega con una tarifa por token en la mano. Una resolución es la unidad que el negocio ya cuenta, corresponde a algo que un responsable de soporte puede defender en una reunión de presupuesto, y no se reprecia en silencio cuando un modelo empieza a escribir respuestas más largas. El mismo argumento está detrás de mi enfoque de costo por resolución.
También es la razón por la que el medidor pertenece al sistema de tickets y no al modelo, y por la que la comparación honesta para un responsable de soporte es contra una persona y no contra una API. Lo desarrollé en el costo de IA frente a agente humano.
La otra mitad es conocer el número antes de comprometerte con él. Simulo cada despliegue con los tickets históricos del propio cliente primero, lo que da una tasa de resolución y un costo con tráfico real y no con un benchmark. Ese hábito vino de ver bots de apariencia confiada dar respuestas incorrectas en silencio en producción, una disciplina propia que se cubre en prevenir las alucinaciones de la IA, y de paso resuelve también el problema de la previsión. Hay más sobre eso en la guía de construir o comprar, que es la decisión que la mayoría de los lectores de una tarifa realmente están tomando.
Prueba eesel
Si estás calculando Muse Spark 1.2 porque planeas construir automatización de soporte sobre una API de modelo en bruto, la tarifa por token es el número menos interesante del proyecto. eesel se instala sobre tu helpdesk, lee tu base de conocimiento existente y los tickets pasados, y empieza a resolver conversaciones de primera línea en minutos, a 1 crédito por ticket, de modo que la factura sigue al trabajo hecho y no a los tokens gastados.
Lo primero que vale la pena probar es la simulación. Apúntala a tu historial de tickets y, antes de que nada llegue a un cliente, obtienes una tasa de resolución y un costo proyectado con tu propio tráfico, que es la previsión que una tarifa por token estructuralmente no puede darte.

Un responsable de ingeniería que pasó exactamente por esta decisión explicó su razonamiento con claridad. De forma anónima, dirige una empresa de hardware de cajeros de Bitcoin con una base de conocimiento de más de 300 artículos en Confluence y Telegram:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Gratis para probar, y puedes ver los números simulados antes de decidir nada.
El veredicto sobre los precios de Muse Spark 1.2
Con $1.25 de entrada y $4.25 de salida, Muse Spark 1.2 es la mejor relación calidad-precio de la tabla de frontera por encima de 56 en el índice de inteligencia, y Meta merece reconocimiento por no reajustar el precio con la mejora, por no cobrar nada extra por contexto largo y por hacer el caching automático en lugar de un ejercicio de configuración.
Lo que hay que tener en cuenta al planificar es que el modelo se volvió un 37 % más caro de ejecutar sin que el precio cambiara, porque responde un 78 % más largo que 1.1. Limita tus tokens de salida, vigila lo que arrastra tu cadena de prompts y revisa tu pico de solicitudes por minuto antes de asumir que el nivel contributor está disponible para ti.
Y si la carga es una cola de soporte, calcúlala en resoluciones. Es la única unidad que ha sobrevivido a una factura real.