Las 8 mejores alternativas a MAI-Transcribe-2 en 2026

Kira

Katelin Teen
Última edición September 8, 2026
MAI-Transcribe-2 es el nuevo modelo de voz a texto de Microsoft AI, y es excelente: una tasa media de error por palabra del 5,2 % en 60 idiomas y un precio de lanzamiento de 0,10 $ por hora. Si encaja en tu stack, es una de las opciones más sólidas que hay. Pero ese precio es una promoción, es una vista previa solo por lotes sin SLA y vive dentro de Azure, así que muchos equipos querrán otra opción.
Estas son las ocho mejores alternativas y la razón en una línea para elegir cada una:
- Google Gemini 3.5 Transcribe - la precisión más parecida, y la opción obvia si ya estás en Google.
- ElevenLabs Scribe v2 - lo mejor para medios y doblaje, con identificación de 32 hablantes y etiquetado de eventos de audio.
- Deepgram - la elección para agentes de voz en tiempo real y streaming telefónico.
- AssemblyAI - transcripción más una capa integrada de resúmenes, sentimiento y redacción de datos sensibles.
- OpenAI GPT-Transcribe - el más fácil de acoplar a un flujo existente de OpenAI.
- Speechmatics - la mayor cobertura de idiomas y despliegue local real.
- Amazon Transcribe - la opción por defecto si tus datos ya están en AWS.
- OpenAI Whisper - el modelo gratuito y de código abierto que alojas tú.
Una cosa que conviene decir desde el principio, porque construyo agentes de IA en eesel y eso condiciona cómo leo toda esta categoría: una transcripción precisa no es lo que nadie quería de verdad. Es la materia prima. Elijas el modelo que elijas, alguien tiene que leer el texto, encontrar la respuesta y resolver el ticket, y eso es un trabajo distinto de la transcripción.
Por qué mirar más allá de MAI-Transcribe-2
Primero, seamos justos con el modelo establecido, porque se lo gana. MAI-Transcribe-2 está en lo más alto de la comparación de precisión FLEURS de Microsoft, transcribe una hora de audio en unos diez segundos y, a 0,10 $ por hora, deja a todos por debajo. Cuando leí los primeros comentarios de desarrolladores, las reacciones eran de las que no se pueden fingir. Un desarrollador independiente le pasó un clip difícil del mundo real:
"Probé a pasarle una homilía en eslovaco con mucho eco... Lo hizo mucho mejor que ElevenLabs, al 45 % del precio."
El audio ruidoso, con eco y que no está en inglés es justo lo que rompe a los modelos más flojos, así que es una señal real. Entonces, ¿por qué buscar en otro sitio? Por tres razones concretas, ninguna de ellas una crítica al modelo en sí.
Primero, el precio es un blanco móvil. Esos 0,10 $ son una promoción de lanzamiento que dura "hasta finales de año", y Microsoft no ha dicho qué pasará después. Como referencia, el anterior MAI-Transcribe-1.5 sigue costando 0,36 $ por hora, así que una tarifa estándar de v2 en ese rango no sorprendería a nadie. Un comentarista de Hacker News hizo exactamente la pregunta que Microsoft dejó abierta:
"¿se puede usar para streaming o solo por lotes? ¿dan el precio para cuando acabe el descuento de lanzamiento (hasta fin de año)?"

Segundo, es una vista previa pública lanzada sin SLA, que Microsoft marca como no apta para producción, y la API principal solo funciona por lotes con un límite de archivo de 300 MB. El audio en vivo requiere una configuración aparte de Voice Live. Tercero, es un modelo de Azure, así que se accede a él mediante Azure Speech, un área de pruebas para desarrolladores o enrutadores de terceros, no mediante una aplicación independiente. Si estás construyendo en otro sitio, esa gravedad del ecosistema es un coste real.
Nada de eso hace de MAI-Transcribe-2 una mala opción. Solo significa que "el más barato y preciso hoy" no es lo mismo que "el que mejor encaja con tu proyecto", y en esa brecha viven estas alternativas.
Cómo las comparé
He pasado mucho tiempo dentro de estas API, leyendo la documentación, las páginas de precios y las listas de parámetros, así que elegí las dimensiones que realmente cambian tu arquitectura, no los puntos de marketing. Importan cinco cosas:
- Precisión, medida como tasa de error por palabra (WER, el porcentaje de palabras que el modelo falla). Cuanto menor, mejor.
- Precio por hora de audio, normalizado para poder comparar en igualdad de condiciones.
- Lotes frente a tiempo real, porque un modelo solo por lotes no puede alimentar a un agente telefónico en vivo por muy preciso que sea.
- Identificación de hablantes y marcas de tiempo, las etiquetas de hablante y la sincronización palabra a palabra que convierten un muro de texto en algo utilizable.
- Despliegue, es decir, si puedes ejecutarlo en tu propio hardware o debes enviar el audio a la nube del proveedor.
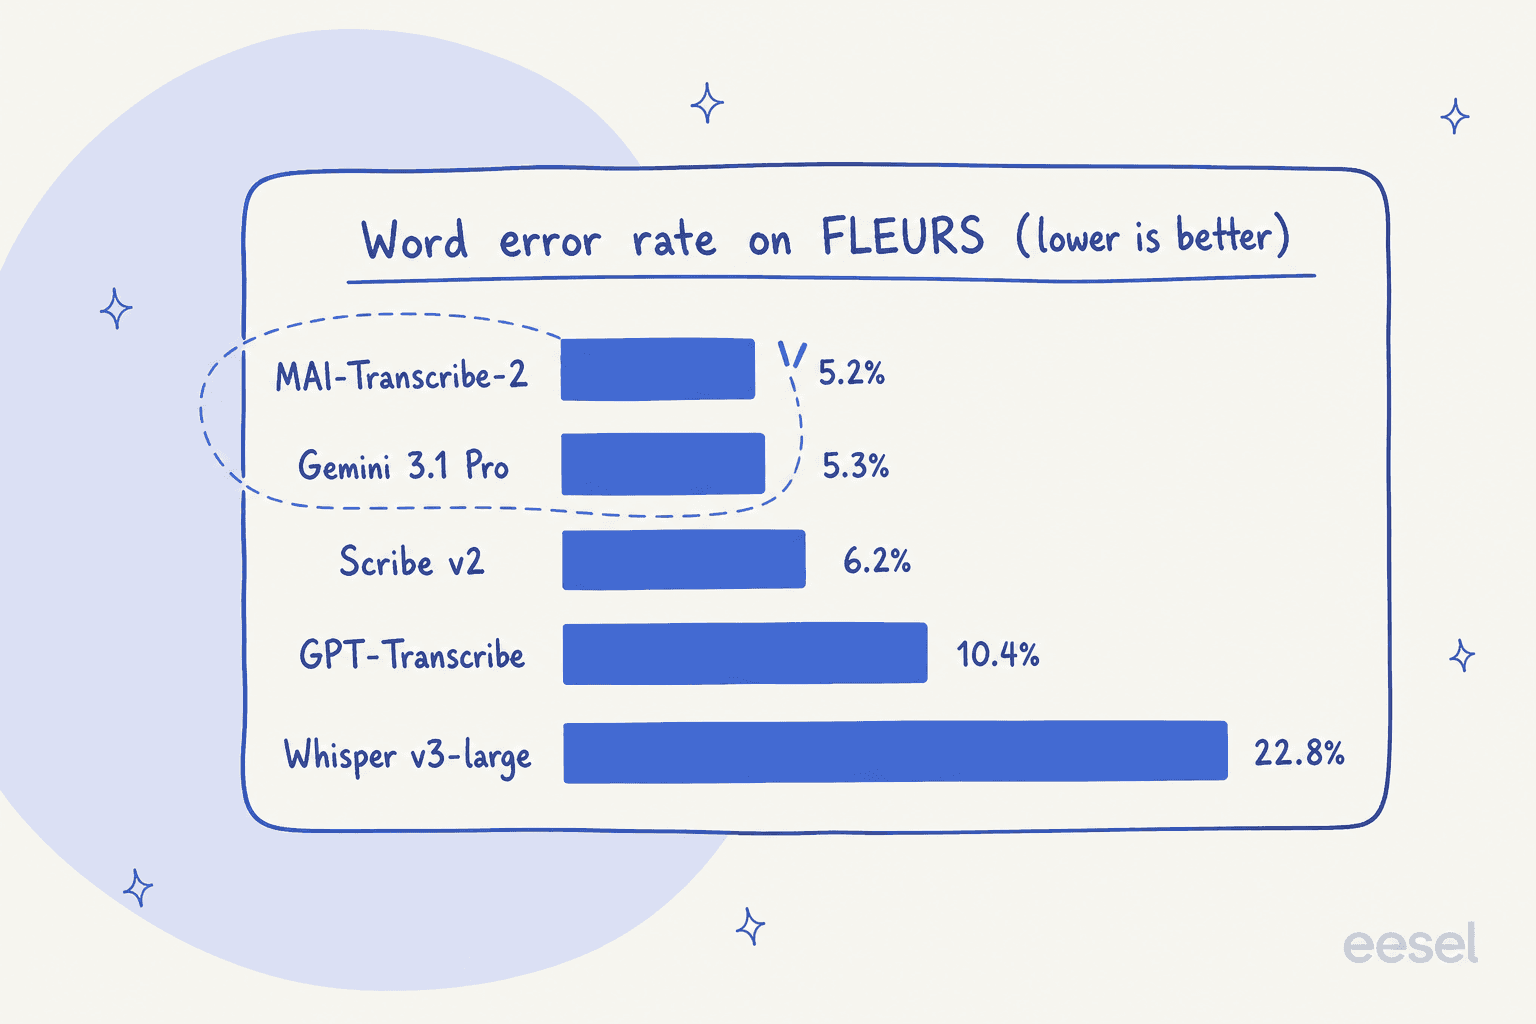
En precisión pura, así queda el campo en la propia comparación FLEURS de Microsoft. Conviene interiorizar una cosa de este gráfico: la cima es un empate casi total, y la verdadera diferencia está entre los líderes y el Whisper abierto, más antiguo.
Las mejores alternativas a MAI-Transcribe-2 de un vistazo
Antes de los análisis detallados, aquí está todo el campo en una tabla. Los precios son por hora de audio para transcripción estándar por lotes, convertidos de la tarifa por minuto o por token publicada por cada proveedor.
| Modelo | Mejor para | Precio por lotes/h | Streaming en tiempo real | Idiomas | Identificación de hablantes | Alojamiento propio | Nivel gratuito |
|---|---|---|---|---|---|---|---|
| MAI-Transcribe-2 | Lotes multilingües más baratos | 0,10 $ (promo) | Solo mediante Voice Live | 60+ | Sí | No | No |
| Gemini 3.5 Transcribe | Precisión más cercana | ~0,30 $ | Sí (modelo live) | 85+ | Hasta 8 | No | Sí |
| ElevenLabs Scribe v2 | Medios y doblaje | 0,22 $ | Sí (realtime) | 90+ | Hasta 32 | No | 10.000 créditos/mes |
| Deepgram | Agentes de voz en tiempo real | 0,26 $ | Sí (punto fuerte) | 40+ | Sí | Sí (Enterprise) | 200 $ de crédito |
| AssemblyAI | Inteligencia de audio | 0,21 $ | Sí | 99+ | Sí | No | 185 h |
| OpenAI GPT-Transcribe | Flujos nativos de OpenAI | 0,27 $ | Salida en streaming | 99+ | Modelo aparte | No | No |
| Speechmatics | Amplitud de idiomas, local | 0,24 $ | Sí (<1 s) | 55+ | Sí | Sí (Enterprise) | 100 $ de crédito |
| Amazon Transcribe | Equipos que ya usan AWS | 0,36 $ | Sí | 100+ | Sí | No | 60 min/mes (12 meses) |
| Whisper (código abierto) | Coste de API cero | 0 $ (alojamiento propio) | No (lotes) | 99+ | Complemento | Sí | Gratis |
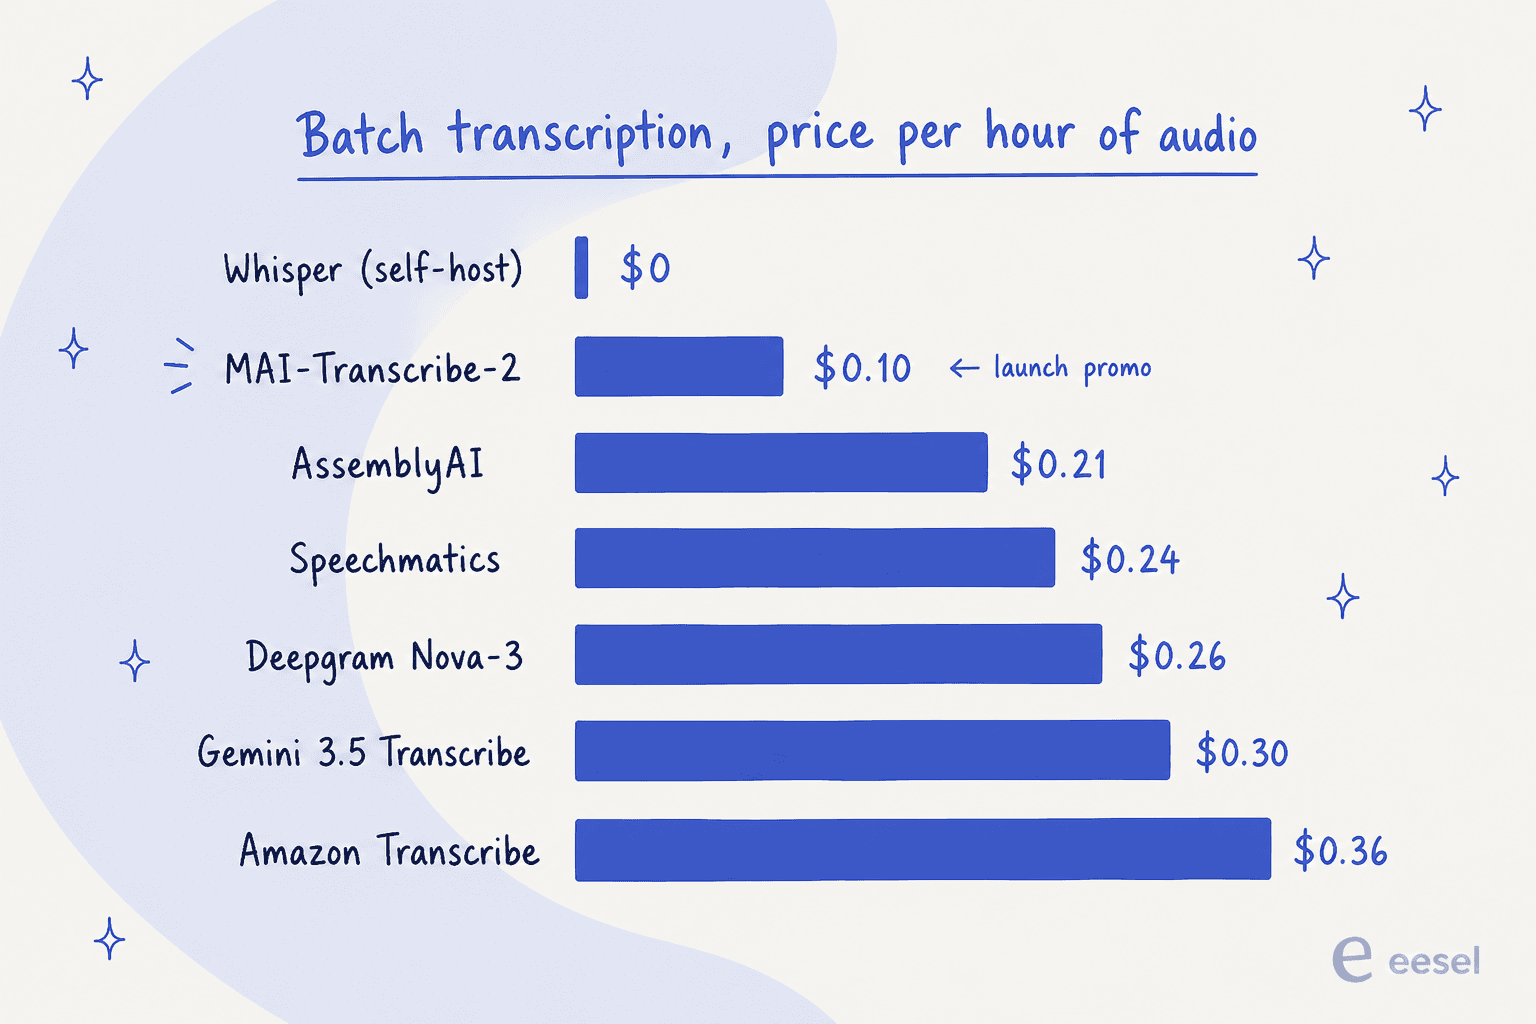
Los precios por lotes de pago se agrupan mucho más de lo que la mayoría espera. Cuando termine la promoción de MAI-Transcribe-2, todo el campo queda a pocos céntimos de distancia.
1. Google Gemini 3.5 Transcribe
Mejor para: equipos que quieren la precisión más cercana a MAI-Transcribe-2 y ya construyen sobre Google.
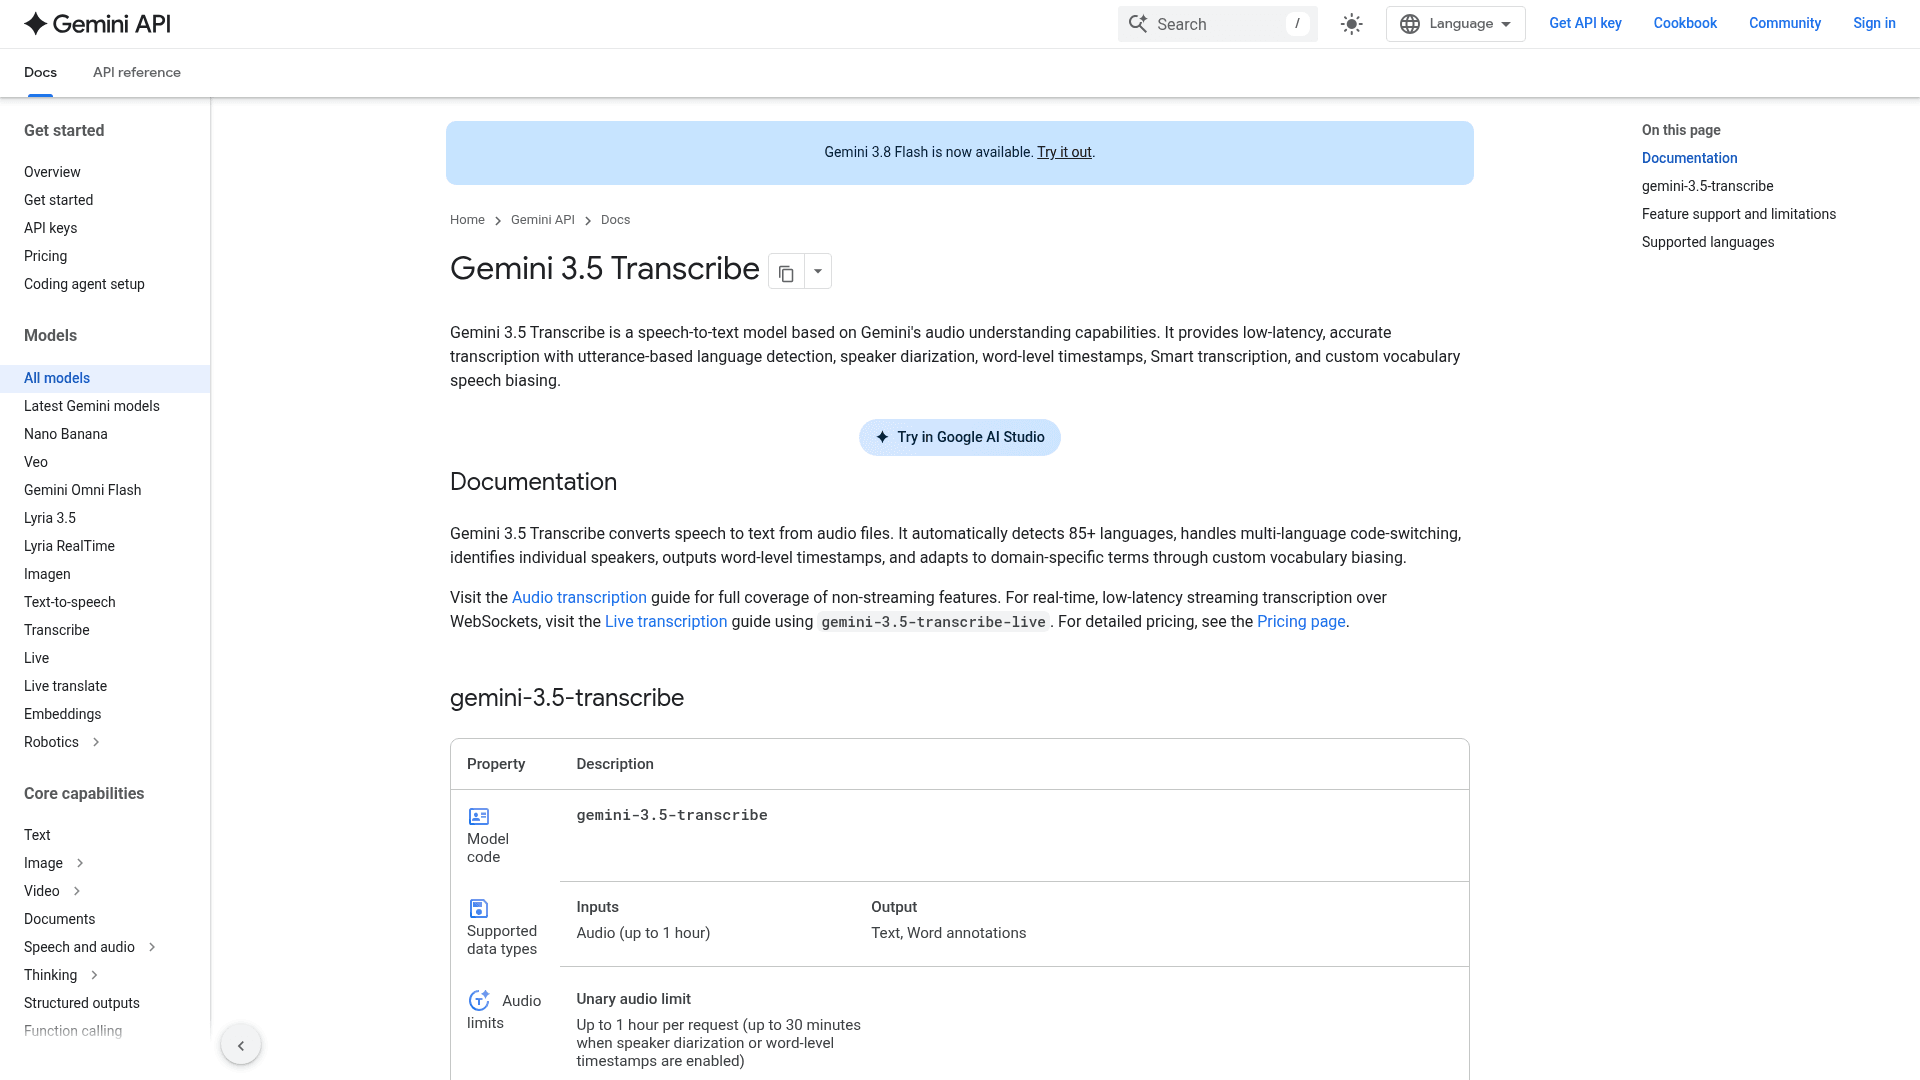
Google es la alternativa que iguala a MAI-Transcribe-2 cara a cara. En la propia tabla FLEURS de Microsoft, Gemini 3.1 Pro registra un 5,3 %, una décima por detrás, y Google además ofrece un modelo de voz a texto dedicado, gemini-3.5-transcribe, más una variante de streaming gemini-3.5-transcribe-live. Esa división importa: el modelo de archivos admite audio de hasta una hora por solicitud (30 minutos si activas la identificación de hablantes o las marcas de tiempo por palabra), mientras que el modelo live hace streaming de baja latencia mediante WebSockets.
Obtienes un conjunto completo de funciones: más de 85 idiomas con cambio de idioma a mitad de frase, identificación de hasta ocho hablantes, marcas de tiempo por palabra y sesgo de vocabulario personalizado de hasta 1.000 términos. Se parece más a una pila completa de comprensión de audio que a un simple endpoint de transcripción.
En cuanto al precio, el modelo dedicado se cobra por tokens: la entrada de audio cuesta 2,00 $ por millón de tokens y la salida de texto 12,00 $ por millón, lo que resulta en una tarifa combinada de aproximadamente 0,005 $ por minuto, o unos 0,30 $ por hora. Hay un nivel gratuito para probar, una buena rampa de entrada.
Nuestra opinión: si la precisión es tu único factor decisivo y no estás casado con Azure, esta es la opción. Es el único modelo que se codea con MAI-Transcribe-2 en el benchmark, y tener una variante de streaming propia cierra la gran carencia que deja MAI. El inconveniente es que Google no ha publicado un WER propio destacado, así que para las cifras exactas confías en la comparación de Microsoft.
2. ElevenLabs Scribe v2
Mejor para: equipos de medios, pódcast y doblaje que necesitan etiquetas de hablante detalladas y etiquetado de eventos de audio.
ElevenLabs se hizo un nombre en la generación de voz, y Scribe es su lado de voz a texto. El buque insignia actual es scribe_v2, con una variante scribe_v2_realtime que ronda los 150 ms de latencia. En la comparación FLEURS de Microsoft queda en el 6,2 %, un paso por detrás de los líderes pero en muy buena compañía, y la propia ElevenLabs afirma más del 98 % de precisión de transcripción con desgloses de WER por idioma.
Donde Scribe se adelanta es en la riqueza de la salida. Cubre más de 90 idiomas, identifica hasta 32 hablantes (el máximo de esta lista), etiqueta eventos de audio dinámicos como risas y música, y reconoce 65 tipos de entidades. Para quien corta subtítulos o transcribe grabaciones con varios hablantes, ese detalle es todo el sentido.
El precio se factura por hora: Scribe v2 cuesta 0,22 $ por hora por lotes y 0,39 $ en tiempo real, con complementos como detección de entidades (+0,070 $/h) y prompting de términos clave (+0,050 $/h). El nivel gratuito da 10.000 créditos al mes, aunque sin licencia comercial. Un desarrollador resumió el atractivo práctico en Hacker News:
"El modelo Scribe de ElevenLabs también es especialmente bueno en precisión, y lo uso para transcripciones de alta calidad o subo archivos a mano a su API para obtener identificación de hablantes y marcas de tiempo."
Nuestra opinión: Scribe v2 es el modelo a batir para trabajo de medios, donde la identificación de 32 hablantes y el etiquetado de audio se ganan su sitio. Va algo por detrás en WER bruto y es más caro que las opciones más baratas, pero para equipos de contenido la calidad de salida lo compensa. Para transcribir llamadas de soporte sin más, los modelos más baratos hacen el mismo trabajo básico.
3. Deepgram
Mejor para: agentes de voz en tiempo real, sistemas telefónicos y cualquier producto que haga streaming de audio en vivo.
Deepgram es el favorito de los desarrolladores para la transcripción en tiempo real y la respuesta más clara a lo único que MAI-Transcribe-2 no hace bien de serie: el streaming en vivo. Aparece en la mayoría de las recopilaciones de empresas de voz con IA por una buena razón. Su modelo insignia Nova-3 maneja tanto lotes como streaming, y un modelo más nuevo llamado Flux está pensado específicamente para agentes de voz, con detección de turnos incorporada. Si estás conectando voz a un árbol telefónico o a un agente en vivo, aquí es donde empiezan los desarrolladores.
El precio es agresivo y muy transparente. Nova-3 cuesta 0,0043 $ por minuto para audio grabado (unos 0,26 $ por hora) y 0,0048 $ por minuto para streaming, facturado al segundo sin redondeo. Tienes 200 $ de crédito gratuito, unas 750 horas, para probar. Cubre más de 40 idiomas, hace identificación de hablantes y marcas de tiempo por palabra, y admite prompting de términos clave para tu jerga.
Lo otro que merece mención es el despliegue. Deepgram ofrece contenedores autoalojados en su nivel Enterprise, con SOC 2, HIPAA, RGPD y residencia de datos en la UE, de modo que los equipos regulados pueden mantener el audio en su propia infraestructura. Es un diferenciador genuino frente a las API solo en la nube de esta lista.
Nuestra opinión: para cualquier cosa en tiempo real, Deepgram es mi recomendación por defecto frente a MAI-Transcribe-2. Menos idiomas que Gemini o Whisper, pero su latencia de streaming, la facturación por segundo y la opción de alojamiento propio lo hacen la elección práctica para productos de voz en vivo. Si todo tu audio son archivos grabados, los líderes en precisión pueden superarlo.
4. AssemblyAI
Mejor para: equipos que quieren transcripción más resúmenes, sentimiento y redacción de datos sensibles en una sola llamada de API.
El planteamiento de AssemblyAI es que la transcripción es solo el primer paso. Su modelo insignia Universal-3.5 Pro hace el voz a texto, y encima hay toda una capa de inteligencia de audio: resumen, análisis de sentimiento, detección de temas, detección de entidades, redacción de PII y un LLM Gateway para ejecutar prompts de modelos de lenguaje sobre el audio. Si de otro modo unirías tres servicios, AssemblyAI lo hace en uno.
El precio es por hora y de los más bajos de aquí. Universal-3.5 Pro cuesta 0,21 $ por hora en modo asíncrono y 0,45 $ en tiempo real, mientras que el anterior Universal-2 baja a 0,15 $ por hora. Las funciones de inteligencia se cobran aparte por hora, de modo que solo pagas por lo que activas. El nivel gratuito es generoso: 185 horas de audio pregrabado y 333 de streaming, sin tarjeta.
Una nota honesta: AssemblyAI promociona una "precisión líder del sector en audio del mundo real" pero no publica una sola cifra FLEURS en sus páginas principales, así que no aparece en la comparación de Microsoft. Lo eliges por la capa de inteligencia y el precio, no por un WER destacado que puedas comprobar.
Nuestra opinión: si tu producto necesita el análisis y no solo la transcripción, como resúmenes de llamadas o puntuación de sentimiento, AssemblyAI te ahorra acoplar un segundo proveedor. Solo para transcripción bruta es competitivo, pero no claramente mejor que los líderes en precisión. El enorme nivel gratuito facilita probarlo.
5. OpenAI GPT-Transcribe
Mejor para: equipos que ya usan un flujo de OpenAI y quieren la transcripción en el mismo SDK.
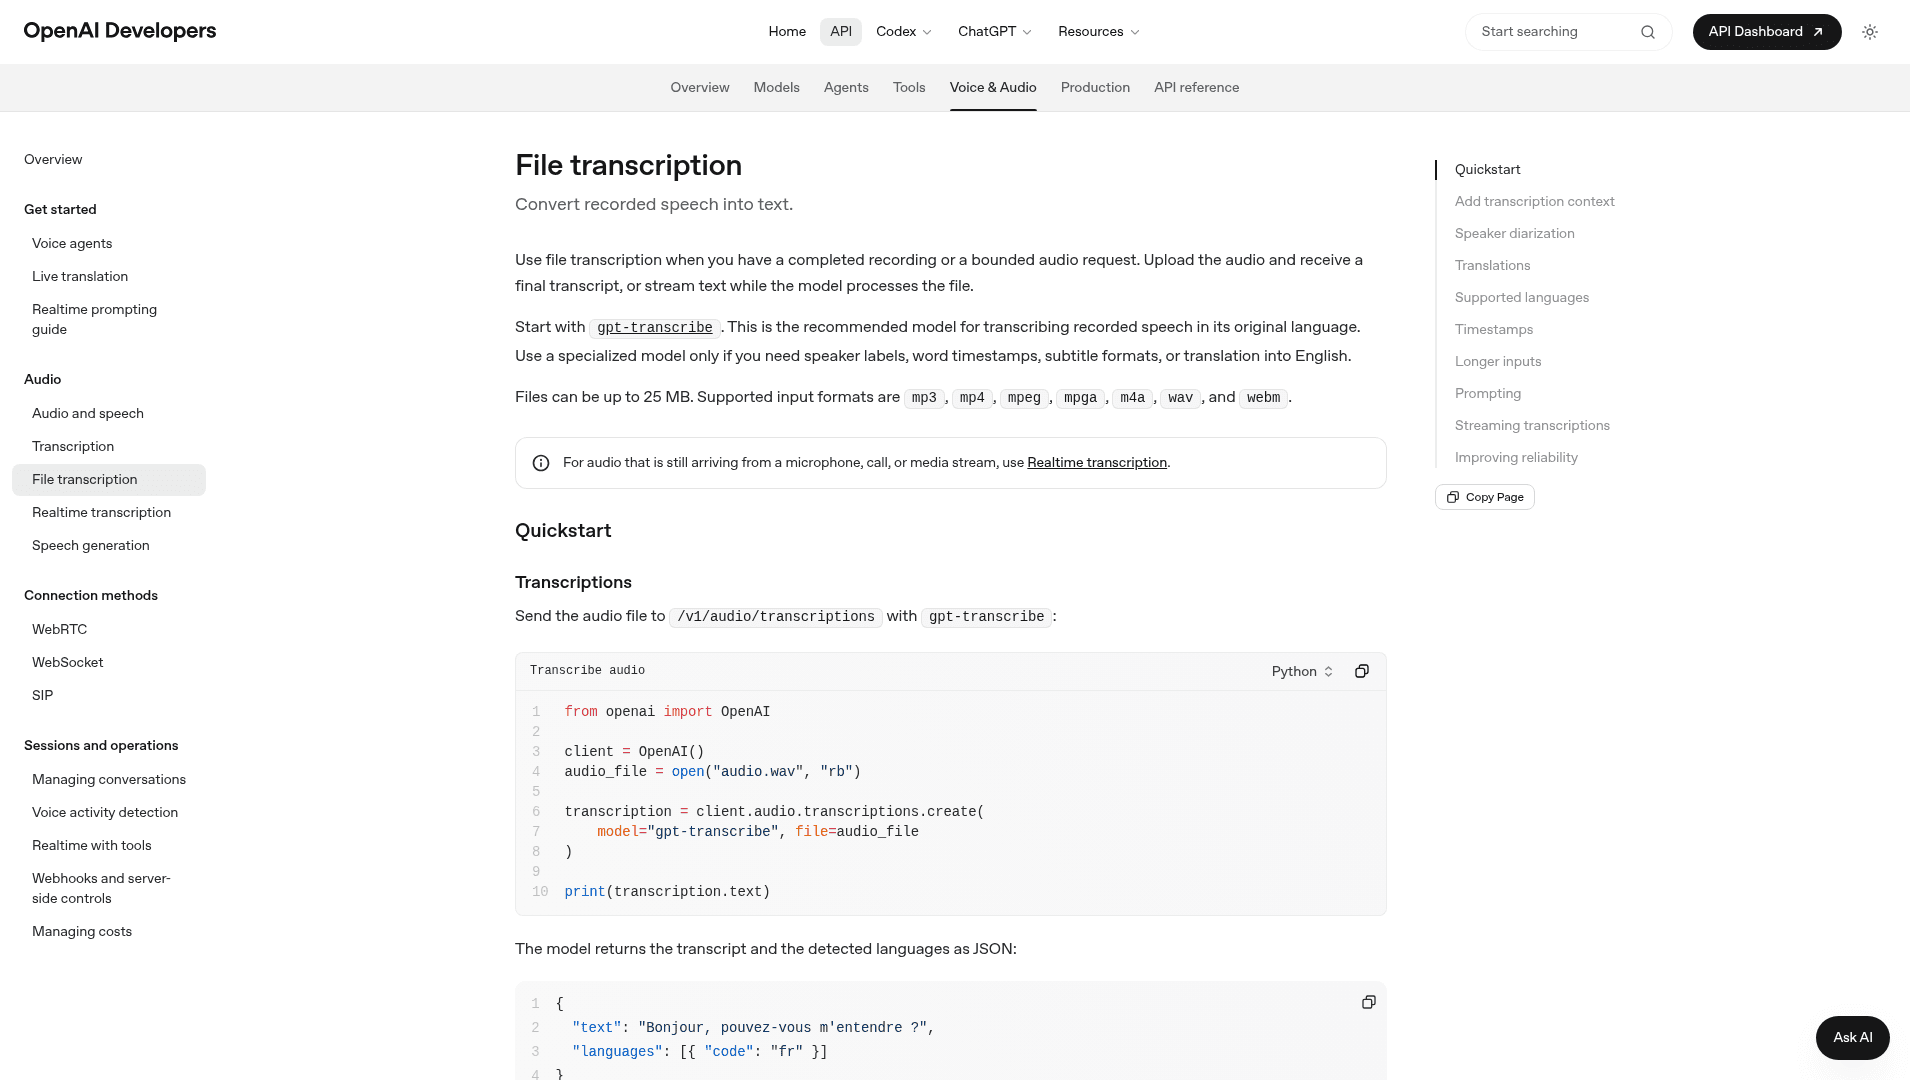
OpenAI ha renovado discretamente su oferta de transcripción. gpt-transcribe es ahora el valor por defecto recomendado, con gpt-4o-transcribe, gpt-4o-mini-transcribe y el heredado whisper-1 aún disponibles. En la tabla FLEURS de Microsoft, GPT-Transcribe queda en el 10,4 %, muy por detrás de los líderes, aunque las reseñas del mundo real son más cálidas de lo que sugiere esa cifra:
"Utter usa GPT-4o Transcribe por defecto para la transcripción en la nube y, según mi experiencia, es el mejor de su clase. La diferencia se nota más en nombres, terminología de nicho y vocabulario técnico."
El precio es por minuto de audio: gpt-transcribe cuesta 0,0045 $ por minuto (unos 0,27 $ por hora), gpt-4o-transcribe 0,006 $ y gpt-4o-mini-transcribe unos baratos 0,003 $. Los archivos tienen un límite de 25 MB, y se admiten alrededor de 99 idiomas con detección automática.
El inconveniente que conviene prever: los modelos básicos no etiquetan hablantes. La identificación de hablantes vive en un modelo aparte, gpt-4o-transcribe-diarize, y las marcas de tiempo por palabra solo llegan con el heredado whisper-1. Así que la ordenada historia de "una sola API" tiene un par de asteriscos según los metadatos que necesites.
Nuestra opinión: el motivo para elegir GPT-Transcribe es la integración, no la precisión. Si ya llamas a OpenAI, añadir transcripción es un cambio de una línea y la calidad práctica con nombres y jerga gusta. Si lo prioritario es la precisión en muchos idiomas, el benchmark dice que mires antes Gemini o MAI.
6. Speechmatics
Mejor para: la mayor cobertura de idiomas y acentos, y equipos que necesitan despliegue local.
Speechmatics es el especialista empresarial, construido en torno a una precisión independiente del acento y una filosofía de idiomas "global-first". Cubre más de 55 idiomas y dialectos de transcripción además de 69 pares de traducción, y su modelo multilingüe Melia maneja el cambio de idioma en mitad de la conversación, una ventaja real con audio en varios idiomas.
El precio es por hora y basado en créditos, con niveles claros. El procesamiento por lotes va de 0,129 $ por hora en el modelo Melia hasta 0,40 $ en el modelo Enhanced, con el nivel Standard en 0,24 $; el tiempo real cuesta de 0,24 $ a 0,43 $. Hay 100 $ de crédito gratuito y un descuento automático del 20 % por encima de 500 horas al mes. Obtiene 4,7 sobre 5 en G2 con 70 reseñas.
Lo más destacado es el despliegue. Speechmatics ofrece autoalojamiento real: Private Cloud, Container, Virtual Appliance e incluso opciones On-Device, todas de nivel Enterprise, con SOC 2 Type II, ISO 27001, RGPD y HIPAA. Según se informa, Adobe Premiere y Stenograph lo ejecutan en el dispositivo. Si tu audio legalmente no puede salir de tus instalaciones, este es uno de los pocos modelos de aquí que lo permite.
Nuestra opinión: Speechmatics es la respuesta cuando el cumplimiento normativo y la amplitud de idiomas pesan más que un precio mínimo. No es el más barato ni el campeón de FLEURS, pero la propuesta local y la precisión independiente del acento lo convierten en la opción segura para empresas reguladas y multilingües. Los equipos pequeños que buscan la factura más baja mirarán en otra parte.
7. Amazon Transcribe
Mejor para: equipos cuyos datos e infraestructura ya viven en AWS.
Amazon Transcribe es la opción de la nube consolidada, y toda su propuesta de valor es que es nativo de AWS. Los trabajos por lotes leen y escriben en S3, encaja en los flujos de eventos de Lambda y alimenta a Bedrock y a Amazon Connect Contact Lens para resúmenes generativos. Si ya eres una empresa AWS, no hay proveedor nuevo, ni facturación aparte, ni una nueva revisión de seguridad.
El precio es por segundo, escalonado para bajar con el volumen. El lote estándar cuesta 0,006 $ por minuto (unos 0,36 $ por hora) y el streaming 0,01 $ por minuto, con identificación de hablantes, vocabulario personalizado e identificación de idioma incluidos. El nivel gratuito es de 60 minutos al mes durante los primeros 12 meses. También hay un nivel Transcribe Medical compatible con HIPAA, a unos 0,075 $ por minuto, que identifica automáticamente la información de salud protegida.
Cubre más de 100 idiomas y ofrece lo habitual: identificación de hablantes, vocabulario personalizado, redacción de PII e información de Call Analytics. Lo que no publica es una cifra de precisión destacada, por lo que está ausente de la comparación de Microsoft, y su precisión en el mundo real tiene una reputación irregular frente a los proveedores más nuevos centrados en el modelo.
Nuestra opinión: el argumento a favor de Amazon Transcribe es operativo, no de precisión. Dentro de AWS es el camino de menor resistencia, y la facturación e IAM unificadas valen dinero real. Fuera de AWS, hay pocos motivos para elegirlo frente a los modelos especializados, más afilados y baratos, y pagas un sobrecoste a la tarifa estándar.
8. OpenAI Whisper (código abierto)
Mejor para: equipos con sus propias GPU que quieren coste cero por hora y control total.
Whisper es el modelo que popularizó la transcripción de código abierto, y sigue siendo el punto de referencia para el autoalojamiento. Tiene licencia MIT tanto en el código como en los pesos, se ofrece en seis tamaños desde tiny (39 M de parámetros) hasta large-v3 (1550 M) más una versión turbo de 809 M, y se instala con un único pip install. No hay factura de API en absoluto, solo pagas el cómputo, aproximadamente 10 GB de VRAM para ejecutar large-v3.
La contrapartida honesta es la precisión y el esfuerzo. En la comparación FLEURS de Microsoft, whisper-large-v3 queda en el 22,8 %, muy por detrás de los modelos modernos, lo que ilustra con claridad lo rápido que se ha movido este campo. Tampoco tiene identificación de hablantes integrada (añades pyannote o WhisperX) ni streaming nativo. Pero para muchas cargas de trabajo la calidad es más que suficiente, como lo expresó un usuario que lo aloja por su cuenta:
"He estado ejecutando whisper large-v3 en un M2 Max mediante un endpoint autoalojado y, sinceramente, la precisión es lo bastante buena como para que haya dejado de molestarme con modelos de limpieza. Lo que más me molestaba era la latencia en fragmentos más largos."
Si quieres Whisper sin gestionar servidores, OpenAI también ofrece whisper-1 como API a 0,006 $ por minuto.
Nuestra opinión: Whisper es la opción cuando el control de los datos y el coste marginal cero pesan más que la precisión de primer nivel. A gran escala, el autoalojamiento puede quedar por debajo de cualquier API de pago de aquí. Solo hay que presupuestar el tiempo de GPU, el complemento de identificación de hablantes y la brecha de precisión frente a un modelo de 2026 como MAI-Transcribe-2 o Gemini.
¿Cuál deberías elegir realmente?
La respuesta honesta es que la transcripción se ha convertido en una capa de commodity, así que la elección depende del trabajo y no de un único "mejor" modelo, igual que elegir software de helpdesk con IA depende del encaje más que de un ranking. Este es el atajo que yo usaría.
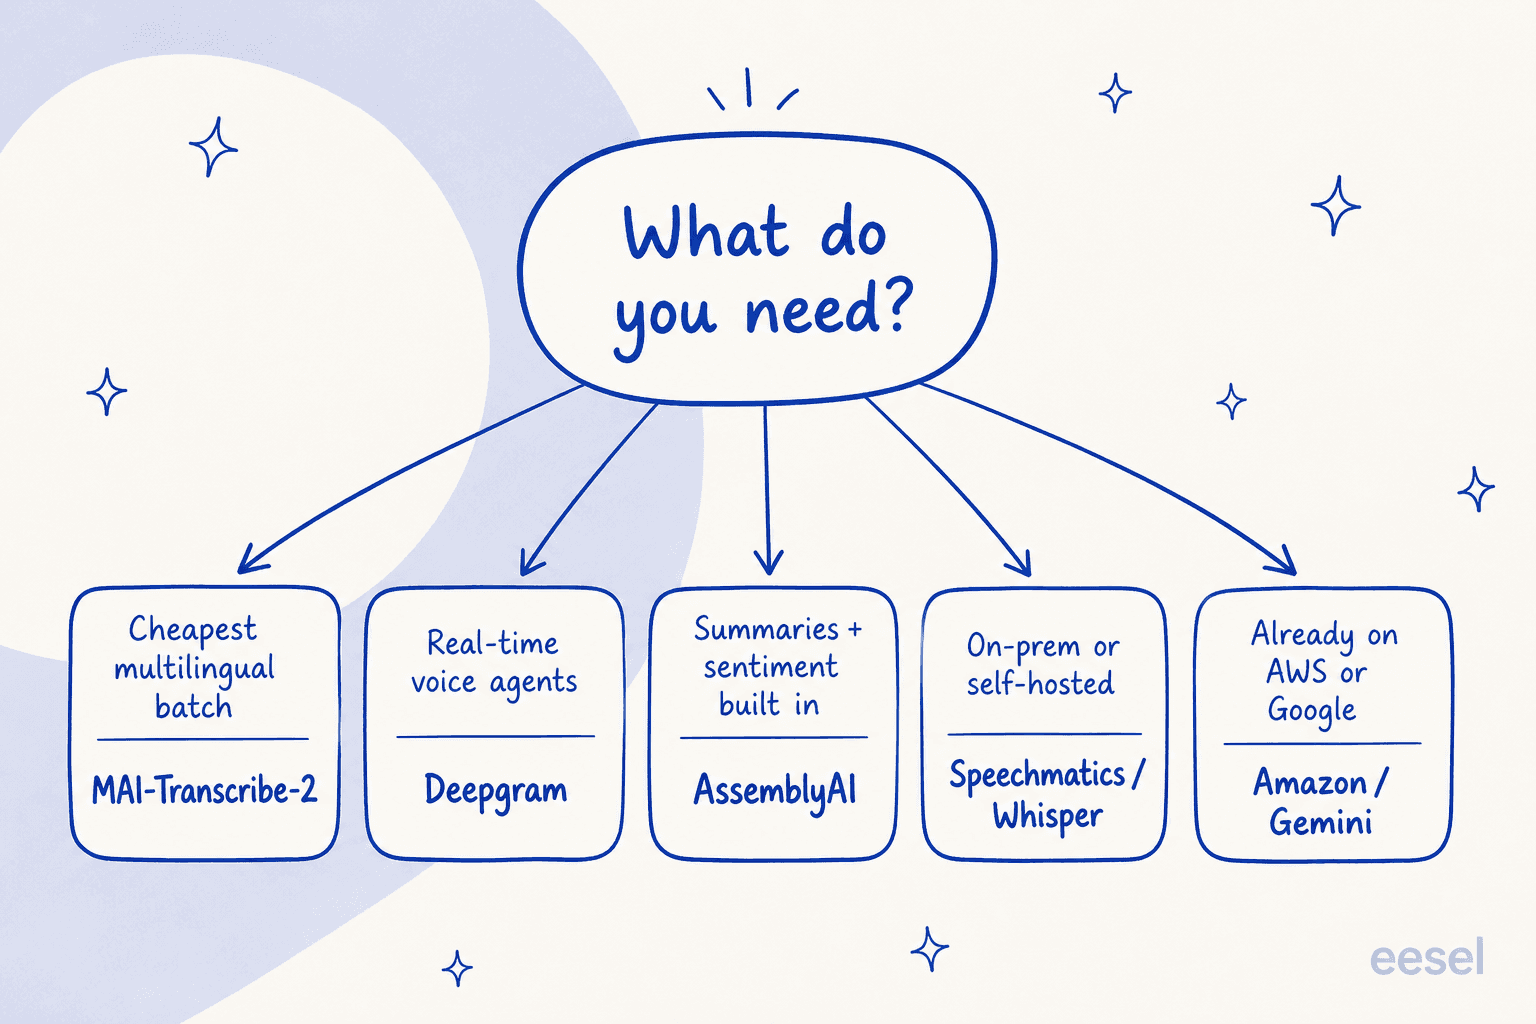
Si persigues la factura más baja para lotes multilingües, ganan MAI-Transcribe-2 o Deepgram. Si construyes agentes de voz en vivo, Deepgram o Speechmatics. Si necesitas resúmenes y sentimiento listos para usar, AssemblyAI. Si te limita el cumplimiento normativo o el despliegue local, Speechmatics o Whisper. Si ya vives en una nube, usa Amazon Transcribe o Gemini y ahórrate el trabajo de integración.
Lo que el ranking no muestra
Este es el replanteamiento al que volví una y otra vez mientras investigaba esto, y es lo que realmente importa si trabajas en soporte. La transcripción solía ser la parte difícil y cara. Ya no lo es. MAI-Transcribe-2 y todos los modelos de esta lista la han convertido en un commodity rápido, barato y casi resuelto. Es estupendo, pero significa que el valor se ha desplazado.
Una transcripción precisa de una llamada de soporte no es lo que nadie quería. El texto aún hay que leerlo, la respuesta aún hay que encontrarla en tus documentos y tickets anteriores, y la respuesta aún hay que redactarla y el ticket resolverlo. El modelo te da los oídos. No te da al compañero de equipo.
Llevo años viendo esto en eesel. Hemos ejecutado IA en colas de soporte en vivo con miles de tickets reales, y la lección que se quedó es que la precisión de la transcripción nunca fue el cuello de botella; lo fue la resolución. Por eso también simulamos cada despliegue con los tickets pasados reales de un equipo antes de que responda a un solo cliente, para que veas cómo habría gestionado tu cola en lugar de fiarte de un benchmark. Un modelo que suena seguro pero da respuestas erróneas es peor que ningún modelo, y ese riesgo está en la capa de resolución, no en la de transcripción.
Prueba eesel para convertir transcripciones en resoluciones
Cada modelo de esta lista es infraestructura. eesel es el empleado que trabaja encima. Construimos compañeros de IA que contratas para un trabajo concreto, y el compañero de IA para helpdesk es el que retoma justo donde se detiene un modelo de transcripción: lee el texto, saca la respuesta de tu centro de ayuda y de tickets anteriores, y redacta o envía la respuesta directamente en Zendesk, Freshdesk o Slack. Combina un modelo como MAI-Transcribe-2 con eesel y un ticket de voz transcrito pasa a ser un ticket resuelto, no solo un párrafo ordenado.
Y como todos estos son modelos con enfoque API-first, los desarrolladores que los eligen suelen querer el mismo control sobre su automatización de soporte. eesel tiene una CLI pública justo para eso: maneja el mismo compañero y el mismo espacio de trabajo desde una terminal, de modo que una persona puede ejecutarla a mano, un script puede automatizarla y los agentes de código como Claude Code o Cursor pueden operarla sin interfaz, sin necesidad de panel. Conectas la transcripción al principio del flujo y eesel al extremo que resuelve. Es gratis para probar, se integra con tu helpdesk en unos minutos y simula con tus tickets pasados reales antes de responder a un solo cliente.