Las 8 mejores alternativas a Laya AI en 2026

Rama Adi

Katelin Teen
Última edición September 21, 2026
Por qué la gente busca alternativas a Laya AI
Me dedico a construir integraciones y APIs, así que Laya me cae bien. El diseño es ingeniería honesta: en lugar de pedirle a un modelo autorregresivo gigante que "responda solo en JSON" y rezar, Laya ejecuta un encoder bidireccional sobre tu estado, evalúa preguntas tipadas en una sola pasada y devuelve probabilidades calibradas. Sin generación de tokens no hay campos alucinados ni JSON mal formado, por construcción. Es Apache 2.0, funciona a $0,00 por 1M de tokens autoalojado y se presenta como la respuesta abierta al Jev cerrado de TypeSafe.
El problema empieza en la propia sección de limitaciones de Laya, en la que el hilo de Hacker News se cebó enseguida. Tal cual sale, el modelo base obtiene aproximadamente 0,35 en el benchmark de decisiones tipadas, apenas por encima del 0,318 de la línea base aleatoria. La impresionante cifra de 0,766 solo aparece tras ajustarlo con la partición de entrenamiento del benchmark. Es un asterisco enorme, y los profesionales del hilo lo dijeron sin rodeos:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev. Like the point here isn't your ML aptitude it's how easy is it for developers to drop this into a product and use it. I'm more than capable of training a bert classifier... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores."

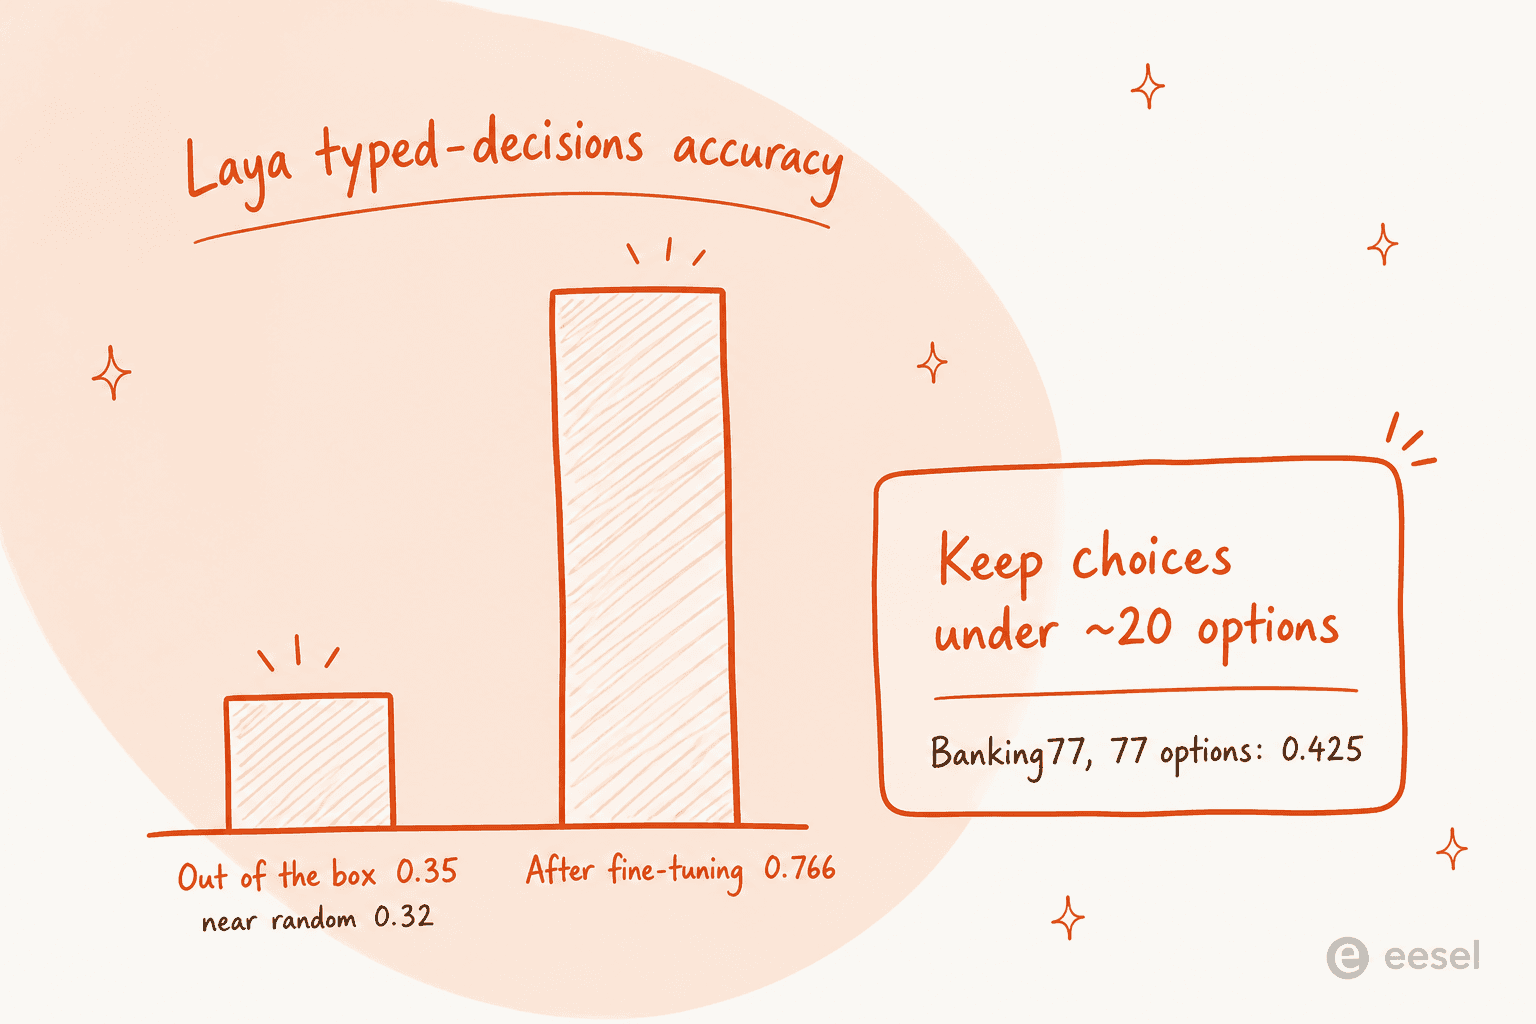
Hay un segundo techo que conviene conocer antes de comprometerte. Las preguntas de elección de Laya empeoran a partir de unas 20 opciones, porque las etiquetas candidatas comparten un presupuesto fijo de tokens. En Banking77, un conjunto de intenciones con 77 etiquetas, Laya obtuvo 0,425 mientras que Jev llegó a 0,870. Muchos problemas reales de enrutamiento tienen más de 20 categorías, así que no es un caso marginal para todos.
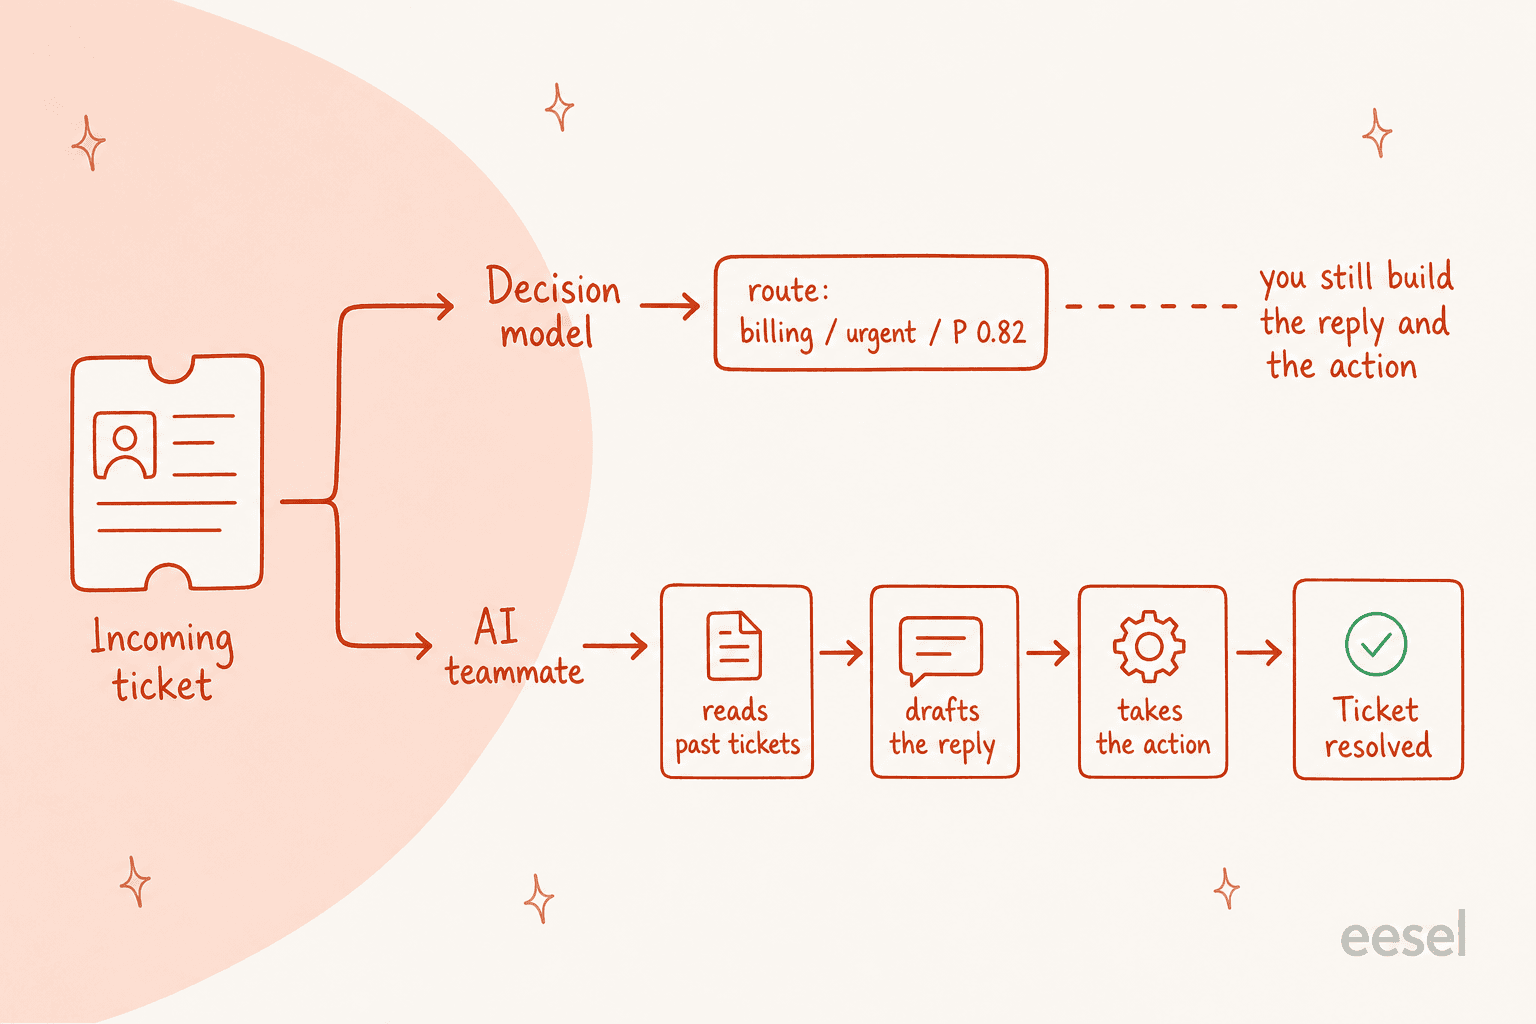
Y luego el punto de enfoque, el que más me importa. Incluso en su mejor versión, Laya responde una pregunta. Te dice este ticket es de facturación, urgente, P(0,82). No redacta la respuesta, no reembolsa el pedido ni escala a una persona. Eso está bien si vas a construir tú el producto que lo rodea, y es un obstáculo definitivo si creías que comprabas un resultado. Un comentarista resumió muy bien el atractivo de toda la categoría:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
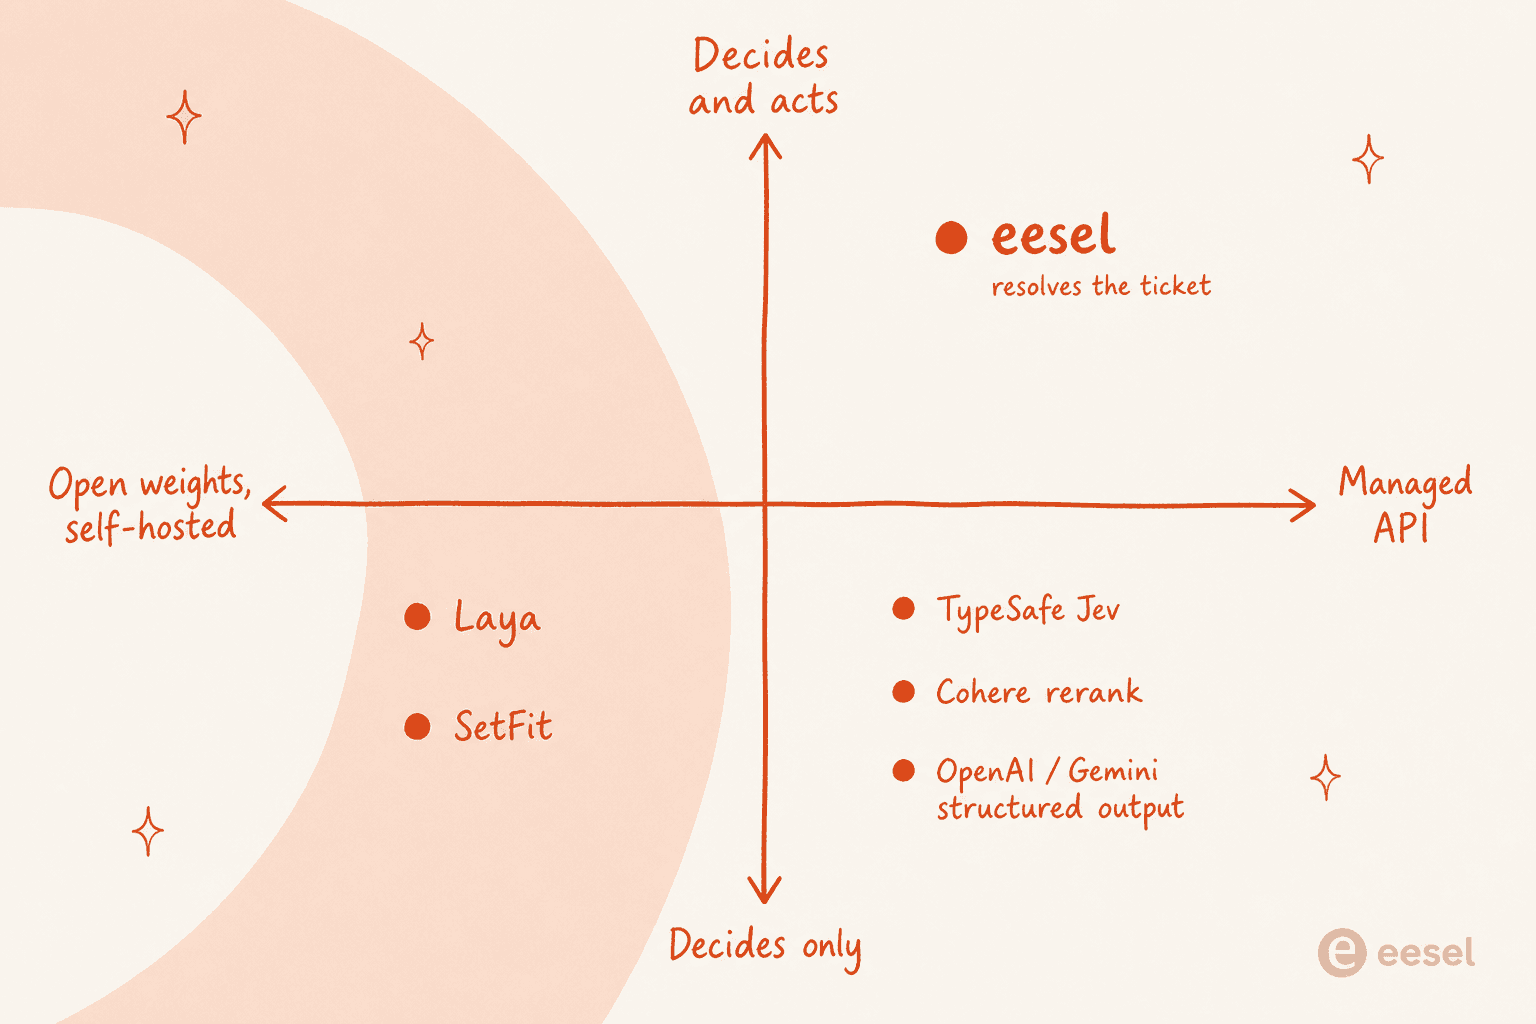
Esa es la tensión que cada alternativa de abajo resuelve a su manera: cuánto quieres ejecutar tú mismo, y si quieres una decisión o una resolución.
Cómo elegí estas alternativas
Valoré cada opción según cinco criterios:
- Qué hace realmente - clasificador puro, API de decisión tipada, librería de salida restringida o un compañero completo que actúa.
- Autoalojado vs. gestionado - ¿ejecutas los pesos o llamas a un endpoint?
- La historia de la confianza - ¿puedes fiarte de la puntuación lo bastante como para actuar automáticamente, o es una caja negra? Todo el argumento de Laya es la calibración, así que las alternativas se miden con ese listón.
- Coste real - licencia, precio por llamada y el tiempo de ingeniería que nadie pone en el presupuesto.
- Alcance multilingüe - Laya cubre más de 100 idiomas, así que los equipos de soporte globales necesitan saber a qué renunciarían.
Este es el panorama en una imagen antes de entrar en cada herramienta.
Alternativas a Laya AI de un vistazo
| Herramienta | Ideal para | Tipo | ¿Autoalojable? | Decide o actúa | Unidad de facturación | Precio inicial |
|---|---|---|---|---|---|---|
| eesel | Resolver de verdad tickets de soporte | Compañero de IA | Gestionado | Decide y actúa | Planes de créditos desde $299/mes | Plan gratuito (100 créditos) |
| TypeSafe Jev | Un gemelo gestionado de Laya | API de decisión | Gestionado | Decide | Por 1M de tokens | $0,042 / 1M de entrada, salida gratis |
| SetFit | Clasificación few-shot propia | Clasificador OSS | Sí | Decide | Ninguna (cómputo) | $0 (Apache 2.0) |
| Cohere | Relevancia RAG + clasificación | API gestionada | Opción VPC / on-prem | Decide | Por búsqueda / por 1M | ~$2,00 / 1K búsquedas |
| OpenAI Structured Outputs | Equipos que ya usan GPT | Función de LLM | Gestionado | Decide | Por 1M de tokens | Sin recargo sobre el modelo |
| Google Gemini | Clasificación estructurada gestionada más barata | Función de LLM | Gestionado | Decide | Por 1M de tokens | Flash-Lite es el más barato |
| Outlines / Instructor | Seguridad de esquema sobre tu propio LLM | Librerías OSS | Sí | Decide | Ninguna (cómputo) | $0 (Apache-2 / MIT) |
| Cloudflare Workers AI | Inferencia en el edge, incluido Jev | Catálogo gestionado | Gestionado | Decide | Neurons | Nivel gratuito, luego por uso |
1. eesel
Ideal para: equipos que se dan cuenta de que la decisión era solo el primer paso, y lo que realmente necesitan es que el ticket de soporte se resuelva.
Seré honesto desde el principio, porque el skill de blog con el que escribo insiste en ello: eesel no es un modelo de decisión, y si necesitas específicamente una primitiva de clasificación tipada de 33 ms para tu propio pipeline, una de las herramientas siguientes es un reemplazo literal mejor. Pero la mayoría de quienes evalúan Laya para soporte no quieren una etiqueta, quieren el resultado al que esa etiqueta debía conducir. Ese es el hueco que cubre eesel.

eesel es una plataforma de compañeros de IA: contratas compañeros listos para trabajar en tareas concretas, y la plantilla actual es un compañero de helpdesk con IA y un redactor de blog con IA. El compañero de helpdesk hace todo el ciclo que un modelo de decisión no puede: lee años de tickets pasados y tu centro de ayuda, redacta la respuesta, ejecuta la acción y enruta o escala cuando no está seguro. El enrutamiento es una función suya, no todo el producto.
Aquí es donde nuestros años ejecutando IA en colas de soporte reales importan para esta comparación. Los propios datos de Laya muestran algo que merece una pausa: en el barrido multilingüe, su modelo en inglés obtuvo 0,000 de precisión en jemer mientras reportaba 0,952 de confianza media. Un modelo puede estar equivocado con confianza y con calibración. Lo aprendimos por las malas viendo bots dar respuestas seguras que eran totalmente erróneas, y por eso cada despliegue de eesel se simula contra tus tickets históricos antes de tocar una conversación real. Ves primero la tasa real de resolución automática con tus propios datos, no una cifra de benchmark.
Para los desarrolladores a los que les gustó la programabilidad de Laya, eesel expone el mismo compañero mediante la CLI de eesel y MCP, de modo que puedes instalarlo, conectar fuentes de conocimiento, fijar instrucciones, ejecutar una simulación y revisar la actividad desde una terminal o un script. Agentes de código como Claude Code, Codex y Cursor pueden manejarlo igual. Es el mismo compañero que un responsable de soporte no técnico configura en el panel, solo que operado como código.
Ventajas:
- Decide y resuelve, en Zendesk, Freshdesk, Slack, correo y más de 100 herramientas.
- Simula con tu historial real de tickets antes de salir en vivo, así la confianza se apoya en tus datos.
- Se entrena en lenguaje natural, además de una superficie completa de CLI y MCP para el público programador.
Desventajas:
- No es una primitiva de clasificación pura; si de verdad necesitas una sola llamada a un modelo en tu stack, no tiene la forma adecuada.
- Es un compañero gestionado, no pesos que puedas ejecutar aislados de la red.
Precio: Gratis para empezar, luego un precio mensual fijo desde $299/mes por 500 créditos (1 crédito por ticket o chat), así pagas por tickets gestionados y no por token adivinado.
Veredicto: si la decisión de enrutamiento siempre fue para resolver una cola de soporte, sáltate la primitiva y contrata al compañero. Si de verdad necesitas un clasificador independiente, sigue leyendo.
2. TypeSafe Jev
Ideal para: el caso de uso exacto de Laya, pero gestionado, sin nada que ajustar ni alojar tú.
Jev es el modelo al que Laya quiso responder, así que es la alternativa más natural de la lista. TypeSafe, fundada por Diogo Almeida (coinventor de RLHF en OpenAI), lo llama el primer "modelo System 1" público: envías estado sin estructurar más preguntas tipadas y devuelve decisiones probabilísticas tipadas en una pasada paralela, con las mismas tres primitivas que Laya tomó prestadas: noul, choice y score.
La comparación con Laya es clara. Jev es cerrado y de pago, pero es realmente plug-and-play sin paso de entrenamiento, justo lo que la gente de Hacker News repetía que a Laya le faltaba. Los benchmarks de Laya afirman que es 7,8 veces más rápido y está mejor calibrado que Jev, pero son cifras de Laya en la configuración de Laya, y solo valen tras el fine-tuning que Jev no te pide. En una tarea de 77 clases, recuerda, Jev en realidad ganó a Laya por 0,870 a 0,425.
Ventajas:
- Sin pesos, sin GPU, sin fine-tuning, la experiencia plug-and-play que Laya no ofrece.
- Fuerte en tareas de elección de alta cardinalidad donde Laya se desploma.
- Los tokens de salida son gratis, así que decidir leyendo mucho sale barato.
Desventajas:
- Cerrado y propietario, sin opción aislada ni on-prem.
- Aún en acceso anticipado, sin página pública de precios más allá de la tarifa de abajo, y con lista de espera.
Precio: $0,042 por 1M de tokens de entrada, salida gratis, facturado a través de la API.
Veredicto: si te gustó el concepto de Laya pero no sus deberes de fine-tuning ni su GPU, Jev es la versión gestionada de la misma idea. Solo ten presente que cambias apertura por comodidad. Para un cara a cara completo en el lado gestionado, mi resumen de alternativas a Jev profundiza más.
3. SetFit
Ideal para: equipos dispuestos a etiquetar unos pocos ejemplos y entrenar, que quieren un clasificador completamente suyo.
Si el requisito de fine-tuning de Laya es el problema, SetFit lo replantea como la característica. Es un framework de Hugging Face (con Intel Labs y el UKP Lab) para clasificación de texto few-shot: ajusta de forma contrastiva el cuerpo de un sentence-transformer y luego entrena una pequeña cabeza de clasificación sobre los embeddings. Sin prompts, sin verbalizers.
El resultado estrella es la mejor parte: con solo 8 ejemplos etiquetados por clase, SetFit es competitivo con ajustar RoBERTa Large sobre un conjunto completo de 3.000 ejemplos, con un orden de magnitud menos de parámetros y un entrenamiento mucho más rápido. Funciona en CPU o en una GPU modesta, es Apache-2.0, y el soporte multilingüe viene gratis al cambiar por un cuerpo de sentence-transformer multilingüe. Como ibas a ajustar Laya de todos modos, SetFit es probablemente el camino más maduro y mejor documentado al mismo destino de "clasificador pequeño y rápido".
Ventajas:
- Realmente few-shot, con ~8 ejemplos por clase ya avanzas.
- Totalmente abierto (Apache-2.0), autoalojado, inferencia a $0, igual que Laya.
- Lo bastante pequeño para entrenarse y servirse en hardware común.
Desventajas:
- Solo clasificador, sin API de "decisiones" calibrada ni primitivas noul/choice/score.
- Sin enrutador de idiomas integrado; el cuerpo multilingüe lo eliges tú.
- Sigues aportando datos etiquetados y ejecutando el ajuste en dos etapas.
Precio: gratis, Apache-2.0. pip install setfit y listo.
Veredicto: el hermano de espíritu open source más cercano a Laya para clasificación. Si la capa de confianza calibrada y el enrutador multilingüe no son decisivos, SetFit es una forma con menos dramas de tener un clasificador propio.
4. Cohere
Ideal para: las tareas de relevancia RAG y clasificación para las que la gente recurre a Laya, entregadas como una API gestionada y apta para empresas.
Varios de los casos de uso estrella de Laya, sobre todo el filtrado de relevancia de pasajes RAG, son justo lo que Cohere domina discretamente desde hace años. Sus modelos Rerank puntúan cuán relevante es cada pasaje para una consulta, y sus endpoints Embed y Classify se encargan del trabajo de "a qué categoría pertenece este texto", todo sin que entrenes ni alojes nada.
La pila de recuperación de Cohere es la parte que los profesionales realmente adoran. Los equipos describen habitualmente Rerank como la razón por la que se quedan, incluso cuando generan con el modelo de otro proveedor, porque el ranking de relevancia es el trabajo para el que fue construido.
En qué se diferencia de Laya: es una API gestionada, no pesos, aunque Cohere es inusualmente flexible en eso, y ofrece despliegues "Model Vault" en VPC y on-prem para equipos que necesitan que los datos no salgan de casa. Es un camino intermedio que Laya (totalmente autoalojado) y Jev (totalmente cerrado) no ofrecen.
Ventajas:
- Rerank es el mejor de su clase en relevancia RAG, un caso de uso estrella de Laya.
- Soporte de más de 100 idiomas en Embed 4 y Rerank 4.
- Opción VPC / on-prem para equipos regulados, más un nivel gratuito para desarrolladores.
Desventajas:
- Gestionado y de pago por defecto, no el autoalojamiento a $0 que ofrece Laya.
- Orientado a empresas, así que llevar la pila de recuperación a producción es trabajo real de ingeniería, no una instalación de una línea.
Precio: Rerank 4 Fast cuesta $2,00 / 1K búsquedas, Rerank 4 Pro $2,50 / 1K, Embed 4 $0,12 / 1M de tokens (texto). Nivel de prueba gratuito para desarrolladores.
Veredicto: si lo que querías de Laya era ranking de relevancia o clasificación y prefieres no ejecutar una GPU, Cohere es la respuesta gestionada y madura, sobre todo si necesitas una opción on-prem.
5. OpenAI Structured Outputs
Ideal para: equipos que ya usan GPT y quieren decisiones tipadas con esquema garantizado sin añadir un modelo nuevo.
No necesitas estrictamente un modelo de decisión dedicado para obtener salida tipada. La función Structured Outputs de OpenAI hace que un modelo GPT-5.6 respete un JSON Schema que le proporcionas, de modo que la respuesta se ajusta garantizadamente a tus tipos (o devuelve un rechazo explícito), y se integra directamente con Pydantic o Zod.
La salvedad honesta es la que giró todo el debate de "no puede alucinar": válido según el esquema no es lo mismo que correcto. Un modelo puede darte una respuesta perfectamente tipada que simplemente está mal, y a diferencia de Laya, un LLM general ofrece una señal de confianza más difusa (puedes leer logprobs, pero no es la distribución calibrada que Laya está hecho para producir). Además pagas la latencia y el coste completos de un LLM por llamada, que es el exceso de más de 500 ms que Laya se propuso explícitamente reemplazar en decisiones simples tipo reflejo.
Ventajas:
- Ningún modelo nuevo que adoptar si ya usas OpenAI.
- Adherencia garantizada al esquema, con rechazos explícitos por seguridad.
- Structured Outputs en sí no añade recargo sobre la tarifa base de tokens.
Desventajas:
- Coste y latencia completos de un LLM para lo que Laya hace en 33 ms.
- La confianza vía
logprobses un indicador aproximado, no probabilidades de decisión calibradas.
Precio: sin recargo por la función, pagas las tarifas de tokens del modelo subyacente (los GPT-5.6 de gama alta van de $0,20 a $5,00 por 1M de entrada).
Veredicto: el camino de menor resistencia si GPT ya está en tu stack y tu volumen de decisiones es modesto. A gran volumen, el coste por llamada es justo lo que empuja a la gente hacia un modelo de decisión hecho a propósito.
6. Google Gemini
Ideal para: la ruta gestionada más barata hacia la clasificación estructurada, con un modelo que la nombra como caso de uso de primera clase.
La salida estructurada de Gemini funciona con el mismo principio que la de OpenAI: pasas un esquema de respuesta y Gemini lo respeta, y la documentación de Google menciona explícitamente la "clasificación estructurada" como caso de uso soportado y no como un truco.
Gemini se gana su propio hueco frente a OpenAI por el precio en el extremo bajo: el nivel Flash-Lite apunta directamente a clasificación de alto volumen y bajo coste, que es la presión económica que lleva a la gente a Laya en primer lugar. Si quieres decisiones estructuradas gestionadas pero las cuentas de tokens de un modelo de gama alta te asustan, los modelos pequeños de Gemini son la palanca gestionada más barata aquí. Se aplica la misma salvedad de "tipado pero no necesariamente correcto" de la sección de OpenAI: es un LLM general, no un modelo de decisión calibrado.
Ventajas:
- La clasificación estructurada es un caso de uso documentado y de primera clase.
- El precio de Flash-Lite está pensado para decisiones baratas de alto volumen.
- Gran cobertura multilingüe sin configuración extra.
Desventajas:
- Sigue habiendo latencia de LLM y una señal de confianza aproximada, no la calibración de Laya.
- Te ata a la superficie de API de Google.
Precio: sin recargo por la función sobre las tarifas de tokens de los modelos Gemini, con Flash-Lite como el nivel más barato.
Veredicto: la mejor opción gestionada cuando el coste por decisión lo es todo y no necesitas confianza calibrada. En la práctica, la salida estructurada de OpenAI con un suelo más barato.
7. Outlines e Instructor
Ideal para: equipos que quieren conservar su propio LLM (abierto o alojado) pero imponer un esquema al decodificar.
Si tu objeción a Laya es "no quiero un modelo aparte, solo quiero que mi modelo actual deje de devolver basura", dos librerías open source lo resuelven directamente. Outlines (de dottxt) impone la estructura al decodificar, de modo que el modelo solo puede emitir tokens que encajen en tu esquema, y funciona con OpenAI, Ollama y vLLM. Instructor envuelve las llamadas al modelo con Pydantic y validación, y se ha convertido en la forma por defecto de obtener salida tipada en más de 15 proveedores.
No son modelos de decisión, son barandillas alrededor del modelo que ya ejecutas. Esa es su fortaleza (trae tus propios pesos, sin nueva dependencia que servir) y su límite (heredas la latencia, el coste y la falta de confianza calibrada de tu modelo base). Outlines es Apache-2, Instructor es MIT, ambos gratis. Ten en cuenta que dottxt también vende una API alojada de pago sobre la librería abierta, por si prefieres no ejecutarla.
Ventajas:
- Conserva tu modelo actual, solo haz que su salida sea segura en tipos.
- Totalmente abiertos (Apache-2 / MIT), autoalojados, proyectos activos.
- La imposición al decodificar de Outlines es realmente difícil de romper.
Desventajas:
- No es un modelo, sin ganancia de velocidad ni de coste sobre el LLM de debajo.
- Sin probabilidades de decisión calibradas, sin enrutador multilingüe.
Precio: gratis y de código abierto. Outlines tiene una API alojada de dottxt de pago si la quieres gestionada.
Veredicto: la herramienta correcta si el problema real era la seguridad del esquema, no la velocidad de decisión. Combínala con un modelo local pequeño y obtendrás la mayor parte de la garantía de "nunca mal formado" de Laya sin adoptar un modelo nuevo.
8. Cloudflare Workers AI
Ideal para: equipos que quieren modelos pequeños (incluido el propio Jev) ejecutándose en el edge, facturados por uso.
Cloudflare Workers AI es un animal algo distinto: un catálogo de más de 65 modelos alojados que ejecutas en el edge, cerca de tus usuarios, sin infraestructura propia. Es relevante aquí por una razón concreta: aloja typesafe/jev, así que si lo que buscas es el concepto de modelo de decisión, Cloudflare es una de las formas de llamarlo realmente.
El argumento frente a autoalojar Laya es la latencia y las operaciones: tu decisión se ejecuta en una ubicación edge cercana a la petición y nunca tocas una GPU. El argumento frente al coste $0 de Laya es la honestidad: pagas por uso (en la unidad "Neurons" de Cloudflare), aunque hay un nivel gratuito para empezar. Es menos un reemplazo equivalente de Laya y más una superficie de despliegue para toda la categoría.
Ventajas:
- Inferencia en el edge, baja latencia de red, cero infraestructura que gestionar.
- Aloja Jev y docenas de otros modelos pequeños en una sola superficie de facturación.
- Nivel gratuito, luego medición transparente basada en Neurons.
Desventajas:
- De pago por uso, no el autoalojamiento gratuito que da Laya.
- Eliges del catálogo de Cloudflare, no ejecutas pesos personalizados arbitrarios.
Precio: asignación gratuita, luego medición en Neurons.
Veredicto: más una respuesta a "dónde ejecutarlo" que a "qué ejecutar". Si la latencia en el edge y no tener operaciones importan más que el último céntimo, es una forma limpia de desplegar un modelo de decisión sin GPU.
¿Cuál deberías elegir realmente?
El mapa del principio lo dice mejor: tus dos preguntas reales son cuánto quieres ejecutar tú mismo y si quieres una decisión o una resolución. Este pequeño selector te lleva a la lista corta.
Prueba eesel
Si encontraste Laya mientras intentabas hacer más inteligente una cola de soporte, aquí va el atajo: la decisión de enrutamiento nunca fue el objetivo, sino cerrar el ticket. eesel es el compañero de helpdesk con IA que toma la decisión de triaje y actúa en consecuencia: redacta la respuesta, ejecuta la acción y escala cuando no está seguro, en vivo dentro de Zendesk, Freshdesk, Slack y más de 100 herramientas.
La parte que responde a la mayor salvedad de Laya: como un modelo seguro de sí mismo aún puede equivocarse, eesel simula cada despliegue sobre tus tickets históricos antes de tocar a un cliente real, así ves la verdadera tasa de resolución con tus datos, no un benchmark. Y para los desarrolladores a los que les gustó la programabilidad de Laya, la CLI y MCP de eesel te permiten manejar el mismo compañero desde una terminal, un script o un agente de código. Empieza gratis.