Alternativas a Qwen-UI-Agent: 8 agentes GUI que puedes usar de verdad en 2026

Rama Adi

Katelin Teen
Última edición August 24, 2026
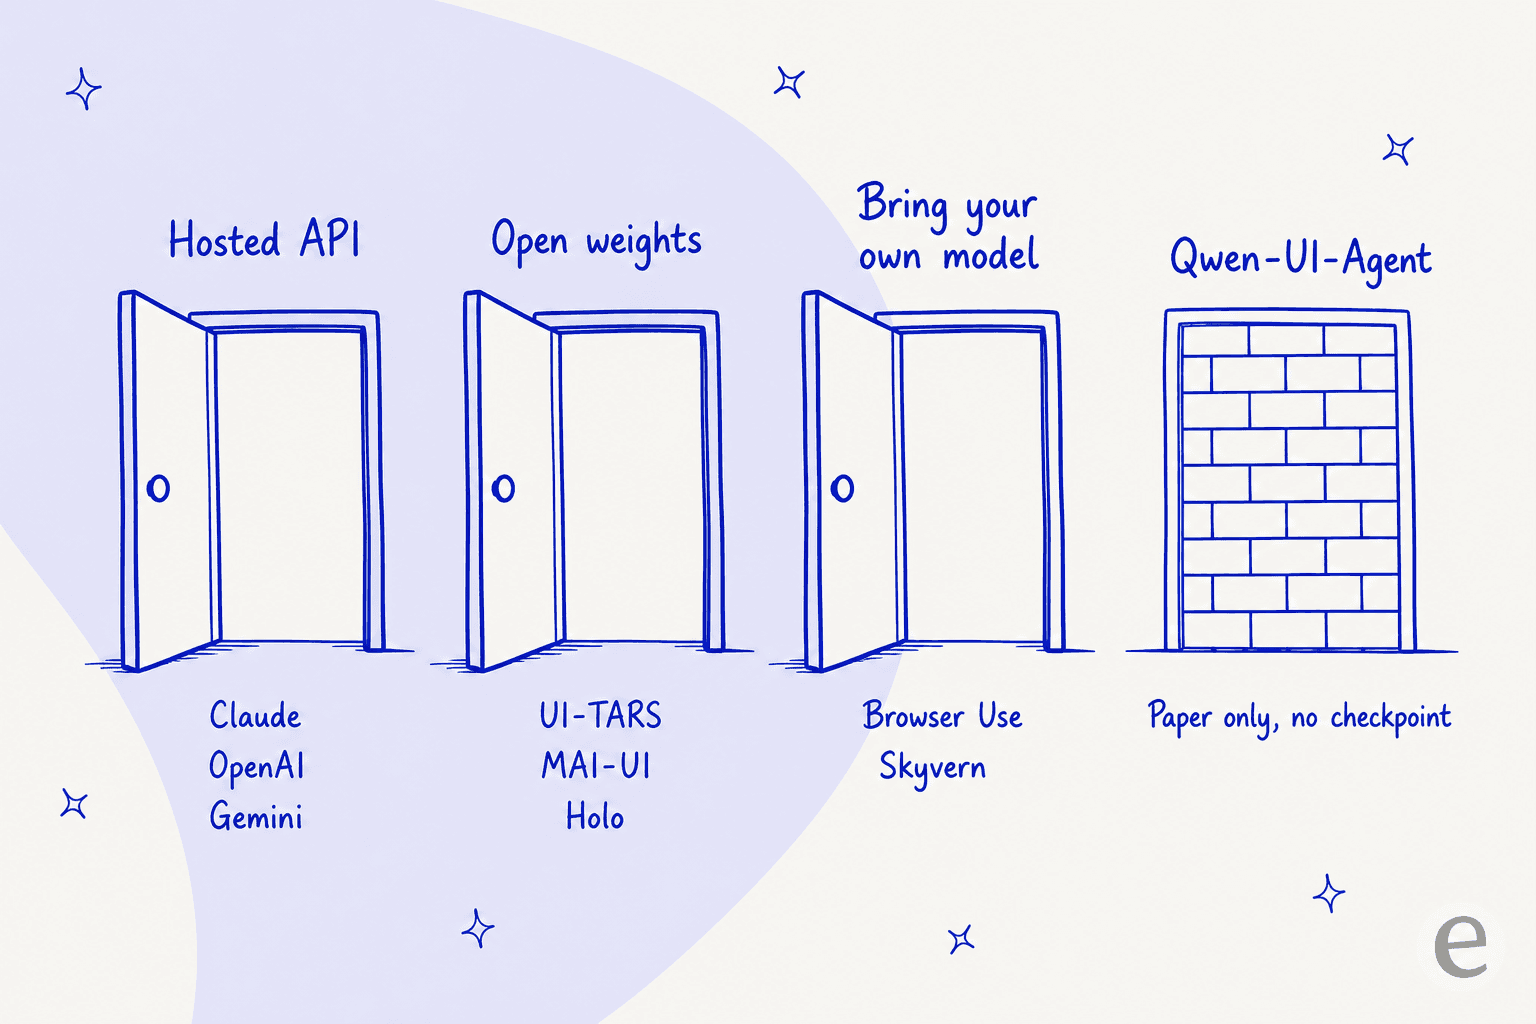
No puedes cambiarte de Qwen-UI-Agent, porque todavía no hay nada de lo que cambiarse. El equipo Tongyi MAI de Alibaba publicó el 30 de julio de 2026 un informe técnico con excelentes cifras móviles y después no entregó ni un checkpoint, ni una API, ni un precio. La organización de Hugging Face lista cuatro modelos y ninguno es este. Así que buscar alternativas es, en realidad, buscar un agente GUI que exista.
Existen ocho, y se ordenan en tres vías en lugar de un ranking. Las API alojadas de Anthropic, OpenAI y Google te dan los modelos más fuertes y la mejor infraestructura de seguridad, con Google como el único que además maneja Android. Los pesos abiertos de UI-TARS, MAI-UI y Holo 3.1 te dan Apache 2.0 y un portátil bajo tu control, con un coste real en precisión. Browser Use y Skyvern no te dan ni un modelo ni un misterio: manejan Chromium con el LLM que les indiques, y son la forma más barata de terminar una tarea web.
Dos cosas me sorprendieron. Todo agente GUI de pesos abiertos que puedes descargar es un ajuste fino de Qwen, así que dejar Alibaba es un movimiento de licencias y no de arquitectura. Y en las propias trazas de Qwen-UI-Agent, el 55,1 % de sus acciones en el benchmark de escritorio más difícil fueron comandos escritos, no clics. El mejor agente del mundo para manejar pantallas evita la pantalla cuando puede. Si el trabajo que tenías en mente son tickets de soporte, toma la indirecta: eesel se conecta a Zendesk y Gorgias a través de sus API y te deja hacer una prueba en seco con los tickets del mes pasado, algo que ningún ratón puede hacer.
Qué busca realmente la gente cuando escribe esto
Construyo integraciones para vivir, así que mi primer instinto con cualquier modelo de agente nuevo es ir a buscar el endpoint. Con Qwen-UI-Agent no hay ninguno.
Lo cual es una pena, porque Alibaba suele entregar. Si llegaste aquí desde nuestro resumen de alternativas a Qwen o la reseña de Qwen, sabrás que los modelos de texto tienen tarifas públicas y endpoints reales. Este no.
Vale la pena ser preciso, porque la cobertura no lo fue. El sitio del proyecto tiene exactamente tres botones: informe técnico, GitHub y un vídeo de demostración. El repositorio de GitHub tiene 2,2k estrellas y cero versiones, cero etiquetas y cero paquetes. La organización Tongyi-MAI en Hugging Face publica Z-Image, Z-Image-Turbo, MAI-UI-8B y MAI-UI-2B, y esa es toda la lista. Apache 2.0 aparece en el README, pero una licencia en un repositorio de figuras no es un modelo que puedas ejecutar.
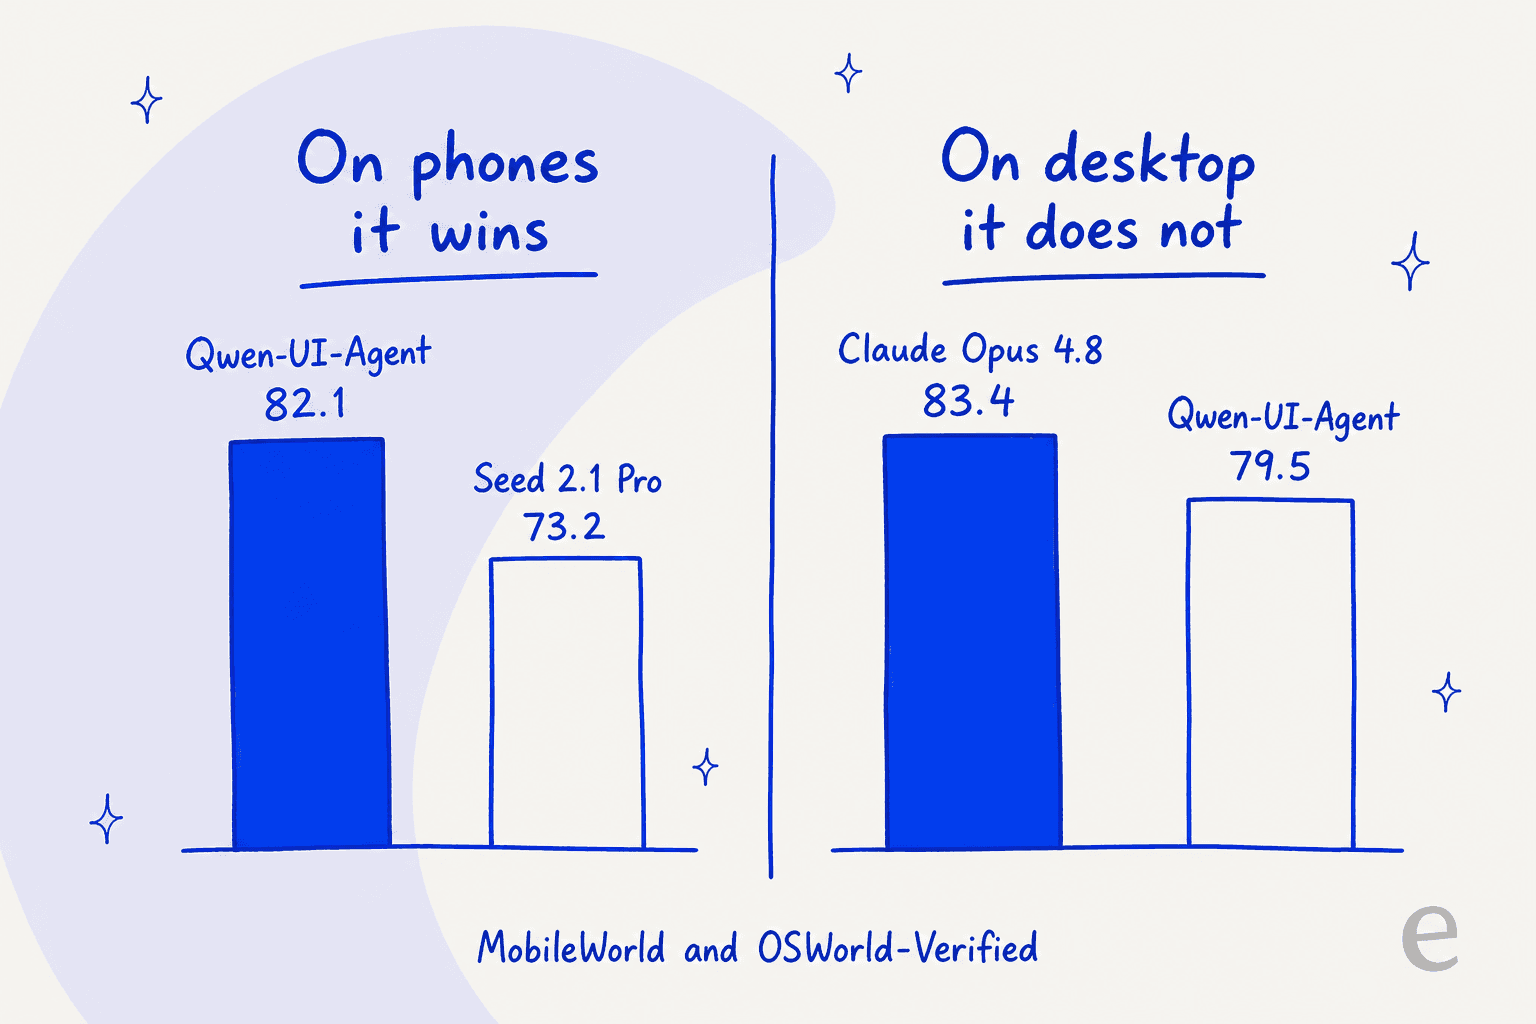
Nada de eso hace que el trabajo sea peor. El titular del artículo es una variante de 27B que los autores llaman su modelo principal para la evaluación de extremo a extremo, según el informe técnico, y en móviles es con comodidad lo mejor que alguien ha publicado: 82,1 % en MobileWorld frente al 73,2 de Seed 2.1 Pro, y 92,2 % en un benchmark reservado de 409 tareas en 104 apps Android reales, ejecutado en una flota de más de 100 teléfonos físicos. Esa última cifra es la interesante, porque se midió en dispositivos reales y no en emuladores.
En el escritorio es donde la historia se aplana al recontarla. Un resumen semanal muy compartido lo dijo así:
"Alibaba also released Qwen-UI-Agent, a 27B GUI agent model that claims top scores on MobileWorld (82.1%), OSWorld-Verified (79.5%), and WebArena (73.6%), beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro."
El propio gráfico de Alibaba dice otra cosa en la cifra del medio. En OSWorld-Verified, Claude Opus 4.8 saca 83,4 y Qwen-UI-Agent saca 79,5, y el artículo afirma claramente que queda segundo, solo por detrás de Opus 4.8. En el conjunto más difícil de largo plazo, OSWorld-v2, la brecha se amplía a 40,0 frente a 54,8 de Opus 4.8 en progreso parcial. La afirmación de "superar" vale para móvil y para WebArena. No vale para el benchmark de escritorio que citan la mayoría de los compradores.
También conviene recordar que esta categoría tiene historial de prometer de más. Adept AI lanzó ACT-1, el primer agente serio que hacía clic en pantallas, y luego cambió de rumbo; Rabbit AI vendió un gran modelo de acciones dentro de un aparato de consumo. Las demos de agentes manejando software ya se han adelantado a la realidad antes, una buena razón para leer cada gráfico de este artículo dos veces.
Así que el planteamiento honesto de todo este artículo: no estás reemplazando un producto, estás eligiendo tu primero. Y la elección depende menos de la puntuación que de por cuál de tres puertas entras.
Qué dice la clasificación neutral
Casi todas las cifras de la sección anterior las reportan los propios proveedores, incluida Alibaba. Así que antes de la lista, aquí está el mismo benchmark ejecutado por alguien que no tiene nada que vender.
OSWorld-Verified tiene un tablero gestionado por sus mantenedores, donde el equipo de OSWorld evalúa las propuestas ellos mismos, con ajustes unificados, sobre las mismas 361 tareas. No se muestra como tabla en la página, se carga en el cliente desde una hoja de cálculo, así que aquí están los ocho mejores resultados de ese archivo.
| Puesto | Agente o modelo | Institución | Tipo | Tasa de éxito |
|---|---|---|---|---|
| 1 | Intelligence-Indeed Agent | Intelligence Indeed | Framework de agentes | 90.19 |
| 2 | claude-fable-5[1m] | Anthropic | Modelo general | 85.96 |
| 3 | Pointer Agent w/ Opus 4.7 | Pointer | Framework de agentes | 83.64 |
| 4 | claude-opus-5[1m] | Anthropic | Modelo general | 83.39 |
| 5 | Coasty CUA v1 | Coasty Team | Modelo general | 82.81 |
| 6 | Holo3-35B-A3B | H Company | Modelo especializado | 82.56 |
| 7 | Pointer Agent w/ Sonnet 4.6 | Pointer | Framework de agentes | 81.45 |
| 8 | Muse Spark 1.1 | Meta Superintelligence Labs | Modelo general | 80.67 |
De ahí salen tres cosas, y las tres dieron forma a este artículo.
Qwen-UI-Agent no está y no puede estar. La regla de envío del tablero es que concertas una reunión y los mantenedores ejecutan el código de tu agente en su lado. Sin checkpoint ni API no hay nada que puedan ejecutar. Las únicas entradas de Alibaba en toda la hoja de 66 entradas son Qwen 3.7 Plus con 73,3 y GUI-Owl-1.5 32B con 55,44. Si tomas el 79,5 autoinformado de Alibaba al pie de la letra y lo metes en esta tabla, queda en el puesto 9 de 66, fuera de los ocho primeros.
El líder es un arnés, no un modelo. Cinco de los doce primeros son frameworks de agentes que envuelven el modelo de otro, y la entrada número uno es uno de ellos con 90,19. Si esperabas comprar un modelo y listo, el tablero dice que el andamiaje vale más puntos que los pesos.
Un modelo de pesos abiertos sí está en la mezcla. Holo3-35B-A3B está sexto con 82,56, que es más que la afirmación publicada por la propia H Company de 78,85 y está verificado por alguien que no es H. Es la cifra más creíble para cualquier agente GUI descargable, y subió a Holo en mi lista.
Vale la pena señalar para quien cite estas cifras: el rendimiento humano en OSWorld es del 72,36 %, y todo lo que está en esos doce primeros lo supera. Y un detalle de nombres con el que hay que tener cuidado: Anthropic autoinforma 83,4 para Opus 4.8, mientras que la fila con 83,39 en esta hoja se llama claude-opus-5[1m] y no existe ninguna fila de Opus 4.8. La cifra coincide, la etiqueta no.
Cómo elegí y qué medí
Pasé esta semana en la documentación, las fichas de modelo, los archivos de licencia y las tarifas de cada candidato, y descarté todo lo que no pude verificar en las propias páginas del proveedor. Seis cosas decidieron la lista.
Si puedes conseguirlo hoy. Un artículo no es una alternativa. O hay pesos descargables, o hay un endpoint con precio, o queda fuera.
Quién pone la pantalla. Todos estos necesitan algo que manejar: una máquina virtual, un Chromium sin interfaz, un dispositivo Android. Casi ninguno lo aporta. Esa es la partida que todos olvidan.
Qué pantallas maneja. Navegador, escritorio y móvil son tres productos distintos con un mismo nombre, y los proveedores no son igual de honestos sobre cuáles hacen.
De quién es el arnés que produjo la puntuación. Todas las cifras de este artículo son reportadas por el proveedor salvo que diga lo contrario, y varias se midieron en benchmarks modificados. Lo señalo cada vez. El tamaño de esa brecha tampoco es hipotético. En un hilo de Launch HN le discutieron a un fundador una afirmación de SOTA y respondió con ambas cifras en una sola frase:
"We've hit 82.8% on OSWorld Verfied(on the official page) and with our latest internal testing we're hitting 85.6% which we've posted"

Eso es una prima autoinformada de 2,8 puntos, declarada con honestidad, por un proveedor cuya cifra en el tablero neutral puedo ir a comprobar. Supón que algo similar se esconde detrás de cada gráfico de esta categoría, incluido el de Alibaba.
Cuánto cuesta una ejecución. No el precio por millón, sino el coste por ejecución, que está dominado por el número de pasos porque cada paso reenvía toda la trayectoria más una captura nueva. Si quieres la misma aritmética aplicada a plantilla, nuestra comparación de costes de agentes lo hace. Los profesionales lo siguen obsesivamente, y sus cifras no son suaves:
"Numbers I was seeing: - 20 to 50 LLM calls per task - $0.50 to $3.00 per task at Claude Sonnet 4.6 prices - Half the runs drifted off-task halfway through"

Si puedes probar antes de producción. Es lo que más importa en la práctica y lo que nadie resuelve. Es un problema medio resuelto para agentes de texto, como muestra nuestra guía de OpenAI Evals, y sin resolver en cuanto la salida es un movimiento de ratón.
Sobre el coste, aquí está la aritmética que cambió mi forma de pensar sobre los presupuestos de agentes GUI. Arrastra el número de pasos y mira cómo se curva la gráfica.
Las ocho alternativas de un vistazo
| Herramienta | Ideal para | Cómo se obtiene | Pantallas que maneja | Licencia o precio | Mejor puntuación publicada y de quién es el arnés | Quién pone la pantalla | Prueba en seco antes de producción | Defensa contra inyección | Nivel gratuito |
|---|---|---|---|---|---|---|---|---|---|
| Claude computer use | Trabajo de escritorio que tiene que salir bien | API alojada, GA | Escritorio, navegador | Opus 5 $5 / $25 por MTok | 83.4% OSWorld-Verified (Opus 4.8, Anthropic) | Tú | No | Clasificadores activados por defecto | No |
| Gemini computer use | Una API para móvil y escritorio | API alojada, flag de vista previa | Navegador, móvil, escritorio | 3.7 Flash $0.75 / $3.75 por MTok | 83.0% OSWorld-Verified (3.6 Flash, Google) | Tú | No | Opcional, desactivada por defecto | No |
| OpenAI computer use | Equipos que ya usan la Responses API | API alojada, GA | Escritorio, navegador | Sol $4 / $20, Luna $0.20 / $1.20 | 92.8% Online-Mind2Web (OpenAI) | Tú | No | Política publicada, tú la aplicas | No |
| ByteDance UI-TARS | Una licencia permisiva que puedas distribuir | Pesos en Hugging Face | Escritorio, navegador, Android vía plantilla | Apache 2.0 | 27.5% OSWorld para el 8B abierto (ByteDance) | Tú | No | Ninguna | Los pesos son gratis |
| MAI-UI 8B y 2B | El primo descargable más cercano | Pesos en Hugging Face | Móvil, escritorio | Apache 2.0 | 65.7% ScreenSpot-Pro para el 8B (Alibaba) | Tú | No | Ninguna | Los pesos son gratis |
| Holo 3.1 | Pesos abiertos con respaldo alojado | Pesos más API alojada | Web, escritorio, móvil | Apache 2.0, API $0.25 / $1.80 | 82.56% OSWorld-Verified, 6.º (tablero de los mantenedores) | Tú, o los agentes gestionados de H | No | No documentada | 10 RPM, sin tarjeta |
| Browser Use | Trabajos de navegador a gran volumen | Biblioteca Python más nube | Solo navegador | Biblioteca MIT, nube desde $29/mes | 87.4% en Odysseys (alojado por terceros) | La nube pone Chromium | No | No documentada | 10 tareas/mes |
| Skyvern | Flujos con sesión iniciada y 2FA de por medio | Autoalojado o nube | Solo navegador | AGPL-3.0, nube desde $29/mes | 85.85% WebVoyager, ene. 2025 (Skyvern) | La nube pone Chromium | No | No documentada | 5.000 créditos |
Dos columnas merecen una mirada atenta. Nadie ofrece una prueba en seco, el mayor hueco operativo de toda la categoría. Y quién pone la pantalla divide la lista limpiamente: los tres laboratorios de frontera te dan un modelo y te desean suerte con la máquina virtual, mientras que Browser Use y Skyvern te dan un navegador en marcha y te dejan elegir el modelo.
1. Claude computer use
Ideal para automatización de escritorio donde un clic equivocado sale caro.
Cómo funciona. Declaras una sola entrada de herramienta y el modelo de Anthropic devuelve acciones para que las ejecute tu código. La versión actual es un conjunto de herramientas de cliente, computer_toolset_20260801, que agrupa 17 herramientas miembro tras una declaración y no necesita cabecera beta. Funciona en Fable 5, Mythos 5, Opus 5, Opus 4.8 y Sonnet 5, y notablemente no en Haiku 4.5. Lo bueno para cualquiera que construya una cadena real es que puedes darle al mismo modelo una herramienta bash y un editor de archivos en el mismo array tools, para que pueda salir de la GUI y pasar a una terminal a mitad de tarea.
Vale la pena conocer dos superficies vecinas si vas por aquí: Claude Managed Agents para alojar y supervisar el bucle, y la plataforma de escritorio de Claude si prefieres limitar un agente a una app en lugar de a todo un sistema operativo.
Lo que me gusta. Las puntuaciones son las mejores publicadas en escritorio: 83,4 % en OSWorld-Verified para Opus 4.8, y 70,57 % en el nuevo y más difícil OSWorld 2.0 para Opus 5 frente al 62,6 de GPT-5.6 Sol. Pero lo que realmente valoro es la capa de seguridad. Declaras la herramienta oficial y Anthropic ejecuta automáticamente clasificadores de inyección de prompts sobre cada captura, y cuando uno salta, se guía al modelo para que te pida confirmación antes de volver a actuar. Anthropic dice que corre en paralelo a la inferencia con latencia añadida casi nula y sin coste adicional. Nadie más de esta lista lo incluye activado por defecto.
Dónde se queda corto. No hay historia móvil en absoluto. El entorno de referencia es X11 en Linux dentro de un contenedor, el vocabulario es enteramente de ratón y teclado, y no hay tocar, deslizar ni pellizcar en ninguno de los 17 miembros. Así que justo en el eje donde Qwen-UI-Agent es más fuerte, esto no es un sustituto. Anthropic también enumera la latencia como su primera limitación, con sus propias palabras, posiblemente demasiado lento comparado con una persona haciendo los mismos clics. Y el sobrecoste de tokens es real: la definición del conjunto de herramientas cuesta unos 4.520 tokens de entrada en cada solicitud antes de que hayas enviado un píxel, y cada captura suma entre 1.000 y 1.800. Otra trampa para quien implemente: la API no reduce las imágenes demasiado grandes por ti, las rechaza.
Precios.
| Modelo | Entrada / MTok | Salida / MTok | Lectura de caché | Notas |
|---|---|---|---|---|
| Opus 5 | $5.00 | $25.00 | $0.50 | El modo rápido es exactamente 2x |
| Opus 4.8 | $5.00 | $25.00 | $0.50 | Tiene la puntuación del 83,4 % |
| Sonnet 5 | $2.00 | $10.00 | $0.20 | Conjunto de herramientas compatible |
| Fable 5 | $10.00 | $50.00 | $1.00 | Conjunto de herramientas compatible |
| Haiku 4.5 | $1.00 | $5.00 | $0.10 | Conjunto de herramientas no compatible |
El modo por lotes reduce a la mitad ambos lados, el contexto completo de 1M se cobra a tarifas estándar sin escalón, y el uso del ordenador es apto para retención cero de datos porque el bucle corre de tu lado.
Veredicto: si el trabajo ocurre en un escritorio y el alcance de un error es más que una molestia, este es con el que empezaría, y los clasificadores de inyección integrados son la razón. Descártalo si el trabajo ocurre en un teléfono, porque simplemente no puede. Si la preocupación es la dependencia del proveedor y no la capacidad, nuestra lista de alternativas a Claude cubre el resto del campo. Quien compare a los dos grandes proveedores de API de tú a tú sacará más de nuestra guía de API de OpenAI frente a Anthropic que de un gráfico de benchmarks.
2. Gemini computer use
Ideal para cubrir móviles y escritorios desde un único endpoint alojado.
Cómo funciona. Ya no hay un modelo dedicado de uso del ordenador. Google integró la capacidad en una herramienta computer_use incorporada que se acopla a modelos Flash generales, y el antiguo gemini-2.5-computer-use-preview-10-2025 ahora está etiquetado como vista previa heredada. La herramienta en sí no cuesta nada extra, se factura como tokens normales a la tarifa del modelo. Las coordenadas vuelven normalizadas a una cuadrícula de 0 a 999, y Google es explícito en que es una herramienta del lado del cliente, así que el bucle lo ejecutas tú.
Lo que me gusta. Es la única API alojada de la lista con un entorno móvil documentado, y eso es un diferenciador real y no una frase de marketing. Hay tres tablas de acciones separadas: ENVIRONMENT_BROWSER con 21 acciones, ENVIRONMENT_MOBILE con 10 que Google describe como optimizadas para Android y que añade open_app, list_apps y long_press mientras elimina scroll y hotkey, y ENVIRONMENT_DESKTOP con 17 para control del cursor a nivel de sistema operativo. La trayectoria en escritorio también es empinada: OSWorld-Verified pasó de 65,1 en 3 Flash a 78,4 en 3.5 Flash y a 83,0 en 3.6 Flash, lo que deja a Google a medio punto de lo mejor de Anthropic. Y es, con diferencia, la ruta alojada más barata.
Dónde se queda corto. La divulgación es desordenada de una forma que te costará una tarde. La página de índice de modelos aún lista solo el modelo 2.5 heredado entre los modelos de herramientas y agentes, la puntuación más alta de OSWorld que publica Google pertenece a un modelo que la página de uso del ordenador no lista, y el uso del ordenador sigue figurando como "Supported (Preview)" incluso en gemini-3.7-flash, ya disponible de forma general. Google tampoco ha vuelto a publicar Online-Mind2Web, WebVoyager ni AndroidWorld para ningún modelo 3.x, así que la capacidad móvil tiene un espacio de acciones documentado y ningún benchmark actual detrás. La detección de inyección de prompts existe pero viene desactivada por defecto, lo contrario de la postura de Anthropic. No hay nivel gratuito para esto en absoluto. Y el precio del modelo recomendado se duplica el 1 de enero de 2027.
Precios.
| Modelo | Entrada / MTok | Salida / MTok | Nota |
|---|---|---|---|
gemini-3.7-flash | $0.75 | $3.75 | Recomendado. Sube a $1.50 / $7.50 el 1 ene. 2027 |
gemini-3.5-flash | $1.50 | $9.00 | |
gemini-3.5-flash-lite | $0.30 | $2.50 | La ruta más barata de todo este artículo |
gemini-2.5-computer-use-preview | $1.25 | $10.00 | Vista previa heredada |
Veredicto: la opción si necesitas un solo proveedor para navegador, escritorio y Android, y la opción si el coste por ejecución es la restricción determinante. Activa la detección de inyección antes de hacer cualquier otra cosa y calcula tu presupuesto de 2027 con el precio posterior al aumento. Nuestro desglose de los precios de Gemini 3 tiene la tarifa más amplia si lo estás modelando en serio, y Gemini Agentic Vision cubre cómo la captura se convierte en un objetivo de clic. Sopesar a Google frente al resto del campo es tarea de nuestro artículo de alternativas a Gemini.
3. OpenAI computer use
Ideal para equipos cuya pila ya termina en la Responses API.
Cómo funciona. computer-use-preview está obsoleto y fuera de la tarifa. El uso del ordenador ahora es tools: [{ type: "computer" }] en los tres niveles de GPT-5.6, sin cargo por llamada por la herramienta en sí. La guía documenta tres formas de arnés en lugar de una, algo que agradecí: el bucle integrado que devuelve acciones de interfaz estructuradas, una herramienta personalizada sobre un arnés de Playwright o Selenium que ya tengas, y un arnés de ejecución de código donde el modelo alterna entre hacer clic y escribir scripts cortos. El vocabulario de acciones es de nueve tipos, y se agrupan en un array actions[] en lugar de ir de una en una.
Lo que me gusta. Las cifras de navegador son con diferencia las más fuertes aquí: 92,8 % en Online-Mind2Web, 67,3 % en WebArena-Verified, 90,4 % en BrowseComp. OpenAI también publica un resultado de cliente y no solo un benchmark, con un 95 % de éxito al primer intento en unos 30.000 portales de impuesto predial, subiendo al 100 % en tres intentos. Y el nivel Luna abarata la experimentación a $0,20 de entrada y $1,20 de salida.
Dónde se queda corto. Sin móvil, confirmado de cinco maneras: los dos entornos documentados son de escritorio, las resoluciones recomendadas se llaman de escritorio, no hay tocar, deslizar ni volver en el vocabulario, y todo benchmark publicado es de escritorio o navegador. El modelo de seguridad también fue en la dirección equivocada. La herramienta de disponibilidad general eliminó el apretón de manos pending_safety_checks de la era de la vista previa, así que lo que obtienes ahora es una política de confirmación de tres niveles publicada, un fragmento de prompt contra inyección listo para pegar y la instrucción de mantener una lista de dominios permitidos, todo lo cual implementas tú. Conviene saber antes de planificar en torno al lado de consumo: ChatGPT agent está retirado, y su sustituto, el navegador en la nube de ChatGPT Work, no aceptará credenciales, no usará autocompletado ni gestor de contraseñas, no iniciará sesión en sitios web ni completará pagos. La propia API de OpenAI supera a su propio agente de consumo por 21,9 puntos en Online-Mind2Web.
Precios.
| Modelo | Entrada / MTok | En caché | Salida / MTok | Contexto largo ent. / sal. |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $20.00 | $8.00 / $30.00 |
gpt-5.6-terra | $2.00 | $0.20 | $12.00 | $4.00 / $18.00 |
gpt-5.6-luna | $0.20 | $0.02 | $1.20 | $0.40 / $1.80 |
Batch y Flex cuestan la mitad, el modo rápido el doble, y son tarifas promocionales hasta el 21 de noviembre de 2026. La publicación de lanzamiento listaba Sol a $5 / $30 y Luna a $1 / $6, así que Luna funciona ahora a una quinta parte de su propio precio de lista. También hay un límite de nivel de contexto largo en 270K tokens que un bucle de capturas alcanza más rápido de lo que pensarías, y el nivel gratuito no es compatible en absoluto. Del lado del consumidor, las cifras están en nuestra guía de precios de Atlas, un producto distinto a otro precio.
Veredicto: la opción centrada en el navegador, y la que elegiría si el sistema circundante ya habla de function calling y prefieres añadir una herramienta antes que adoptar un proveedor. Reserva tiempo de ingeniería para la capa de seguridad, porque ese trabajo ahora es tuyo. Consulta modelos de OpenAI para ver cómo se diferencian los tres niveles en otros sitios.
4. ByteDance UI-TARS
Ideal para una licencia permisiva que realmente puedas distribuir en un producto comercial.
Cómo funciona. Seis checkpoints están en la organización ByteDance-Seed bajo Apache 2.0, sin restricción ni aceptación por clic: un 2B, dos variantes de 7B, dos variantes de 72B y el 1.5-7B que todo el mundo usa de verdad. Los nombres de los repositorios quedan cortos en tamaño, ya que el "7B" tiene en realidad 8,3B parámetros y el "72B" 73,4B. Incluye tres plantillas de prompt, COMPUTER_USE, MOBILE_USE y GROUNDING, así que el móvil es una capacidad documentada del modelo con las acciones long_press, open_app, press_home y press_back.
Lo que me gusta. Apache 2.0 sin cláusula no comercial, confirmado en el archivo LICENSE, en las seis fichas de modelo y en el repositorio de la app de escritorio. El ecosistema alrededor del 8B es el más profundo de cualquier agente GUI abierto: 11 ajustes finos, 13 cuantizaciones y builds GGUF preparados para llama.cpp, LM Studio, Jan y Ollama. Por eso tiene unas 808.000 descargas al mes mientras que el 72B tiene 446. Puedes tener un agente GUI funcionando en un portátil esta noche, comercialmente, gratis.
Dónde se queda corto. Los benchmarks de titular pertenecen a un modelo que no puedes tener. La tabla de escala de ByteDance pone al 1.5-7B descargable en un 27,5 % en OSWorld y un 49,6 % en ScreenSpot-Pro, frente a 42,5 % y 61,6 % del 1.5 interno que cubrió la prensa. Son 15 y 12 puntos de diferencia, y curiosamente el 72B puntúa peor que el 7B en ambos. El panel de evaluación comunitaria de Hugging Face lo enturbia aún más al atribuir al 7B un 61,6 % en ScreenSpot-Pro, contradiciendo el 49,6 % de ByteDance, así que trata esa columna como no resuelta. UI-TARS-2 se anunció en septiembre de 2025 y nunca ha tenido pesos, algo que el propio informe de Alibaba confirma de forma independiente al listarlo como código cerrado. ByteDance no ha publicado ninguna cifra de OSWorld-Verified a pesar de figurar como contribuyente de la corrección que la produjo.
La imagen del impulso es lo que más pesaría. El repositorio del modelo tiene 11.374 estrellas, cero etiquetas, cero versiones y un último commit del 5 de septiembre de 2025. El monorepo de escritorio tiene 38.697 estrellas y un último commit de julio de 2026. Las herramientas están vivas y la línea de modelos está congelada. La app instalable es solo para macOS y Windows, sin build para Linux, y la última versión con instaladores es la v0.2.4 de agosto de 2025, mientras que /releases/latest resuelve a una versión de CLI sin archivos adjuntos, que es justo el enlace en el que la guía de inicio rápido te dice que hagas clic.
Si estás dimensionando un modelo pequeño para tu propio hardware en lugar de perseguir una clasificación, nuestro artículo sobre modelos de lenguaje pequeños es un mejor marco para esta decisión que cualquier tabla de benchmarks.
Precios. Los pesos son gratis. La ruta alojada es doubao-1-5-ui-tars-250428 en Volcengine a ¥1,75 por millón de entrada y ¥3,50 por millón de salida listados, aunque esa página renderiza sus precios en el cliente, así que volvería a comprobarlo antes de presupuestar, y Volcengine es una nube de la región de China. El sucesor Doubao-Seed-2.1-Pro figura a ¥6 y ¥30, un producto distinto a otro precio. Para un despliegue occidental, el autoalojamiento o un proveedor de inferencia de terceros es el camino práctico.
Veredicto: cógelo por la licencia y el ecosistema, no por la puntuación, y calibra con 27,5 % en lugar de 42,5 %. Vale la pena nombrar un riesgo en voz alta: la propia sección de limitaciones de ByteDance señala que el modelo maneja CAPTCHAs, lo describe como una preocupación de acceso no autorizado, y no hay ninguna salvaguarda técnica en un checkpoint Apache 2.0. Si estás sopesando pesos abiertos en general, nuestro artículo de alternativas a Kimi K2.5 cubre cómo se valora el resto de ese campo.
5. MAI-UI 8B y 2B
Ideal para lo más parecido a Qwen-UI-Agent que realmente puedes descargar, del mismo laboratorio.
Cómo funciona. Son los dos checkpoints que el equipo MAI de Alibaba sí publicó, subidos el 25 de diciembre de 2025 y anunciados cuatro días después, ambos Apache 2.0, ambos con arquitectura qwen3_vl. MAI-UI-8B tiene 8,77B parámetros en cuatro fragmentos con 16,33 GiB, y MAI-UI-2B tiene 2,13B en un solo archivo de 3,96 GiB. Son los predecesores directos de Qwen-UI-Agent, lo que los convierte en el sustituto más honesto de lo que realmente aporta el posentrenamiento de ese equipo.
Lo que me gusta. Mismo laboratorio, mismo linaje, Apache 2.0 y lo bastante pequeños para ser prácticos. El 2B en particular cabe cómodamente en una tarjeta de 8 GB según la aritmética de los pesos. Existen cuantizaciones de la comunidad para ambos, siete para el 8B y cinco para el 2B. Y el propio benchmark MobileWorld se puede descargar libremente aunque el modelo que lo lidera no, así que al menos puedes evaluar con honestidad.
Dónde se quedan cortos. Lee las fichas de modelo con cuidado, porque imprimen cifras de los buques insignia de la familia en lugar de las de los propios checkpoints. El 76,7 % en AndroidWorld de la ficha del 2B pertenece a un modelo de 235B que nunca salió. Las únicas cifras por tamaño que el equipo ha publicado son de ScreenSpot-Pro sin zoom, del registro de novedades del repositorio: 67,9 % para un 32B que tampoco salió, 65,7 % para el 8B y 57,4 % para el 2B. Frente al 76,6 % de Qwen-UI-Agent en el mismo ajuste, eso es 10,9 y 19,2 puntos por detrás en grounding. En trabajo de extremo a extremo la brecha es mucho más fea: el mejor resultado de MAI-UI en MobileWorld fue 41,7 % frente a 82,1 %, una diferencia de 40,4 puntos. El grounding es casi un problema resuelto en pesos abiertos. Terminar un flujo de varios pasos no lo es.
Dos notas prácticas. No se publica ninguna cifra de VRAM en ningún sitio, ni en ninguna de las dos fichas ni en el repositorio, así que los números anteriores son mi aritmética a partir del tamaño de los pesos y no una afirmación del proveedor. Y ningún proveedor de inferencia de Hugging Face sirve ninguno de los dos modelos, así que local es la única ruta.
Precios. Gratis, Apache 2.0, y todo el coste es tu tiempo de GPU.
Como contexto de cómo el resto del mundo de pesos abiertos fija expectativas, Mistral AI publica más detalle por checkpoint que cualquiera de estas dos fichas. DeepSeek V3.2 también.
Veredicto: el modelo más interesante de aquí para entender lo que será Qwen-UI-Agent, y uno de los más débiles para trabajar de verdad. Ejecutaría el 8B para aprender el espacio de acciones y calibrar expectativas, y luego usaría una API alojada para todo lo que vea un cliente. También dice algo que la colección MAI-UI siga mostrando dos elementos, actualizada por última vez el 6 de enero de 2026, seis meses antes de que se anunciara Qwen-UI-Agent.
6. Holo 3.1
Ideal para pesos abiertos cuando además quieres un endpoint alojado como respaldo.
Cómo funciona. H Company, con sede en París, ha lanzado cinco generaciones en doce meses, y Holo 3.1 llegó el 1 de junio de 2026. Lo que lo hace inusual es que el mismo checkpoint se vende de dos formas. La API de H documenta un modo de bucle de agente, donde Holo es el cerebro de un agente de navegador o escritorio, y un modo de localización de elementos, donde le pasas una imagen más una descripción del objetivo y recibes {x, y} en una cuadrícula de 0 a 1000. Ese segundo modo lo convierte en un componente de grounding listo para usar dentro del agente de otra persona, algo que no ofrece ninguna de las API de frontera.
Lo que me gusta. Es la única entrada de todo el artículo cuya cifra de titular no tuve que aceptar por confianza. Holo3-35B-A3B está sexto en el tablero OSWorld-Verified de los mantenedores con 82,56 %, por delante de Muse Spark 1.1 de Meta y a menos de un punto de la fila Opus de Anthropic, y es el único modelo especializado de pesos abiertos entre los seis primeros. La afirmación publicada por H para Holo3 era 78,85 %, así que por una vez el proveedor se infravaloró.
Además, Holo 3.1 es el lanzamiento más permisivo que ha hecho H: siete checkpoints todos Apache 2.0, que abarcan 0,8B, 4B, 9B y un 35B-A3B de mezcla de expertos, además de builds FP8, NVFP4 y Q4 GGUF del buque insignia. H informa de que los builds cuantizados quedan a unos dos puntos del checkpoint BF16 en OSWorld. El móvil es la mejora principal de esta generación, con AndroidWorld pasando del 67 % al 79,3 % en el 35B-A3B. Y el precio alojado es el más bajo de cualquier modelo de este artículo, a $0,25 de entrada y $1,80 de salida, con un nivel gratuito de 10 solicitudes por minuto y sin tarjeta.
Dónde se queda corto. La generosidad de la licencia tiene un filo. En generaciones anteriores el patrón era modelos pequeños Apache 2.0 y grandes solo de investigación: Holo2-30B-A3B y Holo2-235B-A22B son ambos CC BY-NC 4.0, igual que Holo1.5-72B, así que ninguno es utilizable en un producto sin llamar a H. Y el buque insignia actual fue más allá de solo investigación. holo3-122b-a10b no tiene pesos en absoluto, solo API, y la propia lista de modelos de H lo dice. Dos páginas de H discrepan en un punto sobre la cifra de AndroidWorld de la variante pequeña, 71 % frente a 72 %. La cuadrícula por benchmark de Holo 3.1 se publica solo dentro de una imagen en la ficha del modelo, no como texto. Su compuesto de titular incluye H Corporate Benchmarks, 486 tareas construidas con la propia fábrica de entornos sintéticos de H, así que cualquier afirmación de Pareto de ese gráfico se califica en parte con deberes no publicados. Y el producto gestionado Computer-use Agents de julio de 2026 no publica ninguna tarifa.
Precios.
| Ruta | Tarifa | Contexto | Notas |
|---|---|---|---|
| Pesos, familia Holo 3.1 | Gratis, Apache 2.0 | n/d | 0.8B a 35B-A3B, más FP8, NVFP4, GGUF |
API holo3-1-35b-a3b | $0.25 ent. / $1.80 sal. por MTok | 65.536 | Function calling, nivel gratuito 10 RPM |
API holo3-122b-a10b | $0.40 ent. / $3.00 sal. por MTok | 65.536 | Sin pesos, sin function calling |
| Computer-use Agents | No publicado | n/d | Navegador y escritorio en vivo, móvil no listado |
Veredicto: mi elección entre las opciones de pesos abiertos, y la única que pondría por delante de una API alojada por méritos, porque el 82,56 % está en el tablero de otro y no en el de H. También es la opción mejor formada para un equipo que quiere empezar alojado y pasar a autoalojado sin cambiar de familia de modelos, y la única donde los mismos pesos pueden servir como subrutina de grounding dentro de otro agente. Lee la licencia de la generación que elijas en lugar de darla por sentada, porque cambia entre tamaños y el buque insignia actual no tiene pesos.
7. Browser Use
Ideal para tareas de navegador que necesitas ejecutar mil veces sin vigilancia.
Cómo funciona. Es la opción que más gente describe mal, así que vale la pena ser exacto. Browser Use empezó como un arnés y no como un modelo: una clase Agent que ejecuta el bucle observar, decidir, actuar contra Chromium, con el LLM como argumento intercambiable del constructor. Ahora también incluye modelos, endpoints alojados bu-* con bu-2-0 por defecto más un bu-30b-a3b-preview de pesos abiertos. Pero el arnés es anterior al modelo y no lo requiere, y la lista de proveedores es inusualmente larga: Google, OpenAI, Anthropic, Azure, Bedrock, Groq, Cerebras, DeepSeek, Mistral, OpenRouter, LiteLLM, Ollama local y cualquier cosa compatible con OpenAI mediante una URL base personalizada. Aportas tu propia clave en todos los casos.
Lo que me gusta. 110,3k estrellas, 12,1k forks, MIT en la biblioteca y un ritmo de lanzamientos que no ha bajado. También es la única entrada donde la nube aporta el navegador, lo que elimina el mayor coste oculto de toda la categoría. Y los precios son inusualmente legibles: las suscripciones compran un fondo de créditos dólar por dólar que drenan dos medidores, así que puedes hacer previsiones de verdad.
Dónde se queda corto. Solo navegador, y son directos al respecto. Cada sesión es un Chromium remoto al que se llega por CDP, la superficie de la API es /runs y /browsers, y se posicionan en contra de los agentes de uso del ordenador en lugar de como uno. Ojo con una trampa sutil en su documentación: macOS, Windows y Linux aparecen como huellas que imita el modo sigiloso, no como plataformas que se manejan. Las más de 1.000 integraciones son API a las que llama el agente, no aplicaciones que maneje.
Su historia de benchmarks también necesita lectura con cuidado. El 89,1 % tantas veces citado en WebVoyager salió de una ejecución con gpt-4o, con código y prompts modificados, 55 tareas eliminadas y evaluaciones fallidas o desconocidas corregidas a mano, y la propia Browser Use dice en esa publicación que el benchmark no está probando realmente lo correcto. Su titular actual es un 82 % de precisión estricta en un conjunto interno de tareas no públicas. La afirmación más sólida es la alojada por terceros: primer puesto en Odysseys con 87,4 % en 200 tareas web de largo plazo. Ten en cuenta además que MIT cubre solo la biblioteca, que la nube se rige por términos aparte y que la documentación te remite a la nube para CAPTCHAs, gestión de memoria y ejecución en paralelo.
Precios.
| Plan | Mensual | Créditos | Sesiones simultáneas |
|---|---|---|---|
| Free | $0 | Solo recargas, 10 tareas/mes | 3, o 10 tras una recarga |
| Dev | $29 | $29 | 25 |
| Business | $299 | $299 | 200 |
| Scaleup | $999 | $999 | 500 |
Los dos medidores de debajo importan más que el plan. La infraestructura de navegador se factura a $0,02 por hora de navegador, que es nada, mientras que el proxy gestionado se factura a $5 por GB, bajando a $4 en Scaleup, y la salida sin proxy a $0,20 por GB. Un gigabyte de tráfico por proxy cuesta lo mismo que 250 horas de navegador, así que el proxy es el verdadero centro de coste. Los agentes alojados funcionan a 1,2x las tarifas del proveedor subyacente, y traer tu propia clave añade una comisión de orquestación de 0,2x, así que BYOK te compra control y no ahorro. Ejecutar BU 2.0 en tu propia biblioteca es el camino más barato, a $0,60 de entrada y $3,50 de salida sin cargo por hora de navegador. No se publica ningún plan empresarial, así que los SLA y los términos de retención dependen de ventas.
Veredicto: si el objetivo es un sitio web, empieza aquí en lugar de con una API de uso del ordenador de frontera. Obtienes un navegador en marcha, un modelo intercambiable y una factura predecible, y el resultado de terceros en Odysseys es la cifra más creíble de este artículo. Quien lo compare con un simple scraper debería leer antes nuestro artículo de alternativas de web scraping, porque muchos trabajos que parecen de agente no lo son.
8. Skyvern
Ideal para flujos web con sesión iniciada donde el 2FA es el verdadero obstáculo.
Cómo funciona. Skyvern no es solo visión, y esa es la decisión de diseño que lo define. Una captura y un árbol DOM simplificado van juntos al modelo, y su propio planteamiento es que la imagen aporta el diseño y el contexto visual mientras el DOM aporta los identificadores de elemento a los que Playwright puede apuntar. Luego Playwright ejecuta. Las credenciales se inyectan en el navegador y no en el prompt, así que el modelo nunca las ve. Su ablación está publicada de forma refrescante: un solo actor puntúa alrededor del 45 % en WebVoyager, añadir un planificador lo lleva al 68,7 %, y añadir un validador al 85,85 %.
Lo que me gusta. Es la única entrada aquí construida en torno a la realidad aburrida del trabajo web con sesión iniciada, y esa realidad es justo donde el enfoque de pura visión se cae. Un profesional que ejecutó cuatro agentes en paralelo describió el umbral así:
"the pattern that actually mattered wasn't which agent, it was that any task with login + 3 or more steps breaks on every screenshot-driven approach. … once you drop the browser sandbox and drive the OS accessibility tree directly, you get real element handles instead of pixel guesses and the failure rate falls roughly 4x on long tasks."
El diseño de DOM más captura de Skyvern es la misma idea aplicada una capa más arriba. Además: se gestionan segundos factores TOTP, por correo y por SMS, hay una bóveda de credenciales con soporte para Bitwarden, 1Password y Azure Key Vault, y un botón "Take Control" que devuelve una sesión en vivo a una persona a mitad de ejecución. Route Memorization es la parte inteligente de la hoja de ruta: compilar una ejecución exitosa del agente en un script barato de Playwright que se autorrepara cuando se rompe, algo que ya se entrega como caché de código. Es la respuesta correcta al coste por paso.
Dónde se queda corto. La licencia tiene una salvedad que necesitas leer. El README dice que la lógica central es AGPL-3.0 con la excepción de las medidas anti-bot disponibles en la nube gestionada, así que la capa anti-bot deliberadamente no está en el repositorio. El autoalojamiento no tiene coste de software pero tiene dos precipicios: allí no existe la resolución automática de CAPTCHA, y el agente en su lugar se detiene 30 segundos para intervención manual. Las afirmaciones sobre CAPTCHA también se estrechan a medida que profundizas, desde la resolución nativa sin servicios de terceros de la página de inicio hasta documentos que nombran tipos concretos y luego dicen que resolver no está garantizado. Solo navegador, en sus propias palabras, si ocurre en un navegador que Skyvern pueda ejecutar. La cifra de 85,85 % en WebVoyager es de enero de 2025 con GPT-4o y 8 tareas eliminadas, y Skyvern dice en esa misma página que la clasificación ha avanzado desde entonces. Su cifra más reciente es 64,4 % en su propio WebBench. Algunas de sus propias páginas también se contradicen, en el número de acciones del nivel gratuito y en la cobertura de países del proxy.
Precios.
| Free | Hobby | Pro | Enterprise | |
|---|---|---|---|---|
| Precio | $0 | $29/mes | $149/mes | A medida |
| Créditos | 5.000 únicos | 30.000/mes | 150.000/mes | A medida |
| Acciones estimadas | ~170 | ~1.200 | ~6.200 | A medida |
| Ejecuciones simultáneas | 1 | 10 | 25 | 100 |
| 2FA y TOTP | No | No | Sí | Sí |
| Proxy | Centro de datos | Centro de datos | Residencial | Residencial |
El coste en créditos por paso nunca se publica, así que lo derivé: unos 25 créditos por acción salen a unos $0,024 por paso en ambos niveles de pago, idéntico en cada uno, lo que significa que la mejora compra volumen, concurrencia y 2FA y no una mejor tarifa unitaria. Una tarea típica lleva de 2 a 10 pasos, así que unos $0,05 a $0,24. No se publica en ningún sitio una tarifa de exceso, y las ejecuciones fallidas siguen consumiendo crédito.
Veredicto: la opción del especialista, y los especialistas están infravalorados. Si el trabajo es entrar en un portal que no es tuyo y completar un formulario tras un segundo factor, esto está mejor planteado que cualquier API general de uso del ordenador. Ten presente el 2FA al comparar niveles, porque empieza en $149 y no en $29. Si estás sopesando un agente que aprende frente a selectores codificados a mano, nuestro artículo de agente de IA frente a chatbot plantea bien ese equilibrio.
La cifra que nadie cita del artículo de Qwen-UI-Agent
Este es el hallazgo que reformuló la categoría para mí, y viene de las propias trazas del establecido y no de un competidor.
El espacio de acciones de Qwen-UI-Agent no es puramente gráfico. Junto a click, type, drag y long_press expone cli_command para bash, api_call, ask_user y terminate. Así que cuando el modelo ejecuta una tarea de escritorio puede elegir entre hacer clic en un botón y escribir un comando. Y elige mucho el comando. En OSWorld-Verified, las acciones CLI son el 40,7 % de todas las acciones y aparecen en el 92,0 % de las tareas. En el más difícil OSWorld-v2, sube a 55,1 % de las acciones en el 98,2 % de las tareas.
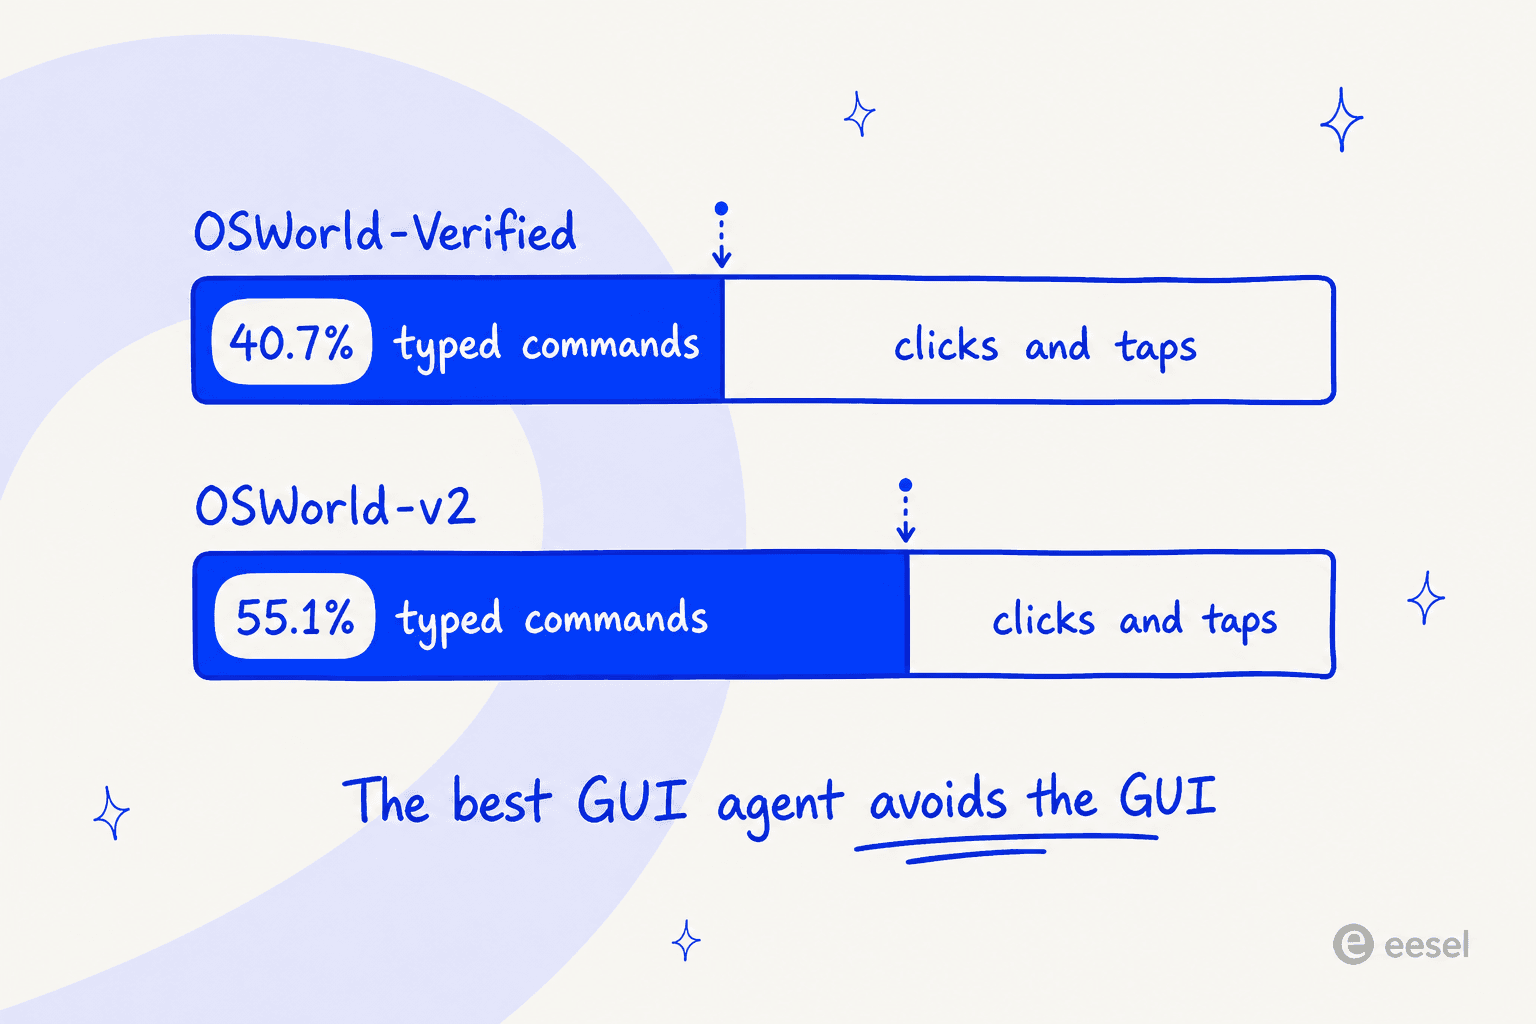
Léelo otra vez. El mejor agente que maneja pantallas publicado en 2026, con libertad de elección, dedica más de la mitad de sus acciones en el benchmark de escritorio más difícil a no manejar la pantalla.
Las cifras de ByteDance dicen lo mismo desde el otro lado. UI-TARS-2 puntúa 29,6 % en BrowseComp con su conjunto completo de herramientas, y 7,0 % cuando se restringe a operación solo GUI sin SDK. Es su propia ablación, y significa que aproximadamente tres cuartas partes de esa puntuación vinieron del acceso a terminal y herramientas y no de los píxeles.
Por eso las herramientas CLI con agentes rinden discretamente mejor que los agentes de pantalla en todo lo que una terminal alcanza, y por eso una automatización basada primero en API como Zapier AI supera a una que hace clic en píxeles siempre que exista el endpoint.
La conclusión práctica es una pregunta que hacer antes de elegir nada de la tabla anterior: ¿tiene este trabajo una API? Si la tiene, un agente que maneja la pantalla es la forma cara, frágil e inauditable de hacer algo que podrías hacer con una llamada autenticada. Los agentes GUI se ganan el sueldo en las superficies que no tienen API, que es una categoría real y grande: herramientas internas heredadas, portales gubernamentales, software de escritorio de 2009, paneles de proveedores sin historia de integración. Simplemente es mucho más pequeña de lo que sugieren las demos.
La mitad de los fallos nunca fueron culpa del modelo
Lo otro útil del informe de Qwen-UI-Agent es la Tabla 10, donde los autores tomaron un modelo base, Qwen 3.7 Plus, y clasificaron cada una de sus trayectorias fallidas en dispositivos reales en lugar de solo reportar una tasa de éxito. No he visto a ningún otro laboratorio publicar esto, y debería cambiar cómo presupuestas.
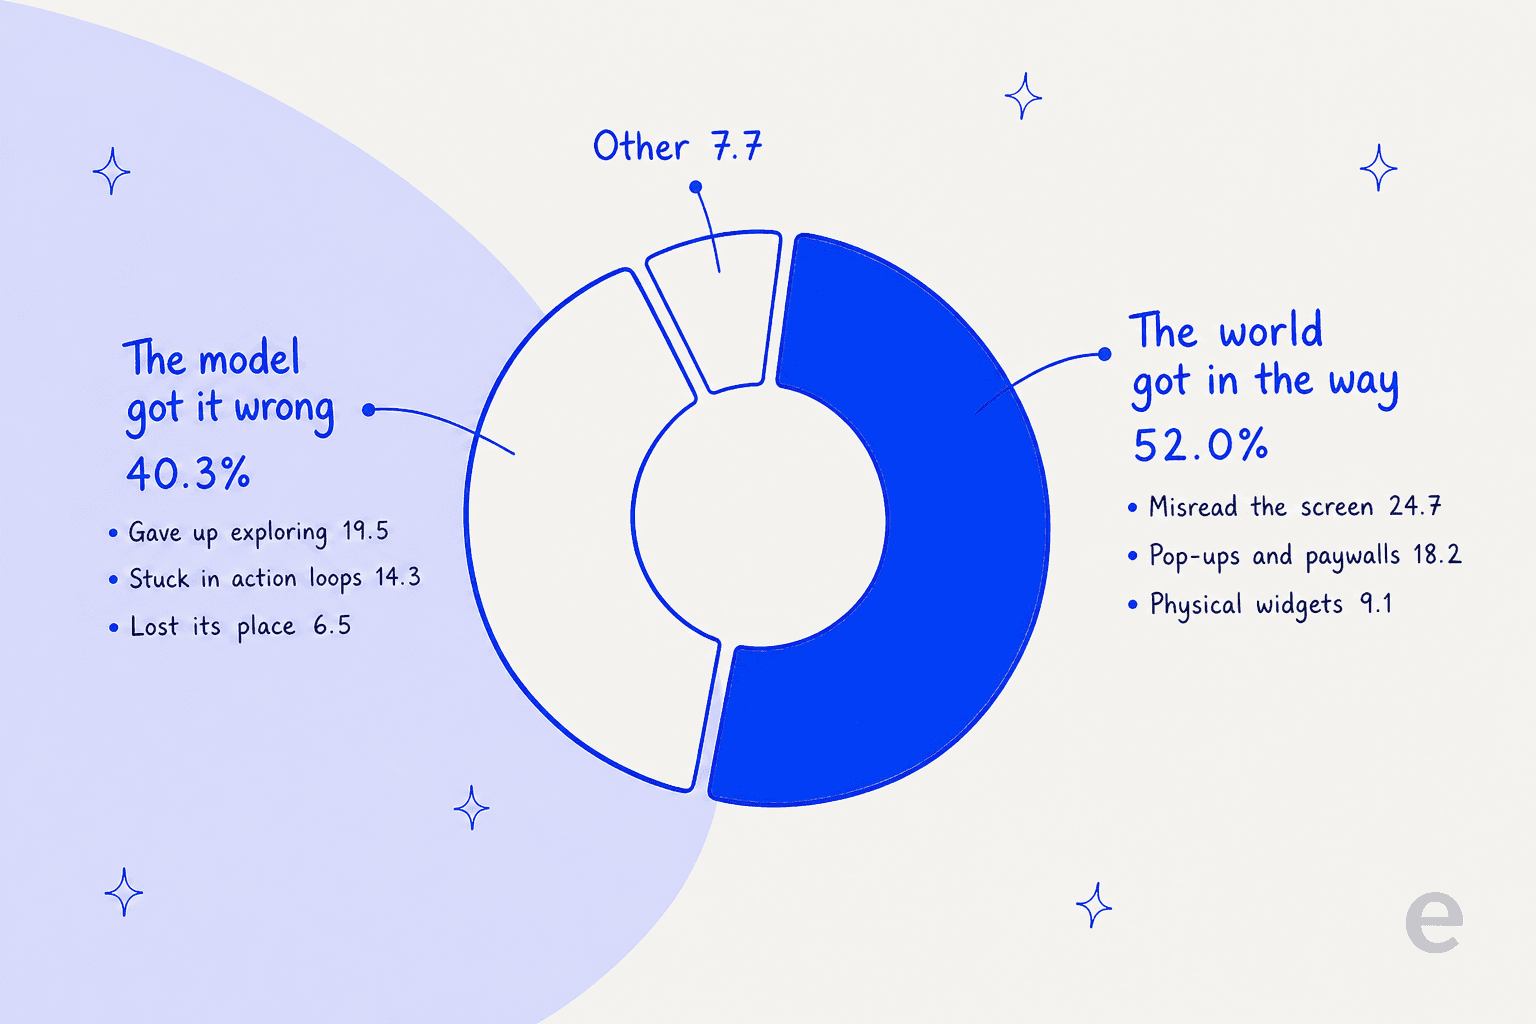
En las ejecuciones fallidas de Qwen 3.7 Plus, los desafíos del escenario del mundo real suponen el 52,0 %: leer mal la interfaz con 24,7 %, interferencia de ventanas emergentes, anuncios, muros de pago y CAPTCHAs con 18,2 %, y problemas con widgets físicos con 9,1 %. Las limitaciones de capacidad de ejecución suponen el 40,3 %: no explorar con 19,5 %, quedarse atascado en bucles de acciones con 14,3 % y perder el estado de ejecución con 6,5 %. Qwen-UI-Agent es el modelo más fuerte, así que su propia mezcla será distinta, pero la forma de la distribución es el hallazgo.
La razón por la que importa esta división es que comprar un modelo mejor solo aborda la mitad más pequeña. Un diálogo modal, un banner de cookies, un muro de pago y un CAPTCHA no son problemas del modelo, y son la mayoría de lo que sale mal. Por eso la partida de proxy de Browser Use y el manejo de CAPTCHA de Skyvern no son características incidentales. Atacan la distribución real de fallos, mientras que una API de frontera ataca el 40 %.
Una salvedad que debo señalar, ya que me he apoyado en las cifras de Alibaba todo el tiempo. MobileWorld-Real es el benchmark propio de Alibaba, y lo puntúa AutoJudge, el propio juez agente de Alibaba, que el artículo reporta con un 92,8 % de precisión de coincidencia exacta en 666 ejemplos examinados por expertos. Los autores enumeran el error del juez como su primera limitación declarada, que es el instinto correcto. Las apps de demostración son además del ecosistema de consumo chino, así que el 92,2 % en dispositivos reales es una señal sobre el método y no una promesa sobre el SaaS occidental.
Toda alternativa abierta es un ajuste fino de Qwen
Esto me pilló por sorpresa. Fui a buscar una salida arquitectónica de Alibaba y no la hay.
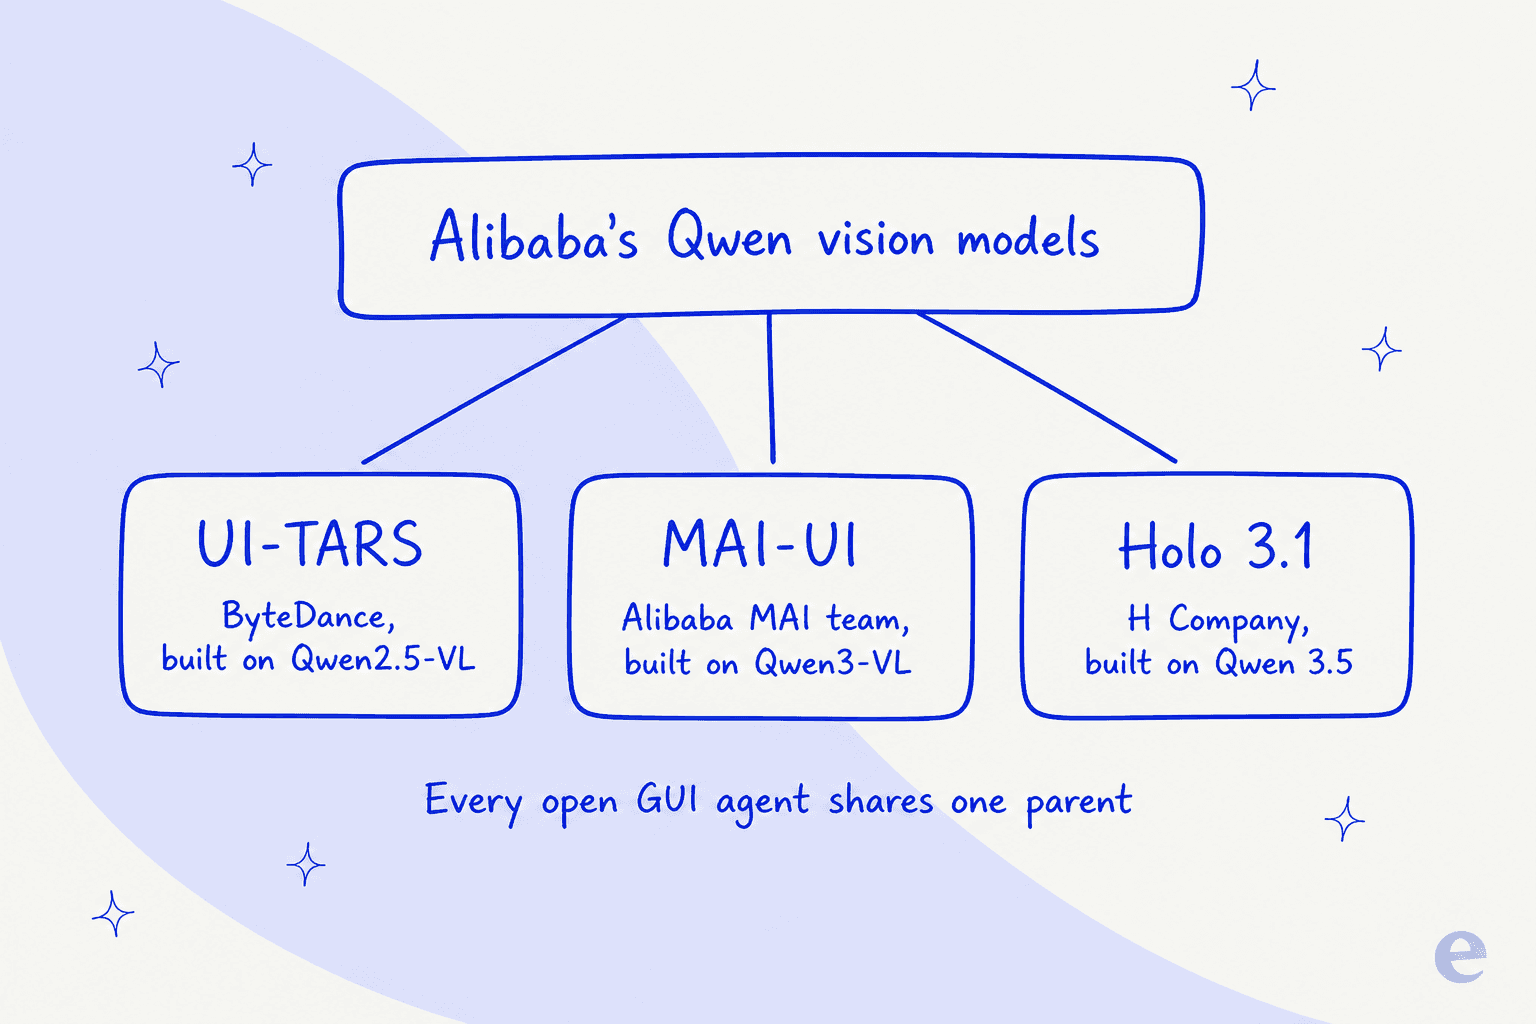
UI-TARS-1.5-7B está entrenado a partir de Qwen2.5-VL-7B, dicho explícitamente en la propia página Seed de ByteDance, y su etiqueta de arquitectura en Hugging Face es qwen2_5_vl. MAI-UI es qwen3_vl. Cada generación de Holo es un derivado de Qwen, de Qwen2.5-VL a Qwen3-VL y a la familia Qwen 3.5, y el archivo de licencia de Holo1 dice que el producto se construyó con Qwen y que la Qwen Research License prevalece en caso de conflicto. Cada gráfico de benchmark de la versión Holo 3.1 compara Holo con la familia Qwen 3.5 en lugar de con la línea de agentes GUI de Alibaba.
Así que "dejar Alibaba" en agentes GUI de pesos abiertos significa cambiar de licencia, jurisdicción y equipo de posentrenamiento, no de arquitectura base. Eso es algo que se puede querer de verdad, sobre todo si la licencia es lo que te bloquea, y la contribución de H Company es propia: el posentrenamiento específico para GUI, la fábrica de entornos sintéticos, el arnés. Pero nadie debería elegir uno de estos tres creyendo haber escapado de Qwen. La lectura honesta es que los modelos de visión de Alibaba son el sustrato de toda esta categoría abierta, y por eso un agente GUI de Alibaba la lidera.
A quién dejé fuera y por qué
Manus. Intenté evaluarlo y no pude iniciar sesión. Su sitio muestra ahora mismo un aviso de que el acceso se reanuda a las 8:00 del 25 de agosto de 2026, explicando que están procesando una eliminación programada de datos para cumplir requisitos regulatorios en jurisdicciones específicas mientras Manus se prepara para reanudar operaciones como empresa independiente. No puedo recomendar un producto que no pude abrir hoy. Vale la pena revisarlo, y nuestra guía de Manus AI y el desglose de precios de Manus AI lo cubren mientras tanto.
Seed 2.1 Pro. El modelo de uso del ordenador de frontera actual de ByteDance es real y competitivo, con 78,8 % en OSWorld-Verified en la comparación de Alibaba. Pero es solo API en una nube de la región de China a ¥6 y ¥30 por millón de tokens, y el propio anuncio de Seed 2.1 de ByteDance nunca menciona UI-TARS, así que el linaje que asume la mayoría de la cobertura es una inferencia y no una afirmación.
GUI-Owl-1.5-32B-Instruct. Aparece en todas las tablas de Alibaba como el mejor especialista abierto anterior, y con 43,9 % en MobileWorld frente a 82,1 % la brecha generacional es demasiado amplia para recomendarlo como opción actual.
Asistentes que leen la pantalla y nunca actúan. Herramientas al estilo de Cluely vigilan tu pantalla y aconsejan, y copilotos de navegador como Edge Copilot resumen la página en la que estás. Útiles, y no el mismo trabajo que completar una tarea, así que fuera del alcance aquí.
Todo lo que no tiene precio. El producto gestionado Computer-use Agents de H Company y cada plataforma de agentes de "contáctanos" que miré. Si un proveedor no publica una tarifa para un producto medido, un comprador no puede compararlo, y no voy a fingir lo contrario.
Si el trabajo son tickets de soporte, la pantalla es la puerta equivocada
Una buena parte de quienes buscan esto no intentan automatizar una app de escritorio heredada. Quieren una IA que trabaje un servicio de atención, y un agente que maneja la pantalla parece la vía de propósito general para llegar ahí.
Yo lo rebatiría, y no solo porque trabajo en la alternativa. Tu servicio de atención ya tiene una API. Zendesk, Freshdesk, Gorgias, Front y Jira Service Management exponen el ticket como un objeto que puedes leer y escribir, lo que significa que un agente que maneja la pantalla elige localizar ese ticket buscándolo y haciendo clic en él. Por eso las herramientas especializadas de triaje de tickets y un agente de IA para el servicio de atención superan a la automatización de pantalla en la misma cola. Cada cambio de diseño, modal y prueba A/B se convierte en un nuevo modo de fallo, y según la Tabla 10 de arriba, esa clase de problema es la mayoría de lo que se rompe.
Hay también un problema más sutil que un equipo que ejecuta esto en producción descubrió por las malas, y es lo más agudo que leí en toda la semana:
"we run screen-driven agents against web forms in production and the failure mode that took us longest to find wasn't navigation, it was commits that don't commit. a react controlled select can render the right value after a click while the framework's internal state never updated, so every pixel says done and the submitted payload says null. vision-only verification passes because the screen genuinely looks correct."
Cada píxel dice hecho y la carga enviada dice null. Ese es todo el riesgo de un agente guiado por píxeles en una cola de tickets en una línea, y el proveedor que fue cuestionado en ese hilo lo concedió: su agente se guía por la pantalla, así que no afirman que los píxeles puedan demostrar todas las transiciones de estado ocultas. Una llamada a una API devolvió 200 o no lo devolvió.
El problema mayor es probar. Todos los proveedores de este artículo recomiendan una máquina virtual aislada, una lista de dominios permitidos y una persona en el circuito, y ninguno ofrece una prueba en seco con tu propio trabajo pasado. Ese hueco no es académico. Es la primera pregunta que hace un responsable de soporte, casi con estas mismas palabras:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Es un responsable de CX de una marca directa al consumidor de suplementos que gestiona unos 7.000 tickets al mes en Gorgias y Shopify. Un agente GUI no tiene respuesta para eso, porque un clic no lleva puntuación de confianza, y no tiene nada parecido a una escalada con IA. La elección del modelo importa mucho menos aquí que la recuperación de información, de lo que trata nuestro artículo sobre el mejor LLM para soporte.
Aprendí esta parte por las malas y no de forma teórica. Al principio, tres cuentas de eesel de pago tenían bots que inventaban respuestas cuando la recuperación volvía vacía, porque faltaba el respaldo estricto. Uno inventó afirmaciones de suscripción sobre células solares y las envió a clientes reales. Otro, ante una pregunta de producto, respondió "Oxygen" directamente de la tabla periódica. Nada en el producto me mentía, simplemente narraba un éxito que no había logrado, la misma clase de afirmación que un agente GUI que informa de que hizo clic en el botón. La diferencia es que una llamada a una API deja un registro que puedes comprobar y una coordenada no. Ese incidente es la razón por la que ahora cada despliegue se simula contra tickets históricos antes de acercarse a un cliente, y es el argumento más fuerte que conozco para evitar alucinaciones por diseño y no por prompt.
Prueba eesel en tu servicio de atención
Si lo que realmente necesitas es un compañero de IA en tu cola de tickets y no un ratón robótico, eso es eesel. Se conecta a Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot, Salesforce Service Cloud y Jira Service Management a través de sus API y llama a herramientas con nombre, así que una acción es una llamada de API registrada y no una coordenada que alguien espera que haya caído en el píxel correcto.
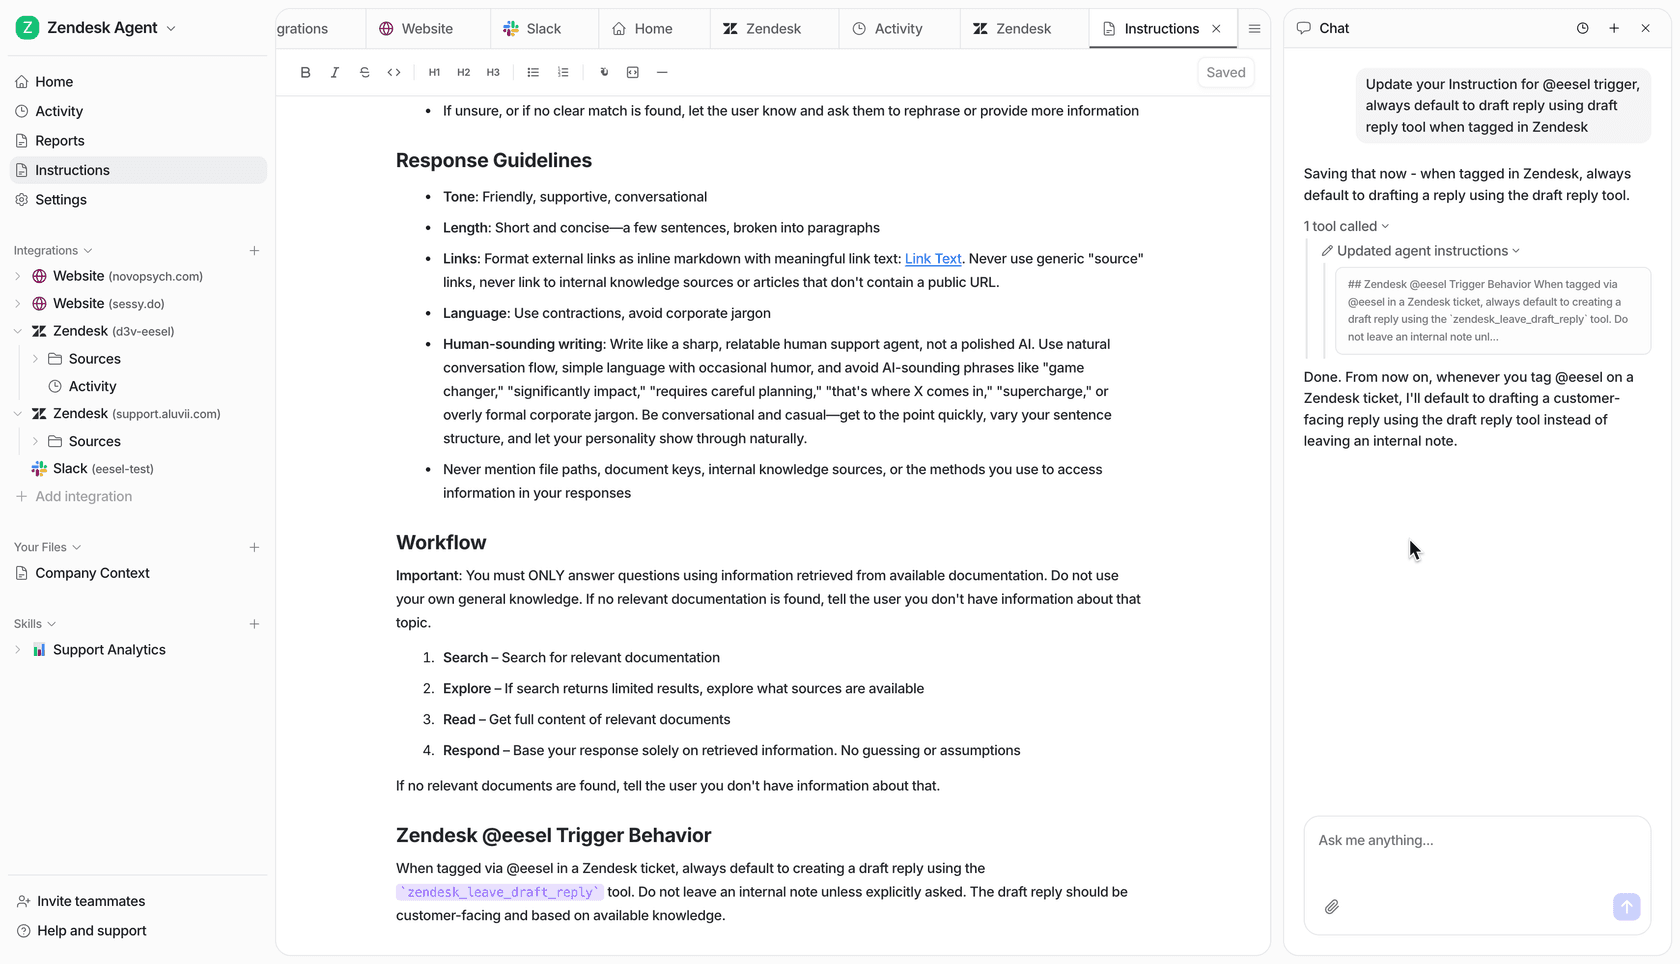
Lo que más importa para cualquiera que acabe de leer ocho secciones sobre agentes que no se pueden probar es la Simulación. Apúntala a tus propios tickets pasados y ejecuta la cadena completa del agente en un entorno aislado sin enviar ninguna respuesta real, hace que un juez puntúe cada respuesta, te muestra una comparación lado a lado con lo que tu equipo envió de verdad, marca cada una como Perfecta, Aceptable o Fallida, y te devuelve huecos de cobertura por tema con correcciones de instrucciones sugeridas. Luego la vuelves a ejecutar. Esa es la prueba en seco que nada de este artículo ofrece.
Los precios funcionan como sugiere el widget de arriba: un precio mensual fijo, desde 299 $/mes por 500 créditos, donde 1 crédito es un ticket o un chat sin importar cuántos mensajes vayan y vengan, sin tarifa de plataforma ni por usuario. Si enrutas 200 de tus 1.000 tickets, solo esos 200 usan créditos; 1.000 créditos al mes son 499 $. Compáralo con un medidor por paso donde el mismo ticket cuesta lo que la interfaz decida cobrarte ese día. Una salvedad honesta: un crédito se usa sea el resultado perfecto o no, así que esto es por ticket gestionado y no por ticket resuelto.
El grounding es la otra mitad. eesel lee tu centro de ayuda, tu documentación y tus tickets pasados existentes en lugar de mirar una pantalla, y nuestras guías sobre cómo entrenar con una base de conocimiento y cómo conectar bases de conocimiento cubren cómo funciona eso en la práctica.
Para ver cómo es en producción, Gridwise informó de que resolvió el 73 % de las solicitudes de nivel 1 en el primer mes tras una prueba de siete días, y Smava gestiona más de 100.000 tickets al mes de forma totalmente automática en alemán en Zendesk. Si prefieres ver primero el campo más amplio, nuestro resumen de IA para atención al cliente es la comparación honesta.
Empieza con 100 créditos gratis, sin tarjeta y con todas las funciones desbloqueadas. Prueba eesel, o apúntalo primero a los tickets del mes pasado y mira la puntuación antes de decidir.