Las 9 mejores alternativas a Grok Voice 3 en 2026

Rama Adi

Katelin Teen
Última edición October 15, 2026
¿Por qué mirar más allá de Grok Voice 3?
Empiezo por la parte honesta: Grok Voice 3.0 es muy bueno. En mi reseña de Grok Voice 3 lo llamé mi elección por defecto para un agente telefónico que tiene que ejecutar acciones, y nada de lo ocurrido en el último día lo ha cambiado. Artificial Analysis lo colocó en el n.º 1 de su índice speech-to-speech, n.º 1 en éxito de tareas en llamadas en vivo (94,8 %) y n.º 2 en τ-Voice, el benchmark que simula llamadas de soporte reales con herramientas y un documento de políticas.
"SpaceXAI's Grok Voice 3.0 is the new leading Speech to Speech model, debuting at #1 on the Artificial Analysis Speech to Speech Index at 86.9, while also being competitive on latency"
Entonces, ¿por qué la gente busca alternativas a Grok Voice 3 solo un día después del lanzamiento? Leyendo la documentación y las tablas de benchmarks, hay cinco razones reales:
- Concurrencia en una cuenta nueva. La concurrencia de speech-to-speech ahora sube con el gasto acumulado: 10 sesiones con 0 $, 20 con 50 $, 50 con 250 $, 100 con 1.000 $ y 200 con 5.000 $. En producción está bien, pero un equipo que quiera probar 50 llamadas simultáneas el primer día tiene que prepagar para desbloquear el nivel.
- Idiomas. La documentación de speech-to-speech de xAI enumera más de 20 idiomas. Gemini Live lista 70, ElevenLabs más de 90.
- Es una API, no un centro de llamadas. Tú aportas la línea telefónica, el flujo de la llamada, la analítica y la ruta de escalado. xAI sí vende un Voice Agent Builder sin código, pero muchos equipos quieren una plataforma completa.
- La latencia fue en la dirección equivocada. El tiempo hasta el primer audio es de 0,81 segundos, frente a 0,70 en Grok Voice 2.0. Sigue siendo más rápido que todos los modelos cercanos del índice, pero no es el Grok más rápido.
- Precio. 0,08 $ por minuto (4,80 $ la hora) está en la mitad de la tabla. Gemini 3.8 Live se mide en 0,84 $ la hora.
Si ninguno de esos cinco te afecta, puedes parar aquí y fijar grok-voice-3.0. Si alguno te afecta, la alternativa correcta depende de cuál sea, y aclararlo es lo que hace el resto de este artículo. Para ver el panorama más amplio del proveedor, mi artículo de alternativas a xAI cubre también los modelos de texto.
Tres tipos de alternativa
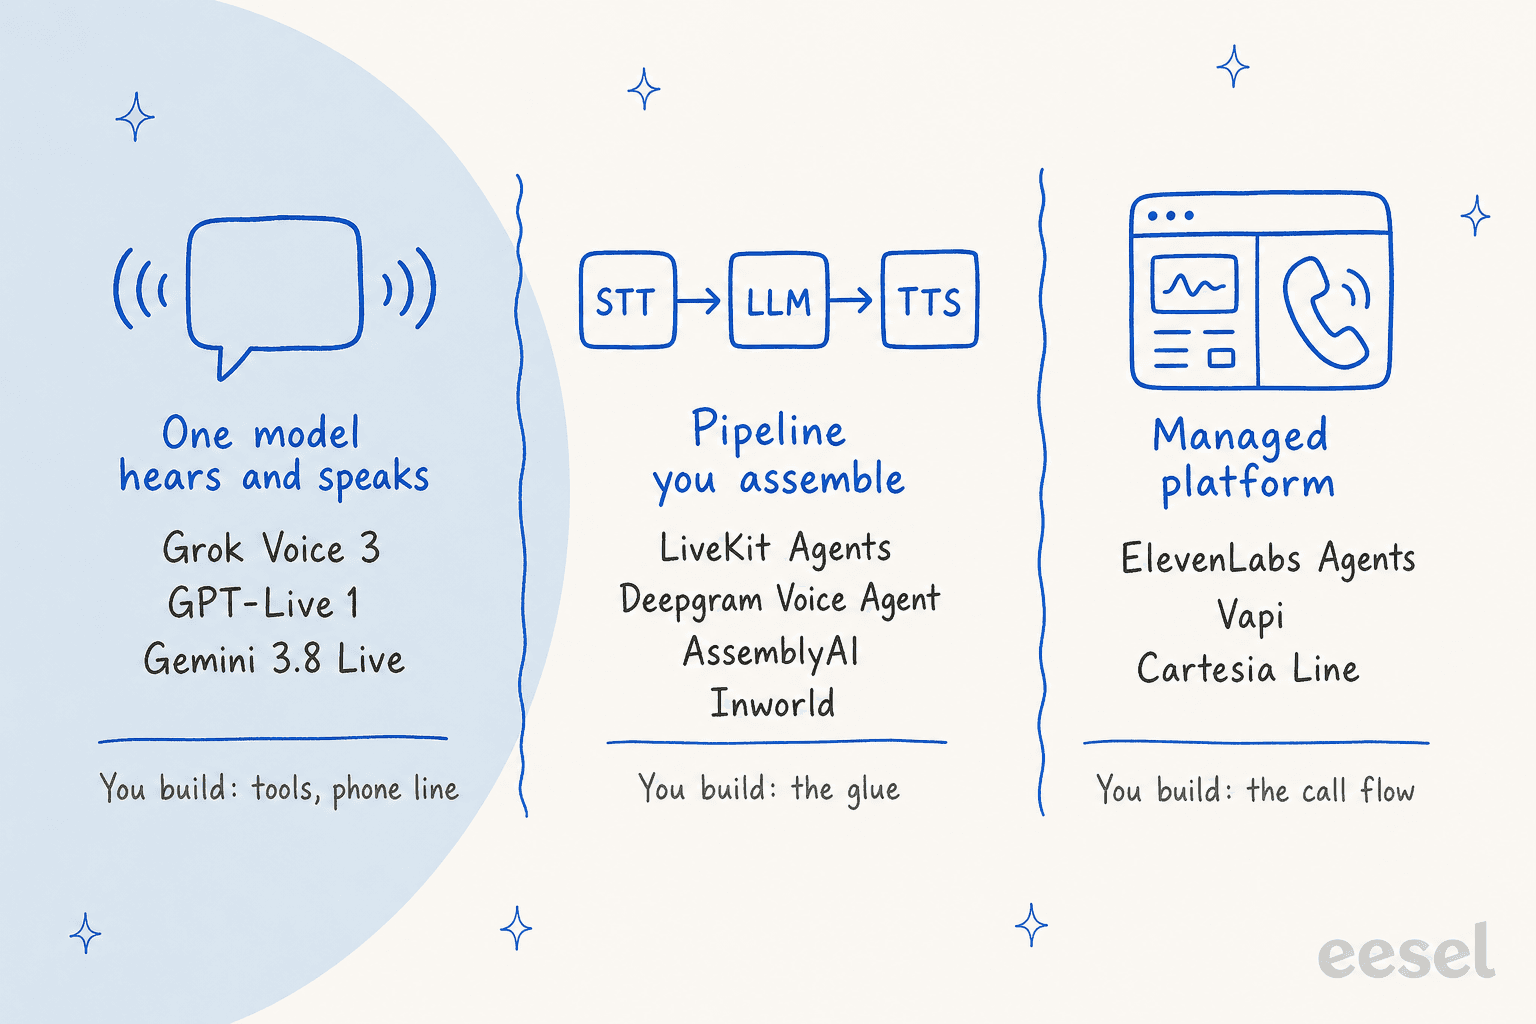
Cuando le pedí a ChatGPT alternativas a Grok Voice 3, ordenó la respuesta en tres grupos, y creo que ese marco es lo más útil que un comprador puede llevarse de esta página. Las herramientas de abajo no son intercambiables: cambiar de un grupo a otro modifica quién controla los turnos de palabra y la telefonía, y también las llamadas a herramientas.
- Los modelos speech-to-speech oyen audio y responden en audio dentro de un solo modelo. Menos piezas móviles, interrupciones naturales y las mejores puntuaciones de benchmark. Aun así, construyes tú las herramientas y la conexión telefónica.
- Los pipelines encadenan speech-to-text, un LLM de texto y text-to-speech. Más saltos, pero puedes cambiar cualquier pieza, usar cualquier LLM y leer una transcripción limpia en cada paso.
- Las plataformas gestionadas envuelven un pipeline con números de teléfono, un constructor, pruebas y analítica. Tú construyes el flujo de la llamada; ellas llevan la fontanería.
Un desarrollador en Hacker News cuestionó el primer grupo, y conviene tenerlo en cuenta:
"Yeah, sadly "audio to audio" seems to mean "we transcript it automatically for you internally which gets passed to the model", otherwise we'd be seeing models that are able to hear nuance in the input voice and pronunciation, which AFAIK, no model does yet."

Para una línea de soporte esto importa menos que cómo suena. Los clientes quieren que encuentren su pedido, no que aprecien su acento.
Cómo elegí estas nueve
Construyo la capa de integración en eesel, es decir, el código que conecta un agente de IA con un helpdesk en vivo, así que leo estas herramientas como constructor. De cada una leí la documentación y la página de precios del proveedor el 15 de octubre de 2026, capturé yo mismo las páginas de producto y saqué cada cifra de benchmark de la clasificación speech-to-speech de Artificial Analysis. Los precios proceden solo de las páginas de los proveedores.
Lo que no hice fue pasar mil llamadas de producción por cada una, porque Grok Voice 3.0 solo tiene un día. Cuando cito una latencia, es el tiempo hasta el primer audio medido por Artificial Analysis o la cifra publicada por el propio proveedor, y digo cuál de las dos.
La lista corta empezó con las seis herramientas que nombró ChatGPT (OpenAI, Google, ElevenLabs, Deepgram, LiveKit, Vapi), y añadí tres que aparecían en las propias pruebas de sistemas en cascada del benchmark o que tienen una API real de agentes de voz: Cartesia, AssemblyAI e Inworld. Dejé fuera Retell AI porque su nicho se solapa con Vapi; mi reseña de Retell AI lo cubre si estás comparando ambos.
Alternativas a Grok Voice 3 comparadas
Aquí está todo el campo en una tabla. "Tarifa principal" es la cifra de la página de precios del proveedor, y en la columna siguiente va lo que deja fuera.
| Herramienta | Tipo | Tarifa principal | No incluido | Inicio gratis | Concurrencia (de entrada al máximo publicado) | Tiempo hasta el primer audio | Idiomas | Teléfono | Cumplimiento (según el proveedor) |
|---|---|---|---|---|---|---|---|---|---|
| Grok Voice 3.0 (referencia) | Speech-to-speech | $0.08/min | Tu operador | Sin plan gratuito indicado | 10 a 200 según el gasto acumulado | 0.81s (AA) | 20+ | SIP nativo, Twilio, LiveKit | SOC 2 Type II, apto para HIPAA con BAA, DPA de GDPR |
| GPT-Live 1 | Speech-to-speech | $0.05/min | Modelo de backend y uso de herramientas | No | No figura en la página de precios | 1.24s a 1.34s (AA) | No figura en la página del modelo | SIP directo, Twilio, Telnyx, Bandwidth | SOC 2 Type 2, BAA disponible |
| Gemini 3.8 Live | Speech-to-speech | $0.005/min entrada, $0.018/min salida | Search grounding por encima de 5,000/mes | Sí, plan gratuito | No figura en la página de precios | 1.18s (AA) | 70 | Solo WebSocket | Los datos del plan de pago no se usan para entrenar |
| LiveKit Agents | Pipeline (código abierto) | $0.01/min de sesión de agente | STT, LLM, TTS, telefonía | 1,000 min de agente/mes | 5 a 600 | Depende de los modelos | Depende de los modelos | Números de EE. UU., SIP, Twilio, WhatsApp | SOC 2 Type II, BAA en Scale |
| Deepgram Voice Agent | Pipeline (gestionado) | $0.075/min | Nada en Standard | $200 de crédito | Hasta 45 en pago por uso | Sin medir | 45+ (Nova) | Documentación de telefonía | SOC 2 Type 2, HIPAA BAA, endpoint en la UE |
| AssemblyAI Voice Agent | Pipeline (gestionado) | $0.075/min | Nada indicado | Registro gratuito | No figura en la página de precios | Sin medir | 32 | Guía de número de teléfono | SOC 2 Type 2, BAA |
| Inworld Realtime | Pipeline (API estilo S2S) | Por pieza: STT $0.15/hr, TTS desde $15/1M de caracteres | Tokens del LLM | Inicio gratis bajo demanda | No publicada | 204ms el mejor, 462ms mediana (proveedor) | ~500 (TTS) | G.711 desde Twilio | SOC 2 Type II, GDPR, HIPAA como complemento |
| ElevenLabs Agents | Plataforma gestionada | $0.08/min | LLM, tu operador | 15 min/mes | 4 a 40, ráfaga hasta 3x | Sin medir | 90+ | Twilio, troncal SIP | BAA en Enterprise |
| Vapi | Plataforma gestionada | $0.05/min de hosting | STT, LLM, TTS a precio de coste | $5 de crédito | 4 a 30, +$10 por línea | Sin medir | Depende de los modelos | SIP de Vapi gratis, Twilio directo | Complemento HIPAA $2,000/mes |
| Cartesia Line | Plataforma gestionada | $0.06/min | $0.014/min por número de Cartesia | $1 de crédito de agente (~17 min) | 8 a 60 | Sin medir | Depende de la voz | Números de Cartesia | SOC 2 Type II, HIPAA, GDPR |
La columna de latencia AA solo está rellena para los modelos speech-to-speech, ya que Artificial Analysis mide el tiempo hasta el primer audio en esos. En pipelines y plataformas, la latencia depende de los modelos que conectes, que es la variable que tú controlas.
Lo que cuestan realmente los minutos
Las tarifas principales no cuadran entre sí, porque cada proveedor deja fuera una pieza distinta. La calculadora de abajo pone todas las herramientas en el mismo plano: un minuto de una llamada de soporte en la que el agente habla cerca de la mitad del tiempo. Escribe tus minutos de llamada mensuales y las barras se reconstruyen solas.
Escribe tus minutos de llamada mensuales para ver la factura a precio de lista de cada herramienta. Tarifas de la página de precios de cada proveedor el 15 de octubre de 2026; GPT-Live 1, Inworld y ElevenLabs excluyen parte del coste del LLM, así que tómalos como mínimos.
Dos cosas destacan. Primero, la mayor parte del campo se agrupa entre 0,075 $ y 0,083 $ por minuto, lo que significa que Grok Voice 3.0 no es caro para lo que hace. Segundo, los dos extremos en coste (Gemini 3.8 Live e Inworld) son también los dos en los que cambias algo real: precisión en tareas de soporte en el caso de Gemini, y una elección de LLM hecha a mano en el de Inworld. Para el contexto de lo que vale un minuto de voz con IA frente a una persona, mi desglose de agente de IA frente a coste humano hace las cuentas.
Cambios speech-to-speech
Estos dos son los reemplazos directos, con la misma arquitectura que Grok, con un modelo que escucha y también habla. Si tu código ya habla el formato de eventos de OpenAI Realtime (la API de Grok está pensada para ser compatible con él), el cambio es sobre todo un endpoint y una clave.
El benchmark que más importa para una línea de soporte es τ-Voice, que puntúa si el problema de un llamante simulado quedó realmente resuelto. Aquí es donde se separan tres familias speech-to-speech:
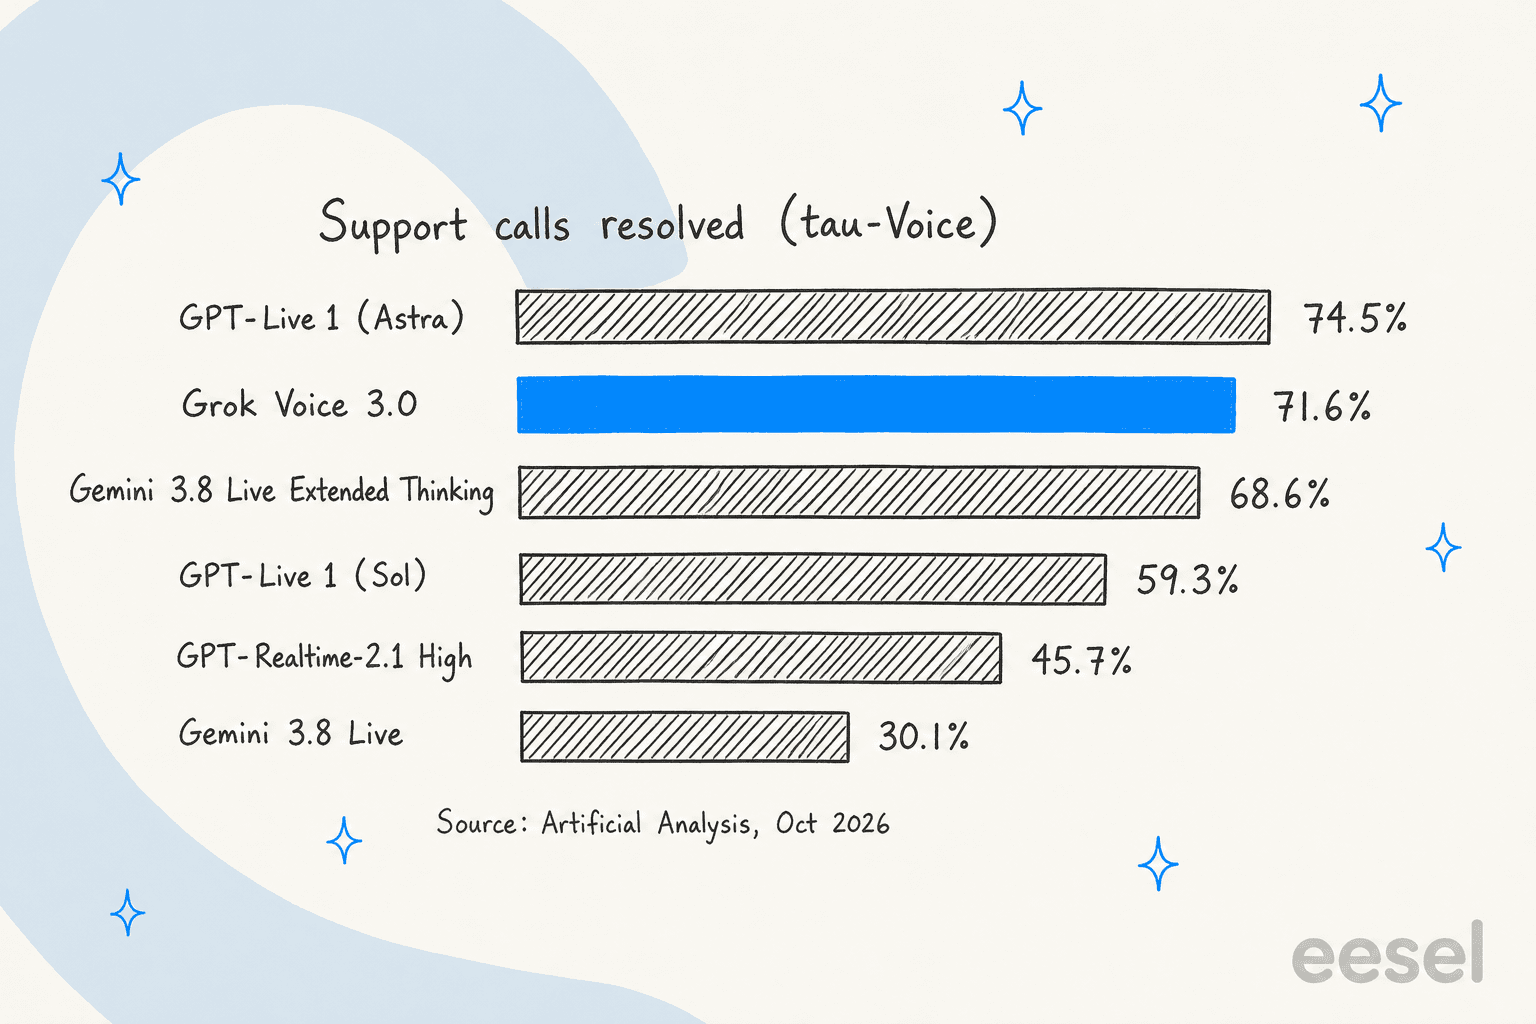
Fíjate en la barra de abajo. Gemini 3.8 Live es la segunda voz más apreciada en pruebas de escucha a ciegas y el modelo más barato de aquí, y aun así resuelve el 30,1 % de las llamadas. Agradable y correcto son puntuaciones distintas.
1. OpenAI GPT-Live 1 y la Realtime API
Ideal para: líneas de soporte donde terminar la tarea importa más que cualquier otra cosa, y equipos que ya usan OpenAI.
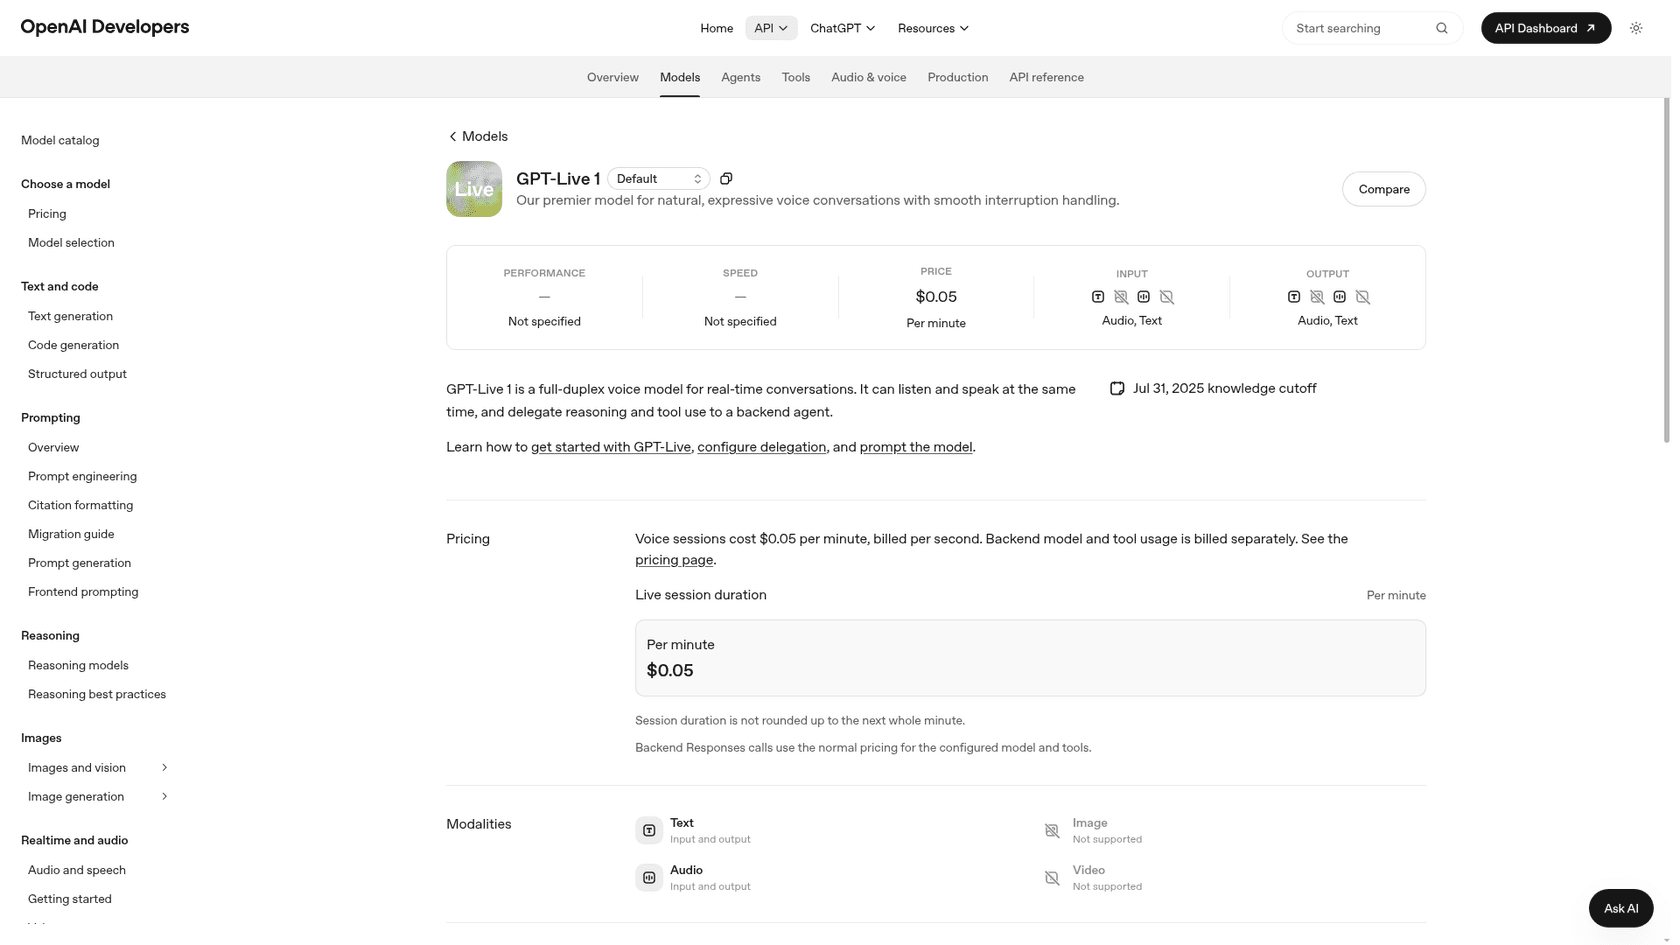
OpenAI tiene ahora dos vías de voz. GPT-Live 1 es un modelo full-duplex que, según su página del modelo, "can listen and speak at the same time, and delegate reasoning and tool use to a backend agent". La Realtime API anterior, con gpt-realtime-2.1, es un único modelo speech-to-speech que gestiona turnos de audio, herramientas e interrupciones en una sola sesión. La diferencia importa para el soporte: GPT-Live delega el razonamiento difícil a un modelo de texto aparte (Astra o Sol en el benchmark), y esa configuración es la que lidera τ-Voice.
Las llamadas telefónicas pueden llegar hasta él mediante un troncal SIP directo, y OpenAI publica guías de socios para Twilio, Telnyx, Bandwidth, LiveKit y Daily/Pipecat en su documentación de telefonía. Los desarrolladores en Hacker News se mostraron entusiasmados en el lanzamiento:
"I was excitedly awaiting this hitting the API, because ofc there wasn't a super high fidelity option for drop-in voice interface in front of a given harness. This is blowing me away so far!"
Lo que hace mejor que Grok:
- El único modelo que supera a Grok en τ-Voice: 74,5 % para GPT-Live 1 (Astra, medium) frente a 71,6 %.
- El agente de backend es cualquier modelo que configures, así que tu agente de texto actual y sus herramientas pueden quedar detrás de la voz.
- Facturación por segundo a 0,05 $ por minuto, sin redondear a un minuto entero.
Dónde se queda corto:
- Tarda más en empezar a hablar: 1,34 s hasta el primer audio con Astra y 1,24 s con Sol, frente a 0,81 s de Grok.
- Los 0,05 $ de la tarifa principal excluyen el modelo de backend. Artificial Analysis midió la configuración con Astra en 5,83 $ la hora, más que los 4,80 $ de Grok.
- Artificial Analysis señala que las puntuaciones τ-Voice de GPT-Live proceden de una sola prueba, frente a tres para la mayoría de los modelos.
- La página del modelo no indica los idiomas admitidos, una carencia que un usuario de HN también señaló.
Precios:
| Modelo | Precio | Notas |
|---|---|---|
| GPT-Live 1 | $0.05/min, facturado por segundo | Las llamadas de Responses del backend se facturan a las tarifas de ese modelo |
| gpt-realtime-2.1 | $32 / $64 por 1M de tokens de audio entrada / salida | Texto $4 / $24 por 1M |
| gpt-realtime-2.1-mini | $10 / $20 por 1M de tokens de audio entrada / salida | Texto $0.60 / $2.40 por 1M |
Todo de la página de precios de OpenAI. Las cuentas completas están en mi artículo de precios de GPT-Live 1, y hay una lista aparte de alternativas a GPT-Live 1 si vienes desde el otro lado.
Mi opinión: el cambio más sólido si tus llamadas son de mucha tarea (reembolsos, reservas, cambios de cuenta) y puedes vivir con medio segundo extra antes de que el agente hable. Descártalo si necesitas una lista de idiomas publicada o un presupuesto fijo por minuto. Si vas a conectar herramientas, lee primero sobre las llamadas a herramientas en Realtime, porque el silencio mientras corre una función es donde los clientes cuelgan.
2. Google Gemini 3.8 Live
Ideal para: llamadas de alto volumen y bajo riesgo (líneas de información, recordatorios de reservas, puertas de entrada multilingües) donde el coste y la cobertura de idiomas pesan más que la precisión en tareas.
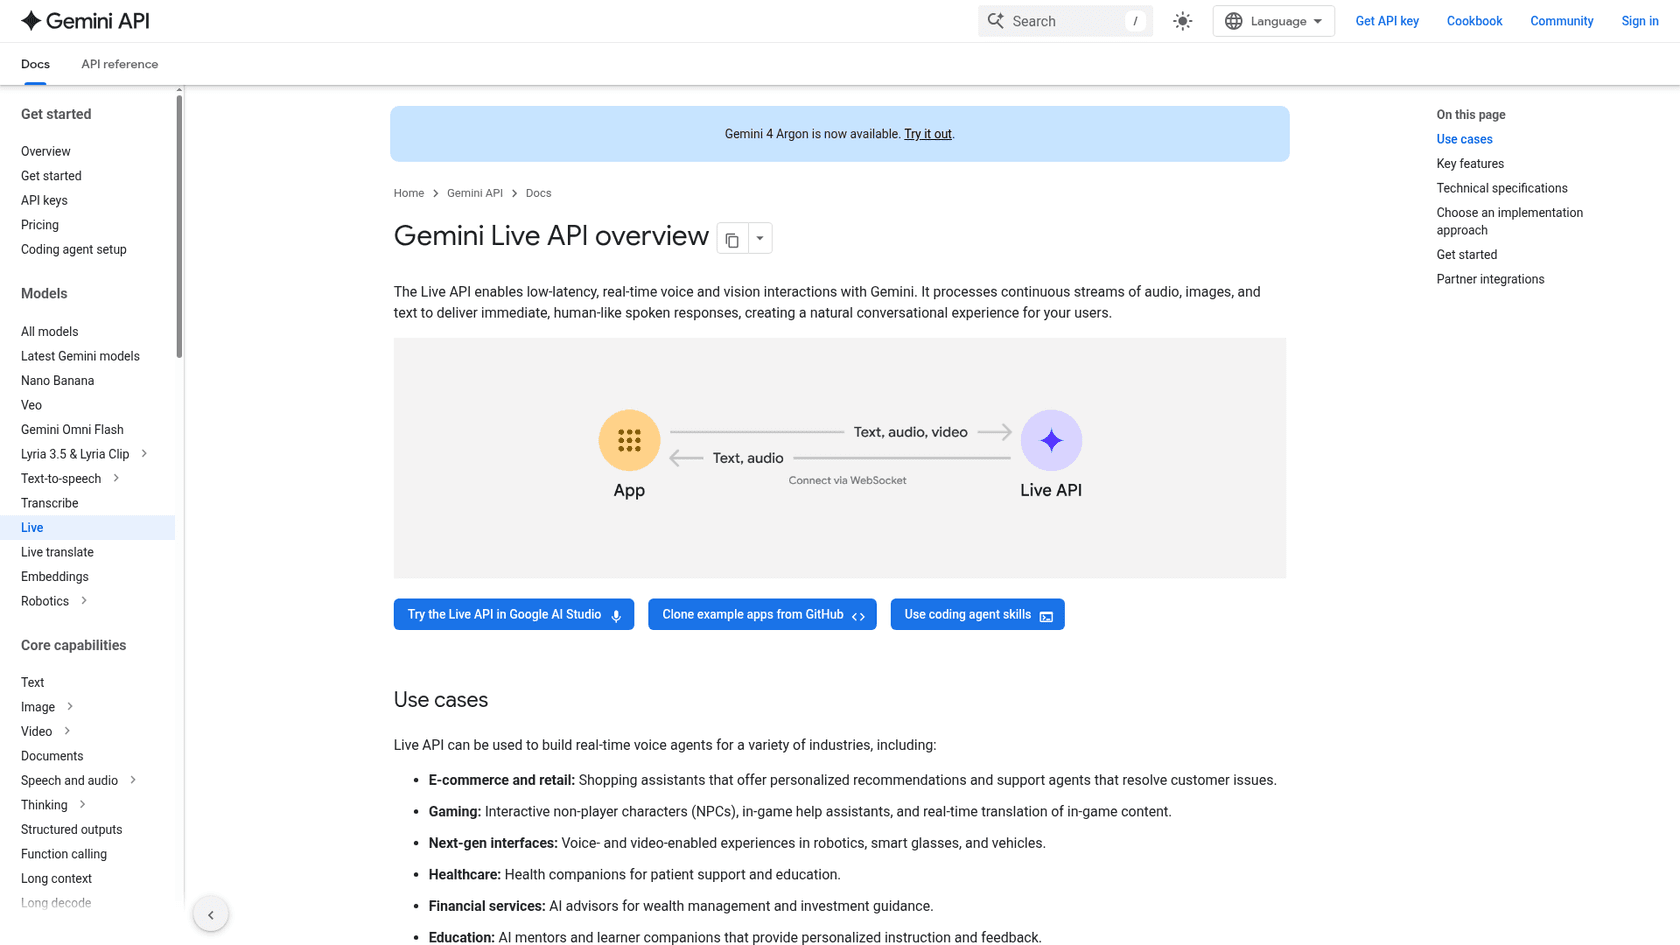
Google llama a Gemini 3.8 Live "the default option for most low-latency voice agent experiences", y es un modelo estable, no una vista previa. La Live API es un WebSocket con estado que acepta audio, imágenes y texto y responde en audio, en 70 idiomas. Las llamadas a funciones ahora se ejecutan de forma asíncrona por defecto, así que el modelo puede seguir hablando mientras corre una consulta.
También hay una variante Extended Thinking, que razona en segundo plano. Esa puntúa un 68,6 % en τ-Voice, cerca de Grok, pero su tiempo hasta el primer audio es de 1,35 s y Artificial Analysis la midió en 3,50 $ la hora. La familia Live de Google incluye además Live Translate para traducción speech-to-speech, un modelo aparte.
Lo que hace mejor que Grok:
- Precio: 0,005 $ por minuto de audio de entrada y 0,018 $ de salida. Artificial Analysis midió 0,84 $ la hora frente a los 4,80 $ de Grok.
- 70 idiomas admitidos frente a más de 20.
- Un plan gratuito en la página de precios, y en el plan de pago tus datos no se usan para mejorar los productos de Google.
- La segunda puntuación más alta de preferencia humana del ranking (Elo 1088).
Dónde se queda corto:
- τ-Voice de 30,1 % para el modelo estándar. Suena bien y a menudo no termina el trabajo.
- Las sesiones sin compresión de contexto se limitan a 15 minutos de audio, y una conexión dura unos 10 minutos antes de que necesites reanudación de sesión.
- Solo WebSocket. No hay SIP nativo, así que una línea telefónica pasa por un socio como LiveKit.
- El modelo tiene un límite de tokens de entrada de 131.072.
Precios:
| Concepto | Plan gratuito | Plan de pago |
|---|---|---|
| Entrada de audio | Gratis | $3.00 por 1M de tokens o $0.005/min |
| Salida de audio | Gratis | $12.00 por 1M de tokens o $0.018/min |
| Entrada / salida de texto | Gratis | $0.75 / $4.50 por 1M de tokens |
| Google Search grounding | Compatible | 5,000 gratis/mes, luego $14 por 1,000 |
Mi opinión: la opción correcta cuando el coste por minuto lo decide todo y el agente sobre todo informa en lugar de actuar. Para una línea que tiene que cambiar pedidos o emitir abonos, probaría Extended Thinking junto a Grok antes de confiar en el modelo estándar. Si ya usas Gemini 3.8 Flash para texto, la cuenta de facturación compartida es un pequeño extra.
Pipelines que montas tú
Estos cuatro encadenan speech-to-text, un LLM de texto y text-to-speech. Los saltos extra cuestan latencia, y un desarrollador de Reddit resumió bien el equilibrio:
"The core problem I found with the Retell/Vapi approach was the latency that chaining 3 services sequentially together added. STT provider → LLM → TTS provider. Each hop adds latency and you're managing 3 WebSocket connections plus your own VAD and turn-taking logic."

La otra cara es el control. Con un pipeline, el LLM es cualquier modelo que quieras, incluido el que ya usa tu agente de texto, y obtienes una transcripción limpia en cada paso para control de calidad y resúmenes de llamadas. Deepgram, AssemblyAI e Inworld ejecutan el pipeline por ti como una sola API, mientras que LiveKit te da el framework para ejecutarlo tú mismo.
3. LiveKit Agents
Ideal para: equipos de ingeniería que quieren ser dueños del stack, cambiar modelos con libertad y gestionar sus propios números de teléfono.
LiveKit Agents es un framework de código abierto (Apache 2.0) para añadir un programa en Python o Node.js a una llamada como participante de pleno derecho. Se encarga de las partes difíciles de la voz: transmitir audio por el pipeline, detección de turnos, interrupciones y orquestación del LLM. También admite modelos en tiempo real, incluidos GPT-Live y Gemini Live, y la documentación de xAI lista LiveKit como forma admitida de conectar Grok. Así que LiveKit es menos un reemplazo de Grok y más una capa que te deja reemplazar Grok después sin reescribir.
LiveKit Cloud añade el alojamiento y los números de teléfono, simulaciones y observabilidad, además de un catálogo de inferencia alojado para llamar a modelos sin claves de API separadas.
Lo que hace mejor que Grok:
- Libertad de modelos: la página de precios lista decenas de LLM, modelos STT y TTS con tarifas por minuto, desde GPT-5 nano a 0,0002 $/min hasta Deepgram Flux a 0,0065 $/min.
- Telefonía integrada: un número gratuito de EE. UU., troncales SIP y conectores de Twilio y WhatsApp.
- Hasta 600 sesiones concurrentes en el plan Scale, publicadas en la página.
- Simulaciones de texto y audio para probar el agente antes de que lleguen clientes reales, gratis hasta el 31 de octubre.
Dónde se queda corto:
- Tú eres el integrador. Elegir y ajustar tres modelos es trabajo de verdad.
- La latencia depende de tus decisiones, y no existe una cifra independiente de tiempo hasta el primer audio para "LiveKit" en conjunto.
- HIPAA con un BAA firmado empieza en el plan Scale, desde 500 $ al mes.
Precios:
| Plan | Precio | Minutos de agente incluidos | Sesiones concurrentes | Destacado |
|---|---|---|---|---|
| Build | $0 | 1,000 | 5 | 1 número gratuito de EE. UU., 50 minutos entrantes |
| Ship | Desde $50/mes | 5,000, luego $0.01/min | 20 | Colaboración en equipo, reversión instantánea |
| Scale | Desde $500/mes | 50,000, luego $0.01/min | Hasta 600 | HIPAA BAA, fijación de región |
| Enterprise | A medida | A medida | A medida | Precios de inferencia por volumen, SSO |
La calculadora de LiveKit valora un agente telefónico de ejemplo (Gemma 4 31B, STT de AssemblyAI, TTS de Fish Audio, un número de EE. UU. y observabilidad) en 0,0479 $ el minuto, cerca de un 40 % por debajo de Grok.
Mi opinión: mi elección para un equipo con ingenieros que espera cambiar de modelo más de una vez. Es la única opción aquí donde pasar de Grok a Gemini o a GPT-Live es un cambio de configuración. Descártalo si nadie en el equipo quiere encargarse de un pipeline de voz.
4. Deepgram Voice Agent API
Ideal para: equipos que quieren una API de pipeline gestionada a precio fijo, con la opción de traer su propio LLM.
La Voice Agent API de Deepgram "handles the full speech pipeline (listening, thinking, and speaking)" a través de un único WebSocket. Configuras el modelo de voz y el proveedor de LLM, la voz y el endpointing, y luego añades llamadas a funciones y traspasos entre varios agentes. Su modelo de voz Flux está pensado para agentes de voz, con detección de turnos y gestión de interrupciones integradas. Cuando Artificial Analysis probó el stack por defecto de Deepgram, era Nova-3 para escuchar, GPT-4o Mini para pensar y Aura-2 para hablar.
Lo que hace mejor que Grok:
- Un crédito gratuito de 200 $ sin tarjeta, que según Deepgram cubre unos 43.000 minutos de transcripción con Nova.
- Las opciones de traer lo tuyo recortan el precio: 0,050 $ el minuto si aportas tanto el LLM como la voz.
- Hasta 45 conexiones de agente concurrentes con pago por uso simple, sin escalera de gasto.
- SOC 2 Type 2, HIPAA con BAA para Enterprise y un endpoint dedicado en la UE.
Dónde se queda corto:
- El LLM por defecto en la prueba de Artificial Analysis fue GPT-4o Mini, un modelo pequeño para llamadas de soporte complejas. Planea traer el tuyo para todo lo que dependa mucho de políticas.
- Sin puntuación τ-Voice ni de latencia de Artificial Analysis para el agente completo.
- Se factura por tiempo de conexión WebSocket, así que un socket abierto e inactivo también cuesta dinero.
Precios:
| Nivel | Pago por uso | Growth |
|---|---|---|
| Standard | $0.075/min | $0.068/min |
| Standard, TTS propio | $0.065/min | $0.051/min |
| Custom, LLM propio | $0.059/min | No indicado |
| Custom, LLM + TTS propios | $0.050/min | $0.041/min |
| Advanced | $0.163/min | $0.146/min |
Growth exige un compromiso desde 4.000 $ al año, según la página de precios de Deepgram.
Mi opinión: el pipeline más limpio de "una API, un precio" de aquí. Buen encaje para un equipo que ya tiene un agente LLM y quiere envolverlo con los oídos y la voz de Deepgram a 0,050 $ el minuto. Menos atractivo si quieres que el LLM por defecto haga el razonamiento.
5. AssemblyAI Voice Agent API
Ideal para: equipos que quieren el precio todo incluido más simple y un reconocimiento de voz sólido, y no les molesta el LLM propio de AssemblyAI.
AssemblyAI es más conocida por el speech-to-text, y su Voice Agent API apila tres piezas propias: el modelo de voz Universal-3.6 Pro Realtime, un LLM propio "tuned for spoken conversation rather than text chat" y su propia voz de baja latencia. La guía rápida pone a hablar a un agente en el navegador con cuatro comandos y luego lo conecta a un número de teléfono.
Lo que hace mejor que Grok:
- Un precio fijo de 4,50 $ la hora (0,075 $ el minuto), con reconocimiento de voz, LLM y voz incluidos.
- El modelo de voz admite 32 idiomas con prompting de términos clave, útil para nombres de productos y SKU.
- Las cuentas de pago pueden excluirse del entrenamiento, y un BAA firmado lo hace automáticamente, según la página de seguridad de AssemblyAI.
Dónde se queda corto:
- El LLM incluido es el propio de AssemblyAI. No hay un benchmark publicado de cómo maneja una política de soporte y herramientas.
- Sin puntuación de Artificial Analysis para el agente completo.
- Los límites de concurrencia no están en la página de precios; las condiciones por volumen pasan por ventas.
Precios:
| Componente | Precio |
|---|---|
| Voice Agent API (orquestación y alojamiento) | $4.50/hr ($0.075/min) |
| Modelo de voz Universal-3.6 Pro Realtime | Incluido |
| LLM del Voice Agent | Incluido |
| TTS del Voice Agent | Incluido |
| Descuentos por volumen, ingeniero desplegado | Contactar con ventas |
Mi opinión: una opción por defecto sensata para un equipo al que le importa sobre todo oír bien a los clientes (acentos, líneas ruidosas, nombres de producto) y que quiere una sola línea en la factura. Probaría su LLM con 30 de mis llamadas más difíciles antes de comprometerme, porque es la parte sin puntuación pública.
6. Inworld Realtime API
Ideal para: equipos que quieren una API estilo speech-to-speech con LLM a elección y el menor coste de voz por minuto.
La Realtime API de Inworld parece un modelo speech-to-speech desde fuera: una conexión WebSocket o WebRTC que "listens, reasons and talks back". Por dentro es un pipeline con el speech-to-text propio de Inworld, tu elección entre 8 LLM alojados y sus voces TTS-2 al final. El atractivo para un usuario de Grok es que sus eventos y su configuración de sesión coinciden con la API OpenAI Realtime, así que un cliente se mueve con un endpoint y una clave nuevos.
Lo que hace mejor que Grok:
- Sin tarifa de speech-to-speech encima. Cada pieza se factura a su propia tarifa: speech-to-text a 0,15 $ la hora, TTS-2 Flash desde 15 $ por millón de caracteres bajo demanda.
- Eliges el LLM, así que el razonamiento puede ser tan potente (o tan barato) como quieras.
- Primer audio medido por el proveedor de hasta 204 ms, con una mediana de 462 ms en 17 turnos medidos.
- GDPR y SOC 2 Type II en todos los planes.
Dónde se queda corto:
- Las cifras de latencia son mediciones propias de Inworld, no independientes.
- El precio es una suma de partes, así que prever una factura da más trabajo que con una tarifa plana por minuto.
- HIPAA y BAA son complementos en el plan más alto publicado.
- El audio telefónico llega como G.711 desde Twilio, así que el número de teléfono lo aportas tú.
Precios:
| Plan | Mensual | TTS-2 Flash por 1M de caracteres | STT 1 por hora |
|---|---|---|---|
| On-Demand | $0 | $15 | $0.15 |
| Creator | $25 | $10 | $0.10 |
| Builder | $100 | $9 | $0.10 |
| Developer | $300 | $8 | $0.10 |
| Growth | $1,500 | $7 | $0.10 |
Inworld estima unos 1.000 caracteres de habla por minuto, así que la salida de voz sale a unos 0,01 $ a 0,015 $ por minuto en que el agente habla, más los tokens del LLM. Más en mi desglose de precios de Inworld AI y la lista de alternativas a Inworld.
Mi opinión: la jugada de costes más interesante para equipos que ya están contentos con un LLM de texto. Te da la experiencia de desarrollo al estilo Grok con la flexibilidad de un pipeline. Espera si necesitas cifras de latencia independientes o una línea telefónica llave en mano.
Plataformas gestionadas de agentes de voz
Estas tres envuelven un pipeline con lo que un responsable de soporte necesita para operar de verdad un agente telefónico: números y un constructor, pruebas y analítica, además de concurrencia que se puede comprar. Cedes algo de control y una tarifa de plataforma a cambio de no construir nada de eso tú mismo. Si tu equipo está sopesando una plataforma, mi resumen de la mejor IA para soporte por voz cubre más opciones, y también la lista de alternativas a Voiceflow.
7. ElevenLabs Agents
Ideal para: equipos que quieren un agente gestionado con la mayor cobertura de idiomas y las voces más naturales.
ElevenLabs se hizo un nombre con las voces, y ElevenAgents es su plataforma para "natural, human-sounding agents in 90+ languages" en voz, chat y correo. Configuras un agente con un constructor de flujos, le adjuntas una base de conocimiento y herramientas, lo despliegas en una línea telefónica, la web o el móvil, y lo supervisas con pruebas y analítica integradas. El stack por defecto que probó Artificial Analysis fue Scribe v2 Realtime, Gemini 2.5 Flash y Eleven Flash v2, y puedes elegir de una larga lista de LLM o traer el tuyo.
Lo que hace mejor que Grok:
- Más de 90 idiomas, la mayor cobertura de esta lista.
- Concurrencia publicada en cada plan, de 4 llamadas en Free a 40 en Business, y precios de ráfaga que permiten a los agentes atender hasta 3x ese límite al doble de tarifa.
- Sin cargo de telefonía: trae Twilio o un troncal SIP y paga directamente a tu operador.
- Un constructor de agentes completo, para que un responsable de soporte pueda cambiar el flujo sin desplegar.
Dónde se queda corto:
- Los 0,08 $ el minuto son antes del LLM. La calculadora de precios muestra Gemini 2.5 Flash a 0,0029 $ el minuto; los modelos más potentes cuestan más.
- Los BAA para HIPAA solo están en Enterprise.
- Sin puntuación τ-Voice independiente para el agente completo.
Precios:
| Plan | Mensual | Minutos de llamada incluidos | Llamadas concurrentes |
|---|---|---|---|
| Free | $0 | 15 | 4 |
| Starter | $6 (primer mes $1) | 75 | 6 |
| Creator | $22 (primer mes $11) | 275 | 10 |
| Pro | $99 | 1,238 | 20 |
| Scale | $299 | 3,738 | 30 |
| Business | $990 | 12,375 | 40 |
| Enterprise | A medida | A medida | Elevadas |
Los minutos extra cuestan 0,08 $ en todos los planes, y los minutos de ráfaga 0,16 $, según la página de precios de ElevenAgents. Hay más detalle en mi artículo de precios de ElevenLabs y en la lista de alternativas a ElevenLabs.
Mi opinión: el cambio gestionado más fácil para un equipo de soporte, sobre todo uno multilingüe. En Business, 12.375 minutos incluidos por 990 $ salen a los mismos 0,08 $ que Grok, con constructor, telefonía y analítica además. Descártalo si necesitas HIPAA sin contrato Enterprise.
8. Vapi
Ideal para: desarrolladores que quieren una plataforma gestionada pero siguen queriendo elegir cada modelo y pagar a los proveedores a precio de coste.
Vapi se sitúa entre LiveKit y ElevenLabs. Gestiona la infraestructura (alojamiento y telefonía, monitorización, más pruebas con simulación), y tú eliges el transcriptor, el LLM y la voz de su catálogo, facturados "with no markup". Su página de inicio cita al equipo de soporte de Ring pasando de cero a producción en dos semanas. Un desarrollador de Reddit que opera sistemas de producción en él rebatió la idea de que solo sirva para prototipos:
"Vapi is good at PoC stage and it is good at production usage, it is not a fair criticism at all - I have many production AI voice systems running on Vapi right now with no issues."
Lo que hace mejor que Grok:
- Cualquier combinación de modelos, incluidos los speech-to-speech, con los proveedores pasados a precio de coste.
- La telefonía y el SIP de Vapi son gratis, y la concurrencia extra cuesta una tarifa plana de 10 $ por línea al mes.
- Llamadas de prueba simuladas antes de que los clientes reales oigan al agente.
Dónde se queda corto:
- La tarifa de alojamiento de 0,05 $ se suma a cada modelo. La propia estimación de Vapi para 1.000 minutos cae entre 82 $ y 129 $, es decir, de 0,082 $ a 0,129 $ el minuto.
- HIPAA es un complemento de 2.000 $ al mes.
- Los SLA de disponibilidad empiezan en el paquete Pro de 999 $ al mes.
Precios:
| Paquete | Mensual | Llamadas concurrentes | Destacado |
|---|---|---|---|
| Sin paquete | $0, $5 de crédito gratis | 4 | $0.05/min de alojamiento, 14 días de retención de datos |
| Core | $29 | 10 | Cero retención de datos, SLA de soporte de 2 días laborables |
| Pro | $999 mínimo (10 % de la tarifa de alojamiento) | 30 | RBAC, soporte por Slack, SLA de disponibilidad del 99 % |
| Premier | A medida | Elevadas | SLA de disponibilidad del 99,9 %, SIP dedicado |
Todo de la página de precios de Vapi.
Mi opinión: el punto medio adecuado cuando quieres funciones de plataforma pero te niegas a quedar atado a los modelos de un solo proveedor. Presupuesta la tarifa de alojamiento más tres proveedores, y el total suele quedar en los 0,08 $ de Grok o por encima.
9. Cartesia Line
Ideal para: equipos que quieren un agente gestionado con control a nivel de código y la tarifa plana de plataforma más baja.
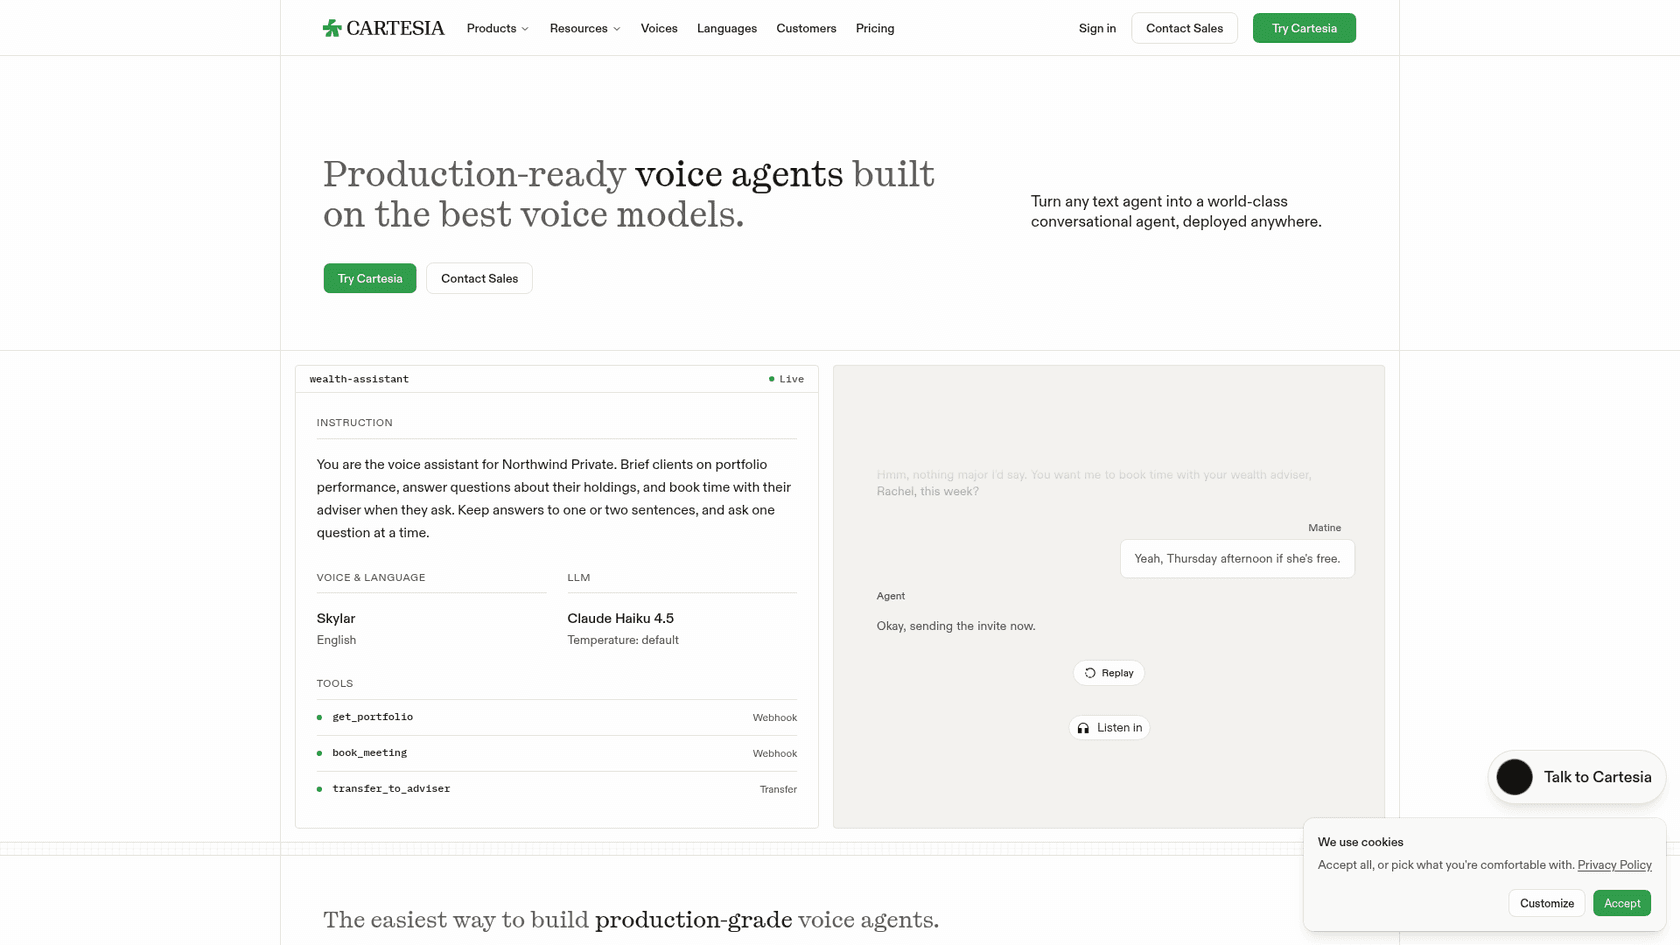
Line "brings voice to your text agents" usando el speech-to-text Ink y las voces Sonic de Cartesia, que cubrí en mi reseña de Cartesia Sonic 3. Escribes la lógica de razonamiento en código con su SDK (cualquier LLM, cualquier API) o prototipas en el constructor sin código, y luego despliegas en el runtime gestionado de Cartesia con registros de llamadas, evaluaciones y despliegues versionados a los que puedes volver. Hay una CLI para desplegar y probar desde un terminal.
Lo que hace mejor que Grok:
- 0,06 $ el minuto por el agente gestionado, la tarifa plana de plataforma más baja de esta lista.
- El uso de LLM es gratis para los agentes creados en la interfaz, por tiempo limitado.
- SOC 2 Type II, HIPAA y GDPR indicados en su sitio.
- Las cuotas del plan vuelven como crédito de agente: el plan Scale de 299 $ incluye 299 $ para gastar en agentes.
Dónde se queda corto:
- La promoción del LLM es por tiempo limitado, así que planifica tu presupuesto como si fueras a pagar por los tokens.
- La concurrencia tiene su techo en 60 llamadas en el plan Scale antes de Enterprise.
- Sin puntuación τ-Voice independiente para el agente completo.
Precios:
| Plan | Mensual | Crédito de agente incluido | Llamadas concurrentes |
|---|---|---|---|
| Free | $0 | $1 (~17 min) | 8 |
| Pro | $5 | $5 | 12 |
| Startup | $49 | $49 | 20 |
| Scale | $299 | $299 | 60 |
| Enterprise | A medida | A medida | A medida |
Las llamadas cuestan 0,06 $ el minuto, más 0,014 $ el minuto por un número de teléfono de Cartesia, según la página de precios de Cartesia. Si la calidad de voz es el factor decisivo, mi comparativa Cartesia vs. ElevenLabs profundiza más.
Mi opinión: una opción sólida para un equipo de desarrollo al que le gusta el enfoque gestionado de ElevenLabs pero quiere escribir el agente en código. Vigila la línea del LLM en tu factura cuando termine la promoción.
Cómo elegir al ganador en una semana
Los benchmarks acortan la lista y luego deciden tus propias llamadas. El consejo de ChatGPT fue pasar las mismas 20 a 50 conversaciones de prueba por tus dos o tres mejores candidatos, y estoy de acuerdo, con un cambio: usa llamadas reales, no inventadas.
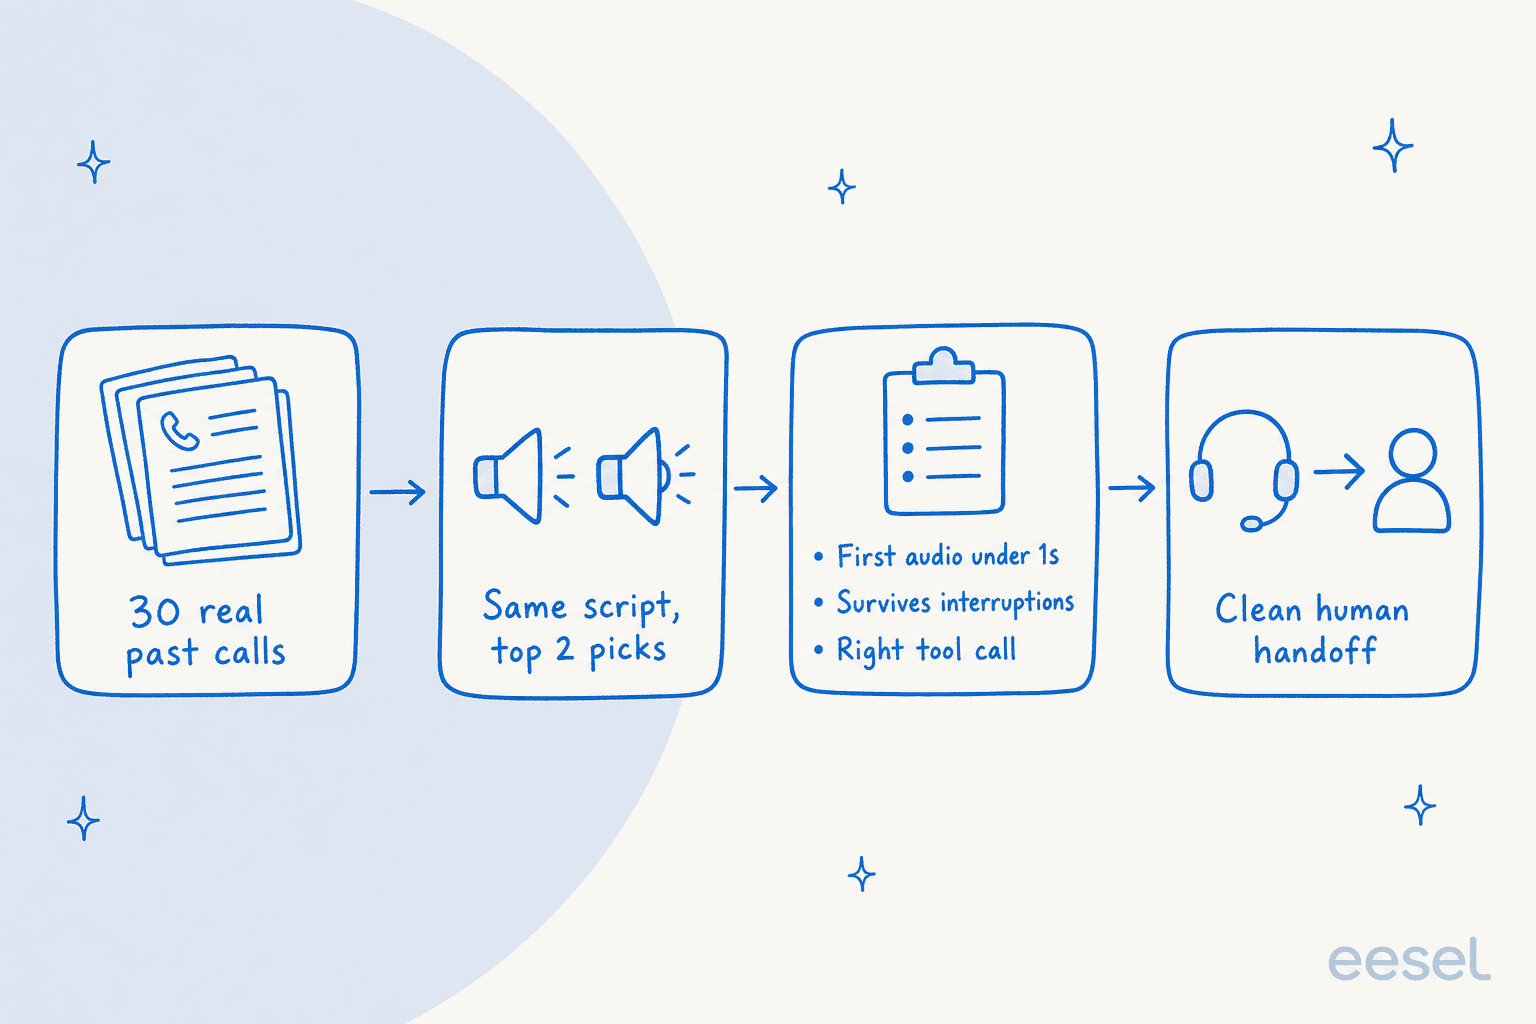
- Saca 30 llamadas pasadas reales. Transcripciones de tu sistema telefónico, ponderadas hacia las llamadas que a tu equipo le resultan más difíciles: reembolsos, clientes enfadados, cambios de cuenta.
- Pasa el mismo guion por tus dos primeras. Grok Voice 3.0 debería ser normalmente una de ellas, ya que es la vara que hay que superar.
- Puntúa tres cosas. Tiempo hasta el primer audio (¿oye el cliente una respuesta en menos de un segundo?), interrupciones (¿se detiene y escucha cuando el cliente la corta?) y llamadas a herramientas (¿llamó a la función correcta con el número de pedido correcto?).
- Comprueba el traspaso. Todo agente de voz falla en algunas llamadas. Lo que importa es si pasa al cliente a una persona con el contexto. Mi artículo de buenas prácticas de traspaso cubre lo que debería incluir ese contexto.
Si ya usas agentes de voz con IA de Zendesk o los agentes de voz de Freshcaller, incluye también la opción nativa de tu helpdesk en la prueba. A veces la respuesta aburrida es la que gana.
Lo que no arregla ninguna de estas nueve
Cada modelo y plataforma de arriba es, en lo que hace, un motor de conversación. El benchmark τ-Voice da a cada uno un documento de políticas y un conjunto de herramientas escritos para la prueba. En tu línea telefónica, el agente sabe exactamente lo que le conectas y nada más.
Ahí es donde la mayoría de los despliegues reales de soporte por voz pasan su tiempo: decidir qué puede decir el agente, mantener las respuestas al día y conectarlo con los datos de pedidos y cuentas. En nuestras llamadas de ventas, la petición más constante entre compradores es la misma: entrenar la IA con los tickets pasados del equipo. Una marca de suplementos directa al consumidor de esas llamadas pasa unos 7.000 tickets al mes por Gorgias y Shopify, con un sistema telefónico aparte al lado. Su agente telefónico y su cola de tickets necesitan las mismas respuestas.
Los equipos que lo hacen bien tratan al agente telefónico como un chatbot de base de conocimiento con voz: una fuente de respuestas mantenida, de la que leen todos los canales. Si todavía estás decidiendo si la IA puede responder llamadas de soporte en tu equipo, o si merece la pena automatizar el soporte telefónico, empieza por los canales de texto. Son más baratos por interacción, más fáciles de medir y construyen el conocimiento que luego necesitará el agente de voz.
Mi guía para automatizar la atención al cliente explica el orden en que lo haría.
Combina cualquiera de ellas con eesel
La API de voz es la infraestructura, y eesel es el empleado. El compañero de IA para el helpdesk de eesel se incorpora a tu Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y de tu centro de ayuda, y trabaja la cola de correo y chat que hay detrás de toda línea telefónica. Antes de ponerlo en marcha, puedes ejecutarlo contra tus propios tickets pasados y comparar sus respuestas con lo que tu equipo envió de verdad.

Para desarrolladores, el punto de conexión es MCP. Cada espacio de trabajo de eesel es un servidor MCP: npx @eesel/cli mcp token de la CLI de eesel imprime la URL y un token de 30 días, de modo que un agente de voz en Grok, GPT-Live o LiveKit pueda consultar las mismas respuestas que usa tu agente de tickets. La misma CLI te permite automatizar el agente desde un terminal o dárselo a un agente de código como Claude Code. Todavía no he probado esa combinación en una línea telefónica en vivo, así que tómala como una construcción prometedora y vigila la latencia de una llamada a herramienta a mitad de frase.
El precio es un plan fijo de créditos mensuales: 299 $ al mes por 500 créditos, donde un ticket o chat es un crédito, con 100 créditos gratis y sin tarjeta para empezar. Prueba eesel con una parte de tu cola antes de elegir una voz, para que la que gane tenga algo que valga la pena decir.