

Qwen-UI-Agent es el mejor agente que conduce teléfonos que se haya publicado, y no puedes usarlo. El equipo Tongyi MAI de Alibaba publicó el 30 de julio de 2026 un paper, un vídeo de demostración y un benchmark. El repositorio de GitHub tiene 2.2k estrellas y cero versiones. No hay pesos en Hugging Face, ni API, ni tarifa.
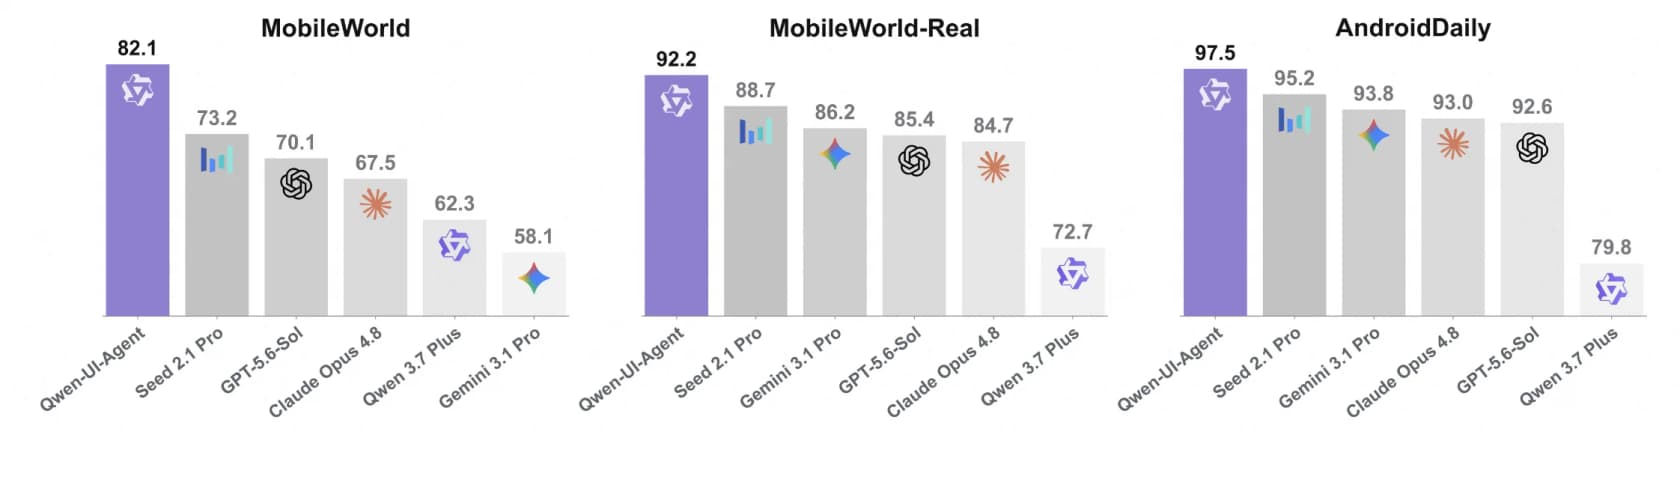
Las cifras móviles son reales y grandes. 82.1% en MobileWorld, que son 14.6 puntos por encima de Claude Opus 4.8 y 38.2 puntos por encima del mejor modelo GUI especializado anterior. Las cifras de escritorio son donde la cobertura en inglés se equivocó. En OSWorld-Verified, el propio gráfico de Alibaba pone a Opus 4.8 en 83.4 y a Qwen-UI-Agent en 79.5. En trabajo de escritorio de largo recorrido completa el 13.9% de las tareas. En investigación web difícil en inglés saca 64.1 frente a 90.1 de GPT-5.5.
Yo construyo la parte de agentes de eesel, así que lo que sigo releyendo de este paper no es el ranking. Es la Tabla 10, donde el equipo clasificó cada fallo en dispositivos reales. El 52% fue culpa de la pantalla, no del modelo: anuncios, muros de pago, CAPTCHAs, páginas en blanco, un texto de ejemplo gris confundido con texto escrito. Ese es el número que dice dónde encaja controlar pantallas y dónde no.
Qué es en realidad Qwen-UI-Agent
La mayoría de los modelos de los que lees responden preguntas. Este opera dispositivos. Le das una tarea en lenguaje normal, mira una captura de pantalla y emite un toque, un deslizamiento, una pulsación de tecla o un comando bash. Luego vuelve a mirar.
El paper evalúa tres tamaños: un modelo de 27B, una variante dispersa de 35B-A3B y uno de 4B. Cada cifra destacada pertenece al de 27B. La base es casi seguro Qwen3.5-27B, porque las tablas de capacidad general del paper ponen a ambos lado a lado y las puntuaciones son casi idénticas: 72.4 frente a 73.5 en MMMU-Pro, 83.1 frente a 83.1 en RealWorldQA. Lo que haya hecho el entrenamiento GUI, no se comió el razonamiento general del modelo, que es más de lo que se puede decir de la mayoría de los ajustes finos especializados.
Es la continuación de MAI-UI 1.0, el trabajo anterior del mismo equipo, y hereda su costumbre de nombrar las cosas según lo que miden. Si no conoces la familia, nuestro resumen de Qwen cubre los modelos principales y la reseña de Qwen tiene la lectura de negocio. El buque insignia actual de Alibaba, Qwen3.8-Max, es un animal totalmente distinto: más grande, más charlatán y no hecho para pulsar botones.
Lo que lo convierte en un agente GUI base y no en un bot móvil es su alcance. Un modelo, cuatro entornos: teléfonos Android, Linux de escritorio, navegadores web y un modo de búsqueda profunda basado en API. Existen productos con nombre que hacen una de esas cosas. Hacer las cuatro en un solo checkpoint es la afirmación.
La tabla de benchmarks y la parte que se leyó de más
Aquí está cada cifra destacada publicada en un solo lugar, con quién ocupa de verdad el primer puesto.
| Eje | Benchmark | Qwen-UI-Agent | Mejor publicado | Veredicto |
|---|---|---|---|---|
| GUI móvil | MobileWorld (50 pasos) | 82.1% | Qwen-UI-Agent | Lidera por 8.9 sobre Seed 2.1 Pro |
| Móvil, dispositivos reales | MobileWorld-Real | 92.2% | Qwen-UI-Agent | Lidera por 3.5 sobre Seed 2.1 Pro |
| Móvil, tareas diarias | AndroidDaily | 97.5% | Qwen-UI-Agent | Lidera por 2.3 |
| Escritorio | OSWorld-Verified | 79.5% | Claude Opus 4.8, 83.4% | Segundo |
| Escritorio, largo recorrido | OSWorld-v2 partial | 40.0% | Claude Opus 4.8, 54.8% | Tercero, detrás de GPT-5.5 |
| Escritorio, tareas terminadas | OSWorld-v2 binary | 13.9% | Claude Opus 4.8, 20.6% | Segundo |
| Navegador | WebArena | 73.6% | Qwen-UI-Agent | Lidera por 1.7. El humano es 78.2% |
| Grounding | ScreenSpot-Pro (zoom) | 81.5% | Qwen-UI-Agent | Lidera por 0.8 |
| Búsqueda profunda, EN | BrowseComp | 64.1% | GPT-5.5, 90.1% | 26 puntos por detrás |
| Búsqueda profunda, ZH | BrowseComp-ZH | 75.0% | Apodex-1.0-mini, 80.6% | Segundo |
El lado móvil de esa tabla no está reñido. Míralo.
Ahora mira el mismo conjunto de gráficos para escritorio y web. Los paneles central y derecho son victorias. El izquierdo no, y la barra que lo supera está etiquetada.
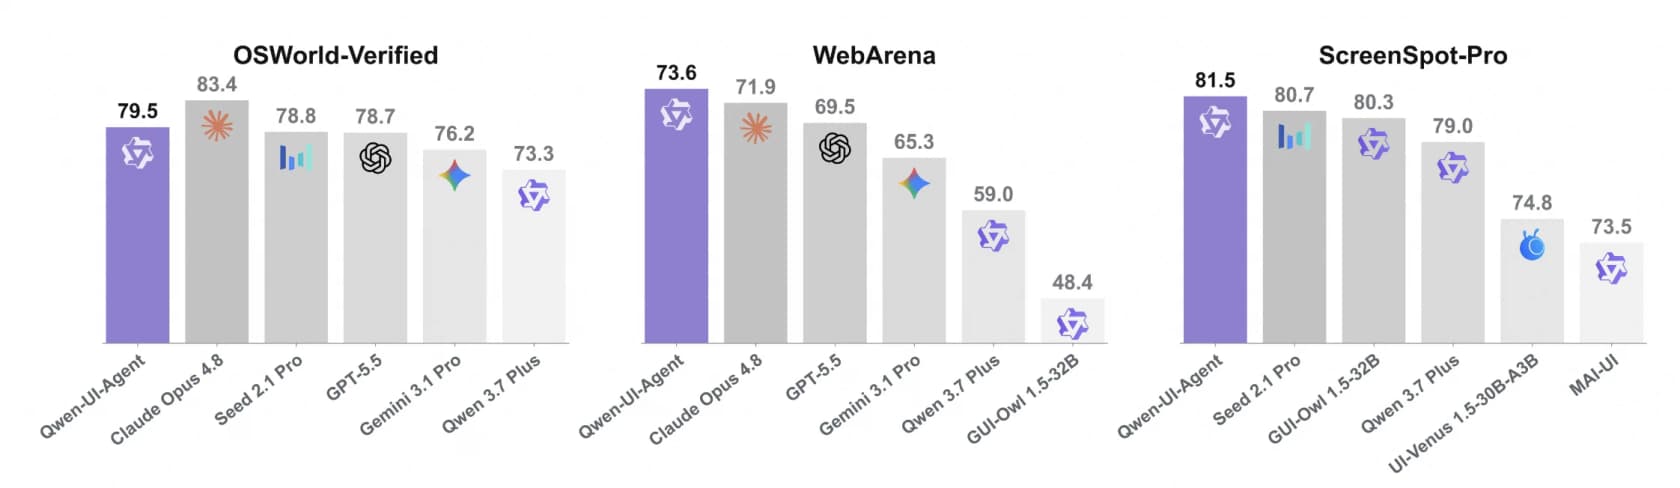
Alibaba fue franca con esto. El paper dice que el modelo queda "second among all compared models and trailing only Claude Opus 4.8" en OSWorld-Verified, y el resumen divide la afirmación con cuidado: estado del arte en móvil, competitivo en ordenador y navegador. El redondeo ocurrió después. Un resumen semanal de IA china muy compartido informó de las mejores puntuaciones en los tres, MobileWorld, OSWorld-Verified y WebArena, "beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro." Dos de esos tres son ciertos. El de escritorio no, según el propio gráfico de barras de Alibaba.
Esto importa porque los dos ejes describen trabajos distintos. Reservar un billete de tren en una app es una tarea móvil. Conciliar una hoja de cálculo entre cuatro ventanas es una tarea de escritorio. Un modelo puede dominar una y perder la otra, y este lo hace.
Elige el trabajo y luego lee el número
Un solo espacio de acciones para toques y comandos de terminal
La decisión de diseño que me parece más interesante no tiene nada que ver con la visión. Es la lista de acciones.
Junto a los verbos GUI esperables, click, long_press, type, drag, system_button, wait, el modelo dispone de cli_command para ejecutar bash, api_call para llamadas estructuradas a servicios y ask_user para detenerse a preguntar a una persona. Todo en un espacio plano, elegido turno a turno. Así el agente nunca se ve obligado a expresar "renombrar cuarenta archivos" como cuarenta clics. Puede escribir el comando sin más.
Y lo hace constantemente. En OSWorld-v2, el 55.1% de las acciones del agente son comandos escritos y no acciones de pantalla. En OSWorld-Verified es el 40.7%, y aparecen en el 92.0% de las tareas.
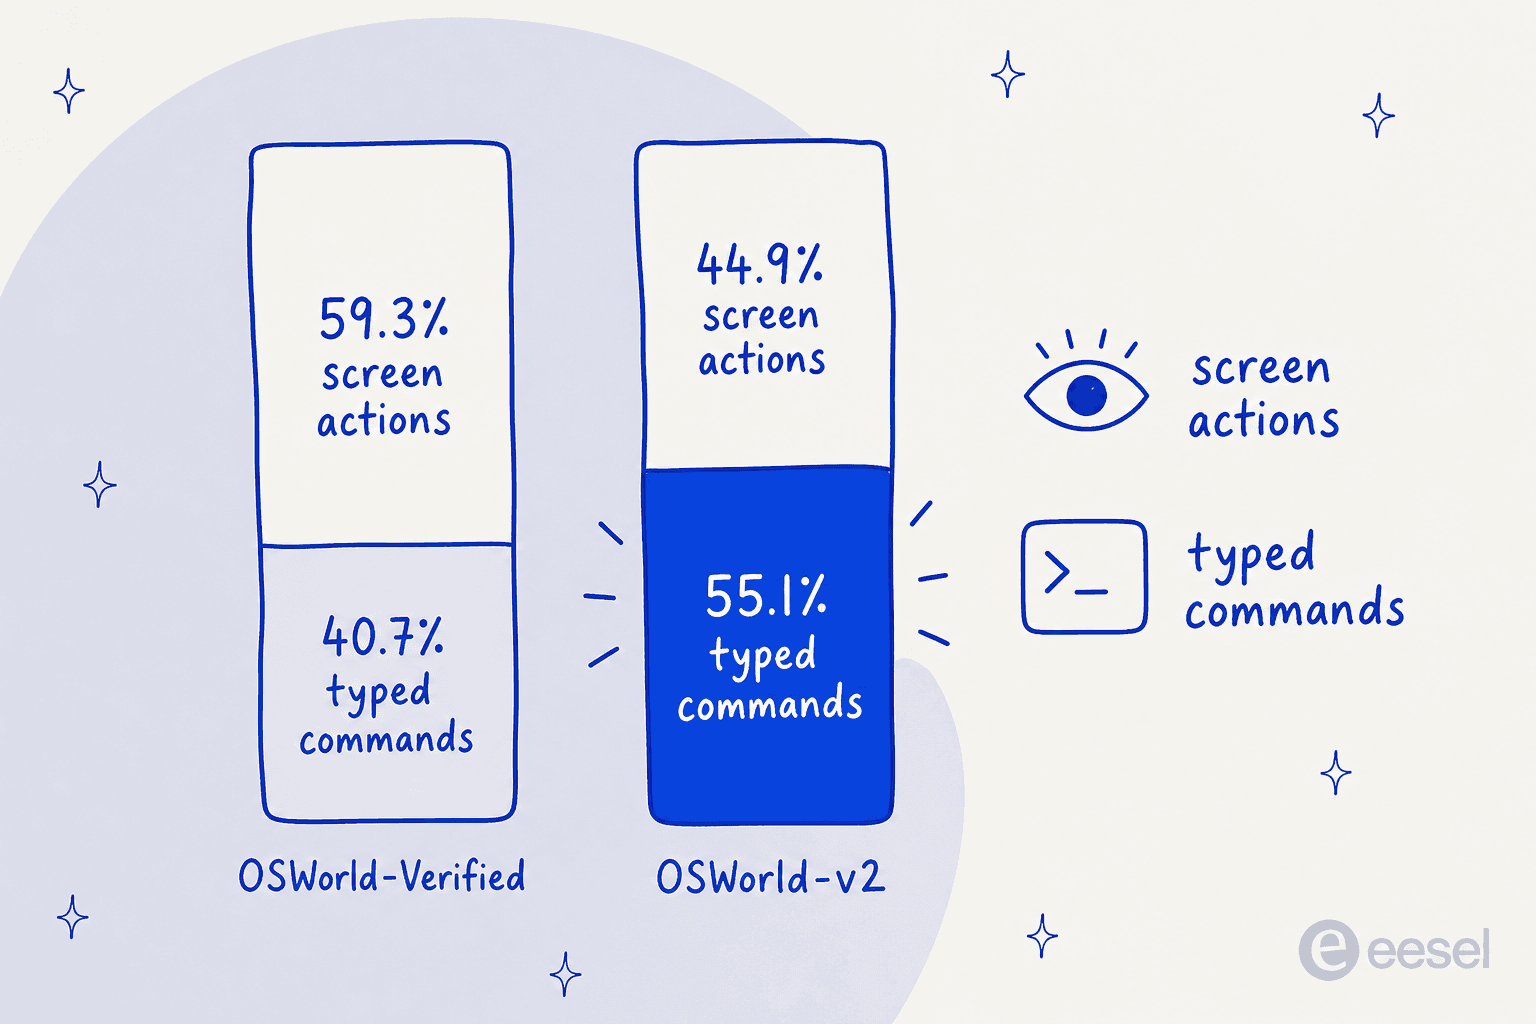
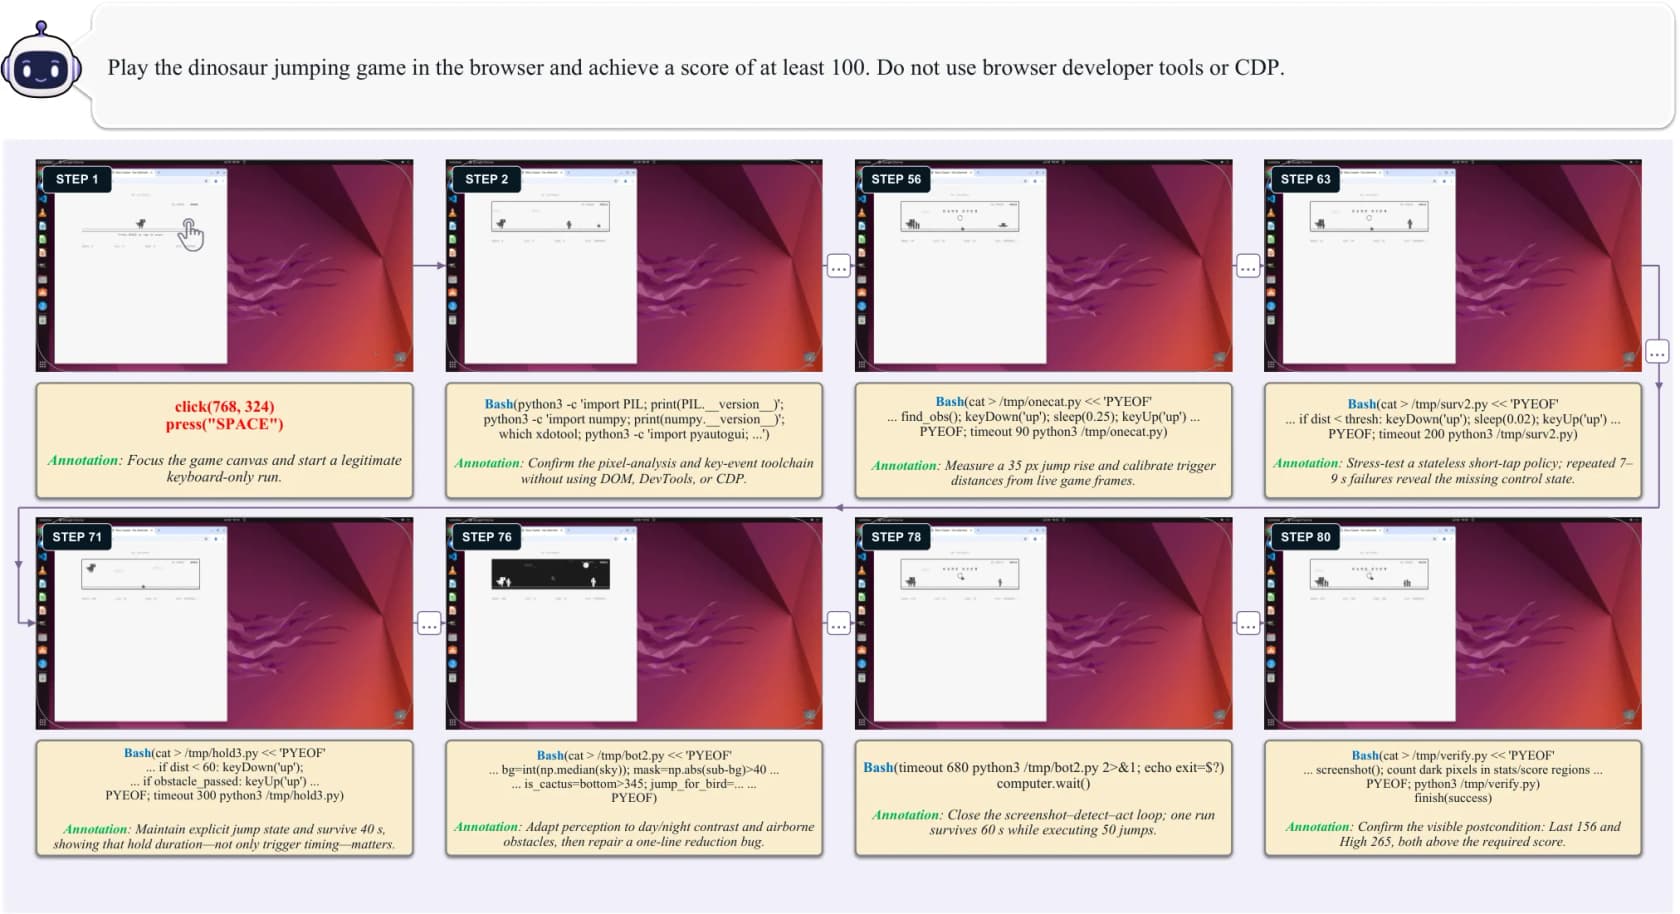
Piénsalo un momento. El producto estrella es un agente de pantalla. Dale un teclado y una shell, y en el benchmark de escritorio más difícil dedica la mayoría de sus acciones a no tocar la pantalla. La frase del propio paper para el patrón es bash como manos, GUI como ojos, y la trayectoria que mejor lo muestra es la de la tarea de conseguir 100 puntos en el juego del dinosaurio del navegador sin abrir las herramientas de desarrollo. A lo largo de 80 pasos el agente observa el canvas mediante capturas y luego escribe y reescribe Python para cronometrar los saltos.
El segundo truco de eficiencia es el agrupamiento. En lugar de una acción por turno del modelo, emite varias: el 39.6% de las acciones en OSWorld-Verified y el 41.6% en OSWorld-v2 llegan agrupadas, con un promedio de 3.1 primitivas cada una. Un ejemplo del paper es una secuencia de 21 acciones que rellena un correo y llega al selector de adjuntos, y se detiene ahí porque la siguiente decisión necesita una captura nueva. Cada turno evitado es una captura, una pasada de inferencia y un viaje de ida y vuelta menos, que es exactamente el coste que el paper señala en su propia sección de trabajo futuro como el principal obstáculo para el uso práctico.
Si has visto a un agente de navegador arrastrarse por un formulario campo a campo, esta es la solución. Chrome auto-browse tiene la misma forma de problema, y por eso la latencia por paso, y no la precisión, suele ser lo que mata una demo.
La cifra en dispositivos reales es la interesante
La mayoría de los agentes GUI se entrenan y puntúan en simuladores, porque un simulador se puede reiniciar y verificar. Alibaba construyó lo contrario: un entorno de ejecución con más de 100 teléfonos físicos que cubren más de 150 apps, además de un benchmark a juego.
MobileWorld-Real son 409 tareas escritas por humanos en 104 apps Android en vivo, excluidas del entrenamiento. Cuentas reales, contenido cambiante, permisos reales, red real. La lista de tareas se lee como el sábado de una persona: encontrar la publicación de receta más guardada, comprar los ingredientes sin condimentos para una entrega a las 18:45, comparar los tiempos a pie desde tres hoteles hasta un puente, calcular cuándo llega el tren y reservar una reunión para la siguiente hora en punto.
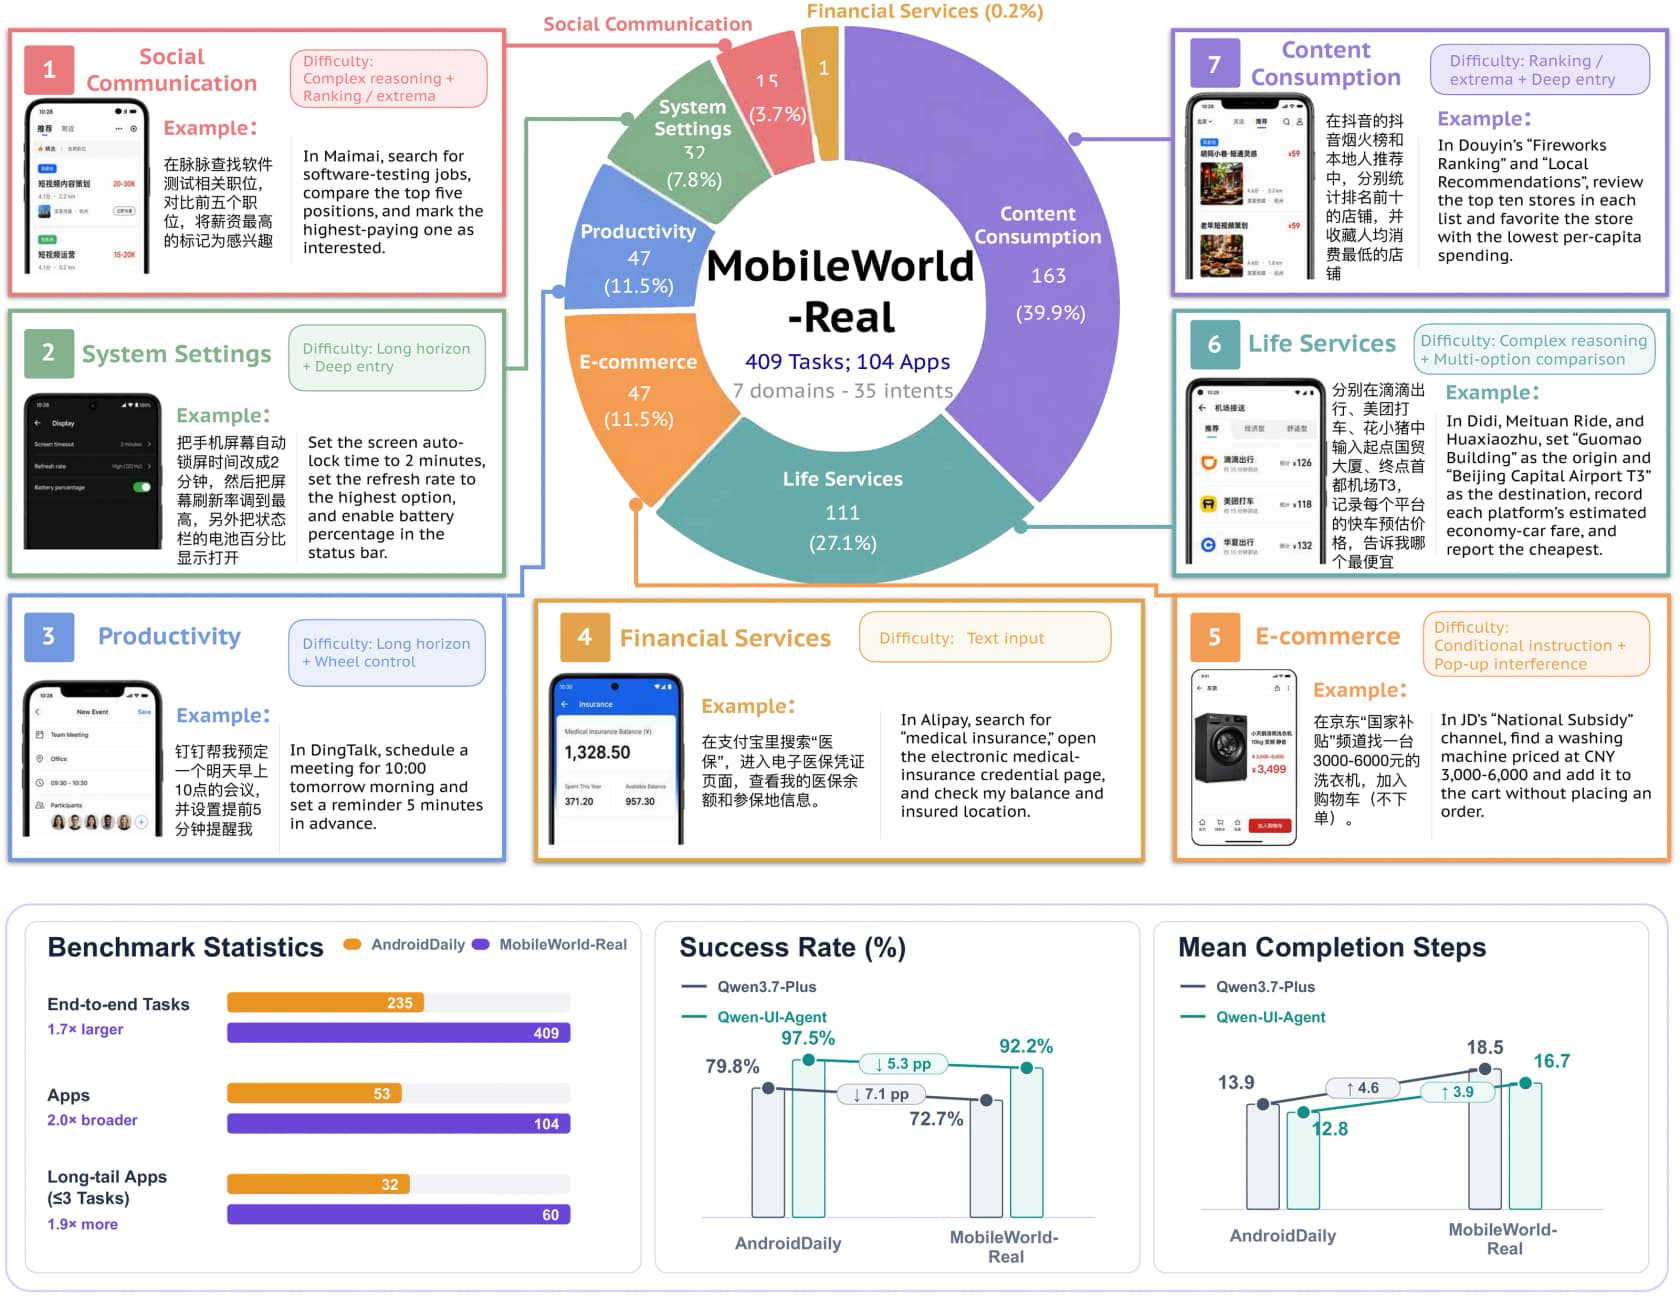
Dos salvedades honestas corresponden al 92.2%. Primero, es el benchmark de la propia Alibaba, lo cual está bien y es normal, pero no es un marcador independiente. Segundo, los teléfonos físicos no exponen los internos de las apps, así que no hay un verificador determinista. La puntuación la hace un agente llamado AutoJudge, que lee la instrucción más la traza completa de acciones y capturas y devuelve aprobado, fallo o error de entorno. El equipo situó su precisión en 92.8% de coincidencia exacta con 666 ejemplos revisados por expertos, y puso el error del juez como primera limitación del paper. Respeto que empezaran por ahí. También significa que la parte alta de ese ranking tiene una banda de tolerancia.
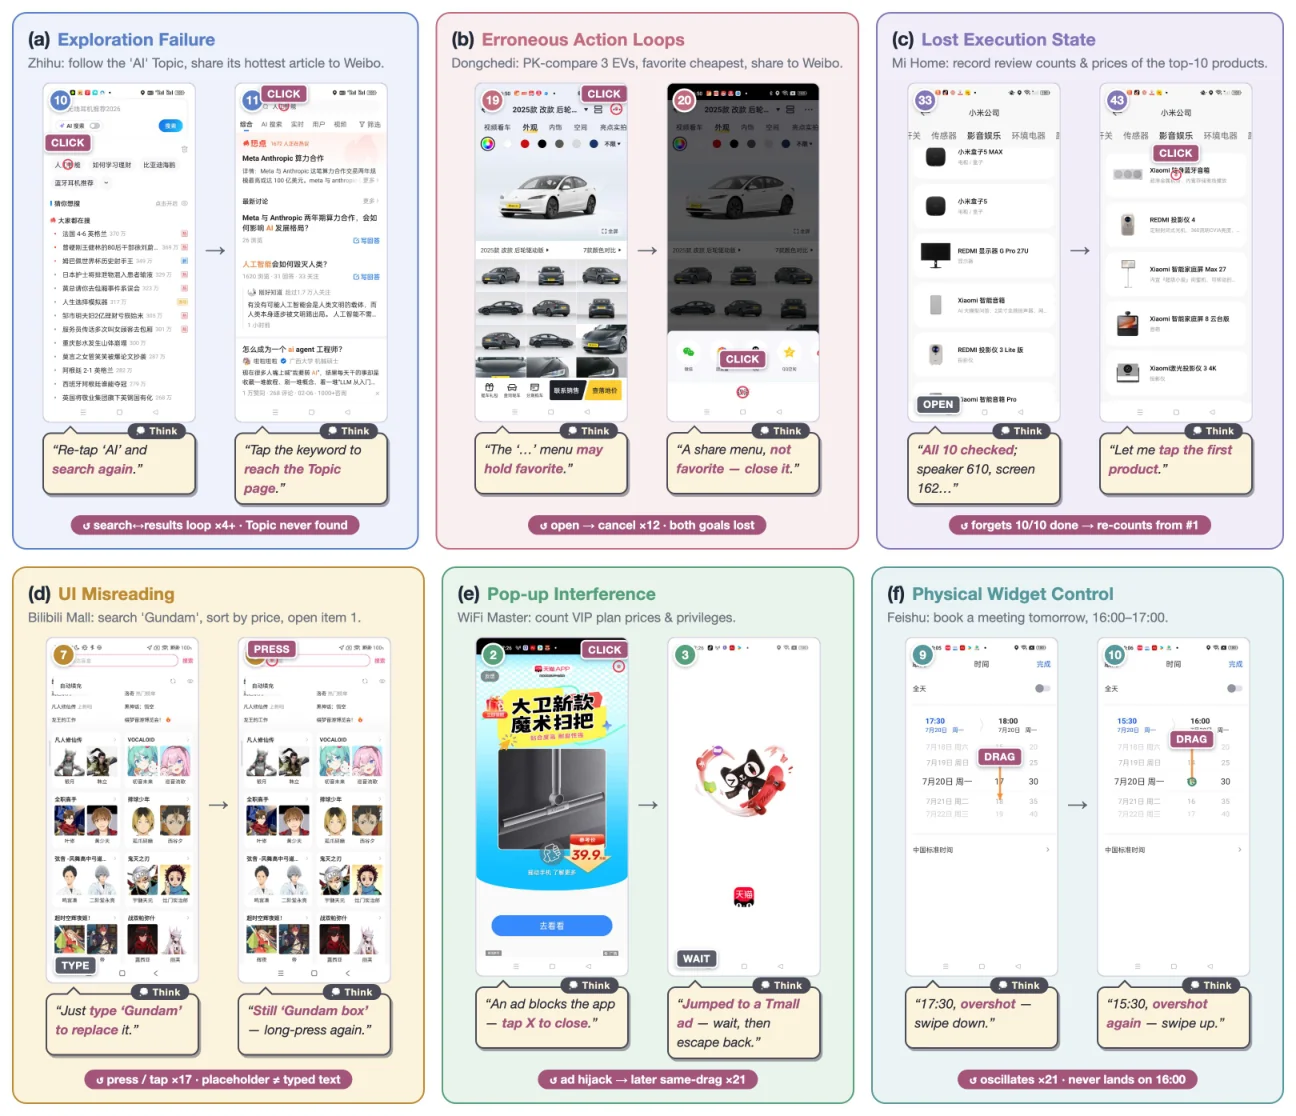
La recompensa de todo ese hardware aparece en el análisis de fallos, que es la sección que leería primero si solo tuviera cinco minutos. El equipo tomó cada trayectoria fallida de Qwen 3.7 Plus en dispositivos reales y la clasificó.
| Patrón de fallo | Proporción | Cómo se ve |
|---|---|---|
| Mala lectura de la interfaz | 24.7% | Texto de ejemplo gris leído como texto escrito, así que sigue vaciando un campo vacío |
| Interferencia de ventanas emergentes | 18.2% | Anuncios, muros de pago, CAPTCHAs, páginas en blanco |
| Fallo de exploración | 19.5% | No encuentra una función escondida tras varios menús |
| Bucles de acciones erróneas | 14.3% | Repite doce veces una acción que no hizo nada |
| Control de widgets físicos | 9.1% | Se pasa en un selector de hora en ambas direcciones y nunca acierta |
| Pérdida del estado de ejecución | 6.5% | Olvida qué subtareas ya terminó y empieza de nuevo |
Suma las filas de arriba y el 52.0% de los fallos son del entorno y no del razonamiento: aterrizó un anuncio, una página quedó en blanco, un texto de ejemplo parecía texto. Solo el 40.3% son el agente quedándose corto en sus propios términos. El verdadero adversario de un agente GUI es la interfaz, y las interfaces cambian sin avisar a nadie.
¿Se puede usar de verdad? No, todavía no
Esta es la parte que se saltó cada hilo de anuncio, así que seré claro sobre lo que existe.
| Lo que quizá quieras | Lo que existe hoy |
|---|---|
| Pesos del modelo | Ninguno. Tongyi-MAI en Hugging Face tiene MAI-UI-2B y MAI-UI-8B de diciembre de 2025 y enero de 2026, nada más reciente |
| Código de inferencia | Ninguno. El repositorio tiene 2.2k estrellas, 199 forks, cero versiones, cero paquetes |
| Una API alojada | Ninguna publicada |
| Precios | Ninguno, porque no hay nada que facturar |
| Una app para consumidores | No anunciada |
| Lo que puedes leer | El informe técnico, el sitio del proyecto, vídeos de demostración y el benchmark MobileWorld-Real |
La licencia Apache 2.0 del README cubre el contenido del repositorio, no un checkpoint, algo que conviene saber antes de que alguien te diga que este es abierto. Alibaba tiene historial de publicar pesos con el tiempo, así que la lectura sensata es "todavía no" y no "nunca". Pero ahora mismo Qwen-UI-Agent es un resultado de investigación, no algo que puedas poner en un flujo de trabajo. La guía de precios de Qwen cubre los modelos que sí puedes llamar, y Qwen 3.7 Flash es el barato que la gente ya usa en producción.
Si estás comprando y no leyendo, el conjunto de comparación honesto son los modelos que ya responden hoy a tus llamadas de API. En control de escritorio eso significa primero Claude Opus 5, y nuestra reseña de Opus 5 detalla por qué.
Por debajo, Gemini 3.5 Pro es la opción creíble más barata con visión, y GPT-5.6 es aquella para la que la mayoría de los equipos ya tiene una clave.
Si los pesos abiertos son un requisito y no una preferencia, los dos que vale la pena enfrentar son Kimi K3 y el nivel barato de DeepSeek. Nuestro análisis de DeepSeek V4 Flash explica por qué el nivel barato es el que la gente despliega de verdad.
Qué significa esto si gestionas una cola de soporte
Aquí tengo que declarar un interés, porque es mi trabajo diario. Construyo funciones de agentes en eesel, y la fantasía que un agente GUI vende a un responsable de soporte es concreta y seductora: una IA que entra en el helpdesk y trabaja los tickets como un empleado nuevo, sin proyecto de integración.
Dos cosas de este paper desaconsejan recurrir a eso en primer lugar.
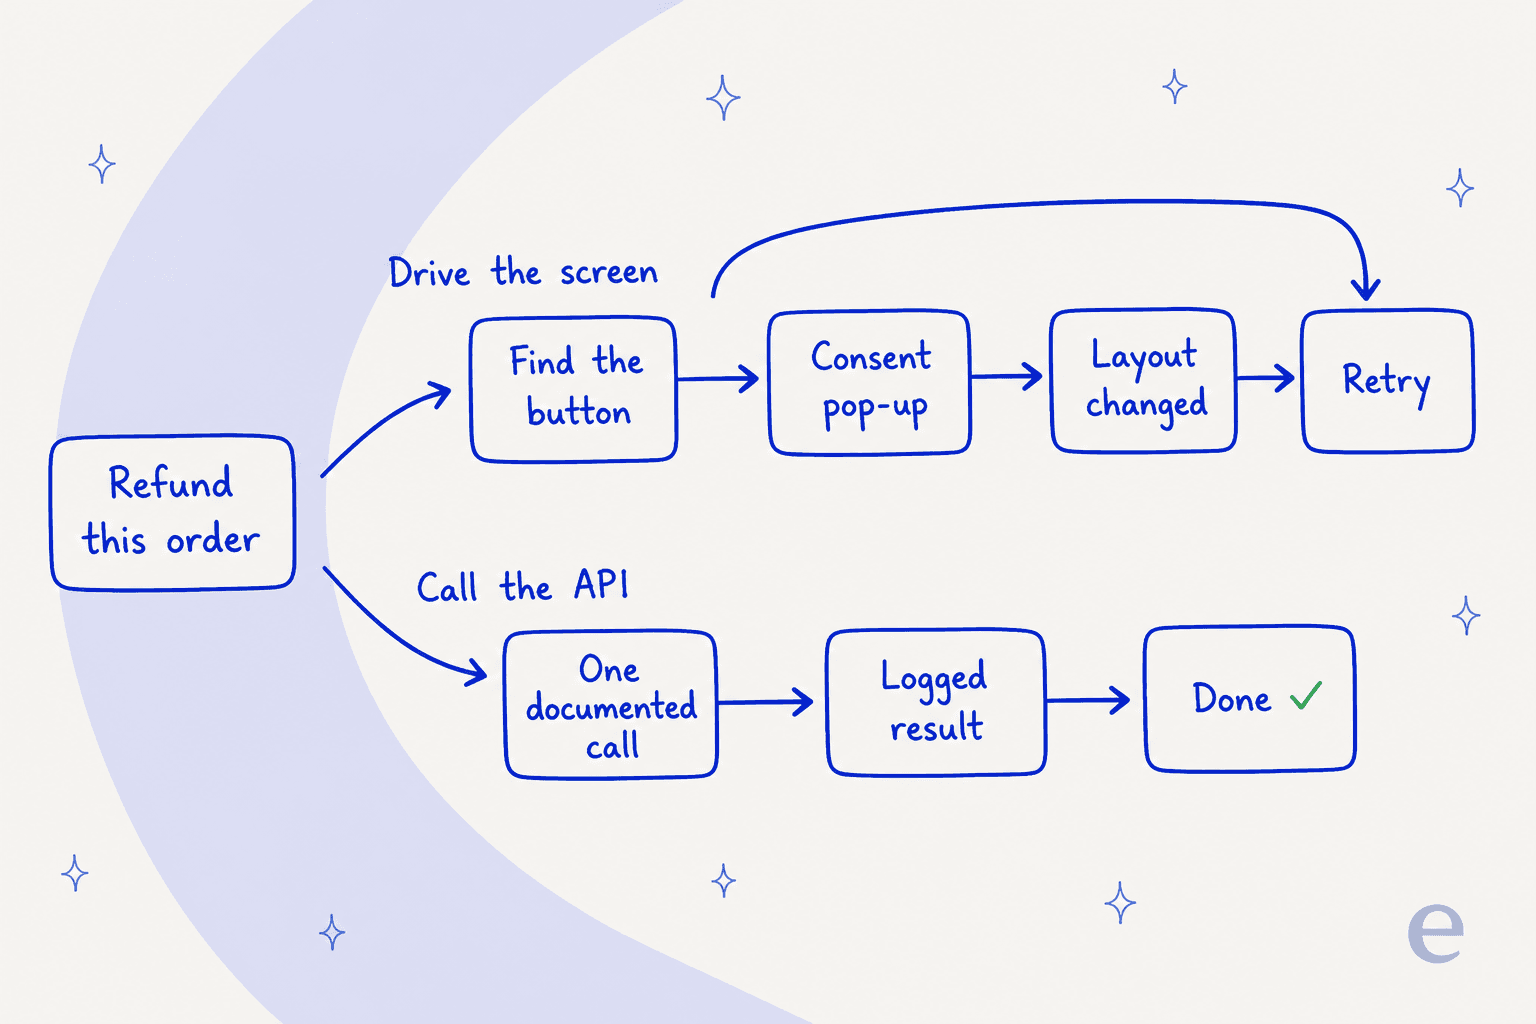
La primera es esa tabla de fallos. Anuncios, muros de pago, páginas en blanco y estados de campo mal leídos son la mayoría de los fallos en dispositivos reales, y una interfaz de helpdesk tiene los mismos peligros en versión suave: un banner de consentimiento, un tooltip de tour de funciones, un modal que solo aparece a los administradores, una tabla que se recoloca con otro zoom. Tu flujo de reembolsos no debería estar a una versión de CSS de romperse. Todo helpdesk que valga la pena tiene una API por una razón. La API de Zendesk hace en una llamada documentada lo que un agente de píxeles tiene que ganarse con seis clics y algo de suerte. Lo mismo ocurre con Freshdesk API v2, con límites de uso publicados con los que puedes planificar. Controlar pantallas es la herramienta adecuada para la larga cola de sistemas internos que nunca tuvieron API, no para los que sí la tienen.
La segunda es ask_user, y lo digo como elogio. Alibaba puso "parar y consultar con la persona" en el espacio de acciones en lugar de añadirlo después, de modo que el agente rellena el importe y la nota de Alipay y se detiene en el paso de pago. Esa es exactamente la forma de la objeción que más escucho en soporte. Un responsable de CX que maneja unos 7.000 tickets al mes nos lo dijo así, y se me ha quedado grabado desde entonces:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eso no es una petición de función sobre pantallas. Es una petición de un límite de confianza, que es la misma idea de diseño que Alibaba entregó como una acción. Si vas en esa dirección, las reglas de traspaso son el punto de partida práctico. La mecánica del disparador en sí está en las reglas de escalado. Lo que decide primero en qué cubo cae una conversación suele ser la clasificación de tickets.
Lo tercero es lo que Alibaba gastó 100 teléfonos en demostrar, y se generaliza más allá del móvil. Un número de un simulador no predice el comportamiento en el entorno real. Ese es todo el argumento de su entorno en dispositivos reales, y es el mismo argumento para ejecutar un agente de IA sobre tus propios tickets históricos antes de que responda uno en vivo. Lo aprendimos por las malas hace años, viendo a un bot de tono seguro dar respuestas equivocadas con total aplomo, y por eso nada en eesel sale en vivo sin una pasada de simulación antes. Si quieres la versión más amplia de ese argumento, el control de calidad del soporte explica cómo lo miden realmente los equipos. El equivalente humano está en el coaching de agentes.
Nada de esto es una crítica a Qwen-UI-Agent. Es un operador de dispositivos, y muy bueno en teléfonos. No tiene modelo de tickets, base de conocimiento, cola ni concepto de cliente, así que queda una capa por debajo de las herramientas de nuestro resumen de los mejores agentes de IA y de la lista más acotada del mejor agente de IA para soporte. Un trabajo totalmente distinto.
Si quieres el mapa de categorías, los ejemplos de agentes de IA muestran dónde rinde cada tipo. Agentes de IA frente a chatbots traza la línea que la mayoría de los compradores buscan de verdad, y los chatbots basados en reglas cubren la generación anterior a esta.
Prueba eesel
Si lo que quieres es una IA que trabaje tu cola en lugar de hacer clics en ella, eso es lo que construimos. eesel se conecta a través de la API del helpdesk que ya usas, aprende de tus tickets pasados y de tu centro de ayuda en lugar de adivinar, y ejecuta una simulación sobre tu historial real de tickets antes de que un solo cliente vea una respuesta. Obtienes de antemano la tasa de aciertos, los huecos y la redacción que corregir. Se factura por ticket gestionado, no por puesto, así que un mes tranquilo cuesta menos que uno movido.

Ese panel de aprobaciones es la idea de ask_user en producción: cada acción de herramienta que el agente quiso realizar, y si una persona la aprobó, la rechazó o todavía no ha decidido.
Empieza por IA para helpdesk si quieres el panorama general, desvío de tickets si persigues una cifra concreta, o herramientas de automatización del soporte si aún estás comparando.
Si no, prueba eesel gratis. Sin llamada previa.
Entonces, ¿en qué queda todo esto?
Qwen-UI-Agent es la prueba publicada más sólida hasta ahora de que un modelo de tamaño medio con arquitectura abierta puede manejar un teléfono mejor que un generalista de frontera. 82.1% en MobileWorld frente a 67.5% de Opus 4.8 no es un error de redondeo, y 38.2 puntos sobre el mejor especialista anterior son un salto. El espacio de acciones híbrido es la idea correcta y el agrupamiento es la optimización correcta. Alibaba también reportó las partes que no la favorecen, algo más raro de lo que debería ser.
También es inaccesible, no está probado en stacks de apps occidentales, es segundo en escritorio y va 26 puntos por detrás en investigación en inglés. Si lees una sola cosa más allá del ranking, que sea la Tabla 10. La pantalla es el adversario, no el modelo, y eso es cierto tanto si la interfaz es Douyin como si es tu helpdesk. Donde exista una API, usa la API. Donde no, esta línea de trabajo es la que acabará llenando el hueco, y por eso mismo vale la pena seguirla.
Mientras tanto, las preguntas que deciden tu trimestre son las aburridas. Si tu base de conocimiento con IA es lo bastante buena para responder desde ella. Si el enrutamiento de tickets envía las cosas al lugar correcto antes de que ninguna IA las toque.
Luego la pregunta del dinero, que es el coste de agente de IA frente a humano con tu volumen real, no con el de un proveedor. Y la pregunta del enfoque, porque el planteamiento de los compañeros de equipo de IA y el del empleado de IA divergen más de lo que sugiere el marketing.
Por último, la que todos aplazan: si un sistema de tickets con IA compensa la migración desde el que tienes. Para el resto de la oferta de Alibaba, las alternativas a Qwen son el resumen y la reseña de Qwen3.8-Max es el pariente más cercano de este artículo.
Preguntas frecuentes
¿Qué es Qwen-UI-Agent?
¿Qwen-UI-Agent es de código abierto o descargable?
¿Qué tan bueno es el agente de UI de Qwen comparado con Claude y GPT?
¿Cuánto cuesta Qwen-UI-Agent?
¿Puede un agente GUI manejar mi helpdesk por mí?
¿Qué pasa si el agente se equivoca en un ticket real?
ask_user para poder detenerse antes de un pago o un borrado, que es la misma idea que un umbral de confianza en soporte: responder automáticamente lo que el agente tiene claro y pasar el resto a una persona. Nuestras guías sobre reglas de traspaso y reglas de escalado explican cómo configurarlo.