

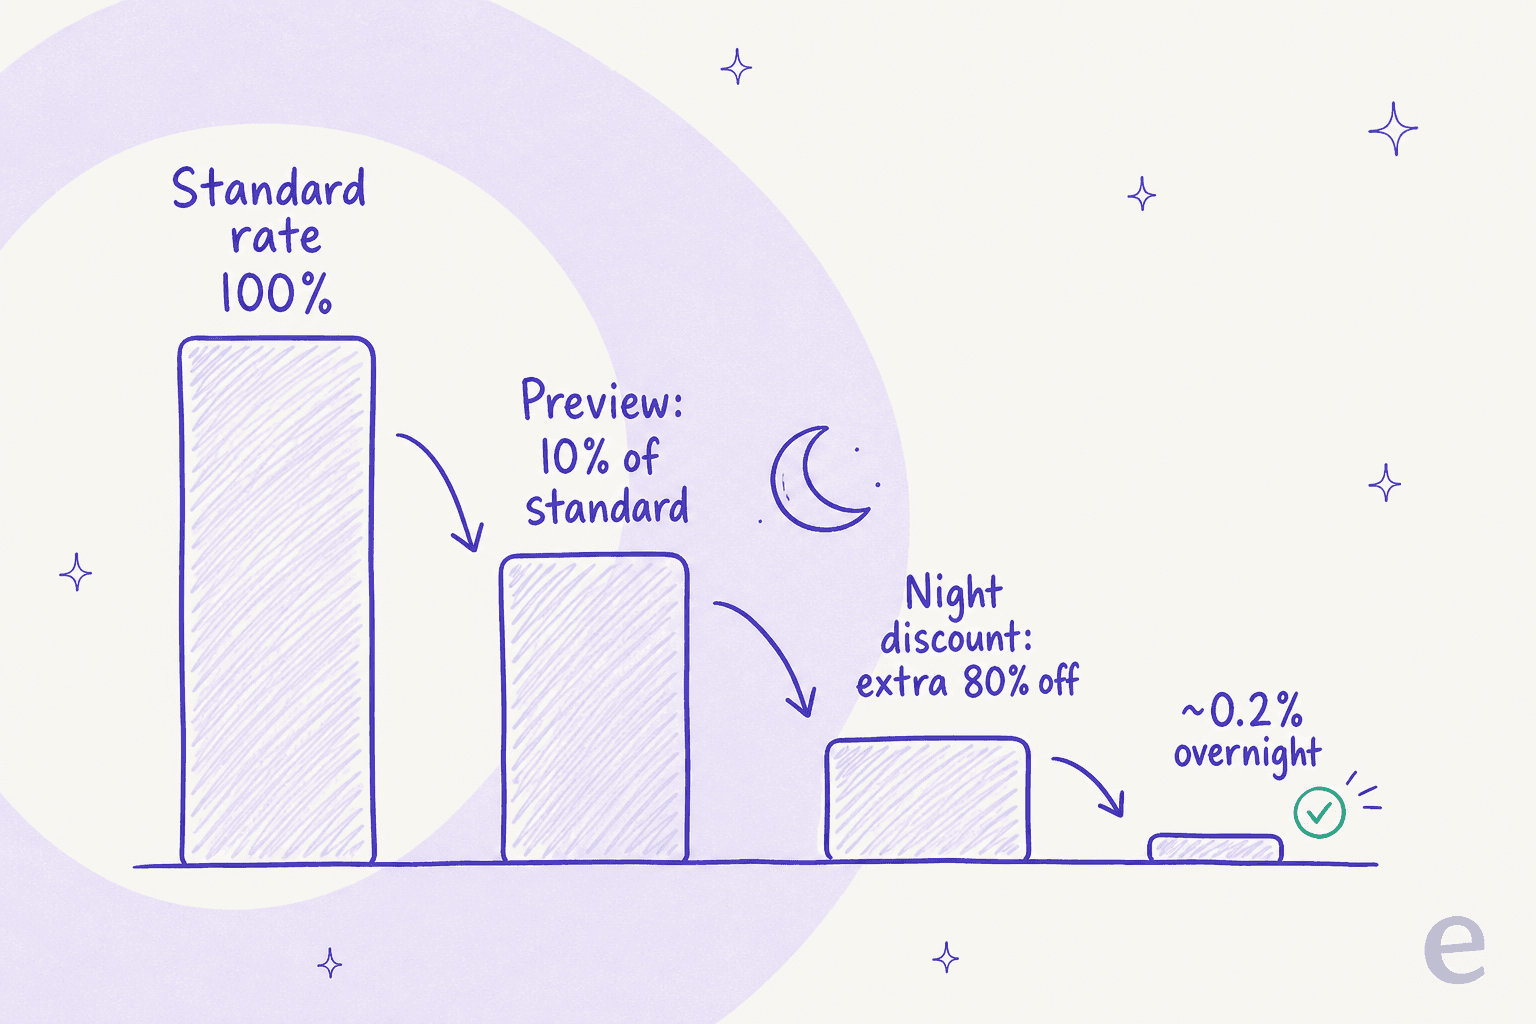
Alibaba presentó Qwen3.8-Max en preview el 19 de julio de 2026, y lo que realmente hizo que los desarrolladores prestaran atención no fueron los 2,4 billones de parámetros, sino el precio. Durante el preview, el modelo se vende al 10% del precio estándar a través de la suscripción Token Plan de Alibaba y sus productos de programación Qoder y QoderWork, con un descuento nocturno adicional del 80% que reduce la tarifa fuera de hora punta a aproximadamente el 0,2% del precio estándar.
Hay dos trampas que debes conocer antes de calcular ningún presupuesto. Primero, todavía no existe un precio por token independiente, algo poco habitual para un modelo de nivel Max. Todo funciona a través de una suscripción basada en créditos, así que tu coste real depende de la velocidad a la que quemas créditos, no de una tarifa de entrada/salida clara que puedas prever. Segundo, ese 10% es un precio promocional de preview, no el precio a largo plazo.
Llevo años viendo a equipos elegir un modelo por su tarifa de etiqueta y llevarse una sorpresa con la factura tres semanas después. Para cualquier cosa de la que realmente dependas, especialmente un agente de soporte, el precio del modelo es la partida pequeña. Esta guía recorre el precio real de Qwen3.8-Max, el coste oculto del consumo de créditos, y cómo pensar en ello antes de integrarlo en nada.
Por qué leo esta etiqueta de precio con tanto cuidado
Construyo y escribo sobre IA en eesel, y dos años haciendo SEO me enseñaron que el número que la gente busca ("precio de Qwen3.8-Max") y el número que realmente paga rara vez coinciden. Mi trabajo diario está aún más cerca de esa brecha: en eesel llevamos años poniendo modelos de frontera en colas de soporte reales, y la lección que se repite es que el precio por token casi nunca es lo que determina el coste de ejecutar IA sobre trabajo real.
Así que cuando un modelo de 2,4 billones de parámetros aparece con un 10% de descuento, mi instinto no es "barato, a implementarlo". Es: ¿en qué unidad me están cobrando realmente, a qué velocidad se agota y qué pasa con el precio cuando termine la fiesta? Esa es la lente de todo este artículo. Si quieres las especificaciones completas y la afirmación de "segundo solo detrás de Fable 5", el explicativo de Qwen3.8-Max y la reseña práctica cubren eso. Aquí seguimos el rastro del dinero.
Qué estás pagando en realidad
Un poco de contexto rápido, porque el precio solo tiene sentido cuando sabes en qué nivel estás. Qwen (Tongyi Qianwen) es la familia de modelos de Alibaba Cloud, y "Max" es la línea insignia propietaria, por encima de los niveles más baratos Plus y Turbo, y por encima de los checkpoints de peso abierto de Qwen3. Qwen3.8-Max es el modelo Max más reciente, presentado en preview como Qwen3.8-Max-Preview y descrito como un modelo de Mixture-of-Experts de 2,4 billones de parámetros que procesa texto, imágenes, vídeo y documentos.
El dato de precio importante se esconde en ese sufijo "Preview": esto es un lanzamiento promocional, no un producto asentado. La tarifa del 10%, el precio por token que falta y la promesa de "pesos abiertos próximamente" son todo estado de preview. Eso importa porque es la diferencia entre un precio con el que puedes planificar un año entero y un precio que puede cambiar bajo tus pies el mes que viene.
La oferta de preview de Qwen3.8-Max, en una línea
Esto es lo que repitió cada desarrollador: durante el preview, Qwen3.8-Max funciona al 10% del precio estándar, entregado a través de tres vías:
- Token Plan, la suscripción de Alibaba basada en créditos (la vía principal para consumidores).
- Qoder, el producto de programación agéntica de Alibaba.
- QoderWork, la versión de equipo/espacio de trabajo del mismo producto.
No hay una tarifa por token independiente publicada. Para un modelo de nivel Max eso es inusual, y es lo más importante que hay que entender sobre el precio de Qwen3.8-Max: no estás comprando tokens a una tarifa fija, estás comprando créditos en una suscripción y gastándolos con un descuento de preview.
Niveles del Token Plan Personal
El punto de entrada para consumidores es el Token Plan (Personal Edition). Es una suscripción mensual que otorga una reserva de créditos, limitada de dos formas: una cuota de 7 días y una cuota renovable de 5 horas (para que no puedas agotar los créditos de un mes entero en una tarde).
| Nivel | Mensual | Cuota de créditos a 7 días | Cuota de créditos a 5 horas |
|---|---|---|---|
| Lite | ~6 $ (39 CNY) | 2.500 créditos | 700 créditos |
| Standard | ~20 $ (139 CNY) | 10.000 créditos | 3.000 créditos |
| Pro | ~70 $ (499 CNY) | 40.000 créditos | 12.000 créditos |
Fuente: Alibaba Cloud Token Plan. Las cifras en dólares son conversiones aproximadas de los precios en CNY y varían con el tipo de cambio.
El crédito, no el dólar, es la unidad real aquí. Un "crédito" corresponde al consumo de tokens, y cuántos tokens compra un crédito depende del modelo y del descuento que se le aplique encima. Eso nos lleva a la parte que hace que el precio de etiqueta parezca casi gratis.
El descuento nocturno que lo hace parecer casi gratis
Además del 10% de descuento en preview, Alibaba añade un descuento nocturno: un 80% adicional sobre el consumo de créditos entre las 22:00 y las 08:00 (UTC+8). Combinando ambos, las ejecuciones fuera de hora punta quedan en aproximadamente el 0,2% del precio estándar.
Es una jugada agresiva y deliberada. Está diseñada para que los desarrolladores prueben el preview de forma barata, y si tu carga de trabajo se puede procesar por lotes (evaluaciones, generación de datasets, tareas de programación nocturnas), programarla dentro de la ventana nocturna de UTC+8 es una palanca real de reducción de costes. Si estás en América, la noche en UTC+8 coincide más o menos con tu horario laboral, lo cual es o bien conveniente o bien inútil según dónde estés.
La trampa es la misma que lleva cualquier tarifa promocional: te está enseñando el coste del descuento, no el coste del producto. Haz prototipos al 0,2%, pero presupuesta al 100%.
El coste oculto que nadie pone en la página de precios
Esta es la línea que subrayaría en cualquier conversación sobre el precio de Qwen3.8-Max. El modelo de suscripción por créditos es exactamente lo que los usuarios de Qwen ya han reportado antes.
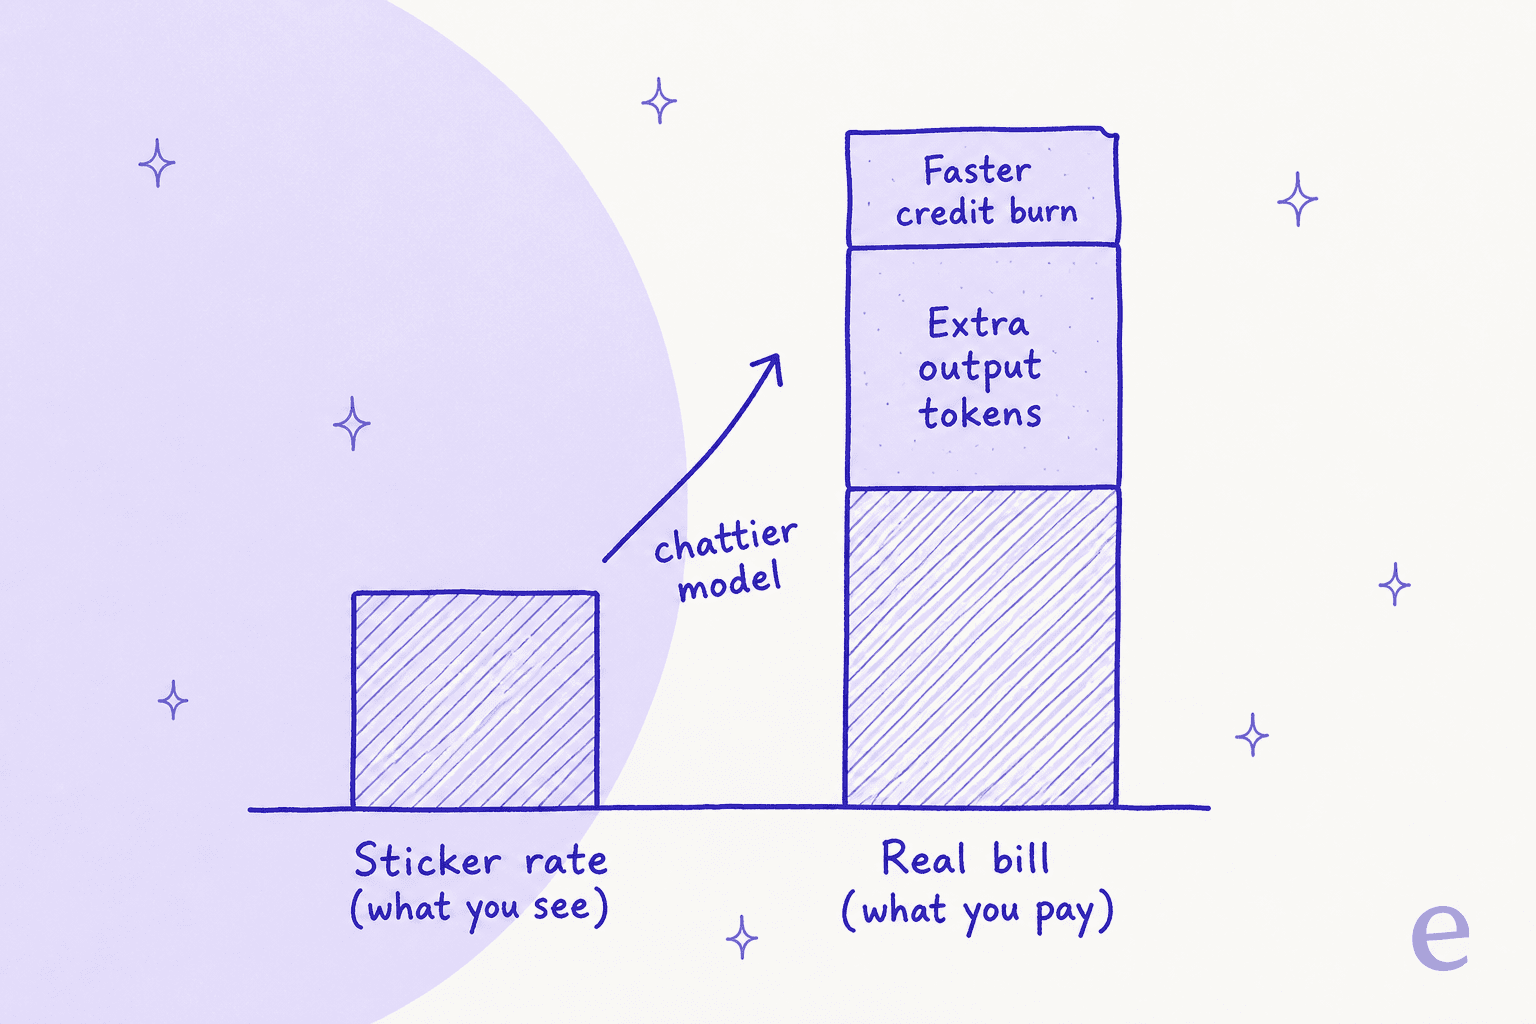
En la generación anterior, usuarios de Reddit reportaron que los créditos se agotaban mucho más rápido de lo esperado. Y hay una razón estructural para que esto ocurra: los modelos de Qwen tienden a generar más tokens de salida por tarea que otros modelos comparables. Como los tokens de salida suelen costar más que los de entrada y se factura por consumo, un modelo más "hablador" infla la factura real en silencio incluso cuando la tarifa de etiqueta parece baja.
Junta todo eso y el descuento de preview está tapando un modelo de medición que históricamente sorprende a la gente. La tarifa del 10% oculta el consumo. Cuando termine el preview y el descuento desaparezca con él, ese consumo es lo que realmente vas a notar. Así que la forma honesta de leer el precio de Qwen3.8-Max es: barato para probar, impredecible para depender de él, al menos hasta que Alibaba publique una tarifa real por token que puedas prever.
Calcula tu propio coste de preview
Como no hay una tarifa por token clara, lo más útil que puedo darte es una forma de sentir la forma de la factura. Introduce un consumo mensual de créditos aproximado y observa cómo el descuento de preview y la ventana nocturna cambian lo que pagarías, frente a ejecutarlo a precios estándar.
Lo que la calculadora transmite mejor que un párrafo: el preview es asombrosamente barato, pero "tu estimación" está construida sobre un descuento, no sobre un precio. Modela también la columna estándar, porque es en la que vivirás más adelante.
Cómo se compara el precio
En coste de acceso puro, el preview supera a todos, ese es todo el diseño. Pero la comparación es donde muerde la tarifa por token que falta, porque no puedes alinear Qwen3.8-Max con una tabla de precios normal.
- Kimi K3, el buque insignia de 2,8 billones de parámetros de Moonshot, con un precio aproximado de 3 $/15 $ por millón de tokens de entrada/salida. Eso es nivel Sonnet, no nivel barato, y destaca que es una tarifa publicada y previsible. Kimi K3 llegó días antes que Qwen3.8-Max, y el momento elegido fue claramente una respuesta.
- El nivel superior de Claude (Fable 5), el modelo con el que Alibaba se está midiendo, con un precio por encima de Kimi K3, también con una tarifa publicada clara.
- Qwen3.8-Max, el más barato para probar, el menos claro para presupuestar. Una suscripción de créditos con un descuento promocional no es el mismo tipo de cifra que 3 $/15 $ por millón de tokens.
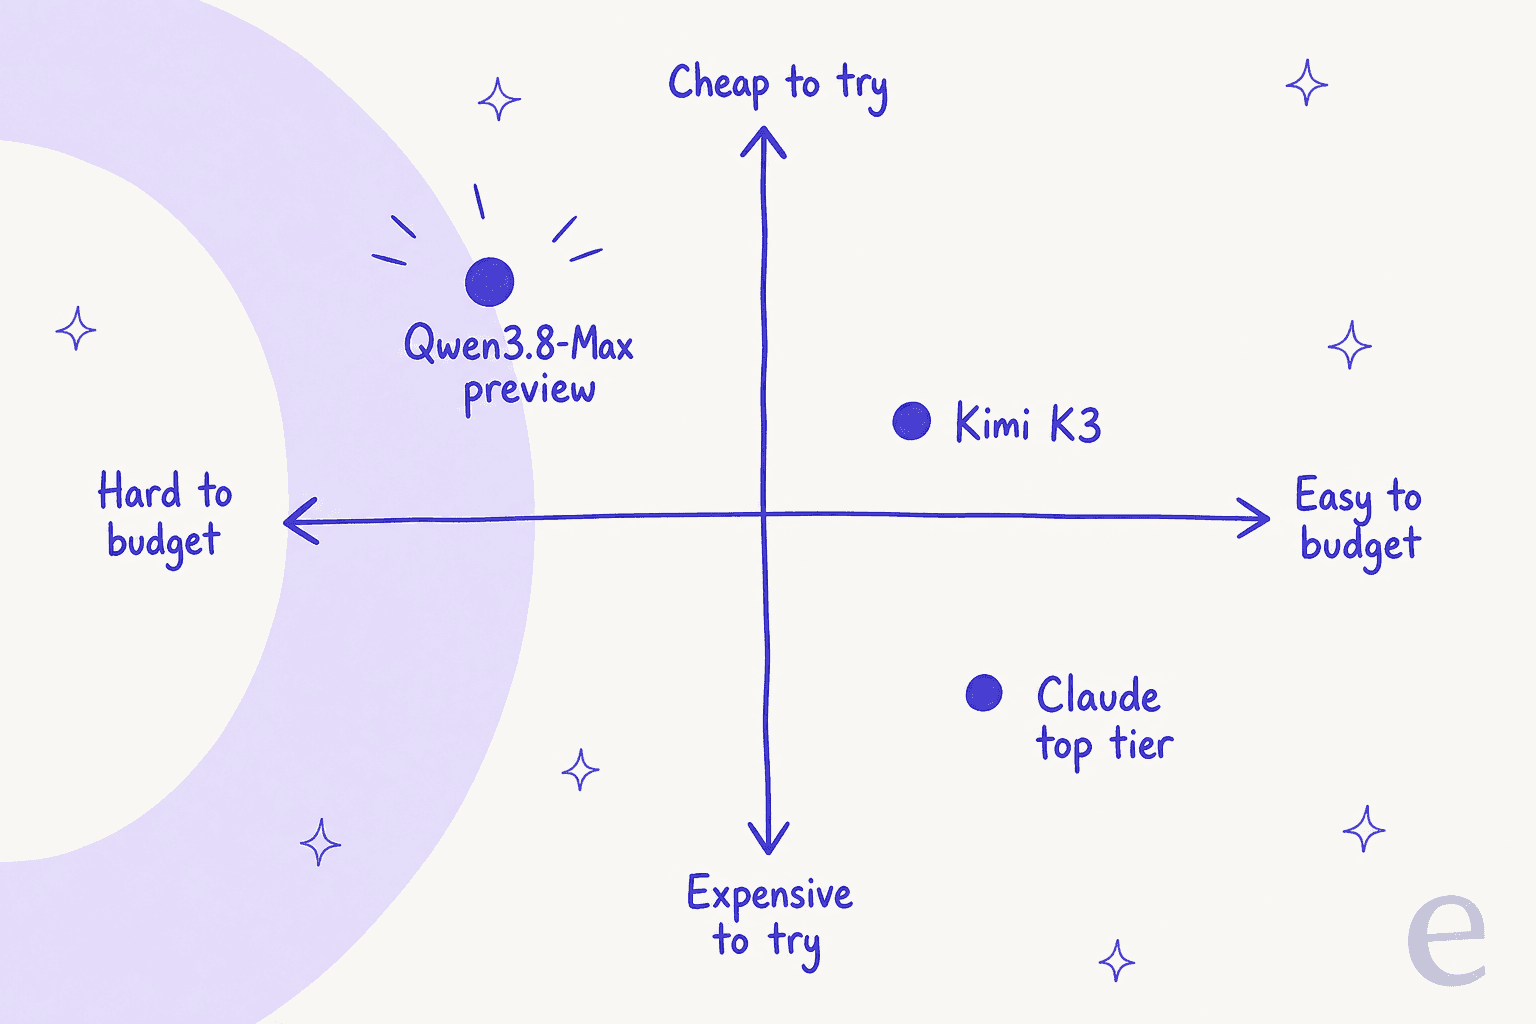
Si tu decisión es "cuál es más barato para experimentar esta semana", el preview gana fácilmente. Si es "con cuál puedo prever un año de gasto de producción", Qwen3.8-Max es actualmente el más difícil de responder, precisamente porque el precio de preview es un objetivo móvil. Para el panorama más amplio, el resumen de mejores modelos de IA y la guía de alternativas a Qwen son buenas siguientes lecturas.
Dónde el precio del modelo deja de importar: el trabajo real
Aquí está la parte que más me importa, porque es el error que veo cometer a los equipos con cada modelo nuevo. Cuando el trabajo es atención al cliente, el precio del modelo es el número pequeño de la factura.
Un modelo en bruto, por muy barato e inteligente que sea, no tiene memoria de tus tickets, ni barreras de seguridad, ni conexión con tu helpdesk. Para responder a un cliente real necesita tu base de conocimiento, tus políticas, reglas de escalado y una forma de derivar a un humano cuando no está seguro. Construir y mantener esa capa es donde vive el coste real, no en la diferencia entre el 10% y el 100% de una tarifa por token. Un cliente de eesel resumió la decisión de construir frente a comprar de forma clara:
"We could try to write our own LLM application, but we didn't want to invest our time into that. We wanted something we wouldn't have to maintain."
a mid-market support lead evaluating build vs buy
Esa es la buena noticia silenciosa sobre Qwen3.8-Max, Kimi K3, o el que sea que lidere la tabla de tamaños el mes que viene. Una IA para atención al cliente bien construida hereda cada avance de frontera sin que tengas que rehacer nada, y su precio está ligado a los tickets resueltos, no a un saldo de créditos de preview que tienes que vigilar.
Ese es el vacío que llena eesel AI. Envuelve un modelo de frontera con tu conocimiento y tus barreras de seguridad, se conecta con Zendesk, Freshdesk y más, y, la parte que importa para el coste, simula sobre tus tickets históricos antes de que nada salga en vivo, así que ves la tasa de resolución y las respuestas exactas sobre conversaciones pasadas reales primero.
¿Quieres un agente de IA que convierta cualquier modelo de frontera en resolución real de tickets? Prueba eesel gratis, sin tarjeta de crédito.
La conclusión sobre el precio de Qwen3.8-Max
El preview es una forma barata de probar un modelo multimodal de 2,4 billones de parámetros: 10% del precio estándar, bajando a ~0,2% por la noche. Trátalo como una prueba, no como un plan. Las dos cosas a vigilar son la tarifa por token que falta (no puedes prever con claridad sobre una suscripción de créditos) y el consumo histórico de créditos que el descuento está ocultando por ahora. Haz prototipos ahora, presupuesta la tarifa real más adelante, y si el trabajo es de soporte, recuerda que el precio del modelo nunca fue el número que importaba.