

Qwen3.8-Max es el nuevo buque insignia de Alibaba, presentado en vista previa el 19 de julio de 2026. Alibaba lo llama modelo disperso de Mixture-of-Experts con 2,4 billones de parámetros y su primer modelo multimodal por encima de 1 billón de parámetros, que admite texto, imágenes, vídeo y documentos. La frase titular del equipo de Qwen es directa: dicen que es "segundo solo después de Fable 5".
Hay dos advertencias tan importantes como el titular. Primero, en la vista previa no había tabla de referencia, ni ficha técnica, ni licencia, así que "segundo solo después de Fable 5" es una afirmación del proveedor, no un resultado medido. Segundo, se le llama de pesos abiertos pero los pesos no estaban disponibles, y no se dio ninguna fecha. La vista previa es un producto real y comprable, vendido al 10% del precio estándar a través del Token Plan de Alibaba.
Si te interesa Qwen3.8-Max para hacer algo de verdad, como responder tickets de soporte, ten esto presente: el modelo es la parte fácil. Llevo años poniendo IA en colas de soporte en producción, y una afirmación de rendimiento no es un agente de soporte. Lo difícil es conectar un modelo con tu conocimiento, tus barreras de seguridad y tu helpdesk, que es el trabajo que hace eesel AI sin importar qué modelo esté ganando esta semana.
Qué es realmente Qwen3.8-Max
Qwen (Tongyi Qianwen) es la familia de modelos de Alibaba Cloud, que abarca texto, visión, audio, código y agentes. El nivel "Max" es la línea insignia propietaria, por encima de los niveles más baratos Plus y Turbo y por encima de los checkpoints de pesos abiertos de Qwen3. Qwen3.8-Max es el más nuevo, y Alibaba lo presentó en vista previa como "Qwen3.8-Max-Preview" el 19 de julio de 2026.
Aquí va la versión honesta, porque el propio lanzamiento fue inusualmente escueto. No hubo publicación oficial de blog, ni ficha técnica, ni tabla de referencia en la vista previa, solo dos publicaciones en X del equipo de Qwen y un endpoint de vista previa funcional y de pago. Así que la mayor parte de lo que sigue es el propio relato de Alibaba, que nadie fuera del laboratorio había verificado de forma independiente todavía.
Las especificaciones que Alibaba declara:
- 2,4 billones de parámetros totales, un diseño disperso de Mixture-of-Experts (Qwen en X).
- El primer Qwen multimodal por encima de 1T de parámetros, capaz de manejar texto, imágenes, vídeo y documentos, según el investigador principal Shuai Bai.
- Una ventana de contexto de 1 millón de tokens, heredada de su predecesor Qwen3.7-Max.
- Orientado a codificación, flujos de trabajo agénticos y tareas de "cotrabajo profesional" de largo horizonte, que es donde Alibaba dice que supera a Qwen3.7-Max.
El número de parámetros activos por token, el conjunto completo de referencias y la licencia faltaban todos en la vista previa. Alibaba dijo que llegarían. Hasta que lo hagan, trata las especificaciones internas como marketing, no como medición.
Bajo el capó: cómo funciona Qwen3.8-Max
Aquí es donde un recuento de parámetros gigante deja de ser el titular. Un modelo denso de 2,4T sería demasiado caro de ejecutar, así que Qwen3.8-Max es un modelo de Mixture-of-Experts: la mayoría de esos parámetros permanecen inactivos en cualquier token dado, y solo se activa una pequeña porción. Ese es el mismo truco que permite que los niveles más baratos de Qwen superen en precio a sus rivales, aquí escalado.
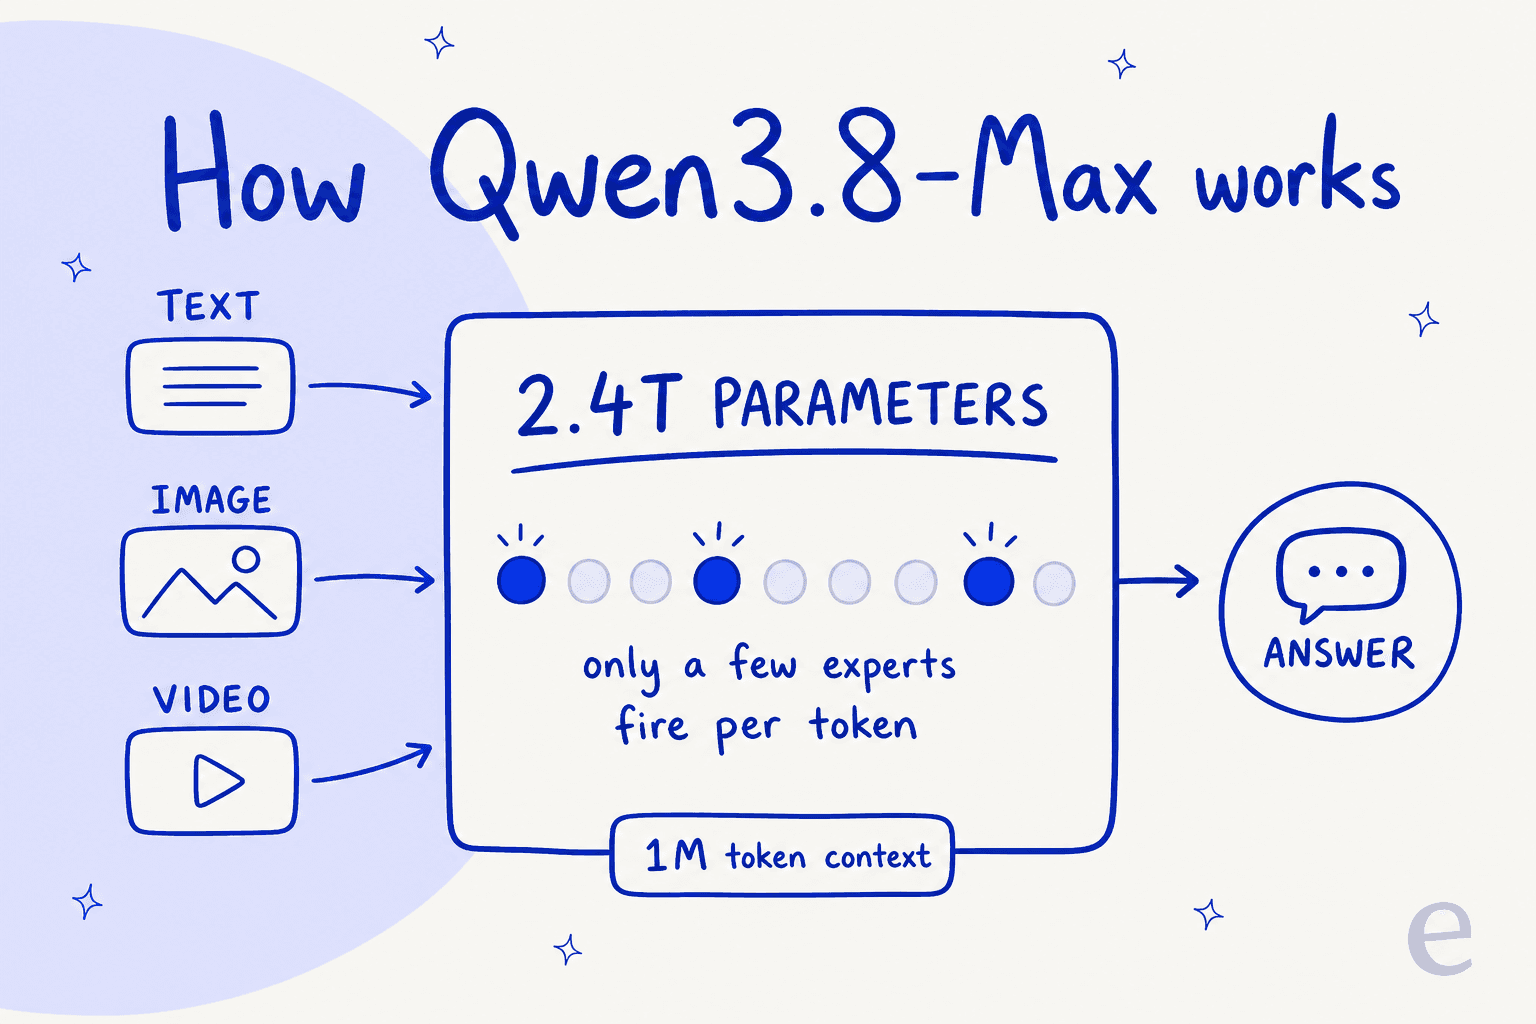
La parte multimodal es el verdadero salto para la línea Max. Los modelos Max anteriores eran primero de texto; aquí Alibaba dice que el modelo ingiere de forma nativa imágenes, vídeo y documentos junto con texto, algo que Shuai Bai señaló como el detalle pionero:
"Qwen3.8-Max Preview is now available for early access! This is our first trillion-parameter multimodal model."
La pega que conviene repetir: la relación de dispersión, el número de expertos y la receta de entrenamiento no se publicaron. Así que conocemos la forma que Alibaba describe (enorme, dispersa, multimodal) pero no las cifras que permitirían reproducirla o clasificarla. Ese es un vacío real para un modelo que reclama un puesto entre los dos mejores.
Lo que Alibaba afirma sobre el rendimiento
Aquí está la frase que todos citaron. La propia publicación de lanzamiento del equipo de Qwen la enmarca contra la cima del sector:
"Qwen3.8 is launching and going open-weight soon! With a massive 2.4T parameters, this model is continuously evolving. We believe it's one of the most powerful models available today... second only to Fable 5."
"Segundo solo después de Fable 5" es una apuesta grande, siendo Fable 5 el modelo Claude de gama alta actual. El problema es que no hay nada detrás todavía: ni gráfico de referencia, ni puntuación de índice independiente, ni ficha técnica. Como contexto, el buque insignia anterior, Qwen3.7-Max, se lanzó en mayo de 2026 con cifras reales, 80,4% en SWE-bench Verified y el modelo chino mejor posicionado en el índice de inteligencia de Artificial Analysis en su momento. Qwen3.8-Max llegó con la confianza pero sin los comprobantes.
También hay un patrón que vale la pena señalar, con cuidado. Qwen tiene un largo historial de encabezar las tablas de descargas de modelos abiertos y de publicar buenos resultados de referencia, y una crítica recurrente es que puede parecer más fuerte en las evaluaciones que en el uso real y desordenado. Así que una afirmación autoproclamada de "top dos" antes de cualquier prueba independiente es exactamente el tipo de afirmación que hay que tomar con cautela.
Cuánto cuesta Qwen3.8-Max
Esta es la parte que realmente hizo clic entre los desarrolladores. Durante la vista previa, Qwen3.8-Max se vende al 10% del precio estándar a través de tres vías: la suscripción Token Plan de Alibaba, y sus productos de codificación agéntica Qoder y QoderWork. Todavía no hay una tarifa de API por token independiente publicada, lo cual es inusual para un modelo Max.
Los niveles Personal del Token Plan se ven así:
| Nivel | Mensual | Cuota de créditos cada 7 días | Cuota de créditos cada 5 horas |
|---|---|---|---|
| Lite | ~6 $ (39 CNY) | 2.500 créditos | 700 créditos |
| Standard | ~20 $ (139 CNY) | 10.000 créditos | 3.000 créditos |
| Pro | ~70 $ (499 CNY) | 40.000 créditos | 12.000 créditos |
Fuente: Alibaba Cloud Token Plan (edición Personal). Además de la tarifa de vista previa del 10%, Alibaba añade un descuento nocturno, un 80% extra de descuento en el consumo de créditos entre las 22:00 y las 08:00 (UTC+8), lo que se traduce en aproximadamente un 0,2% de la tarifa estándar para las ejecuciones fuera de horario. Eso es agresivo, y está claramente diseñado para que la gente pruebe la vista previa a bajo coste.
El modelo de créditos por suscripción es también exactamente lo que los usuarios de Qwen han criticado antes. En la generación anterior, usuarios de Reddit informaron que los créditos se agotaban mucho más rápido de lo esperado, y los modelos de Qwen tienden a generar más tokens de salida por tarea que sus competidores, lo que infla silenciosamente el coste real aunque el precio de etiqueta parezca bajo. El descuento de vista previa disimula eso por ahora. Cuando termine, prevé el gasto.
Un detalle útil: el endpoint del Token Plan habla tanto el protocolo de API de OpenAI como el de Anthropic, así que clientes externos como Claude Code, Cursor, Cline y Codex funcionan de inmediato en cuanto emites una clave. Si ya vives en una de esas herramientas, probar la vista previa es cosa de cinco minutos.
¿Deberías subirte a Qwen3.8-Max ahora mismo?
La vista previa es barata y fácil de probar, lo que convierte "¿debería cambiarme a esto?" en la pregunta equivocada y "¿qué estoy probando realmente?" en la correcta. Recorre la decisión de abajo antes de reconstruir nada importante alrededor de una vista previa.
El panorama más amplio: una carrera de pesos abiertos entre laboratorios chinos
Si quitamos los detalles, esta es la razón por la que Qwen3.8-Max se volvió tendencia: llegó días después del modelo de 2,8 billones de parámetros Kimi K3 de Moonshot AI, y Alibaba posee aproximadamente un 36% de participación en Moonshot. Así que dos laboratorios de la misma órbita están ahora compitiendo por fijar el techo de tamaño de los modelos casi de vanguardia, y ambos prometen pesos abiertos. En Hacker News, el comentario más votado interpretó el momento exactamente así:
"I assume that this announcement has been prompted by that of Moonshot AI... I wonder if Alibaba has always planned to make this big LLM open weights, or they have chosen to do this now, to better compete with Moonshot AI."

La lectura a la que llegó mucha gente es que comoditizar la inteligencia de vanguardia es en sí misma la estrategia, y que es bueno para todos río abajo sin importar el motivo:
"The Chinese firms seem to be working hard to commoditize intelligence which may be the most effective way to debase American frontier labs. And yeah: it also happens to be really good for humanity."
Para un comprador, la conclusión no es qué laboratorio gana. Es que la capa del modelo se vuelve más barata y mejor cada pocas semanas, y la jugada inteligente es construir de manera que puedas cambiar el motor sin tener que rehacer toda la fontanería a su alrededor.
Dónde termina un modelo de vanguardia y empieza el trabajo de soporte
Ahora la parte que más me importa, porque me dedico a construir agentes de IA. Es tentador leer un lanzamiento así y pensar "genial, conecto el mejor modelo y mi cola de soporte se resuelve sola". No funciona así, y esa brecha es exactamente donde la mayoría de los proyectos de soporte con IA fracasan en silencio.
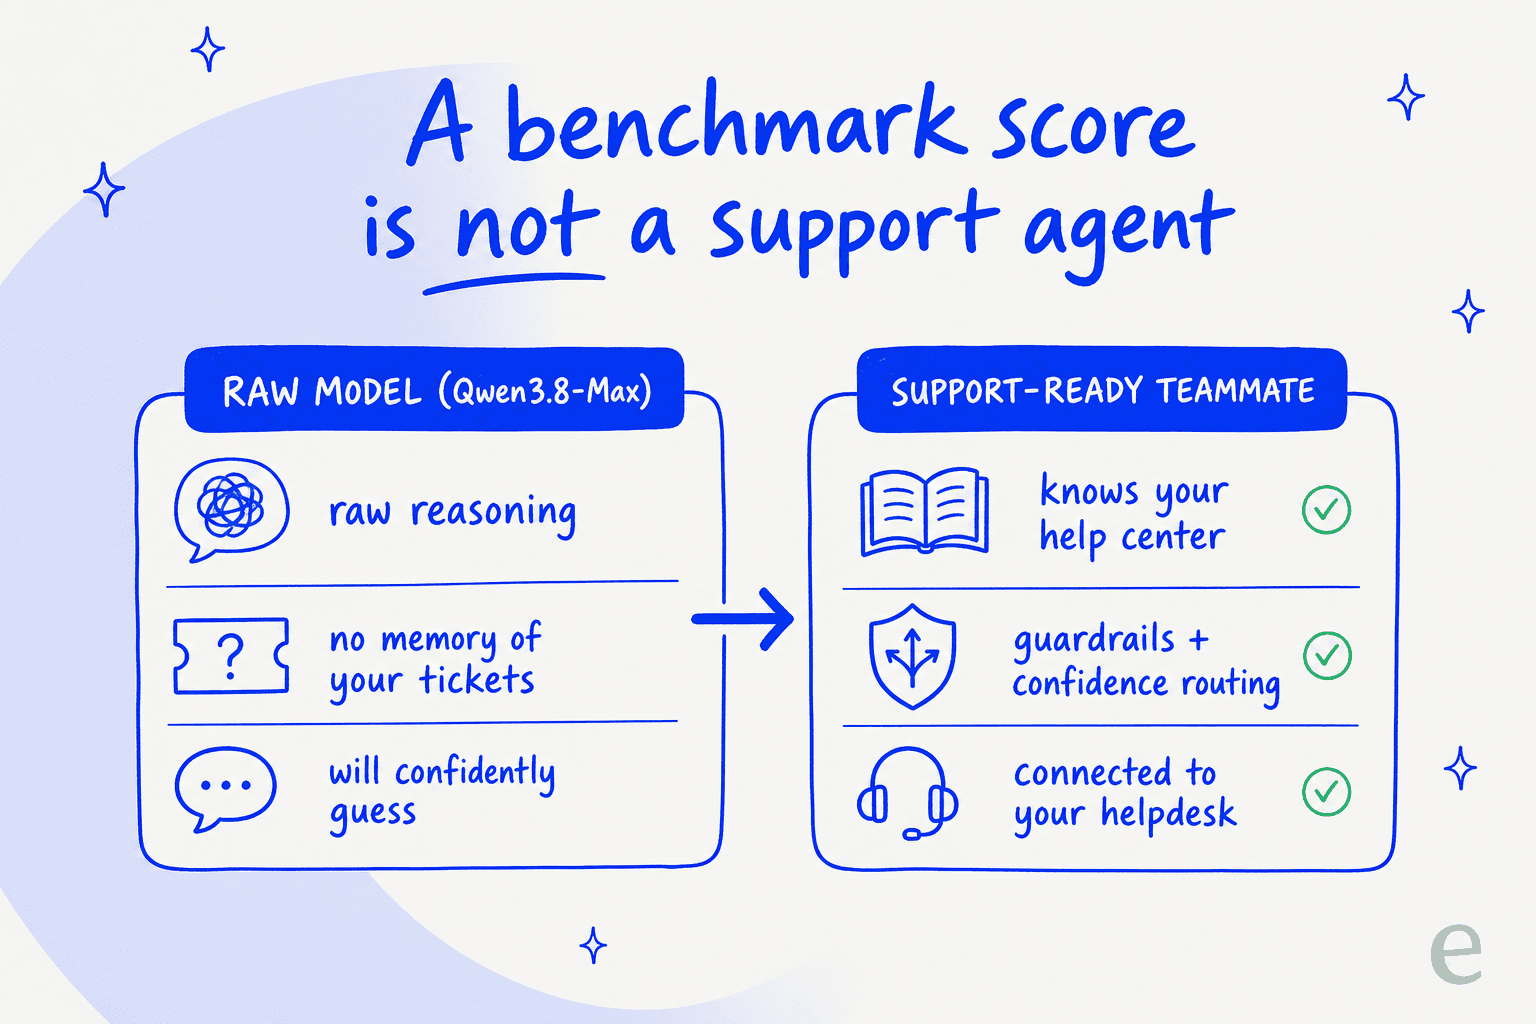
Un modelo como Qwen3.8-Max te da razonamiento en bruto. Lo que no te da es ninguna idea de tu política de reembolsos, tus casos límite de producto, o el hecho de que el ticket #4021 es un cliente VIP que ya ha escrito dos veces. No tiene memoria de tus tickets pasados, ni una barrera de seguridad que impida que invente una respuesta con total confianza, ni conexión con el helpdesk donde realmente ocurre el trabajo. Un recuento de parámetros mayor no arregla nada de eso.
Llevamos años poniendo IA en colas de soporte en producción, y la lección que se nos quedó grabada es que un modelo que suena seguro dando una respuesta equivocada es peor que ninguna respuesta. El bot de un cliente de pago confirmó alegremente que admitía modelos de producto que ni siquiera estaban en su base de datos, porque el centro de ayuda decía "admitimos todos los modelos". Ese es el fallo que un modelo en bruto de vista previa hace más probable, no menos, precisamente porque suena tan seguro de sí mismo. Como me dijo un responsable de soporte:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers wrong, I cannot go check all my 7,000 tickets to see if it made a good answer. I need an AI that only handles the tickets it's confident about, and leaves the rest alone."
a DTC brand CX lead handling 7,000 tickets a month
Por eso eesel AI ejecuta una simulación sobre tu historial de tickets antes de que nada se ponga en marcha, para que veas la tasa de resolución y las respuestas exactas sobre conversaciones pasadas reales primero, no después de que un cliente salga perjudicado. También por eso las respuestas se enrutan por nivel de confianza: si el agente no está seguro, redacta un borrador para un humano o escala en vez de adivinar. Haciéndolo así, Gridwise alcanzó un 73% de resolución de tickets de nivel 1 en su primer mes.
Y podrías conectar tú mismo un modelo como Qwen3.8-Max a tu stack. La mayoría de los equipos descubre que el mantenimiento es el coste real, que es la decisión de construir frente a comprar que un cliente resumió muy bien: "Podríamos intentar escribir nuestra propia aplicación de LLM, pero no queríamos invertir nuestro tiempo en eso. Queríamos algo que no tuviéramos que mantener." El modelo subyacente importa mucho menos que ese envoltorio, que es la buena noticia silenciosa sobre Qwen3.8-Max, Kimi K3, o lo que gane el próximo mes: una IA para atención al cliente bien construida hereda cada avance de vanguardia sin que tengas que rehacer nada.
Prueba eesel AI
Si llegaste hasta aquí porque quieres un modelo de IA que realmente resuelva tickets y no solo charle, ese es todo el sentido de eesel AI. Se conecta con Zendesk, Freshdesk, Slack y más de 100 herramientas adicionales, aprende de tu centro de ayuda y tickets pasados, y empieza a redactar o resolver en minutos, no semanas.

El diferenciador es la rampa de confianza: simula sobre tu historial real de tickets, ve las cifras, empieza en modo borrador, y pasa a totalmente autónomo solo cuando estés satisfecho. Obtienes la inteligencia del modelo de vanguardia con barreras de seguridad hechas para soporte. Prueba eesel gratis, sin tarjeta de crédito.