

En móviles, nada publicado lo supera. Un 92,2 % en MobileWorld-Real, un benchmark de 400 tareas ejecutado en dispositivos Android físicos, por delante de Seed 2.1 Pro, Gemini 3.1 Pro, GPT-5.6 Sol y Claude Opus 4.8. Ese es Qwen-UI-Agent, el nuevo agente GUI de base de Alibaba. Aun así, la ingeniería que hay debajo es a lo que más volví. Un espacio de acciones que mezcla clics en pantalla con comandos Bash. Acciones por lotes, de modo que ocurren varias cosas por turno del modelo. Y aprendizaje por refuerzo en línea sobre trayectorias de más de 100 pasos.
Luego está la cifra de escritorio, que nadie cita. En OSWorld-v2, el conjunto de uso de ordenador de horizonte largo, Qwen-UI-Agent obtiene un 40,0 % de progreso parcial frente a un 54,8 % de Claude Opus 4.8. O sea: un agente de móvil, competitivo en escritorio. No un controlador de pantalla general que casualmente es bueno en móviles. Conviene saberlo antes de leer "estado del arte" y asumir que significa en todas partes.
Lo que decide si algo de esto te importa: no puedes ejecutarlo. Sin pesos en Hugging Face. Sin endpoint alojado, y tampoco precios. Construyo agentes de IA que actúan dentro de colas de soporte reales en eesel, y tras más de tres años poniendo agentes en tickets en vivo, la lección que me queda es que una puntuación te dice un techo y nada sobre un suelo. Lo que de verdad hace que un agente pase el filtro de un responsable de soporte es demostrarlo con su propio historial antes de que toque a un cliente, por eso cada despliegue de eesel empieza como una simulación sobre tickets pasados en lugar de un lanzamiento.
Qué es realmente Qwen-UI-Agent
Qwen-UI-Agent es un único modelo que maneja software como lo haría una persona: mirando la pantalla y haciendo clic en ella. Salió del equipo MAI-UI dentro del laboratorio Tongyi de Alibaba y es el sucesor directo de MAI-UI 1.0, que lanzó checkpoints de 8B y 2B en diciembre de 2025. Si quieres primero el panorama más amplio de Alibaba, nuestra visión general de Qwen y nuestra reseña de Qwen cubren la familia de modelos.
El artículo apareció en arXiv el 30 de julio de 2026 y casi de inmediato fue el artículo número uno del día en Hugging Face, donde ahora suma 308 votos positivos. El sitio del proyecto lo presenta como un agente que "piensa, busca y actúa en móvil, escritorio y web".
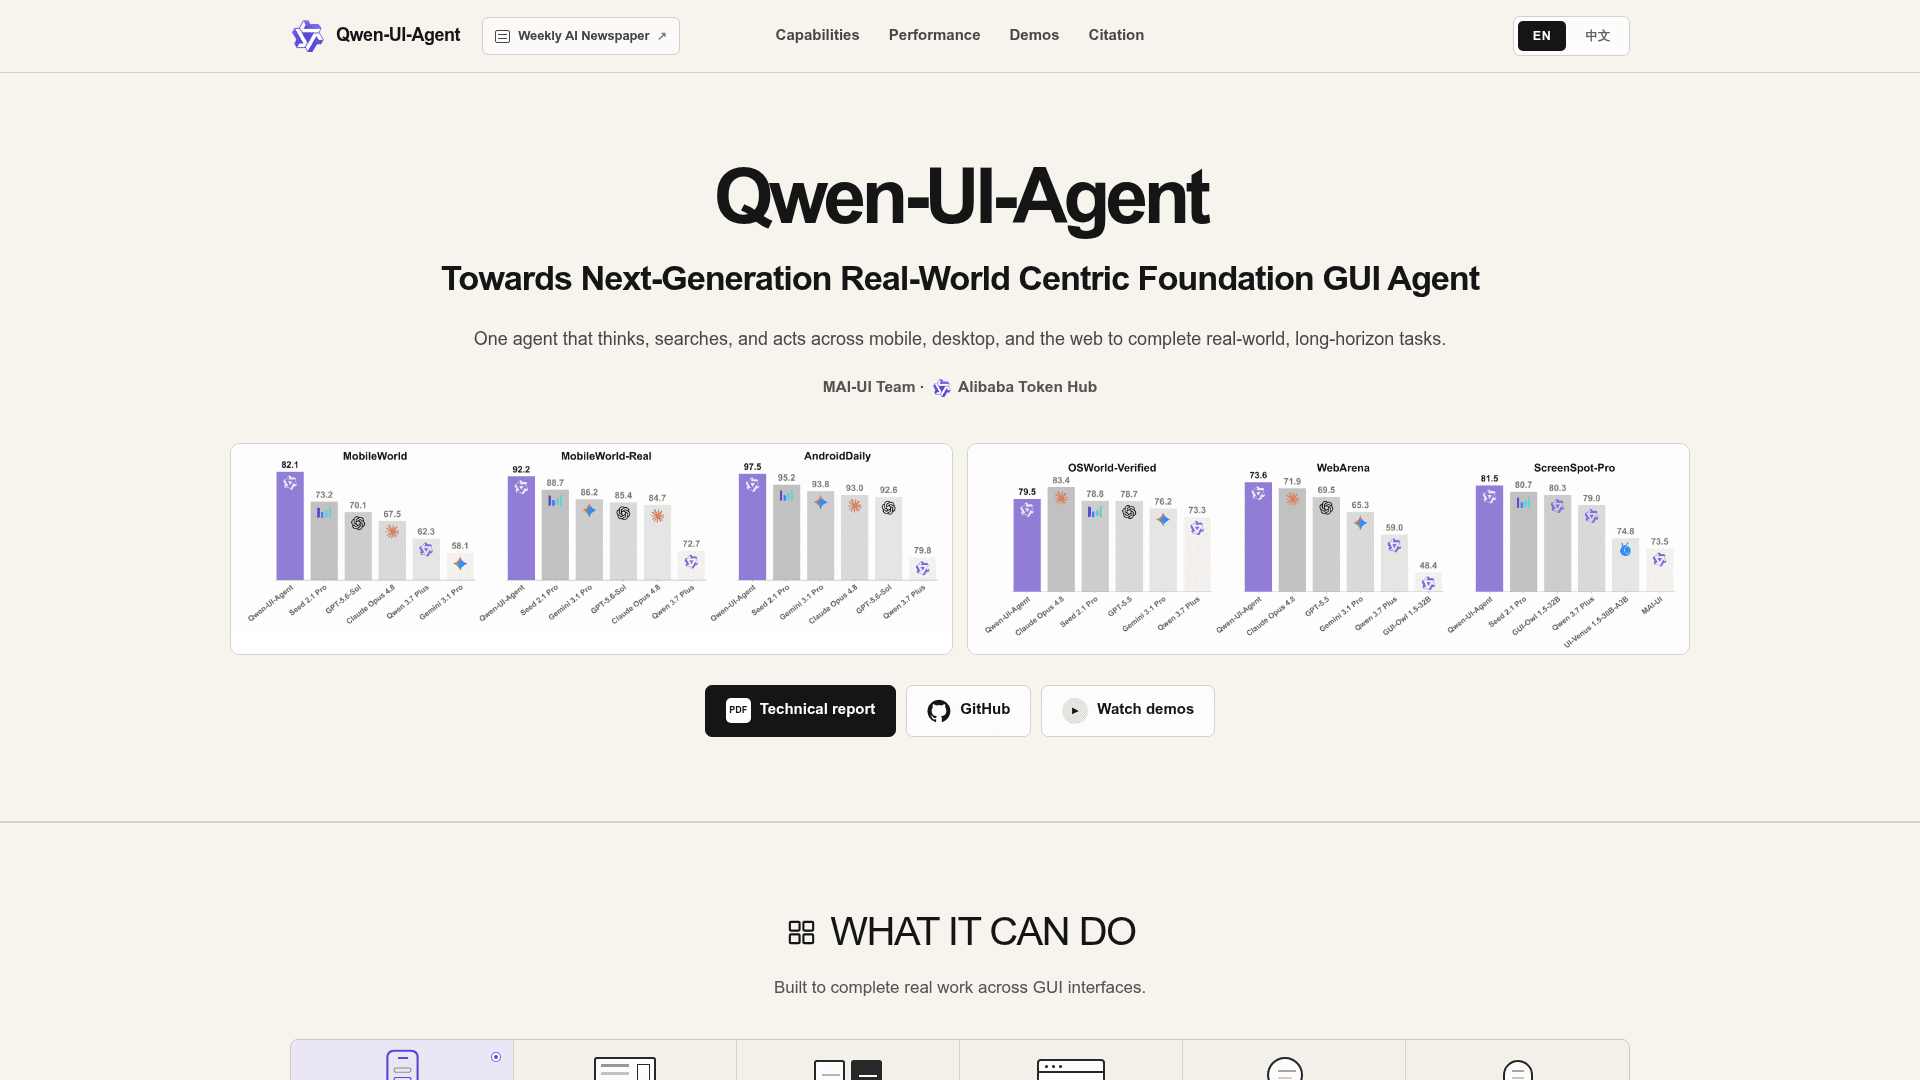
Fíjate en los tres botones bajo los gráficos. Informe técnico, GitHub, ver demos. Esa es toda la superficie de distribución ahora mismo, y volveré sobre ello.
Cuatro escenarios viven dentro del único modelo. Uso de GUI móvil y uso de ordenador, más uso de navegador y luego lo que Alibaba llama DeepSearch. Este último es el comportamiento de investigación profunda y no está añadido a posteriori. El agente puede salir de una app, ir a verificar algo en la web abierta y volver a la app para actuar según lo que encontró. Una de las demos publicadas lo muestra sacando afirmaciones de un vídeo social, contrastándolas con artículos de investigación y volviendo a escribir un comentario que nombra el problema concreto.
Si la categoría en sí es nueva para ti, nuestros artículos sobre agentes de IA y sobre agentes frente a chatbots cubren el terreno más rápido que el artículo científico. Para el extremo de licencias permisivas del sector, también tenemos nuestro resumen de agentes de IA de código abierto.
Cómo funciona por dentro
Esta es la parte que me resulta más interesante como alguien que construye agentes para ganarse la vida, porque tres de las decisiones de diseño no son obvias, y las tres apuntan al mismo modo de fallo.
GUI y CLI en un solo espacio de acciones
La mayoría de los agentes de pantalla solo pueden hacer clic. Qwen-UI-Agent puede hacer clic o ejecutar un comando Bash, y elige entre ambos dentro de un único espacio de acciones unificado. El propio informe de Alibaba sobre tareas de uso de ordenador dice que los comandos CLI y los clics GUI emergen como los dos tipos de acción dominantes, que es una forma educada de decir que el modelo descubrió que algunos trabajos salen mucho más baratos con un comando de shell que con treinta clics.
Cualquiera que haya visto a un agente de navegador intentar renombrar cuarenta archivos arrastrándolos entenderá de inmediato por qué esto importa.
Acciones por lotes
En lugar de emitir una acción, esperar una captura de pantalla y volver a pensar, el modelo emite varias acciones dentro de una única decisión. Alibaba reporta que alrededor del 40 % de las salidas de acción van por lotes en tareas de uso de ordenador.
La implicación de coste es real. Cada turno en un agente de pantalla significa una captura nueva entrando en el contexto, y las capturas son tokens caros. Reducir a la mitad el número de turnos en una tarea larga es la diferencia entre un flujo viable y uno que se come el presupuesto en silencio, que es la misma aritmética detrás del coste de los agentes de IA a escala.
Entrenado en teléfonos reales, no solo en simuladores
Esta es la afirmación principal, y también la que más querría verificar si pudiera. Alibaba dice que construyó un entorno móvil en vivo de más de 100 teléfonos físicos que cubren más de 150 apps, y lo usó para construir tareas, recopilar trayectorias, entrenar y evaluar. También construyó su propio benchmark sobre esa flota, MobileWorld-Real, con más de 400 tareas en más de 100 apps.
El propósito declarado es cerrar la brecha entre simulación y realidad, y el diseño ataca justo lo que hace engañosas las puntuaciones de simulador. Las apps reales tienen indicadores de carga, diseños con pruebas A/B, sesiones caducadas y fallos de red que una sandbox nunca reproduce.
El entrenamiento ejecuta después aprendizaje por refuerzo en línea sobre trayectorias de más de 100 pasos, con unos 10.000 entornos desplegándose a la vez. Lo que lo alimenta es un volante de datos al estilo AutoResearch, donde los agentes construyen las tareas, los entornos y los verificadores, diagnostican sus propios fallos y luego planifican la siguiente iteración.
Un harness para trabajo proactivo
La última pieza es una capa de harness ligera que permite al agente empezar a trabajar a partir de una señal del mundo real en lugar de un prompt. La demo de Alibaba es una notificación de vuelo cancelado. El agente la nota, abre apps de viaje en vivo, compara vuelos y trenes con la reunión de las 14:00 del usuario y vuelve con opciones ordenadas. No reserva, algo que vale la pena señalar. Presenta una decisión y se detiene.
Esa contención es el instinto correcto, y es el mismo que hay detrás de las buenas prácticas de traspaso de agentes de IA en soporte. Google tomó el camino opuesto con Chrome auto-browse, que actúa dentro del navegador en lugar de preguntar primero.
Los resultados de los benchmarks, leídos con honestidad
Aquí la historia se divide en dos.
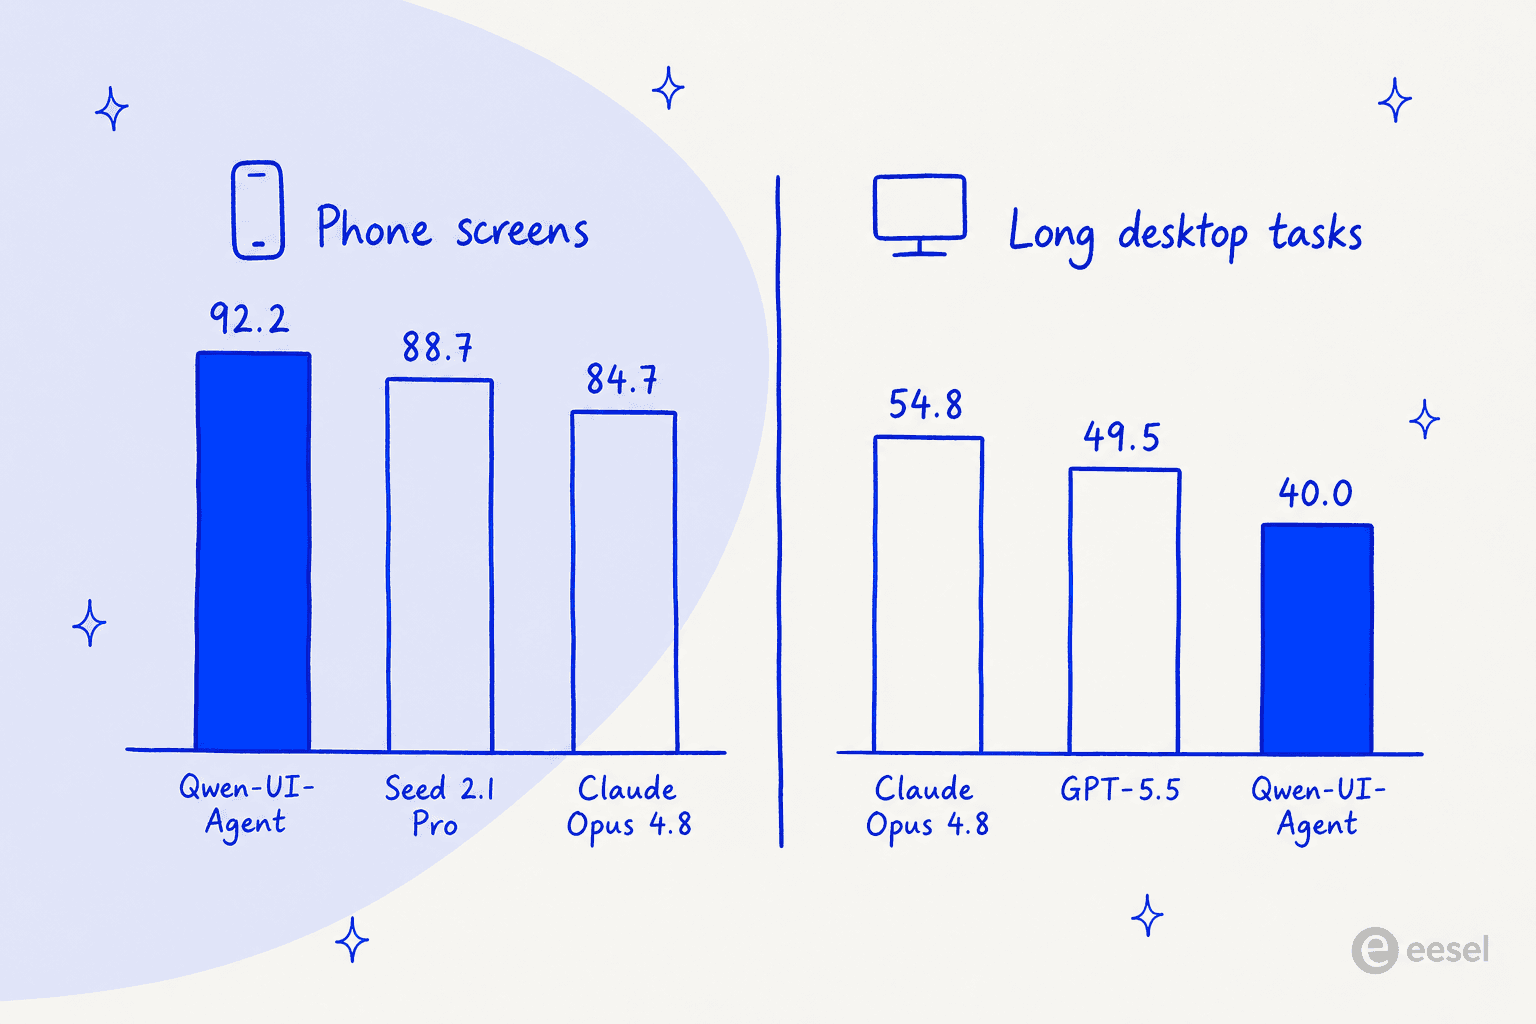
En móviles gana, con claridad
| Benchmark móvil | Qwen-UI-Agent | Seed 2.1 Pro | Gemini 3.1 Pro | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| MobileWorld | 82.1 | 73.2 | 58.1 | 70.1 | 67.5 |
| MobileWorld-Real | 92.2 | 88.7 | 86.2 | 85.4 | 84.7 |
| AndroidDaily | 97.5 | 95.2 | 93.8 | 92.6 | 93.0 |
El margen en MobileWorld es el que más me llama la atención. Casi nueve puntos por delante del siguiente modelo, y más de 14 puntos por delante de GPT-5.6 Sol, en un benchmark donde las tareas implican intercambios interactivos entre agente y usuario en lugar de ejecución a ciegas. No son diferencias de redondeo.
En escritorio es competitivo, y luego no
| Benchmark de ordenador y navegador | Qwen-UI-Agent | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| OSWorld-Verified | 79.5 | 83.4 | 78.7 | 76.2 |
| OSWorld-v2 (progreso parcial) | 40.0 | 54.8 | 49.5 | no reportado |
| WebArena | 73.6 | 71.9 | 69.5 | 65.3 |
OSWorld-Verified es un casi. Cuatro puntos por detrás de Claude Opus 4.8, pero aún por delante de GPT-5.5 y de Gemini 3.1 Pro. WebArena lo gana de forma clara. Luego OSWorld-v2, el conjunto de horizonte largo, abre una brecha de 14,8 puntos frente a Opus 4.8.
El patrón encaja con lo que cuenta el entrenamiento móvil. Las tareas de móvil son cortas, acotadas y muy practicadas dentro de esa flota de dispositivos reales. Los flujos largos de escritorio son donde los modelos se desvían, y la deriva es lo más difícil de entrenar para eliminar. El propio resumen de Alibaba usa la palabra "competitivo" para uso de ordenador y "estado del arte" solo para móvil. Es una descripción justa, que la mayor parte de la cobertura aplana en una sola afirmación.
En grounding arrasa
El grounding es la habilidad aburrida que decide si algo de lo anterior funciona de verdad. ¿Puede el modelo poner el cursor en el píxel correcto? Qwen-UI-Agent lidera todos los benchmarks de grounding del informe: 81,5 % en ScreenSpot-Pro con zoom, 76,6 % sin zoom, 97,5 % en SS-V2, 70,0 % en UI-Vision.
La cifra sin zoom es la honesta aquí. El zoom es un truco de harness que recorta y vuelve a examinar la pantalla, así que un modelo que solo gana con él se apoya en andamiaje. Ganar sin él significa que la percepción en sí es real.
¿Y el modelo general de debajo?
Alibaba también reporta que el entrenamiento GUI no lobotomizó el modelo base, y publica una comparación con Qwen3.5-27B para probarlo.
| Benchmark general | Qwen-UI-Agent | Qwen3.5-27B |
|---|---|---|
| MMLU-Pro | 86.5 | 86.0 |
| MMMU-Pro | 72.4 | 73.5 |
| MathVision | 82.8 | 82.0 |
| IFEval (strict) | 90.2 | 90.4 |
| Tau2-Bench | 89.9 | 89.2 |
| Terminal-Bench 2.0 | 50.1 | 41.1 |
| BrowseComp-ZH | 75.0 | 62.1 |
Que Terminal-Bench suba nueve puntos y BrowseComp-ZH trece es lo que cabría esperar de un modelo al que se enseñó a usar un shell y a buscar. La pequeña caída en MMMU-Pro y en IFEval es el impuesto por ello, y es un impuesto pequeño. Una fila va en la otra dirección: QwenClawBench baja de 48,5 a 44,2, algo que el informe publica en lugar de ocultar.
Lo que los números no dicen
Tres salvedades. En honor a Alibaba, dos de ellas vienen de la propia Alibaba.
Cada puntuación se reprodujo en el entorno propio de los autores. La nota de evaluación del sitio del proyecto lo dice directamente y añade que algunos ajustes de harness, juez, simulador, runtime o subconjunto de tareas difieren de las evaluaciones oficiales. Varias de las filas de competidores llevan una daga que las marca como reproducidas por los autores en lugar de copiadas del informe del propio proveedor. Es más transparencia de la que la mayoría de lanzamientos de modelos se molesta en dar, y también significa que no son las mismas condiciones bajo las que publicaron los proveedores.
Las demos se construyen sobre el ecosistema de apps chino. Douyin, Hema, Trip.com, Amap, Dianping, Xiaohongshu, 12306, DingTalk, Beike. La ingeniería generaliza. El 92,2 % concreto no se traslada automáticamente a una flota de teléfonos con Slack, Shopify y Gmail. Si tus flujos son de SaaS occidental, trata esa cifra móvil como una señal fuerte sobre el método y no como una promesa sobre tus propias apps.
El repositorio del sitio delata el estado del lanzamiento. El repositorio del propio sitio del proyecto aún lleva una instrucción de edición para reemplazar las tarjetas de recursos "próximamente" por las URL finales del informe, el código y los checkpoints en el momento del lanzamiento, y una nota de que las cifras de resultados que entran en conflicto en el borrador se omiten deliberadamente hasta que los valores estén congelados. Es un proyecto aún en marcha, no un producto lanzado.
¿Puedes ejecutarlo hoy?
No. Y esta es la sección que yo leería primero si fuera tú.
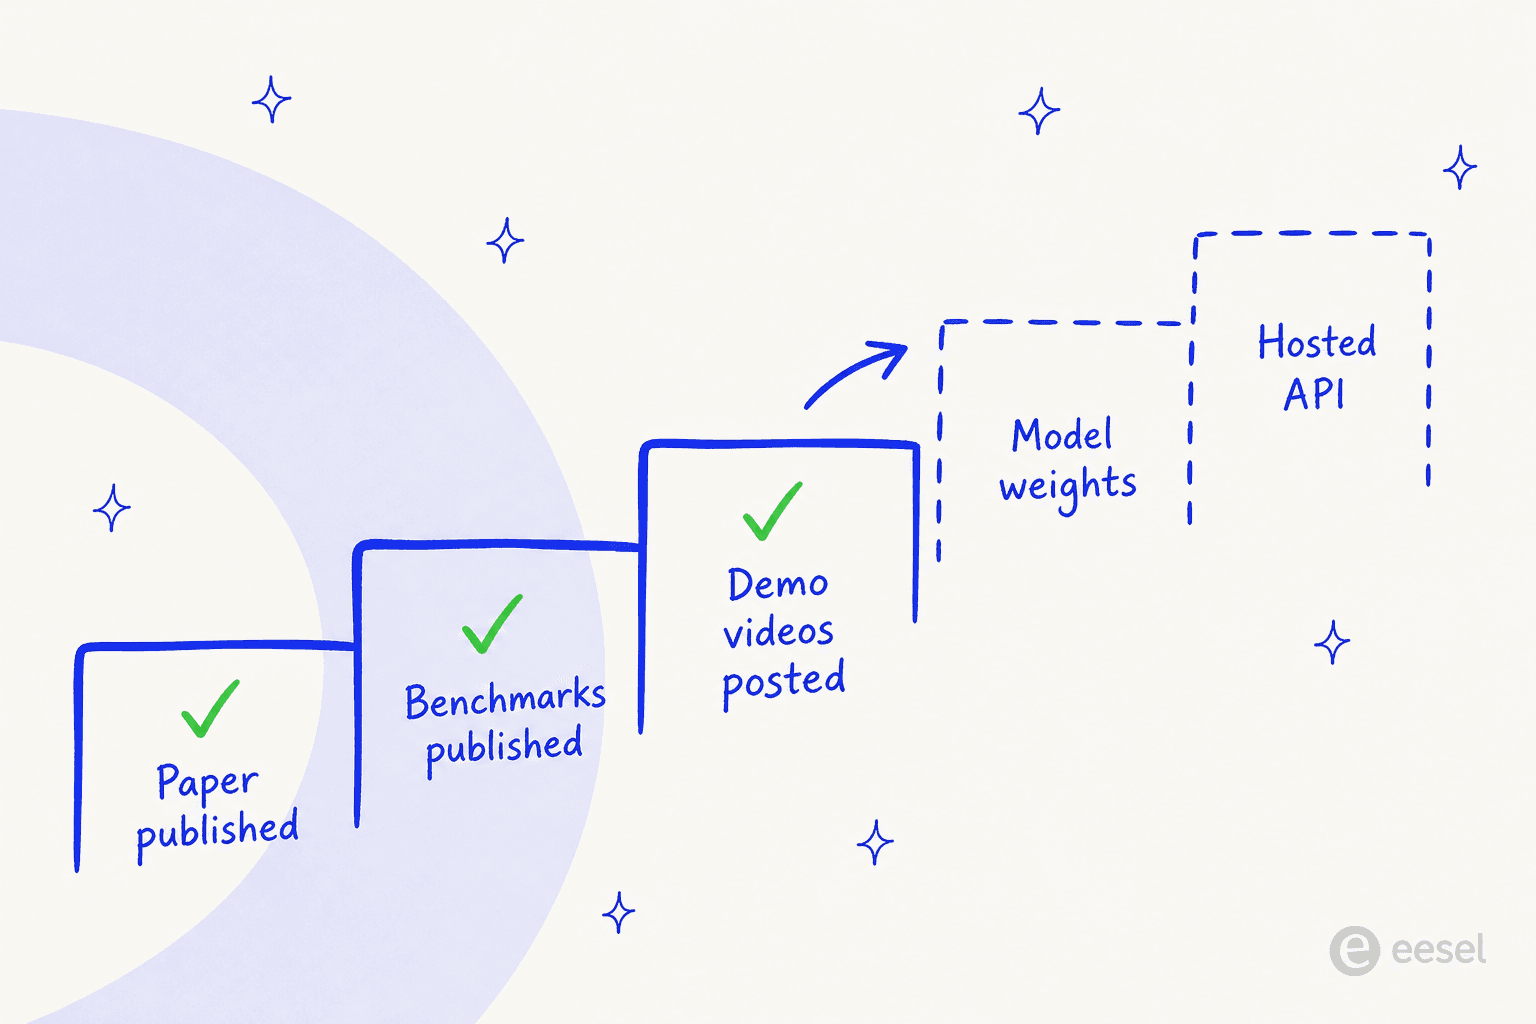
Esto es lo que comprobé, el 24 de agosto de 2026:
- La organización Tongyi-MAI en Hugging Face lista cuatro modelos: Z-Image, Z-Image-Turbo, MAI-UI-8B y MAI-UI-2B. Ningún Qwen-UI-Agent.
- La página del artículo reporta cero modelos, cero datasets y cero Spaces vinculados.
- El repositorio de GitHub llamado Qwen-UI-Agent es solo código fuente del sitio web, y lo dice en negrita al principio de su readme.
- El repositorio de implementación, Tongyi-MAI/MAI-UI, tiene 2,2k estrellas y ningún release, ninguna etiqueta y ningún enlace a un checkpoint de este modelo.
- No hay ninguna entrada de Qwen-UI-Agent en el catálogo de modelos de Alibaba, así que no hay endpoint ni tarifa.
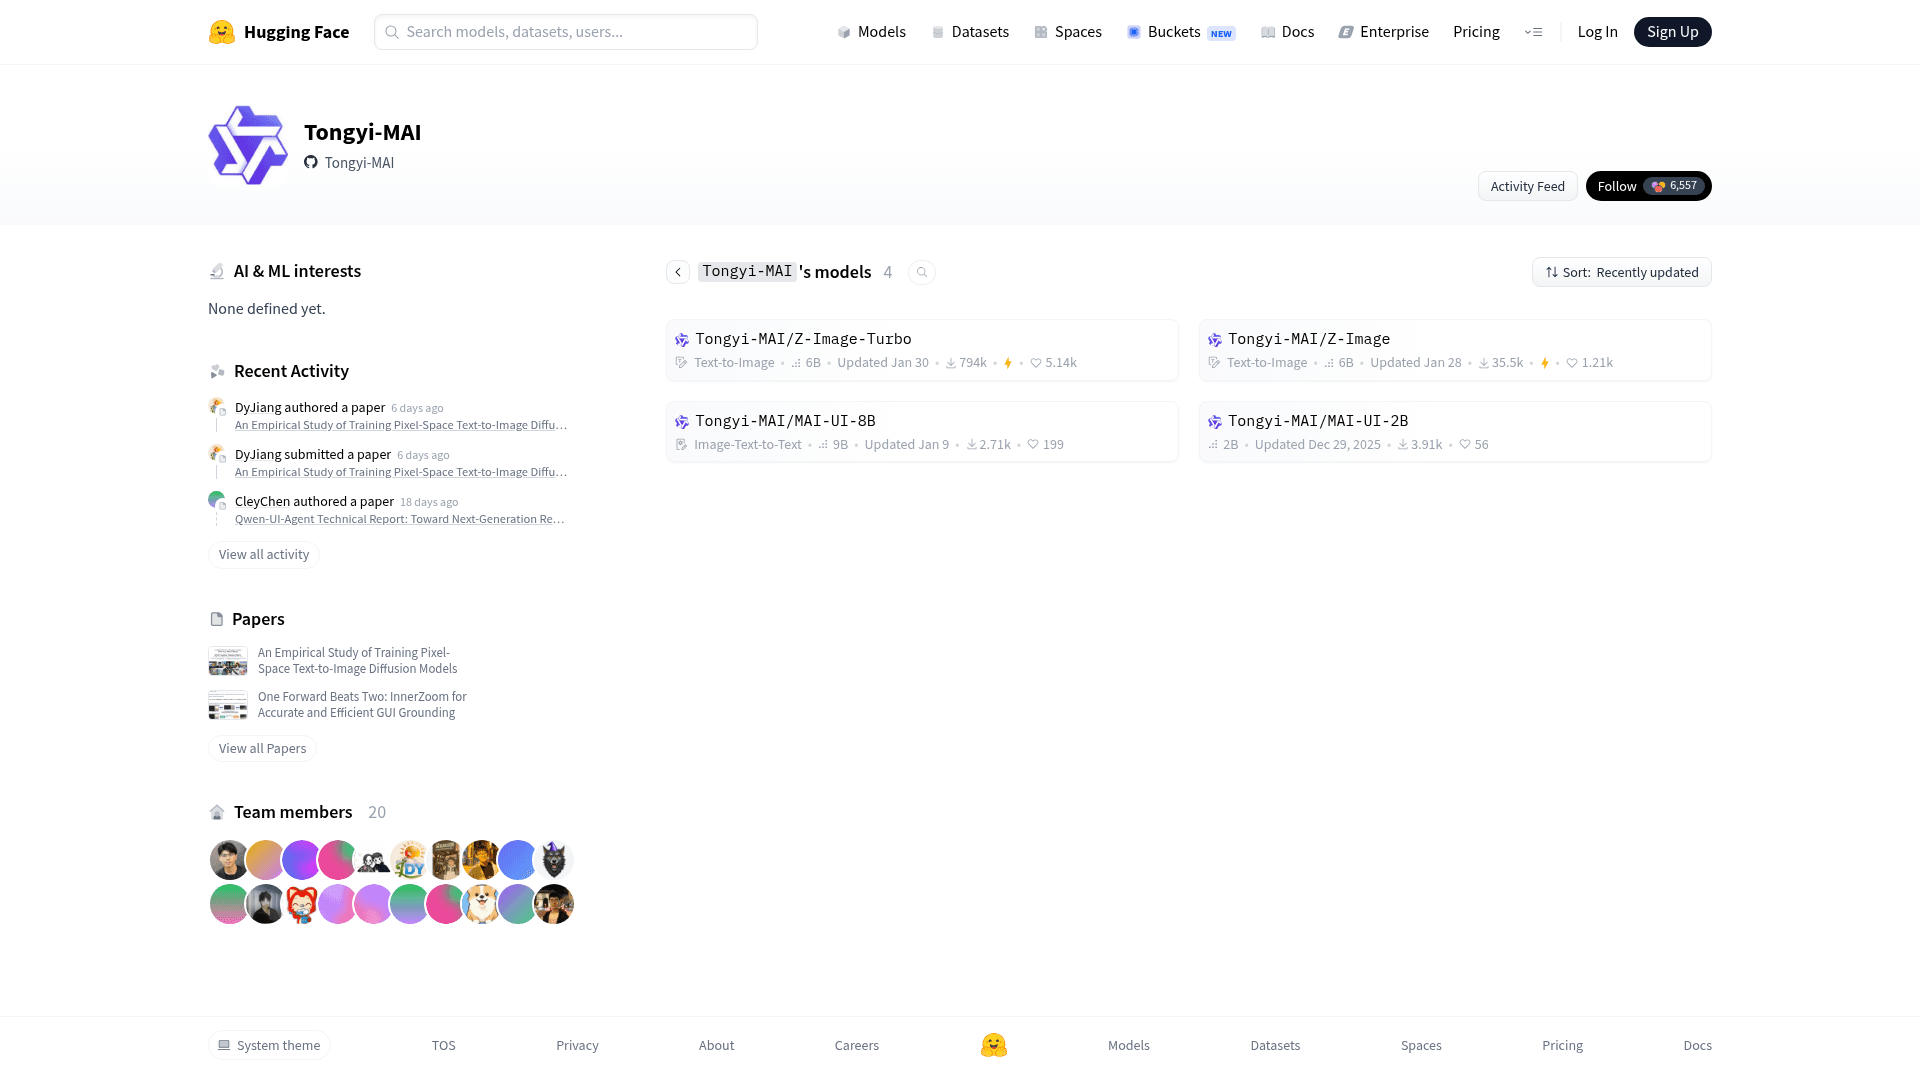
La única señal alentadora es el precedente. El mismo equipo lanzó MAI-UI 8B y 2B en diciembre de 2025, y el readme afirma que el proyecto tiene licencia Apache 2.0. Alibaba también ha publicado pesos de su línea insignia, como cubre nuestra reseña de Qwen 3.8 Max. Así que un lanzamiento abierto es bastante plausible. Simplemente no es algo sobre lo que puedas planificar un trimestre.
Si necesitas algo que se pueda llamar este mes, la lista corta práctica pasa por las alternativas a Qwen y Kimi K3. Para una opción abierta más barata, está DeepSeek V4 Flash.
Qué significa esto si gestionas una cola de soporte
Quiero ser cuidadoso en esta sección, porque "agente GUI obtiene 89,9 en un benchmark de soporte" es justo el tipo de titular que acaba dentro de una presentación para el consejo.
Tau2-Bench es un benchmark real, y 89,9 es una buena puntuación en él. Pero mira lo que mide frente a lo que un responsable de soporte realmente necesita. En las llamadas oigo los mismos requisitos una y otra vez. Entrénalo con nuestros propios tickets pasados. Pon una cita en cada respuesta. Y déjanos ver qué habría hecho, antes de que lo haga. Un agente que maneja la pantalla estructuralmente no puede darte la segunda ni la tercera. Hace clic. No hay un objeto de respuesta al que adjuntar una fuente, y tampoco hay modo de prueba en seco para un ratón, por eso la prevención de alucinaciones en soporte empieza por el alcance y no por la elección del modelo.
Un equipo de soporte de hardware con el que hablé, que gestiona unos 250 tickets al mes en Zendesk en varios idiomas, convirtió las citas en un requisito imprescindible antes de que nada saliera en vivo. Otro, una empresa de servicios de TI del sector público que pierde a dos agentes senior este año, quería la IA entrenada con sus propios tickets resueltos, precisamente para que el conocimiento de quienes se van no se fuera con ellos. Ninguno de los dos es un problema de pantalla. Ambos son problemas de recuperación y gobernanza, más cercanos a las preguntas de qué LLM conviene para soporte que a nada de este artículo, razón por la cual el mejor modelo de IA para tickets de soporte rara vez es el más grande.
El patrón que de verdad funciona es aburrido, y se cumple en casi todos los despliegues que he visto. Empezar en modo borrador, donde la IA escribe y un humano envía. Luego pasar a la automatización completa cuando los números se lo hayan ganado. Esa es la forma del trabajo de asistencia de agentes de IA, y por eso la contención y la calidad de las escaladas predicen mejor un despliegue exitoso que cualquier benchmark de esta página. El control de calidad de soporte es la otra mitad de ese ciclo.
Donde un agente GUI realmente se gana su lugar es en la larga cola de operaciones internas para las que nadie construyó nunca una API. Un panel de administración heredado. Un portal de proveedores o alguna herramienta interna de 2014. Eso es valor real, y también está infravalorado. Simplemente es un trabajo distinto de resolver tickets de clientes, igual que la automatización de flujos de trabajo es un trabajo distinto de la desviación de tickets.
Dónde encaja eesel
Si estás leyendo un artículo sobre agentes GUI porque lo que realmente quieres es una cola de helpdesk más pequeña, el atajo es saltarte por completo la capa de pantalla. eesel se conecta directamente a Zendesk, Freshdesk, Gorgias y el resto, aprende de tus propios tickets pasados y centro de ayuda en lugar de un rastreo público, y cita la fuente en cada respuesta que da. Se comporta menos como un controlador de pantalla y más como el planteamiento de compañeros de equipo de IA y empleado de IA que usamos para este trabajo.
Lo que más importa para esta comparación: puedes ejecutarlo en simulación sobre miles de tus tickets históricos y leer exactamente qué habría respondido, antes de que un solo cliente lo vea. Ese es el paso de "demuéstralo primero" que una puntuación de benchmark nunca puede sustituir, y lleva minutos en lugar de un ciclo de compras. Prueba gratuita.
Para quién es Qwen-UI-Agent
Vale la pena seguirlo de cerca si estás construyendo automatización móvil, haces QA contra dispositivos Android reales o investigas agentes GUI y quieres el método mejor documentado actualmente. El bucle de entrenamiento en dispositivos reales y el espacio de acciones GUI más CLI son las dos ideas con más probabilidad de aparecer en el próximo lanzamiento de todos los demás.
Vale la pena ignorarlo por ahora si necesitas algo en producción este trimestre. No hay nada que desplegar. Lee el artículo, anota la técnica y vuelve cuando aparezca un checkpoint. Mientras tanto, Qwen 3.7 Flash es el modelo de Alibaba que realmente puedes llamar.
Vale la pena ser escéptico si tus cargas de trabajo son flujos largos de escritorio. El 40,0 % en OSWorld-v2 es la cifra que debería guiar esa decisión, y no el 92,2 % en móviles. Para ese tipo de trabajo, Claude Opus 5 y sus predecesores siguen siendo la apuesta más segura, y nuestro artículo de alternativas a Opus 5 cubre el resto del campo.
No es la herramienta adecuada en absoluto si intentas automatizar la atención al cliente. No porque sea débil. Apunta a una superficie diferente, eso es todo. Lo que necesitan los equipos de soporte es algo que se conecte al helpdesk y aprenda de tu base de conocimiento y de los tickets resueltos.
A partir de ahí el trabajo es el enrutamiento, la clasificación de tickets y escaladas de soporte limpias cuando hace falta un humano. Manejar la pantalla no es el cuello de botella por ahí, y tratarlo como tal es como los equipos acaban con una demo impresionante y una cola sin cambios.
El veredicto
Qwen-UI-Agent es el artículo sobre agentes GUI más interesante del año y el producto menos utilizable de esta comparación. Ambas cosas son ciertas a la vez.
El resultado móvil es el verdadero titular y merece serlo: un 92,2 % en más de 400 tareas en una flota de teléfonos físicos, superando a cuatro modelos de frontera, no es un artefacto de benchmark. El método detrás, en particular la mezcla de comandos de shell en el flujo de clics y el agrupado de acciones por turno, es el tipo de idea que se copia.
El resultado de escritorio es la verdadera salvedad: un 40,0 % en uso de ordenador de horizonte largo frente a un 54,8 % de Claude Opus 4.8 es una brecha amplia, y el trabajo de escritorio de horizonte largo es de todos modos la mayor parte de lo que la gente entiende por "uso de ordenador" en un contexto empresarial.
Y la disponibilidad es el verdadero bloqueo. Apache 2.0 en un readme es una intención. Hasta que de verdad aparezca un checkpoint, esto es investigación de la que aprender, no software que comprar. Si la cola que tienes delante es una cola de soporte y no una pantalla, el mejor agente de IA no será el que haga clic más rápido. Será el que te dejaron probar con tus propios tickets antes de confiar en él.