

Gemini 4 Neon es el modelo de Google que usaría para trabajo agéntico difícil y documentos largos, ejecutado en high: Artificial Analysis lo puntúa con 59,6 por $3,74 por tarea, casi la mitad de los $7,76 de Carbon para la misma puntuación. No es la ruta más barata a esa puntuación. Astra de OpenAI llega a 60,1 por $2,07, y Neon escribe de cinco a seis veces más tokens por tarea. Su verdadera ventaja es la honestidad: acertó mal en 14% de las preguntas que no pudo responder, frente al 54% al 61% de Sol y Astra.
La CLI de eesel permite que un agente de código suba artículos de ayuda aprobados a un compañero de equipo de helpdesk de eesel y pruebe sus respuestas en tus propios tickets, que es como yo comprobaría cualquier modelo antes de que le responda a un cliente.
Cómo reseñé Gemini 4 Neon
Todavía no he hecho pasar a Neon por mi propia suite de pruebas, así que cada cifra de abajo viene de tres fuentes que pude comprobar el día del lanzamiento, el 19 de noviembre de 2026:
- Las propias páginas de Google: el post de lanzamiento, la ficha del modelo y la página de precios.
- Artificial Analysis: leí los resultados por ajuste de Neon, Carbon, Hydrogen, Sol, Astra y Opus 5.5 en sus páginas de modelo. Su índice es una suite de 9 evaluaciones, así que "tarea" más abajo significa una tarea de benchmark, no uno de tus tickets.
- El hilo de lanzamiento en Hacker News, que superó los 460 puntos el día en que abrió.
Intenté usar Reddit y X para la voz de los usuarios y no logré que ninguno cargara, así que las citas de la comunidad son todas de Hacker News. Si tu propia carga de trabajo se ve distinta a un benchmark, trata mi veredicto como una preselección, no como un resultado. La guía de Neon cubre el ID del modelo, el acceso y la migración, así que aquí lo mantengo breve.
Qué es Gemini 4 Neon, en un párrafo
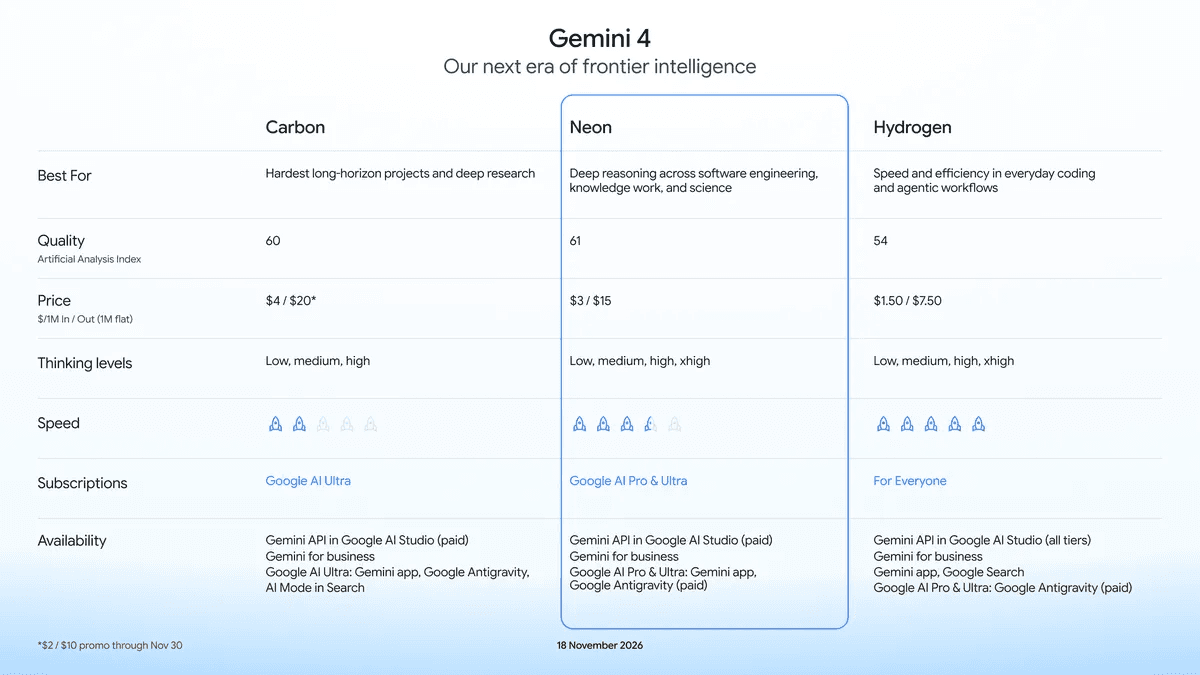
Neon es el modelo intermedio de la familia Gemini 4 de Google, lanzado el 18 de noviembre de 2026 como gemini-4-neon. Google dice que está adaptado de Carbon, comparte su ventana de 1.048.576 tokens y tiene cuatro niveles de razonamiento: low, medium, high (el predeterminado) y xhigh. Cuesta $3 por millón de tokens de entrada y $15 por millón de tokens de salida, sin nivel gratuito. Google lo llama el equilibrio entre "profundidad y eficiencia", y su propio gráfico lo coloca entre Hydrogen y Carbon:
¿Es bueno Gemini 4 Neon en lo difícil?
Sí, y la evidencia es más sólida que en la mayoría de las afirmaciones del día de lanzamiento porque la tabla de clasificación y la propia tabla de Google coinciden. Artificial Analysis pone a Neon en 61,4 en xhigh y 59,6 en high, por delante de Opus 5.5 con 59,1 y Sol con 57,3 (sus mejores ajustes). La tabla reportada por el propio proveedor muestra de dónde viene esa ventaja:
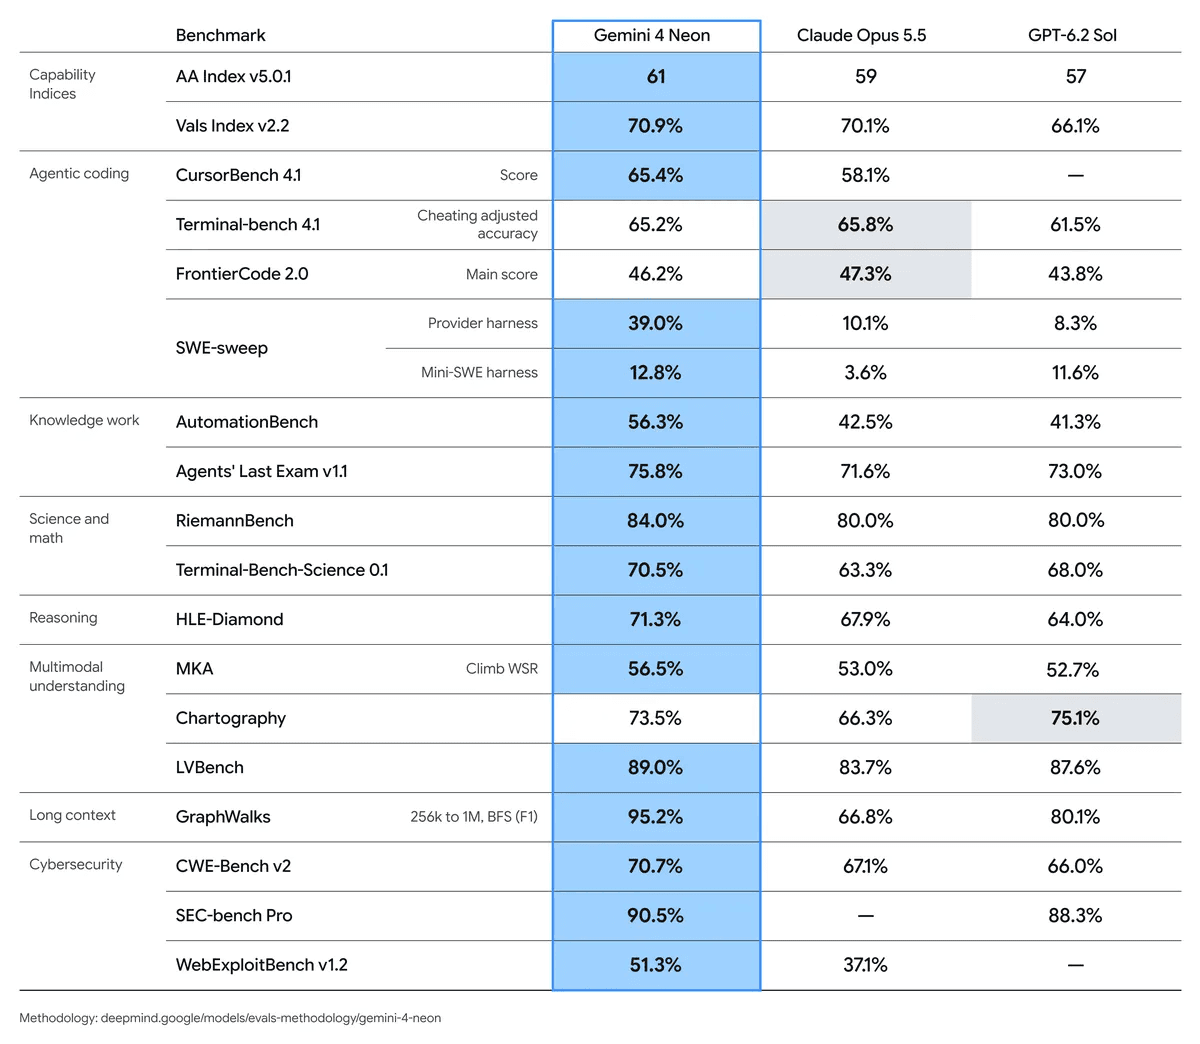
Leyendo las columnas en lugar de las celdas en negrita:
- Agentes de trabajo de conocimiento: AutomationBench
56.3%frente a42.5%de Opus 5.5 y41.3%de Sol. - Contexto largo: GraphWalks de 256k a 1M tokens,
95.2%frente a66.8%y80.1%. Si tu trabajo es "leer un documento muy largo y responder con precisión", esta es la fila que importa. - Codificación, mixto: Opus 5.5 va ligeramente adelante en Terminal-Bench 4.1 (
65.8%frente a65.2%) y FrontierCode 2.0 (47.3%frente a46.2%). La ventaja de Neon en SWE-sweep de39.0%usa el propio arnés de pruebas de Antigravity, así que no me apoyaría en ella.
Estas son cifras de Google, elegidas por Google. Las independientes son las filas de Artificial Analysis de abajo, y cuentan una historia más interesante que la puntuación destacada.
¿Cuánto cuesta Neon por tarea en cada ajuste?
El precio por token oculta la mayor parte de la factura, porque los tokens de razonamiento se facturan como salida. Aquí están los datos de Artificial Analysis por ajuste para Neon junto a sus hermanos, tal como los leí el 19 de noviembre:
| Ajuste | Puntuación de índice | Costo por tarea | Minutos por tarea | Tokens de salida por tarea |
|---|---|---|---|---|
| Neon low | 44,1 | $0,75 | 3,7 | 21.726 |
| Neon medium | 54,9 | $1,90 | 8,3 | 50.000 |
| Neon high (predeterminado) | 59,6 | $3,74 | 14,8 | 90.188 |
| Neon xhigh | 61,4 | $6,44 | 21,5 | 141.631 |
| Carbon high | 60,0 | $7,76 | 37,2 | 122.768 |
| Hydrogen xhigh | 53,9 | $3,16 | 15,2 | 154.406 |
| Opus 5.5 max | 59,1 | $10,04 | 24,5 | 173.313 |
| Astra high | 60,1 | $2,07 | 5,9 | 17.828 |
| Sol max | 57,3 | $1,01 | 8,5 | 40.360 |
Tres cosas destacan:
- Neon vence a Carbon en su propio terreno. En high igualá la puntuación de Carbon con medio punto de diferencia por un 52% menos de costo y un 60% menos de tiempo. Google afirma un 32% menos de costo por tarea frente a Carbon, así que según estos datos la diferencia real es mayor que la promesa.
- High es el punto óptimo. Pasar de medium a high compra 4,7 puntos de índice por $1,84 más. Pasar de high a xhigh compra 1,8 puntos por $2,70 más y 6,7 minutos adicionales.
- Astra es el problema. Con la misma puntuación, Astra cuesta $2,07 por tarea y termina en 5,9 minutos. El precio por token de Astra es más alto ($8 de entrada, $40 de salida), pero resulta un 45% más barato por tarea porque escribe 17.828 tokens frente a los 90.188 de Neon.
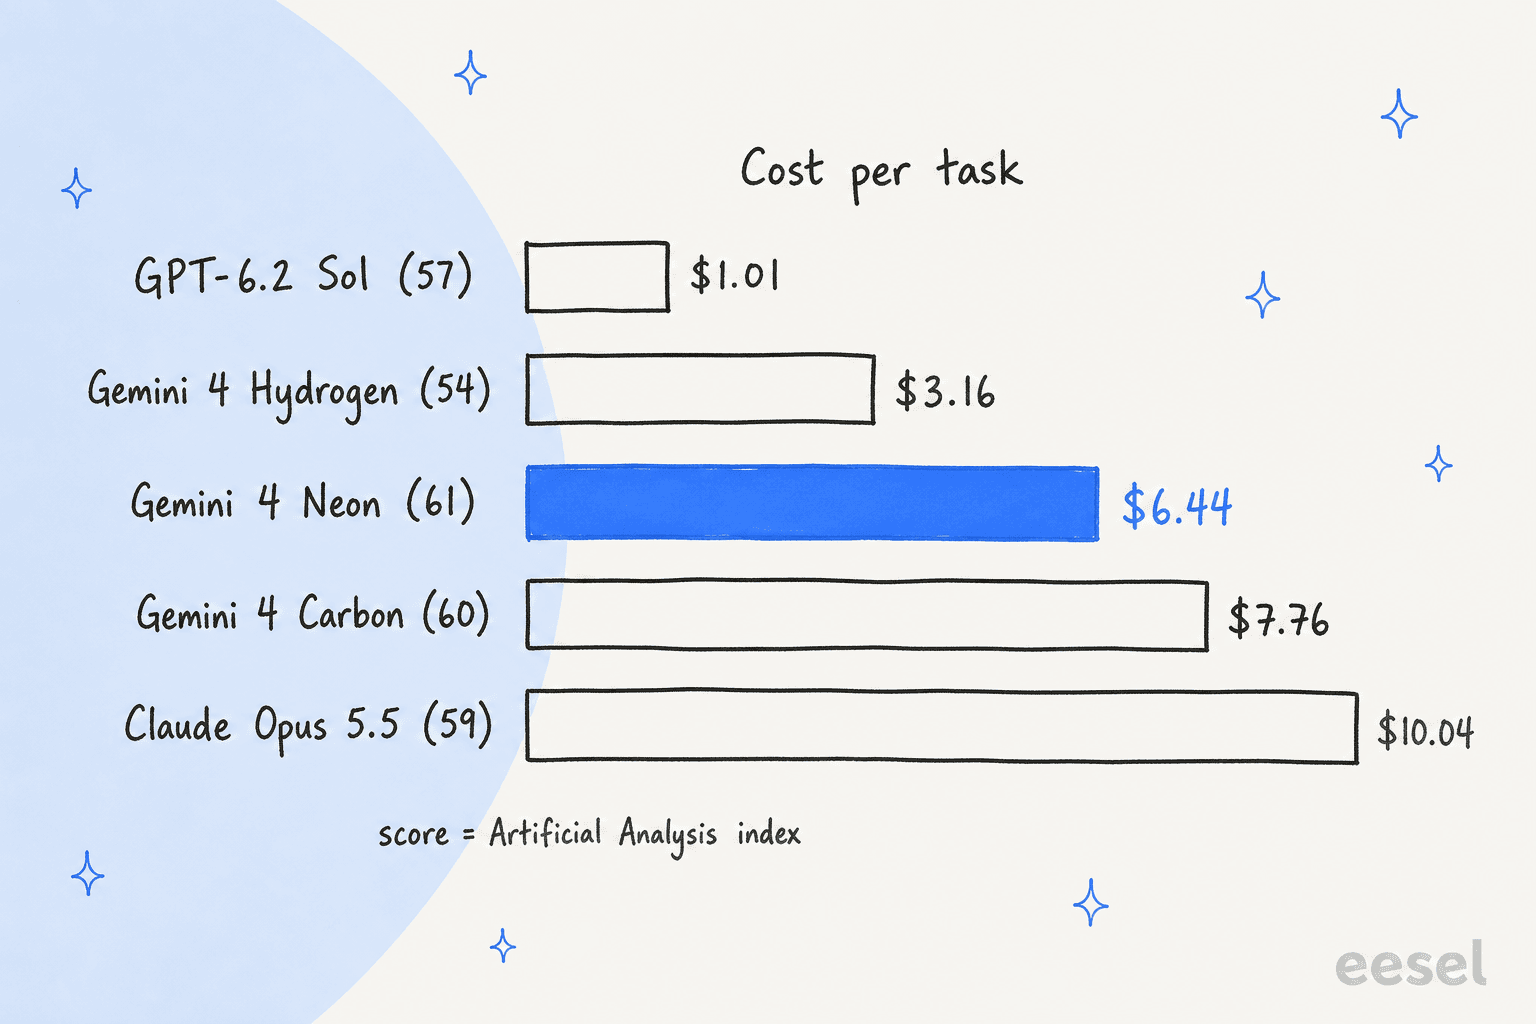
El gráfico usa el mejor ajuste de cada modelo, que es la forma justa de comparar "qué es lo máximo que puede hacer este modelo" y la forma injusta de comparar "qué debería pagar". Para la segunda pregunta, usa la tabla.
¿Alucina menos Gemini 4 Neon que Sol y Opus?
Este es el hallazgo que cambió mi visión del modelo. En la prueba AA-Omniscience de Artificial Analysis, que puntúa cuántas veces un modelo da una respuesta incorrecta en lugar de rehusarse cuando no sabe, la familia Gemini 4 se separa mucho del resto:
| Modelo y ajuste | Tasa de alucinación (menor es mejor) | Preguntas respondidas correctamente |
|---|---|---|
| Gemini 4 Argon high | 4% | 48% |
| Gemini 4 Carbon medium | 4% | 49% |
| Gemini 4 Hydrogen xhigh | 8% | 50% |
| Gemini 4 Carbon high | 11% | 58% |
| Gemini 4 Neon high | 14% | 59% |
| Gemini 4 Neon xhigh | 14% | 60% |
| Claude Opus 5.5 max | 50% | 66% |
| GPT-6.2 Sol max | 55% | 62% |
| GPT-6.2 Astra high | 58% | 66% |
| Claude Fable 5.2 high | 58% | 77% |
Neon dice "no lo sé" con mucha más frecuencia que Opus, Sol o Astra, y lo paga en precisión bruta: 59% al 60% de aciertos frente al 66% de Astra y el 77% de Fable 5.2. Entre los modelos de Google, también se arriesga más a adivinar que Carbon medium, Argon o Hydrogen.
Si ese intercambio es bueno depende del trabajo. Para un agente de investigación que siempre debe producir una respuesta, los rechazos adicionales son friccion. Para un agente orientado al cliente que debería derivar cuando no está seguro, un modelo que se abstiene está más cerca de lo que quieres, y es el comportamiento que busco primero. Una advertencia que quiero decir en voz alta: AA-Omniscience es una prueba de conocimiento general. No mide cómo se comporta un modelo con tu centro de ayuda, así que pruébalo en tus propios tickets antes de creerlo.
¿Dónde se queda corto Gemini 4 Neon?
Encontré seis límites reales, en orden de cuánto me molestarían:
- Es verborrágico. En xhigh escribió 283 millones de tokens de salida en todo el índice, frente a 60,9 millones de Sol. Los tokens de salida son los de $15, así que tu factura se mueve con los hábitos del modelo, no solo con la lista de precios.
- El ajuste más alto es lento. Artificial Analysis midió 56,5 segundos hasta el primer token de respuesta en xhigh y 110 tokens por segundo después de eso. Carbon necesita 73 segundos y 55 tokens por segundo, así que Neon es más rápido que Carbon, pero no es un modelo de chat en vivo por encima de
medium. - Astra y Sol son más baratos por tarea. Por token, Neon es más barato que Astra. Por tarea, no, como muestra la tabla. Sol max puntúa 57,3 por $1,01, que es 6,4 veces más barato que Neon xhigh.
- Es menos preciso cuando debería responder. Ver la tabla de alucinación: el intercambio es precaución por corrección.
- El acceso tiene condiciones. No hay un nivel gratuito de API, y la FAQ de Antigravity, según citó un lector de Hacker News, prohíbe a las herramientas de terceros usar el acceso de suscripción. Lo llamaron un factor decisivo:
"I'd like to keep my Gmail account, so Google can keep their model and will not get my business."

Otro lector señaló la solución alternativa, que son simples claves de API:
"You can't use subsidized tokens in 3rd party apps. Although they just suspend your Gemini account now, not your google account."
- El informe de seguridad está pendiente. La ficha del modelo de Google dice que el informe completo llegará en los próximos días, así que yo retendría cualquier carga de trabajo regulada hasta que llegue.
¿Qué modelo supera a Neon para tu trabajo?
Así es como tomaría la decisión hoy:
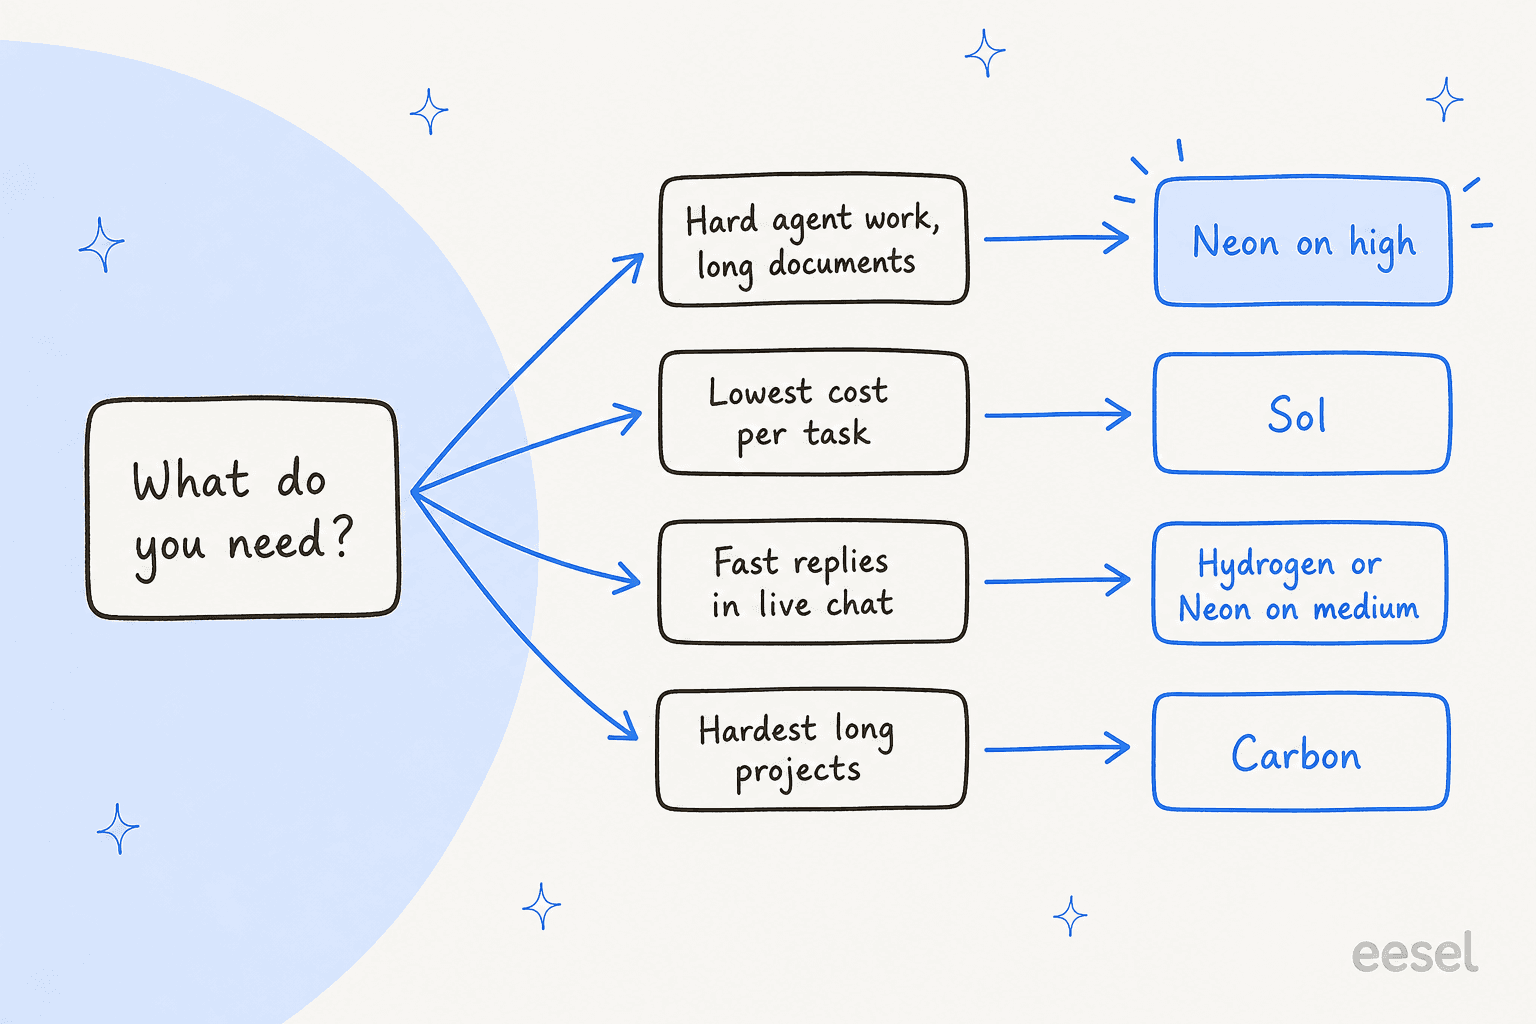
La bifurcación esconde la parte interesante, que es que el costo y la alucinación tiran en direcciones opuestas. Así que aquí están los datos en una herramienta. Fija la puntuación de índice más baja que puedas aceptar y la tasa de alucinación más alta que puedas tolerar, y lista cada ajuste de Artificial Analysis que recopilé que supera ambas barreras, el más barato primero:
Prueba los extremos. Pide una puntuación de 55 sin límite de alucinación y Sol xhigh gana en precio con $0,65. Pon un techo cerca del 20% con la misma puntuación y Neon high es la respuesta más barata con $3,74, con Carbon medium como la opción prudente al 4%. Baja la puntuación a 54 y Neon medium toma el control a $1,90. La familia Gemini 4 es el único lugar donde se obtiene una puntuación alta y una tasa de error baja juntas, y ese es el caso honesto a favor de Neon.
¿Cómo se compara Neon con Carbon, Hydrogen, Astra, Sol y Opus?
| Modelo | Precio por 1M entrada/salida | Mejor puntuación de ajuste | Costo por tarea (mejor) | Tasa de alucinación | Mi opinión en una línea |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3 / $15 | 61,4 | $6,44 | 14% | El mejor Gemini para trabajo difícil; ejecútalo en high |
| Gemini 4 Carbon | $4 / $20 después de la promoción | 60,0 | $7,76 | 11% | Neon lo reemplaza para la mayoría del trabajo |
| Gemini 4 Hydrogen | $1,50 / $7,50 | 53,9 | $3,16 | 8% | El predeterminado para tareas pequeñas |
| GPT-6.2 Astra | $8 / $40 | 62,1 | $4,00 | 59% | Puntuación más alta, menos tokens, adivina más |
| GPT-6.2 Sol | $2 / $10 | 57,3 | $1,01 | 55% | El más barato por tarea, por mucho |
| Claude Opus 5.5 | $4 / $20 | 59,1 | $10,04 | 50% | Neon lo igualá por aproximadamente un tercio del costo |
El precio de lista de Carbon es $4/$20 desde el 1 de diciembre y $2/$10 hasta el 30 de noviembre, lo que lo hace más barato por token que Neon solo por unos días más. Eso no cambia las cuentas por tarea, porque Carbon razona mucho más tiempo.
¿Qué dice la gente sobre Gemini 4 Neon?
El hilo de lanzamiento en Hacker News superó los 460 puntos. La respuesta más útil comparó a Neon con sus rivales en Vals y luego puso el precio en contexto:
"Latency is by far the best for the level of quality. It's about 2x more expensive than Sol 6.2, but significantly better and faster. You get what you pay for."
La diferencia por token frente a Sol es de 1,5 veces, no de 2, y por tarea de benchmark está entre 1,9 y 6,4 veces según el ajuste, así que "you get what you pay for" se sostiene en calidad pero es más caro de lo que suena. Otro lector leyó el mismo precio como una pérdida:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Según las cifras de Artificial Analysis, eso está cerca de ser correcto en costo por tarea y equivocado en alucinación, que es por lo que separo las dos cosas en esta reseña. Un tercer comentarista, que prueba trabajos agénticos largos, estaba menos interesado en la puntuación:
"Argon and Carbon both made such discoveries such as "it would seem that i need to be pointing at an enemy to shoot them". Its almost entertaining to read, its like its discovering the world on first principles."
Ese usuario estaba empezando la misma tarea en Neon cuando publicó, así que todavía no hay veredicto. Y un lector resumió lo que muchos quieren de Google:
"Hydrogen has already became my default for 80% of small tasks. If Neon is as fast but smarter that would honestly be very cool"
Según los datos, Neon es más inteligente que Hydrogen por 8,8 puntos en high, pero cuesta el doble por tarea ($3,74 frente a $1,87). Son comentaristas individuales, no una encuesta, y no pude acceder a Reddit ni a X para conseguir más.
¿Quién debería usar Gemini 4 Neon?
| Eres... | Mi consejo |
|---|---|
| Alguien que usa Carbon o Argon para codificación o análisis difíciles | Cambia a Neon en high y compara. Misma puntuación, casi la mitad de costo y tiempo. |
| Alguien que paga por Opus 5.5 en max | Prueba Neon high. La puntuación es equivalente y la factura es cerca de un tercio. |
| Alguien que construye un agente planificador y uno ejecutor | Neon planifica, Hydrogen ejecuta. |
| Alguien que lee documentos muy largos | Neon, según la fila de GraphWalks de Google y los resultados de trabajo de conocimiento de AA. |
| Alguien que optimiza el costo por tarea por encima de todo | Salta Neon. Usa Sol o Astra. |
| Alguien que construye una respuesta de chat en vivo | Neon en medium como máximo, o Hydrogen. |
| Alguien que necesita un nivel gratuito | Hydrogen. Neon no tiene ninguno. |
| Alguien en Gemini 3.8 Flash para trabajos sencillos | Quédate ahí. Neon es excesivo y más verborrágico. |
Si estás eligiendo entre familias, mi comparación ChatGPT contra Gemini y el resumen de alternativas a Gemini van más lejos. Mi lectura más amplia sobre este nivel está en el artículo sobre frontier AI.
¿Qué significa esta reseña para los equipos de soporte?
Un agente de soporte es un lugar donde el resultado de "rehusarse en lugar de adivinar" importa más que la puntuación destacada. Una respuesta incorrecta dicha con confianza a una pregunta de reembolso cuesta más que una derivación a una persona. Pero el modelo es solo una parte. Lo que el agente sabe, cuándo debe derivar y si alguien lo probó antes del lanzamiento deciden cómo se comporta.
Ese es el patrón de cómo smava, una empresa alemana de comparación de préstamos, ejecuta eesel en un solo Zendesk. Entre el 8 de agosto y el 8 de septiembre de 2026, tres agentes de eesel gestionaron alrededor de 27.000 tickets: uno categorizó cerca de 14.600 de ellos, uno redactó cerca de 15.300 respuestas a partir de 820 macros y artículos de ayuda, y agentes por marca prepararon respuestas listas para el cliente. Cada agente tiene una tarea y una lista de cosas que nunca debe hacer, y las personas aprueban cada borrador antes de enviarlo. SamCart lo divide de la misma forma: un agente para el correo de Freshdesk, otro para el chat del sitio web, cada uno con su propio tono.
La elección del modelo es un ajuste dentro de ese diseño, no el diseño. Si quieres comparar modelos en tu cola, simula al agente con tickets pasados y observa la tasa de derivación, no solo la precisión. Mi guía de cuál es el mejor LLM cubre las comprobaciones que haría, y el costo del servicio al cliente con IA muestra lo que cuesta una cola en total.
Si tu equipo construye en una terminal, la CLI de eesel permite que un agente de código haga las partes repetibles: subir artículos de ayuda y macros exportados, ajustar las instrucciones del agente y hacer preguntas de prueba antes de salir a producción. Conectar el helpdesk en sí todavía necesita que un administrador lo apruebe. Consulta las CLI de codificación agéntica y la guía de un servidor MCP para agentes de IA para ver cómo esas herramientas trabajan con modelos como Neon.
Mi veredicto sobre Gemini 4 Neon
Úsalo si de todos modos ibas a pagar por Carbon u Opus 5.5, ejecútalo en high y mide el costo por tarea, no por token. Sáltalo si el costo por tarea es tu única restricción, porque Sol y Astra son más baratos, o si necesitas un nivel gratuito. Su mejor característica no es la puntuación de 61,4. Es que un modelo tan capaz adivine mal tan pocas veces, algo que merece la pena probar antes de decidir.
Prueba eesel
Si estás eligiendo un modelo porque quieres mejores respuestas en tu cola, el compañero de equipo de helpdesk de IA de eesel te da eso sin tener que decidirte por un modelo. Aprende de tus tickets pasados y de tu centro de ayuda, deriva a una persona cuando la respuesta no está en tu documentación, y puedes probarlo en el historial real de tickets antes de que le responda a nadie. Funciona dentro de Zendesk y Freshdesk, y es lo primero que probaría para implementar IA en el soporte al cliente.
El precio es un plan de créditos mensual fijo, con un plan gratuito de 100 créditos y sin tarjeta, así que un cambio de precio de un modelo no mueve tu factura. Prueba eesel en una porción de tu cola.