

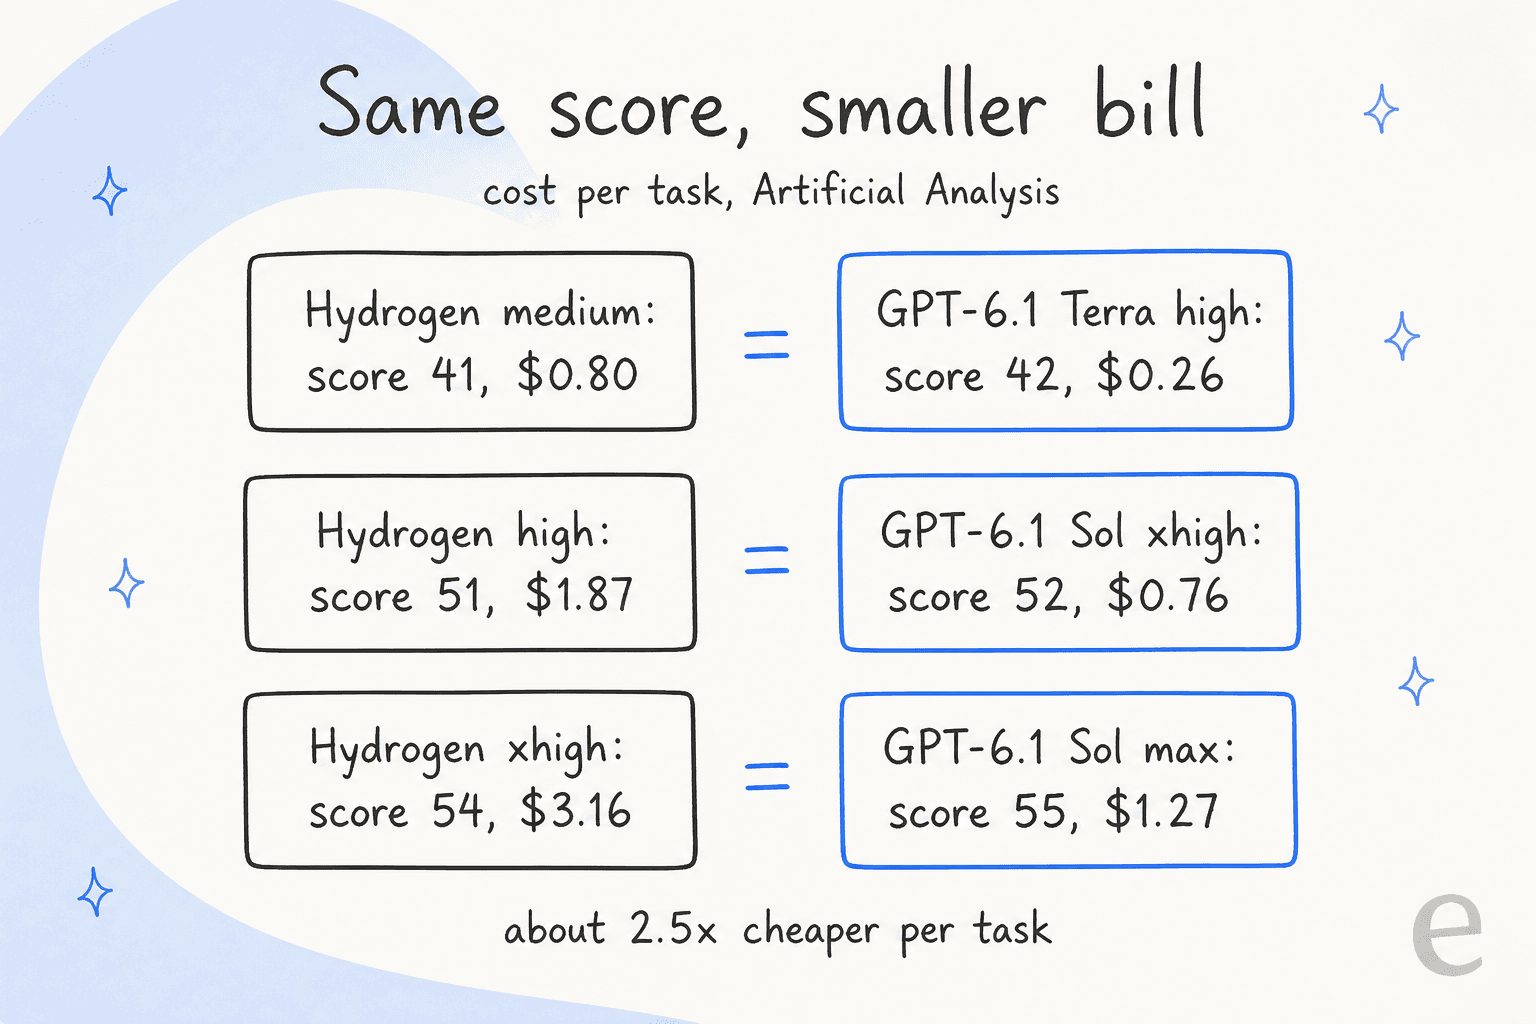
La mejor alternativa a Gemini 4 Hydrogen para la mayoría de desarrolladores es GPT-6.1 Sol con esfuerzo xhigh. Cuesta más por token que Hydrogen, pero Artificial Analysis lo puntúa con 52 por $0,76 por tarea, mientras Hydrogen en su nivel estándar high puntúa 51 por $1,87. Hydrogen piensa mucho antes de responder, y pagas por cada uno de esos tokens.
Elige Claude Sonnet 5.5 para agentes de código y de uso del ordenador, DeepSeek V4.1 Flash para la factura más pequeña, y Gemini 4 Carbon solo para los problemas más difíciles. Si estás construyendo un agente de soporte, eesel es un compañero de helpdesk ya hecho que se apoya en modelos como estos, y su CLI permite que un agente de código cargue tus artículos de ayuda y pruebe sus respuestas antes de lanzarlo.
¿Por qué mirar más allá de Gemini 4 Hydrogen?
Empiezo por la parte buena, porque hay mucha. Gemini 4 Hydrogen se lanzó el 12 de noviembre de 2026 a $1,50 por millón de tokens de entrada y $7,50 por millón de salida, con precio plano en toda su ventana de 1 millón de tokens. Tiene un nivel gratuito con límite de velocidad, acepta texto, imágenes, audio, vídeo y PDF, y con pensamiento bajo y medio es rápido: 1,3 y 3,7 minutos por tarea del Intelligence Index en Artificial Analysis. Google también lo reporta 2,5 veces más rápido que Gemini 3.8 Flash en su configuración predeterminada, según la publicación de lanzamiento.
Los desarrolladores siguen mirando alternativas, y en mi experiencia es por una de cuatro razones:
- La factura sube rápido con pensamiento alto. El precio por token nunca cambia, pero el coste por tarea sí. Artificial Analysis sitúa a Hydrogen en
$0,29por tarea en low,$0,80en medium,$1,87en high (el predeterminado) y$3,16en xhigh. Es un rango de 11 veces en el mismo modelo, porque AA lo describe como "very verbose" en el nivel más alto. - Código y uso del ordenador quedan por detrás de Claude. La propia ficha de modelo de Google pone a Sonnet 5.5 por delante en Terminal-Bench 4.1 (
63,9%frente a57,0%) y OSWorld-2.1 (83,9%frente a77,6%). - La migración rompe cosas. Según las notas de migración de Google, Hydrogen ignora
temperature,top_pytop_k, rechaza el nivel de pensamientominimal, elimina el caché de contexto explícito, y puede devolverMALFORMED_FUNCTION_CALLsi le pides escribir llamadas a herramientas en JSON crudo sin declarar herramientas. - Los precios de Google siguen moviéndose. Más sobre esto más abajo, porque cambia las cuentas para cualquiera que esté en Gemini 3.8 Flash.
El hilo de lanzamiento en Hacker News resumió bien el dilema:
"My TL;DR is: seems like a better choice than Sonnet in areas outside of coding, and at high reasoning it's smarter than Terra but somewhat more expensive."

¿Qué pasa a continuación con los precios de Gemini?
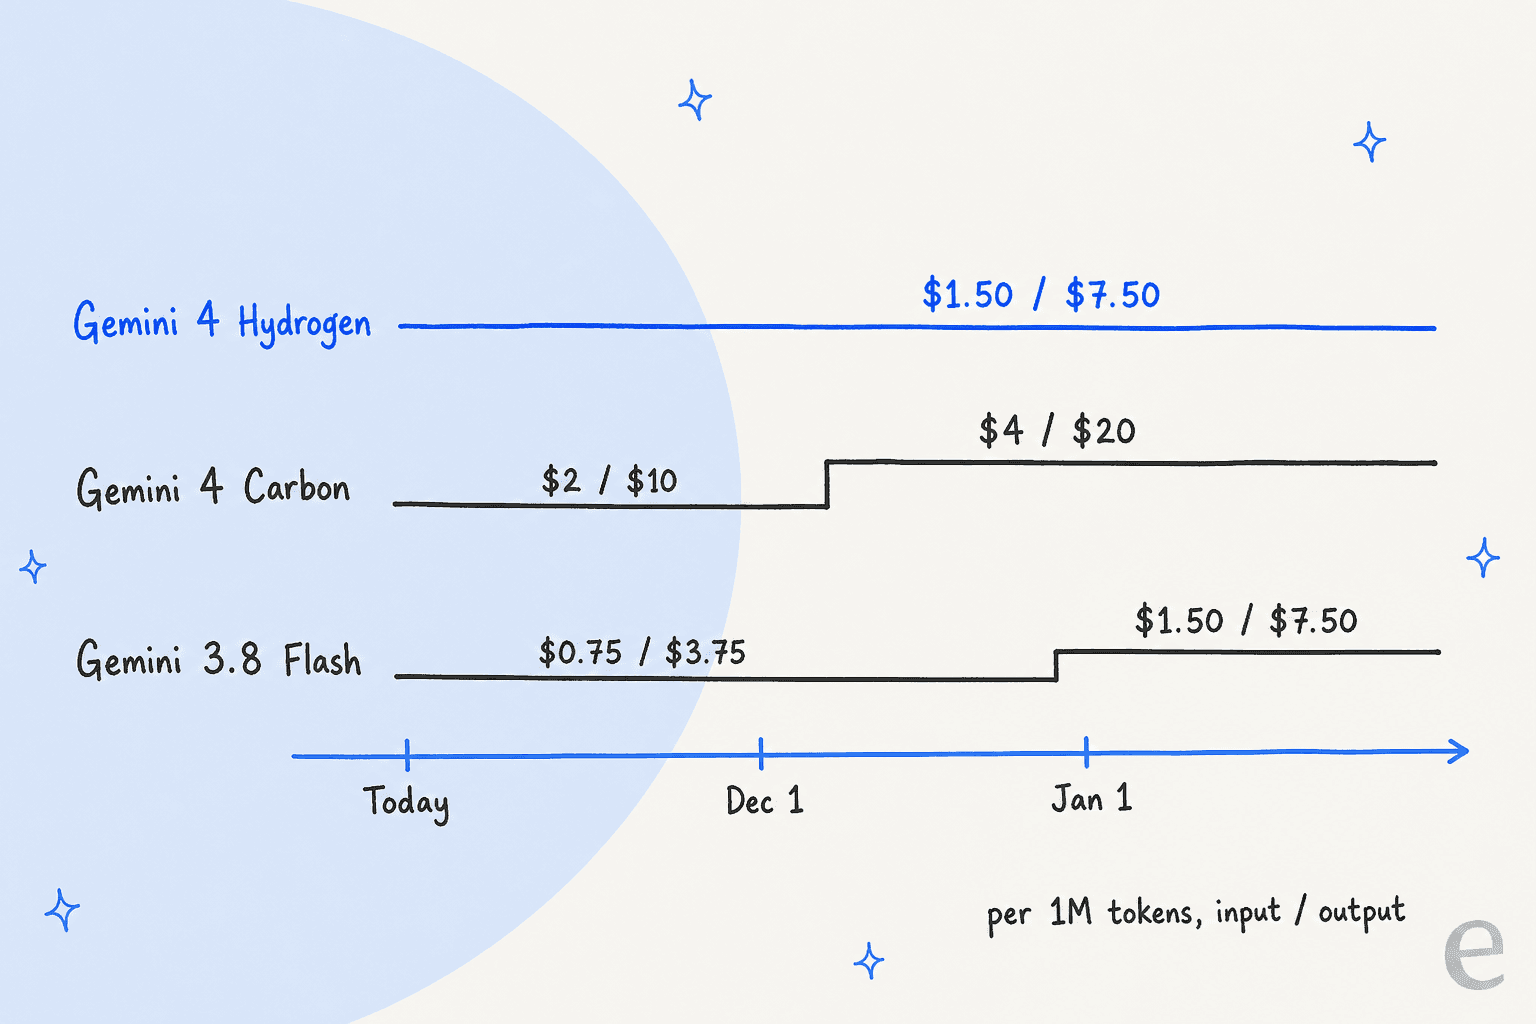
Dos cambios de precio de Google llegan en las próximas siete semanas. Gemini 4 Carbon pasa de $2/$10 a $4/$20 el 1 de diciembre de 2026, y Gemini 3.8 Flash pasa de $0,75/$3,75 a $1,50/$7,50 el 1 de enero de 2027, ambos según la página de precios de la API de Gemini. Desde enero, Flash y Hydrogen tendrán el mismo precio de lista, por lo que Google llama a Hydrogen la mejora recomendada.
Un usuario de Flash en el hilo de lanzamiento ya había hecho esa cuenta:
"If this is Google's strategy we'll have to migrate to Luna, because costs are already high for our workload on 3.8 Flash"
Oigo la misma preocupación en equipos de soporte. Un equipo de hardware B2B con el que hablé se había visto afectado cuando los precios de un proveedor de IA anterior "más que se duplicaron", y pidió un contrato anual solo para fijar la tarifa. El riesgo de precio es una razón real para tener un segundo modelo listo.
Cómo elegí y puse precio a estos modelos
Construyo las integraciones y APIs que conectan los agentes de IA de eesel con los helpdesks, así que paso mucho tiempo cambiando modelos bajo un agente en marcha. Esta es la lección que se repite: un token barato puede dar una tarea cara. Por eso cada elección de abajo se juzga según:
- Precio de lista por 1M de tokens, leído el 13 de noviembre de 2026 en la propia página de precios de cada proveedor.
- Coste por tarea, puntuación y tiempo por tarea de Artificial Analysis, que ejecuta la misma suite Intelligence Index en cada modelo y registra lo que cada uno gastó realmente, tokens de pensamiento incluidos. Anoto el nivel de esfuerzo entre paréntesis, porque un modelo puede caer en cualquier punto de la tabla según ese ajuste.
- Una factura mensual para un comprador: un agente que envía 1 millón de solicitudes al mes, cada una con 2.000 tokens de entrada y 300 de salida. Son 2.000 millones de tokens de entrada y 300 millones de salida, antes de caché o tokens de pensamiento. Es un piso, no una previsión.
También hice una búsqueda nueva en ChatGPT con la pregunta que escribiría un desarrollador. Su lista corta fue Claude Sonnet 5.5, GPT-6.1 Terra, GPT-6.1 Sol, Claude Opus 5.5 y DeepSeek, y dijo que el número a vigilar es "coste por tarea exitosa". Mantuve los cinco y añadí Gemini 4 Carbon, Kimi K3.1 Pro y GPT-6 Luna para cubrir las rutas del mismo proveedor, de pesos abiertos y de presupuesto.
Alternativas a Gemini 4 Hydrogen comparadas
| Modelo | Entrada / salida por 1M | Entrada en caché | Contexto | Pesos abiertos | Puntuación AA (nivel) | Coste por tarea AA | Tiempo por tarea AA | Factura mensual (comprador de ejemplo) |
|---|---|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen (base) | $1.50 / $7.50 | $0.075 | 1M | No | 51 (high) | $1.87 | 8.3 min | $5,250 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | No | 52 (xhigh) | $0.76 | 9.8 min | $7,000 |
| GPT-6.1 Terra | $1 / $5 | $0.05 | 1.05M | No | 42 (high) | $0.26 | 4.2 min | $3,500 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | No | 55 (max) | $10.02 | 33.0 min | $7,000 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | No | 48 (medium) | $2.45 | 7.2 min | $14,000 |
| Gemini 4 Carbon | $2 / $10, luego $4 / $20 desde el 1 dic. | $0.10 | 1M | No | 58 (medium) | $4.68 | 23.8 min | $7,000, luego $14,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fuera de pico | $0.003 | 1M | Sí (MIT) | 33 (max) | $0.60 | 15.1 min | $480 |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1M | Sí | 46 | $3.68 | 38.3 min | $7,000 |
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | 1.05M | No | 28 (max) | $0.15 | 11.6 min | $350 |
Lee las últimas tres columnas antes de la primera. En precio de lista, Hydrogen parece más barato que Sol. Por tarea, Sol hace un trabajo algo mejor por alrededor del 40% del coste, y en un tiempo similar. Las puntuaciones, costes y tiempos vienen de la página de Artificial Analysis de cada modelo del 13 de noviembre de 2026.
¿Cuánto te costaría cada uno al mes?
Introduce cuántas tareas de agente ejecutas al mes, y elige un tamaño. La calculadora multiplica por el coste por tarea de Artificial Analysis de cada modelo, así que incluye los tokens de pensamiento que la factura de precio de lista anterior deja fuera. Las tareas de AA son trabajos agénticos largos, así que trata los totales como una forma de comparar modelos entre sí, no como tu factura exacta.
1. GPT-6.1 Sol
Mejor para: desarrolladores que quieren trabajo al nivel de Hydrogen por menos por tarea, y pueden vivir con la forma de API de OpenAI.
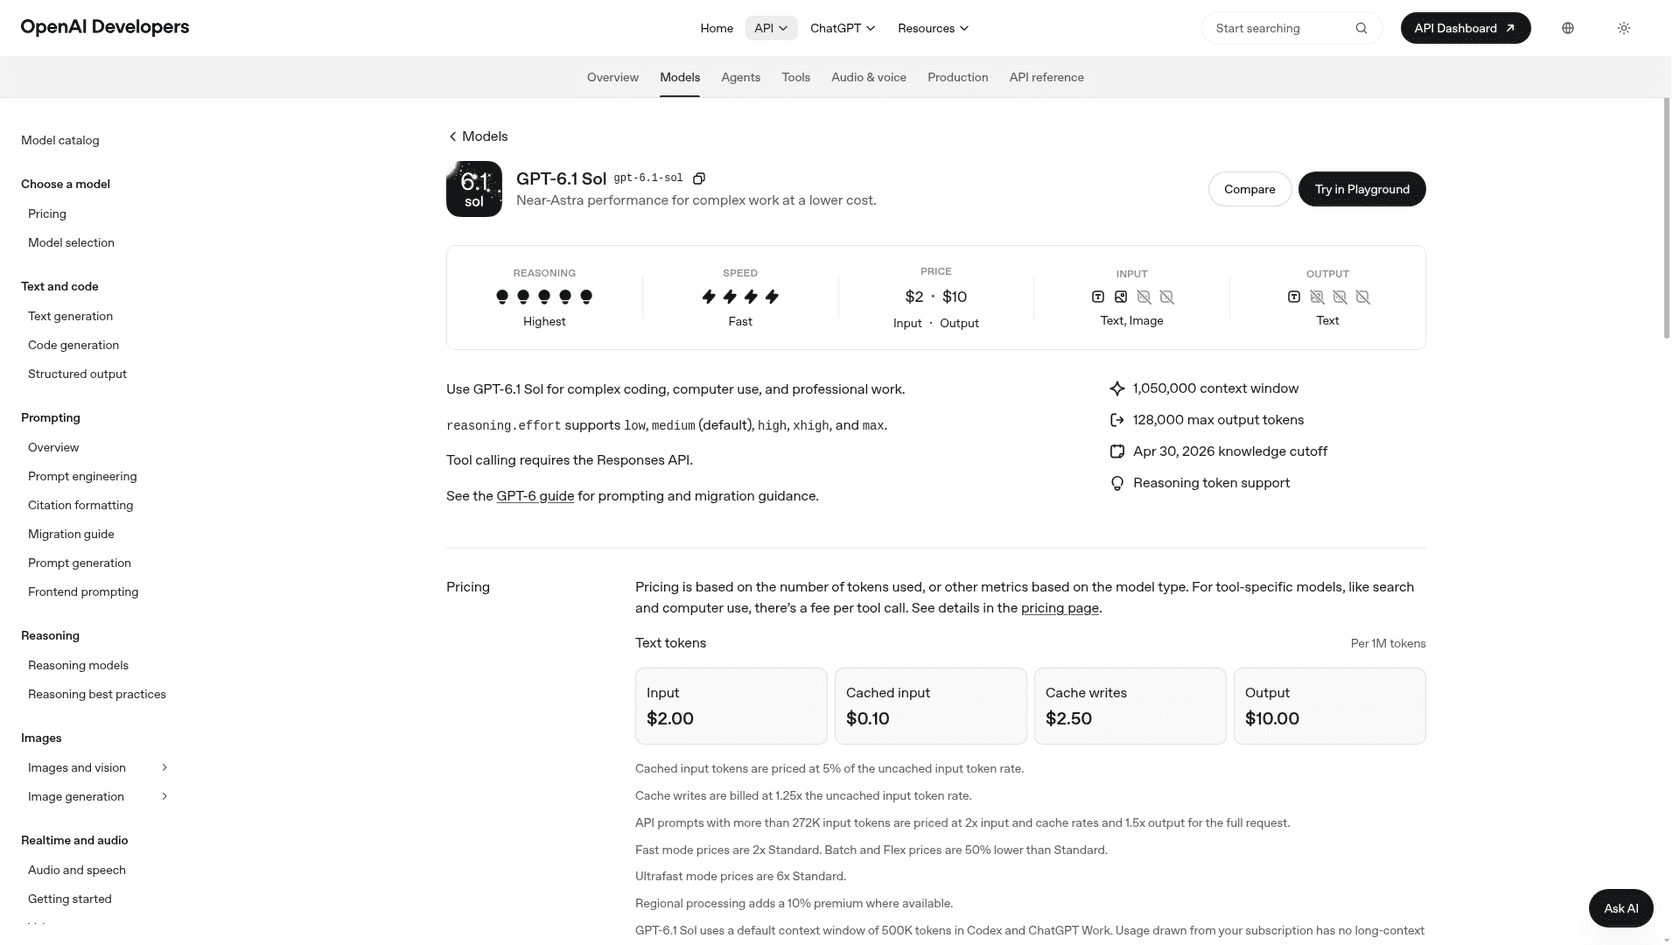
GPT-6.1 Sol es el segundo escalón de OpenAI, por debajo de GPT-6 Astra. OpenAI lo describe como "Near-Astra performance for complex work at a lower cost", y por tarea es lo más cercano a una actualización directa de Hydrogen en esta lista.
Pros
- En xhigh puntúa
52por$0,76por tarea en9,8minutos. Hydrogen en high puntúa51por$1,87en8,3minutos. - En max puntúa
55por$1,27, más barato que Hydrogen en xhigh (54,$3,16). - Cinco niveles de esfuerzo, de
lowamax, así que puedes ajustarlo igual que ajustarías el nivel de pensamiento de Hydrogen.
Contras
- Las llamadas a herramientas requieren la Responses API, así que una integración con forma de Gemini necesita trabajo real.
- Sin nivel gratuito, y los prompts de más de 272K tokens de entrada cuestan 2x la entrada y 1,5x la salida en toda la solicitud.
- Su fecha límite de conocimiento es el 30 de abril de 2026.
Precios: $2 de entrada, $0,10 en caché, $10 de salida por 1M de tokens en la página de precios de OpenAI. Batch y Flex cuestan la mitad.
Mi opinión: si estabas a punto de poner Hydrogen en xhigh, prueba primero Sol en xhigh. Por tarea es el camino más barato a la misma puntuación. La reseña de GPT-6.1 Sol tiene una prueba práctica con un ticket de soporte.
2. GPT-6.1 Terra
Mejor para: trabajo rápido y barato donde Hydrogen en low o medium ya es suficientemente bueno.
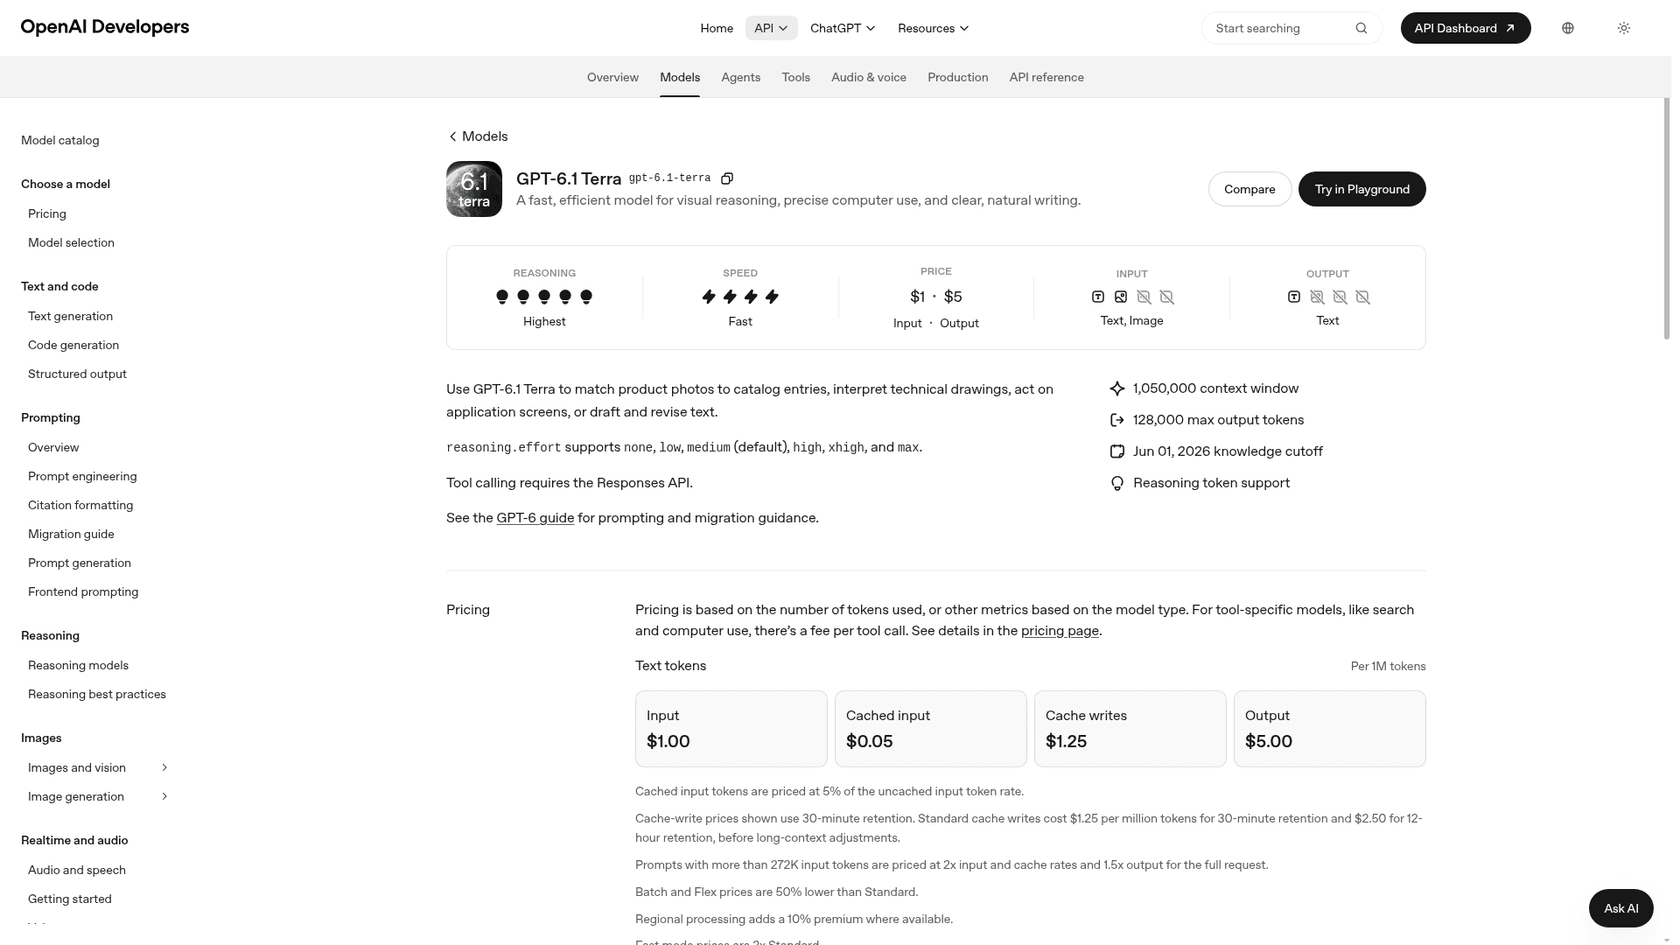
GPT-6.1 Terra está un escalón por debajo de Sol, y es el rival más directo de Hydrogen. Google incluso lo puso en su propia tabla comparativa, donde Hydrogen le gana en 8 de 9 filas compartidas.
Pros
- En high puntúa
42por$0,26por tarea en4,2minutos. Hydrogen en medium puntúa41por$0,80en3,7minutos. Eso es alrededor de un tercio del coste por la misma puntuación. - Tiene un nivel de esfuerzo
nonepara una vía rápida sin pensamiento, que Hydrogen no ofrece. - El precio de lista es un tercio más bajo que el de Hydrogen tanto en entrada como en salida.
Contras
- La tabla de Google pone a Hydrogen por delante en SWE-sweep (
13,5%frente a5,8%) y AutomationBench (76,1%frente a60,2%). - Llevarlo a max (
51,$0,96,14,2minutos) es más lento que Hydrogen en high. - Mismo requisito de Responses API para llamadas a herramientas que Sol.
Precios: $1 de entrada, $0,05 en caché, $5 de salida por 1M de tokens, según la página de precios de OpenAI.
Mi opinión: el cambio para tráfico de alto volumen y dificultad media. Para tareas difíciles, sube a Sol en lugar de llevar Terra al máximo. La reseña de GPT-6.1 Terra muestra cómo se comportó con tickets reales.
3. Claude Sonnet 5.5
Mejor para: agentes de código, trabajo en terminal y uso del ordenador.
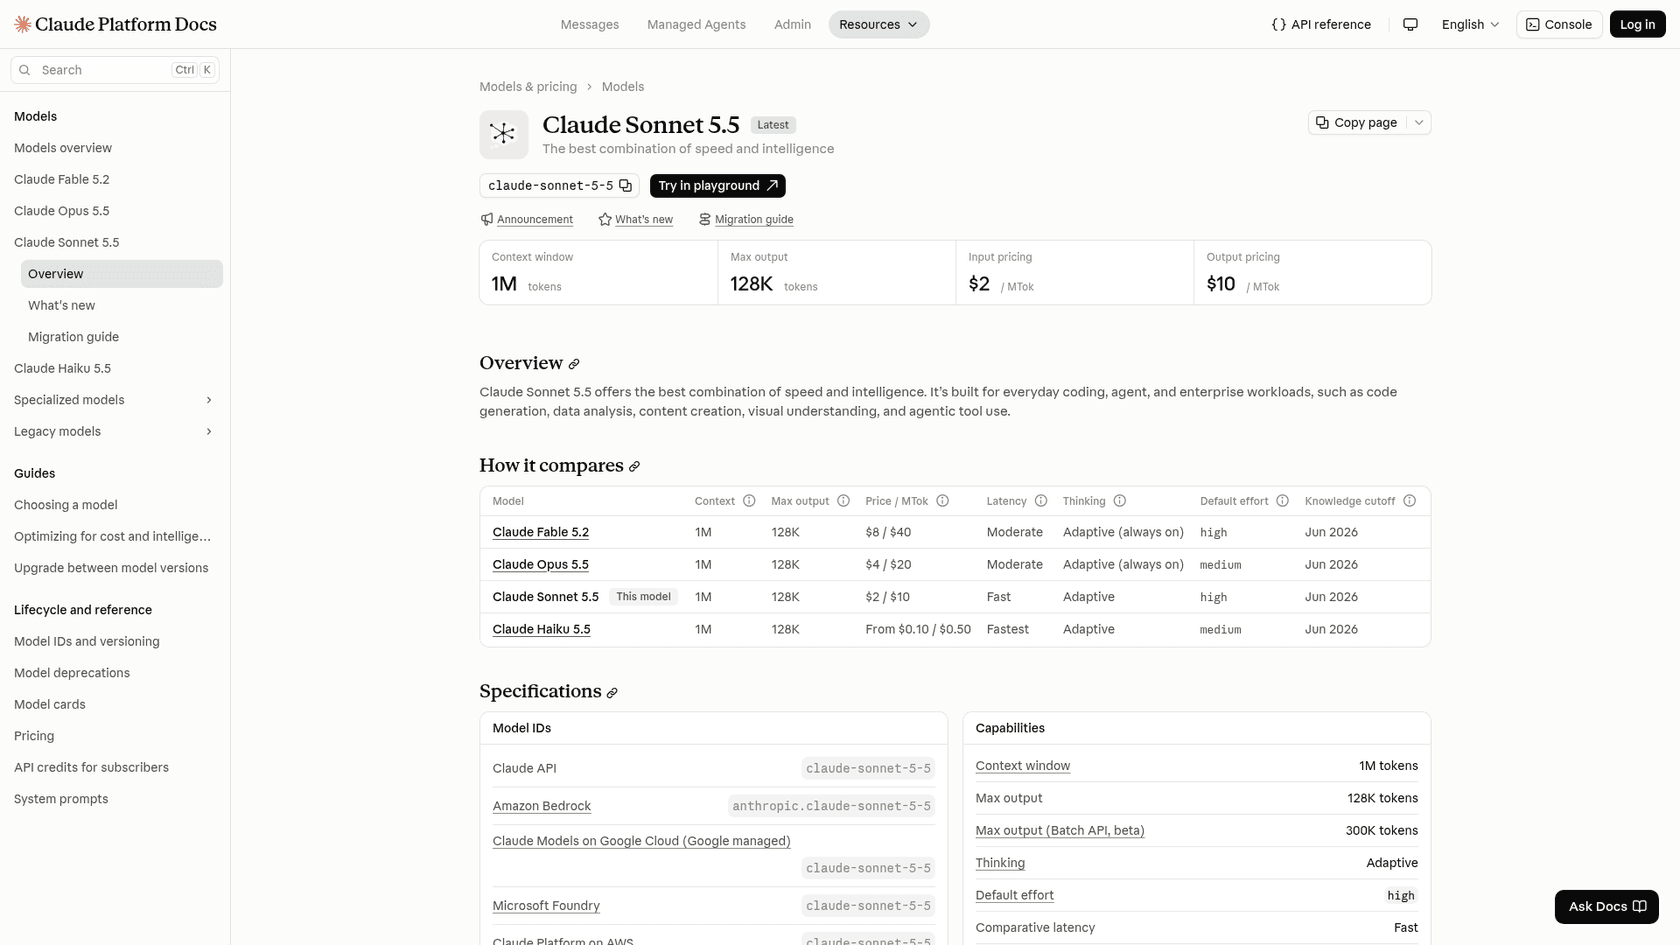
Claude Sonnet 5.5 es el modelo intermedio de Anthropic, al que Anthropic llama "the best combination of speed and intelligence". ChatGPT lo clasificó como la mejor alternativa a Hydrogen, y los propios números de Google explican por qué está en la conversación.
Pros
- Supera a Hydrogen en las dos filas de agentes que más importan para herramientas de código: Terminal-Bench 4.1 (
63,9%frente a57,0%) y OSWorld-2.1 (83,9%frente a77,6%), según la ficha de modelo de Google. - En max puntúa
55, por encima del mejor de Hydrogen (54en xhigh). - Precio plano en toda la ventana de 1M, y lecturas de caché a
$0,10.
Contras
- En max cuesta
$10,02por tarea y tarda33minutos en Artificial Analysis. En medium baja a$0,78, pero la puntuación baja a31. - Hydrogen gana las filas de SWE-sweep (
13,5%frente a3,1%) y HLE-Diamond (58,8%frente a53,3%) de Google. - API estricta: un
temperaturedistinto del predeterminado y untool_choiceforzado devuelven ambos error, cubierto en la reseña de Sonnet 5.5.
Precios: $2 de entrada, $0,10 de lectura en caché, $10 de salida por 1M de tokens en la página de precios de Anthropic. Batch lo reduce a la mitad.
Mi opinión: elígelo cuando el agente escribe código o maneja un ordenador. Para trabajo de conocimiento general, Hydrogen es la mejor compra, lo que coincide con lo que concluyó el hilo de HN.
4. Claude Opus 5.5
Mejor para: agentes de larga duración donde acertar importa más que la factura.
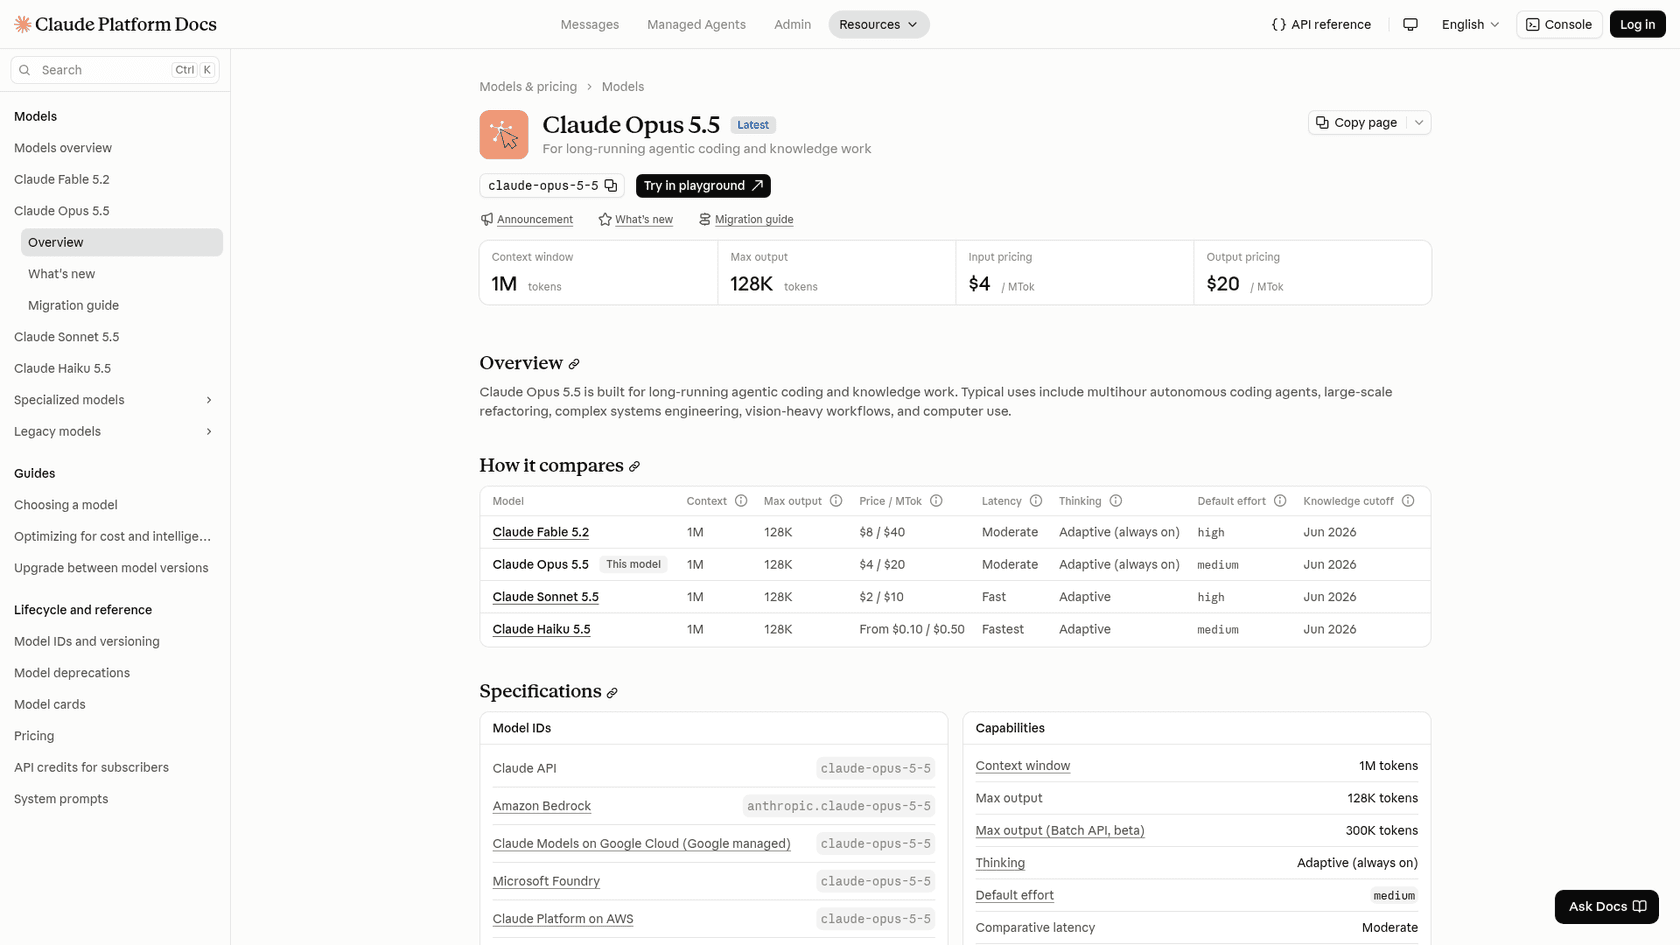
Claude Opus 5.5 es el modelo grande de Anthropic, construido "for long-running agentic coding and knowledge work". Aquí es la opción más cara por token, así que pertenece a esta lista como objetivo de escalado, no como predeterminado.
Pros
- En max puntúa
59en Artificial Analysis, la segunda puntuación más alta de esta comparación tras Carbon en high. - En medium, su nivel predeterminado, puntúa
48por$2,45en7,2minutos. - Las lecturas de caché cuestan
$0,20, solo el 5% del precio de entrada, lo que ayuda a agentes que reenvían un prompt de sistema largo.
Contras
- Precio de lista de
$4/$20, así que la factura de ejemplo es de$14.000, casi 3 veces la de Hydrogen. - En max,
$10,04por tarea y25,2minutos. - El pensamiento siempre está activo, lo que Anthropic lista como "Adaptive (always on)", y se factura como salida.
Precios: $4 de entrada, $0,20 de lectura en caché, $20 de salida por 1M de tokens en la página de precios de Anthropic. El modo Fast es $8/$40.
Mi opinión: un planificador, no un trabajador. Deja que Opus planifique o revise, y que algo más barato haga los pasos. La reseña de Opus 5.5 tiene los números por nivel de esfuerzo.
5. Gemini 4 Carbon
Mejor para: equipos que se quedan en Google y necesitan más razonamiento del que da Hydrogen.
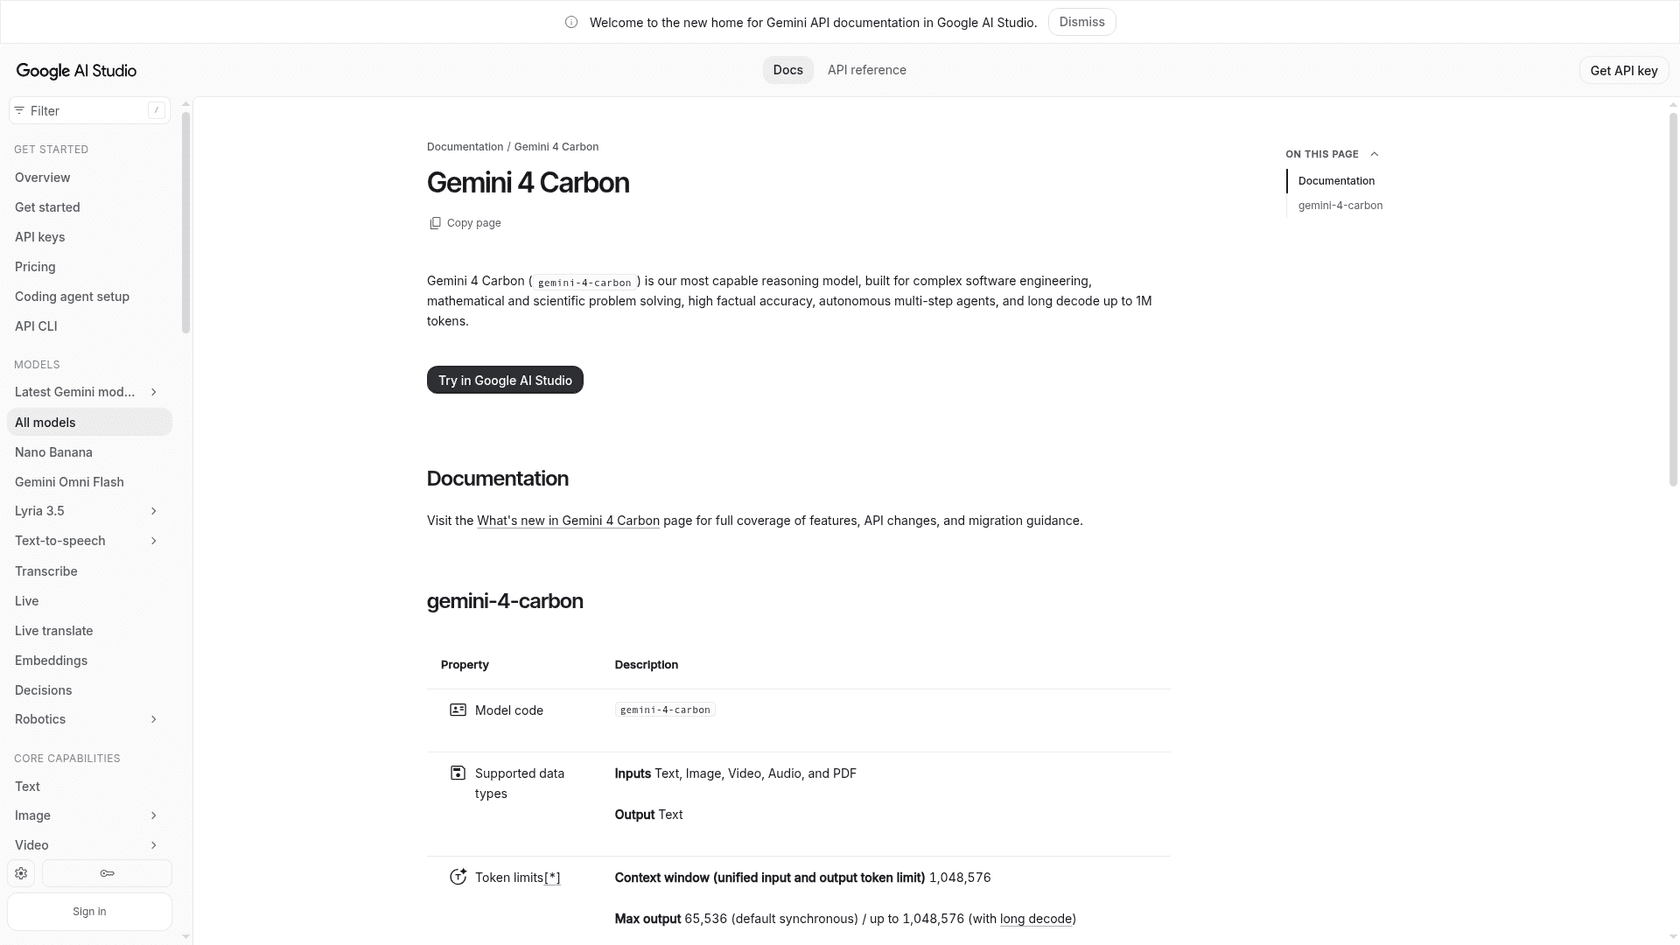
Gemini 4 Carbon es el hermano mayor de Hydrogen y alcanzó disponibilidad general el 10 de noviembre de 2026. Misma API y mismas entradas, así que este es el cambio que requiere menos trabajo de toda la lista.
Pros
- En medium puntúa
58en Artificial Analysis, y60en high, la puntuación más alta de esta comparación. - Mantienes el SDK de Gemini, el Search grounding y las entradas multimodales que ya construiste.
- El Orchestrator en Antigravity de Google combina Carbon para planificar con Hydrogen para ejecutar, lo que muestra el reparto previsto.
Contras
$4,68por tarea en medium,$5,48en high, y de23,8a27,4minutos por tarea.- El precio se duplica a
$4/$20el 1 de diciembre de 2026, y no hay nivel gratuito. - Por defecto está en medium y limita en high, así que no hay xhigh.
Precios: $2 de entrada, $0,10 en caché, $10 de salida por 1M de tokens hasta el 30 de noviembre de 2026, luego $4/$0,20/$20, según la página de precios de la API de Gemini. Más en la reseña de Gemini 4 Carbon.
Mi opinión: enruta aquí tu 10% más difícil y mantén Hydrogen para el resto. Enviarlo todo a Carbon después del 1 de diciembre es una factura alta por unos pocos puntos de puntuación.
6. DeepSeek V4.1 Flash
Mejor para: la factura más baja, y equipos que quieren pesos abiertos.
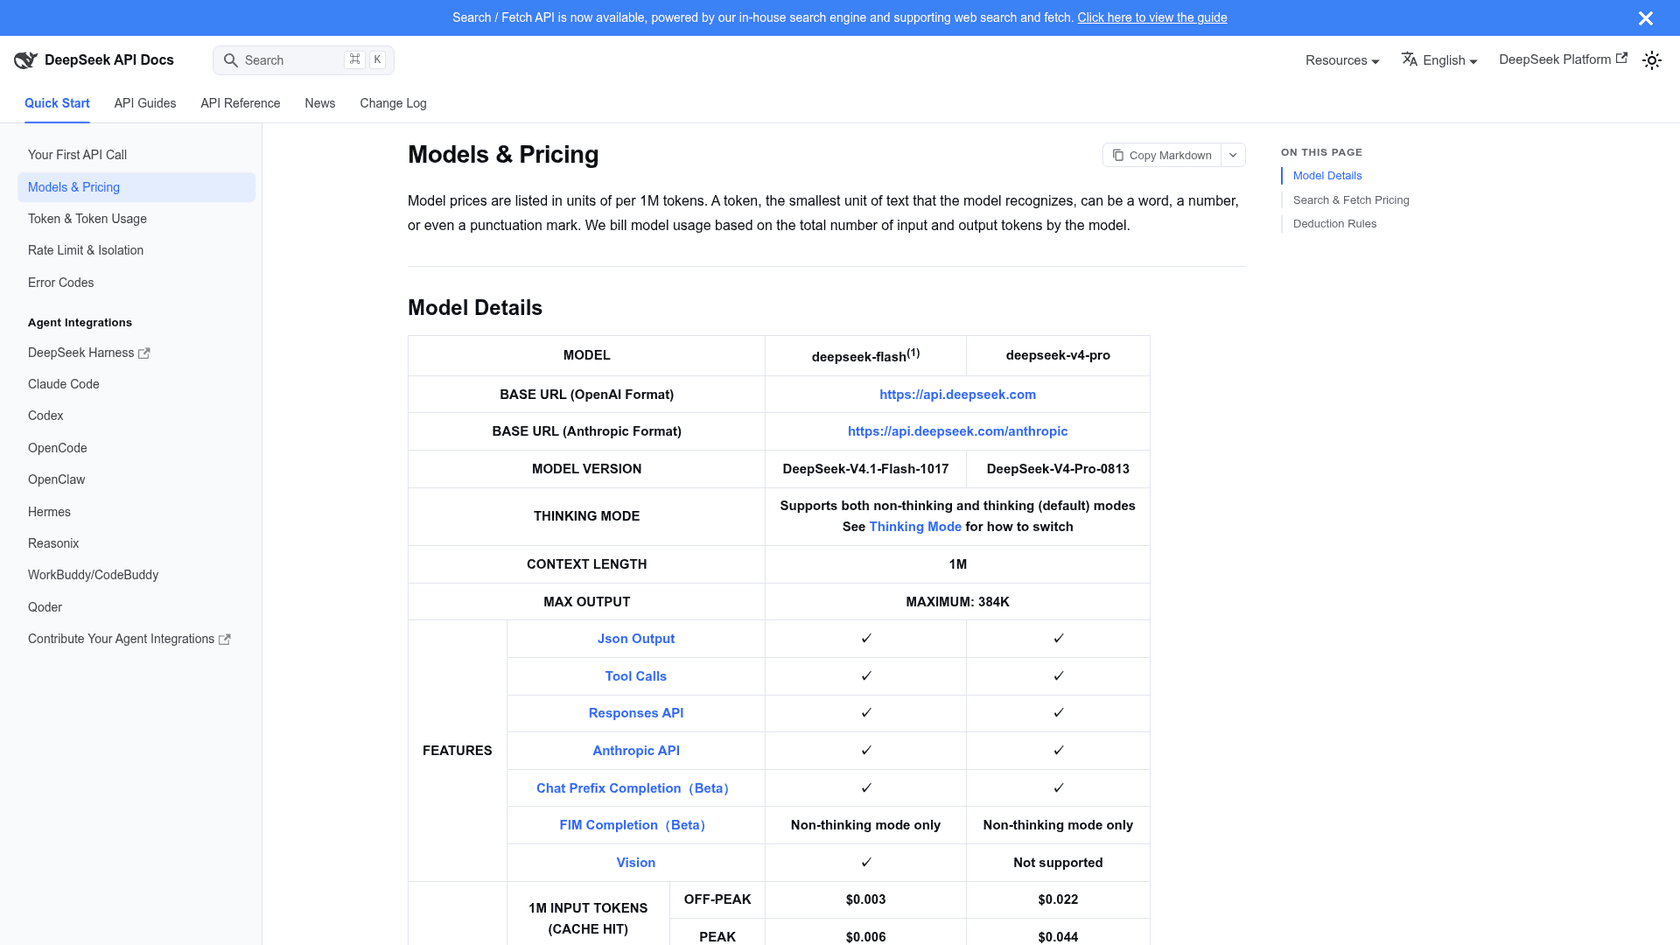
DeepSeek V4.1 Flash se llama deepseek-flash en la API de DeepSeek, y el nombre antiguo deepseek-v4-flash ahora también redirige a él. Es el único modelo de esta lista que cuesta menos de una décima parte del precio de lista de Hydrogen.
Pros
$0,15/$0,60por 1M de tokens fuera de pico, así que la factura de ejemplo es$480frente a los$5.250de Hydrogen.- Pesos con licencia MIT, así que tú o un proveedor de hosting podéis ejecutarlo fuera de China.
- Entrada de visión, llamadas a herramientas, salida JSON, y endpoints en formato OpenAI y formato Anthropic.
Contras
- Puntúa
33en max en Artificial Analysis, muy por debajo de Hydrogen en medium (41). - Las horas de pico (
01:00a04:00y06:00a10:00UTC, días laborables) duplican el precio. - En la propia plataforma de DeepSeek, tus datos van a una empresa con sede en China, así que revisa eso contra tus reglas de datos primero.
Precios: $0,15 de entrada, $0,003 de acierto de caché, $0,60 de salida por 1M de tokens fuera de pico; $0,30/$0,006/$1,20 en pico, según la página de precios de DeepSeek.
Los benchmarks no cuentan toda la historia aquí. Un desarrollador que hizo pruebas de agentes cara a cara publicó esto:
"Right now DeepSeek Flash 4.1 Flash has a 64% win rate against GPT 6.1 Sol. Small data still, but it has 33 wins vs. 18 losses"
Mi opinión: merece una prueba comparativa para cualquier trabajo de alto volumen antes de pagar las tarifas de Hydrogen. La guía de precios de DeepSeek V4.1 Flash cubre las cuentas de las horas pico.
7. Kimi K3.1 Pro
Mejor para: equipos que necesitan un modelo grande de pesos abiertos y pueden esperar las respuestas.
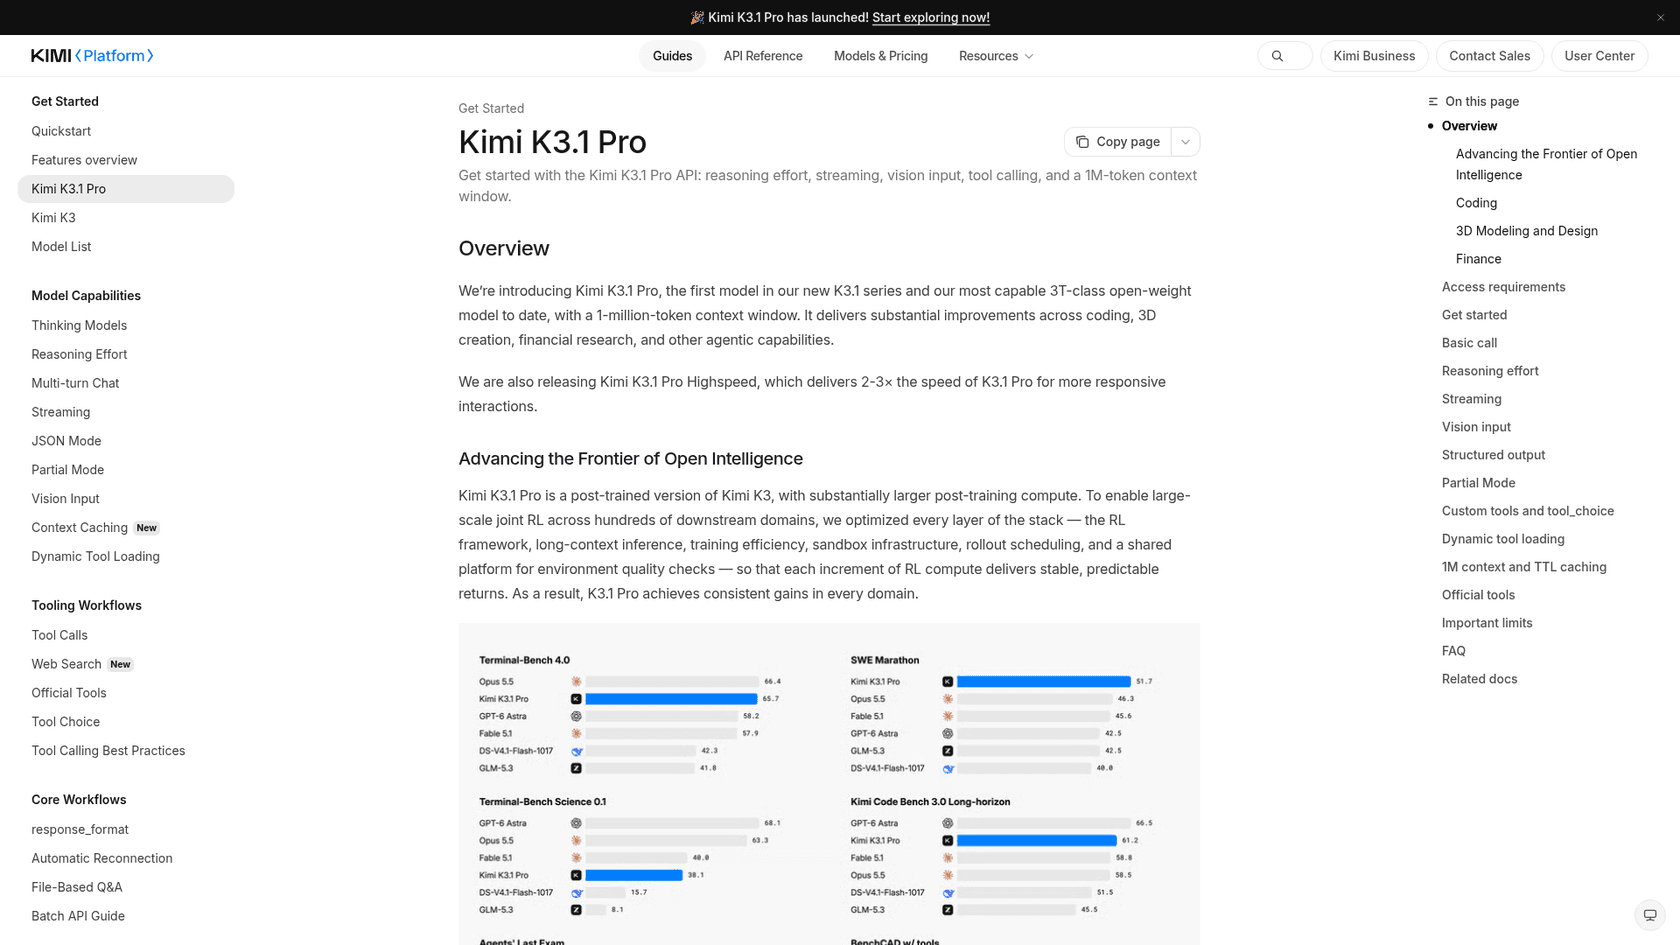
Kimi K3.1 Pro es el buque insignia de Moonshot AI, descrito en su documentación como "our most capable 3T-class open-weight model to date". Sus pesos ya están en Hugging Face.
Pros
- Artificial Analysis lo clasifica primero entre 28 modelos de pesos abiertos de su clase de tamaño, con
46. - Contexto de 1.048.576 tokens, entrada de imagen, e inferencia por lotes al 60% del precio estándar.
- Una versión Highspeed (
$4/$20) va de 2 a 3 veces más rápido, según Moonshot.
Contras
$3,68por tarea y38,3minutos en Artificial Analysis, lo que lo marca como lento y caro para un modelo de pesos abiertos.- AA midió un tiempo hasta el primer token de respuesta de
172segundos a unos31tokens por segundo. - Mismo precio de lista de
$2/$10que Sol, con una puntuación más baja.
Precios: $2 de entrada, $0,20 de acierto de caché, $10 de salida por 1M de tokens en la página de precios de Moonshot.
Mi opinión: una opción cuando los pesos abiertos son el requisito, no un ahorro frente a Hydrogen. Si solo necesitas lo más barato, gana DeepSeek. La reseña de Kimi K3.1 Pro entra más a fondo.
8. GPT-6 Luna
Mejor para: triaje, etiquetado y enrutamiento al precio más bajo posible.
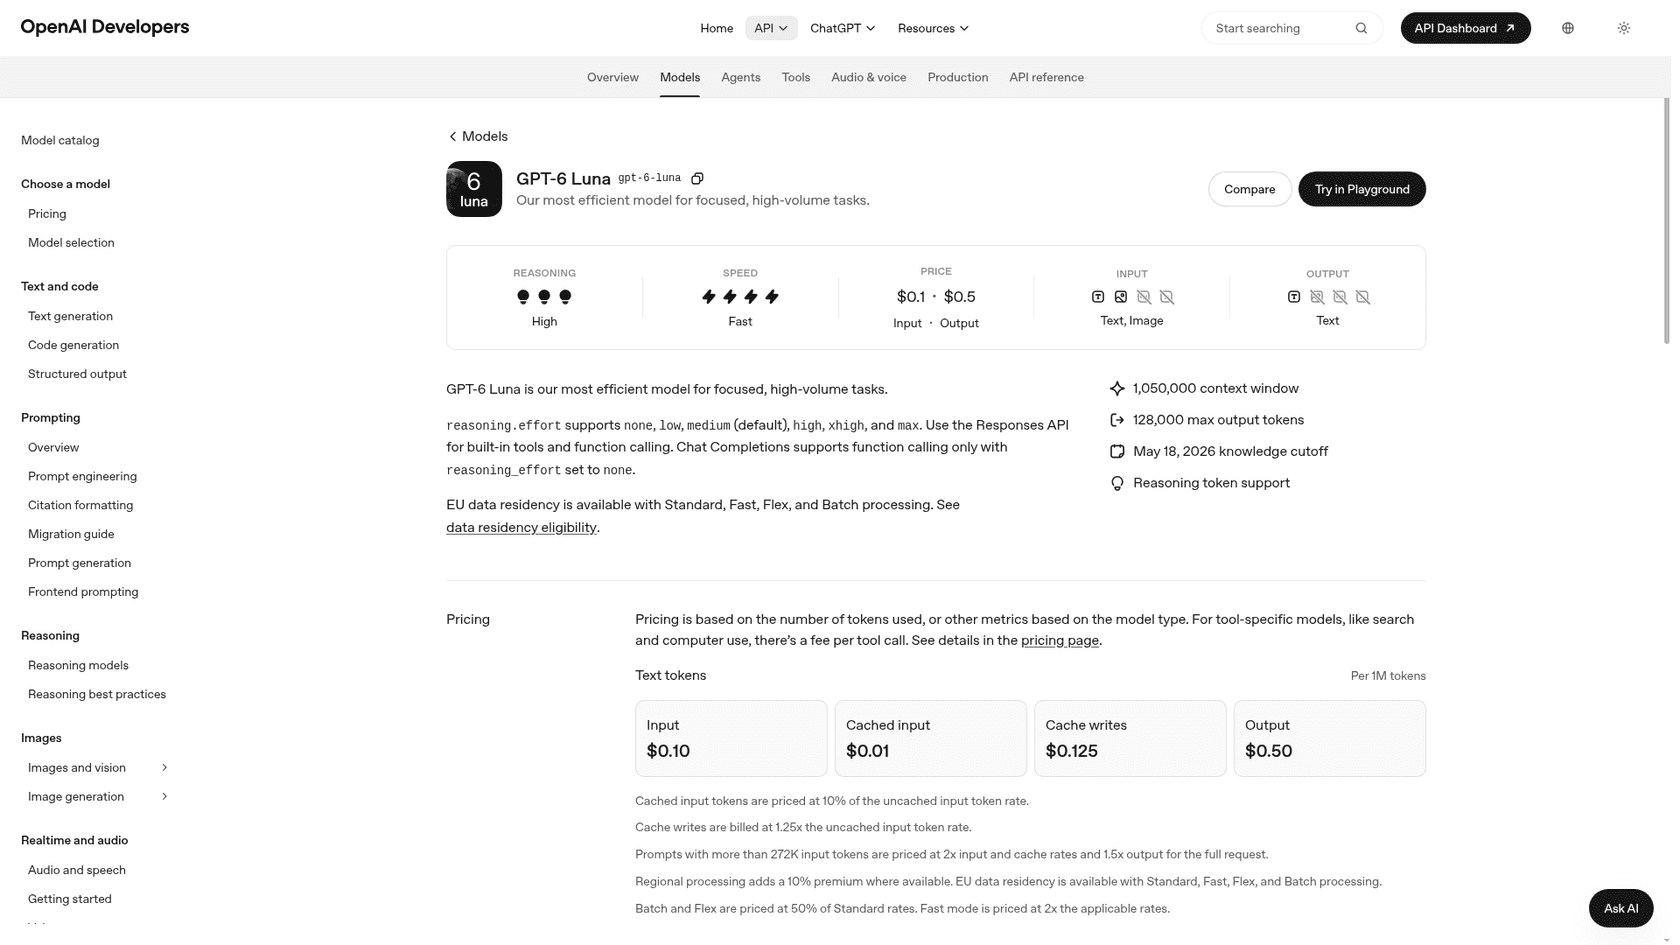
GPT-6 Luna es el modelo más pequeño de OpenAI, "our most efficient model for focused, high-volume tasks". Es donde miraron primero los usuarios de Gemini 3.8 Flash cuando Hydrogen llegó al doble del precio actual de Flash.
Pros
$0,10/$0,50por 1M de tokens, así que la factura de ejemplo es$350.$0,15por tarea con esfuerzo max en Artificial Analysis, lo más barato de esta lista.- Admite function calling de Chat Completions cuando el esfuerzo está en
none, lo que facilita portar código de enrutamiento simple.
Contras
- Puntúa
28en max, muy por debajo de Hydrogen incluso en medium. - Mismo recargo por prompt largo que los otros modelos de OpenAI por encima de 272K tokens de entrada.
- No es un modelo para trabajo de agente de varios pasos por sí solo.
Precios: $0,10 de entrada, $0,01 en caché, $0,50 de salida por 1M de tokens en la página de precios de OpenAI.
Mi opinión: la puerta de entrada de una configuración enrutada, no un reemplazo completo de Hydrogen. Déjalo clasificar solicitudes y pasar arriba las difíciles.
¿Qué alternativa a Gemini 4 Hydrogen deberías elegir?
Parte de por qué te vas, no de la clasificación. Cada razón apunta a un modelo distinto:
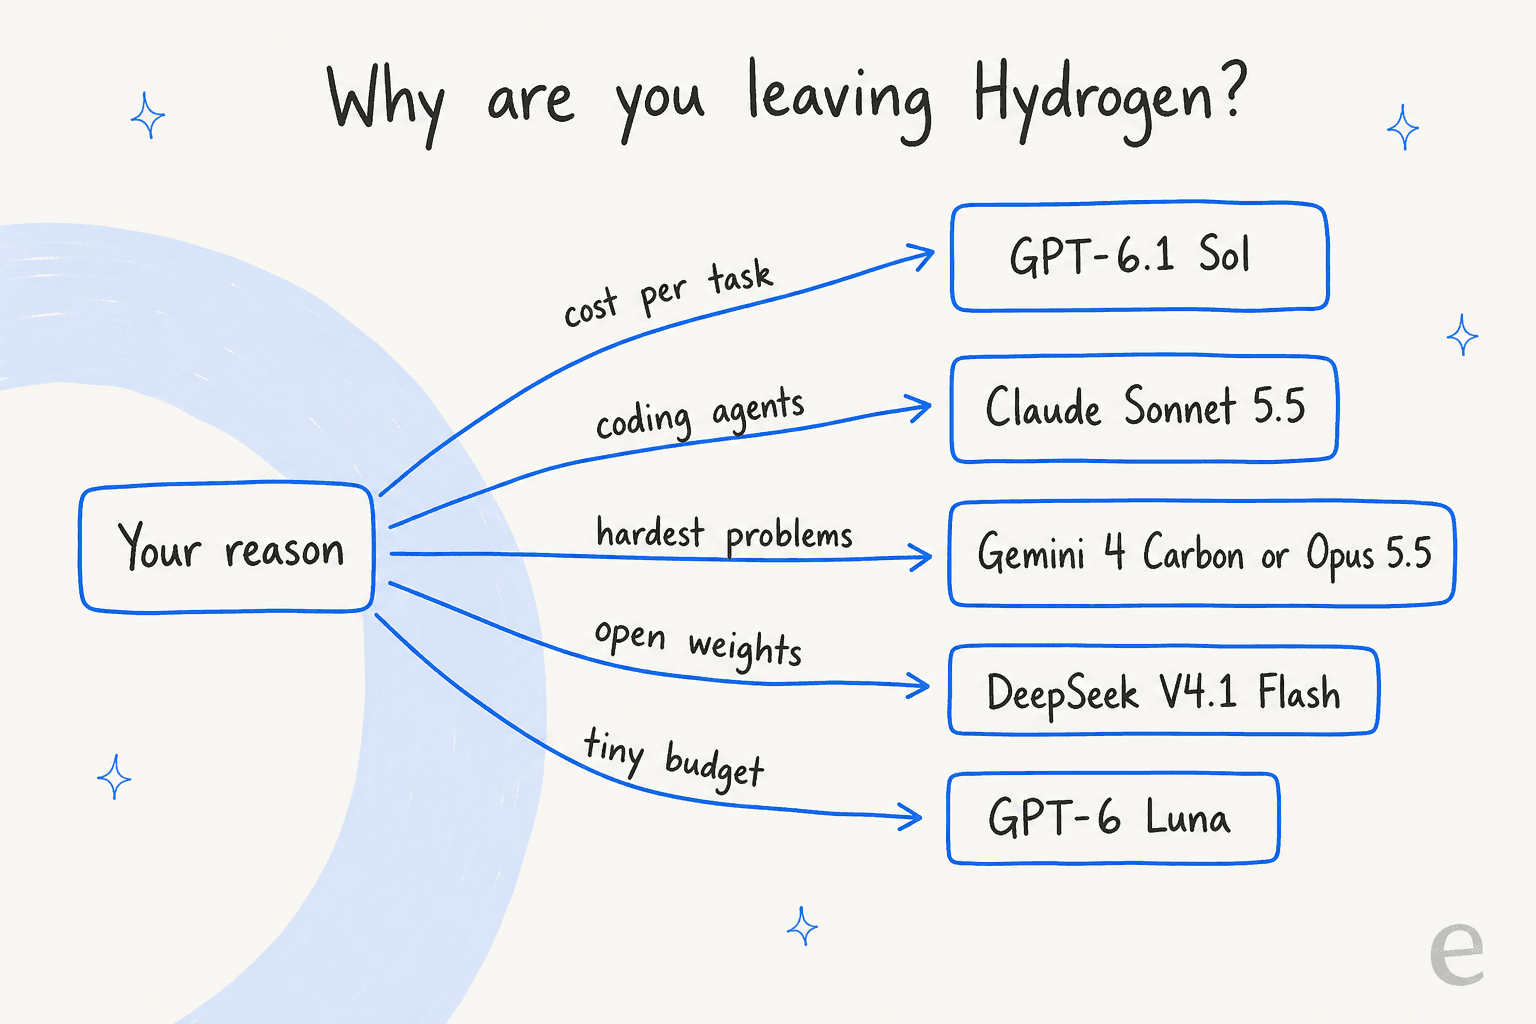
| Si tu razón es... | Elige | Por qué |
|---|---|---|
| La factura en high o xhigh | GPT-6.1 Sol | 52 por $0.76 frente al 51 de Hydrogen por $1.87 |
| Trabajo rápido y barato de nivel medio | GPT-6.1 Terra | 42 por $0.26 frente al 41 de Hydrogen medium por $0.80 |
| Agentes de código o de uso del ordenador | Claude Sonnet 5.5 | Gana Terminal-Bench 4.1 y OSWorld-2.1 en la propia tabla de Google |
| Problemas más difíciles, quedándote en Google | Gemini 4 Carbon | 58 en medium, misma API |
| Problemas más difíciles, cualquier proveedor | Claude Opus 5.5 | 59 en max, precio bajo de lectura en caché |
| Factura más baja | DeepSeek V4.1 Flash | $480 frente a $5,250 en la factura de ejemplo |
| Pesos abiertos en el nivel más alto | Kimi K3.1 Pro | Mejor modelo de pesos abiertos de su clase en AA |
| Triaje y enrutamiento | GPT-6 Luna | $0.15 por tarea |
Tampoco tienes que elegir solo uno. Un comentarista en el hilo de lanzamiento describió la configuración que recomendaría para la mayoría de agentes:
"I have found it a good subagent workhorse for code implementation, with some higher level model doing the spec and review."
Eso es Hydrogen como trabajador y algo como Carbon u Opus como planificador, el mismo reparto que Google construyó en Orchestrator. Si la factura es el problema, cambia el trabajador por Sol o Terra y mantén la estructura.
¿Cómo pruebas una alternativa antes de cambiar?
Los benchmarks clasifican modelos en las tareas de otro. Antes de mover tráfico de producción, ejecuta las tuyas:
- Saca 50 a 100 solicitudes reales de tus registros, incluyendo las incómodas.
- Prueba cada candidato en dos niveles de esfuerzo, porque el nivel mueve el coste más que el modelo.
- Mide el coste por tarea exitosa, contando los reintentos, no el coste por millón de tokens.
- Revisa las trampas de migración: Hydrogen ignora los ajustes de muestreo, Claude rechaza un
temperaturedistinto del predeterminado, y OpenAI quiere la Responses API para llamadas a herramientas. Un prompt afinado para uno no se traslada sin cambios. - Mantén un modelo de respaldo conectado, para que el próximo cambio de precio o caída sea un cambio de configuración, no una reescritura.
El propio consejo de Google para Hydrogen dice lo mismo: ejecuta tus evaluaciones "at all four levels" antes de decidirte por uno.
Si el modelo es para una cola de soporte
Mucha gente que compara alternativas a Hydrogen en realidad está construyendo un bot de soporte. Llevo años conectando agentes de IA a helpdesks en vivo, y el modelo rara vez es lo que falla primero; las reglas que lo rodean sí lo son. Los fallos que veo son un bot que promete algo que no puede hacer, o que no traspasa cuando debería. Un modelo más grande no arregla eso. Reglas claras de escalamiento y respuestas basadas en tu propio centro de ayuda y tickets anteriores sí lo hacen, y así es también como mantienes bajas las alucinaciones de IA, sea cual sea el modelo que escriba las palabras.
SE Ranking es un buen ejemplo de esa capa. Ejecuta tres productos en Zendesk con un agente de eesel por producto, respondiendo desde unas 16.800 páginas de conocimiento, y gestionó 4.650 conversaciones en un mes. Reembolsos, extensiones de prueba y solicitudes de hablar con una persona van al equipo con los detalles ya recopilados. Swiftreg, un vendedor de matrículas privadas, responde unos 2.100 tickets de Zendesk al mes desde datos de pedidos en vivo, bajo reglas que escribió su propio equipo. Ninguna de las dos configuraciones depende de qué modelo sea el más rápido esta semana.
Si prefieres trabajar desde una terminal, la CLI de eesel controla el mismo compañero que el panel. Un agente de código como Claude Code puede subir conocimiento aprobado, como artículos de ayuda exportados y respuestas guardadas, ajustar las instrucciones del agente, y hacer preguntas de prueba para revisar las respuestas antes de que nada salga en vivo. Conectar el helpdesk en sí todavía necesita a alguien con acceso de administrador que lo apruebe, y el conocimiento subido no es lo mismo que el probado, así que el paso de prueba se mantiene.
Prueba eesel
Hydrogen, Sol y Sonnet son motores. Si lo que estás construyendo es automatización de soporte, eesel es el compañero de helpdesk con IA que hace el trabajo sobre modelos como estos. Se conecta al helpdesk que ya usas, sea Zendesk, Freshdesk u otro, aprende de tus tickets anteriores, macros y centro de ayuda, y sigue las reglas de traspaso que tú fijes. Antes de responder a nadie, puedes ejecutarlo contra tus tickets reales anteriores y comparar sus respuestas con lo que envió tu equipo.
El precio es un plan de créditos mensual fijo: un ticket o chat es un crédito, desde $299 al mes por 500 créditos. No hay cargo por token, así que tu factura no se mueve cuando Google u OpenAI cambian las suyas. Puedes probar eesel gratis con 100 créditos durante 7 días en una parte de tu cola.