

Gemini 4 Neon cuesta $3.00 por 1M de tokens de entrada y $15.00 por 1M de tokens de salida, sin nivel gratuito, y los tokens de pensamiento se cobran como salida. El precio de etiqueta esconde la factura real: en Artificial Analysis una tarea cuesta $0.75 en low, $1.90 en medium, $3.74 en el high por defecto y $6.44 en xhigh. Batch y Flex reducen la tarifa a la mitad, Priority suma 80%, y un acierto de caché reduce la entrada a $0.15. El precio de lanzamiento de Carbon de $2/$10 termina el 30 de noviembre, así que el argumento a favor de Neon sobre Carbon empieza el 1 de diciembre.
La CLI de eesel permite que un agente de código suba artículos de ayuda aprobados a un compañero de helpdesk de eesel y pruebe sus respuestas con tickets pasados, que es cómo yo comprobaría el coste y el comportamiento de cualquier modelo antes de que responda a un cliente.
Cómo puse precio a Gemini 4 Neon
Todo lo que lleva un signo de dólar viene de la página de precios de Google, que leí el 19 de noviembre de 2026, el día después del lanzamiento, incluidas las pestañas de Batch, Flex y Priority. Las reglas de caché vienen de la documentación de caché de Google, y las definiciones de los niveles de su página de inferencia Flex. El coste por tarea viene de Artificial Analysis, donde una "tarea" es una tarea de referencia de su índice, no uno de tus tickets o pull requests.
No he ejecutado Neon en mi propia carga de trabajo. Los ejemplos mensuales de abajo usan recuentos de tokens que elegí y marco como suposiciones, así que pon los tuyos en la calculadora. El primer resumen de Neon está aquí, y el análisis del día de lanzamiento tiene el lado de la calidad. Este artículo trata solo del dinero.
¿Cuánto cuesta Gemini 4 Neon por millón de tokens?
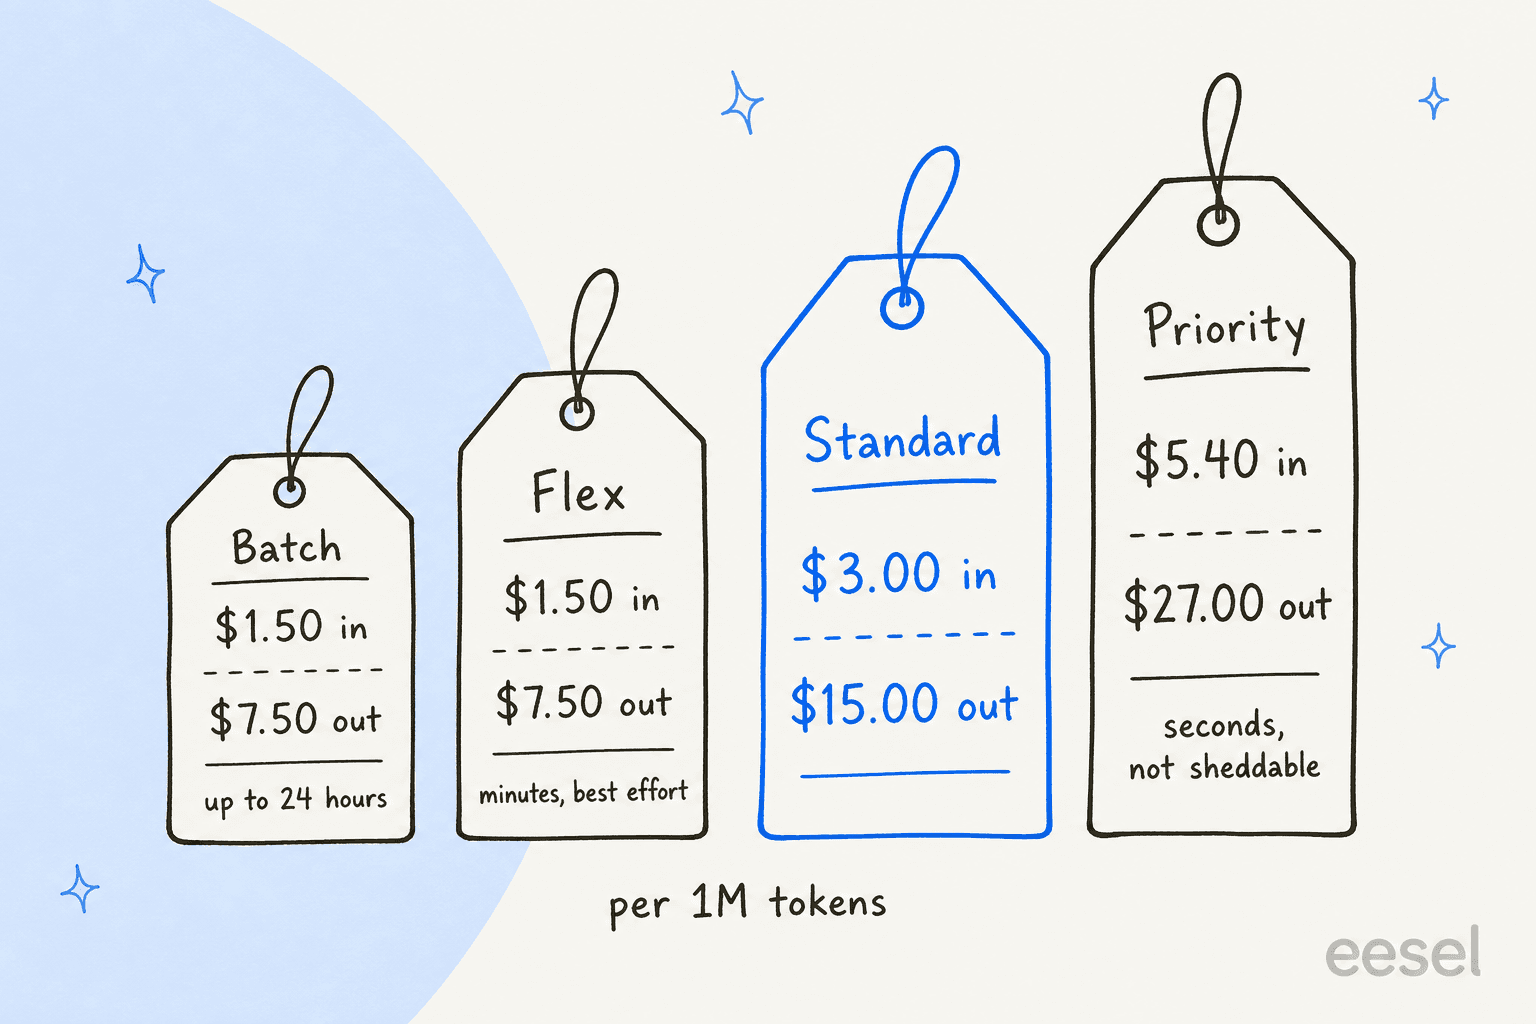
Neon se cobra por millón de tokens en cuatro niveles de servicio. La página de Google indica un único precio para toda la ventana de contexto de 1,048,576 tokens, sin una tarifa más alta para prompts largos.
| Nivel | Entrada | Salida (pensamiento incl.) | Entrada en caché | Velocidad y fiabilidad |
|---|---|---|---|---|
| Batch | $1.50 | $7.50 | $0.075 | Asíncrono, hasta 24 horas |
| Flex (vista previa) | $1.50 | $7.50 | $0.075 | Síncrono, objetivo de 1 a 15 minutos, best effort |
| Standard | $3.00 | $15.00 | $0.15 | Segundos a minutos |
| Priority | $5.40 | $27.00 | $0.27 | Segundos, no reducible |
Tres detalles que no me saltaría:
- Sin nivel gratuito. La columna Free dice "Not available", y Google indica que cada token se cuenta y se cobra. Gemini 4 Hydrogen sí tiene uno, así que es el lugar más barato para prototipar.
- Priority es el más caro. Google lo describe como un 75 a 100% más caro que Standard. En Neon la página muestra
$5.40y$27.00, que es un80%más. - Flex es una ganga con truco. Cuesta lo mismo
$1.50/$7.50que Batch, pero es una función en vista previa con disponibilidad best effort. Google indica que su ahorro apunta a "non-production evals, background agents, and data enrichment", y yo no apoyaría ahí una respuesta de cara al cliente.
Puedes acceder a Neon mediante la API de pago de Gemini o, según la página de novedades de Google, mediante los planes Google AI Pro y Ultra en AI Studio. El acceso por suscripción, como Google AI Ultra, es una factura distinta de la API, así que lo dejo fuera de las cuentas aquí.
¿Cuánto cuesta realmente una tarea en Gemini 4 Neon?
Los precios por token te dicen la tarifa, no la factura, porque un modelo que piensa más tiempo escribe más tokens de salida. Aquí están los datos de Artificial Analysis por configuración para Neon:
| Nivel de pensamiento | Puntuación del índice | Coste por tarea | Minutos por tarea | Tokens de salida por tarea |
|---|---|---|---|---|
| low | 44.1 | $0.75 | 3.7 | 21,726 |
| medium | 54.9 | $1.90 | 8.3 | 50,000 |
| high (por defecto) | 59.6 | $3.74 | 14.8 | 90,188 |
| xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
La puntuación por dólar cae rápido. De medium a high pagas $1.84 más por 4.7 puntos de índice. De high a xhigh pagas $2.70 más por 1.8 puntos y esperas 6.7 minutos extra. La propia recomendación de Google es ejecutar tus evaluaciones en los cuatro niveles y "pick the lowest thinking_level that meets your quality bar", que es la forma correcta de leer esta tabla.
Esta es la parte que encontré más útil. Multiplica los tokens de salida por $15 y high sale a unos $1.35 de los $3.74, cerca del 36%. Los otros $2.39 son entrada, el contexto que un agente vuelve a leer en cada turno. Asumo que Artificial Analysis cobra al precio de lista, así que trata la división como una guía aproximada. Pero apunta en la misma dirección en cada nivel: en el trabajo de agentes, el lado de la entrada es la factura más grande, y la tasa de caché importa más que el precio de salida.
¿Es Gemini 4 Neon más barato que Carbon?
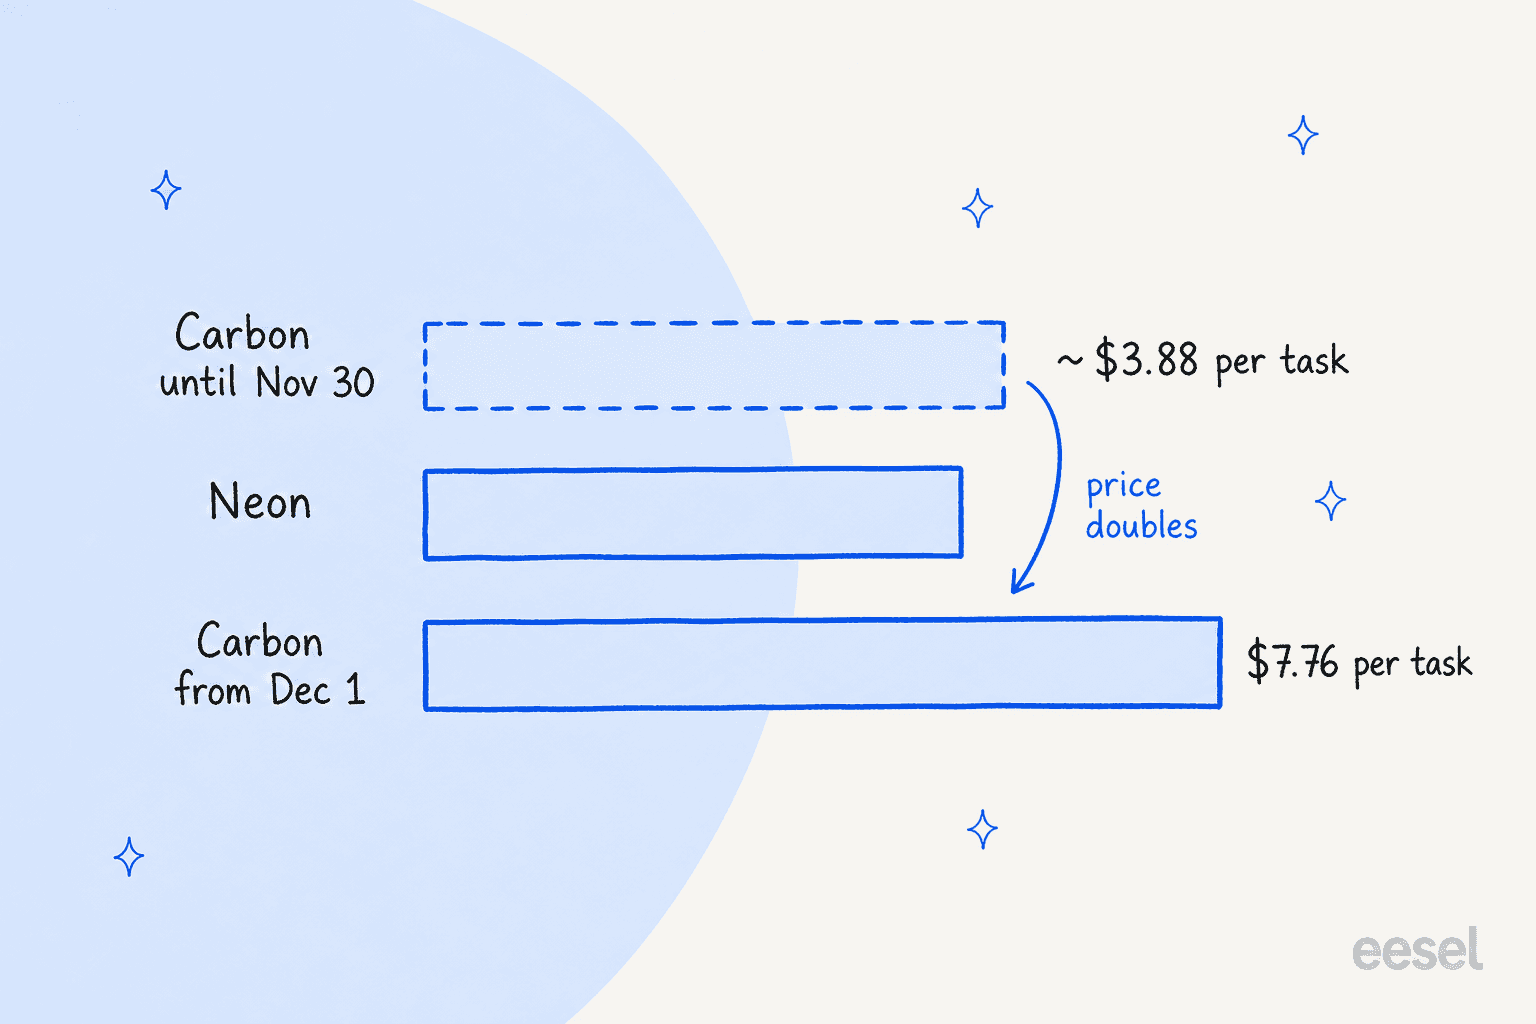
El 1 de diciembre, sí, aproximadamente a la mitad. Hasta entonces, está cerca de un empate.
Gemini 4 Carbon y Argon llevan un precio de lanzamiento en la página de Google: $2.00 de entrada y $10.00 de salida "through November 30, 2026", luego $4.00 y $20.00 desde el 1 de diciembre. La fila de Neon no tiene fecha de fin ni escalón.
El coste de Artificial Analysis para Carbon, $7.76 por tarea, está calculado al precio de diciembre. Su página de Carbon dice que Carbon "costs $4.00 per 1M input tokens and $20.00 per 1M output tokens". Ambas tarifas se duplican el 1 de diciembre, así que el mismo trabajo cuesta la mitad hasta entonces. Según mi aritmética, eso es cerca de $3.88 por tarea hasta el 30 de noviembre, frente a los $3.74 de Neon.
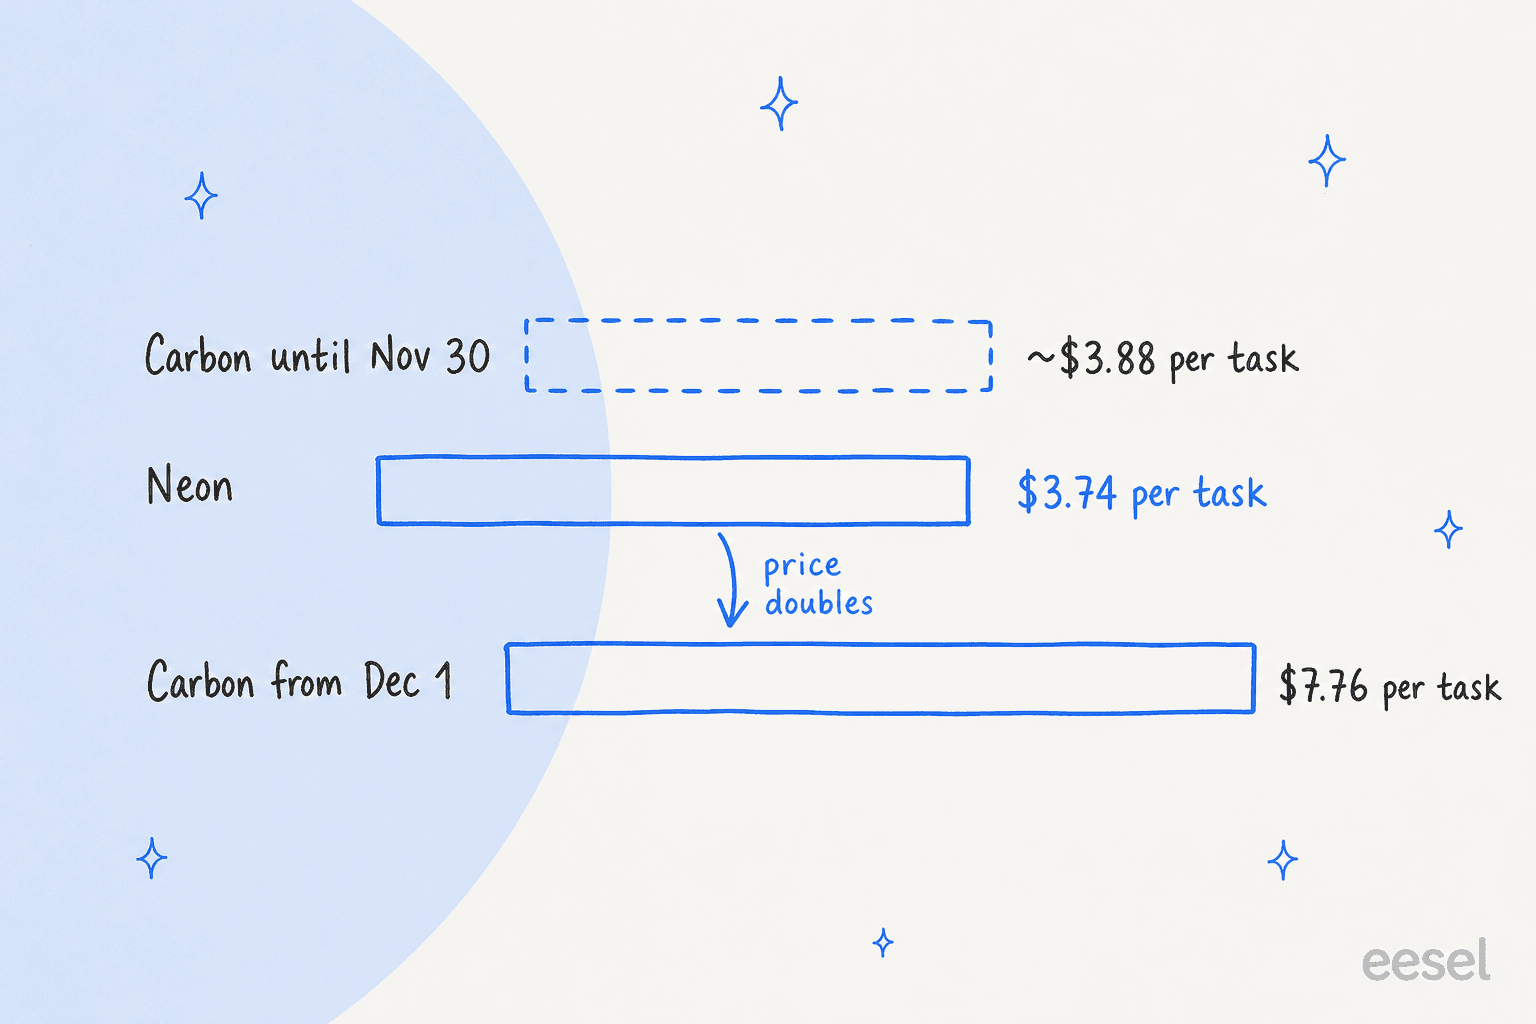
Los $3.88 son mi estimación, no una cifra de ninguna de las dos empresas. Asume que Carbon escribe los mismos tokens por tarea antes y después del cambio de precio, lo que debería pasar porque el modelo no cambia. La propia afirmación de lanzamiento de Google es un 32% menos de coste por tarea que Carbon, y el precio de lista de diciembre hace que la brecha sea aún mayor que eso.
Lo que haría yo: si estás probando Carbon ahora, presupuesta al precio de diciembre, no al promocional. Un lector de Hacker News notó el posicionamiento incómodo el día del lanzamiento:
"So it's better and cheaper than the recently released Carbon? So Carbon is already deprecated, or?"

No está obsoleto. Está puesto a precio de promoción hasta que termine el mes, y Neon es el modelo con el precio estable. Mi análisis de Carbon cubre dónde Carbon sigue ganando, y la entrada de precios de Argon muestra que comparte los escalones de precio de Carbon.
¿Cómo se compara Neon con Astra, Sol y Opus en coste?
No muy bien en precio. Por tarea, Neon es más caro que los modelos de OpenAI y más barato que la configuración tope de Anthropic, cuyas tarifas están en la guía de precios de la API de Anthropic. Aquí están los mismos datos de Artificial Analysis, en la configuración de mejor puntuación o por defecto de cada modelo:
| Modelo y configuración | Puntuación del índice | Coste por tarea |
|---|---|---|
| GPT-6.2 Sol max | 57.3 | $1.01 |
| GPT-6.2 Astra high | 60.1 | $2.07 |
| Gemini 4 Neon high | 59.6 | $3.74 |
| Gemini 4 Hydrogen xhigh | 53.9 | $3.16 |
| Gemini 4 Carbon high (precio de diciembre) | 60.0 | $7.76 |
| Claude Opus 5.5 max | 59.1 | $10.04 |
El precio por token de Astra es más alto que el de Neon, pero aun así es más barato por tarea porque escribe unos 17,800 tokens donde Neon escribe unos 90,200. Una tarifa más barata no significa un modelo más barato, y un lector de Hacker News lo dijo sin rodeos desde el punto de vista del comprador:
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
En coste, solo, estoy de acuerdo. El argumento de Neon es su baja tasa de alucinaciones, que cubrí en el análisis. Si tu pregunta es el precio, el análisis de GPT-6.2 Sol, mi resumen más amplio de alternativas a Gemini y la comparación de OpenAI frente a la API de Gemini son mejores puntos de partida.
¿Cuánto ahorra el caché en Neon?
Un acierto de caché se cobra a $0.15 por millón de tokens en vez de $3.00, así que un 95% menos en esos tokens. El truco es que no puedes activarlo ni dirigirlo. La documentación de Google dice que el caché explícito no está soportado en los modelos Gemini 4, y que el caché implícito "is enabled by default". Tres reglas deciden si obtienes el descuento:
- El mínimo son 4,096 tokens. Los prompts más cortos nunca llegan al caché.
- El orden importa. Google dice que pongas "large and common contents at the beginning of your prompt" y envíes prefijos similares cerca en el tiempo.
- Los bucles de agentes tienen un suelo. En uso multi-turno, Gemini cachea toda la solicitud anterior solo si la nueva solicitud añade al menos 2,050 tokens. Para añadidos más pequeños, "re-processes the last 2,050 tokens of the previous request at the standard input rate". La mayoría de los turnos de agentes superan esa barra, pero un bot charlatán con respuestas cortas puede no hacerlo.
Esto es lo que vale eso en un documento largo. Digamos que cargas un paquete de contrato de 500,000 tokens y haces 100 preguntas, cada una respondida en 2,000 tokens. Estas son mis suposiciones, con precios a la tarifa Standard:
| Escenario | Coste de entrada | Coste de salida | Total para 100 preguntas |
|---|---|---|---|
| Cada pregunta sin caché | $150.00 | $3.00 | $153.00 |
| Primera sin caché, 99 aciertos de caché | $1.50 + $7.43 | $3.00 | $11.93 |
Eso es un ahorro del 92%, pero solo si cada seguimiento acierta el caché, algo que el caché implícito no promete. Lee usage.total_cached_tokens en tus primeras ejecuciones para ver qué obtienes realmente antes de planificar en torno a eso.
¿Cuánto cuesta un mes realista?
Depende de tres cifras que controlas: tokens de entrada, tokens de salida y proporción de caché. Construí una calculadora para que puedas poner las tuyas. Calcula la misma carga de trabajo en Neon, Hydrogen y los dos precios de Carbon.
Los valores por defecto son mi carga de trabajo ilustrativa de tickets de soporte: 5,000 solicitudes al mes, 6,000 tokens de entrada cada una con un prefijo en caché del 75%, y 1,500 tokens de salida incluido el pensamiento. En Standard eso es cerca de $0.028 por solicitud y $138 al mes en Neon. El mismo ticket cuesta cerca de $0.014 en Hydrogen y, desde diciembre, cerca de $0.037 en Carbon.
Otras tres cargas de trabajo, con el mismo método:
| Carga de trabajo (mis suposiciones) | Neon, Standard | Lo mismo en Batch o Flex |
|---|---|---|
| 5,000 respuestas de soporte, 6,000 de entrada (75% en caché), 1,500 de salida | $138 | $69 |
| 5,000 respuestas de soporte, sin aciertos de caché | $202 | $101 |
200 tareas de agente en high, a los $3.74 de Artificial Analysis | $748 | $374 (mi mitad) |
La fila sin caché es la que hay que mirar. Es la misma lógica que el coste por ticket, donde la unidad por la que divides importa más que la tarifa del titular. Perder el caché añade un 46% a la factura de soporte, y pasa en silencio si tu prompt está por debajo de 4,096 tokens o tu prompt de sistema cambia en cada solicitud.
¿Qué más aparece en una factura de Neon?
Cuatro cosas quedan fuera de la tarifa por token.
- Grounding de búsqueda. Google da 5,000 solicitudes de búsqueda gratis al mes, compartidas entre todos los modelos Gemini 3 y más nuevos, y luego cobra
$14por 1,000 solicitudes, con un tope diario de 1,500 solicitudes. Google también indica que un prompt puede disparar varias búsquedas, y se cobra cada una. Lo mismo aplica al grounding de Maps. - Sobrecarga de herramientas. Google dice que se cobra cada token que el modelo procesa, "including thinking tokens and internal tool system instructions and function declarations when using grounding". Las listas de herramientas largas también son tokens de entrada.
- Salida que no leíste. Los tokens de pensamiento se cobran incluso cuando solo ves una respuesta corta. Pon
max_output_tokenslo bastante alto para que el límite no corte una ejecución de razonamiento, pero vigila los campos de uso. - Decodificación larga. La salida puede superar los 65,536 tokens hasta la ventana completa, y cada uno de esos tokens cuesta
$15por millón.
¿Qué tier y nivel de Neon debería elegir?
Elige la combinación más barata que cumpla tu barra de calidad, y después mídela durante una semana. Mis puntos de partida:
- Chat de cliente en vivo o una herramienta de código interactiva: Standard en
medium. Priority cuesta un80%más y solo compra fiabilidad. - Evals nocturnas, backfills, enriquecimiento de datos: Batch para cualquier cosa que pueda esperar un día, Flex para cualquier cosa que necesite la respuesta en minutos. Ambos cuestan
50%menos. - Una tarea de agente difícil donde
highse queda corto:xhigh, por 1.8 puntos de índice más y72%más de coste por tarea. Prueba primero. - La calidad no importa mucho: usa Gemini 3.8 Flash o Hydrogen. Neon no es el modelo para trabajo barato.
Si estás eligiendo un modelo para un agente de IA de soporte, la factura de tokens es la decisión menor. Mi guía de coste de atención al cliente con IA pone la línea del modelo junto al software, las personas y el tiempo de revisión que suelen dominar. Swiftreg, un vendedor británico de placas de matrícula privadas, ejecutó dos agentes de eesel en Zendesk y gestionó cerca de 2,100 tickets entre el 8 de agosto y el 8 de septiembre de 2026, enviando 1,494 respuestas públicas. Sus agentes responden a partir de consultas de pedidos en vivo que escribió el equipo y llevan reglas estrictas sobre qué debe ir a una persona. Esa configuración, no el modelo, decide si una respuesta es correcta, y merece la pena simularlo con tickets pasados antes de pagar por un modelo mejor. Mi lista de los mejores modelos de IA para tickets de soporte es la siguiente parada.
Si tu equipo trabaja en una terminal, la CLI de eesel permite que un agente de código suba artículos de ayuda y macros exportados, ajuste las instrucciones del agente y haga preguntas de prueba antes de salir en vivo. Conectar el helpdesk en sí todavía necesita que alguien con acceso de administrador lo apruebe. El patrón más amplio está en mi artículo sobre CLIs de código agéntico.
Mi veredicto sobre los precios de Gemini 4 Neon
Neon tiene un precio justo y no es barato. Su tarifa es estable, sus niveles son claros, y un carril de Batch o Flex a mitad de precio es útil para trabajo en segundo plano. Pero su coste por tarea depende del nivel de pensamiento que elijas y de si tus prompts aciertan el caché, así que mide ambos antes de comprometerte. Si lo estás comparando con Carbon, espera hasta el 1 de diciembre para comparar precios de lista, y si el coste por tarea es tu única restricción, GPT-6.2 Astra y Sol son más baratos. Para el panorama completo, empieza con el resumen de precios de Gemini, luego la comparación de ChatGPT frente a Gemini.
Probar eesel
Si estás poniendo precio a un modelo porque quieres mejores respuestas en tu cola, el compañero de IA para helpdesk de eesel te da eso sin una decisión de modelo. Aprende de tus tickets pasados y tu centro de ayuda, pasa a una persona cuando la respuesta no está en tus documentos, y puedes probarlo con historial real de tickets antes de que responda a nadie. Funciona dentro de Zendesk, Freshdesk y otros helpdesks, como en el ejemplo de Zendesk de abajo.
El precio es un plan de créditos mensual fijo, con un plan gratis de 100 créditos y sin tarjeta, así que un cambio de precio de un modelo no mueve tu factura. Prueba eesel en una parte de tu cola.