Alternativas a GPT-6 Cyber: 8 opciones y cómo conseguir acceso de verdad

Rama Adi

Katelin Teen
Última edición 6 de noviembre de 2026
La mejor alternativa a GPT-6 Cyber para la mayoría de los equipos de seguridad es Claude Opus 5.5 a través del Cyber Verification Program de Anthropic. Su nivel Red Team terminó 34 de 50 tareas ofensivas sin bloqueos, igualando al modelo con las salvaguardas desactivadas, a $4/$20 por 1M de tokens, una quinta parte de los $20/$100 de GPT-6 Cyber. Si solo revisas tu propio código, el consejo de OpenAI se mantiene: empieza en Daybreak Blue, no en Red. GPT-6 Cyber es la opción correcta solo cuando necesitas exploits que funcionen contra objetivos remotos y puedas esperar una segunda aprobación.
¿Por qué la gente busca alternativas a GPT-6 Cyber?
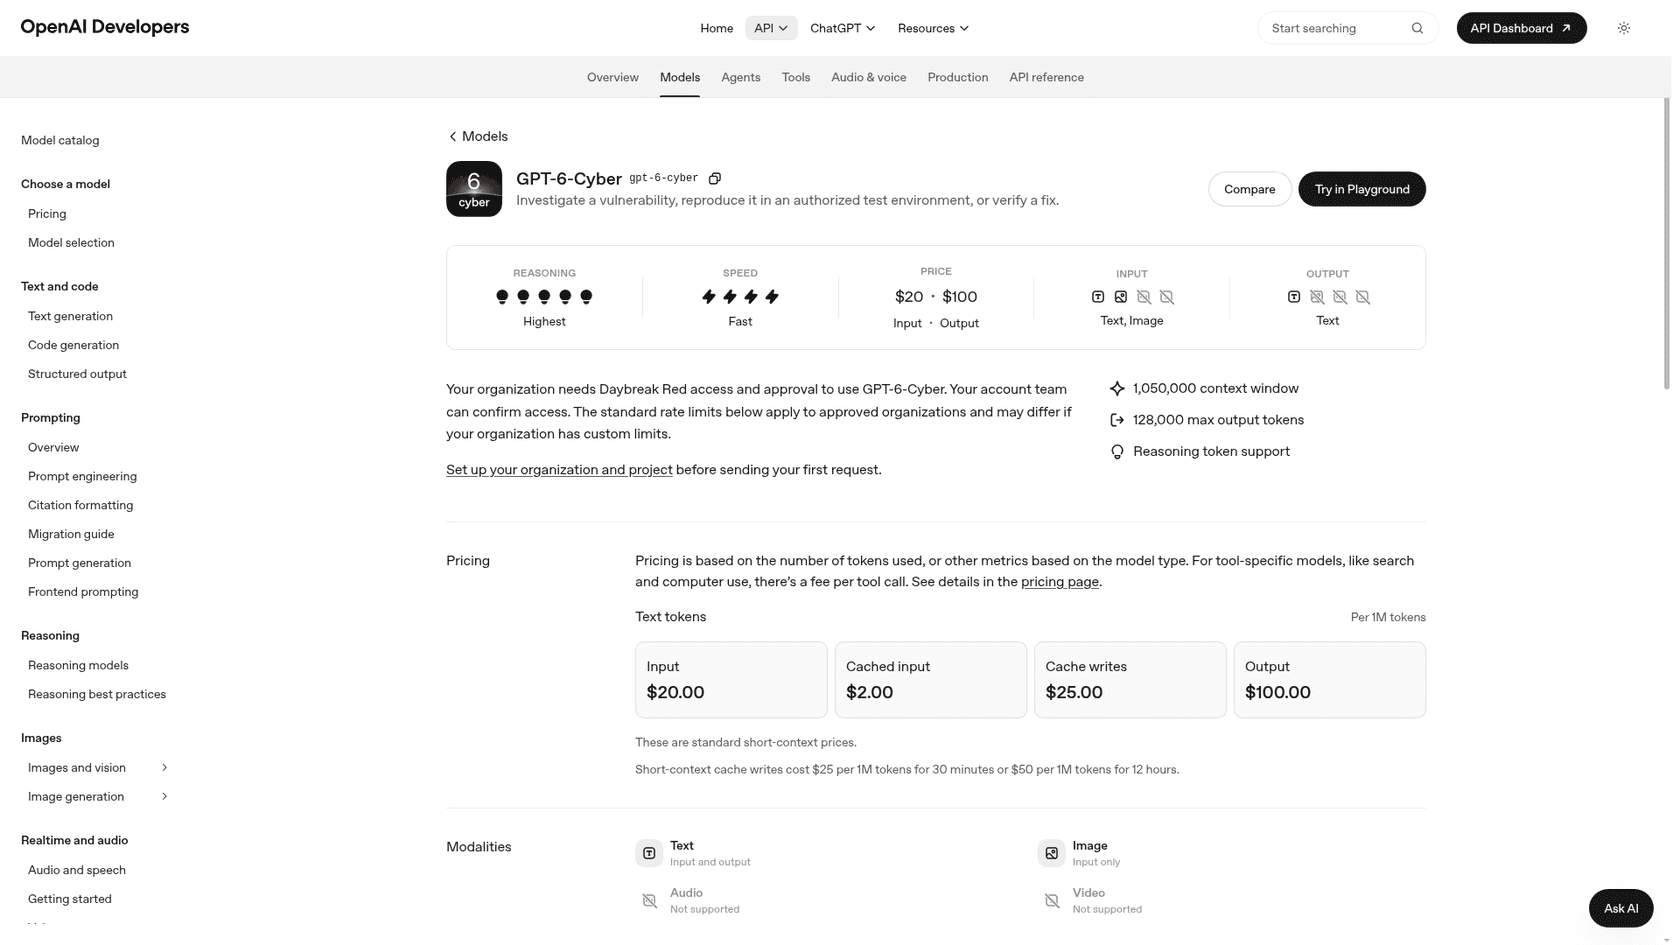
OpenAI lanzó GPT-6 Cyber el 5 de noviembre de 2026, y sobre el papel es el modelo cyber más fuerte del que alguien ha publicado cifras. En ExploitGym puntúa 48,5%, frente al 32,1% de GPT-5.6 Cyber. En el nuevo RemoteExploitBench de OpenAI, GPT-6 Astra bajo Daybreak Blue rechazó todas las tareas, mientras que GPT-6 Cyber completó el 95%.
Tres cosas hacen que la gente busque en otro lado el mismo día:
- La barrera es doble. La guía de acceso de Daybreak dice que GPT-6 Cyber necesita Daybreak Red más una aprobación aparte de GPT-6 Cyber, y el post de lanzamiento dice que empieza con "un grupo selecto" de clientes de Red.
- El precio se duplicó. La tarifa de precios de la API de OpenAI indica que
gpt-6-cybercuesta $20 de entrada y $100 de salida por 1M de tokens. Eso es el doble de GPT-6 Astra, que ya era la tarifa estándar más cara de la tabla. - Está clasificado como Critical. OpenAI clasifica el modelo como Critical en ciberseguridad bajo su Preparedness Framework, y el acceso a la API de Red exige una lista blanca de IP por defecto.
Soy Rama, y construyo las integraciones y APIs detrás de los compañeros de IA de eesel. La mayor parte de mi semana se va en conectar modelos a sistemas reales, y en mi experiencia el papeleo de acceso suele tardar más que el código. Esa es la lente de esta lista. Un modelo que no puedes conseguir aprobado este trimestre no te ayuda, sin importar lo alto que puntúe. Es la misma razón por la que eesel lanza el eesel CLI: un agente de codificación con IA puede cargar conocimiento aprobado en un compañero de eesel y probar sus respuestas desde una terminal, mientras que conectar el propio helpdesk todavía espera la aprobación de un administrador.
La reacción de la comunidad el día del lanzamiento decía lo mismo:
"What's the point of delaying Daybreak Blue availability, when high-impact CVEs are being dropped several times a week?"

Cómo elegí estas alternativas a GPT-6 Cyber
Antes de escribir, le hice a ChatGPT la pregunta que haría un responsable de seguridad, y comprobé qué páginas leyó. Fue directo al Cyber Verification Program de Anthropic, Claude Mythos y Google CodeMender. También dividió la tarea en dos: leer tu propio código fuente y atacar sistemas que ya están en marcha. Mantuve esa división porque decide qué barrera tienes que pasar.
Cada opción de abajo se comprobó contra las propias páginas del proveedor el 6 de noviembre de 2026. Las puntué según:
- Acceso: quién puede solicitarlo y cuánto tarda la revisión.
- Precio: la tarifa publicada por token o por puesto, de la propia página del proveedor.
- Ajuste al trabajo: revisión de código fuente o exploits contra objetivos en vivo.
- Evidencia: benchmarks publicados por el proveedor, con la advertencia de que los laboratorios suelen probar en sus propios benchmarks.
- Condiciones de datos: reglas de retención, porque ahora todo programa cyber exige alguna.
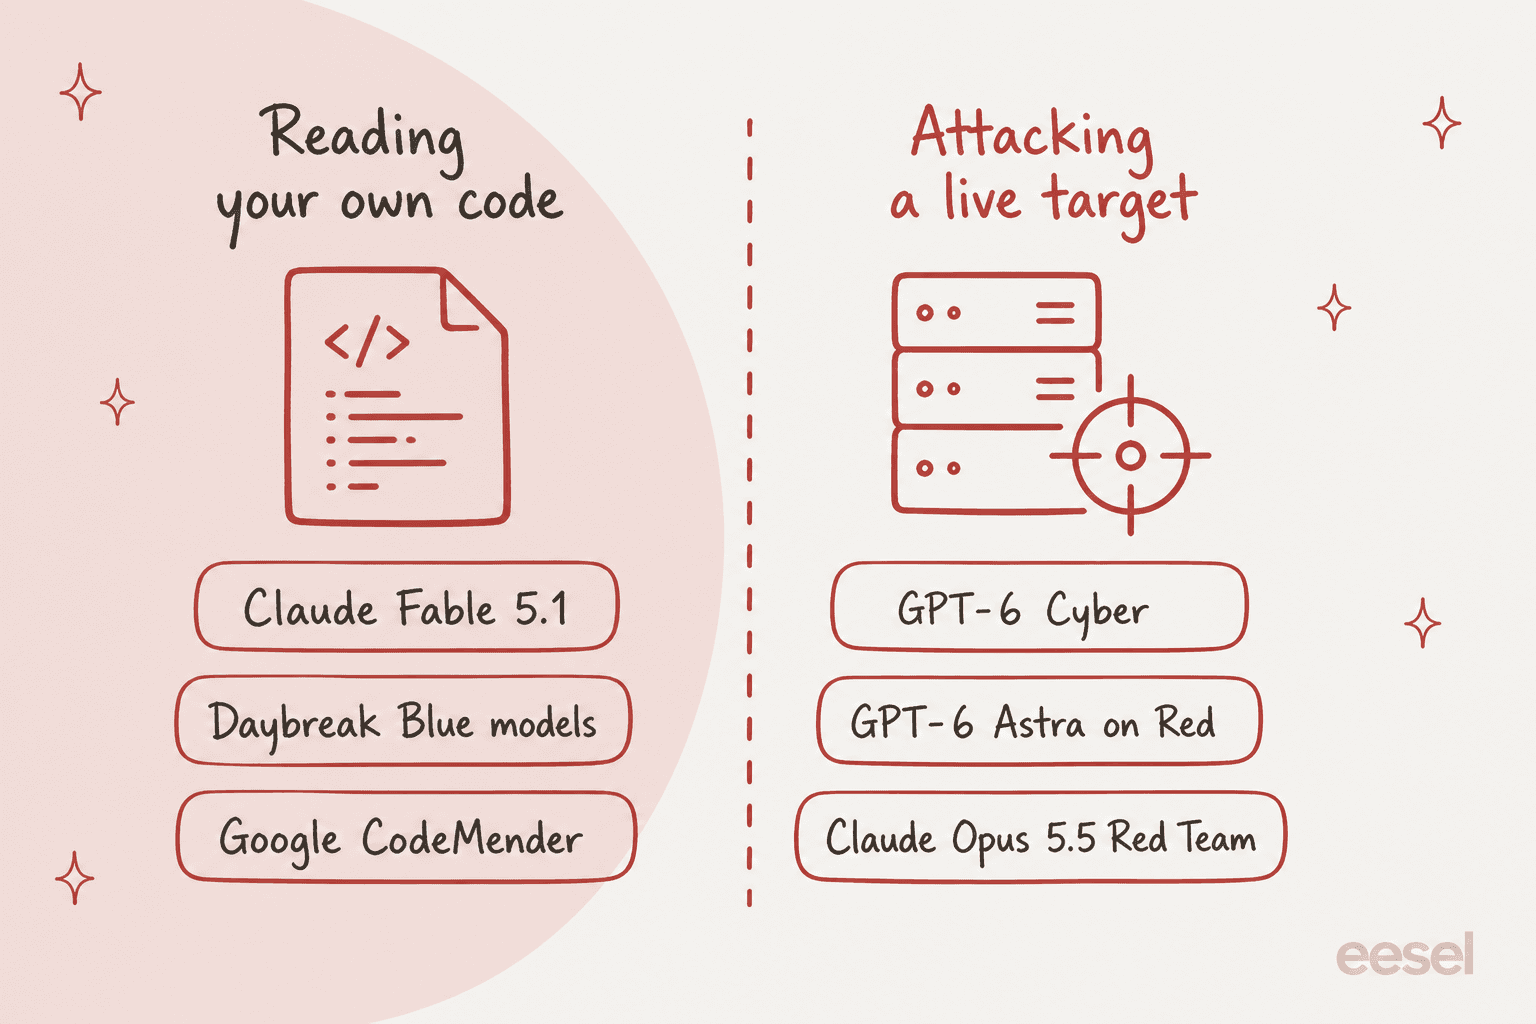
Alternativas a GPT-6 Cyber comparadas
| Opción | Proveedor | Barrera de acceso | Espera típica | Precio por 1M de tokens (entrada / salida) | ¿Exploits contra objetivos en vivo? | Autoalojable | Regla de retención de datos | Mejor para |
|---|---|---|---|---|---|---|---|---|
| GPT-6 Cyber (referencia) | OpenAI | Daybreak Red + aprobación aparte | Primero clientes selectos | $20 / $100 | Sí (95% en RemoteExploitBench) | No | Los usuarios ZDR deben usar Private Safety Processing | Desarrollo de exploits remotos |
| Claude Opus 5.5 + CVP | Anthropic | CVP Defense o Red Team Access | Días (Defense), semanas (Red Team) | $4 / $20 | Sí, en el nivel Red Team | No | Retención obligatoria | La mayoría de los equipos de seguridad |
| Claude Mythos 5.1 | Anthropic | CVP Specialized Access | Revisión en profundidad con el gobierno de EE. UU. | $10 / $50 | Sí | No | Retención de 30 días | Evaluadores de infraestructura crítica |
| GPT-6 Astra en Daybreak Red | OpenAI | Daybreak Red | Revisión de Red | $10 / $50 | Parcialmente (42,4% ExploitGym) | No | Condiciones estándar de OpenAI | Opción de OpenAI a mitad de precio |
| GPT-5.6 Cyber | OpenAI | Solo Daybreak Red | Revisión de Red | No listado por nombre | Sí (32,1% ExploitGym) | No | Condiciones estándar de OpenAI | Organizaciones Red esperando GPT-6 Cyber |
| Modelos de Daybreak Blue | OpenAI | Daybreak Blue | Llave de hardware para personas individuales | GPT-6 Luna $0,10 / $0,50 | No | No | Condiciones estándar de OpenAI | Revisión defensiva y triaje |
| Claude Fable 5.1 | Anthropic | Ninguna | Instantáneo | $10 / $50 | No (se redirige a Opus) | No | Condiciones estándar de Claude | Revisión de código fuente, sin papeleo |
| Google CodeMender | Google Cloud | Ventas; modelos cyber vía Fairwind | Ciclo de ventas | Contactar con ventas | Prueba de concepto en tu propio sandbox | Los exploits se ejecutan localmente | El código se queda en tu entorno | Pipeline de encontrar, probar y parchear |
| GLM-5.3 | Z.ai | Ninguna | Instantáneo | Pesos gratuitos | Sí, sin supervisión de ningún laboratorio | Sí | A definir por ti | Investigación con air gap |
¿Qué alternativa a GPT-6 Cyber se ajusta a tu equipo?
Responde dos preguntas. Cada camino termina en una recomendación y el paso de acceso para empezar hoy.
Reviso código que pertenece a mi equipo, o triajeo informes de vulnerabilidades
No puedo esperar ninguna solicitud
Puedo esperar unos días
Quiero un pipeline gestionado de encontrar y arreglar
Hago pen tests autorizados o ejercicios de red team
Somos una organización y podemos esperar unas semanas
Ya tenemos Daybreak Red
Probamos redes eléctricas, telecom o sistemas de vuelo
Nada puede salir de nuestro laboratorio con air gap
1. Claude Opus 5.5 con el Cyber Verification Program
Lo que obtienes
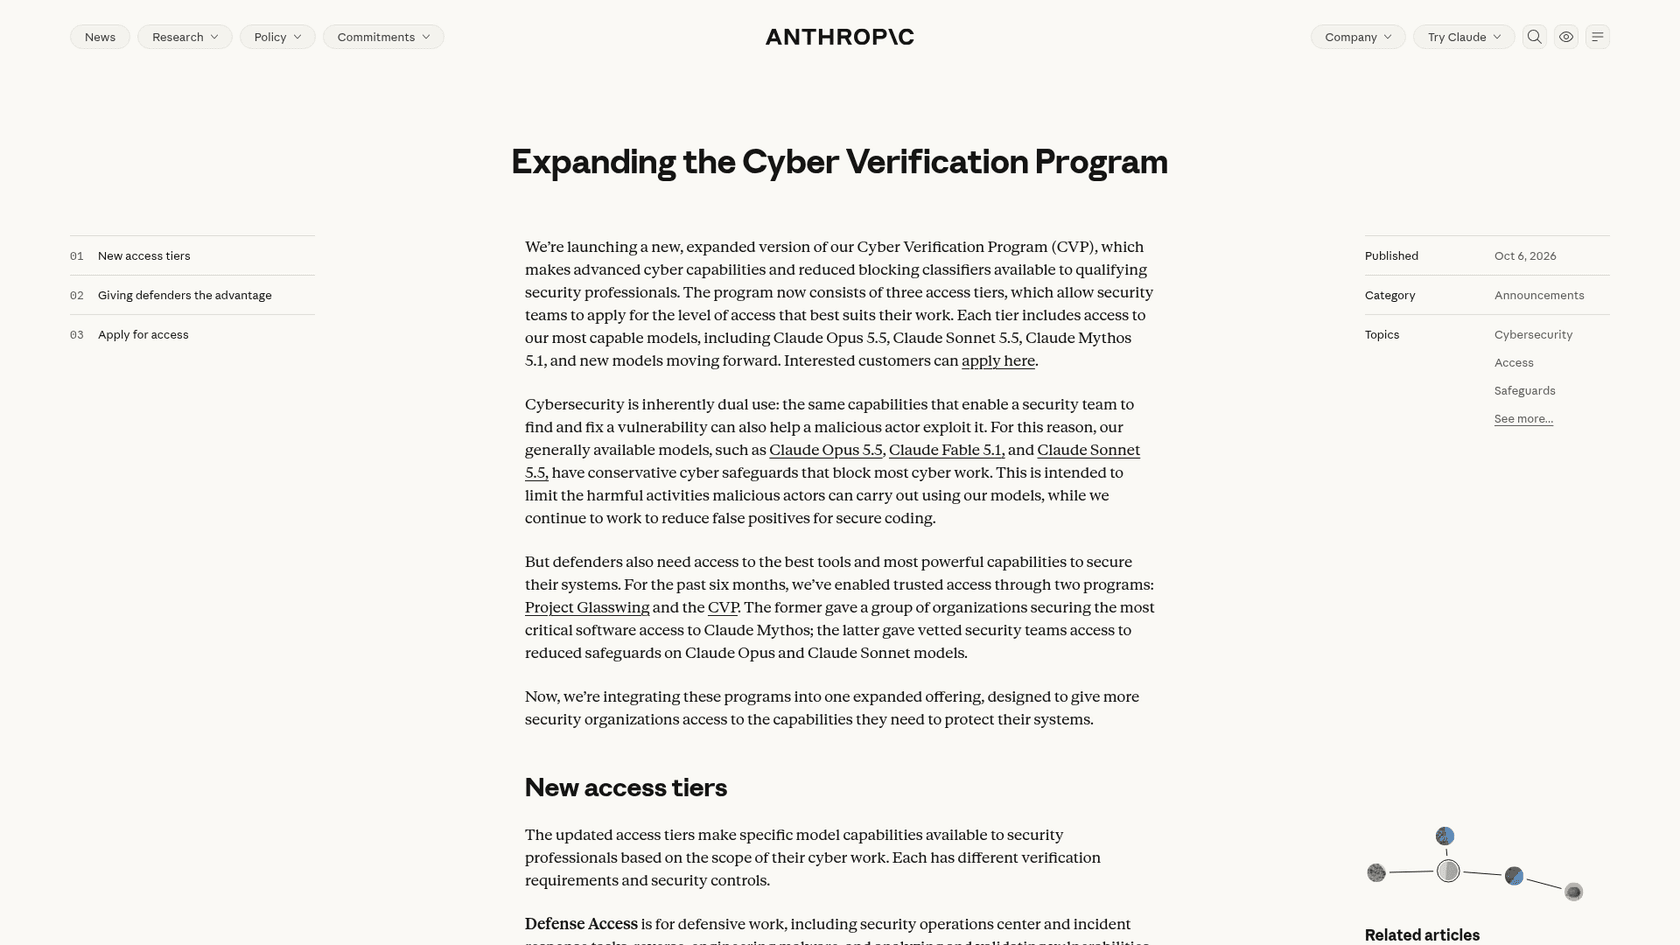
El 6 de octubre de 2026 Anthropic fusionó Project Glasswing y su antiguo programa de verificación en un único Cyber Verification Program con tres niveles. Claude Opus 5.5 es el modelo que la mayoría de los equipos ejecutará sobre él. Anthropic probó los niveles en CyScenarioBench, que mide operaciones cyber de varias etapas:
- Sin CVP: cada tarea se bloqueó en el primer prompt.
- Defense Access: 46 de 50 pruebas se bloquearon en algún momento.
- Red Team Access: sin bloqueos, y 34 de 50 tareas completadas, igualando la tasa de éxito del 67,6% de Opus 5.5 con las salvaguardas desactivadas.
Esa última línea es la que importa. En el nivel correcto, las salvaguardas no cuestan nada medible en este benchmark.
Cómo consigues acceso
Defense Access cubre trabajo de SOC, respuesta a incidentes, ingeniería inversa de malware y validación de vulnerabilidades. Anthropic busca responder esas solicitudes "en pocos días". Red Team Access añade pen testing autorizado y tarda unas semanas, y mientras esperas te colocan en Defense Access. Red Team Access es solo para organizaciones, así que los investigadores individuales no pueden conseguirlo.
Precio
Opus 5.5 cuesta $4 de entrada y $20 de salida por 1M de tokens en la página de precios de Claude. Eso es una quinta parte de la tarifa de GPT-6 Cyber, tanto en entrada como en salida. Consulta los precios de Opus 5.5 para las tarifas de caché y batch.
Dónde se queda corto
La retención de datos es obligatoria para todo miembro del CVP, así que una configuración sin retención de datos tiene que esperar a las Enterprise Frontier Safeguards de Anthropic, que según dice llegan "más adelante este otoño". El CVP funciona en Claude Platform, Vertex AI y Microsoft Foundry, pero en Amazon Bedrock solo para los equipos que cumplen esas salvaguardas. Y CyScenarioBench es el benchmark propio de Anthropic, así que no se compara directamente con el ExploitGym de OpenAI.
Elige esta opción si
eres una organización que necesita pruebas ofensivas y no puede esperar la segunda aprobación de OpenAI. Para una comparación directa de los modelos generales, mira GPT-6 Sol frente a Opus 5.5.
2. Claude Mythos 5.1
Lo que obtienes
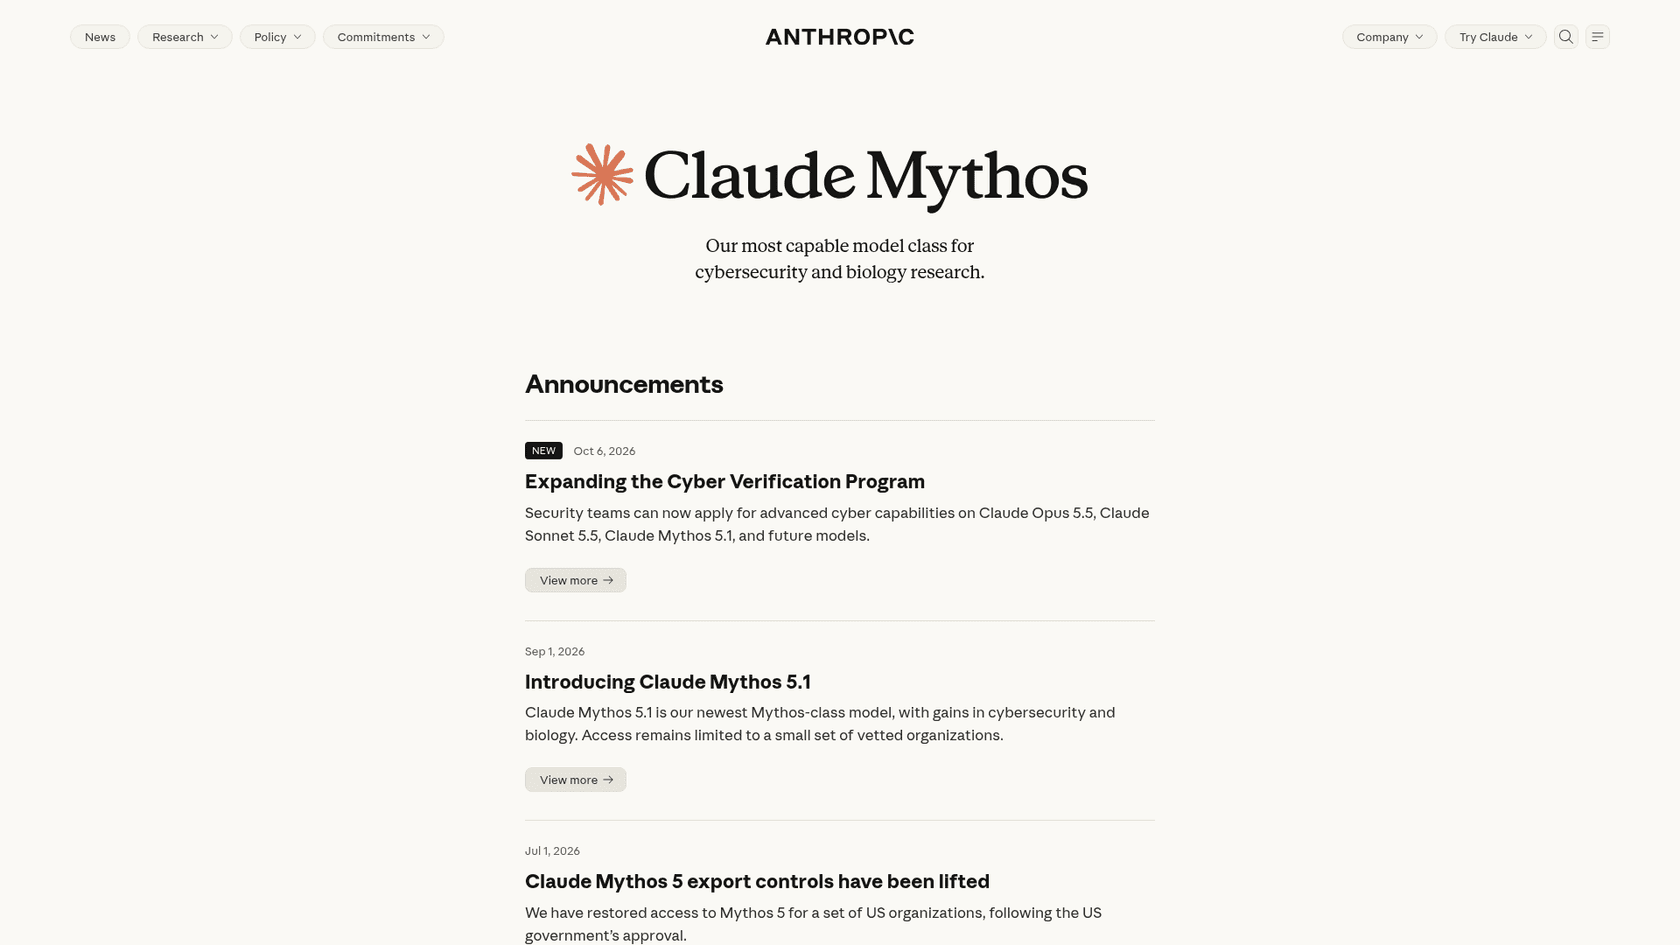
Claude Mythos 5.1 es la correspondencia directa más cercana a GPT-6 Cyber: la "clase de modelo más capaz de Anthropic para investigación en ciberseguridad y biología". Es el mismo modelo base que Claude Fable 5.1, con las salvaguardas cyber relajadas para usuarios verificados. Anthropic dice que los socios de Glasswing que usan modelos Mythos encontraron al menos 129.000 vulnerabilidades verificadas entre abril y julio de 2026. Lo llama un límite inferior, extraído de 33 informes de socios. El producto de escaneo y parcheo de Anthropic, Claude Security, también funciona ahora sobre Mythos 5.1.
Cómo consigues acceso
A través del nivel Specialized Access del CVP. Está reservado para organizaciones que prueban sistemas "que podrían afectar la vida de las personas o alterar mercados", como redes eléctricas, redes de telecomunicaciones y transferencias interbancarias. Anthropic revisa cada caso en profundidad junto con el gobierno de EE. UU. Los miembros existentes de Glasswing pasaron sin necesidad de una nueva aprobación.
Precio
$10 de entrada y $50 de salida por 1M de tokens, lo mismo que GPT-6 Astra y la mitad de GPT-6 Cyber. Más detalles en los precios de Mythos 5.1.
Dónde se queda corto
La mayoría de los equipos no van a calificar. Usar Mythos 5.1 también significa aceptar por defecto una política de retención de datos de 30 días para la supervisión de seguridad. Si no pruebas infraestructura crítica, Opus 5.5 en Red Team Access es la vía realista de Anthropic.
Elige esta opción si
defiendes sistemas en la categoría de infraestructura crítica y quieres la clase de modelo con la que competía OpenAI. Mi análisis de Mythos 5.1 cubre la diferencia de benchmark con Fable.
3. GPT-6 Astra en Daybreak Red
Lo que obtienes
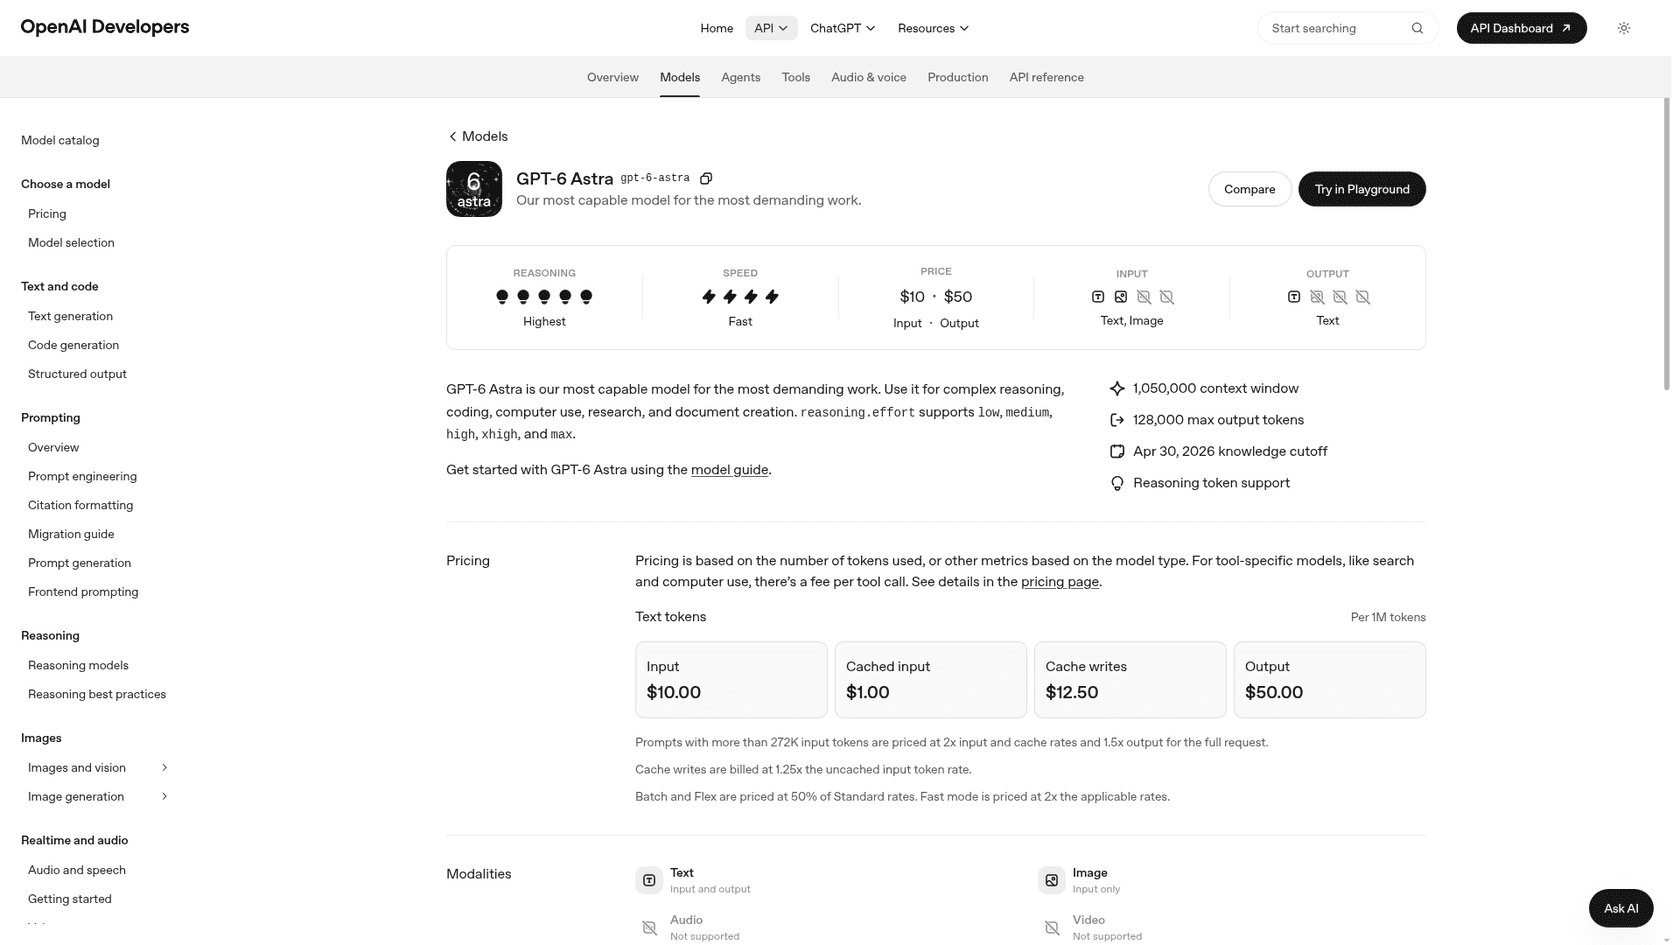
GPT-6 Cyber es "una variante especializada en cyber de GPT-6 Astra", según su system card. Así que el modelo base ya es fuerte. En la propia tabla de ExploitGym de OpenAI, Astra bajo Daybreak Blue puntúa 42,4% frente al 48,5% de GPT-6 Cyber. Eso es cerca del 87% de la puntuación a mitad del precio por token. En la evaluación de pen testing web, Astra encontró el 32,0% de las vulnerabilidades frente al 40,3% de Cyber.
Cómo consigues acceso
La guía de acceso lista los rechazos reducidos en Astra como una función de Daybreak Red. En Blue, Astra mantiene las salvaguardas estándar, aunque OpenAI dice que está ampliando una alpha de Blue para Astra. Fíjate en la advertencia de las cifras: con las salvaguardas estándar activadas, Astra puntuó 0,0% en ExploitGym.
Precio
$10 de entrada y $50 de salida por 1M de tokens, con entrada en caché a $1. Mira los precios de GPT-6 Astra.
Dónde se queda corto
Astra en Blue rechazó el 100% de las tareas de RemoteExploitBench, así que la explotación remota es exactamente donde le cede el paso a GPT-6 Cyber. Y aun así necesitas Red para los rechazos reducidos.
Elige esta opción si
ya tienes Daybreak Red, tu trabajo es mayormente desarrollo de exploits locales, y prefieres no pagar el doble. Mi análisis de GPT-6 Astra lo cubre como modelo general.
"for code review and security checks I think Astra-6 is really great like it'd go so deep and find bugs so small everybody missed that too with using external skills for review."
4. GPT-5.6 Cyber
Lo que obtienes
La generación anterior, lanzada en agosto. Con el lanzamiento de GPT-6 Cyber, OpenAI puso GPT-5.6 Cyber a disposición de todo cliente de Daybreak Red, sin aprobación aparte del modelo. Puntúa 32,1% en ExploitGym, así que pierdes unos 16 puntos frente a GPT-6 Cyber. En alineación, GPT-5.6 Cyber se mantuvo dentro del alcance en el 94,49% de las pruebas honeypot de OpenAI, frente al 99,93% de GPT-6 Cyber.
Cómo consigues acceso
Solo la aprobación de Daybreak Red. Si ya estás en Red, es la versión que puedes usar hoy mismo.
Precio
La tarifa de precios de OpenAI no lista una fila gpt-5.6-cyber por nombre. Mi post sobre los precios de GPT-5.6 Cyber sigue cómo ha cambiado esa fila.
Dónde se queda corto
La tasa fuera de alcance importa más que la diferencia de benchmark. Alrededor de 5 de cada 100 pruebas honeypot fueron tras servicios que al modelo no se le dijo que tocara, así que mantenlo en un sandbox con revisión de acciones.
Elige esta opción si
tienes Red y quieres empezar esta semana mientras tu aprobación de GPT-6 Cyber está pendiente. La lista anterior de alternativas a GPT-5.6 Cyber muestra cuánto se movió el panorama en tres meses.
5. Modelos de Daybreak Blue (GPT-6 Sol, GPT-6 Luna)
Lo que obtienes
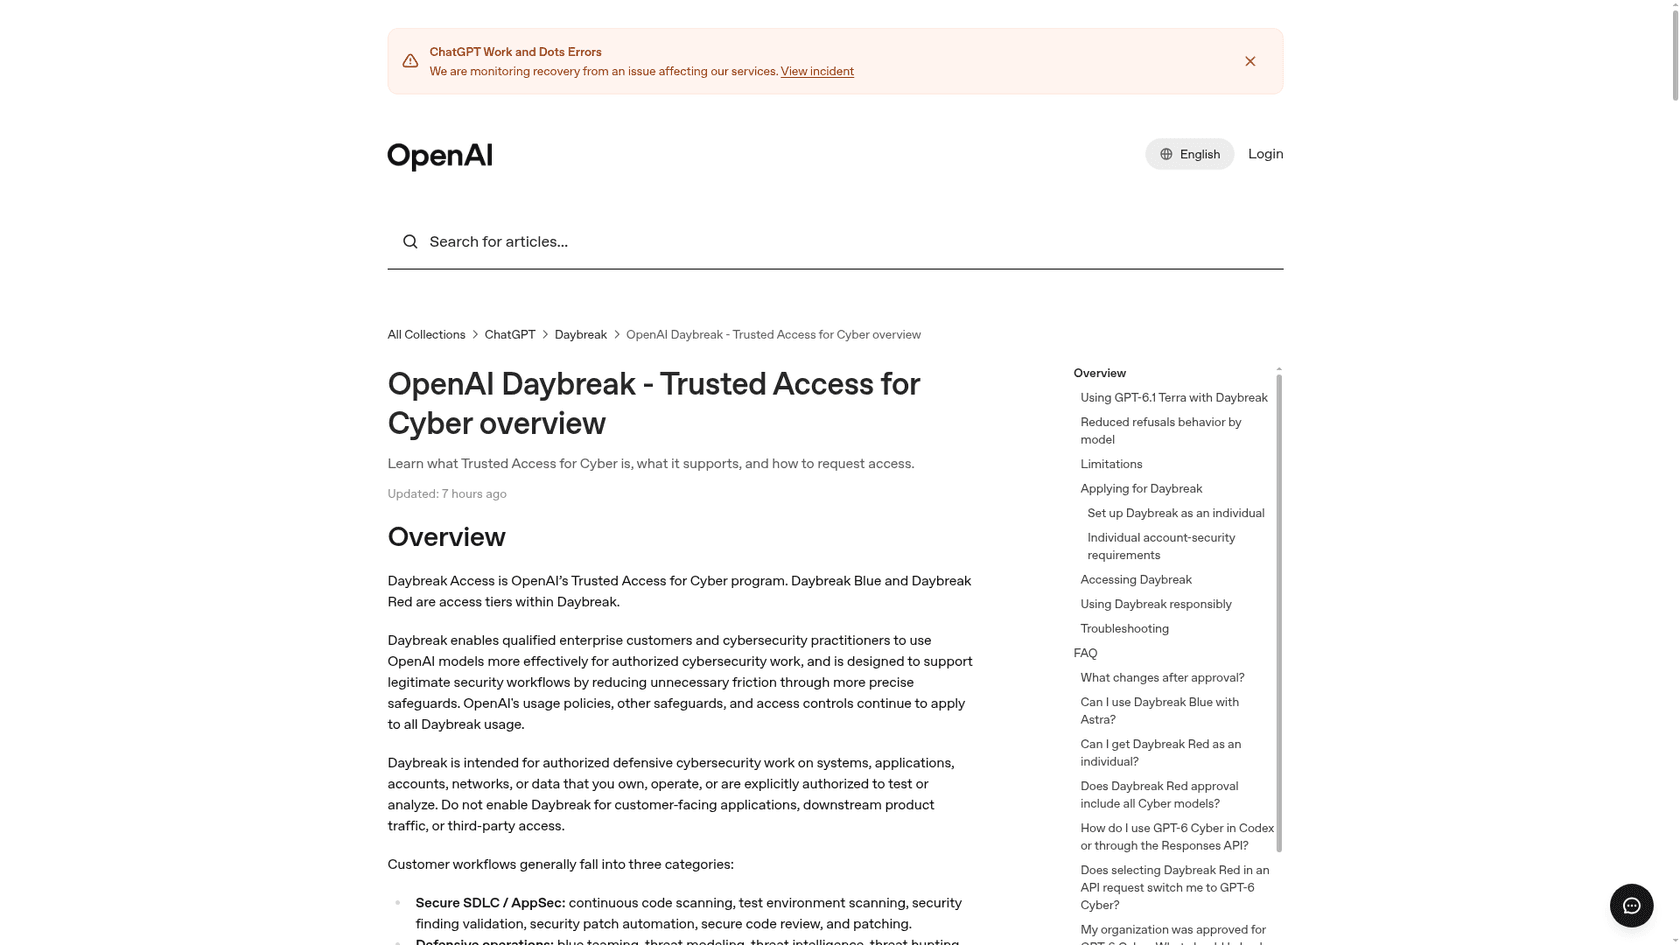
Daybreak Blue da rechazos reducidos en los modelos principales compatibles, incluidos GPT-5.5, GPT-5.6 Sol, GPT-6 Sol y GPT-6 Luna. Cubre revisión de código segura, triaje de vulnerabilidades, ingeniería de detección, respuesta a incidentes, análisis de malware y validación de parches. OpenAI lo llama el punto de partida recomendado para la mayoría de los equipos de seguridad.
Cómo consigues acceso
Las organizaciones solicitan a través del formulario de Daybreak. Las personas individuales solicitan en chatgpt.com/cyber, y necesitan un plan de pago elegible, Advanced Account Security, y al menos una llave de seguridad de hardware FIDO2. Una passkey sincronizada no cuenta. Otra trampa de la guía: la aprobación por sí sola no activa nada. Configuras access_programs.cyber en la Responses API, o activas el interruptor de Daybreak en Codex.
Precio
GPT-6 Luna cuesta $0,10 de entrada y $0,50 de salida por 1M de tokens. GPT-6.1 Sol está en $2 / $10, pero ten en cuenta que 6.1 Sol mantiene las salvaguardas estándar en Blue y solo obtiene rechazos reducidos en Red.
Dónde se queda corto
Sin modelos especializados en cyber, y sin exploits contra objetivos remotos. Astra mantiene aquí las salvaguardas estándar.
Elige esta opción si
tu trabajo es defensivo y vives en las herramientas de OpenAI, especialmente Codex o Codex Security.
"For defensive purposes, do I only need Daybreak Blue? I assume it's much easier to get Daybreak Blue access than Daybreak Red."
Según la guía de OpenAI, la respuesta es mayormente sí.
6. Claude Fable 5.1 (sin solicitud)
Lo que obtienes
Claude Fable 5.1 es el mismo modelo base que Mythos 5.1, lanzado con salvaguardas cyber y de biología. Desde septiembre, esas salvaguardas son más estrechas: Fable 5.1 ya puede identificar vulnerabilidades de software en código fuente. El post del CVP de Anthropic también dice que sus modelos de disponibilidad general pueden seguir haciendo revisión de código, parchear problemas conocidos y encontrar bugs en código fuente propio.
Cómo consigues acceso
Una clave de API normal. Sin formulario, sin revisión.
Precio
$10 de entrada y $50 de salida por 1M de tokens, con lecturas de caché a $0,25. Detalles en los precios de Fable 5.1.
Dónde se queda corto
El pen testing, la generación de exploits y el escaneo de vulnerabilidades basado en binarios todavía se derivan a un modelo Opus cuando se activan las salvaguardas. Para cualquier cosa dirigida a un objetivo en vivo, vuelves a solicitar el CVP.
Elige esta opción si
quieres un modelo de frontera revisando tu código esta misma tarde. Si tu equipo ya trabaja en Claude Code, mira la seguridad de Claude Code para los permisos.
7. Google CodeMender
Lo que obtienes
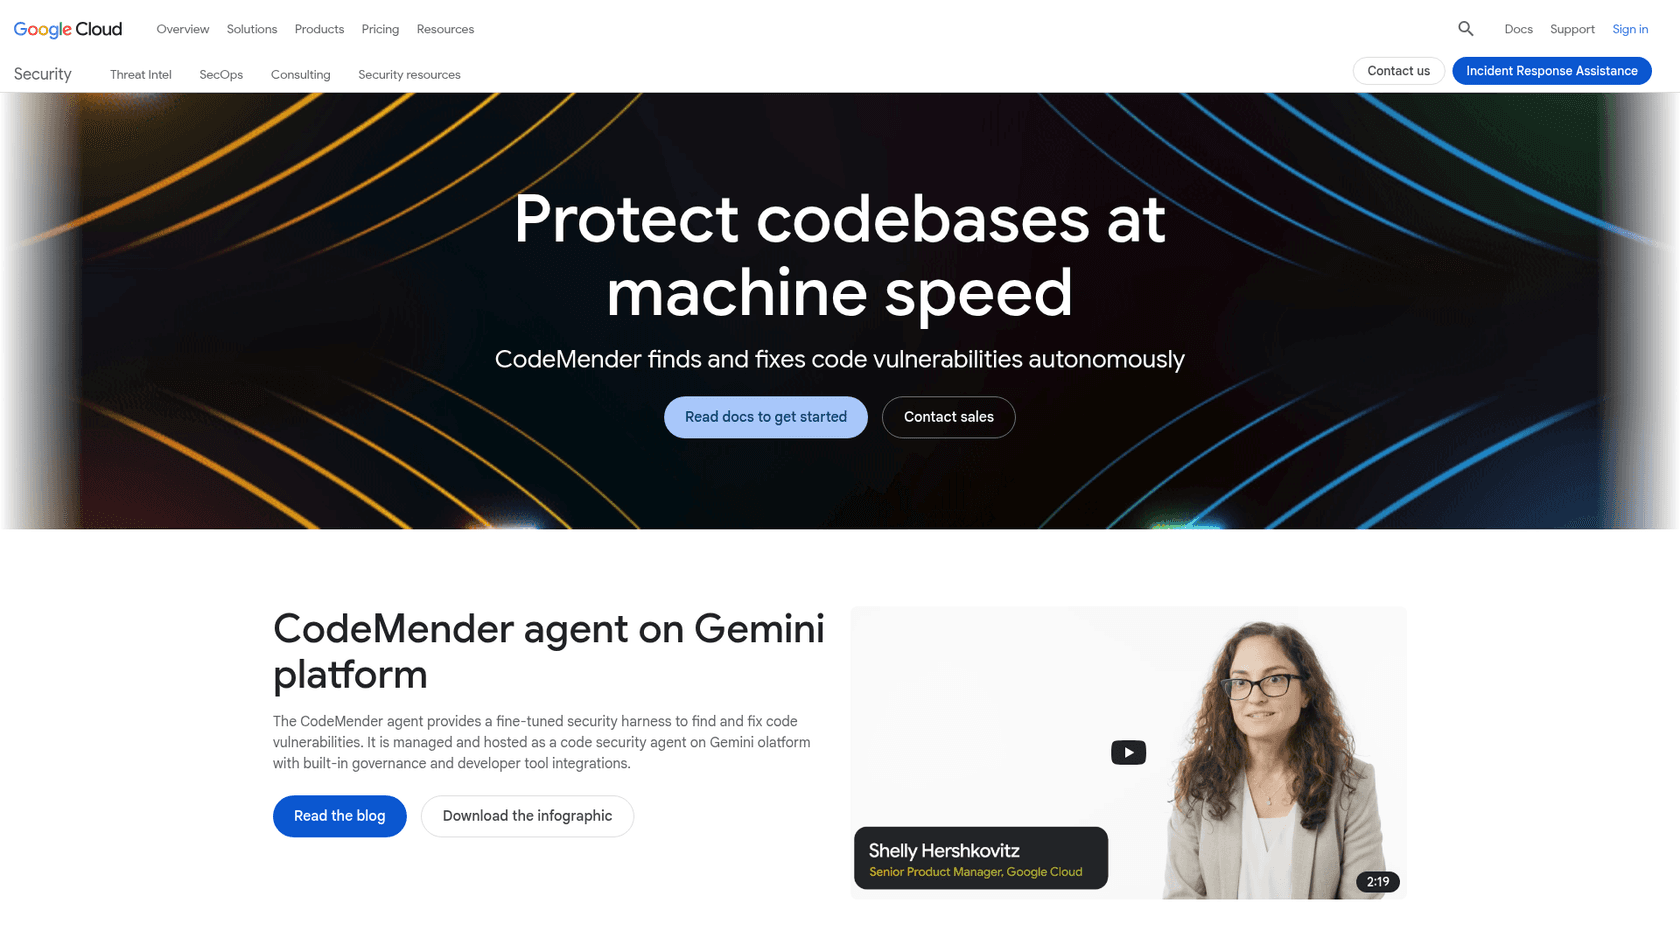
CodeMender es un agente, no un modelo. Escanea, luego prueba, luego parchea. Construye tu código y ejecuta un exploit de prueba de concepto en un sandbox gestionado por el cliente para confirmar que un hallazgo es real. Después escribe una solución, comprueba el parche con un juez LLM, y entrega a los desarrolladores un diff para aprobar. Es compatible con C/C++, Java, Python, TypeScript/JavaScript, Go, Rust y Ruby, y funciona con hallazgos de Wiz.
Cómo consigues acceso
CodeMender funciona sobre la Gemini Enterprise Agent Platform de Google, a través de ventas. Los propios modelos cyber de Google son más restringidos. La página de CodeMender dice que Gemini 3.8 Flash Cyber es exclusivo para clientes y gobiernos dentro del Fairwind Program. Fairwind lista más de 650 socios, y un subconjunto de ellos obtiene Gemini 4 Argon dentro de CodeMender.
Precio
No publicado. La página solo ofrece "Contact sales".
Dónde se queda corto
Está construido para tu propia base de código, no para hacer pen testing en la red de otro. Y sin Fairwind acabas en los modelos generales, no en los cyber de Google.
Elige esta opción si
prefieres tener gestionado el ciclo de encontrar, verificar y arreglar, en lugar de construir tu propio arnés alrededor de un modelo en crudo.
8. GLM-5.3 (pesos abiertos)
Lo que obtienes
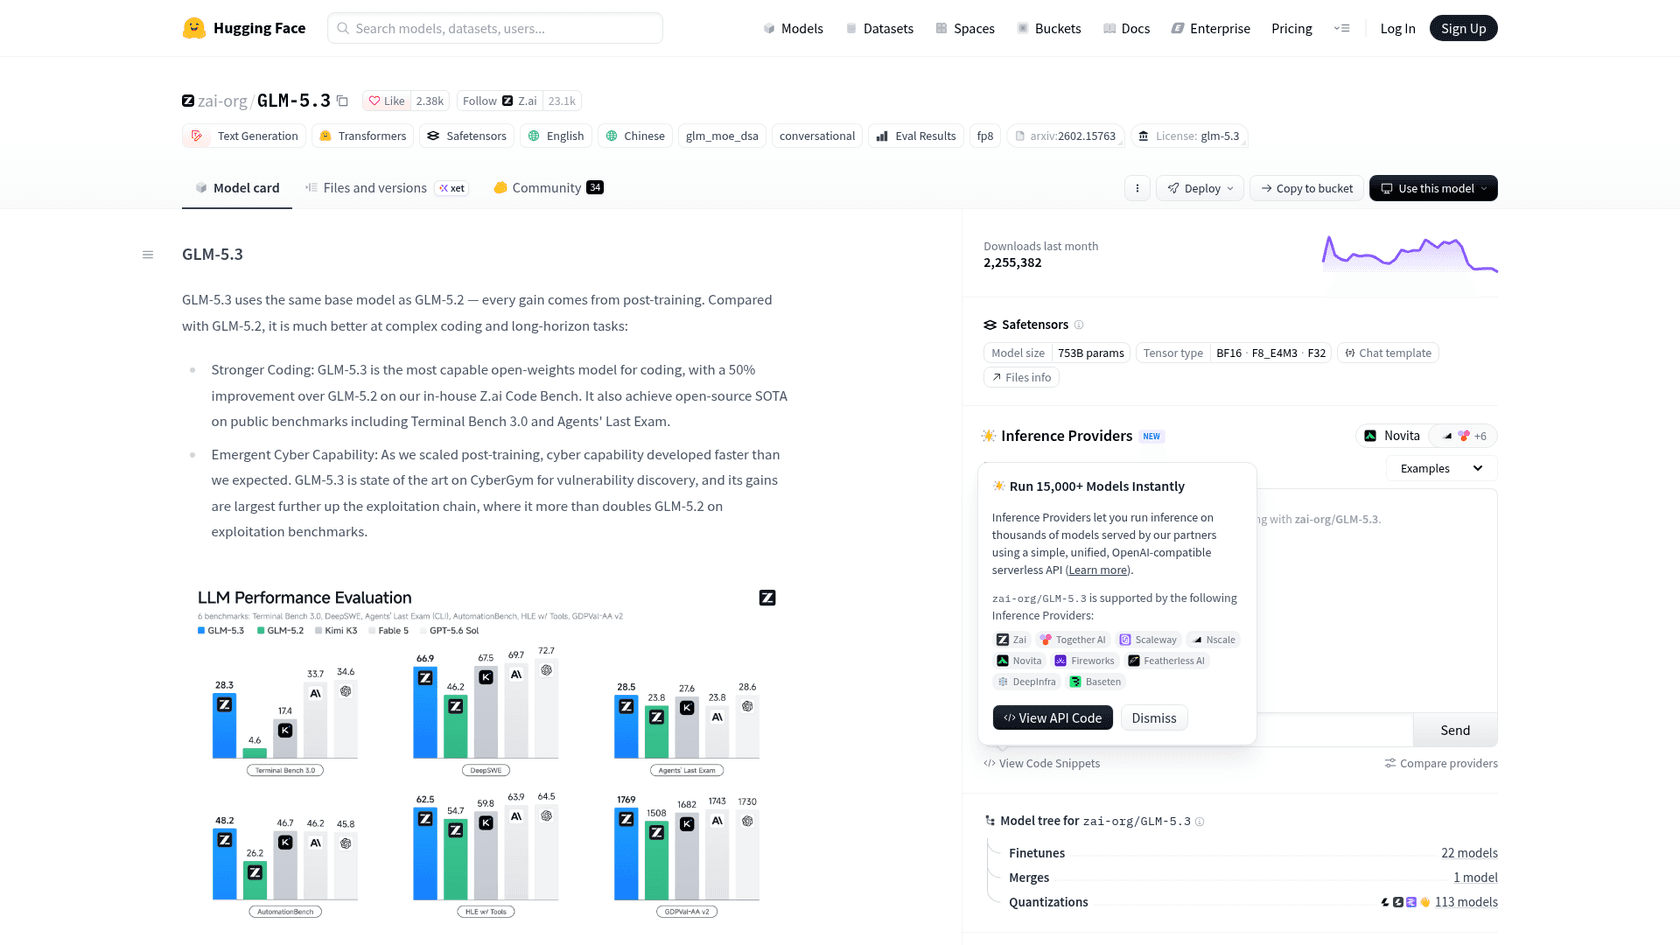
GLM-5.3 de Z.ai es el modelo más fuerte que puedes descargar. Su ficha de modelo dice que la habilidad cyber "se desarrolló más rápido de lo que esperábamos" durante el post-entrenamiento. En la propia tabla de Z.ai, GLM-5.3 encabeza CyberGym con 84,5, pero en ExploitBench puntúa 54,4 frente a 76,5 de GPT-5.6 Sol. El CAISI del NIST lo calificó como el modelo de pesos abiertos más capaz en cyber publicado hasta la fecha, unos cuatro meses por detrás de la frontera de EE. UU., según cita el análisis de Anthropic.
Cómo consigues acceso
Descarga los pesos desde Hugging Face. Nadie revisa tu caso de uso.
Precio
Los pesos son gratuitos. Tu factura es el hardware para ejecutar un modelo de este tamaño.
Dónde se queda corto
No hay ningún laboratorio vigilando el mal uso, y eso corta en ambos sentidos. Anthropic descubrió que los rechazos integrados de GLM-5.3 se podían saltar el 64% de las veces con una historia de tapadera, el 92% con razonamiento precargado, y el 100% una vez abliterado. Para un equipo de seguridad, el problema es el control del alcance, no la ética. GPT-6 Cyber se mantuvo dentro del alcance en el 99,93% de las pruebas honeypot de OpenAI. Con GLM-5.3, tu propio sandbox y tus reglas de enfrentamiento hacen ese trabajo.
Elige esta opción si
tu trabajo no puede salir de un laboratorio con air gap, o necesitas ingeniería inversa sin ningún rechazo. El más pequeño GLM-5.3 Flash funciona con menos hardware.
"Full 5.3 has a scary-good grasp of debugging assembly, QEMU and hex dumps in my experience, it would make for a good “sleuth” model to find potential vulns."
¿Cuánto cuesta realmente cada opción?
Los precios por token solo se comparan entre iguales. Aquí están las tarifas de salida publicadas, una junto a otra:
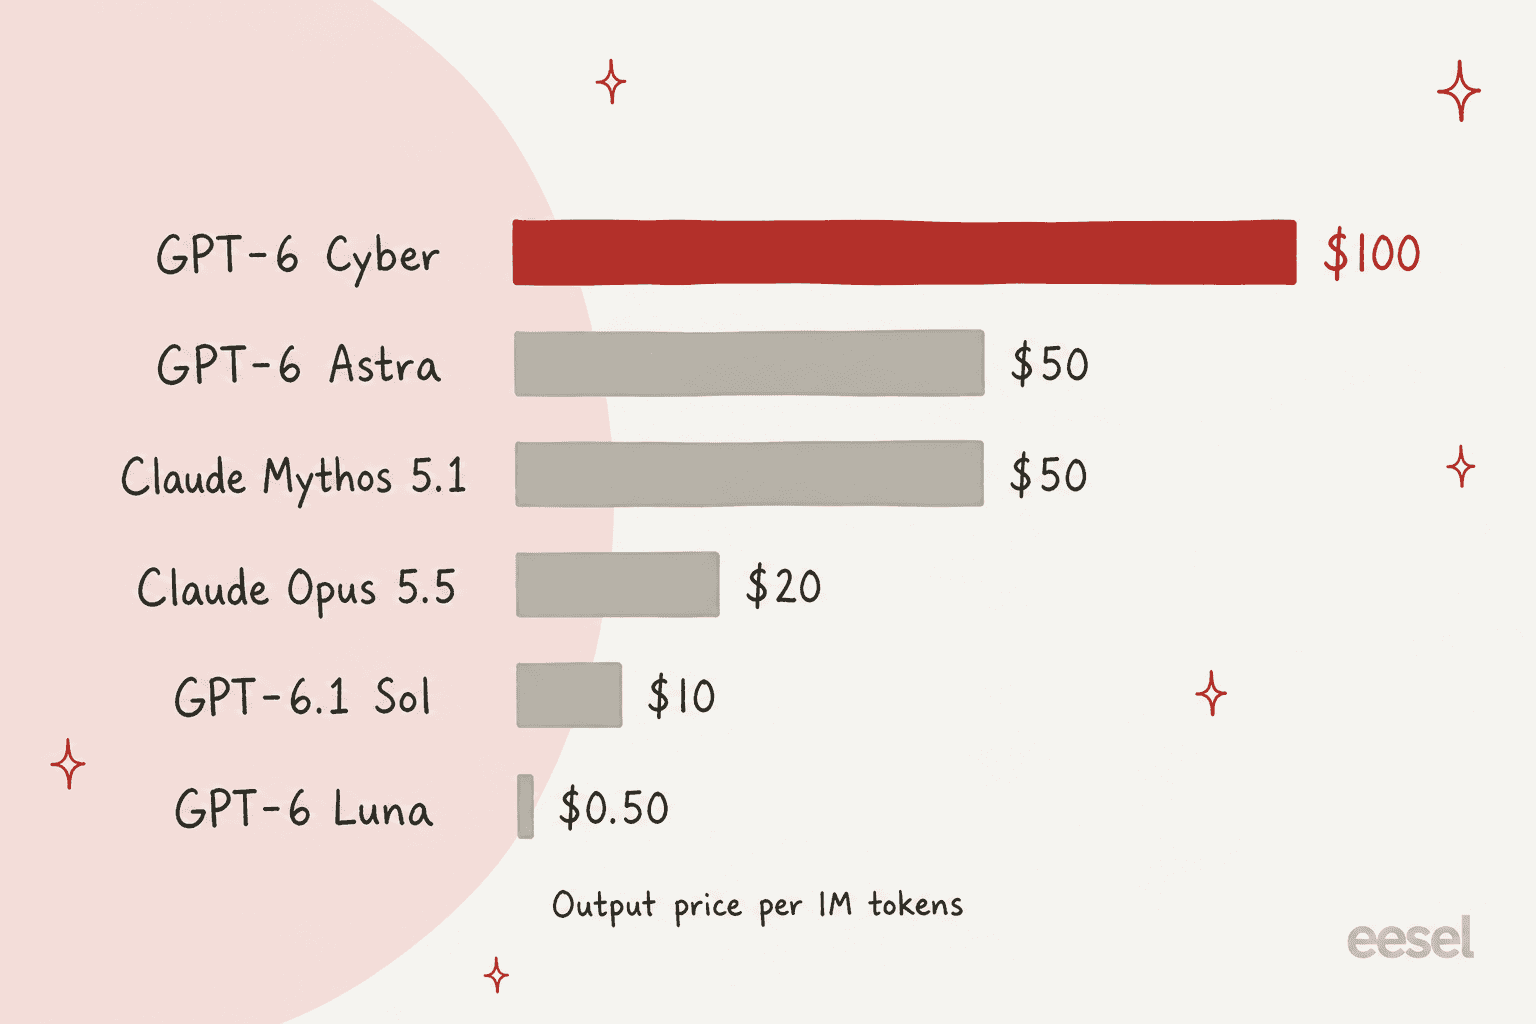
El gráfico esconde dos cosas. Primero, el trabajo cyber consume mucha salida porque el modelo escribe código de exploits e informes, así que la columna de salida es la que duele. Segundo, un modelo más barato que rechaza la mitad de tus tareas no es más barato. Por eso el nivel de acceso importa tanto como la tarifa.
Si prefieres comprar un producto en vez de un modelo, algunas herramientas de seguridad publican precios en sus propios sitios:
| Producto | Precio publicado | Qué es |
|---|---|---|
| Strix | Pro $29 por puesto al mes, los pentests se facturan por prueba | Agente de pentest y revisión de PR, prueba de 7 días |
| MindFort | Starter $499/mes (250 créditos), Scale $999/mes (800 créditos) | Agentes de pentest continuo |
| GitHub security | Secret Protection $19, Code Security $30 por committer activo al mes | Escaneo y autofix en el repositorio |
| XBOW | Pedir cotización | Pentesting autónomo |
| Anthropic OSS Scanner | Gratis para proyectos aceptados | Escaneos periódicos para proyectos de código abierto críticos |
Los mantenedores de código abierto tienen una segunda vía gratuita a través de Patch the Planet de OpenAI, llevada a cabo con Trail of Bits, Calif y HackerOne.
¿Qué tan difícil es abrir cada puerta?
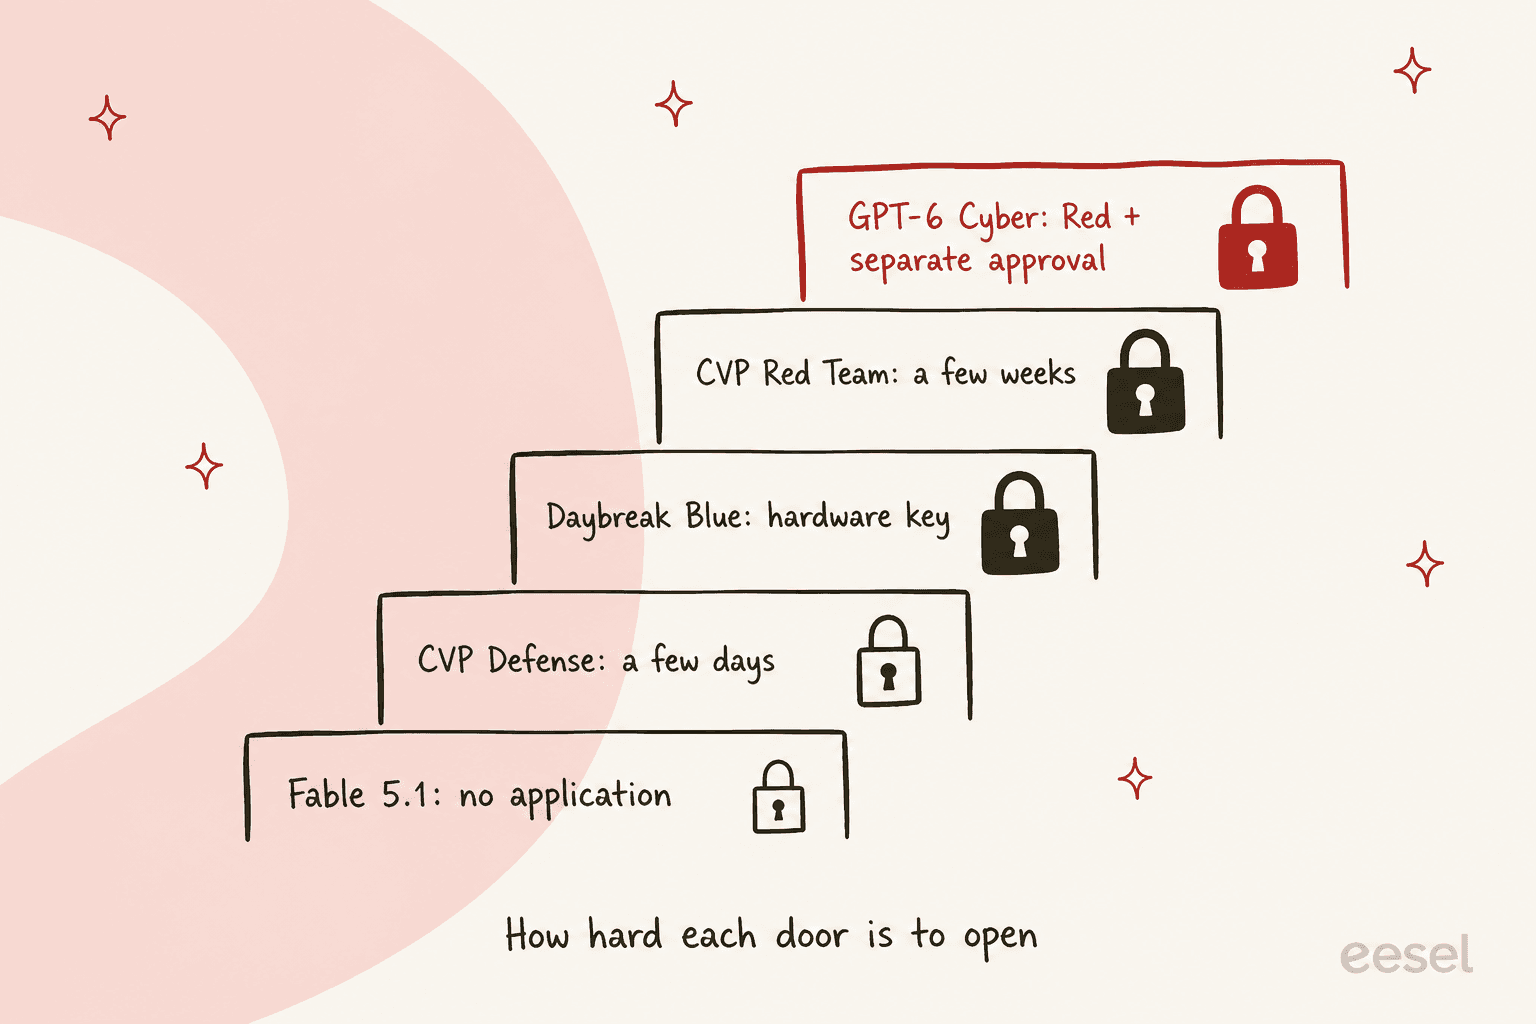
Mi consejo es solicitar en paralelo. Empieza el Defense Access de Anthropic y el Daybreak Blue de OpenAI el mismo día, y mejora cuando tu trabajo lo necesite. Ambos laboratorios ahora piden pruebas de controles de seguridad y cierta retención de datos. Es la misma revisión que veo en el lado de soporte: la lista de verificación de seguridad de proveedores de IA que un cliente aplica a eesel se parece mucho a lo que Anthropic pide a un solicitante de Red Team.
¿Qué pasa después de encontrar la vulnerabilidad?
Los modelos cyber se están volviendo muy buenos en la primera mitad del trabajo. GPT-6 Cyber produjo pruebas reproducibles para 81 vulnerabilidades de Firefox de alta severidad. Los socios de Mythos registraron 129.000. Cada una de ellas se convierte en un aviso, luego en un parche, luego en una ola de correos de "¿nos afecta esto?" en la bandeja de soporte de alguien.
Esa segunda mitad es donde paso mi tiempo. Un modelo cyber es infraestructura. eesel es el compañero que se encarga de las conversaciones que vienen después. El compañero de IA para helpdesk de eesel se une a tu helpdesk existente, aprende de tus tickets anteriores, tu centro de ayuda y el aviso que acabas de publicar, y se prueba contra tickets históricos antes de responder a nadie.
Timengo es un buen ejemplo. Es una empresa danesa de correo seguro y Digital Post que usa eesel en Freshdesk. El compañero redacta respuestas de soporte técnico en danés a partir de unos 5.300 tickets y artículos de ayuda anteriores, preparó 300 tickets en un mes, y escribió 180 borradores, que un ingeniero de soporte revisa antes de enviarlos. A mayor escala, SE Ranking ejecuta un agente por producto en tres conexiones de Zendesk y gestionó 4.650 conversaciones en un mes.
Durante un incidente eso importa, porque el nuevo aviso y sus preguntas frecuentes pueden entrar como conocimiento en la misma hora, y puedes hacerle preguntas de prueba al compañero antes de que lo hagan los clientes. Hay una guía en gestionar agentes de IA desde la terminal.

¿Vas a lanzar una solución esta semana? Prueba eesel en tu centro de ayuda y mira cómo responde a las preguntas sobre la vulnerabilidad antes de que tus clientes empiecen a preguntar. Más sobre cómo funcionan estos compañeros en compañeros de IA.
Entonces, ¿qué alternativa a GPT-6 Cyber deberías elegir?
- La mayoría de los equipos de seguridad: solicita hoy mismo CVP Defense Access y usa Claude Opus 5.5. Mejora a Red Team Access si haces pen testing.
- Empresas de OpenAI con trabajo defensivo: Daybreak Blue en GPT-6 Sol o Luna, como recomienda la propia OpenAI.
- Ya en Daybreak Red: GPT-5.6 Cyber ahora, Astra para trabajo de exploits a mitad de precio, GPT-6 Cyber una vez aprobado.
- Infraestructura crítica: Mythos 5.1 vía CVP Specialized Access, o Daybreak Red for Critical Infrastructure.
- Con air gap o sin solicitud: Fable 5.1 para código fuente, GLM-5.3 si nada puede salir del laboratorio.
GPT-6 Cyber es la herramienta correcta cuando tu trabajo es hacer funcionar exploits contra objetivos remotos y puedes esperar la segunda aprobación de OpenAI. Para todo lo demás, la puerta que puedes abrir esta semana gana al modelo que no puedes.