

AIカスタマーサポートは、受信したメッセージを読み取り、自社のドキュメントや過去のチケットから答えを探し、返信するか会話を人間に引き渡すかを決めるソフトウェアです。面白いのは回答の部分ではありません。引き渡しの部分です。期待外れになる導入の多くは、検索はうまくいっているのにエスカレーションを誤っています。
実際のキューで通用する範囲設定のルールはこうです。量が多く判断が単純なチケットを自動化し、誤ると高くつくか元に戻しにくいものはすべて外す。チームが痛い目を見るのは中間層で、その対処法は、AIに推測させるのではなく回答を拒否できるようにする確信度のしきい値です。
現実的な導入には2日ではなく2〜4週間かかり、遅いのはソフトウェアではなくナレッジベースです。まだ人間が送信ボタンを押す草稿モードで始め、ちょうど1種類のチケットだけを自動送信にし、そこから広げていきます。私はeeselで何年もサポートAIを作ってきましたが、パターンは一貫しています。何かが自己解決するよりずっと前から、草稿作成の速さだけで1か月目は十分に価値があります。
eeselを試すツールとして選ぶなら、最初の設定はAIコーディングエージェントに任せられます。アクセスを承認すると、ヘルプデスクを接続し、AIが回答すべきドキュメントを追加し、人間がまだ送信ボタンを押す草稿モードで開始します。これにより、どのチケットタイプを最初に自動送信にするか決めている間も、1週目から草稿作成の速さを得られます。コーディングエージェントによる設定ガイドを参照してください。
AIカスタマーサポートの実体
マーケティングの言葉をそぎ落とすと、4つのステップです。メッセージが届く。システムがヘルプセンター、過去のチケット、接続済みのその他すべてを検索する。十分な確信を持って答えられるかどうかを判断する。そして回答するか、人間が確認するための草稿を作るか、エスカレーションする。
それだけです。「エージェント型」「自律的」「知的」といった言葉はすべて、この4つのステップそれぞれがどれだけうまく実行されているかについての主張にすぎません。
この用語は常に混同されているので、デモに耐える区別の仕方をここで示します。3つの質問で、目の前にあるものがどのカテゴリかが分かります。出力を読むのは誰か、システムへの書き込みができるか、推論するのかスクリプトに従うのか。
| 出力を読むのは誰か | システムを変更できるか | どう判断するか | |
|---|---|---|---|
| ルールベースのチャットボット | 顧客 | いいえ | あなたが描いた決定木 |
| AIエージェント | 顧客 | 許可すれば可能 | コンテンツを基に推論する |
| コパイロット | 自社の担当者 | 人間が送信したときのみ | 推論し、人間が承認する |
ルールベースのチャットボットは、顧客が実際の人間らしい言い回しで何かを言った瞬間に破綻します。AIサポートエージェントはコンテンツを基に推論し、行動できます。コパイロットは草稿を作り、自社の担当者に送信ボタンを押させます。AIエージェントとチャットボットの違いは、裏にあるモデルではなく、その仕組みが仕事を最後までやり遂げることを許されているかどうかにあります。
ほぼすべてのベンダーのページに出てくるので分解しておく価値のある言葉がもう1つあります。「自社データで学習済み」です。これは3つの完全に異なる仕組みをまとめて指しています。
- ファインチューニングはコンテンツをモデルの重みに焼き込みます。更新が遅く、データはすでに外に出てしまっています。
- **Retrieval(検索拡張)**はドキュメントをインデックス化し、回答時にそこから引用します。これがRAGの意味であり、実際にほとんどの人がやっていることです。記事を編集すれば、次の再インデックスでそれが反映されます。
- ライブのツール呼び出しは、その場で注文APIに問い合わせます。3つの中で唯一、「自分の荷物はどこにあるか」に答えられる方法です。インデックスが作られた時点では、その答えはまだ存在していなかったからです。
ベンダーにはこの3つのうちどれを指しているのか確認してください。これによって、ポリシー変更がどれだけ速く反映されるか、自社データのうちどれだけがシステムの外に出るか、そもそもアカウント固有の質問に答えられるかどうかが変わります。デモを見る前に、ヘルプセンターにおけるRAGとファインチューニングのトレードオフを理解しておく価値があり、その下の層を知りたいなら、サポート向けベクトル検索がRetrievalの仕組みを扱っています。
1件のチケットで見る仕組み
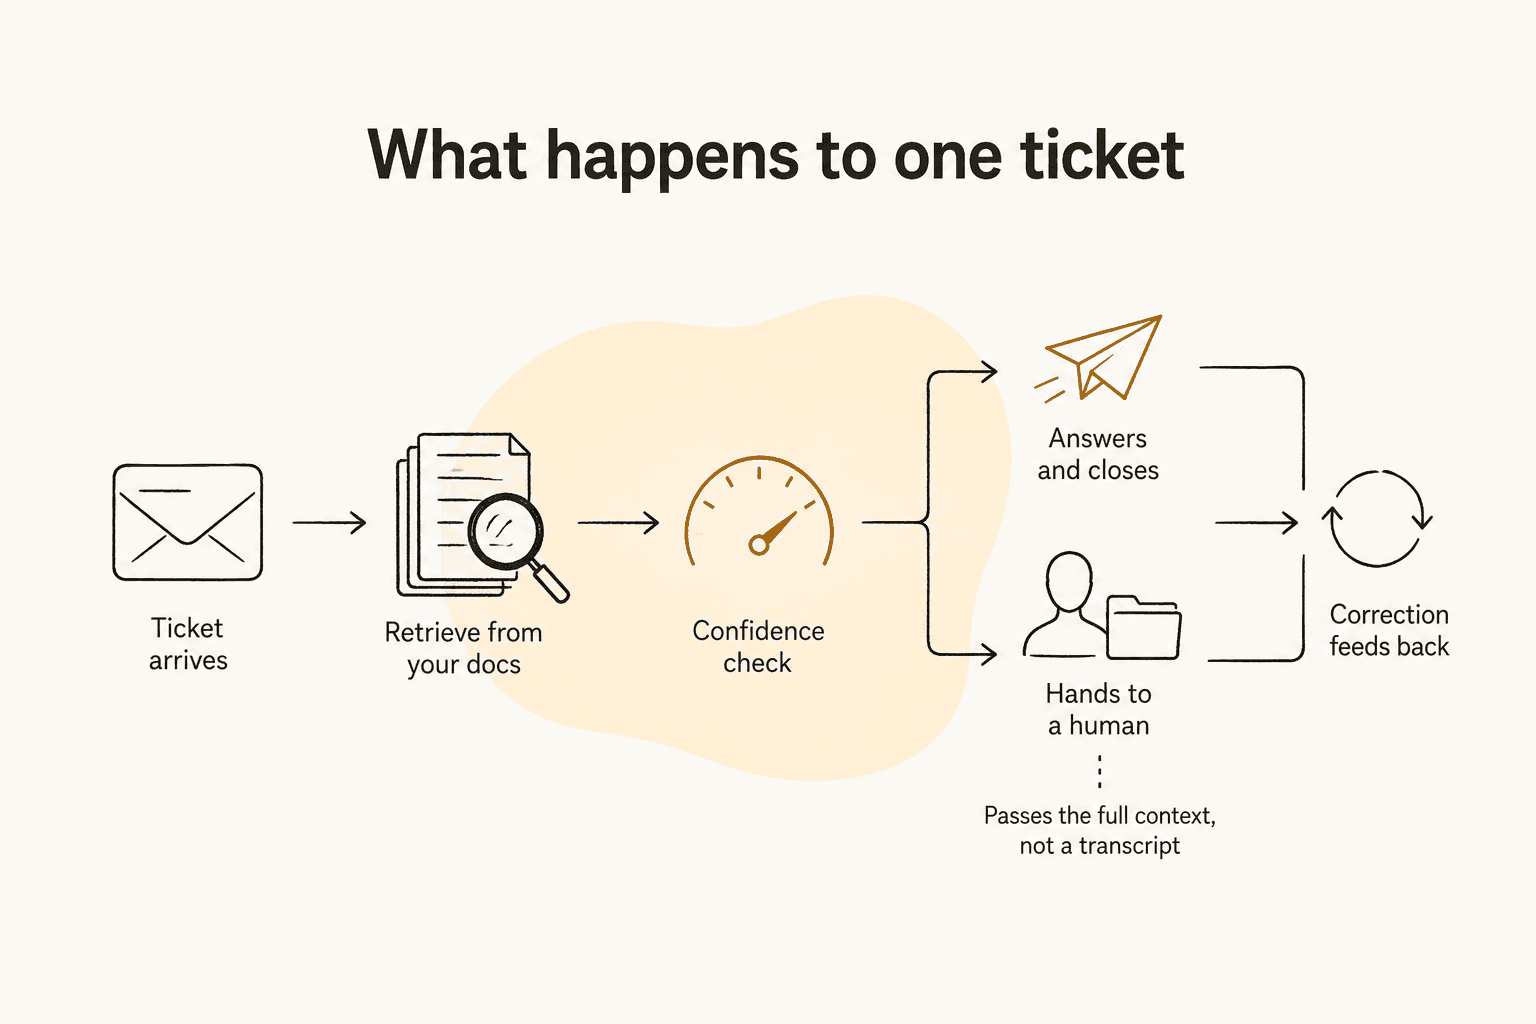
1件のチケットを追ってみると、この仕組みはもう謎ではなくなります。
チケットを読み、何が求められているかを把握する。 キーワードの一致ではありません。意図分類、エンティティ抽出、そして感情の読み取りを組み合わせることで、「注文44182について質問するのはこれで3回目で、もう我慢できない」という文が、注文状況の質問、注文番号、怒っている顧客という3つに分解されます。この最後の信号は想像以上に重要で、感情分析がそもそもAIが回答するかどうかを決めることも多いです。
接続済みのすべてを同時に検索する。 ヘルプセンターの記事、過去の解決済みチケット、マクロ、社内Wiki、アップロード済みのPDF。優れたシステムはこれらをインテグレーションごとに分断せずにまとめて扱うので、1つの回答が公開ドキュメントと社内のランブックの両方を根拠にできます。Groundingとは、モデルの記憶ではなく取得されたテキストに回答を結び付けることを指す用語で、精度を左右する最大の単一要因です。
話すべきかどうかを確認する。 これが確信度スコアのステップで、良い導入と悪い導入が分かれるのはここです。確信度が高ければ回答を送信します。確信度が低ければ、代わりに人間向けの内部メモを書きます。eeselでは、この挙動は数値的なしきい値を調整するのではなく、平易な言葉で設定できるもので、ヘルプデスクエージェントのドキュメントはそのフォールバックをはっきりと述べています。分からなければそう言うか、エスカレーションする、というものです。
行動する、または引き渡す。 行動するとは、システムに書き込むことです。チケットにタグを付ける、フィールドを更新する、注文を確認する、返金を発行する、会話を終了する。引き渡すとは、文脈を添えた本当の転送のことです。詳しくは後述しますが、誰もがここへの投資を惜しんでいる部分です。
修正がフィードバックされる。 担当者が草稿を書き直したり、システムに「もっとくだけた言い方だった」と伝えたりすると、それは消えるのではなく指示の変更として残ります。このループがなければ、毎週同じことを教え直すことになります。

任せるべきこと、任せるべきでないこと
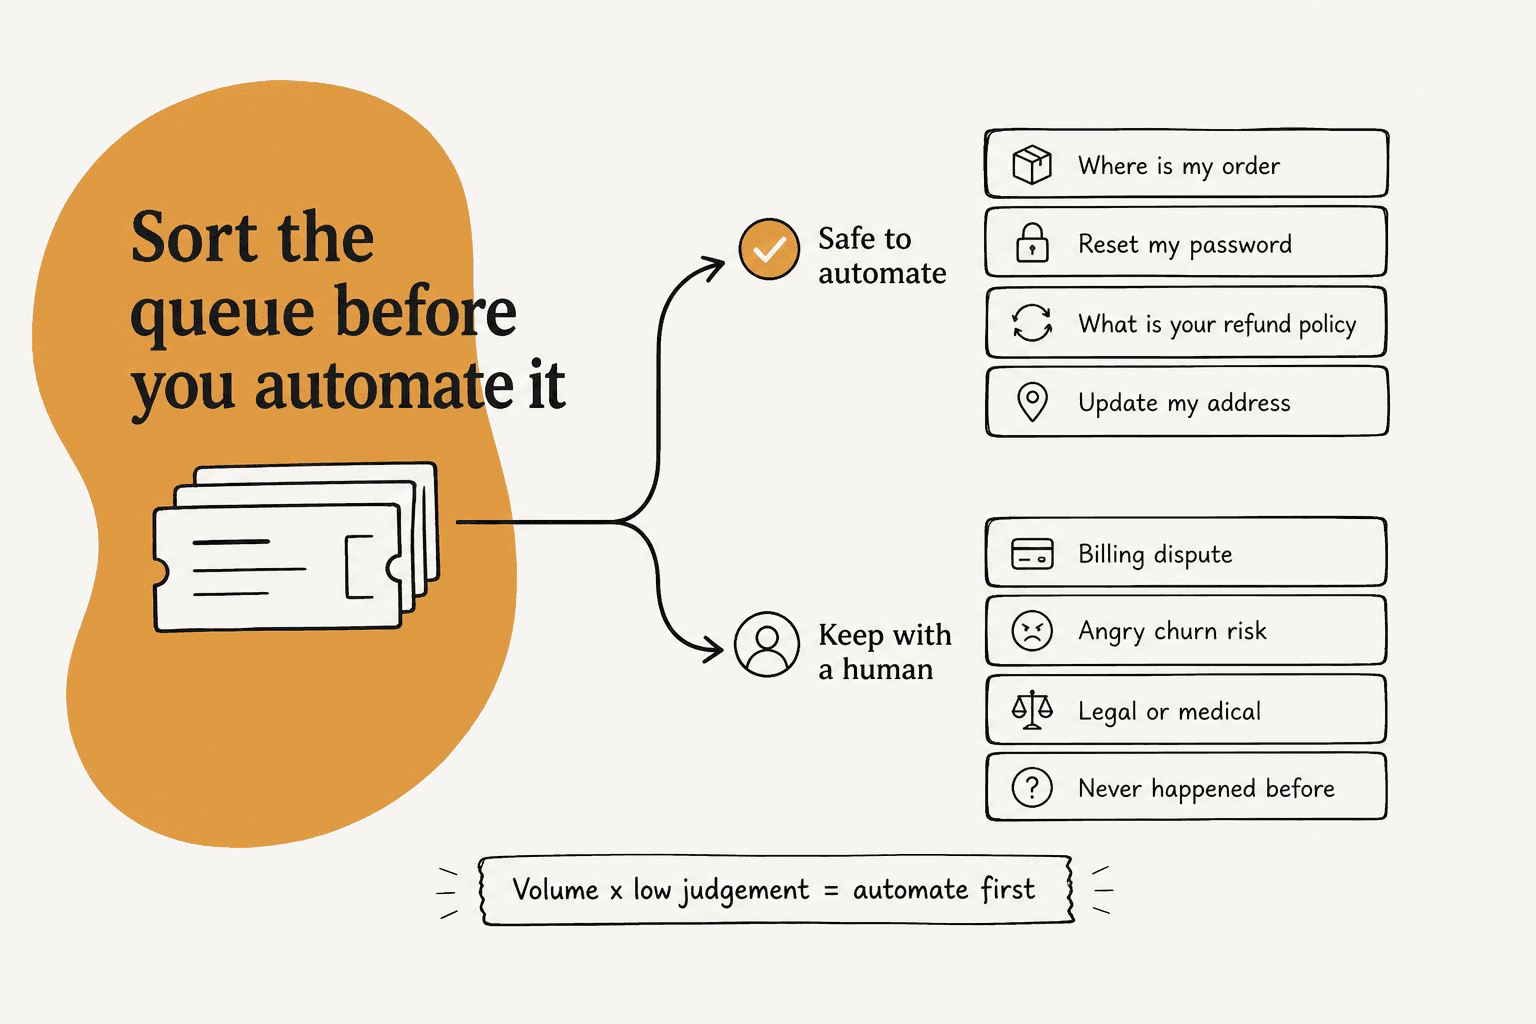
私が何度も立ち返る範囲設定のルールは、量の多さと判断の単純さの掛け算です。量が多いだけでは不十分です。同一の請求トラブルが1000件あっても、それは1000件の請求トラブルのままだからです。判断が単純なだけでも不十分です。月に2回しか来ない質問を自動化しても見合わないからです。
まず自動化すべきもの: 注文状況とWISMO。パスワードの再設定。文書化された答えが1つあるポリシーに関する質問。住所やサブスクリプションの変更。チケットのトリアージとルーティング。翻訳。これらには共通点があります。正しい答えがすでにどこかに書かれていて、間違った答えを送ってもフォローアップメール1本で済み、金銭的な損害にはならない点です。
スパムもこのリストに入り、過小評価されています。後で触れる実際の試用では、受信キューの22%がゴミで、人間が一文字も読む前にすべて検知できたことは、顧客に対するリスクが一切ない、初日からの成果でした。
人間に任せるべきもの: 誤ると高くつくか元に戻しにくいものすべて。
- ポリシーの例外対応。 30日間の返品期間の35日目は、判断の問題であって検索の問題ではありません。AIはそれを旗立てしてエスカレーションすべきであり、決定すべきではありません。
- 自分で設定した上限を超える金額。 その数字を書き出しておきます。エージェントはX ドルまでクレジットを発行でき、それを超えたら人間が承認します。このルールを公開している企業はほとんどありませんが、実際の導入にはどこも必ずあります。
- 規制対象の会話。 医療、法律、金融に関する助言です。コンプライアンスは料金ページに貼るバッジではなく、エージェントが言ってよいことへの制約です。
- すでに怒っている顧客。 最初のメッセージでの良い引き渡しは、4通目での素晴らしい回答に勝ります。
- 一度も起きたことのないこと。 チケット履歴に前例がなく、ドキュメントにも何もなければ、retrievalは何も返しません。そして、まさにその条件下でモデルは作り話を始めます。
最後の項目は深く掘るべきです。自社の製品で実際にこれがどう悪化したかをライブで見てきたからです。retrievalが空で返ってきたとき、止まるよう指示されていないモデルは、その隙間を学習データで埋めてしまいます。実際に、デンマークの太陽光エネルギー事業者を含む有料顧客がいて、その企業のボットは製品に関する作り話をして実際の人に送ってしまいました。ナレッジベースに一致するものがなく、回答を拒否するよう誰も指示していなかったためです。解決策は決して「より良いモデル」ではありませんでした。厳格なしきい値と、回答を拒否するフォールバックでした。
同じテストのもっと簡単なバージョンがあり、どんな導入の前にもホワイトボードに書いておきたいものです。このアクションは1クリックで元に戻せるか? 戻せないなら、人間が承認します。これは返金、解約、アカウント削除、そして顧客がスクリーンショットを取るようなメールを送るすべての操作を含みます。
これについて私が聞いた中で最も鋭い言葉は、月に約7000件のGorgiasチケットを3万件の注文に対して処理しているDTC向けサプリメントブランドのCXリーダーから出たものです。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
我々はおそらくその理由でその取引を失いましたが、まさにそれだからこそ私は何度もこれを引用しています。「Leave them alone」は「すべてに答える」よりも厳しいプロダクト要件であり、実際にバイヤーが気にしているのはそれです。
本当に効くメリットと、誰も書かない限界
誠実なメリットのリストはマーケティングのリストより短いですが、そこに載っている項目はどれも検証可能です。
営業時間外のカバー。 これは最も議論の余地が少ない成果です。以前は一晩中放置されていたキューが、今では午前3時に最初の対応を受け取り、営業時間外のカバーは小さなチームが最初に実感することが多い部分です。
ヘルプセンターを翻訳せずに言語の範囲を広げる。 日本語のチケットは、英語のドキュメントから日本語の回答を得られます。eeselの顧客の1つであるローン比較プラットフォームのSmavaは、月に10万件を超えるドイツ語のチケットを処理する完全自動化されたZendeskエージェントを運用しており、この数字はヘルプデスクエージェントのページで公開されています。多言語サポートは以前は人員の問題でしたが、今はほとんどそうではなくなっています。
つまらない層でのスピード。 範囲を絞ったチケットタイプでは、初回応答時間が大きく下がります。もうその前にキューが存在しないからです。
一貫性。 すべての担当者が返金ポリシーの質問に同じように答えます。華やかではありませんが、あなたのQAリーダーが3年間求めてきたものです。
次は限界を、はっきりと述べます。本番環境でぶつかるより、ここで知っておいてほしいからです。
書かれた知識の質に完全に依存し、その知識はたいてい形が間違っています。 あるバス追跡サービスのサポートマネージャーは、ナレッジベース全体が管理者向けに書かれていた一方で、チケットはすべて乗客から来ていたと話してくれました。Retrievalは完璧に機能していましたが、回答は相変わらず分かりにくいものでした。古くなったヘルプセンターのコンテンツは同じ問題の裏返しです。3月にポリシーが変わり、記事は変わらず、8月になってもAIは自信満々に死んだポリシーを引用しています。
高いデフレクション率は、失敗している導入を隠すことがあります。 チケットが閉じられ、再連絡が増えているなら、それは解決ではなく回避です。両方を一緒に追わなければ、ダッシュボードに嘘をつかれます。
過剰なエスカレーションは実在する失敗モードで、見た目は安全そうに見えます。 すべてを人間に渡すエージェントは何も壊さず、誰も怒らせませんが、静かに、そして決してリターンを生みません。
トーンは精度とは別の問題です。 これは実際の数字で私たちを驚かせたもので、下にある実例の核心部分です。
うまく作っても、顧客に嫌われることがあります。 これは誰も料金ページに書かない限界で、私が読んだ中で最も誠実なバージョンは、そのプロジェクトを率いた人から出たものです。
"This is so true. I led the implementation of an AI customer service agent and even though management thinks it's a great success the metrics tell a totally different story. Our customers hated it. I haven't seen anything in tech that is hated more. Before you think we did a bad job with our solution, I can tell you we went with some of the best and did our own intensive testing and worked on latencies etc., I actually thought the final version was pretty good but our customers just hated it."

このコメントを簡単には片付けられない理由は、その中盤にある先回りした自己弁護です。私の見立てでは、そのギャップはほぼ常にポジショニングの問題です。顧客がやり過ごせる道具としてのAIは問題なく、顧客が突破しなければならない門としてのAIは問題です。
運用の仕事を消すのではなく、移動させます。 誰かがナレッジベースを所有し、エスカレーションを確認し、週次レポートを読みます。チャーンした24件のeesel顧客を見た共同創業者のAmogh Sardaは、同じ共通点を見つけました。「zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier.」導入はどちら側でも自動で回るものではありません。
実際にチームが使っている場面
実際のキューで私が目にすることの大部分は、5つのパターンでカバーできます。
注文状況と配送。 eコマースの中で量が最も多く判断が最も単純な質問であり、答えがShopifyにあってヘルプセンターにはない以上、ドキュメント検索ではなくライブのツール呼び出しを最も必要とするものです。範囲を決める前に注文追跡の自動化を読んでおく価値があります。
上限付きの返品と返金。 AIは返金を処理できます。文書化されたポリシーの範囲内であればです。ドルの上限を設定し、それを超えるものはすべて承認の裏に置けば、金庫を丸ごと渡すことなく量をカバーできます。返金の自動化の仕組みは、AIそのものより承認の設計に関するものです。
Tier-1トリアージ。 AIが顧客に一度も返信しない場合でも、分類、タグ付け、優先順位付け、ルーティングは実質的な成果です。Tier-1デフレクションが見出しを取りますが、チケットルーティングは担当者が最初に気づく、より静かな方です。
すでに使っているヘルプデスク内でのエージェント支援。 コパイロット型のパターンです。担当者がチケットを開いたときには草稿がすでに用意されています。新しい習慣はゼロなので、導入率は高く、リスクはほぼゼロです。
社内ITと従業員サポート。 始めるのに最も安全な場所です。対象が顧客ではなく同僚だからです。InDebtedのIT責任者は、Jira Service Managementのキューにeeselをファーストレスポンダーとして置き、「just like an agent would」のように振る舞うと表現しました。彼らは55%を目指しながら15%のデフレクションにいますが、私は派手な数字よりこの数字が好きです。それが3か月目の正直な姿だからです。
同じスタックを使っているなら、Jira Service Management向けAIで設定を扱っており、同じパターンはITを越えてHRヘルプデスクや一般的な従業員サポートにも広がります。
技術的な深さも自動的に対象外になるわけではなく、これは私自身も驚きました。自社のログで見た中で最も強いデフレクションの1つは、産業用オートメーションベンダーの現場エンジニアが、エラーコードとネットワークの症状を伴うハードウェア障害を報告したケースでした。エージェントはPDFマニュアルを6回検索し、そのうち2件を全文読み、構造化された一連の切り分けテストを草稿にしました。深さは障壁ではありません。答えがどこかに書かれているかどうかが障壁です。
エスカレーション設計、誰もが飛ばす部分
長年これに取り組んできた私の本音です。エスカレーション設計こそがプロダクトです。回答すること自体は、今ではもう当たり前の前提です。チームが守りたいと思う導入と、チームが拒む導入を分けるのは、AIが完結させるべきではない会話の20%で何が起きるかです。
これについて私が見た中で最も明快な外部からの裏付けは、コンタクトセンターの運営者が、ローンチ後に自分たちの数字に実際に何が起きたかを説明した言葉でした。
"AHT question nobody wants to answer lol. shipped a billing/tracking bot, decent containment, but AHT on escalated calls went up. agents had to read the transcript, figure out what the bot already tried, re-ask half of it anyway. fixed by forcing a structured handoff summary instead of raw transcript dump (saved more time than the automation itself). CSAT fine on deflected stuff, tanked on anything that bounced back after a failed bot attempt"

最後の一文を二度読んでください。CSATは、ボットが完結させた会話では問題なく、跳ね返ってきた会話では崩れました。自動化はうまく機能していました。引き渡しがプロダクトの欠陥であり、それを直したことは自動化そのものより多くの時間を節約しました。
私が見てきた3つの失敗はすべて、間違った回答より悪いものです。
自分でアナウンスするだけの引き渡し。 ボットは顧客に人間へ転送すると伝えながら、実際には転送しません。あるオランダのホスティング企業はZendesk上でこれを繰り返し経験し、さらに転送時に顧客の名前とメールが引き継がれない問題も重なって、最終的に自前の仕組みを作りました。このクラスのバグについてAmoghが言った言葉が頭に残っています。「If hard-fail it's silent-failure class (worst class for trust).」目に見えるエラーは回復可能です。静かにどこにも行き着かなかった会話は回復できません。
虚無へのエスカレーション。 ある導入ではメールでエスカレーションしていましたが、そのエスカレーションメールは、誰も書いた記憶のないルールによって自動的にクローズされていました。人間はそれを一度も目にしませんでした。ダッシュボードはエスカレーションが正しく発火していると表示していました。
人間になりすますAI。 同じ導入での話です。エージェントはチケット履歴から人間の担当者の名前を拾い、その名前で署名するようになっていました。顧客は人間に対応してもらえたと思い込んでいました。ボットに名前を付け、それが何であるかをはっきり言わせましょう。
つまり具体的には、本番公開前に良いエスカレーション設計が定めておくべきことです。
- トリガー。 人間を明示的に求める発言。同じ質問が2回繰り返される。設定した基準を超える感情の読み取り。ブロックリストにある意図。名前付きの高価値アカウント。そして、ほとんど誰も書かないもう1つ、エスカレーションしない条件です。これは、AIが諦めるのではなく続行すべきだとあなたが決めた条件です。
- ペイロード。 完全な会話履歴、AIが何を試し、なぜ止まったのかを示す明確な要約、感情の読み取り、そして取得したすべての記録です。トランスクリプトだけでは人間がすべてを読み直す羽目になり、それは助けの正反対です。引き渡しのベストプラクティスではここをさらに深く扱っています。
- ルート。 どのキューに、どの優先度で、AIの感情の読み取りが優先度を上げてよいかどうかです。エスカレーション管理は、会話の問題であると同時にルーティングの問題でもあります。
- 顧客に伝える内容。 待ち時間を伝えますか?トランスクリプトは見えたままにしますか?引き渡し時の会話設計を正しく行うのは安く済み、その違いはすぐに実感できます。
- 誰もいないときに何が起きるか。 夜間、週末、キューが200%になっているとき。これは実際に最もよく起きるエスカレーションの失敗であり、最も文書化されていないものです。答えは通常、偽の約束ではなく本当の期待値を設定する待機パターンです。
最後の点には、「とにかく謝って待つ」よりも洗練されたバージョンがあります。私たちが一緒に仕事をしているあるフィンテック企業は、第三者の支払いパートナーを待つ間、月に7000件から8000件のエスカレーション済みチケットを抱えていますが、AIを使って誠実な状況更新でエスカレーション済みチケットを温めています。ナレッジベースは不要で、指示だけです。エスカレーションは必ずしも会話が止まることを意味しません。
すべての引き渡しが複雑というわけでもありません。これは自社のログからの例で、あるSEOツールのウェブサイトチャットでの出来事です。顧客はプロジェクトからキーワードを削除する方法を質問し、回答を得て、検索エンジンを削除する方法を質問し、別の回答を得て、その後「人間と話せますか?」と聞き、すぐに転送されました。2つの質問はセルフサービスで解決し、1つはきれいな終わり方でした。これが外から見た「機能しているシステム」の姿で、まったく目立たないものですが、それがまさにポイントです。
Zendeskを特に使っているなら、Zendeskのエスカレーションルールがネイティブ側を扱い、チャットでの人間への引き渡しが秒単位が本当に重要になるライブチャネルのバージョンを扱っています。
導入の進め方、週単位で
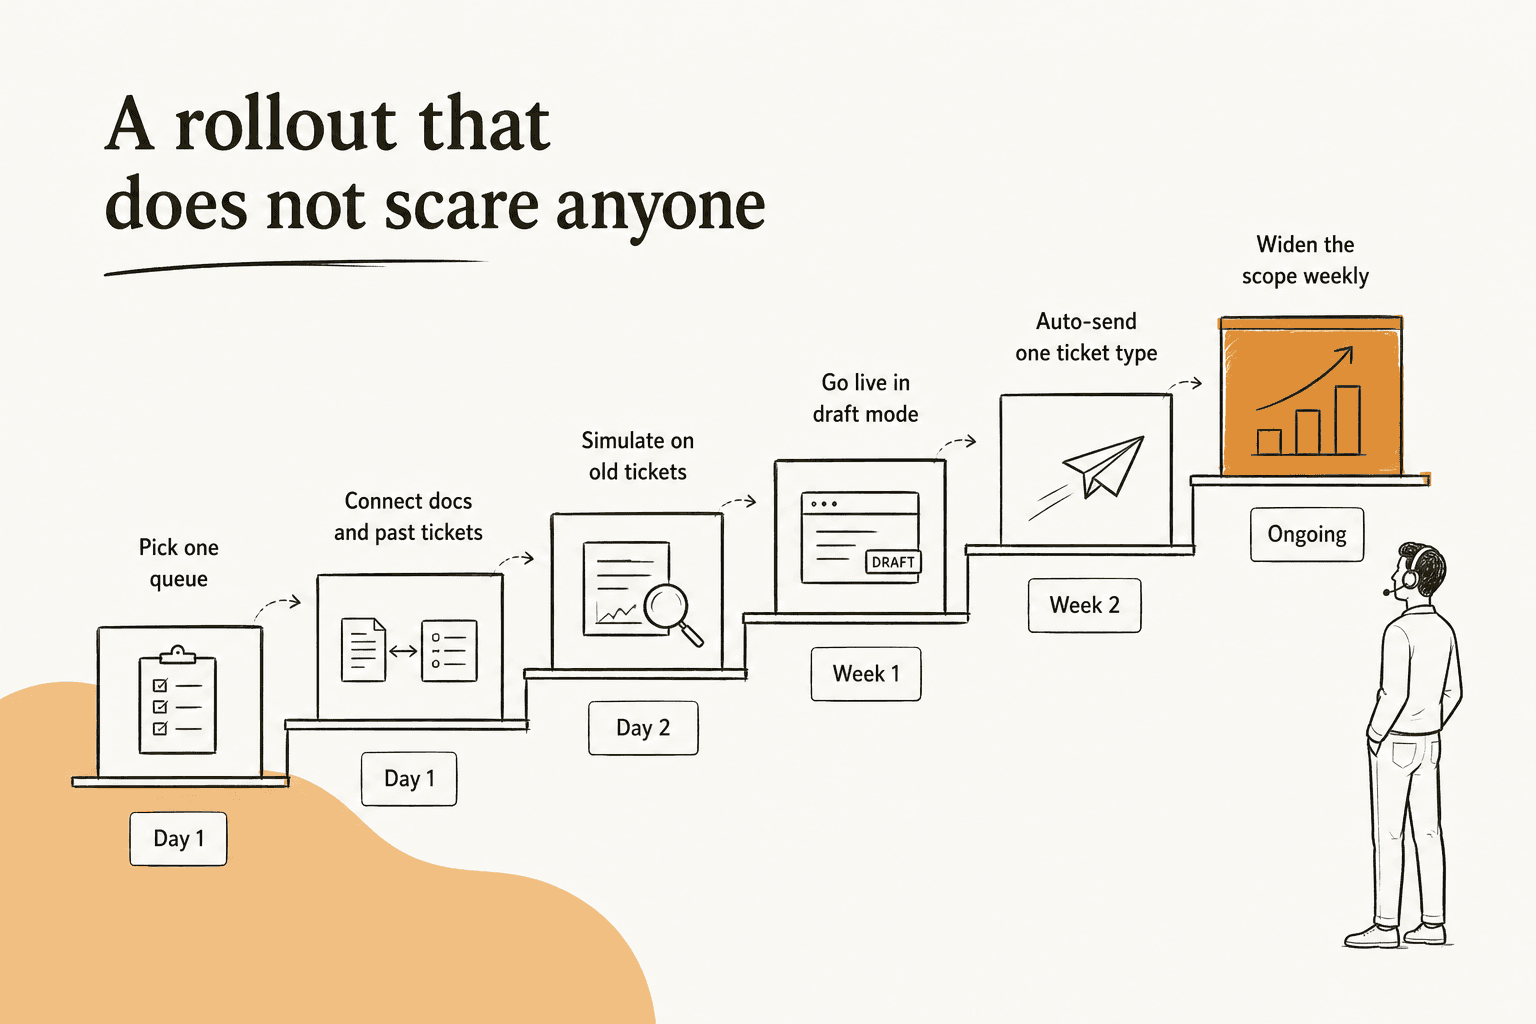
ヘルプデスクを接続し、最初の回答を得るまでは約30分です。チームが信頼できる導入に到達するまでは2〜4週間かかり、遅いのはソフトウェアではありません。
初日:ヘルプデスク全体ではなく、1つのキューを選ぶ。 1つのチャネル、1種類のチケット、1つの言語。最もよく見る失敗は、チームが初日にAIをすべてに向け、どこでも平凡な結果を得て、そのカテゴリは機能しないと結論づけることです。
初日:過去のチケットを含めて知識を接続する。 ドキュメント、ヘルプセンター、マクロ、そして解決済みのチケット履歴です。最後のものは、バイヤーが何よりも先に求めるものであり、Amoghのこれについてのメモは率直です。「past ticket training strikes again. Classic. People really, really, really want to train on past tickets.」また、現実的なトーンがどこから来るかもこれで分かります。ヘルプセンターはポリシーの声で書かれ、チケットは人間の声で書かれているからです。開始するのに完璧なナレッジベースも不要です。あるイギリスのZendeskチームは、9個の同期済みマクロから56件の解決済みタスクを得て、トライアル終了後も38日間使い続けました。
2日目:すでに回答済みのチケットでシミュレーションする。 これはほぼどのベンダーページも説明しないステップであり、私が絶対に飛ばしたくないステップです。過去のチケットのバッチを再生し、エージェントに何を言っていたかを草稿として作らせ、その草稿をチームが実際に送った内容と比較して評価します。eeselのシミュレーションはサンドボックスモードで実行され、テーマ別のカバレッジを報告するので、意味のない単一の精度数字ではなく「返金ポリシー28%、SSOログインエラー35%」のような形で結果が得られます。そして具体的なギャップを埋めて再実行します。
結果を見る前に合格基準を決めておきましょう。そうでなければ、得られた結果を正当化してしまいます。私の基準は、少なくとも100件の実際のチケットのサンプルで、範囲に含めた意図についての事実誤りが5%未満であり、囲い込んだカテゴリでは誤りがゼロであることです。
1週目:草稿モードで本番公開する。 実際のチケット、実際の顧客、そしてすべての返信は依然として人間を通して送られます。AIが草稿にした内容と担当者が実際に送った内容の差を測定し、その差はこれまでで最も役に立つ診断になります。これは1週目の最悪の結果が「無駄になった草稿」で済むことも意味します。
2週目:ちょうど1種類のチケットを自動送信にする。 自社で最も範囲が狭く、最も文書化されており、最も元に戻しやすいものを選びます。注文状況が定番の選択です。1週間、人間がすべての会話を読んで監視します。
3週目以降:パーセンテージではなく範囲で広げる。 1度に1つの意図を追加し、チケットデフレクションの数字を再連絡率の数字と並べて確認します。お金やアカウントの状態に関わるものはすべて、適切だと感じるよりもずっと長く承認の裏に置かれます。
何も売り込んでいない誰かから同じ手順を聞きたいなら、これが私が書きたいものに近いです。
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."
再オープンされた会話のレビューは、そこから盗みたい具体策です。範囲設定の文書は、AIが何を処理すべきかを示します。再オープンの記録は、AIが実際に何を処理できるかを教えてくれます。
実際にスケジュールを狂わせる2つのことがあり、どちらもベンダーのロードマップには載っていません。1つ目はナレッジベースの整理で、これは本当に人間が時間をかける仕事です。2つ目はインテグレーションの認証情報で、ヘルプデスクの管理者権限を持つ人が休暇中だったりするからです。両方のために予算を確保してください。
そして、こうしたすべてを超えたところに、どんな技術的な問題よりも頻繁に見かける失敗モードがあり、それは回答の質とは何の関係もありません。トライアルが完全に設定され、インテグレーションも接続され、ドキュメントも同期されているのに、誰もトリガーを配線していないせいで一度もタスクが発火しないことがあります。他のケースではすべてを正しく行っても止まることがあります。あるコホートでは、起動されたトライアルの10件中9件で96%の品質スコアを記録する会話が実際に機能していましたが、実際にコンバージョンしたのはそのうち1件だけでした。どちらの場合もAIが問題だったわけではありません。設定は導入ではなく、導入は定着ではありません。誰かがそれをオンにして、所有し続ける必要があります。
完全な導入ガイドにはこの手順の長いバージョンがあり、AIサポートの実装では、ここで省略したチェンジマネジメント側を扱っています。
自社の数字で見る、月ごとの計算
ほとんどのコストモデルは成熟したデフレクション率に一気に飛ぶため、1か月目はがっかりするように感じられます。自社の量を入れてみれば、立ち上がりの形がはっきり見えてきます。
課金単位はこの話のもう半分であり、このカテゴリで最も高くつく未定義の言葉です。人に対する席数課金。何かが解決したときだけの解決件数課金。AIが触れたすべての会話に対するチケット課金。これらは同じ量でもまったく異なる請求額を生み出すので、ベンダーに聞くべき質問は「いくらか」ではなく、何が起きたらカウンターが増えるのかです。eeselの答えは、料金ページでは、処理したチケットまたはチャット1件につき1クレジット(500クレジットで月299ドルから)で、メッセージが何往復しようと関係ありません。これは意図的に、サポートチームがすでに考えている単位です。解決単価の記事で正しい比較を行い、AIサポートのコストで各モデルを並べて比較しています。
何を測るべきか、ベンダーが混同する3つの言葉

ほぼすべてのベンダーのページで3つの指標が互換的に使われていますが、それぞれ測っているものは異なります。これが重要なのは言葉にこだわっているからではなく、顧客の体験が悪化している間でも、そのうち1つの指標だけは見た目が良くなりうるからです。PostHogのサポートリーダーは、このズレを私以上にうまく言い表しています。
"Most companies don't realize the frustration they're creating. They look at the numbers, see fewer tickets coming in, and read it as a good sign: customers must be doing fine. Companies call it "deflection." Customers call it being ignored."
PostHogがサポートAIではなくプロダクト分析を売っている会社であり、その投稿自体がサポートキューの前にAIを置くことそのものに反対していることは注目に値します。私は完全には同意しませんが、AIを道具として置くのかゲートとして置くのかという彼らの区別は正しく、デフレクションの数字だけではどちらを作ったのかは分かりません。
| 指標 | 分子 | 分母 | 隠されるもの |
|---|---|---|---|
| デフレクション率 | 一度も人間に届かなかった接触 | すべての接触 | 問題が解決したかどうか |
| 解決率 | 人間を介さずに実際に解決した問題 | AIが関与した会話 | 再連絡も一緒に測っていれば何も |
| コンテインメント率 | そのチャネル内に留まった会話 | そこに入ってきた会話 | 顧客が諦めたかどうか |
この系統のパーセンテージはどれも分母がなければ意味を持たず、ベンダーは最も大きな数字が出るフレーミングを選んで引用します。毎回それを取り戻す質問はこうです。何に対する何パーセントで、どの期間のものか?
実際に毎週私が見ているのはこれらです。
- 解決率と再連絡率をあわせて見る。 どちらか一方だけでは何も分かりません。2つ一緒なら、すべてが分かります。解決率を改善するガイドは、数字が誠実になった後の続きです。
- エスカレーション率とその理由。 健全なエスカレーションは失敗ではありません。Retrievalが何も見つけられなかったせいで発生したエスカレーションは、AIの問題ではなくナレッジベースのチケットです。
- ナレッジギャップ率。 エージェントが「答えられない」と旗立てした質問です。これは一覧全体の中で間違いなく最も実行可能な数字です。やるべきことのリストそのものだからです。
- 3通りに分けたCSAT。 AIが解決した会話、エスカレーションした会話、そして全体を混ぜたもの。これは3つの異なる数字で、混ぜた数字が最も使い物になりません。
- 自分の時間を含めたチケット単価。 ソフトウェアの価格は簡単な部分です。AIサポートのROIを正しく測るには、ナレッジベースの整理とレビューの時間も数える必要があります。
より詳しいリストについては、サポート指標の記事がここより深く掘っています。エスカレーションの質の側を特に知りたいなら、コンテインメント率が次に読むべき記事です。
実際のワークフロー、最初から最後まで
これは私が人々に何度も紹介している試用例です。結果が誰も予想していなかったものだったからです。
Zendeskを使い、裏側にShopifyがある、月に約1000件のチケットを処理するドイツのオンラインジュエリー販売店は、何かをオンにして祈るようなことはしませんでした。彼らはエージェントを実際のライブの受信箱に対して本当に動かしました。284件のチャットと、100件のチケットによるクロス検証を行い、すべての数字が自社のチームが既に対応済みのチケットから得られたものでした。
受信箱はおおよそ、直接の消費者向けサポートが38%、スパムが22%、社内のB2Bが21%に分かれていました。トリアージは93%の精度、スパム検知は誤検知ゼロで100%という結果になり、全体の4分の1近くがゴミである受信箱においては、顧客向けの返信が1件も存在する前からの、本物の初日成果でした。
草稿の質が最も強かったのは、まさに文書化がしっかりしたポリシーが存在する領域でした。保証請求で96.4%の有用な草稿、返品と返金で93.8%、商品に関する問い合わせと返金状況で100%です。
そして、みんなが止まった数字がありました。それらの草稿のうち、そのまま送られたのはわずか12%でした。
直感的にはこれを精度の問題として読みたくなります。しかし違いました。担当者が草稿を書き直した理由を分解したところ、編集の約65%は純粋な長さとトーンの問題で、担当者が8〜15文の草稿を1〜3文の返信に圧縮していたためでした。約20%はAIが接続されていないデータ、ERPや物流システムが必要なものでした。編集のうち、AIが事実を間違えていたために行われたものはわずか約5%でした。編集に対してではなく全サンプルに対して別に評価したところ、事実誤りの割合は7%でした。
この区別は、こうした導入を運用してきた中で私が学んだ最も有用なことです。「AIが間違っている」と「AIが自分たちらしい言い方をしていない」は異なる問題であり、解決策も異なります。そして、そのうち良い知識で解決できるのは片方だけです。 その試用から出た提言は具体的でした。直近の担当者の返信200件で学習させれば、そのまま採用される割合は12%から30〜40%へ上がるはずだというものです。

対比として、立ち上がりの反対側で公開されている2つの数字があります。Gridwiseは7日間の試用後の最初の1か月でTier-1リクエストの73%を解決し、これはeeselのプロダクトページで公開されています。Global Payはドキュメント内で回答を見つける時間を最大80%節約したと報告しています。どちらも本物で、どちらも公開されていますが、どちらもあなたの1か月目がどうなるかを示すものではありません。ジュエリーの試用の方こそ、それなのです。
AIカスタマーサポートにeeselを試す
これまでの内容が自分のキューに当てはまるように感じたなら、それはeeselが作られた課題の形そのものです。eeselはヘルプデスクを置き換えるのではなく、すでに運用しているヘルプデスクに接続します。Zendesk、Freshdesk、Gorgias、Front、Help Scout、HubSpot、Jira Service Managementに対応しています。ドキュメントと解決済みのチケットを読み取り、人間が先に目を通さない限り顧客には何も届かない草稿モードで開始します。
実際に強く勧めたい部分はシミュレーションです。何かが自分のチームで機能するかどうかを決める前に、自分たちの過去のチケットでエージェントを動かし、それが何を言っていたかをチームが実際に送った内容と並べて読んでください。この比較は、デモでは答えられない問いに答えてくれます。本番公開したあとは、固定の月額料金(500クレジットで月299ドルから)で、プラットフォーム料金も席数課金もなく、最初の100クレジットは無料です。それは、判断を下すのにほとんどのチームが必要とする以上のシミュレーションです。

eeselを試す、あるいは自分のチケットに対して誰かに案内してもらいながら見たい場合は、AIヘルプデスクエージェントのページが出発点になります。
よくある質問
AIカスタマーサポートとは何ですか?
AIカスタマーサポートは、顧客からの受信メッセージを読み取り、自社のドキュメントやチケット履歴から答えを探し、返信するか人間に引き渡すかを決めるソフトウェアです。実務上役に立つ区別は、決定木に従う台本型のルールベースのチャットボットと、自社のコンテンツを基に推論し、ヘルプデスク内でアクションを実行できるAIサポートエージェントの違いです。
AIカスタマーサポートが決して対応すべきでないことは?
誤ると高くつくか元に戻しにくいもの全般です。ポリシーの例外対応、請求に関する紛争、法律・医療・金融の助言、そしてすでに怒っている顧客からのチケットです。良い基準は不可逆性のテストです。1クリックで元に戻せない操作は人間が承認します。ガードレールに関する記事では、こうした境界線をどう組み込むかを説明しています。それが欠けているとどうなるかはハルシネーションを防ぐ方法で解説しています。
AIカスタマーサポートの導入にはどれくらい時間がかかりますか?
ヘルプデスクを接続し、最初のエージェントが回答できるようになるまでは約30分です。信頼できる導入に到達するまでは2〜4週間かかり、それを長引かせるのはほとんどの場合ソフトウェアではなくナレッジベースです。導入ガイドでは手順を、古くなったヘルプセンターのコンテンツでは最初に行う点検を扱っています。
AIカスタマーサポートは既存のヘルプデスクと連携できますか?
できます。ヘルプデスクを置き換えるより、その上に重ねる方がたいてい安全です。eeselはZendesk、Freshdesk、Gorgias、Front、Help Scout、HubSpot、Jira Service Managementに接続するので、キューやマクロ、レポートはそのまま残ります。完全なリストはインテグレーションページにあります。実際にどう見えるかはZendesk向けAIで確認できます。
AIカスタマーサポートはサポート担当者を置き換えますか?
実際のキューで起きているのは、繰り返しの多い層が消え、人間の仕事がより難しく価値の高いものになることです。人間に届くチケットは、あいまいなものです。AIと人間の担当者のコスト比較とTier-1デフレクションの記事で、境界線がどこにあるかを扱っています。