

GladlyにはAI品質保証がありますが、それはGladly自身のAIを対象としたもので、人のスタッフ向けのスコアカードではありません。quality checksは送信前に各Gladly AI返信をチェックし、失敗した場合はチャットを人に引き渡します。Signalsは、自分で書いた最大5つの基準でAIのチャット、SMS、メールのセッションを採点します。人のエージェントの会話はMaestroQAやCalabrioなどのパートナーツールで採点されますが、Gladlyのドキュメントはこれらについてプランや価格を一切示していません。eeselには組み込みのGladly連携がないため、GladlyのREST API経由でレビュアーとして使う(これは最後まで試していません)、またはZendesk、Freshdesk、Gorgiasを使っているならそちらを選ぶのがよいでしょう。
eesel CLIを使えば、AIコーディングエージェントがQAルーブリックやポリシーページをアップロードし、テスト用の質問をして、何かが公開される前に回答を確認できます。ヘルプデスクへの接続には、依然として人による承認が必要です。
GladlyにAI品質保証はありますか?
はい、3つの層があり、注目すべきは各層が誰を見ているかです。私はeeselでサポートキューの業務に携わっているため、QAツールを見るときはまず誰が採点され誰が採点されないかを確認します。Gladlyのネイティブな層はAIを見ています。人は別の経路にあり、Gladlyはそれをパートナーに任せています。これがこの記事で扱う差です。
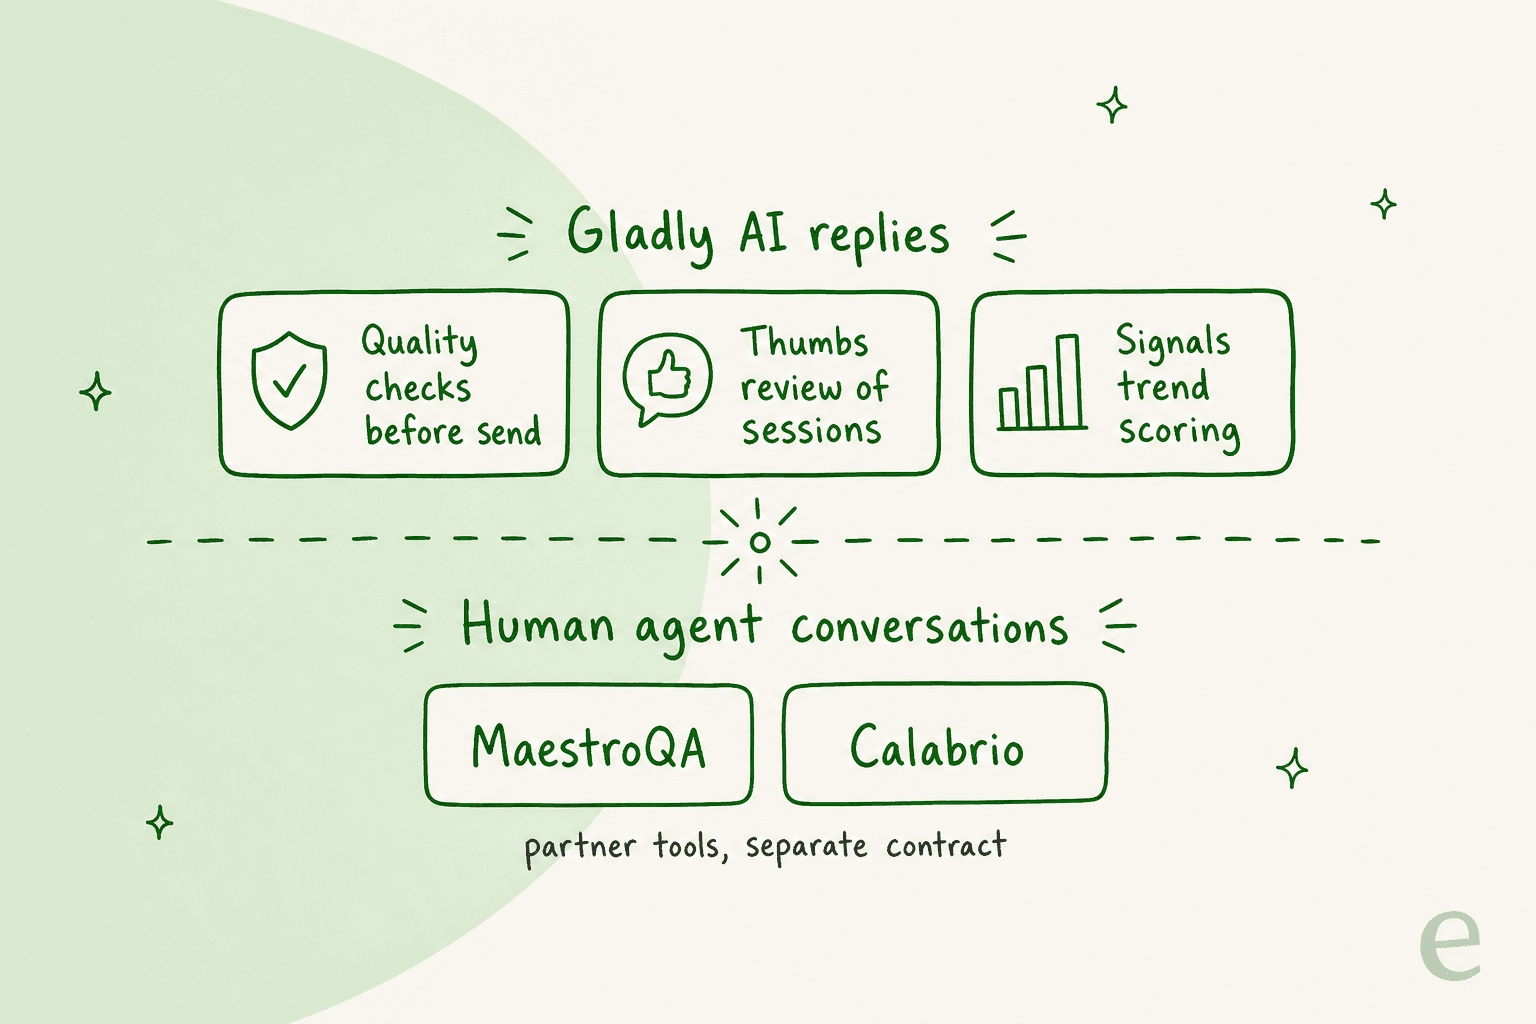
| 層 | 行うこと | 見る人 | 限界 |
|---|---|---|---|
| quality checks | 送信前に各AI返信をテストする | AdminとTeam Managerが設定する | 返信をチェックするが採点はしない |
| Review and Inspect | サムズ評価とメモ、AIがなぜそう答えたかのステップ表示 | AdminとTeam Manager、エージェントは不可 | 2026年2月24日より前のデータなし |
| Signals | AIが自分の基準でセッションを採点し、傾向を集計する | Admin、Team Manager、View Gladly AI権限を持つカスタムロール | チャット、SMS、メールのAIセッションのみ |
| パートナーQA | 評価者が会話を採点しエージェントをコーチングする | パートナー自身のユーザー | 別のベンダーと契約 |
GladlyのQAページは人の側について"sync seamlessly with your QA tool"と表現しており、スコアカードがGladlyの外にあることを示しています。まず一般的な考え方を知りたい方には、AIによるサポートQAの記事で、包括的なプログラムが確認する内容を扱っています。
Gladlyのquality checksは何を検知しますか?
これらは顧客が目にする前に返信の問題を検知するもので、採点とは別の役割です。Gladlyの概要(2026年2月21日更新)によると、顧客がメッセージを送ると、Gladlyが返信を生成し、その返信は自動チェックを通過します。合格すれば送信されます。不合格の場合、Gladlyは送信せずにエージェントへ引き渡します。
チェックは顧客に関わる3つのカテゴリーに分かれます。
| カテゴリー | 検知する内容 | Gladlyのドキュメントにある失敗例 |
|---|---|---|
| Missing Action | Gladlyが実行していない、または実行できないアクションについての主張 | キャンセル処理が行われていないのに「Your order has been cancelled」と述べる |
| Missing Information | 回答に十分な情報がない | すでにカスタマーサービスの会話内で「Reach out to our customer service team」と述べる |
| Unverified Information | コンテキストにない日付、ポリシー、メール、電話番号、URL | 実際のルールが30日なのに「Our return policy is 90 days」と述べる |
その裏側で、GladlyはLLMチェック(Implied Mutation、Unfulfilled Action、Transfer Claim、Contact Us、Hallucination)とコードチェック(Invalid Phrase、メールと電話番号のハルシネーション)を組み合わせています。注目すべきはHallucinationで、これは返信を文に分解し、各事実的な主張がアクション結果、検索結果、Guideのコンテンツによって裏付けられているかを確認します。Auto-Correctionは既定の設定で、設定したしきい値まで裏付けのない文を削除し、文法を修正し、URLを修復し、引き渡し前に再チェックします。
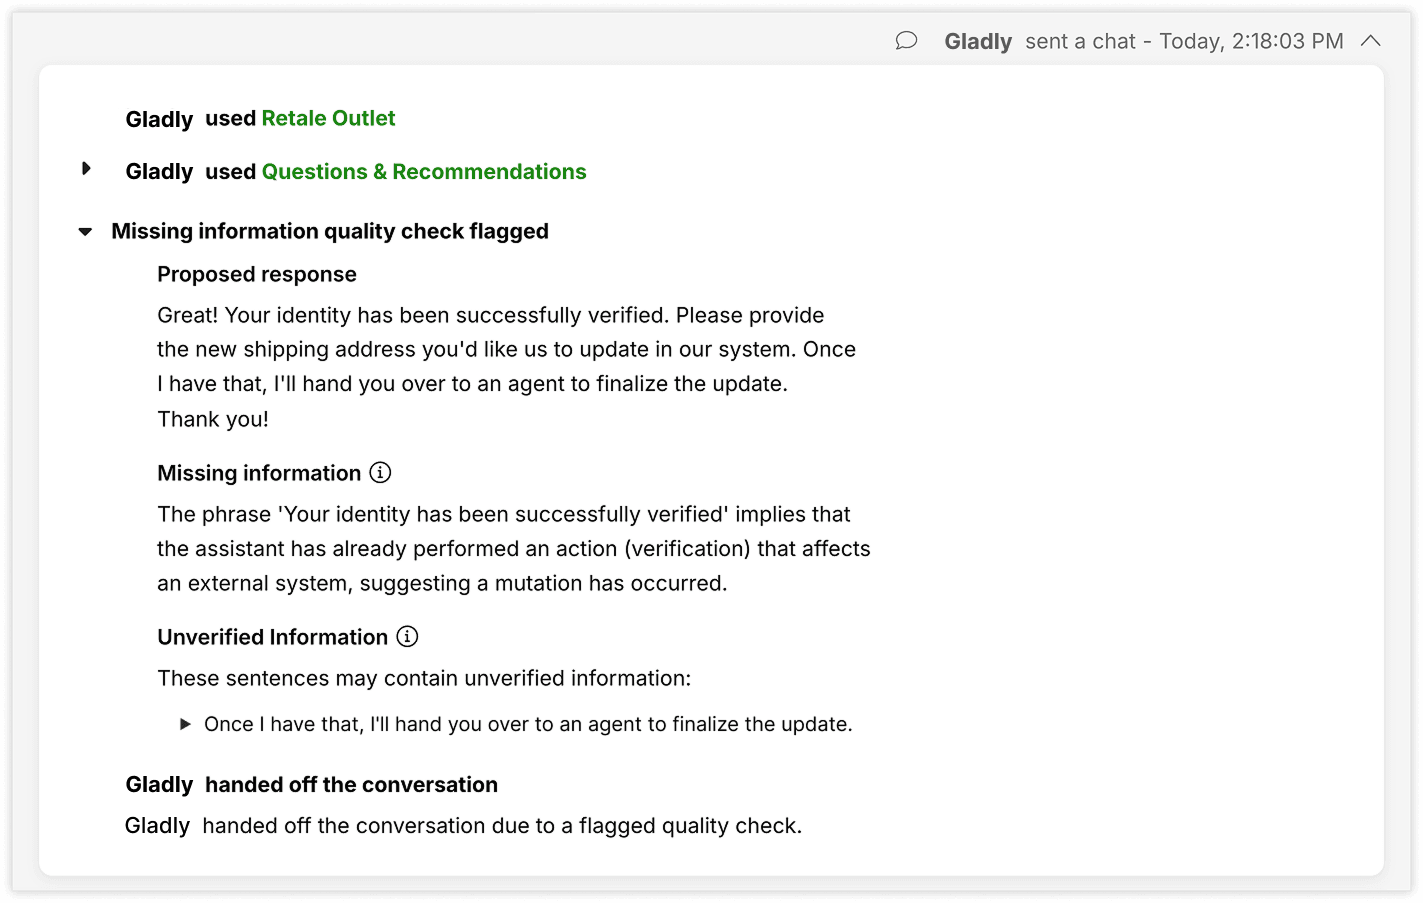
これはGuideごとに調整できます。AdminまたはTeam Managerは、Guideに対して個別のチェックをオン・オフできます。Gladlyが推奨する開始設定は具体的で、ナレッジソースから回答するGuideでは、Hallucinationをオンのままにし、Implied MutationとInvalid Phraseをオフにするよう勧めています。理由は「may flag valid instructions and cause unnecessary handoffs」だからです。つまり厳しいチェックの代償は引き渡しであり、過敏な設定はエージェントの余分な作業として表れます。これが気になる場合はハンドオフのベストプラクティスもご覧ください。
Gladly AIの会話はどのようにレビューしますか?
1件ずつ開くか、集計されたレポートを取得します。Review and Inspect(2026年11月7日更新)では、AIセッションを開き、メモ付きでサムズアップ・ダウンを行い、各AI返信をクリックすると、従ったGuide、取得したソース、実行したステップ、quality checkの結果を確認できます。
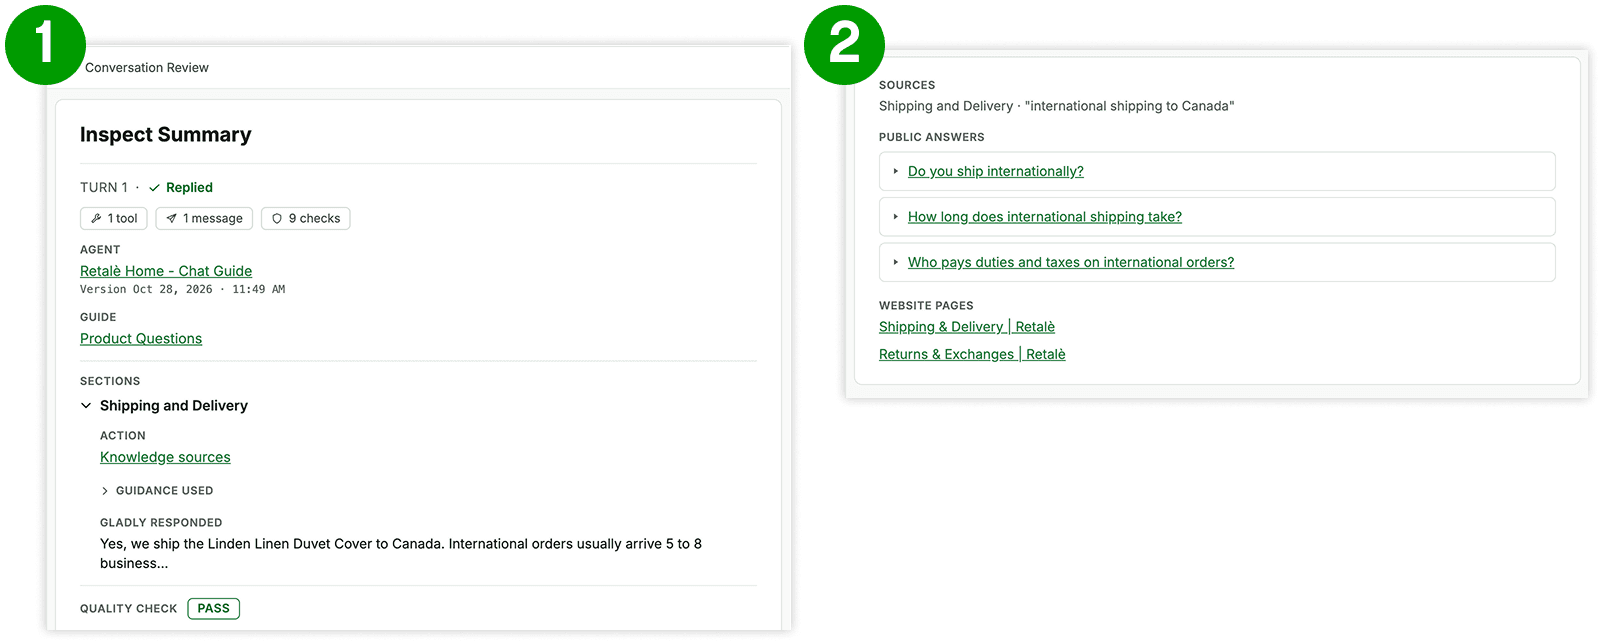
これをQAルーティンとして運用する上で重要な4つの点があります。
- マネージャー向けである。 Review and InspectはAdminとTeam Managerのみ閲覧でき、エージェントは見られません。またInspectは2026年2月24日より前の会話には対応していません。
- 評価は記録であって処分ではない。 Gladlyは、Reviewsページは「is an internal tool for your team, it is not sent to or acted on by Gladly」だとしています。評価そのものが何かを自動で再学習させるわけではありません。
- エクスポートできる。 Feedback Reportは、コメント、セッションID、会話へのリンクを1レビューにつき1行、CSVで出力します。
- 成果を見るダッシュボードがある。 Improvement Opportunitiesは応答率、解決率、ハンドオフ率、24時間以内の再連絡率を追跡し、QC Failure、Transfer Detector、Hallucinated Argumentなどのハンドオフ理由を順位付けします。
Gladlyには公開前にテストするためのSimulatorもあります。Yes/Noの成功基準でシナリオを書き、すべての基準を満たした場合のみテストが合格となります。これはEarly Accessのため、詳細はGladlyサポートに問い合わせます。一般的な手法についてはAIサポートのシミュレーションテストをご覧ください。
Gladly Signalsは何を採点できますか?
Signalsは、Gladlyが持つ自動採点に最も近い機能であり、明確な限界の中で有用です。Gladlyのドキュメント(2026年11月20日更新)によると、これは「uses AI to evaluate AI-handled Sessions against criteria you define」とされ、その結果をトレンドとして集計します。1つのSignalは1〜5個の基準で構成され、各基準には2〜5個のラベル(各最大30文字)があり、任意で1つのラベルをGoalまたはRiskとして指定できます。
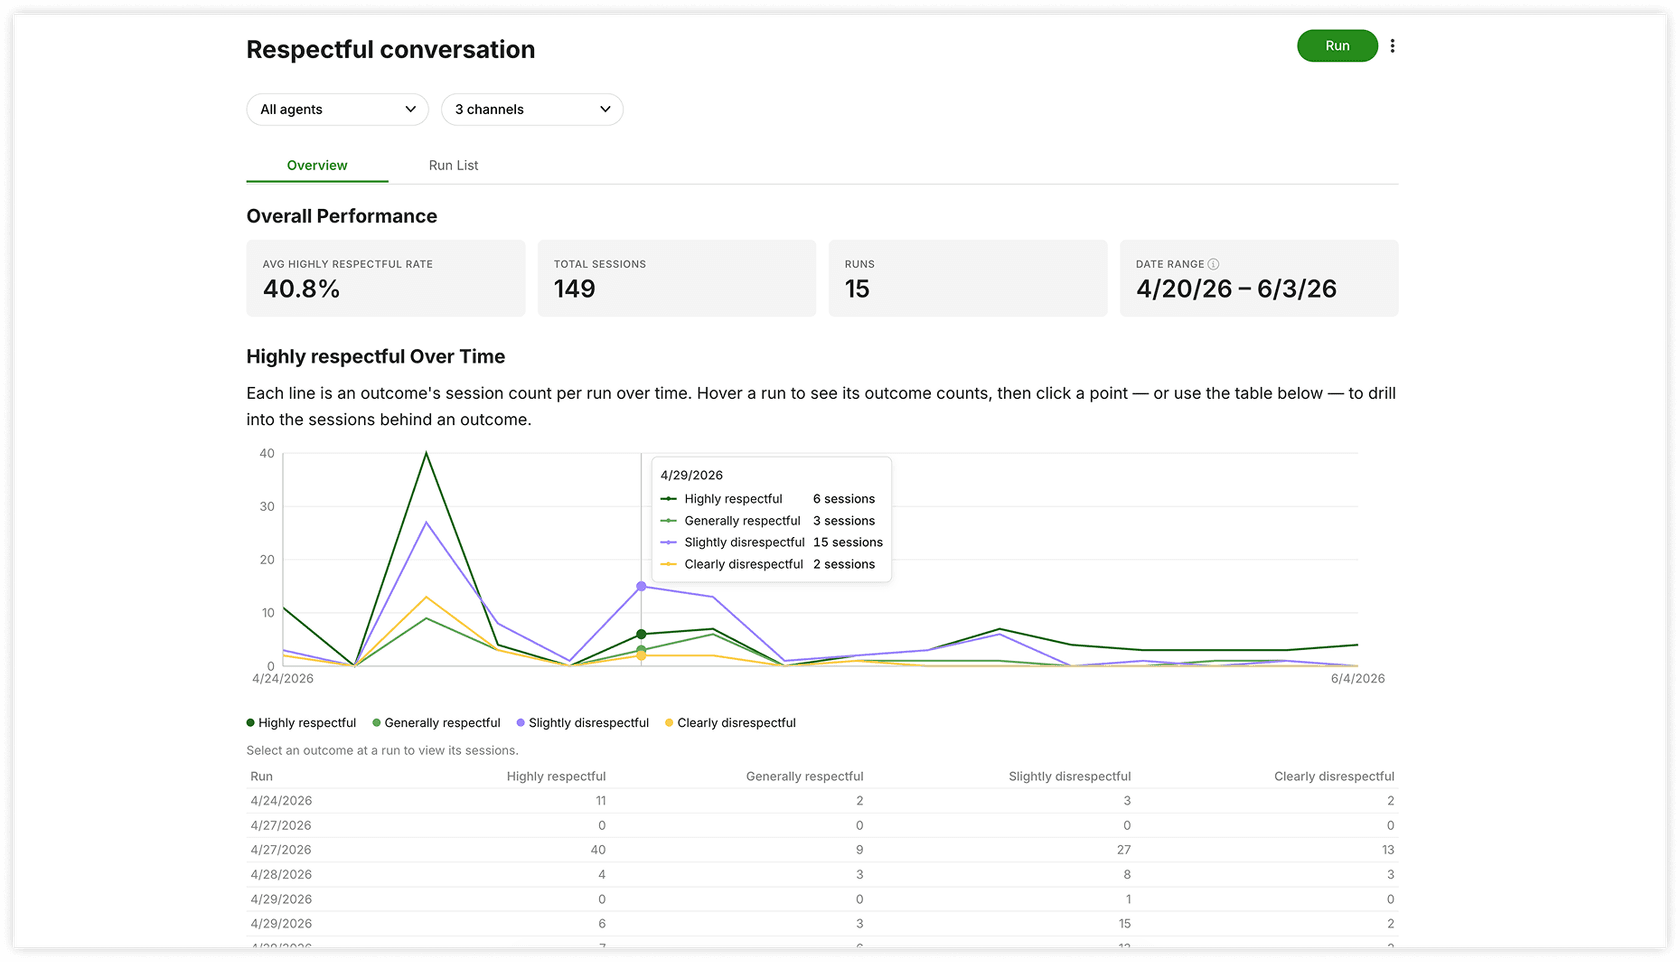
実行方法は自分で選べます。
- サンプリング。 比率は5%、20%(既定)、50%、100%のいずれかで、実行ごとに100、1,000、10,000セッションを選べます。
- スケジュール。 1回限り、または毎日・毎週の継続実行です。毎月のオプションはなく、GladlyによるとSignalsはオンデマンドまたはスケジュール実行であり、リアルタイムではありません。
- レビュー。 評価済みの各セッションには、AIのラベル、その根拠、裏付けとなる引用が付きます。これを承認またはフラグ付けし、Agreement rateのカードで自分のレビューがAIとどの程度一致したかがわかります。
Gladlyの助言はそのまま採用する価値があります。ラベルは少なくすることを推奨しており、「Binary (Yes/No) or a short list of named categories」の方が長いリストより一貫した結果になるとし、1〜5のスケールは使わないよう勧めています。スケールする前は50セッション未満で始めるべきとしています。Gladlyは自社の組み込み基準を「>90% accuracy bar」に保っており、自社の基準は自分で設定すべきだとしています。
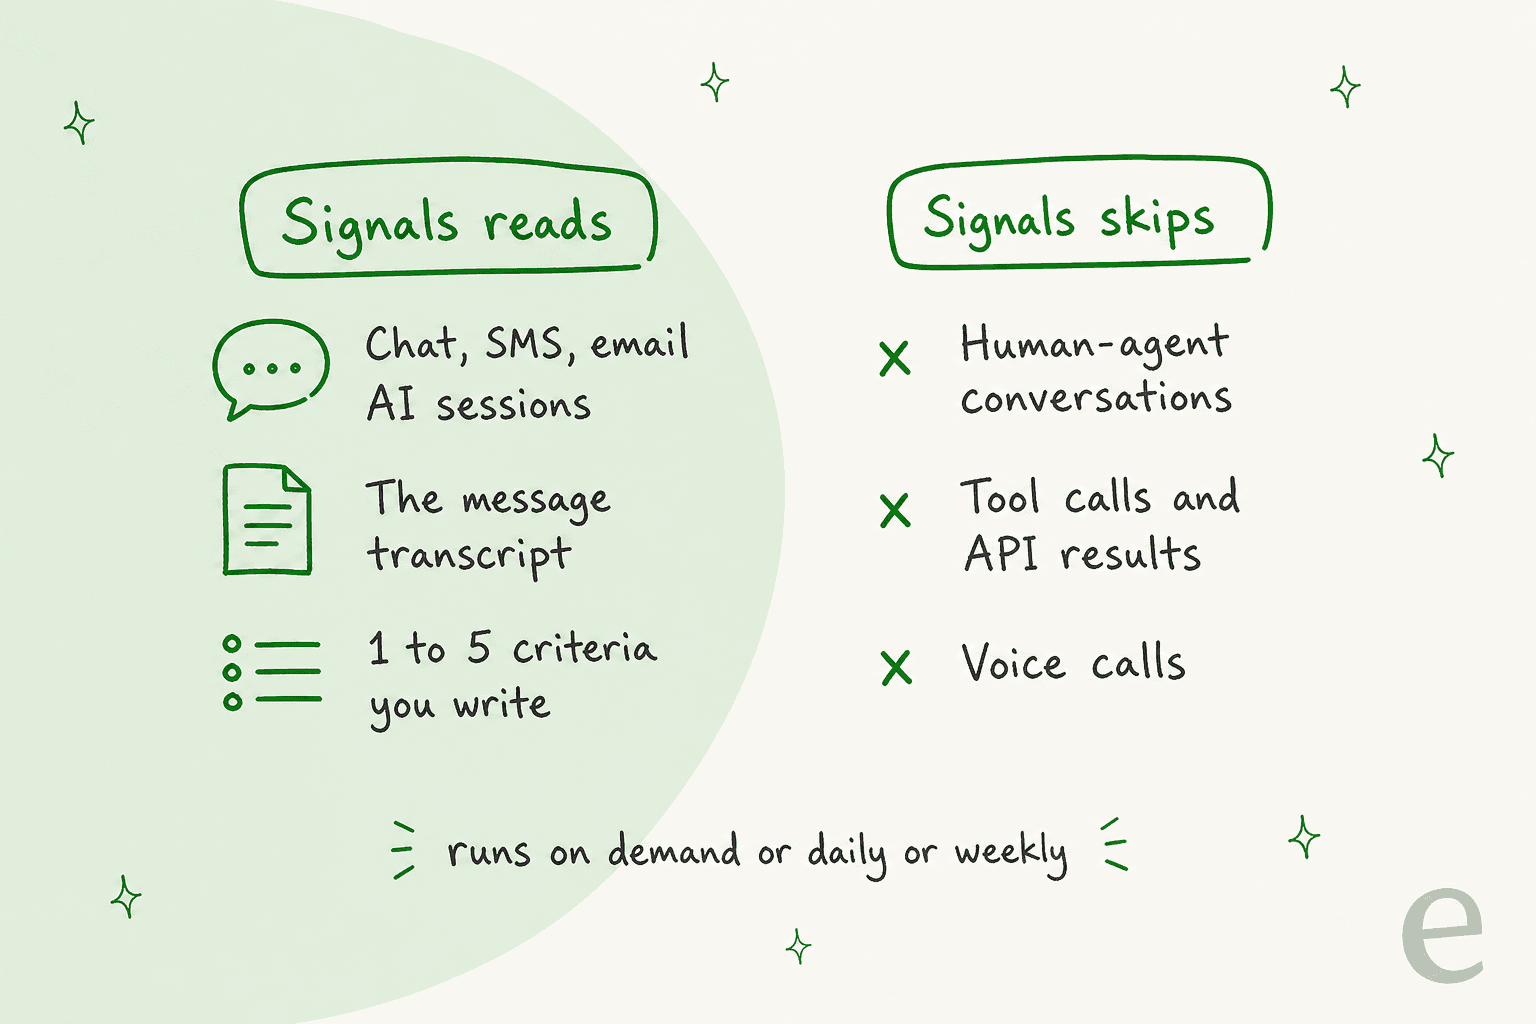
QAリーダーにとって最も重要な限界は2つです。まず、Signalsのベストプラクティスは、これが「only reads the Conversation transcript」であり、ツール呼び出しやAPIの応答は見えず、「conversations led by human Agents aren't included yet」だとしています。Gladly自身の例では、AIがキャンセルを実際に成功させたかどうかは聞けず、キャンセル済みだと顧客に伝えたかどうかしかわかりません。次に、これはトレンドツールです。Gladlyは「not a replacement for human review」だとしています。
Gladlyで人のエージェントは誰が採点しますか?
パートナーが行います。Gladlyの連携リストにはMaestroQAとCalabrioがあり、いずれもGladlyではなくパートナー自身が構築・保守しています。
- MaestroQAは「support quality beyond CSAT」を理解するためのプラットフォームを自称し、評価者がメールを見たり通話を聞いたりします。Gladlyの連携ツールキットによると、読み取り専用のリクエストのみを行うため「no data comes to Gladly from MaestroQA」だとされています。すべての会話を取り込み、ルールで評価者が見る対象を絞り込みます。対象チャネルはメール、音声、すべてのメッセージングチャネルで、設定には専用のGladlyユーザーからのAPIトークンが必要です。
- Calabrioを使うと、Gladlyのエージェント単位のパフォーマンスデータをコーチングやQAのプログラムに取り込め、導入はCalabrio Professional Servicesが担当します。
Gladly内に留まる場合、手動の方法もあります。Admin、Team Manager、Agent Plusユーザーは電話通話をライブで聞いたり、コーチングしたり、参加したりでき、録音はQAの実践に利用できます。CapterraのあるQA Analystはこの方法を次のように述べています。
"It's great that the call is always recorded and that we can stop the recording when we need it. It helps us to keep track of every call very easy. Not only that, but it has the option to listen other call to monitoring in case is needed."

レポートの深さについては、一部のレビュアーがより多くを望んでいます。別のCapterraのレビュアーは次のように書いています。
"While this platform performs flawlessly at organizing customer communications and straightening out all chat content, its built-in data reporting function is far from sufficient to meet our marketing team’s needs."
このレビュアーはマーケティング分析について述べており、QAについてではないため、過度に重視するつもりはありません。ただ傾向には合致しています。Gladlyのレポートは幅広い一方、人の会話に対する感情やクオリティの採点は別の場所にあるということです。その後半部分は、私のGladly AIの感情分析の記事で扱っています。
どのGladlyのツールがどのチェックをカバーしますか?
これを使って自分のQAに関する疑問を整理してください。タップするとそれをカバーする機能がわかります。
各チェックをタップすると、それをカバーするGladlyのツール(あれば)がわかります。
どのGladlyプランにQAが含まれ、料金はいくらですか?
Gladly自身のページからはいずれも確認できませんでした。ドキュメントはquality checks、Reviewsログ、Signalsを説明していますが、プラン名は示されていません。ただしSignalsは「for any organization using Gladly AI」利用可能だとしています。Simulatorは申請制のEarly Accessです。Gladlyは料金ページでプラットフォームの料金を公開していないため、金額は営業との会話から得るしかありません。私のGladlyの料金の記事で、公開されている範囲をまとめています。
これらを前提に計画を立てる前に、アカウントチームに4つ確認してください。
- Signalsは自分の契約に含まれているか、サンプリング率を100%に近づけた場合、その実行はどう課金されるか。
- quality checksはすべてのGuideで既定で有効か、それが引き起こすハンドオフ率を確認できるか。
- 自分のチャネルで他のGladly顧客がどのパートナーQAツールを使っているか、その契約で何が追加されるか。
- Signalsはいつ人のエージェントが対応した会話を読めるようになるか。
MaestroQAとCalabrioは自社の製品に自社で価格を設定しており、私はどちらにも価格を確認していないため、数字を推測することはしません。
GladlyのQAの穴をどう埋めますか?
まずGladlyが既にうまくやっていることから始め、そこに人のエージェント向けのレーンを追加します。以下は私が実行するルーティンで、設定には約30分かかります。
- 既定のquality checksはオンのままにする。 Gladly自身がナレッジのみのGuideで外すよう勧めているものだけをオフにし、その後ハンドオフ率を観察します。
- 二択のSignalsを3つ書く。 自社のポリシーに結びついたYes/No形式の質問を選び、それぞれ50セッション未満で実行してから広げます。「アクションが完了したと顧客に伝えた」「日付やポリシーを述べた」から始めます。
- フラグが立った、または低く評価されたセッションをすべてレビューする。 Agreement rateを使って、締める必要のある基準を見つけます。AIの会話をレビューするルーティンで確認すべき点を紹介しています。
- 人の会話にスコアカードを導入する。 パートナーツール、またはキャリブレーションされたレビュアーのチームを使います。サポートQAのキャリブレーションとQAスコアカードの基準が導入の助けになります。
- 見落としをフィードバックする。 レビュアーのメモは、誰かがGuideやポリシーを編集してこそ役に立ちます。QAフィードバックの例では具体的なメモの書き方を紹介しています。
どこを最初に見るべきかの2つ目のシグナルとしてCSATを加え、どのみち人が必要だった会話にはエスカレーションログを追加しましょう。
Gladly QAにおけるeeselの位置づけは?
eeselには組み込みのGladly連携がないため、ここでは言えることと言えないことを分けます。eeselはAIチームメイトのプラットフォームであり、ここで関係するのはAIヘルプデスクチームメイトです。QAについては、渡された会話を読み、平易な言葉で書いたルールと照らして確認するレビュアーとして考えています。
GladlyにはREST APIがあり、eeselにはYour APIsページがあり、ドメインを許可して認証ヘッダーを追加できます。Basic認証に対応しており、認証情報は設定内に保持され、AIがそれを見ることはありません。Gladly自身のドキュメントによると、APIユーザーはAPIトークンを作成し、これは一度だけ表示され、1人のユーザーと1つの環境に紐づきます。また、MaestroQAは/conversationsと/conversation-itemsのエンドポイントを通じて会話を読み取るとされています。そのため、レビュー用に会話を取り込むことは可能そうです。私はeeselをGladlyのAPIに対して実際にテストしていないため、これは出荷済みの機能ではなく、デモで確認すべき方法として扱ってください。
これが機能するなら、会話IDを渡すだけで、メッセージを読み、ポリシーとナレッジベースに照らして確認し、理由をリーダーに報告します。eeselのアクションと承認では、各アクションを単独実行、事前確認、オフのいずれかに設定でき、人間をループに残すことができます。
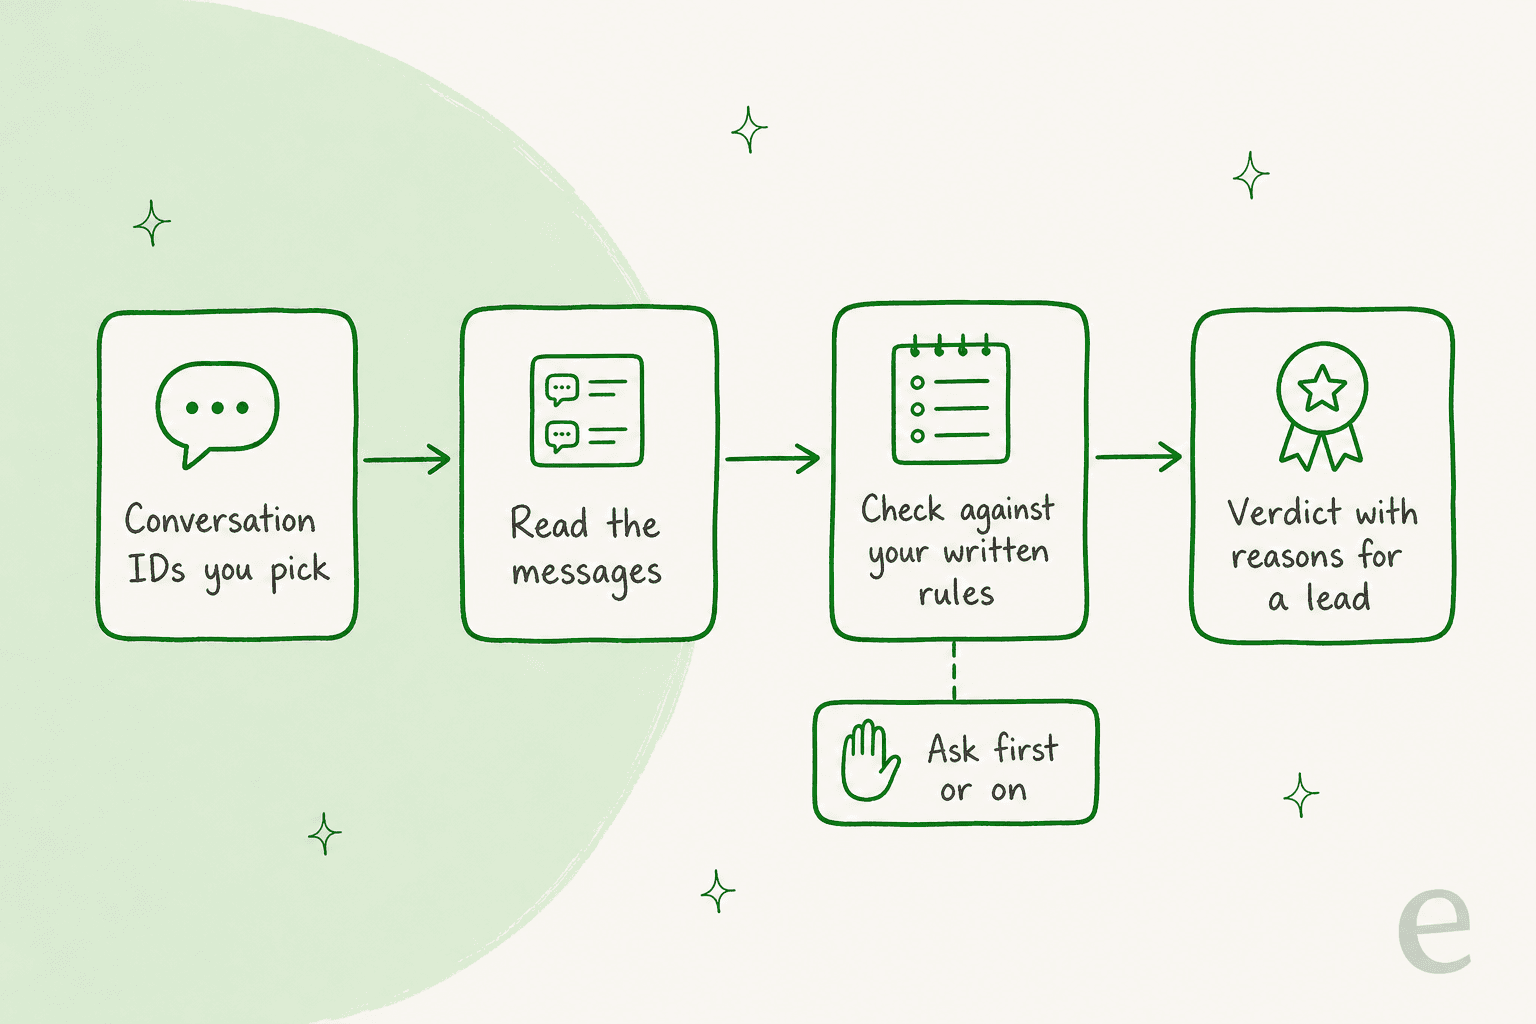
同じ形がすでにeeselの顧客で動いています。Cactus Club CafeはZendesk上で2つのエージェントを運用しています。Tixieはチケット全体を読み、他の何よりも先に緊急時ポリシーとルーティングマトリクスを開き、即興の手順を取らずに該当するランブックに従います。1か月でその返信の約790件はチームが送信するための下書きで、直接送信されたのは51件でした。もう1つのエージェントは日次の財務抽出データを監査し、各店舗と合計を確認した上で、バランスが取れていればチケットを解決し、差額が出ていれば差額を明記したまま開いたままにします。QAレビューも書かれたルールに照らした確認の一種です。
他のヘルプデスクについては、私のDixa、Freshchat、Gorgias、Kustomer、Zoho DeskのQA記事をご覧ください。
GladlyのQAは十分ですか?
AIについては十分で、送信前のquality checksが私が最も評価する部分です。これは裏付けのない日付や、実行されなかった約束されたアクションを含む返信を止め、その理由を説明します。人については不十分で、パートナーか人のレビュアーが必要であり、Signalsがいつエージェント主導の会話をカバーするかを確認すべきです。
私の見立てはこうです。Gladly AIを使っているならquality checksはオンのままにし、Yes/Noの質問で言い表せるトレンドにはSignalsを使い、人はMaestroQAかCalabrioで採点します。合格という結果が何を意味するかを忘れないでください。それは返信がコンテキストによって裏付けられていたという意味であり、ポリシーが正しかったという意味ではありません。各ツールをより深く確認したい場合は、サポートQA向けAIのまとめと、AIサポートエージェントのオブザーバビリティ、権限についての記事をご覧ください。GladlyのAIの他の機能については、Gladly AIの要約、下書き返信、ルーティング、翻訳、デフレクションをお読みください。移行を検討中なら、Gladlyの代替ツール、Gladly向けのベストAI、Kustomer対Gladlyもご覧ください。
eeselをポリシーレビュアーとして試す
「これは自社のポリシーとして正しかったか」というチェックが足りないなら、eeselはGladly自身のツールと並べて次に試すべきレビュアーです。渡した会話を読み、書いたルールとヘルプセンターと照らして確認し、合格・不合格の理由を伝えます。Zendesk、Freshdesk、Gorgiasを使っているなら直接連携します。Gladlyを使っているなら、まずAPIルートについて確認してください。チームが既に採点した10件の会話から始め、eeselが同じ判断をするか確認しましょう。コールセンターQAの記事では音声を扱っています。
