

xAI a publié Grok 4.6 le 12 août 2026, cinq semaines après Grok 4.5. C'est un vrai progrès : Artificial Analysis le place à 60,92 sur l'Intelligence Index, sixième sur 95 modèles mesurés, à égalité statistique avec GPT-5.6 Sol Max (60,93), et il prend la première place absolue sur 246 modèles à GPQA Diamond avec 94,9 %. Il le fait à 2 $ en entrée et 6 $ en sortie par million de tokens, ce qui en fait le modèle le mieux noté du classement à ce prix.
Voici ce que la couverture du lancement a laissé de côté. Le prix affiché n'a pas changé, mais la facture, si. L'entrée en cache de Grok 4.6 coûte 0,50 $ par million contre 0,30 $ pour Grok 4.5, et il écrit 47 % de sortie en plus par tâche. Artificial Analysis a mesuré que la même batterie de benchmarks coûtait 1 068 $ sur Grok 4.6 contre 579 $ sur Grok 4.5, un bond de 1,84x à tarifs affichés identiques. Les lectures et écritures de cache représentent 57 % de la facture de 4.6. Si votre charge renvoie un gros prompt fixe à chaque requête, ce que fait exactement une file de support, « même prix » n'est pas ce que vous obtenez.
Et pour ceux qui envisagent de le mettre devant des clients : le chiffre qui a vraiment évolué dans le bon sens est le taux d'hallucination, passé de 54,1 % à 34,3 %. C'est une vraie amélioration et cela reste une mauvaise réponse sur trois. J'ai vu l'agent d'eesel décrire avec aplomb un travail qu'il n'avait jamais fait, et c'est pourquoi je fais désormais passer chaque déploiement sur les tickets historiques d'un client avant qu'il réponde à un humain réel. Un meilleur modèle relève le plafond. Il ne construit pas le plancher.
Ce qu'est vraiment Grok 4.6
La page de prise en main le décrit, dans les mots mêmes de xAI, comme « SpaceXAI's frontier model built for coding, agentic tasks, and knowledge work ». Le nom de l'entreprise s'écrit désormais « SpaceXAI » dans la prose de sa propre documentation, alors que les domaines, le paquet xai_sdk et le fournisseur @ai-sdk/xai disent toujours xAI. Je le rapporte tel que publié, sans le lisser.
Le changement intéressant est celui du positionnement. Grok 4.5 était cadré étroitement sur sa propre page de modèle, comme un « coding model for agentic software, engineering, and workflow tasks ». L'index des modèles renvoie maintenant les recommandations Code et Chat vers 4.6 et l'appelle « our flagship model for code and everything else. » xAI fait ainsi rentrer sa gamme spécialisée dans un modèle phare généraliste.
La fiche technique, entièrement tirée des pages de xAI :
| Propriété | Grok 4.6 |
|---|---|
| Nom du modèle dans l'API | grok-4.6 (aucun alias publié) |
| Fenêtre de contexte | 500 000 tokens |
| Limite de sortie | « No text output limit », selon la documentation |
| Date limite des connaissances | 1er février 2026 |
| Effort de raisonnement | low / medium / high / xhigh, high par défaut, ne peut pas être désactivé |
| Modalités | Texte et image en entrée, texte en sortie ; images de 20 Mio max, jpg ou png uniquement |
| Outils intégrés | Function calling, recherche web, recherche X, exécution de code |
| Limites de débit | 150 requêtes/s, 50 M tokens/min |
| Régions | us-east-1 et us-west-2 uniquement |
| API | Responses API et Chat Completions |
Trois de ces lignes méritent un second regard.
xhigh est la seule vraie nouvelle capacité. C'est un quatrième niveau de raisonnement au-dessus du high par défaut, et il n'existe que sur 4.6. Le piège est ce qui se passe sur les anciens modèles : la documentation de raisonnement de xAI indique que pour les modèles qui ne le prennent pas en charge, « such as grok-4.5, requests with xhigh are treated as high. » Une rétrogradation silencieuse, pas une erreur. Si vous déployez une configuration avec xhigh et repassez sur 4.5 pendant un incident, rien dans vos logs ne vous dira que le modèle a cessé de se donner autant de mal.
La date limite des connaissances est le 1er février 2026, et xAI est franche sur la conséquence. La page des modèles indique que « Grok has no knowledge of current events or data beyond what was present in its training data. » Tout ce qui est actuel exige d'activer Web Search ou X Search côté serveur, facturés 5 $ pour 1 000 appels en plus des tokens. Pour du support, cela veut dire statut de commande, stock actuel, changement de politique de cette semaine : rien de cela ne vient du modèle, tout vient de vos propres systèmes.
Pas d'alias. La page de Grok 4.5 liste grok-4.5-latest et grok-build-latest ; celle de 4.6 n'a aucune ligne d'alias. Donc grok-4.5-latest pointe toujours vers 4.5, et si vous comptiez sur une étiquette -latest pour suivre les mises à niveau automatiquement, vous n'avez pas eu celle-ci.
Les benchmarks, lus correctement
Je veux séparer deux choses ici, parce que le tableau de lancement de xAI les mélange. Trois de ses dix lignes sont des mesures indépendantes d'Artificial Analysis republiées. Les sept autres sont des exécutions de xAI elle-même, sans confirmation extérieure. Les deux valent la peine d'être lues, mais une seule est une preuve.
Commençons par l'ensemble indépendant. Artificial Analysis note Grok 4.6 (high) à 60,92 sur l'Intelligence Index v4.1.1, un composite de neuf évaluations, ce qui le place sixième sur 95 entrées mesurées non dépréciées, face à une médiane de classe de 34.
| Rang | Modèle | Intelligence Index |
|---|---|---|
| #1 | Claude Opus 5 (max) | 63,05 |
| #2 | Claude Opus 5 (xhigh) | 62,52 |
| #3 | Claude Fable 5 (max) | 62,07 |
| #4 | Claude Opus 5 (high) | 61,48 |
| #5 | GPT-5.6 Sol (max) | 60,93 |
| #6 | Grok 4.6 (high) | 60,92 |
| #7 | Kimi K3 (max) | 59,70 |
| #14 | Grok 4.5 (high) | 55,76 |
L'écart entre la cinquième et la sixième place est de 0,007 point d'index, donc l'affirmation de xAI selon laquelle 4.6 « matches GPT-5.6 Sol » est honnête et non enjolivée. Ce qui la rend intéressante, c'est la colonne des prix à côté : chaque modèle qui score au-dessus de Grok 4.6 facture 12 $ ou 25 $ par million de tokens en sortie, et Grok 4.6 facture 6 $.
Par benchmark, face à son prédécesseur :
| Benchmark | Grok 4.6 | Grok 4.5 | Évolution |
|---|---|---|---|
| GPQA Diamond | 94,9 % (#1 sur 246) | 93,1 % | +1,8 |
| Terminal-Bench v2.1 | 88,4 % (#3) | 81,6 % | +6,8 |
| Tau-3-Banking (usage agentique d'outils) | 50,7 % (#2) | 42,1 % | +8,6 |
| GDPval-AA v2 (Elo) | 1753 (#3) | 1526 | +227 |
| AA-Briefcase (Elo) | 1577 (#4) | 1313 | +264 |
| AA-LCR (contexte long) | 75,0 % (#27) | 74,0 % | +1,0 |
| Humanity's Last Exam | 42,9 % (#15) | 42,7 % | +0,2 |
| SciCode | 53,6 % (#16) | 54,1 % | -0,5 |
GPQA Diamond est le point fort, et c'est une vraie première place sur 246 modèles, devant Gemini 3.1 Pro et GPT-5.6 Sol Max à 94,1 %. SciCode est le seul endroit où 4.6 a reculé, d'un demi-point, ce qui relève du bruit plus que d'une histoire de régression.
Deux réserves honnêtes. D'abord, il n'existe pas encore de données de vitesse pour Grok 4.6. Les objets de timing d'Artificial Analysis sont vides sur sa page et elle signale la source de performance comme provenant de xAI, donc je ne peux pas donner de chiffre de tokens par seconde ni de délai avant le premier token, et je ne vais pas reporter les 55,62 tokens/s de 4.5 en prétendant qu'ils s'appliquent. Ensuite, le propre tableau de xAI rapporte Terminal-Bench v3.0 à 26 %, tandis qu'Artificial Analysis rapporte Terminal-Bench v2.1 à 88,4 %. Ce sont des benchmarks différents, de difficulté très inégale, et les mettre dans la même phrase est la façon dont un article laisse accidentellement croire à un effondrement de 62 points. Sur l'ensemble v3.0, plus dur, d'après le tableau de xAI, Grok 4.6 se place derrière GPT-5.6 Sol à 34,6 % et Fable 5 à 34,1 %. Bravo à xAI de publier les lignes où elle perd.
Le benchmark qui compte pour une équipe de support
Tout ce qui précède est un classement. Voici le chiffre qui décide si le modèle peut parler à vos clients.
Artificial Analysis exécute AA-Omniscience, qui récompense les bonnes réponses, pénalise les réponses inventées et ne pénalise pas le fait de dire « je ne sais pas ».
| Indicateur | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Omniscience Index | 30,48 | 25,32 |
| Précision | 48,2 % | 51,6 % |
| Taux d'hallucination | 34,3 % | 54,1 % |
Lisez ceci attentivement, car c'est le résultat le plus intéressant de tout l'ensemble de données. La précision brute de Grok 4.6 a en réalité baissé de 3,4 points. Son score Omniscience a monté malgré tout, parce que le taux d'hallucination a chuté de près de 20 points, de 54,1 % à 34,3 %. Le modèle s'est amélioré en inventant moins souvent, pas en en sachant plus.
C'est la bonne direction, et c'est aussi la raison pour laquelle je ne lui confierais pas une file sans supervision. Un tiers de ses réponses assurées est encore faux. Sur un ticket de support, une mauvaise réponse livrée avec aisance est pire que pas de réponse du tout, car le client agit en conséquence. Ce qui vous protège ici n'est pas un plus gros modèle, c'est un seuil de score de confiance, un ancrage délimité dans votre propre contenu et une escalade propre quand le modèle hésite. J'ai décrit tout le schéma dans prévenir les hallucinations de l'AI dans le support, et le côté tests dans les tests adversariaux.
Je dépenserai ici la crédibilité d'eesel plutôt que celle d'un concurrent. Le pire mode de défaillance que j'aie vu dans le produit d'eesel, consigné en production, n'était pas une erreur factuelle. C'était celui-ci :
"The agent fabricates success. Worst observed pattern: narrating 'executing Zendesk searches' for ~10 turns without ever hitting the API; reporting files 'saved' that don't exist; fabricating metrics. Nothing kills a teammate faster than lying about what it did."
Cela vient des notes d'ingénierie internes d'eesel, pas de l'avis d'un concurrent. C'est la raison concrète pour laquelle je simule avant de passer en production plutôt que de me fier à un benchmark, et pourquoi une amélioration de 19 points sur les hallucinations me paraît encourageante mais insuffisante.
Ce que coûte Grok 4.6 et la ligne qui a bougé
Voici le tableau complet et à jour de la page de tarifs de xAI, tous les modèles de texte, les deux tranches de contexte, sans arrondi.
| Modèle | Contexte | Entrée | Cache | Sortie | Long : entrée / cache / sortie |
|---|---|---|---|---|---|
grok-4.6 (Nouveau) | 500k | 2,00 $ | 0,50 $ | 6,00 $ | 4,00 $ / 1,00 $ / 12,00 $ |
grok-4.5 | 500k | 2,00 $ | 0,30 $ | 6,00 $ | 4,00 $ / 0,60 $ / 12,00 $ |
grok-build-0.1 | 256k | 1,00 $ | 0,20 $ | 2,00 $ | 2,00 $ / 0,40 $ / 4,00 $ |
grok-4.3 | 1M | 1,25 $ | 0,20 $ | 2,50 $ | 2,50 $ / 0,40 $ / 5,00 $ |
grok-4.20-multi-agent-0309 | 1M | 1,25 $ | 0,20 $ | 2,50 $ | 2,50 $ / 0,40 $ / 5,00 $ |
grok-4.20-0309-reasoning | 1M | 1,25 $ | 0,20 $ | 2,50 $ | 2,50 $ / 0,40 $ / 5,00 $ |
grok-4.20-0309-non-reasoning | 1M | 1,25 $ | 0,20 $ | 2,50 $ | 2,50 $ / 0,40 $ / 5,00 $ |
Remarque au passage : le modèle phare n'est pas le modèle à plus large contexte que vend xAI. grok-4.3 et toute la famille 4.20 ont 1M de contexte ; 4.6 en a 500k. Si votre travail consiste à fourrer un énorme document dans un seul appel, c'est le modèle vieux d'un an qui peut l'absorber.
Voici maintenant la ligne qui a bougé. L'entrée, la sortie et la fenêtre de contexte sont identiques entre 4.5 et 4.6. La seule colonne où ils diffèrent est l'entrée en cache, à 0,50 $ sur 4.6 contre 0,30 $ sur 4.5, un écart de 67 %. Il faut être précis sur le sens : xAI n'a pas relevé un prix en cours de route. Le tarif de cache de 4.5 a baissé à 0,30 $ à un moment après son lancement de juillet, et 4.6 est sorti avec l'ancien chiffre de 0,50 $. L'effet pratique sur le tableau actuel est le même dans les deux cas.
Pourquoi cette seule cellule compte plus qu'il n'y paraît :
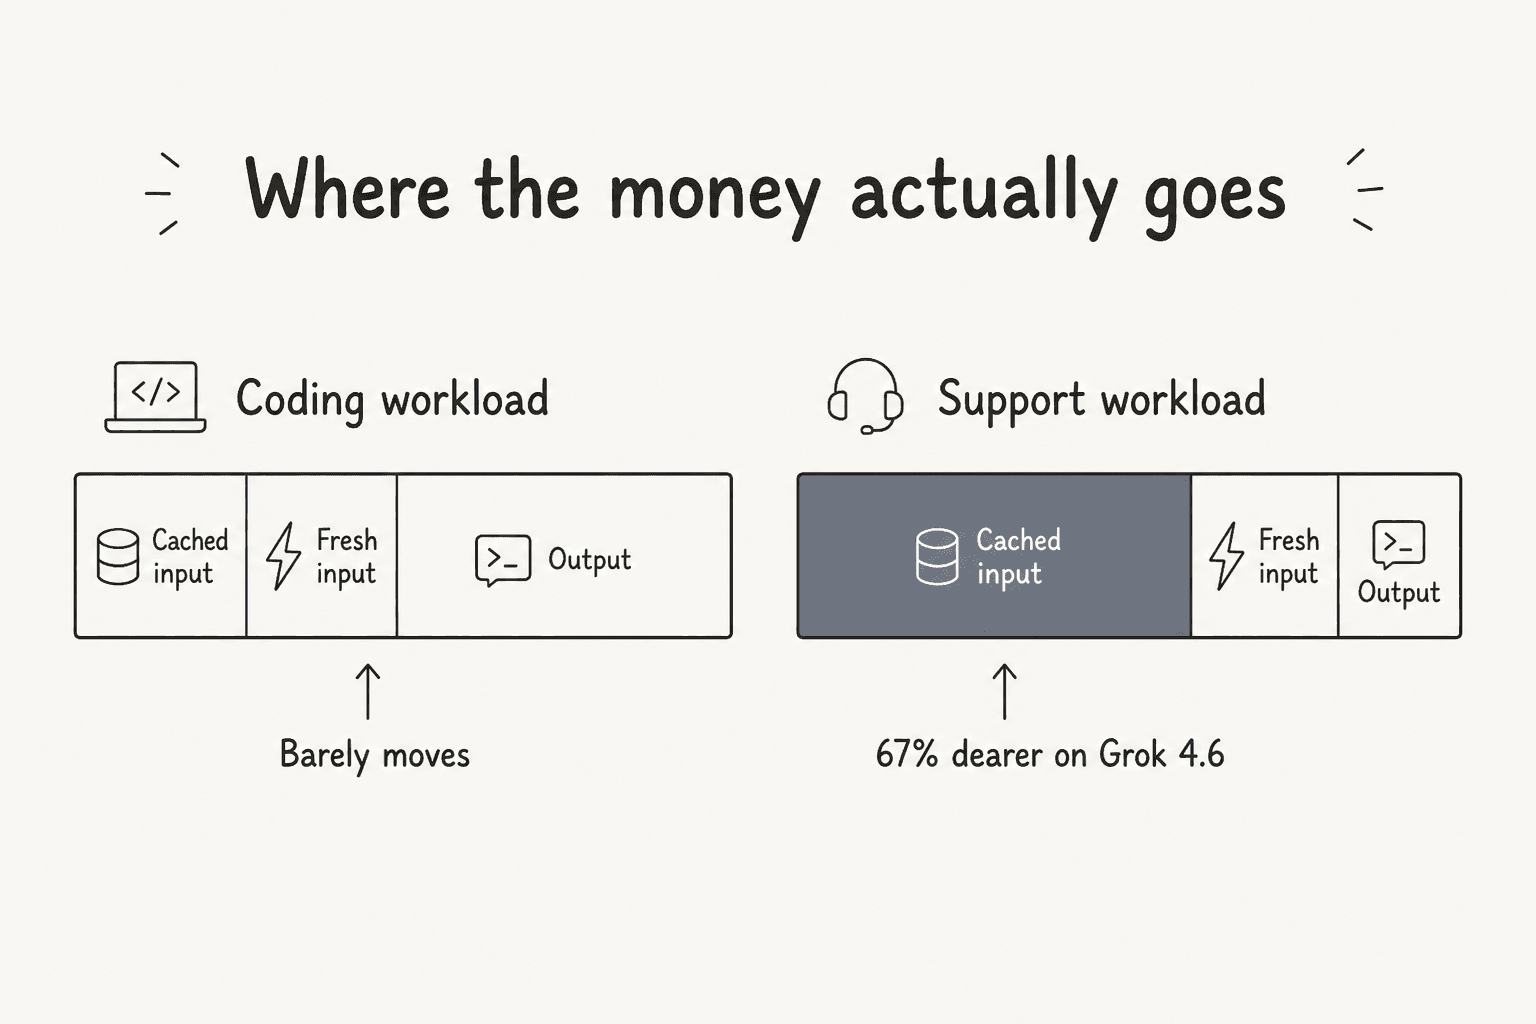
Une session de code est lourde en sortie : longues générations, un contexte qui change sans cesse. Une charge de support est son image miroir. Chaque ticket renvoie le même prompt système, les mêmes règles de ton, le même bloc de contenu du centre d'aide, et reçoit trois phrases en retour. C'est une facture dominée par le cache, et l'entrée en cache est le seul tarif où 4.6 est le modèle le plus cher.
Vous n'avez pas à me croire sur l'ampleur de l'effet, car Artificial Analysis publie ses dépenses réelles. Exécuter la même batterie de l'Intelligence Index a coûté :
| Ligne de coût | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Lectures de cache | 357,94 $ | 84,70 $ |
| Écritures de cache | 253,63 $ | 111,33 $ |
| Tokens de raisonnement | 374,97 $ | 312,20 $ |
| Tokens de réponse | 57,96 $ | 46,98 $ |
| Entrée hors cache | 23,96 $ | 24,01 $ |
| Total | 1 068,47 $ | 579,21 $ |
| Par tâche | 0,8367 $ | 0,3601 $ |
1,84x la facture totale au même prix affiché, et les lectures plus écritures de cache en représentent 57 %. Une partie vient du tarif, une partie du comportement : 4.6 a généré 21 735 tokens de sortie par tâche contre 14 795 pour 4.5, soit 47 % de plus, et a consommé 2,4x plus de tokens d'entrée. L'efficacité en tokens était l'argument de lancement de Grok 4.5, et le verdict d'Artificial Analysis sur la verbosité est passé de « better than average » à « somewhat higher than average » entre les deux versions. Un modèle qui réfléchit davantage coûte plus cher même si la grille tarifaire dit le contraire.
Entrez vos propres chiffres
La forme de votre charge décide si la mise à niveau est gratuite ou une hausse de 25 %. Plutôt que de débattre de moyennes, voici donc l'arithmétique avec vos données.
Les deux arêtes que personne ne lit
Au-delà du tarif de cache, deux mécaniques de cette page de tarifs vous surprendront à la facture.
La falaise des 200k fait basculer toute la requête, ce n'est pas un palier. La formulation de xAI est sans ambiguïté : les modèles à tarification en contexte long facturent les tarifs du contexte long pour tous les tokens d'une requête dès que le prompt atteint le seuil. Un prompt de 201k tokens ne coûte pas le double sur le millier supplémentaire. Il coûte le double sur les 201 000.
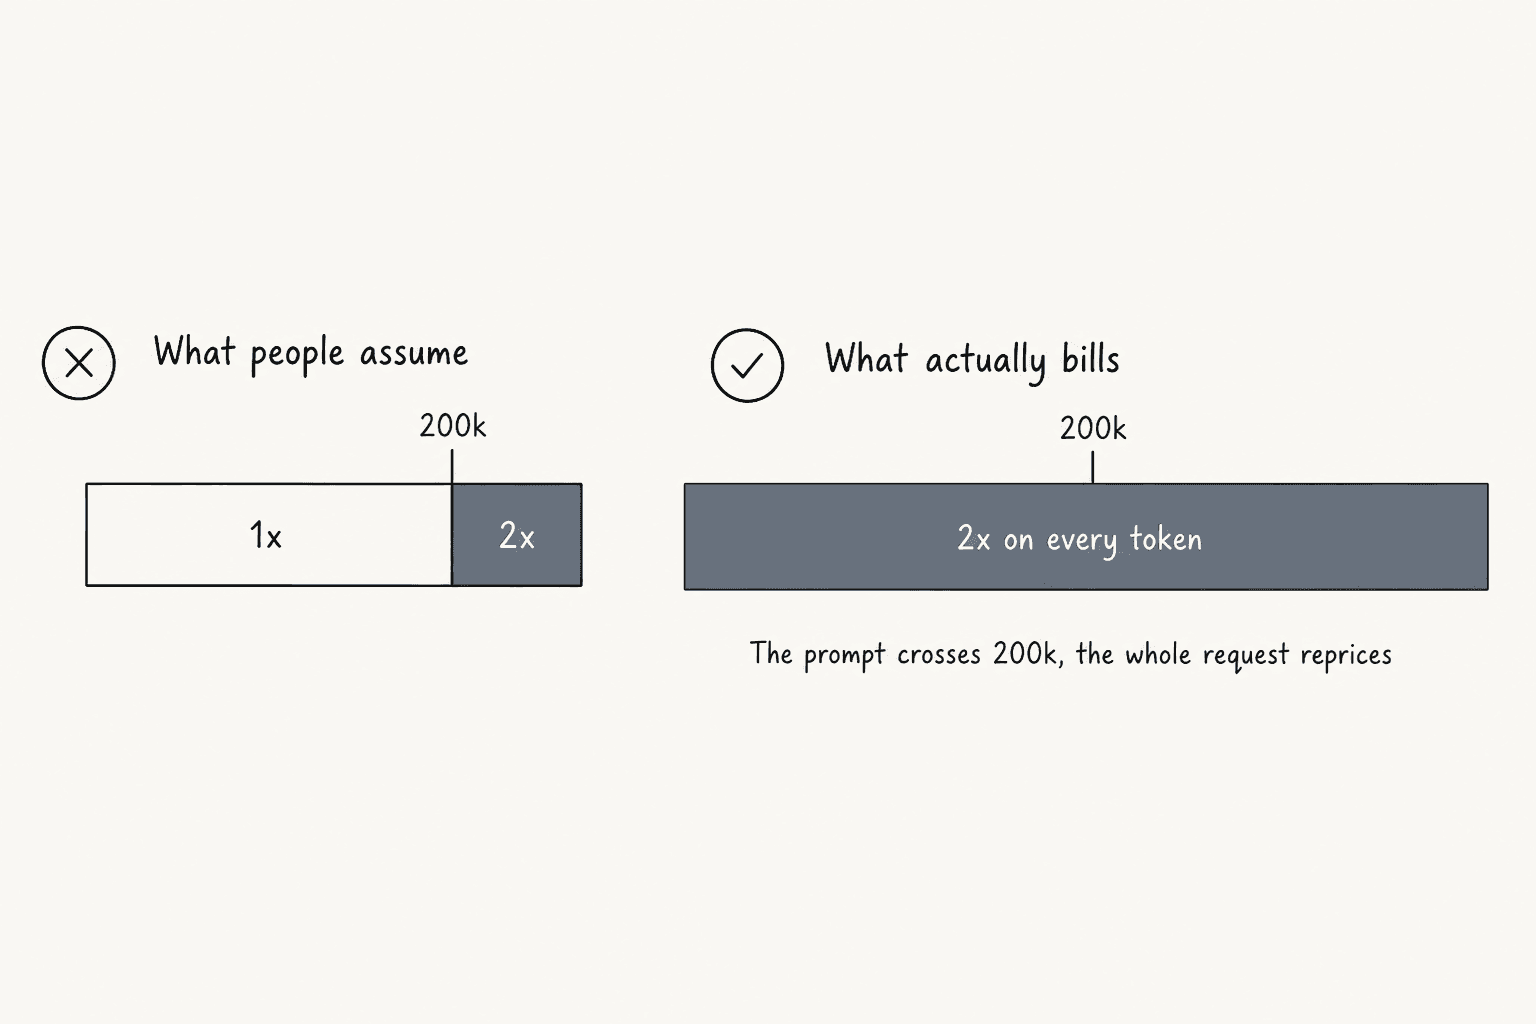
C'est pourquoi la documentation de xAI pousse autant la compaction de contexte. Pour une boucle agentique qui accumule des résultats d'outils tour après tour, la compaction est un contrôle des coûts, pas un détail de rangement. Si votre agent dépasse 200k au tour neuf, le tour neuf coûte le double dès son premier token.
Le tarif de cache avantageux n'est pas automatique. C'est le point le plus utile de toute la page de 4.6, et il est d'une franchise inhabituelle pour un document de fournisseur. La page de prise en main de 4.6 vous dit de définir un prompt_cache_key, ou l'en-tête x-grok-conv-id sur Chat Completions, car « it routes a conversation's requests to the same server, making cache hits reliable; without it you often pay full input price on a cache-cold server. » Relisez : le mode de défaillance par défaut est de payer 2,00 $ au lieu de 0,50 $. Si vous construisez sur Grok 4.6 en sautant un en-tête, votre facture peut quadrupler sur la ligne d'entrée sans que rien ne paraisse cassé.
Vient ensuite l'inversion du batch. La remise de 20 % de la Batch API s'applique à grok-4.3 et aux trois variantes grok-4.20. Elle ne s'applique pas à 4.6, 4.5 ni grok-build-0.1. Donc pour un travail groupable et riche en cache comme la classification de tickets de nuit ou le tri d'un arriéré, le grok-4.3 vieux d'un an est nettement moins cher que le modèle phare, à 1,25 $ en entrée et 2,50 $ en sortie avec 20 % de remise en plus. La grille tarifaire cache tout cela, et je testerais 4.3 avant de supposer que le modèle le plus récent est le bon pour le travail en volume.
Deux points mineurs à connaître. Priority Processing est un multiplicateur distinct de 2x sur tous les types de tokens et ne se facture que si la réponse confirme "service_tier": "priority". Et il existe des frais de 0,05 $ par requête pour les violations des règles d'usage détectées avant la génération dans la Responses API, ce qui signifie que vous pouvez payer cinq centimes pour une requête qui n'a rien produit.
Grok 4.6 face aux autres modèles phares
Sur le seul prix affiché, Grok 4.6 est excellent. Chaque chiffre ci-dessous provient de la page du fournisseur lui-même.
| Modèle | Contexte | Entrée /1M | Cache /1M | Sortie /1M |
|---|---|---|---|---|
| Grok 4.6 | 500k | 2,00 $ | 0,50 $ | 6,00 $ |
| Claude Sonnet 5 | 1M | 2,00 $ | 0,20 $ | 10,00 $ |
| Claude Opus 5 | 1M | 5,00 $ | 0,50 $ | 25,00 $ |
| GPT-5.6 Sol | 1,05M | 5,00 $ | 0,50 $ | 30,00 $ |
| Gemini 3.1 Pro Preview | 1,05M | 2,00 $ | 0,20 $ | 12,00 $ |
| DeepSeek V4 Flash | 1M | 0,14 $ | 0,0028 $ | 0,28 $ |
En sortie, Grok 4.6 est le moins cher d'ici hors DeepSeek : 6 $ contre 10 $ pour Sonnet 5, 12 $ pour Gemini 3.1 Pro, 25 $ pour Opus 5 et 30 $ pour Sol. Combinez cela à un score d'Intelligence Index à égalité et vous obtenez un vrai résultat : Artificial Analysis mesure Grok 4.6 à 0,8367 $ par tâche de l'Index contre 1,2312 $ pour GPT-5.6 Sol, soit la même intelligence mesurée pour 32 % de moins, et 2,8x moins que les 2,3369 $ de Claude Opus 5.
Passons au recadrage, et c'est là qu'un lecteur du support doit ralentir. Regardez la colonne du cache, pas celle de la sortie. Claude Sonnet 5 met en cache à 0,20 $ contre 0,50 $ pour Grok 4.6. Sonnet 5 a aussi une fenêtre de 1M sans aucun supplément de contexte long (Anthropic indique qu'une requête de 900k tokens est facturée au même tarif par token qu'une de 9k) et une remise batch forfaitaire de 50 % là où Grok 4.6 n'en a aucune.
Le verdict honnête se découpe donc par charge de travail plutôt que par modèle :
- Longues sorties, contexte changeant, génération de code : Grok 4.6 gagne sur le prix, nettement. 6 $ en sortie contre 10 $ ou 30 $, il n'y a pas photo, et les benchmarks confirment la qualité.
- Sorties courtes, énormes prompts réutilisés, volume groupable : autrement dit une file de support. Sonnet 5 est 2,5x moins cher sur la ligne qui domine votre facture, n'a pas de falaise à 200k où tomber et divise par deux en batch. La sortie moins chère de Grok 4.6 compte à peine quand vos réponses font trois phrases.
C'est une réponse plus utile que « Grok 4.6 est bon marché », et on ne la voit qu'en lisant la colonne du cache. Pour une vue plus large du choix de modèle pour le support, mon tour d'horizon du meilleur agent AI pour ce travail explique pourquoi le LLM le mieux noté est rarement le bon choix, et RAG contre un LLM brut couvre la moitié ancrage.
Une note d'équité sur la comparaison elle-même : l'entrée en cache n'est pas la même chose d'un fournisseur à l'autre. Anthropic et OpenAI facturent séparément l'écriture d'une entrée de cache, Google facture le stockage de cache à l'heure, et xAI et DeepSeek publient un tarif de lecture sans frais d'écriture séparés sur la page. Comparer la seule colonne du cache flatte légèrement Anthropic et OpenAI. Gemini 3.1 Pro facture aussi les tokens de réflexion comme de la sortie, donc ses 12 $ sont sous-estimés sur le travail riche en raisonnement, et c'est toujours un modèle Preview.
Où l'obtenir réellement
Pour les particuliers, la page de tarifs de xAI publie moins de chiffres qu'on ne l'attendrait, car grok.com affiche ses prix sous forme de rouleaux de chiffres animés qui ne contiennent aucun chiffre réel. Voici ce qui est publié :
| Formule | Prix | Remarques |
|---|---|---|
| Free | 0 $ | Recherche web et X en temps réel, mode Voice, Connectors. Ne cite pas Grok 4.6 |
| SuperGrok Lite | Non publié | Accès à Grok Build, mode Expert, conversations 2x plus longues |
| SuperGrok | 30 $/mois | Première formule à citer Grok 4.6 comme avantage, conversations 5x plus longues |
| SuperGrok Plus | 100 $/mois | Création d'app en un prompt, vidéo 1080p, priorité aux heures de pointe |
| SuperGrok Heavy | Non publié | Usage maximal, équipe d'agents plus grande, X Premium+ inclus |
| Business | 30 $/mois par utilisateur | Gestion des sièges, RBAC, vérification de domaine |
| Enterprise | Sur mesure | SSO, SCIM, contrôles d'audit, résidence des données, tarifs au volume |
Grok 4.6 est cité comme avantage à partir de SuperGrok, pas dans Free. Les formules payantes sont passées en juin 2026 à un seul pool d'usage hebdomadaire partagé entre Chat, Imagine, Voice et Build, et xAI publie le mécanisme mais aucun nombre absolu de messages. Atteindre le pool n'est pas un arrêt brutal : vous retombez sur les limites de la formule gratuite pour Chat et Voice. Les Extra Usage Credits commencent à 5 $, expirent au bout d'un an, et xAI dit clairement qu'ils sont « priced at standard rates, which means the cost per action is higher than the effective rate you get from the included weekly usage in your plan. »
Le fait le plus lourd de conséquences pour qui achète via les achats : Grok 4.6 est un lancement par API directe et partenaires, pas par les hyperscalers.
| Canal | Grok 4.6 au lancement |
|---|---|
| xAI API, Grok Build, OpenRouter | Disponible dès le premier jour |
| Cursor | xAI dit oui ; la page de modèles de Cursor ne listait encore que 4.5 |
| Azure AI Foundry | Toujours Grok 4.3 |
| AWS Bedrock | Toujours Grok 4.3 |
| GitHub Copilot | Toujours Grok 4.5 |
Si votre organisation a standardisé sur Bedrock ou Copilot, vous ne pouvez pas encore accéder à 4.6. Si vous êtes sur Azure Foundry, vous achetez Grok 4.3 à 1,25 $ et 2,50 $, ce qui est moins cher mais en retard de deux générations. Cet écart finira par se combler, et il compte dès maintenant si une politique d'achats impose que toute l'inférence passe par un seul cloud. C'est le même schéma que j'ai vu avec Grok Bot et Grok Voice Think Fast 2 : xAI livre d'abord sur ses propres surfaces et laisse les revendeurs rattraper leur retard.
Ce qu'un modèle de pointe change pour une file de support, et ce qu'il ne change pas
Toutes les cinq semaines arrive un nouveau modèle et la question tombe dans ma boîte : faut-il changer ? Ayant livré les intégrations qui se placent entre un modèle et un helpdesk, ma réponse est presque toujours que le modèle n'était pas le goulot d'étranglement.
Ce que Grok 4.6 change, honnêtement :
- L'usage agentique d'outils s'est amélioré. 50,7 % sur Tau-3-Banking, deuxième sur 97, en hausse de 8,6 points. Si votre automatisation appelle un système de commandes ou une API de retours en pleine conversation, cette fiabilité est ce qui permet à l'automatisation des workflows d'aller au bout au lieu de caler à mi-chemin.
- L'invention a nettement reculé. De 54,1 % à 34,3 %, c'est la plus grande amélioration de la version, et c'est celle qui compte le plus quand la sortie va à un client.
- Le coût par unité d'intelligence s'est amélioré face aux rivaux. 32 % moins cher par tâche qu'un GPT-5.6 Sol à égalité, c'est de l'argent réel à volume.
Ce qu'il ne change pas :
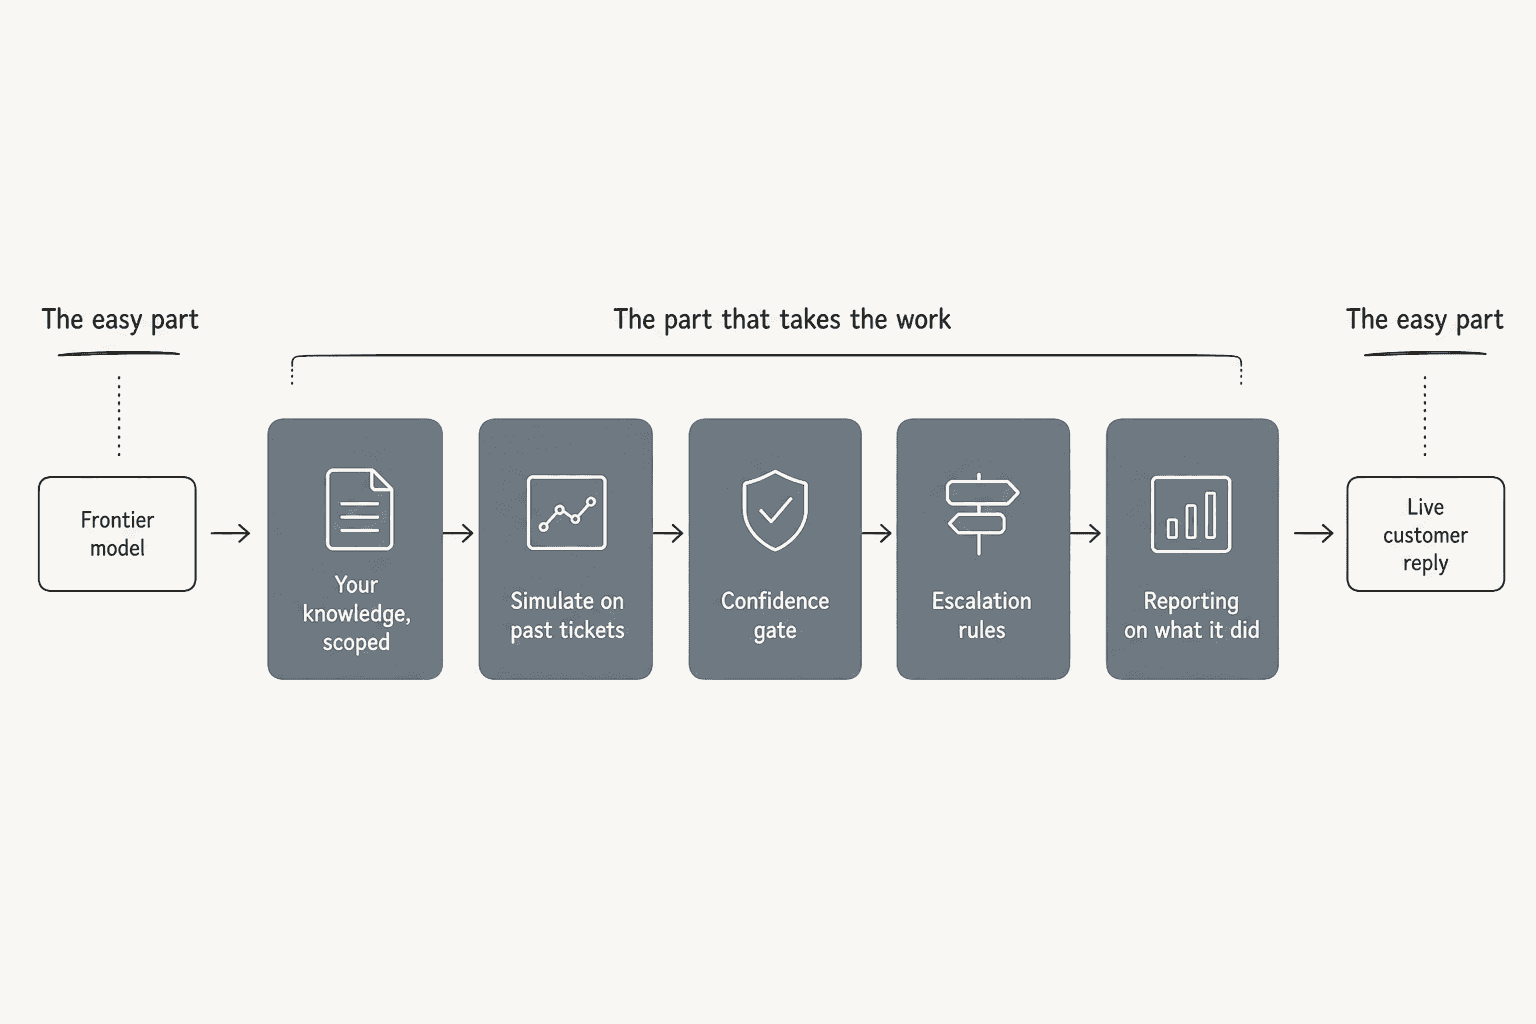
- Vos connaissances restent vos connaissances. La date limite de février 2026 signifie que le modèle ne sait rien de votre politique de remboursement, de vos SKU ni de la panne de mardi dernier. Cela vient de l'entraînement sur votre base de connaissances et des anciens tickets, et aucun score de benchmark ne s'y substitue.
- 34,3 % d'hallucination demandent toujours une barrière. Seuils de confiance, garde-fous et passage à un humain quand le modèle hésite. Mesurer s'il aurait dû répondre est une discipline à part entière, traitée dans taux de confinement et qualité de l'escalade.
- Le prix du token est la ligne la moins chère du dispositif. Aux valeurs par défaut du widget, Grok 4.6 coûte environ 1,5 centime de tokens par conversation. L'intégration, les règles de tri, la boucle de relecture, le reporting, l'astreinte quand il déraille : tout cela écrase les tokens. C'est exactement pourquoi le coût par résolution bat le coût par million de tokens comme chiffre de planification.
- Acheter reste préférable à construire pour la plupart des équipes. Ce compromis est une décision à part, et construire ou acheter est par où je commencerais, pas dans une grille de tarifs.
- Vous ne pouvez toujours pas savoir ce qu'il fera sur vos tickets. Un classement est un substitut. Votre file est le test. Les pratiques d'évaluation existent précisément parce que les deux divergent plus souvent qu'on ne le voudrait.
Si vous voulez la couche plateforme plutôt qu'un seul modèle, commencez par les logiciels AI de service client. Pour les indicateurs auxquels je tiendrais un déploiement, la résolution automatisée des tickets et le taux de résolution sont les deux qui comptent.
eesel pour la partie que le modèle ne fait pas
Grok 4.6 est un bon modèle. Si vous livrez du code, utilisez-le, le rapport prix-score est le meilleur du classement. Ce qu'il n'est pas, c'est un agent de support, et la raison honnête est qu'un modèle brut ignore ce que votre équipe a déjà dit à ce client, n'a aucun moyen de savoir quand se taire et ne garde aucune trace de ce qu'il a fait ensuite.
eesel est cette couche. Il se branche sur Zendesk, Freshdesk, Gorgias et les autres en quelques minutes, apprend de votre centre d'aide, de vos macros et de vos tickets résolus pour sonner déjà comme votre équipe et, la partie vers laquelle je vous pousserais le plus, exécute une simulation sur vos propres tickets historiques avant de répondre à un seul client en direct. Vous voyez la précision sur vos données, comblez les lacunes qui apparaissent, relancez, et ce n'est qu'ensuite que vous passez en production. Avec un modèle qui invente encore un tiers du temps, cette répétition fait la différence entre une expérience et un incident.

La tarification repose sur un prix mensuel fixe plutôt que sur les tokens : les formules démarrent à 299 $/mois pour 500 crédits, d'après la page de tarifs, avec 1 crédit par ticket ou conversation quel que soit le nombre de réponses, sans frais par siège et sans facturation des tickets que traitent vos humains. Vous avez 100 crédits gratuits sans carte et pouvez d'abord router une tranche, de sorte que 1 000 tickets par mois dont 200 envoyés à l'AI utilisent 200 crédits, ce qui tient dans la formule à 299 $/mois. Activez le dépassement optionnel avec un plafond que vous fixez si vous voulez une limite stricte. Les pages sécurité et enterprise couvrent la conformité, et nos clients montrent si cela fonctionne.
Essayez eesel gratuitement, lancez la simulation et laissez vos propres tickets vous dire ce que le classement ne peut pas.
Questions fréquentes
Qu'est-ce que Grok 4.6 et quand a-t-il été lancé ?
xhigh. Si le modèle vous importe moins que le fait d'en mettre un sur une file en production, ce travail revient à un agent AI de helpdesk.Combien coûte Grok 4.6 par million de tokens ?
Grok 4.6 est-il moins cher que Grok 4.5 ?
Puis-je utiliser Grok 4.6 pour le support client ?
Où obtenir Grok 4.6 et combien coûte SuperGrok ?
Grok 4.6 est-il meilleur que Grok 4.5 ?
Quelle est la fenêtre de contexte de Grok 4.6 et que fait xhigh ?
xhigh est un quatrième niveau de raisonnement au-dessus du high par défaut et n'existe que sur 4.6 ; d'après la documentation de raisonnement de xAI, les anciens modèles traitent silencieusement une requête xhigh comme high au lieu de renvoyer une erreur. Pour les charges de support, la taille du prompt est généralement d'abord un problème de récupération avant d'être un problème de fenêtre de contexte.