

Comment je l'ai testé, et où s'arrêtent mes preuves
Je construis des intégrations et des API chez eesel, la tuyauterie entre un modèle et un helpdesk en production. Ceci est donc un avis de développeur : j'ai lu chaque page de la documentation speech-to-speech de xAI, les notes de version, les tableaux de limites de débit, ainsi que le classement complet et le fil de lancement d'Artificial Analysis, et j'ai tout comparé à ce que j'avais écrit sur Grok Voice 2.0 il y a deux mois.
Ce que je ne peux pas prétendre, c'est un millier d'appels en production sur une ligne téléphonique réelle, car le modèle a un jour. Quand je parle du comportement à grande échelle, le chiffre provient soit d'une limite publiée, soit des chiffres Starlink de xAI, et je précise lequel.
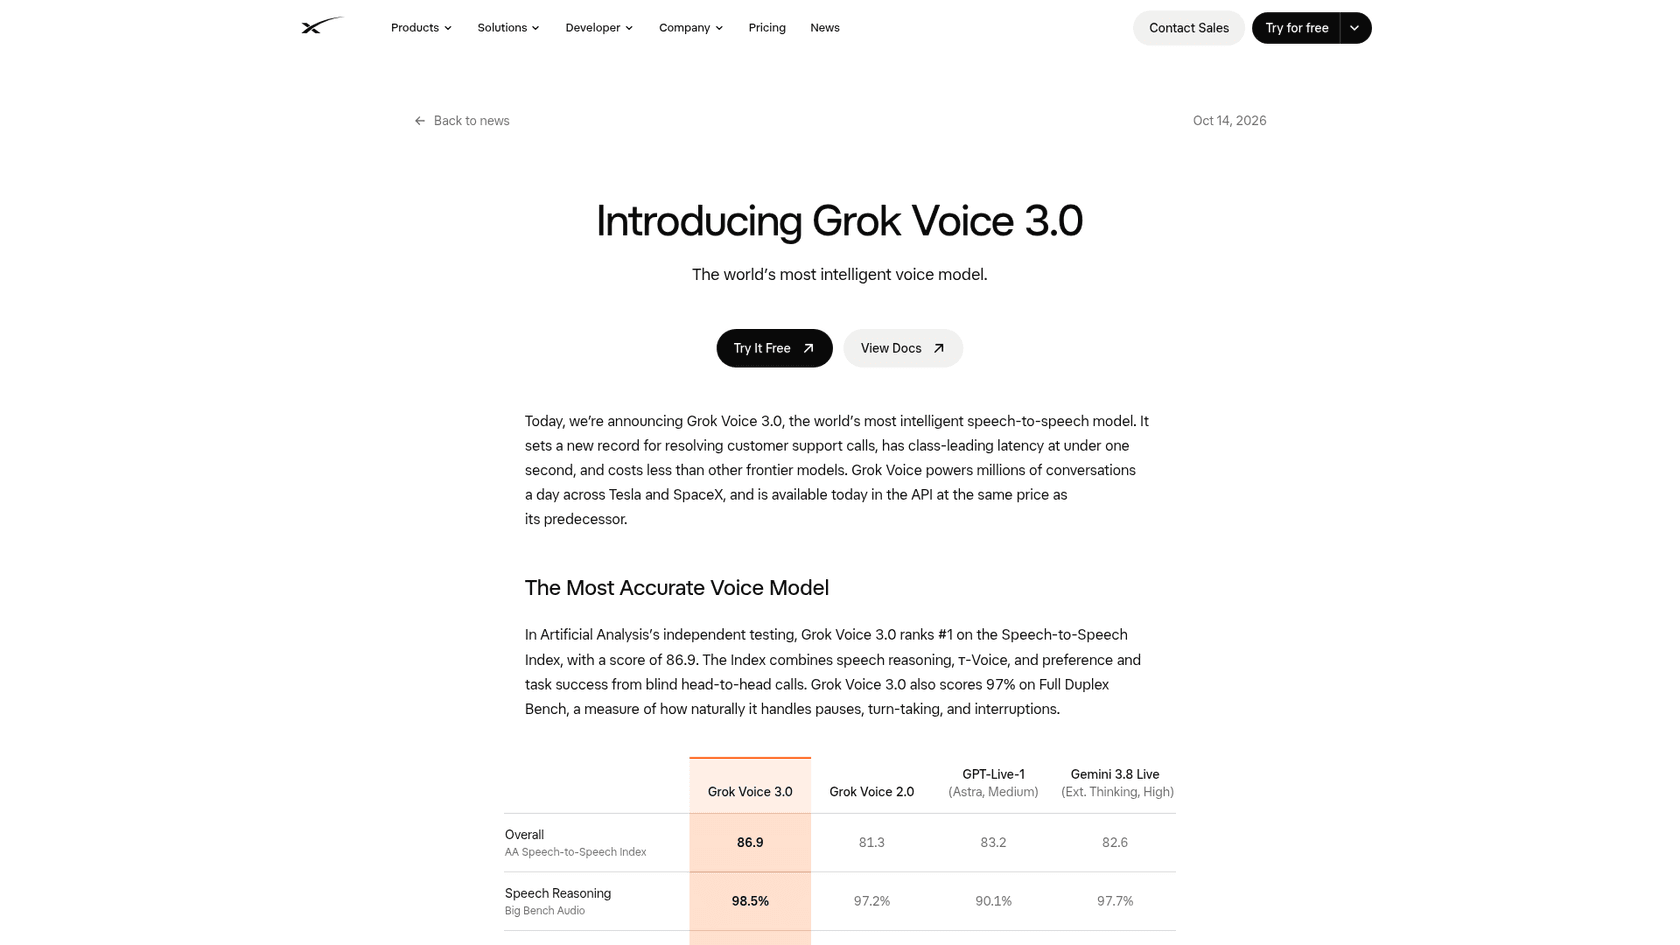
Une note sur les noms avant de commencer. La documentation et l'annonce de lancement de xAI sont désormais signées SpaceXSI, et Artificial Analysis liste l'éditeur comme SpaceXAI. Même équipe, même API sur api.x.ai, même famille Grok. Selon l'annonce de lancement, la même voix tourne aussi dans le mode vocal de Grok Bot et dans les voitures Tesla. Si vous évaluez l'éditeur dans son ensemble, mon article sur les alternatives à xAI offre la vue d'ensemble.
Le tableau de bord
Je mets d'abord tout le verdict, et le détail ensuite.
| Dimension | Grok Voice 3.0 | vs 2.0 | Mon avis |
|---|---|---|---|
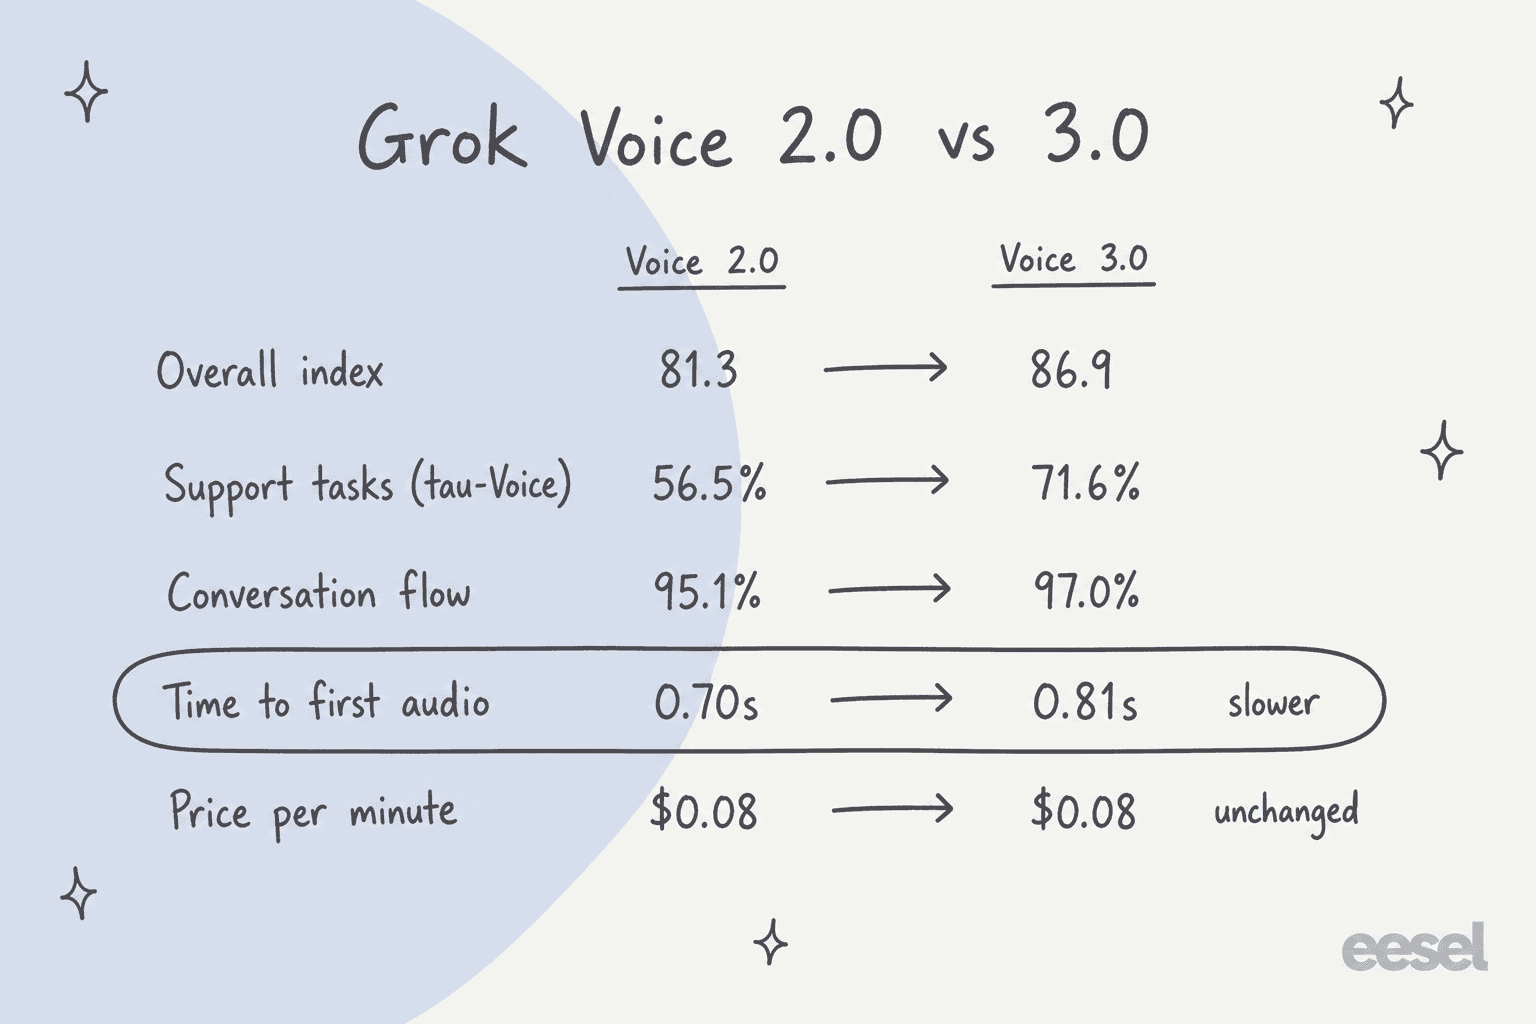
| Global | 86.9 indice AA, n°1 | 81.3 | Meilleure moyenne du tableau, 3.7 points devant GPT-Live-1 (Astra) |
| Tâches de support | 71.6% τ-Voice, n°2 | 56.5% | La vraie amélioration. 2.9 points derrière GPT-Live-1 (Astra) |
| Réussite des tâches en appel réel | 94.8%, n°1 | 94.6% | Déjà proche du plafond avec la 2.0 |
| Préférence humaine | Elo 1070, n°3 | 1011 | Deux modèles Gemini semblent plus sympathiques aux auditeurs |
| Fluidité de la conversation | 97.0% Full Duplex Bench | 95.1% | Les interruptions et les pauses sont un problème réglé ici |
| Raisonnement vocal | 98.5% Big Bench Audio | 97.2% | Gain minime, déjà saturé |
| Latence | 0.81s avant le premier audio | 0.70s | Plus lent que la 2.0, plus rapide que tous les modèles proches dans l'indice |
| Prix | $0.08/min | $0.08/min | Inchangé |
| Simultanéité | 10 à 200 selon le palier | 10 fixe | Corrigé, si vous dépensez |
| Régions | us-east-1, eu-west-1, us-saltlake-2 | us-east-1 | Les équipes européennes peuvent enfin l'évaluer |
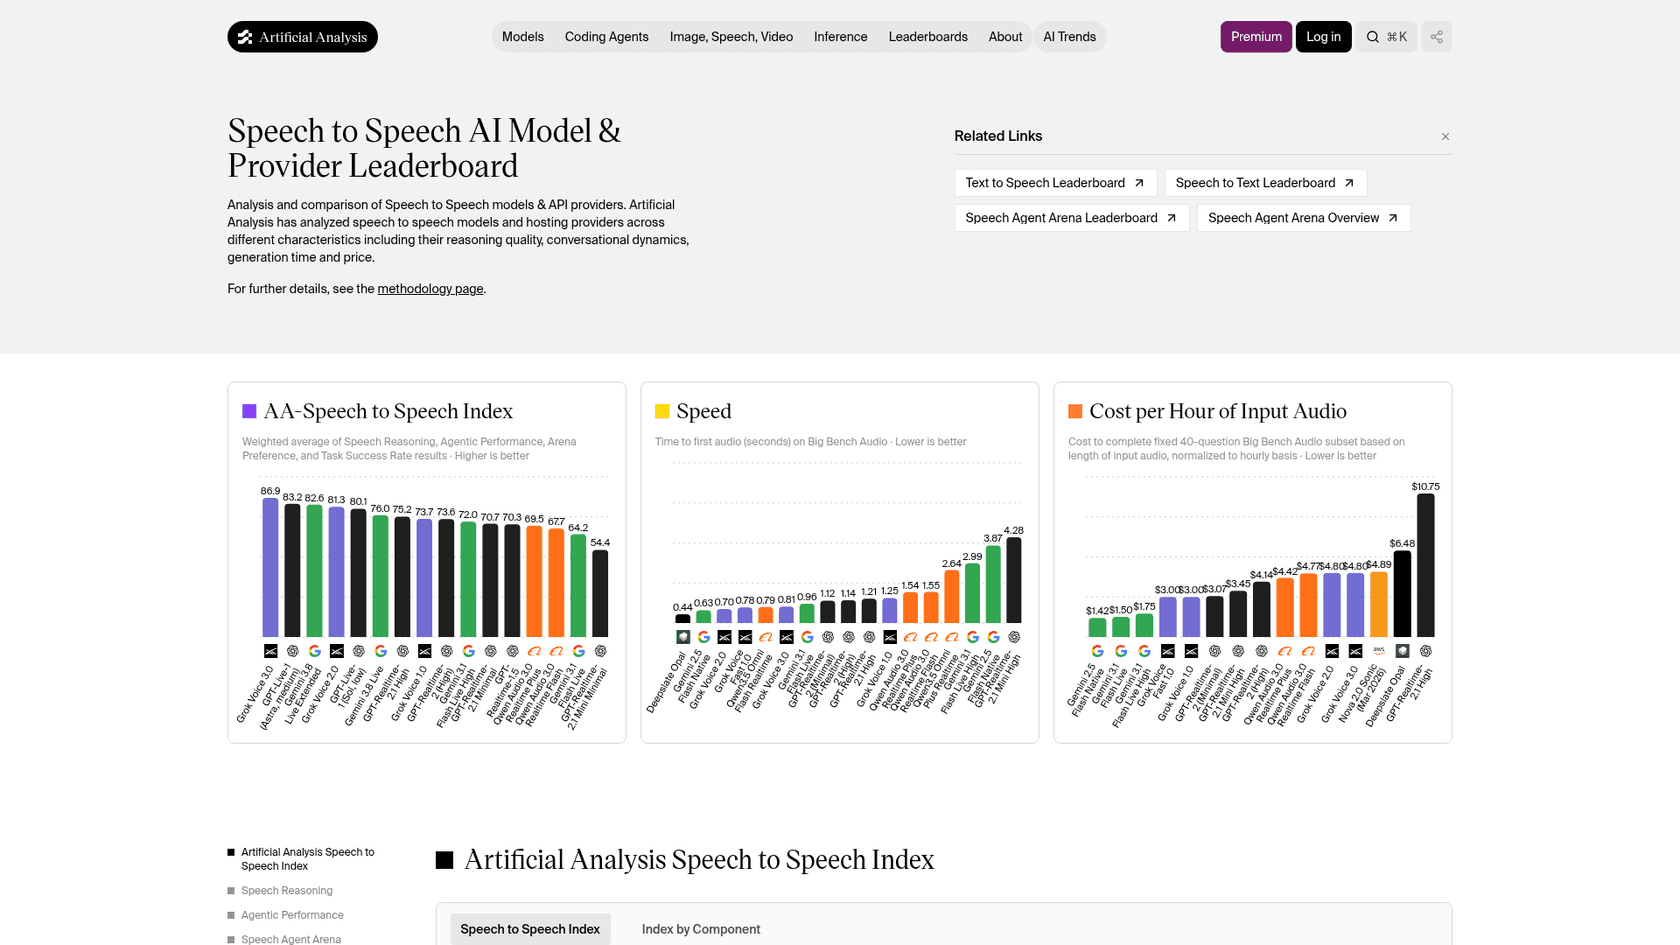
Tous les chiffres de benchmark viennent d'Artificial Analysis, dont les chiffres de lancement ont aussi été republiés dans l'annonce de Grok Voice 3.0 de xAI.
Verdict : pour une équipe qui construit un agent vocal téléphonique ou intégré à une application et qui doit faire des choses (retrouver une commande, émettre un avoir, réserver un créneau), c'est mon choix par défaut en ce moment. Figez la version, budgétez le palier dont vous avez besoin et réglez le problème de la connaissance séparément.
Là où il gagne
Trois choses m'ont marqué, et une seule est le chiffre que xAI a choisi de mettre en avant.
Le score sur les tâches de support est le titre, pas l'indice
τ-Voice est le benchmark auquel je me fie le plus pour quiconque lit ceci depuis une équipe de support. Un appelant simulé appelle le modèle avec un problème réaliste (modifier un vol, contester un achat en magasin, régler un problème télécom), le modèle joue l'agent de support avec des outils et un document de règles, et il ne marque que si l'état final de la base de données est exactement correct. Artificial Analysis décrit la méthode en détail, jusqu'à la moyenne sur trois essais.
Grok Voice 2.0 avait obtenu 56.5%. La 3.0 obtient 71.6%, un bond de 15.1 points en une version. C'est la différence entre un agent qui échoue quatre appels sur neuf et un qui échoue environ deux sur sept, et pour une file d'attente, cet écart se traduit en effectifs, pas en erreur d'arrondi.
Ce n'est pas le meilleur score. GPT-Live-1 (Astra, medium) est à 74.5%. Mais Astra met 1.34 seconde à commencer à parler, contre 0.81s pour Grok, et xAI s'appuie précisément sur ce compromis dans son annonce de lancement. Si vous choisissez entre les deux, mon avis sur GPT-Live-1 couvre plus en profondeur le côté OpenAI.
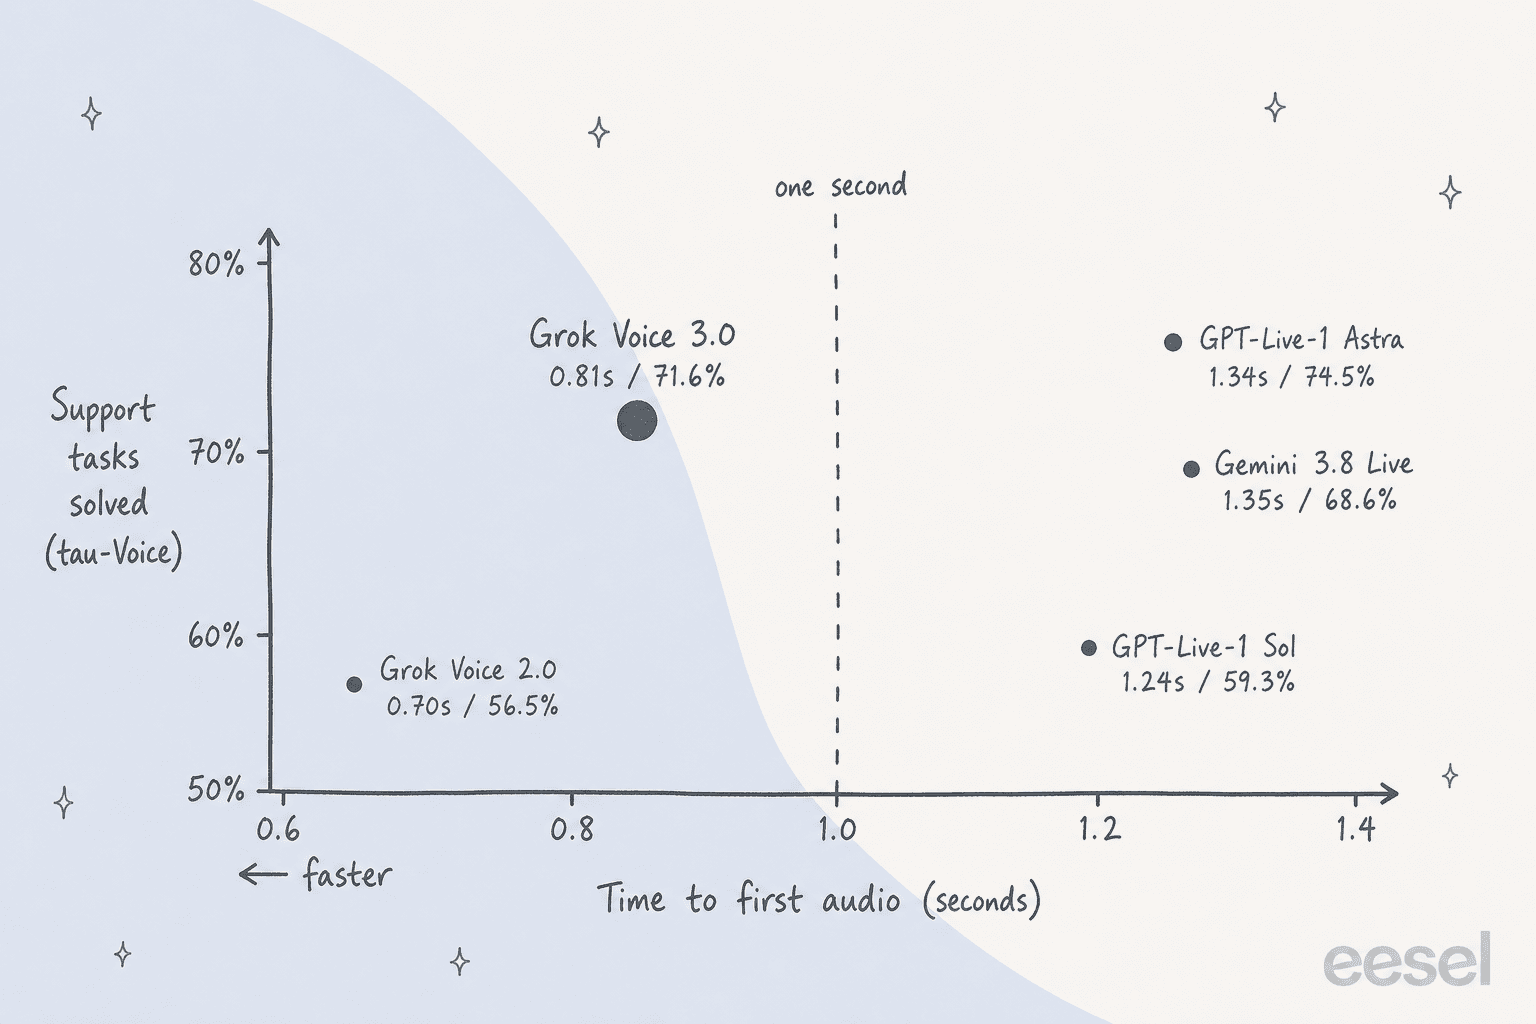
Ce graphique résume à peu près tout l'argumentaire de Grok Voice 3.0 en une image : tous les modèles qui résolvent plus de 65% des tâches de support mettent plus de 1.3 seconde à répondre, sauf celui-ci. Le fil d'Artificial Analysis le dit simplement :
"Grok Voice 3.0 and Grok Voice 2.0 the only models in the top 5 of our Speech to Speech Index under 1 second."
Il termine ce qu'il commence en appel réel
Le Task Success Rate provient de la Speech Agent Arena d'Artificial Analysis, où de vraies personnes tiennent des conversations en direct avec deux modèles cachés (réserver un rendez-vous chez le dentiste, ce genre de choses). Grok Voice 3.0 mène à bien 94.8% des tâches, le plus haut du classement, juste devant Gemini 3.8 Live à 93.2%.
Une note de bas de page utile : Grok Voice 2.0 était déjà à 94.6%, ce n'est donc pas là que la 3.0 a progressé. C'est un domaine où la gamme Grok était déjà solide, et la 3.0 l'a conservé tout en s'améliorant sur les cas plus difficiles de τ-Voice.
Les chiffres de Starlink, avec la réserve jointe
xAI affirme que les centres d'appels de Starlink utilisent Grok Voice pour répondre à 20,000 appels par jour en plusieurs langues, résoudre environ 70% sans humain et conclure un appel de vente sur quatre avant que l'appelant ne raccroche. Un seul agent vérifie les clients, dépanne le matériel, émet des avoirs et expédie des équipements de remplacement.
C'est l'affirmation de production la plus concrète que j'aie vue cette année chez un éditeur de modèles vocaux. C'est aussi une société sœur qui parle d'elle-même, sans méthode publiée derrière. Je traiterais les 70% comme « ce qui est possible avec un accès profond aux outils et un produit étroit », pas comme une prévision pour votre file. D'après mon expérience, le taux de résolution que vous obtenez dépend bien plus de ce que l'agent peut consulter et faire que du modèle, ce qui est la même leçon que tout déploiement d'un agent IA de centre d'appels.
Là où le texte de lancement en fait trop
Rien de tout cela n'est malhonnête. C'est le cadrage habituel d'une annonce de lancement, bon à connaître avant de le citer à votre patron.
- « Class-leading latency. » 0.81s est excellent parmi les modèles les mieux notés, mais Grok Voice 2.0 était plus rapide à 0.70s, et les entrées les plus rapides du classement (Deepslate Opal à 0.44s, par exemple) sont plus rapides encore. Lecture juste : le plus rapide des modèles intelligents.
- « Costs less than other frontier models. » Vrai face à GPT-Live-1 (Astra) et GPT-Realtime-2.1. Pas face à tout : Artificial Analysis mesure Gemini 3.8 Live Extended Thinking (High) à $3.50 par heure d'audio en entrée et GPT-Live-1 (Sol) à $4.47, contre $4.80 pour Grok. Ce sont des coûts d'exécution de benchmark, pas des prix catalogue, mais la tendance est claire.
- « World's most intelligent. » Il mène l'indice composite. En préférence humaine il est 3e (Elo 1070, derrière Gemini 3.1 Flash Live Minimal à 1100 et Gemini 3.8 Live à 1088), et en raisonnement vocal pur trois modèles marquent plus haut.
La réaction sur X était surtout enthousiaste, mais la réponse la plus tranchante sous le fil d'Artificial Analysis est celle que tout responsable de support devrait coller sur son écran :
"Scores are one thing. The real test is a drive-thru order with a toddler in the back seat."
C'est juste. Les benchmarks tournent sur un audio propre et des scénarios bien rangés, alors que vos appelants sont en haut-parleur dans une voiture. Faites vos propres appels de test avec un vrai bruit de fond avant de croire l'un de ces chiffres, y compris les bons.
L'API : rien à migrer, beaucoup à aimer
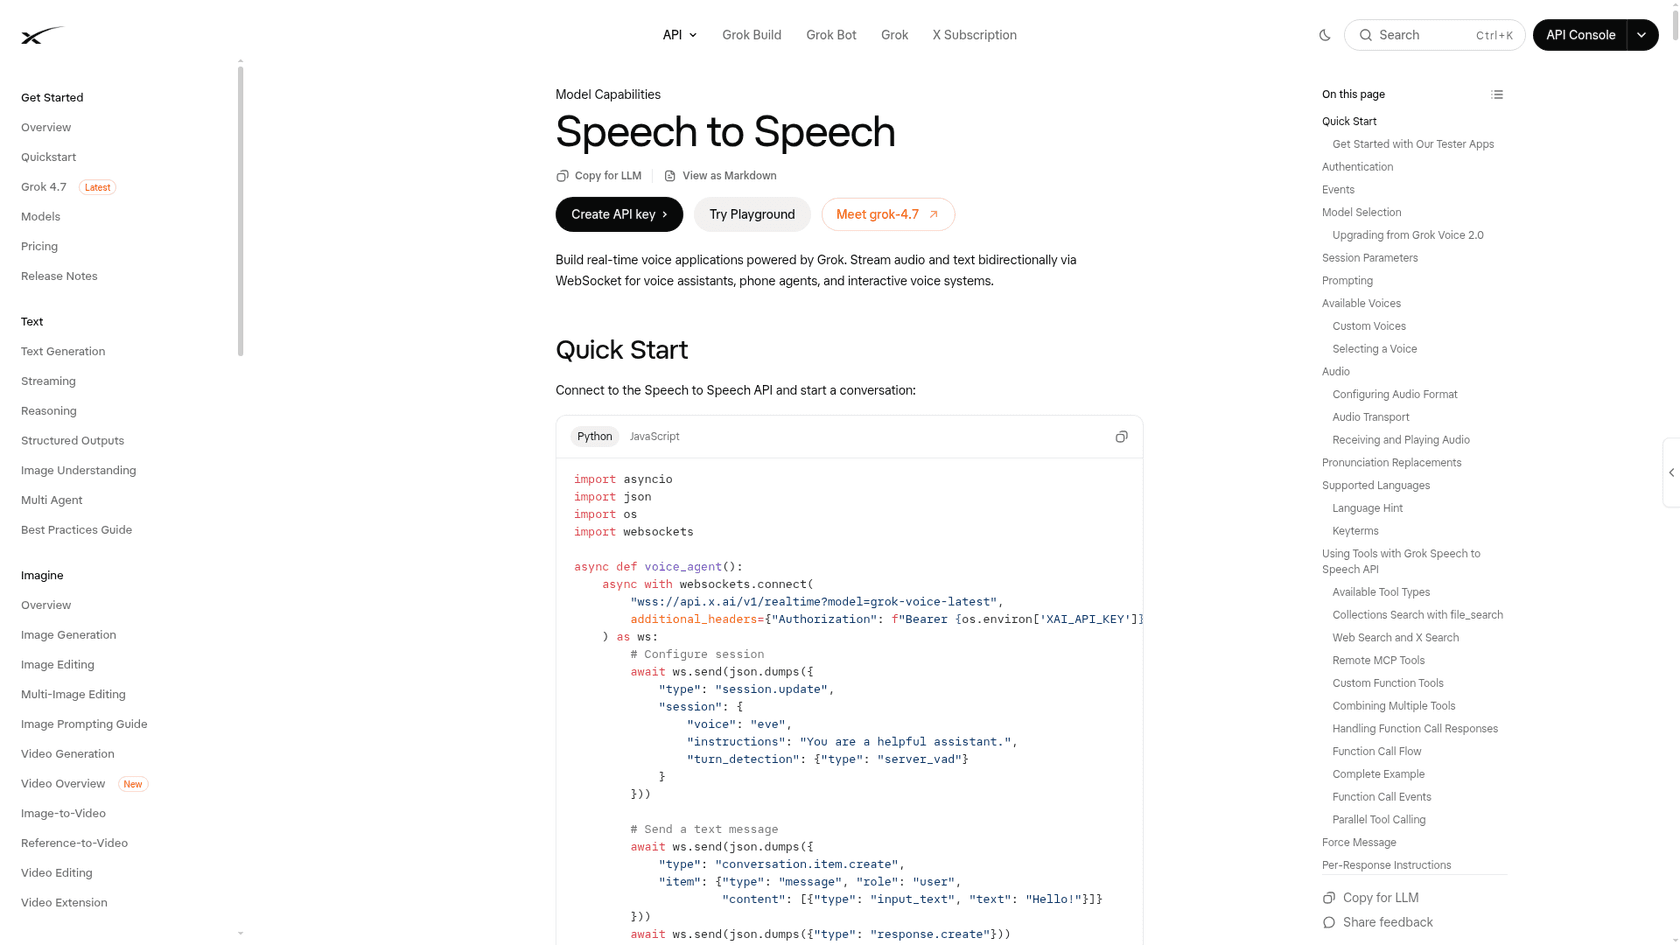
Les notes de version de xAI le disent en une ligne : l'API est inchangée. Même endpoint (wss://api.x.ai/v1/realtime), mêmes paramètres de session, mêmes événements, même prix. Si vous appelez l'alias grok-voice-latest, vous avez été basculé sur la 3.0 automatiquement, et grok-voice-2.0 est désormais déprécié.
C'est une bonne nouvelle, et aussi un petit avertissement. Les mises à niveau automatiques sont formidables jusqu'au jour où votre prompt soigneusement réglé se met à se comporter autrement un mardi quelconque. Sur une ligne de support, je figerais explicitement grok-voice-3.0 et je changerais de version délibérément, après une série d'appels de test.
Il reste aussi compatible au niveau du protocole avec l'API OpenAI Realtime, donc une équipe déjà construite sur GPT Realtime peut échanger l'URL de base et la clé et faire la majeure partie du chemin. Les éléments sur lesquels je construirais réellement, tous tirés de la documentation speech-to-speech :
| Fonctionnalité | Ce qu'elle fait | Pourquoi une équipe de support s'y intéresse |
|---|---|---|
Outils : file_search, web_search, x_search, mcp, function | Recherche dans des documents importés, appelle vos API, joint un serveur MCP distant en pleine conversation | C'est ainsi que l'agent émet le remboursement au lieu de le promettre |
| Appels téléphoniques SIP | Achemine directement des appels PSTN, de centre de contact ou PBX, avec DTMF | Pas de passerelle téléphonique séparée à surveiller |
| G.711 μ-law / A-law | Codecs téléphoniques natifs | Pas de délai de transcodage sur l'audio téléphonique |
force_message | Prononce une phrase fixe sans passer par le modèle | « Cet appel est enregistré » est dit mot pour mot, à chaque fois |
keyterms (jusqu'à 100) | Oriente la transcription vers vos noms de produits | Vos codes SKU ne sont plus mal compris |
replace | Corrige la prononciation des noms de marque dans l'audio parlé | Sans modifier la transcription que vous stockez |
| Reprise de session | Rejoue les tours précédents après une coupure de connexion | Un appel mobile coupé ne repart pas de « bonjour » |
idle_timeout_ms | Relance un appelant silencieux après un délai défini | Gère le moment « vous êtes toujours là ? » |
reasoning.effort | high (par défaut) ou none | Un levier pour échanger de la réflexion contre de la vitesse sur les parcours simples |
Si vous hésitez entre WebSocket et WebRTC pour un client navigateur, mon explication Realtime API vs WebRTC s'applique aussi ici, puisque le format de transmission est le même.
Deux autres choses à savoir. Les voix peuvent être clonées à partir d'un extrait de référence d'au plus 120 secondes, et la présentation de la voix liste 20 langues avec accents natifs, le modèle détectant lui-même la langue de l'appelant. Sur X, l'une des premières questions sous l'annonce de lancement d'Elon Musk portait exactement là-dessus :
"Does it handle switching languages mid conversation? Genuinely curious how it does with Hungarian"
Le hongrois n'est pas dans la liste, attendez-vous donc à « varying degrees of accuracy », selon les mots de xAI. Si vos appelants parlent une langue hors de ces 20, testez d'abord.
L'appel d'outils en parallèle, ainsi que le conseil de la documentation pour éviter le chevauchement audio pendant les appels d'outils, me disent que cette équipe a livré de vrais agents téléphoniques. Quiconque a construit sur des appels d'outils en temps réel sait que le silence gênant pendant l'exécution d'une fonction est le moment où les appelants raccrochent.
Les limites qui ont changé depuis la 2.0
Si vous avez lu mon avis sur la 2.0, c'est la section qui compte le plus, car deux des trois murs que j'avais signalés en août ont bougé.
La simultanéité est désormais un escalier de dépenses
En août, chaque équipe avait 10 sessions simultanées, point final. Le tableau des limites de débit actuel lie la simultanéité du speech-to-speech à votre palier de dépenses, et les paliers se débloquent automatiquement selon les dépenses API cumulées depuis le 1er janvier 2026. Ils ne redescendent jamais.
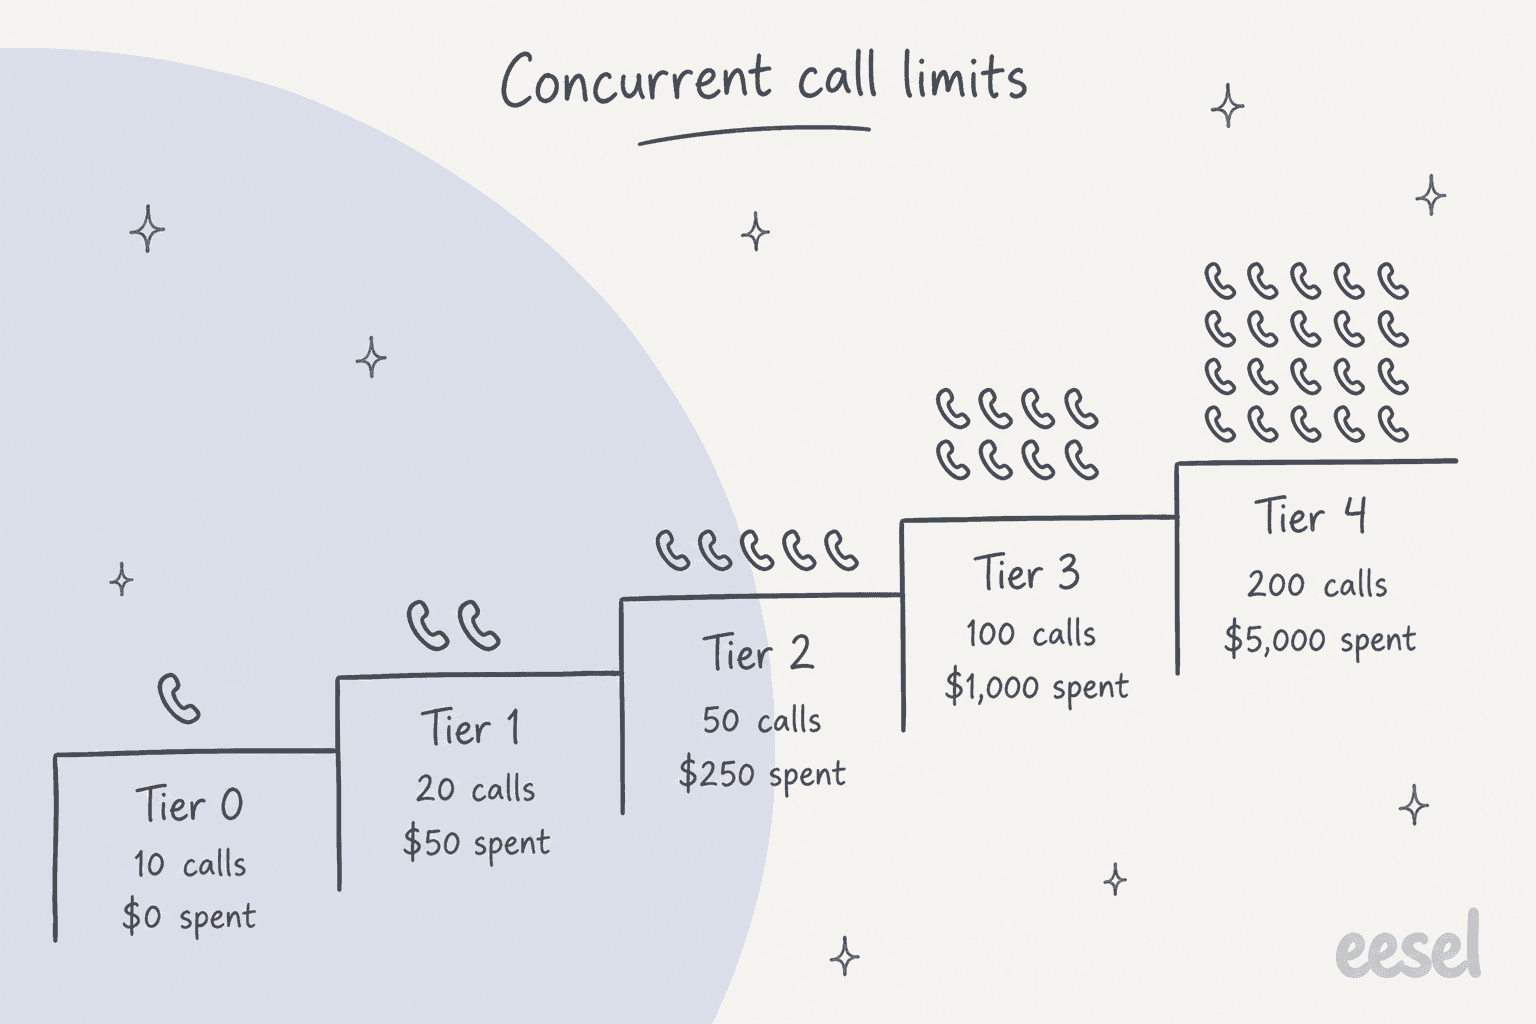
| Palier | Dépenses API cumulées | Sessions vocales simultanées |
|---|---|---|
| Tier 0 | $0 | 10 |
| Tier 1 | $50 | 20 |
| Tier 2 | $250 | 50 |
| Tier 3 | $1,000 | 100 |
| Tier 4 | $5,000 | 200 |
| Entreprise | Sur demande | Personnalisé |
À $0.08 la minute, $5,000 représentent 62,500 minutes de conversation. Une file qui prend 500 appels de quatre minutes par jour y arrive en un mois environ, donc le plafond cesse d'être un frein pour toute équipe en production. Il compte encore pour les pilotes : un nouveau compte ne peut pas faire un test de charge de 50 appels simultanés dès le premier jour sans prépayer des crédits pour débloquer le palier.
Il existe maintenant une région UE
La page du modèle Grok Voice 3.0 liste us-east-1, eu-west-1 et us-saltlake-2. En août, il n'y avait que us-east-1, ce qui mettait fin à la discussion pour beaucoup d'équipes européennes. La documentation vocale de xAI mentionne aussi SOC 2 Type II, l'éligibilité HIPAA avec un BAA, des accords de traitement de données RGPD, et une déclaration selon laquelle l'audio est traité en temps réel et « never stored or used for training ». Je n'ai rien audité de tout cela. C'est ce que publie l'éditeur, et c'est suffisant pour lancer une revue de sécurité.
Ce qui n'a pas changé : il ne sait rien de vous
Le modèle est plus intelligent, mais il n'est pas à vous. Tous les chiffres ci-dessus supposent un document de règles et des outils écrits par quelqu'un pour le benchmark. Sur votre ligne, l'agent sait exactement ce à quoi vous le connectez : une collection importée, vos fonctions, un serveur MCP. L'essentiel du travail d'un vrai déploiement de support vocal se trouve là, ainsi que dans la décision de savoir quand passer la main à un humain.
Les équipes que je vois réussir traitent l'agent téléphonique comme un chatbot de base de connaissances avec une voix : les réponses vivent dans une seule source maintenue, et chaque canal y puise. Si vous hésitez encore à automatiser le support téléphonique, commencez par là, pas par le choix du modèle.
Ce que ça coûte, calculs faits
Le tarif vocal de Grok est le plus simple de la catégorie, directement depuis la page de tarifs xAI :
| API vocale | Prix |
|---|---|
Speech to speech (grok-voice-3.0) | $0.08 par minute ($4.80 par heure) + $0.004 par entrée texte |
Speech to speech (grok-voice-2.0, déprécié) | Même tarif |
| Speech to text | $0.10 par heure (REST), $0.20 par heure (streaming) |
| Text to speech | $15.00 par 1M de caractères |
Il n'y a ni licences par utilisateur ni frais de plateforme, ni minimum non plus, juste un tarif pour chaque minute, que le modèle ait beaucoup réfléchi ou non. La facture est donc facile à prévoir. Entrez vos propres chiffres :
Pour fixer les ordres de grandeur : une équipe qui prend 500 appels par jour de 4 minutes chacun dépense environ $4,800 par mois, et à son heure de pointe a environ 7 appels en cours simultanément, dans la limite du palier gratuit de 10. La simultanéité ne commence à poser problème qu'au-delà de quelques milliers d'appels par jour. Les 20,000 appels par jour de Starlink, avec la même hypothèse de 4 minutes (xAI ne publie pas la durée des appels), représenteraient 80,000 minutes et $6,400 par jour. Pour l'angle des modèles moins chers, mon article sur les tarifs de Grok Voice 2.0 compare les prix à la minute de toute la catégorie, et ma comparaison du coût d'un agent humain place le chiffre par appel à côté d'un salaire.
Comment il se place face à la concurrence
Une carte rapide des modèles que vous présélectionneriez à ses côtés, tout provenant du classement d'Artificial Analysis (le coût est le coût d'exécution mesuré par AA par heure d'audio en entrée, pas un prix catalogue) :
| Modèle | Indice AA | τ-Voice | Délai avant le premier audio | Coût AA par heure |
|---|---|---|---|---|
| Grok Voice 3.0 | 86.9 | 71.6% | 0.81s | $4.80 |
| GPT-Live-1 (Astra, medium) | 83.2 | 74.5% | 1.34s | $5.83 |
| Gemini 3.8 Live Extended Thinking (High) | 82.6 | 68.6% | 1.35s | $3.50 |
| Grok Voice 2.0 | 81.3 | 56.5% | 0.70s | $4.80 |
| GPT-Live-1 (Sol, low) | 80.1 | 59.3% | 1.24s | $4.47 |
| GPT-Realtime-2.1 High | 75.2 | 45.7% | 1.21s | $10.75 |
Pour un regard extérieur, xAI cite aussi EVA-Bench, le benchmark ouvert de ServiceNow pour les agents vocaux d'entreprise sur plus de 200 scénarios, où Grok Voice 3.0 obtient le meilleur score de précision avec 74%.
Si vous voulez une plateforme complète plutôt qu'un modèle, le compromis est différent. Des outils comme Retell AI, Vapi et ElevenLabs enveloppent les modèles dans des parcours d'appel et des tableaux de bord, avec de l'analytique par-dessus.
Si vous vivez dans un helpdesk, vérifiez d'abord ce qu'il propose en natif : les agents vocaux IA de Zendesk et les agents vocaux de Freshcaller méritent tous deux un coup d'œil. Mon panorama des meilleurs agents vocaux IA couvre le reste.
Si vous n'avez besoin que de la voix et voulez apporter votre propre cerveau, les moteurs de synthèse vocale comme Cartesia Sonic 3 se situent plus bas dans la pile, et la carte plus large des entreprises de voix IA montre qui vend quoi. Pour les alternatives au sein de la même famille, ma liste des alternatives à Grok Voice 2.0 reste valable pour les concurrents.
Qui devrait s'y mettre, et qui devrait attendre
La réponse courte à la question de savoir si l'IA peut répondre aux appels de support est désormais un oui ferme pour la couche modèle. Qui devrait agir :
Changez maintenant si vous utilisez déjà Grok Voice 2.0 (c'est la même API et le même prix, donc le seul coût est une série d'appels de régression), ou si vous construisez un agent téléphonique qui doit mener à bien des tâches en plusieurs étapes et dont chaque 100ms de silence vous coûte des appelants.
Faites d'abord un duel si vous utilisez déjà GPT-Live-1 (Astra). Il gagne encore sur τ-Voice de 2.9 points. Savoir si l'avance de 0.5 seconde de Grok compense cela dépend de la part d'outils dans vos appels.
Attendez ou regardez ailleurs si vos appelants parlent des langues hors des 20 prises en charge, si vous avez besoin d'un constructeur de parcours d'appel sans code (commencez par le Voice Agent Builder de xAI ou une plateforme ci-dessus), ou si votre blocage n'est pas la voix du tout mais les réponses. Mon guide de la meilleure IA pour le support vocal couvre les options clés en main. Une voix brillante qui lit la mauvaise politique de remboursement reste la mauvaise politique de remboursement, et elle figure en tête de toute liste des problèmes de chatbots qui font abandonner les clients.
Grok gère l'appel. eesel gère ce qu'il faut dire.
Grok Voice 3.0 est un moteur de conversation. Il ne connaît ni votre délai de retour, ni vos 50,000 derniers tickets, ni les clients qui obtiennent le geste commercial. C'est la moitié que couvre eesel : un coéquipier IA de helpdesk qui rejoint Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et traite la file d'e-mails et de chats qui se trouve derrière chaque ligne téléphonique. Avant sa mise en service, vous pouvez le lancer sur vos propres anciens tickets et comparer ses réponses à ce que votre équipe a réellement envoyé.

Pour les développeurs, les deux s'assemblent proprement sur le papier. L'outil mcp de Grok accepte une URL de serveur, un jeton authorization et des en-têtes personnalisés. Chaque espace de travail eesel est un serveur MCP : lancez npx @eesel/cli mcp token depuis la CLI eesel et elle affiche l'URL, un jeton de 30 jours et l'en-tête X-Eesel-Agent-Id, exactement la forme que demande Grok. La même CLI permet de scripter et d'inspecter l'agent depuis un terminal ou de le confier à un agent de code comme Claude Code. Je n'ai pas encore testé cet assemblage sur une ligne téléphonique réelle, considérez-le donc comme une construction prometteuse, pas comme une intégration livrée, et surveillez la latence supplémentaire d'un appel d'outil en milieu de phrase.
Le tarif est un forfait mensuel fixe de crédits : $299 par mois pour 500 crédits, où un ticket ou un chat compte pour un crédit, avec 100 crédits gratuits pour essayer et sans carte. Essayez eesel sur une partie de votre file avant votre prochain pilote vocal, pour que l'agent au téléphone ait quelque chose qui vaille la peine d'être dit.
Frequently Asked Questions
Grok Voice 3.0 est-il assez bon pour des appels de support en production ?
Qu'est-ce qui a changé dans Grok Voice 3.0 par rapport à Grok Voice 2.0 ?
Combien coûte Grok Voice 3.0 ?
Grok Voice 3.0 est-il meilleur que GPT-Live-1 ?
Dois-je modifier mon code pour passer à Grok Voice 3.0 ?
grok-voice-latest, vous êtes déjà sur la 3.0. Si vous aviez figé grok-voice-2.0, remplacez le nom du modèle par grok-voice-3.0 ; le endpoint, les paramètres de session et les événements restent les mêmes. Les applications construites sur l'API OpenAI Realtime peuvent toujours migrer en changeant l'URL de base et la clé.