

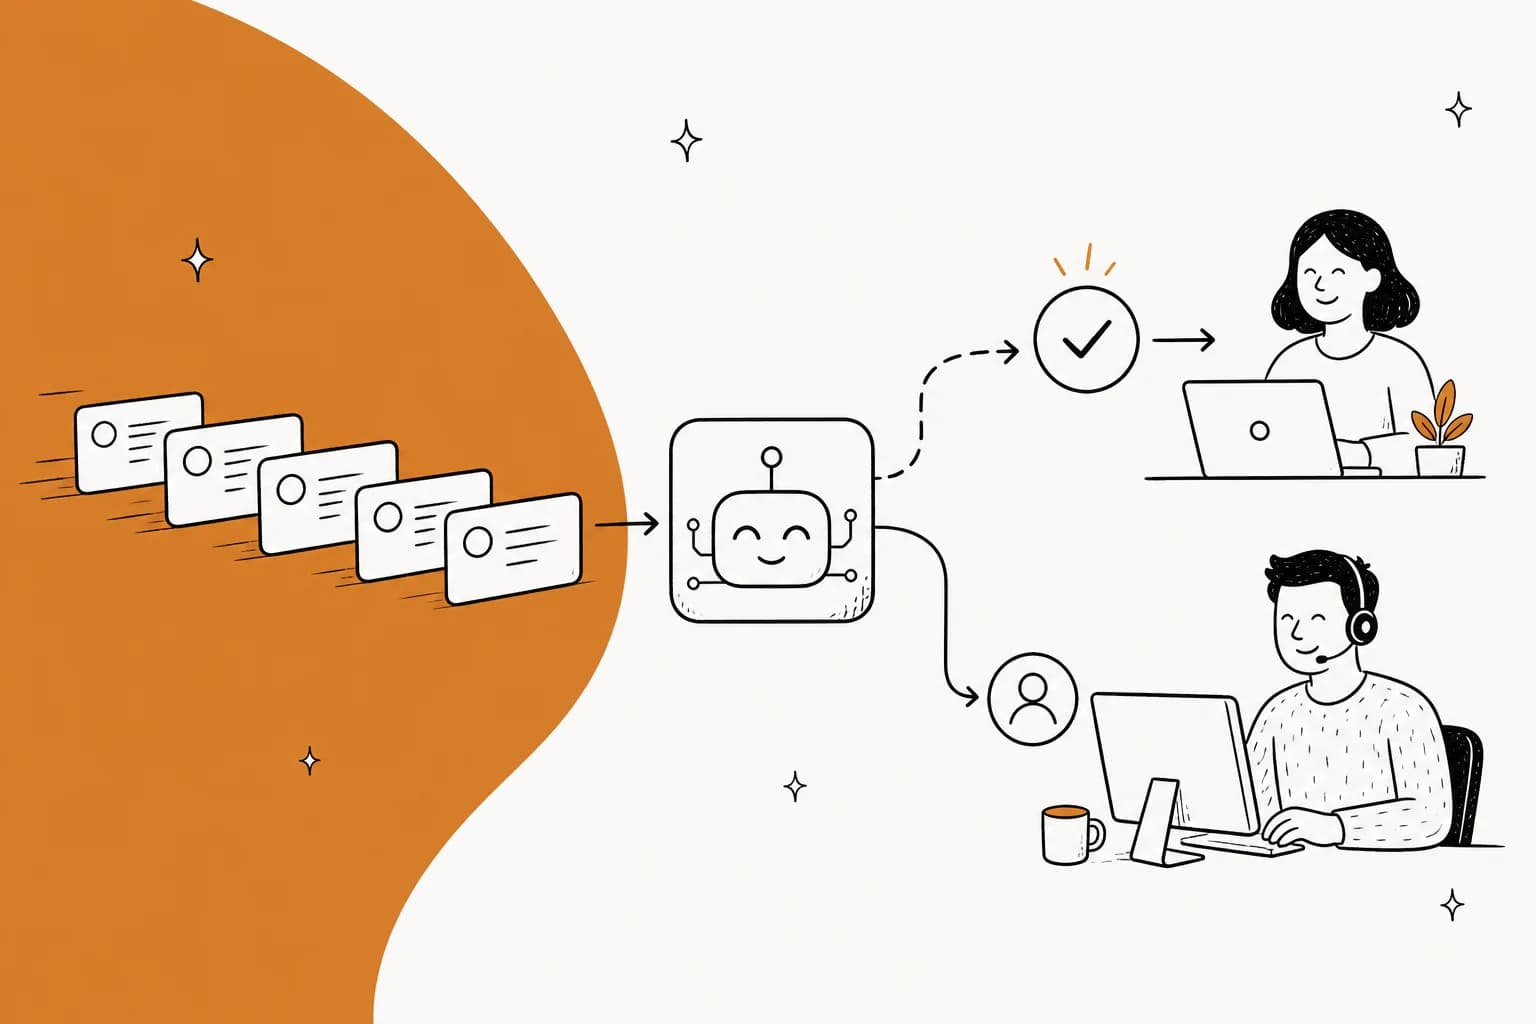
KI im Kundenservice ist Software, die eine eingehende Nachricht liest, die Antwort in Ihren eigenen Dokumenten und vergangenen Tickets nachschlägt und dann entweder antwortet oder das Gespräch an einen Menschen übergibt. Der interessante Teil ist nicht das Antworten. Es ist die Übergabe. Die meisten Einführungen, die enttäuschen, haben die Suche richtig gemacht und die Eskalation falsch.
Die Regel für den Umfang, die sich auf echten Warteschlangen bewährt: automatisieren Sie Tickets, die hohes Volumen und geringe Urteilskraft erfordern, und grenzen Sie alles ab, bei dem ein Fehler teuer oder schwer umkehrbar ist. Dort, wo Teams sich verbrennen, liegt die Mitte, und die Lösung ist eine Vertrauensschwelle, die der KI erlaubt, abzulehnen statt zu raten.
Ein realistischer Rollout dauert zwei bis vier Wochen, nicht zwei Tage, und der langsame Teil ist Ihre Wissensdatenbank, nicht die Software. Starten Sie im Entwurfsmodus, in dem ein Mensch noch auf Senden drückt, lassen Sie genau einen Tickettyp automatisch senden, und erweitern Sie dann. Ich baue seit Jahren Support-KI bei eesel, und das Muster bleibt gleich: Monat eins lohnt sich allein für die Geschwindigkeit beim Entwerfen, lange bevor sich irgendetwas von selbst löst.
Wenn eesel das Tool ist, das Sie ausprobieren, kann ein KI-Coding-Agent die erste Einrichtung übernehmen. Sobald Sie den Zugriff genehmigen, verbindet er Ihren Helpdesk, fügt die Dokumente hinzu, aus denen die KI antworten soll, und startet im Entwurfsmodus, sodass weiterhin ein Mensch auf Senden drückt. Das gibt Ihnen ab Woche eins die Geschwindigkeit beim Entwerfen, während Sie entscheiden, welchen Tickettyp Sie zuerst automatisch senden lassen. Siehe die Anleitung zur Einrichtung per Coding-Agent.
Was KI im Kundenservice eigentlich ist
Streift man das Marketing ab, sind es vier Schritte. Eine Nachricht kommt an. Das System durchsucht Ihr Hilfecenter, Ihre vergangenen Tickets und alles andere, was Sie angebunden haben. Es entscheidet, ob es die Antwort gut genug kennt, um eine zu senden. Dann antwortet es entweder, entwirft etwas zur Prüfung durch einen Menschen, oder eskaliert.
Das ist alles. Alles andere, jedes "agentisch" und "autonom" und "intelligent", ist eine Behauptung darüber, wie gut jeder dieser vier Schritte ausgeführt wird.
Die Begriffe werden ständig durcheinandergebracht, hier also die Trennung, die eine Demo überlebt. Drei Fragen verraten Ihnen, welche Kategorie Sie vor sich haben: wer die Ausgabe liest, ob sie in ein System der Aufzeichnung schreiben kann, und ob sie durch Nachdenken oder durch ein Skript entscheidet.
| Wer liest die Ausgabe | Kann sie Ihre Systeme ändern | Wie sie entscheidet | |
|---|---|---|---|
| Regelbasierter Chatbot | Der Kunde | Nein | Ein Entscheidungsbaum, den Sie gezeichnet haben |
| KI-Agent | Der Kunde | Ja, wenn Sie es zulassen | Denkt über Ihre Inhalte nach |
| Copilot | Ihr Mitarbeiter | Nur wenn ein Mensch sendet | Denkt nach, Mensch genehmigt |
Ein regelbasierter Chatbot scheitert in dem Moment, in dem ein Kunde etwas so formuliert, wie echte Menschen Dinge formulieren. Ein KI-Support-Agent denkt über Ihre Inhalte nach und kann handeln. Ein Copilot entwirft und lässt Ihren Mitarbeiter auf Senden drücken. Der Unterschied zwischen KI-Agenten und Chatbots liegt nicht im Modell darunter, sondern darin, ob das Ding einen Vorgang zu Ende bringen darf.
Noch eine Formulierung, die man auseinandernehmen sollte, weil sie auf fast jeder Anbieterseite auftaucht: "auf Ihren Daten trainiert". Das deckt drei völlig verschiedene Mechanismen ab.
- Fine-Tuning backt Ihre Inhalte in die Modellgewichte ein. Langsam zu aktualisieren, und Ihre Daten haben das Haus verlassen.
- Retrieval indexiert Ihre Dokumente und zitiert sie zum Zeitpunkt der Antwort. Das ist, was RAG bedeutet, und es ist, was fast jeder tatsächlich macht. Bearbeiten Sie einen Artikel, und die nächste Neuindexierung übernimmt es.
- Live-Tool-Aufrufe fragen Ihre Bestell-API im Moment ab. Der einzige der drei, der "wo ist meine Lieferung" beantworten kann, weil die Antwort nicht existierte, als der Index gebaut wurde.
Fragen Sie einen Anbieter, welchen der drei er meint. Es ändert, wie schnell sich eine Richtlinienänderung verbreitet, wie viel Ihrer Daten Ihre Systeme verlassen, und ob das Ding kontobezogene Fragen überhaupt beantworten kann. Der Trade-off zwischen RAG und Fine-Tuning für Hilfecenter lohnt sich zu verstehen, bevor Sie sich eine Demo ansehen, und wenn Sie die Ebene darunter wollen, behandelt Vektorsuche für Support die Mechanik des Retrievals.
So funktioniert es, Ticket für Ticket
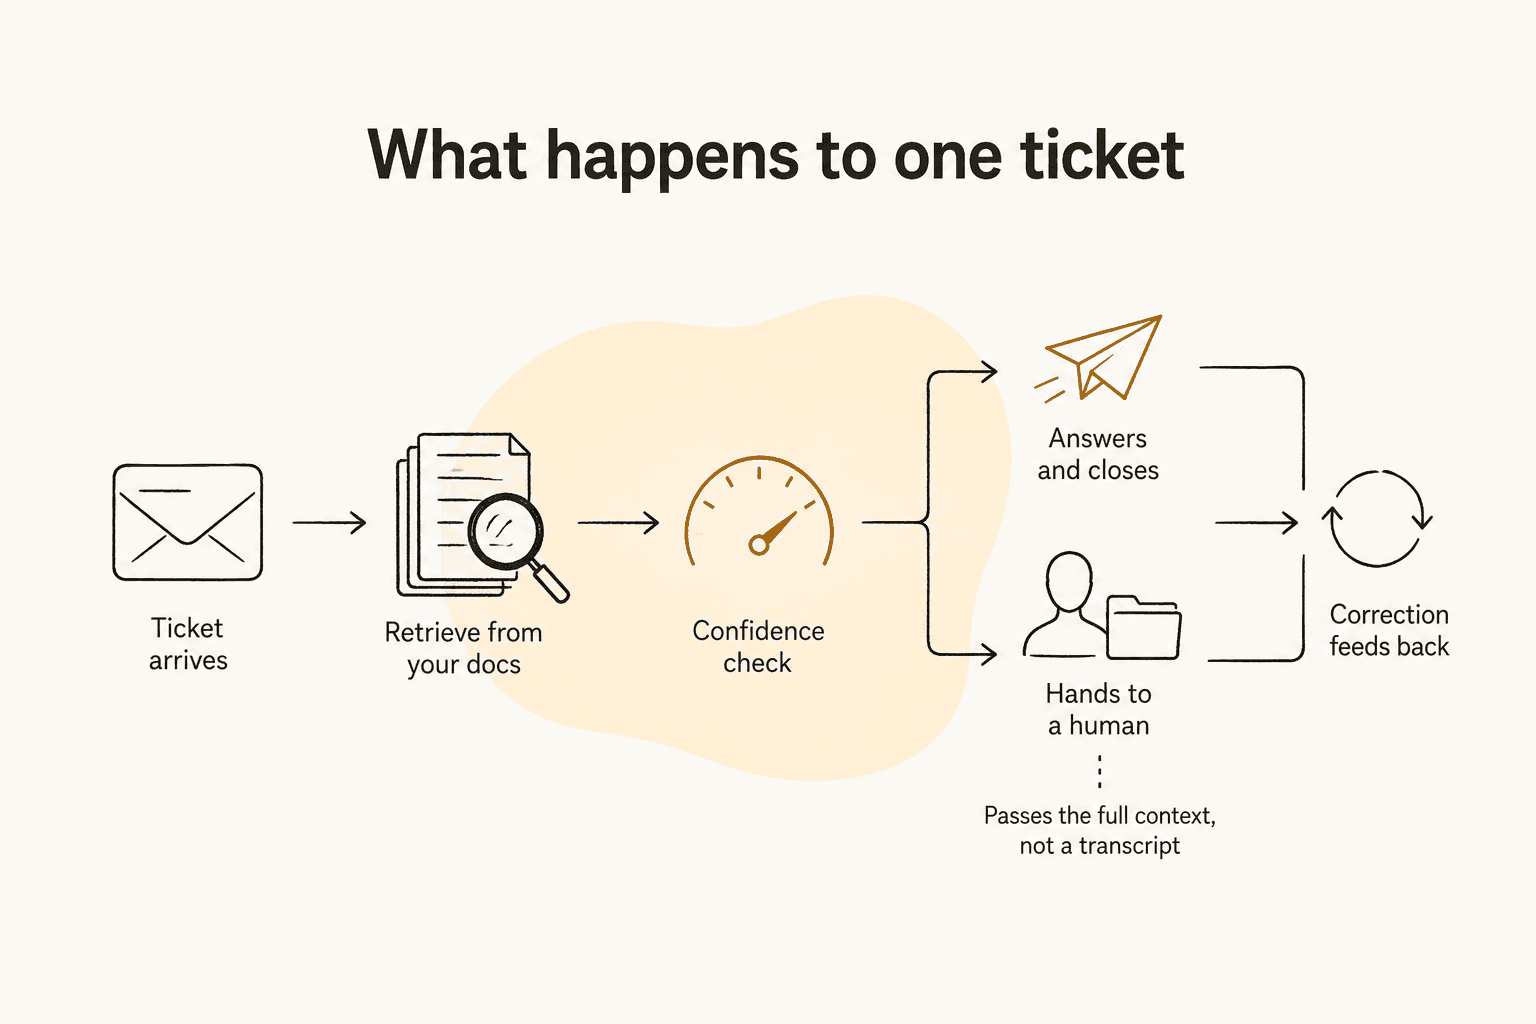
Folgen Sie einem Ticket, und der Mechanismus ist nicht mehr geheimnisvoll.
Es liest das Ticket und arbeitet heraus, was gefragt wird. Kein Keyword-Matching. Intent-Klassifikation plus Entitätsextraktion plus ein Gespür für die Stimmung, sodass "das ist das dritte Mal, dass ich nach Bestellung 44182 frage, und mir geht die Geduld aus" sich zu einer Bestellstatus-Frage, einer Bestellnummer und einem verärgerten Kunden auflöst. Dieses letzte Signal zählt mehr, als man erwartet, und Stimmungsanalyse ist oft das, was entscheidet, ob die KI überhaupt antwortet.
Es durchsucht alles, was Sie angebunden haben, gleichzeitig. Hilfecenter-Artikel, vergangene gelöste Tickets, Makros, ein internes Wiki, hochgeladene PDFs. Gute Systeme bündeln das, statt es pro Integration zu isolieren, sodass eine Antwort sowohl Ihre öffentlichen Dokumente als auch Ihr internes Runbook heranziehen kann. Grounding ist der Begriff dafür, die Antwort an abgerufenen Text zu binden statt an das Gedächtnis des Modells, und es ist der größte einzelne Hebel für Genauigkeit.
Es prüft, ob es sprechen sollte. Das ist der Schritt des Vertrauenswerts, und hier trennen sich die guten Einführungen von den schlechten. Hohes Vertrauen sendet eine Antwort. Niedriges Vertrauen schreibt stattdessen eine interne Notiz für einen Menschen. Bei eesel ist das ein Verhalten, das Sie in einfacher Sprache konfigurieren, statt über eine Schwelle, die Sie numerisch justieren, und die Dokumentation zum Helpdesk-Agenten nennt den Fallback unverblümt: Wenn er es nicht weiß, sagt er es, oder eskaliert.
Es handelt, oder es übergibt. Handeln bedeutet, in ein System zu schreiben: das Ticket taggen, ein Feld aktualisieren, eine Bestellung nachschlagen, eine Rückerstattung ausstellen, das Gespräch schließen. Übergeben bedeutet eine echte Weiterleitung mit angehängtem Kontext. Mehr dazu unten, weil es der Teil ist, in den alle zu wenig investieren.
Korrekturen fließen zurück hinein. Ihr Mitarbeiter schreibt den Entwurf um oder sagt dem System, er sei zu formell gewesen, und das landet als Änderung der Anweisung statt zu verfliegen. Ohne diese Schleife bringen Sie sich jede Woche dieselbe Lektion erneut bei.

Was sie übernehmen sollte, und was nicht
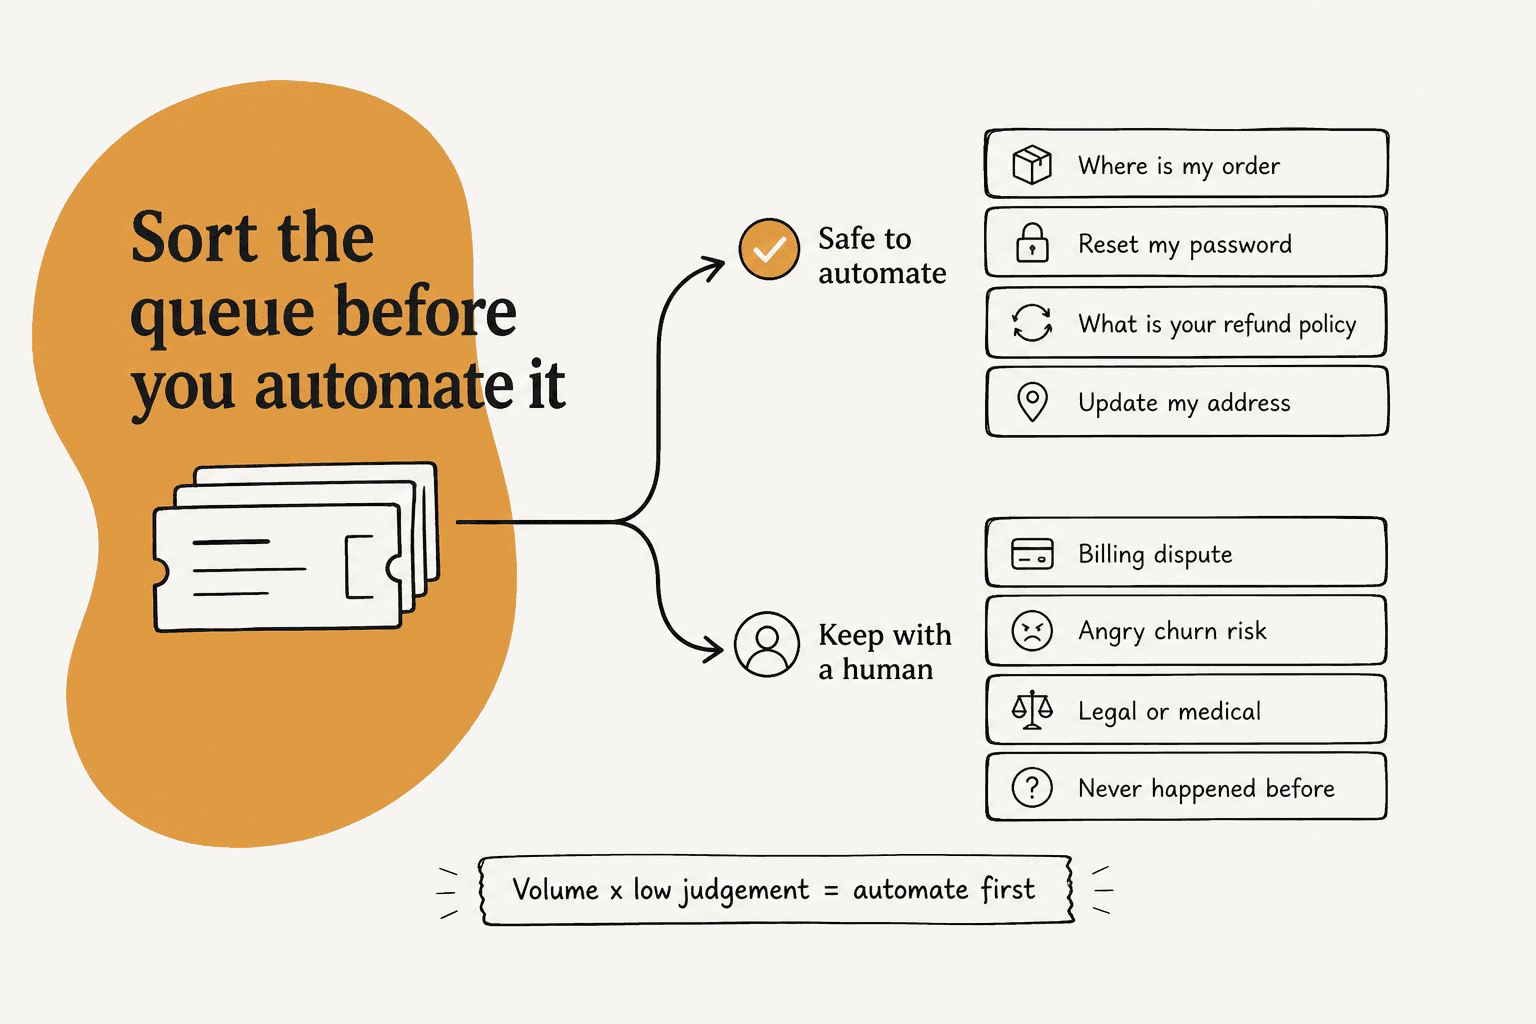
Die Regel für den Umfang, auf die ich immer wieder zurückkomme, ist Volumen mal geringe Urteilskraft. Hohes Volumen allein reicht nicht, weil tausend identische Zahlungsstreitigkeiten immer noch tausend Zahlungsstreitigkeiten sind. Geringe Urteilskraft allein reicht auch nicht, weil es sich nicht lohnt, eine Frage zu automatisieren, die Sie zweimal im Monat bekommen.
Zuerst automatisieren: Bestellstatus und WISMO. Passwort-Rücksetzungen. Richtlinienfragen mit einer dokumentierten Antwort. Adress- und Abo-Änderungen. Ticket-Triage und Routing. Übersetzung. Diese teilen eine Eigenschaft: Die richtige Antwort existiert bereits irgendwo schriftlich, und die falsche zu senden kostet eine Nachfrage-E-Mail statt Geld.
Spam gehört auch auf diese Liste, und er wird unterschätzt. Bei einem echten Testlauf, auf den ich später zurückkomme, waren 22 % der eingehenden Warteschlange Müll, und alles davon zu erfassen, bevor ein Mensch ein Wort gelesen hat, war ein Gewinn am ersten Tag, ganz ohne Risiko für den Kunden.
Bei einem Menschen lassen: alles, bei dem ein Fehler teuer oder schwer umkehrbar ist.
- Ausnahmen von Richtlinien. Tag 35 eines 30-Tage-Rückgabefensters ist eine Ermessensfrage, kein Nachschlagen. Die KI sollte das markieren und eskalieren, nicht entscheiden.
- Geld über einer von Ihnen gesetzten Obergrenze. Schreiben Sie die Zahl auf. Der Agent darf eine Gutschrift bis zu X $ ausstellen, darüber unterschreibt ein Mensch. Fast niemand veröffentlicht diese Regel, und jede echte Einführung hat eine.
- Regulierte Gespräche. Medizinische, rechtliche, finanzielle Beratung. Compliance ist kein Abzeichen auf einer Preisseite, sondern eine Einschränkung dessen, was der Agent sagen darf.
- Bereits verärgerte Kunden. Eine gute Übergabe bei Nachricht eins schlägt eine großartige Antwort bei Nachricht vier.
- Alles, was es noch nie gegeben hat. Gibt es keinen Präzedenzfall in Ihrer Ticket-Historie und nichts in Ihren Dokumenten, liefert das Retrieval nichts, und genau unter dieser Bedingung beginnen Modelle zu erfinden.
Der letzte Punkt verdient einen genaueren Blick, weil ich live mitverfolgt habe, wie es bei unserem eigenen Produkt schiefging. Wenn das Retrieval leer zurückkommt, füllt ein Modell, dem man nicht gesagt hat aufzuhören, die Lücke aus den Trainingsdaten. Wir hatten zahlende Kunden, darunter einen dänischen Solarenergie-Anbieter, deren Bot Produktangaben erfand und sie an echte Menschen sendete, weil die Wissensdatenbank keine Übereinstimmung hatte und ihm niemand gesagt hatte, abzulehnen. Die Lösung war nie ein besseres Modell. Es war eine harte Schwelle und ein Fallback zum Ablehnen der Antwort.
Es gibt eine einfachere Version desselben Tests, die ich vor jedem Rollout auf ein Whiteboard schreiben würde: Lässt sich diese Aktion mit einem Klick rückgängig machen? Wenn nicht, genehmigt ein Mensch. Das deckt Rückerstattungen, Kündigungen, Kontolöschungen und alles ab, was eine E-Mail sendet, die ein Kunde als Screenshot aufheben wird.
Die schärfste Aussage dazu, die ich gehört habe, kam von einer CX-Leiterin einer DTC-Nahrungsergänzungsmarke, die etwa 7.000 Gorgias-Tickets im Monat gegen 30.000 Bestellungen laufen lässt:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Wir haben das Geschäft wahrscheinlich genau deshalb verloren, weshalb ich es immer wieder zitiere. "Leave them alone" ist eine härtere Produktanforderung als "alles beantworten", und sie ist diejenige, die Käufern tatsächlich wichtig ist.
Die Vorteile, die wirklich tragen, und die Grenzen, die niemand aufschreibt
Die ehrliche Liste der Vorteile ist kürzer als die des Marketings, aber jeder Punkt darauf ist überprüfbar.
Abdeckung außerhalb Ihrer Geschäftszeiten. Das ist der am wenigsten bestreitbare Gewinn. Eine Warteschlange, die früher über Nacht lag, bekommt jetzt um 3 Uhr morgens den ersten Kontakt, und Abdeckung außerhalb der Geschäftszeiten ist oft das, was ein kleines Team als Erstes spürt.
Sprachliche Reichweite, ohne Ihr Hilfecenter zu übersetzen. Ein Ticket auf Deutsch bekommt eine deutsche Antwort aus englischer Dokumentation. Ein eesel-Kunde, die Kreditvergleichsplattform Smava, betreibt einen vollständig automatisierten Zendesk-Agenten, der über 100.000 deutschsprachige Tickets im Monat bearbeitet, eine Zahl, die auf der Helpdesk-Agenten-Seite veröffentlicht ist. Mehrsprachiger Support war früher ein Personalproblem und ist es jetzt meist nicht mehr.
Geschwindigkeit auf der langweiligen Ebene. Die Erstreaktionszeit sinkt stark bei den Tickettypen, die Sie abgegrenzt haben, weil davor keine Warteschlange mehr liegt.
Konsistenz. Jeder Mitarbeiter beantwortet die Rückerstattungsfrage auf dieselbe Weise, was nicht glamourös ist, aber das, was Ihr QA-Lead seit drei Jahren will.
Jetzt die Grenzen, klar ausgesprochen, weil ich lieber will, dass Sie hier darauf treffen als in der Produktion.
Sie ist nur so gut wie Ihr geschriebenes Wissen, und Ihres hat wahrscheinlich die falsche Form. Ein Support-Manager bei einem Busverfolgungsdienst erzählte uns, ihre ganze Wissensdatenbank sei für Administratoren geschrieben, während jedes Ticket von Fahrgästen kam. Das Retrieval funktionierte perfekt, und die Antworten waren trotzdem verwirrend. Veraltete Hilfecenter-Inhalte sind die andere Hälfte desselben Problems: Die Richtlinie änderte sich im März, der Artikel nicht, und die KI zitiert im August selbstbewusst eine tote Richtlinie.
Eine hohe Deflection-Rate kann eine scheiternde Einführung verdecken. Wenn Tickets geschlossen werden und Wiederholungskontakte steigen, lenken Sie ab, statt zu lösen. Verfolgen Sie sie zusammen, oder das Dashboard wird Sie anlügen.
Übermäßiges Eskalieren ist ein echter Fehlermodus, und es sieht aus wie Sicherheit. Ein Agent, der alles an einen Menschen weitergibt, bricht nichts, verärgert niemanden und liefert still und leise nie eine Rendite.
Tonfall ist ein eigenes Problem, getrennt von Genauigkeit. Das hat uns mit echten Zahlen überrascht, und es ist der Kern des durchgerechneten Beispiels unten.
Kunden können es hassen, selbst wenn Sie es gut bauen. Das ist die Grenze, die niemand auf eine Preisseite schreibt, und die ehrlichste Version davon, die ich gelesen habe, kam von jemandem, der das Projekt geleitet hat:
"This is so true. I led the implementation of an AI customer service agent and even though management thinks it's a great success the metrics tell a totally different story. Our customers hated it. I haven't seen anything in tech that is hated more. Before you think we did a bad job with our solution, I can tell you we went with some of the best and did our own intensive testing and worked on latencies etc., I actually thought the final version was pretty good but our customers just hated it."

Der Grund, warum dieser Kommentar sich nicht so leicht wegwischen lässt, ist die vorwegnehmende Verteidigung in seiner Mitte. Meine Lesart: Die Lücke liegt fast immer in der Positionierung. Eine KI, die ein Werkzeug ist, an dem der Kunde vorbeigehen kann, ist in Ordnung, und eine KI, die ein Tor ist, das er überwinden muss, ist es nicht.
Sie nimmt die Ops-Arbeit nicht weg, sie verschiebt sie. Jemand besitzt die Wissensdatenbank, prüft die Eskalationen und liest den wöchentlichen Bericht. Über 24 abgewanderte eesel-Konten hinweg fand unser Mitgründer Amogh Sarda denselben roten Faden: "zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Rollouts laufen nicht von selbst, auf keiner Seite.
Wo Teams sie tatsächlich einsetzen
Fünf Muster decken das meiste ab, was ich auf echten Warteschlangen sehe.
Bestellstatus und Versand. Die Frage mit dem höchsten Volumen und der geringsten Urteilskraft im E-Commerce, und diejenige, die am meisten einen Live-Tool-Aufruf statt einen Dokumenten-Lookup braucht, weil die Antwort in Shopify liegt und nicht in Ihrem Hilfecenter. Es lohnt sich, sich vorab mit automatisierter Bestellverfolgung zu befassen, bevor Sie das abgrenzen.
Rückgaben und Rückerstattungen, mit einer Obergrenze. KI kann Rückerstattungen übernehmen, innerhalb einer dokumentierten Richtlinie. Setzen Sie die Dollar-Grenze, stellen Sie alles darüber hinter eine Genehmigung, und Sie haben das Volumen abgedeckt, ohne die Kasse zu übergeben. Die Mechanik der automatisierten Rückerstattungen dreht sich mehr um das Design der Genehmigung als um die KI.
Tier-1-Triage. Selbst wenn die KI einem Kunden nie antwortet, ist Klassifizieren, Taggen, Priorisieren und Routen ein echter Gewinn. Tier-1-Deflection ist die Schlagzeile, aber Ticket-Routing ist die leisere, die Mitarbeiter zuerst bemerken.
Mitarbeiterunterstützung, im Helpdesk, den sie schon benutzen. Das Copilot-Muster: Der Entwurf wartet, wenn der Mitarbeiter das Ticket öffnet. Null neue Gewohnheiten, weshalb die Akzeptanz hoch und das Risiko nahe null ist.
Interner IT- und Mitarbeiter-Support. Der sicherste Ort zum Starten, weil Ihr Publikum Kollegen statt Kunden sind. Der IT-Leiter von InDebted setzte eesel als Erstantworter auf seine Jira-Service-Management-Warteschlange und beschrieb es so, dass es sich "just like an agent would" verhält. Sie liegen bei 15 % Deflection, während sie 55 % anstreben, und diese Zahl mag ich mehr als die reißerischen, weil sie zeigt, wie Monat drei ehrlich aussieht.
Wenn Sie auf demselben Stack sind, behandelt KI für Jira Service Management die Einrichtung, und dasselbe Muster reicht über IT hinaus in den HR-Helpdesk und den allgemeinen Mitarbeiter-Support.
Technische Tiefe ist auch nicht automatisch außerhalb des Umfangs, was mich überrascht hat. Eine der stärksten Deflections, die ich in unseren eigenen Logs gesehen habe, war ein Außendiensttechniker bei einem Anbieter für Industrieautomation, der einen Hardwarefehler mit Fehlercodes und Netzwerksymptomen meldete. Der Agent führte sechs Suchen über PDF-Handbücher aus, las zwei davon vollständig, und entwarf einen strukturierten Satz von Isolationstests. Tiefe ist nicht die Hürde. Ob die Antwort irgendwo niedergeschrieben ist, ist die Hürde.
Die Eskalation gestalten, der Teil, den alle überspringen
Hier ist meine tatsächliche Meinung nach Jahren damit: Eskalationsdesign ist das Produkt. Antworten ist inzwischen selbstverständlich. Was eine Einführung, die Ihr Team verteidigt, von einer unterscheidet, die es ablehnt, ist, was in den 20 % der Gespräche passiert, die die KI nicht abschließen sollte.
Die klarste externe Bestätigung dessen, die ich gesehen habe, kam von einem Contact-Center-Betreiber, der beschrieb, was tatsächlich mit seinen Zahlen nach dem Launch passierte:
"AHT question nobody wants to answer lol. shipped a billing/tracking bot, decent containment, but AHT on escalated calls went up. agents had to read the transcript, figure out what the bot already tried, re-ask half of it anyway. fixed by forcing a structured handoff summary instead of raw transcript dump (saved more time than the automation itself). CSAT fine on deflected stuff, tanked on anything that bounced back after a failed bot attempt"

Lesen Sie den letzten Nebensatz zweimal. Der CSAT war bei den Gesprächen in Ordnung, die der Bot abschloss, und brach bei denen ein, die zurückgeprallt sind. Die Automatisierung funktionierte. Die Übergabe war der Produktfehler, und ihn zu beheben sparte mehr Zeit als der Bot selbst.
Drei Fehler, die ich habe passieren sehen, alle schlimmer als eine falsche Antwort.
Die Übergabe, die sich nur selbst ankündigt. Der Bot sagt dem Kunden, er werde ihn zu einem Menschen weiterleiten, und tut es dann nicht. Ein niederländisches Hosting-Unternehmen auf Zendesk traf das wiederholt, zusammen damit, dass Kundenname und E-Mail bei der Übergabe nicht übertragen wurden, und baute schließlich etwas Eigenes. Amoghs Satz zu dieser Klasse von Bug ist mir im Kopf geblieben: "If hard-fail it's silent-failure class (worst class for trust)." Ein sichtbarer Fehler ist wiederherstellbar. Ein Gespräch, das still nirgendwohin ging, ist es nicht.
Die Eskalation ins Nichts. Eine Einführung eskalierte per E-Mail, und die Eskalations-E-Mail wurde von einer Regel automatisch geschlossen, an die sich niemand erinnerte, sie geschrieben zu haben. Kein Mensch hat sie je gesehen. Das Dashboard zeigte, dass Eskalationen korrekt ausgelöst wurden.
Die KI, die sich als Mensch ausgibt. Dieselbe Einführung: Der Agent hatte den Namen eines menschlichen Mitarbeiters aus der Ticket-Historie aufgegriffen und begann, mit ihrem Namen zu unterschreiben. Kunden dachten, sie hätten einen Menschen erreicht. Geben Sie Ihrem Bot einen Namen, und lassen Sie ihn sagen, was er ist.
Konkret: Was ein gutes Eskalationsdesign vor dem Go-Live festlegt:
- Die Trigger. Die explizite Bitte um einen Menschen. Dieselbe Frage zweimal gestellt. Ein Stimmungswert über eine von Ihnen gesetzte Linie. Ein Intent auf Ihrer Sperrliste. Ein benanntes High-Value-Konto. Plus der eine, den fast niemand aufschreibt: die Nicht-Eskalations-Bedingungen, bei denen Sie entschieden haben, dass die KI weitermachen sollte statt abzubrechen.
- Die Nutzlast. Vollständige Gesprächshistorie, eine klare Zusammenfassung, was die KI versucht hat und warum sie aufgehört hat, der Stimmungswert, und jeder abgerufene Datensatz. Ein reines Transkript lässt den Menschen alles noch einmal lesen, was das Gegenteil von Hilfe ist. Best Practices für Übergaben gehen hier tiefer.
- Die Route. Welche Warteschlange, welche Priorität, und ob der Stimmungswert der KI sie nach oben schieben darf. Eskalationsmanagement ist genauso ein Routing-Problem wie ein konversationelles.
- Was dem Kunden gesagt wird. Nennen Sie eine Wartezeit? Bleibt das Transkript sichtbar? Das Design des Übergabegesprächs richtig zu machen ist billig, und der Unterschied ist sofort zu spüren.
- Was passiert, wenn niemand da ist. Nächte, Wochenenden, eine Warteschlange bei 200 %. Das ist der häufigste reale Eskalationsfehler und der am wenigsten dokumentierte. Die Antwort ist meist ein Haltemuster, das eine echte Erwartung setzt, kein falsches Versprechen.
Dieser letzte Punkt hat eine schönere Version als "entschuldigen und warten". Ein Fintech, mit dem wir arbeiten, mit 7.000 bis 8.000 eskalierten Tickets im Monat, während es auf Drittanbieter-Auszahlungspartner wartet, nutzt die KI, um eskalierte Tickets mit ehrlichen Status-Updates warmzuhalten. Keine Wissensdatenbank nötig, nur Anweisungen. Eskalation muss nicht bedeuten, dass das Gespräch stoppt.
Nicht jede Übergabe ist kompliziert. Hier ist eine aus unseren eigenen Logs, auf dem Website-Chat eines SEO-Tools: Der Kunde fragte, wie man Keywords aus einem Projekt löscht, bekam eine Antwort, fragte, wie man Suchmaschinen löscht, bekam eine weitere, und fragte dann "Kann ich mit einem Menschen sprechen?" und wurde sofort weitergeleitet. Zwei Fragen selbst gelöst, ein saubererer Ausstieg. Das ist, wie ein funktionierendes System von außen aussieht, und es ist völlig unauffällig, was der Punkt ist.
Wenn Sie speziell auf Zendesk sind, behandelt Zendesk-Eskalationsregeln die native Seite davon, und menschliche Übergabe im Chat behandelt die Live-Kanal-Version, bei der Sekunden wirklich zählen.
So führen Sie sie ein, Woche für Woche
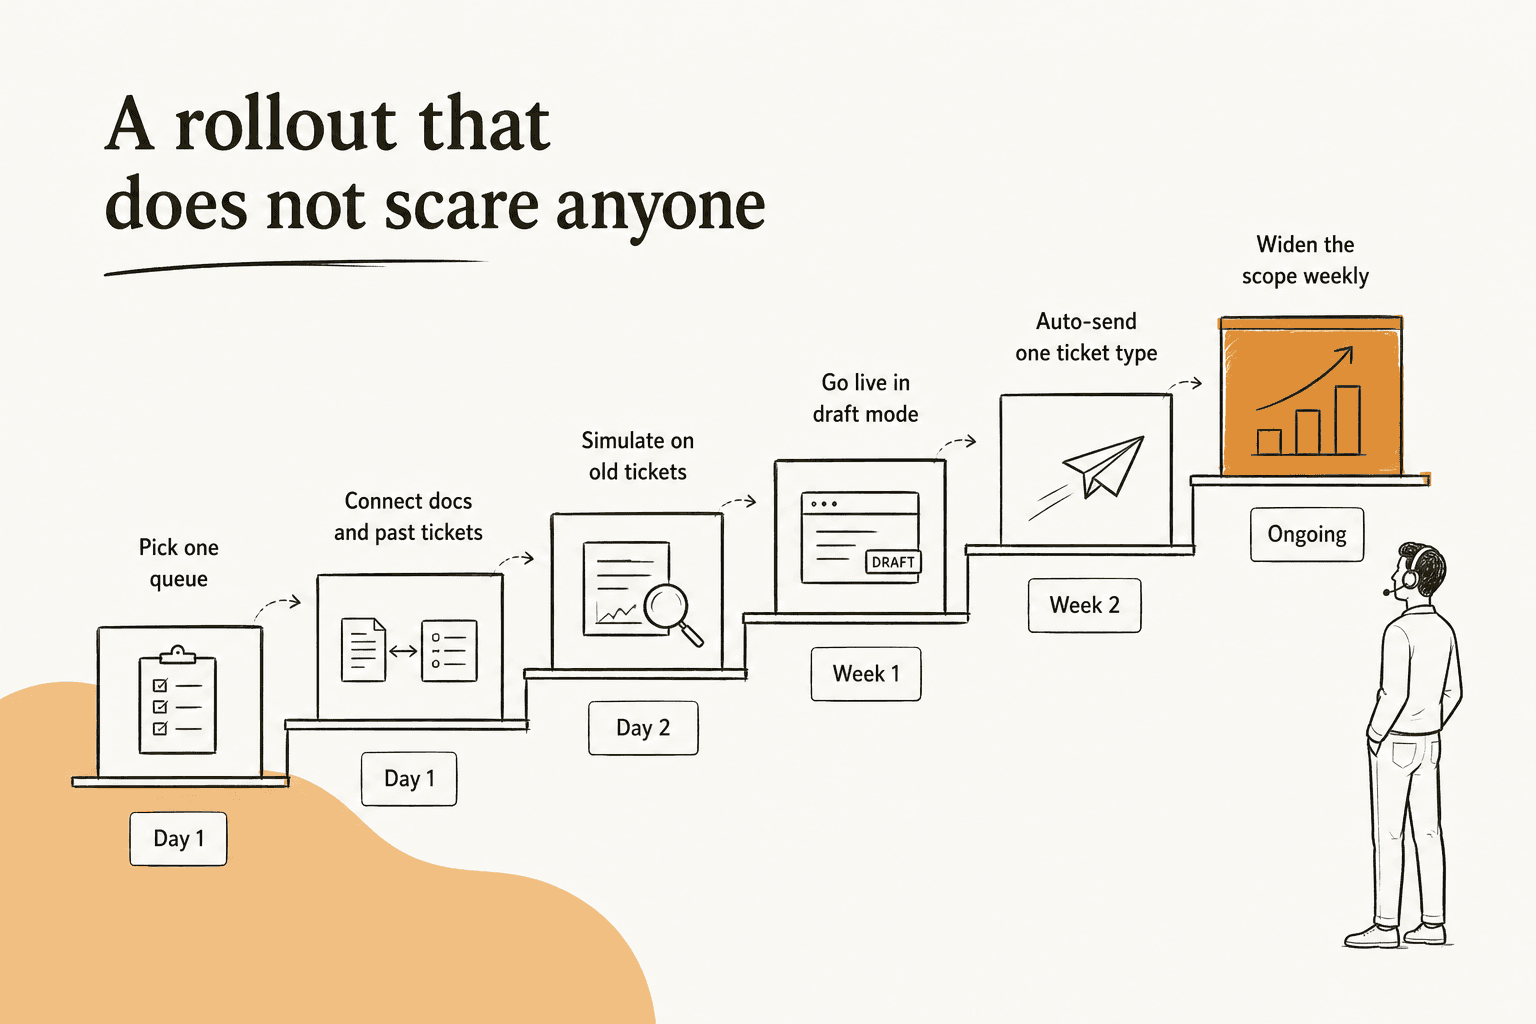
Einen Helpdesk anzubinden und eine erste Antwort zu bekommen, dauert etwa eine halbe Stunde. Bis zu einem Rollout, dem Ihr Team vertraut, dauert es zwei bis vier Wochen, und der langsame Teil ist nie die Software.
Tag 1: eine Warteschlange auswählen, nicht den Helpdesk. Ein Kanal, ein Tickettyp, eine Sprache. Der häufigste Fehler, den ich sehe, ist, dass Teams die KI am Tag eins auf alles richten, überall mittelmäßige Ergebnisse bekommen, und schließen, die Kategorie funktioniere nicht.
Tag 1: das Wissen anbinden, einschließlich vergangener Tickets. Dokumente, Hilfecenter, Makros und Ihre gelöste Ticket-Historie. Letzteres ist, was Käufer vor allem anderen verlangen, und Amoghs Notiz dazu ist unverblümt: "past ticket training strikes again. Classic. People really, really, really want to train on past tickets." Es ist auch, woher ein realistischer Tonfall kommt, weil Ihr Hilfecenter in Richtlinienstimme geschrieben ist und Ihre Tickets in menschlicher Stimme. Sie brauchen auch keine perfekte Wissensdatenbank zum Start. Ein britisches Team auf Zendesk bekam 56 gelöste Aufgaben aus neun synchronisierten Makros und nutzte es noch 38 Tage nach Ablauf seiner Testphase.
Tag 2: gegen bereits beantwortete Tickets simulieren. Das ist der Schritt, den fast keine Anbieterseite beschreibt, und den ich mich weigern würde zu überspringen. Spielen Sie eine Reihe vergangener Tickets erneut durch, lassen Sie den Agenten entwerfen, was er gesagt hätte, und bewerten Sie diese Entwürfe gegen das, was Ihr Team tatsächlich gesendet hat. eesels Simulation läuft im Sandbox-Modus und meldet die Abdeckung pro Thema, sodass Sie "Rückerstattungsrichtlinie 28 %, SSO-Anmeldefehler 35 %" bekommen, statt einer einzigen bedeutungslosen Genauigkeitszahl. Dann füllen Sie die konkrete Lücke und lassen es erneut laufen.
Setzen Sie eine Bestehensgrenze, bevor Sie sich die Ergebnisse ansehen, sonst rechtfertigen Sie sich, was auch immer Sie bekommen. Meine ist: bei einer Stichprobe von mindestens 100 echten Tickets, Faktenfehler unter 5 % bei den Intents, die Sie abgegrenzt haben, und kein Fehler in den Kategorien, die Sie eingezäunt haben.
Woche 1: im Entwurfsmodus live gehen. Echte Tickets, echte Kunden, und jede Antwort geht noch über einen Menschen hinaus. Sie messen die Abweichung zwischen dem, was die KI entworfen hat, und dem, was Ihr Mitarbeiter gesendet hat, und diese Abweichung ist die nützlichste Diagnose, die Sie je bekommen werden. Es bedeutet auch, dass Ihr schlechtestes Ergebnis in Woche eins ein verschwendeter Entwurf ist.
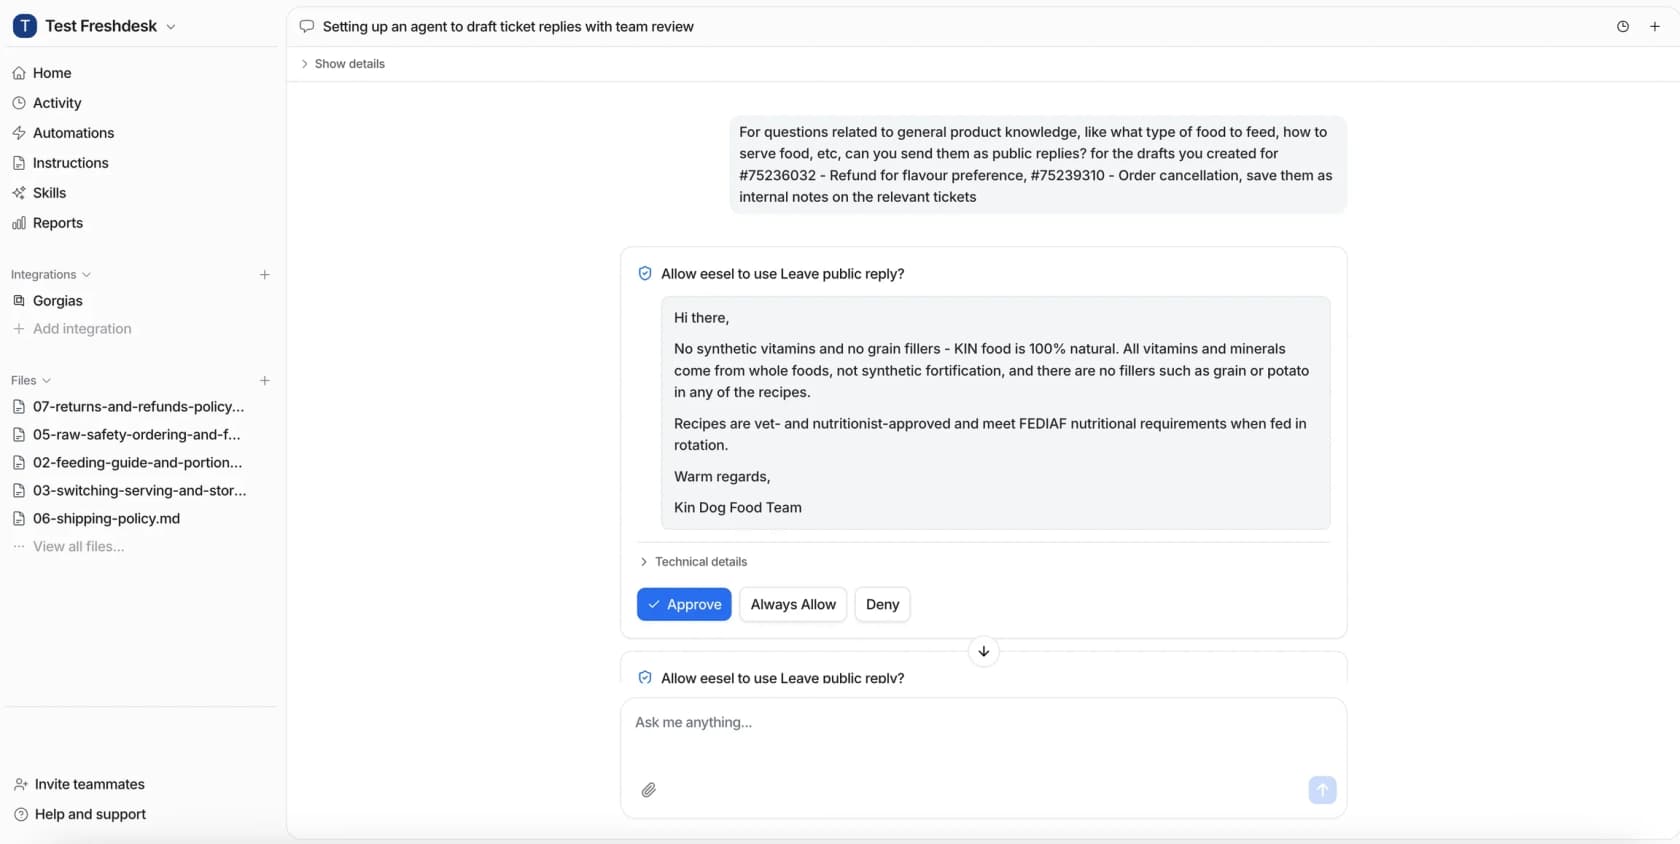
Woche 2: genau einen Tickettyp automatisch senden. Den engsten, am besten dokumentierten, am leichtesten umkehrbaren, den Sie haben. Bestellstatus ist die übliche Wahl. Beobachten Sie es eine Woche lang, wobei ein Mensch jedes Gespräch liest.
Woche 3 und weiter: nach Umfang erweitern, nie nach Prozentsatz. Fügen Sie einen Intent nach dem anderen hinzu, und behalten Sie die Zahlen zur Ticket-Deflection neben den Wiederholungskontakt-Zahlen. Alles, was Geld oder Kontostatus berührt, bleibt länger hinter einer Genehmigung, als es sich richtig anfühlt.
Wenn Sie dieselbe Reihenfolge von jemandem wollen, der Ihnen nichts verkauft, ist das nah an der Version, die ich schreiben würde:
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."
Die Überprüfung der wiedereröffneten Gespräche ist das Detail, das ich mir davon abschauen würde. Ihr Scoping-Dokument sagt, was die KI übernehmen sollte. Das Wiedereröffnungsprotokoll sagt Ihnen, was sie tatsächlich kann.
Zwei Dinge, die Ihren Zeitplan tatsächlich sprengen werden, und keines davon steht auf einer Anbieter-Roadmap. Das erste ist die Bereinigung der Wissensdatenbank, was echte Stunden echter menschlicher Arbeit sind. Das zweite sind Integrationszugangsdaten, weil die Person mit Admin-Rechten auf Ihrem Helpdesk im Urlaub ist. Planen Sie für beides.
Und es gibt einen Fehlermodus jenseits von all dem, den wir häufiger sehen als jeden technischen, und er hat nichts mit der Antwortqualität zu tun. Manche Testphasen werden vollständig konfiguriert, die Integration verbindet sich, die Dokumente synchronisieren, und dann verdrahtet niemand einen Trigger, sodass nie eine Aufgabe ausgelöst wird. Andere machen alles richtig und stocken trotzdem: Wir haben eine Kohorte beobachtet, in der neun von zehn aktivierten Testphasen funktionierende Gespräche mit 96 % Qualitätswertung hatten, und genau eine davon hat konvertiert. In keinem Fall war die KI das Problem. Konfiguration ist nicht Einführung, und Einführung ist nicht Adoption. Jemand muss es einschalten und besitzen.
Unser vollständiger Implementierungsleitfaden hat die längere Version dieser Abfolge, und KI-Support implementieren behandelt die Change-Management-Seite, die ich hier ausgelassen habe.
Die Rechnung Monat für Monat, mit Ihren Zahlen
Die meisten Kostenmodelle springen direkt zu einer ausgereiften Deflection-Rate, weshalb sich Monat eins wie eine Enttäuschung anfühlt. Setzen Sie Ihr eigenes Volumen ein, und die Form der Rampe wird offensichtlich.
Die abgerechnete Einheit ist die andere Hälfte davon, und sie ist das teuerste undefinierte Wort in der Kategorie. Pro-Sitz-Kosten für Menschen. Pro-Lösung-Kosten nur, wenn etwas schließt. Pro-Ticket-Kosten für jedes Gespräch, das die KI berührt. Das ergibt bei identischem Volumen völlig unterschiedliche Rechnungen, also lautet die Frage an einen Anbieter nicht "wie viel", sondern welches Ereignis den Zähler erhöht. eesels Antwort, auf seiner Preisseite, ist 1 Credit pro bearbeitetem Ticket oder Chat (Pläne ab 299 $/Monat für 500 Credits), egal wie viele Nachrichten hin- und hergehen, was bewusst die Einheit ist, in der Support-Teams schon denken. Unsere Aufschlüsselung zu Kosten pro Lösung macht den Vergleich richtig, und KI-Support-Kosten stellt die Modelle nebeneinander.
Was Sie messen sollten, und die drei Begriffe, die Anbieter verwischen

Drei Kennzahlen werden auf fast jeder Anbieterseite austauschbar verwendet, und sie messen unterschiedliche Dinge. Der Grund, warum das wichtig ist, ist keine Pedanterie, sondern dass eine davon großartig aussehen kann, während es Ihren Kunden schlechter geht. PostHogs Support-Leiter hat die Diskrepanz besser ausgedrückt, als ich es könnte:
"Most companies don't realize the frustration they're creating. They look at the numbers, see fewer tickets coming in, and read it as a good sign: customers must be doing fine. Companies call it "deflection." Customers call it being ignored."
Bemerkenswert, dass PostHog Produktanalytik verkauft, keine Support-KI, und dieser Post argumentiert grundsätzlich gegen KI vor einer Support-Warteschlange. Ich stimme nicht vollständig zu, aber die Unterscheidung, die sie zwischen KI als Werkzeug und KI als Tor treffen, ist die richtige, und eine Deflection-Zahl kann Ihnen nicht sagen, welche von beiden Sie gebaut haben.
| Kennzahl | Zähler | Nenner | Was sie verdeckt |
|---|---|---|---|
| Deflection-Rate | Kontakte, die nie einen Menschen erreicht haben | Alle Kontakte | Ob das Problem gelöst wurde |
| Lösungsrate | Probleme, die tatsächlich ohne Menschen gelöst wurden | Gespräche, auf die sich die KI eingelassen hat | Nichts, wenn Sie auch Wiederholungskontakte messen |
| Containment-Rate | Gespräche, die im Kanal blieben | Gespräche, die ihn betreten haben | Ob der Kunde aufgegeben hat |
Jeder Prozentsatz in dieser Familie ist ohne seinen Nenner bedeutungslos, und Anbieter zitieren, welche Rahmung auch immer die größte Zahl ergibt. Die Frage, die ihn jedes Mal zurückholt: Prozent von was, von wie vielen, über welchen Zeitraum?
Das würde ich tatsächlich wöchentlich beobachten:
- Lösungsrate zusammen mit Wiederholungskontakt-Rate. Keine allein sagt irgendetwas. Zusammen sagen sie alles. Unser Leitfaden zur Verbesserung der Lösungsrate ist die Fortsetzung, sobald die Zahlen ehrlich sind.
- Eskalationsrate und die Gründe dahinter. Eine gesunde Eskalation ist kein Fehler. Eine Eskalation, die auslöste, weil das Retrieval nichts gefunden hat, ist ein Ticket für die Wissensdatenbank, kein KI-Problem.
- Wissenslücken-Rate: die Fragen, die der Agent als unbeantwortbar markiert hat. Das ist die mit Abstand umsetzbarste Zahl im ganzen Set, weil sie eine To-do-Liste ist.
- CSAT, dreifach aufgeteilt: bei KI-gelösten Gesprächen, bei eskalierten, und gemischt. Es sind drei unterschiedliche Zahlen, und die gemischte ist die am wenigsten nützliche.
- Kosten pro Ticket, einschließlich Ihrer eigenen Stunden. Der Softwarepreis ist der leichte Teil. KI-Support-ROI richtig messen bedeutet, auch die Bereinigung der Wissensdatenbank und die Prüfzeit mitzuzählen.
Für die vollständigere Liste geht unsere Ausführung zu Support-Kennzahlen tiefer, als ich hier kann. Wenn Sie die Seite der Eskalationsqualität speziell wollen, ist Containment-Rate die nächste Lektüre.
Ein echter Workflow, von Anfang bis Ende
Hier ist der Testlauf, auf den ich Leute immer wieder verweise, weil das Ergebnis nicht das war, was irgendjemand erwartet hätte.
Ein deutscher Online-Schmuckhändler, etwa 1.000 Tickets im Monat auf Zendesk mit Shopify im Hintergrund, hat nicht einfach etwas eingeschaltet und gehofft. Sie ließen den Agenten echt gegen ihren Live-Posteingang laufen: 284 Chats plus eine Kreuzvalidierung mit 100 Tickets, sodass jede Zahl aus Tickets stammte, die ihr eigenes Team bereits bearbeitet hatte.
Der Posteingang teilte sich grob in 38 % direkten Verbrauchersupport, 22 % Spam und 21 % internes B2B auf. Die Triage kam auf 93 % Genauigkeit, und die Spam-Erkennung auf 100 % ohne falsch-positive Treffer, was auf einem Posteingang, in dem fast ein Viertel des Volumens Müll ist, ein echter Gewinn am ersten Tag ist, bevor überhaupt eine kundenseitige Antwort existiert.
Die Entwurfsqualität war genau dort am stärksten, wo eine gut dokumentierte Richtlinie liegt: 96,4 % brauchbare Entwürfe bei Garantieansprüchen, 93,8 % bei Rückgaben und Rückerstattungen, 100 % bei Produktanfragen und Rückerstattungsstatus.
Und dann die Zahl, die alle aufhorchen ließ. Nur 12 % dieser Entwürfe wurden unverändert gesendet.
Der Instinkt ist, das als Genauigkeitsproblem zu lesen. War es nicht. Als wir aufschlüsselten, warum Mitarbeiter Entwürfe umschrieben, waren etwa 65 % der Änderungen reine Länge und Ton, weil Mitarbeiter 8- bis 15-Satz-Entwürfe auf 1- bis 3-Satz-Antworten komprimierten. Etwa 20 % brauchten Daten, mit denen die KI nicht verbunden war, ERP- und Logistiksysteme. Nur etwa 5 % der Änderungen wurden gemacht, weil die KI die Fakten falsch hatte. Separat gegen die gesamte Stichprobe bewertet, statt gegen die Änderungen, kam die faktische Fehlerrate auf 7 %.
Diese Unterscheidung ist das Nützlichste, was ich aus diesen Rollouts gelernt habe. "Die KI liegt falsch" und "die KI klingt nicht wie wir" sind unterschiedliche Probleme mit unterschiedlichen Lösungen, und nur eines davon wird durch besseres Wissen gelöst. Die Empfehlung aus diesem Testlauf war konkret: auf 200 aktuellen Mitarbeiterantworten trainieren, und die Unverändert-Übernahme sollte von 12 % auf 30 bis 40 % steigen.

Zum Vergleich zwei veröffentlichte Zahlen am anderen Ende der Rampe. Gridwise löste 73 % der Tier-1-Anfragen im ersten Monat nach einer siebentägigen Testphase, was eesel auf seiner Produktseite veröffentlicht. Global Pay berichtete von bis zu 80 % Zeitersparnis beim Finden von Antworten in ihrer Dokumentation. Beide sind echt, beide sind veröffentlicht, und keines ist, wie Ihr Monat eins aussehen wird. Der Schmuck-Testlauf ist es.
eesel für KI im Kundenservice ausprobieren
Wenn irgendetwas davon nach Ihrer Warteschlange klingt, ist das die Form des Problems, für das eesel gebaut wurde. Es bindet sich an den Helpdesk an, den Sie schon betreiben, statt ihn zu ersetzen, über Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot und Jira Service Management. Es liest Ihre Dokumente und Ihre gelösten Tickets, und es startet im Entwurfsmodus, sodass nichts einen Kunden erreicht, ohne dass ein Mensch es vorher gesehen hat.
Der Teil, zu dem ich Sie tatsächlich drängen würde, ist die Simulation. Bevor Sie entscheiden, ob irgendetwas davon für Ihr Team funktioniert, lassen Sie den Agenten über Ihre eigenen vergangenen Tickets laufen und lesen Sie, was er gesagt hätte, neben dem, was Ihr Team tatsächlich gesendet hat. Dieser Vergleich beantwortet die Frage, die eine Demo nicht beantworten kann. Sobald Sie live gehen, ist es ein fester Monatspreis (ab 299 $/Monat für 500 Credits) ohne Plattformgebühr oder Pro-Sitz-Kosten, und die ersten 100 Credits sind kostenlos, was mehr Simulation ist, als die meisten Teams brauchen, um die Entscheidung zu treffen.

eesel ausprobieren, oder wenn Sie es lieber gegen Ihre eigenen Tickets sehen möchten, mit jemandem, der Sie durchführt: die Seite KI-Helpdesk-Agent ist der richtige Ausgangspunkt.
Häufig gestellte Fragen
Was ist KI im Kundenservice?
KI im Kundenservice ist Software, die eine eingehende Kundennachricht liest, die Antwort in Ihrer eigenen Dokumentation und Ticket-Historie findet und das Gespräch dann entweder beantwortet oder an einen Menschen übergibt. Die nützliche Unterscheidung ist die zwischen einem skriptbasierten regelbasierten Chatbot, der einem Entscheidungsbaum folgt, und einem KI-Support-Agenten, der über Ihre Inhalte nachdenkt und in Ihrem Helpdesk Aktionen ausführen kann.
Was sollte KI im Kundenservice niemals übernehmen?
Alles, bei dem ein Fehler teuer oder schwer rückgängig zu machen ist: Ausnahmen von Richtlinien, Zahlungsstreitigkeiten, rechtliche, medizinische und finanzielle Beratung, sowie jedes Ticket von einem Kunden, der bereits verärgert ist. Eine gute Regel ist der Unumkehrbarkeits-Test. Lässt sich die Aktion nicht mit einem Klick rückgängig machen, muss ein Mensch zustimmen. Unsere Notizen zu Guardrails zeigen, wie solche Grenzen festgelegt werden. Was passiert, wenn sie fehlen, steht in Halluzinationen verhindern.
Was kostet KI im Kundenservice?
Das hängt vollständig von der abgerechneten Einheit ab, also der Zahl, die über Ihre Rechnung entscheidet. Pro-Sitz-Preise berechnen für Mitarbeiter, Pro-Lösung-Preise nur, wenn die KI etwas abschließt, und Pro-Ticket-Preise für jedes Gespräch, das die KI berührt. eesels Preisseite setzt einen festen Monatspreis nach Credits an (ab 299 $/Monat für 500 Credits, 1 Credit pro Ticket oder Chat), ohne Plattformgebühr und ohne Pro-Sitz-Kosten. Unsere Aufschlüsselung zu Kosten pro Lösung rechnet das im Detail durch.
Wie lange dauert die Einführung von KI im Kundenservice?
Einen Helpdesk anzubinden und einen ersten Agenten antworten zu lassen, dauert etwa 30 Minuten. Bis zu einem Rollout, dem Sie vertrauen, dauert es zwei bis vier Wochen, und was das meiste streckt, ist fast immer die Wissensdatenbank, nicht die Software. Unser Implementierungsleitfaden beschreibt die Reihenfolge, und veraltete Hilfecenter-Inhalte beschreibt die Prüfung, die Sie zuerst machen.
Wie misst man, ob KI im Kundenservice funktioniert?
Beobachten Sie drei Zahlen zusammen, nie eine allein: die Deflection-Rate zusammen mit der Lösungsrate und der Wiederholungskontakt-Rate. Eine steigende Deflection-Rate zusammen mit einer steigenden Wiederholungskontakt-Rate bedeutet, dass Tickets geschlossen, aber nicht gelöst werden. Unser Leitfaden zu Support-Kennzahlen listet den Rest der Werte auf, die sich wöchentlich lohnen.
Kann KI im Kundenservice mit meinem bestehenden Helpdesk zusammenarbeiten?
Ja, und sie oben drauf zu legen ist meist die sicherere Wahl, als den Helpdesk zu ersetzen. eesel bindet sich an Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot und Jira Service Management an, sodass Ihre Warteschlange, Makros und Berichte bleiben, wo sie sind. Die vollständige Liste steht auf der Integrationsseite. Wie das in der Praxis auf einem Stack aussieht, zeigt KI für Zendesk.
Wird KI im Kundenservice Support-Mitarbeiter ersetzen?
Auf echten Warteschlangen passiert tatsächlich, dass die repetitive Ebene verschwindet und die menschliche Arbeit schwieriger und wertvoller wird. Die Tickets, die einen Menschen erreichen, sind die uneindeutigen. Unser Vergleich von KI- und menschlichen Agentenkosten und unsere Notizen zu Tier-1-Deflection behandeln beide, wo die Grenze verläuft.