

A Gladly realmente tem garantia de qualidade com IA, mas ela é voltada para a própria IA da Gladly, não para um scorecard da sua equipe. Os quality checks filtram cada resposta da Gladly AI antes do envio e entregam o chat a uma pessoa se algum falhar, e o Signals pontua sessões de IA de chat, SMS e e-mail de acordo com até cinco critérios que você escreve. Conversas de agentes humanos são pontuadas em ferramentas de parceiros como MaestroQA ou Calabrio, e a documentação da Gladly não nomeia nenhum plano ou preço para nada disso. O eesel não tem conexão embutida com a Gladly, então eu o usaria como revisor pela API REST da Gladly (não testei isso de ponta a ponta), ou como a escolha se você usa Zendesk, Freshdesk ou Gorgias.
Com a CLI do eesel, um agente de IA para código pode enviar sua rubrica de QA e suas páginas de política, depois fazer perguntas de teste e verificar as respostas antes de qualquer coisa entrar em produção. Uma pessoa ainda precisa aprovar qualquer conexão com um helpdesk.
A Gladly tem garantia de qualidade com IA?
Sim, em três camadas, e o que vale notar é quem cada camada observa. Eu trabalho na fila de suporte da eesel, então leio uma ferramenta de QA perguntando quem é pontuado e quem não é. Na Gladly, as camadas nativas olham para a IA. As pessoas ficam em uma trilha separada que a Gladly entrega a parceiros, e essa é a lacuna de que trata este artigo.
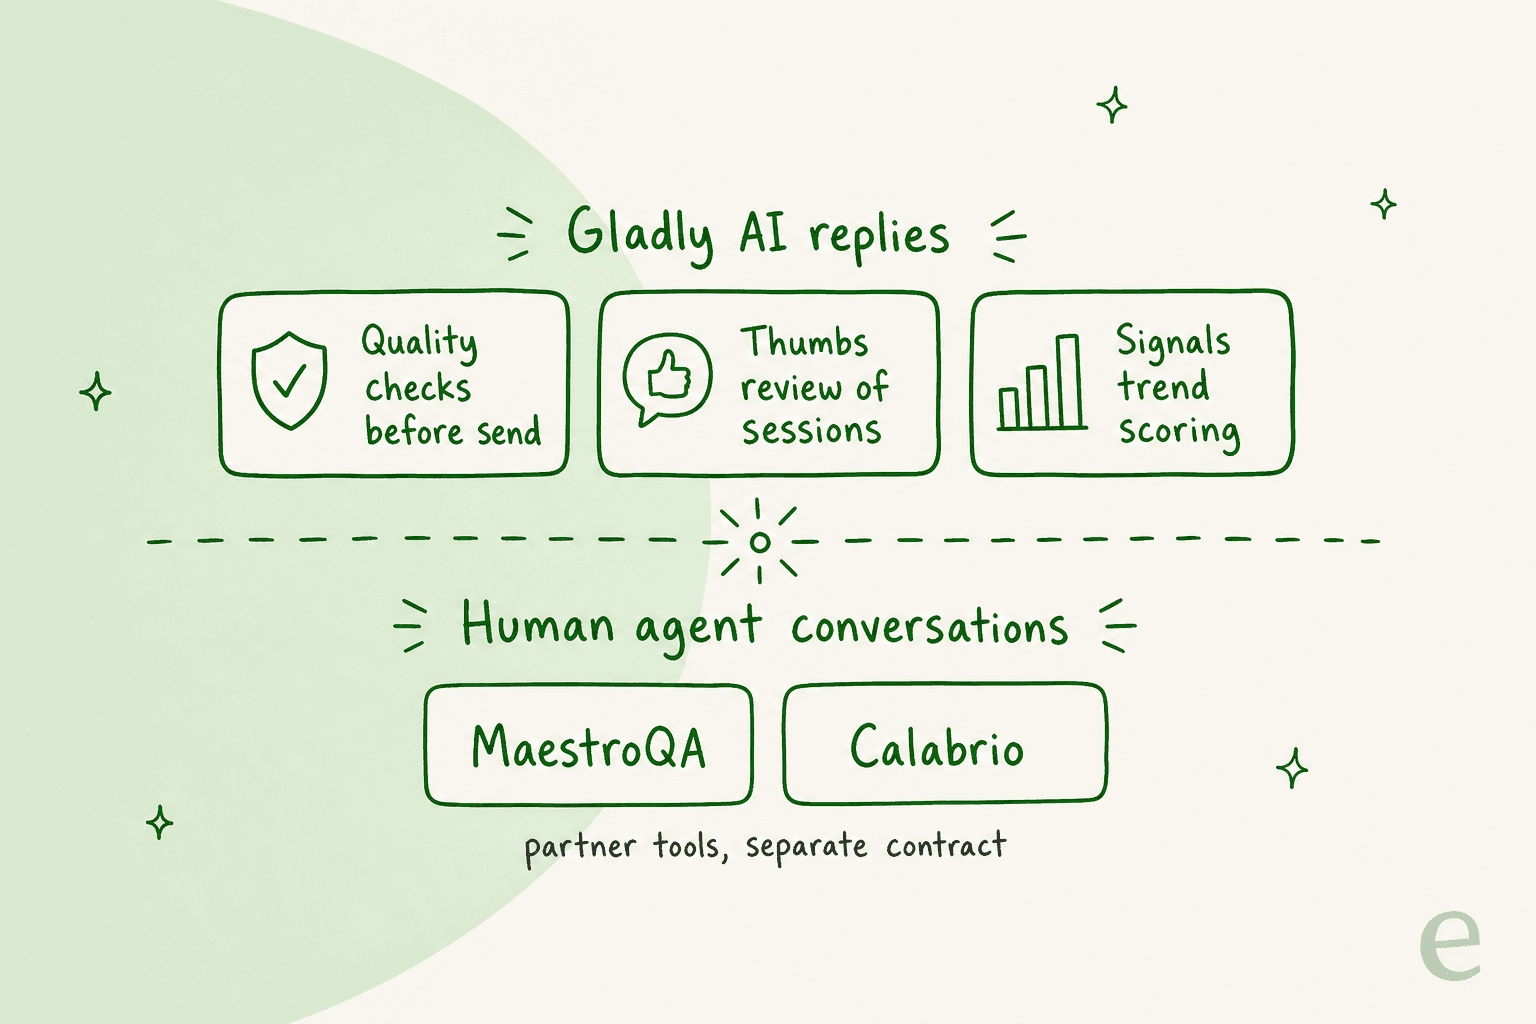
| Camada | O que faz | Quem vê | Limite |
|---|---|---|---|
| Quality checks | Testa cada resposta de IA antes do envio | Admins e Team Managers configuram | Verifica a resposta, mas não dá uma pontuação |
| Review and Inspect | Avaliação por polegar e notas, mais uma visão passo a passo de por que a IA respondeu assim | Admins e Team Managers, não os agentes | Sem dados antes de 24 de fevereiro de 2026 |
| Signals | A IA pontua sessões de acordo com seus critérios e agrega tendências | Admins, Team Managers, funções personalizadas com View Gladly AI | Apenas sessões de IA de chat, SMS e e-mail |
| QA de parceiro | Avaliadores pontuam conversas e fazem coaching com agentes | Os próprios usuários do parceiro | Fornecedor e contrato separados |
A página de QA da Gladly descreve o lado humano como "sync seamlessly with your QA tool", o que mostra que o scorecard vive fora da Gladly. Se você quiser a ideia geral primeiro, meu guia sobre IA para QA de suporte cobre o que um programa completo verifica.
O que os quality checks da Gladly detectam?
Eles detectam problemas na resposta antes que o cliente os veja, o que é um trabalho diferente de pontuar. Segundo o resumo da Gladly (atualizado em 21 de fevereiro de 2026), um cliente envia uma mensagem, a Gladly gera uma resposta, e a resposta passa por checks automatizados. Se aprovada, é enviada. Se reprovada, a Gladly entrega a um agente em vez de enviar.
Os checks se dividem em três categorias voltadas ao cliente:
| Categoria | O que ela marca | Exemplo de falha da documentação da Gladly |
|---|---|---|
| Missing Action | Afirmações sobre ações que a Gladly não executou ou não pode executar | "Your order has been cancelled" quando nenhum cancelamento foi executado |
| Missing Information | Informação insuficiente para responder | "Reach out to our customer service team" dentro de uma conversa que já é de atendimento ao cliente |
| Unverified Information | Datas, políticas, e-mails, telefones ou URLs que não estão no contexto | "Our return policy is 90 days" quando a regra real é de 30 dias |
Por baixo, a Gladly mistura checks de LLM (Implied Mutation, Unfulfilled Action, Transfer Claim, Contact Us, Hallucination) com checks de código (Invalid Phrase, alucinação de e-mail e telefone). Hallucination é o que eu acompanharia de perto: ele divide a resposta em frases e pergunta se cada afirmação factual é respaldada por resultados de ações, resultados de busca ou conteúdo do Guide. Auto-Correction é uma configuração padrão que remove frases sem respaldo até um limite configurado, corrige a gramática, repara URLs e verifica novamente antes de entregar.
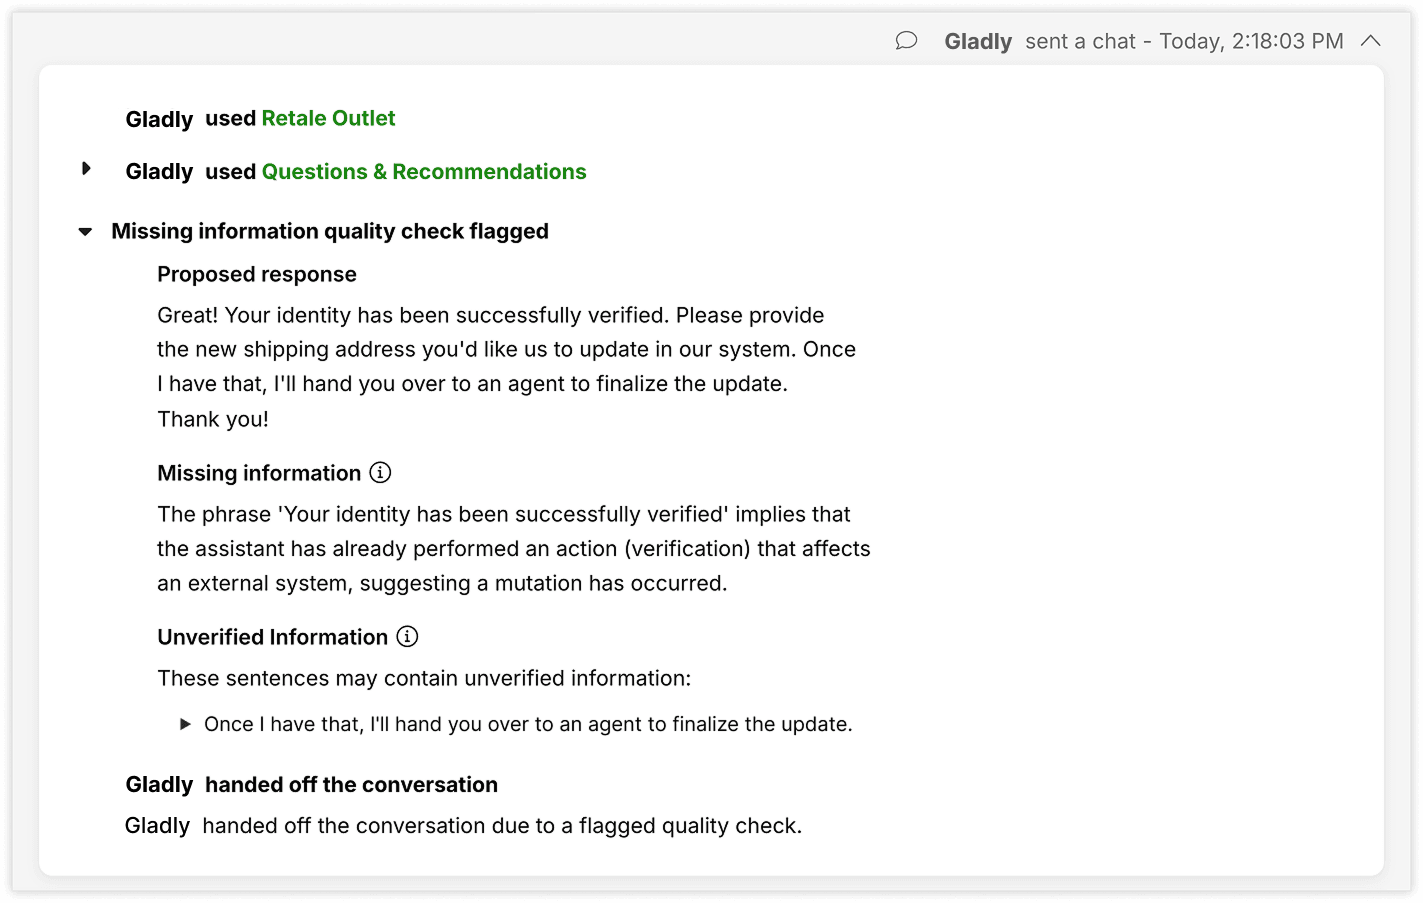
Isso pode ser ajustado por Guide. Um Admin ou Team Manager pode ativar ou desativar checks individuais para um Guide, e o ponto de partida recomendado pela Gladly é específico: para um Guide que responde a partir de fontes de conhecimento, manter Hallucination ativado e desativar Implied Mutation e Invalid Phrase, porque eles "may flag valid instructions and cause unnecessary handoffs". Isso mostra que o custo de um check estrito é uma entrega, então uma configuração sensível demais aparece como trabalho extra para seus agentes. Leia minhas notas sobre boas práticas de handoff se isso for importante para você.
Como você revisa conversas da Gladly AI?
Você as abre uma a uma, ou extrai os relatórios agregados. No Review and Inspect (atualizado em 7 de novembro de 2026), você abre uma sessão de IA, dá um polegar para cima ou para baixo com uma nota, e clica em qualquer resposta de IA para ver o Guide seguido, as fontes consultadas, os passos executados e o resultado do quality check.
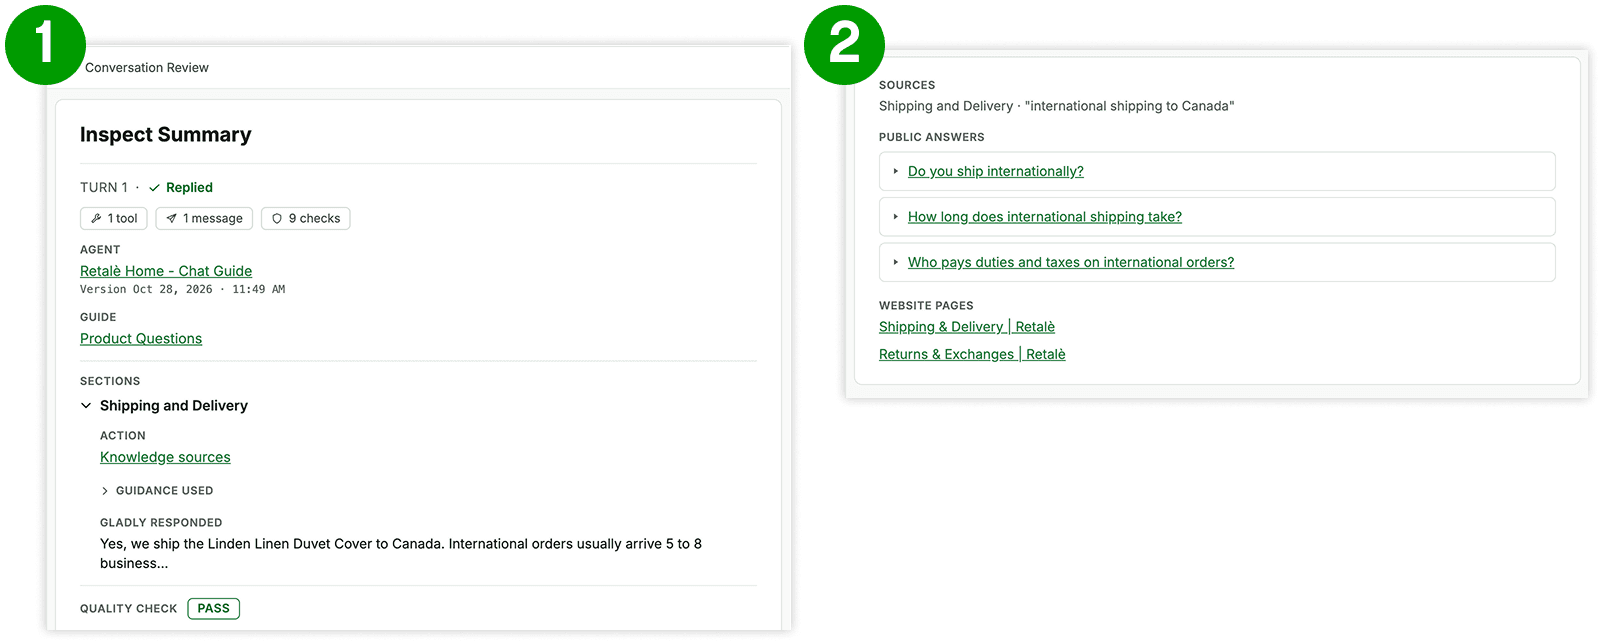
Quatro detalhes moldam como você rodaria isso como uma rotina de QA:
- É para gestores. Review and Inspect são visíveis para Admins e Team Managers, não para agentes, e o Inspect não está disponível para conversas anteriores a 24 de fevereiro de 2026.
- As avaliações são um diário. A Gladly diz que a página de Reviews "is an internal tool for your team, it is not sent to or acted on by Gladly". As avaliações não retreinam nada por conta própria.
- Você pode exportá-las. O Feedback Report gera uma linha por review com o comentário, o ID da sessão e o link da conversa, em CSV.
- Há um painel de resultados. O Improvement Opportunities acompanha taxas de resposta, resolução, handoff e recontato em 24 horas, e classifica motivos de handoff como QC Failure, Transfer Detector e Hallucinated Argument.
A Gladly também tem um Simulator para testar antes do lançamento. Você escreve um cenário com critérios de sucesso de sim ou não, e cada critério precisa passar para que o teste passe. Ele está em Early Access, então você entra em contato com o suporte da Gladly para saber mais. Para o método geral, veja testes de simulação de suporte com IA.
O que o Gladly Signals pode pontuar?
O Signals é o que a Gladly tem de mais próximo de pontuação automatizada, e é útil com limites claros. Segundo a documentação da Gladly (atualizada em 20 de novembro de 2026), ele "uses AI to evaluate AI-handled Sessions against criteria you define", e depois agrega os resultados em tendências. Você monta um Signal com um a cinco critérios, cada um com dois a cinco labels (até 30 caracteres cada), e opcionalmente marca um label como Goal ou Risk.
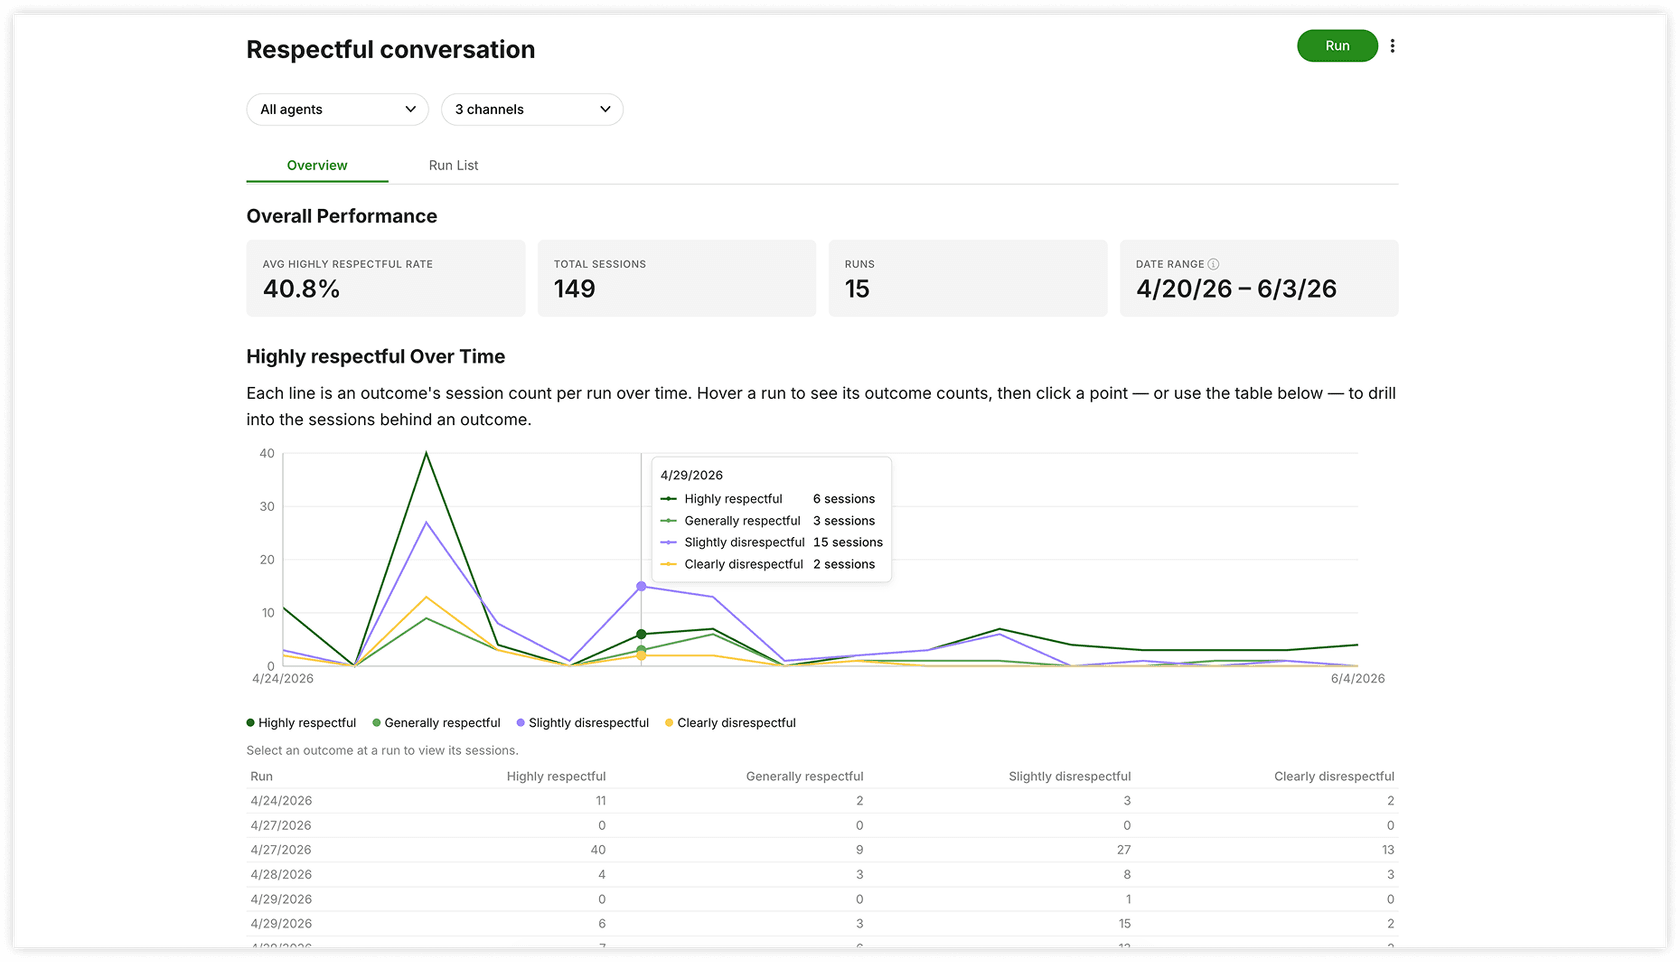
Você escolhe como ele funciona:
- Amostragem. A taxa é de 5%, 20% (padrão), 50% ou 100%, com 100, 1.000 ou 10.000 sessões por execução.
- Agendamento. Pontual, ou contínuo diário ou semanal. Não há opção mensal, e a Gladly diz que o Signals roda sob demanda ou agendado, não em tempo real.
- Revisão. Cada sessão avaliada traz o label da IA, seu raciocínio e uma citação de apoio. Você aprova ou marca cada uma, e um cartão de taxa de concordância mostra com que frequência sua revisão coincidiu com a da IA.
O conselho da Gladly é a parte que eu copiaria. Prefira menos labels, já que "Binary (Yes/No) or a short list of named categories" produz resultados mais consistentes do que uma lista mais longa, e nunca use uma escala de 1 a 5. Comece com menos de 50 sessões antes de escalar. A Gladly mantém seus próprios critérios integrados em uma barra de ">90% accuracy" e diz que você deve definir a sua.
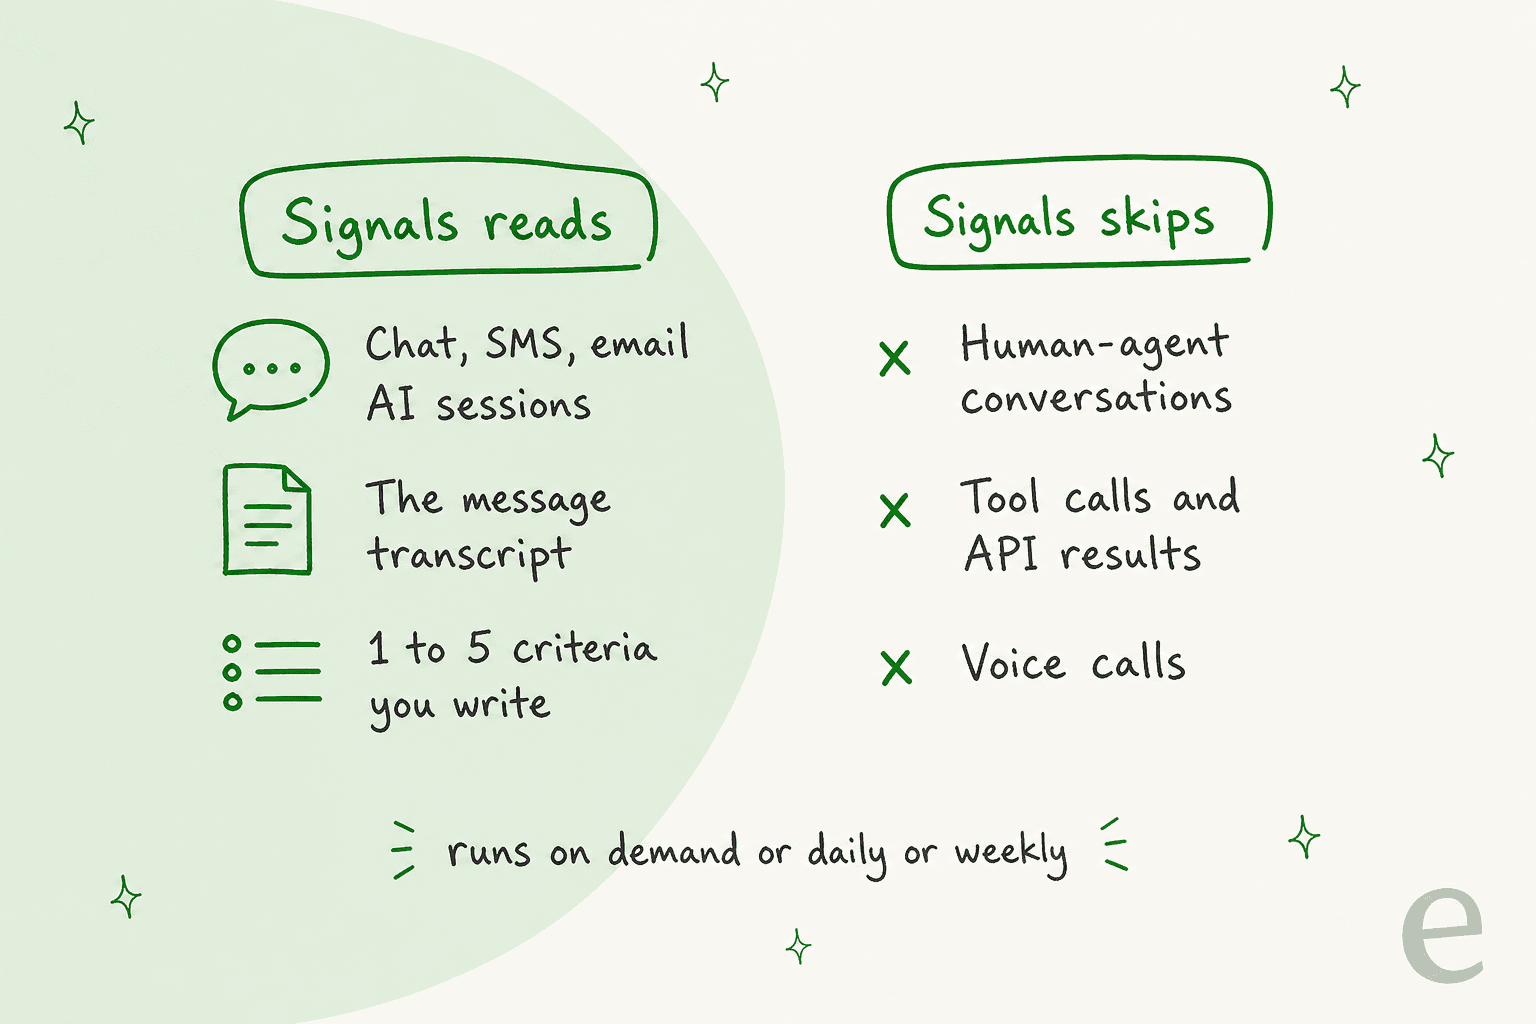
Dois limites importam mais para uma líder de QA. Primeiro, as boas práticas do Signals dizem que ele "only reads the Conversation transcript", então não consegue ver chamadas de ferramentas nem respostas de API, e "conversations led by human Agents aren't included yet". O próprio exemplo da Gladly: você não pode perguntar se a IA realizou com sucesso um cancelamento, apenas se ela disse ao cliente que o pedido foi cancelado. Segundo, é uma ferramenta de tendências. A Gladly diz que ele "not a replacement for human review".
Quem pontua agentes humanos na Gladly?
Um parceiro faz isso. A lista de integrações da Gladly inclui MaestroQA e Calabrio, ambos construídos e mantidos pelo parceiro, não pela Gladly.
- MaestroQA se descreve como uma plataforma para entender "support quality beyond CSAT", onde avaliadores veem e-mails e escutam chamadas. Segundo o kit de integração da Gladly, ele faz requisições somente leitura, então "no data comes to Gladly from MaestroQA". Ele traz todas as conversas e depois usa regras para restringir o que os avaliadores veem. Os canais são e-mail, voz e todos os canais de mensagens, e a configuração exige um token de API de um usuário dedicado da Gladly.
- Calabrio permite levar os dados de desempenho por agente da Gladly para programas de coaching e QA, com a Calabrio Professional Services cuidando da implementação.
Se você permanecer dentro da Gladly, também há uma via manual. Admins, Team Managers e usuários Agent Plus podem escutar, treinar ou entrar em chamadas telefônicas em tempo real, e as gravações ficam disponíveis para práticas de QA. Uma QA Analyst no Capterra descreve essa via assim:
"It's great that the call is always recorded and that we can stop the recording when we need it. It helps us to keep track of every call very easy. Not only that, but it has the option to listen other call to monitoring in case is needed."

A profundidade de relatórios é onde alguns avaliadores querem mais. Outro avaliador no Capterra escreve:
"While this platform performs flawlessly at organizing customer communications and straightening out all chat content, its built-in data reporting function is far from sufficient to meet our marketing team’s needs."
Esse avaliador está falando de análise de marketing, não de QA, então eu não estenderia demais essa leitura. Mas ela combina com o padrão: o relatório da Gladly é amplo, e sua pontuação de sentimento e qualidade de conversas humanas vive em outro lugar. Minhas notas sobre análise de sentimento com IA da Gladly cobrem a outra metade.
Qual ferramenta da Gladly cobre qual check?
Use isto para organizar suas próprias perguntas de QA. Toque em uma para ver o que a cobre.
Toque em cada check para ver qual ferramenta da Gladly, se houver alguma, o cobre.
Qual plano da Gladly inclui QA, e quanto custa?
Não consegui confirmar nenhuma das duas coisas nas próprias páginas da Gladly. A documentação descreve os quality checks, o registro de Reviews e o Signals sem nomear um plano, embora o Signals diga estar disponível "for any organization using Gladly AI". O Simulator está em Early Access por solicitação. A Gladly não publica preços de plataforma em sua página de preços, então o número vem de uma ligação de vendas. Meu guia de preços da Gladly cobre o pouco que é público.
Pergunte quatro coisas à sua equipe de conta antes de planejar algo em torno disso:
- O Signals está no meu contrato, e como suas execuções são cobradas se eu elevar a taxa de amostragem para perto de 100%?
- Os quality checks estão ativos por padrão em cada Guide, e posso ver a taxa de handoff que eles causam?
- Qual ferramenta de QA de parceiro outros clientes da Gladly usam nos meus canais, e o que esse contrato adiciona?
- Quando o Signals vai ler conversas conduzidas por agentes humanos?
MaestroQA e Calabrio precificam seus próprios produtos, e eu não precifiquei nenhum dos dois, então não vou arriscar um número.
Como cobrir as lacunas no QA da Gladly?
Comece pelo que a Gladly já faz bem, e depois adicione uma trilha para agentes humanos. Esta é a rotina que eu seguiria, com cerca de 30 minutos para configurar:
- Mantenha os quality checks padrão ativados. Desative apenas os que a própria Gladly recomenda remover em um Guide baseado apenas em conhecimento, e observe sua taxa de handoff depois.
- Escreva três Signals binários. Escolha perguntas de sim ou não ligadas às suas políticas, execute cada uma em menos de 50 sessões, e depois amplie. Comece com "disse ao cliente que uma ação foi feita" e "informou uma data ou política".
- Revise toda sessão marcada ou com pontuação baixa. Use a taxa de concordância para encontrar critérios que precisam ser ajustados. Minha rotina de revisão de conversas de IA mostra o que procurar.
- Coloque um scorecard nas conversas humanas. Use uma ferramenta de parceiro, ou uma equipe calibrada de revisores. Calibração de QA de suporte e critérios de scorecard de QA ajudam você a começar.
- Devolva os erros encontrados. A nota de um revisor só é útil se alguém editar o Guide ou a política. Exemplos de feedback de QA mantêm as notas concretas.
Adicione o CSAT como um segundo sinal de onde olhar primeiro, e um registro de escalonamento para as conversas que precisaram de uma pessoa de qualquer forma.
Onde o eesel se encaixa no QA da Gladly?
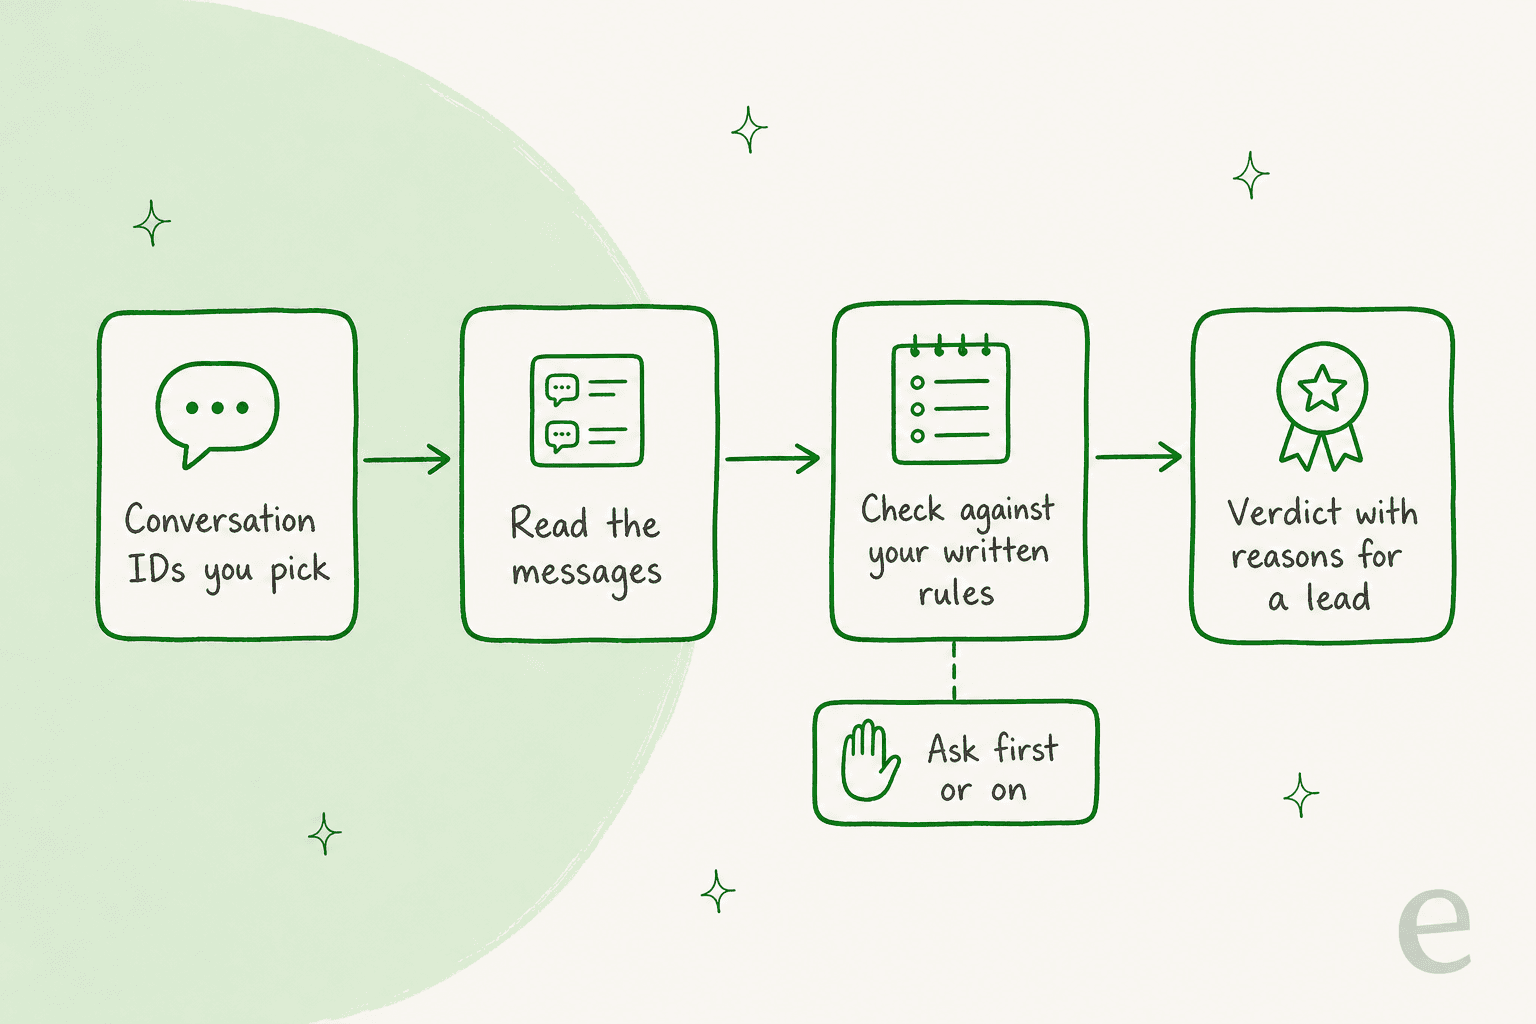
O eesel não tem uma conexão embutida com a Gladly, então aqui está o que posso e não posso dizer. O eesel é uma plataforma de colegas de equipe com IA, e o que importa aqui é o colega de equipe de helpdesk com IA. Para QA, eu penso nele como um revisor que lê as conversas que você entrega a ele e as verifica contra regras que você escreve em palavras simples.
A Gladly tem uma API REST, e o eesel tem uma página Your APIs onde você autoriza um domínio e adiciona um cabeçalho de autenticação. Autenticação básica é suportada, as credenciais ficam nas configurações, e a IA nunca as vê. A própria documentação da Gladly diz que um usuário de API cria um token de API, que é mostrado uma única vez e está vinculado a um usuário e a um ambiente, e que o MaestroQA lê conversas pelos endpoints /conversations e /conversation-items. Então trazer uma conversa para revisão parece possível. Eu não testei o eesel contra a API da Gladly, então trate isso como uma rota a confirmar em uma demo, não como um recurso já entregue.
Se isso funcionar, você daria a ele IDs de conversa, e ele leria as mensagens, as verificaria contra sua política e sua base de conhecimento, e relataria os motivos a um líder. Nas ações e aprovações do eesel, cada ação pode rodar por conta própria, perguntar antes ou ficar desativada, o que mantém um humano no loop.
A mesma forma já funciona para clientes do eesel. A Cactus Club Cafe opera dois agentes no Zendesk. A Tixie lê o ticket inteiro, abre a política de emergência e a matriz de roteamento antes de qualquer outra coisa, e segue o runbook correspondente sem passos improvisados. Cerca de 790 de suas respostas em um mês foram rascunhos para a equipe enviar, contra 51 enviadas diretamente. Um segundo agente audita o extrato financeiro diário, verifica cada loja e o total, e então resolve o ticket como equilibrado ou o deixa aberto com a diferença indicada. Uma revisão de QA também é uma verificação contra regras escritas.
Para os outros helpdesks, veja meus guias de Dixa, Freshchat, Gorgias, Kustomer e Zoho Desk.
O QA da Gladly é suficiente?
Para a IA, sim, e os quality checks antes do envio são a parte que eu avalio mais alto. Eles impedem uma resposta com uma data sem respaldo ou uma ação prometida que nunca aconteceu, e explicam o motivo. Para pessoas, não: você precisa de um parceiro ou de um revisor humano, e deveria perguntar quando o Signals vai cobrir conversas conduzidas por agentes.
Minha opinião: se você usa a Gladly AI, mantenha os quality checks ativados, use o Signals para as tendências que você conseguir nomear em uma pergunta de sim ou não, e pontue seus humanos no MaestroQA ou Calabrio. Lembre-se do que significa um check aprovado. Significa que a resposta foi respaldada pelo contexto, não que a política estava certa. Para verificações mais profundas entre ferramentas, veja meu panorama de IA para QA de suporte e minhas notas sobre observabilidade de agente de suporte com IA e permissões. Para o resto da IA da Gladly, leia resumos com IA da Gladly, respostas de rascunho, roteamento, tradução e deflection. Está avaliando uma troca? Veja as melhores alternativas à Gladly, a melhor IA para Gladly e Kustomer vs Gladly.
Testar o eesel como seu revisor de políticas
Se o check que está faltando para você é "isso estava certo segundo nossa política?", o eesel é o revisor que eu testaria a seguir, ao lado das próprias ferramentas da Gladly. Ele lê as conversas que você entrega a ele, as verifica contra as regras que você escreve e sua central de ajuda, e diz por que elas passaram ou falharam. Se você usa Zendesk, Freshdesk ou Gorgias, ele se conecta diretamente. Se você usa Gladly, pergunte primeiro sobre a rota de API. Comece com dez conversas que sua equipe já pontuou, e veja se o eesel concorda. O guia de QA de call center cobre voz.

Teste o eesel gratuitamente, ou agende uma demo para perguntar como ele revisaria suas conversas da Gladly.