

O Re:amaze não tem um scorecard de garantia de qualidade com IA: não encontrei nada em sua central de ajuda, página de preços ou novidades de produto que pontue uma conversa segundo critérios de QA, e o que mais se aproxima é a lista de respostas recentes no Individual Staff Report do Plus (69 $ por membro da equipe ao mês). O que ele oferece a um líder de suporte são relatórios de velocidade e de com que frequência uma resposta resolveu o problema (todos os planos), relatórios de equipe e pesquisas de satisfação (também Plus), e um conjunto de ferramentas para conferir as respostas do seu próprio Agente de IA. Nenhum deles confere se uma resposta estava certa segundo sua política ou se foi marcada com a tag certa, e o Success Rate do relatório de IA conta requisições de API bem-sucedidas, não respostas certas. Para conferir isso, um líder pode pontuar à mão uma amostra semanal, ou uma colega de IA como o eesel pode revisar conversas arquivadas recentemente conforme uma programação, contra regras que você escreve, e deixar seus motivos em uma nota interna. Um agente de código como o Claude Code pode configurar essa revisão pelo CLI do eesel, ainda que alguém precise copiar o token de API do Re:amaze para conectar.
O Re:amaze tem garantia de qualidade com IA?
Não com esse nome, e não como scorecard. Trabalho na equipe de suporte do eesel, então ao ler os recursos de QA de um helpdesk eu me faço uma única pergunta: isso pegaria uma resposta errada antes de um cliente pegar? No Re:amaze, a resposta honesta é "só depois que um cliente reclama". (Para o resto do produto, veja minha análise do Re:amaze.)
Aqui está o que o Re:amaze oferece para garantia de qualidade, segundo seu resumo de relatórios, seu guia de ferramentas de IA e sua página de preços, verificados em 22 de novembro de 2026:
| Recurso do Re:amaze | Plano | O que diz a um líder de QA | O que não diz |
|---|---|---|---|
| Response Time, First Response Resolve Rate, Average Thread Size | Basic | Quão rápido as respostas saíram e com que frequência uma resposta resolveu o caso | Se a resposta estava certa |
| Relatórios de Appreciations, Tags e Satisfaction Ratings | Pro, segundo o resumo de relatórios | Quais respostas os clientes gostaram, quais tags são usadas, o que os clientes avaliaram | Qual tag deveria ter sido usada |
| Staff Summary e Individual Staff Reports, pesquisas de satisfação | Plus | As respostas, tempos de resposta, avaliações e respostas recentes de cada agente | Se essas respostas seguiram seu processo |
| Fontes do Agente de IA, correções, testes e Learned Answers | Com o Agente de IA | De onde veio uma resposta de IA, e um lugar para corrigi-la | Como os agentes humanos estão se saindo |
| Ask About This Conversation | Ferramentas de IA | Uma resposta a uma pergunta que você digita sobre um thread | Qualquer coisa que abranja muitas conversas |
O que os relatórios do Re:amaze dizem sobre qualidade?
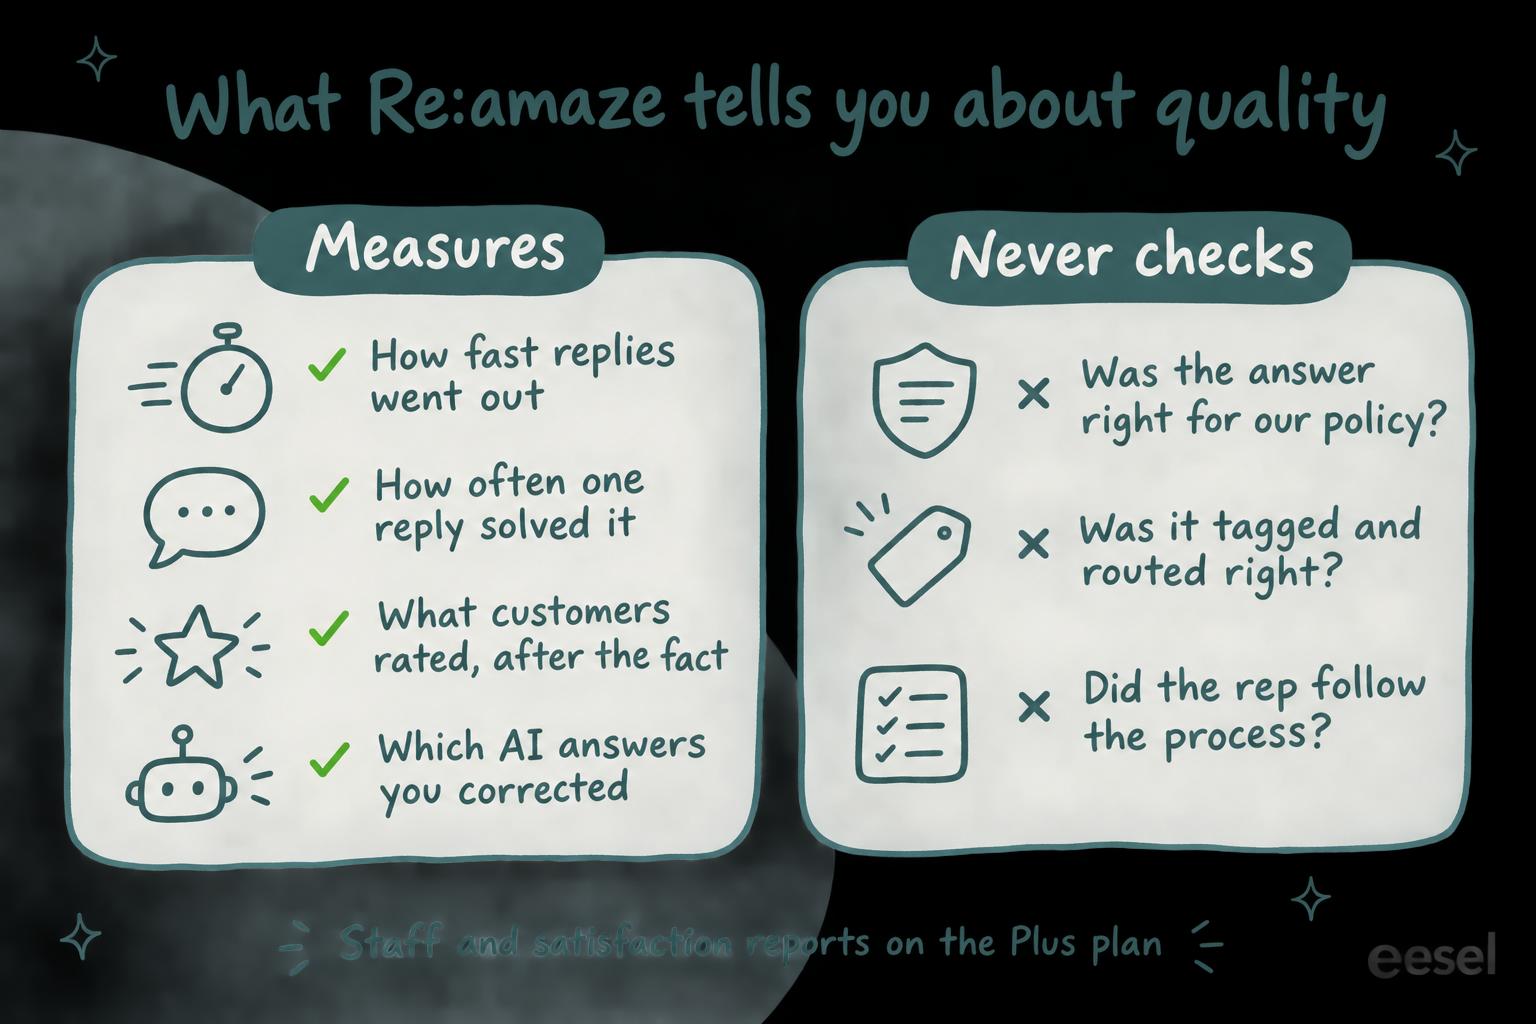
Dizem muito sobre velocidade e pouco sobre o resultado. Todos os planos têm o relatório Response Time (o verbete de glossário first response time explica a métrica pela qual a maioria das equipes começa) e o First Response Resolve Rate, que o Re:amaze descreve como "uma métrica de qualidade que reflete a eficácia das respostas da sua equipe": com que frequência uma resposta resolveu o problema do cliente, perto do que a maioria das equipes chama de first contact resolution. O relatório Average Thread Size é seu parceiro, e o próprio guia do Re:amaze diz que um número alto "pode indicar que um problema é difícil de resolver ou que os agentes não estão dando respostas suficientemente completas."
No Plus, o Individual Staff Report detalha isso por agente: respostas, tempo médio de resposta, appreciations, conversas resolvidas ou arquivadas, tamanho médio de thread e, se você envia pesquisas, a avaliação média do agente. Você pode comparar um agente com a média da equipe ou de um departamento. No final está "uma lista contínua de suas respostas recentes", que segundo o Re:amaze os gestores podem usar "para monitorar a qualidade do suporte no nível individual."
Essa última linha é o mais perto que o Re:amaze chega de QA. Ela dá a você uma lista de leitura; alguém ainda precisa abrir cada resposta e julgá-la.
Duas coisas para saber antes de confiar nos números:
- As conversas são datadas por quando começaram. O Re:amaze atribui as métricas de conversa "ao momento em que a conversa foi criada", então uma conversa aberta em 9 de dezembro e reaberta e arquivada em 11 de dezembro conta uma vez, em 9 de dezembro. Os números da semana passada podem mudar depois que a semana termina.
- As respostas são contadas por mensagem. O Re:amaze diz que a contagem de Response "é um indicador melhor de atividade" do que as contagens de Resolved e Archived.
O que as pesquisas de satisfação do Re:amaze acrescentam?
O veredito do próprio cliente, tarde. As pesquisas de satisfação automatizadas estão no Plus: em Settings, depois Email Channels, ative Satisfaction Surveys, escolha um atraso em horas e quais estados de conversa disparam uma pesquisa (escolher Resolved envia uma só depois que a conversa é resolvida). A pesquisa pode usar carinhas, rótulos descritivos ou 1 a 5 estrelas, e o relatório Satisfaction Ratings mostra a média, a faixa de Abysmal a Great, e os comentários mais recentes.
Há uma particularidade de plano. A página de preços e o guia de pesquisas colocam as avaliações de satisfação no Plus, mas o resumo de relatórios lista o relatório Satisfaction Ratings no Pro. Se você está no Pro, confirme com o Re:amaze antes de planejar em torno disso.
Uma avaliação diz como o cliente se sentiu sobre o resultado. Ela não diz qual resposta causou isso, e só vem dos clientes que respondem. Uma pontuação baixa diz por onde começar a ler. Minhas notas sobre CSAT com IA vão mais a fundo em ler o CSAT ao lado do QA.
Como você confere as respostas do Agente de IA do Re:amaze?
É aqui que o Re:amaze fez mais trabalho. Em junho de 2026, ele lançou um conjunto de ferramentas para conferir o que seu Agente de IA diz:
- Sources em cada resposta. Uma contagem de fontes aparece em cada resposta de IA; clique para ver quais fontes de conhecimento ela usou, "uma forma rápida de perceber se a IA se apoiou em algo desatualizado ou pegou informação do lugar errado."
- Improve Response. Envie uma correção em qualquer resposta de IA, e ela é guardada para a IA usar na próxima vez. O Re:amaze diz que as correções são mantidas em um único lugar onde você pode editá-las ou excluí-las, e as configurações de IA têm uma aba AI Agent Corrections.
- Test AI Agent. Faça a ele as perguntas que os clientes fazem e leia as respostas completas antes de um cliente fazer isso. O Re:amaze sugere voltar a isso sempre que você mudar um artigo, um modelo ou uma Learned Answer.
- Learned Answers. Quando o Agente de IA escala e uma pessoa termina a conversa, o Re:amaze redige uma resposta a partir do que aconteceu e a coloca em fila para revisão. Nada é adicionado até você salvar, e sugestões não salvas expiram depois de 14 dias.
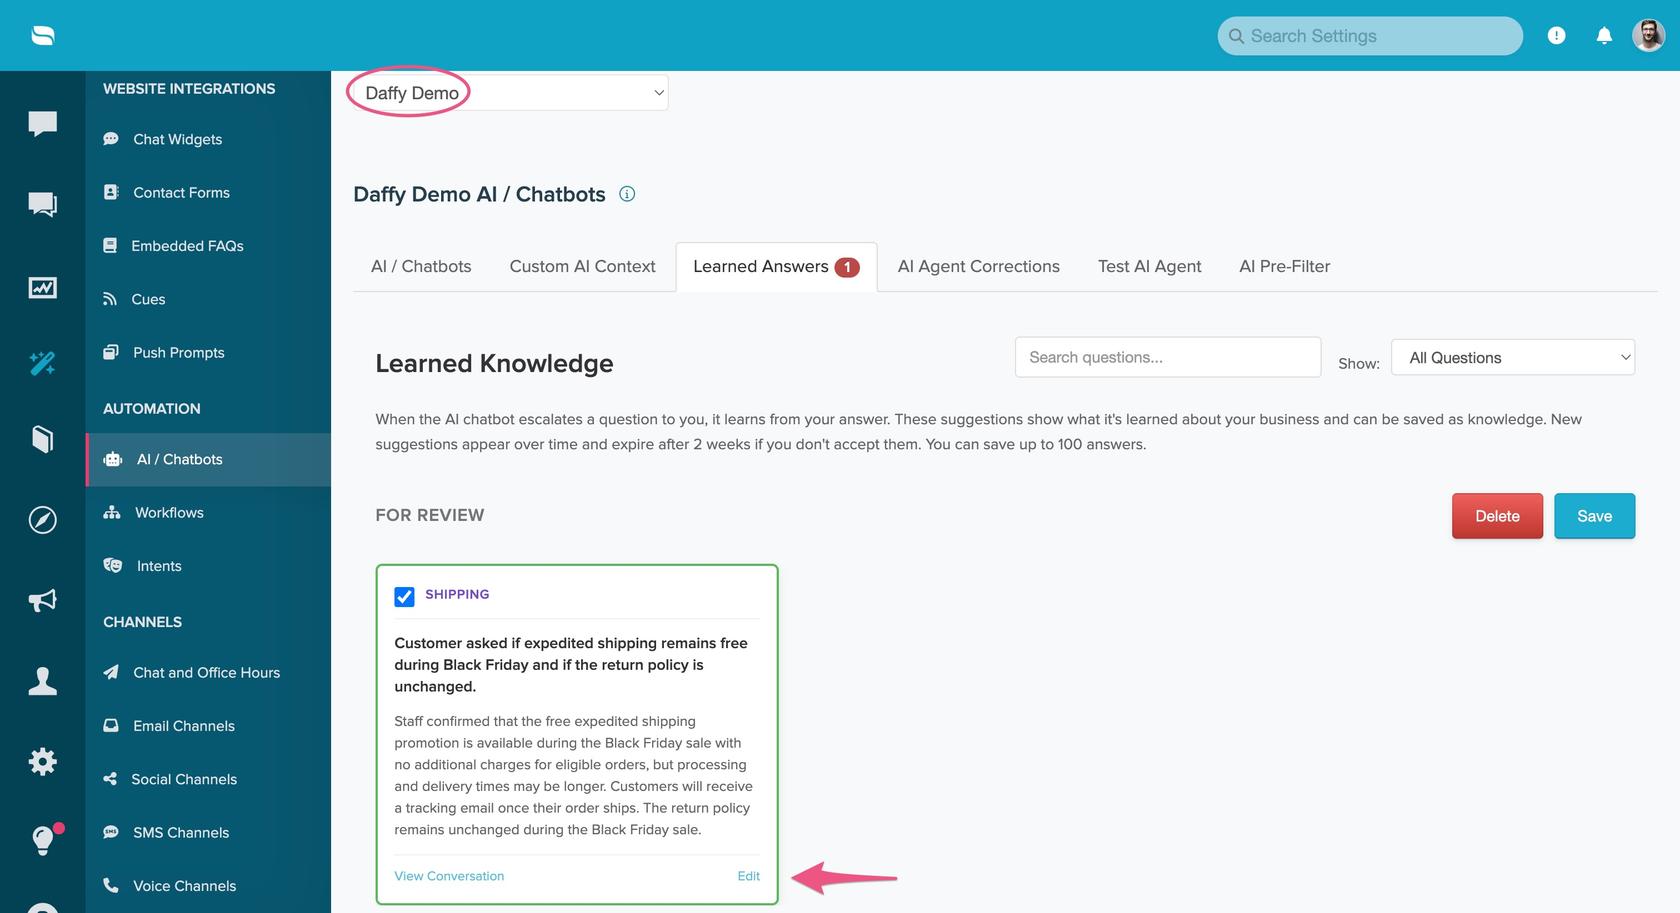
São boas ferramentas para manter o Agente de IA honesto, e eu usaria todas. Mas note o que elas têm em comum: uma pessoa encontra primeiro a resposta ruim. Nada pontua as conversas do Agente de IA por você.
Observe também os relatórios de IA. O AI Productivity Report tem um Success Rate, que "mede o número de requisições de API de IA bem-sucedidas", e um Content Score, uma lista de configuração (+20% por criar 20 artigos de FAQ, +20% por configurar o Custom AI Context). Um Success Rate de 100% significa que a IA rodou todas as vezes, não que ela acertou todas as vezes.
O que o Re:amaze não consegue conferir?
As três coisas para as quais existem a maioria dos programas de QA:
- A resposta estava certa segundo nossa política? Nenhum relatório ou ferramenta de IA compara uma resposta com suas regras de reembolso, envio ou garantia. Ask About This Conversation responde a uma pergunta que você digita sobre um thread, mas isso é uma conversa por vez, à mão.
- Foi marcada com a tag e roteada certas? AI Pre-Filter e Workflows aplicam tags às conversas, e o relatório de Tags conta quais tags são mais usadas, mas nada as confere depois. Nenhum diz que uma solicitação de reembolso saiu com a tag de envio, e se seus relatórios dependem de tags, esse erro se espalha por todos os gráficos.
- O agente seguiu o processo? Pediu o número do pedido, ofereceu a etiqueta de devolução, escalou uma ameaça de chargeback: nada disso é pontuado.
Se em vez disso você considerar uma ferramenta de QA dedicada, confira se ela se conecta ao Re:amaze antes de comprar.
Quanto custa o Re:amaze para QA?
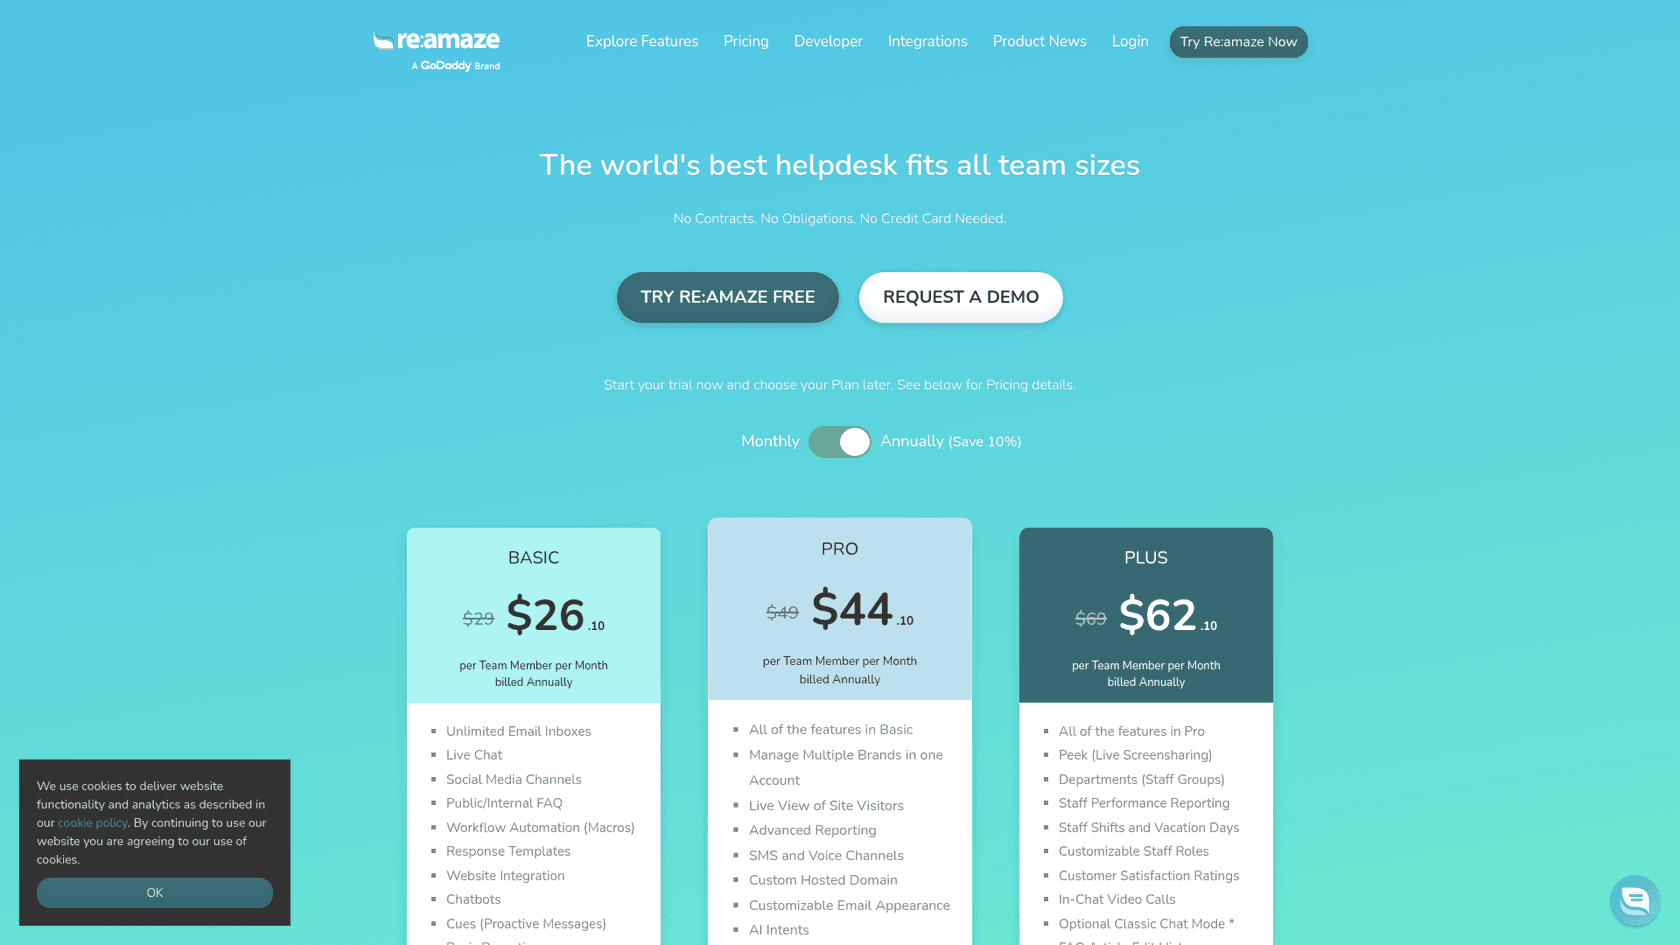
Os relatórios e pesquisas relevantes para QA vêm com o plano, então o custo é o salto para o Plus. Preços da página de preços, verificados em 22 de novembro de 2026:
| Plano | Por membro da equipe ao mês | Cobrança anual | O que ele adiciona para QA |
|---|---|---|---|
| Basic | 29 $ | 26,10 $ | Response Time, First Response Resolve Rate, Average Thread Size; Agente de IA com 5 resoluções por usuário ao mês |
| Pro | 49 $ | 44,10 $ | Advanced Reporting (Tags, Appreciations, Workflow); 10 resoluções de Agente de IA por usuário |
| Plus | 69 $ | 62,10 $ | Staff Performance Reporting, Customer Satisfaction Ratings; 20 resoluções de Agente de IA por usuário |
| Starter | 59 $ fixos ao mês | Não informado | Os recursos do Basic para membros de equipe ilimitados, até 500 conversas respondidas ao mês |
Resoluções extras do Agente de IA custam 0,85 $ cada. Para uma equipe de 10 pagando mensalmente, o Pro custa 490 $ e o Plus 690 $, então os relatórios e pesquisas por agente chegam com um salto de 200 $ ao mês. Meu detalhamento de preços do Re:amaze e meu guia de custos do Re:amaze trazem outros tamanhos de equipe.
Como você cobre o que o Re:amaze deixa de fora?
Escolha o que você quer conferir e veja o que cobre isso:
Escolha uma conferência para ver o que cobre isso no Re:amaze, e o que cobre isso se nada cobrir.
Há duas formas de cobrir o resto.
Pontuar uma amostra à mão
A rota mais barata não precisa de nada novo, e é onde a maioria dos guias de QA de suporte com IA começa. Toda semana, um líder toma dez ou vinte conversas arquivadas recentemente (primeiro as threads mais longas e as avaliações mais baixas, se houver), lê cada uma e a pontua contra uma rubrica curta em uma planilha: resposta certa para a política, tag certa, processo seguido. No Plus, a lista de respostas recentes em cada Individual Staff Report é uma lista de leitura pronta. Combine primeiro o que cada pontuação significa para que dois revisores pontuem a mesma conversa do mesmo jeito: a calibração de QA de suporte ajuda, e esses exemplos de feedback de QA também.
O limite é o óbvio: uma pessoa lê uma amostra, e os resultados ficam fora do Re:amaze.
Ter uma colega de IA revisando com suas regras
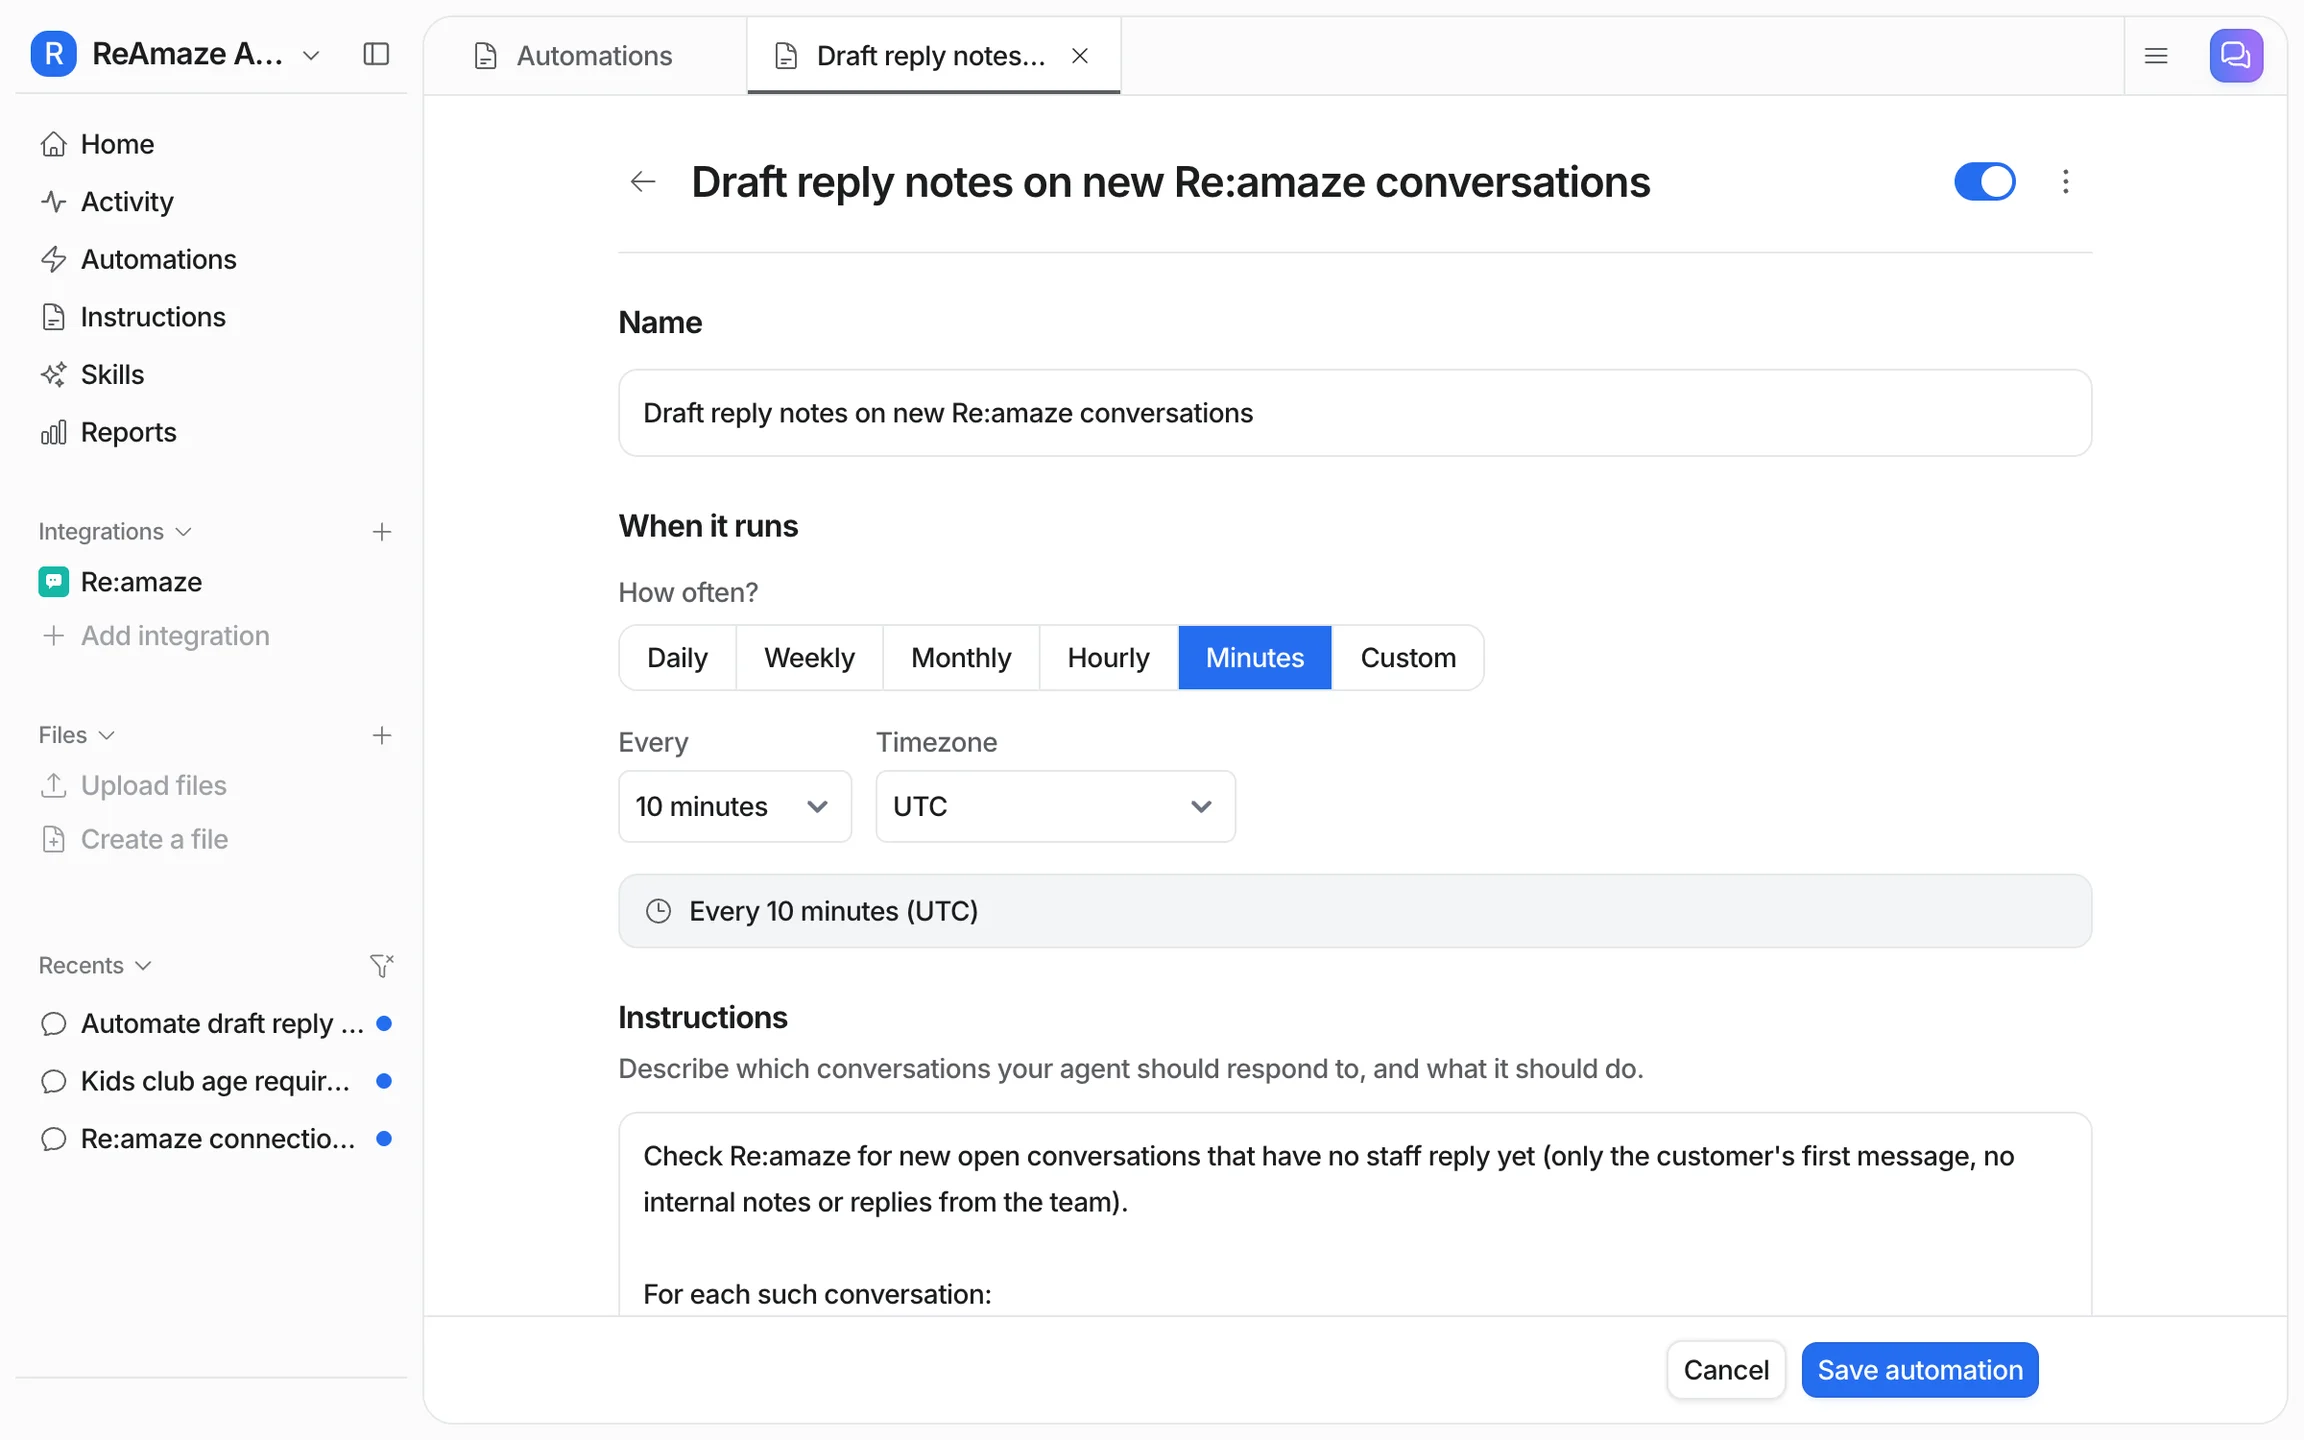
A segunda rota é um agente de IA que executa a revisão por conta própria e deixa o resultado no Re:amaze. É isso que eu faria com o eesel. A integração com o Re:amaze do eesel roda conforme uma programação, tão frequente quanto a cada dez minutos, ou de hora em hora, diária ou semanalmente, e pode listar conversas arquivadas e filtrá-las por tag. Para cada uma, ela lê as 40 mensagens mais recentes com seus autores, notas internas incluídas, além das tags, status e responsável da conversa. Ela aprende com antecedência a partir dos seus modelos de resposta e conversas passadas, e lê os artigos da sua central de ajuda ao vivo, então uma política que você publicou é algo que ela já leu.
Defina uma programação diária e, em cada execução, ela pega as conversas arquivadas modificadas mais recentemente e:
- Lê o thread com suas tags.
- Confere contra as regras que você escreveu em palavras simples ("reembolsos depois de 30 dias precisam da aprovação de um líder", "perguntas de cobrança recebem a tag de cobrança", "nunca prometer uma data de envio").
- Deixa seu veredito e seus motivos como uma nota interna.
- Adiciona uma tag como qa-review às que um líder deveria ler, para que um líder possa filtrá-las.
Você escreve as regras, então as conferências de marcação, processo e política são só mais linhas, alteradas sempre que suas políticas mudam. Conheça os limites primeiro: ele não vê anexos nem campos personalizados, e em um thread com mais de 40 mensagens só lê as 40 mais recentes. Ele roda conforme uma programação em vez do momento em que uma conversa fecha, porque o Re:amaze não tem gatilhos de evento no eesel. O mesmo agente eesel também pode redigir respostas como notas internas, se você quiser.
Conferências diárias como essa já rodam para clientes do eesel. A Cactus Club Cafe roda um segundo agente eesel no seu helpdesk Zendesk que auditoria o extrato financeiro diário toda manhã: ele confere cada loja e resolve o ticket como equilibrado ou o deixa aberto com a diferença nomeada. Entre 8 de agosto e 8 de setembro de 2026, ele rodou cerca de 60 vezes. Uma revisão de QA tem a mesma forma: uma conferência contra regras escritas, com o resultado deixado na conversa.
O Re:amaze é suficiente para QA?
Para velocidade e resultado, sim. First Response Resolve Rate e Average Thread Size são sinais honestos que a maioria das equipes pequenas subutiliza, e no Plus o relatório por agente com avaliações e respostas recentes dá a um líder uma lista de leitura semanal sensata. As ferramentas do Agente de IA são melhores que a maioria: fontes em cada resposta, correções guardadas e um ambiente de teste são exatamente o que você precisa para impedir que um agente de IA se desvie.
Minha opinião: comece com os relatórios que você já tem. Observe o First Response Resolve Rate e o Average Thread Size em cada Individual Staff Report, leia as threads mais longas toda semana, e use o Test AI Agent sempre que mudar um artigo. Não confunda o Success Rate do relatório de IA com acerto. E se a pergunta de QA da sua equipe é "foi certo?", não "foi rápido?", o Re:amaze deixa isso com você: uma amostra pontuada à mão se seu volume é pequeno, um revisor de IA se não for. As respostas de outros helpdesks para a mesma pergunta estão nos meus artigos sobre garantia de qualidade com IA no Gorgias, garantia de qualidade com IA no Help Scout e garantia de qualidade com IA no Front, e meu resumo de ferramentas de IA para QA de suporte compara opções dedicadas.
Experimente o eesel como seu revisor de QA no Re:amaze
Se a conferência que falta é "essa resposta estava certa segundo nossa política?", o eesel é o revisor que eu adicionaria ao Re:amaze. Ele se conecta com um token de API, lê sua central de ajuda e conversas passadas, e conforme uma programação diária confere cada conversa arquivada recentemente contra as regras que você escreve, deixando seus motivos em uma nota interna e marcando com tag as que valem o tempo de um líder. Comece pedindo a ele no chat do painel para revisar suas conversas arquivadas mais recentes, leia o que ele sinaliza, e só então ative a programação.
Experimente o eesel de graça, ou agende uma demonstração para ver como ele revisa suas próprias conversas do Re:amaze.