

A garantia de qualidade com IA do Front é o Smart QA: no plano Enterprise (105 $ por assento ao mês, cobrado anualmente), a IA do Front pontua cada conversa resolvida ou arquivada nas caixas compartilhadas que você escolher, segundo um scorecard que você monta com 15 critérios padrão e seus próprios critérios personalizados. As notas aparecem em um painel lateral e em um relatório do Smart QA, e um admin pode substituir qualquer uma delas. Ele faz mais do que checar o tom, com duas ressalvas. Os critérios leem apenas as mensagens da conversa, então o Front diz que tags, horários e roteamento não podem ser pontuados, e ele passou para um modelo mais rigoroso em 20 de novembro de 2026, então as médias caem a partir dessa data sem que sua equipe tenha piorado. Para verificar o que o Smart QA não consegue (a tag certa, a caixa certa, a política da sua central de ajuda), um líder pode ler uma amostra semanal, ou um colega de equipe de IA como o eesel pode revisar cada conversa arquivada segundo regras que você escreve e deixar seus motivos em um comentário interno. Um agente de código como o Claude Code pode configurar essa revisão pelo CLI do eesel, ainda que alguém autorizado a aprovar apps no Front precise aprovar a conexão mesmo assim.
O Front tem garantia de qualidade com IA?
Sim. O Front chama isso de Smart QA, e o discurso da sua página de produto é que "alguém precisa revisar cada ticket", mas não precisa ser você. Eu construo as integrações do eesel, então leio um recurso como esse pelo que ele realmente lê e escreve, não pelo que a página de produto diz.
O Smart QA não é o único sinal de garantia de qualidade do Front. Veja o que um líder de suporte obtém, segundo a própria documentação do Front e sua página de preços:
| Recurso do Front | Plano | O que mostra a um líder de QA | O que não mostra |
|---|---|---|---|
| Smart QA | Enterprise | Como cada colega de equipe e agente de IA pontuou segundo seus critérios, com motivos e trechos citados | Nada sobre tags, horários ou roteamento |
| Smart CSAT | Enterprise | O quão satisfeito o cliente provavelmente ficou, a partir do sentimento, esforço e resolução | Qual parte foi mérito do atendente |
| Simulações do Compass | Com um agente Autopilot | Se o agente de IA passa nos seus critérios em conversas reais passadas antes de entrar em produção | Como os colegas de equipe humanos estão se saindo |
| AI Topics | Todos os planos | Por que os clientes escrevem | Se receberam uma boa resposta |
Como funciona o Front Smart QA?
A IA do Front lê cada conversa assim que ela é resolvida ou arquivada, pontua cada colega de equipe que respondeu segundo os critérios do seu scorecard, e escreve um motivo curto para cada nota. A configuração tem duas partes:
- Um scorecard. Nas configurações da empresa, abra Front AI, depois a aba Smart QA, e clique em Create scorecard. Marque os critérios padrão que quiser, adicione personalizados, e edite como qualquer um deles é pontuado. Você pode manter vários scorecards.
- Uma regra. Em Rules and macros de um workspace, crie uma regra a partir do modelo Review conversations with Smart QA. Ele pergunta quais tipos de conversa, quais caixas compartilhadas, quais respostas de colegas de equipe, quanto tempo esperar depois que uma conversa é arquivada ou resolvida, e qual scorecard usar.
Os 15 critérios padrão se dividem em três grupos. Communication inclui Brevity, Empathy, Friendliness, Grammar and spelling, Greeting offered, Information gathering, Personalization, Professionalism, Readability e Tone. Solution inclui Comprehension e Solution offered. Proactivity inclui Adaptability, Demo offered e Upsell. Alguns só se aplicam quando o momento surge (Upsell, quando "surge uma oportunidade clara de upsell/cross-sell"); caso contrário, o critério mostra N/A e não conta.
Cada critério é pontuado em uma escala de 1 a 5 ou de forma binária com aprovado e reprovado. As escalas se tornam porcentagens (um 1 é 0%, um 4 é 75%), e o relatório calcula a média, então um colega de equipe com um 1 e um 4 em Tone mostra 38%.
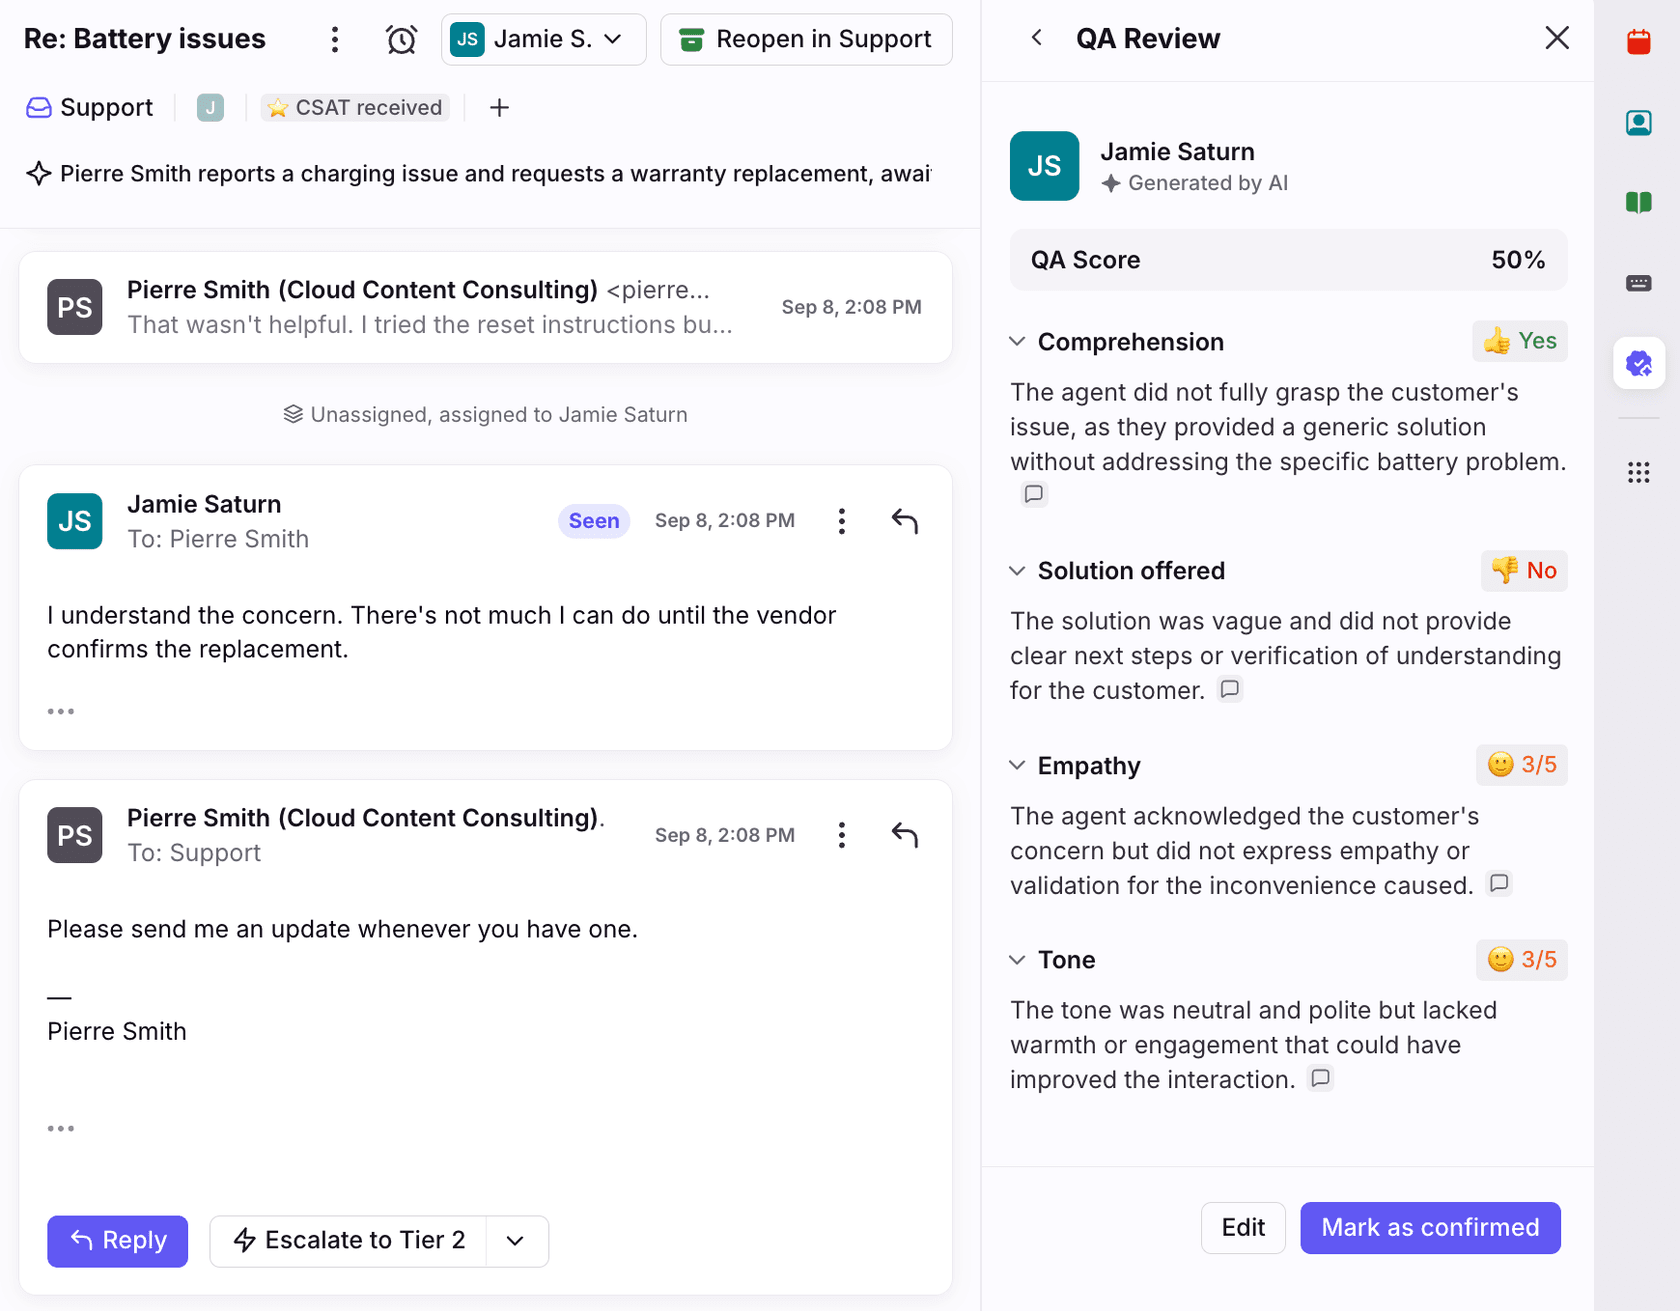
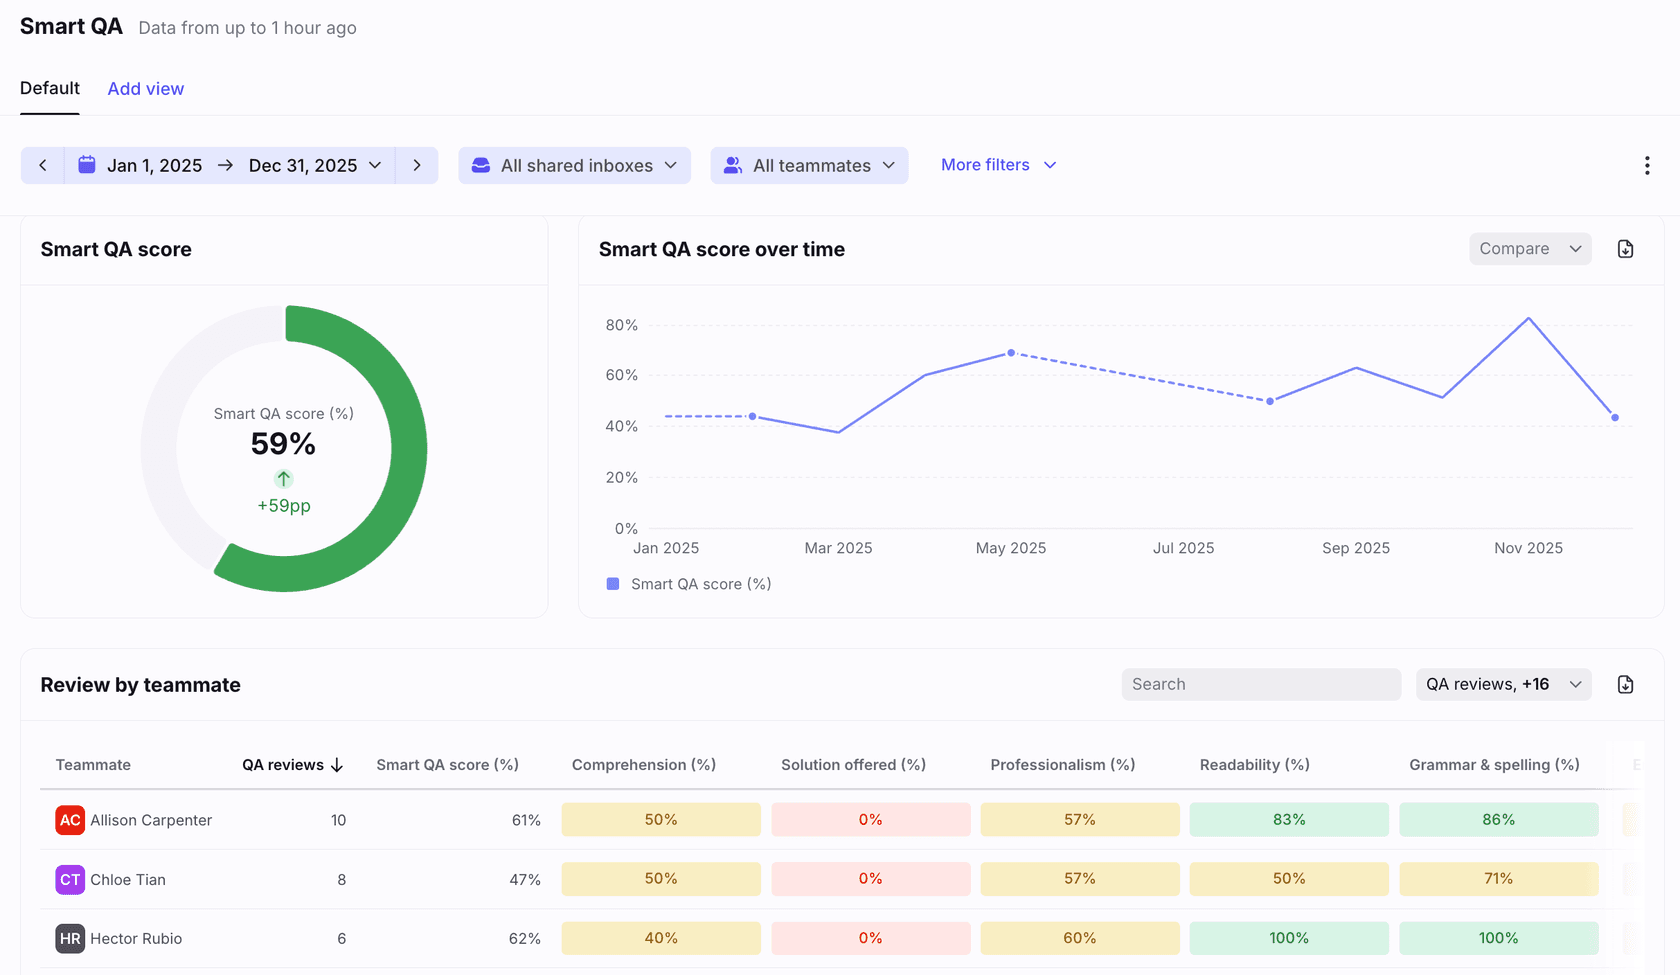
Os resultados aparecem em dois lugares, ao lado do Smart CSAT se você o usar. O painel Smart QA and CSAT na barra lateral da conversa mostra a revisão, e para conversas pontuadas depois de 6 de setembro de 2026, cada motivo cita até três trechos que você pode clicar para ir direto. O relatório Smart QA em Analytics calcula a média de cada critério por colega de equipe, ordena as conversas por nota e exporta para um arquivo.
As regras que vale a pena conhecer antes de confiar nos números:
- Admins podem substituir. Edite uma nota no painel ou no relatório, adicione um comentário, e clique em Save & mark as reviewed. O nome do admin substitui "Generated by AI", e o relatório se atualiza em uma hora.
- Atendentes veem só as próprias. Admins com permissões de analytics veem tudo. O Front também pede que você avise os atendentes quando o Smart QA é aplicado às conversas deles.
- Agentes de IA também são pontuados. Todo colega de equipe que responde antes de a conversa ser resolvida ou arquivada é avaliado, "tanto colegas humanos quanto agentes de IA". avaliação de agentes de IA aborda testar um agente antes de ele entrar em produção.
- O Front diz para não confiar só nisso. O artigo pede que você "confie na sua própria avaliação e análise, ou na de especialistas, para decisões importantes".
Por que as notas do Front Smart QA caíram em novembro de 2026?
Porque o Front mudou o modelo. Em 20 de novembro de 2026, o Smart QA passou para um modelo aprimorado que, segundo o Front, pontua de forma mais parecida com revisores humanos especialistas. A parte que um líder vai sentir: "Antes da atualização, cerca de dois terços das notas eram 5. Agora, cerca de 1 em 4 conversas pontua 5." O Front diz para esperar médias mais baixas e tratar a data da atualização como uma nova linha de base.
Então, se a nota do Smart QA da sua equipe caiu esta semana, não abra ainda um plano de coaching. Compare as semanas depois de 20 de novembro entre si, e se você relatar a QA para cima, marque a quebra no gráfico. Eu veria isso como boa notícia: uma escala em que dois terços das conversas tiram a nota máxima não consegue distinguir seu melhor atendente de um médio.
Como funcionam os critérios personalizados no Front Smart QA?
Você descreve a verificação em palavras simples e o Front transforma isso em uma escala. No seletor Criteria na aba Smart QA, clique em Create criteria, dê um nome e uma descrição, e a documentação do Front sugere dizer "o que o critério avalia, o que ele não avalia". Generate escreve a partir disso uma escala de 1 a 5 ou aprovado e reprovado, que você pode editar, e Applicability define se isso se aplica a toda conversa ou só às que você descrever. Um validador aponta "Too vague" ou "Not a condition", mas ainda deixa você salvar.
O próprio exemplo do Front é um critério chamado Solution accuracy:
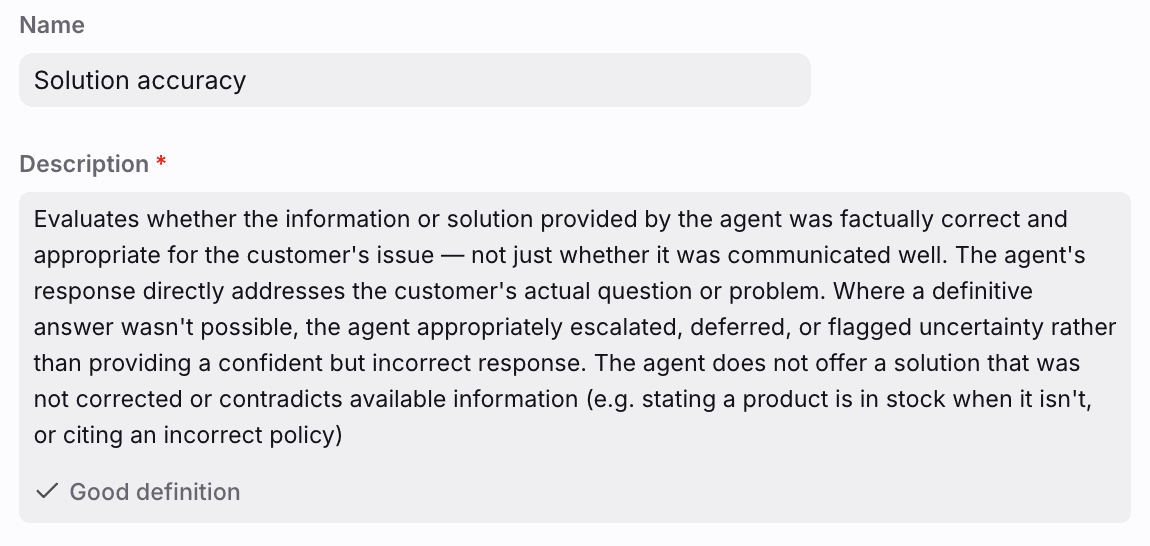
Esse é o critério que a maioria das equipes quer primeiro, e ele também mostra o limite. A descrição pergunta se a resposta contradiz "informações disponíveis (por exemplo, dizer que um produto está em estoque quando não está, ou citar uma política incorreta)". O artigo do Front diz o que um critério avalia: as respostas do colega de equipe revisado, com "todas as outras mensagens da conversa como contexto". Ele não lista sua central de ajuda, seus níveis de estoque nem seus documentos de política como entradas. Então uma verificação de política funciona quando a regra está no próprio critério ("reembolsos após 30 dias precisam da aprovação de um líder") ou na conversa, e eu testaria em algumas conversas cuja resposta você já conhece antes de confiar nela.
O que o Front Smart QA não consegue ver?
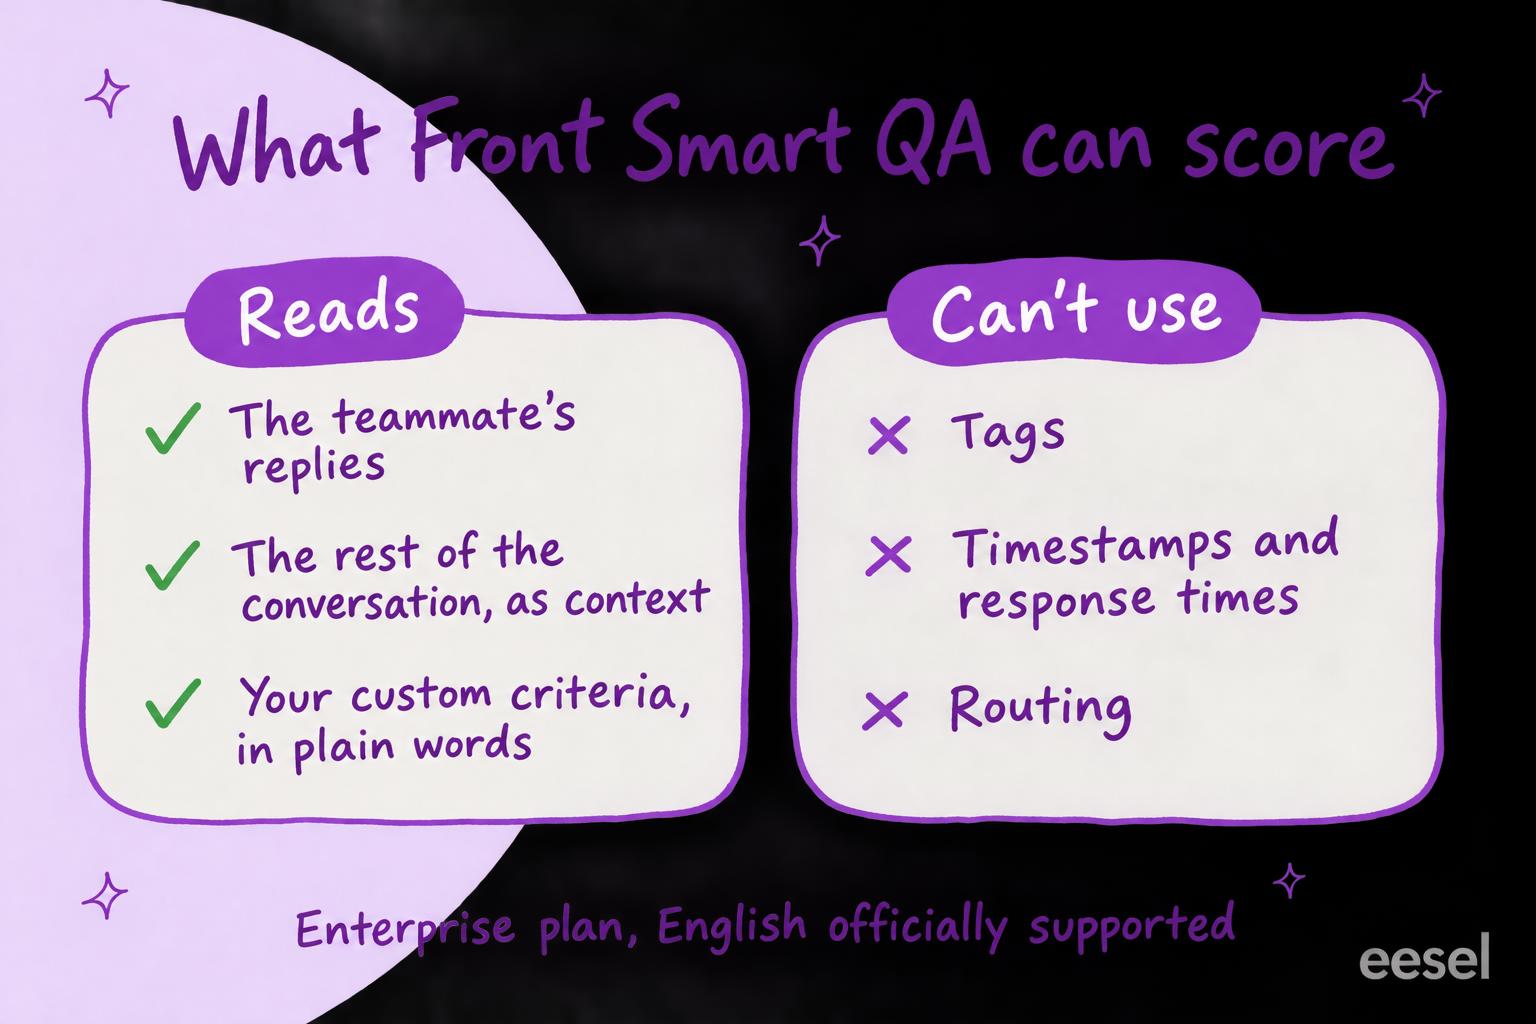
O registro em torno da conversa. O artigo do Front é explícito: "Conversation metadata such as tags, time between responses, and other information is not able to be used in the evaluation." Então nenhum critério consegue verificar se um pedido de reembolso recebeu a tag Refund, se uma pergunta de cobrança foi movida para a caixa Billing, ou se uma resposta saiu dentro do seu SLA. Se o seu relatório depende de tags, uma tag errada é uma falha de QA que o Smart QA não vai detectar. As regras de status de ticket e as regras de atribuição do Front precisam ser verificadas de outra forma.
Os outros limites, do mesmo artigo:
- Só caixas compartilhadas. Caixas pessoais não são revisadas a menos que um admin as espelhe para uma compartilhada com uma regra.
- Resolvida ou arquivada, com uma resposta. Uma conversa precisa de pelo menos uma mensagem recebida e uma enviada.
- Não retroativo. Uma regra pontua conversas arquivadas ou resolvidas depois de criada, então o trimestre passado fica sem nota.
- Inglês. "Only English is officially supported at this time"; outros idiomas podem dar "unexpected results". A QA de suporte multilíngue aborda as opções.
- As exclusões são definidas na regra. Ela restringe por caixa, tipo de conversa e colega de equipe; qualquer outra coisa é uma substituição manual depois do fato.
Quanto custa a QA com IA do Front?
O Smart QA vem com o Enterprise. A central de ajuda do Front diz que ele está "included with the latest Enterprise plan at no additional cost", e a página de preços lista "AI Copilot, QA, and CSAT included" no Enterprise. A palavra "latest" importa se você tem um contrato Enterprise mais antigo: pergunte ao Front se o seu inclui isso. Preços verificados em 21 de novembro de 2026, cobrados anualmente:
| Plano | Por assento ao mês | Limite de assentos | O que adiciona para QA |
|---|---|---|---|
| Starter | 25 $ | Até 10 | Analytics básico, AI Topics |
| Professional | 65 $ | Até 50 | Analytics avançado; o Copilot é um complemento de 20 $ por assento |
| Enterprise | 105 $ | Sem limite listado | Smart QA, Smart CSAT e Copilot incluídos, relatórios personalizados |
Para uma equipe de 10, o Professional custa 650 $ por mês e o Enterprise 1.050 $, então o Smart QA chega com um salto de 400 $ por mês. Se você comprasse o Copilot de qualquer forma (200 $ por mês para 10 assentos no Professional), a diferença cai para 200 $, que também dão Smart CSAT, roteamento e tags com IA, e regras ilimitadas. Para testar primeiro, o modelo de regra tem um botão Start free trial que inicia 30 dias de Enterprise. O detalhamento de preços do Front do eesel tem o resto, incluindo a cobrança do Autopilot.
O que um programa de QA precisa que o Smart QA deixa para você?
A maioria dos programas de QA verifica três coisas que o Smart QA não alcança totalmente: se a resposta coincidiu com uma política que vive em um documento, se a conversa foi marcada com tag e roteada como seus relatórios esperam, e como foi em conversas em outro idioma ou em uma caixa pessoal. Escolha o que você quer verificar e veja o que cobre isso:
Escolha uma verificação para ver o que cobre isso no Front, e o que cobre isso quando nada cobre.
Há duas formas de cobrir o resto.
Pontuar uma amostra manualmente
O caminho mais barato não precisa de nada novo, e é onde a maioria dos guias de QA de suporte com IA começa. Toda semana, um líder filtra as conversas arquivadas da semana anterior em uma caixa, lê dez ou vinte (as notas mais baixas do Smart QA primeiro, se você as tiver), e confere cada uma segundo uma rubrica curta em uma planilha: resposta certa para a política, tag certa, caixa certa. Combine primeiro o que cada nota significa para que dois revisores pontuem a mesma conversa da mesma forma: a calibração de QA ajuda, assim como estes exemplos de feedback de QA.
O limite é o óbvio: uma pessoa lê uma amostra, e os resultados vivem fora do Front.
Deixar um colega de equipe de IA revisar segundo suas regras
O segundo caminho é um agente de IA que faz a revisão por conta própria e deixa o resultado no Front. É isso que eu faria com o eesel. A integração com o Front do eesel pode iniciar uma execução quando uma conversa é arquivada, e a execução já tem as tags, o responsável, os campos personalizados, a caixa e a conversa, comentários internos incluídos (em uma conversa muito longa, a página mais recente de mensagens). Ele aprende da sua central de ajuda do Front com antecedência, então uma política que você publicou é algo que ele já leu.
Configure uma automação nesse gatilho e, para cada conversa arquivada, ela:
- Lê a conversa com suas tags e caixa de entrada.
- Confere contra as regras que você escreveu em palavras simples ("reembolsos após 30 dias precisam da aprovação de um líder", "perguntas de cobrança recebem a tag Billing", "nunca prometer uma data de envio").
- Deixa seu veredito e seus motivos como um comentário interno na conversa.
- Adiciona uma tag que você criou no Front, como qa-review, às que um líder deveria ler, para que uma visualização ou filtro de analytics as encontre.
Você escreve as regras, então tags, roteamento e política são só mais linhas, alteradas sempre que suas políticas mudam. Uma coisa para saber primeiro: o eesel só adiciona tags que já existem no Front, uma por vez, então alguém precisa criar a tag de revisão antes de você começar. O mesmo agente eesel também pode triar novos e-mails e redigir respostas como comentários internos, se você quiser.
Verificações diárias como essa já funcionam para clientes do eesel. O Cactus Club Cafe usa um segundo agente eesel no seu helpdesk Zendesk que auditoria o extrato financeiro diário todas as manhãs: ele confere cada loja e resolve o ticket como balanceado, ou o deixa aberto citando a diferença. Entre 8 de agosto e 8 de setembro de 2026, ele rodou cerca de 60 vezes. Uma revisão de QA tem a mesma forma: uma verificação contra regras escritas, com o resultado deixado na conversa.
O Front Smart QA é suficiente?
Dando o crédito devido: o Smart QA cobre bastante. Critérios personalizados em palavras simples, uma opção de aprovado e reprovado, trechos citados, substituições manuais que alimentam o relatório, e agentes de IA pontuados no mesmo cartão que as pessoas. O próprio exemplo do Front, Solution accuracy, mostra que ele sabe o que as equipes querem da QA além do tom.
Minha opinião: no Enterprise, ative, comece com cinco ou seis critérios (Solution offered, Comprehension, Tone, e um critério personalizado que escreva por completo sua política mais descumprida), e use as notas mais baixas como sua lista de leitura. Redefina a linha de base a partir de 20 de novembro. Não trate isso como o programa todo: um atendente pode pontuar bem em todos os critérios enquanto marca a conversa com a tag errada, e o Smart QA nunca vai saber. Se você está no Professional, o Enterprise é um salto de 400 $ por mês para 10 assentos em que a QA é só uma de várias coisas que ele adiciona, e um revisor que confere suas regras e suas tags em cada conversa cobre mais do que um scorecard busca fazer. O eesel tem o mesmo detalhamento para Help Scout e a nota de QA HubSpot, e seu resumo de ferramentas de QA de suporte também cobre os pontuadores dedicados.
Experimente o eesel ao lado do Front
Mantenha o Smart QA para o que ele faz bem. O que o eesel pode fazer depende de quem está pedindo, e você escolhe quais ações rodam por conta própria, quais pedem confirmação antes e quais ficam desativadas; para uma execução de revisão, deixe comentários e tags rodarem por conta própria e mantenha as respostas desativadas. Deixe-o ler suas conversas arquivadas do Front contra o resto da sua rubrica (suas políticas publicadas, suas tags e caixas de entrada), escrita em palavras simples e alterada sempre que suas políticas mudam. Ele deixa seus motivos em um comentário interno e marca com tag as conversas que um líder deveria ler.
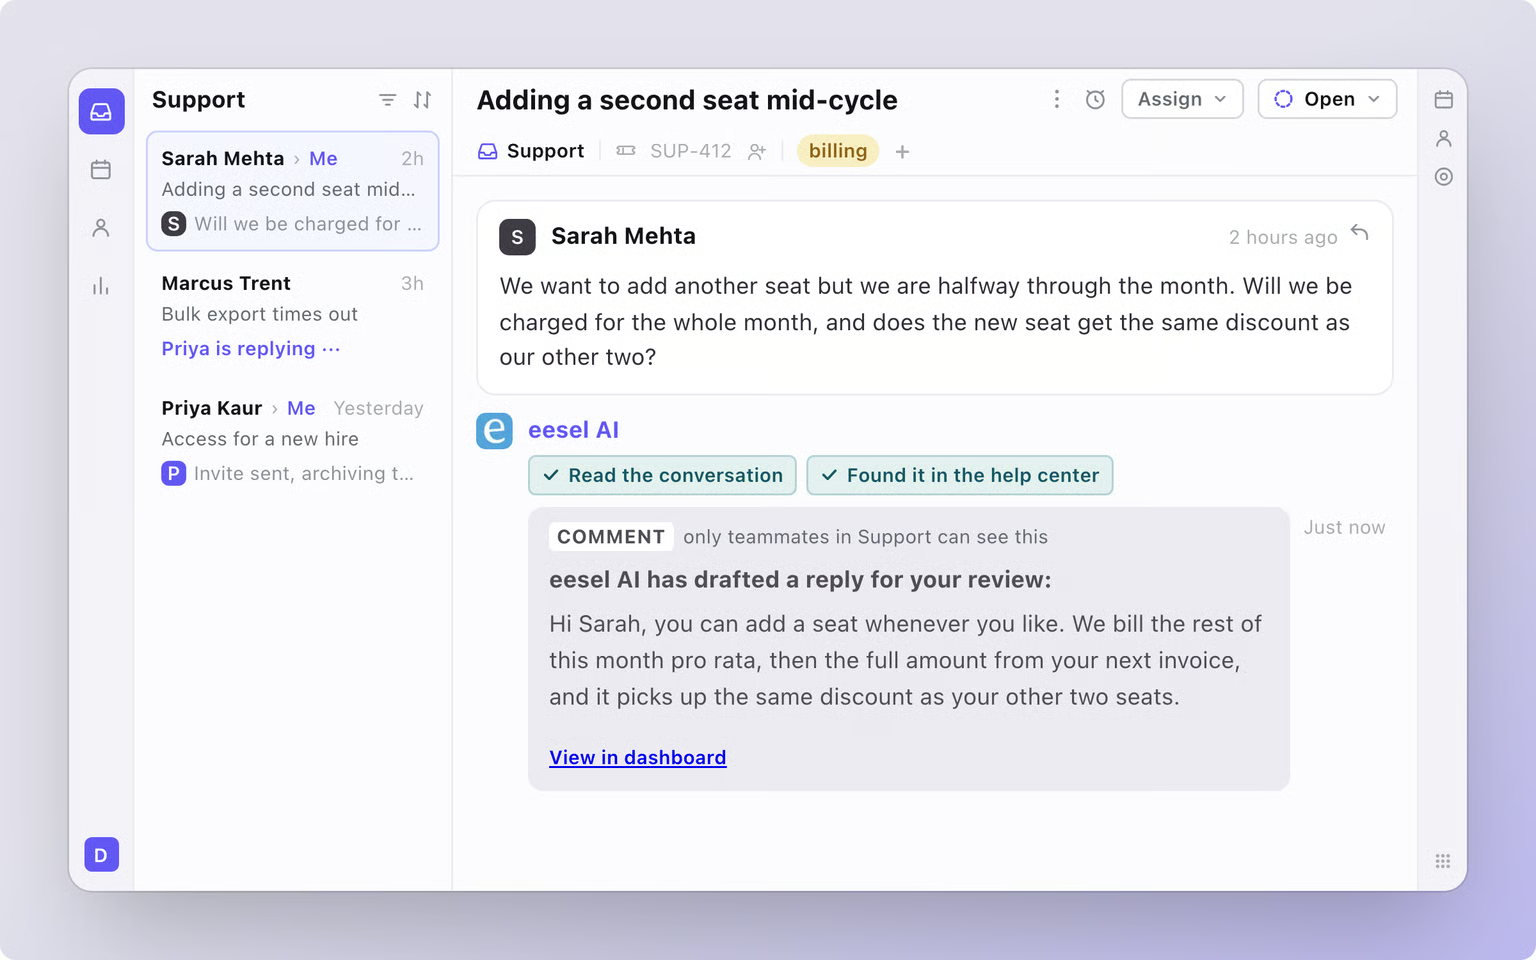
Experimente o eesel na sua caixa de entrada do Front, começando pelas conversas arquivadas de ontem.