

A avaliação de agentes de IA do Front é uma ferramenta chamada Compass, e a parte que você executa antes do go-live é a aba Simulations, que funciona apenas para agentes Autopilot. Uma simulação reproduz uma conversa real contra critérios que você escreve, não envia nada a clientes e limita cada execução a 10 trocas. Depois do lançamento, o Compass pontua respostas ao vivo com Smart QA e Smart CSAT. Ele verifica o comportamento que você descreveu, não se uma resposta corresponde à sua central de ajuda, então leia as transcrições também. O Compass não tem custo extra, enquanto o Autopilot começa em 0,05 $ por conversa.
O eesel trabalha dentro do Front como um colega de equipe de IA de helpdesk que redige como comentários internos, e cada lançamento é simulado primeiro contra as próprias conversas passadas da equipe. Com a eesel CLI, um agente de código de IA pode enviar conhecimento aprovado, como artigos de ajuda do Front exportados e respostas salvas, depois fazer perguntas de teste e verificar as respostas antes que algo vá ao ar. Conectar a própria caixa do Front ainda precisa da aprovação de um admin.
O que é a avaliação de agentes de IA do Front, e onde ela vive?
É o Compass, e ele fica na própria página do agente nas configurações da empresa. O artigo do Compass do Front diz que ele ajuda admins a testar agentes de IA, medir a qualidade das conversas, acompanhar sinais de desempenho e obter recomendações. Você precisa de permissões de admin da empresa e de um agente existente. Três abas fazem o trabalho: Simulations para testar antes da implantação, Performance para monitorar a saúde, e Replies para ler cada mensagem de IA.
O nome levou alguns meses para se firmar, então buscas por "scorecards" ou "relatórios de avaliação" não levam a nada na documentação do Front. Em agosto, um gerente de comunidade do Front pediu parceiros de design para um conjunto de ferramentas que "pontue cada interação de IA, diagnostique o que deu errado e valide mudanças antes do go-live". Em 6 de outubro, o Front apresentou o Compass em suas atualizações de produto, e o resumo de 26 de outubro lista avaliação de agentes e teste de agentes como duas linhas separadas.
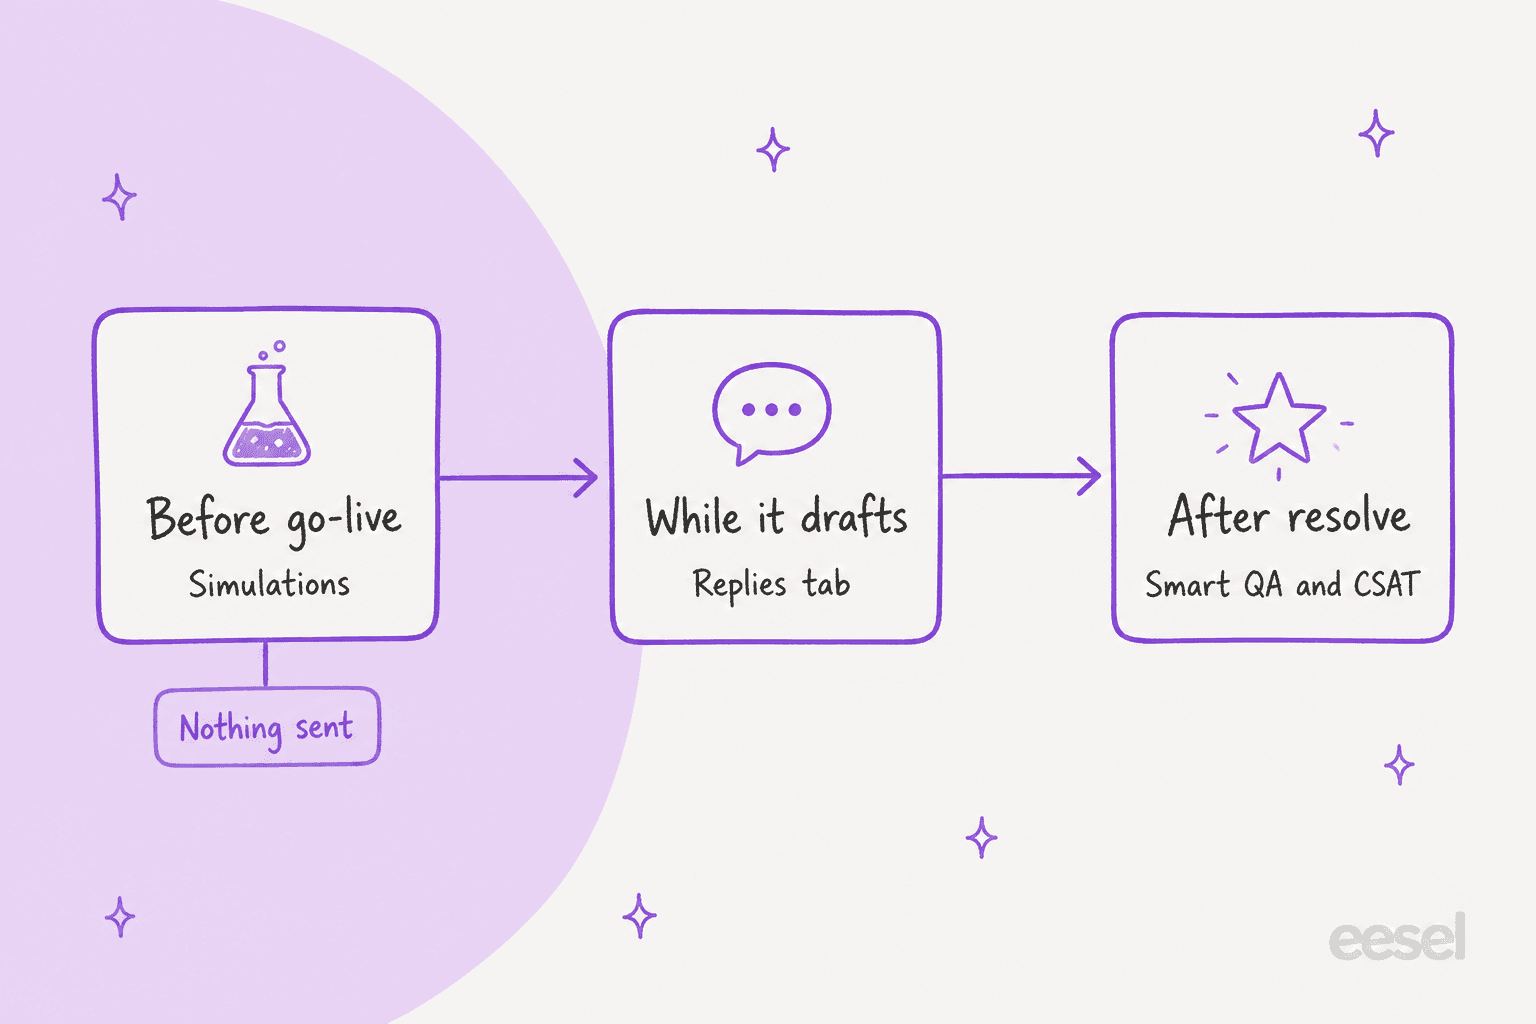
Eu leio a avaliação em três camadas, e a imagem acima é como eu explicaria a um líder de suporte. Antes do go-live você executa simulações, enquanto o agente redige você lê a aba Replies, e depois que uma conversa é resolvida, Smart QA e Smart CSAT a pontuam. Cada camada responde a uma pergunta diferente, o que importa para o widget mais abaixo.
De quais planos e complementos do Front isso precisa?
O Compass em si é gratuito, mas o que ele avalia geralmente não é. O post de lançamento do Front diz que agentes externos estão disponíveis em todos os planos, Autopilot é um complemento cobrado por uso em todos os planos, e o Compass funciona para ambos sem custo adicional. Usar o Compass com Autopilot precisa do complemento Autopilot.
| Peça | O que o Front diz | Fonte |
|---|---|---|
| Agentes externos (Claude, Codex, Sierra e outros) | Disponíveis em todos os planos | post de lançamento do Front |
| Agentes Autopilot | Complemento cobrado por uso em todos os planos, a partir de 0,05 $ por conversa | preços do Front |
| Compass (Simulations, Performance, Replies) | Sem custo adicional, complemento Autopilot necessário para agentes Autopilot | artigo do Compass |
| Smart QA e Smart CSAT | Incluídos no plano Enterprise mais recente sem custo extra | artigo do Smart QA |
| Assento Enterprise | 105 $ por assento por mês, cobrado anualmente | preços do Front |
O artigo do Smart QA acrescenta um teste Enterprise de 30 dias para equipes em outros planos, iniciado a partir do modelo de regra. O que a documentação não diz é se um cliente Professional que adiciona Autopilot recebe pontuações de Smart QA sobre as respostas da IA. O artigo do Compass diz que o Smart QA é ativado automaticamente para agentes de IA, e o artigo do Smart QA diz que é um recurso Enterprise, então pergunte ao Front antes de orçar em torno disso. Meu post sobre preços do Front tem os números por assento, e Front AI cobre a linha de produtos mais ampla.
Como funcionam as simulações do Front?
Você monta um set de conversas de teste, dá critérios a cada uma e as executa. Um set é um grupo nomeado de simulações relacionadas que você reexecuta como base depois de cada mudança, segundo o artigo do Compass. Os passos:
- Abra o agente, selecione Simulations e clique em Create set. Dê um nome e, opcionalmente, escolha um scorecard de Smart QA.
- Clique em Create simulation. Escolha uma conversa recente e aberta nas caixas selecionadas, ou digite um ID de conversa ou de ticket.
- Adicione critérios de simulação e depois clique em Create and run.
- Para muitas conversas de uma vez, cole IDs separados por vírgula. Cada uma se torna sua própria simulação, e Run set executa todas.
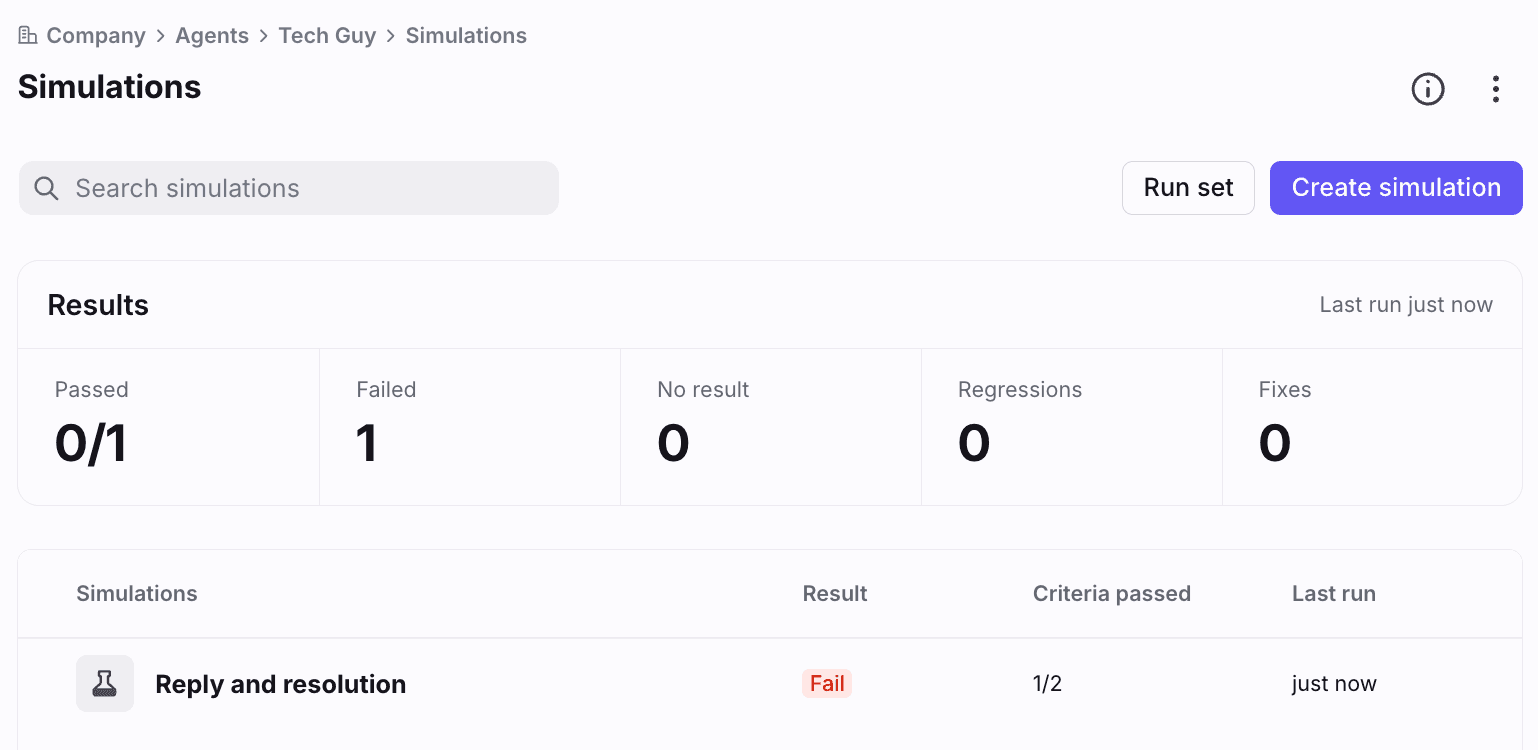
O painel de resultados acima conta aprovados, falhados, sem resultado, regressões e correções. O artigo de ajuda do Front diz que cada conversa é executada contra o agente com um cliente simulado, limitada a 10 trocas, e as execuções são ilimitadas. Nada chega a um cliente real, nenhuma conversa ao vivo muda, e as análises permanecem intactas.
Os critérios são onde está o trabalho. Você escreve um nome e uma descrição do comportamento esperado, clica em Generate scale para obter condições de aprovação e falha, e um validador marca qualquer coisa vaga, agrupada ou não verificável até que fique "Good definition". O Front sugere três critérios iniciais: o agente nunca afirma ter feito uma ação que não fez, ele escala quando deveria, e não escala quando não deveria. Esses são os mesmos três defeitos que eu colocaria no primeiro set de testes de qualquer agente de suporte.
O que uma simulação do Front pode ver, e o que não pode?
Esse é o limite que mais importa. Uma simulação julga o comportamento a partir de evidências visíveis, e o artigo do Compass lista o que são essas evidências. O validador consegue ver mensagens enviadas, notas internas, tags, movimentos de caixa, atribuição, status do ticket, chamadas de conector e como a conversa terminou. Ele não consegue ver o conteúdo ou a ordem de um Playbook, o corpo de um artigo de conhecimento, campos personalizados, registros de contato, rascunhos ou anexos.
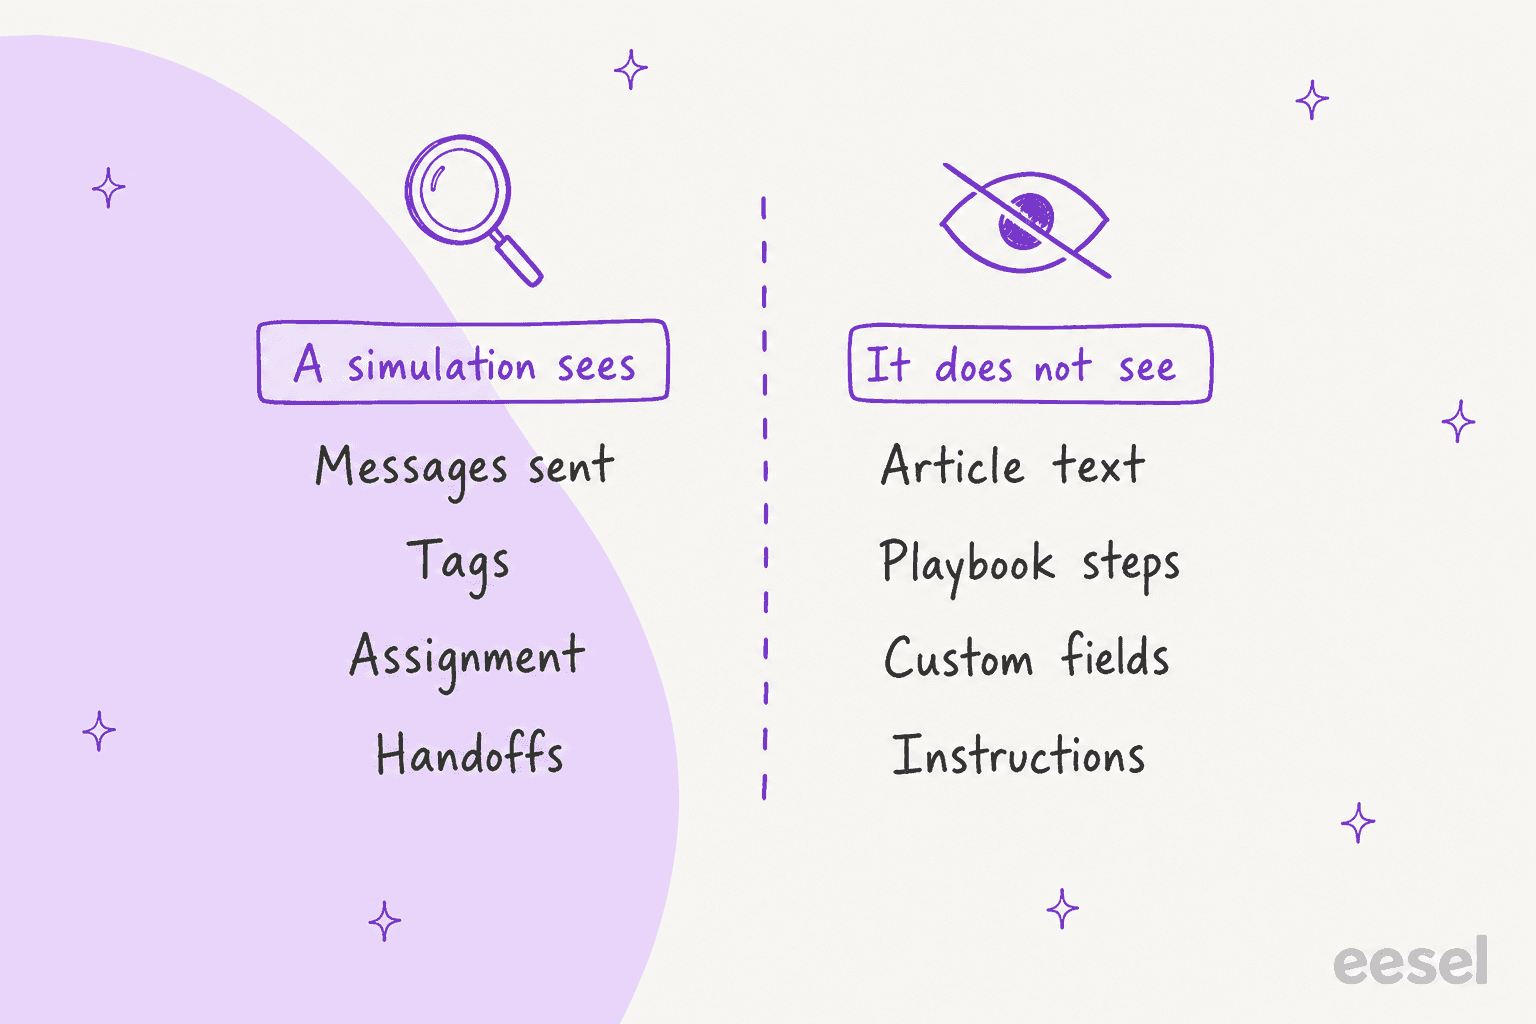
As instruções do agente, diretrizes e configurações de tom também ficam ocultas, a menos que o agente se refira a elas sem declará-las. O FAQ do Front diz claramente que os critérios não conseguem verificar respostas contra fontes de conhecimento ou Playbooks, então seu conselho é escrever critérios baseados em comportamento e ler a transcrição para checar a precisão. Uma simulação aprovada prova que o agente se comportou como você descreveu, não que a resposta dele estava certa. O artigo classifica tom e formatação como trabalho do scorecard de Smart QA e diz para mantê-los fora dos critérios.
Para uma pergunta de reembolso, isso significa que "escala para uma pessoa quando o cliente pede o dinheiro de volta" é um bom critério, e "cita a janela correta de 30 dias" não é testável, porque o texto do artigo é invisível para o validador. O segundo você detectaria lendo a transcrição, e meu guia sobre adversarial testing e as entradas do glossário sobre AI hallucination e AI grounding explicam por que essa leitura importa.
Como ler o resultado de uma simulação?
Você abre uma simulação e obtém a transcrição, os critérios e um veredito. O artigo do Front diz que a visão detalhada mostra uma prévia da conversa e os resultados, com histórico de execuções e reexecuções no menu de três pontos, e indicadores de seta que comparam a execução atual com execuções anteriores para mostrar progresso ou retrocessos.
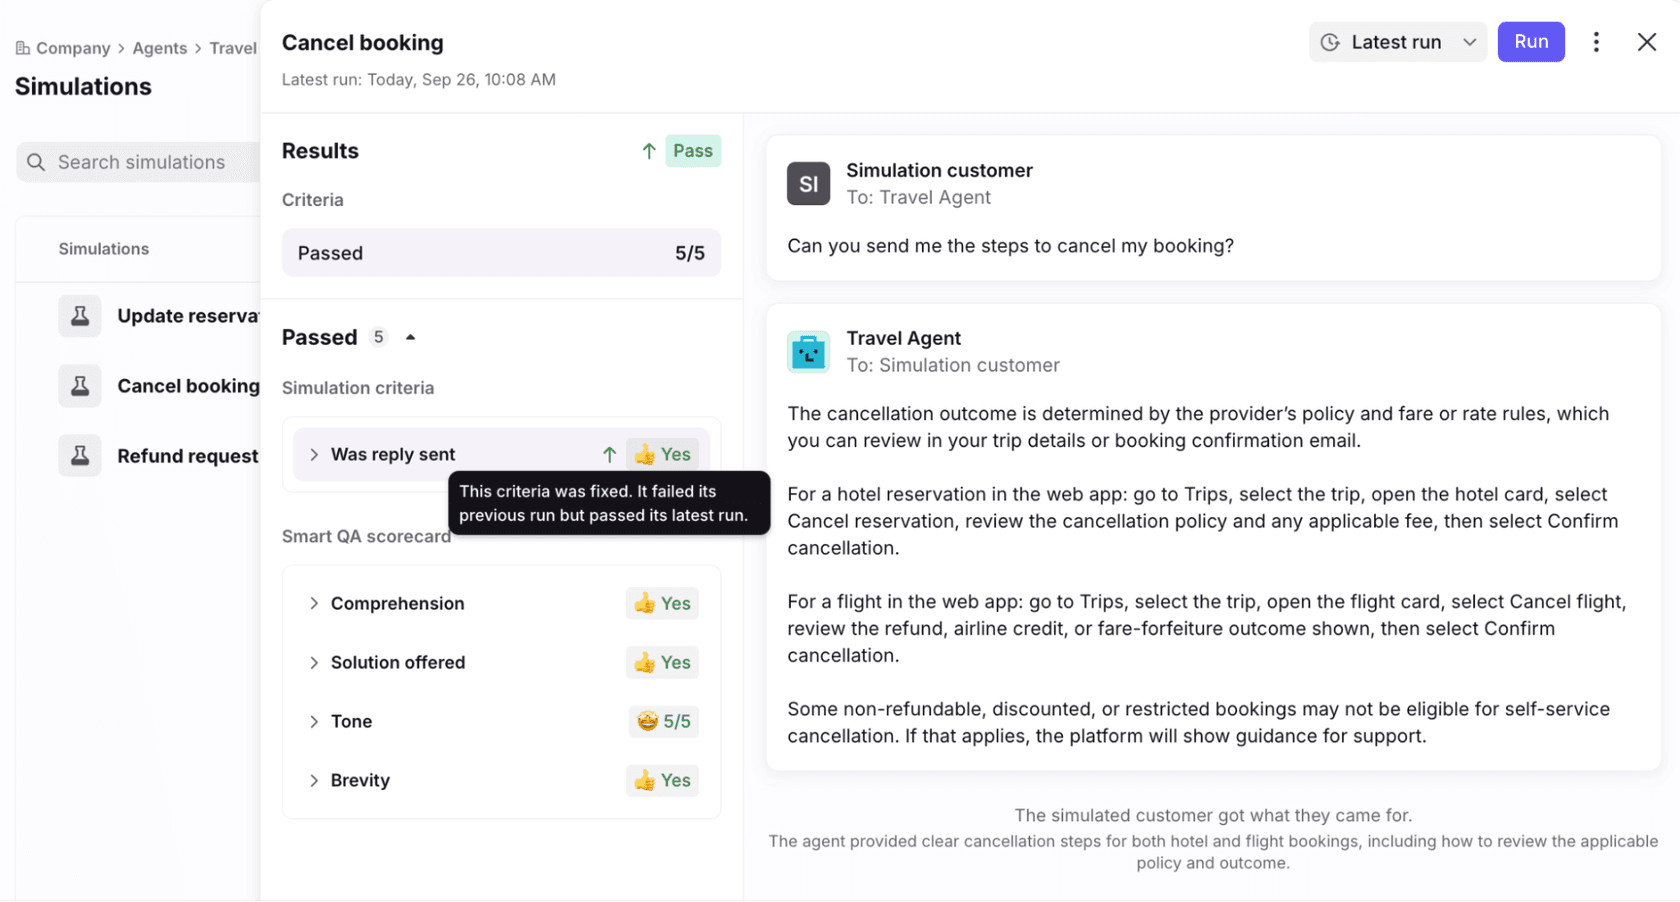
Na captura de tela, um critério que falhou na última execução e passou nesta leva uma dica dizendo que foi corrigido, e o scorecard de Smart QA está anexado abaixo. Esse é o ciclo para o qual o Front está projetando: mudar as instruções ou o conhecimento, reexecutar o mesmo set e observar tanto retrocessos quanto correções. O Smart QA só avalia respostas, então se o agente corretamente fica em silêncio e escala, o scorecard não se aplica, mas seus critérios sim.
O que o Compass mede quando o agente está ao vivo?
O Compass classifica cada resposta como Sem sinal, Boa, Ok ou Ruim, construída a partir de cinco sinais. O artigo do Compass os nomeia:
- Smart CSAT. Roda automaticamente sobre respostas de IA em conversas resolvidas e infere satisfação. Colegas humanos não são avaliados por esse caminho.
- Smart QA. Roda 24 horas após a resolução sobre respostas de IA, com um scorecard padrão de Brevidade, Tom, Solução oferecida e Compreensão.
- Nível de edição do rascunho. Detecta se um rascunho de IA foi enviado como estava, levemente editado, muito editado ou descartado.
- Feedback dos colegas. Polegar para cima ou para baixo em rascunhos e respostas, com detalhes opcionais que só admins conseguem ver.
- Feedback inferido. A IA do Front infere um sinal a partir de correções ou edições pesadas.
A aba Performance reúne tudo isso com métricas de resolução e envolvimento e uma lista chamada Opportunities. O Front diz que isso ajuda a julgar se um agente está saudável o bastante para expandir a cobertura ou passar de rascunhos para respostas automáticas, e o que corrigir primeiro.
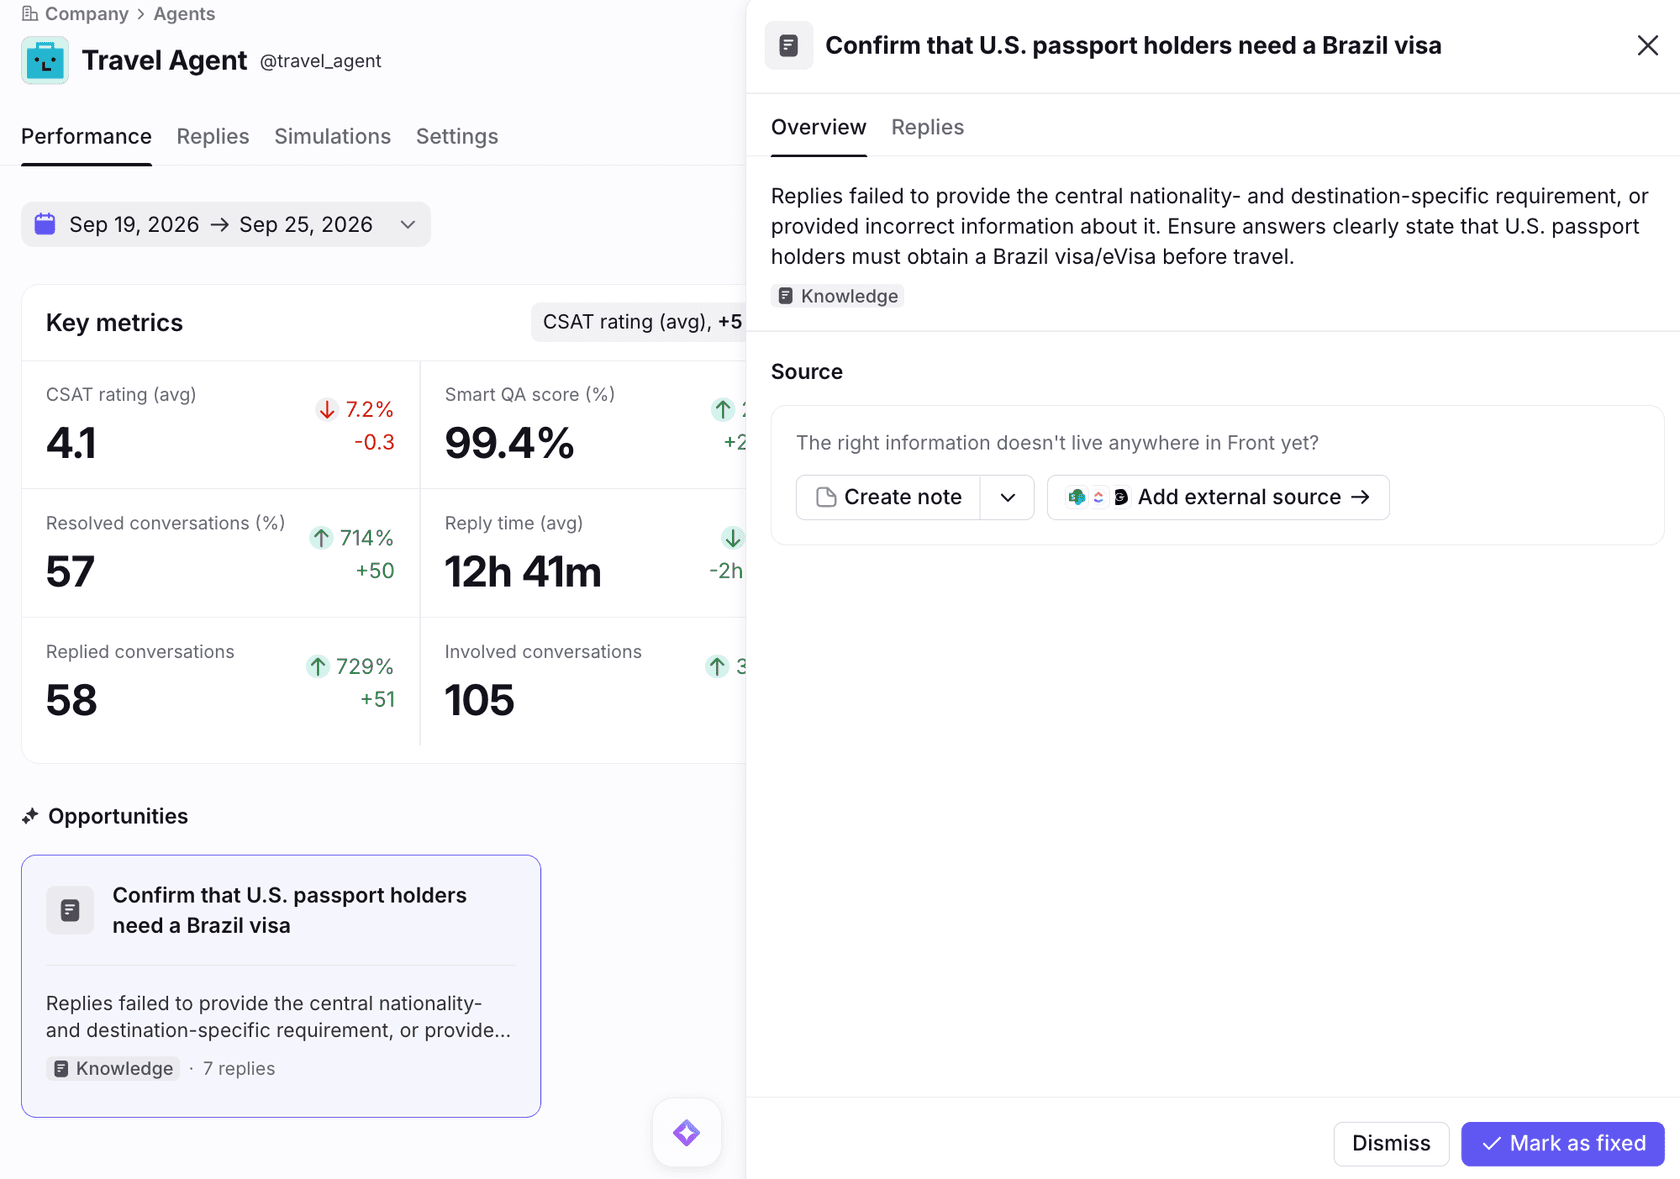
Uma Opportunity mostra um resumo, um tipo de lacuna e quantas respostas ela afeta, e a correção sugerida geralmente aponta para conhecimento ou instruções do agente. No exemplo do Front, respostas sobre uma exigência de visto para o Brasil estavam erradas, e o painel oferece criar uma nota ou adicionar uma fonte externa. A aba Replies lista cada rascunho e resposta automática com filtros por caixa, tipo de resposta, tópico e sinal, e mostra as fontes por trás de cada uma. Se você se apoiar no CSAT como seu número principal, lembre-se de que aqui ele é inferido, e meu post sobre AI CSAT explica até onde confiar nisso.
Os artigos de Smart QA e Smart CSAT do Front definem os limites. Só contam conversas de caixa compartilhada, cada uma precisa de ao menos uma mensagem de entrada e uma de saída, e a conversa precisa estar Resolved ou Archived. O inglês é o único idioma oficialmente suportado. As regras não são retroativas, então o histórico anterior à existência de uma regra não é pontuado. O Front relata cerca de 99% de precisão em conteúdo factual para o Smart QA e cerca de 90% de alinhamento com o CSAT do cliente para o Smart CSAT, que são números do próprio Front.
A avaliação funciona para agentes externos como Claude ou Sierra?
Em parte. O post de lançamento do Front diz que o Compass avalia toda conversa tratada por agentes no Autopilot ou em outro provedor, e o Compass é gratuito para ambos. O artigo do Compass diz que o teste de agentes, a aba Simulations, é só para agentes Autopilot, e para agentes externos as fontes da aba Replies são o conhecimento passado pelo MCP. Então um agente externo recebe pontuação ao vivo, mas você o testa com seu próprio sistema antes de conectá-lo. O post de lançamento do Front cita um cliente, a Next Level Sports, dizendo que o Compass dá às suas equipes de suporte e engenharia um único lugar para revisar respostas de IA e medir a qualidade.
Qual ferramenta do Front responde a qual pergunta?
Escolha a pergunta que você está tentando responder, e a ferramenta muda. Este widget é meu próprio resumo dos artigos do Front, então a última linha de cada painel é onde ler o detalhe.
Rule testing é a exceção, por isso eu o listo. O artigo de rule testing do Front verifica se uma conversa passa pelas condições e ações de uma regra, em qualquer plano, com a opção de montar uma conversa simulada do zero. Vale a pena executá-lo na regra que atribui conversas ao seu agente, como explica meu post Front load balancing para limites de atribuição.
Como eu implantaria um agente de IA do Front com essas ferramentas?
Comece com rascunhos, teste em sets, e amplie só quando os sinais concordarem. O artigo de agentes Autopilot do Front descreve um agente redator que cria rascunhos em conversas novas, configurado com orientação só de redação e uma regra montada a partir do modelo Assign to AI agent. A partir daí:
- Monte um set de 15 a 20 conversas. Misture perguntas simples, pedidos de reembolso, clientes irritados e coisas que o agente deveria recusar. O Front diz que uma amostra variada dá cobertura mais ampla, e eu puxaria do último mês de tráfego real.
- Adicione os três critérios iniciais. Nunca afirma ter feito uma ação que não fez, escala quando deveria, não escala quando não deveria.
- Execute, leia cada transcrição, corrija, reexecute. Observe as setas de regressão depois de cada mudança nas instruções ou no conhecimento.
- Vá ao ar como agente redator. Verifique a aba Replies para o nível de edição do rascunho e os polegares dos colegas, não só a pontuação média.
- Mova tópicos para respostas automáticas um por um. Use a aba Performance e a lista Opportunities para decidir, e mantenha regras e metas de tempo como seu placar. Meus posts Front time goal rules e SLA best practices cobrem esse lado.
O comportamento de transferência merece seus próprios critérios. Se o agente escala, a conversa precisa chegar à pessoa certa com contexto, o que meus posts AI agent handoff best practices e AI escalation percorrem. O glossário tem entradas sobre escalation rate e AI guardrails.
O que a documentação do Front não diz sobre avaliar agentes de IA?
Bastante coisa, e cada lacuna é algo que eu perguntaria ao Front ou testaria antes de confiar nisso.
- Restrição de plano para Smart QA em respostas de IA. Incluído no Enterprise segundo um artigo, ativado automaticamente segundo outro, e nenhuma página reconcilia isso para um cliente Professional com Autopilot.
- Se as simulações chamam sistemas ao vivo. O validador consegue ver chamadas de conector, mas a documentação não diz se uma execução simulada atinge ferramentas reais ou isoladas.
- Um limite de aprovação. Não há taxa de aprovação ou tamanho de set sugerido além de "usar uma amostra variada".
- Comparação com o que sua equipe enviou. Os critérios descrevem comportamento. O artigo não descreve pontuação contra a resposta que uma pessoa realmente escreveu naquela conversa.
- Idiomas no Compass. O artigo do Compass fica em silêncio sobre isso. Os artigos de Smart QA e Smart CSAT dizem que só o inglês é oficialmente suportado.
- Exportação ou acesso via API. Não encontrei menção a exportar resultados de simulação nem a executar sets pela API.
- Vozes externas. O post do Compass do Front na comunidade tinha 0 respostas e 122 visualizações quando eu o li, então ainda não tenho uma avaliação de profissional para citar.
Nada disso torna o Compass uma ferramenta fraca. Um simulador baseado em critérios com validador, histórico de execuções e setas de regressão é um sistema de testes real. É um design diferente de reproduzir o histórico, que é a comparação que mais me interessa a seguir.
Como o eesel testa um agente de IA antes de ele responder clientes do Front?
O eesel testa contra suas próprias conversas passadas, e o Front testa contra critérios que você escreve. Os dois são complementares, e eu não escolheria um só por isso. A simulação do eesel reproduz tickets passados com o envio desligado, redige uma resposta para cada um, compara com o que sua equipe realmente enviou, agrupa os resultados por tema e classifica correções por impacto. O relatório separa acertos, acertos parciais, transferências corretas e falhas diretas. O próprio exemplo da documentação do eesel são 20 tickets resolvidos, dos quais 17 correspondem à qualidade de resposta da equipe.
| Simulações do Front Compass | Simulação do eesel | |
|---|---|---|
| O que testa | Comportamento contra critérios que você escreve | Respostas contra o que sua equipe realmente enviou |
| Entrada de teste | IDs de conversa das suas caixas | Tickets passados, ou casos gerados sem um helpdesk |
| Lado do cliente | Cliente simulado, máximo de 10 trocas | Uma resposta redigida por ticket passado |
| Aplica-se a | Apenas agentes Autopilot | O agente do eesel |
| Envia a clientes | Não | Não |
| Depois de uma execução | Reexecutar o set, ler as setas | Correções salvas como regras em frases simples, depois reexecutar |
O cliente simulado de múltiplos turnos do Front é o que o replay do eesel não reproduz, e a própria página de simulação do eesel diz que chats de múltiplos turnos com personas interpretadas por IA são melhor atendidos pelo próprio simulador de um helpdesk. Na outra direção, o artigo do Front não descreve verificar uma resposta contra uma resposta de referência, que é onde reproduzir o histórico ajuda.
A parte conquistada, para mim, é a ordem do lançamento. O eesel roda IA em filas de suporte ao vivo há anos, e o hábito que ficou é que nada responde a um cliente antes de ser reproduzido contra o próprio histórico daquela equipe e depois redigido em tickets ao vivo por uma ou duas semanas. A Norden-Frisia, uma balsa alemã, usou uma semana de teste com os últimos três meses de tickets e macros antes de assinar. A Textla começou com um teste em que o eesel só deixava notas internas para a equipe ver o que ele teria dito, e a Innr ainda revisa cada rascunho e trabalha em direção a respostas autônomas para um conjunto escolhido de tópicos. Nenhuma das três usa o Front, então leia isso como o mesmo método em outros helpdesks.
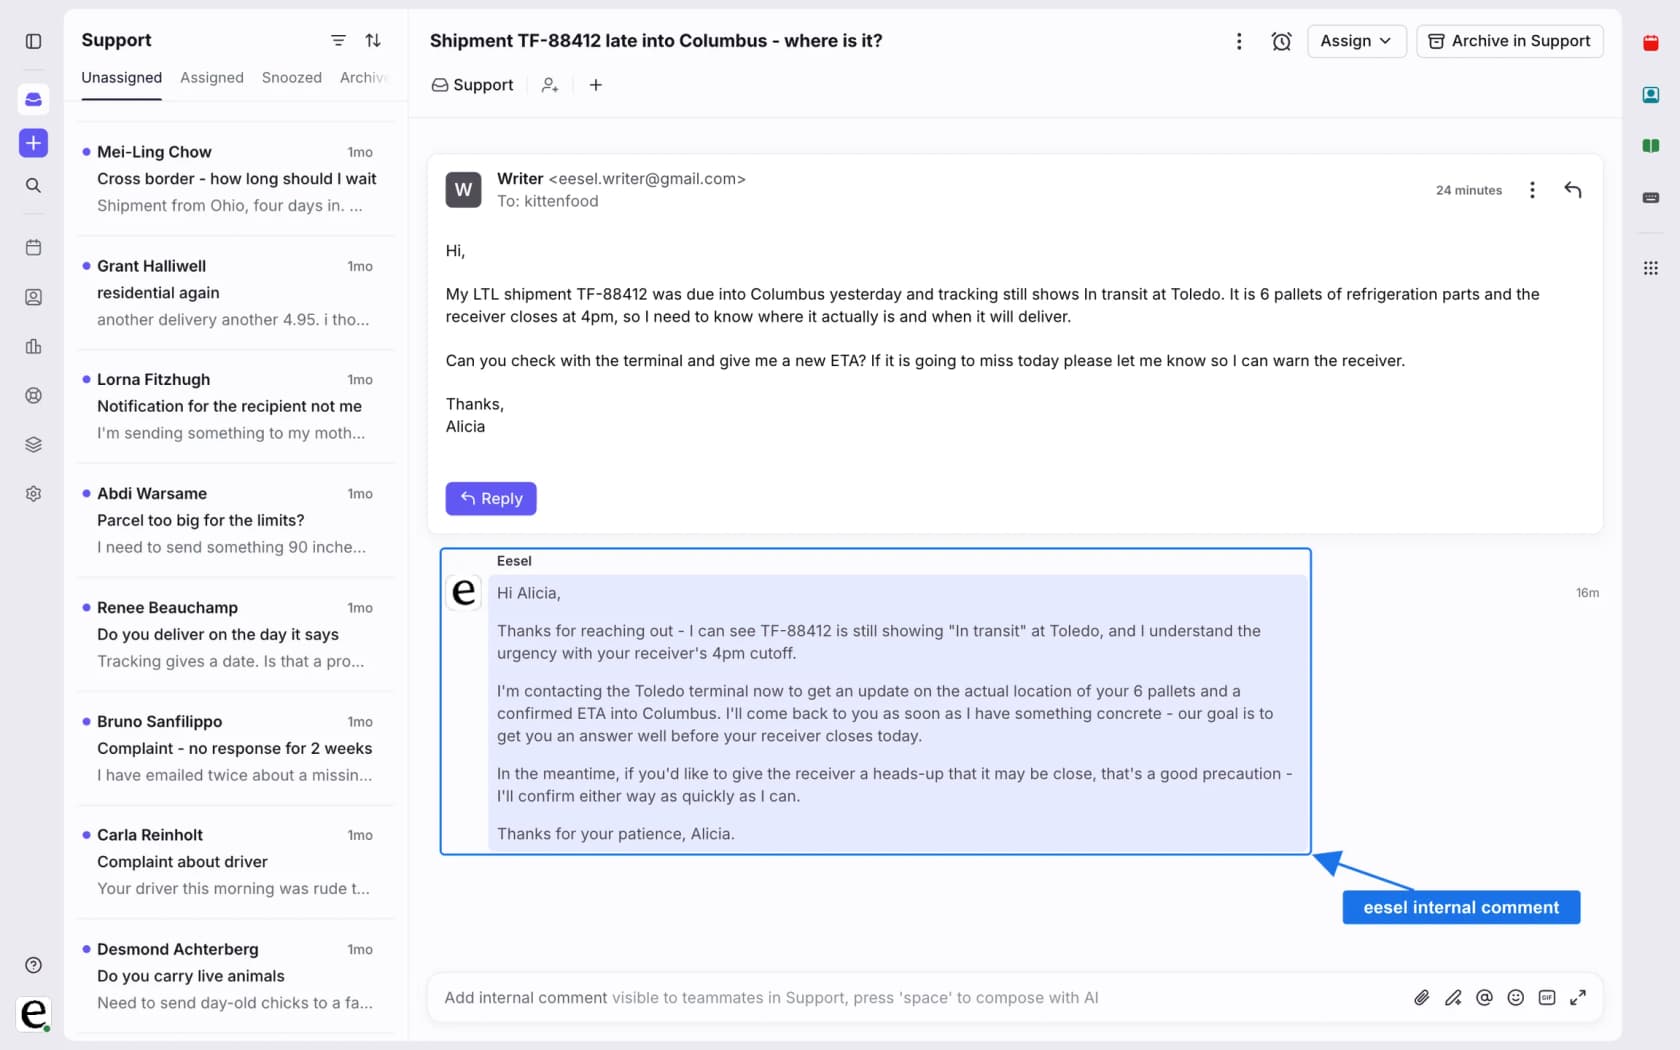
No Front, os documentos de integração do eesel listam gatilhos para uma mensagem de cliente, uma primeira mensagem, uma menção a @eesel e uma conversa arquivada, com ações para responder, deixar um comentário interno, marcar, atribuir, atualizar campos e arquivar. A documentação recomenda começar com comentários internos e não descreve uma simulação específica do Front, então eu executaria o replay em um lote pequeno e leria o relatório. A CLI ajuda nesse ciclo. eesel files upload ./refund-policy.pdf adiciona conhecimento aprovado, eesel chat "what's our refund policy?" testa uma resposta, eesel approvals lista ações retidas, e --dry-run mostra uma prévia de uma escrita. A documentação da CLI não menciona simulações, então essas execuções acontecem no dashboard.
Teste o eesel na sua caixa do Front
Se você quiser a versão deste processo focada em replay primeiro, o eesel entra na sua caixa compartilhada do Front como um colega de equipe de IA de helpdesk. Ele lê sua central de ajuda e conversas passadas, redige respostas como comentários internos, e pode marcar e atribuir, então sua equipe revisa rascunhos reais antes que algo seja enviado. Execute a simulação sobre seu próprio histórico, mantenha suas regras e metas de tempo como placar, e amplie para respostas diretas quando os rascunhos corresponderem ao que uma pessoa escreveria. Os planos pagos começam em 299 $ por mês por 500 créditos, e há um plano gratuito com 100 créditos para testar em algumas conversas reais (preços do eesel).
Para a configuração, veja meu guia adding AI to Front, o comparativo best AI for Front e Front vs eesel. Para comparar ferramentas, veja minha Front review e Front alternatives. Para o resto da configuração do Front, Front ticket status rules, Front shared inbox ownership e Front required resolution fields mostram onde o trabalho de um agente cai, e o glossário explica shared inbox, support quality assurance e resolution rate. Try eesel em algumas conversas reais antes de decidir.