

Por que uma auditoria de prontidão para IA não é uma limpeza de conteúdo
Eu construo os agentes de IA na eesel, então leio centrais de ajuda como o agente lê: como uma pilha de texto que é cortada em pedaços e pesquisada por significado. O Zendesk descreve o processo com clareza na documentação. O conteúdo de conhecimento é dividido em trechos, cada trecho é armazenado com um vetor numérico, e os trechos que melhor correspondem são usados para escrever a resposta. O modelo nunca lê sua central de ajuda como uma pessoa lê. Ele lê os trechos que tiveram a maior pontuação para aquela pergunta específica.
Isso muda o que significa "bom conteúdo". Uma pessoa passa batido pelo artigo desatualizado porque sabe que existe um mais novo. Um sistema de recuperação não tem esse discernimento, então, se os dois correspondem, os dois podem ser usados. Esse é o núcleo da geração aumentada por recuperação, e é por isso que uma central de ajuda que funciona bem para pessoas ainda pode produzir uma resposta de IA errada.
Já vi isso dar errado em contas reais. Uma equipe de suporte técnico B2B me contou que a central de ajuda dizia "damos suporte a todos os modelos", e o bot já tinha dito sim a uma marca que não estava no banco de dados deles. Clientes pagantes também viram bots responderem com conhecimento geral quando a recuperação não encontrava nada relevante. Ambos são problemas de conhecimento antes de serem problemas do modelo, e ambos são mais baratos de achar antes do go-live. Este post cobre a verificação de prontidão para IA. Para a limpeza geral de manter, mesclar ou arquivar, escrevi um guia separado de auditoria da base de conhecimento de suporte.
As quatro formas de uma base de conhecimento fazer a IA responder errado
Toda resposta errada que rastreio termina em uma de quatro causas. Dar nome a elas torna a auditoria mais rápida, porque cada uma tem um teste diferente e uma correção diferente.
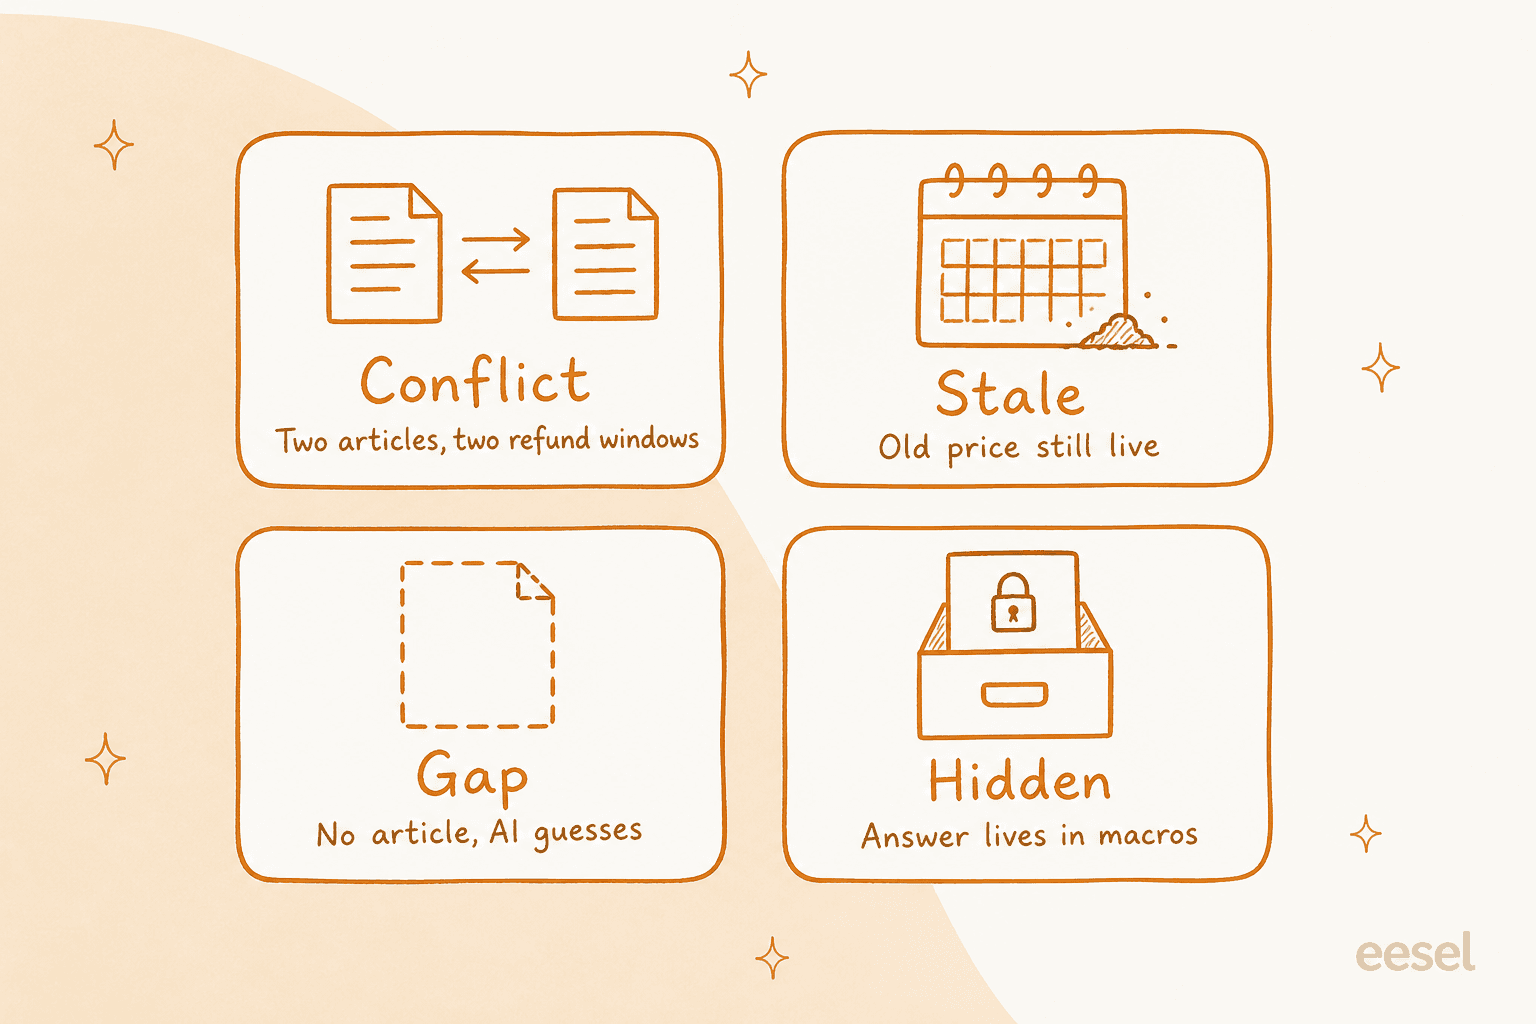
As quatro falhas, na ordem em que as verifico: dois artigos que discordam, um fato que envelheceu, um tema sem artigo e uma resposta que mora num lugar que a IA não consegue ler.
Conflito. Dois artigos dão respostas diferentes. O Gorgias usa um exemplo na própria documentação: se um artigo da central de ajuda diz que o prazo de devolução é de 30 dias e uma entrada de guidance diz 14, o agente pode não responder da mesma forma toda vez (documentação do Gorgias). A IA não está confusa. Ela recuperou os dois, e nada lhe disse qual prevalece.
Desatualizado. O artigo já esteve certo. Preços, nomes de planos, horários limite de envio e nomes de recursos envelhecem mais rápido, e uma linha desatualizada é repetida com total confiança. As regras de verificação de artigos do Zendesk existem para isso: até 20 regras que redefinem artigos para não verificados em um cronograma, para que um responsável precise reconfirmá-los.
Lacuna. Nenhum artigo cobre a pergunta. Um agente bem comportado encaminha. Um mal configurado preenche o silêncio com conhecimento geral. O Gorgias observa que, quando um tema não está coberto, o agente muitas vezes encaminha a conversa para sua equipe, o que é seguro, mas caro se o tema tem alto volume.
Escondido. Sua equipe sabe a resposta, mas ela mora em macros, num wiki interno, num vídeo do Loom ou na cabeça de um agente sênior. Ouvi isso de uma marca DTC que queria automatizar cerca de metade do volume de e-mails enquanto seu conhecimento estava em ferramentas de SOP, vídeos não transcritos e macros antigas. Uma IA só pode responder com o que você conecta, e a parte conectada era a mais fraca.
Use o widget abaixo em qualquer artigo sobre o qual tenha dúvida. Ele mostra como a falha se parece, como encontrá-la e a regra que aplico antes do go-live.
Qual falha é este artigo?
Escolha o tipo de falha para ver como encontrá-la e a regra de go-live que uso.
Clique em cada tipo de falha para ver como ela se parece, como encontrá-la e a regra que verifico antes do go-live.
Audite em ordem de risco, não em ordem alfabética
O erro comum é auditar a central de ajuda inteira de forma uniforme. Uma resposta errada sobre o horário da loja e uma resposta errada sobre reembolsos não custam o mesmo, então classifico os temas por duas coisas: quantos tickets geram e o que custa uma resposta errada. Coloco reembolsos, devoluções, cancelamentos e pagamentos no nível mais alto.
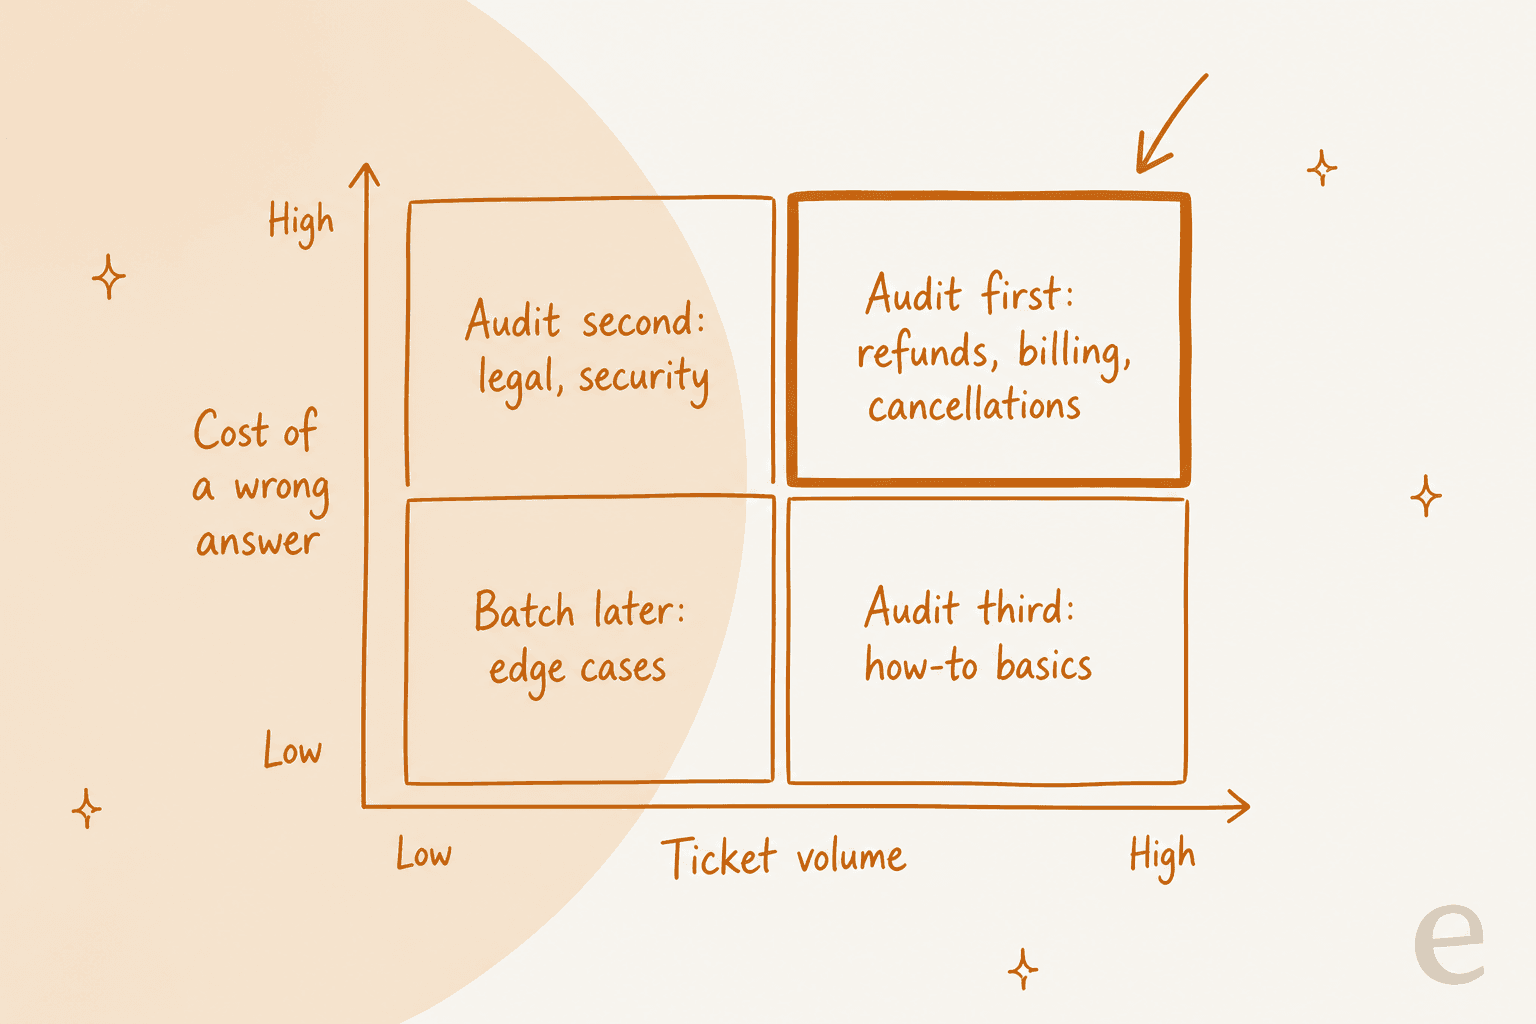
Ordem de auditoria por custo de uma resposta errada e volume de tickets: temas de dinheiro primeiro, jurídico e segurança em segundo, o básico de uso em terceiro, casos de borda agrupados depois.
| Nível | Temas | O que verifico | Barreira típica de go-live |
|---|---|---|---|
| 1: dinheiro | Reembolsos, devoluções, cancelamentos, cobrança, falhas de pagamento | Conflitos, números desatualizados, exceções, quem pode aprovar | Zero respostas erradas nos testes |
| 2: risco | Termos legais, segurança, privacidade, acesso à conta | Redação aprovada pelo responsável certo, encaminhamento claro | Zero respostas erradas, escalar na dúvida |
| 3: volume | Envio, assinaturas, o básico de uso, solução de problemas | Precisão, completude, linguagem simples | A maioria das respostas correta, o resto escala de forma limpa |
| 4: cauda | Casos de borda, perguntas raras sobre o produto | Agrupar depois, usar encaminhamento enquanto isso | O encaminhamento é aceitável |
Para o nível 1, também leio as regras de reembolso como um agente leria. Quem pode aprovar uma exceção, em que valor, e qual é a redação exata? Meu post sobre a matriz de aprovação de reembolsos detalha isso, e o guia de IA para pedidos de reembolso cobre o que automatizar. Se uma resposta do nível 1 exige um julgamento, configure o tema para encaminhar em vez de responder. A Rúngne faz exatamente isso: a equipe escolhe os temas que a IA responde diretamente, como política e rastreamento, e mantém cancelamentos, itens danificados e pacotes perdidos com pessoas. Mover um tema de um lado para o outro é editar uma lista, não um projeto. A configuração deles está na história da Rúngne.
Como a IA de cada helpdesk lê seu conhecimento
Esta é a parte que a maioria das auditorias pula. Antes de corrigir um artigo, você precisa saber se a IA consegue vê-lo e quão fresca é a cópia dela. Li a documentação de cada fornecedor para isto (todas as páginas editadas ou atualizadas em setembro e outubro de 2026), e as diferenças importam.
| IA do helpdesk | O que lê | Quão fresco | O que verificar |
|---|---|---|---|
| Zendesk AI agents | Centrais de ajuda do Zendesk, web crawler, conectores de conhecimento (até 50 fontes externas) | Central de ajuda pesquisada ao vivo. Fontes externas como na última sincronização, geralmente a cada 24 horas. O crawler atualiza a cada 30 minutos, o Confluence a cada 24 horas | Artigos restritos só chegam a clientes autenticados. Fontes demais podem reduzir a precisão e aumentar a latência |
| Freshdesk Freddy AI Agent | URLs, arquivos, artigos de soluções públicos, perguntas e respostas personalizadas, apps do Google Drive e SharePoint | Ressincronização manual, carimbo de data da última sincronização. Mudanças no SharePoint a cada 15 minutos, aproximadamente | Somente artigos públicos. URLs protegidas, artigos privados e texto em imagens ou tabelas são ignorados |
| Gorgias AI Agent | Guidance, artigos da central de ajuda, site da loja, URLs públicas, documentos | A ressincronização de site e URL é manual, uma vez a cada 24 horas | Somente páginas públicas. PDFs incorporados, vídeo e imagens não são extraídos. Rascunhos não são usados em respostas ao vivo |
| Help Scout Scout | Site de Docs, páginas do site, PDFs, arquivos Word e Excel, fontes de texto | O Docs permanece sincronizado. Sites precisam de ressincronização manual | Escolha páginas específicas, não sites inteiros. Arquivos do Google precisam ser compartilhados por link |
| HubSpot Customer Agent | Artigos e páginas da HubSpot, URLs públicas (até 5.000 relacionadas), arquivos | Artigos da HubSpot ressincronizam ao editar. Outras fontes, semanalmente | Fontes privadas não são citadas, mas ainda podem influenciar as respostas |
Zendesk. A documentação do Zendesk diz que uma central de ajuda conectada é pesquisada no momento da pergunta, enquanto as fontes externas estão como na última sincronização, geralmente a cada 24 horas. A lição prática é que uma edição num wiki externo não vai ao ar por um dia, e o web crawler roda com muito mais frequência que o conector do Confluence. Artigos restritos da central de ajuda só são usados quando o cliente está autenticado, e a documentação observa que você não pode testar respostas com conteúdo restrito no widget de teste. Se suas melhores respostas ficam atrás de um login, seu teste de lançamento não vai mostrar isso. Mais na minha visão geral do Zendesk AI.
Freshdesk. O guia de conhecimento do Freddy lista limites que vale a pena ler antes de conectar qualquer coisa: 10 URLs por agente, até 3.000 páginas por site, 200 arquivos por agente de 35 MB cada, e artigos de soluções apenas quando visíveis a todos os usuários. Artigos privados ou restritos são excluídos. Ele também oferece uma ferramenta útil de auditoria: depois de uma conversa, o painel de detalhes mostra de quais fontes o agente recuperou. Para o Confluence, o Freshdesk recomenda uma conta de serviço dedicada, porque, se o administrador da configuração perder o acesso, esses artigos são tratados como excluídos. Veja as fontes de conhecimento do Freddy e a integração da eesel com o Freshdesk.
Gorgias. O Gorgias diz que guidance tem mais peso entre seus tipos de conhecimento, o que faz de guidance o primeiro lugar para procurar conflitos com sua central de ajuda. As sincronizações do site da loja e de URLs são apenas de páginas públicas, não atualizam automaticamente e podem ser refeitas uma vez a cada 24 horas. Snippets extraídos de um site não podem ser editados, mas podem ser desativados se tiverem conteúdo desatualizado. O recurso Opportunities (beta) mostra lacunas e conflitos a partir de conversas reais, um atalho útil. Mais na análise do Gorgias AI Agent 2.0.
Help Scout. O Scout, o agente que nasceu do AI Answers, permanece sincronizado com seu site de Docs o tempo todo, mas fontes de sites precisam de ressincronização manual quando preços ou um processo mudam. O Help Scout também recomenda apontá-lo para as páginas específicas com suas melhores informações em vez de um site inteiro, e diz que imagens e vídeo não devem carregar sozinhos os passos importantes. Detalhes em IA para Help Scout e na integração da eesel com o Help Scout.
HubSpot. O Customer Agent ressincroniza artigos da base de conhecimento quando são editados e outras fontes semanalmente. A linha para ler duas vezes é a do conteúdo privado: fontes privadas não serão citadas, mas o conteúdo delas ainda pode aparecer nas respostas. Isso torna "escondido" um risco mais sutil, porque um documento interno que você conectou como referência ainda pode vazar sua redação. Veja HubSpot AI agent para um quadro mais amplo.
Verifique a cobertura com tickets reais
Ler artigos diz se eles estão certos. Os tickets dizem se são os artigos certos. Eu puxo os tickets dos últimos 90 dias e os agrupo por tema, depois dou a cada tema uma de quatro marcas.
- Coberto. Existe um artigo, está atual e concorda com o que os agentes realmente respondem.
- Parcial. Existe um artigo, mas ele responde a uma pergunta próxima ou omite a exceção que os agentes sempre mencionam.
- Em conflito. Duas fontes discordam, ou o artigo discorda do que os agentes enviam na prática.
- Ausente. Sem artigo. Os agentes respondem de memória ou com uma macro.
A resposta do agente é a evidência mais útil aqui. Quando seus melhores agentes acrescentam de forma consistente uma frase que o artigo não tem, essa frase é a lacuna. Uma gerente de suporte com quem conversei tinha uma central de ajuda escrita inteiramente para administradores, enquanto os tickets vinham de usuários finais. Nenhuma leitura artigo por artigo pega isso. Comparar com os tickets pega.
Classifique os resultados por volume. Temas do nível 1 com marca parcial ou ausente vão para o topo da lista de correções. Quanto a métodos, escrevi sobre mapear consultas para lacunas e o fluxo de análise de lacunas de conhecimento no Zendesk, e a implantação mais ampla pertence ao meu guia de erros de implementação.
Monte um conjunto de testes e defina regras de go-live
Defina a barra de aprovação antes de rodar o teste. Se você decidir depois, todo resultado parece aceitável.
Monte o conjunto com perguntas reais. Pegue de 50 a 100 mensagens reais de clientes, com mais peso nos níveis 1 e 2, e inclua algumas que a IA não deveria responder: um reembolso fora da política, uma pergunta jurídica, um pedido que exige consulta à conta. Para cada uma, escreva como é uma resposta correta ou um encaminhamento correto e nomeie o artigo de origem de onde ela deveria vir.
Pontue quatro coisas por resposta. Ela recuperou a fonte certa? A resposta estava correta? Estava completa, com as exceções incluídas? Escalou quando deveria? A última é a mais pulada, e se conecta à sua taxa de escalonamento e à sua taxa de contenção quando você estiver no ar.
Use as ferramentas de teste do fornecedor, dentro dos limites delas. O Help Scout tem uma área de Test, e o Gorgias permite testar rascunhos antes de publicar. O widget de teste do Zendesk não consegue testar respostas com conteúdo restrito.
Reproduza tickets antigos se sua ferramenta permitir. A habilidade Simulation da eesel puxa tickets antigos, gera respostas de IA, compara com o que humanos realmente enviaram, pontua a correspondência e produz um relatório de lacunas. É o mais próximo que conheço de testar com seus próprios dados sem que um cliente veja uma resposta errada. Meu post sobre testes de agentes de suporte com IA percorre um plano mais completo.
Regras de go-live que recomendo. São barras minhas, não um padrão de fornecedor, então ajuste ao seu risco:
- Temas dos níveis 1 e 2: zero respostas erradas no conjunto de testes, e todo caso incerto é encaminhado.
- Nível 3: pelo menos nove em dez respostas corretas, e todo erro encaminhado em vez de chutado.
- Sem conflitos em aberto no nível 1, e todo artigo do nível 1 verificado nos últimos 90 dias.
- Todo tema de alto volume coberto ou configurado para escalar.
- Um responsável nomeado para a revisão semanal após o lançamento.
O ciclo semanal depois do go-live
Uma auditoria de lançamento envelhece tão rápido quanto suas políticas. No primeiro mês rodo o mesmo ciclo curto toda semana, e depois o mantenho mensal e também sempre que uma política muda.
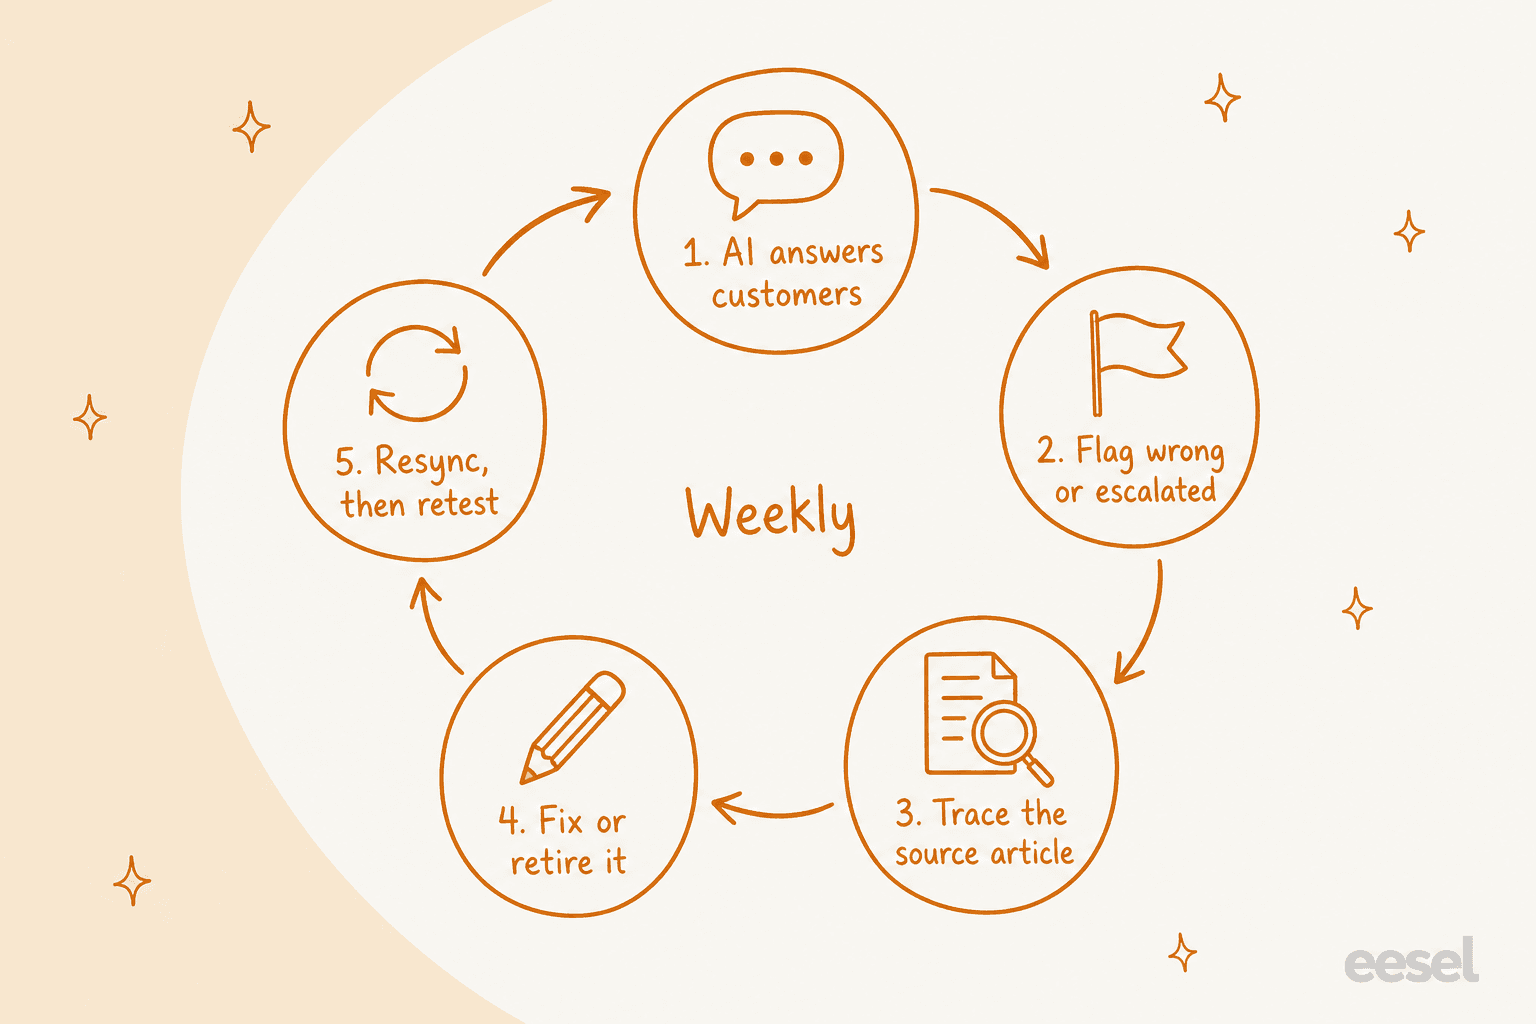
O ciclo semanal: ler o que a IA errou ou escalou, rastrear até uma fonte, corrigir, ressincronizar e então testar de novo.
- Puxe as conversas erradas e escaladas. No Help Scout, ordenar Reports > Scout por resolução mostra aquelas em que os clientes não foram ajudados. No Freshdesk, os detalhes da conversa mostram quais fontes foram usadas.
- Rastreie cada uma até uma fonte. Foi um conflito, um fato desatualizado, uma lacuna ou uma resposta escondida? Use os mesmos quatro rótulos para o padrão aparecer.
- Corrija ou aposente a fonte. Aposentar é melhor que remendar quando dois artigos se sobrepõem.
- Ressincronize. Este é o passo que as pessoas esquecem. Uma fonte de site do Gorgias, uma fonte de site do Help Scout e uma URL do Freshdesk precisam de atualização manual antes que a IA veja a edição.
- Teste de novo. Rode de novo as perguntas que falharam, mais um punhado do nível 1.
As métricas que vale acompanhar estão no meu guia de métricas de atendimento ao cliente com IA.
Como a eesel lida com a auditoria na prática
O colega de helpdesk com IA da eesel aprende com sua central de ajuda, seus tickets passados e documentos como Confluence e Google Docs, e então trabalha dentro do seu helpdesk atual. Dois clientes nomeados mostram como a auditoria fica no dia a dia.
- A SamCart roda agentes eesel separados nos tickets de e-mail do Freshdesk e no chat do site, ambos respondendo a partir de cerca de 280 artigos da central de ajuda. Os agentes são instruídos a linkar apenas artigos públicos, de modo que material interno mais antigo possa embasar uma resposta sem ser enviado a um vendedor. Quando um artigo descreve algo que não está mais disponível, a equipe adiciona uma correção e o agente para de oferecê-lo. Essa é a correção do desatualizado, feita sem reescrever o artigo inteiro.
- A Rúngne roda três agentes no Gorgias, divididos por função. Um faz triagem e etiquetas, outro redige respostas para pessoas enviarem, e outro responde sozinho perguntas simples de política e rastreamento. Cancelamentos, danos e pacotes perdidos ficam com a equipe. A lista de temas é o controle.
O padrão é o mesmo: decidir quais temas a IA pode responder, manter dinheiro e julgamentos com pessoas e tratar as correções como hábito. Meu post sobre como treinar um agente de suporte com IA e o guia de base de conhecimento com IA cobrem a parte de construção.
Experimente a eesel
A auditoria decide se sua central de ajuda está pronta. O teste decide se ela está pronta o bastante. Se quiser rodar esse teste nos seus próprios tickets, o colega de helpdesk com IA da eesel se conecta ao Zendesk, Freshdesk, Gorgias, Help Scout ou HubSpot, aprende com sua central de ajuda e tickets passados e pode ser reproduzido em conversas antigas antes de responder a um cliente. O preço é por plano, e você pode ver os planos e começar grátis.
Experimente a eesel grátis, ou agende uma demo e eu mostro como ela lida com os seus próprios tickets.