

Adicione llms.txt à sua central de ajuda se sua plataforma tiver um botão para isso, mas não espere tráfego de busca por causa dele. É um mapa para agentes de IA que alguém envia ao seu site, não um sinal de ranking: o Google diz que seus recursos de IA não o usam, e operadores que registram seu tráfego veem rastreadores de IA ignorá-lo. GitBook, Mintlify, Document360, ReadMe e HelpDocs geram um. Zendesk, Help Scout e Freshdesk não, então você gera um arquivo curado e o hospeda você mesmo. Uma IA de suporte conectada ao seu helpdesk, como a eesel, lê seus artigos diretamente e não precisa do arquivo de forma alguma.
O que é llms.txt, em termos de central de ajuda?
llms.txt é um arquivo markdown simples que lista suas páginas mais úteis, com uma nota de uma linha em cada uma, para que um agente de IA encontre o artigo certo sem precisar passar por menus de navegação e avisos de cookies. Jeremy Howard publicou a proposta em setembro de 2024, e a versão 2 chegou em agosto de 2026. O próprio argumento da especificação é que "o arquivo em si permanece pequeno o suficiente para caber no contexto" enquanto o detalhe vive por trás dos links.
Eu construo agentes de IA na eesel, e o mecanismo é mais simples do que a maioria dos guias faz parecer. Um agente (Claude Code, Cursor, uma sessão do ChatGPT em que alguém colou sua URL) busca /llms.txt, lê a lista, escolhe os links que correspondem à pergunta, e abre essas páginas. Se cada link apontar para uma versão markdown limpa do artigo, o agente obtém a resposta sem precisar analisar seu tema visual. Não acontece mais nada.
O formato tem uma parte obrigatória e algumas opcionais, segundo a especificação do formato llms.txt:
- Um H1 com o nome do site. "Esta é a única seção obrigatória."
- Um resumo em bloco de citação que diz ao agente o que a central de ajuda cobre.
- Texto livre com quaisquer notas sobre como ler o arquivo.
- Seções H2 de links, cada linha como
[nome](url): descrição. - Uma seção
## Optionalpor convenção, para links que um agente pode pular quando estiver com pouco espaço. A versão 2 removeu qualquer significado especial de análise para ela, segundo a página de mudanças.
Dois detalhes importam especificamente para centrais de ajuda. Primeiro, um arquivo cobre as URLs sob seu caminho, então uma central de ajuda que vive em yourcompany.com/help pode ter seu próprio /help/llms.txt. Segundo, a especificação pede versões markdown de cada página na mesma URL com .md adicionado. A maioria das centrais de ajuda hospedadas por um helpdesk não as serve, o que afeta qual caminho de configuração você escolhe abaixo.
Se você quiser o panorama maior de quem lê uma central de ajuda hoje (mecanismos de busca, mecanismos de resposta de IA, agentes de codificação, seu próprio bot de suporte), meu checklist de legibilidade para IA cobre os ajustes de artigos que vêm antes de tudo isso.
O llms.txt realmente ajuda uma central de ajuda?
Ele ajuda um tipo de leitor e não faz nada por outro. Aqui está o que as fontes primárias dizem, objetivo por objetivo:
| O que você quer | O llms.txt ajuda? | A evidência |
|---|---|---|
| Ranking mais alto no Google | Não | O Google diz que você pode ignorar "arquivos de texto de IA desnecessários (como llms.txt)" (guia de otimização para IA) |
| Aparecer nos AI Overviews ou no AI Mode | Não | "Não há requisitos técnicos adicionais" além de estar indexado com um snippet (recursos de IA do Google) |
| Citações em respostas do ChatGPT ou Claude | Não comprovado | Operadores com logs de servidor relatam que rastreadores de IA não o buscam (citações abaixo) |
| Um agente de codificação configurando seu produto | Sim | A especificação diz que agentes "seguem os links relevantes"; este é seu uso mais intenso |
| Um agente encontrando uma resposta em uma central de ajuda grande | Sim, se o arquivo for curado | Um índice curto cabe no contexto; 4.000 links não cabem |
| Substituir seu sitemap | Não | A especificação chama sitemaps de lista completa e llms.txt de "uma visão curada" |
O Google é incomumente direto sobre isso. Seu guia de IA generativa diz que você não precisa de "novos arquivos legíveis por máquina, arquivos de texto de IA, marcação ou Markdown para aparecer na Busca Google", porque "a própria Busca Google não os usa". A auditoria de llms.txt do Lighthouse do Chrome marca um arquivo ausente como não aplicável, "já que fornecer o arquivo é opcional no momento", e só avisa quando a requisição retorna um erro de servidor.
A adoção ainda é pequena. O HTTP Archive Web Almanac 2025 encontrou llms.txt em 2,13% dos sites desktop e 2,10% dos sites mobile em seu rastreamento de julho de 2025, e 39,6% desses arquivos vieram de um único plugin de SEO do WordPress, então uma parte deles nunca foi uma escolha deliberada.
Os relatos de logs de servidor combinam com isso:
"I can definitively say llms.txt is not used by any AI players. I run a blogging platform with around 80k blogs and /llms.txt is not requested by anything (other than humans checking to see if there's an llms.txt path)."

O argumento a favor vem de pessoas que entregam o arquivo a um agente de propósito:
"It's a single link you can give your AI agent and ask to "read this, understand it does, implement it"."
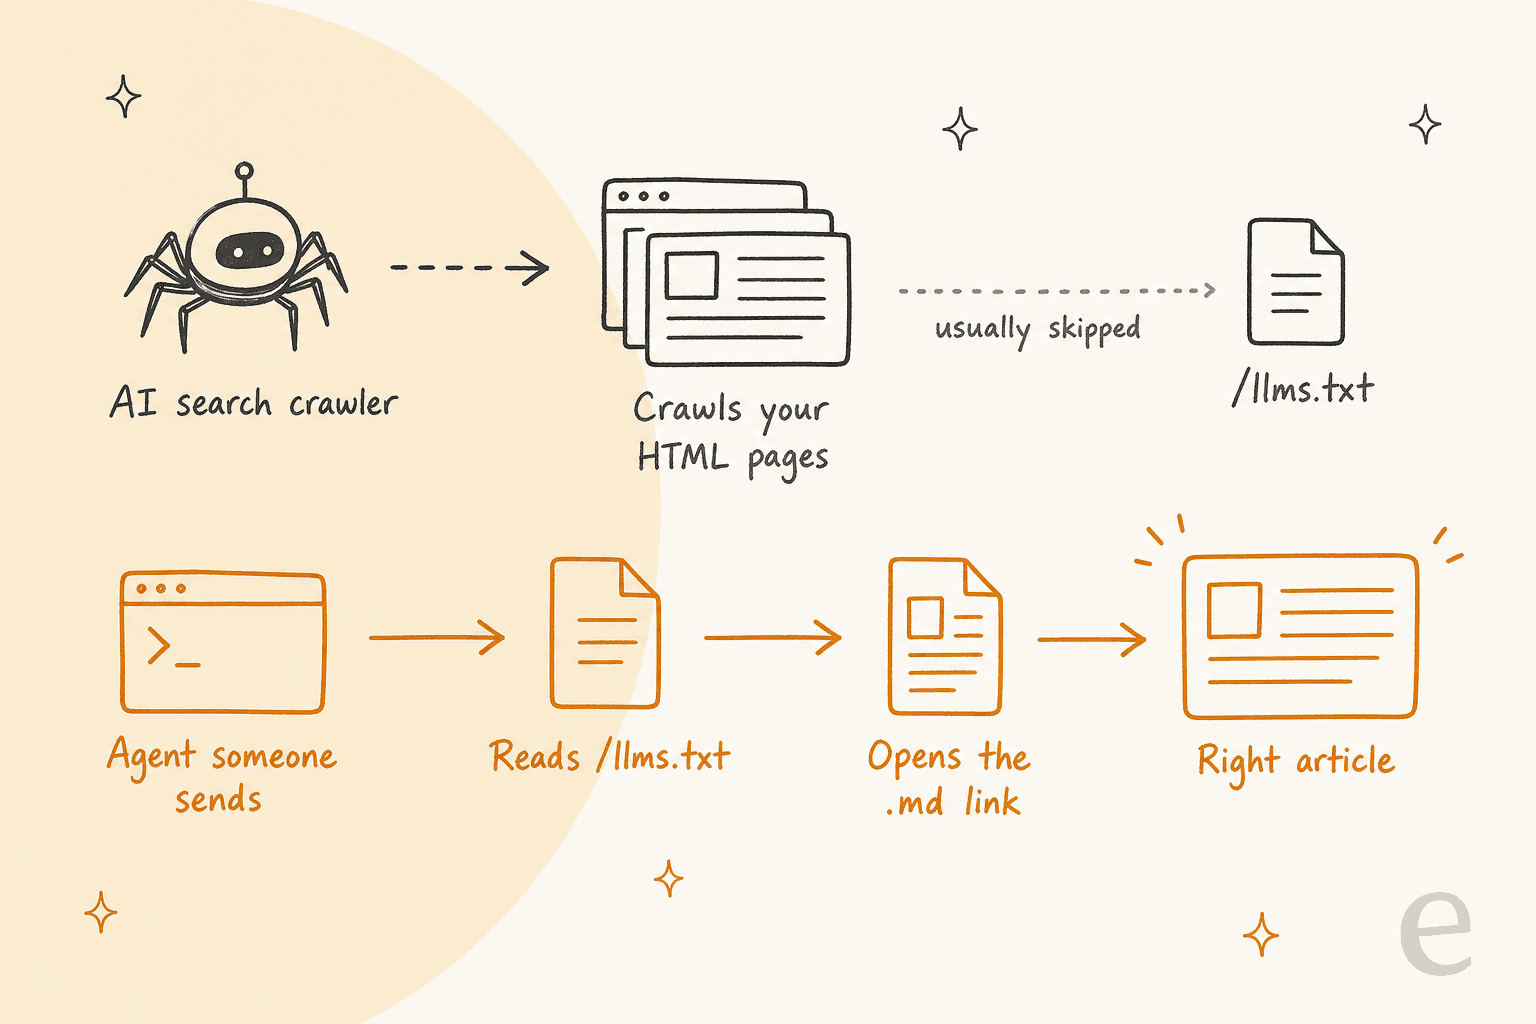
Então o veredito honesto: llms.txt é buscado por agentes que vêm procurar, não empurrado para índices de busca. Para uma central de ajuda, esse leitor é um desenvolvedor conectando sua API, um cliente que colou a URL da sua ajuda em um assistente de IA, ou o agente de um parceiro verificando sua política de reembolso. Se nada disso importa para você, invista a hora nos seus artigos. Se você tem curiosidade sobre como os mecanismos de resposta de IA escolhem fontes, minha explicação sobre mecanismos de busca com IA cobre esse lado.
Quais plataformas de central de ajuda podem publicar /llms.txt?
Essa é a pergunta que a maioria dos guias de llms.txt deixa de lado, e ela decide quanto trabalho vai te dar. Sua plataforma de central de ajuda cai em um de três grupos.
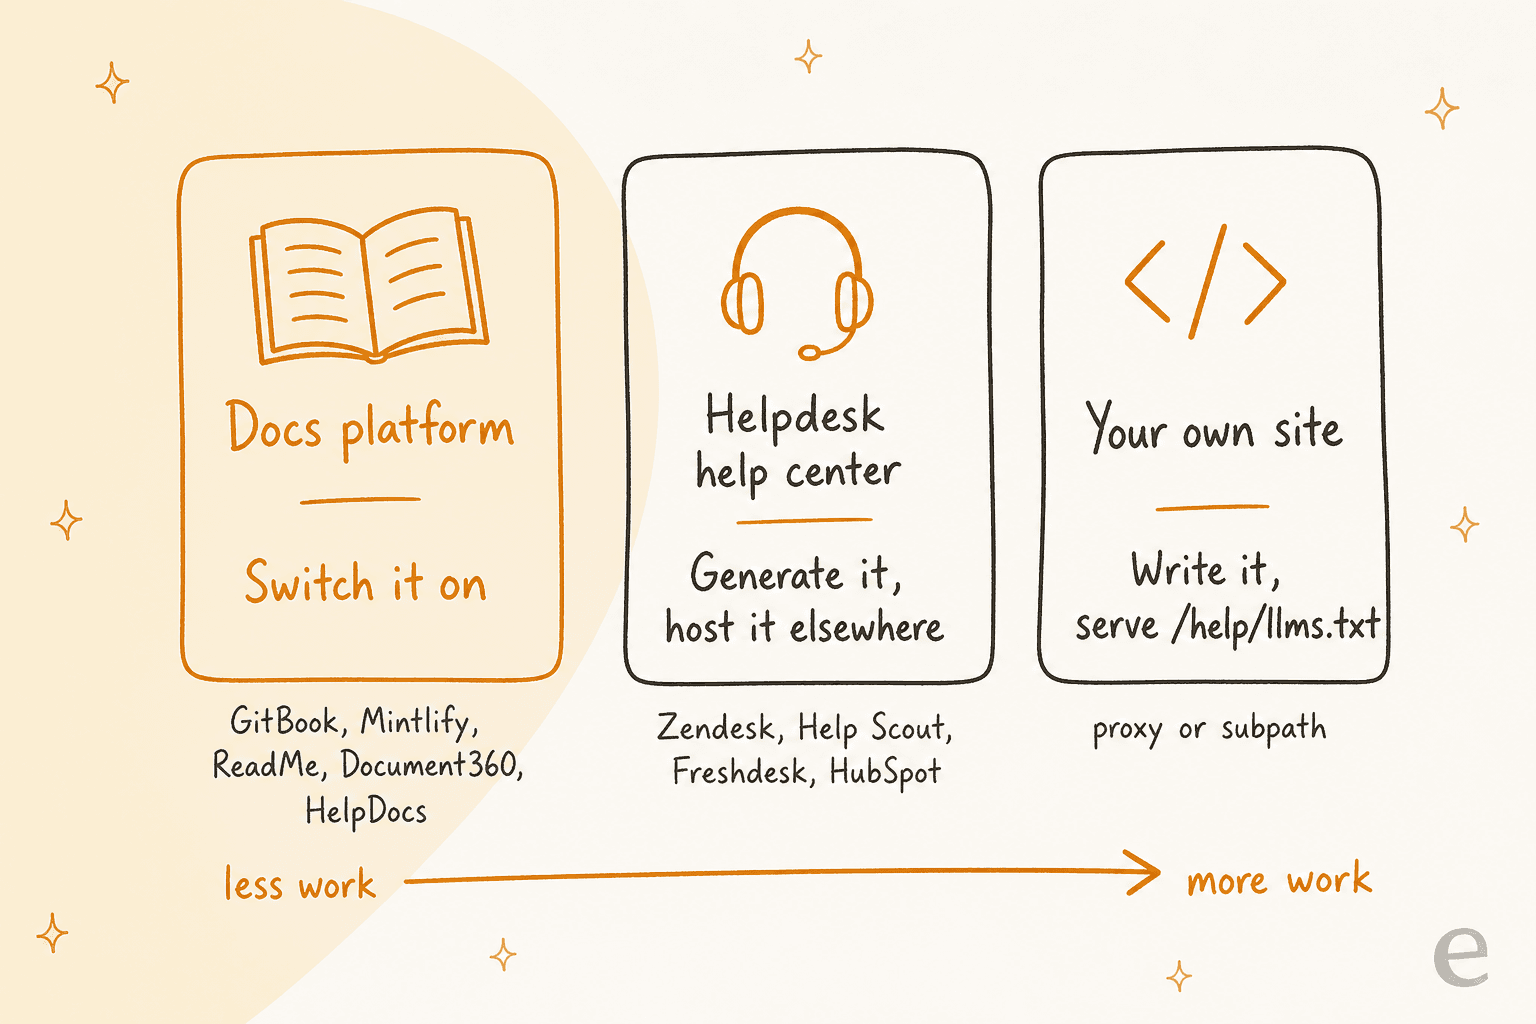
Conferi a documentação de cada fornecedor em 17 de novembro de 2026. Veja como as coisas estão:
| Plataforma | llms.txt | llms-full.txt | Controle de curadoria | Fique atento a |
|---|---|---|---|---|
| GitBook | Automático, em todos os planos incluindo o Free | Sim | Não documentado | Páginas ocultas permanecem no llms-full.txt |
| Mintlify | Automático, também em /.well-known/llms.txt | Sim | Páginas ocultas e noindex excluídas; um arquivo personalizado sobrescreve | Arquivo gerado limitado a 100.000 caracteres, depois dividido |
| ReadMe | Ativado por padrão, todos os planos | Não documentado | Páginas ocultas excluídas; arquivo personalizado permitido | Um arquivo personalizado para a atualização automática |
| Document360 | Automático, reconstruído a cada publicação | Não documentado | Excluir um artigo dos mecanismos de busca também o remove do llms.txt | Artigos sem descrição aparecem só pelo título |
| HelpDocs | Botão em Settings, AI, todos os planos | Não documentado | Não documentado | Centrais de ajuda privadas não geram arquivo |
| Zendesk Guide | Sem opção nativa | Via um app do Marketplace | O app pode excluir categorias, seções, etiquetas | Você hospeda o arquivo você mesmo |
| Help Scout Docs | Nenhuma menção na documentação | Não | n/a | Gere e hospede você mesmo |
| Freshdesk | Nenhuma menção na documentação | Não | n/a | Gere e hospede você mesmo |
| Base de conhecimento da HubSpot | Nenhuma menção na documentação | Não | n/a | Gere e hospede você mesmo |
As fontes de cada linha estão vinculadas nas seções abaixo.
Plataformas de documentação que constroem para você
Se sua central de ajuda roda em uma plataforma de documentação, o trabalho está majoritariamente feito. A documentação do GitBook diz que ele "publica automaticamente formatos amigáveis para IA", incluindo llms.txt, llms-full.txt e versões .md de cada página. Uma pegadinha fácil de perder: "Hiding a page only removes it from the published table of contents", então uma página oculta ainda fica no llms-full.txt. Despublique tudo que você não quer que agentes leiam. Minha análise de preços do GitBook cobre qual plano você precisa para um domínio personalizado.
O Mintlify te dá o maior controle. Ele exclui páginas ocultas e noindex, permite que você coloque seu próprio llms.txt para sobrescrever o gerado, e em sites parcialmente autenticados lista apenas páginas públicas para visitantes anônimos.
A página de llms.txt do ReadMe é direta sobre o que o arquivo pode e não pode fazer: "think of LLMs.txt as control over what an agent finds when it looks, not a guarantee that it will."
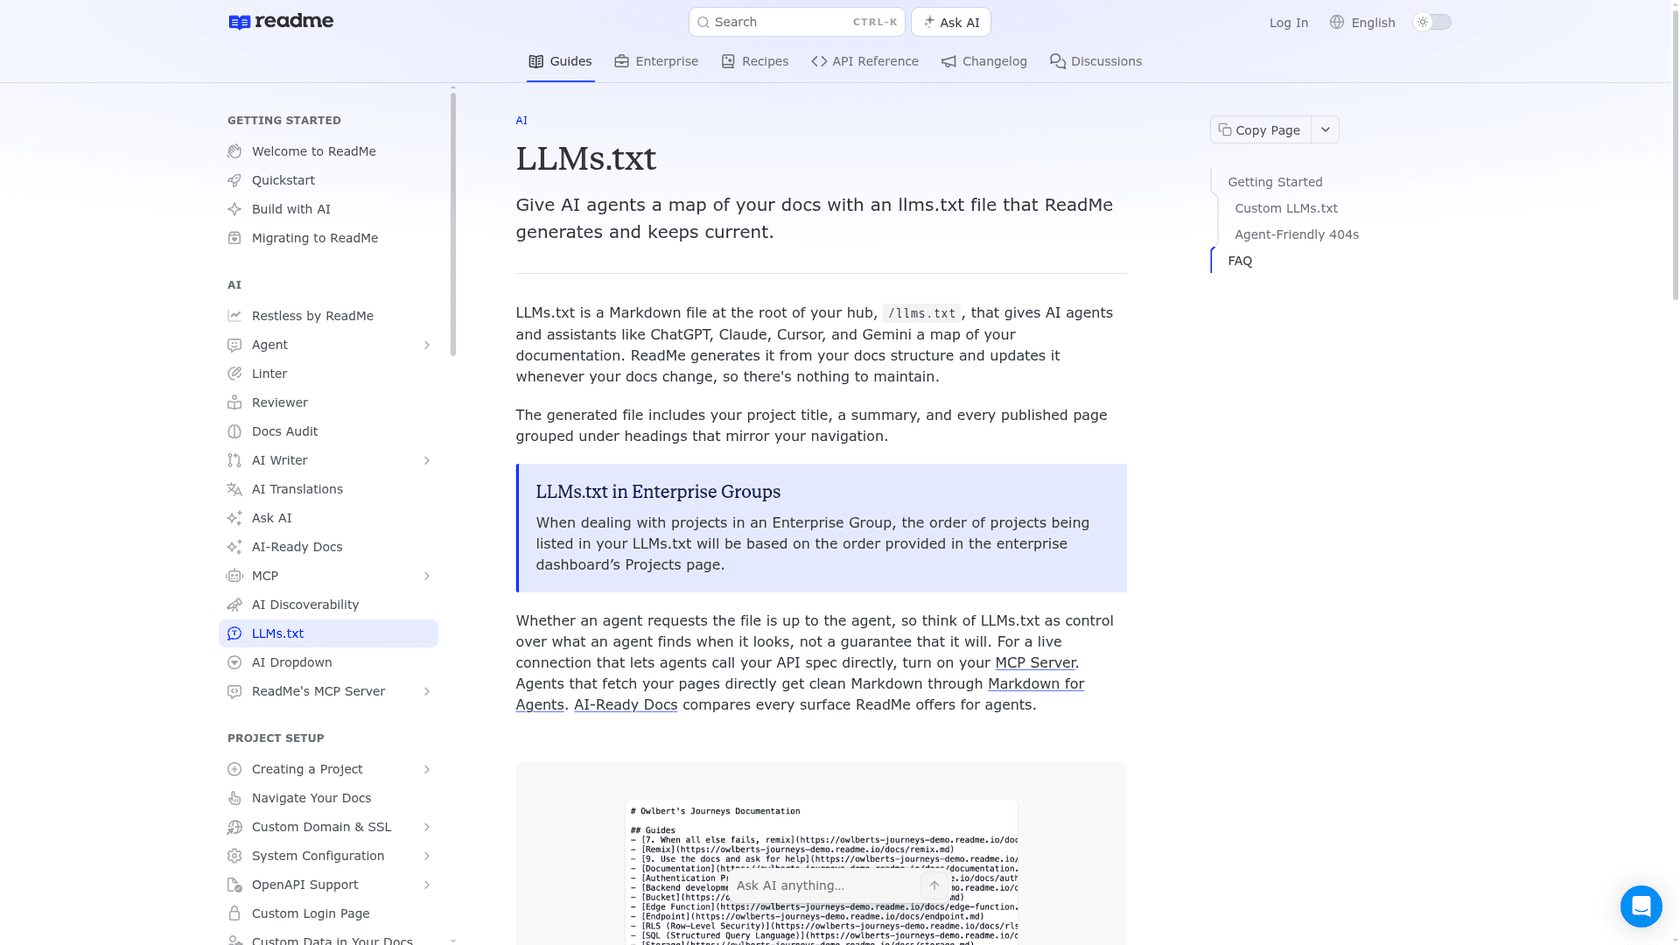
O Document360 constrói o arquivo a partir do seu conteúdo publicado e o atualiza "whenever you publish, update, or remove content." As descrições vêm da descrição de busca de cada artigo, então um artigo sem descrição aparece só com o título puro, o que dá a um agente quase nada para escolher. Se você estiver comparando fornecedores de base de conhecimento nisso, minha lista de alternativas ao Document360 é um bom ponto de partida.
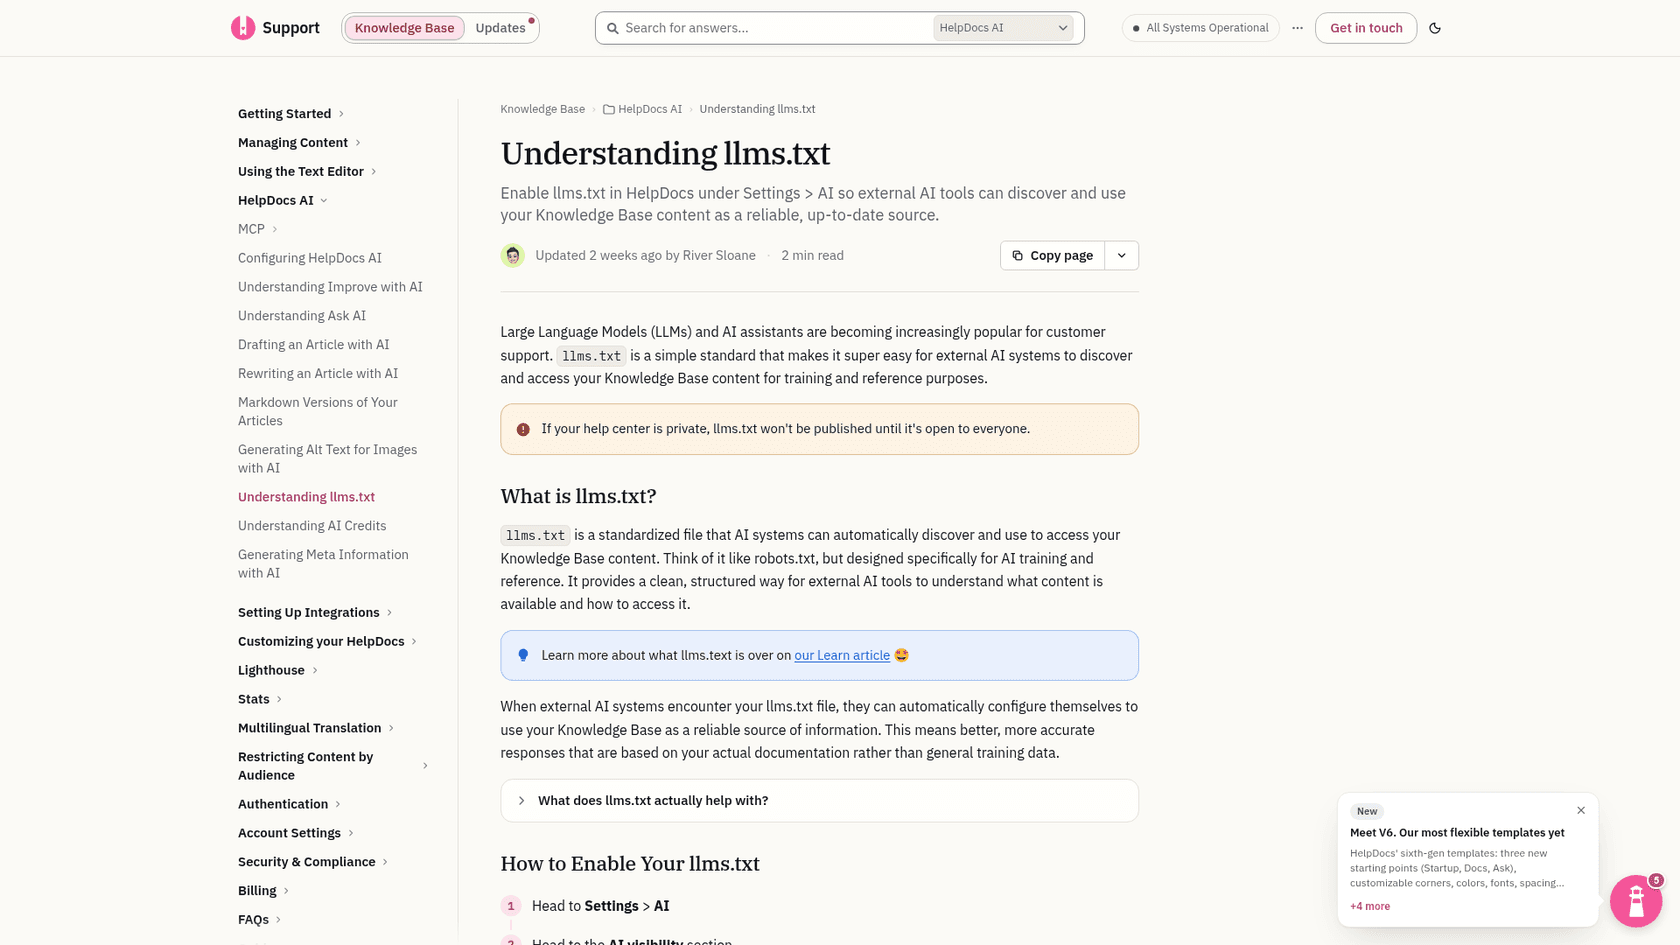
O HelpDocs é a adição mais recente. Sua atualização de 14 de outubro de 2026 tornou artigos em markdown e llms.txt "available now, on every plan", e você ativa isso em Settings, AI, AI visibility.
Centrais de ajuda de helpdesk que (ainda) não fazem isso
As centrais de ajuda agrupadas com helpdesks são uma história diferente. Pesquisei a documentação do Zendesk Guide, Help Scout Docs, Freshdesk, base de conhecimento da HubSpot, Helpjuice e Zoho Desk por um recurso de llms.txt e não encontrei nenhum. Também solicitei /llms.txt na própria central de ajuda de cada fornecedor em 17 de novembro de 2026:
| Central de ajuda | /llms.txt em 17 de nov. de 2026 |
|---|---|
| support.zendesk.com | 404 |
| docs.helpscout.com | 404 |
| support.freshdesk.com | 404 |
| knowledge.hubspot.com | 404 |
| docs.gorgias.com | 200, com links de artigo .md |
| help.shopify.com | Redirecionamento 308 para um guia para agentes |
O Gorgias é o caso atípico interessante: sua própria central de ajuda serve um arquivo com links .md, mas não consegui encontrar um artigo de ajuda que o ofereça como recurso para clientes, então verifique sua própria central de ajuda do Gorgias antes de contar com isso.
Para o Zendesk, os limites estão documentados. O Guide permite que você faça upload de arquivos .txt como recursos de tema, mas eles vivem em um caminho de CDN, não em /llms.txt. O mapeamento de host aponta support.yourcompany.com para o Zendesk com um CNAME, e isso é tudo o que muda. Meu guia de subdomínio vs. domínio personalizado cobre essa configuração com mais detalhes.
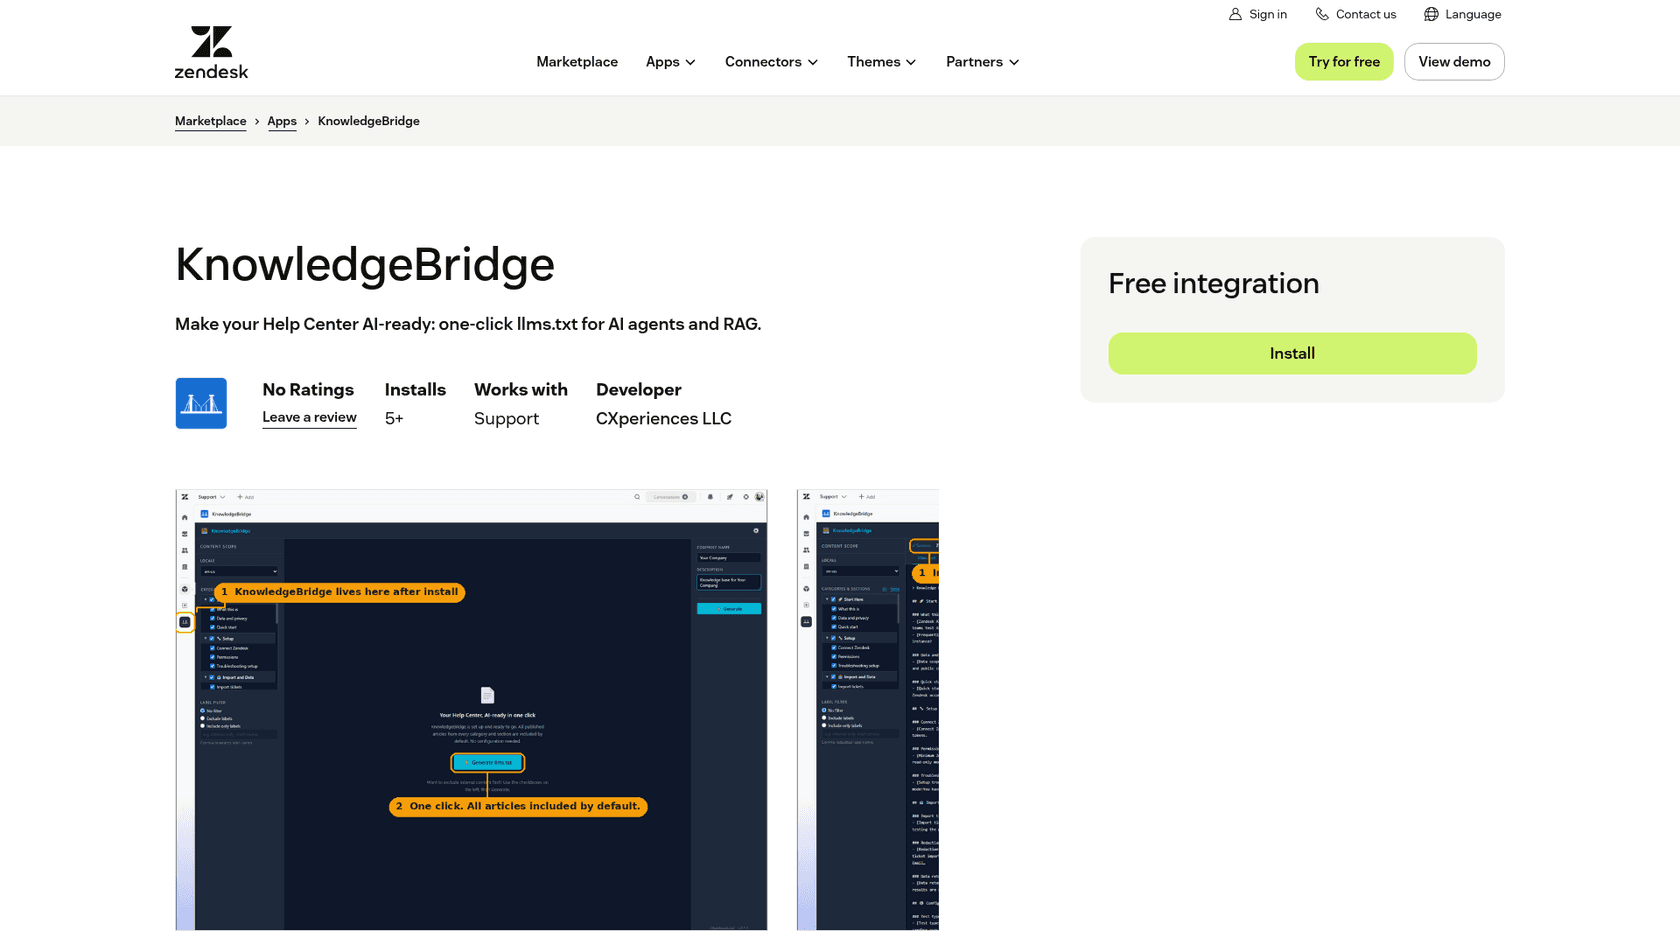
O mais próximo de uma opção nativa é o KnowledgeBridge, um app gratuito do Marketplace da CXperiences LLC com mais de 5 instalações. Ele constrói llms.txt e llms-full.txt a partir da sua central de ajuda e pode pular categorias, seções ou artigos rotulados, mas a saída é um download. Seus próprios passos de configuração dizem para você hospedar os arquivos no seu domínio.
Como você adiciona llms.txt ao Zendesk, Help Scout ou Freshdesk?
Você gera o arquivo em outro lugar e o hospeda onde controla a raiz. Aqui está a configuração que eu usaria, do início ao fim, em cerca de uma hora para uma central de ajuda de algumas centenas de artigos.
- Escolha onde o arquivo vai viver. A opção fácil é seu site principal:
yourcompany.com/llms.txtcom uma seção## Help centerque vincula aos artigos da sua central de ajuda. Se seu site de marketing já tem um llms.txt (plugins de SEO do WordPress costumam gerar um), adicione a seção a esse arquivo em vez de criar um segundo. A opção mais forte, se sua central de ajuda estiver sob um subcaminho comoyourcompany.com/helpatravés de um proxy reverso, é/help/llms.txt, já que a especificação diz que o arquivo mais específico vence. - Obtenha a lista de artigos públicos. O endpoint List Articles do Zendesk funciona sem login, e "the response lists only the articles that the requesting agent, end user, or anonymous user can view", então uma chamada anônima não pode expor um artigo restrito. Meu passo a passo da API de artigos cobre a paginação. Para o Freshdesk, a API de base de conhecimento faz o mesmo trabalho, e o Help Scout tem sua própria API de Docs.
- Selecione e descreva. Se preferir trabalhar em uma planilha, comece a partir de uma exportação da central de ajuda. Pegue os 30 a 100 artigos que respondem à maioria dos seus tickets, agrupe-os sob seus nomes de categoria reais, e escreva uma linha por artigo que diga qual pergunta ele responde.
- Faça upload e vincule. Coloque o arquivo no seu site principal e vincule-o do rodapé da sua central de ajuda, para que humanos (e agentes que começam na sua central de ajuda) o encontrem.
- Teste-o como a especificação diz. "Test your file by asking an agent questions about your content, giving it only your llms.txt as a starting point", segundo llmstxt.org. Faça as cinco perguntas que sua equipe mais responde e verifique qual artigo o agente abre.
Para o passo 2 no Zendesk, isto puxa os artigos públicos em inglês, mais recentes primeiro, como linhas de lista prontas para editar:
curl -s "https://support.yourcompany.com/api/v2/help_center/en-us/articles.json?per_page=100&sort_by=updated_at&sort_order=desc" \
  | jq -r '.articles[] | select(.draft == false) | "- [\(.title)](\(.html_url)): "'
Cole a saída no seu modelo e preencha as descrições manualmente. Para ver por que a curadoria importa no Zendesk: a mesma chamada contra a própria central de ajuda do Zendesk relatou 4.687 artigos em inglês em 17 de novembro de 2026. Ninguém quer um agente lendo essa lista.
Duas pegadinhas específicas do Zendesk. Se você restringir artigos com segmentos de usuário, a chamada anônima os descarta silenciosamente, que é o que você quer, mas confira isso antes de adicionar qualquer artigo manualmente. E se você administra várias centrais de ajuda de marca, dê a cada marca sua própria seção, ou seu próprio arquivo por domínio de marca, para que um agente não misture duas políticas de devolução.
Como deveria ser o llms.txt de uma central de ajuda?
Curto, agrupado pelas perguntas que os clientes fazem, e escrito para um leitor sem contexto. Aqui está um modelo que você pode copiar:
# Acme Help Center

> Official help for Acme customers: setting up an account, billing and invoices,
> shipping and returns, and connecting Acme to other tools. Answers here are
> current; if an article and an old blog post disagree, the article wins.

Articles are written for customers, not admins. For API reference, see
https://developers.acme.com/llms.txt. To reach a person, see "Contact support" below.

## Getting started

- [Create your Acme account](https://help.acme.com/en-us/articles/101): Sign-up steps, email verification, and what the free trial includes.
- [Invite your team](https://help.acme.com/en-us/articles/102): Adding users, roles and seat limits.

## Billing

- [Change or cancel your plan](https://help.acme.com/en-us/articles/201): Upgrades, downgrades, cancellation and when changes take effect.
- [Refund policy](https://help.acme.com/en-us/articles/202): Who qualifies for a refund, the 30-day window, and how to request one.

## Shipping and returns

- [Start a return](https://help.acme.com/en-us/articles/301): The returns portal, return labels and what items can't be returned.

## Contact support

- [Contact support](https://help.acme.com/en-us/articles/401): Hours, channels and what to include so we can help faster.

## Optional

- [Release notes](https://help.acme.com/en-us/articles/501): Product changes by month.
- [Full sitemap](https://help.acme.com/sitemap.xml): Every public article.
Algumas escolhas aí são deliberadas:
- O bloco de citação diz ao agente qual fonte vence. O conteúdo de suporte se contradiz entre posts de blog, macros antigas e artigos arquivados. Uma linha dizendo que a central de ajuda é a fonte atual evita que um agente cite um post de blog de 2023.
- As descrições nomeiam a pergunta, não o tópico. "Who qualifies for a refund, the 30-day window, and how to request one" permite que um agente combine com a pergunta de um cliente. "Refund information" não faz isso. É o mesmo trabalho de escrever boas meta descrições, e você muitas vezes pode reaproveitá-las.
- Contato com suporte tem sua própria seção. A central de ajuda da Shopify faz algo parecido: seu arquivo pede que agentes respondam primeiro a partir de artigos atuais e leiam um guia de suporte antes de contatar o suporte em nome de um comerciante.
- A documentação para desenvolvedores recebe um apontador, não uma fusão. Se você tem uma API, vincule o próprio llms.txt dela em vez de amontoar endpoints no arquivo da central de ajuda.
Você deveria listar todos os artigos ou curar?
Curar. Todo o sentido da especificação é um arquivo que caiba no contexto de um agente, e uma lista completa de artigos de uma central de ajuda madura não cabe. Veja o que três arquivos reais de central de ajuda pesavam quando os busquei em 17 de novembro de 2026:
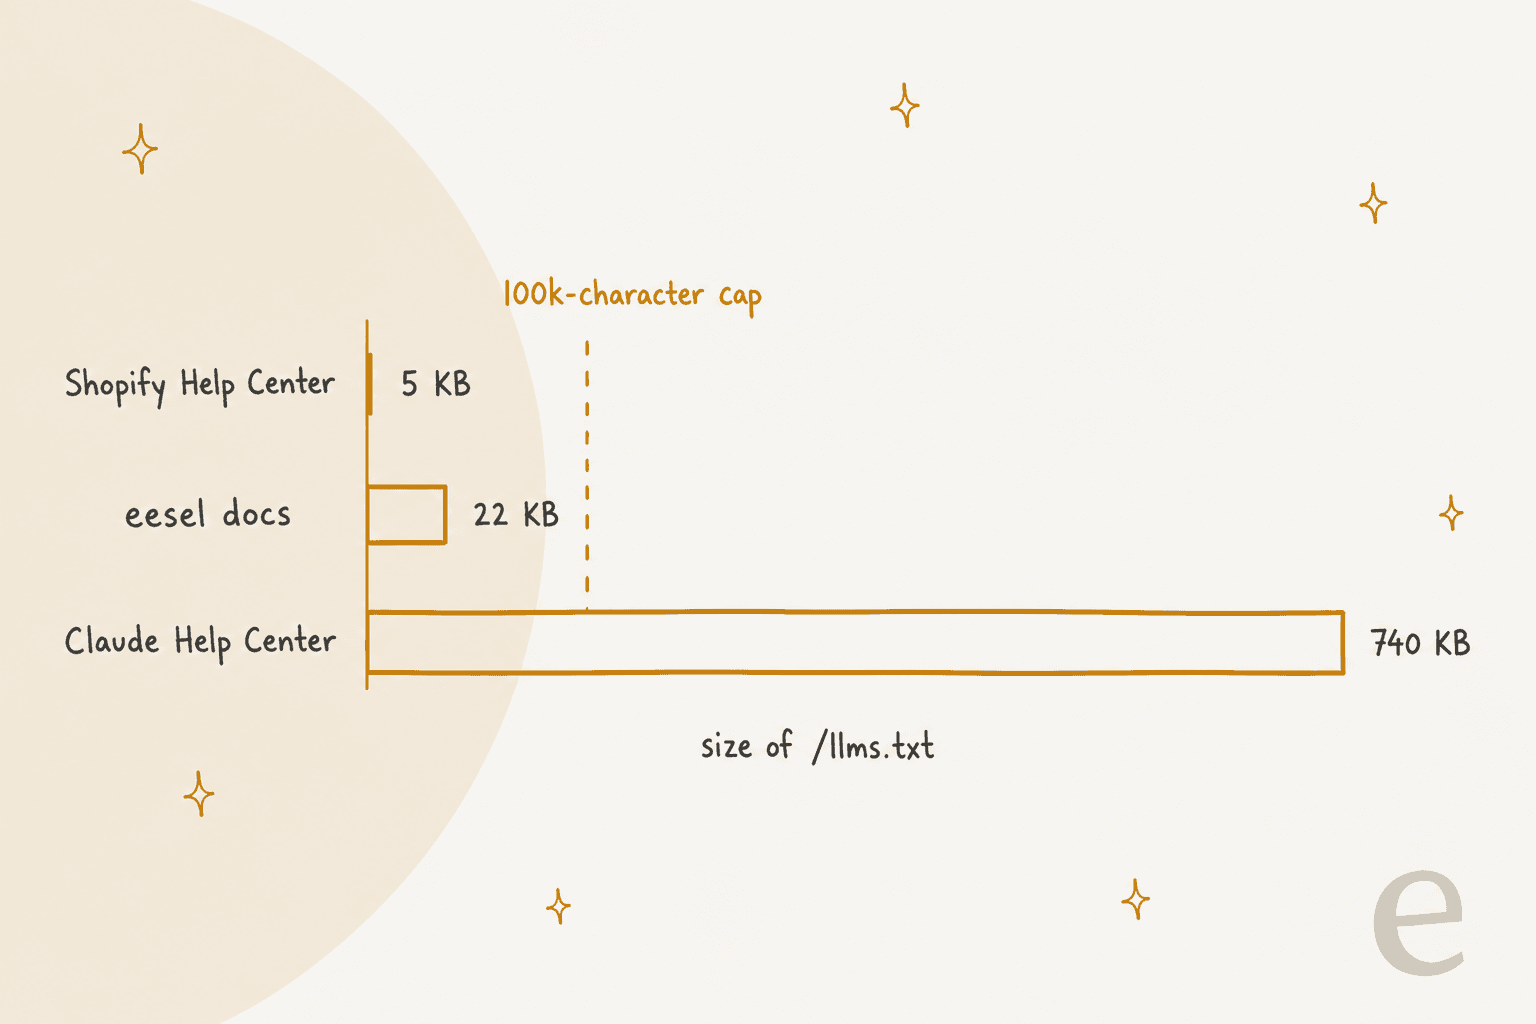
- Central de ajuda da Claude: 740 KB, 4.528 links. Cada artigo, repetido em mais de 10 seções de idioma.
- Documentação própria da eesel: 22 KB, 86 links, cada um com uma descrição de uma linha. É gerada pelo GitBook e cobre toda a central de ajuda da eesel, que é pequena porque a documentação do produto é pequena.
- Central de ajuda da Shopify: 5 KB e nenhuma lista de artigos. É um guia para agentes: como obter qualquer página em markdown, como as URLs funcionam, e onde fica o sitemap em markdown.
Para comparação, o Mintlify limita seu llms.txt gerado a 100.000 caracteres antes de dividi-lo em índices menores, segundo sua documentação de llms.txt. O ReadMe oferece uma opção "Summarize Index" pelo mesmo motivo, segundo sua página de AI Discoverability.
Depois tem o llms-full.txt, o arquivo único com o texto completo de cada página. Ele não está na especificação atual de forma alguma; a página de mudanças diz que a ferramenta de expansão de contexto "is no longer part of the proposal." GitBook e Mintlify ainda assim produzem um, e o da eesel chega a 1,3 MB. Isso é útil para um desenvolvedor que quer baixar sua documentação para um repositório, mas grande demais para um agente tentando responder a uma única pergunta de reembolso.
Minha regra geral: abaixo de cerca de 100 artigos, liste todos com descrições. Acima disso, liste os 30 a 100 principais por volume de tickets, e aponte para seu sitemap em ## Optional quanto ao resto, do jeito que a Shopify aponta agentes para seu sitemap em markdown. Para descobrir quais artigos carregam o peso, mapear consultas de busca e verificar quais seus agentes mais vinculam é mais rápido do que adivinhar.
Como você mantém o llms.txt atualizado?
Um llms.txt desatualizado é peor que nenhum, porque ele manda agentes com confiança para artigos movidos ou excluídos. O quanto de trabalho isso dá depende do caminho de configuração:
- Arquivos gerados se atualizam sozinhos. Document360 e ReadMe reconstroem a cada publicação, e o Mintlify chama sua versão de "always up to date."
- Arquivos personalizados congelam. O ReadMe diz claramente que com um arquivo personalizado "your llms.txt will no longer be updated automatically." O Mintlify restaura a versão gerada se você excluir a sua, então você sempre pode voltar atrás.
- Arquivos auto-hospedados precisam de um cronograma. Como qualquer processo de base de conhecimento autoatualizável, execute novamente a extração de artigos mensalmente, ou sempre que reorganizar categorias. Um pequeno job agendado que compara a nova lista com a antiga e sinaliza URLs removidas captura a maioria das quebras.
Toda vez que você regenerar, verifique os links. Esta linha única imprime qualquer URL no arquivo que não retorne 200:
grep -oE 'https://[^)]+' llms.txt | while read u; do
  code=$(curl -s -o /dev/null -w '%{http_code}' -L "$u"); [ "$code" != "200" ] && echo "$code $u"
done
Artigos movidos geralmente são o culpado. Os redirecionamentos do Zendesk para artigos movidos mantêm os links antigos funcionando para humanos, mas um arquivo curado deveria apontar para a URL atual para que o agente não desperdice um salto. Se artigos desatualizados são um problema recorrente, meu guia para detectar conteúdo desatualizado cobre como capturá-los antes que cheguem a qualquer leitor, humano ou IA.
Para centrais de ajuda localizadas, decida por idioma. Uma central de ajuda multilíngue pode ter um arquivo por idioma, ou um arquivo com o idioma padrão e uma nota sobre como as URLs de idioma funcionam, que é o que a Shopify faz.
Como você sabe se algo está lendo?
Confira seus logs, porque os painéis não vão te dizer. Filtre os logs do seu servidor web ou CDN por requisições a /llms.txt e olhe os user agents. Duas das plataformas de documentação fazem isso por você: o HelpDocs mostra requisições de ferramentas de IA reconhecidas em sua aba de estatísticas de IA, e o GitBook tem um relatório Agents & MCP.
Ajuste suas expectativas com pessoas que já olharam:
"What I've seen from ASNs is that visits are coming from GOOGLE-CLOUD-PLATFORM (not from Google itself), and OVH. Based on UA, users are: WebPageTest, BuiltWith, and zero LLMs based on both ASN and UA."
As visitas que vale a pena contar são as iniciadas pelo usuário, como o ChatGPT-User da OpenAI, que sua documentação de rastreadores descreve como visitas que uma pessoa dispara em vez de rastreamento automático, mais requisições de ferramentas de codificação. Esses são os leitores para quem o llms.txt existe. Se o número continuar perto de zero depois de um trimestre, essa é sua resposta para essa central de ajuda, e a hora é melhor investida nos próprios artigos, ou em um servidor MCP, que responde a perguntas em tempo real em vez de entregar uma lista estática.
Sua IA de suporte precisa de llms.txt?
Não, se ela se conectar ao seu helpdesk. O llms.txt existe para agentes externos que só têm sua URL. Sua própria IA de suporte não deveria ser uma delas: ela deveria ler cada artigo público diretamente, além das macros e tickets anteriores que nunca chegam à central de ajuda.
É assim que funciona o colega de equipe de IA para helpdesk da eesel. Ele se conecta ao Zendesk, Freshdesk, Help Scout, HubSpot ou Gorgias, sincroniza a central de ajuda como fonte de conhecimento, e redige ou envia respostas com o artigo usado vinculado. A Dokument 24, um serviço dinamarquês de documentos jurídicos no Zendesk, o roda sobre cerca de 1.900 páginas do seu site e 640 tickets e artigos do Zendesk, e entre 8 de agosto e 8 de setembro de 2026 preparou cerca de 680 tickets com rascunhos de resposta em dinamarquês para a equipe enviar.
A parte que o llms.txt não consegue corrigir é o que os artigos dizem. Em uma chamada de vendas da eesel com a qual aprendi, uma equipe dinamarquesa de telemática veicular no Zendesk descreveu um bot confirmando suporte para marcas de carro que eles não suportavam, porque um artigo dizia que eles suportavam "todos os modelos". Um llms.txt perfeitamente curado teria apontado direto para esse artigo. O conserto foi a frase, não o índice, por isso uma auditoria de base de conhecimento costuma ser melhor do que um arquivo novo. Se você está pesando RAG versus fine-tuning para sua central de ajuda, o mesmo ponto se aplica: a recuperação só retorna o que o artigo diz.
eesel: deixe sua central de ajuda responder tickets
Se a IA com a qual você mais se importa é a que responde seus clientes, comece por aí. O colega de equipe de helpdesk da eesel aprende da sua central de ajuda no dia em que você a conecta, sem precisar de llms.txt, e mostra quais artigos produzem rascunhos fracos. Uma empresa de automação industrial colocou sua biblioteca técnica atrás de um chat da eesel que responde apenas a partir dos documentos, e as lacunas nessas respostas agora vão direto para o backlog da equipe de documentação. Esse é o ciclo que torna uma central de ajuda melhor para todo leitor, IA ou humano.
Desenvolvedores podem configurá-la sem o painel. Com a CLI da eesel, um agente de codificação pode fazer upload de um arquivo de política aprovado com eesel files upload, verificar o que a sincronização da central de ajuda contém, e fazer perguntas de teste com eesel chat antes que qualquer coisa chegue a um cliente. Conectar o próprio helpdesk ainda precisa que alguém com acesso de administrador aprove. Teste a eesel gratuitamente por 7 dias e passe seus últimos dez tickets por ela.
Perguntas frequentes
Minha central de ajuda precisa de um arquivo llms.txt?
Como adiciono llms.txt a uma central de ajuda do Zendesk?
/llms.txt, e o mapeamento de host só muda o nome do host. Gere a lista pela API da central de ajuda (uma chamada anônima retorna apenas artigos públicos) ou pelo app gratuito KnowledgeBridge do Marketplace, e depois hospede-a no seu site principal com um link da sua central de ajuda. Meu guia da API de artigos explica a chamada de listagem.