

Para tornar sua central de ajuda legível por agentes de IA, conserte primeiro os artigos, depois os arquivos: uma pergunta por artigo, respondida em texto simples nas duas primeiras frases, seções que fazem sentido quando lidas sozinhas, e uma data em tudo que muda. Depois permita no robots.txt os bots de busca de IA que você quer, e mantenha as barreiras de login onde você realmente as quer. llms.txt e MCP vêm por último: em 17 de novembro de 2026, as próprias centrais de ajuda do Zendesk e do Help Scout ainda retornavam 404 para /llms.txt.
O leitor que mais importa é a sua própria IA de suporte. O colega de IA para helpdesk da eesel responde a partir da sua central de ajuda e de tickets passados, e cada rascunho que sua equipe corrige aponta para um artigo a ser ajustado. Com a CLI da eesel, um agente de código pode verificar o que a sincronização da central de ajuda realmente contém e disparar perguntas de teste antes de ir ao ar; um administrador ainda precisa aprovar a conexão do helpdesk.
Quem está lendo sua central de ajuda hoje?
Sou engenheiro de software na eesel com dois anos de trabalho em SEO nas costas, e a pergunta que recebo de responsáveis por suporte e documentação mudou. Antes era "por que esse artigo não ranqueia?". Agora é "por que o ChatGPT disse a um cliente que nosso prazo de reembolso é de 14 dias quando é 30?". A resposta curta é que sua central de ajuda tem três novos leitores, e cada um a lê de um jeito diferente.
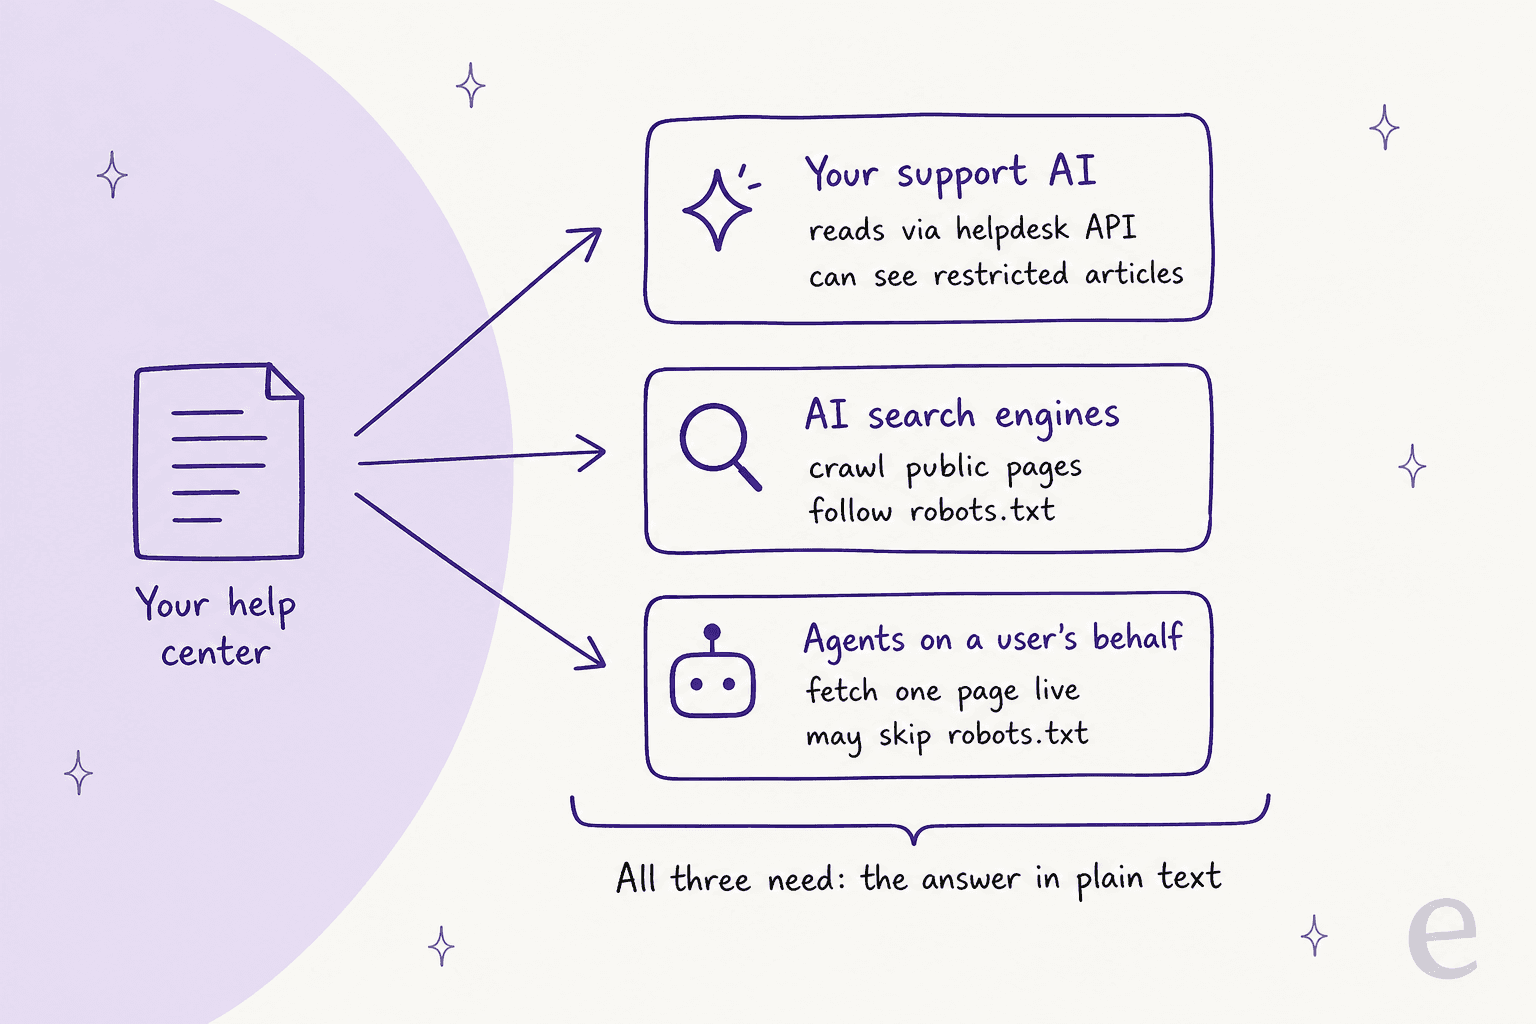
- Sua própria IA de suporte. O bot ou copiloto que você treinou com sua base de conhecimento normalmente sincroniza artigos pela API do helpdesk em uma agenda. Não se importa com robots.txt, e pode ler artigos restritos se você permitir.
- Mecanismos de busca de IA. A busca do ChatGPT, Claude, Perplexity e os AI Overviews do Google rastreiam suas páginas públicas com antecedência, da mesma forma que mecanismos de busca de IA constroem qualquer índice. Eles seguem o robots.txt, uma regra por bot.
- Agentes agindo por um usuário. Quando alguém pergunta ao ChatGPT sobre seu produto, ele pode buscar sua página em tempo real como
ChatGPT-User. Um agente de código pode trazer sua documentação como markdown, e um cliente MCP pode consultá-la como ferramenta.
Veja como eles diferem nas coisas que você controla:
| Leitor | Como ele entra | Segue o robots.txt? | Vê artigos só de login? | Executa JavaScript? |
|---|---|---|---|---|
| Sua IA de suporte | Sincronização ou conector via API do helpdesk | Não, usa seu acesso de API | Sim, se a conexão tiver permissão | Não precisa, lê o corpo do artigo |
| Rastreadores de busca de IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot) | Rastreia URLs públicas | Sim | Não | Os rastreadores do ChatGPT e do Claude não fizeram isso no teste da Vercel; o Gemini faz |
| Buscadores ativados pelo usuário (ChatGPT-User, Claude-User, Perplexity-User) | Busca uma URL durante um chat | Nem sempre, veja o passo 4 | Não | Trate como não |
| Agentes de código e clientes MCP | llms.txt, páginas markdown, ferramentas MCP | Depende do cliente | Só com credenciais | Não precisa |
A coluna que deveria te preocupar é a última. A análise de tráfego de rastreadores de IA da Vercel encontrou que os rastreadores do ChatGPT e do Claude buscam arquivos JavaScript mas não os executam, então tudo que é renderizado no lado do cliente fica invisível para eles. Todo leitor na tabela consegue ler texto simples que esteja na página ou na resposta da API. É por isso que os três primeiros passos abaixo são sobre os artigos em si, e por isso eles valem a pena para os quatro leitores ao mesmo tempo. Como a IA de suporte depois escolhe um trecho é uma questão de retrieval, mas ela só pode escolher a partir do que conseguiu ler.
Quão legível por IA está sua central de ajuda agora?
Antes dos passos, faça a auditoria. Leva dez minutos, com um artigo aberto em uma aba do navegador e o administrador do seu helpdesk em outra.
Marque o que já é verdade; a pontuação sobe conforme você avança. Os itens que você não consegue marcar apontam para os passos abaixo.
Passo 1: escreva uma pergunta por artigo, respondida nas primeiras linhas
Um leitor de IA raramente usa o artigo inteiro. Mecanismos de busca e bots de suporte dividem páginas em trechos, extraem os dois ou três que parecem mais próximos da pergunta, e escrevem uma resposta a partir deles. Então a unidade para a qual você escreve é o trecho, não a página.
O GitBook diz isso claramente no seu guia de documentação pronta para LLM: "O GitBook cuida da camada de entrega. Sua escrita define a qualidade das respostas de IA." O checklist dele é curto: dê a cada página um propósito claro, use títulos descritivos e seções curtas, declare restrições, valores padrão e requisitos diretamente, inclua valores exatos, e atualize o conteúdo quando o produto mudar.
Na prática, isso significa três mudanças para a maioria das centrais de ajuda:
- Títulos são perguntas que os clientes fazem. "Como eu mudo meu e-mail de cobrança?" vence "Visão geral das configurações de cobrança". É o mesmo conselho que dou para escrever artigos de base de conhecimento, e também costuma coincidir com o que as pessoas digitam na busca.
- A resposta vem primeiro. Uma ou duas frases que resolvem a pergunta, depois os passos, depois os casos extremos. Se um trecho é extraído isoladamente, a primeira frase é a que precisa sobreviver.
- Cada seção se sustenta por si só. Repita o substantivo. "Ative isso" não significa nada em um trecho que perdeu seu título.
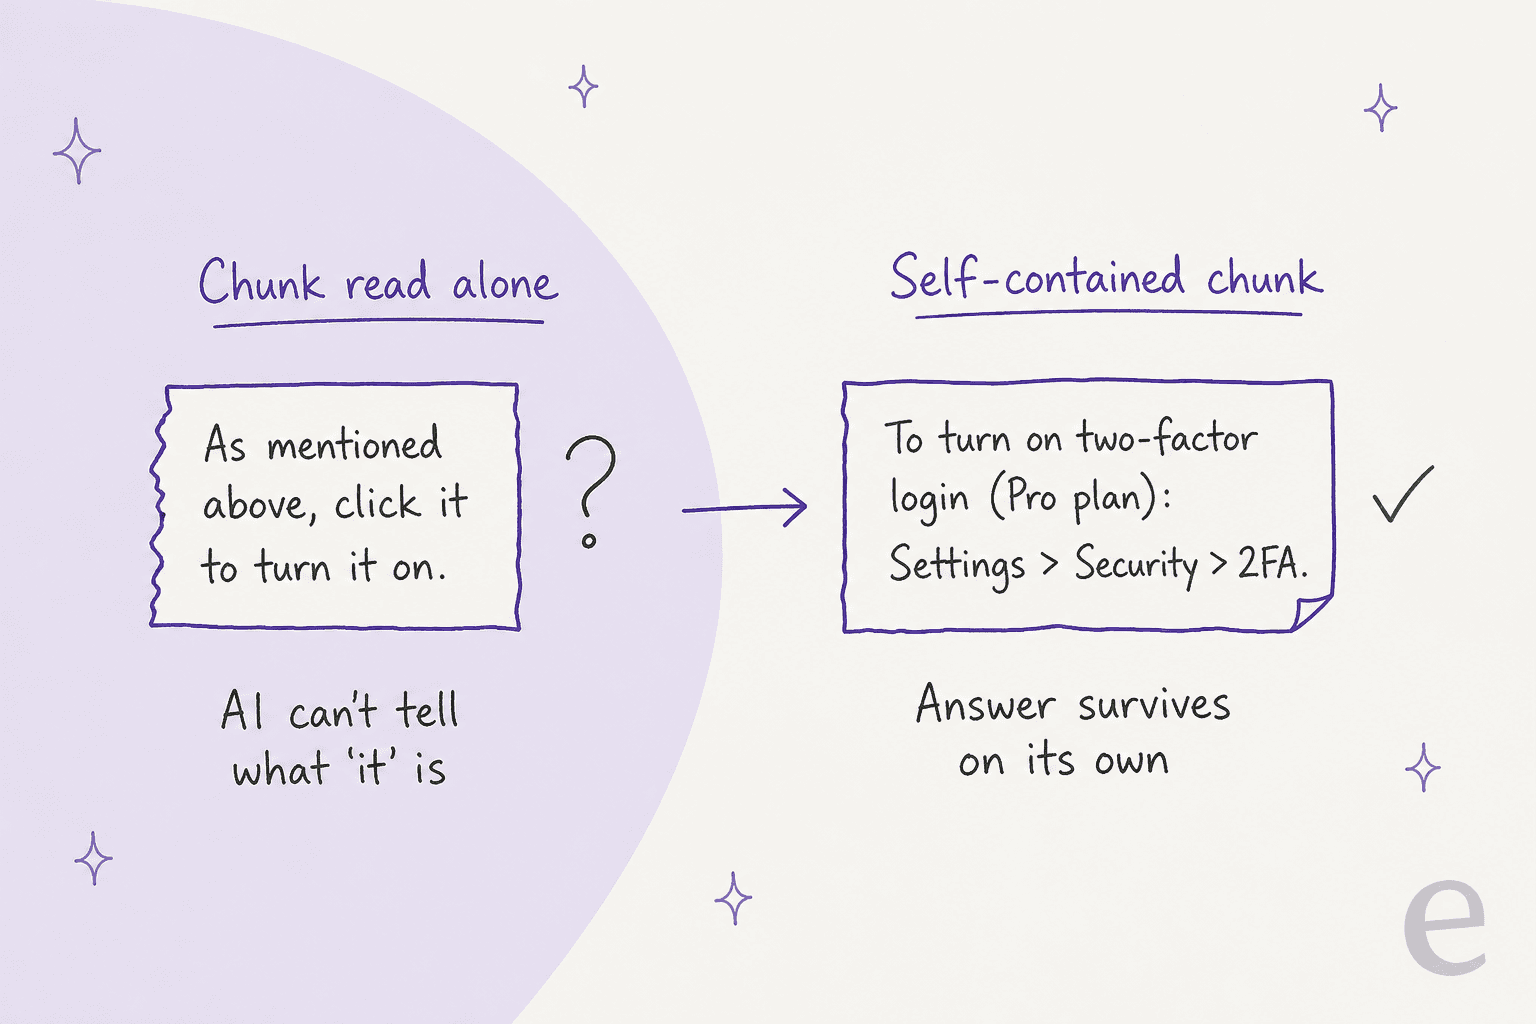
Uma pergunta por artigo também evita uma falha silenciosa. Um "FAQ da conta" longo com 25 respostas em uma única página acaba dividido em trechos que compartilham um único título, então a IA não consegue saber qual resposta pertence a qual pergunta. Dividir primeiro as páginas grandes de FAQ é o ganho mais rápido que conheço para desviar FAQs com IA.
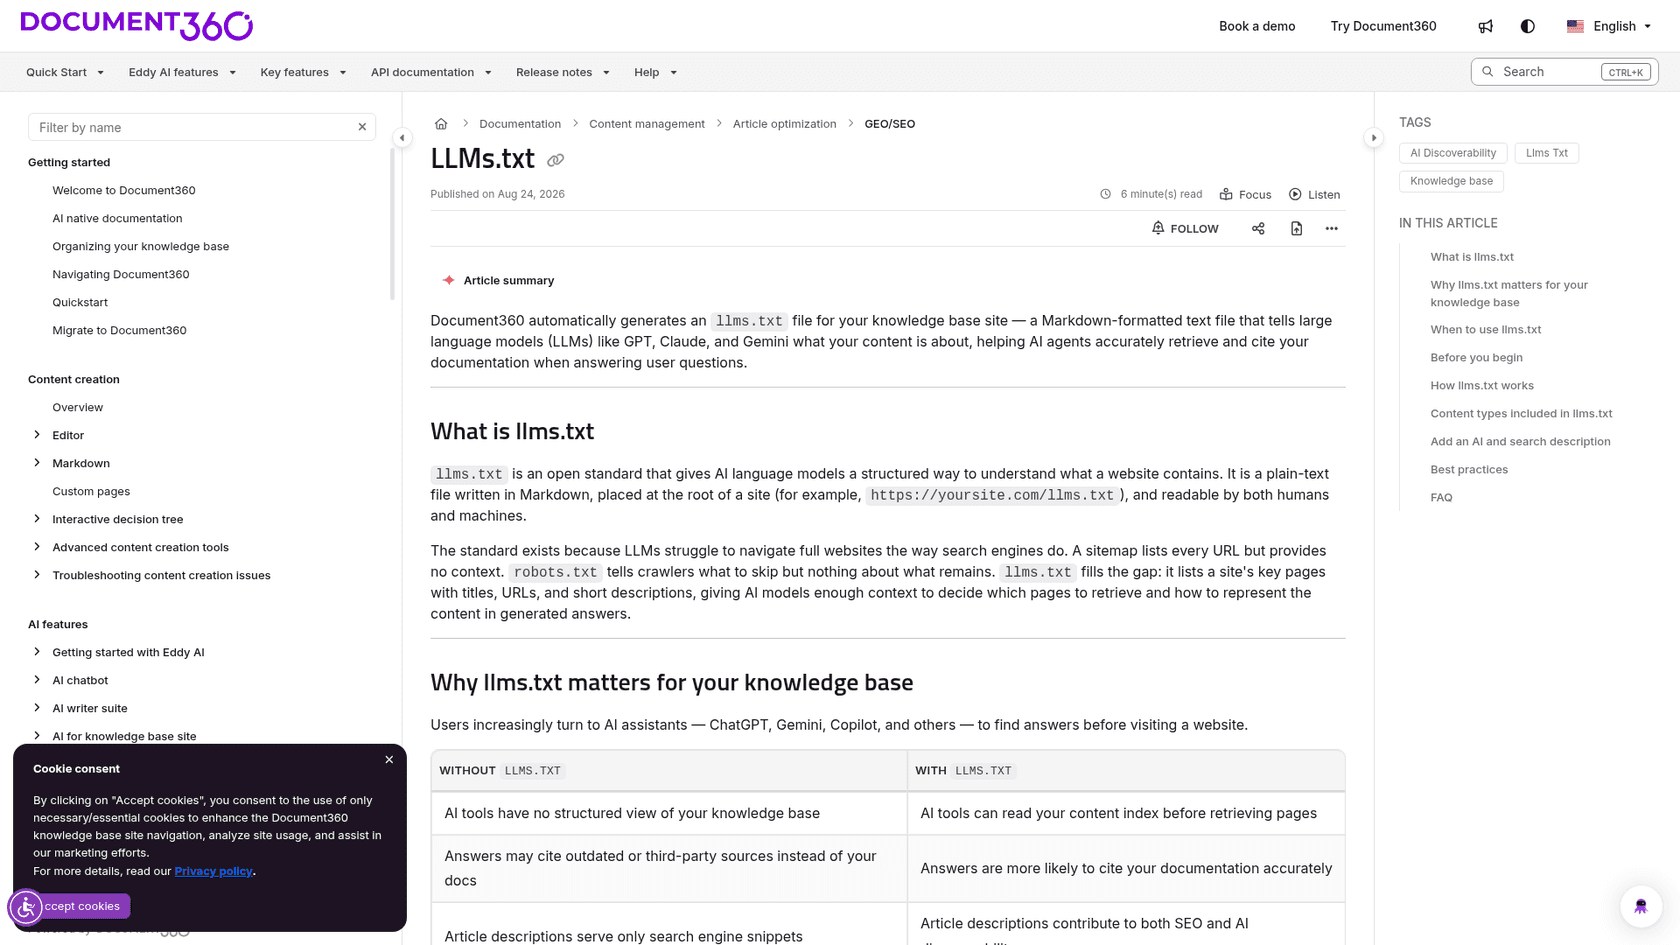
Se você usa o Document360, há uma segunda razão para escrever bons resumos: o llms.txt gerado por ele usa a "descrição de IA e busca" de cada artigo, e segundo a documentação de llms.txt do Document360, conteúdo sem uma dessas descrições "é incluído no llms.txt apenas pelo título."
Passo 2: tire as respostas de imagens, vídeos, PDFs e widgets de clique para abrir
Esse é o passo que mais quebra respostas de IA que eu vejo. Um artigo de ajuda diz "vá para as configurações mostradas abaixo", e o único lugar onde o caminho aparece é uma captura de tela. A pessoa que lê o vê. A maioria dos leitores de IA não vê.
As próprias orientações do Google sobre recursos de IA listam "garantir que o conteúdo importante esteja disponível em forma textual" como uma das bases para aparecer nos AI Overviews e no AI Mode. O mesmo vale para sua IA de suporte: uma sincronização que pega o corpo do artigo recebe o texto e a URL da imagem, não o que está desenhado na imagem.
Onde a resposta costuma se esconder, e o que fazer sobre isso:
| Onde a resposta se esconde | O que os leitores de IA recebem | Correção |
|---|---|---|
| Captura de tela de uma página de configurações | Uma URL de imagem e talvez um texto alternativo | Escreva o caminho do menu em texto: Configurações > Segurança > 2FA. Mantenha a captura como backup (dicas de formatação) |
| Vídeo tutorial incorporado | Um player incorporado, sem passos | Adicione os passos ou uma transcrição abaixo do vídeo (vídeos incorporados) |
| PDF ou anexo de slides | Muitas vezes ignorado, ou lido sem estrutura | Mova o conteúdo para o artigo (anexos) |
| Abas ou acordeões carregados por um script | Nada, se o texto chega só depois do JavaScript rodar | Mantenha o texto no HTML. Um bloco <details> simples funciona porque o texto já está lá |
| Preços ou limites em um widget incorporado | Nada | Diga o número em uma frase com data |
Isso importa também para o seu próprio bot, não só para a busca pública. Na SE Ranking, a eesel responde chats em tempo real para três produtos a partir de cerca de 14.100 páginas de central de ajuda, e suas instruções dizem que ela nunca descreve um menu ou botão que não encontrou no conhecimento. Essa é a regra certa para um agente de suporte. Também significa que um caminho de menu que só existe em uma captura de tela é um caminho que o agente não vai dar, então o cliente é transferido para uma pessoa por algo que sua central de ajuda já cobre.
Um teste rápido para qualquer artigo: olhe o código-fonte da página (ou a resposta da API) e procure pelo passo chave. Se não estiver no texto, assuma que nenhum leitor de IA o tem.
Passo 3: date seus fatos, e aposente artigos antigos corretamente
Um leitor de IA é confiante por padrão. Se um artigo antigo diz que o prazo de reembolso é de 14 dias e um mais novo diz 30, o modelo pode citar qualquer um dos dois, e não vai acrescentar "mas confira a data". Conteúdo desatualizado causa mais dano em uma resposta de IA do que em uma página, porque o cliente nunca vê o rodapé "última atualização 2023".
Três hábitos resolvem a maior parte disso:
- Coloque a data junto ao fato. "Reembolsos estão disponíveis até 30 dias após a compra (política vigente desde outubro de 2026)" sobrevive a ser extraído dentro de um trecho. Um rodapé não sobrevive.
- Apague ou junte duplicados. Dois artigos respondendo a mesma pergunta com números diferentes são a causa mais comum de uma resposta de IA errada que eu vejo. Faça primeiro uma varredura de conteúdo desatualizado da central de ajuda.
- Redirecione, não devolva 404. Nos dados de rastreamento da Vercel, o ChatGPT gastou 34,82% das suas requisições em páginas 404 e outros 14,36% seguindo redirecionamentos. Quando você move um artigo, configure o redirecionamento para que mecanismos de busca de IA caiam na versão atual.
Sua própria IA de suporte também precisa de uma regra para conflitos. A OroSoft roda a eesel como copiloto do Freshdesk, que trata a central de ajuda como a fonte da verdade para políticas, e quando a central de ajuda e os tickets passados discordam, ela segue o mais recente. Sua central de ajuda se resincroniza toda segunda-feira. Esse é o ciclo que toda equipe precisa, seja qual for a ferramenta que use:
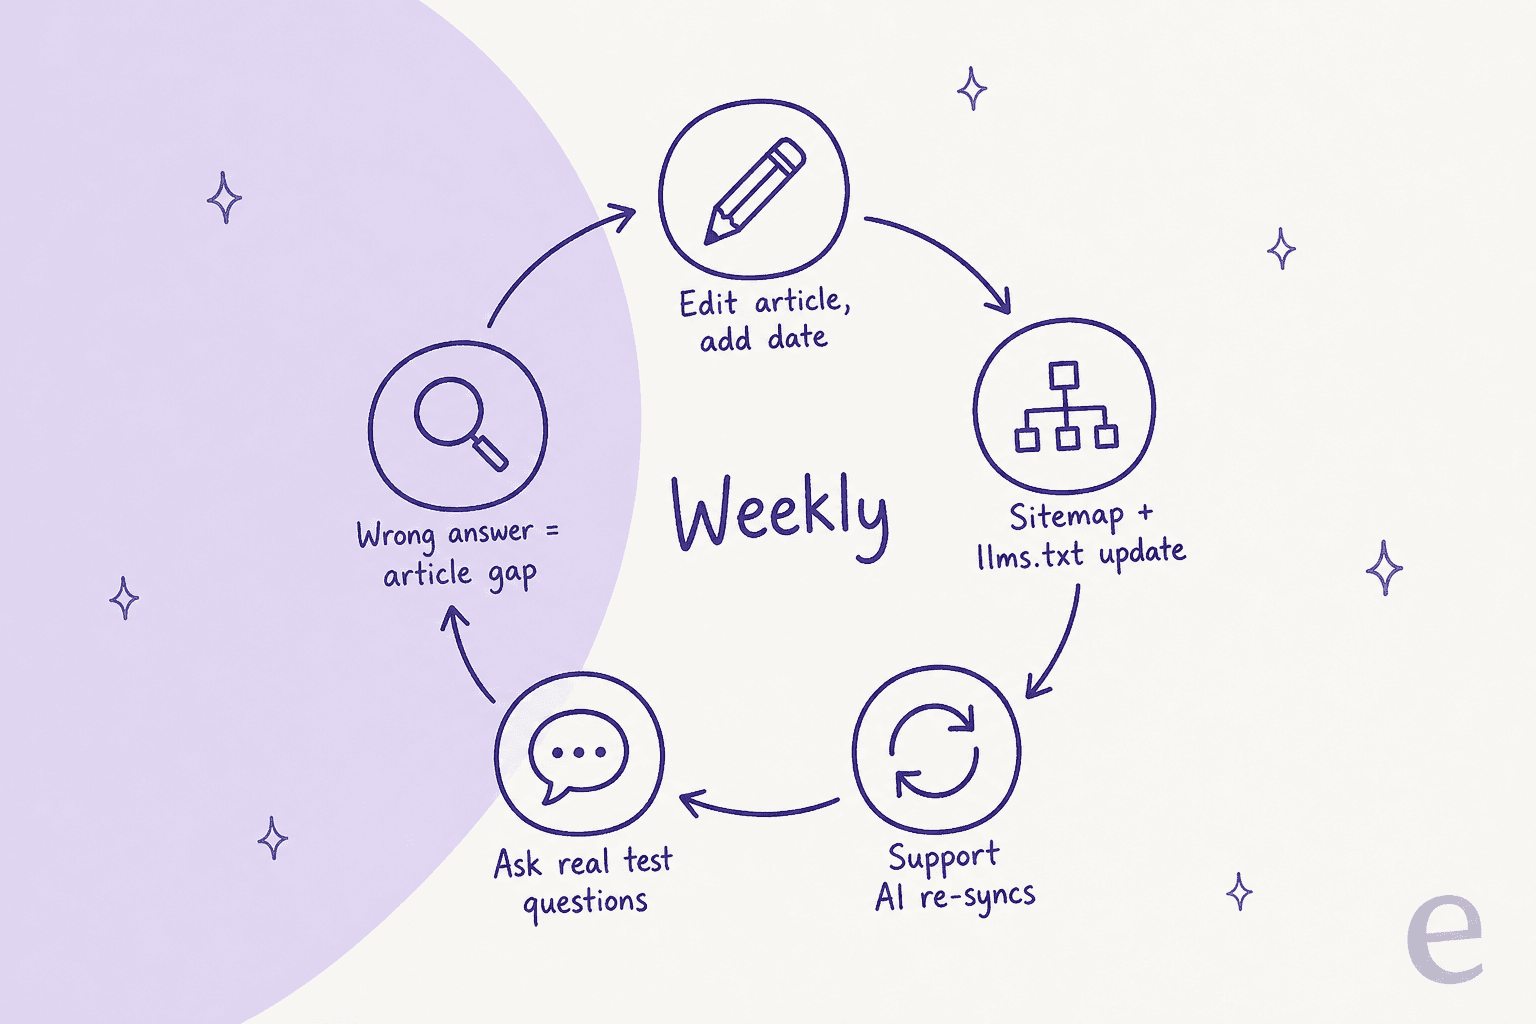
O Zendesk regenera o sitemap da sua central de ajuda a cada duas horas, segundo seu artigo sobre SEO da central de ajuda, então o lado público basicamente se cuida. A agenda de sincronização do seu bot é a que vale verificar. Se ela sincroniza mensalmente, uma mudança de política fica errada nas respostas de IA por até um mês. Uma base de conhecimento que se atualiza sozinha ajuda na outra direção: ela pega respostas que nunca chegaram a um artigo.
Passo 4: decida quais bots de IA podem ler isso
A maioria das empresas de IA agora divide seus bots por tarefa: um para treinamento de modelo, um para busca, um para buscas que um usuário pede. Você pode permitir um e bloquear outro. É aqui que vejo equipes de suporte escondendo acidentalmente sua central de ajuda, geralmente depois que alguém colou um trecho de robots.txt de "bloquear todos os bots de IA".
| Empresa | Rastreador de treinamento | Rastreador de busca | Buscador ativado pelo usuário |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User ("as regras do robots.txt podem não se aplicar") |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User (bloquear isso para a recuperação direcionada pelo usuário) |
| Perplexity | nenhum listado | PerplexityBot | Perplexity-User ("geralmente ignora as regras do robots.txt") |
| Google-Extended (um token de controle, não um bot separado) | Googlebot | não coberto aqui |
Cada nome de empresa leva à documentação de rastreadores daquela empresa.
A regra para uma central de ajuda pública é simples: permita os rastreadores de busca. A OpenAI diz que sites que optam por sair do OAI-SearchBot "não serão mostrados nas respostas de busca do ChatGPT", e a Anthropic diz que bloquear o Claude-SearchBot "pode reduzir a visibilidade e a precisão do seu site nos resultados de busca dos usuários". Se você deixa ou não os rastreadores de treinamento entrarem é uma decisão separada para suas equipes jurídica e de marketing.
Um robots.txt de central de ajuda que mantém o acesso de busca de IA enquanto sai do treinamento se parece com isto:
# Busca de IA: deixe esses indexarem a central de ajuda
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Treinamento de modelo: uma decisão de política, não de respostas
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Três detalhes em que as pessoas tropeçam:
- O Google-Extended faz mais do que treinamento. O Google diz que ele também controla o grounding no Gemini Apps e no Vertex AI, então bloqueá-lo pode manter seus artigos fora das respostas do Gemini, embora "não afete a inclusão de um site na Busca do Google".
- Mudanças não são instantâneas. A OpenAI diz que pode levar cerca de 24 horas depois de uma mudança no robots.txt para seus sistemas de busca se ajustarem.
- O robots.txt só cobre o domínio onde está. As instruções da Anthropic dizem para repetir as regras em cada subdomínio, o que importa se sua central de ajuda vive em
help.ousupport.
Se você quer ver com que frequência os mecanismos de IA realmente te citam depois disso, isso é uma questão de otimização para mecanismos de resposta, e essas ferramentas cobrem o lado do rastreamento.
Passo 5: coloque a barreira de login onde você realmente a quer
Todo leitor de IA público para em uma página de login. O Zendesk é direto sobre isso: se sua central de ajuda exige login, "o sitemap não será gerado automaticamente. Rastreadores web não conseguem acessar centrais de ajuda fechadas ou restritas." A documentação de llms.txt do Mintlify diz o mesmo para seus arquivos gerados: em sites totalmente autenticados, "ferramentas de IA que não conseguem se autenticar não conseguem acessá-los."
Esse é o comportamento correto. O erro é colocar respostas públicas atrás da barreira por acidente, geralmente porque uma categoria inteira foi restrita a um segmento de usuários por causa de um único artigo sensível. Audite as restrições artigo por artigo, e restrinja por segmento apenas o que realmente precisa ser privado.
Depois planeje duas faixas:
- Faixa pública: tudo que um potencial cliente ou cliente poderia perguntar antes de fazer login. É isso que mecanismos de busca de IA e buscadores no estilo ChatGPT vão citar.
- Faixa privada: artigos específicos de conta, só para parceiros ou internos. Só a sua própria IA de suporte deveria ler isso, por meio de uma conexão de API com permissão, como a API do Zendesk Guide ou a API de base de conhecimento do Freshdesk.
Isso fica mais específico do que as pessoas esperam. Em uma chamada de vendas da eesel, uma equipe de logística enterprise precisava de dois agentes a partir de um único Zendesk: um para usuários anônimos que responde só a partir de artigos públicos, e um para usuários registrados que também lê um subconjunto de artigos restritos. Esse é o instinto certo. Decida qual público cada leitor de IA atende, e dê a ele exatamente esse conteúdo.
Passo 6: adicione llms.txt e versões em markdown
Agora a parte com que a maioria dos guias começa. O llms.txt é um padrão proposto: um arquivo markdown em /llms.txt que lista suas páginas principais com descrições de uma linha, mais versões markdown limpas de cada página na mesma URL com .md adicionado. A ideia é poupar um agente de ter que analisar navegação, scripts e banners de cookies para achar uma resposta.
Como as coisas estão em novembro de 2026:
- Agentes de código e clientes de IA usam isso. A especificação diz que arquivos llms.txt são "usados mais pesadamente para documentação de software, onde agentes de código os seguem para encontrar referências de API e tutoriais." O Zendesk adicionou llms.txt e páginas markdown à sua documentação para desenvolvedores em 4 de novembro de 2026, e seu anúncio diz a desenvolvedores para darem ao agente
developer.zendesk.com/llms.txtcomo índice de busca. - Mecanismos de busca não precisam disso. O Google diz que os AI Overviews e o AI Mode não têm "exigências técnicas adicionais" além da elegibilidade normal de Busca. A auditoria de llms.txt do Lighthouse do Chrome marca um arquivo ausente como não aplicável, "já que fornecer o arquivo é opcional por agora."
- Centrais de ajuda de clientes na maioria ainda não têm uma. Em 17 de novembro de 2026, solicitei
/llms.txtem support.zendesk.com, docs.helpscout.com e support.freshdesk.com. As três retornaram 404. As centrais de ajuda dessas mesmas empresas ranqueiam e são citadas sem problema, o que indica onde o llms.txt fica na lista de prioridades.
A comunidade de desenvolvedores está dividida sobre quanto isso importa, e os dois lados têm um ponto:
"LLMs are not reading llms.txt nor AGENTS.md files from servers. We analyzed this on different websites/platforms, and except for random crawlers, no one from the big LLM companies actually requests them, so it's useless."

"llms.txt files have nothing to do with crawlers or big LLM companies. They are for individual client agents to use. I have my clients set up to always use them when they're available, and since I did that they've been way faster and more token efficient when using sites that have llms.txt files."
O segundo comentário vem da conta de Jeremy Howard, que escreveu a proposta do llms.txt, e combina com o que a especificação diz: o llms.txt é para agentes que vêm procurando, não para rastreadores que constroem um índice. Se sua central de ajuda é lida por agentes de código de desenvolvedores (produtos de API, ferramentas dev, qualquer coisa com SDK), vale a pena. Para uma central de ajuda de consumidor, é um seguro barato, não uma palanca de ranqueamento.
Se sua plataforma faz isso por você, ative e siga adiante:
| Plataforma | llms.txt | Páginas markdown | Cuidado com |
|---|---|---|---|
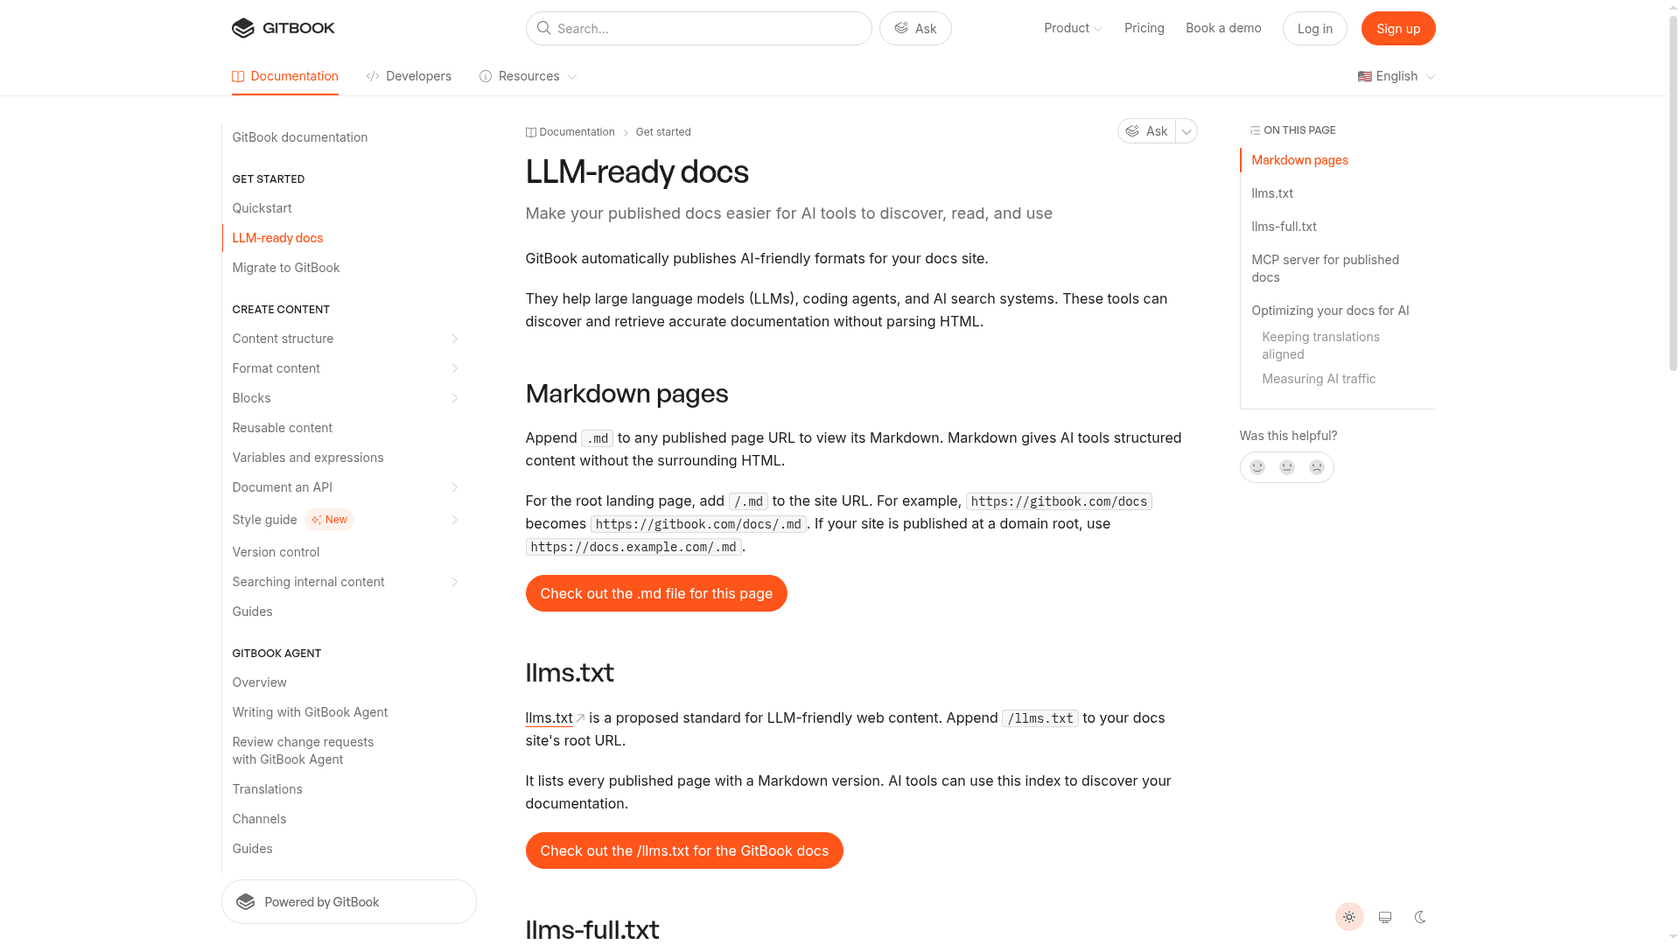
| GitBook | Automático, mais llms-full.txt | Adicione .md a qualquer página | Páginas ocultas continuam incluídas no llms-full.txt e no servidor MCP |
| Mintlify | Automático, também em /.well-known/llms.txt | Adicione .md; páginas HTML linkam sua versão markdown | A configuração "Don't index project" retorna 404 para llms.txt mas não para llms-full.txt |
| Document360 | Automático, atualizado a cada publicação | Páginas oferecem "View as Markdown" | Só o conteúdo público é incluído; artigos sem descrição aparecem só pelo título |
| Central de ajuda do Zendesk | Nenhuma opção embutida que eu tenha encontrado; o app KnowledgeBridge do Marketplace gera os dois arquivos | Pelo app, ou pela sua própria exportação da central de ajuda | Você hospeda e atualiza o resultado |
A linha do GitBook merece um segundo olhar. Segundo a própria documentação do GitBook, "ocultar uma página só a remove do sumário publicado." Se você ocultou uma página desatualizada ou interna em vez de despublicá-la, agentes ainda conseguem lê-la.
Passo 7: ofereça um servidor MCP, e saiba qual tipo você está oferecendo
MCP (Model Context Protocol) permite que um app de IA chame sua central de ajuda como uma ferramenta: buscar, ler uma página, receber markdown de volta, em vez de raspar HTML. Existem dois tipos bem diferentes, e equipes de suporte os confundem.
Servidores MCP de documentação pública são para a IA de qualquer um. O GitBook "expõe um servidor Model Context Protocol (MCP) para cada site de documentação publicado" em /~gitbook/mcp. O servidor MCP de busca do Mintlify dá aos agentes três ferramentas: busca, um sistema de arquivos de documentação somente leitura, e uma ferramenta de envio de feedback que "reporta um problema de documentação para sua equipe quando um agente encontra uma página incorreta, desatualizada, confusa ou incompleta." Essa última ferramenta é a ideia que eu copiaria primeiro: o agente que lê sua documentação registra ali mesmo o reporte do bug.
Servidores MCP de conta são para as próprias ferramentas de IA da sua equipe, com suas permissões:
- O MCP do Help Scout conecta Claude, ChatGPT ou Cursor a conversas, clientes e conteúdo do Docs. Precisa de acesso à API (planos Standard, Plus e Pro) e de uma chave de API do Docs para as ferramentas de base de conhecimento, e os agentes de IA "só acessam dados que a sua conta de usuário específica tem permissão para ver." É uma tarefa diferente das ferramentas de autoatendimento do Help Scout para clientes.
- O Zendesk Bridge, em acesso antecipado, permite que agentes externos como Claude, ChatGPT, Copilot ou Gemini busquem sua central de ajuda e trabalhem tickets por meio de uma conexão MCP governada, segundo o artigo de EAP do Zendesk. É diferente do próprio cliente MCP do Zendesk, que funciona na direção oposta e deixa o Zendesk chamar outras ferramentas.
- O MCP do Document360 conecta ChatGPT e Claude à sua base de conhecimento para buscar e gerenciar artigos.
Nenhum dos dois tipos substitui os passos 1 a 3. Um servidor MCP entrega seu artigo mais rápido e mais limpo; ele não consegue corrigir um artigo desatualizado. Se você quer o contexto de como agentes usam esses servidores, meu post sobre servidores MCP de agentes de IA cobre isso, e o programa de acesso antecipado do canal de ChatGPT do Zendesk mostra para onde isso vai: "respostas generativas" no ChatGPT "direto do conteúdo da Central de Ajuda da sua conta", junto da sua central de ajuda conversacional.
Como você testa se agentes de IA leem isso corretamente?
Pergunte a eles. Parece óbvio, e quase ninguém faz isso de forma programada. Pegue dez perguntas reais dos tickets do mês passado, as específicas com números na resposta, e teste-as em três lugares:
- ChatGPT, Claude e Perplexity com a busca ativada. Confira se eles citam sua central de ajuda, e se o número está atualizado.
- Uma busca bruta.
curl -A "OAI-SearchBot" https://help.yoursite.com/your-articlee procure na saída pela frase chave. Se estiver faltando, um rastreador que não executa JavaScript não consegue vê-la. - Sua própria IA de suporte, antes dos clientes verem. Na eesel, todo lançamento é testado primeiro contra tickets históricos, porque um bot que parece confiante e está errado custa mais confiança do que nenhum bot.
Para documentação de desenvolvedores, a categoria Lighthouse de navegação agêntica do Chrome (Chrome 150 ou mais recente, ainda experimental) verifica llms.txt, estabilidade de layout e se a árvore de acessibilidade está saudável, o que ela chama de "visão de olho de máquina" da sua página.
O melhor ciclo de testes que já vi é o que roda em cada ticket. A Qontro, uma empresa de ERP, conectou o Freshdesk à eesel e carregou sua central de ajuda, fóruns de suporte e cerca de 9.800 tickets passados. Cada ticket novo recebe um rascunho de resposta como nota interna com os artigos de ajuda linkados. A equipe compara cada rascunho com a resposta que uma pessoa realmente enviou, e onde o rascunho estava errado, "normalmente aponta para um artigo de ajuda faltando ou incompleto, ou uma regra que precisa ser ajustada." Sua central de ajuda se resincroniza toda sexta-feira. Cerca de um em cada dez rascunhos agora sai com pouca ou nenhuma edição, e o maior ganho até agora é o que os rascunhos revelam sobre as lacunas.
Isso é análise de lacunas de conhecimento sem um projeto separado. A Innr usa a mesma regra de honestidade pelo outro lado: se a central de ajuda não cobre uma pergunta, a eesel diz isso e transfere em vez de adivinhar. Cada transferência é um artigo faltando, que você também pode encontrar mapeando buscas para lacunas da central de ajuda.
Quais erros tornam uma central de ajuda mais difícil de ler para a IA?
Os que eu vejo mais, mais ou menos em ordem de dano:
- Lançar llms.txt antes de consertar os artigos. Lista suas páginas mais rápido; não as torna certas.
- Um robots.txt copiado de "bloquear todos os bots de IA". Geralmente bloqueia OAI-SearchBot e Claude-SearchBot junto com os rastreadores de treinamento, o que tira sua central de ajuda das respostas de busca de IA.
- Ocultar em vez de despublicar. No GitBook, páginas ocultas ficam no
llms-full.txte no servidor MCP. - Respostas em capturas de tela. O motivo mais comum pelo qual uma IA diz "não consegui encontrar isso" sobre algo que você já documentou.
- Duas respostas ativas para uma pergunta. A IA vai citar o trecho que parece mais próximo, não o que é mais novo.
- Uma sincronização mensal do bot. A busca pública se atualiza em horas; uma sincronização lenta deixa seu próprio bot atrás da central de ajuda.
eesel: deixe sua central de ajuda treinar um colega de suporte
Se a principal IA que lê sua central de ajuda é o seu próprio bot de suporte, o jeito mais rápido de tornar isso legível é observá-la ler. O colega de IA para helpdesk da eesel entra no seu helpdesk, aprende com sua central de ajuda, suas macros e tickets passados, e rascunha ou envia respostas com o artigo fonte linkado. Cada rascunho que sua equipe edita te mostra um artigo que precisa de uma resposta mais clara, uma data ou uma fusão, assim como aconteceu com a Qontro.
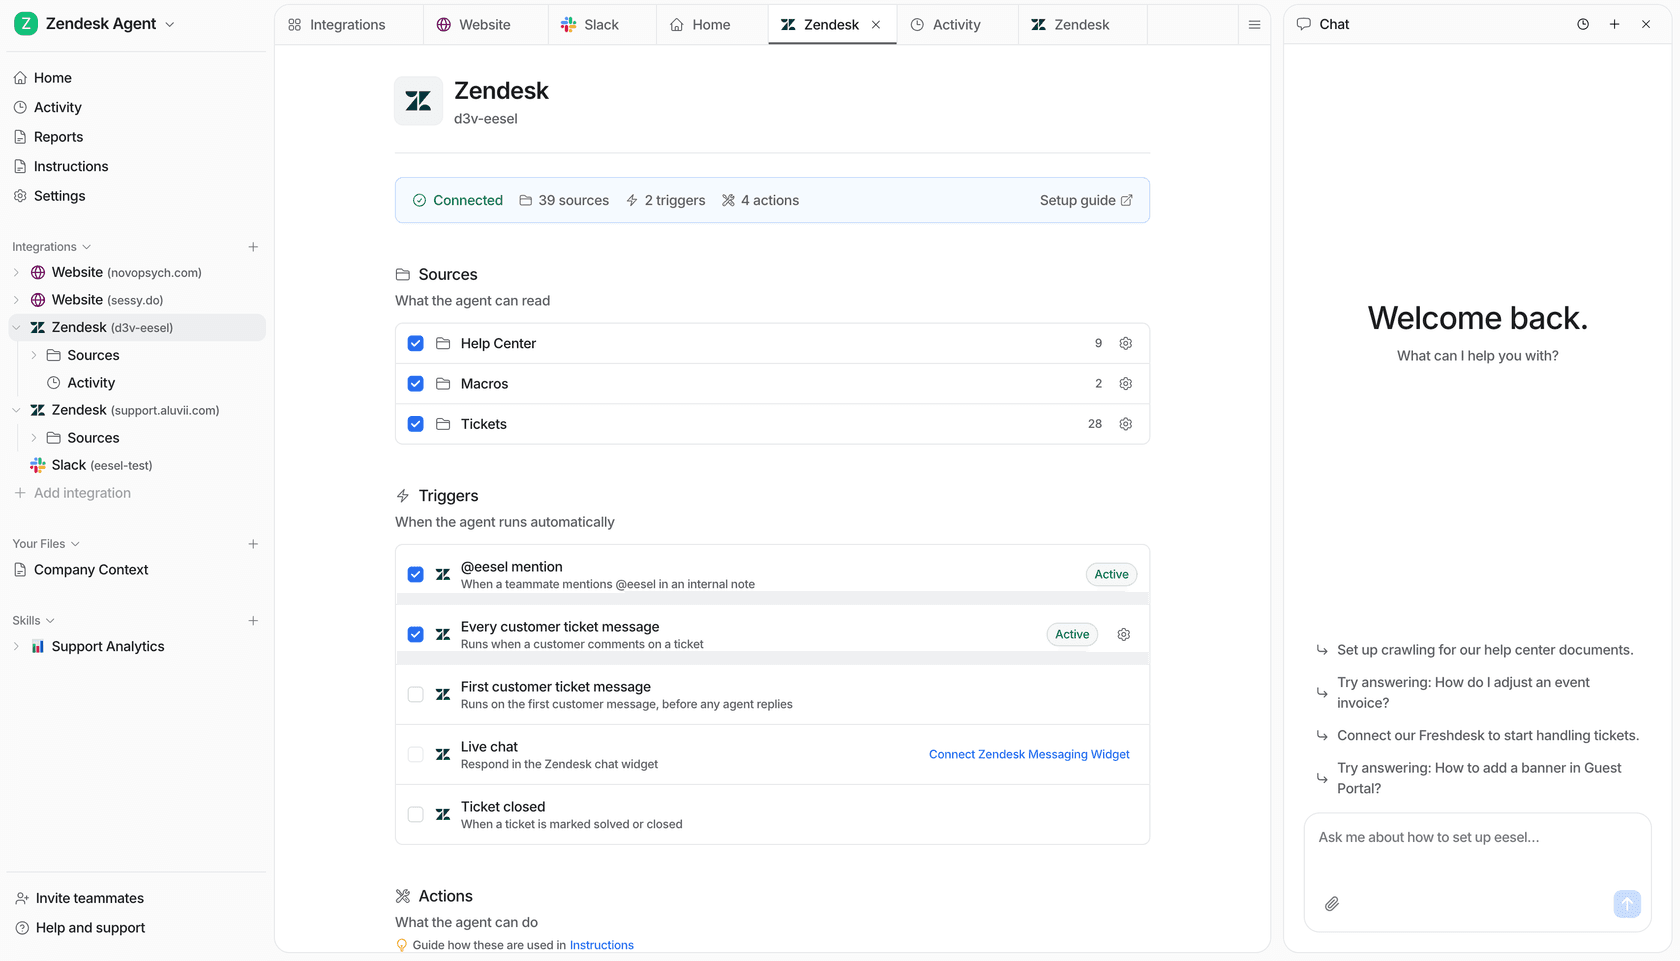
De um terminal, um agente de código pode executar eesel integrations sources zendesk para ver o que a sincronização da central de ajuda realmente contém, enviar um arquivo de política aprovado, e disparar perguntas de teste com eesel chat antes que qualquer coisa chegue a um cliente. Conectar o helpdesk em si ainda precisa de uma pessoa com acesso de admin para aprovar. Teste a eesel de graça e passe seus últimos dez tickets por ela.