

Cinco tickets revisados por agente por mês geram uma nota de qualidade que pode errar em cerca de 31 pontos, então a solução não é uma planilha melhor, e sim pontuar todos os tickets com IA e tratar o resultado como um sinal que uma pessoa confere. Zendesk, Gorgias, Front, HubSpot e Freshdesk oferecem alguma versão disso, e cada um cobre uma parte bem diferente do ticket (o Gorgias pontua 3 critérios com IA, a HubSpot pontua 3 e o Zendesk deixa você escrever os seus).
O ponto que a maioria dos guias ignora: quando um agente de IA assume os tickets repetitivos, os que sobram para os seus humanos são mais difíceis, então o tempo de atendimento sobe, o volume por agente cai e um scorecard criado antes da IA vai punir os seus melhores profissionais. Na Question Beauty, a eesel encerrou sozinha cerca de 280 de 990 tickets do Gorgias em um mês e atribuiu cerca de 250 a uma pessoa com uma nota, então a fila humana é um trabalho diferente daquele para o qual as metas antigas foram definidas. Mostro a conta do tamanho da amostra, o scorecard reponderado que eu usaria como ponto de partida e como manter as notas da IA justas.
Quantas revisões uma nota de agente realmente precisa?
Muito mais do que cinco. Uma nota baseada em cinco tickets revisados é, em grande parte, sorte, e a conta é a padrão para qualquer taxa de aprovação.
Considere um agente que realmente cumpre um critério em 85% das vezes. Com 5 revisões por mês, a margem de erro de 95% é de cerca de 31 pontos: o painel poderia mostrar 55% ou 100% para a mesma pessoa no mesmo mês. Com 20 revisões, é de cerca de 16 pontos, com 100, cerca de 7, e com 500 (todos os tickets), cerca de 3. Essa é a minha própria conta, usando a aproximação normal, com uma correção de população finita no widget abaixo.
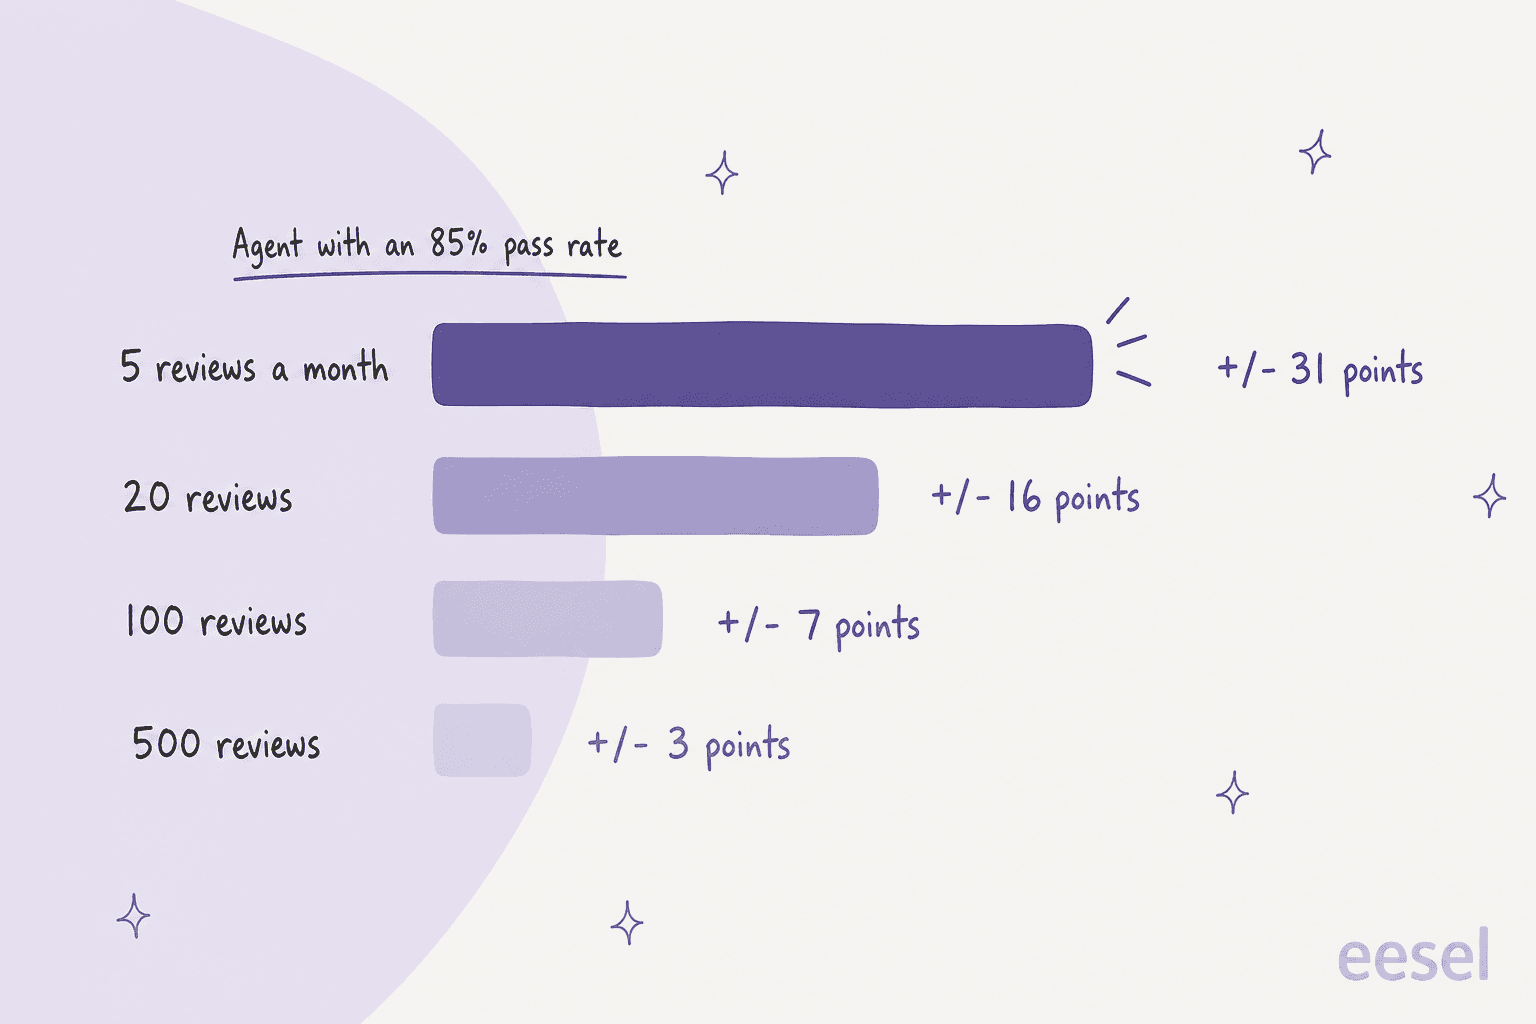
Fica pior quando você compara pessoas. Para distinguir com confiança um agente de 85% de um de 75%, você precisa de cerca de 120 tickets pontuados para cada um. Um líder de equipe que revisa 5 a 10 tickets por semana, de um total de aproximadamente 500 tickets mensais de um agente, nunca chega lá. Leo Gasperin descreveu exatamente isso na antiga equipe dele, e um comentarista deu nome ao problema:
"sampling creates confidence, but not clarity."

Teste com os seus próprios números. O widget abaixo usa o seu volume de tickets e a sua quantidade de revisões.
Digite o seu volume de tickets e a sua quantidade de revisões para ver o tamanho da faixa. O último cartão mostra a quantidade de revisões necessária para distinguir dois agentes com 10 pontos de diferença.
Tratei do argumento mais amplo para abandonar a amostragem em garantia de qualidade em call centers e da versão prática em QA de suporte com IA. Em resumo: a pontuação por IA vale a compra só pelo denominador.
O que um scorecard de desempenho de agente deve medir?
Quatro coisas, nenhuma delas é velocidade isolada: qualidade, resultado, visão do cliente e eficiência por tipo de ticket. O conselho usual é uma nota ponderada (por exemplo, qualidade 40, produtividade 25, experiência do cliente 25, confiabilidade 10), e esse formato é bom. O erro das equipes está nos pesos.
| Grupo | Exemplo de medida | O que ela mostra | A armadilha |
|---|---|---|---|
| Qualidade | Empatia, precisão e resolução pontuadas por IA | A resposta cumpriu o papel? | Um critério que a IA não consegue julgar (o Gorgias deixa precisão e voz da marca para os humanos) |
| Resultado | Taxa de reabertura, resolução no primeiro contato | Continuou resolvido? | Agentes que encerram rápido e reabrem depois |
| Visão do cliente | CSAT | O cliente sentiu que foi ajudado? | Poucas respostas de pesquisa por agente, ou seja, o mesmo problema de ruído |
| Eficiência | Tempo médio de atendimento por tipo de ticket | O trabalho está bem organizado? | Um único número misturando tickets fáceis e difíceis |
Para a lista completa de métricas, meus posts sobre KPIs de atendimento ao cliente e produtividade de agentes de call center aprofundam o tema. Se você estiver escrevendo critérios de avaliação do zero, exemplos de feedback de QA traz formulações que orientam em vez de apenas dar nota.
O que muda quando um agente de IA assume os tickets fáceis?
Sua fila humana fica mais difícil, e todo número por agente definido antes da IA passa a medir um trabalho diferente. A IA responde às perguntas sobre status de pedido e "como eu faço", então o que chega a uma pessoa é a decisão de reembolso, o cliente irritado e o problema que o bot não conseguiu resolver.
Um atendente de call center no Reddit descreveu isso depois que um agente de voz com IA passou a atender na frente das ligações:
"At this point, it's handling a lot of "routine" calls. Which means the calls that come through to us humans are more complicated, or people who are upset about the AI messing something up."

Os números confirmam a sensação. Na Question Beauty, a eesel tratou cerca de 990 tickets do Gorgias em um mês (de 8 de agosto a 8 de setembro de 2026), enviou cerca de 960 respostas, encerrou cerca de 280 tickets sozinha e atribuiu cerca de 250 a uma pessoa com uma nota interna. Reembolsos, reclamações e pedidos de atacado sempre vão para um humano. Os agentes dessa equipe não estão mais lentos do que antes; eles simplesmente nunca mais veem o "onde está meu pedido". O tempo de atendimento por ticket sobe e os tickets por agente caem, e nenhum dos dois é um problema de desempenho.
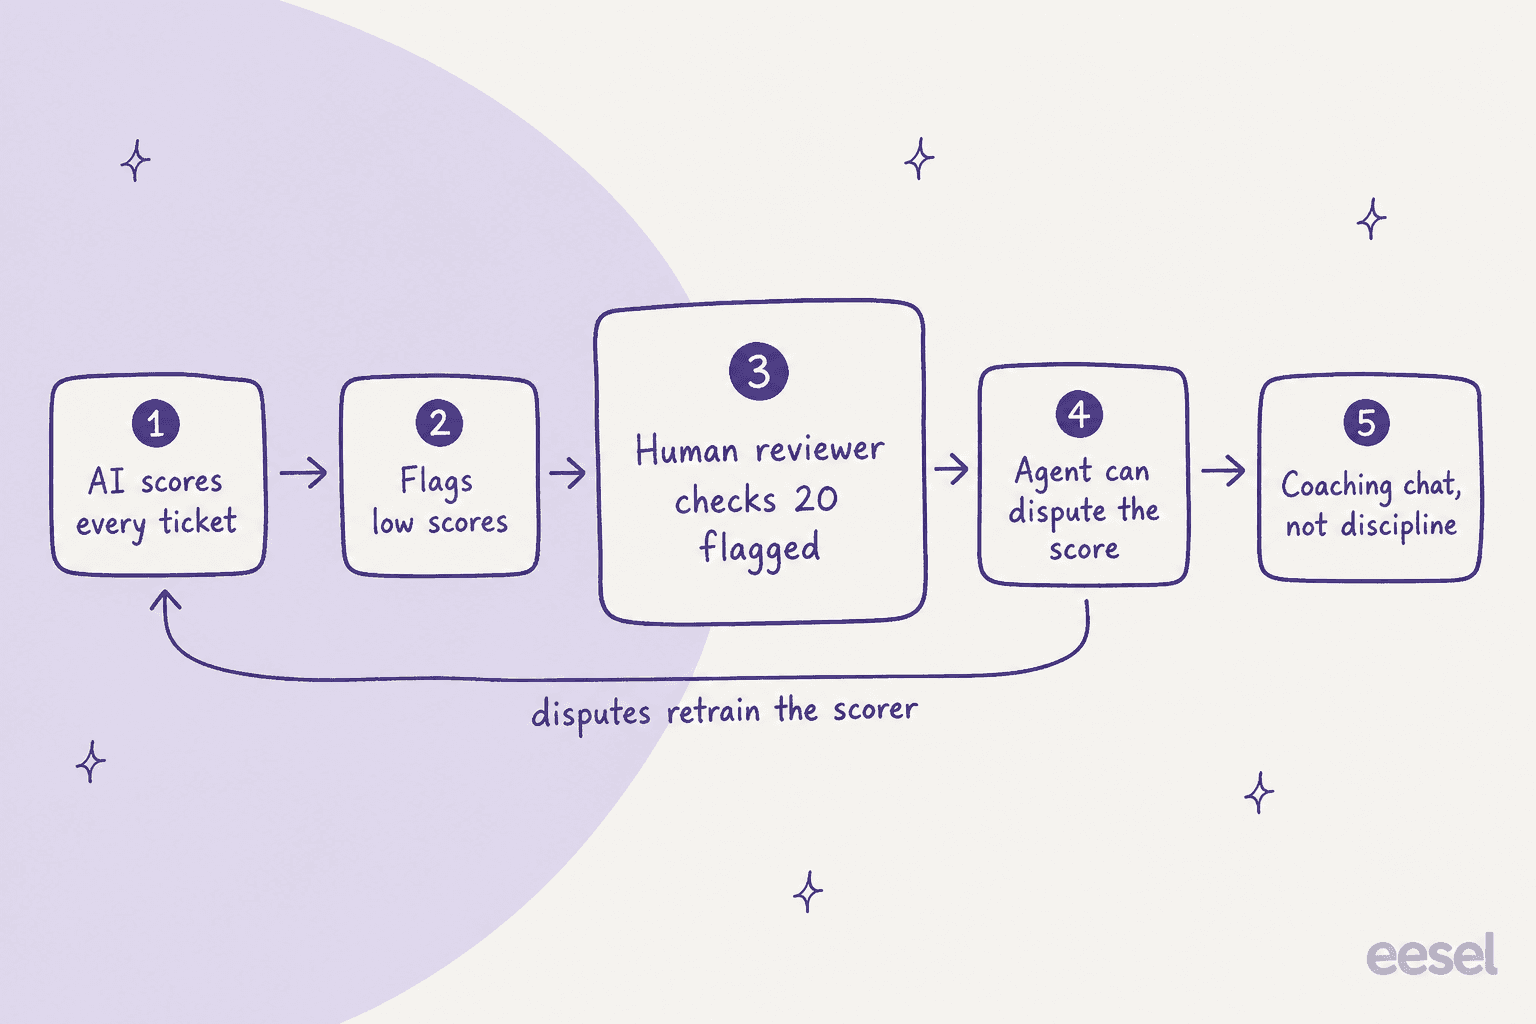
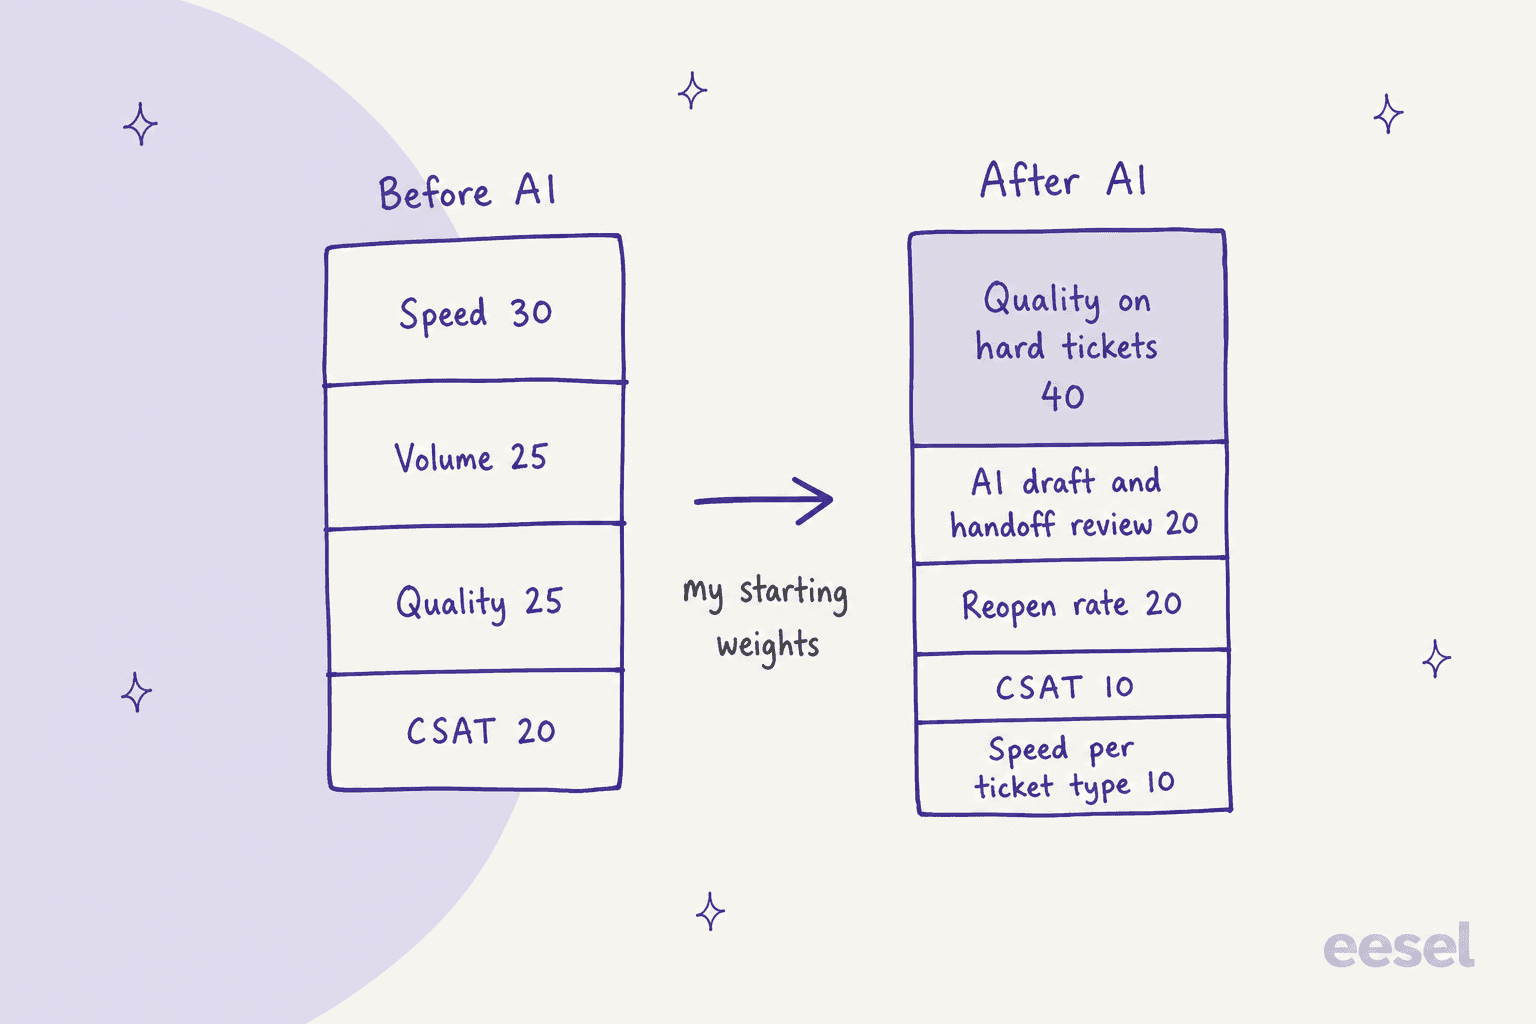
Esta é a reponderação que eu usaria como ponto de partida. São pesos iniciais meus, não um benchmark, então ajuste-os depois da primeira rodada de calibração. O que muda:
- Elimine as metas de volume individuais. Os tickets encerrados por agente caem por definição quando a IA desvia os mais fáceis. Acompanhe o total de horas dos agentes na fila, como explico em IA para reduzir o tempo de atendimento.
- Meça a velocidade por tipo de ticket. Um ticket de reembolso e uma redefinição de senha nunca devem compartilhar o mesmo benchmark. O Gorgias já calcula o tempo de atendimento do ticket apenas nos tickets que um humano atendeu e deixa de fora os tickets resolvidos pelo AI Agent. Copie essa regra em qualquer helpdesk.
- Inclua uma linha sobre o trabalho com a IA. Os agentes agora aprovam, editam ou rejeitam rascunhos e recebem transferências. Na smava, a eesel preparou cerca de 15.300 rascunhos de resposta em um mês em um Zendesk compartilhado, e o agente aprova um rascunho ou escreve @eesel em uma nota para pedir uma macro diferente. Revisar isso bem é uma habilidade: uma nota para "identificou um rascunho errado" e "deixou uma nota de transferência útil" merece lugar no scorecard.
- Revise a transferência, não só a resposta. Se a IA transfere o ticket com o pedido já verificado, isso é qualidade da transferência, e ela afeta os números do agente mais do que a velocidade de digitação.
Um comentarista do Reddit com quase 30 anos de suporte resumiu sem rodeios o custo de ignorar isso:
"Except now imagine an eight-hour shift where practically EVERY conversation you receive is an escalation, an angry customer, an unusual problem or something the AI already couldn't solve."
Isso também é uma questão de coaching e de escala, e trato do lado da equipe em IA para dimensionamento de equipes de suporte e do lado dos turnos em IA para passagem de turno.
Quais ferramentas de helpdesk pontuam a qualidade dos agentes com IA?
Cinco helpdesks oferecem algo nativo, e eles diferem mais do que o marketing sugere. Li a documentação e a página de preços de cada fornecedor, então a tabela abaixo usa apenas as palavras e os preços deles.
| Helpdesk | O que pontua | Quanto do ticket a IA julga | Preço conforme divulgado |
|---|---|---|---|
| Zendesk QA | Todas as interações, de humanos e de agentes de IA; categorias nativas como Empatia ou Solução, além de categorias próprias baseadas em prompts | O que você escrever no scorecard | Complemento de QA em todos os planos Suite, preço não divulgado; o Workforce Engagement Bundle custa US$ 50 por agente por mês, cobrado anualmente |
| Gorgias Auto QA | Tickets encerrados, pontuados 12 horas após o encerramento | 3 critérios (completude da resolução, comunicação, linguagem); outros 4 (precisão, eficiência, conformidade interna, voz da marca) são apenas manuais | Ativado por padrão com uma assinatura do AI Agent, que custa US$ 1,50 por interação automatizada acima do limite do plano |
| Front Smart QA | Todos os tickets, com base em scorecards personalizáveis, além do Smart CSAT | Critérios que você define | Listado como incluído no Enterprise, US$ 105 por usuário por mês, cobrado anualmente |
| Nota de QA da HubSpot | Tickets encerrados do help desk, de 1 a 5 | 3 critérios (tom, clareza, empatia); beta | Service Hub Enterprise, US$ 150 por usuário por mês |
| Freshdesk Quality Coach | Conversas resolvidas, exibidas aos agentes na caixa de entrada, além de um relatório administrativo de Quality Score | 6 parâmetros (abertura e encerramento, pontualidade, qualidade da resposta, sentimento, gramática, palavras de preenchimento) | Ativado nas configurações do Freddy Copilot; o Freddy AI Copilot custa US$ 29 por agente por mês nos planos Pro e Enterprise |
Algumas coisas que notei ao lê-los lado a lado:
- O Zendesk é o mais flexível e o menos transparente no preço. Você escreve os critérios, e o Spotlight sinaliza riscos de cancelamento e loops travados. O QA de AI Agent dele também compara lado a lado as notas de bots e de humanos. O custo é uma conversa com o time de vendas. Explico a configuração em critérios de scorecard do Zendesk QA e Zendesk QA para agentes de IA.
- O Gorgias é o mais honesto sobre seus limites. A documentação diz claramente que precisão e voz da marca só podem ser pontuadas manualmente, que critérios personalizados não estão disponíveis no momento e que tickets com menos de 250 caracteres, tickets de redes sociais e ligações são ignorados. Isso é útil: você sabe qual metade do scorecard ainda precisa de um humano. Veja preços do Gorgias AI Agent para o lado do custo.
- O Front reúne o QA com a inferência de CSAT, então você tem uma visão de qualidade e uma visão de satisfação inferida por IA no mesmo lugar. Preços do Front traz os detalhes dos planos.
- O da HubSpot é o mais cauteloso. É beta e exclusivo do Enterprise; se isso compensa o preço por usuário é uma pergunta que discuto em HubSpot Service Hub AI.
- O do Freshdesk é o mais antigo, e o artigo de ajuda é de 2024, então confira-o com o seu plano antes de montar um processo em cima dele. Os planos estão em preços do Freshdesk.
Se você não usa nenhum deles ou quer uma visão neutra em relação a fornecedores, ferramentas de garantia de qualidade para suporte ao cliente compara as plataformas de QA independentes.
Como manter as notas da IA justas com os agentes?
Trate cada nota como um sinal que escolhe tickets para um humano ler, nunca como um veredicto. Os próprios fornecedores dizem isso: o artigo de ajuda da HubSpot avisa que suas notas de QA podem ser imprecisas e não devem ser a única base para decisões de coaching, desempenho, remuneração, disciplina ou outras decisões sobre uma pessoa.
O ciclo que eu seguiria:
- Pontue todos os tickets com IA. Essa é a correção do denominador, da primeira seção.
- Leia você mesmo os sinalizados. Vinte tickets sinalizados por semana por equipe valem mais do que cinco aleatórios por agente, porque você está lendo onde está o sinal.
- Calibre. Peça a duas pessoas que pontuem os mesmos 20 tickets e compare com a IA. Onde houver divergência, corrija a redação do critério, não as pessoas. Uma discussão no G2 pergunta justamente como as equipes mantêm a calibração humana junto com a pontuação por IA, e a resposta usual é que a IA faz a primeira triagem e as sessões humanas continuam.
- Deixe os agentes contestarem. O Gorgias permite que um revisor edite qualquer parte de uma nota e usa essas edições para ajustar o modelo. Mesmo onde a sua ferramenta não faz isso, um agente que pode dizer "esta nota está errada, e aqui está o porquê" torna o sistema mais preciso e mais confiável.
- Nunca aplique medidas disciplinares só com base em sentimento. As notas de sentimento e de tom punem quem atende os clientes mais irritados, o que, depois do desvio feito pela IA, é todo mundo.
Meu post sobre análise de sentimento com IA para suporte explica por que o sentimento é um péssimo juiz de um agente individual. A justiça também é o motivo pelo qual eu testaria um avaliador antes de confiar nele, do mesmo jeito que você simularia um agente de IA.
Como transformar notas em coaching?
Escolha um comportamento por agente por mês, mostre dois tickets e combine uma mudança. As notas encontram os tickets; a conversa faz o trabalho.
Um plano de 30 dias, na ordem em que eu o faria:
- Semana 1, defina o denominador. Ative o QA com IA do seu helpdesk e deixe que ele pontue todos os tickets encerrados. Ainda não olhe os rankings por agente.
- Semana 2, calibre. Faça a verificação com 20 tickets descrita acima e reescreva qualquer critério que os humanos e a IA leiam de forma diferente.
- Semana 3, reajuste os pesos. Passe para o scorecard pós-IA: sem meta de volume individual, velocidade por tipo de ticket, uma linha para a revisão de rascunhos e transferências.
- Semana 4, comece as conversas individuais. Um ponto forte e um hábito por agente, com os dois tickets como evidência. Coaching de agentes com IA e software de coaching para suporte ao cliente cobrem as ferramentas, e coaching de agentes de IA para suporte trata de treinar a própria IA.
Para novos contratados, o mesmo ciclo funciona mais rápido, já que os rascunhos da IA servem como exemplos prontos: veja integração de agentes de suporte ao cliente.
Como a eesel se encaixa no desempenho dos agentes?
A eesel não pontua os seus agentes humanos. Ela muda no que eles trabalham. A eesel é uma colega de IA para helpdesk que fica dentro do seu helpdesk atual, responde ou redige os tickets repetitivos e passa o restante a uma pessoa com uma nota, de modo que a nota que você monta para a sua equipe reflita o trabalho que sobrou. A eesel opera IA em filas de suporte reais há anos, e cada implantação é simulada primeiro com tickets históricos, o que oferece a visão de antes e depois da fila humana de que um scorecard justo precisa.
Três histórias publicadas de clientes mostram o padrão em helpdesks diferentes:
- Gorgias: a Question Beauty fez a eesel enviar cerca de 960 respostas e encerrar cerca de 280 de 990 tickets em um mês; cerca de 250 foram para uma pessoa com a consulta do pedido já anexada.
- Zendesk: a smava atende cerca de 27.000 tickets por mês em um único Zendesk, em duas marcas. A eesel categorizou cerca de 14.600 deles e preparou cerca de 15.300 rascunhos, e as pessoas aprovam ou redirecionam cada rascunho.
- Freshdesk: na SamCart, a eesel responde aos tickets apenas enquanto nenhum agente estiver atribuído, e um colega que assume o ticket encerra a participação da IA, o que é uma linha clara para decidir de quem são os tickets que entram no scorecard de cada um.

Para avaliar a própria IA, use o scorecard de piloto de IA para suporte, o guia de taxa de resolução da IA e contenção e qualidade da escalação. Para o lado do custo, custo de agente de IA versus agente humano traz a comparação.
Experimente a eesel nos tickets em que sua equipe não deveria ser avaliada
Se os seus agentes estão sendo pontuados por redefinições de senha e perguntas sobre status de pedido, passe esses tickets primeiro para a eesel e reajuste o scorecard em torno do que sobrar. Ela se conecta ao Zendesk, ao Freshdesk, ao Gorgias, ao HubSpot e ao Front, e aprende com a sua central de ajuda e com os tickets anteriores.
Os preços da eesel são planos fixos de créditos: um ticket ou um chat custa 1 crédito, não importa quanto tempo dure, o plano gratuito tem 100 créditos para testar todos os recursos, e os planos pagos começam em US$ 299 por mês por 500 créditos. Experimente a eesel com os seus próprios tickets e veja quanto da sua fila é do tipo fácil.