

Por que o QA de suporte multilíngue falha em silêncio
A maioria dos programas de QA de suporte é construída em inglês e depois esticada. A scorecard é copiada, o grupo de revisores continua o mesmo e alguém liga um botão de traduzir para que os revisores de língua inglesa consigam "ler" a fila em alemão. As notas voltam com aparência boa. Esse é o problema.
Já vi isso dar errado por dentro. A eesel roda IA em helpdesks ao vivo em alemão, holandês, francês, espanhol, romeno e mais há anos, e o pior bug multilíngue que vi a eesel entregar não foi uma tradução ruim. No início de 2026, rascunhos de resposta em alemão e holandês saíram com placeholders crus como {{ticket.requester.first_name}} e [Employee Name], em helpdesks belgas, alemães e holandeses. Um corretor de gramática teria dado nota boa a esses rascunhos. Um falante nativo lendo a resposta uma vez teria percebido em dois segundos.
Esse é o padrão. Os erros que importam em um segundo idioma, na maioria, não são erros de ortografia.
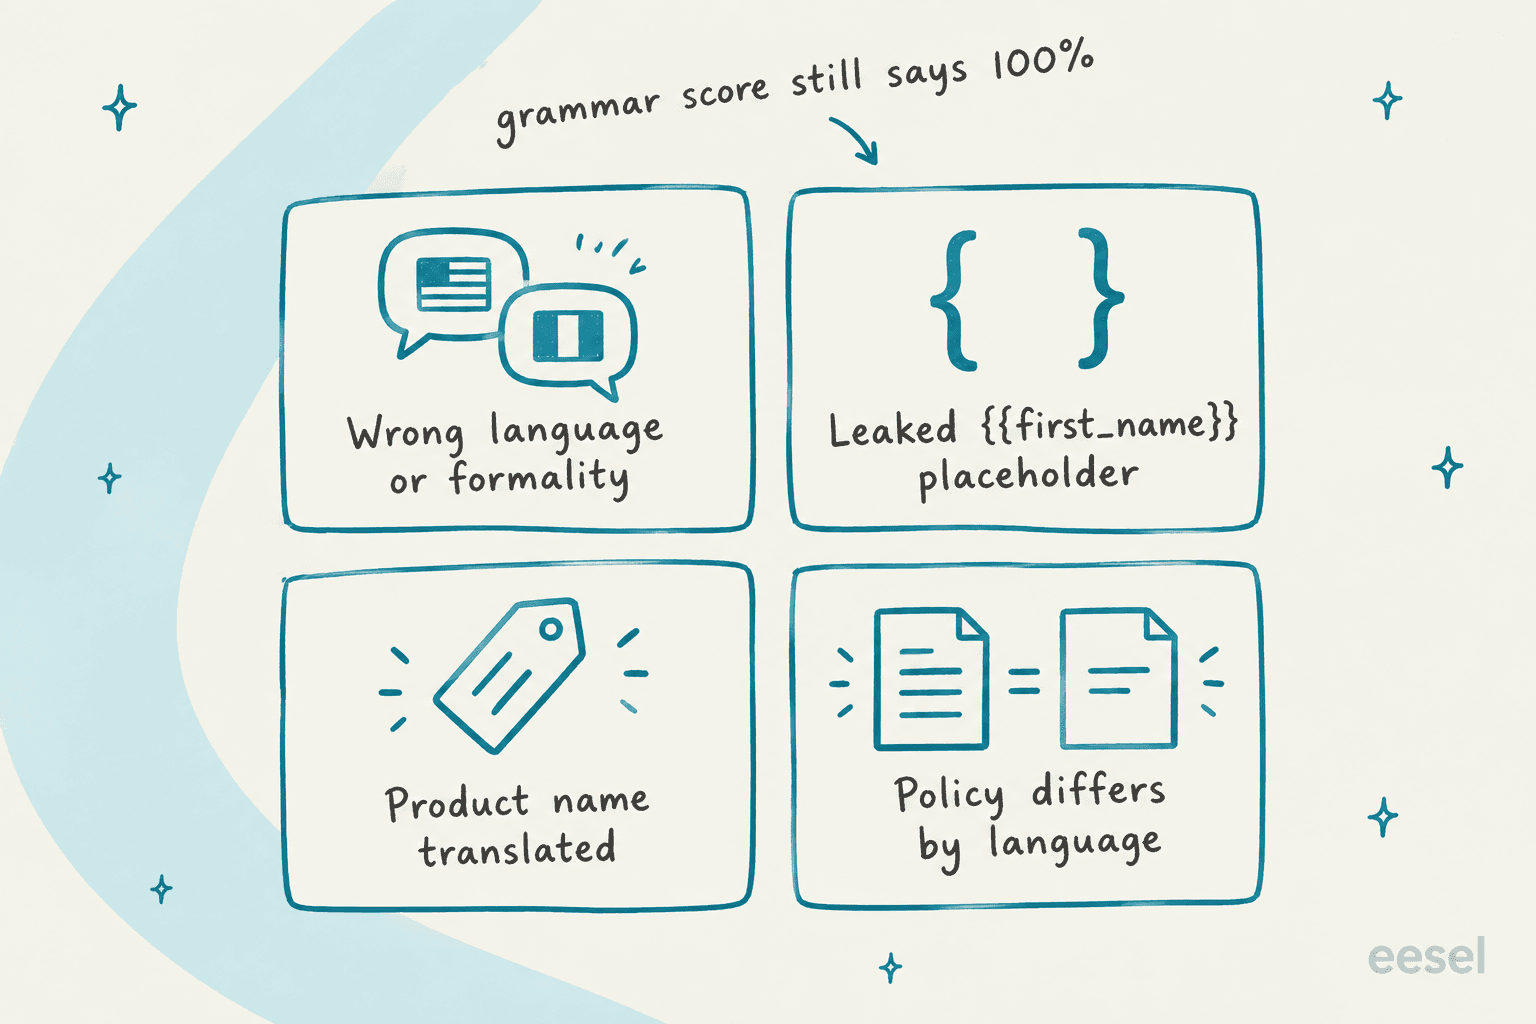
Veja o que escapa quando o QA em outros idiomas é só o QA em inglês com um botão de traduzir:
- Registro e formalidade. Alemão du versus Sie, francês tu versus vous, os níveis de cortesia do japonês. A tradução automática achata isso, então um revisor lendo a versão em inglês nunca vê que o agente tratou um cliente B2B de 60 anos como um adolescente.
- Vazamentos de mecânica. Placeholders, fragmentos em inglês esquecidos numa macro, uma despedida em inglês numa resposta em espanhol. Isso soa como "ninguém aqui fala o meu idioma".
- Terminologia. O nome do seu produto traduzido para um substantivo comum, ou três palavras diferentes para a mesma funcionalidade numa só resposta. Escrevi um guia inteiro sobre glossários de tradução para suporte porque hoje nenhum helpdesk entrega um glossário no nível do ticket.
- Deriva de políticas. A macro em inglês diz devolução em 30 dias, a macro em francês foi traduzida há dois anos e ainda diz 14. Cada resposta é gramaticalmente perfeita e uma delas está errada.
O que pontuar em uma resposta que não está em inglês
Mantenha uma scorecard para todos os idiomas. Dividir em uma "scorecard em alemão" e uma "scorecard em inglês" é o jeito de as notas deixarem de ser comparáveis. O que muda por idioma é quem pode avaliar cada linha e como são os exemplos.
Divido as categorias com uma pergunta: isso sobrevive à tradução? Se um revisor lendo uma tradução automática consegue avaliar com confiança, qualquer revisor treinado pode pontuar. Se o sinal está na redação original, só deve pontuar quem lê o idioma.
| Linha da scorecard | O que verifica | Dá para avaliar com segurança a partir de uma tradução? |
|---|---|---|
| Solução e precisão | Resposta certa, política certa, próximo passo certo | Sim, se a tradução for fiel |
| Processo | Etiquetado, vinculado e escalado corretamente | Sim |
| Compreensão | O agente entendeu a pergunta real | Na maioria |
| Correspondência de idioma | Respondeu no idioma do cliente, sem fragmentos em inglês | Em parte (precisa da visão original) |
| Ortografia e gramática | Mecânica no idioma original | Não |
| Formalidade e tom | Sie vs. du, nível de cortesia, calor humano | Não |
| Terminologia | Nomes de produto intactos, termos aprovados usados | Não |
| Placeholders e vazamentos | Sem tokens {{ }}, sem notas internas, sem despedida no idioma errado | Sim, mas só no original |
As quatro linhas com "Não" são para onde devem ir suas horas de revisão nativa. Todo o resto pode ser avaliado pelos revisores que você já tem, com uma tradução, o que mantém o programa acessível. Para a rubrica geral por trás dessas linhas, meu guia sobre qualidade do idioma no suporte ao cliente detalha gramática, clareza e tom, e o guia de tom no atendimento ao cliente mostra como escrever regras de tom contra as quais dá para avaliar de verdade.
Mais uma regra para a scorecard: faça de "a política difere da fonte em inglês" um erro crítico. O MQM, o framework que equipes profissionais de tradução usam para pontuar qualidade, trata um único erro crítico como reprovação automática, não importa o quão bom seja o resto (MQM values and scores). O QA de suporte deveria pegar isso emprestado. Uma política de reembolso errada e lindamente escrita continua sendo uma política de reembolso errada.
Pegue emprestados os tipos de erro que os tradutores já usam
Você não precisa inventar categorias. O MQM classifica os erros de tradução em sete grupos: terminologia, precisão, convenções linguísticas, estilo, convenções locais, adequação ao público e design e marcação (MQM error typology). Suas penalidades padrão são 0 para neutro, 1 para leve, 5 para grave e 25 para crítico (MQM values and scores). A ISO 5060:2024 é o padrão formal construído sobre a mesma abordagem de tipo de erro mais penalidade.
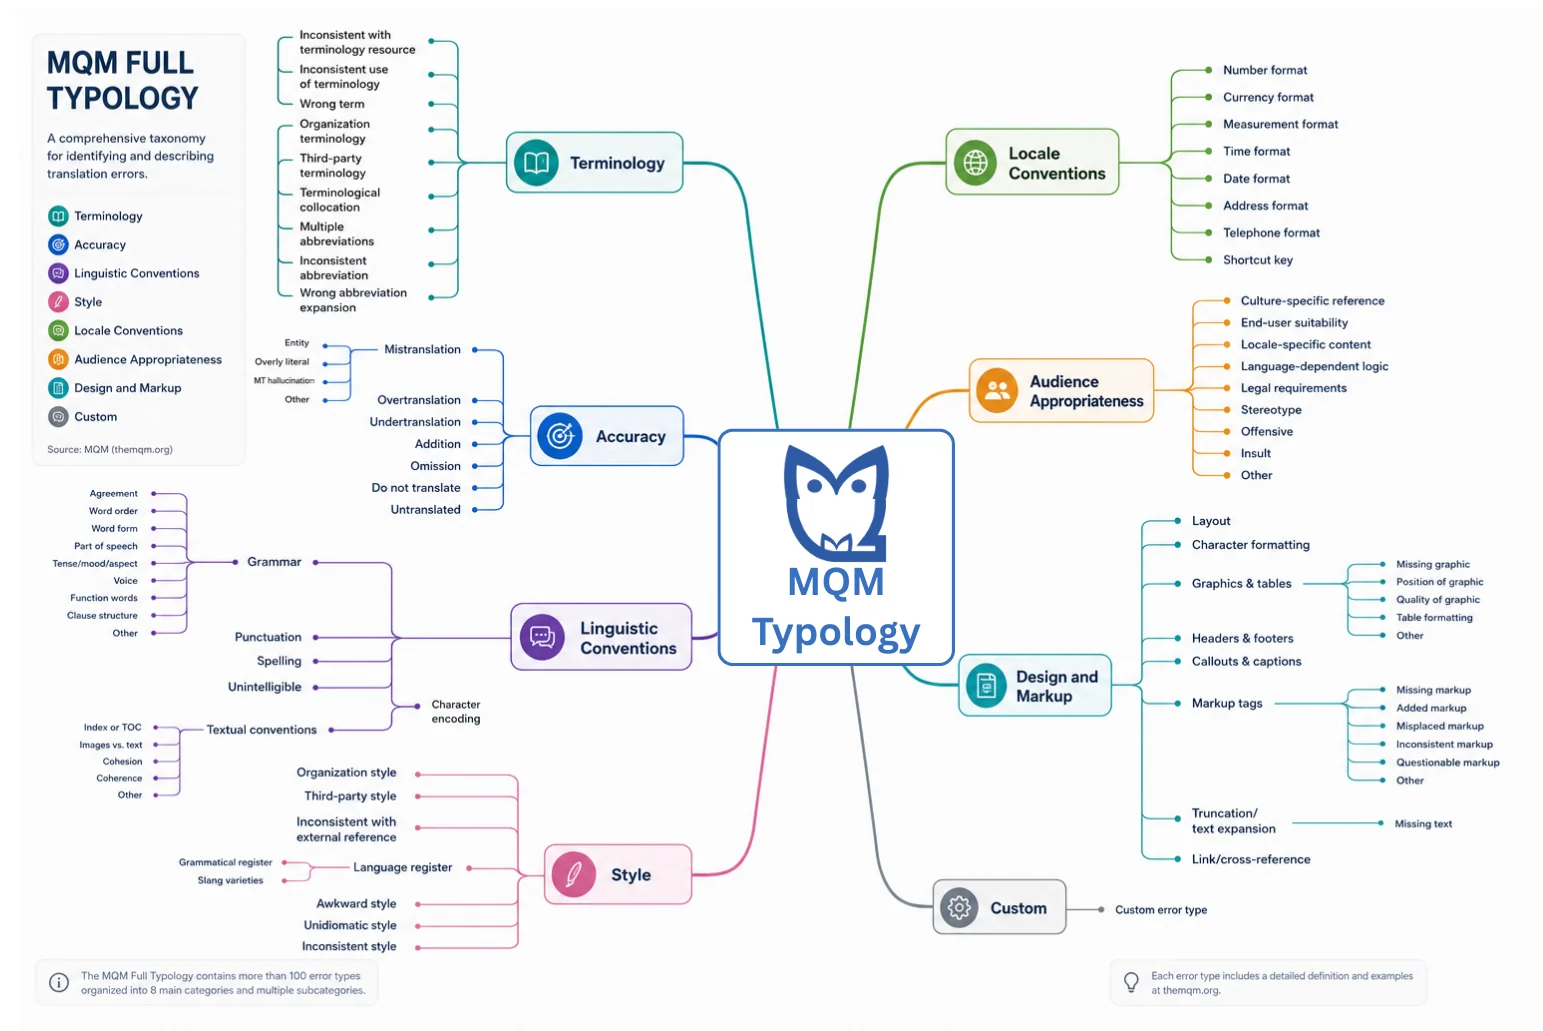
Dois ramos se encaixam bem no trabalho de suporte. "Convenções locais" cobre formatos de data, moeda, número e endereço, exatamente onde um agente treinado nos EUA escreve 10/05 para um cliente alemão que lê como 10 de maio. "Design e marcação" cobre marcação ausente ou quebrada, a família a que pertence o vazamento de placeholder. Eu não rodaria a pontuação completa do MQM em tickets de suporte (ela foi feita para documentos traduzidos e conta erros por 1.000 palavras), mas usar os nomes de categoria dele como tags de erro torna seus dados de QA muito mais acionáveis.
Como amostrar tickets quando um idioma é 84% do volume
A amostragem aleatória é justa entre tickets e injusta entre idiomas. Se o inglês é 84% do seu volume, o alemão 12% e o holandês 4%, uma amostra aleatória de 50 revisões por semana resulta em 42 em inglês, 6 em alemão e 2 em holandês. Duas revisões não conseguem dizer se seu agente de holandês tem um hábito ou teve uma terça-feira ruim. Equipes de telefone têm o mesmo problema, por isso os programas de QA de call center costumam estratificar as amostras também.
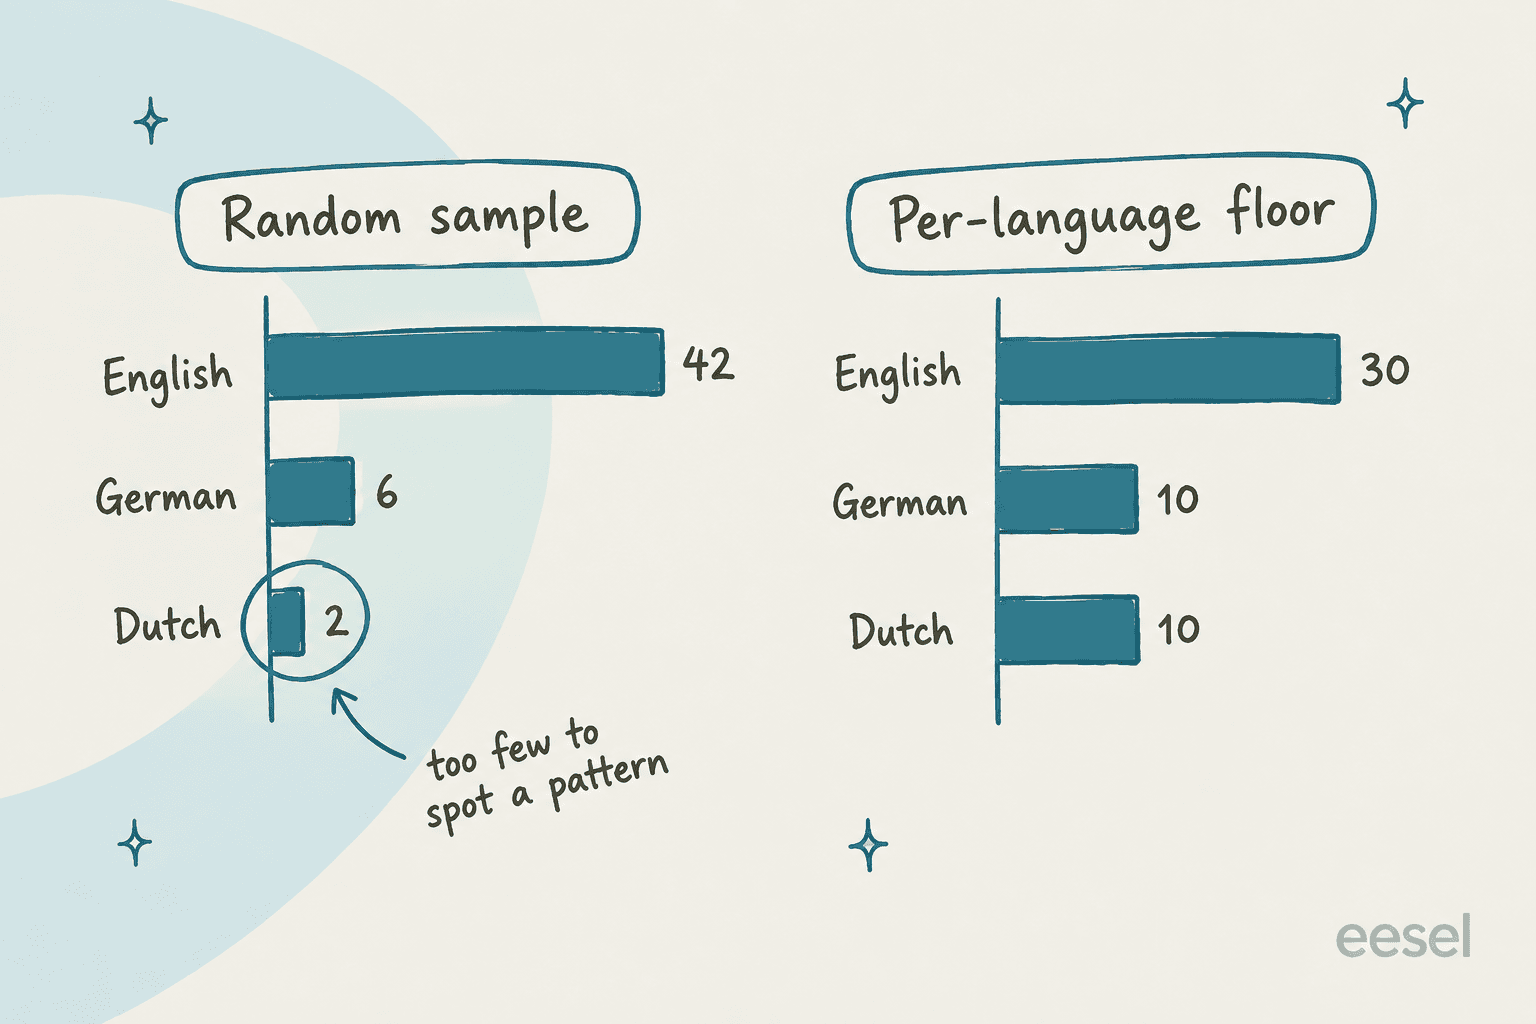
A solução é um piso: cada idioma recebe pelo menos N revisões por semana, e o que sobrar do orçamento vai para os idiomas grandes em proporção ao volume. Com um piso de 10, as mesmas 50 revisões viram 30 em inglês, 10 em alemão e 10 em holandês. O inglês ainda recebe a maior atenção. O holandês finalmente recebe o suficiente para ver um padrão.
Coloque seus próprios números aqui:
Um piso de cerca de 10 por idioma por semana é o menor número em que eu confiaria numa tendência. Se seu orçamento não cobre isso para todos os idiomas, revise os idiomas pequenos a cada duas semanas com 20 em vez de toda semana com 5. Menos lotes, porém maiores, vencem um gotejamento.
Dois filtros tornam a amostra mais inteligente, não apenas maior:
- Sobreamostre agentes novos e idiomas novos. O primeiro mês de um novo mercado ou de uma nova contratação é quando os erros são mais baratos de corrigir. Meu guia de onboarding de agentes explica como antecipar a revisão para quem está começando.
- Sobreamostre CSAT baixo em idiomas pequenos. Um cliente holandês irritado é 1 em 25 tickets em holandês, não 1 em 625 no total. Puxe esses sempre. Ferramentas de CSAT com IA podem destacá-los automaticamente.
Quem revisa o quê: revisores nativos versus revisão traduzida
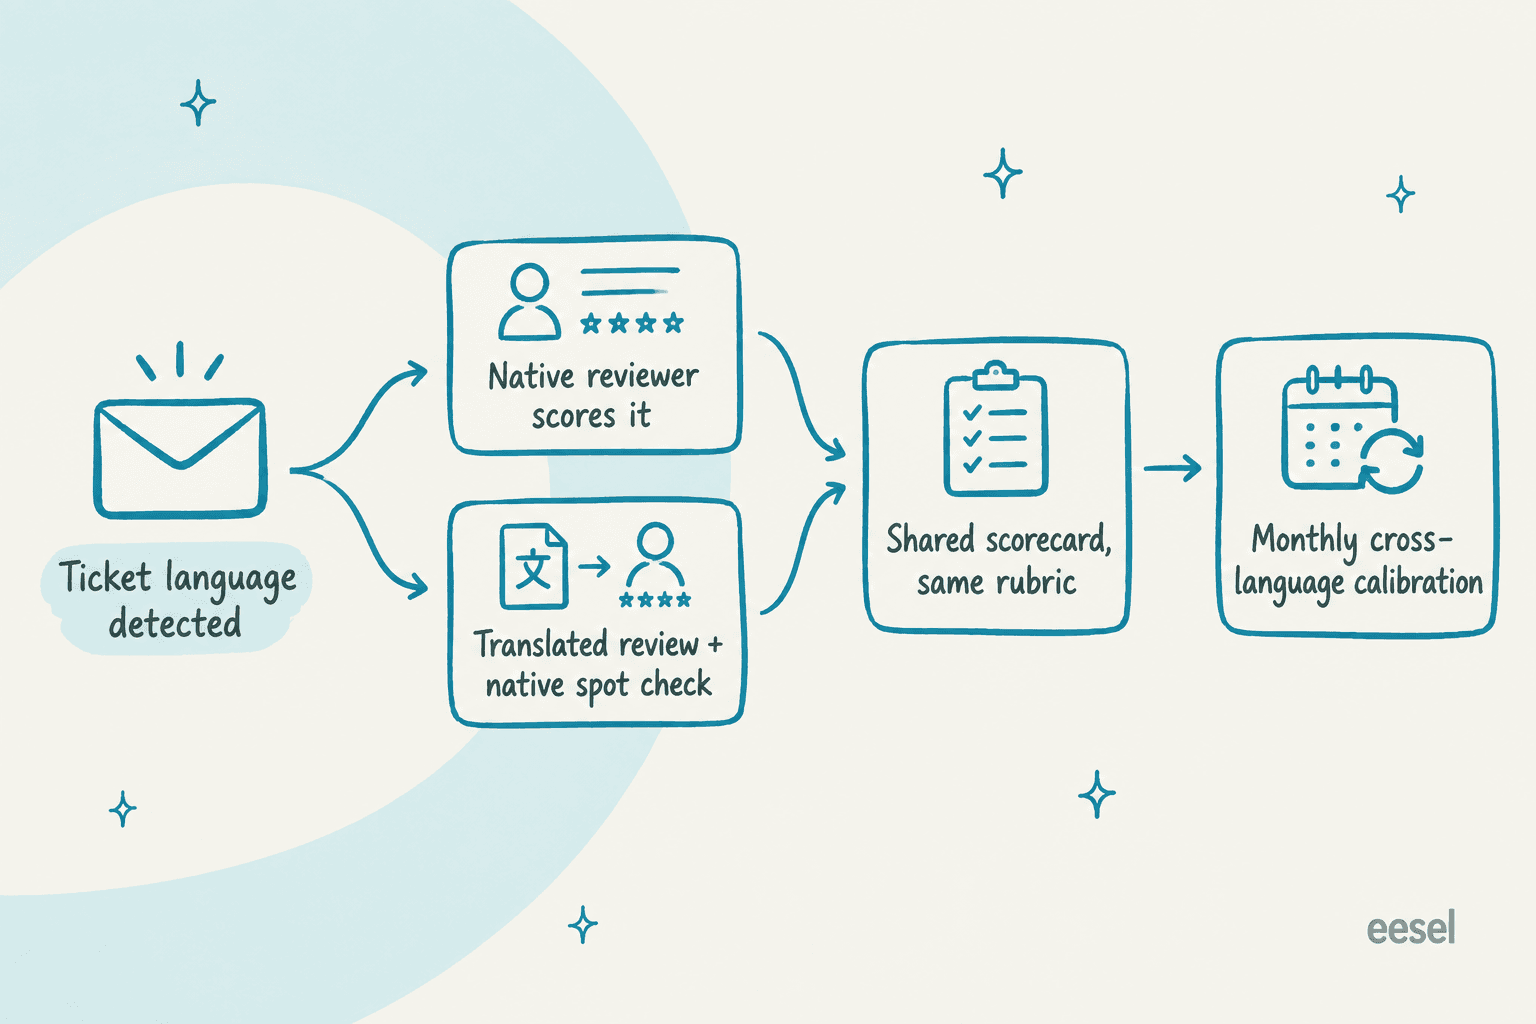
Há três formas de montar a equipe de QA em outros idiomas, e a maioria das equipes acaba usando as três.
1. Revisores nativos em cada idioma. O padrão-ouro e o mais caro. Normalmente um agente sênior daquela equipe de idioma, com algumas horas por semana para revisão. Em equipes offshore, costuma ser o líder da equipe naquele polo. Eles são donos das quatro linhas "Não" da scorecard.
2. Revisão traduzida pela sua equipe central de QA. Seus revisores atuais avaliam solução, processo e compreensão por meio de uma tradução na ferramenta. Barato, e mantém um mesmo par de olhos na precisão em todos os mercados. Equipes com suporte follow-the-sun são as que mais se apoiam nisso.
3. Amostragens nativas sobre revisões traduzidas. Uma vez por mês, um falante nativo reavalia um punhado de conversas que a equipe central já pontuou via tradução. Se as notas se afastarem, a revisão traduzida está deixando algo passar e você move mais volume para a opção 1. É também onde você encontra lacunas de conhecimento que só existem em um idioma.
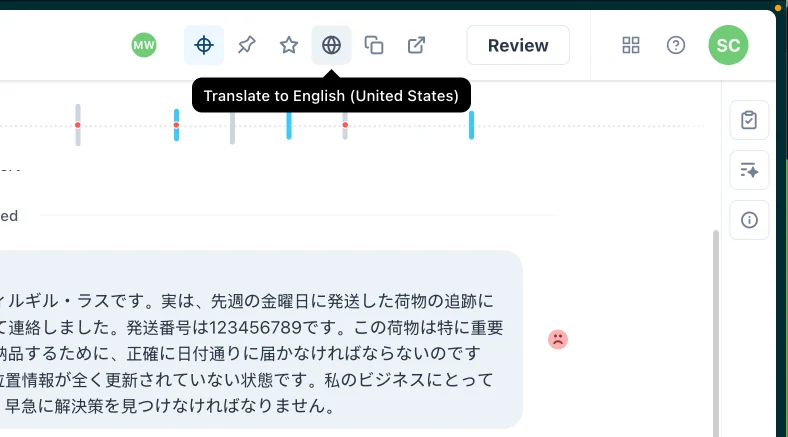
O roteamento é a parte que as ferramentas hoje fazem bem. No Zendesk QA, os revisores podem traduzir uma conversa para o idioma do próprio perfil clicando em um ícone de globo e voltar ao original (Using the Conversations view). Isso cobre 29 idiomas principais, e árabe, hebraico e ucraniano não estão na lista do QA, embora a tradução ao vivo do Support os cubra (Zendesk language support by product).
Para o roteamento, o Zendesk QA tem um filtro de conversa Language (AI) com condições "é" / "não é" (conversation filter types), e os grupos podem organizar revisores "com base em características como o idioma" para uso em atribuições (groups in Zendesk QA). Não encontrei um único botão de "amostrar N por idioma". Você constrói o piso criando uma atribuição por idioma com uma condição Language (AI) e uma contagem fixa.
Um detalhe do lado do Zendesk Support: o campo Language da triagem inteligente é lido do assunto e do primeiro comentário público e "não é atualizado a cada resposta do usuário final" (intelligent triage). Um cliente que começa em inglês e passa para o alemão continua sendo um ticket "em inglês". Usar valores de triagem em fluxos de trabalho também exige o complemento Copilot (triage workflows). Mais sobre essa configuração no meu guia de triagem inteligente do Zendesk.
Isto é o que acontece sem isso. Um líder de QA de call center foi direto no Reddit:
"I was responsible for QA on a team taking Spanish calls. Don't speak a word myself. Yea, plenty of 100's were given."

Notas perfeitas de um revisor que não consegue ler a conversa não são dados de qualidade. São um ponto cego com um número.
O que o QA automatizado pode e não pode pontuar em outros idiomas
O QA automatizado fecha a lacuna de cobertura, mas sua lista de idiomas é mais curta do que a maioria das equipes imagina. Esta é a cobertura do AutoQA do Zendesk QA, que exige o complemento de QA ou de Workforce Engagement (autoscoring categories):
| Categoria do AutoQA | Idiomas com a opção de LLM ativada | Com ela desativada |
|---|---|---|
| Ortografia e gramática | 9 variantes: inglês (EUA, Reino Unido), alemão, francês, polonês, espanhol, português (BR, PT), holandês | As mesmas 9 |
| Legibilidade | Inglês, espanhol | Inglês, espanhol |
| Saudação, encerramento | Todos | 8 idiomas |
| Tom, empatia, compreensão, solução oferecida | Todos | Indisponível |
Releia essa primeira linha. Um agente em italiano, japonês ou sueco não recebe nenhuma nota automática de ortografia e gramática, nem mesmo com a opção de LLM ativada. Se metade da sua equipe escreve nesses idiomas, seu painel de "100% de cobertura" está avaliando todos eles em tudo, menos naquilo que um cliente nativo percebe primeiro.
As configurações por idioma também importam. As exceções de ortografia (até 300) e as saudações aprovadas (até 200) são etiquetadas cada uma com um idioma, e "as saudações não são traduzidas" (customizing AutoQA). O exemplo do próprio Zendesk: aprove "Bom dia" para todos os idiomas e um agente que escreva "Buenos días" numa conversa em espanhol recebe um voto negativo.
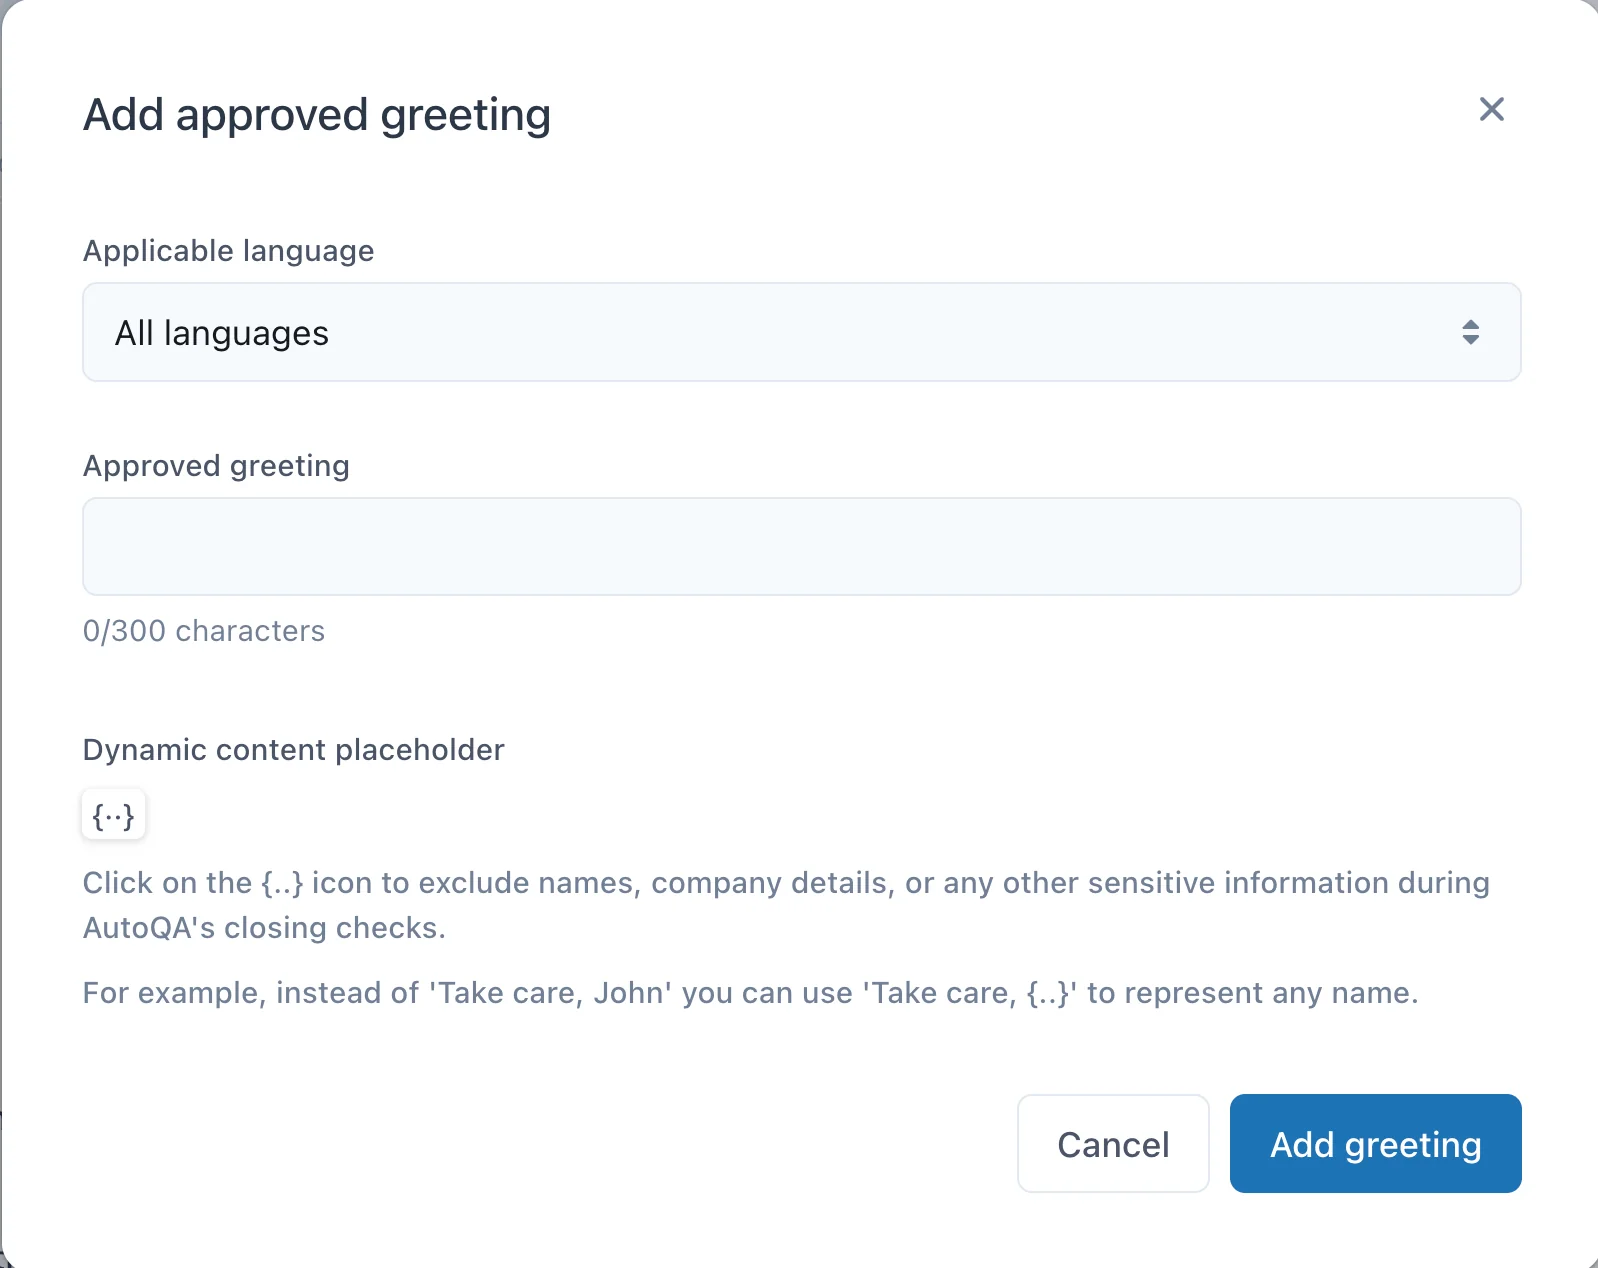
Então defina saudações e encerramentos por idioma no primeiro dia, ou suas notas automáticas punirão exatamente os agentes que estão fazendo a parte localizada certa. O Zendesk também diz que suas avaliações automáticas são "apenas orientativas" e não devem guiar sozinhas decisões de desempenho (Zendesk QA account settings), a postura certa para qualquer idioma em que a nota automática tenha lacunas.
Outras plataformas de QA documentam menos. O evaluagent permite escrever linhas de QA de IA generativa no seu próprio idioma e detecta automaticamente o idioma falado nas ligações. A Rippit (o novo nome da MaestroQA) pontua 100% das conversas com agentes em linguagem natural (Rippit announcement), mas não encontrei recursos documentados de tradução ou de filtro de idioma. Se a cobertura de idiomas importa para você, peça a lista por escrito antes de comprar.
As ferramentas de QA com IA que comparei variam bastante aqui, e meu panorama de ferramentas de QA cobre o campo mais amplo.
O que seu helpdesk oferece aos revisores de fábrica
A ferramenta de QA é só metade da história. Os revisores costumam trabalhar dentro do helpdesk, e o que eles conseguem ver ali depende do recurso de tradução que seus agentes usam.
| Helpdesk | Detecção de idioma | Tradução que um revisor pode ver | Plano ou limite |
|---|---|---|---|
| Zendesk | Campo Language da triagem, ~150 idiomas, só a primeira mensagem | Tradução de conversas em todos os canais exceto voz; traduções de chats recebidos não são salvas e rodam de novo ao recarregar | Tradução de tickets no Team+; triagem em fluxos de trabalho exige Copilot |
| Freshdesk | Detectado por ticket, agentes podem substituir | Live Translate com "See original", 43 idiomas | Pro/Enterprise, 100 tickets traduzidos por licença de Copilot por mês |
| Gorgias | Até 54 idiomas, só o corpo da mensagem | Tradução de entrada e saída, passe o mouse para ver o original | Todos os planos de helpdesk |
| Front | Detectado automaticamente em entrada e saída | A tradução fica visível para todos os colegas na conversa | Starter+, 1.500 solicitações por colega por dia |
| Help Scout | Não documentado para entrada | O AI Assist traduz apenas o texto de saída | Plus/Pro, ou planos por contato |
Duas linhas dessa tabela causam dores de cabeça reais no QA. As traduções de chats recebidos do Zendesk "rodam de novo toda vez que um ticket é atualizado ou recarregado, então os resultados da tradução podem variar" (Zendesk), então o inglês que um revisor lê pode não ser o inglês que o agente viu. E o Freshdesk conta um ticket de novo quando outro agente o traduz (Freshdesk), então um revisor de QA que abre a tradução pode consumir o limite mensal dos agentes. No Freshdesk, faça os revisores usarem a tradução da ferramenta de QA, não a dos agentes.
Para se aprofundar em cada ferramenta, veja as opções nativas de tradução do Zendesk, o Front AI Translate e o Freddy AI Copilot.
Se você usa uma camada de tradução, leia o relatório de qualidade dela
Equipes com Unbabel ou Language I/O já têm um segundo sinal de QA e muitas vezes o ignoram. O Unbabel roda uma estimativa de qualidade em cada tradução, prevendo a nota MQM que um revisor humano daria. Seus relatórios classificam as traduções em cinco faixas, de Best (98 ou mais) a Weak (abaixo de 60), e um par de idiomas reprova no limite quando mais de 10% cai no vermelho (Unbabel quality reporting).
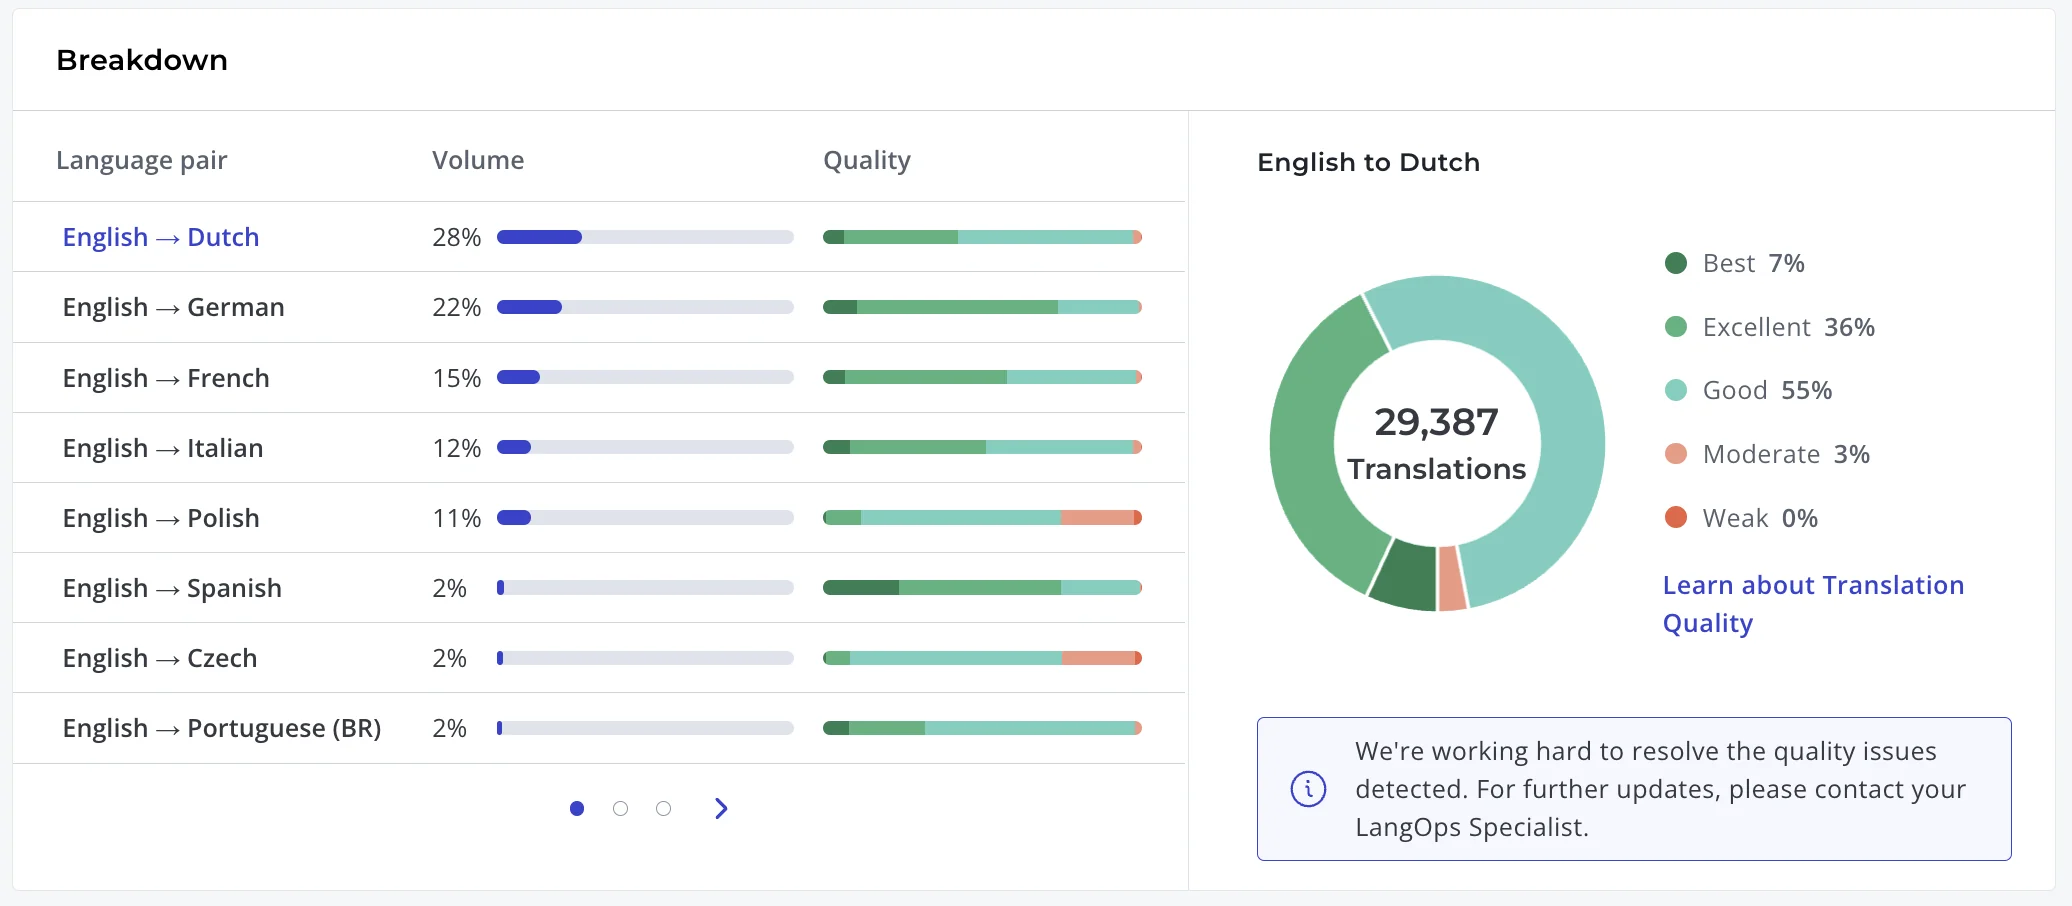
Essa visão por par é útil para a amostragem. Se inglês para polonês tem visivelmente mais traduções Moderate que inglês para alemão, ponha mais das suas horas de revisão nativa em polonês no mês seguinte. A Language I/O descreve um monitoramento de qualidade em tempo real contra resultados anteriores e regras de glossário, e deixa os agentes sinalizar e regenerar uma tradução ruim, embora não publique uma escala de pontuação.
O que esses relatórios não conseguem dizer: se a resposta de origem estava certa. Uma tradução perfeita de uma resposta errada pontua Best. Qualidade de tradução e qualidade de suporte são duas verificações diferentes, e você precisa das duas.
Como calibrar entre equipes de idiomas
A calibração é onde os programas de QA multilíngue se mantêm unidos ou se dividem em ilhas. O objetivo é simples: um "4 de 5" do seu revisor de espanhol precisa significar o mesmo que um "4" do seu revisor de inglês.
O que funciona, na minha experiência:
- Escolha de 5 a 8 conversas por mês, pelo menos uma por idioma. Use uma mistura: uma resposta limpa, uma com erro de política, uma com problema de tom.
- Todos pontuam as mesmas conversas de forma independente, via tradução se necessário. Os revisores nativos também pontuam as linhas só de idioma do seu idioma.
- Compare as notas linha por linha, não os totais. Um total igual pode esconder um revisor rígido no tom e frouxo na precisão.
- Registre cada divergência resolvida como exemplo na rubrica e leve os problemas recorrentes para o coaching. "Usar du com um cliente B2B = falha de tom, ver ticket 4821" vale mais que um parágrafo de definição.
- Acompanhe a dispersão por idioma ao longo do tempo. Se as notas de uma equipe de idioma continuam se afastando, essa equipe precisa da própria sessão.
A nota de precisão do Zendesk QA é um bom modelo aqui: mede a concordância entre o AutoQA e os revisores humanos, e o Zendesk considera alta qualquer concordância acima de 75% (AutoQA dashboard). Aplique a mesma ideia entre seus revisores humanos. Para dar o feedback resultante aos agentes, meus guias de exemplos de feedback de QA e de feedback para agentes de suporte cobrem a redação.
A falha oposta é tão comum quanto: avaliar uma conversa que não está em inglês contra a redação em inglês. Um agente bilíngue descreveu exatamente isso:
"I got QA-ed that my Spanish questions were not close enough to the English script, deducted 7 points."
Não havia roteiro em espanhol. As sessões de calibração são onde esse tipo de regra é pego e reescrito como "corresponde à intenção do roteiro, em espanhol natural".
QA para respostas de IA em outros idiomas
Se um agente de IA redige ou envia respostas em outros idiomas, tudo o que está acima continua valendo, mais uma regra: teste cada idioma antes do lançamento, não só o inglês.
A IA é muito boa em suporte multilíngue. Em um teste da eesel, uma marca alemã de joias com cerca de 1.000 tickets por mês no Zendesk e no Shopify viu seu agente lidar com alemão, inglês, francês, holandês, espanhol, polonês, croata e turco sem que ninguém configurasse um único idioma. Esse é o lado bom. O lado ruim é que cada idioma vira uma superfície ao vivo pela qual você é responsável, inclusive os que ninguém na sua equipe lê.
O outro lado aparece quando ninguém revisa a saída em outros idiomas. Um administrador do Zendesk descreveu seu antigo bot de respostas multilíngue:
"the translations were often times wrong and our customers got mixed languages during their chat with the bot, ID customers will sometimes get Portuguese, IN customers would sometimes get Indonesian, and so on and so forth."
O que eu verificaria por idioma antes de ligar o piloto automático:
- As respostas vêm do seu conhecimento, não de conhecimento geral. O mesmo artigo da central de ajuda deve gerar a mesma política em francês e em inglês. Se sua base de conhecimento multilíngue tem lacunas, a IA as herda.
- A formalidade combina com a sua marca em cada mercado. Escreva como regra ("use Sie com todos os clientes alemães") em vez de torcer para acontecer.
- Nomes de produto ficam sem tradução. Uma lista de não traduzir pertence às suas instruções. Meu guia de glossário de tradução mostra como.
- Sem placeholders, sem fragmentos em inglês, sem despedidas no idioma errado. Esta eu verificaria primeiro, pelas razões que dei no início.
Depois rode contra o histórico. A simulação da eesel reproduz tickets antigos reais, pontua cada resposta e sugere correções (eesel skills). Filtre essa execução para seus tickets em alemão e holandês e você terá uma leitura por idioma antes de um único cliente ver um rascunho. O Zendesk QA também pontua automaticamente os agentes de IA do Zendesk e permite sinalizar outros bots para revisão (AI agents in Zendesk QA), o que cobre o lado pós-lançamento. Meu guia de Zendesk QA para agentes de IA aprofunda.
Erros comuns no QA de suporte multilíngue
- Revisar apenas por tradução. Pega respostas erradas e perde tudo a que um cliente nativo reage primeiro.
- Um revisor de inglês "dono" de todos os idiomas pequenos. Bom para precisão, cego para tom. Dê a cada idioma um revisor nativo de amostragem, mesmo que em meio período.
- Copiar saudações em inglês para todos os idiomas. Suas notas automáticas passam a punir os agentes que localizam direito.
- Confiar no campo de idioma detectado. Muitas vezes ele é definido só pela primeira mensagem. Tickets com idiomas misturados acabam no grupo errado.
- Tratar qualidade de tradução como qualidade de suporte. Uma tradução impecável da política errada ainda falha com o cliente.
- Não versionar macros entre idiomas. A deriva de políticas começa no dia em que alguém atualiza a macro em inglês e esquece as outras cinco. Um SOP de suporte com um responsável por idioma impede isso.
Experimente a eesel para suporte multilíngue
Se você atende em três ou quatro idiomas, a carga de QA cresce a cada mercado que você adiciona. Por isso coloquei a eesel na minha lista das melhores IAs para suporte multilíngue.
O colega de IA para helpdesk da eesel se conecta ao Zendesk, ao Freshdesk e ao resto da sua stack, responde no idioma do cliente sem que você precise traduzir sua central de ajuda, e aceita regras em linguagem natural como "use Sie com clientes alemães" ou "nunca traduza os nomes dos nossos produtos". Antes de entrar no ar, você reproduz seus próprios tickets antigos em cada idioma e vê onde ele teria errado.

A maioria das equipes começa com rascunhos como notas internas, para que seus revisores nativos vejam cada resposta em outro idioma antes de um cliente, e passa para o envio automático por idioma quando as notas se sustentam. Os planos começam em US$ 299 por mês por 500 créditos, com teste gratuito (eesel pricing). Experimente a eesel primeiro em uma fila de um idioma e veja como ela pontua.