

O que é calibração de QA no suporte?
A Zendesk explica de forma direta no seu guia de configuração da calibração: calibração é "the practice of having all your reviewers rate the same batch of conversations and compare their scores and comments." Essa é a ideia toda. As mesmas conversas, a mesma scorecard de QA, pessoas diferentes, e depois uma conversa sobre por que os números não batem. Se você ainda não montou a scorecard, comece pela criação de scorecards no Zendesk QA e volte.
Eu trabalho na fila de suporte da eesel todo dia, e o motivo de isso importar é que as notas de QA não ficam dentro da ferramenta de QA. Elas vão parar em conversas 1:1, em planos de coaching, às vezes em bônus. Se um revisor dá a uma resposta 4 de 5 em tom e outro dá 2 para a mesma resposta, a nota do agente depende da fila em que ele caiu. Os agentes percebem isso rápido, e quando decidem que o QA é uma loteria, o feedback deixa de pegar.
"You could have five QA agents listen to the same call and get five different results. Which isn't fair to the agent as that score could be used to determine if they'll be fired."

A calibração é a solução para isso. Não é um treinamento para agentes, e na maioria das ferramentas os agentes nunca a veem. O guia de configuração da Zendesk diz "Agents do not see any conversation-related information in calibration", e as notas de calibração "don't affect the existing Internal Quality Score (IQS)." É uma checagem dos avaliadores, feita pelos avaliadores.
Por que as notas de QA se afastam
Os revisores não discordam ao acaso. Eles discordam nas categorias em que a rubrica deixa espaço para julgamento: tom, empatia, "a resposta teve o tamanho certo", "o agente foi além do esperado". Processo e precisão costumam coincidir, porque uma política de reembolso foi seguida ou não foi. O tom é onde duas pessoas cuidadosas leem a mesma frase e terminam com dois pontos de diferença.
A outra fonte de desvio é o que significa "aprovado" logo de início. Aqui vai um exemplo real do trabalho da própria eesel. Analisei um teste com tráfego real em uma caixa de entrada do Zendesk de um e-commerce, em que 284 respostas redigidas por IA foram avaliadas de três formas diferentes.
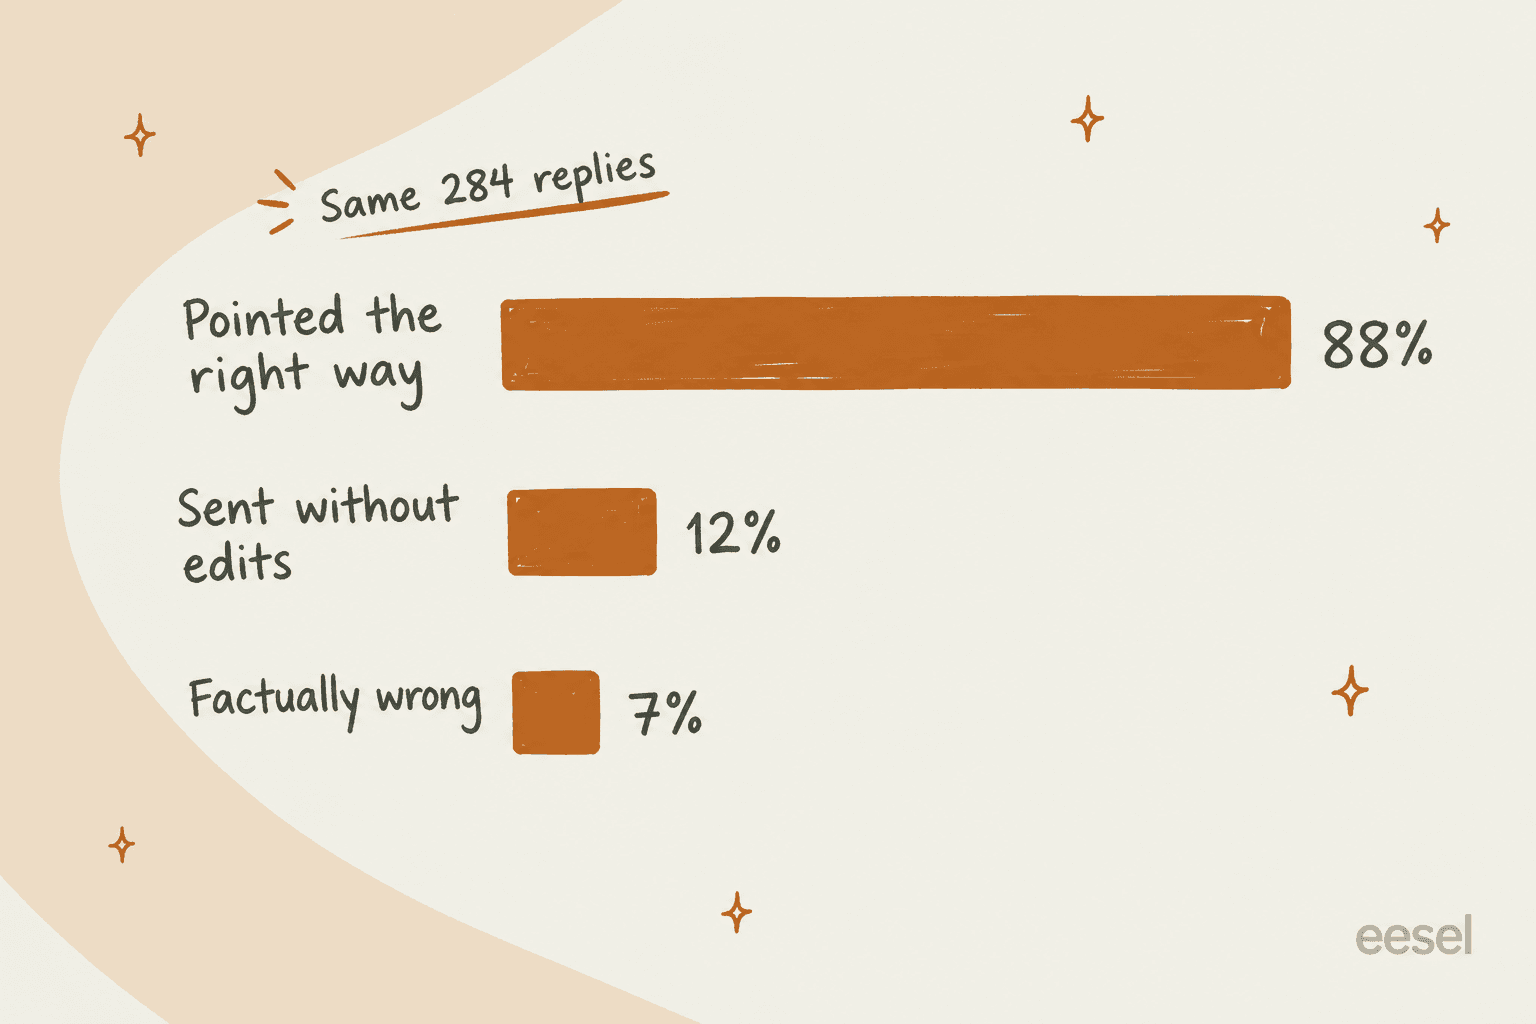
As mesmas respostas, três veredictos: 88% apontavam na direção certa, só 12% foram enviadas sem edições e 7% estavam factualmente erradas. Nenhum desses números está errado. Eles só respondem a perguntas diferentes. Um revisor que avalia "eu enviaria isso do jeito que está?" e outro que avalia "a resposta está correta?" vão pontuar a mesma fila com enorme distância, e os dois vão achar que estão sendo justos. Quando investiguei por que os agentes reescreviam os rascunhos, cerca de 65% das reescritas eram por tamanho e tom, cerca de 20% precisavam de dados do pedido que o rascunho não conseguia ver e cerca de 5% eram porque o rascunho estava factualmente errado. Tamanho e tom são justamente as categorias em que os revisores humanos também se dividem. (Detalhei esse tipo de análise de reescritas no meu guia de análise de erros.)
É por isso que a calibração começa pelo critério, não pela nota. Se a sua scorecard não diz como é um 3 em comparação com um 4 em tom, nenhuma quantidade de discussão fará os revisores concordarem por muito tempo.
Como conduzir uma sessão de calibração de QA
Esta é a sessão que eu conduziria, em cinco etapas. Leva cerca de uma hora por mês, mais 10 a 15 minutos de pontuação por revisor antes.
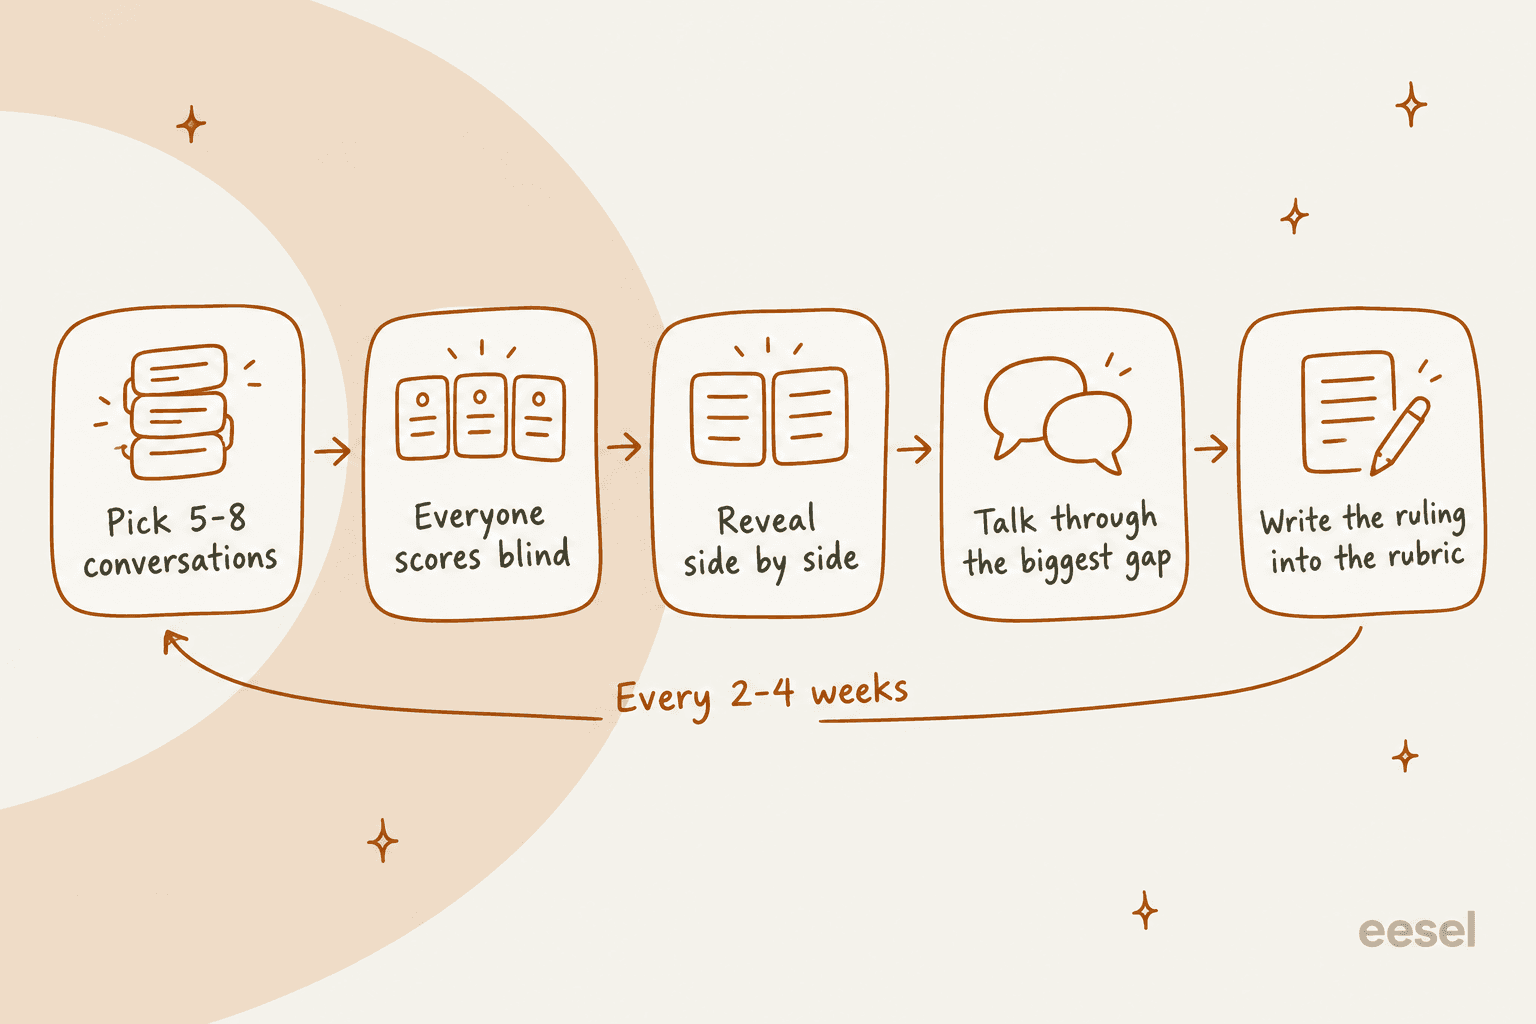
1. Escolha de 5 a 8 conversas que vão gerar discussão
O guia de calibração da Zendesk sugere começar com cerca de cinco conversas. Eu subiria para oito quando a equipe já estiver acostumada. Mais do que isso e a discussão fica apressada.
A seleção importa mais do que a quantidade. Tickets fáceis não ensinam nada, porque todos pontuam igual. A orientação sobre calibração da MaestroQA é puxar tickets com notas de QA baixas, assuntos difíceis ou um processo ou produto que mudou recentemente. A evaluagent acrescenta um ponto justo na sua explicação sobre calibração: mantenha o conjunto equilibrado, não só interações ruins, ou a sessão vira uma revisão de culpados.
Minha mistura: uma conversa que toque uma política que acabou de mudar, uma em que o cliente estava irritado desde a primeira mensagem, um fio longo com várias respostas, uma que correu bem mas pareceu "estranha", e uma que um agente contestou recentemente. Se você atende em mais de um idioma, inclua também uma conversa que não seja em inglês; meu guia de QA de suporte multilíngue explica como calibrar entre equipes de idiomas diferentes.
2. Todos pontuam às cegas
Esta é a etapa que as equipes pulam, e é a que faz o resto funcionar. Se os revisores veem as notas uns dos outros, ou pontuam juntos na sala, a primeira pessoa confiante define o número e todos se deslocam em direção a ele. O webinar sobre calibração da evaluagent descreve a versão em papel desse problema: as pessoas "can change their scores on their paper, and they can be swayed to another person's point of view before they get an opportunity to speak."
No Zendesk QA, às cegas ou aberto é uma configuração do workspace que você escolhe por função. Os revisores podem ser configurados para ver só as próprias revisões, ou para ver as dos colegas apenas depois de enviarem as suas. Líderes e gerentes têm a mesma opção de "depois de enviar", ou "sempre".
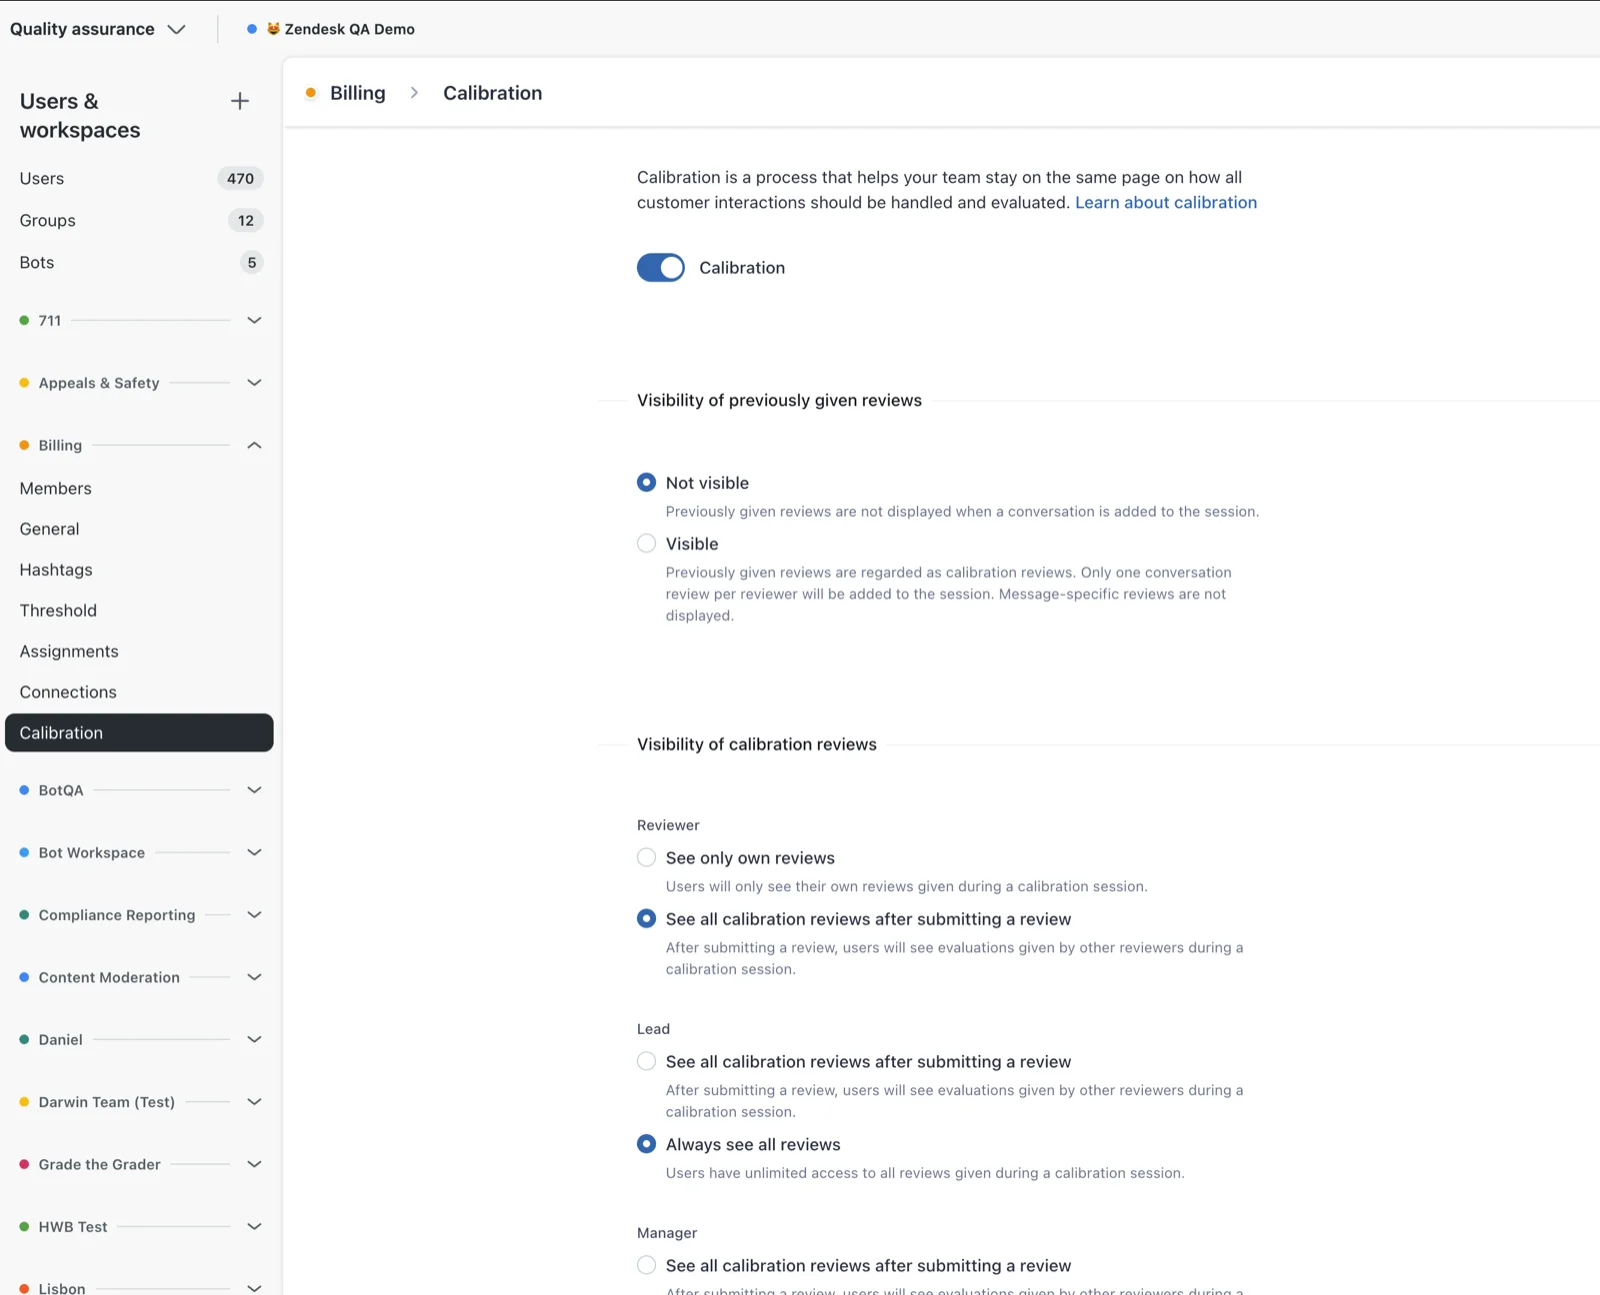
Um detalhe prático: o Zendesk QA não envia notificações de calibração. Segundo a documentação da Zendesk, "it's up to the workspace manager or lead to inform reviewers about the calibration session and its due date." Coloque o prazo no canal da equipe, ou metade dos revisores vai pontuar 10 minutos antes da reunião.
3. Revele as notas lado a lado, contra uma referência
Quando todos tiverem pontuado, coloque as notas em uma grade: revisores na lateral, categorias da scorecard no topo. Você procura duas coisas, às quais volto na próxima seção: categorias com grande dispersão e revisores que destoam em tudo.
Você também precisa de uma referência, ou seja, uma nota "certa" combinada para comparar. O Zendesk QA permite que um gerente marque uma revisão como Baseline review, o que, segundo a Zendesk, "makes it easier to compare scores against it." O painel de calibração então mostra a nota de cada revisor ao lado da nota de referência.
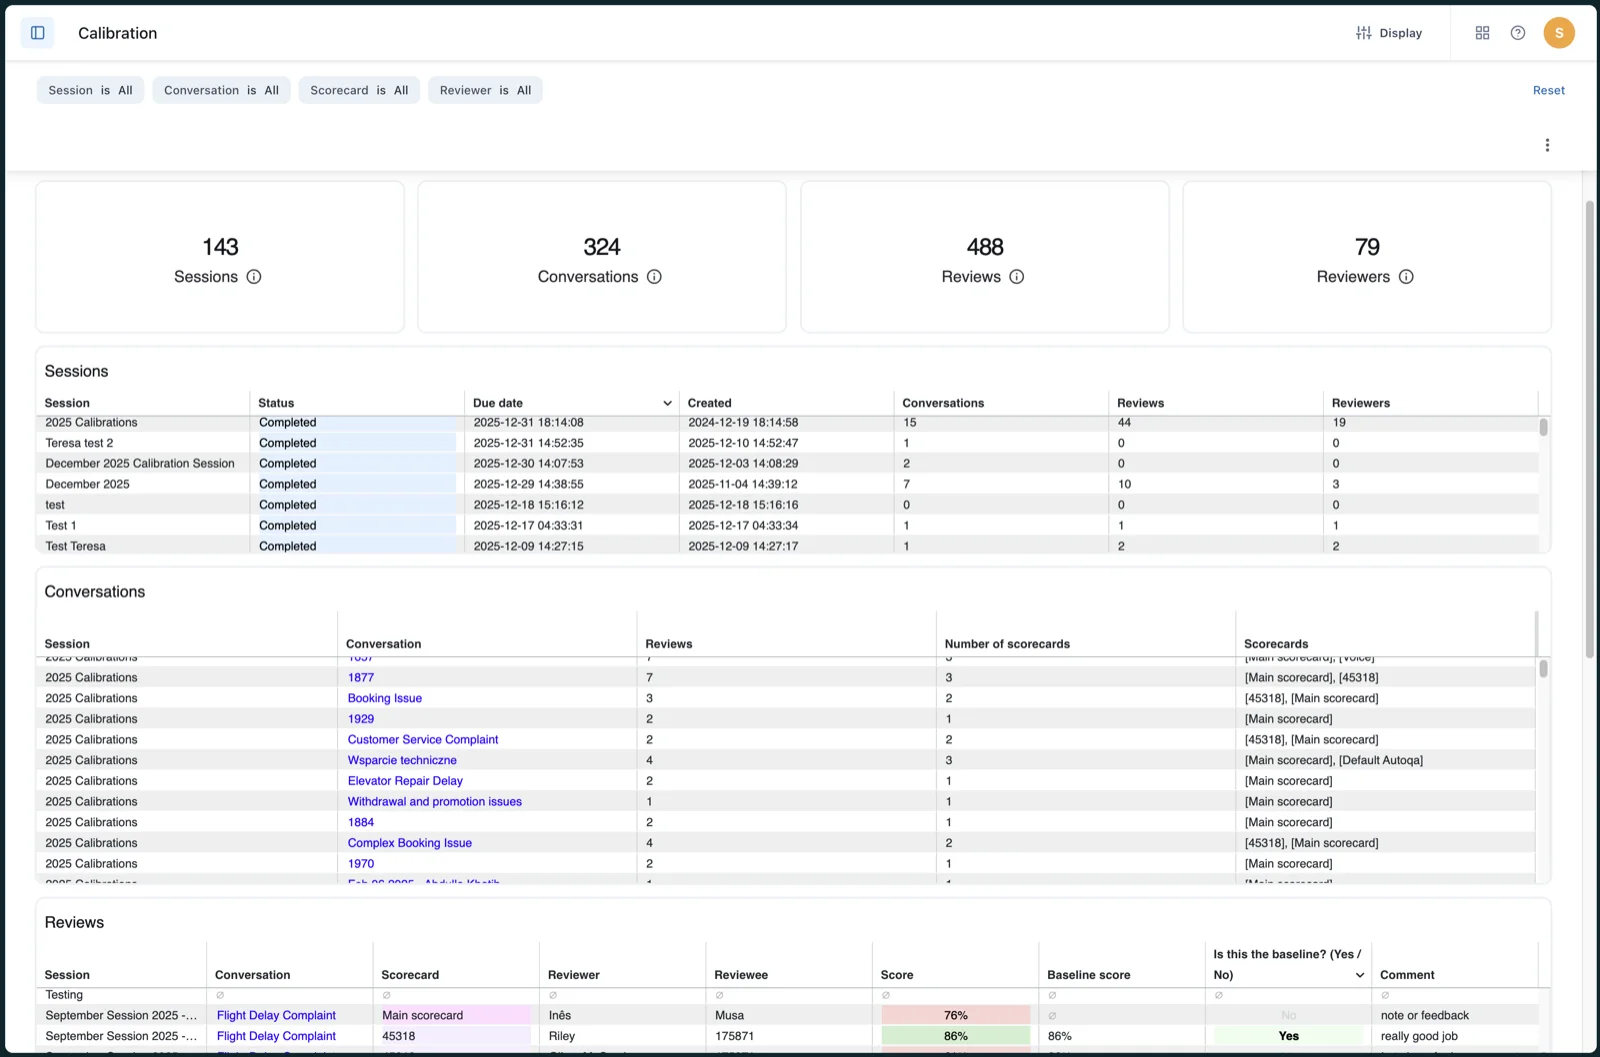
A MaestroQA faz o mesmo com um calibrador final designado. O guia de alinhamento de equipes chama essa pessoa de "your source of truth to measure alignment against", e cada avaliador recebe uma nota de alinhamento em relação a ela.
4. Discuta a maior diferença, não todas
Com 5 conversas e 6 categorias, você tem 30 lugares para discordar. Você não vai conseguir passar por todos em uma hora, e não deve tentar. Ordene por dispersão e gaste a reunião nas duas ou três maiores diferenças.
O objetivo é uma decisão, não um consenso. Um líder da Stitch Fix citado na página de calibrações da MaestroQA disse bem: "We've normalized the expectation that we're driving toward commitment, not consensus." A evaluagent diz o mesmo pelo outro lado: "It's not a democracy, if you like, where majority rules." Se três revisores dizem 4 e um diz 2, a resposta não é automaticamente 4. Quem conhece melhor a política toma a decisão, e todos se comprometem com ela.
5. Escreva a decisão na rubrica
É aqui que a maioria das sessões de calibração falha em silêncio. A equipe concorda, todos assentem, e três semanas depois a mesma discordância reaparece porque nada foi anotado.
Cada diferença resolvida deve virar uma linha na orientação da sua scorecard, com a conversa como exemplo prático. "Tom: uma resposta que pede desculpas duas vezes pelo mesmo problema recebe 3, não 4. Exemplo: ticket #48213." Esse é o artefato que deixa a próxima sessão mais curta. Ele também alimenta seus SOPs de suporte e os exemplos que você usa no onboarding de novos agentes, já que quem acaba de entrar precisa das mesmas decisões que seus revisores acabaram de combinar. Boas decisões soam como bons exemplos de feedback de QA: específicas, ligadas a uma linha da conversa e curtas.
Um líder de QA no r/callcentres descreveu a versão rígida disso:
"Calibrations by quality need to be strictly enforced and maintained. My last team I ran was quality and every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
Problema da rubrica ou do revisor?
Esta é a parte da calibração que acho que a maioria dos guias pula, e é a mais útil. Quando as notas não batem, o padrão da discordância diz o que corrigir.
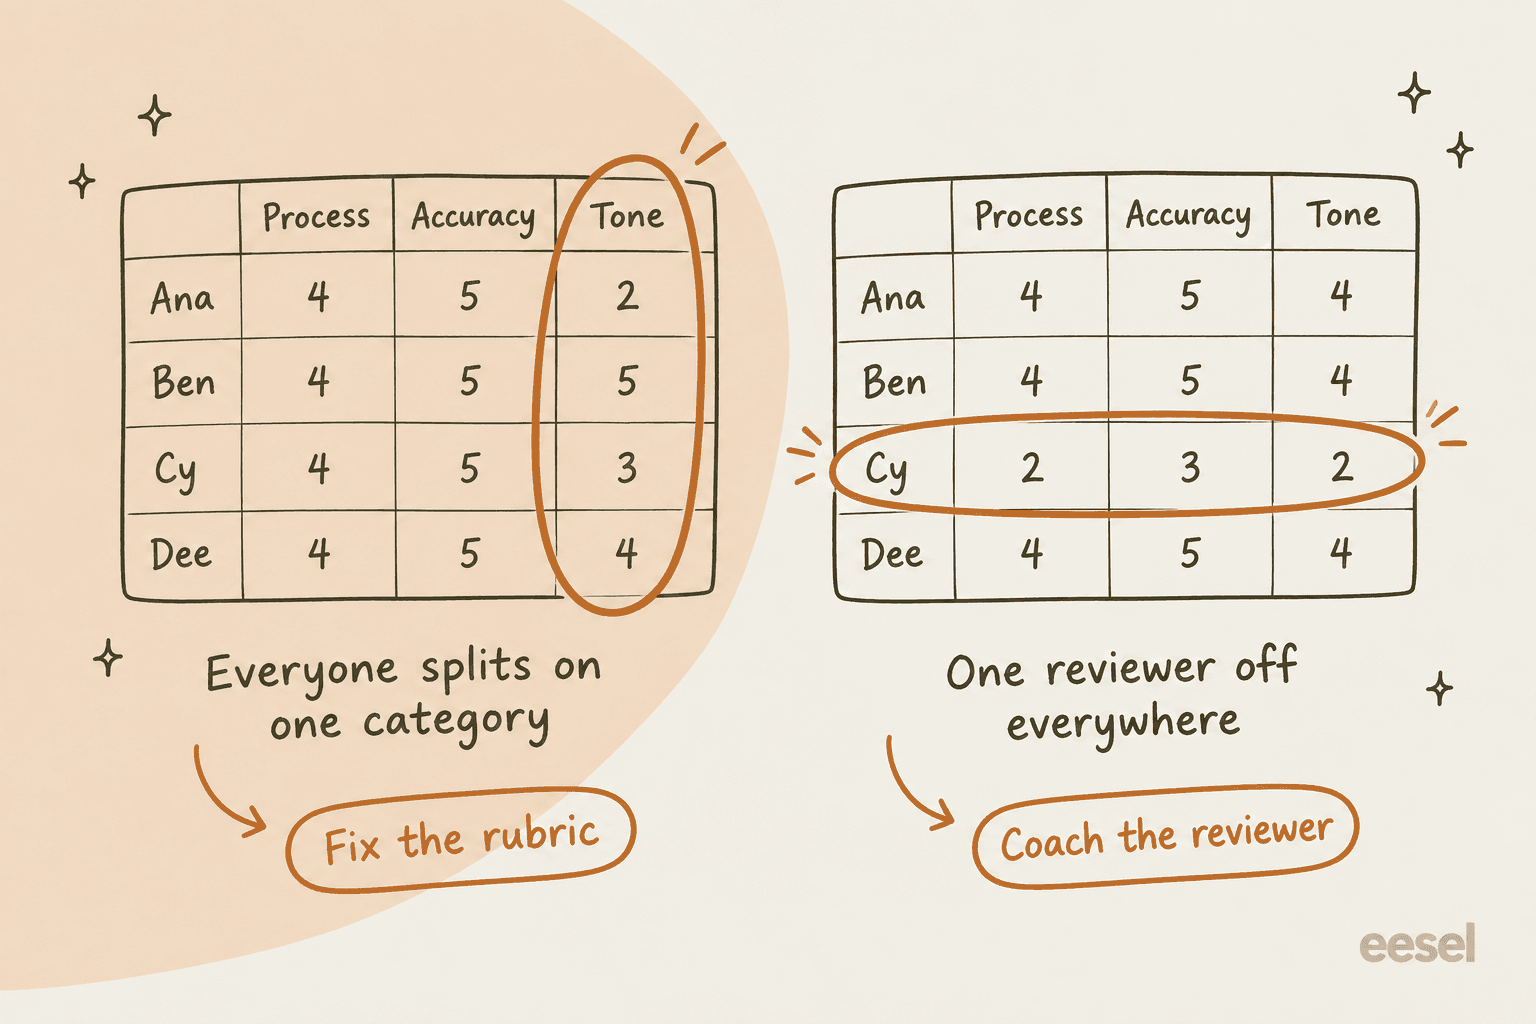
Todos se dividem em uma categoria. Se processo e precisão batem mas o tom vai de 2 a 5 entre quatro revisores, ninguém está "errado". O critério está aberto à interpretação, então corrija a rubrica. Reescreva a orientação de tom com exemplos concretos (meu guia de tom no atendimento ao cliente tem um modelo) e pontue de novo a mesma conversa na próxima sessão para conferir se a diferença fechou.
Um revisor destoa em tudo. Se uma pessoa pontua dois pontos abaixo de todo mundo em todas as categorias, a rubrica está boa. Esse revisor a está lendo de outra forma, então faça coaching do revisor. Sente com ele, do mesmo jeito que você faria para fazer coaching de um agente, percorra uma conversa categoria por categoria e peça que ele pontue mais uma sozinho.
A equipe inteira se afasta da referência na mesma direção. Todos dão 4 e o líder deu 2. Isso geralmente significa que o líder sabe algo que a equipe não sabe, como uma mudança de política que nunca chegou à base de conhecimento. É uma correção de comunicação, não de pontuação.
Experimente com seus próprios números. Digite as notas de cada revisor para uma conversa e o verificador diz qual desses casos você está vendo.
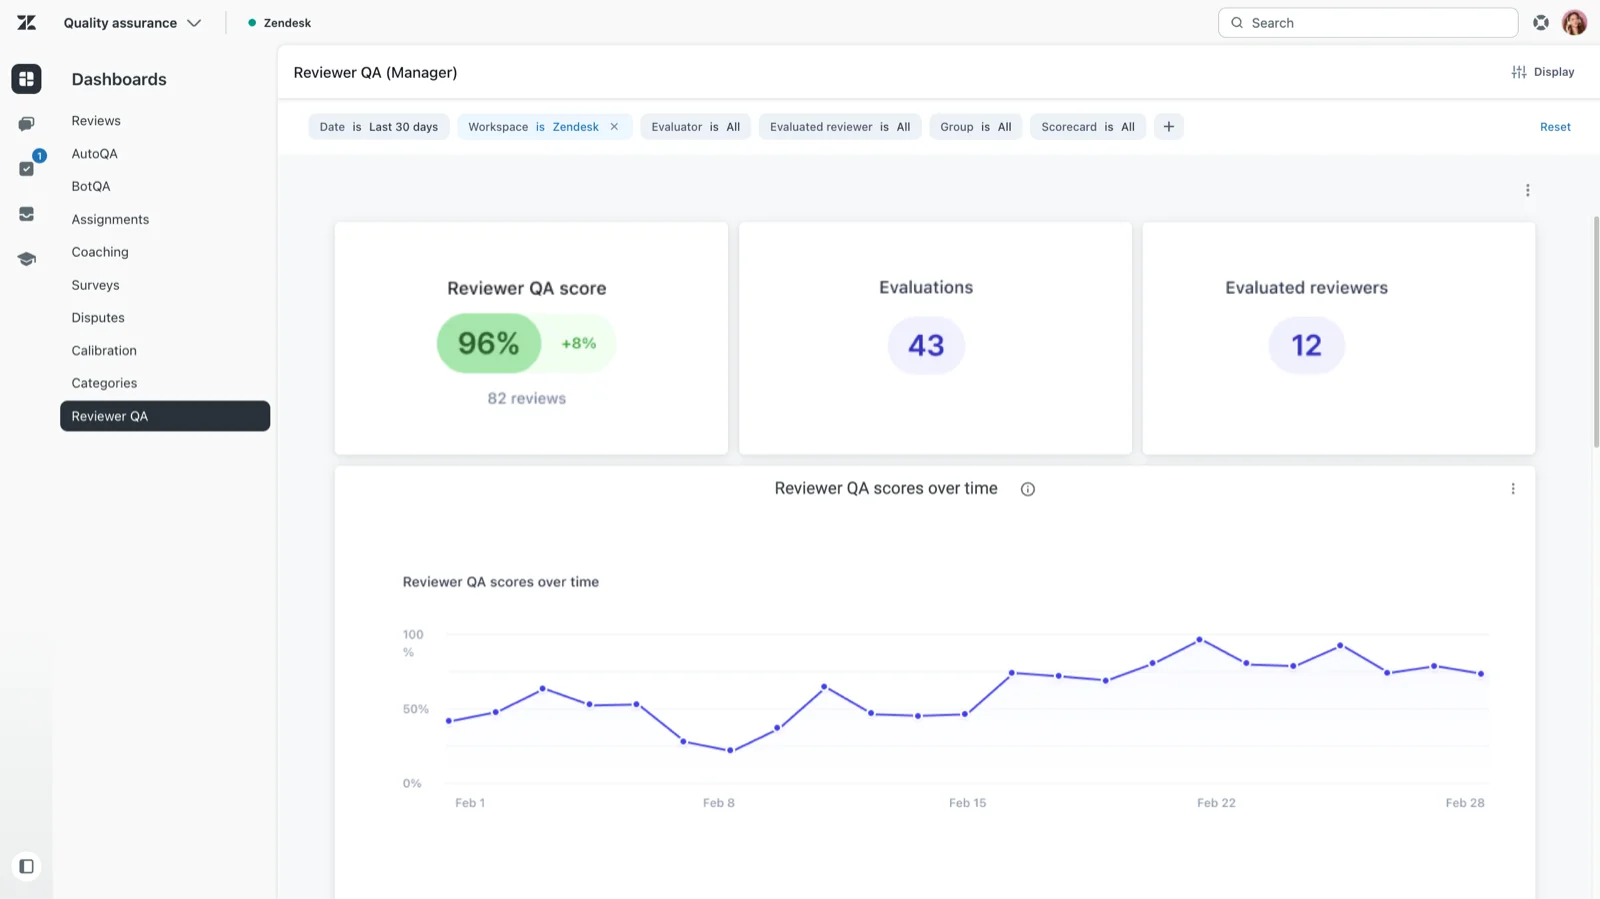
O Zendesk QA também acompanha o lado do revisor ao longo do tempo com um painel separado de Reviewer QA. Ele usa atribuições aleatórias em que alguém avalia as próprias revisões dos revisores, e a documentação do painel da Zendesk diz que serve para "track reviewer accuracy, evaluation history, and coaching trends." Os revisores avaliados veem as próprias notas, mas não conseguem ver quem os avaliou.
O que conta como "calibrado"?
Nenhum fornecedor de QA que verifiquei publica uma nota de aprovação fixa. Aqui está o que as pessoas que fazem isso profissionalmente usam no lugar.
| Fonte | Meta de calibração | Contra o que é medido |
|---|---|---|
| Guia de calibração da Zendesk | Diferença "usually falls around 5 percent" | Referência definida durante a sessão |
| u/mattemer no r/callcentres | Dentro de 3%, alguns elementos 100% | Nota combinada pelo grupo |
| MaestroQA | Nota de alinhamento por avaliador, sem limite fixo | Nota do calibrador final |
| Scorebuddy | % de respostas coincidentes, mais Avg Variation | A nota original sendo reavaliada |
| Zendesk QA AutoQA | Acima de 75% de precisão é "alta concordância" | Notas de revisores humanos |
Minha opinião: busque deixar cada revisor a cerca de 5 pontos da referência na nota total, e nenhuma categoria em que os revisores estejam 2 ou mais pontos distantes em uma escala de 5. Depois acrescente a regra da citação do r/callcentres acima: alguns itens precisam ser 100%. Uma verificação de identidade esquecida ou um valor de reembolso errado não é questão de gosto. Marque-os como itens críticos ou de reprovação automática na scorecard (meu guia de critérios de scorecard mostra como fazer isso no Zendesk QA) para que nunca sejam "calibrados" até virar uma nota parcial.
Fique de olho também no total. Dois revisores podem chegar ao mesmo 80% geral enquanto discordam em três categorias por baixo, um alto onde o outro está baixo. Compare sempre por categoria, não só a nota geral.
Com que frequência você deve calibrar?
A resposta honesta é "com mais frequência do que você faz agora". Veja o que fornecedores e profissionais sugerem:
- Programa de QA novo ou scorecard nova: o guia da MaestroQA diz que vê equipes calibrarem "as frequently as once a week", passarem a mensal quando o alinhamento está alto e voltarem a subir quando uma rubrica nova é lançada.
- Regime estável: o guia da Zendesk diz que sessões mensais servem para a maioria das equipes, e "the more reviewers you have, the more often you should calibrate."
- Equipes de QA grandes: um ex-gerente de QA no r/callcentres fazia "a weekly calibration call so that everyone was on the same page" junto com 5 auditorias por atendente por mês.
Um analista de QA solitário no r/talesfromcallcenters descreveu o outro lado, em que o avaliado é o próprio revisor:
"I was the lone QA agent for a call center of 55-70 people. We had a calibration session each week which involved the call center manager, the management staff, and myself. They chose ten calls that I had evaluated to listen to and score... I was held to a 95% accuracy rating which compared to the average of their call scores."
Eu acrescentaria um gatilho que não está em nenhum calendário: calibre depois de qualquer coisa que mude o que significa "certo". Uma mudança de preço, uma nova política de devoluções, um novo caminho de escalonamento. É aí que os revisores desviam mais rápido, porque alguns sabem da mudança e outros não. Também vale uma sessão sempre que um novo revisor entrar, do mesmo jeito que você encurtaria o tempo de adaptação de um agente com exemplos práticos, antes de as notas dele contarem para os KPIs de suporte de alguém.
Recursos de calibração de QA comparados
A maioria das ferramentas de QA dedicadas tem algum tipo de recurso de calibração. Elas diferem em se a pontuação é às cegas, contra o que a "resposta certa" é medida e o que você vê depois.
| Ferramenta | Recurso | Pontuação às cegas | Medido contra | Os agentes veem? |
|---|---|---|---|---|
| Zendesk QA | Sessões de calibração, Reviewer QA | Configurável por função | Revisão de referência definida por um gerente | Não |
| MaestroQA (agora Rippit) | Team Calibration, Grade-the-Grader | Sim, os avaliadores veem só a própria nota e a final | Calibrador final, nota de alinhamento | Não documentado |
| Scorebuddy | Listas de calibração | Não documentado | Nota original sendo reavaliada | Opção ativável por lista |
| evaluagent | Sessões de calibração, Check-the-Checker | Sim, "blind evaluate" | "Calibrated outcome" combinado | Não documentado |
| Playvox (NICE) | Calibração | Não documentado | "Expert opinions" | Não documentado |
| Level AI | Calibração | Não documentado | Referência do auditor | Não documentado |
Alguns detalhes que vale saber antes de escolher:
O Zendesk QA exige o complemento de QA ou de Workforce Engagement Management. Todo plano Suite indica que o Quality Assurance "Requires QA add-on", e o Workforce Engagement Bundle aparece a US$ 50 por agente por mês, cobrado anualmente. A calibração não fica restrita a um plano superior além disso. Um limite a conhecer: o painel de calibração lista conversas e suas revisões, e um comentário de cliente no artigo de configuração observa que os dados "can only be downloaded conversation by conversation." Se você quer a tendência de um revisor ao longo de várias sessões, planeje levá-la para uma planilha, ou apoie-se no painel Reviewer QA.
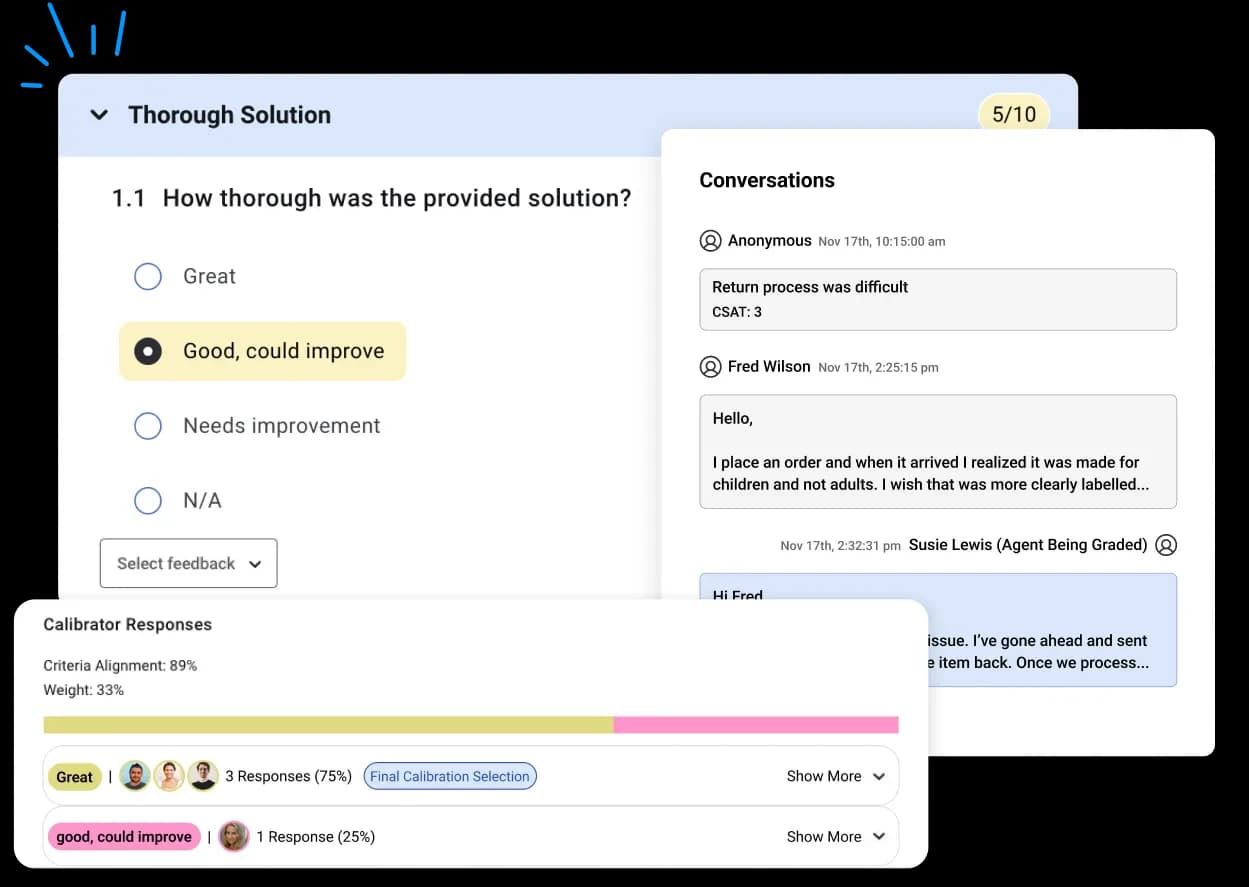
A MaestroQA, agora rebatizada como Rippit, separa duas tarefas: calibração de equipe ao vivo e Grade-the-Grader, em que um avaliador de referência reavalia às cegas tickets que outra pessoa já pontuou. A visualização de calibração mostra como cada calibrador respondeu a cada pergunta, com uma porcentagem de "Criteria Alignment".
O Scorebuddy monta a calibração a partir de resultados já pontuados: você os adiciona a uma lista de calibração e a atribui a usuários, inclusive externos, o que é útil se você terceiriza parte do suporte para um parceiro de BPO. O glossário define Avg Variation como "the average of all differences between a set of Calibration's numerical scores, and the numerical scores of the original Scores." O módulo de calibração está no plano de entrada Foundation, embora os preços sejam "Request a price."
Se você faz QA dentro do seu helpdesk, confira o que ele realmente cobre. Mantenho uma lista mais longa de ferramentas de QA com IA caso você esteja pesquisando. A Gorgias oferece o Auto QA, que pontua conversas automaticamente, mas não encontrei na documentação dela um fluxo de calibração para revisores humanos. O mesmo vale para Freshdesk e Front na documentação que pesquisei. Se o seu helpdesk não tem, uma planilha compartilhada com a grade da etapa 3 resolve bem para uma equipe de três a cinco revisores.
Calibrando avaliadores de IA e agentes de IA
Cada vez mais equipes deixam a IA pontuar 100% das conversas, com humanos revisando uma amostra. Isso não elimina a calibração. Adiciona mais um revisor para calibrar, e é o que revisa mais tickets.
O Zendesk QA mede isso diretamente. O painel do AutoQA tem uma Accuracy score que "measures the consistency and level of agreement between ratings generated by AutoQA and those provided by human reviewers", e acima de 75% conta como alta concordância. Ele também acompanha as Modified AutoQA conversations, em que um humano alterou a nota da IA em pelo menos uma categoria. Essa lista é a sua pauta de calibração para a IA, e é a forma mais rápida de fazer QA de suporte com IA sem confiar cegamente nela: se os humanos continuam corrigindo a mesma categoria, o avaliador de IA e a sua rubrica discordam, e um dos dois precisa de ajuste. As notas do AutoQA também ficam fora do IQS do agente, então a IA não consegue mover silenciosamente a nota de um agente por conta própria.
Os agentes sentem quando ninguém faz isso:
"My company uses AI to score calls, too. You can have a great call, but if it doesn't pick up on certain keywords you get a lousy score for it"
Trate o avaliador de IA como um novo revisor entrando na equipe. Coloque algumas conversas pontuadas pelo AutoQA na sua sessão de calibração, pontue-as às cegas junto com ele e veja onde ele cai. Meu guia de QA de suporte com IA cobre o resto dessa configuração, e a IA consegue fazer QA de suporte? é sincero sobre onde ela ainda fica a desejar.
A mesma lógica vale quando o agente é uma IA. Se um agente de IA responde tickets, seus revisores precisam combinar como avaliar as respostas dele antes de começar, ou você terá o problema de 88% contra 12% de antes, a mesma diferença que aparece quando as equipes discutem a taxa de resolução da IA: um revisor marca uma resposta como aprovada porque a resposta está certa, outro a marca como reprovada porque ela é três parágrafos longa demais. Combine o critério primeiro, depois avalie. Uma voz de marca escrita para a IA torna a categoria de tom muito mais fácil de calibrar. Meu post sobre agentes de IA no Zendesk QA mostra como pontuar conversas de bots.
Erros comuns na calibração de QA
- Pontuar juntos na sala. Você perde a única coisa que veio medir, a discordância original. Pontue sempre às cegas primeiro.
- Calibrar só tickets fáceis. Se toda sessão termina em acordo, você está escolhendo as conversas erradas.
- Tratar a média como a resposta. Três pessoas dizendo 4 não torna 4 o certo. Alguém é dono da decisão.
- Sem acompanhamento por escrito. Se a decisão não chega à orientação da scorecard, você terá a mesma discussão no mês que vem.
- Comparar só as notas totais. Dois revisores podem dar 80% e discordar em metade das categorias.
- Nunca calibrar o avaliador de IA. Ele revisa mais tickets que qualquer outro na equipe. Precisa de um lugar na sessão.
- Fazer sem as contestações dos agentes. Revisões contestadas são material de calibração de graça. O painel de contestações do Zendesk QA até tem uma tabela "Disputed reviewers" que "shows which reviewers may need additional help with consistency and accuracy." Use-a ao escolher as conversas, e veja meu post sobre o feedback aos agentes no Zendesk QA para saber como as contestações voltam aos agentes.
Experimente a eesel para ter respostas de IA em que sua equipe de QA possa confiar
Se você vai colocar IA na sua fila de suporte, a questão da calibração aparece no primeiro dia: como seus revisores vão avaliar o que ela escreve? O colega de IA para helpdesk da eesel entra na sua fila existente do Zendesk, Freshdesk, Gorgias ou Help Scout e deixa sua equipe resolver isso antes de entrar no ar. Ele reproduz tickets passados reais para que os revisores pontuem as respostas dele em comparação com o que seus agentes realmente enviaram, começa como rascunhos em notas internas, e cada execução mostra as fontes e o raciocínio por trás da resposta. Quando um revisor o corrige, a correção vira uma instrução permanente, e a mesma decisão vale para todos os tickets futuros. Dá para testar de graça com 100 créditos, e os planos pagos começam em US$ 299 por mês na página de preços da eesel.
