

Resumo rápido
O único benchmark de agente de suporte com IA que vale a pena usar para tomar decisões é seu agente e sua equipe avaliados nos mesmos tickets, com uma única definição de "resolvido". As taxas de resolução dos fornecedores não podem ser comparadas entre si: Zendesk, Gorgias, HubSpot, Freshdesk, Salesforce e Help Scout usam critérios diferentes, então o mesmo cliente em silêncio conta como sucesso em uma ferramenta e como um talvez em outra. Testes públicos como o tau-bench classificam modelos, não a sua configuração. A simulação da eesel faz exatamente isso: reprocessa seus tickets resolvidos, compara com o que sua equipe realmente enviou e avalia cada tópico antes que qualquer coisa chegue a um cliente.
O que "fazer benchmarking de um agente de suporte com IA" realmente significa?
Eu desenvolvo agentes de IA na eesel, e a pergunta mais comum que ouço depois de uma implementação é alguma versão de "60% é bom?" A resposta honesta é que depende de quais 60%. Quando alguém diz "benchmark", geralmente está falando de uma entre três coisas diferentes, e é ao confundi-las que as equipes acabam com um número que não ajuda a tomar decisões.
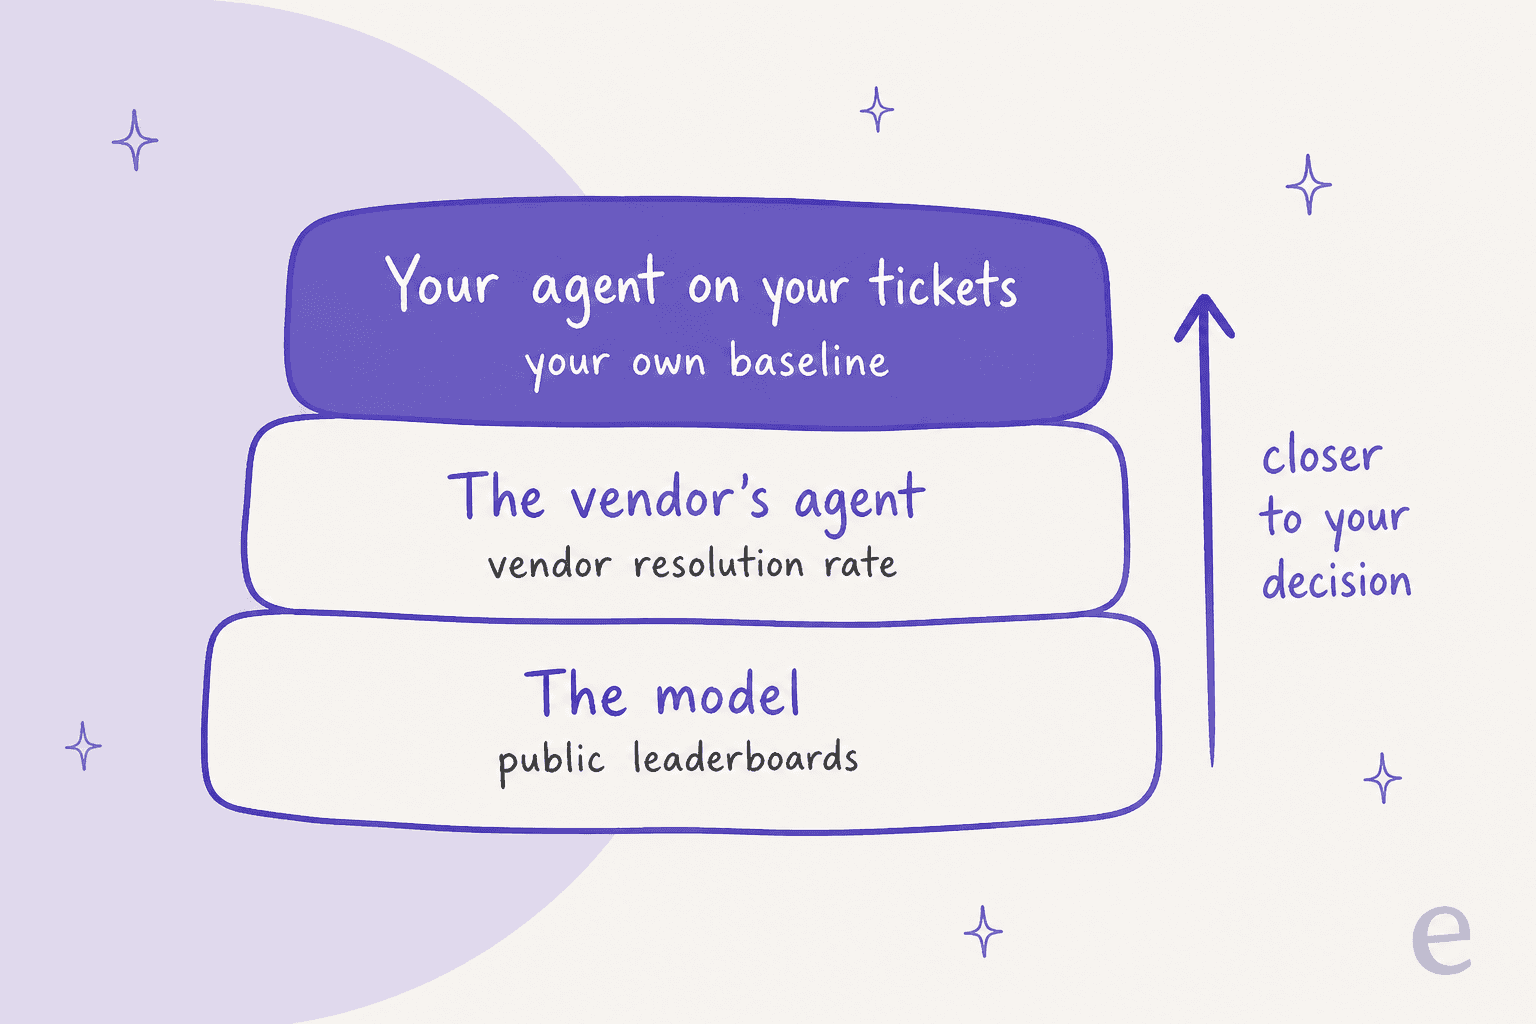
- O modelo. Rankings públicos como o tau-bench testam o grande modelo de linguagem subjacente em tarefas simuladas de suporte. Úteis para escolher um modelo, não dizem nada sobre sua base de conhecimento.
- O agente do fornecedor. A taxa de resolução que seu helpdesk mostra, ou a média que um fornecedor coloca na página inicial. Cada uma é definida por esse fornecedor, para a cobrança desse fornecedor.
- Seu agente nos seus tickets. Sua configuração, sua documentação, suas políticas, avaliadas em comparação com a forma como sua própria equipe lidou com as mesmas perguntas. É isso que diz se você deve ampliar o que a IA atende.
Cada camada se aproxima mais da decisão que você realmente precisa tomar. O restante deste post passa pelas três, porque o erro que mais vejo é uma equipe citando a camada dois como se fosse a camada três.
Por que você não pode comparar as taxas de resolução dos fornecedores?
Porque cada fornecedor contabiliza uma resolução com um critério diferente, e a maioria deles cobra com base nesse mesmo critério. Analisei a documentação de ajuda de cada fornecedor nesta semana, e nenhum deles concorda com outro sobre o que "resolvido" significa.
| Fornecedor | O que conta como resolvido | Janela | A cobrança se baseia nisso? | Preço por unidade |
|---|---|---|---|---|
| Zendesk | A IA respondeu, o cliente não pediu mais nada e um LLM confirma que a solicitação foi resolvida satisfatoriamente. Não passou na verificação = "Contained", sem cobrança | 72h para e-mail, 2h por padrão para mensagens (até 72h), contadas a partir da primeira mensagem | Sim | $1.50 com compromisso de consumo, $2.00 no pagamento conforme o uso |
| Gorgias | Totalmente atendido por IA ou automação, sem necessidade de intervenção humana em 72 horas | 72h | Sim, mais a tarifa do ticket | $1.50 por excedente na página de preços |
| HubSpot | O agente respondeu com uma fonte de conteúdo ou ação e não houve transferência iniciada pelo visitante, ou um lead foi marcado como qualificado, parcialmente qualificado ou não qualificado | 72h após a última mensagem do visitante | Sim | $0.50 (50 créditos) |
| Freshdesk Freddy | Relatórios: encerrado sem intervenção humana. A cobrança é por sessão, independentemente do resultado | 24h para chat, 72h para e-mail por sessão | Não, cobrado por sessão | $49 por 100 sessões |
| Salesforce Agentforce | "Deflected" quando um LLM atribui à sessão uma nota 4 ou 5, significando "mostly or fully resolved" | Tempo limite de abandono de 2h | Não, cobrado por conversa | $2 por conversa |
| Help Scout | A IA respondeu e o cliente não pediu mais ajuda depois | Não documentada | Sim | $0.75 |
Três diferenças importam mais do que as demais.
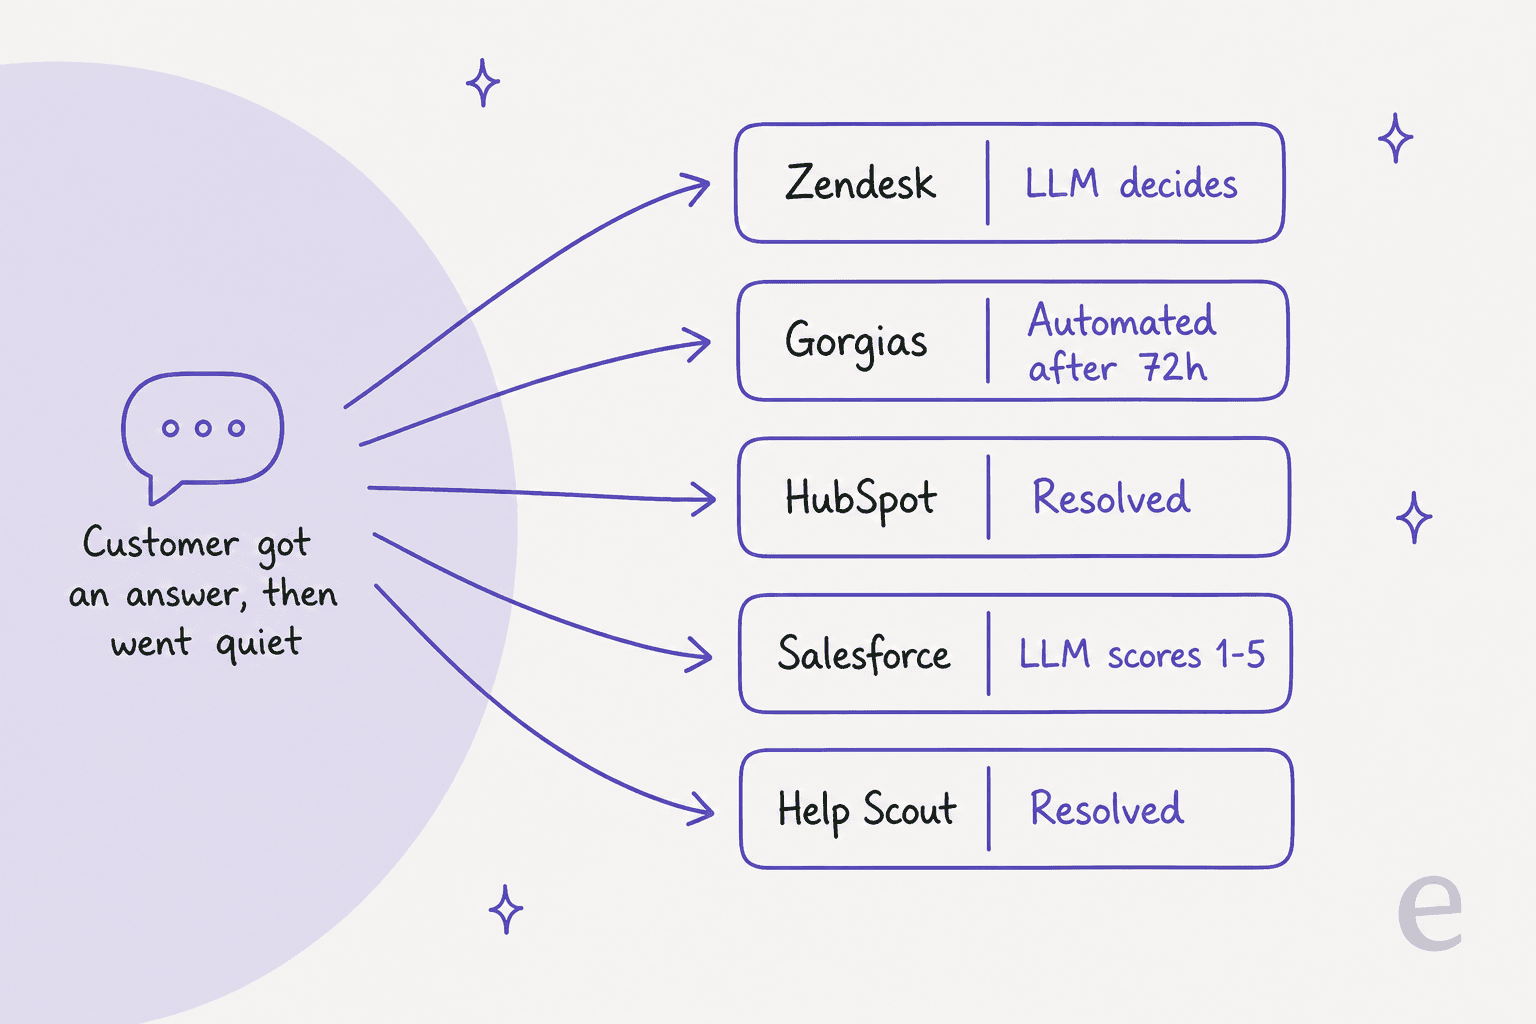
Quem decide se funcionou. Zendesk e Salesforce colocam um LLM para avaliar a transcrição. Gorgias, HubSpot e Help Scout contam a ausência de um humano: ninguém pediu para falar com uma pessoa, então conta. Essas são perguntas diferentes. "O cliente conseguiu o que precisava?" e "o cliente desistiu em silêncio?" parecem idênticas em uma métrica que só verifica o silêncio.
O que impede uma resolução. A própria documentação da HubSpot diz que somente transferências iniciadas pelo visitante contam contra ela, e que eventos posteriores, como "messages from a live agent, a transfer request, or negative feedback, will not change the resolution status". Um fluxo de trabalho que encaminha um ticket a uma pessoa depois que o agente respondeu não desfaz a resolução.
Qual é o denominador. A Gorgias apresenta dois números que parecem semelhantes: uma taxa de sucesso sobre os tickets atendidos pela IA e uma taxa de automação sobre toda a sua carga de trabalho faturável. Mesmo mês, mesmos tickets, duas porcentagens muito diferentes.
Veja como isso aparece em uma conversa comum: o agente responde e o cliente nunca mais escreve.
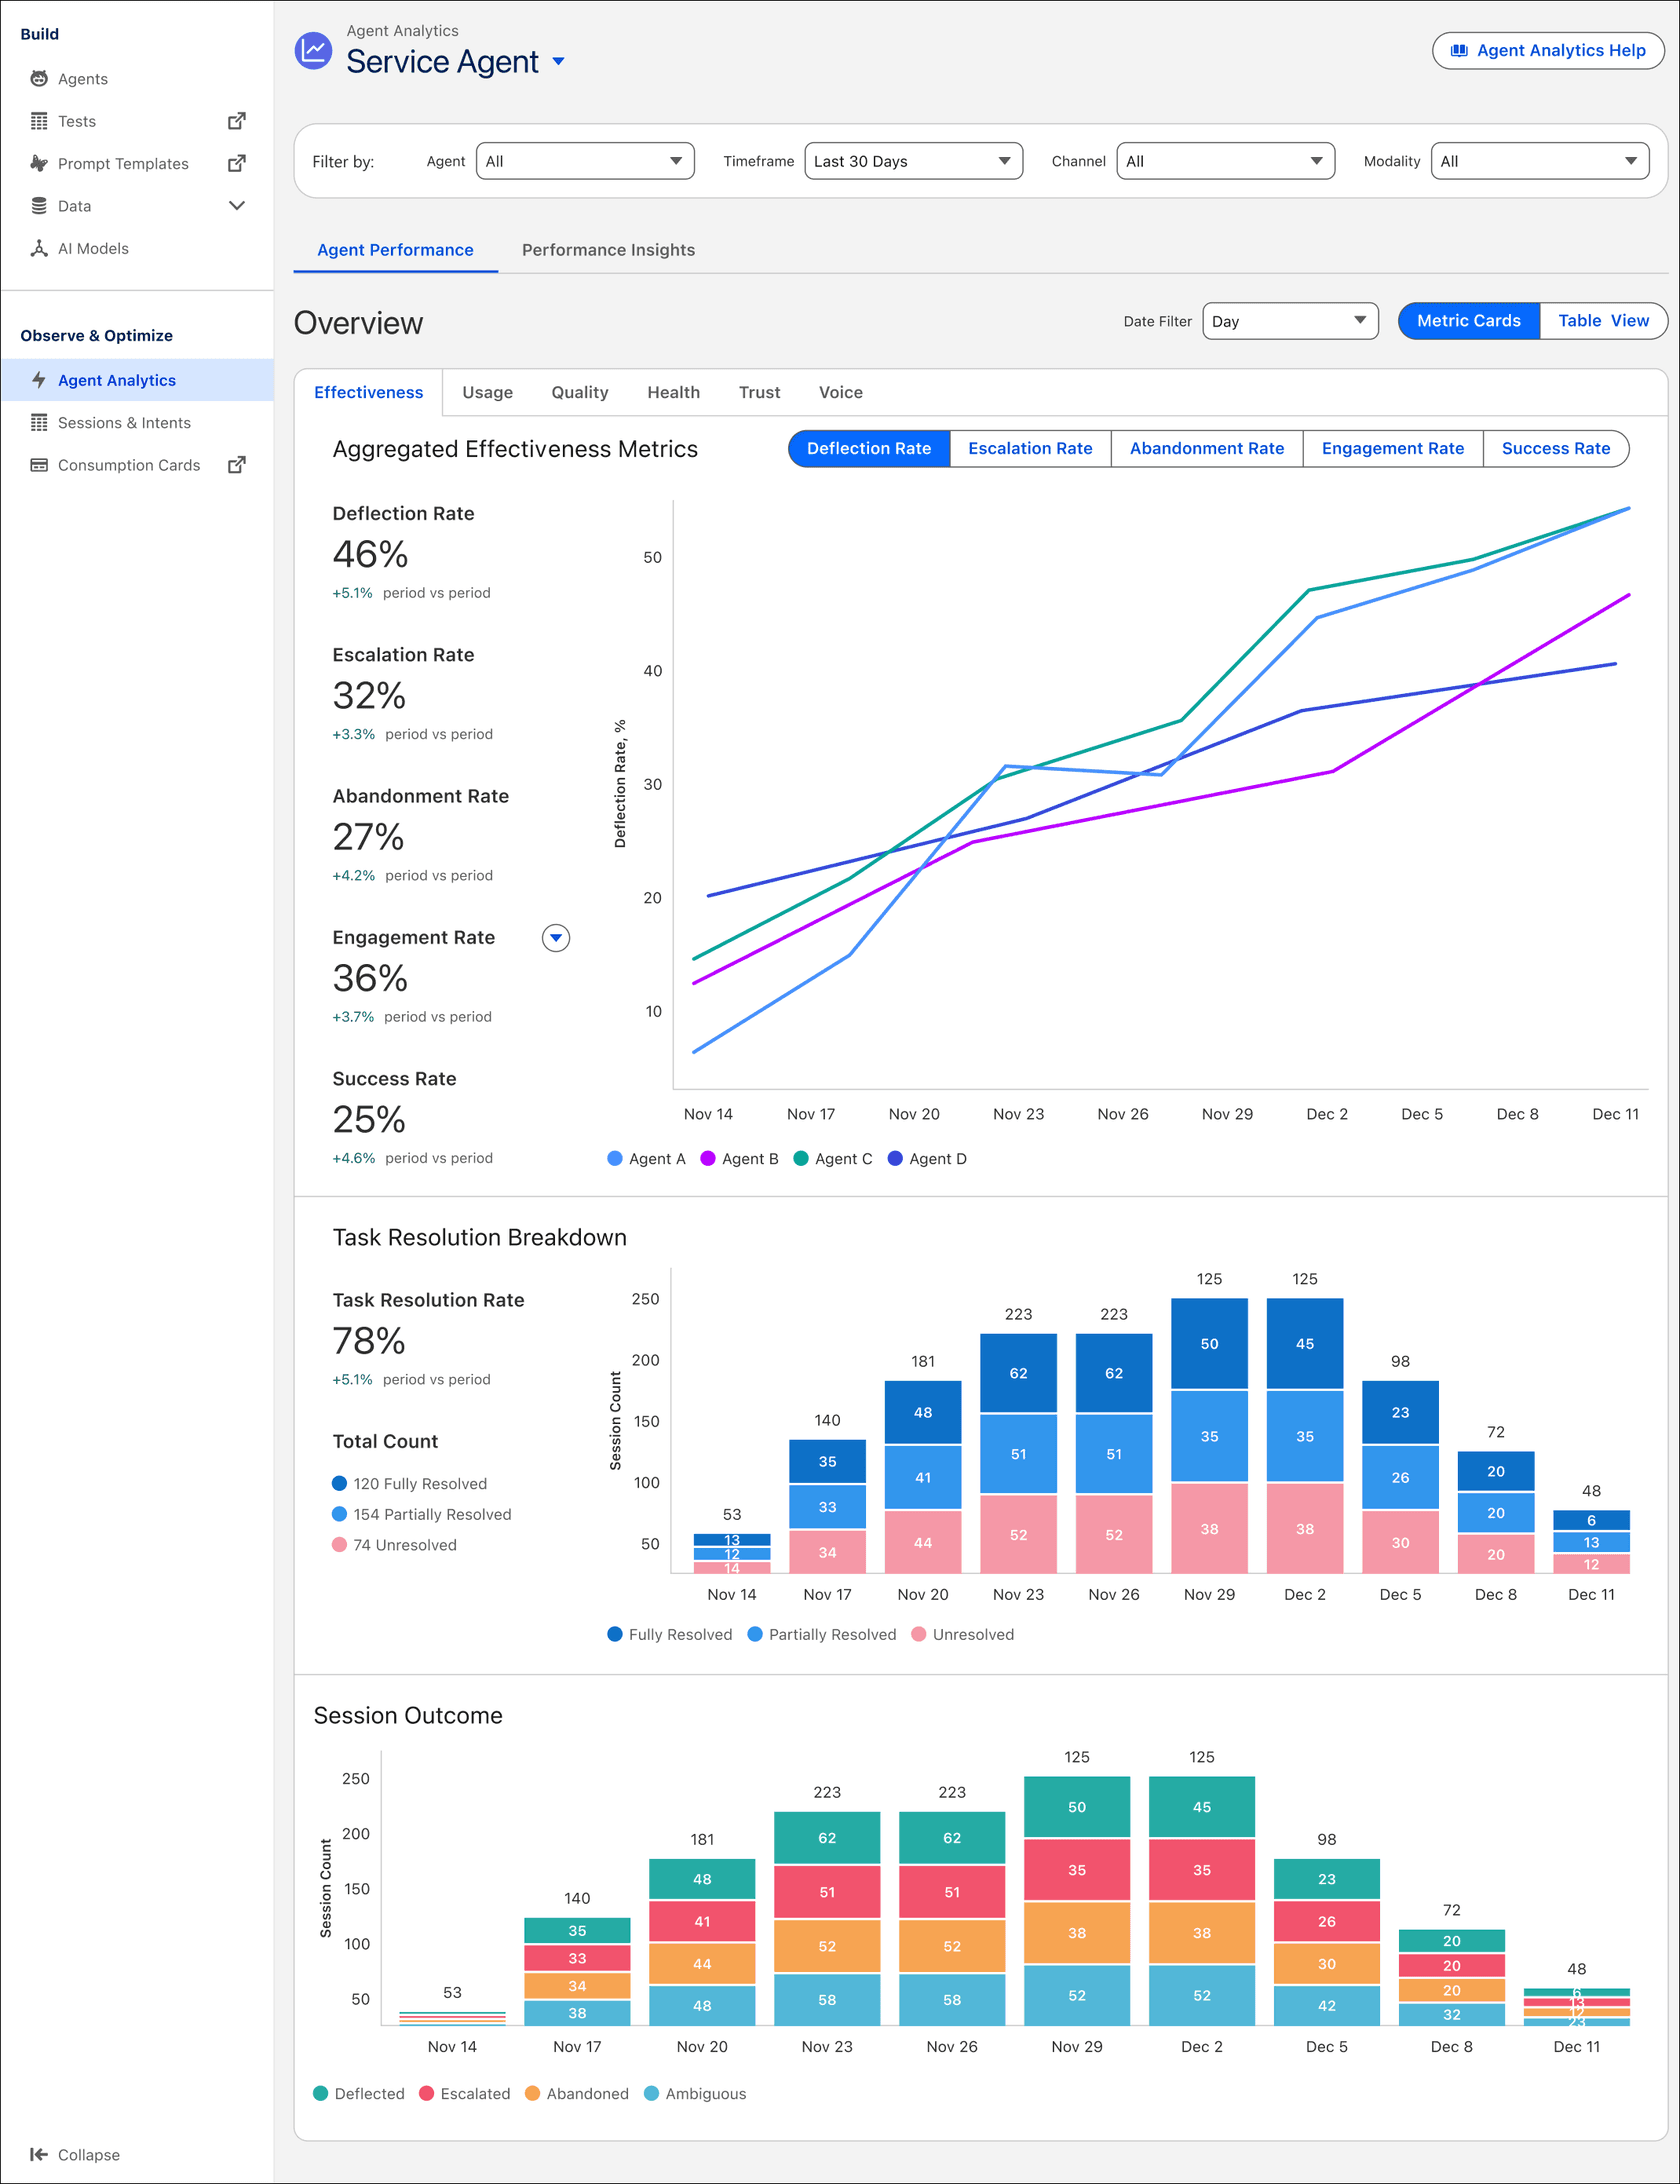
Mesmo dentro de um único produto, o número muda conforme a métrica que você escolhe. O próprio painel de exemplo do Agent Analytics da Salesforce mostra o mesmo conjunto de sessões com uma taxa de desvio de 46%, uma taxa de sucesso de 25% e uma taxa de resolução de tarefas de 78%.
Nada disso torna os fornecedores desonestos. Cada definição está documentada, e o próprio blog da Zendesk alerta que "different tools may classify 'resolved' in different ways". Isso só significa que uma afirmação na página inicial, como os 65% das conversas da HubSpot em 8.000+ clientes, é um número baseado na definição da HubSpot. Não é um patamar que você pode exigir do seu agente da Zendesk ou da Gorgias.
Para conhecer as definições mais a fundo, comece pelo meu post sobre taxa de desvio vs. taxa de resolução. Usuários da Zendesk podem se aprofundar em métricas de agentes de IA da Zendesk, e a parte de preços está em custo por resolução.
"For comparing vendors, the only fair test I know is to run them on the same slice of your own traffic and score it with your own definition. Their published numbers mostly just tell you which definition they chose."

O que benchmarks públicos como o tau-bench dizem a você?
Eles dizem quais modelos lidam bem com tarefas de suporte e, de forma mais útil, com que frequência acertam a mesma tarefa duas vezes. O tau-bench da Sierra coloca um modelo diante de um cliente simulado com ferramentas reais e um documento de políticas e, segundo o artigo do tau-bench, compara "the database state at the end of a conversation" com o estado correto. Ele não avalia o quanto a resposta soou simpática. Avalia se o reembolso realmente foi processado e se deveria ter sido.
A ideia que vale aproveitar para seu próprio benchmark é pass^k. Os autores do artigo a definem como "the chance that all k i.i.d. task trials are successful": execute a mesma tarefa k vezes com um cliente que a formula de maneira diferente a cada vez, e só conte se todas as execuções forem bem-sucedidas. No artigo original, o melhor agente concluiu mais de 60% das tarefas de varejo uma vez, mas menos de 25% quando precisou concluir a mesma tarefa oito vezes.
O ranking atual conta a mesma história. Extraí todas as submissões do bucket de resultados públicos da Sierra:
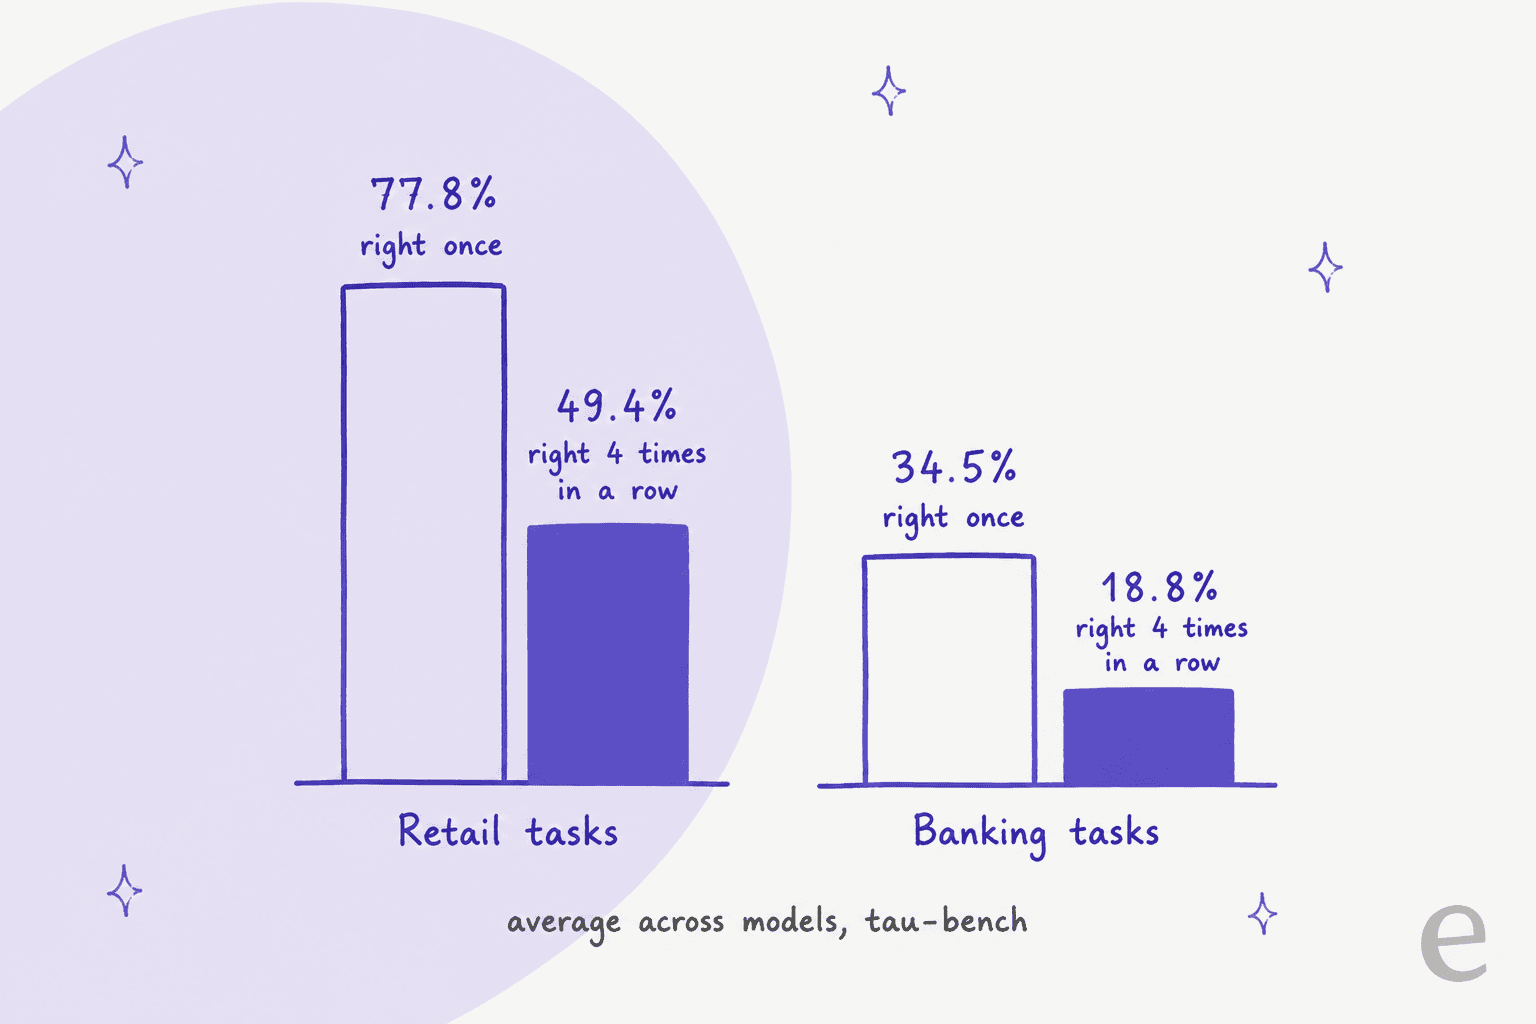
O teste bancário é mais difícil porque a resposta está em 698 documentos de políticas, e não em uma ferramenta, e as tarefas precisam, em média, de 18.6 documentos e 9.5 chamadas de ferramentas, segundo a publicação sobre o tau-Knowledge. Essa é a situação da maioria dos helpdesks reais: a resposta está em algum lugar da sua documentação. O melhor modelo de texto nesse teste, Qwen 3.8 Max, pontua 55.2 em uma execução e 35.1 em quatro execuções.
Se você quiser uma visão mais ampla, a Fireworks publica um índice de suporte ao cliente que mantém cinco benchmarks lado a lado, em vez de misturá-los em uma única pontuação:
| Benchmark (responsável) | O que testa | Pontuação | Líder (novembro de 2026) |
|---|---|---|---|
| τ³-Banking (Sierra) | Solicitações bancárias sujeitas a políticas, com ferramentas e um usuário simulado | Recompensa média por tentativa | Gemini 4 Argon 58.25%, Claude Opus 5.5 56.01% |
| Cresta-Bench (Cresta) | 181 chamadas simuladas distribuídas entre 4 agentes de central de atendimento | pass^3, "a case counts only when all three runs pass" | Claude Opus 5.5 82.57%, Claude Haiku 5.5 em último com 20.05% |
| DuetBench-Diagnosis (Decagon) | Conversas reais de diagnóstico reprocessadas, avaliação às cegas | Classificação Elo | Claude Opus 5 1034.9 |
| τ³-Voice (Sierra) | Agentes de voz full-duplex | Pass@1 | Pine Voice 1.0 87.33% |
| vCX (Retell AI) | Agentes de voz seguindo instruções e chamando ferramentas | Pontuação | GPT-6.1 Sol 93.4% |
Duas ressalvas antes de você se apoiar em qualquer um desses resultados. Primeiro, 27 das 29 submissões de texto no tau-bench foram executadas pela própria Sierra, então é a estrutura de testes de um único laboratório, não uma competição independente. Segundo, e mais importante, nenhum desses testes sabe nada sobre sua política de devolução, suas macros ou os três artigos de ajuda que se contradizem. Um ranking de modelos não é um ranking de agentes de suporte prontos. Use esses testes para selecionar modelos e depois teste sua configuração. Aprofundo a escolha de modelos na minha seleção de modelos para suporte.
Como você faz benchmarking do seu agente de IA em comparação com sua equipe humana?
Você avalia os dois nos mesmos tipos de ticket, com os mesmos critérios, dentro da mesma janela. A armadilha é a média bruta: a IA recebe redefinições de senha e consultas de status de pedidos, sua equipe recebe as disputas de reembolso com clientes irritados, e a IA acaba parecendo mais rápida e melhor porque seus tickets eram mais fáceis.
Este é o método que eu usaria, e é o que recomendaria a qualquer equipe que esteja começando.
- Escolha uma definição de resolvido e coloque-a por escrito. Meu padrão: o problema do cliente foi corrigido, nada contrariou a política e o cliente não voltou com o mesmo problema em 7 dias. Isso é mais rigoroso do que qualquer linha da tabela de fornecedores acima, e deve ser mesmo.
- Primeiro, divida seus tickets por tópico. Reembolsos, status de pedidos, dúvidas de uso, cobrança, bugs. Faça o benchmarking por tópico, nunca como um único número agregado. Uma média entre 90% em dúvidas de uso e 40% em reembolsos resulta em algo sem significado.
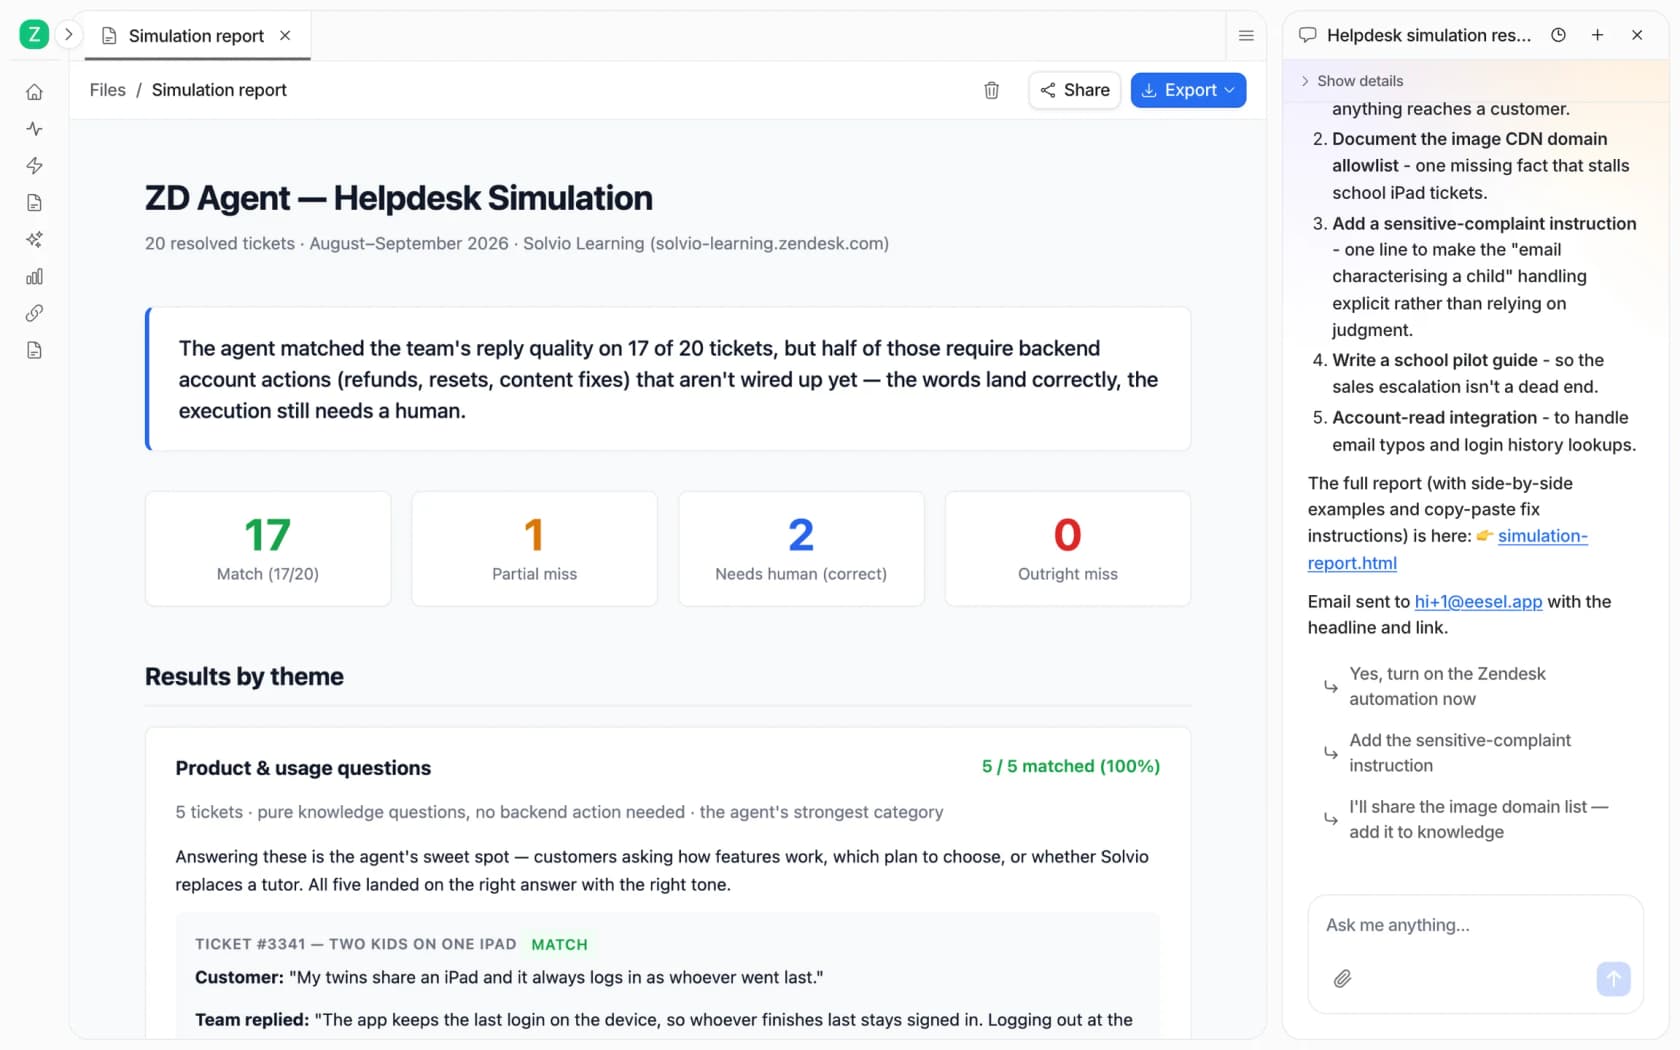
- Reprocesse tickets resolvidos antes de olhar os dados em produção. Pegue tickets que sua equipe já encerrou, faça o agente respondê-los sem enviar nada e compare cada resposta com o que sua equipe realmente escreveu. A resposta da sua equipe é a referência. É aqui que você identifica as piores falhas, sem desgastar a boa vontade dos clientes. Meu guia de testes de simulação aborda avaliação e tamanhos de amostra.
- Avalie manualmente uma amostra às cegas. Misture respostas da IA e de humanos sobre os mesmos tópicos, esconda qual é qual e avalie todas com os mesmos critérios: correta, parcialmente correta, errada, deveria ter transferido. Uma ficha de avaliação de qualidade funciona bem aqui.
- Depois, compare os números em produção, por tópico, na mesma janela. Taxa de reabertura, CSAT, tempo até a resolução e custo por ticket resolvido, IA vs. humano, tópico por tópico.
A etapa 4 importa mais do que parece. Em um teste com tráfego real que a eesel realizou para uma loja online alemã de joias que usa Zendesk e Shopify, o mesmo agente obteve 93% de precisão na triagem, teve uma taxa de erros factuais de 7% e, ainda assim, só 12% dos seus rascunhos foram enviados sem alterações. Três números verdadeiros de um único teste, contando três histórias diferentes. Quando investiguei as reescritas, cerca de 65% eram a equipe encurtando o rascunho ou mudando seu tom, o que é um problema de estilo, não de correção. Se eu tivesse feito o benchmarking apenas com base em "enviado sem alterações", teria chamado de fracasso um agente que estava correto na maior parte do tempo.
Uma amostra separada me ensinou uma segunda lição: teste com tickets reais, não com as perguntas que você faria em uma demonstração. Em uma amostra de 434 chats analisada pela eesel, os chats com IA foram avaliados como bons em 86% dos casos no geral, mas em 79% dos chats que vieram de tickets reais do helpdesk. Suas próprias perguntas são sempre mais fáceis do que as dos seus clientes.
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Uma liderança de CX de uma marca de suplementos DTC que usa Gorgias e Shopify, em uma chamada de vendas da eesel
Essa citação é a razão prática para fazer benchmarking por tópico. Você não consegue auditar tudo, então o verdadeiro trabalho do benchmark é dizer quais tópicos a IA pode assumir e quais deve transferir.
Quais números devem entrar na sua ficha de benchmarking de IA?
Menos do que seu painel mostra. Eu manteria cinco, todos medidos por tópico, todos calculados a partir dos seus próprios dados, e não do campo de resolução do fornecedor.
| Métrica | Como calculá-la | Por que está na lista |
|---|---|---|
| Taxa de envolvimento | Tickets em que a IA atuou ÷ todos os tickets | Mostra quanto da fila a IA chega a ver |
| Taxa de contenção | Tickets da IA sem resposta humana ÷ tickets da IA | Aproximadamente o que a maioria dos fornecedores chama de resolução. Útil, mas generosa |
| Taxa de resolução verificada | Tickets contidos que não voltaram em 7 dias e passaram pela avaliação de qualidade ÷ tickets da IA | A versão honesta do número acima |
| Taxa de automação de ponta a ponta | Resoluções verificadas ÷ todos os tickets | A que importa para o financeiro |
| Resolução no primeiro contato e CSAT, mais custo por resolução verificada, IA vs. humano | Mesma fórmula para ambos, mesmos tópicos, mesma janela | A comparação direta de verdade |
A diferença entre contenção e resolução verificada é o número isolado mais útil que você vai calcular. Se for pequena, o número do fornecedor é próximo o suficiente para ser confiável. Se for grande, o agente está encerrando tickets que não estão realmente encerrados. Uma pessoa responsável pela operação no Reddit aprendeu isso da maneira mais difícil:
"i track cost per resolution with a 48 hour window for reopens, automation rate alone is basically useless we had a period where our "automation rate" looked incredible but half those customers were just giving up and calling in later, the dashboard was lying to us"
Insira os dados do seu próprio mês aqui para ver a diferença:
Com os números padrão, os mesmos 6.000 tickets da IA aparecem como 70% contidos e 52% verificados, e só 31% de toda a fila está realmente automatizada. Os três números são honestos. Só um deles é o número que você deve apresentar ao seu chefe. Para um conjunto mais amplo de métricas, meu guia de métricas de atendimento ao cliente com IA vai mais a fundo. O post sobre KPIs de atendimento ao cliente aborda metas para humanos, e o de benchmarks de custo por ticket aborda o lado humano da comparação de custos.
Como é um bom resultado na prática?
Um bom resultado é uma parcela de tópicos que a IA assume por completo, crescendo de forma intencional, não uma grande porcentagem no primeiro dia. As histórias de clientes da eesel mostram isso com mais clareza do que qualquer média, porque relatam a divisão do trabalho em vez de uma taxa única.
- A ClutchLoop, uma marca de acessórios para celular que usa Gorgias e Shopify, teve cerca de
180respostas enviadas diretamente aos clientes em um mês, "about seven in ten conversations, no person needed". - A Question Beauty, uma marca de cosméticos que usa Gorgias, teve cerca de
280tickets encerrados pela eesel e cerca de250atribuídos a uma pessoa, de um total de990atendidos. - A SE Ranking, que usa Zendesk, teve
2,100chats ao vivo respondidos primeiro pela eesel, de um total de4,650conversas. Agora está testando respostas diretas por e-mail em tickets de teste escolhidos pela linha de assunto, com cada conversa marcada como aberta, resolvida, escalonada ou com uma pessoa, e uma conversa só conta como resolvida "once the customer says it worked". Esse é um critério mais rigoroso do que o de qualquer fornecedor na tabela acima. - O Cactus Club Cafe opera o suporte interno de TI na Zendesk e escolheu a configuração oposta:
790rascunhos de resposta para a equipe técnica "against 51 sent directly". Para os tickets deles, manter uma pessoa no processo é a meta certa para o benchmark.
"In the first month, eesel is resolving 73% of our tier 1 requests. eesel offers easy Zendesk implementation and setup. Our team implemented and achieved results quickly during our 7-day trial."

Observe o escopo dessa avaliação: solicitações de nível 1, não todos os tickets. É exatamente assim que um benchmark deve ser citado. Se alguém apresentar uma taxa de resolução sem dizer quais tickets ela abrange e como "resolvido" foi definido, você ainda não tem um benchmark. Para formas de melhorar o número depois de medi-lo, veja meu guia sobre como melhorar a taxa de resolução.
Quais são os erros mais comuns no benchmarking de IA?
A maioria vem de medir o que é fácil porque o painel já mostra.
- Fazer benchmarking apenas de perguntas que podem ser respondidas. Se seu conjunto de testes só contém perguntas cobertas pela sua documentação, você vai deixar passar a pior falha: o agente inventar uma resposta quando a base de conhecimento não tem nada. Adicione perguntas que você sabe que não consegue responder e verifique se ele transfere o atendimento em vez disso. Meu post sobre alucinações de IA no suporte aborda esse ponto.
- Contar encerramentos em vez de acertos. Uma resposta errada que parece certa ainda encerra o ticket como resolvido.
"The hardest ones are wrong answers that sound right. Nothing errors, the customer doesn't push back, and the ticket can close as resolved. If a refund window changes and the agent is still working from the old policy text, the resolution rate won't flag it, because that metric only counts closures."
- Confiar em uma única execução. O tau-bench mostrou pontuações caindo cerca de um terço até a metade quando a mesma tarefa precisa passar quatro vezes. Execute novamente seu conjunto de testes após cada mudança nas instruções ou na documentação e procure respostas que mudam.
- Poucos tickets por tópico. Um resultado de 85% em 20 tickets representa uma faixa de 64% a 95%. Isso é uma primeira impressão, não um veredito.
- Deixar de fora entradas complicadas. Clientes colam números de pedido errados, escrevem em dois idiomas e, de vez em quando, tentam convencer o bot a dar um desconto. Testes adversariais devem fazer parte do conjunto.
- Comparar com a média de um fornecedor. A média de um fornecedor vem do seu próprio conjunto de clientes e da sua própria definição. Sua referência é a sua equipe.
Se você ainda está escolhendo uma ferramenta, meu checklist de avaliação de fornecedores incorpora esse tipo de teste com tickets ao processo de compra. Meu modelo de RFP faz o mesmo, para que todos os fornecedores sejam avaliados nos mesmos tickets.
Faça benchmarking do seu agente de IA com a eesel
A eesel é uma colega de equipe de IA para helpdesk que entra na sua fila existente, seja no Zendesk ou em outro helpdesk, e o benchmarking faz parte de como ela começa. Segundo a documentação da eesel, sua simulação "replays your real past tickets and compares its answers to what your team sent", depois avalia os resultados por tema e sugere correções nas instruções.
A implementação segue as mesmas etapas do método acima: comece com rascunhos, deixe a IA responder aos tópicos fáceis e ative mais conforme as pontuações justificarem. Funciona da mesma forma nas filas do Freshdesk, e a integração com Gorgias segue a mesma implementação.
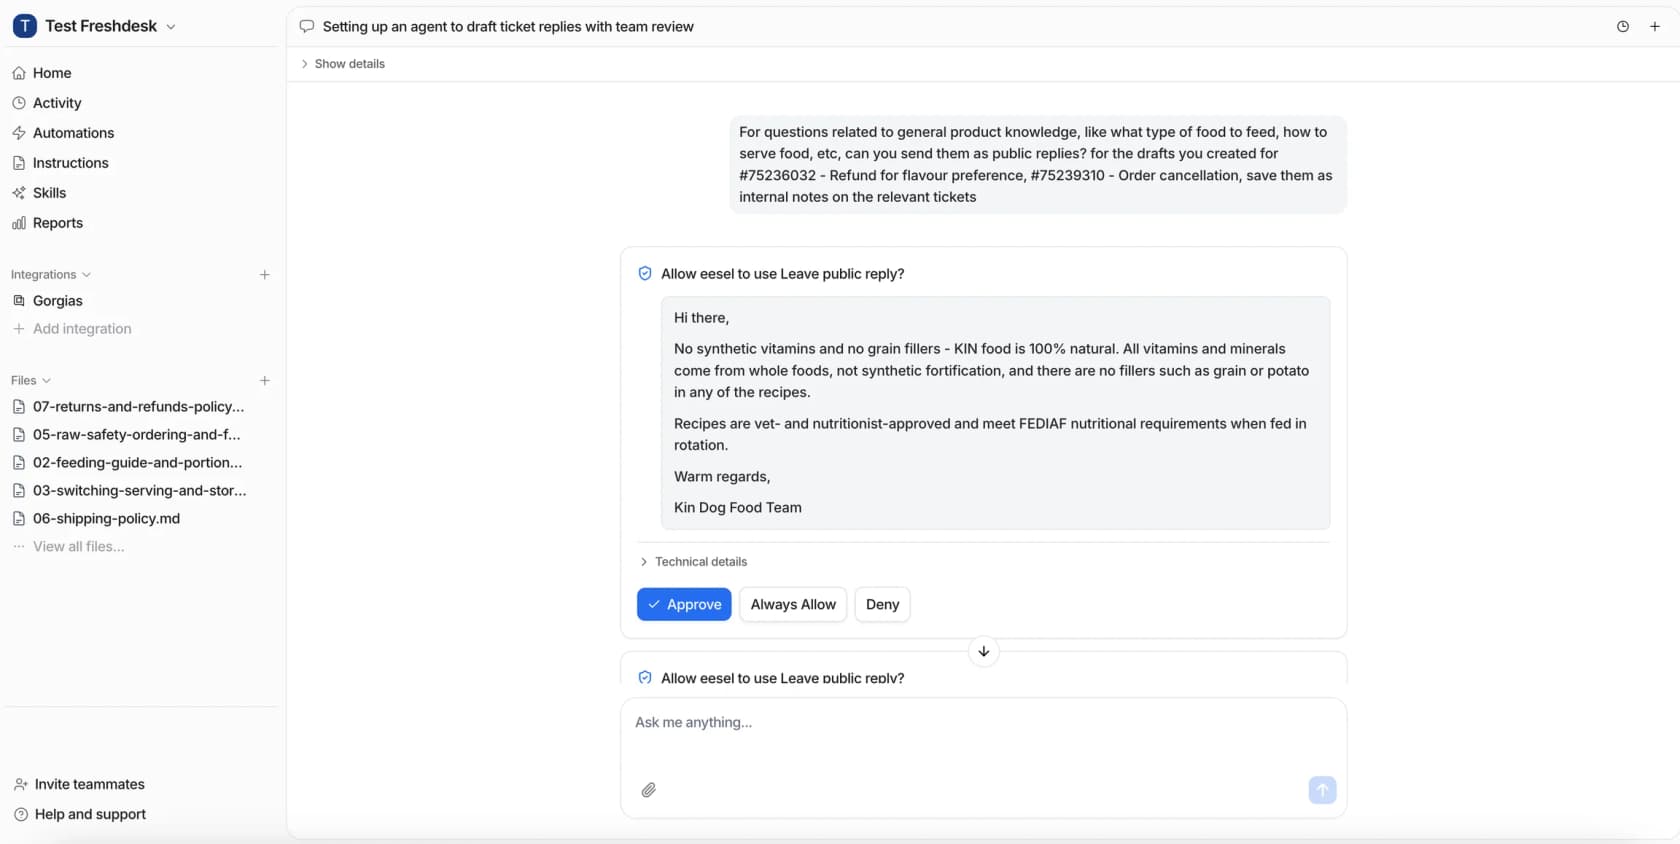
Se você quer seu próprio benchmark em vez da média de um fornecedor, execute uma simulação com os tickets resolvidos do mês passado e veja, tópico por tópico, onde a IA se iguala à sua equipe. Os planos pagos começam em US$ 299 por 500 créditos, e um ticket ou chat usa um crédito. Experimente a eesel primeiro nos seus próprios tickets.