

O teste de simulação de suporte com IA consiste em reproduzir pelo agente de IA tickets que sua equipe já resolveu, com o envio desligado, e avaliar cada resposta antes que qualquer cliente veja uma. A nota só vale o que valem três coisas: quantos tickets você reproduziu por tema, contra o que você avaliou e se o teste podia tocar em sistemas reais. Uma correspondência de 85% em 20 tickets pode na verdade ser qualquer valor entre 64% e 95%, então leia por tema e trate execuções pequenas como uma primeira olhada, não como um veredito.
Dos helpdesks que verifiquei, apenas o agente de e-mail do Freshdesk e a eesel reproduzem seus próprios tickets resolvidos. O simulador do Zendesk roda cenários fictícios, o HubSpot gera perguntas a partir de temas de conversas passadas, o Salesforce gera ou carrega casos de teste, e o Gorgias testa uma conversa de cada vez.
A execução mais útil que já vi, uma checagem cruzada de 100 tickets em uma caixa de entrada real de ecommerce, deu 88% certo na direção, mas apenas 12% dos rascunhos sairiam sem edição e 7% tinham um erro factual. Mesma execução, três notas honestas. É por isso que começo todo lançamento com uma simulação e depois um período de rascunhos em tickets reais. A eesel faz as duas coisas, e a Norden-Frisia assinou em poucos dias depois de uma semana de teste com os próprios tickets antigos.
O que é o teste de simulação de suporte com IA?
O teste de simulação de suporte com IA é um ensaio de um agente de IA com mensagens realistas de clientes, em que cada resposta é registrada e avaliada em vez de enviada. Ele responde a uma pergunta antes do lançamento: se esse agente tivesse atendido sua fila no mês passado, com quantas das respostas dele você ficaria feliz em enviar?
Há três maneiras de alimentar uma simulação, e elas pegam coisas diferentes.
| Tipo de simulação | De onde vêm as mensagens de teste | O que ela pega | O que ela deixa passar |
|---|---|---|---|
| Reprodução de tickets antigos | Tickets resolvidos do seu próprio helpdesk, nas palavras dos seus clientes | Formulação real, mistura real de temas, lacunas na sua base de conhecimento | Problemas novos que você ainda não viu, insistência em várias mensagens |
| Cenários gerados | Uma IA escreve mensagens de clientes a partir dos seus documentos, temas ou um prompt | Cobertura de temas com pouco histórico, casos extremos que você descreve | Como os clientes realmente escrevem, a participação real de cada tema |
| Conjuntos de teste roteirizados | Perguntas que você ou sua equipe escrevem à mão | Riscos conhecidos: reembolsos, jurídico, prompt injection | Tudo em que ninguém pensou em anotar |
Eu sempre começaria pela reprodução, porque é a única construída com o que os clientes realmente enviam. Os testes gerados e roteirizados preenchem os buracos que a reprodução deixa, principalmente nos temas arriscados que não aparecem com frequência suficiente para entrar numa amostra. Meu guia anterior de teste de agentes de suporte com IA reúne os três em um plano de lançamento de quatro etapas, e a lista de verificação pré-lançamento cobre transferências, ações e o botão de desligar. Este artigo aprofunda a simulação em si: como rodar uma e como ler a nota que ela dá.
Por que uma boa nota de simulação ainda pode enganar?
Eu construo as integrações que trazem o histórico de tickets para a eesel, então passo muito tempo olhando o que uma reprodução realmente lê. A lição que continuo reaprendendo é que "85% aprovado" não significa nada até você saber o que "aprovado" significou.
Essa checagem cruzada de 100 tickets do TL;DR é o exemplo mais claro que tenho. Foi um teste em uma caixa de entrada real de ecommerce com cerca de 1.000 tickets por mês. A triagem foi 93% precisa e a detecção de spam, 100%. Os rascunhos apontavam na direção certa 88% das vezes. Mas só 12% seriam enviados exatamente como escritos, e 7% continham um erro factual. Das reescritas, cerca de 65% eram de tamanho e tom, corrigíveis aprendendo com as respostas enviadas da própria equipe, e só cerca de 5% eram o agente errando nos fatos. Se você tivesse parado em "88%", teria lançado com uma taxa de erro de 7% que nunca viu, o tipo de alucinação de IA silenciosa que os clientes encontram antes de você.
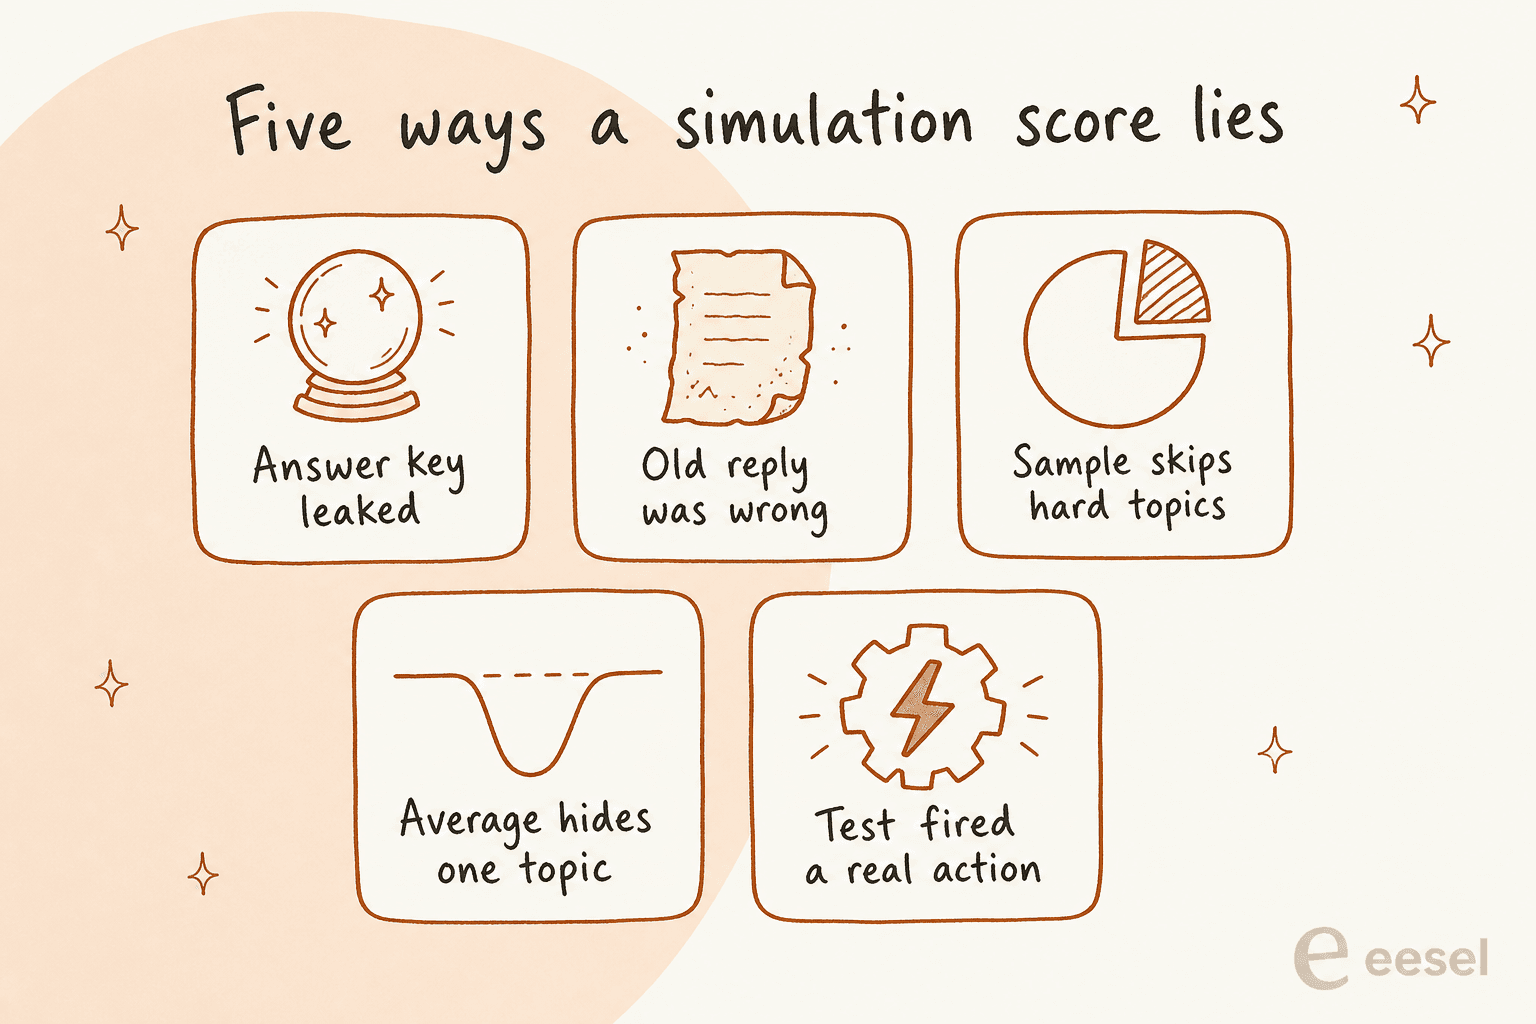
Estas são as cinco maneiras que já vi uma nota de simulação se afastar do que é o dia do lançamento:
- O gabarito vazou. Se o agente consegue ler o próprio ticket em que está sendo testado, ou uma macro escrita depois que esse ticket foi resolvido, ele está se avaliando com as respostas na mão. Escolha tickets com os quais o agente não aprendeu, ou desligue essa fonte de tickets no teste.
- A resposta antiga estava errada. Bater com o que sua equipe enviou é um bom padrão, mas algumas dessas respostas usavam uma política que você já mudou, e outras eram simples erros. Avalie contra a política de hoje e trate uma "divergência" em um ticket desatualizado como acerto.
- A amostra pula os temas difíceis. Vinte tickets recentes de uma quinzena calma podem não ter nenhuma disputa de reembolso. Preencha a amostra por tema e depois acrescente casos escritos à mão para os raros e arriscados.
- A média esconde um tema. Uma nota geral de 90% pode estar sobre um tema que falha sempre. Um comentarista do Reddit disse bem: "A clean average can still hide one common path that fails every time" (u/Bitter_Big4525).
- O teste disparou uma ação real. Uma resposta que nunca é enviada é segura. Um reembolso, um cancelamento ou uma atualização de CRM disparados durante um teste não são. Mais sobre isso no passo 3 abaixo.
"the biggest failure i've seen was an agent that kept pulling data from the wrong user's account because the session token wasn't being passed correctly to the api call, the text responses looked perfect so nobody caught it until a customer complained about seeing someone else's balance"

Esse último é o motivo pelo qual uma simulação precisa olhar o que o agente fez, não só o que ele disse.
De quantos tickets uma simulação de suporte com IA precisa?
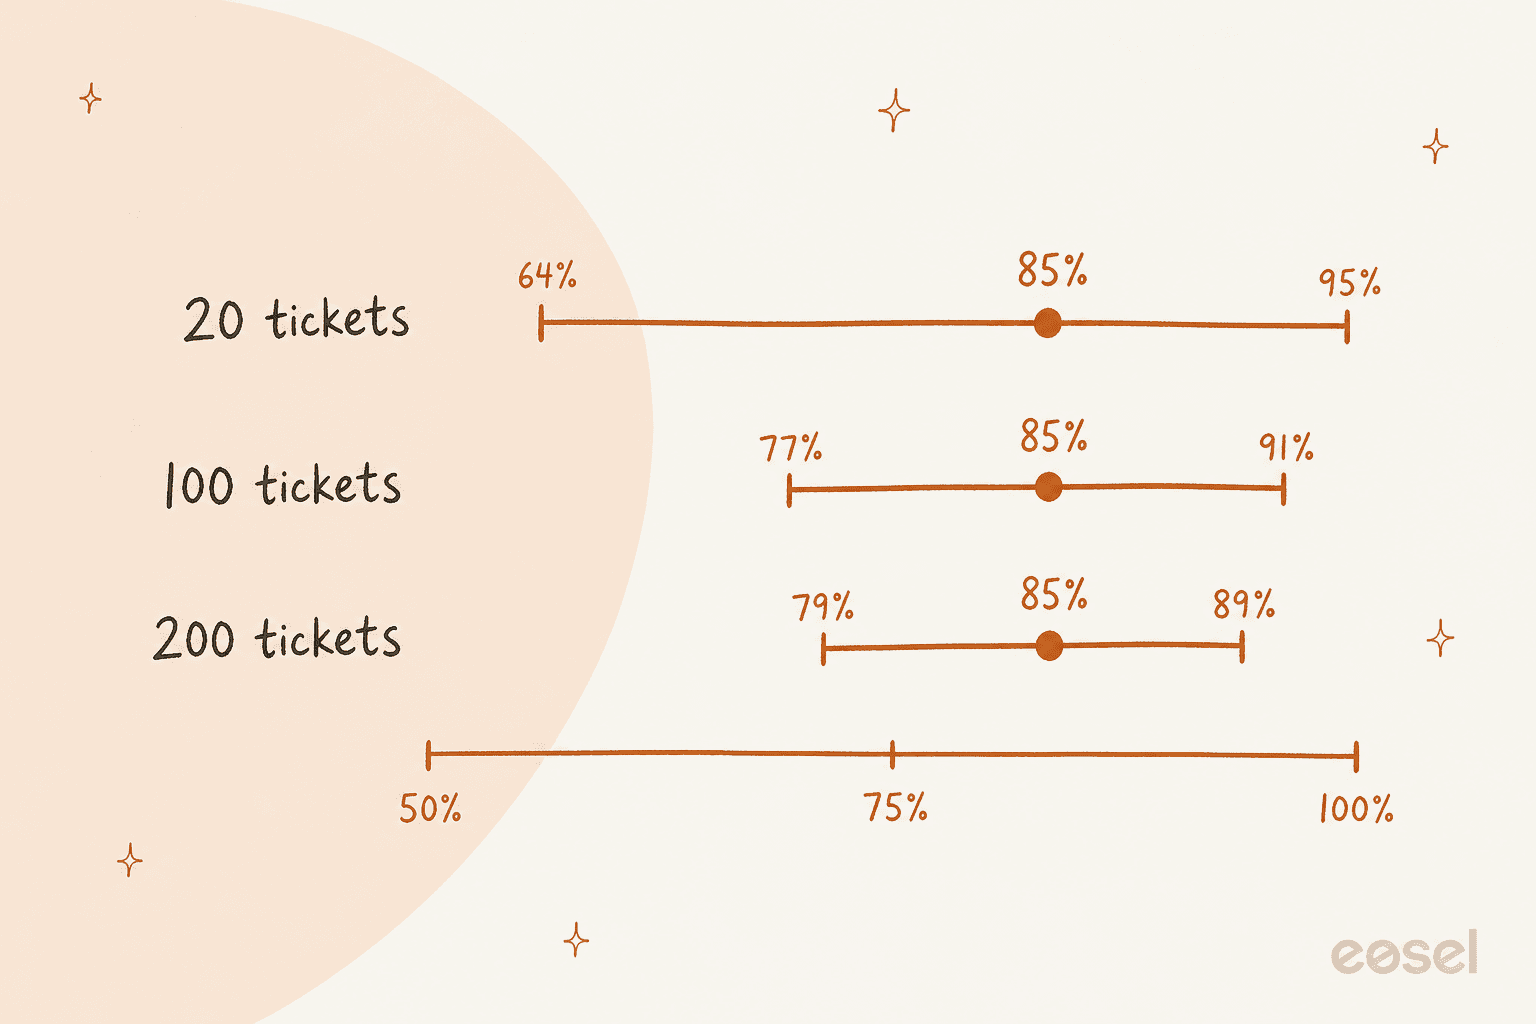
Para uma primeira olhada, 20 tickets bastam. Para decidir o lançamento de um tema, você quer algo mais perto de 100 tickets desse tema, porque execuções pequenas dão uma nota com margem de erro muito ampla.
Aqui está a mesma nota de 85% em três tamanhos de amostra, usando uma faixa de confiança padrão de 95% (o intervalo de Wilson, se quiser conferir minha conta):
| Tickets reproduzidos | Aprovados | Nota | A taxa real provavelmente está entre |
|---|---|---|---|
| 20 | 17 | 85% | 64% e 95% |
| 50 | 42 | 84% | 72% e 92% |
| 100 | 85 | 85% | 77% e 91% |
| 200 | 170 | 85% | 79% e 89% |
| 20 | 20 | 100% | 84% e 100% |
Duas coisas chamam a atenção. Uma execução de 17 em 20 não consegue dizer se você tem um agente de 65% ou de 95%. E um 20 em 20 perfeito só diz que a taxa real de falhas provavelmente está abaixo de uns 16%. É um ótimo sinal para uma primeira execução, mas não basta para pôr um tema em piloto automático total.
A solução é barata: rode a simulação por tema e continue adicionando tickets aos temas que você quer automatizar até que o limite inferior da faixa supere a sua meta. Coloque seus próprios números aqui:
Se um tema recebe só um punhado de tickets por mês, você não terá histórico suficiente para provar nada em nenhum sentido. É um tema para rascunhos ou uma transferência para uma pessoa, não para piloto automático, por melhor que a execução pequena pareça.
Como rodar uma simulação de suporte com IA em que você possa confiar?
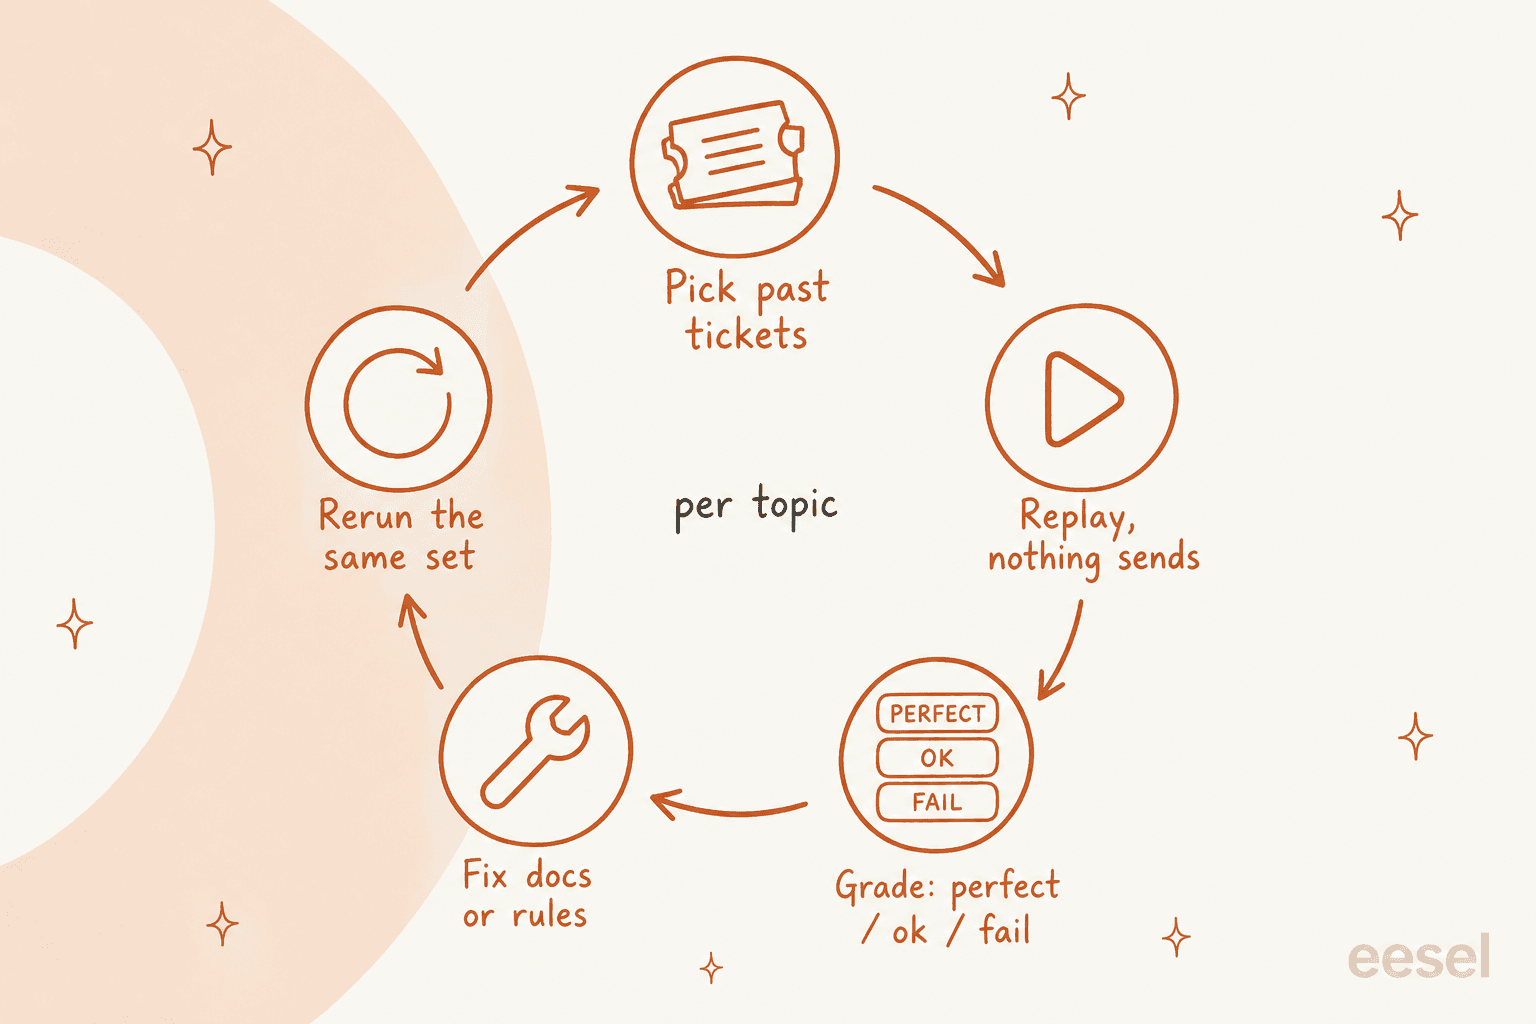
Seis passos, nesta ordem. Funcionam do mesmo jeito se você usar o testador integrado do seu helpdesk, uma planilha ou um agente de IA para helpdesk dedicado. O ciclo inteiro leva uma tarde na primeira vez e minutos a cada repetição depois.
Passo 1: escolha os tickets por tema
Pegue tickets resolvidos dos últimos dois ou três meses, para que reflitam seus produtos e políticas atuais. Agrupe por tema (as tags do seu helpdesk ou os campos de ticket costumam bastar) e pegue de cada tema uma parte próxima da frequência com que ele chega. Depois acrescente um pequeno conjunto escrito à mão para os casos raros e de alto risco: um reembolso fora do prazo, um cliente que pede um gerente, uma mensagem tentando sobrescrever as regras do agente, uma pergunta que seus documentos não respondem de jeito nenhum.
Esse último tipo importa mais do que parece. Algumas das piores falhas iniciais que vi no histórico de clientes da eesel foram bots inventando respostas quando a base de conhecimento não tinha nada relevante. Um conjunto de teste sem perguntas sem resposta não consegue pegar isso, e é o núcleo de prevenir alucinações no suporte.
"The one that worried me most was refund amounts. I ran AI models through support emails with a written refund policy, and 7 of them promised the wrong amount on the same email. The reply reads polite and confident, so nobody catches it until the customer quotes it back. On the easy emails they all looked great. It only showed up on hard emails I wrote and held back."
Passo 2: congele o que o agente sabe e procure vazamentos
Aponte o agente para a mesma central de ajuda, macros e instruções que ele usará no primeiro dia, e nada mais. Cada resposta deve estar fundamentada em uma fonte que você possa apontar, para que o avaliador confira de onde veio. Depois confira se o ticket que você está reproduzindo, e tudo o que foi escrito para respondê-lo, não está no conhecimento do agente. Se o agente aprende com tickets antigos, escolha tickets com os quais ele não aprendeu ou exclua essa fonte na execução de teste.
Passo 3: desligue toda ação que escreve
Desligue o envio e depois confira as ações. Os fornecedores deixam claro que isso não é automático:
- O Gorgias avisa que, quando o agente usa uma ação em uma conversa de teste, "it can affect real customer and order data (like cancelling an order)", e sugere um perfil de cliente fictício (documentação do Gorgias).
- O Salesforce diz "Testing agents can modify CRM data" e orienta a rodar o Testing Center apenas em um sandbox.
- O painel de testes do HubSpot agora mostra "any records that were created or updated" durante um teste (documentação do HubSpot).
Minha regra: em uma simulação, o agente pode ler tudo o que lerá em produção e não escrever nada. Se quiser testar uma ação de reembolso, teste-a separadamente contra um pedido fictício e avalie-a com ações sob aprovação quando for ao ar.
Passo 4: avalie em três níveis, mais uma categoria "nunca"
Uma nota de aprovado/reprovado joga fora a informação mais útil. Eu avalio cada resposta como uma destas:
- Perfeita: você enviaria como está.
- Aceitável: resposta certa, precisa de uma edição leve de tamanho ou tom.
- Falha: errada, incompleta, ou deveria ter transferido e não transferiu.
Depois mantenho uma categoria separada "nunca" para as falhas que impedem o lançamento independentemente da média: uma política inventada, um reembolso prometido que a política não permite, dados de outro cliente, uma transferência perdida em um ticket jurídico ou de segurança. Um comentarista do Reddit descreveu suas categorias como "annoying", "bad" e "burn it down", e o nível burn-it-down "has to be zero or we don't ship" (u/Evening_Event4634).
Deixar um avaliador de IA fazer a primeira passada é ok, e a maioria das ferramentas já faz isso. O Salesforce usa um "LLM judge" que compara cada resposta com uma resposta esperada, e até ele diz que suas notas de qualidade "are not absolute measures of success or failure" (Salesforce). Eu peço que uma pessoa leia cada falha, cada candidato a "nunca" e uma fatia aleatória dos acertos, o que mantém um humano no circuito onde o avaliador é mais fraco. As boas práticas de avaliação da OpenAI dizem o mesmo sobre conferir um avaliador de modelo com pessoas. É o mesmo hábito de uma sessão de calibração de QA, só que apontado para o agente.
Passo 5: leia os resultados por tema e decida por tema
É aqui que a execução vira um plano de implantação. Para cada tema, tome uma de três decisões:
| Como é o resultado do tema | O que eu faria |
|---|---|
| O limite inferior da faixa supera sua meta, zero falhas "nunca" | Candidato a responder sozinho, depois de uma semana de rascunhos em tickets reais |
| Em sua maioria perfeito ou aceitável, algumas falhas que você entende | Rascunhos para uma pessoa enviar, corrigir a causa, rodar de novo |
| Muitas falhas, ou qualquer falha "nunca" | Transferir para uma pessoa, corrigir antes os documentos ou regras |
Lançar por tema, não tudo de uma vez, é como a maioria dos clientes da eesel faz. A Rúngne mantém uma lista de temas que decide o que recebe resposta direta e o que recebe rascunho, e mover um tema de um lado para o outro é editar a lista. A smava marca cerca de 1.100 dos seus 27.000 tickets mensais como elegíveis para resposta automática, com rascunhos para o resto.
Passo 6: corrija e depois rode os mesmos tickets de novo
Quando um tema falha, a correção costuma ser um artigo de ajuda que falta ou é vago, uma instrução frouxa demais ou uma regra de transferência que não dispara. Faça a mudança, rode exatamente o mesmo conjunto de novo e compare. Mantenha no conjunto os tickets que já passaram, porque a correção de um tema pode quebrar outro sem alarde. Rode de novo sempre que mudar o modelo, as instruções, o limite de confiança ou um grande pedaço da base de conhecimento. Pular a repetição depois de uma "pequena mudança" é um dos erros de implementação que mais vejo.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Quais helpdesks permitem simular um agente de IA em tickets antigos?
A maioria dos agentes de IA hoje traz algum tipo de executor de testes, mas eles entendem coisas muito diferentes por "simulação". Se você está escolhendo uma ferramenta, vale a pena incluir isto na sua lista de avaliação de fornecedores. Conferi a central de ajuda de cada fornecedor em 30 de outubro de 2026:
| Ferramenta | Reproduz seus tickets antigos reais? | Entrada de teste | Limite por execução | Como as respostas são pontuadas | Os testes podem tocar dados reais? | Repetições salvas |
|---|---|---|---|---|---|---|
| Simulador de conversas do Zendesk (acesso antecipado) | Não, só dados fictícios | Perfis de cliente e cenários que você escreve ou a IA gera | Não informado | Status por conversa, estimativa de resolução | Não informado; o widget de teste ignora ações de CRM | Cenários com versões, histórico de execuções |
| Agente de IA de e-mail do Freshdesk | Sim, tickets resolvidos | Tickets importados, e-mails digitados ou gerados | 50 | Answered, Unanswered ou Error, mais sua avaliação | Workflows disparam; não informado se ao vivo | Sim |
| Agente de IA de chat do Freshdesk | Não | Perguntas digitadas ou geradas | 100 | Answered ou Unanswered, mais sua avaliação | Não informado | Sim |
| Agente de cliente do HubSpot | Não, gera perguntas a partir de temas de conversas passadas | Perguntas geradas ou digitadas | 8 conjuntos de teste | Você marca Looks good ou Looks bad | Registros podem ser criados ou atualizados | Sim |
| Gorgias AI Agent | Um ticket existente por vez | Mensagem digitada ou um ticket antigo | 1 conversa | Sem nota; você lê o raciocínio dele | Sim, se as ações estiverem ligadas | Não |
| Testing Center do Salesforce Agentforce | Não | Gerado a partir de temas, ações ou conhecimento, ou upload de CSV | 100 gerados, 1.000 por CSV | Juiz de IA contra uma resposta esperada, notas de qualidade de 0 a 5 | Sim, sandbox recomendado | Sim |
| Atlassian Customer Service Management | Não informado | Um conjunto de dados de perguntas | Não informado | Resolvido ou não, revisado por uma pessoa | Não informado | Sim |
| eesel | Sim, tickets resolvidos | Tickets antigos, ou casos gerados sem helpdesk | Execução de exemplo na documentação: 20 tickets | Comparado com o que sua equipe enviou, agrupado por tema | Não, "It sends nothing to customers" | Sim, pode rodar em um agendamento |
Algumas coisas que vale saber sobre cada um.
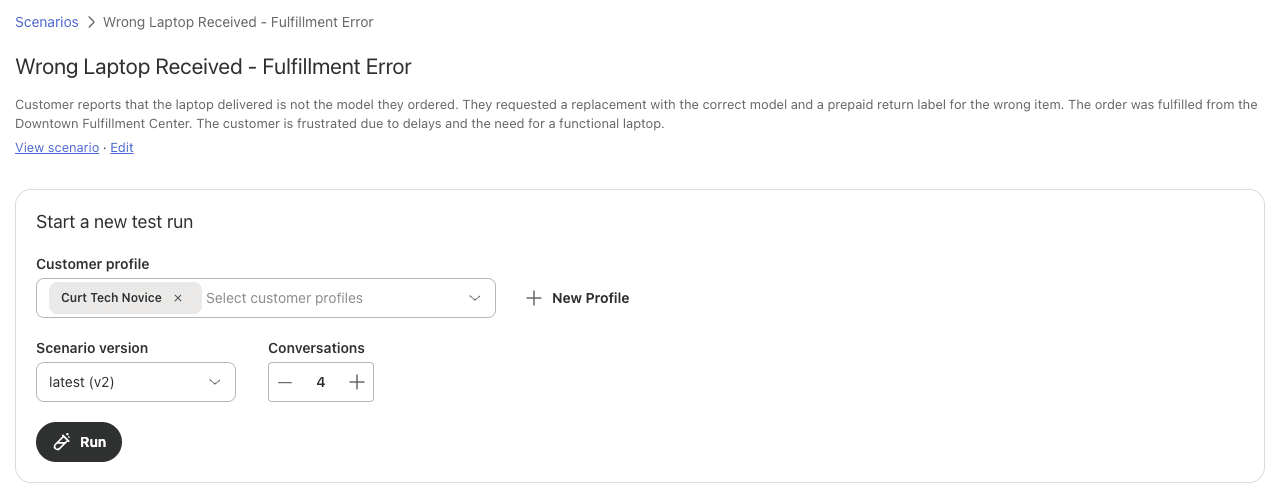
Zendesk. O simulador de conversas está em um programa de acesso antecipado e funciona apenas com um agente de IA de mensagens. Você escreve um cenário (contexto, problema inicial, resultado esperado, valores fictícios) e escolhe um perfil de cliente, e a IA faz o papel do cliente. O Zendesk diz que ele foi "designed for testing with fictional data", então é forte para chats de várias mensagens e fraco para "como teria lidado com o mês passado". Testar nele não consome resoluções automatizadas, o que importa com o preço por resolução do Zendesk. Depois do lançamento, os registros de conversas e o Zendesk QA assumem a avaliação.
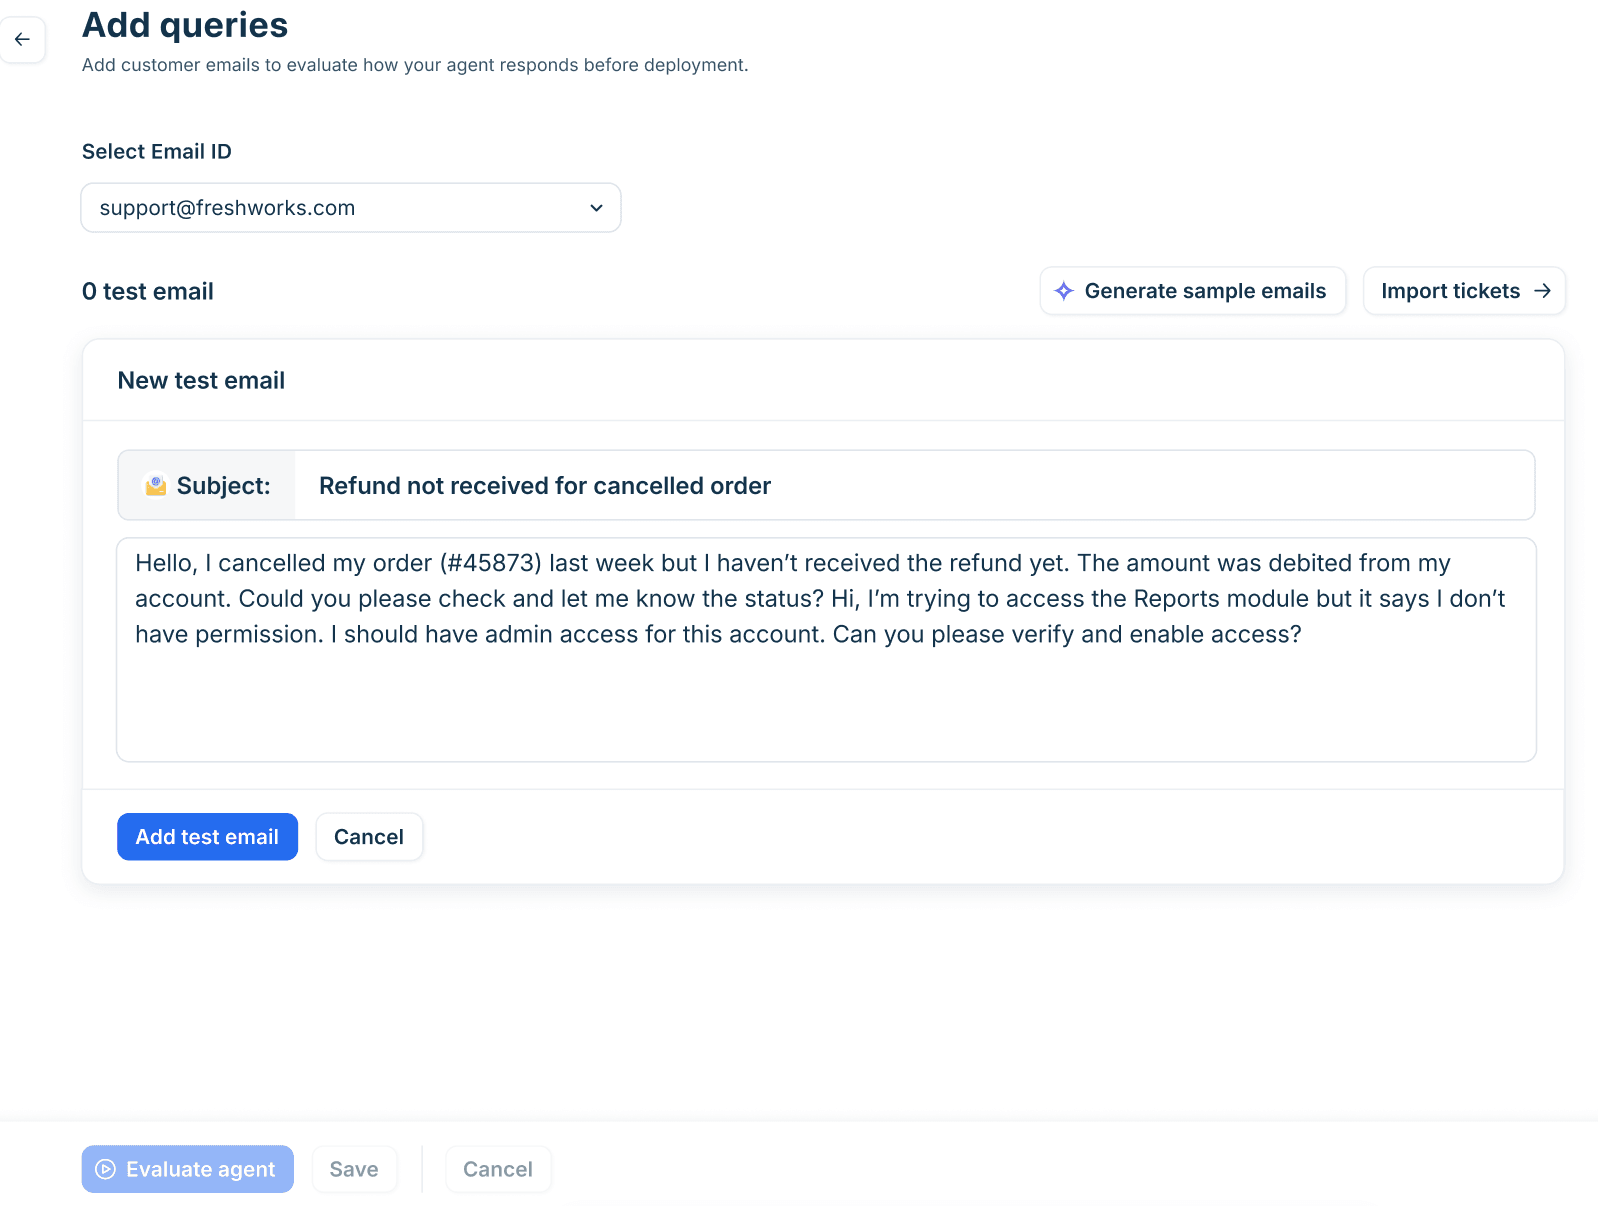
Freshdesk. A etapa Evaluate do agente de e-mail é a coisa integrada mais próxima de uma reprodução real: você pode "Import tickets to use solved historical tickets", até "50 queries per evaluation run" (Freshdesk). A meta do próprio Freshdesk é "at least 20 representative queries before deploying", que, pela tabela acima, eu trataria como um piso. A nota indica se o agente respondeu, não se a resposta bateu com o que seu atendente enviou, então você ainda lê cada uma. Está no Freshdesk Omni Growth, Pro e Enterprise, e há um sandbox se você quiser uma cópia totalmente separada.
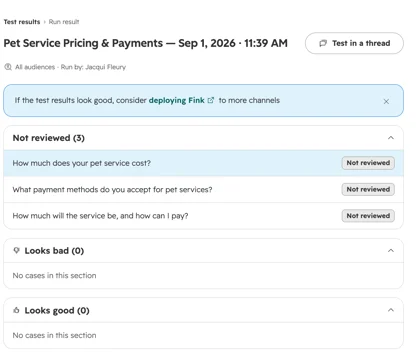
HubSpot. O teste em lote pode "generate them from existing customer conversations", o que significa que escreve perguntas comuns por tema, e um tema precisa de "5 or more conversations on a similar topic" para aparecer. A avaliação é manual, uma resposta por vez, e os conjuntos de teste são salvos para repetições. Os testes não consomem HubSpot Credits.
Gorgias. O Playground pode reexecutar "an existing ticket", que o Gorgias recomenda para "re-simulating a conversation where AI Agent did not initially respond as expected" (Gorgias). É ótimo para conferir uma correção em um ticket, mas não há execução em lote, então você não consegue uma nota sobre 100 tickets. O Gorgias se apoia na revisão ao vivo: o guia de entrada no ar pede que você revise "at least 10 tickets" na primeira semana.
Salesforce e Atlassian. O Agentforce Testing Center tem a pontuação mais detalhada do grupo: verificações de que o tema e a ação certos foram escolhidos, mais um juiz de IA e avaliadores de qualidade opcionais, nas edições Enterprise, Performance, Unlimited e Developer com uma licença adicional de agente (veja os preços do Agentforce). Ele não reproduz casos antigos, porém; você gera testes ou envia um CSV. As avaliações da Atlassian são mais simples: um conjunto de dados de perguntas, cada uma marcada como resolvida ou não, com uma repetição após cada correção.
Se você está no Zendesk, Gorgias ou HubSpot e quer uma reprodução dos seus tickets realmente resolvidos, essa é uma lacuna que você vai preencher fora do helpdesk, seja com uma planilha e muito copiar e colar, seja com uma ferramenta que leia seu histórico de tickets diretamente.
O que uma simulação não consegue dizer?
Uma simulação diz como o agente lida com a primeira mensagem de um ticket cujo formato ele já viu. Ela não consegue dizer por completo quatro coisas:
- Como os clientes insistem. Uma reprodução tem uma mensagem do cliente e uma resposta. Clientes reais respondem "isso está errado", perguntam de novo ou ficam com raiva. Testes roteirizados de várias mensagens ajudam; rascunhos ao vivo ajudam mais.
- O que é novo esta semana. Um lançamento de produto, uma queda ou uma mudança de política geram tickets que seu histórico não tem.
- Como os clientes se sentem. Um comentarista do Hacker News que liderou uma implantação de suporte com IA disse que eles "did our own intensive testing" e mesmo assim descobriram que "our customers just hated it" (victor106). Tom, rapidez e a opção de chegar a uma pessoa importam tanto quanto a precisão.
- Se seus documentos continuam verdadeiros. Uma simulação é uma foto do momento. Se uma página de política mudar no mês que vem, a nota fica velha. Agende uma repetição.
"Shipped a customer service agent for a mid-size e-commerce client last year, manual testing looked clean across every flow we ran. First week in production, users started interrupting mid-response to rephrase their question, agent would drop the original context entirely and answer the new phrasing with confident, wrong information. Support tickets spiked, client was fielding churn risk conversations by day ten. We caught exactly zero of that in manual testing because we were too polite during QA."
É por isso que trato a simulação como a porta de entrada para os rascunhos, não para o piloto automático. O próximo passo são uma ou duas semanas em que o agente redige rascunhos em tickets reais e uma pessoa envia. A Innr está exatamente nessa etapa no Freshdesk: hoje toda resposta é um rascunho, e a equipe está movendo temas escolhidos para respostas autônomas um de cada vez. A SE Ranking está testando respostas diretas por e-mail em tickets de teste escolhidos pelo assunto antes de ampliar. Acompanhe a taxa de resolução e a taxa de reabertura por tema durante esse período (não a deflexão, que conta tickets que nunca chegaram a você), e use-as para decidir o que passa a ser autônomo. Meu artigo sobre o cronograma de implementação mostra quanto tempo essa etapa costuma levar.
Como a eesel roda uma simulação nos seus tickets antigos
Vou ser específico sobre como isso funciona na eesel, já que é a parte do produto sobre a qual vejo mais perguntas.
Você pede no chat. Com um helpdesk conectado, a simulação de helpdesk da eesel "replays your past tickets and scores its answers against what your team actually sent" (documentação da eesel). Sem um, ela escreve casos de teste realistas. A execução redige uma resposta para cada ticket, compara com a resposta da sua equipe, agrupa os resultados por tema e lista correções ordenadas por impacto. Na execução de exemplo da documentação, 17 de 20 tickets resolvidos bateram com a qualidade de resposta da equipe, com um detalhamento por tema abaixo. Trate isso como um exemplo do relatório, não como uma previsão para a sua fila.
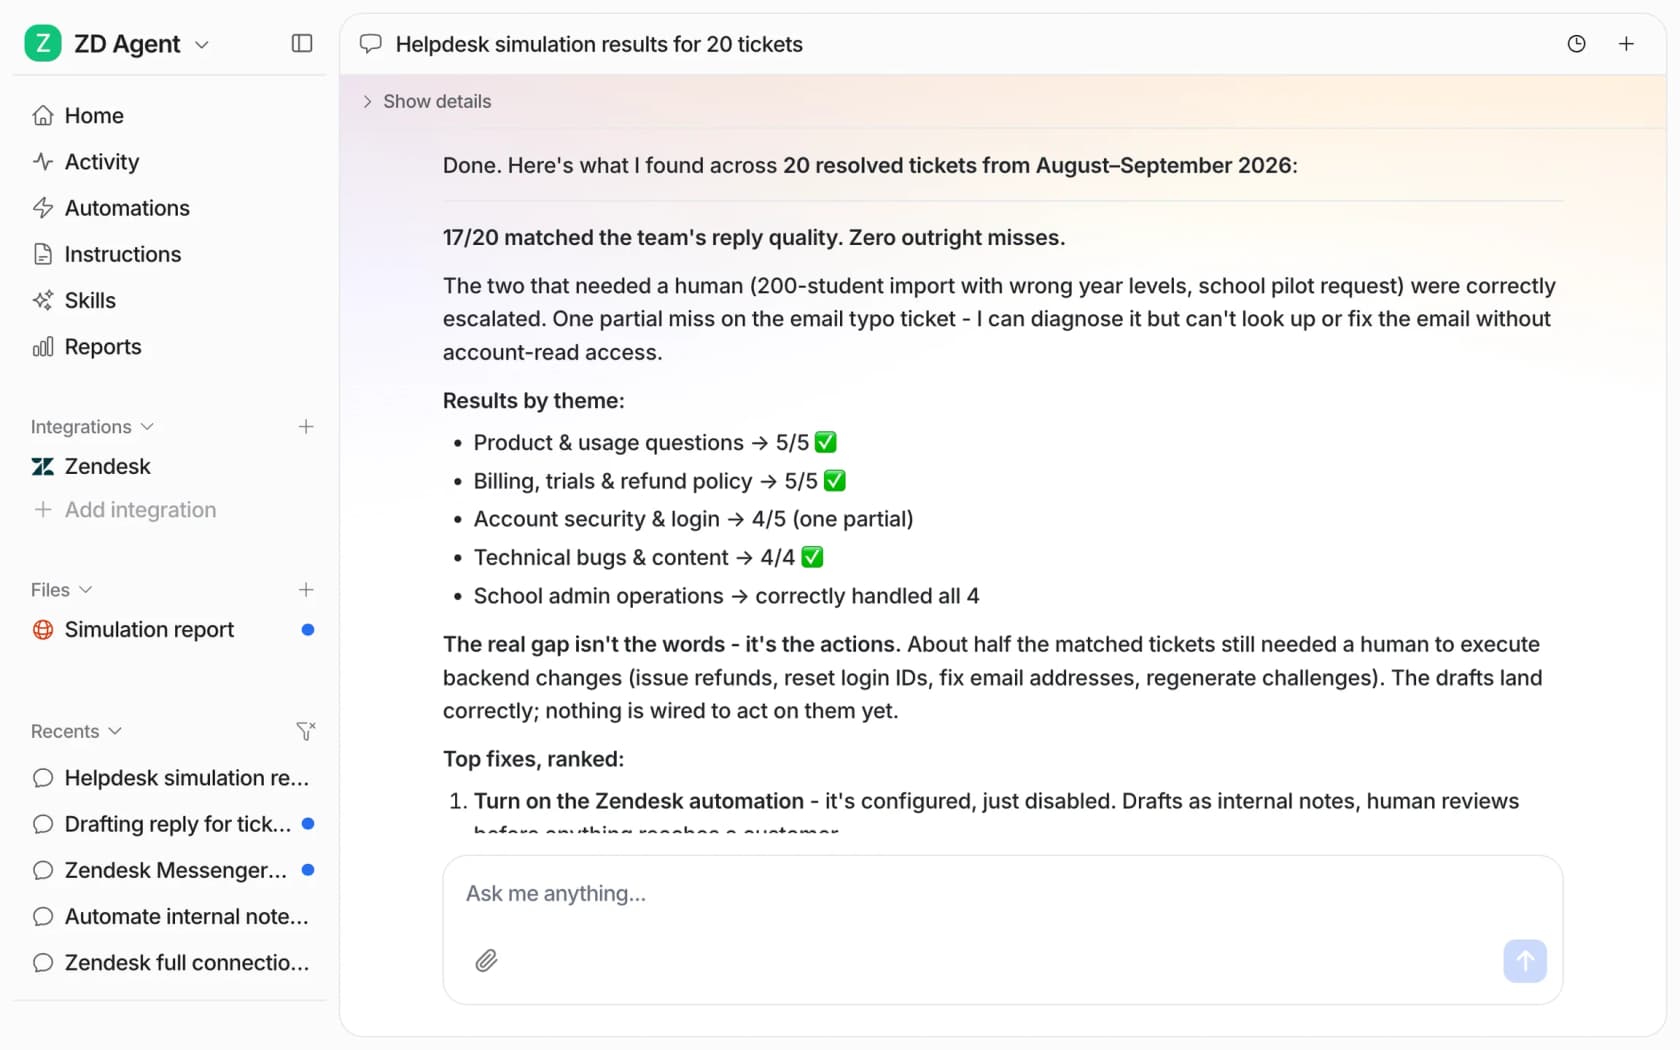
O relatório completo abre ao lado do chat, ticket por ticket: o que o cliente perguntou, o que sua equipe respondeu e como a resposta do agente se comparou. Os dois relatórios de simulação de exemplo na documentação de Skills terminam do mesmo jeito: "It sends nothing to customers". Isso cobre o passo 3.
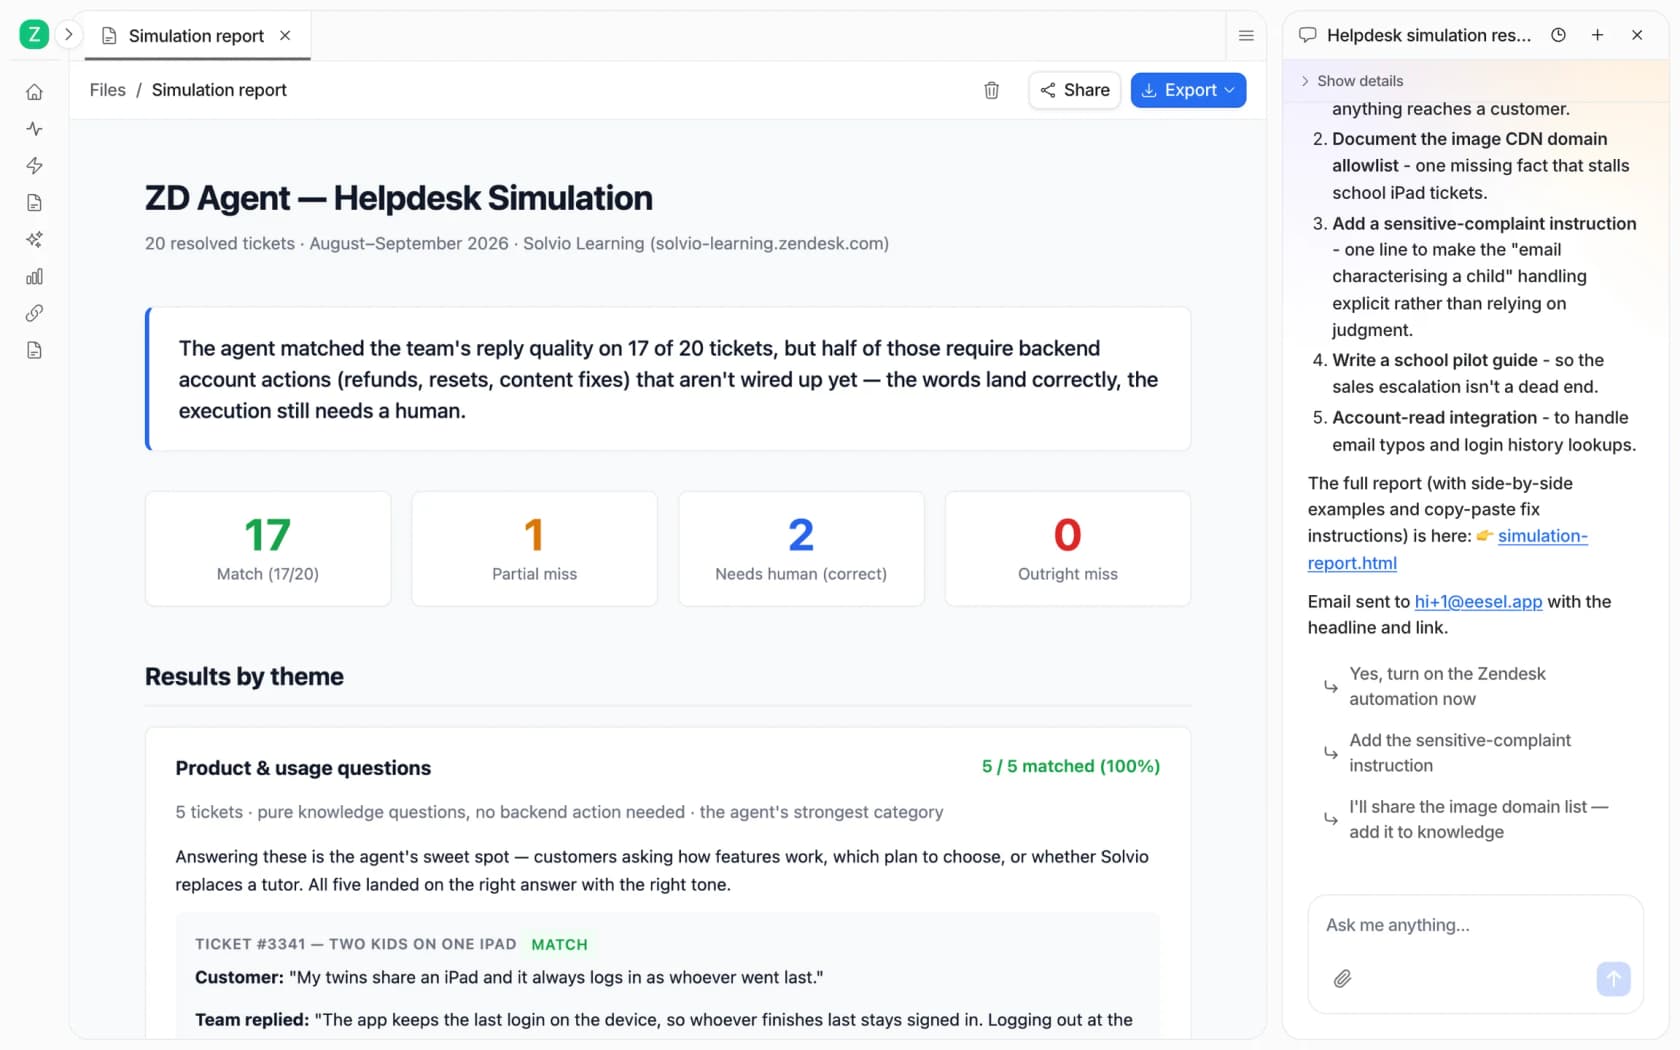
Repare que o relatório não para em "acerto". Ele separa os erros parciais e os tickets que corretamente precisavam de uma pessoa, que é a avaliação em três níveis do passo 4 já embutida. Quando você corrige o agente no chat, ele escreve a correção nas próprias instruções como uma regra em uma frase simples, de modo que a próxima repetição teste a correção. Você também pode anexar a simulação a uma automação para rodar em um agendamento, o que resolve o passo 6 sem que ninguém precise lembrar.
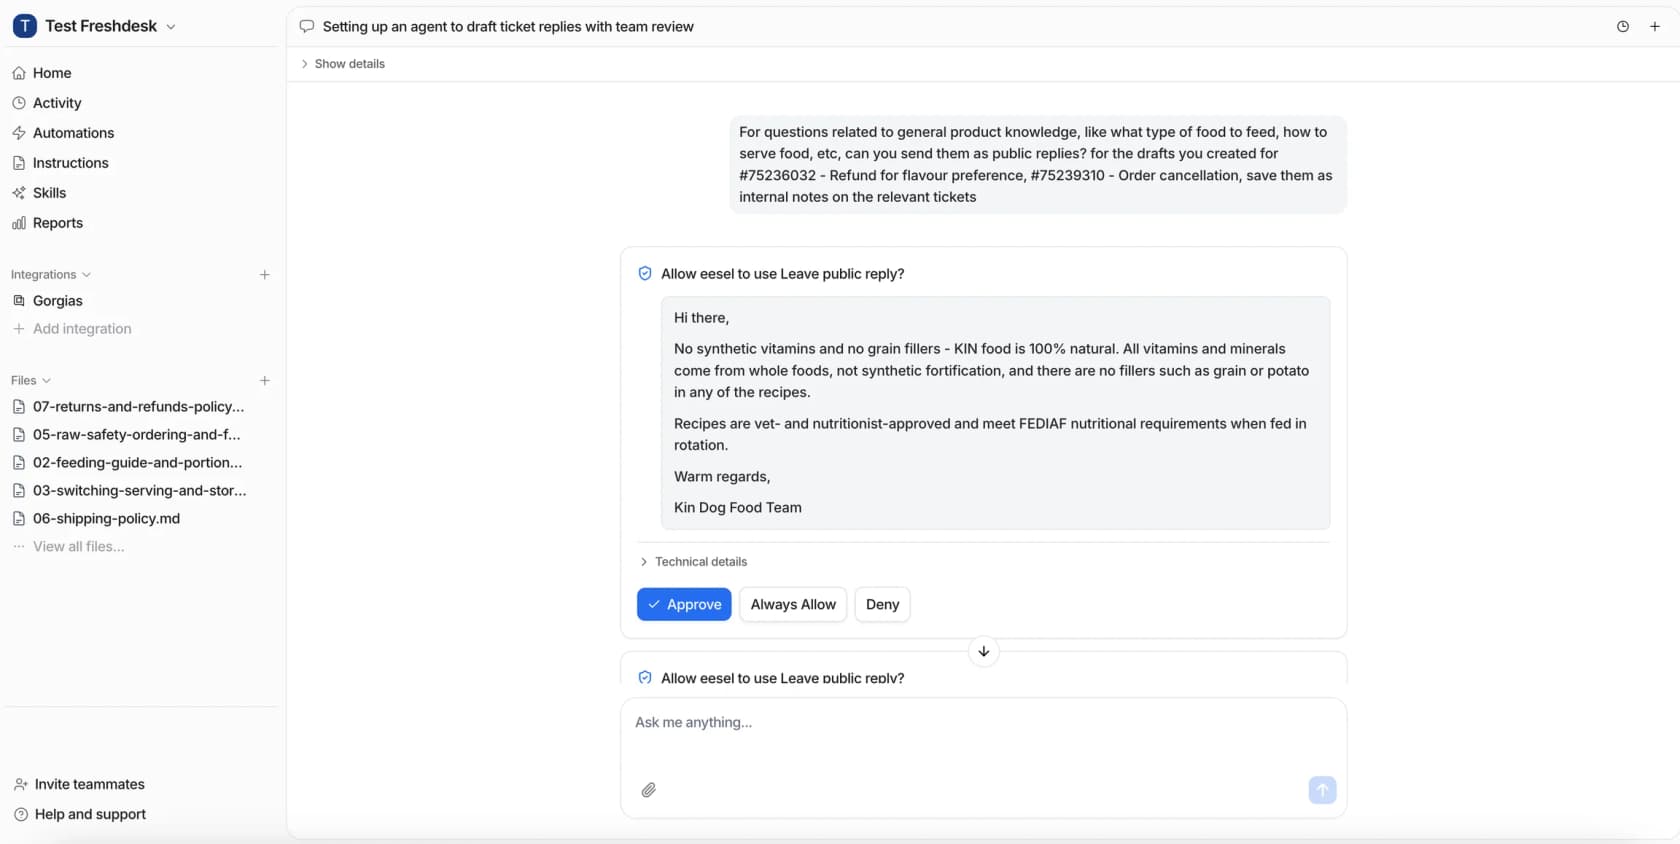
Depois da simulação, toda resposta começa como rascunho ou nota interna, e você move os temas para "responder sozinho" quando estiver pronto. Tudo o que custa dinheiro fica atrás de uma aprovação. Se preferir trabalhar em um terminal, a CLI da eesel permite testar o mesmo agente com eesel chat "what's our refund policy?", ver o que está esperando com eesel approvals e pré-visualizar qualquer escrita com --dry-run antes de ela rodar. Agentes de programação como Claude Code ou Cursor podem acionar esses mesmos comandos.
Onde a eesel não é a escolha certa: se você precisa de simulações de chat de várias mensagens com personas de cliente interpretadas por IA dentro do Zendesk, o simulador próprio dele foi feito para isso. A simulação da eesel trata de como o agente teria respondido ao seu histórico real.
Simule seu agente de IA nos seus próprios tickets com a eesel
Se você está prestes a ligar um agente de IA e quer uma nota da sua própria fila antes, a eesel se conecta ao Zendesk, Freshdesk, Gorgias e HubSpot em poucos minutos, reproduz tickets que sua equipe já resolveu e diz, tema por tema, onde ela está pronta e onde seus documentos têm lacunas, sem enviar nada. A Norden-Frisia fez sua semana de teste com três meses de tickets e macros antigos e assinou em poucos dias. O plano gratuito inclui 100 créditos para experimentar todos os recursos, e os planos pagos começam em US$ 299/mês por 500 créditos.
Experimente a eesel e rode sua primeira simulação ainda esta tarde.