

Resumo
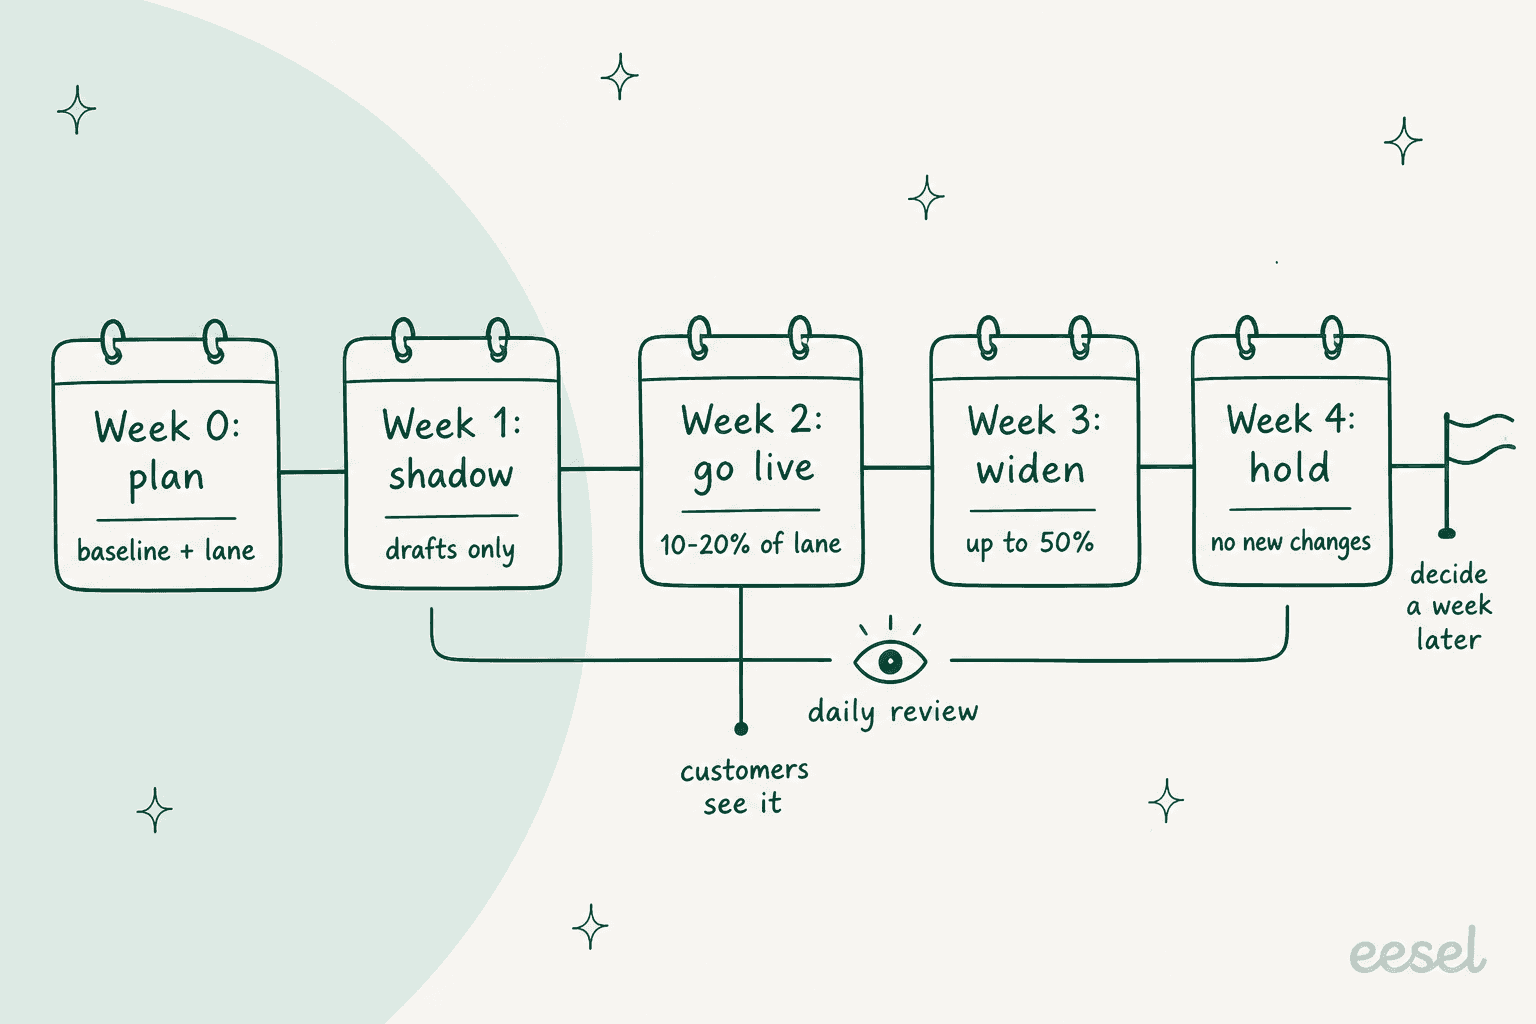
Para fazer um piloto de suporte com IA, dê a ele quatro semanas e uma faixa estreita. A semana 0 é de planejamento: escolha dois ou três tipos de ticket que a IA consiga responder direto dos seus documentos, anote sua linha de base e suas notas de corte, e monte uma fila de IA ao lado de uma fila de controle só humana para os mesmos tickets. A semana 1 é o modo sombra, em que a IA só escreve rascunhos e sua equipe os avalia. Na semana 2 ela responde aos clientes em 10 a 20 % da faixa. Na semana 3 você amplia para cerca de metade. Na semana 4 você não muda nada e deixa os números se estabilizarem, e então decide uma semana depois: expandir, corrigir e testar de novo, ou parar.
A parte que as equipes pulam é a revisão diária. Quinze minutos por dia lendo os tickets de IA de ontem, cada ação que ela tomou e cada conversa reaberta é onde os pilotos são ganhos. Cada erro remonta a uma de quatro causas (uma lacuna de conhecimento, uma instrução, dados ausentes ou roteamento), e cada uma tem uma correção diferente. Reembolsos, cancelamentos e mudanças de conta ficam fora do piloto, ou atrás de uma aprovação humana, até que a faixa só de respostas esteja limpa.
Se você quer um piloto que já funciona assim: a eesel reproduz seus tickets passados para dar uma pontuação antes do primeiro dia, começa como rascunhos dentro de Zendesk, Freshdesk, Gorgias ou HubSpot e registra cada ação para sua revisão diária. A XAP começou com uma única fatia, tickets de encaminhamento redigidos como notas internas, e vai ampliando o filtro a partir daí. O plano gratuito dá 100 créditos para você testar na sua própria fila.
Por que a maioria dos pilotos de suporte com IA dá errado na semana dois
Eu cuido da fila de suporte da eesel, então vejo os pilotos por dentro: as perguntas de configuração na semana um e depois as mensagens de "isso é normal?" na semana dois. Os pilotos que travam raramente travam porque a IA é ruim. Na maioria das vezes é porque ninguém é responsável pela leitura diária do que a IA fez, porque o escopo cresce antes de a primeira faixa estar limpa, e então três mudanças entram na mesma tarde e ninguém sabe qual quebrou as respostas de devoluções.
Aqui vai um caso real. Uma equipe dinamarquesa de telemática veicular na Zendesk descobriu que seu bot dizia aos clientes "sim, damos suporte ao modelo do seu carro" para marcas que não estavam no banco de dados. O modelo não inventava do nada. Um artigo de ajuda dizia que o produto dava suporte a todos os modelos, e a IA acreditou. O resumo da própria equipe sobre a configuração foi "trial and error in the beginning", o que é honesto e é exatamente o trabalho de um piloto: encontrar as frases da sua base de conhecimento que estão erradas de um jeito que um agente humano contorna em silêncio.
Por isso eu planejaria um piloto como um projeto de operações, não como um teste de software. O padrão que funciona, na maioria das equipes com quem converso, é o que todo mundo pede de qualquer forma: começar com a IA redigindo respostas para os agentes e deixá-la responder sozinha aos clientes quando os rascunhos estiverem certos.
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."

Este artigo é um roteiro para essas quatro semanas. Se você quer a parte de medição (o que entra na scorecard e como pontuar), ela está na scorecard do piloto de suporte com IA. Para a sequência de testes pré-lançamento com mais profundidade, veja testes de agente de suporte com IA.
O que preparar antes da semana um
A semana 0 são algumas horas de trabalho espalhadas por alguns dias, e é ela que decide se o resto do piloto poderá ser lido. Cinco coisas precisam ser verdade antes de a IA ver um único ticket real.
- Um responsável, com nome. A pessoa que faz a revisão diária, aprova mudanças e pode mandar pausar. Em equipes pequenas costuma ser o líder de suporte. Não deve ser a mesma pessoa que montou a configuração, pelo mesmo motivo que o próprio guia de testes da Zendesk diz para "select testers who aren't the same people who built your conversation flows".
- Uma linha de base. Os números do último trimestre para os tipos de ticket no escopo: volume semanal, tempo de primeira resposta, taxa de reabertura ou recontato e também quanto custa um ticket tratado por uma pessoa. O guia de KPIs de atendimento ao cliente explica como levantá-los.
- Notas de corte, por escrito. O que precisa ser verdade no fim para você expandir. Eu copiaria os limites e as metas da scorecard do piloto em vez de inventar outros, e os enviaria ao fornecedor antes do primeiro dia.
- Um plano de roteamento. Quais tickets vão para a fila de IA, quais tickets idênticos ficam em uma fila de controle só humana e como você vai etiquetar as duas para poder separá-las depois. Mais sobre isso abaixo.
- Um plano de pausa. Quem pode desligar a IA, onde fica o interruptor no seu helpdesk e o que conta como motivo para usá-lo.
Depois conte à sua equipe de suporte o que está acontecendo e qual é o papel dela. Agentes que descobrem o piloto por uma reclamação de cliente vão tratar a IA como ameaça por meses. Agentes que ouvem "vocês são os revisores, e a IA vai ficar com a pilha de status de pedido" viram sua melhor fonte de relatos de falhas. Um SOP de suporte para o piloto (quem revisa, quando, onde sinalizar uma resposta ruim) leva dez minutos para escrever e poupa muitas conversas no Slack.
| Papel no piloto | Quem | Tempo que leva |
|---|---|---|
| Responsável pelo piloto | Líder de suporte ou agente sênior que não montou a configuração | 15 a 20 minutos por dia, mais um relatório semanal |
| Revisores | 2 ou 3 agentes, de preferência incluindo um mais novo | 10 minutos por dia cada um na semana 1, menos depois |
| Corretor de conhecimento | Quem cuida da sua central de ajuda | Algumas correções por semana, principalmente nas semanas 1 e 2 |
| Contato de escalonamento | Alguém com autoridade sobre reembolsos e contas | Só quando uma transferência exige uma decisão |
Como escolher os tickets para um piloto de suporte com IA
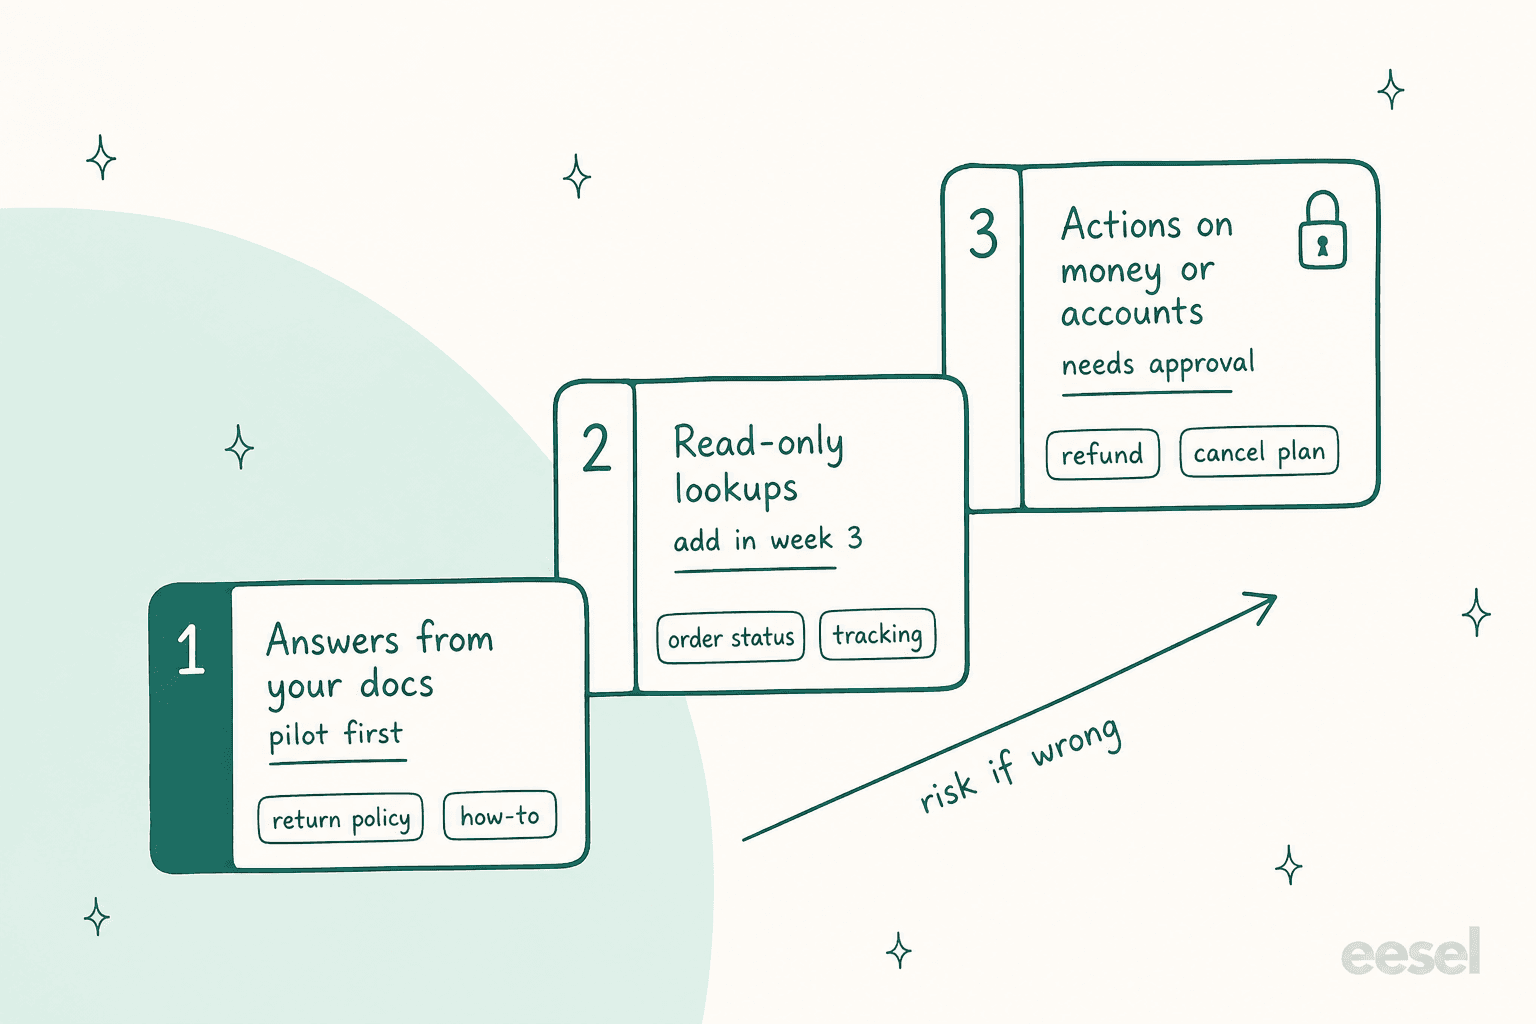
A maioria das equipes ordena os candidatos do piloto por assunto. Eu prefiro ordená-los pelo que a IA precisa fazer para fechar o ticket, porque é aí que está o risco. Há três tipos:
- Respostas dos seus documentos. Política de devolução, prazos de entrega, perguntas de como fazer. Se a IA errar, o cliente recebe uma frase errada, e a correção costuma ser só um artigo.
- Consultas somente de leitura. Status do pedido, rastreamento, detalhes do plano. A IA lê um sistema e relata o que encontrou. Errar aqui significa ler o pedido ou o status errado, o que é pior, mas ainda não muda nada.
- Ações sobre dinheiro ou contas. Reembolsos, cancelamentos, mudanças de endereço, edições de conta. Errar aqui significa que algo já aconteceu e agora você precisa desfazer.
O piloto começa pelo primeiro tipo e adiciona o segundo na semana 3 se a revisão diária estiver limpa; o terceiro espera até depois do piloto, atrás de uma aprovação. Essa divisão também combina com a forma como os fornecedores montam seus próprios testes: a Gorgias, por exemplo, mantém as ações desligadas por padrão nas conversas de teste porque, se ativadas, elas "can affect real customer and order data (like cancelling an order)".
Há mais dois filtros antes de um tipo de ticket entrar. Seus documentos já precisam respondê-lo (se não, isso é trabalho para uma análise de lacunas de conhecimento na semana 0, não um achado do piloto). E ele precisa de volume, porque uma faixa de 15 tickets por semana não vai dizer quase nada em um mês. As perguntas de status do pedido são a favorita de sempre por esse motivo: volume alto, uma consulta e baixo risco.
Decisões de julgamento (reclamações, estornos, clientes irritados) ficam com pessoas durante todo o piloto. Um profissional colocou bem a régua:
"Splitting it by impact makes more sense to me. A slightly awkward response is one thing but anything involving pricing, refunds or account changes should have a much higher bar."
Estreito é ótimo. A XAP, que desenvolve software de preparação para faculdade e carreira, começou sua configuração da eesel no Freshdesk com uma única fatia: tickets em que um aluno pergunta sobre algo que a faculdade ou um órgão estadual resolve, o que exige um encaminhamento educado e correto. Um filtro deixa passar só esses casos (mais redefinições de senha do portal), então a eesel redige a resposta completa como nota interna a partir da resposta pronta da equipe e uma pessoa a envia. Na história deles, o agente de encaminhamento é chamado de "the first slice", e o filtro está sendo ampliado à medida que a equipe adiciona casos de encaminhamento para seus outros portais. Essa é uma faixa de piloto bem feita: pequena, respondível e fácil de conferir.
Insira sua própria mistura de tickets para ver em qual faixa cada tipo cai e se a faixa tem volume suficiente para julgar até o fim da semana 4.
Se a faixa ficar curta, adicione outro tipo de ticket de resposta antes de esticar o calendário. Um piloto mais longo em uma faixa fina geralmente só dá mais tempo para o escopo crescer.
Como separar uma fila de IA e uma fila de controle no seu helpdesk
Você quer os mesmos tipos de ticket, no mesmo canal, tratados de duas formas nas mesmas semanas: alguns pela IA, alguns só por pessoas. O artigo da scorecard explica por que a fila de controle só humana importa para os números. Aqui está onde ficam os controles em cada helpdesk, conferidos na central de ajuda de cada fornecedor em 20 de outubro de 2026.
| Helpdesk | Delimitar a faixa de IA com | Manter uma fila de controle por | Pausar por |
|---|---|---|---|
| Zendesk | Canais por agente de IA; condições de gatilho de um agente de e-mail | Um trafficSplit aleatório com grupo de controle, ativado pelo seu account manager (teste A/B), ou um endereço de suporte separado | Desmarcar o canal em Manage channels |
| Freshdesk | Origens do ticket, "Deploy to internal teams" ou regras personalizadas com até cinco níveis de AND/OR | Uma regra personalizada que deixe parte da faixa de fora (uma caixa de entrada, um atributo do cliente) | Um limite em Daily conversation limits, ou desativar o agente naquela origem |
| HubSpot | Um canal por implantação, horário de trabalho, listas de inclusão e exclusão no e-mail | A porcentagem de Conversation coverage (o resto vai para pessoas) | Desligar a atribuição do customer agent |
| Gorgias | AI Agent > Deploy por canal, uma skill por vez | Deixar um canal ou uma skill desligado para a faixa e comparar | Desligar uma skill "without affecting others" |
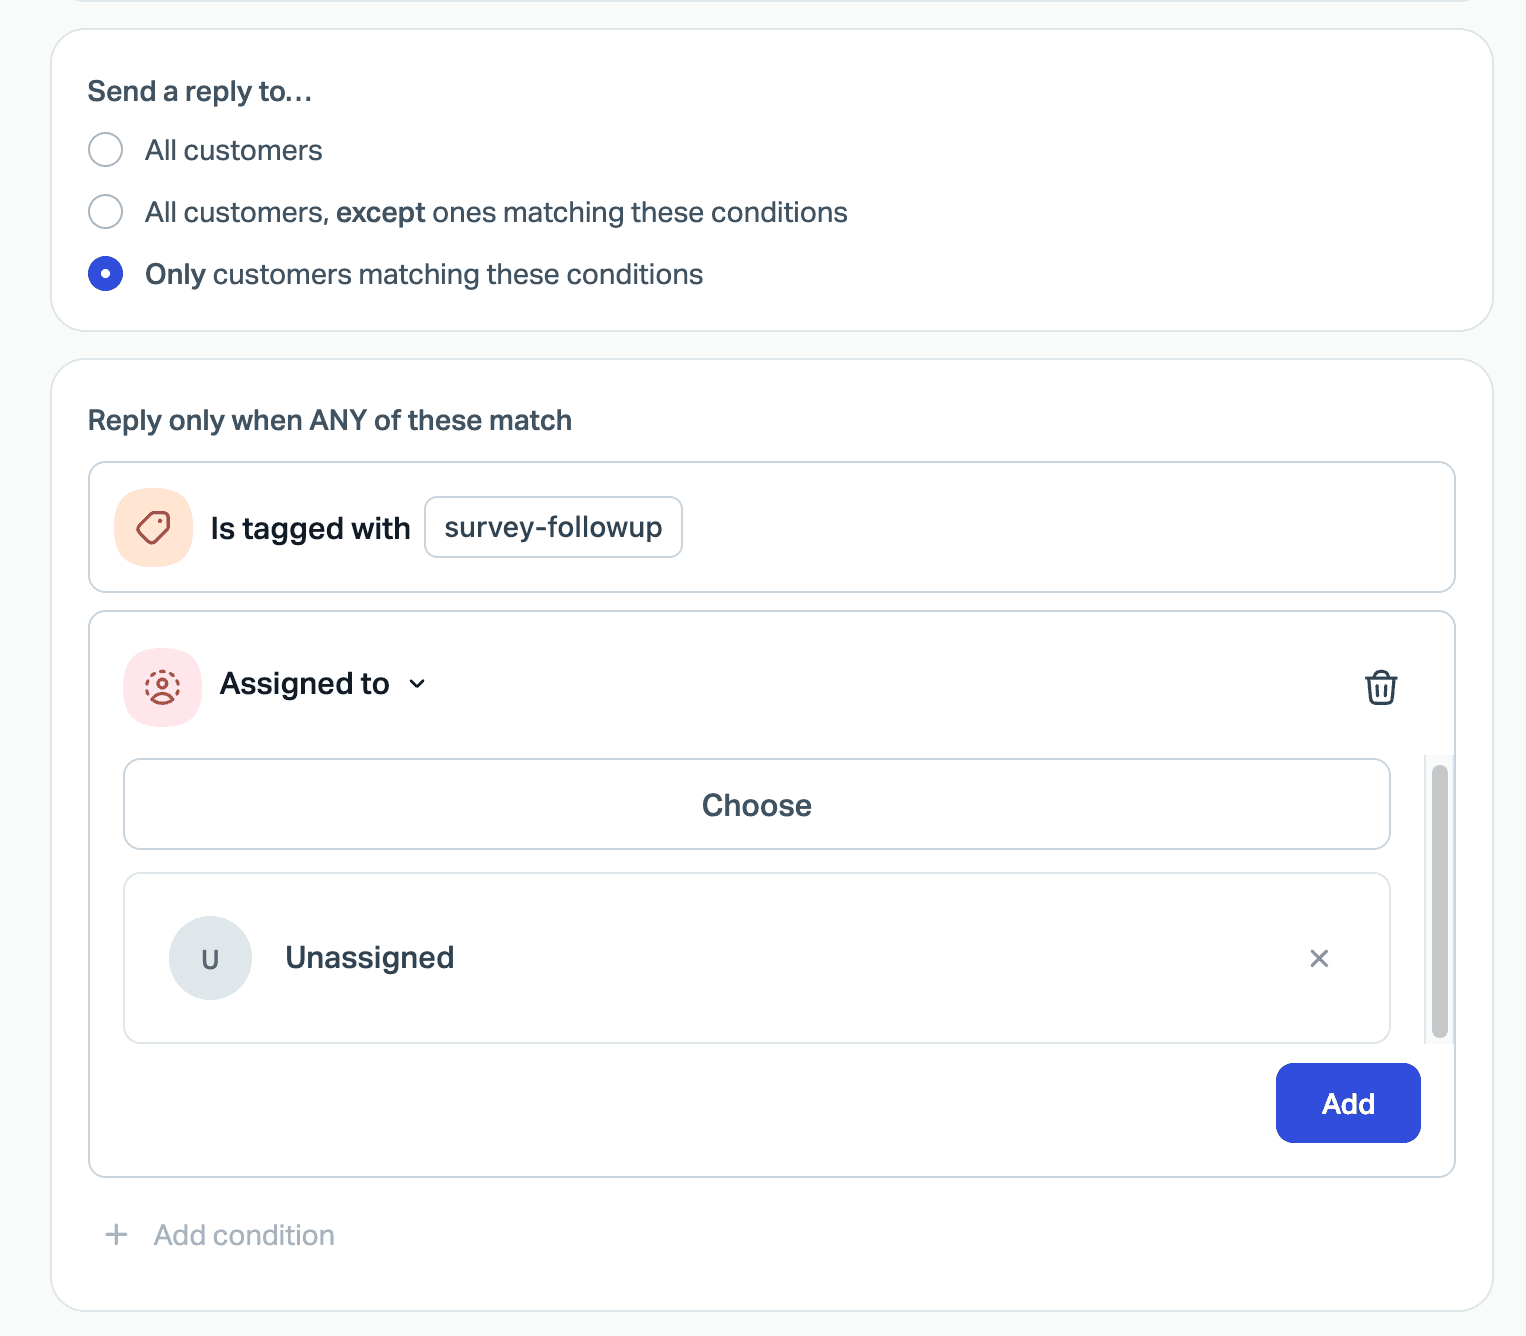
| Help Scout | Por Beacon e por caixa; o e-mail pode ser limitado a "Only customers matching these conditions" | O escopo "except ones matching these conditions" na mesma caixa | O botão Enable por Beacon ou caixa |
Alguns detalhes dessas páginas que fazem diferença em como você configura:
- A Zendesk só permite um agente de IA por vez em cada canal, e um agente criado para mensagens não pode ser trocado depois para e-mail. Decida o canal primeiro, antes de construir.
- A entrada no ar do Freshdesk só vale daqui para frente. Tickets que chegaram antes da implantação "are not retroactively answered", o que significa que o dia um do piloto começa limpo.
- O próprio conselho da HubSpot combina com a rampa daqui: comece com "a single channel or limit it to a small percentage of conversations", depois revise escalonamentos e lacunas de conhecimento antes de expandir. Quando pausado, "it keeps existing chats but won't get new ones".
- A Gorgias oferece visualizações de caixa para os tickets que a IA está tratando, os que ela fechou e os que ela transferiu, o que basicamente já é sua fila de revisão diária pronta.
O construtor de condições do Help Scout é um bom exemplo de como uma faixa pode ser específica: a IA só responde a tickets que combinam com uma etiqueta ou uma regra de atribuição.
Seja qual for o helpdesk, etiquete as duas filas desde o primeiro dia (ai_pilot e ai_control funcionam bem). O guia de etiquetagem de suporte com IA tem mais sobre nomenclatura. Na semana 4 você vai querer jogar os dois conjuntos em uma planilha sem depender do relatório do fornecedor.
Semana 1: modo sombra antes de qualquer cliente ver
Modo sombra significa que a IA trabalha em tickets reais que chegam na sua faixa, mas tudo o que ela escreve é um rascunho ou uma nota interna. Uma pessoa lê e avalia, e então envia, edita ou ignora. Os clientes não veem diferença. Não há risco para o cliente, e é onde aparece a maioria dos problemas corrigíveis.
Antes de a semana sombra começar, eu rodaria a IA nos seus tickets passados para você entrar com uma pontuação em vez de um palpite. A maioria dos helpdesks hoje tem alguma forma de fazer isso sem pagar:
- A avaliação do AI Agent de e-mail do Freshdesk pode Import tickets "to use solved historical tickets", até 50 consultas por execução, e a Freshworks recomenda "at least 20 representative queries before deploying". A prévia "does not affect live conversations or consume message limits".
- Os testes em lote da HubSpot montam perguntas de teste a partir de temas das suas conversas reais, e visualizar ou testar não consome HubSpot Credits.
- As conversas de teste da Gorgias "are free to use" e podem reproduzir "an existing ticket", uma por vez.
- O sandbox, o widget de teste e o simulador de conversas da Zendesk não consomem resoluções automatizadas, mas um agente de e-mail testado em produção consome. O guia de configuração de sandbox no Freshdesk cobre o equivalente nesse lado.
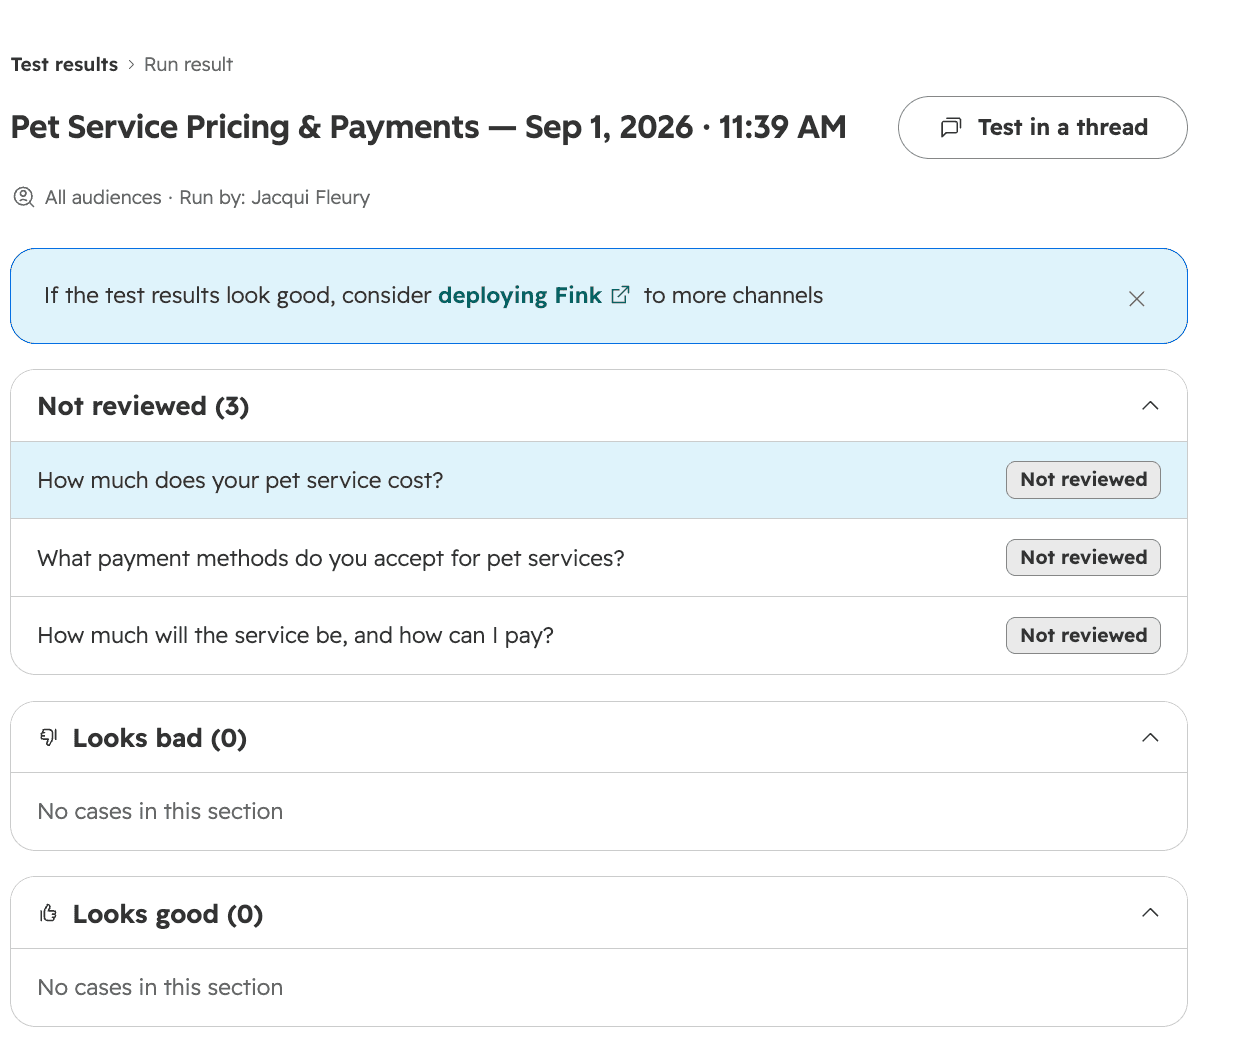
Durante a própria semana sombra, peça aos revisores que avaliem cada rascunho de uma de três formas: enviar como está, enviar com edições ou errado. Guarde uma nota curta em cada "errado". Na sexta você terá uma lista, e essa lista é seu plano de correção da semana 2. Misture também alguns tickets deliberadamente chatos, do tipo insistente "você está errado, me reembolse"; o guia de testes adversariais tem um conjunto para emprestar.
Espere muitos "enviar com edições" no começo, e não entre em pânico. No teste de uma joalheria na eesel, a maioria das edições que os agentes fizeram nos rascunhos era sobre tamanho e tom, o tipo de coisa que melhora quando a IA aprende com as respostas enviadas pela própria equipe. As edições que corrigiam um erro de fato eram só uma parte pequena. É um achado muito diferente de "a IA está errada", e você só o vê se os revisores disserem por que editaram.
O teste de saída da semana 1 é simples: a pilha de "errado" é pequena, e cada item tem uma correção que você fez ou um motivo para o tipo de ticket sair da faixa.
Semanas 2 e 3: entrar no ar com uma fatia e depois ampliar
Na semana 2 a IA começa a responder aos clientes, mas só em uma parte da faixa. Eu começaria com 10 a 20 %. O campo de cobertura da HubSpot faz isso diretamente; em outros helpdesks, uma regra sobre um atributo do cliente ou uma caixa de entrada resolve. O resto da faixa fica com pessoas, o que serve também de fila de controle.
Três regras para essas duas semanas:
- Amplie só depois de um trecho limpo. Se a revisão diária esteve limpa por três ou quatro dias úteis, passe de cerca de 20 % para cerca de metade na semana 3. Se não esteve, fique onde está e corrija primeiro.
- Mude uma coisa por vez e anote a data. Uma faixa ampliada e uma instrução nova no mesmo dia significam que você não sabe qual mexeu nos números. A Swiftreg, que vende placas de carro personalizadas no Reino Unido, mantém suas instruções de suporte na eesel como versões numeradas, implantadas por um procedimento próprio em vez de editadas ao vivo. É mais processo do que a maioria dos pilotos precisa, mas o hábito (toda mudança tem versão e data) é o certo.
- Adicione consultas somente de leitura antes das ações. Se a semana 2 foi limpa em tickets só de resposta, a semana 3 é quando status do pedido e rastreamento podem entrar. As ações continuam desligadas.
Deixe o caminho "falar com uma pessoa" óbvio desde o primeiro dia no ar. Clientes que ficam presos e não encontram um humano não aparecem como falhas na maioria dos painéis; aparecem como conversas abandonadas ou tickets irritados em outro canal. A lista de transferência de agente de IA cobre o que uma transferência deve levar para que seu agente não precise perguntar tudo de novo.
Quanto à transparência, eu diria aos clientes que estão falando com uma IA. A Swiftreg encerra cada resposta pública da IA com um rodapé dizendo que o AI Support Assistant a escreveu e que ela pode conter erros, e o chat ao vivo da HubSpot mostra "Powered by AI" no cabeçalho enquanto o customer agent está atribuído. Isso alinha as expectativas e também torna uma resposta errada mais fácil de perdoar.
A revisão de QA diária que decide seu piloto
Este é o hábito que separa pilotos que terminam em uma decisão clara de pilotos que terminam em discussão. Quinze minutos, no mesmo horário todo dia, da semana sombra até o fim da semana 4.
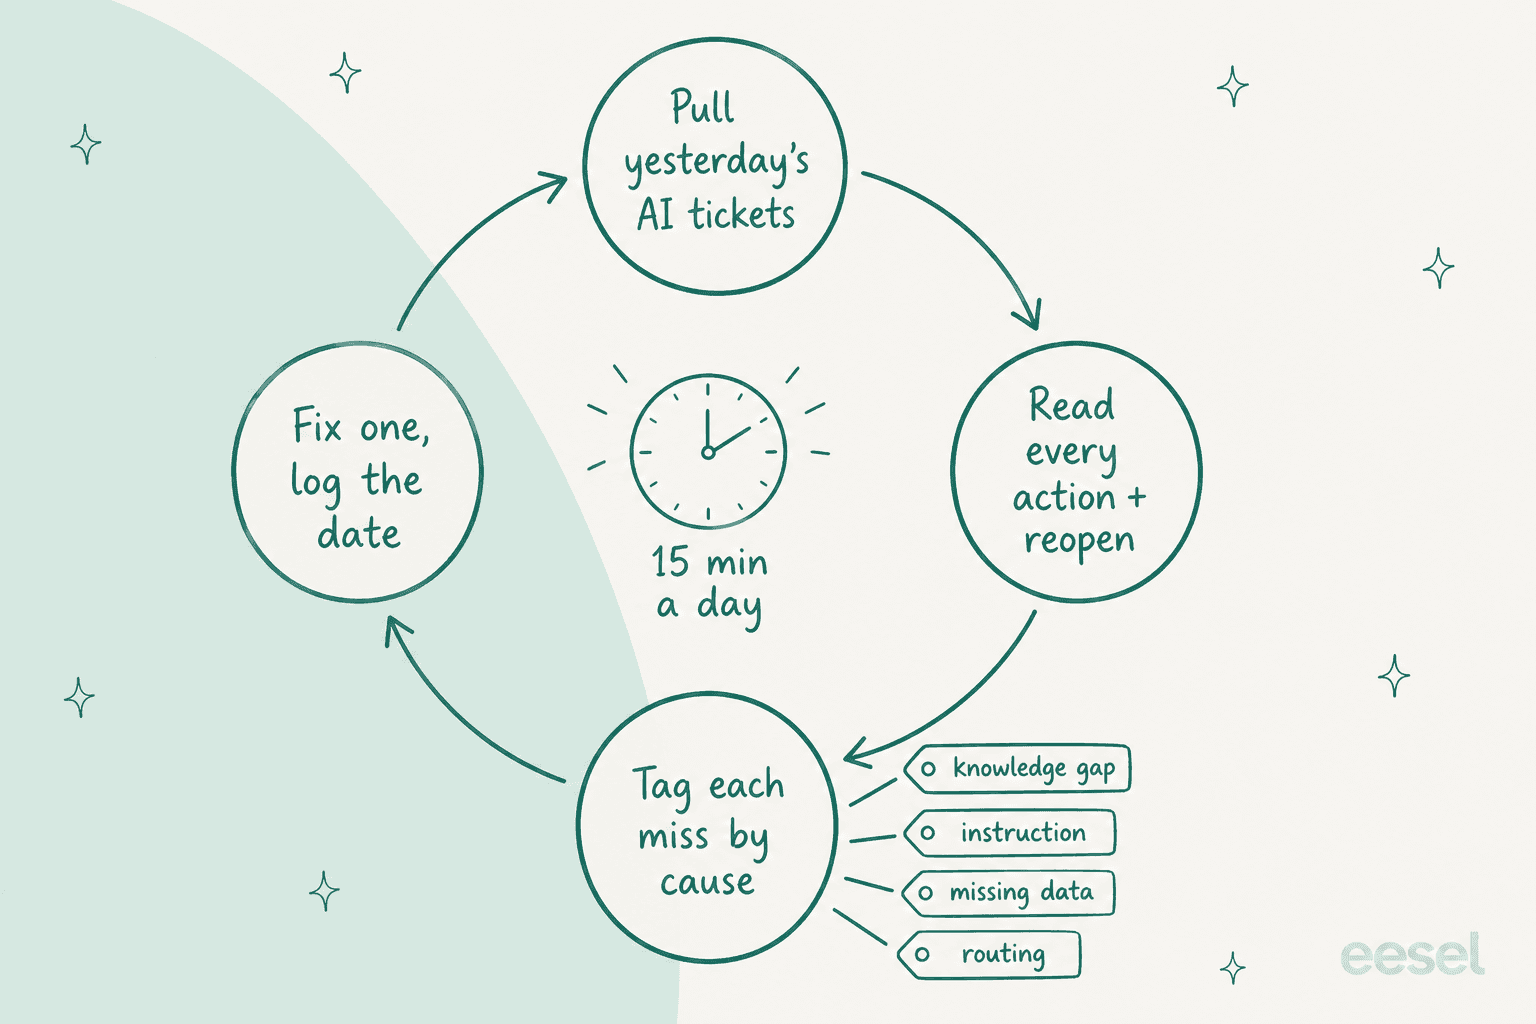
O que entra nos quinze minutos:
- Toda ação que a IA tomou, se alguma estiver ligada. Leia o registro, não só a resposta. Uma resposta pode soar perfeita e ainda assim estar baseada no número de pedido errado.
- Toda conversa reaberta ou de recontato da fila de IA. São os erros que o painel conta como acertos.
- Toda transferência. A pessoa recebeu o suficiente para continuar sem perguntar de novo?
- Uma amostra da pilha de "resolvidos", de 10 a 20 por dia. A Gorgias sugere revisar "at least 10 tickets that AI Agent handled" na primeira semana como parte da entrada no ar; eu manteria esse ritmo durante todo o piloto.
Depois etiquete cada erro pela causa, porque cada causa tem uma correção diferente e também um responsável diferente:
| Causa do erro | Como aparece | A correção | Quem corrige |
|---|---|---|---|
| Lacuna de conhecimento | Respondeu a partir de um artigo desatualizado ou ausente ("we support all models") | Editar ou adicionar o artigo; testar o tema de novo | Responsável pela central de ajuda (auditoria da base de conhecimento) |
| Instrução | Fatos certos, comportamento errado: longo demais, tom errado, não transferiu | Adicionar ou apertar uma regra | Responsável pelo piloto |
| Dados ausentes | Precisava de um pedido, uma conta ou um sistema que não consegue ver | Conectar a fonte, ou tirar o tipo de ticket da faixa | Quem cuida da integração |
| Roteamento | Um ticket que não deveria estar na faixa chegou lá | Apertar o filtro ou o gatilho | Administrador do helpdesk |
Mantenha um registro de mudanças compartilhado com três colunas: a data e o que mudou, e depois por que mudou. O guia de testes da Zendesk sugere o mesmo para os testadores, um arquivo compartilhado para "track whether a resolution has been implemented". Quando um número se mexe na semana 3, o registro diz se foi o artigo que você corrigiu na terça ou a faixa que você ampliou na quarta. Se dois revisores discordam sobre uma resposta ser "errada", uma sessão rápida de calibração de QA acerta o critério antes de a discordância virar ruído nos seus resultados.
O responsável por essa revisão não precisa ser técnico. Na Norden-Frisia, uma linha de balsas alemã para as ilhas do Mar do Norte, a líder de suporte Frauke Hagen toca sozinha a configuração da eesel: ela confere o histórico de conversas e pergunta quando uma resposta contradiz as FAQs, e copia as correções do bot da Zendesk para o chatbot por conta própria. O teste deles durou só uma semana, e o treinamento com tickets passados foi o que decidiu a assinatura.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Quando pausar um piloto de suporte com IA no meio do caminho
Escreva as regras de pausa na semana 0 para que ninguém precise discuti-las em uma terça ruim. Eu pausaria a fila de IA no mesmo dia se qualquer uma destas coisas acontecer:
- Uma ação errada chegou a um cliente: um reembolso no pedido errado, uma mudança na conta errada.
- A IA afirmou uma política que não existe, ou prometeu algo que sua equipe não pode cumprir.
- A parcela de clientes pedindo uma pessoa dispara em comparação com os dias anteriores.
- Uma política mudou e o conhecimento não acompanhou. Um novo prazo de devolução, novos preços ou uma queda. Pause até os artigos serem atualizados e então teste o tema de novo. O guia de gestão de mudanças de política tem uma checklist.
Pausar é barato se você sabe onde fica o interruptor. Na Zendesk isso se faz desmarcando o canal; não há um botão de pausa separado.
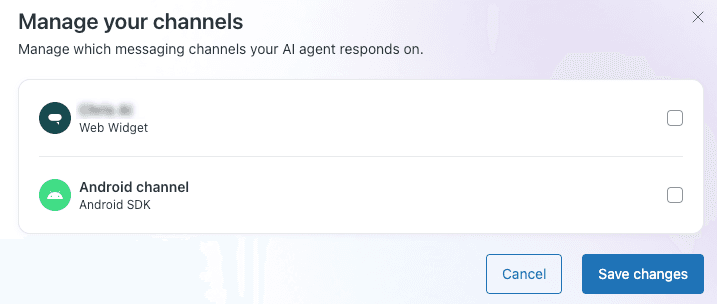
A HubSpot permite "manually pause customer agent assignment by turning it off", o que sugere "when updating or reviewing content sources or making changes to the agent's configuration". O limite diário do Freshdesk é o freio mais suave: "Conversations continue to arrive but the AI stops replying once the limit is reached". Qualquer que seja o que você use, uma pausa não significa um piloto fracassado. Registre-a com data e motivo, faça uma breve análise de erros sobre a causa e reinicie o relógio daquela faixa depois de corrigida.
Semana 4 e depois: expandir, testar de novo ou parar
A semana 4 é uma semana de manutenção. Sem novos tipos de ticket nem mudanças de cobertura, nem instruções novas, a menos que algo esteja quebrado de verdade. Você deixa as últimas mudanças se estabilizarem para que a última semana reflita uma configuração estável. Depois marque a reunião de decisão para uma semana após o fim do piloto, porque as janelas de resolução dos fornecedores e sua própria checagem de recontato precisam de algum tempo para terminar de contar (a scorecard explica o calendário).
A decisão em si é uma de três, e cada uma significa algo concreto para o mês seguinte:
| Decisão | Quando | O que fazer depois |
|---|---|---|
| Expandir | Limites mantidos e metas atingidas na faixa | Suba um degrau: adicione o próximo tipo de ticket de resposta, ou consultas somente de leitura, ou mais um canal. Um por vez, com a mesma revisão diária |
| Corrigir e testar de novo | Seguro, mas abaixo da meta | Trabalhe as principais causas do seu registro de mudanças, rode de novo a reprodução de tickets passados, depois mais duas semanas na mesma faixa |
| Parar | Um limite falhou, ou os clientes voltaram mais do que na fila de controle | Guarde os artigos limpos e as etiquetas dos tickets, anote o motivo e decida se outra ferramenta ou uma faixa mais estreita vale um segundo piloto |
"Expandir" é onde a maioria das equipes quer pular direto para reembolsos. Eu seguraria as ações por mais um ciclo e as passaria primeiro por fluxos de aprovação: a IA prepara o reembolso e uma pessoa aprova, e você conta com que frequência a pessoa discorda. Quando esse número ficar perto de zero por algumas semanas, ações de rotina podem rodar sozinhas. Reembolsos grandes, estornos e tudo acima dos limites da sua matriz de aprovação de reembolsos ficam com pessoas.
Erros que vejo quando as equipes fazem um piloto de IA
- Sem um responsável com nome. A revisão diária vira "quem tiver tempo", que é ninguém na quinta.
- Pilotar os tickets mais difíceis para "testar de verdade". Você vai aprender que tickets difíceis são difíceis. Comece onde a IA pode ganhar e amplie a partir daí.
- Todos os canais de uma vez. Uma semana ruim em chat e e-mail juntos não pode ser atribuída a nenhum dos dois.
- Mudar três coisas no mesmo dia. Você não sabe qual ajudou, nem qual quebrou as devoluções.
- Pular a fila de controle porque o antes e depois parece óbvio. A mistura de tickets e a sazonalidade também mudam.
- Ler o painel do fornecedor em vez dos tickets. O painel diz quantas conversas terminaram, não se estavam certas. A lista mais longa está em erros de implantação de IA no atendimento ao cliente.
Faça seu piloto de suporte com IA com a eesel
A eesel é uma colega de IA para helpdesk que entra na sua fila atual no Zendesk, Freshdesk, Gorgias, HubSpot e outros, e foi feita para ser pilotada do jeito que este artigo descreve:
- Pontuação da semana 0 a partir do seu próprio histórico. A skill Simulation roda seu agente contra tickets passados reais e pontua cada resposta em relação ao que sua equipe enviou, depois sugere mudanças de instruções. Ela não envia nada aos clientes.
- Modo sombra por padrão. Ela começa com rascunhos: cada resposta é um rascunho ou uma nota interna para uma pessoa enviar. Você a deixa responder os casos fáceis de ponta a ponta quando estiver pronto, e pode desligar qualquer coisa a qualquer momento.
- Ações atrás de aprovação. Cada ação é Auto, Needs approval ou Disabled, e as aprovações nunca rodam sozinhas depois de um tempo limite. Os reembolsos podem ficar em Needs approval durante todo o piloto.
- Uma revisão diária já montada. A página Activity lista cada ticket tratado, o que foi pesquisado, cada ação e quem a aprovou, também com o raciocínio. Quando você a corrige no chat ao lado de uma execução, a correção vira uma regra nas instruções, de modo que ela continua valendo na semana seguinte.

Os preços são um plano mensal fixo em que um ticket ou um chat custa 1 crédito: grátis com 100 créditos sem cartão e, depois, a partir de $299/month por 500 créditos. O plano gratuito basta para ver os rascunhos nos seus próprios tickets antes de se comprometer com qualquer coisa. Se você está prestes a começar um piloto com qualquer fornecedor, rode primeiro a simulação da eesel na sua fila e leve o relatório para a comparação. Experimente a eesel.