

O que a qualidade da linguagem no suporte ao cliente realmente significa
Trabalho na fila de suporte da eesel todos os dias, e as respostas que geram reclamação quase nunca são as que têm um erro de digitação. São as que têm quatro parágrafos quando o cliente fez uma pergunta de sim ou não, ou as que soam como um aviso jurídico quando o cliente estava claramente chateado. Por isso, quando uma equipe diz "nossa qualidade da linguagem está caindo", a primeira coisa que pergunto é qual camada.
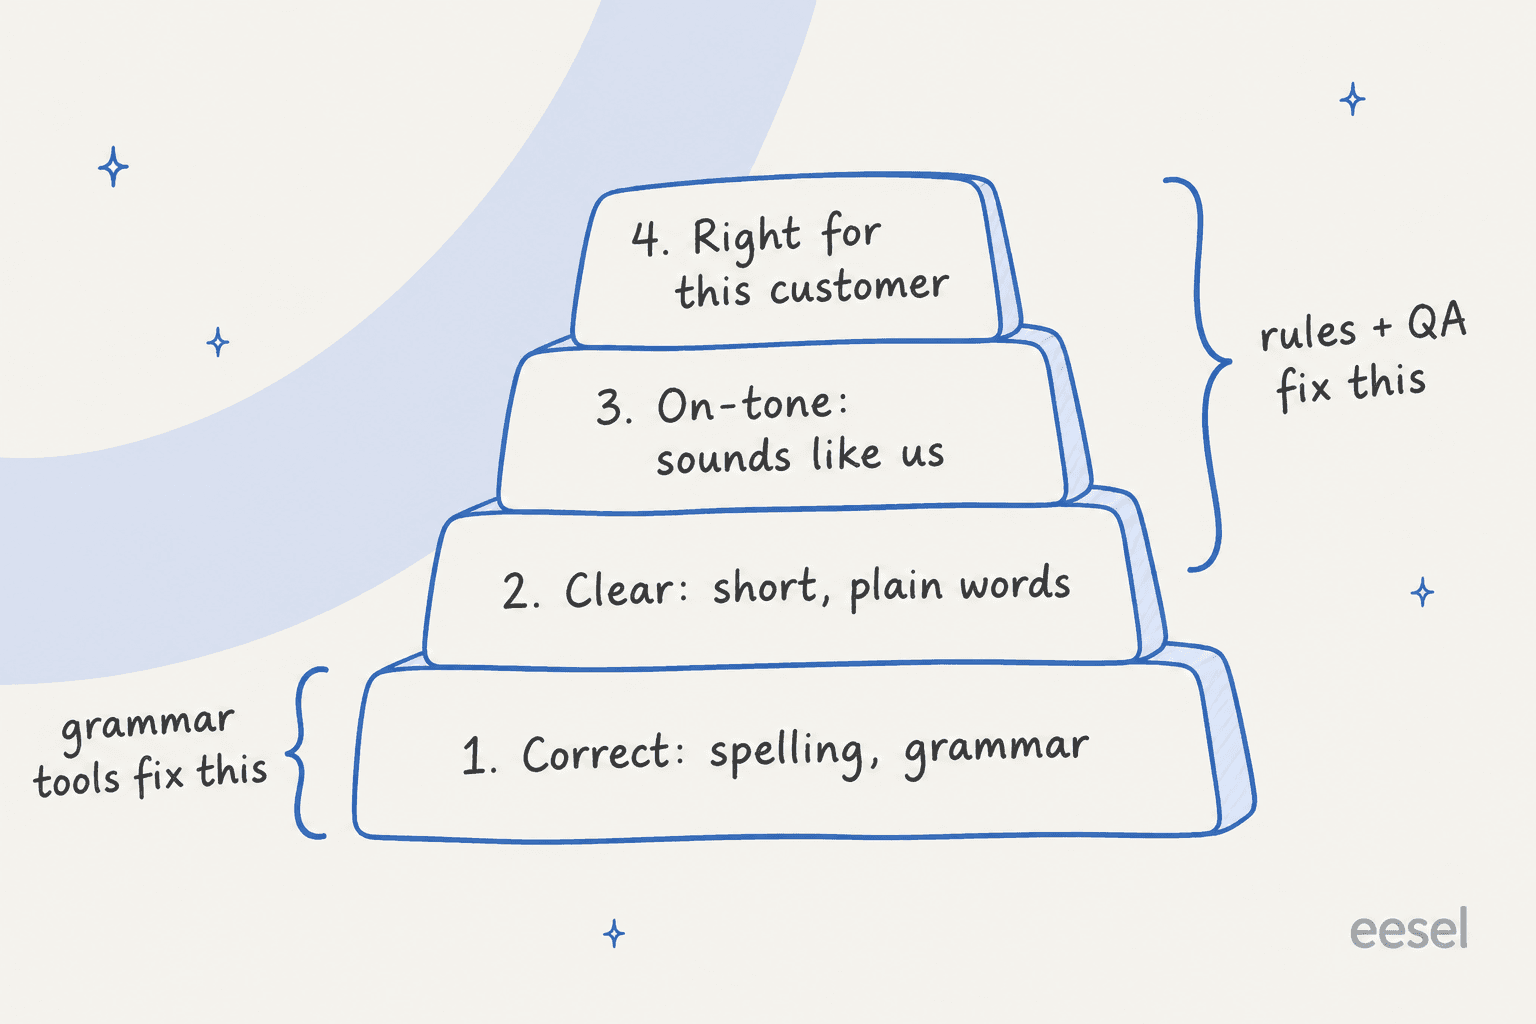
É assim que eu divido:
- Correta. Ortografia, gramática, pontuação, nomes de produto escritos do jeito que você escreve. O software hoje é muito bom nisso.
- Clara. Frases curtas, palavras simples, um pedido por mensagem, a resposta antes da explicação. O software consegue sinalizar frases longas, mas não sabe que o cliente precisava primeiro do passo 3.
- No tom certo. Soa como a sua empresa, com o nível certo de cordialidade. Uma marca de moda para jovens de 22 anos e um provedor de folha de pagamento não deveriam escrever a mesma resposta de reembolso.
- Adequada a este cliente. O idioma dele, a formalidade, o humor, o histórico com você. É a camada que um cliente recorrente irritado percebe.
O útil de dividir assim é que cada camada tem uma correção diferente, e a maioria das equipes gasta demais na camada um e de menos nas outras três. Se você já tem um glossário de tradução para suporte e uma configuração multilíngue, a camada quatro está quase toda coberta no quesito idioma; o que sobra é formalidade e humor.
Por que isso importa mais do que parece
Os clientes leem a qualidade da linguagem como um sinal de competência. Se a resposta é desleixada, assumem que a solução também será. Isso aparece de novo e de novo em discussões públicas, e quanto maior a marca, mais duro o julgamento.
"I was shocked by the middle school level English grammar coming from the company's official customer support. Who knew you could get so much wrong in seven sentences! Bad image for a luxury product."

A versão mais surpreendente: erros de digitação podem fazer uma resposta real parecer falsa. Quando um fã publicou um e-mail genuíno do atendimento da LEGO, a primeira reação no tópico foi que não podia ser verdadeiro.
"Sorry, ain't no way that's legit. The typos, the casual secret-leaking…I'm desperate for more sets just like everyone else, but I highly doubt that actually came from LEGO."

Isso é um problema de confiança, não de estilo. Num mundo em que os clientes já desconfiam de e-mails de phishing, uma resposta de suporte cheia de deslizes parece exatamente o golpe que sua equipe de segurança ensina as pessoas a ignorar.
E não se trata só de erros. Uma resposta pode ser gramaticalmente perfeita e ainda assim cair mal porque é uma resposta pronta colada sem ler a pergunta:
"you'd email with a problem and get a reply that was obviously just someone copying and pasting big chunks of superficially relevant text from some database. So it can happen with people too."
Aí falham as camadas dois e três enquanto a camada um passa.
Como medir a qualidade da linguagem na sua ficha de QA
Você não consegue corrigir o que só percebe quando um cliente reclama. O caminho padrão é adicionar categorias de linguagem à sua ficha de QA de suporte e pontuar uma amostra de tickets por semana. O caminho mais novo é deixar o software pontuar todos.
O que o Zendesk QA pontua automaticamente
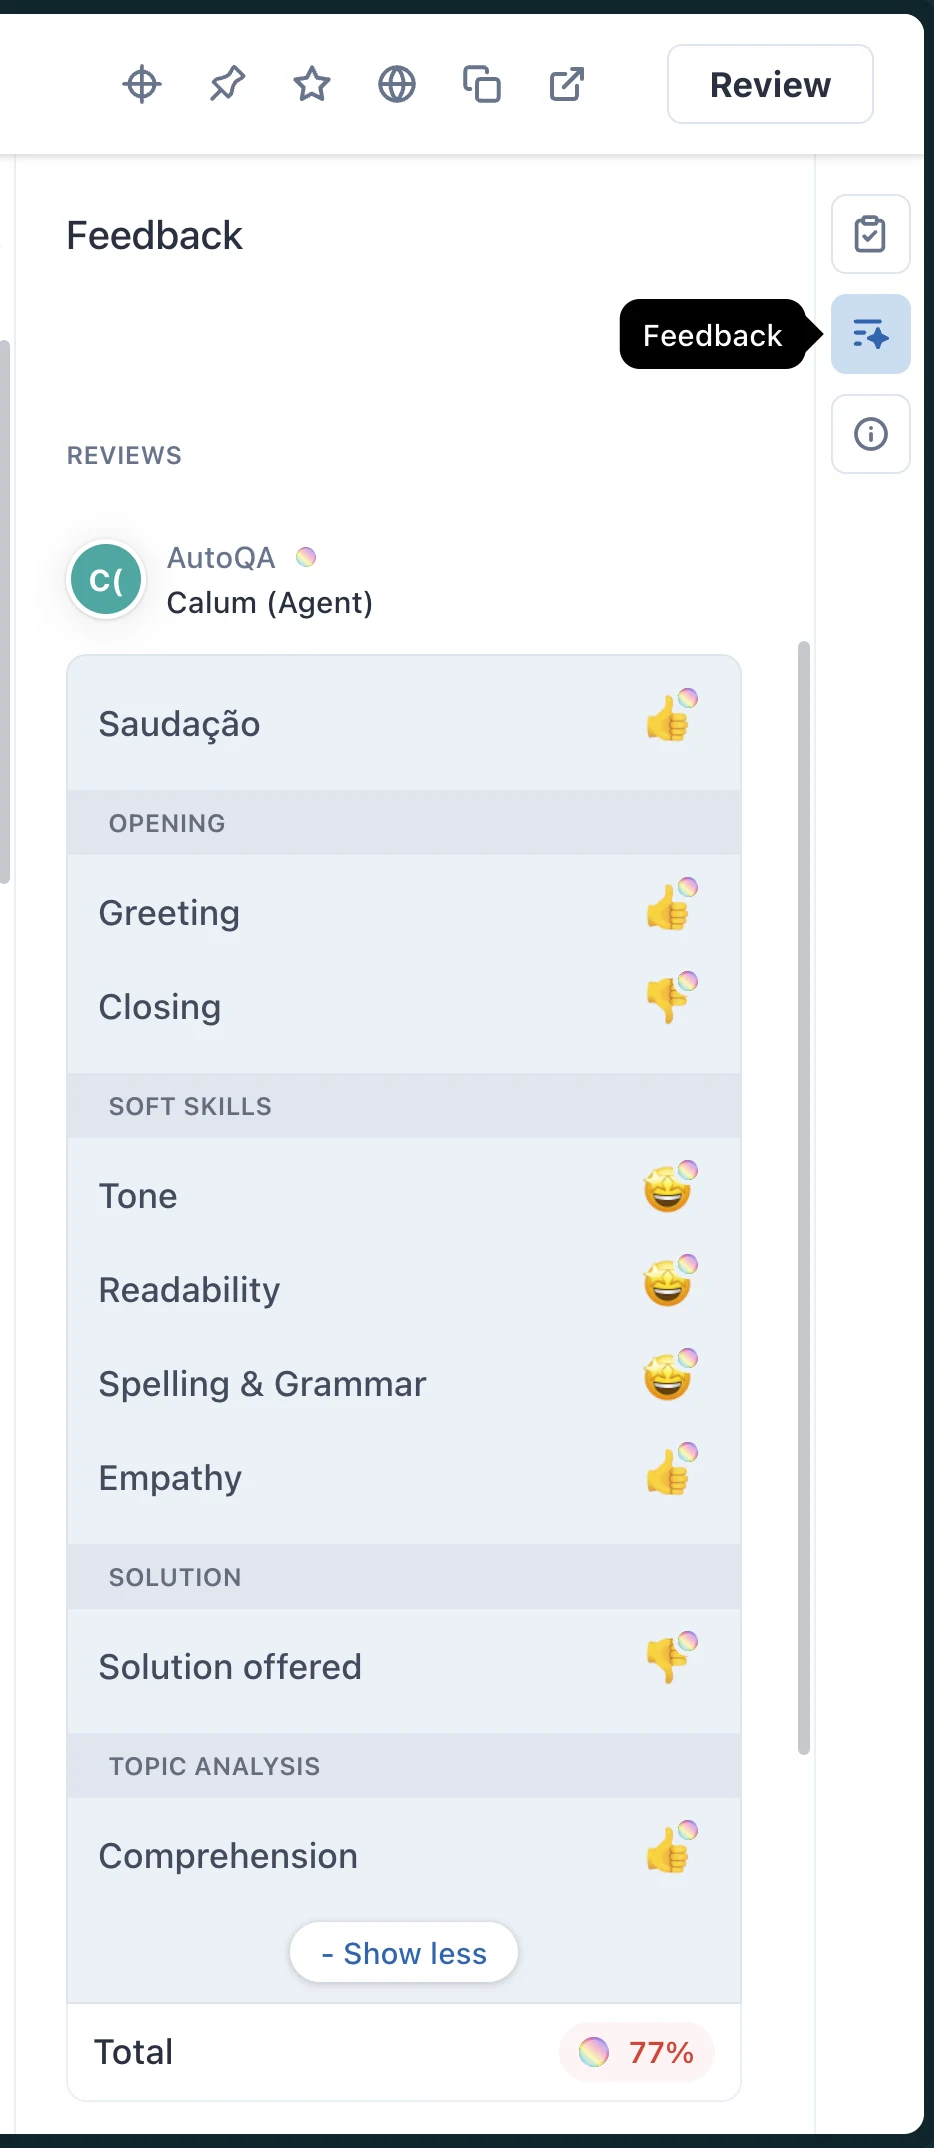
O Zendesk QA (o produto que antes se chamava Klaus) é o exemplo mais claro de pontuação automática de linguagem que encontrei, porque documenta cada categoria. O recurso AutoQA traz oito categorias de sistema que são pontuadas automaticamente por padrão em "100% of your ticket volume":
| Categoria do AutoQA | O que verifica | Tipo de pontuação | Idiomas |
|---|---|---|---|
| Ortografia e gramática | Erros gramaticais, erros de ortografia e de estilo, com cada erro destacado | Personalizável | 9 variantes: inglês (EUA, Reino Unido), alemão, francês, polonês, espanhol, português (Brasil, Portugal), holandês |
| Legibilidade | Complexidade das palavras e tamanho das frases | Escala fixa de 3 pontos | Só inglês e espanhol |
| Tom | Pesos de tom positivo ou negativo | Personalizável | Todos, mas só com a configuração LLM ativada |
| Empatia | Se o agente foi empático com a preocupação do cliente | Positivo/negativo | Todos, só LLM |
| Compreensão | Se o agente entendeu o problema | Positivo/negativo | Todos, só LLM |
| Saudação | Se o agente cumprimentou o cliente | Positivo/negativo | Todos com LLM; 8 idiomas sem |
| Encerramento | Se o agente encerrou bem e ofereceu mais ajuda | Positivo/negativo | Todos com LLM; 8 idiomas sem |
| Solução oferecida | Se o agente propôs uma solução | Positivo/negativo ou N/A | Todos, só LLM |
Todas as linhas vêm do artigo da Zendesk sobre as categorias de pontuação automática.
Alguns detalhes importam mais do que a tabela sugere:
- As verificações puras de escrita têm a menor cobertura de idiomas. Ortografia e gramática cobre 9 variantes de idioma, e a legibilidade cobre só inglês e espanhol. Se metade da sua fila é em italiano ou japonês, essas duas categorias ficam mudas para essa metade.
- A pontuação de tom muda em 6 de outubro de 2026. A Zendesk anunciou que o tom vai "focus exclusively on concrete, professional conduct, such as whether a response is polite or impolite", com novos rótulos para cordialidade, utilidade, cortesia e empatia. Ela avisa que as equipes "might see an average decrease of 15% in their tone scores". Se a linha de tendência de tom cair na semana que vem, provavelmente é o modelo, não a sua equipe.
- Os bots também são avaliados. O AutoQA verifica ortografia e gramática "in both agent and bot interactions", e a página do Zendesk QA diz que tickets de agentes de IA são analisados "without extra charge". Isso é útil se você está avaliando agentes de IA com a mesma ficha dos humanos.
- Tickets curtos são ignorados. Um ticket precisa de uma mensagem do cliente, uma do agente e pelo menos 10 palavras, e só é pontuado depois de Resolvido ou Fechado.
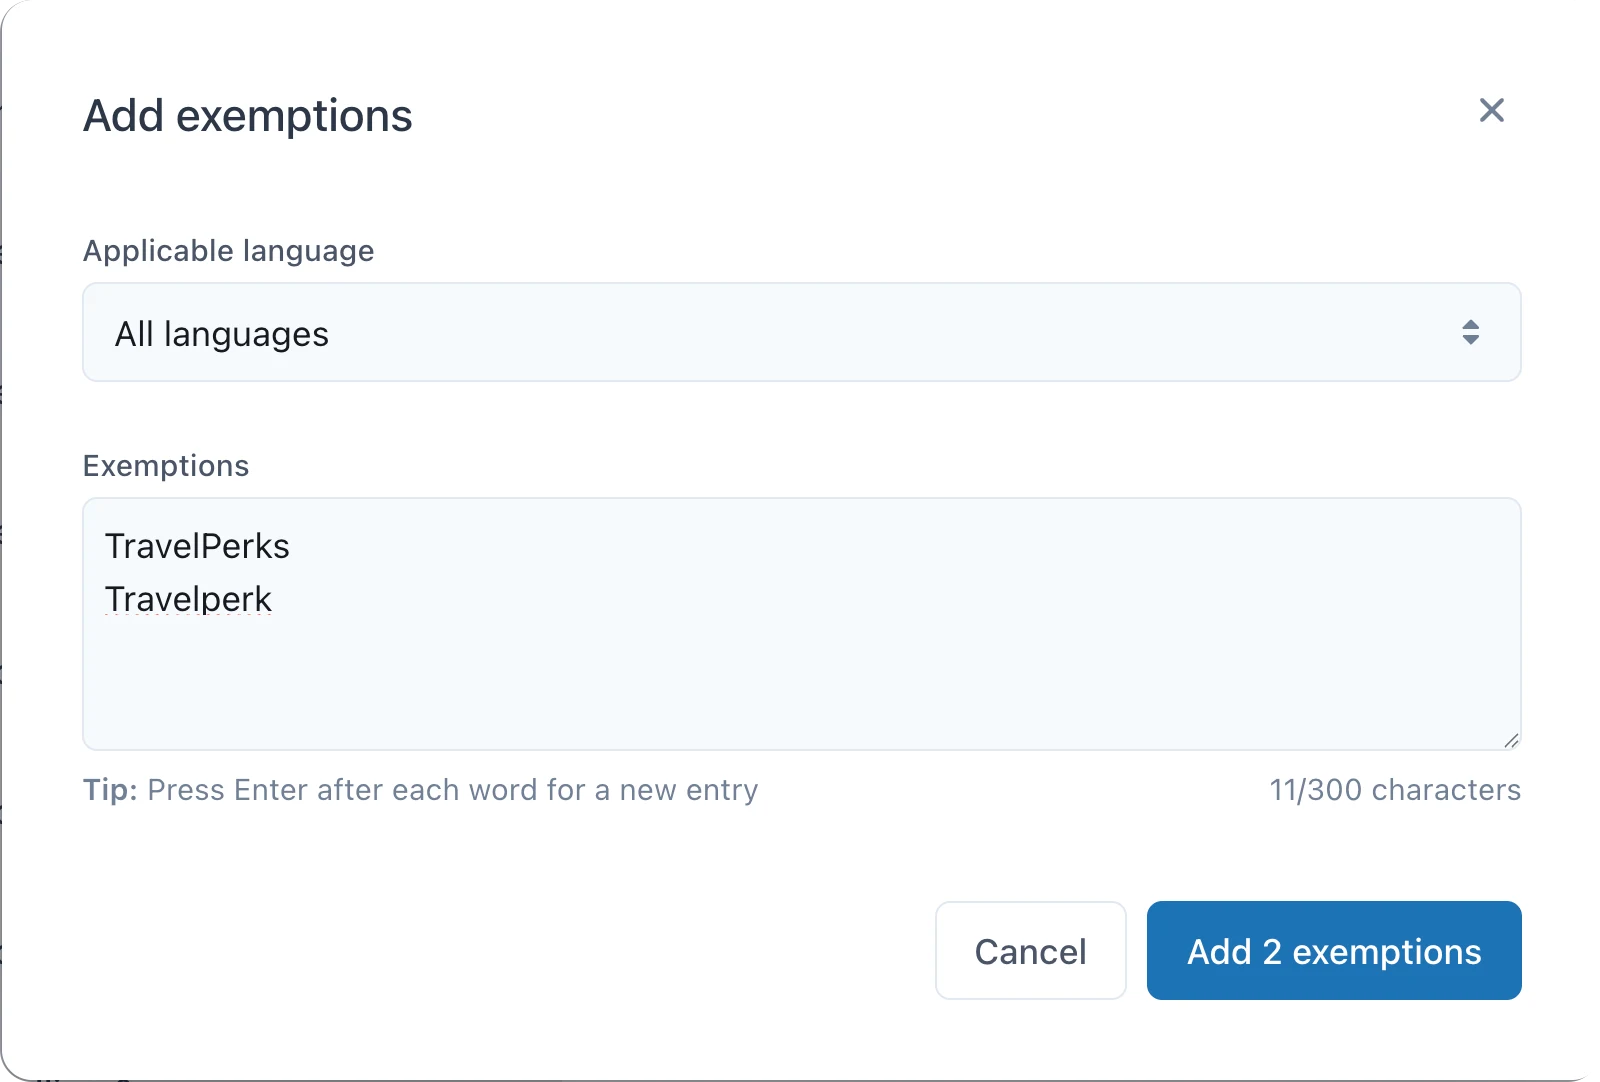
Você também pode ensinar o corretor ortográfico com o seu próprio vocabulário. Os administradores podem adicionar até 300 exceções por idioma, que é onde entram nomes de produto, SKUs e grafias de marca para que deixem de contar como erros.
O porém que eu apontaria a qualquer líder de equipe: a própria Zendesk diz que as avaliações automáticas são "só para orientação" e não devem guiar decisões de desempenho. A pontuação automática (AQS) só entra na sua pontuação de qualidade manual (IQS) quando uma pessoa envia a revisão. Use-a para achar padrões, como o agente que erra as mesmas três palavras toda semana, e depois faça coaching sobre isso.
Sobre preço, o AutoQA exige o complemento QA ou o complemento Workforce Engagement, e a página de preços da Zendesk não mostra um preço avulso de QA. O Workforce Engagement Bundle listado custa US$ 50 por agente por mês, pago anualmente, além do seu plano do Zendesk (Suite Team a partir de US$ 55).
O que outras ferramentas de QA fazem
As outras plataformas de QA costumam deixar você montar uma verificação de linguagem em vez de entregar uma pronta:
- Rippit (antiga MaestroQA) se reconstruiu como uma plataforma centrada em IA que pontua 100% das conversas com agentes de QA que você define. As métricas do AutoQA legado são baseadas em LLM, correspondência de frases e processos, então gramática é uma métrica personalizada que você escreve. Os planos publicados são Free (100 execuções de agente), Starter a US$ 185/mês e Growth a US$ 495/mês.
- evaluagent pontua itens qualitativos por linhas personalizadas da ficha, em vez de uma nota específica de gramática, a partir de US$ 35 por usuário por mês.
Se você usa Zendesk, meu guia de IA para Zendesk mostra o que fica por cima do QA. Se está escolhendo entre plataformas, meus comparativos de IA para QA de suporte e de garantia de qualidade em call center aprofundam mais.
Como corrigir a qualidade da linguagem antes de a resposta sair
Medir depois mostra onde estão os problemas. Corrigir antes de enviar é o que impede que eles cheguem aos clientes. Todo helpdesk grande já tem algum menu de escrita com IA no editor, mas as opções variam mais do que você imaginaria. Só alguns têm uma correção de gramática com nome.
| Helpdesk | Recurso | Opção de gramática? | Opções de tom e tamanho | O que é preciso | Preço |
|---|---|---|---|---|---|
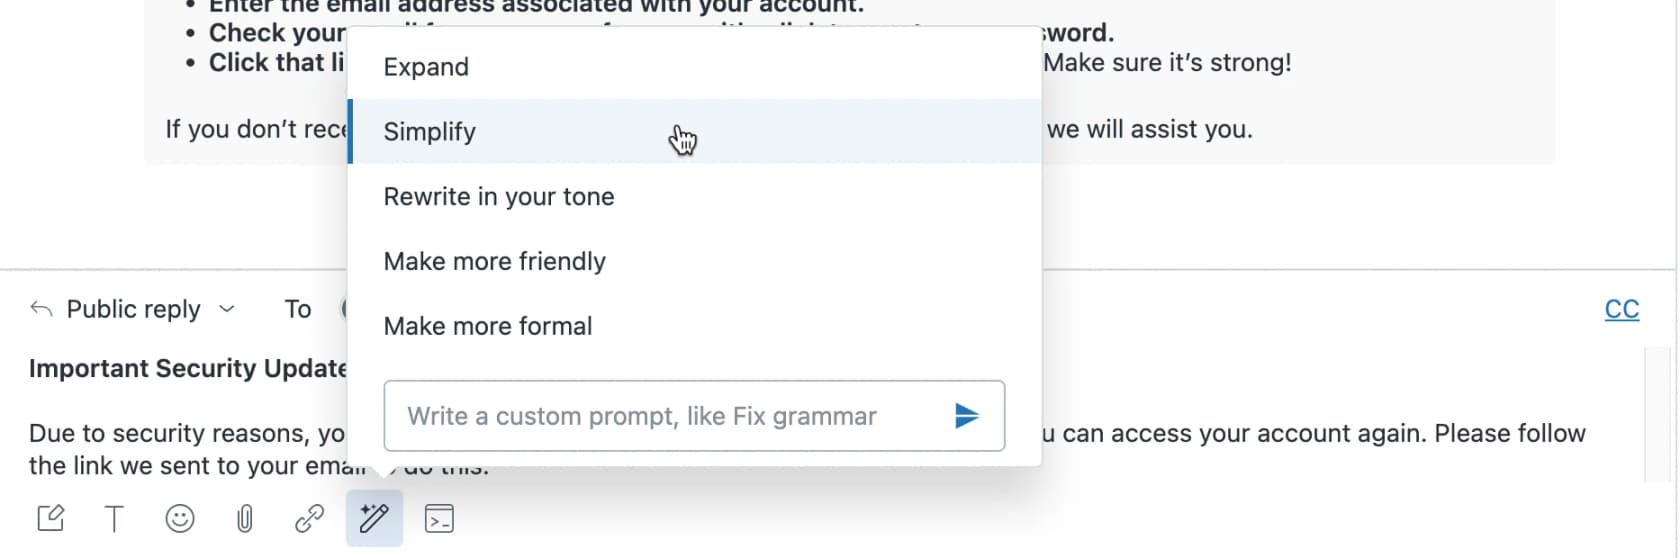
| Zendesk | Enhance writing | Nenhuma opção com nome (só prompt personalizado) | Expand, Simplify, Make more friendly, Make more formal, Rewrite in your tone | Professional+ recebe 5 usos por agente por mês, em conjunto; ilimitado com Copilot | Copilot US$ 50/agente/mês, pago anualmente |
| Freshdesk | Writing Assistant | Incluída no Rephrase ("clarity, grammar, and accuracy") | More formal, Less formal, Expand, Expand as email | Pro ou Enterprise mais Freddy AI Copilot | Complemento de US$ 29/agente/mês |
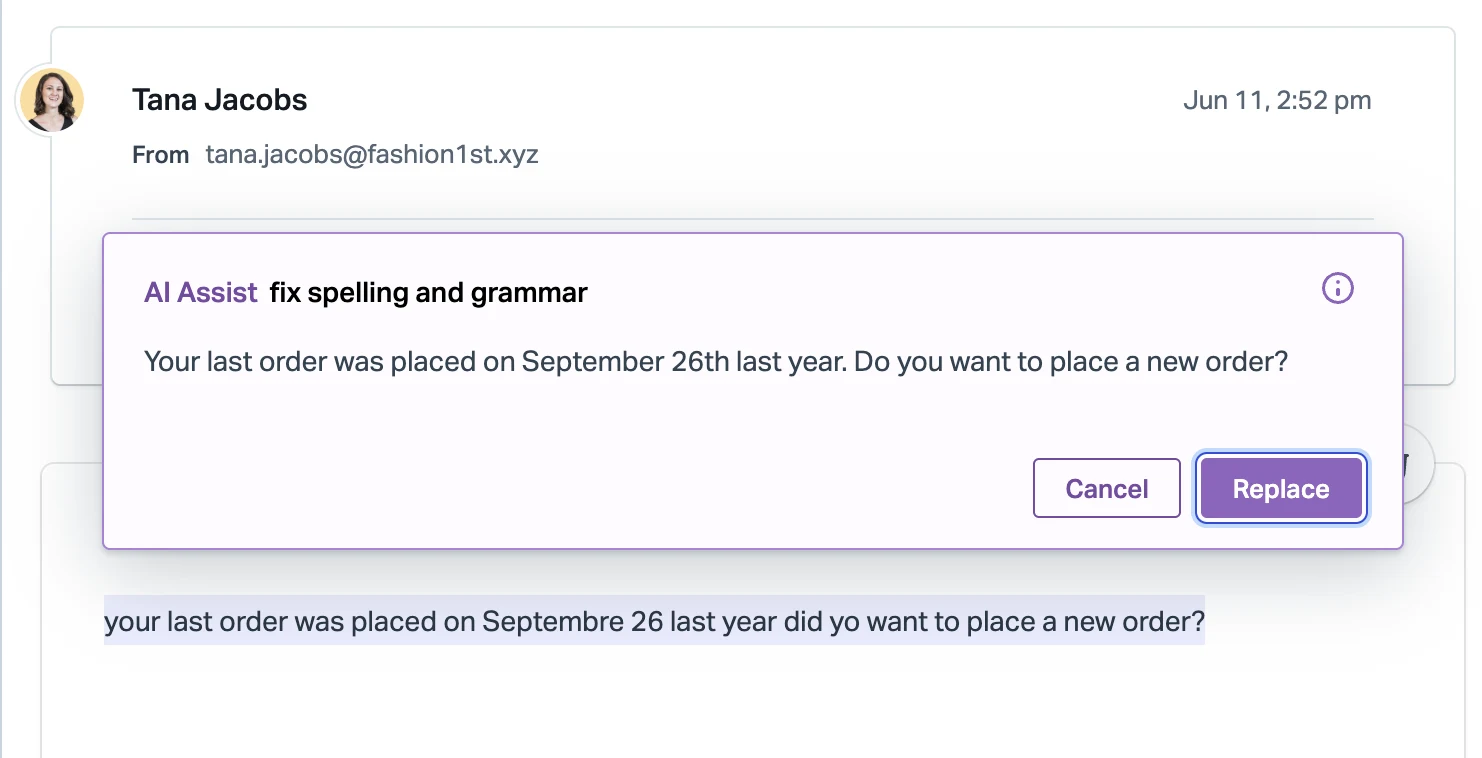
| Help Scout | AI Assist | Sim: Fix spelling and grammar | Longer, Shorter, Friendlier, More professional, Translate | Plus ou Pro (planos por usuário) | Incluído |
| Front | Compose | Sim: ortografia, pontuação, gramática | Tom, expandir ou condensar, traduzir (18 idiomas) | Starter em diante; prompts personalizados exigem Copilot | Incluído (200 usos/dia); Copilot US$ 20/licença/mês |
| HubSpot | Assistente de IA (caixa de conversas) | Sim: Proofread | Change tone, Rewrite, Expand, Shorten | Todos os planos, inclusive Free | Incluído (1.000 usos/dia) |
| Gorgias | Nada documentado para rascunhos de agentes | Não | Só tradução | Todos os planos | Incluído |
Fontes: a central de ajuda de cada fornecedor, consultada em 05/10/2026. O nível gratuito de escrita do Zendesk é limitado a 500 usos por conta por mês.
Duas coisas chamam a atenção. Primeiro, o menu de escrita do Zendesk não tem botão de gramática; a caixa de prompt personalizado sugere literalmente que você digite "Fix grammar", e o nível gratuito acaba com 5 usos por agente por mês. Segundo, o Proofread do HubSpot está incluído em todos os planos, mas a própria documentação do HubSpot avisa que ele "tends to produce inconsistent results in non-English languages". Meus artigos sobre sugestões de tom com IA do HubSpot e Front AI Compose cobrem cada um com mais detalhe.
A versão do Help Scout, incluída nos planos Plus e Pro, é a correção de um clique mais limpa que já vi em um editor:
No Freshdesk, o Writing Assistant fica atrás do complemento Freddy AI Copilot, que só funciona no Pro (US$ 55) e no Enterprise (US$ 89). Meu detalhamento dos preços do Freddy Copilot mostra quanto isso soma por licença.
Ferramentas de gramática dedicadas para equipes de suporte
Se a opção embutida do seu helpdesk é fraca, uma ferramenta de gramática no navegador cobre todos os helpdesks de uma vez. As três que eu avaliaria:
| Ferramenta | Preço | Regras de estilo da equipe | Cobertura de helpdesks | Idiomas | Vale saber |
|---|---|---|---|---|---|
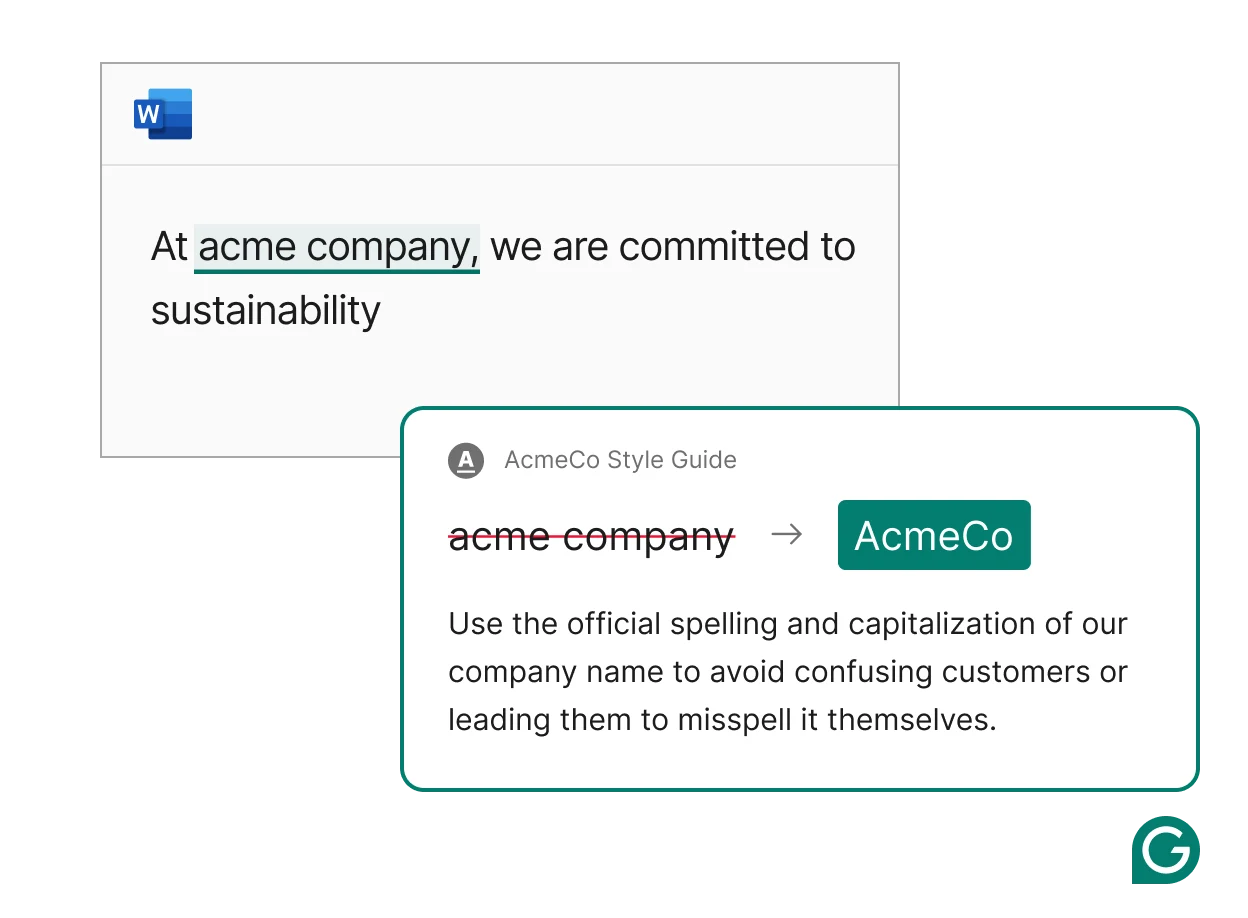
| Grammarly | Free; Pro US$ 12/membro/mês anual (US$ 30 mensal); Enterprise sob consulta | Pro: 1 guia de estilo, 1 tom de marca. Enterprise: ilimitado | Extensão de navegador; Zendesk, Gmail e Salesforce citados | 23 citados | O feedback de tom de marca pode ser limitado ao site do seu helpdesk |
| Sapling | Free; Pro US$ 25/mês (US$ 12 anual); Enterprise a partir de 10 licenças a US$ 15/licença/mês | Snippets, controles de equipe no Enterprise | 26 integrações de suporte, incl. Zendesk, Freshdesk, Gorgias, Help Scout | Vários (espanhol, francês, alemão, português, italiano, chinês, japonês citados) | Hospedagem própria, SOC 2 Type II, HIPAA com BAA |
| LanguageTool | Teams US$ 66,40/usuário/ano (preço promocional de 20% em 05/10/2026) | Guia de estilo e dicionário da equipe | Só complemento de navegador | 31 listados, mais forte em cerca de 7 | Mais barato por licença para um guia de estilo de equipe |
O Grammarly é o padrão por um motivo: suas regras de estilo impõem como os nomes dos seus produtos são escritos, e os tons de marca dão aos agentes feedback de tom enquanto digitam. O limite no Pro é um de cada, então uma empresa com duas marcas precisa do Enterprise. Minha lista de alternativas ao Grammarly cobre o resto.
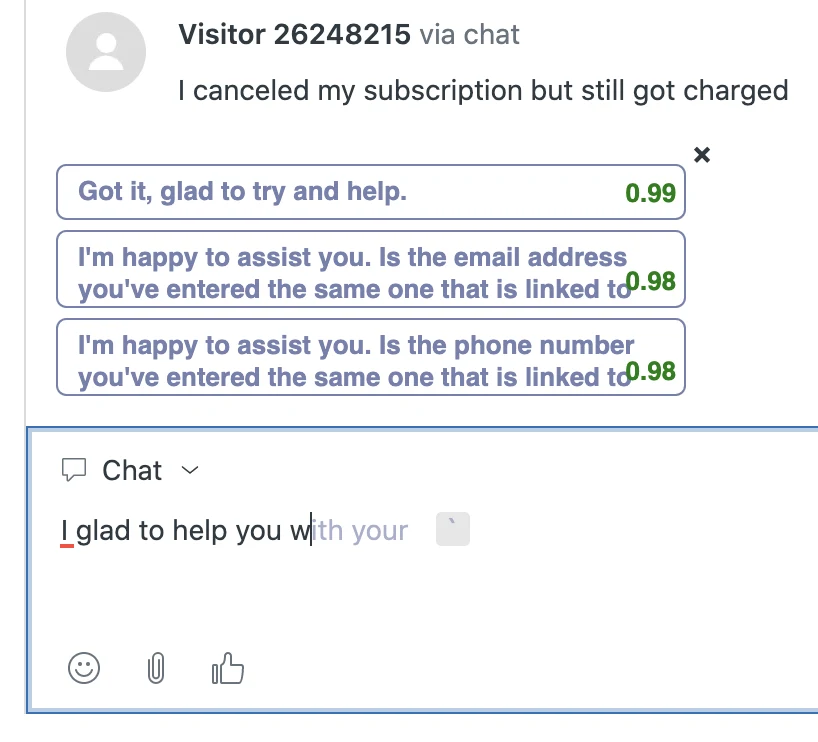
O Sapling é o feito especificamente para suporte. Ele roda dentro da visão de agente do Zendesk com verificação de gramática, autocompletar e respostas sugeridas:
As três corrigem as palavras. Nenhuma sabe se a resposta está certa, se a política de reembolso mudou na semana passada ou se este cliente já escreveu três vezes. Esse é o teto da camada de baixo.
Onde pegar os erros: três pontos de controle
Juntando medir e corrigir, há três lugares onde uma resposta pode ser interceptada, e uma boa configuração usa os três para tarefas diferentes.
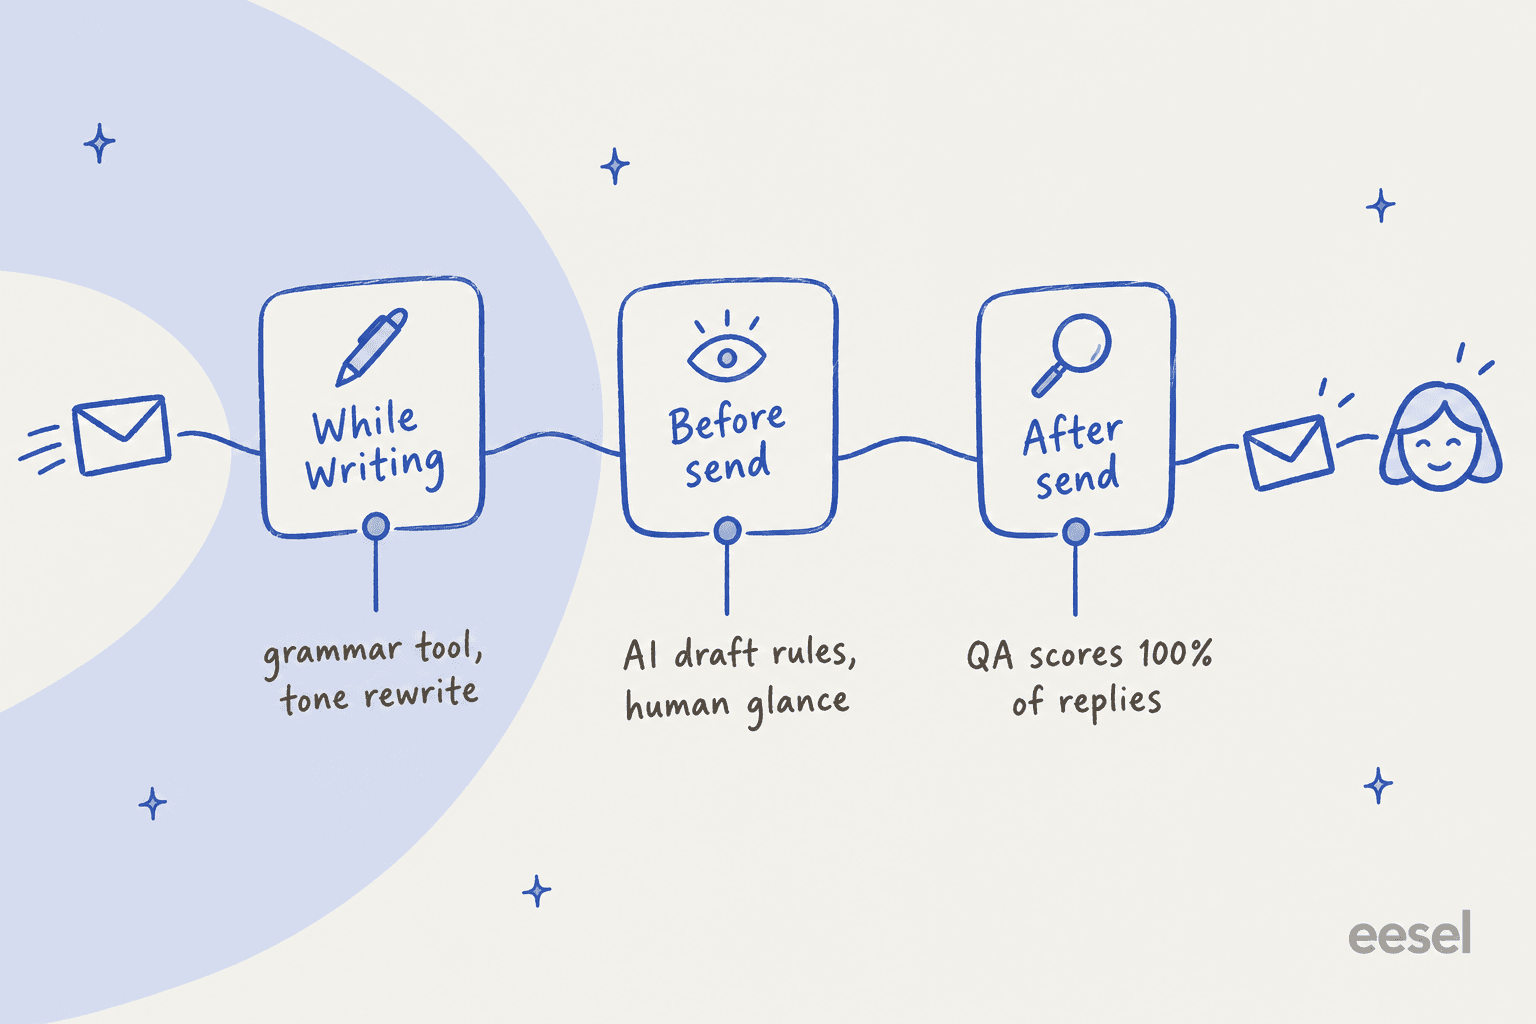
- Ao escrever: uma ferramenta de gramática ou o menu de IA do editor cuida da camada um. Barato, instantâneo, e os agentes param de pensar nisso depois de uma semana.
- Antes de enviar: regras de tom e tamanho, aplicadas pelo agente ou pela IA que redige a resposta. É aqui que a maior parte da qualidade é ganha ou perdida.
- Depois de enviar: a pontuação de QA encontra os padrões, como o agente que pede desculpas demais ou a macro que confunde todo mundo. Devolva isso ao ponto de controle 2.
A maioria das equipes com quem falo só tem o ponto de controle 1 e uma amostra manual de QA de alguns tickets por agente por semana. A lacuna é o ponto de controle 2.
O que a redação com IA muda
Esta é a parte que eu não esperava quando a eesel começou a colocar rascunhos de IA na frente dos agentes. A IA basicamente acaba com o problema de ortografia e gramática. Não acaba com o problema de qualidade da linguagem. Ela o empurra para cima na pirâmide.
Em um teste real, a eesel rodou em uma caixa de e-commerce de cerca de 1.000 tickets por mês no Zendesk, e analisei o que os agentes faziam com os rascunhos. Os rascunhos estavam, na maior parte, certos quanto ao conteúdo, e só cerca de 5% das reescritas aconteceram porque a eesel errou um fato. Mas os agentes enviaram só 12% dos rascunhos do jeito que vieram. O padrão dominante era "olhar e reescrever": os agentes transformavam rascunhos de 8 a 15 frases em respostas de 1 a 3 frases, e cerca de 65% das reescritas eram sobre tamanho e tom.
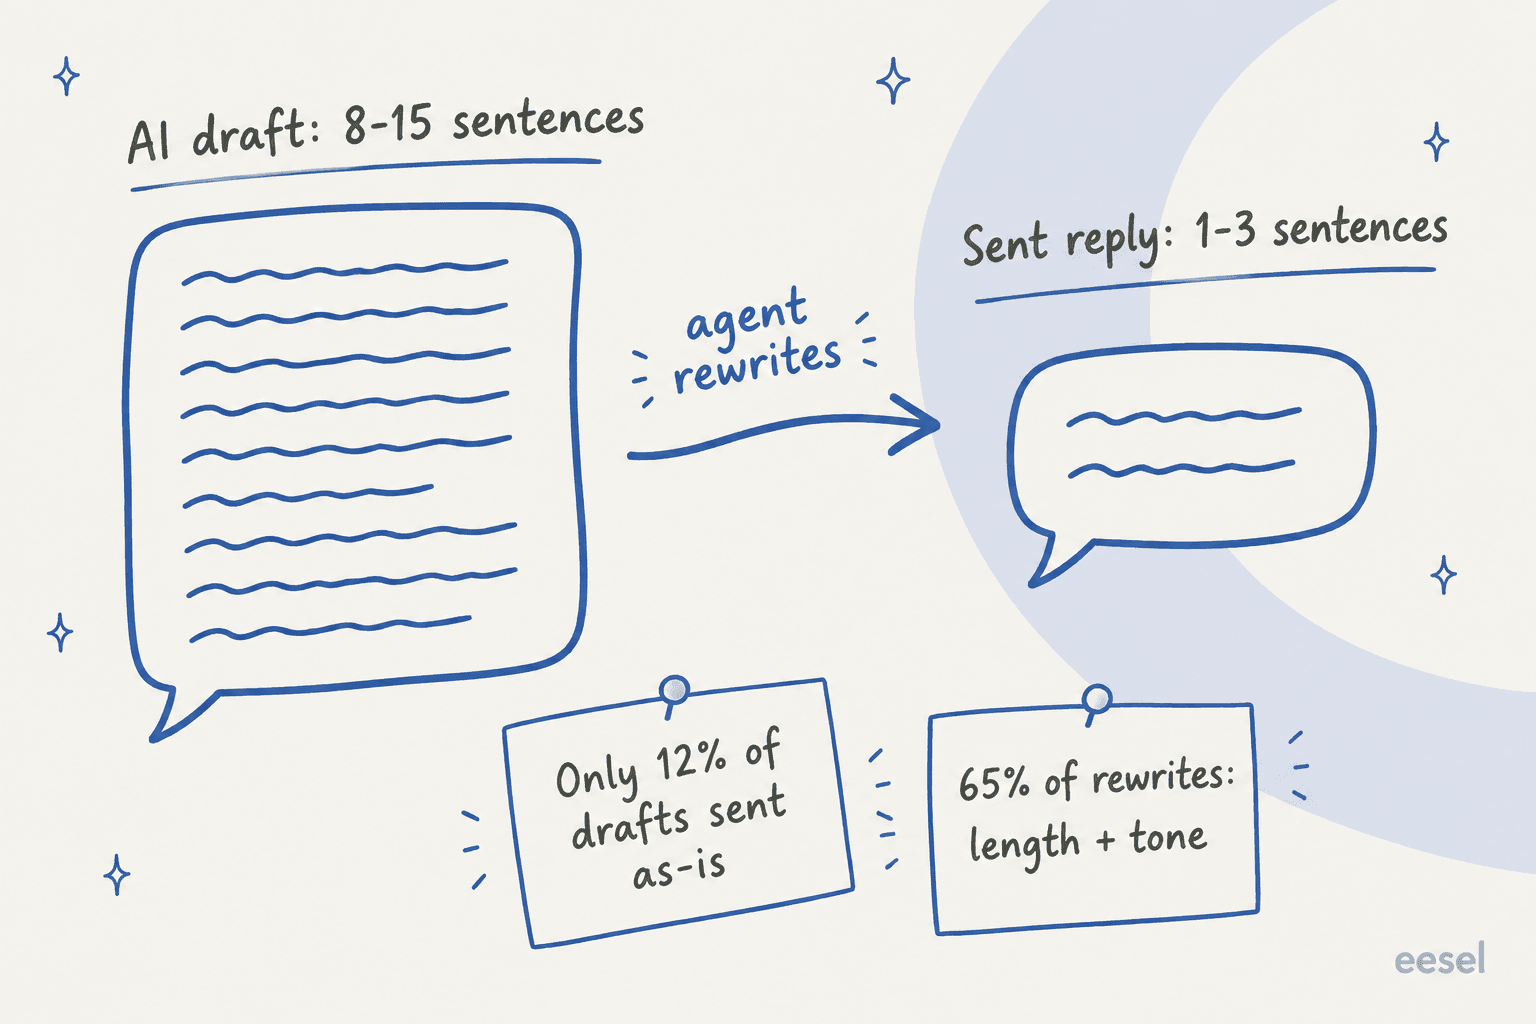
A solução não foi uma ferramenta de gramática. Foi ensinar à IA como aquela equipe realmente escreve, a partir das respostas que ela já tinha enviado. A análise da eesel estimou que treinar com cerca de 200 respostas recentes de agentes poderia levar a adoção sem edição de 12% para 30 a 40%.
Então, se você está lançando rascunhos de IA, a pergunta de qualidade da linguagem não é "ela escreve certo?". É "ela escreve como nós?". Um comentarista do HN fez o mesmo ponto do lado do cliente: a sensação robótica começou muito antes da IA:
"The way support is setup nowadays humans are basically forced to be robots anyway, given a set of canned responses for each scenario and almost no latitude of their own. At least the robot responds instantly."
Quando as respostas de IA soam robóticas, normalmente é porque foram configuradas só com a central de ajuda e nunca viram uma resposta real de um agente. Meu guia de voz de marca com IA mostra a configuração.
Qualidade da linguagem em equipes offshore e de agentes não nativos
É aqui que falar de qualidade da linguagem fica desconfortável, então serei direto: muita da pressão sobre a qualidade da linguagem vem de equipes que mudaram o suporte para agentes offshore ou nearshore e depois viram o CSAT cair nos canais escritos. Inglês escrito fluente é um custo real de contratação:
"I worked in Europe where it was not acceptable to address the customer in broken English. Easily $15 an hour."
Os erros que mais machucam não são os gramaticais. São as expressões regionais que estão corretas onde o agente mora e confundem onde o cliente mora:
"Consider for example phrases like "Kindly do the needful" or "out of station". Phrases they say daily that are completely foreign to American ears."
E pequenos deslizes são lidos como grosseria mesmo quando o conteúdo está certo. Isso é injusto com o agente, mas o cliente só vê o e-mail.
O que eu faria com uma equipe não nativa, em ordem:
- Escreva uma lista de expressões de uma página. Expressões proibidas (com a substituta), saudações e despedidas aprovadas e como dizer não com educação. Isso rende mais do que qualquer ferramenta de gramática.
- Coloque uma ferramenta de gramática no editor e torne-a o padrão, não opcional. Help Scout, Front e HubSpot já têm uma embutida; no Zendesk ou no Freshdesk, adicione Grammarly ou Sapling.
- Use modelos para as mensagens difíceis. Negativas de reembolso, atrasos e pedidos de desculpas são onde o tom dá errado. Crie bons modelos de e-mail ou macros com IA para eles e deixe os agentes adaptá-los.
- Faça coaching sobre padrões, não sobre deslizes. Ferramentas de QA como o Zendesk QA têm cartões de painel para erros repetidos de ortografia e gramática por pessoa avaliada. Uma conversa de coaching sobre um erro repetido vale mais que vinte marcas vermelhas.
- Considere uma camada de redação com IA. Ela nivela as duas camadas de baixo para todos, e o julgamento do agente vai para as duas de cima. Meu comparativo de custo de IA versus offshore faz as contas.
Um programa simples de qualidade da linguagem, passo a passo
Se você está começando do zero, esta é a ordem que eu seguiria. Leva cerca de duas semanas para montar e depois roda sozinho.
- Escolha suas quatro categorias. Ortografia e gramática, clareza, tom, terminologia. Escreva uma frase definindo "bom" para cada uma, com um exemplo real de resposta da sua fila.
- Separe 30 tickets recentes e pontue à mão. Você verá o problema real em uma tarde. Normalmente é tamanho ou tom, não erros de digitação.
- Corrija a camada de baixo com ferramentas. Ative a opção de gramática do editor ou uma ferramenta de gramática para todos os agentes, e adicione os nomes de produto ao dicionário ou à lista de exceções.
- Escreva as camadas de cima. Um guia de tom curto (dois ou três adjetivos, mais palavras que você nunca usa), uma regra de tamanho ("responda nas duas primeiras frases") e exemplos de frases de empatia que soem como você. Coloque isso no seu SOP de suporte.
- Pontue continuamente. Ou pontuação automática em cada ticket ou uma amostra manual semanal. Acompanhe as tendências por agente e por macro.
- Feche o ciclo. Cada erro repetido vira uma regra, uma correção de modelo ou um ponto de coaching. Quem entra na equipe recebe as regras no primeiro dia; combina bem com seu onboarding de agentes e seus cenários de treinamento.
Erros comuns a evitar
- Tratar a gramática como o trabalho inteiro. Uma resposta gramaticalmente perfeita que enterra a solução no terceiro parágrafo é uma resposta ruim.
- Pontuar o tom sem defini-lo. "Seja simpático" significa coisas diferentes para avaliadores diferentes. Calibre primeiro com cinco tickets de exemplo.
- Usar pontuações automáticas em avaliações de desempenho. Até a Zendesk diz para não fazer isso. Use-as para achar padrões e deixe uma pessoa julgar.
- Ignorar filas que não são em inglês. Confira quais idiomas a sua ferramenta de QA realmente pontua. A legibilidade no Zendesk QA, por exemplo, é só para inglês e espanhol.
- Adicionar IA sem seus próprios exemplos. Um copiloto de IA treinado só com a central de ajuda vai escrever como a central de ajuda. Longo, formal, completo. Raramente é assim que o seu melhor agente escreve.
eesel para a qualidade da linguagem no suporte
Se você está adicionando IA à sua fila, a pergunta de qualidade da linguagem é se ela escreve como a sua equipe. É em torno disso que o colega de helpdesk com IA da eesel é construído. Com a conexão completa, ele lê sua central de ajuda, suas macros e tickets antigos para saber como a sua equipe responde antes de redigir qualquer coisa.
Ele funciona dentro de Zendesk, Freshdesk, Help Scout, Gorgias e outros helpdesks, redigindo primeiro como notas internas para que seus agentes continuem no controle.

Regras de tom e tamanho vão em instruções em linguagem natural ("responda em duas frases, sem 'I apologize for any inconvenience'"), e quando você corrige um rascunho no chat, ele salva a correção como regra para que ela valha na semana seguinte. Antes de qualquer coisa entrar no ar, a skill de simulação reproduz tickets reais antigos e pontua cada resposta. Um líder de service desk resumiu bem o resultado:
"It is getting us to the right articles really quickly and easily, as well as curating well-formed responses with consistent, on-brand tone, still keeping our own style and still keeping that human touch."
Eddie Stephens, Service Desk Lead, CartonCloud
Os planos começam em US$ 299 por mês por 500 créditos, em que um ticket é um crédito, não importa o tamanho da conversa, e há um nível gratuito para testar com os seus próprios tickets. Teste a eesel em uma parte da sua fila e compare os rascunhos dela com o que sua equipe realmente enviou.