

O que é análise de erros no atendimento ao cliente?
A análise de erros no atendimento ao cliente é uma revisão repetível de respostas de suporte erradas ou fracas, em que cada falha recebe um rótulo de causa raiz, os rótulos são contados e a causa mais comum é corrigida na origem. Funciona do mesmo jeito se a resposta veio de um agente, de uma macro ou de um agente de IA.
O termo vem do aprendizado de máquina, onde é o passo que as pessoas pulam. Um comentarista do Hacker News resumiu isso sem rodeios há mais de uma década:
"3) Do error analysis/run diagnostics. Go to 1. It is the last step I find inexperienced people usually lacking. You need to examine your errors and find commonalities among them."

Essa é a ideia toda. Uma resposta errada é uma anedota. Quarenta respostas erradas separadas em grupos são uma lista de tarefas.
É fácil confundir com o QA de suporte, então é assim que eu os separo:
| QA de suporte | Análise de erros | |
|---|---|---|
| Pergunta que responde | Quão boa foi a resposta deste agente? | Por que as respostas dão errado, e onde? |
| Unidade de revisão | Um agente, uma ficha de avaliação | Uma falha, uma causa raiz |
| Amostra | Tickets aleatórios ou atribuídos | Tickets que já deram errado (reaberturas, CSAT ruim, escalonamentos, rascunhos rejeitados) |
| Resultado | Uma nota e observações de coaching | Uma lista ordenada de causas, cada uma com um responsável |
| Quem corrige | O agente | Quem é dono da causa: o redator da base de conhecimento, o responsável pela política, o administrador da IA, a equipe de produto |
O QA continua importando. A análise de erros é o que você faz com as falhas que o QA encontra, para que parem de se repetir. Eu construo agentes de IA na eesel, e a hora mais útil de qualquer implantação é aquela em que alguém lê 50 tickets com falha e anota por que cada um falhou.
Por que a maioria dos erros de suporte não é culpa do agente
Quando um cliente recebe uma resposta errada, o instinto é procurar quem a enviou. Mas, lendo o que os agentes dizem sobre os próprios erros, um padrão aparece rápido: o agente estava trabalhando com informação ruim.
"Yes..and they're always outdated never load.. and if you have questions the supervisor will always refer you back there and give you a bad review saying you must not have checked it."

Mudanças de política são o caso clássico. A atualização chega num e-mail ou num canal de chat, e o artigo da base de conhecimento não muda:
"Emails get buried so fast man I swear I will find a important update like 3 days later after already giving wrong info to 10 customers. The knowledge base is good when they actually update it but half the time someone forgot to change the article"
Uma resposta errada, dez clientes. Fazer coaching com esse agente não resolve nada, porque o próximo agente vai ler o mesmo artigo desatualizado. Em outro tópico, um agente descreveu como pediu ajuda numa pergunta sobre desconto: o supervisor disse US$ 30 por mês, um colega disse que não havia desconto, outro disse metade, e um coach levou dez minutos para confirmar que era metade. Três pessoas, três respostas. Isso é falta de uma fonte única de verdade, não um agente descuidado. Meu guia de gestão de mudanças de política mostra como barrar isso na origem.
Agentes de IA falham do mesmo jeito, só que mais rápido. Quando o bot de suporte do Cursor disse aos usuários que um logout era uma nova política de "um dispositivo", o Hacker News tratou como uma história de alucinação de IA. O cofundador do Cursor explicou a causa raiz real no tópico:
"For context, this user's complaint was the result of a race condition that appears on very slow internet connections. The race leads to a bunch of unneeded sessions being created which crowds out the real sessions. We've rolled out a fix."
O bot não tinha nenhum documento explicando o bug, então explicou o sintoma com algo plausível. A resposta errada foi o último elo de uma cadeia que começou com um bug de produto que ninguém havia documentado. Se você só "corrige a IA", perde a parte que realmente quebrou. Meu post sobre alucinações de IA no suporte aprofunda esse padrão.
E às vezes o "erro" nem é um erro. Aqui está o detalhamento do teste de e-commerce, em que os agentes podiam enviar um rascunho da eesel como estava ou reescrevê-lo. Só 12% dos rascunhos saíram sem alteração em 284 chats, o que parece terrível até você ver o motivo:
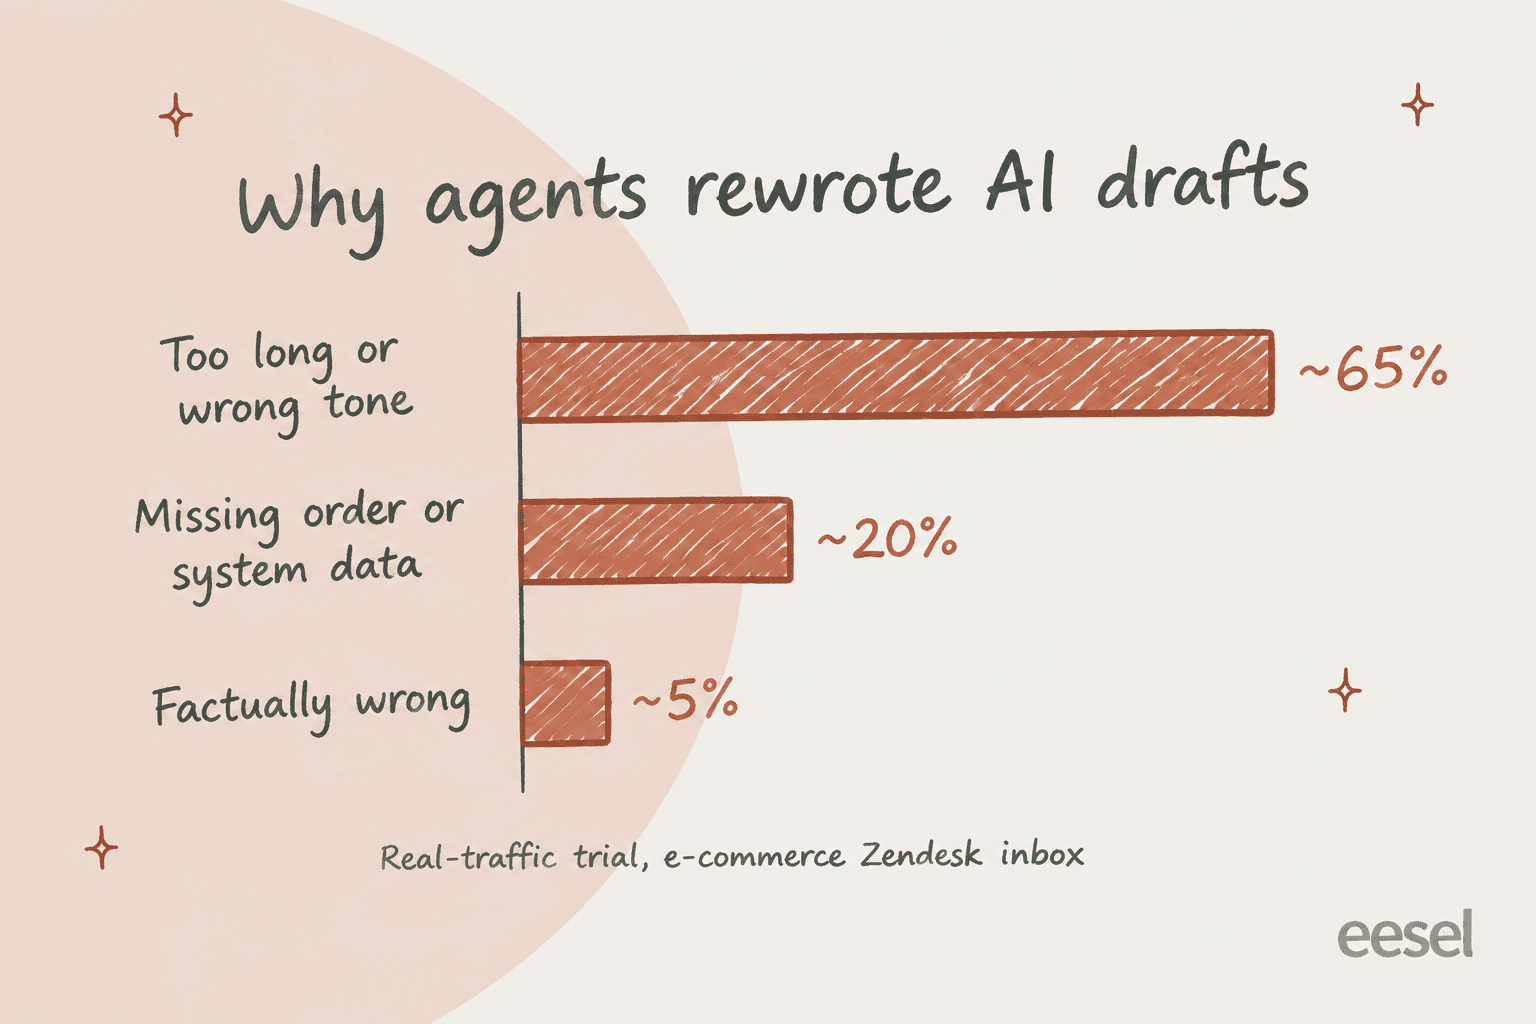
Os agentes normalmente transformavam rascunhos de 8 a 15 frases em respostas de 1 a 3 frases. A maioria das reescritas era um problema de estilo, resolvido treinando com as respostas enviadas da própria equipe e com uma voz de marca para a IA clara. Cerca de um quinto precisava de dados de sistemas que ainda não estavam conectados. O "problema de precisão" era, em grande parte, um problema de tamanho e de acesso a dados. É exatamente para isso que serve a análise de erros: ela impede que você gaste um mês reescrevendo artigos de ajuda quando a correção real é "mantenha em três frases" e "conecte o sistema de pedidos".
Os seis lugares onde uma resposta de suporte dá errado
Toda resposta errada tem uma primeira falha. O truque é parar na primeira, porque tudo o que vem depois é consequência. Se a IA puxou o artigo errado, não importa que a resposta também estivesse longa demais.
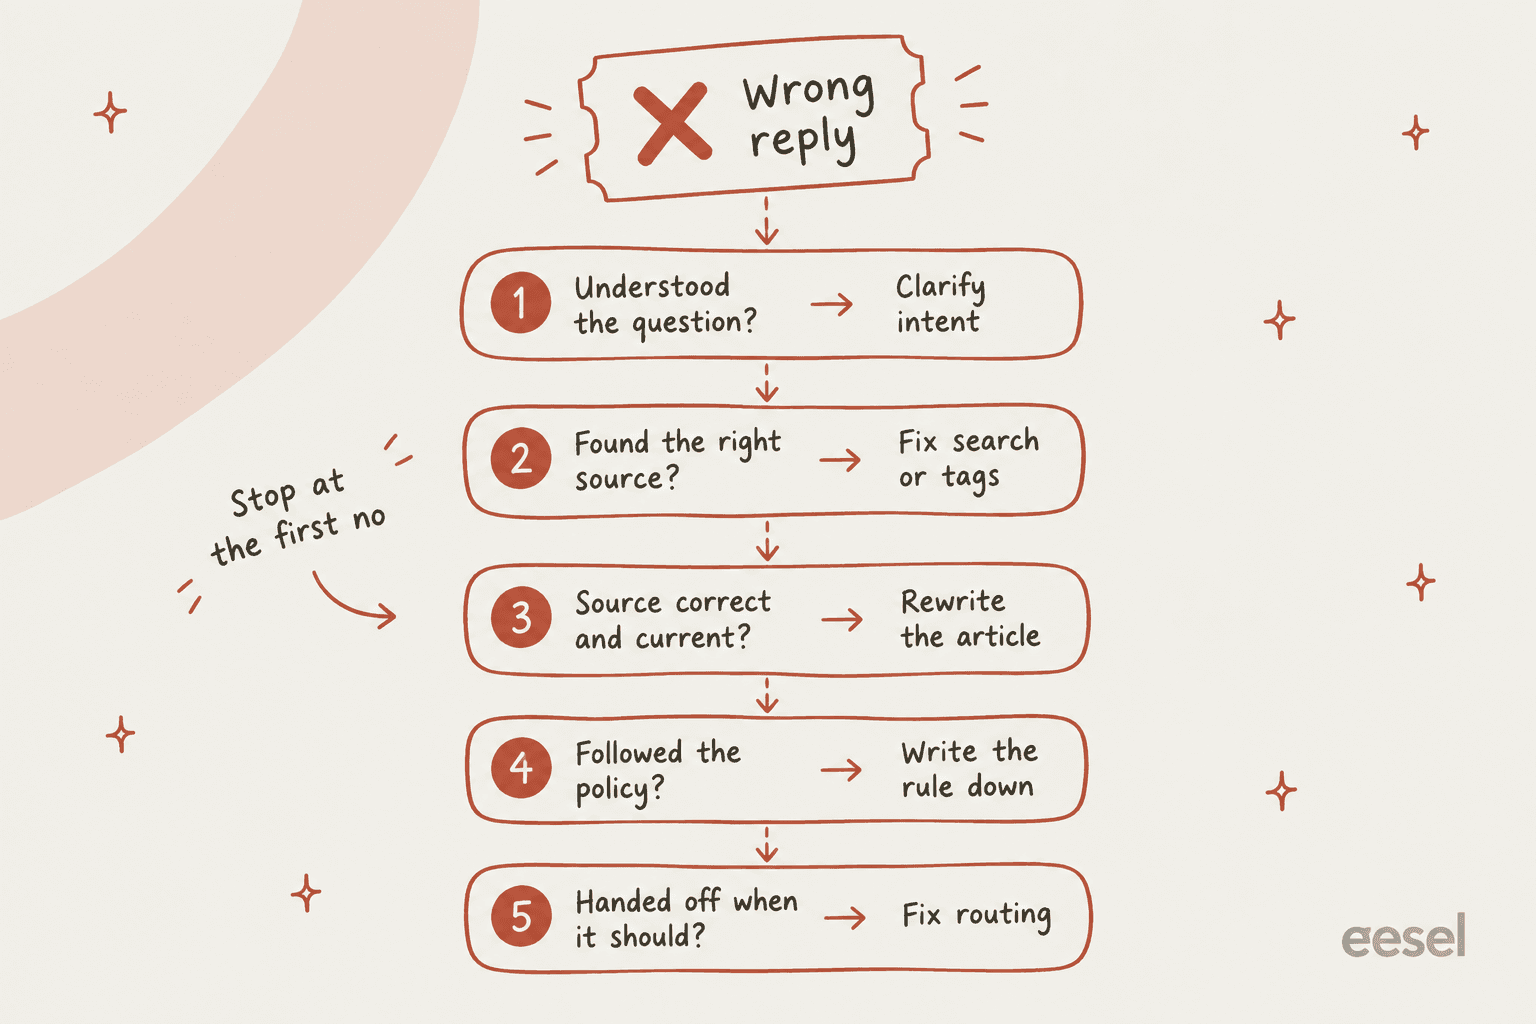
Uso seis grupos: os cinco pontos de verificação acima mais um sexto para respostas que estão corretas mas não funcionam. Escolha um grupo para ver como ele é, como identificá-lo e quem o corrige.
Repare que só o primeiro grupo trata de como a pergunta foi lida. Os grupos dois a cinco são sobre conhecimento, regras e roteamento, coisas que um líder de suporte pode mudar uma vez e resolver para todos. É por isso que a análise de erros compensa mais rápido do que fazer coaching individual: a correção de um artigo pode barrar o mesmo erro em todos os agentes e na IA ao mesmo tempo.
Como fazer uma análise de erros no atendimento ao cliente em 7 passos
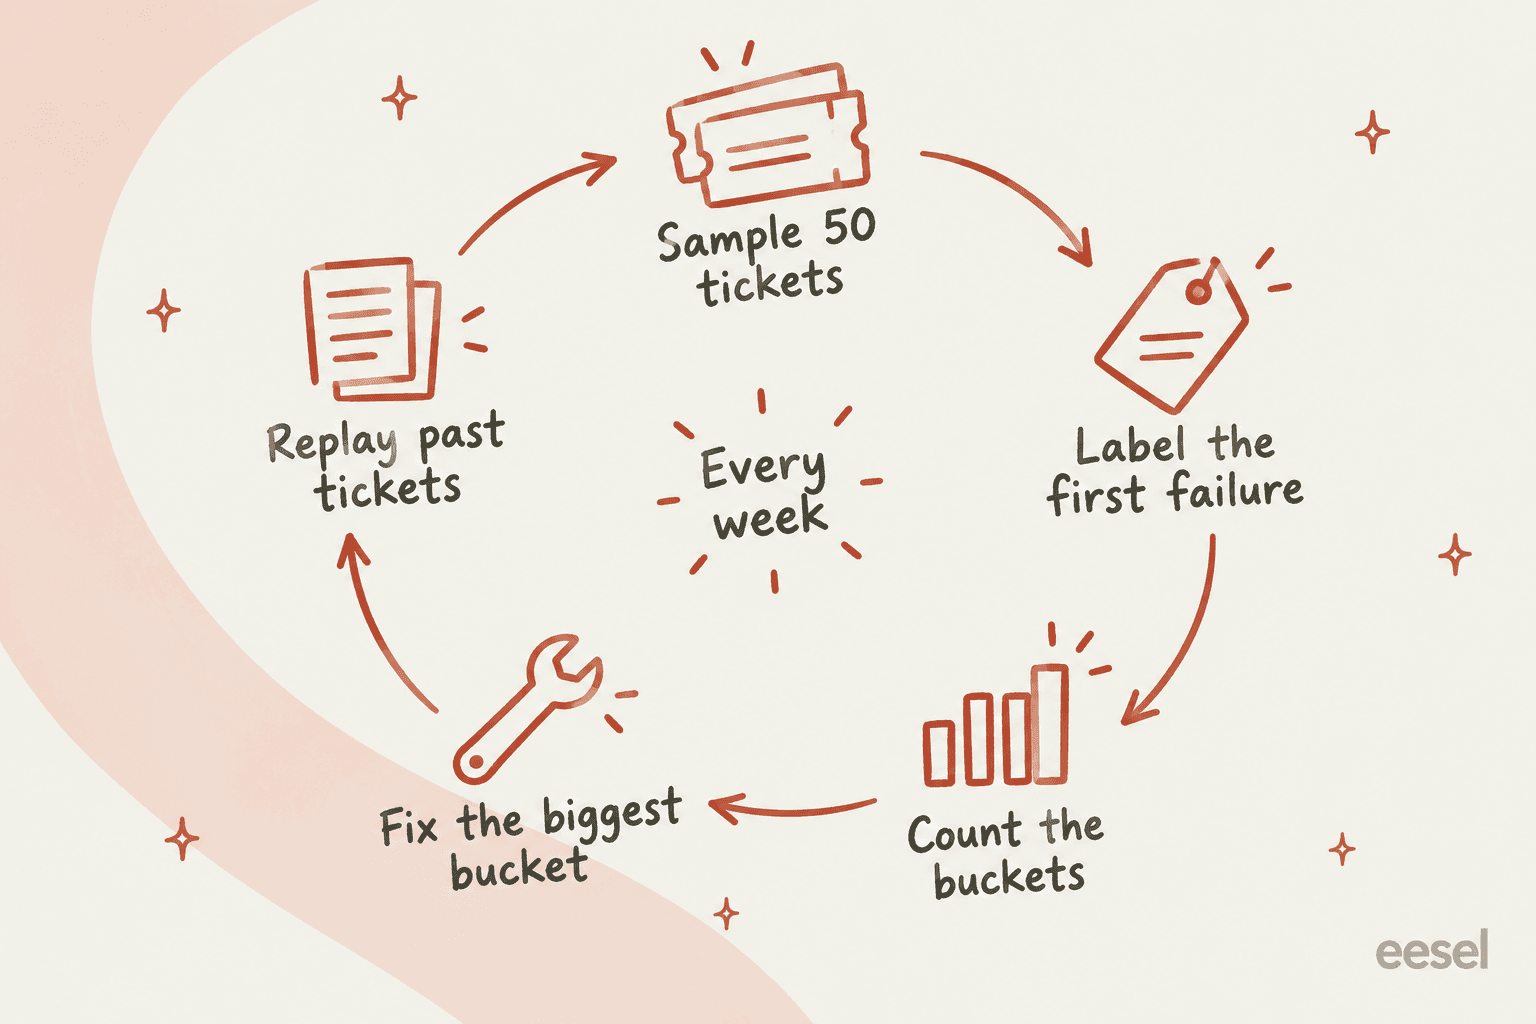
Você consegue fazer a primeira rodada em cerca de duas horas. Depois disso, é um hábito semanal de 30 minutos.
- Puxe as falhas, não uma amostra aleatória. Tickets reabertos, CSAT ruim, escalonamentos vindos da IA, tickets em que um agente rejeitou ou reescreveu um rascunho de IA e contatos repetidos em poucos dias. O Zendesk Explore tem as métricas Reopens e One-touch tickets para isso, e meu guia da métrica de tickets reabertos mostra como filtrá-los.
- Pegue 50. Menos, e uma semana atípica distorce tudo. Mais, e ninguém termina. Se o seu volume for baixo, pegue tudo do último mês.
- Leia cada um e classifique a primeira falha. Use os seis grupos acima. Um rótulo por ticket. Se não conseguir decidir em 30 segundos, marque como "incerto" e siga em frente.
- Conte os grupos. Este é o passo que muda opiniões. "A IA é ruim" vira "14 de 50 eram o mesmo artigo desatualizado de devoluções".
- Corrija o maior grupo na origem. Reescreva o artigo, escreva a regra nos seus SOPs de suporte, mude o roteamento. Dê a cada correção um responsável e uma data.
- Reexecute tickets antigos para verificar a correção. Passe o mesmo tipo de pergunta de volta pelo seu agente ou pela sua IA e veja se a resposta mudou. Não fique apenas esperando os tickets da próxima semana.
- Repita toda semana e acompanhe a distribuição dos grupos. Um programa saudável vê o grupo principal encolher e um novo tomar o lugar dele.
O primeiro passo é onde a maioria das equipes falha em silêncio, porque a métrica óbvia mente. Um ticket que a IA "resolveu" ainda pode ser uma falha:
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
A própria documentação do HubSpot diz o mesmo: deflexões "do not always indicate resolution", já que o cliente pode simplesmente ir embora (base de conhecimento do HubSpot). Então cruze as conversas do bot com os tickets de acompanhamento do mesmo cliente antes de confiar em qualquer taxa de resolução. Meu post sobre como medir a deflexão com IA cobre esse cruzamento.
Para o passo quatro, uma contagem simples basta no início. Um gerente de TI no Reddit descreveu exatamente isso: contar quantos tickets remetem à mesma causa e ligar os pontos, sem obrigar a equipe a passar por um "5 porquês" completo toda vez. Quando os grupos estiverem estáveis, leve-os para o seu helpdesk como tags ou causas raiz de QA para que a contagem aconteça sozinha. Meu guia de análise de tickets de suporte tem um modelo para a planilha de contagem.
Como analisar erros de um agente de suporte com IA
A análise de erros em um agente de IA é mais fácil do que em pessoas em um ponto importante: a IA pode mostrar o seu trabalho. Você vê o que ela pesquisou, o que encontrou e por que escolheu a resposta. Isso você nunca teria de um agente humano no fim de um turno longo.
A pegadinha é que você precisa realmente ler. Um comentarista do Hacker News que constrói agentes defendeu fazer isso à mão, mesmo quando você tem pontuação automática:
"there's still a huge benefit in looking at traces yourself and labeling them. It's time-consuming, yes, but you'll learn a lot about the ways an agent fails in your particular domain, it gives you more reliable golden datasets, you have a mechanism to evaluate your judges, etc."
Ao ler rastros de IA, os seis grupos continuam valendo, mas as evidências são diferentes:
- Pergunta mal interpretada: a intenção ou o caso de uso declarado pela IA não corresponde à pergunta do cliente.
- Fonte errada: a lista de fontes mostra um artigo próximo, mas errado.
- Fonte ruim ou ausente: a IA citou o artigo certo e o artigo está errado, ou não encontrou nada e respondeu mesmo assim. Esse segundo caso é a versão perigosa. Quando a recuperação volta vazia, um modelo pode preencher a lacuna com conhecimento geral. Em uma configuração da eesel para uma equipe de telemática veicular no Zendesk, o bot confirmou suporte a modelos de carro que não estavam no banco de dados do produto, porque a central de ajuda dizia "damos suporte a todos os modelos".
- Política não seguida: a regra existe na cabeça da sua equipe, mas não nas instruções da IA.
- Deveria ter transferido: a conversa tocou num tema da sua lista de transferências, ou deveria estar nela, e continuou. Meu guia de transferência da IA cobre o que deve entrar nessa lista.
Um aviso por experiência: não parta direto para trocar o modelo. Simon Willison perguntou no HN a coisa certa: se você troca de modelo sem avaliações, "how will you tell if the model switch actually helped?" E muitas vezes o modelo nem é o problema. Outro comentarista observou que equipes que culpavam o LLM descobriram que "upstream calls to services that produce data" eram a causa real. No contexto de suporte: a consulta do pedido não retornou nada, então a IA chutou. Esse é o grupo de 20% do teste acima.
Se a sua IA redige rascunhos para os agentes em vez de responder diretamente, cada rascunho rejeitado ou reescrito é dado gratuito de análise de erros. Trate a edição como um rótulo. Meu guia sobre como treinar um agente de suporte com IA cobre como devolver essas edições ao sistema.
O que cada helpdesk mostra quando uma resposta dá errado
Todos os grandes helpdesks já oferecem alguma forma de ver por que a IA respondeu como respondeu. Eles diferem bastante no que mostram e em você poder ou não testar uma correção contra tickets antigos.
| Helpdesk | Onde você vê o "porquê" | Fontes mostradas por resposta? | Códigos de motivo integrados | Testar uma correção contra o histórico? | Requisito | Fonte |
|---|---|---|---|---|---|---|
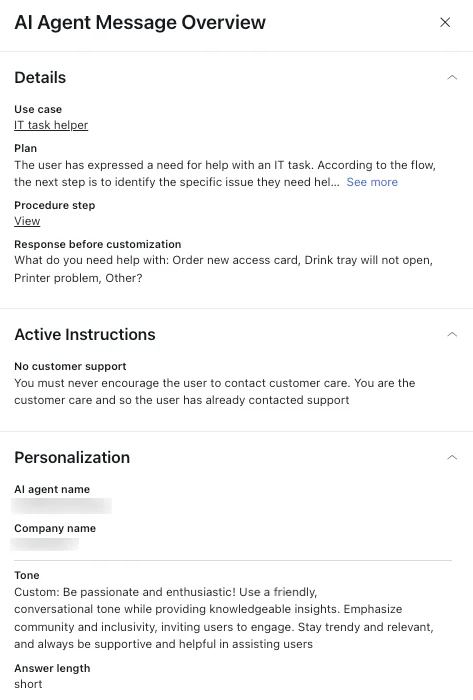
| Zendesk | Logs de conversa: por mensagem Plan, Response before customization, instruções ativas | Por conversa (Resources used), não por artigo em respostas simples de conhecimento | Resoluções personalizadas incl. Unresolved, Escalation failed; causas raiz de QA com níveis | Não documentado em lote | Logs em todos os planos Suite; QA exige o complemento QA ou WEM | Documentação do Zendesk |
| Freshdesk | AI Agent Studio Analyze: aba Improve, Knowledge usage, Ticket logs | Answer Source em testes; contagens por fonte de respostas e feedback | Tipos de Improve: New content, Edit content | Aba Test: até 100 consultas digitadas ou geradas | Growth, Pro, Enterprise | Documentação do Freshdesk |
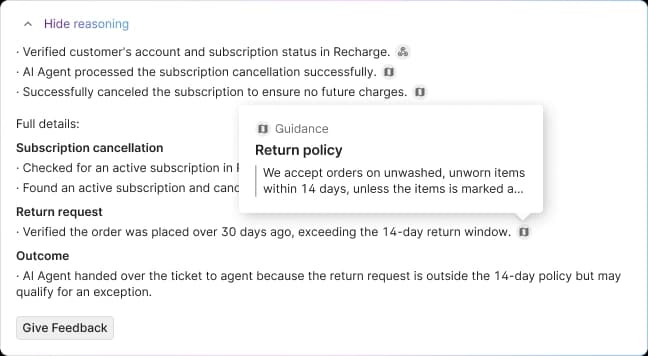
| Gorgias | Show reasoning sob cada mensagem da IA; aba AI Feedback | Sim, com polegar para cima ou para baixo por fonte | Menu "What went wrong"; 3 motivos de transferência; Opportunities: Fill knowledge gap, Resolve conflict | Um ticket existente por vez | Feedback exige Lead ou Admin | Documentação do Gorgias |
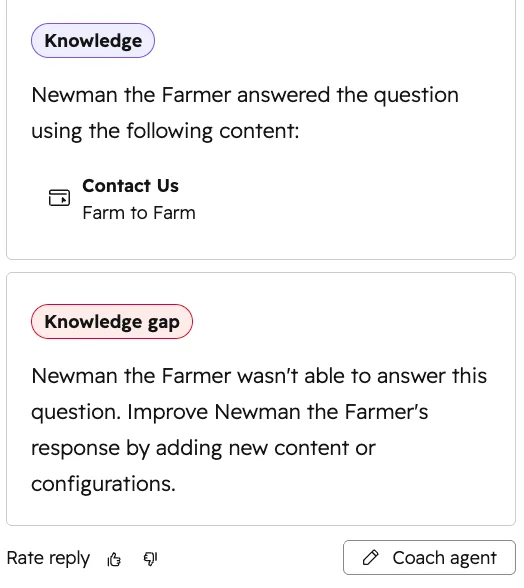
| HubSpot | Coaching opportunities; agent insights no Help Desk | Sim, fontes de conhecimento citadas por resposta | Reason: Knowledge, Handoff, Experience, Action, Other | Não documentado | Pro ou Enterprise mais HubSpot Credits | Documentação do HubSpot |
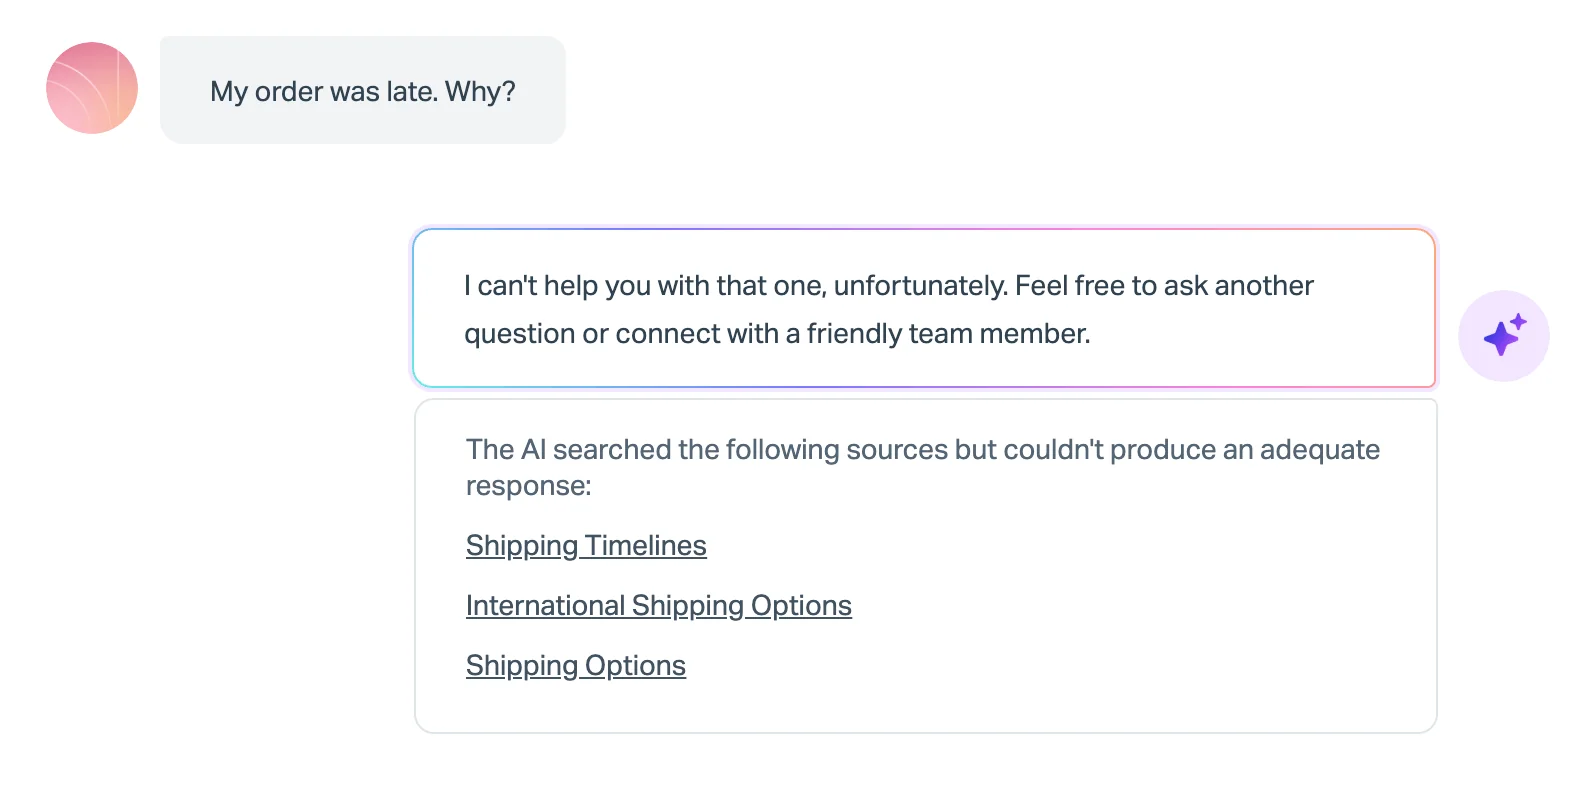
| Help Scout | Aba Beacon Sessions, Improvements | Só quando a IA falha ou pede esclarecimento (Attempted Sources) | Contact helped, Contact not helped, Human escalation | Não documentado | Todos os planos pagos, $0.75 por resolução de IA | Documentação do Help Scout |
| Front | Hub de respostas de IA (AI replies hub) | Sim, com o trecho exato extraído de cada fonte | Não documentado para transferências de IA | Uma conversa existente por vez | Complemento Copilot ou Autopilot; Smart QA $20/seat/month | Documentação do Front |
Todos os recursos e requisitos foram conferidos na documentação de cada fornecedor em outubro de 2026.
A visão por mensagem do Zendesk é a mais detalhada para seus procedimentos generativos. O campo Plan mostra o raciocínio da IA, e Response before customization mostra o texto antes de a sua persona e as instruções serem aplicadas, o que diz se uma resposta ruim veio do raciocínio ou das suas configurações de tom:
O Gorgias torna o raciocínio legível para qualquer função, o que importa mais do que parece. Quando os agentes veem por que a IA transferiu ou respondeu, eles podem relatar a causa em vez de apenas "o bot errou":
O HubSpot rotula cada resposta da IA com o que ela usou, ou a sinaliza como lacuna de conhecimento. Esse rótulo é basicamente o grupo três, já feito para você:
O Help Scout só mostra fontes quando a IA falha, mas para a análise de erros esse é justamente o momento em que você as precisa. Uma resposta que pesquisou três artigos de envio e ainda assim não conseguiu responder "meu pedido atrasou, por quê?" aponta para um artigo ausente, não para um modelo ruim:
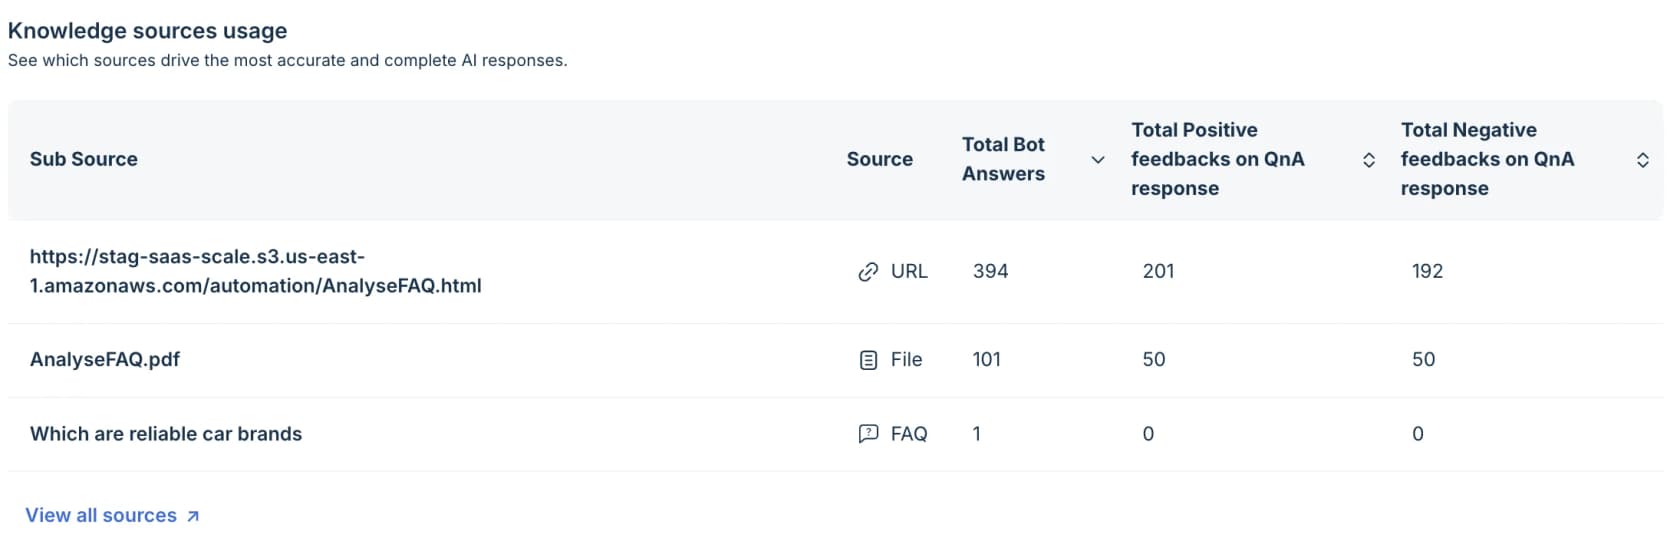
A tabela Knowledge usage do Freshdesk é a melhor visão integrada para o grupo dois. Ela conta quantas vezes cada fonte foi usada em respostas do bot, ao lado do feedback positivo e negativo. A orientação do próprio Freshdesk é que uma fonte citada com frequência e com uma proporção alta de negativos para positivos é o seu principal alvo de revisão de conteúdo:
Duas coisas para saber antes de confiar em qualquer uma delas. Primeiro, o Root Cause Analysis do Freshdesk, apesar do nome, explica picos de volume de tickets com um mapa em árvore, não respostas erradas individuais, e é apenas Enterprise. Segundo, a coluna "testar uma correção" é o ponto fraco em todos. Gorgias e Front permitem reexecutar um ticket existente por vez, e o Freshdesk testa perguntas digitadas ou geradas. Isso é útil para checagens pontuais, mas não diz se a correção da semana passada moveu a taxa de erro em 50 tickets reais.
Onde registrar as causas raiz para poder contá-las
Ler rastros encontra a causa. Contar exige que a causa seja armazenada em algum lugar sobre o qual você possa gerar relatórios. Estes são os melhores lugares integrados que encontrei.
Causas raiz do Zendesk QA. Os revisores podem adicionar uma causa raiz opcional ao pontuar uma categoria, escolhida de uma lista que você define, organizada em níveis e subníveis e reportada em painéis. Ela foi feita para avaliações negativas, que é exatamente a amostra da análise de erros. Exige o complemento QA ou WEM. Meu resumo do Zendesk QA e o guia de critérios de scorecard cobrem a configuração.
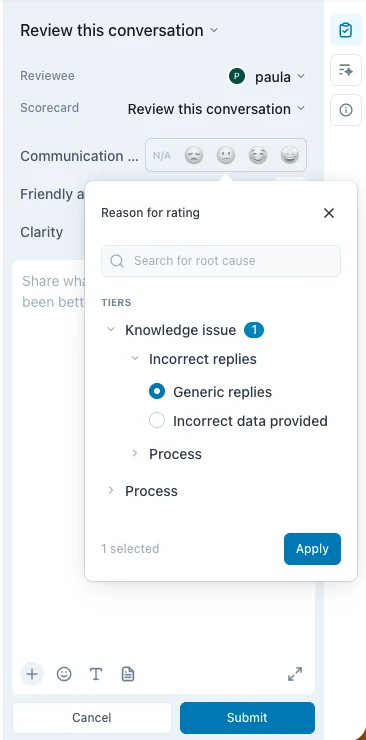
Eu configuraria níveis que correspondam aos seis grupos, com subníveis para os seus casos mais comuns ("Fonte ruim ou ausente > Devoluções", "Fonte ruim ou ausente > Envio"). O Zendesk QA também pontua agentes de IA em scorecards e tem um painel BotQA para taxas de escalonamento e repetição do bot, embora só aceite bots instalados pelo Zendesk Marketplace.
Coaching opportunities do HubSpot. Cada uma traz um Reason (Knowledge, Handoff, Experience, Action, Other) e um Type, incluindo Knowledge gap, Knowledge conflict e "Flagged by Help Desk rep". É o conjunto mais completo de códigos de motivo integrados que encontrei, e se encaixa bem nos grupos três e cinco.
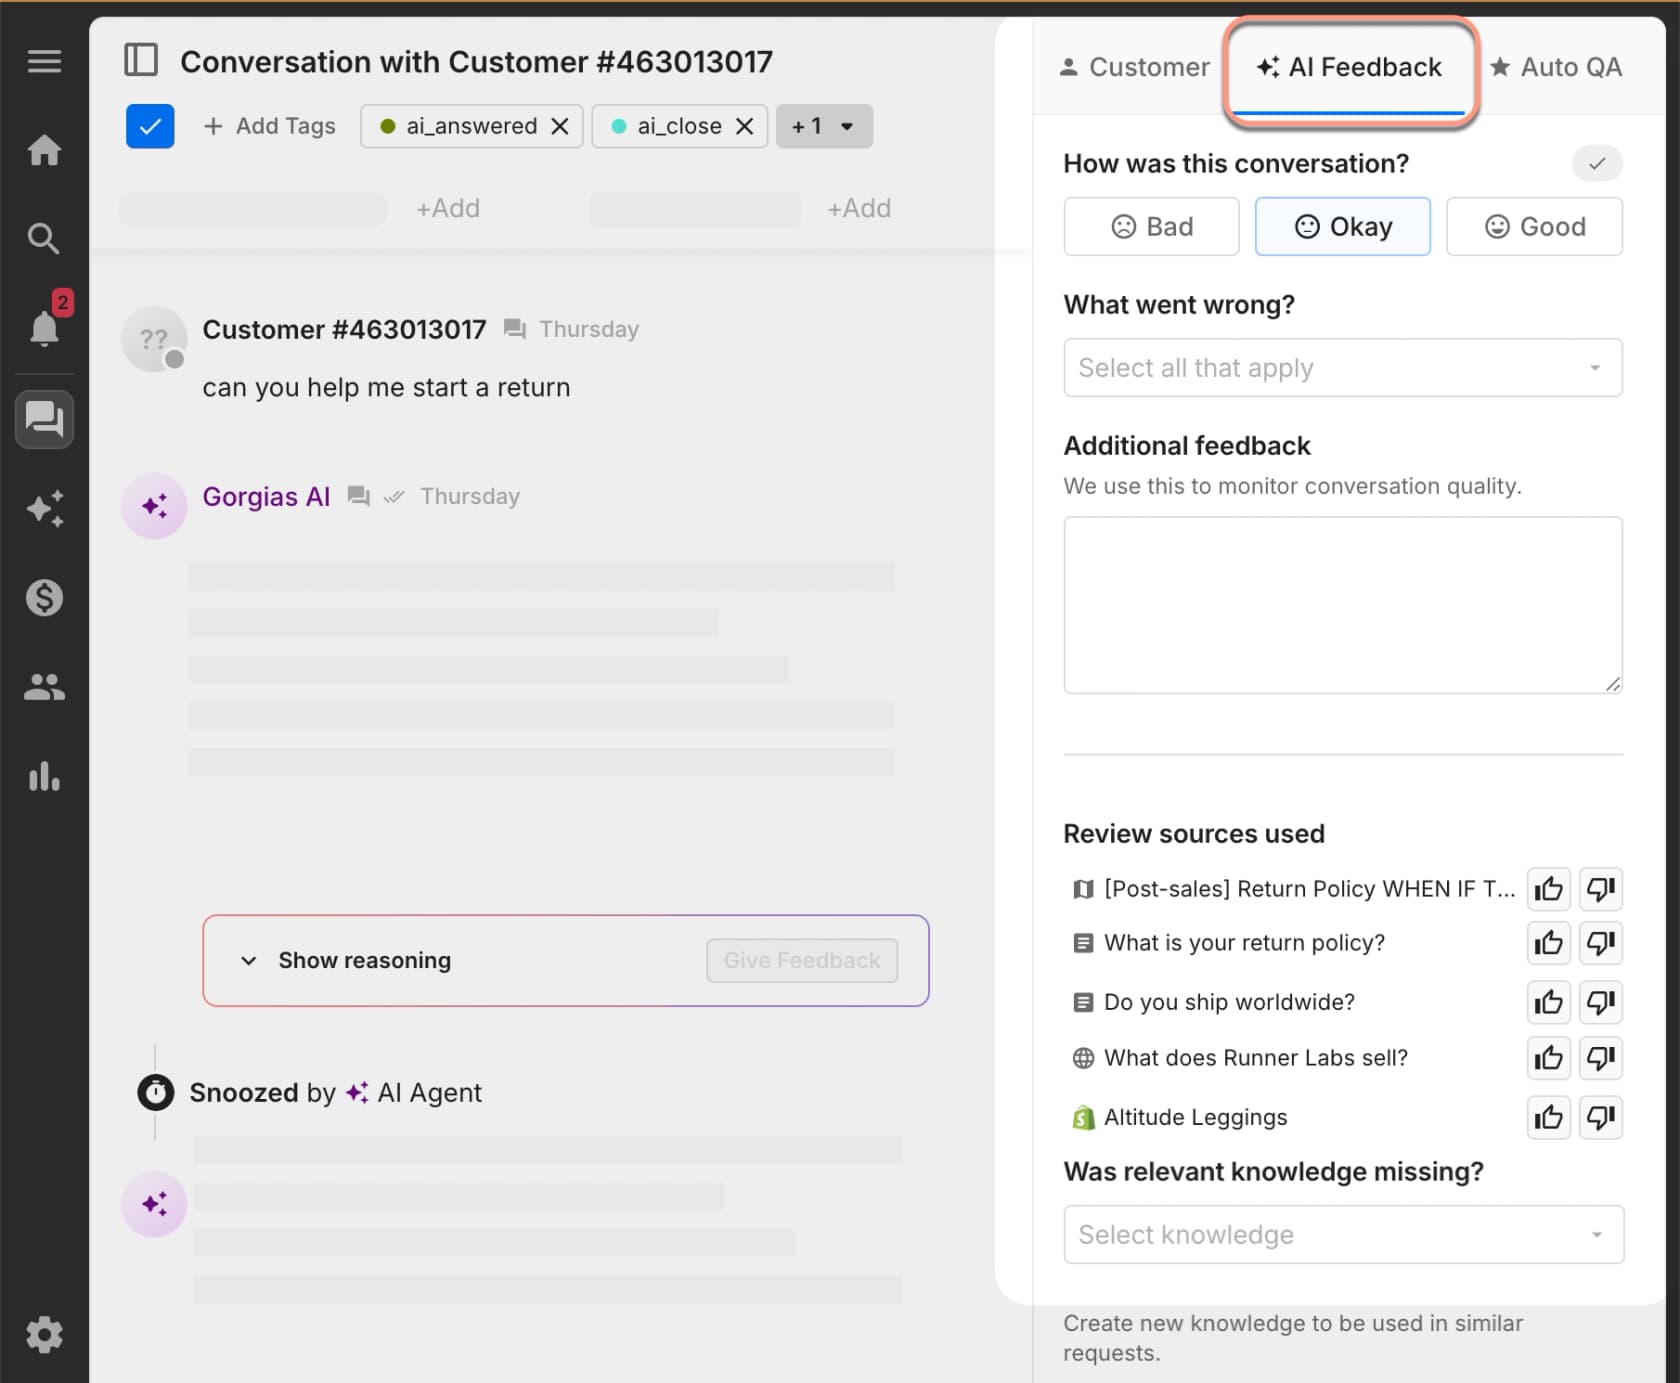
AI Feedback do Gorgias. Em uma avaliação Bad ou Okay, os leads escolhem numa lista "What went wrong", dão polegar para cima ou para baixo em fontes individuais e podem apontar o conhecimento que deveria ter sido usado:
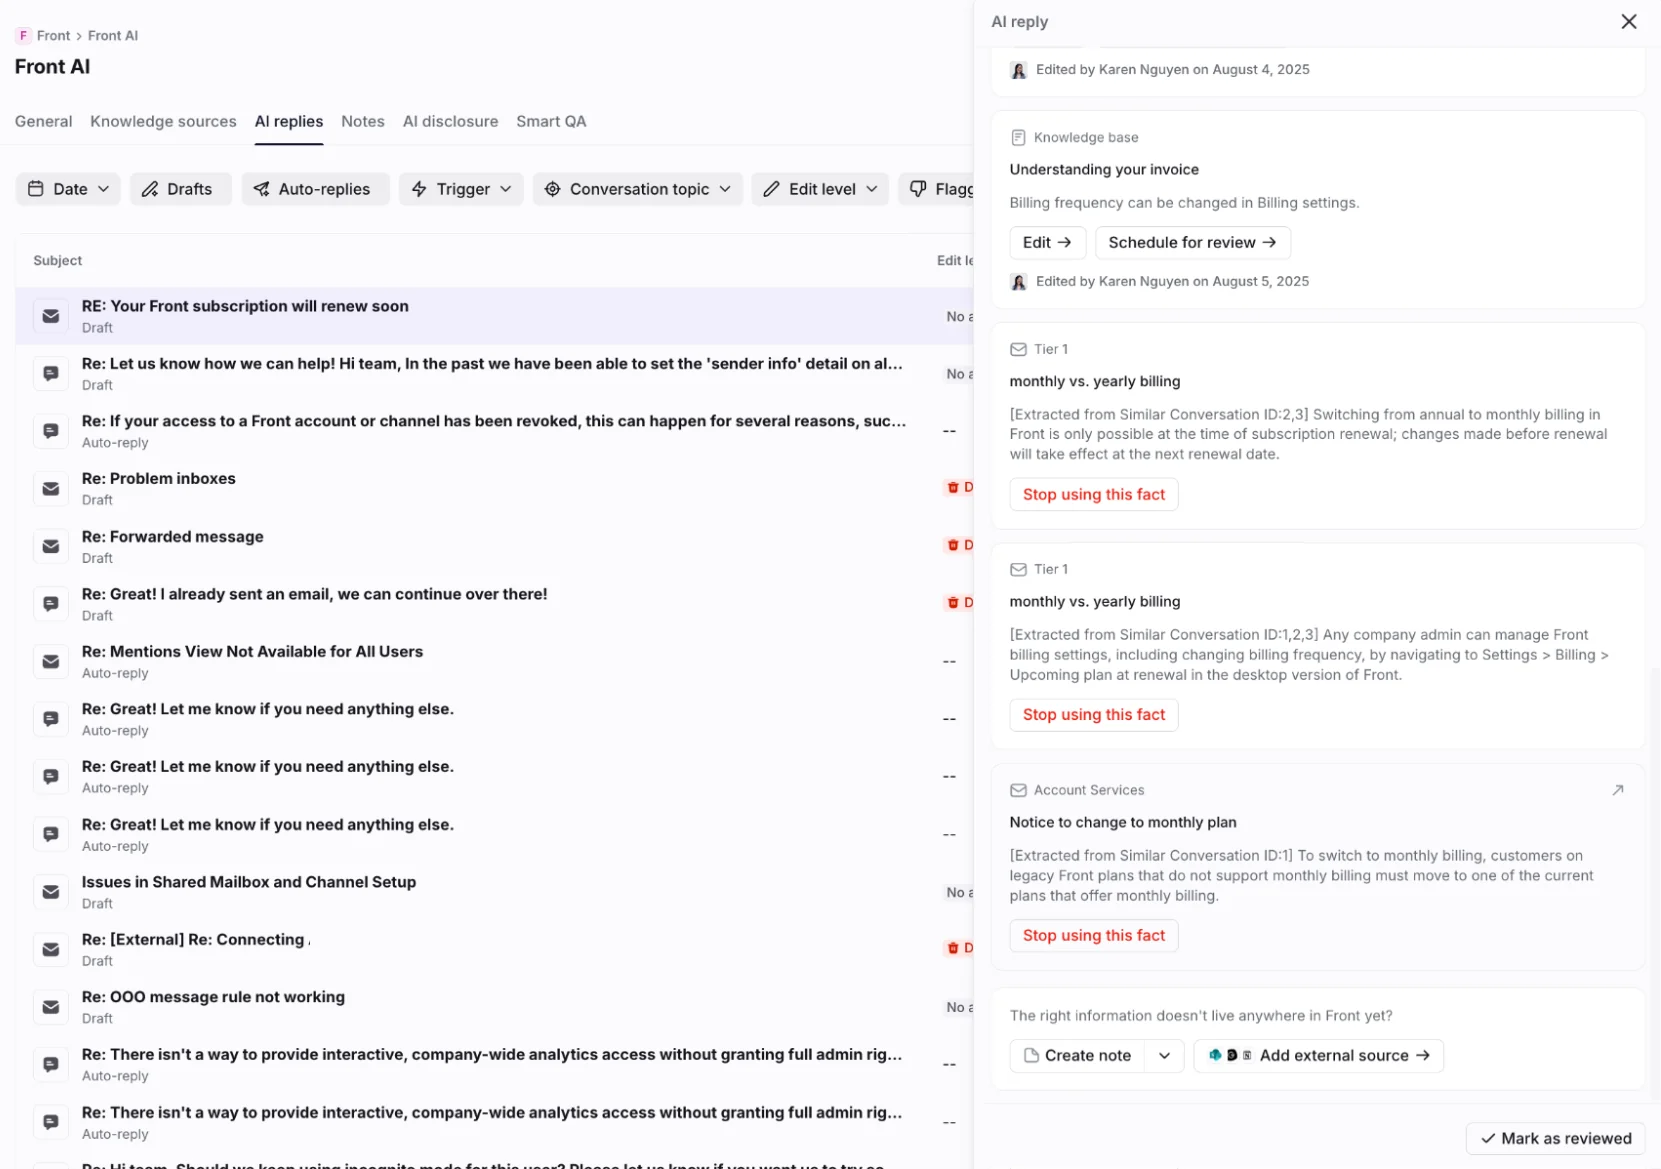
Hub de respostas de IA do Front. Não é um código de motivo, mas é o caminho de correção mais rápido que já vi: cada fonte por trás de uma resposta, com o trecho exato, e ações inline Edit, "Stop using this fact" e Create note.
Se o seu helpdesk não tem nada disso, uma tag de ticket por grupo funciona bem. Mantenha a lista curta. Seis tags são usadas; trinta são ignoradas. Meu guia de tags de suporte com IA mostra como aplicá-las sem adicionar cliques para os agentes.
Corrija o sistema, não a pessoa
A análise de erros só funciona se as pessoas contarem os erros. Isso acaba no momento em que ela vira uma forma de pegar gente no erro. Os agentes são claros sobre como isso é sentido:
"Hold hands up it was something I missed (or didn't consider) but the complaint feedback was otherwise good so it stung to get a fail rather than a learning and fix it"
Às vezes a própria métrica é a causa raiz. Um agente descreveu ser penalizado por esperas de mais de três minutos, quando confirmar a resposta certa leva três minutos ou mais:
"If I put them on hold that long, some get annoyed or escalate. Either way, I'm doomed: penalized if you placed the caller on hold for more than 3 mins or returned back to the caller and tell them you needed more time."
Se uma meta empurra as pessoas a responder antes de conferir, respostas erradas são o resultado previsível. Coloque "o KPI" na sua lista de grupos quando ele aparecer. Meu post sobre KPIs de atendimento ao cliente cobre quais deles saem pela culatra.
Nada disso significa que ninguém é responsabilizado. A distinção de que gosto vem de um tópico sobre revisões sem culpa: as pessoas são "still held to account for their decisions and actions but are not blamed for their results." Um agente que pulou o artigo deve ouvir isso. Um agente que seguiu um artigo errado deve receber um agradecimento por encontrá-lo.
Como é um bom ciclo na prática, segundo um agente cuja equipe acerta nisso:
"But where I work if an agent finds inaccurate information, requests information, or has figured something out that isn't in KB all we have to do is send a message to our supervisor and they pass it along to our head of sales, and the next day KB is updated."
Atualizações da base de conhecimento no dia seguinte. Essa é a meta. Combine com uma auditoria da base de conhecimento regular e uma análise de lacunas de conhecimento, e use sessões de feedback aos agentes para os erros que realmente são individuais.
O mesmo vale para uma IA. Um comentarista do HN disse, sobre o erro de um atendente humano, que queria "better training/docs so it doesn't happen again", e não alguém demitido. Trate a IA da mesma forma e encaminhe erros humanos repetidos para coaching em vez de advertências.
Como a eesel lida com a análise de erros
Eu construo agentes de IA na eesel, então serei específico sobre o que o nosso faz e não faz aqui.
Ele mostra o seu trabalho em cada ticket. Cada execução na página Activity da eesel mostra onde aconteceu, o que a disparou, quais fontes pesquisou, o que fez, o seu raciocínio passo a passo e se encontrou uma lacuna de conhecimento. No Zendesk, cada rascunho nomeia as suas fontes. Então classificar uma resposta errada leva um clique na execução, não um palpite.

Correções viram regras. Quando uma resposta está errada, você diz o que estava errado, no ticket ou no chat, e ele escreve a correção nas suas próprias instruções, ou edita a regra existente se já houver uma que cubra o caso. Um administrador do Zendesk ensinou uma correção do grupo de política em duas linhas: "I have a rule in CS where we do not address a cancel or refund request when there is an issue attached to it." Depois, no rascunho seguinte: "This is incorrect. You have not provided troubleshooting steps yet." Essa regra agora vale para todos os tickets futuros, não só para aquele.
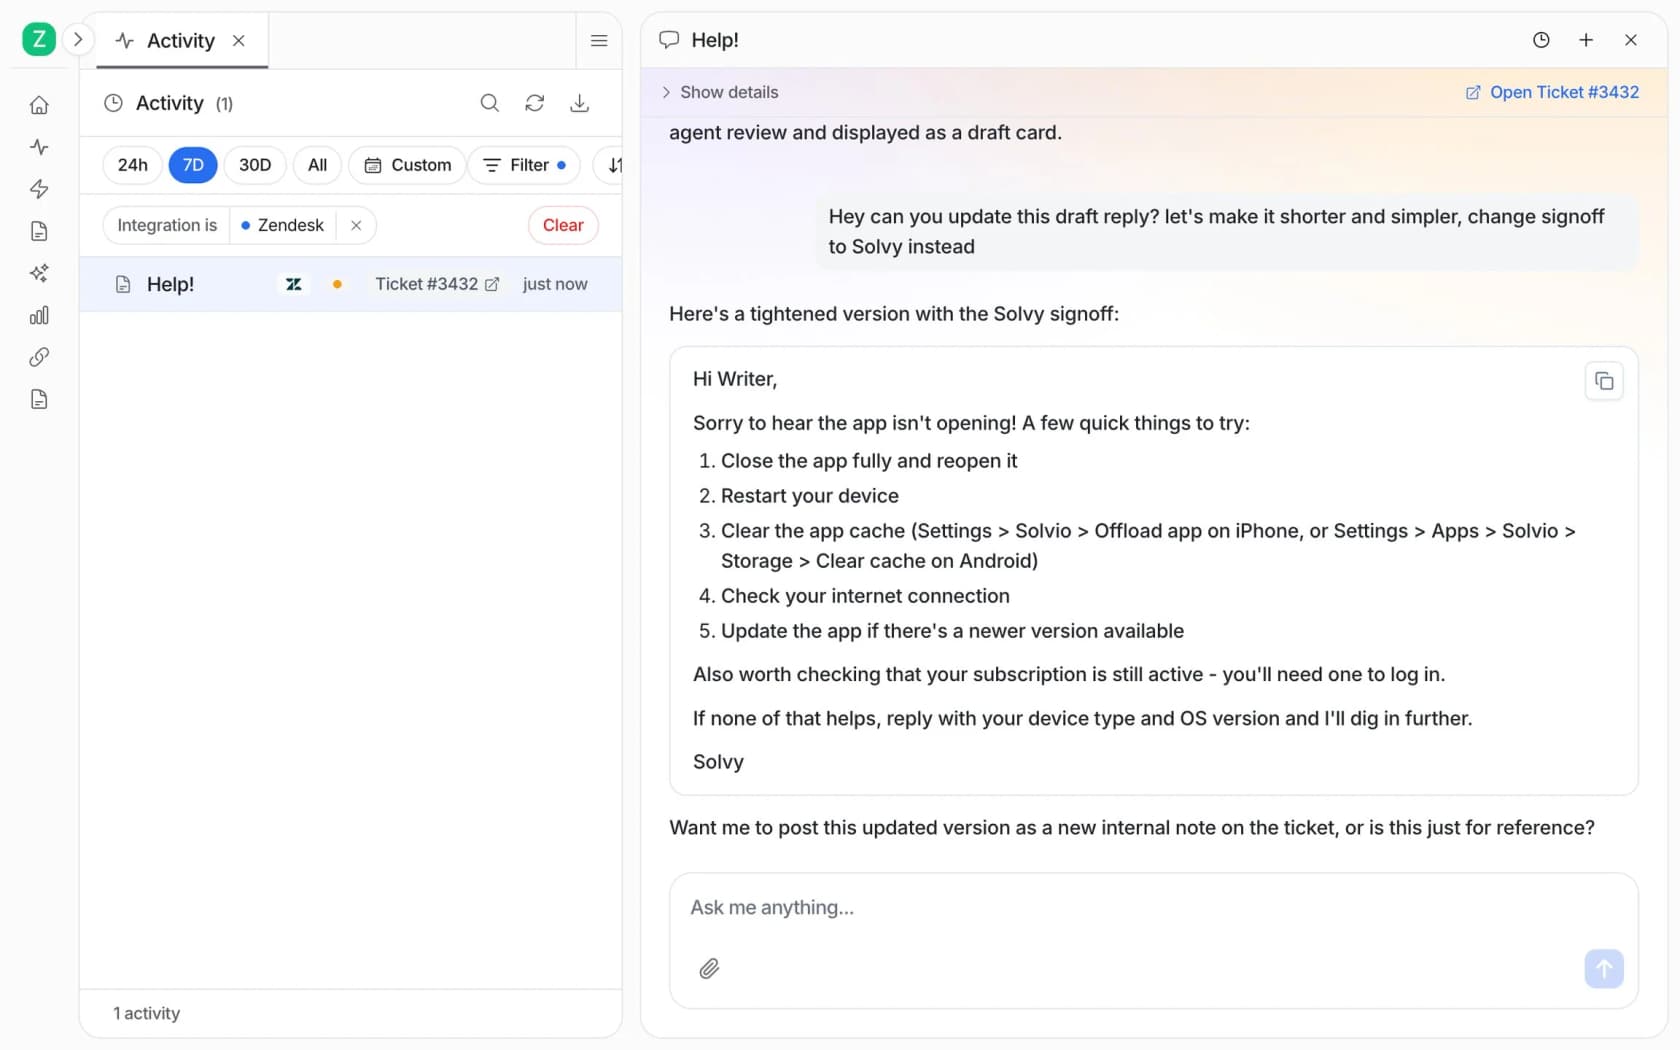
Ele encontra o padrão para você. A skill "Analyze and improve replies" examina o que a sua equipe rejeitou ou editou, encontra o padrão e sugere correções. Esses são os passos três a cinco do método acima, executados sobre os seus próprios dados.
Ele reexecuta tickets antigos reais. A skill de simulação roda o seu agente contra tickets reais já resolvidos, compara cada resposta com o que a sua equipe realmente enviou, pontua por tema de ticket e sugere mudanças nas instruções. No exemplo da documentação, em 20 tickets, 17 igualaram a qualidade de resposta da equipe, e o relatório descobriu que a lacuna real não era o texto, e sim as ações dos agentes, como consultar um log ou escalar para a engenharia:
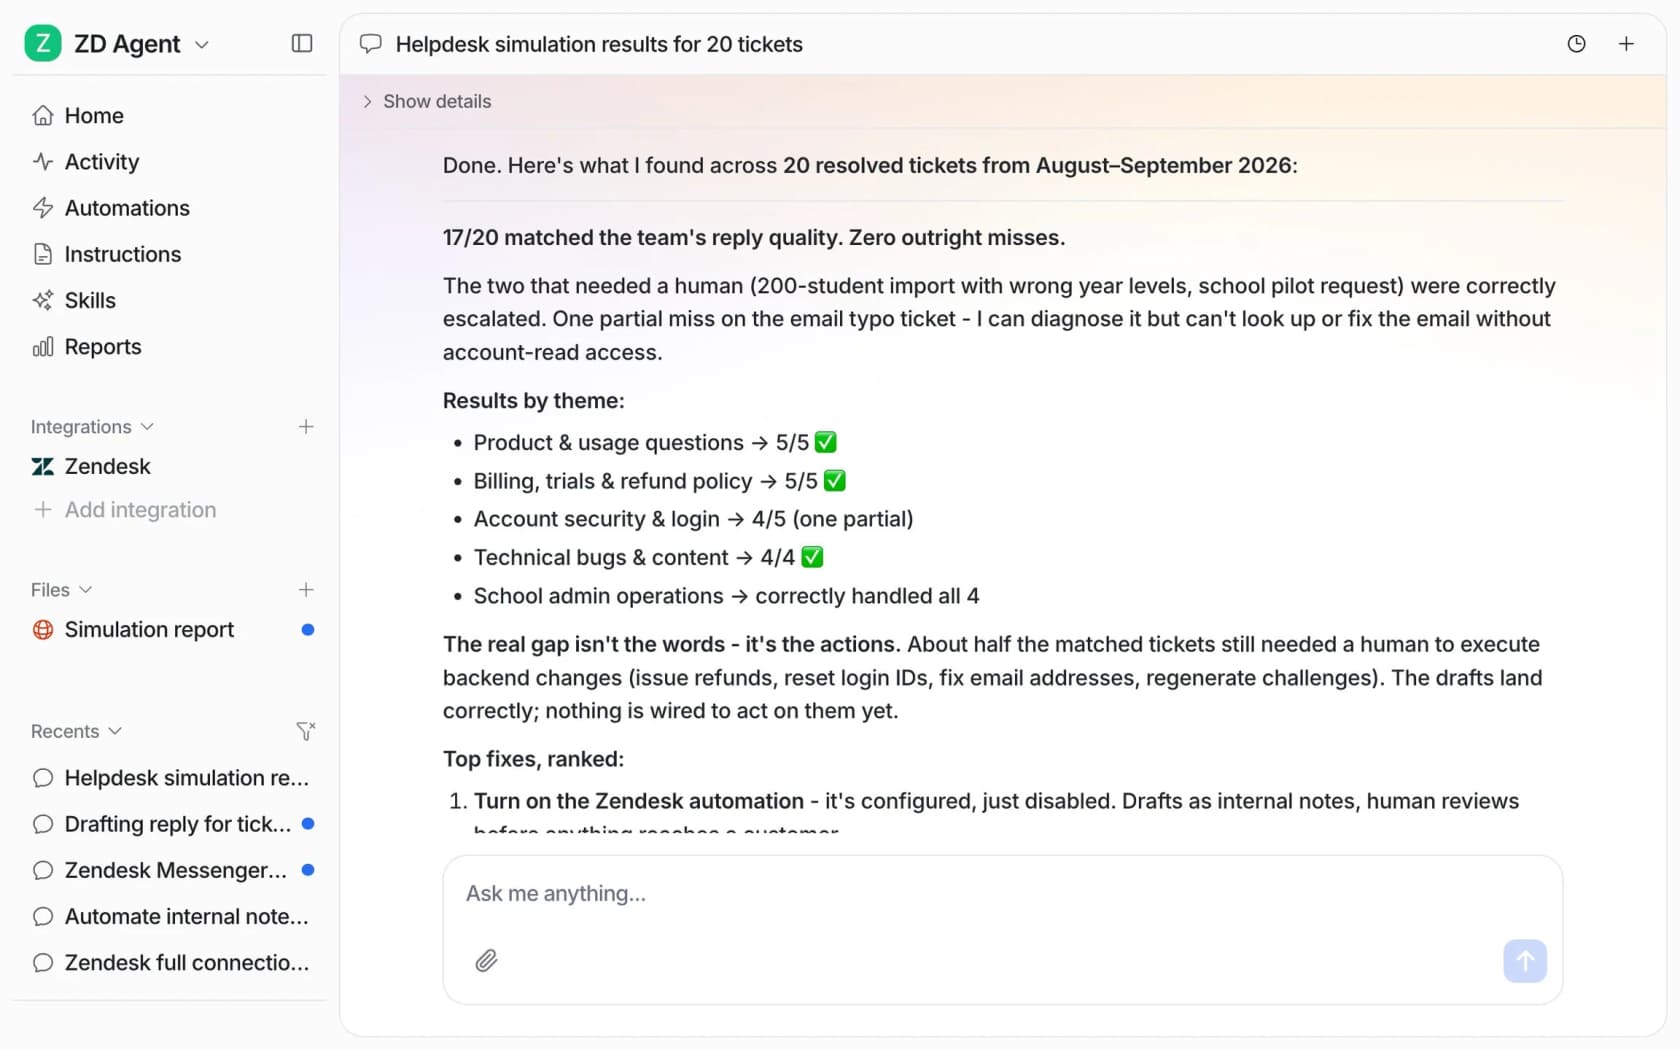
Esse é o passo que eu nunca pularia. É a única forma que conheço de verificar que uma correção funcionou em dezenas de tickets reais antes de os clientes verem. E se a sua equipe trabalha em terminal ou com scripts, a CLI da eesel permite corrigir o agente e imprimir suas regras atuais pela linha de comando, para que um agente de código também possa fazer a revisão semanal.
O que ele não é: um substituto para uma ficha de QA dos seus agentes humanos. O CSAT de IA dele é a nota que uma IA dá às respostas, não feedback de clientes, e eu manteria o seu programa de QA humano em paralelo. Meu resumo de ferramentas de QA de suporte cobre esse lado.
Faça a sua análise de erros com a eesel
Se a sua IA ou a sua equipe continua cometendo os mesmos erros, o colega de IA para helpdesk da eesel dá a você o rastro dos erros em um só lugar. Ele se conecta à sua fila existente do Zendesk, Freshdesk, Gorgias ou Help Scout, registra o que leu e por quê em cada ticket, transforma suas correções em regras permanentes e reexecuta tickets antigos reais para você ver uma correção funcionar antes de ela entrar no ar. Comece com rascunhos como notas internas, rode uma simulação nos tickets do mês passado e você terá a sua primeira contagem de grupos até o fim do dia. É grátis para testar com 100 créditos, e os planos pagos começam em $299 por mês na página de preços da eesel.