

Por que "resolvido" não significa "certo"
Passei os últimos dois anos trabalhando com busca na eesel, e poucos temas de suporte têm tanta intenção de compra quanto este. Ninguém pesquisa "how to train AI on past tickets" por curiosidade. Pesquisa porque está sentado em anos de histórico do helpdesk e acabou de perceber que é o registro mais detalhado de como a sua equipe trabalha. Treinar com tickets anteriores também é o pedido que aparece com mais consistência nas próprias ligações de vendas da eesel.
Mas há um porém. O status de um ticket diz que a conversa terminou. Não diz que o cliente recebeu a resposta certa, que a política citada ainda está em vigor ou que a resposta soou como o agente que você gostaria de clonar. Muitos tickets "resolvidos" foram fechados por uma regra de fechamento automático, reabertos uma semana depois ou respondidos por alguém no primeiro mês de trabalho.
A boa notícia é que o histórico ensina justamente aquilo em que a IA costuma ser pior de fábrica: soar como a sua equipe. Em um teste da eesel, uma marca de e-commerce de joias com cerca de 1.000 tickets por mês no Zendesk e Shopify, os agentes enviaram apenas 12% dos rascunhos da IA como estavam. Quando a equipe olhou o motivo, aproximadamente dois terços das reescritas eram sobre tamanho e tom, transformando rascunhos longos em respostas de uma a três frases, enquanto apenas cerca de 5% corrigiam um fato errado. É exatamente essa a lacuna que um conjunto selecionado das respostas enviadas pela sua própria equipe fecha.
Então o trabalho não é "treinar a IA com tickets anteriores". É "ensinar a IA com os seus melhores tickets anteriores e deixar o resto de fora". É o que este guia percorre, em seis passos. Se você ainda está decidindo de que dados precisa em geral, comece por de que dados você precisa para treinar uma IA e volte.
O que um único ticket anterior pode ensinar a uma IA
Antes de exportar qualquer coisa, ajuda ver que um ticket ensina várias coisas diferentes, e cada lição pertence a um lugar diferente.
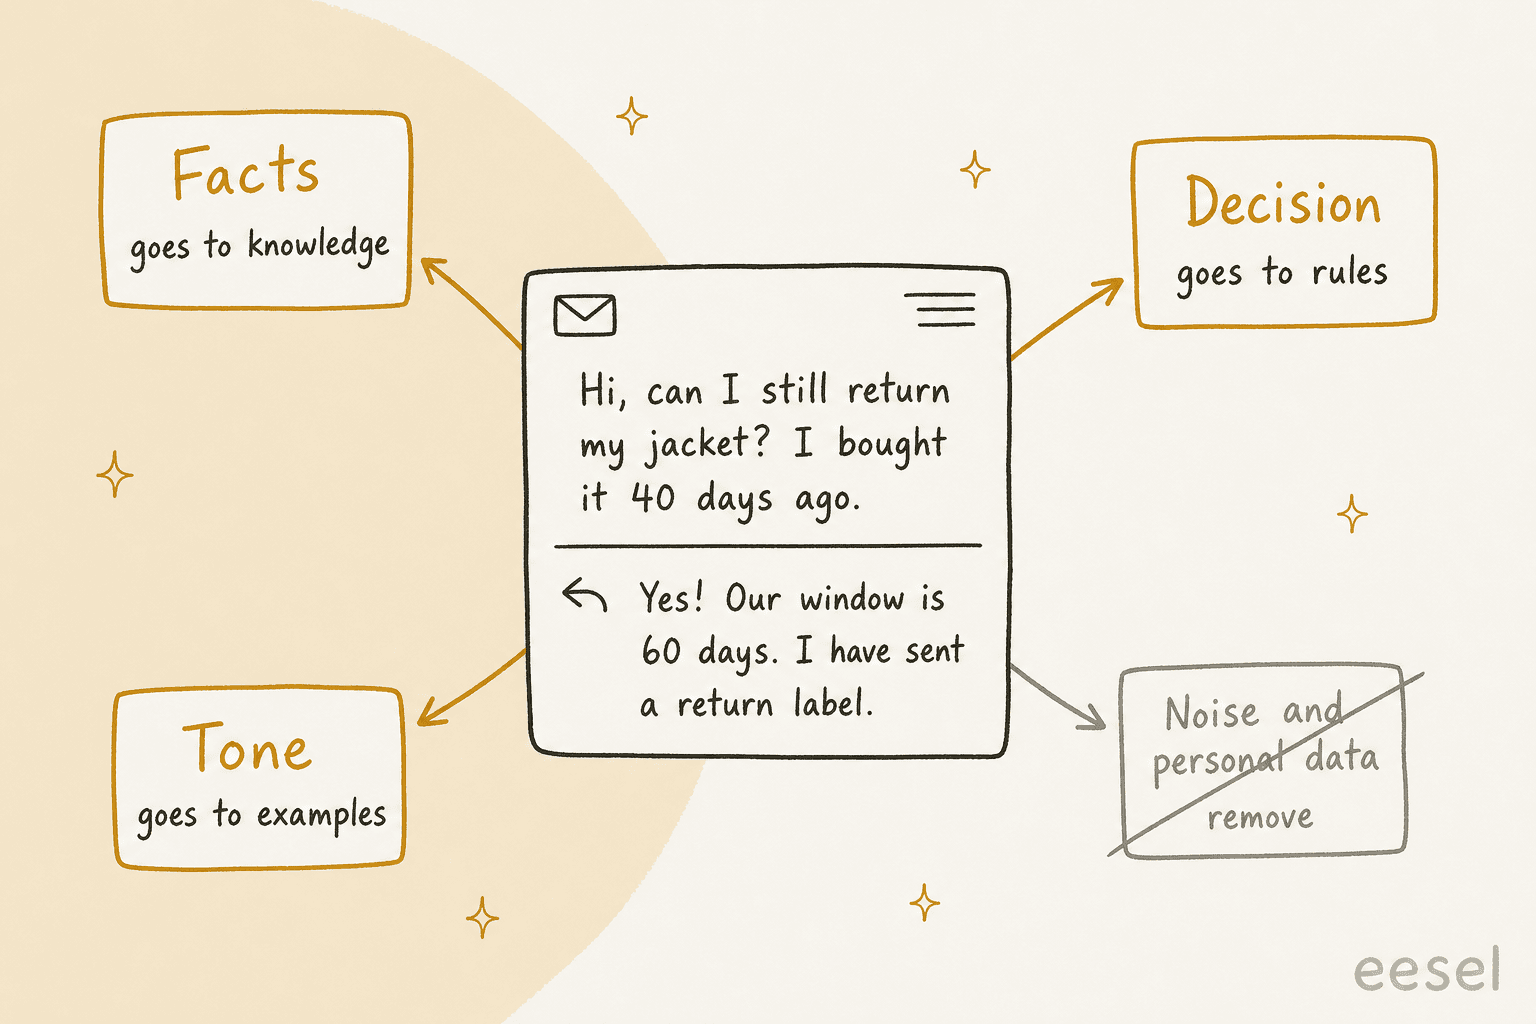
Pegue um pedido de devolução simples. A resposta do agente carrega:
- Um fato: o prazo de devolução é de 60 dias. Isso pertence à sua base de conhecimento, onde pode ser atualizado em um só lugar quando a política mudar.
- Uma decisão: este cliente tem direito, então envie uma etiqueta. Isso é uma regra ("dentro de 60 dias, sem uso, enviar etiqueta; fora do prazo, encaminhar"), e regras são mais seguras escritas do que deduzidas de centenas de exemplos.
- Tom: curto, caloroso, um ponto de exclamação, sem pedido de desculpas. Isso é o que as respostas de exemplo ensinam.
- Ruído: o nome do cliente, endereço, número do pedido, a assinatura do agente e uma nota interna. Nada disso deve chegar à IA.
Se você despeja o ticket inteiro em uma IA, ela aprende os quatro de uma vez e não consegue distingui-los. É assim que você acaba com um bot que cita um prazo de 30 dias de 2023 em uma voz perfeitamente amigável. A Gorgias expõe o risco com clareza: "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time" (documentação de conhecimento da Gorgias). Tickets antigos são a maior fonte desse tipo de conflito.
As três formas de usar tickets anteriores
Há três formas de transformar o histórico de tickets em comportamento de IA, e elas não são igualmente úteis.
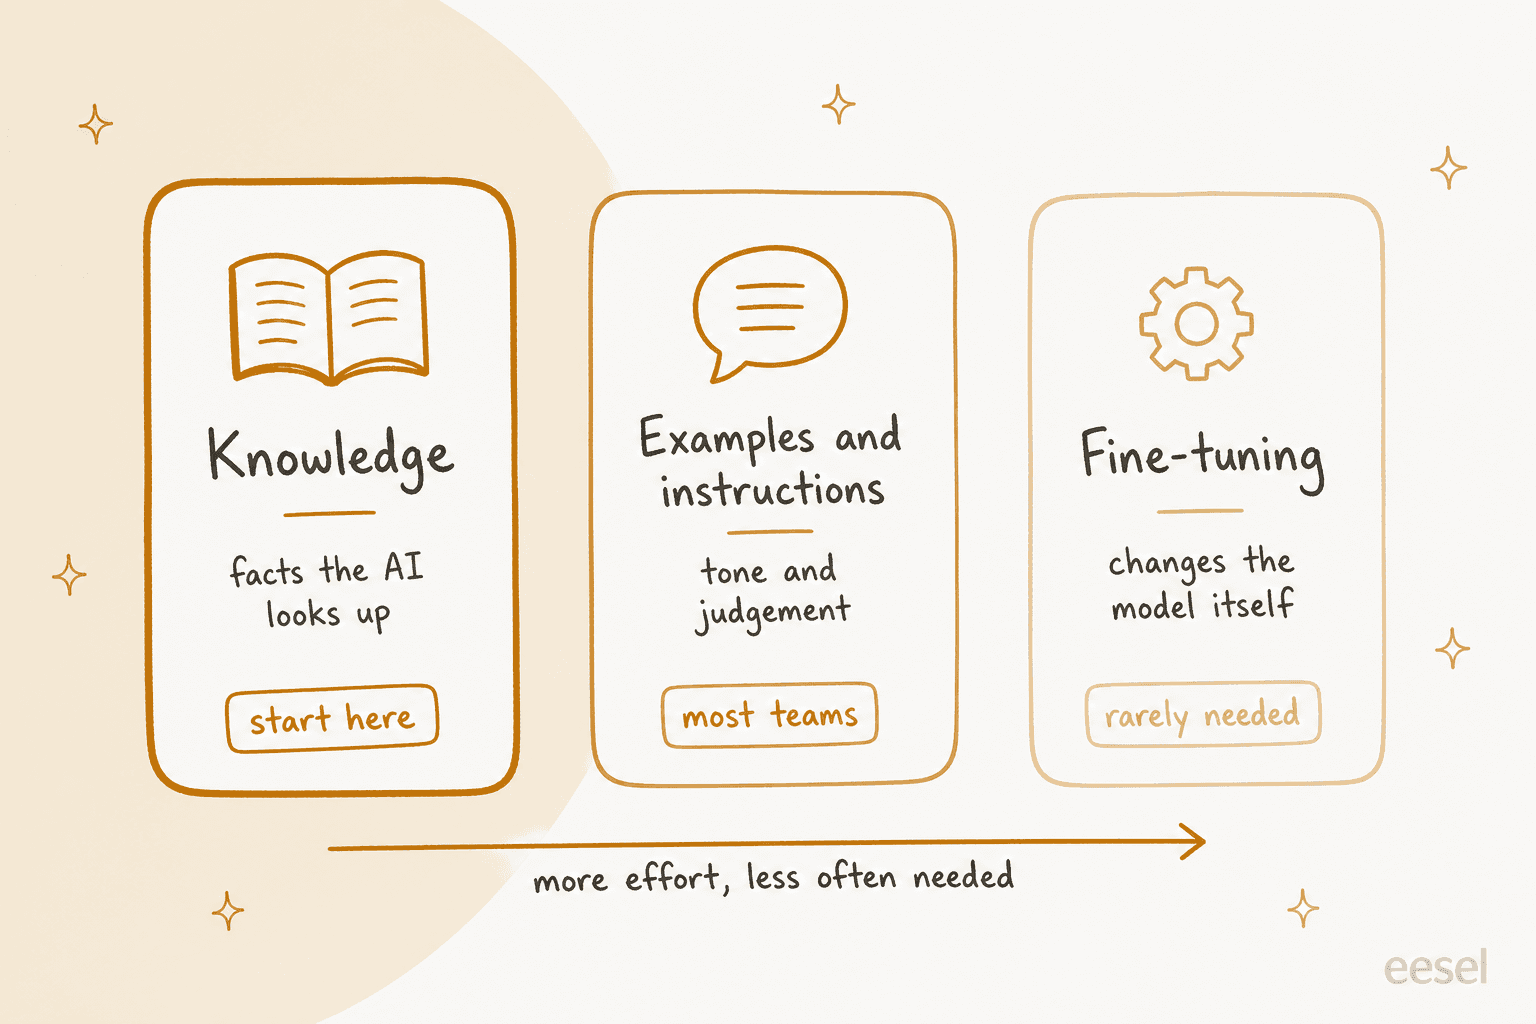
| Método | O que ensina | Como funciona | Esforço | Quando é a escolha certa |
|---|---|---|---|---|
| Extração de conhecimento e recuperação | Fatos, passos, políticas | Extrair respostas dos tickets, transformá-las em artigos ou perguntas e respostas, e deixar a IA consultá-las na hora de responder (RAG) | Baixo a médio | Sempre. É daqui que vem a precisão |
| Exemplos e instruções | Tom, tamanho, julgamento | Escolher algumas dezenas das suas melhores respostas como exemplos, escrever as decisões como regras | Baixo | Quase sempre. É daqui que vem o "soa como nós" |
| Fine-tuning | Formato e estilo em larga escala | Treinar os pesos de um modelo com milhares de conversas de exemplo | Alto | Raramente: volume muito alto, uma tarefa restrita e avaliações provando que o prompting não resolve |
A recuperação é onde mora a precisão. A IA busca na sua central de ajuda, nas suas macros e nas respostas de tickets já limpas quando chega uma pergunta, e responde a partir do que encontra. Quando uma política muda, você edita um artigo e a próxima resposta já está certa. Para a versão mais aprofundada deste argumento, veja RAG vs fine-tuning.
Exemplos e instruções são onde mora o tom. O próprio conselho do Freshdesk para o seu agente de e-mail é "Include examples of ideal responses in your instructions. The agent learns from concrete examples faster than it does from abstract rules" (configuração do agente de IA de e-mail do Freshdesk). Você não precisa de 10.000 tickets para isso. Precisa de 20 a 50 respostas de que os seus melhores agentes se orgulhariam.
Fine-tuning é aquilo sobre o que todos perguntam e de que quase ninguém precisa. A documentação da OpenAI indica o fine-tuning supervisionado como o melhor para classificação, tradução, formatos de saída fixos e "correcting instruction-following failures" (fine-tuning supervisionado da OpenAI). Aprender a sua política atual de reembolso não está nessa lista, porque fatos gravados nos pesos do modelo ficam desatualizados no dia em que a política muda. A documentação também diz "The prompt engineering process may be all you need" (otimização de modelos da OpenAI).
Um desenvolvedor no Reddit tentou mesmo assim, e o resultado é o retrato mais claro que encontrei do que o fine-tuning com tickets brutos realmente faz:
"So I pulled about 8k past tickets which were mostly about shipping, returns, account issues and product information and anonymized the sensitive data then set up a training run. The good news was that it picked up the brand tone and mirrored our macros, but it also prioritized weird quirks too often. Our old agent would write 'hey there' for nearly every tricket so this model started spraying it everywhere."

Eles acabaram voltando para um prompt de sistema rígido e uma camada leve de recuperação. O modelo aprendeu o tom e também o hábito de um agente, porque um fine-tune não distingue uma mania de uma política.
E há uma razão prática para pular isso agora. A OpenAI está encerrando o fine-tuning self-service: organizações que nunca tinham feito fine-tuning perderam o acesso em 7 de maio de 2026, e clientes ativos não podem criar novos jobs depois de 6 de janeiro de 2027 (descontinuações da OpenAI). Se você já é usuário, treinar um modelo gpt-4.1-mini custa $5.00 por milhão de tokens de treinamento, e o modelo ajustado passa a rodar a $0.80 de entrada e $3.20 de saída por milhão de tokens, o dobro da tarifa do modelo base (preços da OpenAI). Para saber mais sobre esse caminho, veja o guia da API de fine-tuning da OpenAI.
Não sabe de qual o seu problema precisa? Escolha o sintoma que você está vendo.
Escolha o sintoma que você está vendo para saber qual parte do seu histórico de tickets o resolve.
O que o seu helpdesk já faz com tickets anteriores
Antes de construir qualquer coisa, verifique o que o seu helpdesk faz por conta própria, porque a resposta varia mais do que o marketing sugere. Passei pela central de ajuda de cada fornecedor para que você não precise.
| Helpdesk | Aprende com tickets anteriores? | Como | Janela de consulta | Preço da IA (página do fornecedor) |
|---|---|---|---|---|
| Zendesk | Em parte | O auto assist usa tickets resolvidos semelhantes apenas quando nenhum procedimento ou artigo se encaixa; procedimentos e rascunhos da central de ajuda são gerados a partir de tickets resolvidos para você publicar | 90 dias para rascunhos gerados | Copilot $50/agente/mês no plano anual; agente de IA $1.50 por resolução automatizada contratada, $2.00 pay-as-you-go |
| Freshdesk | Para testar, não para responder | Tickets anteriores não são uma fonte de conhecimento listada; tickets resolvidos podem ser importados como conjunto de teste | 30 dias por API por padrão | Freddy AI Agent: primeiras 500 sessões incluídas, depois $49 por 100 sessões |
| Gorgias | Indiretamente | "Opportunities" (beta) sugere lacunas de conhecimento e conflitos a partir de conversas que a IA não conseguiu resolver; você aprova cada uma | Os relatórios usam 28 dias | $0.85 a $1.00 por interação automatizada |
| HubSpot | Sim | Gera pares de perguntas e respostas a partir de tickets resolvidos ou conversas da caixa de entrada; você aceita, pula ou recusa cada um | 90 dias ou um segmento de tickets | 50 créditos por resolução, $0.50 nas tarifas pay-as-you-go |
Alguns detalhes chamaram a atenção.
O Zendesk trata tickets como último recurso. O auto assist sugere respostas "based on procedures, help center articles, similar solved tickets", e a ordem importa: "If there are no relevant procedures or help center articles available, then similar solved tickets are used" (Sobre o auto assist). Só contam tickets da mesma marca. O Zendesk também redige até três procedimentos por marca por semana a partir de "Relevant solved tickets from the last 90 days", mas cada um espera um administrador publicá-lo (procedimentos gerados por IA). Os preços estão na página de preços do Zendesk.
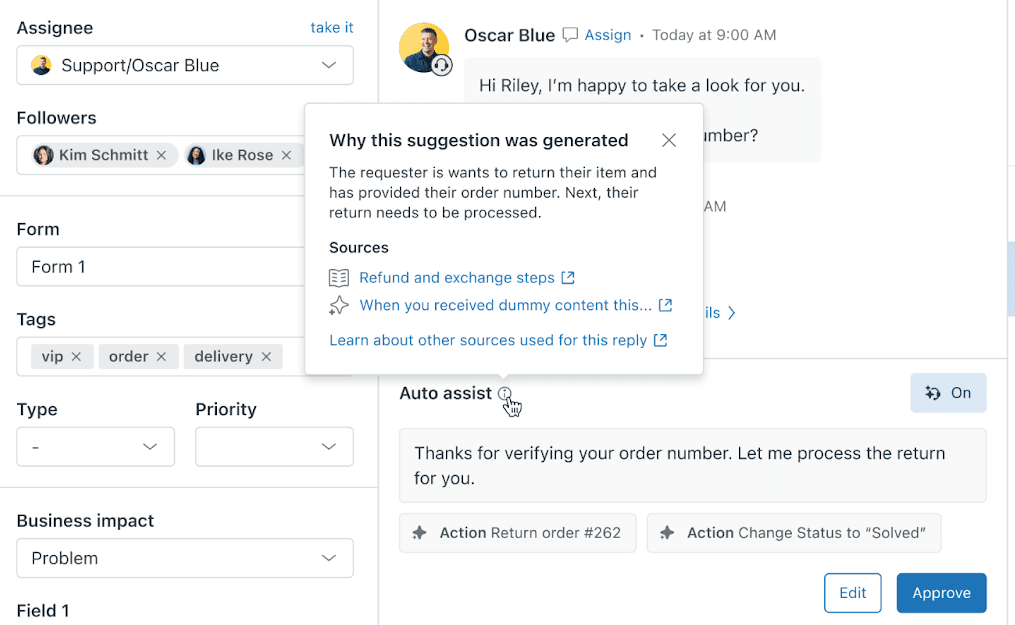
O Knowledge builder do Zendesk também vale conhecer se você ainda não tem uma central de ajuda. Ele lê os últimos 90 dias de tickets e propõe até 40 artigos. As regras dele para tickets são um bom modelo para o seu próprio filtro: apenas Resolvidos ou Fechados, apenas comentários públicos não vazios, e sem notas internas, spam ou problemas pontuais. O próprio Zendesk diz que "will likely not be helpful" para uma central de ajuda bem mantida.
O Freshdesk mantém os tickets fora do caminho da resposta. Ele lista as fontes do agente de IA como "URLs, files, solution articles, custom Q&As, and external apps" (documentação de conhecimento do Freshdesk). O histórico aparece nos testes: você pode importar tickets históricos resolvidos para uma execução de avaliação. Mais sobre isso no passo 5. Os preços estão na página de preços do Freshdesk.
O HubSpot é o mais direto. Ele vai "generate knowledge sources from your resolved tickets, inbox conversations, or uploaded files", agrupados em tópicos como pares no estilo FAQ para você revisar (gerador de conhecimento do HubSpot). Está nos planos Professional e Enterprise.
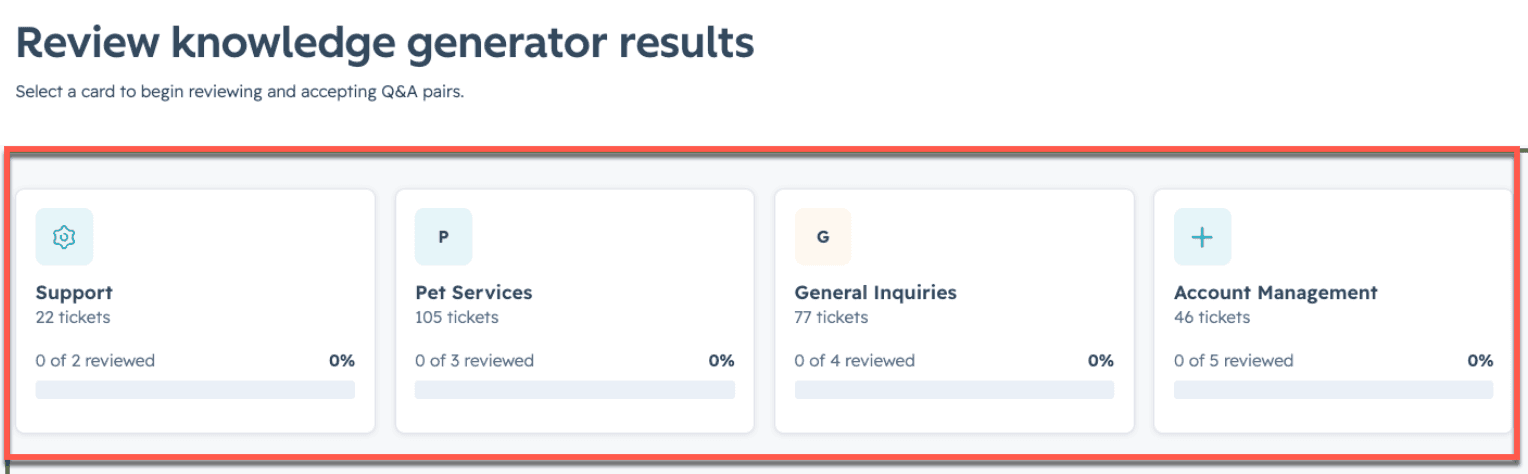
Note o padrão: todo fornecedor que aprende com tickets coloca uma etapa de aprovação humana no meio. É o fornecedor dizendo, com educação, que o histórico bruto de tickets não é seguro para aprender sem revisão.
Passo 1: exporte os tickets, com a conversa anexada
A primeira surpresa para a maioria das equipes: a exportação padrão de tickets normalmente não inclui a conversa. Você recebe o assunto, o status e os campos, mas não a troca de mensagens com a qual realmente quer aprender.
- Zendesk: a exportação incremental recomendada é o endpoint
GET /api/v2/incremental/tickets/cursor.json, até 1.000 tickets por página e 10 requisições por minuto (30 com o complemento High Volume), apenas para administradores. Os comentários não vêm nela. Busque-os no fluxo de eventos de tickets cominclude=comment_events, ou por ticket no endpoint de comentários, ondepublic: falsemarca uma nota interna. O guia de exportação incremental do Zendesk tem o passo a passo completo. - Freshdesk: a exportação pela interface "will NOT give you the entire conversation from the ticket or historical data" (documentação de exportação do Freshdesk). Use uma exportação da conta ou a API, que retorna apenas os últimos 30 dias a menos que você passe
updated_since, e no máximo 30.000 tickets por chamada de lista (API do Freshdesk). - Gorgias: a exportação de visualizações comporta até 1 milhão de tickets, mas não tem o texto das mensagens. "Export with message content" a partir de um detalhamento de analytics cobre apenas os 30 dias mais recentes, até 100.000 tickets, apenas mensagens públicas (documentação de exportação da Gorgias).
Exporte apenas mensagens públicas. As notas internas são onde os agentes escrevem "o cliente está mentindo, reembolse mesmo assim para isso acabar", e você não quer que a IA aprenda com isso. As próprias ferramentas do Zendesk descartam notas internas pelo mesmo motivo.
Passo 2: filtre os tickets que ensinariam a coisa errada
Este é o passo que faz ou desfaz o projeto. Você não está tentando manter o maior número possível de tickets. Está tentando manter aqueles que mostraria com gosto a um novo contratado como "é assim que fazemos".
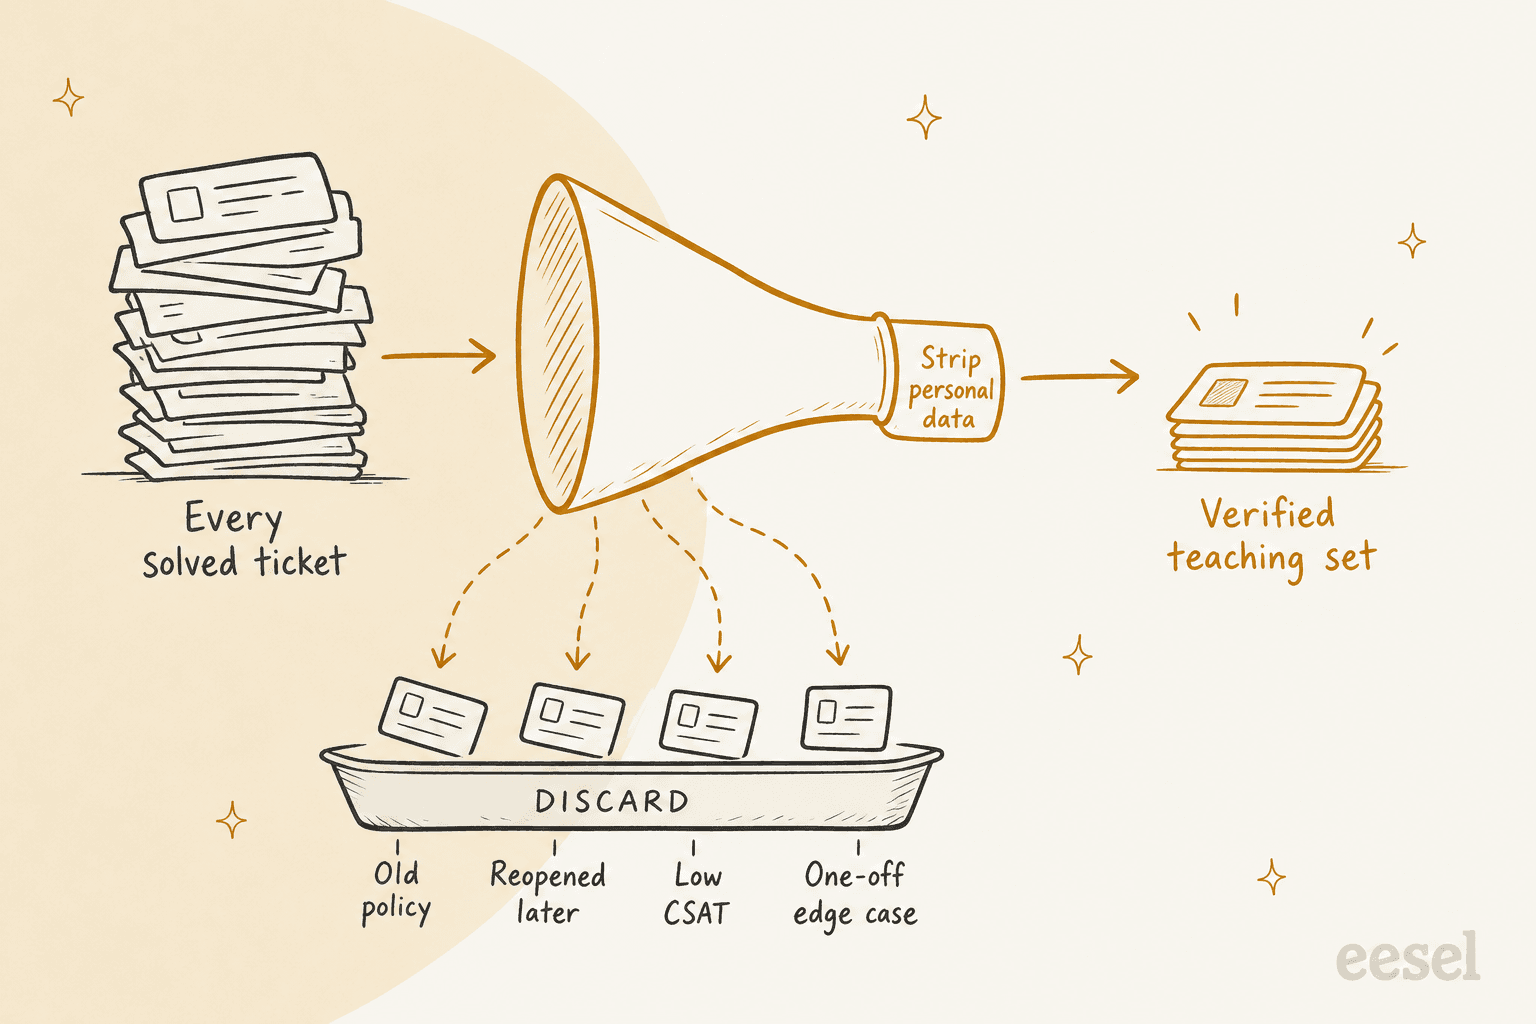
Descarte estes:
- Tickets anteriores à sua última mudança de política. Se a sua política de devolução mudou em março, tudo antes de março ensina a regra antiga. Na dúvida, comece pelos últimos três a seis meses. Zendesk e HubSpot usam ambos 90 dias por padrão em seus próprios recursos de aprendizado com tickets.
- Tickets que foram reabertos, escalados depois do "resolvido" ou seguidos de um segundo ticket sobre o mesmo problema. A primeira resposta não funcionou.
- Tickets com nota baixa de CSAT ou uma revisão de QA reprovada. Se você faz QA de suporte, os tickets aprovados no QA são o seu conjunto de ouro.
- Tickets fechados automaticamente sem resposta de agente, spam e acompanhamentos de "obrigado!".
- Casos isolados. O acordo sob medida que o seu head de suporte fez uma vez para um VIP não deve virar a resposta padrão.
- Picos sazonais, se distorcerem a mistura. Uma marca de entrega de flores em uma ligação de vendas da eesel pediu 300 tickets aleatórios por mês ao longo de 10 meses, deixando de fora os picos do Dia dos Namorados e do Dia das Mães, para que um pico de fevereiro não abafasse os outros 10 meses.
A orientação da OpenAI sobre dados de treinamento diz o mesmo pelo outro lado: "a smaller amount of high-quality data is generally more effective than a larger amount of low-quality data" (boas práticas de fine-tuning da OpenAI). Ela também avisa que o desequilíbrio ensina hábitos. Se 60% das respostas de exemplo dizem "I cannot answer this" mas apenas 5% deveriam, "you will likely get an overabundance of refusals." O seu histórico de tickets tem a sua própria versão desse viés, geralmente em direção ao seu mês mais movimentado.
Um administrador do Zendesk no Reddit descreveu bem o problema do histórico bruto, e é a razão de este passo existir:
"I am not entirely sure this approach would be bullet-proof (especially for businesses that have struggled to offer consistent customer support across agents - yes, I've worked for one!). Also, training on tickets is only half the battle, it's integrating all the other "knowledge" sources that makes a difference."
Passo 3: remova os dados pessoais antes de indexar qualquer coisa
Tickets de suporte estão cheios de nomes, e-mails, endereços, números de pedido e, às vezes, números de cartão e senhas que os clientes colam quando estão frustrados. Se isso entra no conhecimento de uma IA, o risco não é apenas de conformidade. É a IA repetir os dados de um cliente na resposta a outro.
Os fornecedores são explícitos quanto a isso. A documentação do HubSpot avisa que fontes de conhecimento privadas "will not be cited, but their content may still appear in responses", portanto "do not include personal, confidential, sensitive information, or private customer data" (fontes de conhecimento do HubSpot). O complemento Advanced Data Privacy and Protection do Zendesk sinaliza nomes, e-mails, endereços, números de cartão, números de seguro social, endereços IP e telefones nos comentários, com um aviso que vale ler duas vezes: "Ticket redaction cannot be reversed" (redação do Zendesk).
O lado jurídico é simples de enunciar, como fez um comentarista do Hacker News:
"A support ticket or live chat with a customer is customer data. With things like GDPR you need to know exactly where customer data is stored and for how long."

Então não redija os tickets no seu helpdesk para preparar um conjunto de treinamento. Redija a cópia com a qual você está treinando. Algumas regras que eu seguiria:
- Mascare, não apague. Substitua um e-mail por
[EMAIL]em vez de removê-lo, para que o exemplo continue natural e a IA aprenda a "pedir o e-mail do pedido" sem aprender o e-mail real de ninguém. - Mantenha IDs de pedido fora dos exemplos, a menos que você esteja ensinando o formato. A IA deve consultar pedidos ao vivo, não memorizá-los.
- Falhe fechado. Se um ticket não puder ser limpo, pule-o. Um conjunto menor é melhor que um vazamento.
- Confira a chave. As configurações de redação costumam vir desativadas por padrão. Na eesel, por exemplo, a redação de tickets anteriores está desativada em workspaces criados recentemente, e a documentação diz "Check the toggle rather than assuming it's on" (redação de PII da eesel).
Para mais sobre a mecânica, veja redigir PII em transcrições de suporte e a análise da privacidade de dados da IA do Zendesk.
Passo 4: divida cada ticket em fatos, decisões e tom
Agora pegue o seu conjunto limpo e encaminhe cada lição ao seu lugar.
Fatos viram conhecimento. Quando a mesma pergunta recebe a mesma resposta correta em 15 tickets e não há artigo de ajuda para ela, isso é um artigo que falta, não um exemplo de treinamento. Escreva-o uma vez, na sua central de ajuda ou em um documento interno, e deixe a IA recuperá-lo. Esta parte também deixa a sua equipe humana mais rápida, porque respostas que viviam na cabeça de uma pessoa acabam escritas. Uma análise de lacunas de conhecimento é a versão sistemática deste passo.
Decisões viram regras. Reembolso acima de um limite, uma reclamação de garantia, uma ameaça jurídica, um VIP irritado: são decisões de julgamento, e uma IA que as aprendeu de exemplos será inconsistente, porque os seus agentes também foram. A documentação da OpenAI coloca um número no motivo: se as pessoas concordam em apenas 70% dos casos, "the model would likely not be able to do better than this" (boas práticas de fine-tuning da OpenAI). Escreva a regra, incluindo o caminho de escalação, e teste-a. O design do Zendesk também reflete isso: o auto assist sugere ações apenas "if they're defined in your procedures", nunca a partir de tickets semelhantes.
O tom vira exemplos. Escolha de 20 a 50 respostas dos seus melhores agentes nos seus principais temas: uma resposta curta de "onde está o meu pedido", uma resposta cuidadosa de cobrança, um não amigável. Rotule cada uma com o que a torna boa ("duas frases, sem pedido de desculpas, link de rastreamento"). Isso basta para mudar tamanho e voz, que é onde vai a maior parte do tempo de edição. Os guias sobre voz de marca da IA e tom de suporte explicam como escrever as regras que ficam ao lado dos exemplos.
A OroSoft, que faz software para a indústria de metais preciosos, mostra como isso fica na prática. O agente da eesel dela no Freshdesk aprende com cerca de 6,100 tickets anteriores, ressincronizados toda noite, mas tem a instrução de preferir tickets resolvidos e fechados, dar peso aos recentes e tratar a central de ajuda como fonte de verdade para políticas, seguindo a fonte mais recente quando as duas discordam. Quando um ticket anterior se encaixa, o rascunho copia a estrutura, o tom e o tamanho dele, de modo que uma resposta curta que funcionou antes continua curta. E ele nunca copia nomes ou dados de clientes de tickets antigos.
Extrair conhecimento dos tickets também não precisa ser sofisticado. Um comentarista do Hacker News descreveu assim como apontou um modelo para o seu histórico:
"read this historical dump of 15k support tickets and break them into categories that make sense, then propose help docs that i could write to handle the most frequent queries in each category"
Esse é o instinto certo: o resultado são documentos de ajuda que uma pessoa escreve e aprova, não um modelo que memorizou 15.000 tickets.
Passo 5: reserve tickets recentes e reproduza-os
Este é o erro de teste que vejo com mais frequência: equipes testam a IA com os mesmos tickets dos quais ela aprendeu, tiram uma ótima nota e lançam. Claro que foi bem. Ela já tinha visto as respostas.
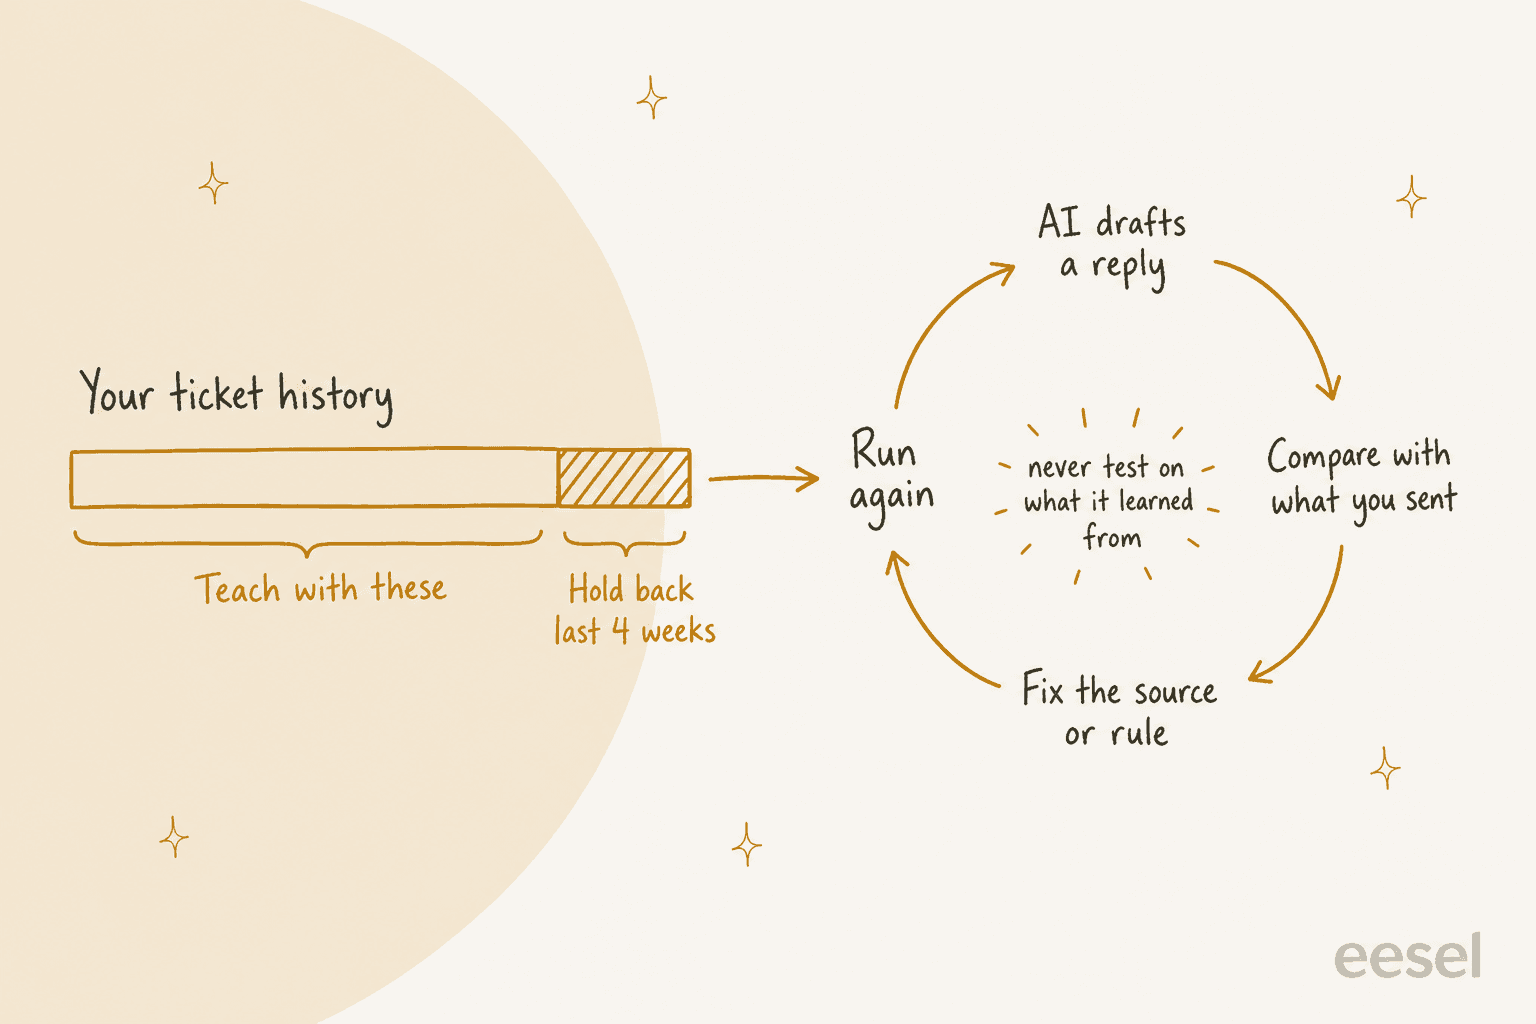
A documentação da OpenAI diz sem rodeios: "Good evals first!", e recomenda um conjunto reservado que "acts as a control group" (fine-tuning supervisionado da OpenAI). O mesmo vale quando você nem está fazendo fine-tuning. Uma versão simples:
- Reserve as três a quatro semanas mais recentes de tickets resolvidos fora da importação. São as mais representativas das perguntas de hoje e a IA não as viu.
- Reproduza de 50 a 100 delas. Peça à IA para redigir uma resposta a cada mensagem do cliente sem enviar nada.
- Compare cada rascunho com o que a sua equipe realmente enviou, e pontue precisão e tom separadamente. Um rascunho pode estar correto nos fatos e ainda assim precisar de uma reescrita completa.
- Rastreie cada erro até uma causa: um artigo ausente (corrija o conhecimento), uma decisão errada (corrija a regra) ou a voz errada (corrija os exemplos). Depois execute de novo.
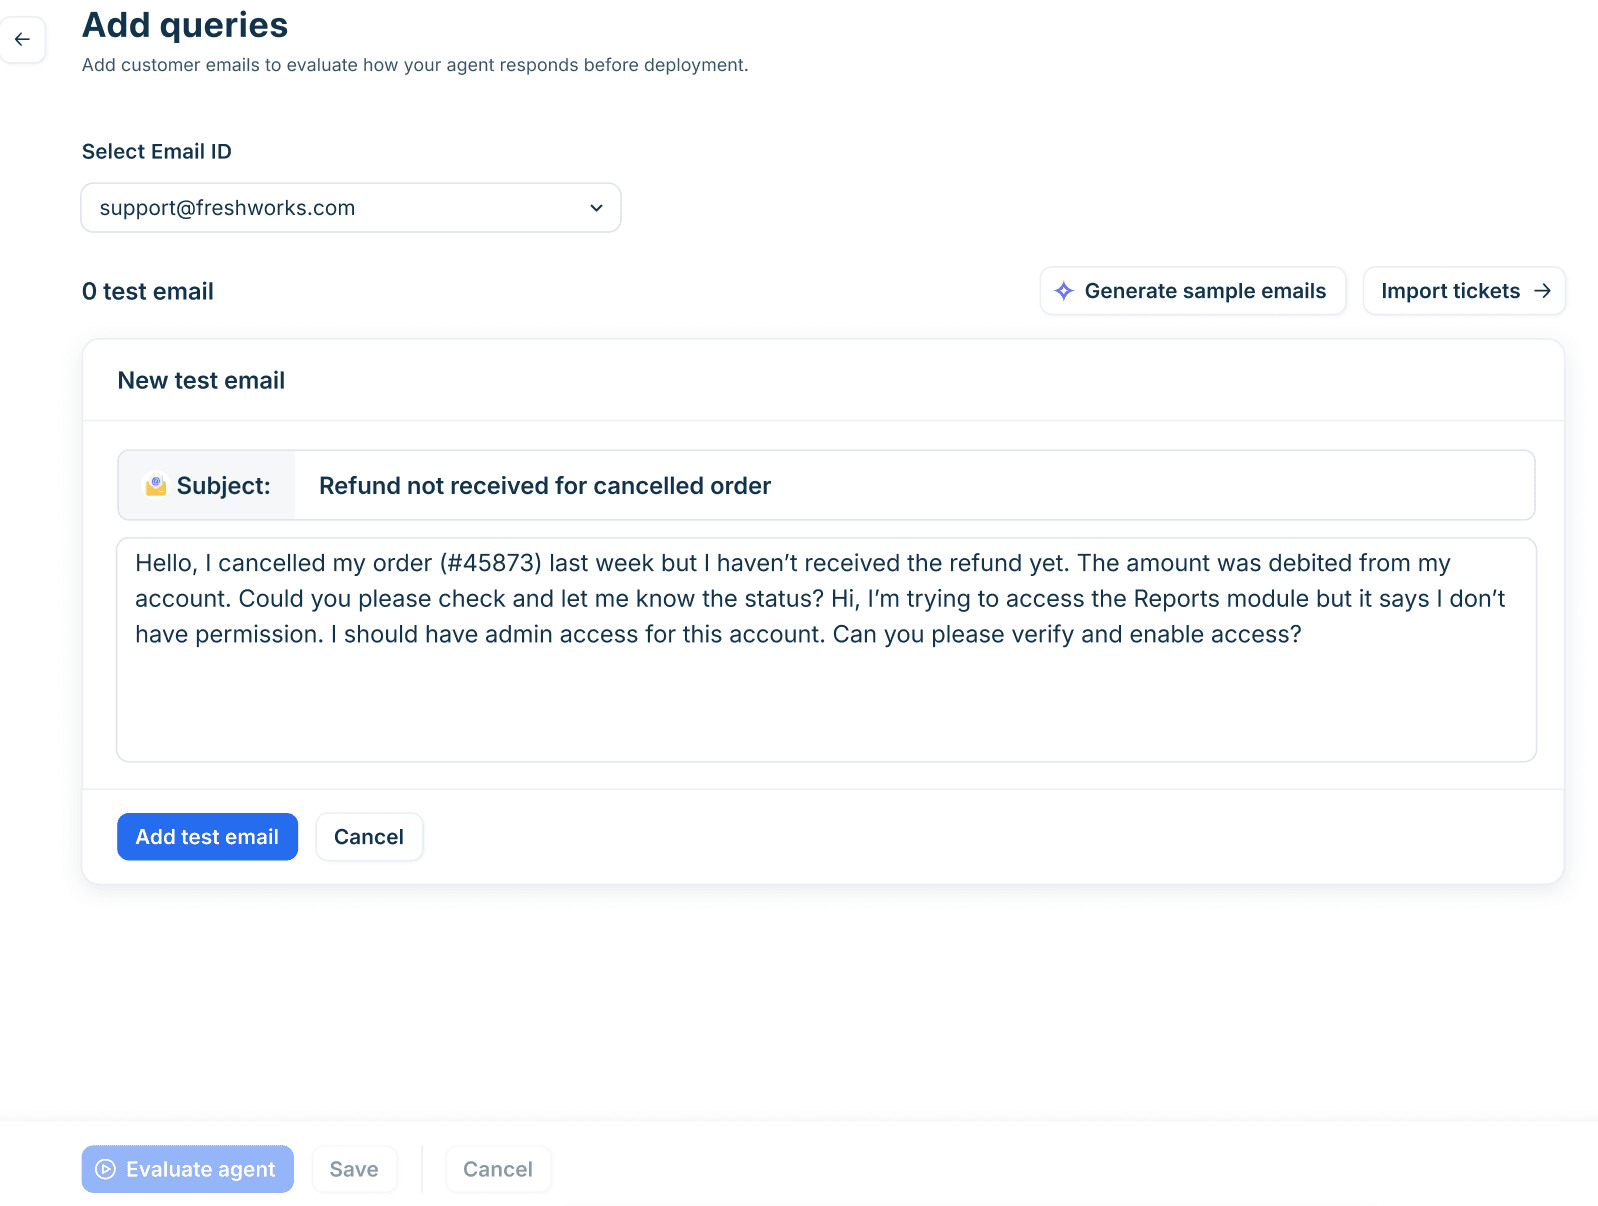
A maioria dos helpdesks oferece uma ferramenta para a reprodução. O agente de e-mail do Freshdesk permite "Import tickets to use solved historical tickets" como conjunto de teste, até 50 consultas por execução, e recomenda pelo menos 20 consultas representativas antes de implantar (configuração do agente de IA de e-mail do Freshdesk). Os testes em lote do HubSpot não usam créditos. A habilidade Simulation da eesel redige uma resposta a 20 tickets que a sua equipe resolveu recentemente, compara cada uma com o que a sua equipe enviou e agrupa os resultados por tema com correções, sem enviar nada aos clientes.
A empresa de ERP em nuvem Qontro transformou essa comparação em hábito em vez de uma barreira de lançamento. O agente da eesel dela redige em todo novo ticket do Freshdesk, e a equipe compara cada rascunho com a resposta que uma pessoa realmente enviou. Quando o rascunho estava errado, isso geralmente aponta para um artigo de ajuda ausente ou uma regra que precisa ser apertada, e eles corrigem. Cerca de um em cada dez rascunhos agora sai com pouca ou nenhuma edição, e a proporção está subindo devagar. Para um plano de testes completo, veja testes de agentes de suporte com IA e as verificações em testar antes do lançamento.
Passo 6: mantenha o treinamento atualizado
O treinamento com tickets não é uma importação única. Os seus produtos, políticas e clientes mudam, e uma IA que aprendeu com os tickets do ano passado vai ficando desatualizada aos poucos.
- Ressincronize em um cronograma. A empresa dinamarquesa de software Timengo ressincroniza a sua central de ajuda do Freshdesk todo domingo, rastreia novamente a sua documentação toda segunda, traz os tickets abertos semanalmente e o histórico completo de tickets mensalmente. Os bots da Norden-Frisia ressincronizam a partir do Zendesk, então uma mudança em um artigo sobre bagageiros de teto ou descontos para pessoas com deficiência chega ao bot sem retreinamento.
- Aposente tickets quando uma política mudar. Quando você atualizar o prazo de devolução, os tickets antigos que o citam devem sair do conjunto de treinamento no mesmo dia.
- Procure lacunas nos tickets novos. As perguntas que a IA não conseguiu responder neste mês são os artigos de ajuda do mês que vem. O HubSpot sinaliza lacunas de conhecimento em tickets que o agente não conseguiu responder, e o Opportunities da Gorgias mostra tópicos que a sua IA "has repeatedly handed over to your team" (Gorgias Opportunities). Uma base de conhecimento que se atualiza sozinha é o objetivo, com uma pessoa aprovando cada mudança.
- Faça uma auditoria trimestral do conhecimento em que a IA se apoia. Uma auditoria da base de conhecimento de IA vai pegar mais respostas desatualizadas do que qualquer ajuste de prompt.
Erros comuns ao treinar uma IA com tickets anteriores
- Importar tudo "por segurança". Mais tickets significam mais políticas antigas e mais decisões inconsistentes. Selecione primeiro.
- Dizer à IA para ignorar alguns tickets em vez de removê-los. Instruções não filtram o conhecimento de forma confiável. Se uma fila não deve ser aprendida (dados de teste, um produto antigo, tickets de outra equipe), exclua-a da importação.
- Aprender decisões a partir de exemplos. Limites de reembolso e regras de escalação pertencem à escrita, onde você pode testá-los.
- Esquecer os dados pessoais até o jurídico perguntar. Redija a cópia de treinamento antes de indexar qualquer coisa.
- Testar com dados de treinamento. Reserve tickets recentes, ou a sua nota está te bajulando.
- Recorrer primeiro ao fine-tuning. É a opção mais lenta e cara e resolve o problema menos comum.
- Tratar o lançamento como o fim. A fase piloto é onde você encontra as lacunas que o seu histórico não cobria.
Como a eesel aprende com os seus tickets anteriores
Serei sincero que tenho um viés aqui, mas a eesel foi construída em torno exatamente deste fluxo, então vale mostrar como ele se encaixa nos seis passos.
- Importação com controle. Com uma conexão completa ao Zendesk, Freshdesk ou Gorgias, a eesel lê a sua central de ajuda, macros e tickets anteriores. A primeira importação é uma amostra de até 1.000 tickets resolvidos recentes, e você pode filtrar por status e data para importar mais (documentação de configuração do Zendesk). Se uma fonte não deve ser aprendida, você a desliga na página da integração porque, como diz a documentação, mandá-la ignorar tickets anteriores "does not stop it finding them; the switch does."
- Dados pessoais mascarados antes da indexação. Os tickets anteriores passam por um detector que cobre 15 tipos de dados pessoais, substituídos por máscaras tipadas como
[REDACTED:EMAIL], e tickets que não podem ser limpos são pulados em vez de armazenados brutos (documentação de redação de PII). - Reprodução antes de entrar no ar. A habilidade Simulation reproduz tickets resolvidos recentes, pontua cada resposta contra o que a sua equipe enviou e sugere mudanças nas instruções. Nada roda em tickets reais até você criar uma automação, e a maioria das equipes começa com rascunhos.
- Correções que permanecem. Quando você corrige uma resposta no chat, a eesel escreve a correção nas próprias instruções, então o ajuste se mantém na semana seguinte.
- Uma CLI para a parte técnica de exportar e importar. Se preferir automatizar isso com scripts, ou pedir a um agente de código como Claude Code ou Cursor, a CLI da eesel controla o mesmo agente a partir de um terminal, com saída em JSON.
eesel integrations sources zendeskmostra o que as fontes de central de ajuda, macros e tickets contêm,eesel integrations download start zendeskas copia para o conhecimento da eesel, eeesel chatpermite pedir que importe um intervalo de datas específico ou execute uma simulação. É o mesmo agente do painel, então tudo o que você configurar lá aparece nos dois.
A varejista sueca de veículos elétricos Nordbutiker é um bom exemplo da ideia "selecionar, não despejar". Ela opera quatro lojas na Suécia, Noruega, Dinamarca e Finlândia, e o bot de cada loja aprende com os tickets resolvidos da própria marca no Zendesk, de modo que as respostas refletem o que os agentes daquela loja realmente disseram. Tudo o que o site e os tickets anteriores não cobrem, como peças de reposição e reclamações de garantia, vai para uma pessoa.
Treine uma IA com os seus tickets anteriores com a eesel
Se você está sentado em anos de histórico do helpdesk e quer uma IA que responda como os seus melhores agentes, a eesel é o caminho mais curto que conheço. Ela entra no Zendesk, Freshdesk ou Gorgias como um novo contratado que já leu a sua central de ajuda, as suas macros e os seus melhores tickets anteriores, com os dados pessoais mascarados. Depois reproduz os seus tickets recentes para mostrar onde teria errado antes de redigir uma única resposta real.
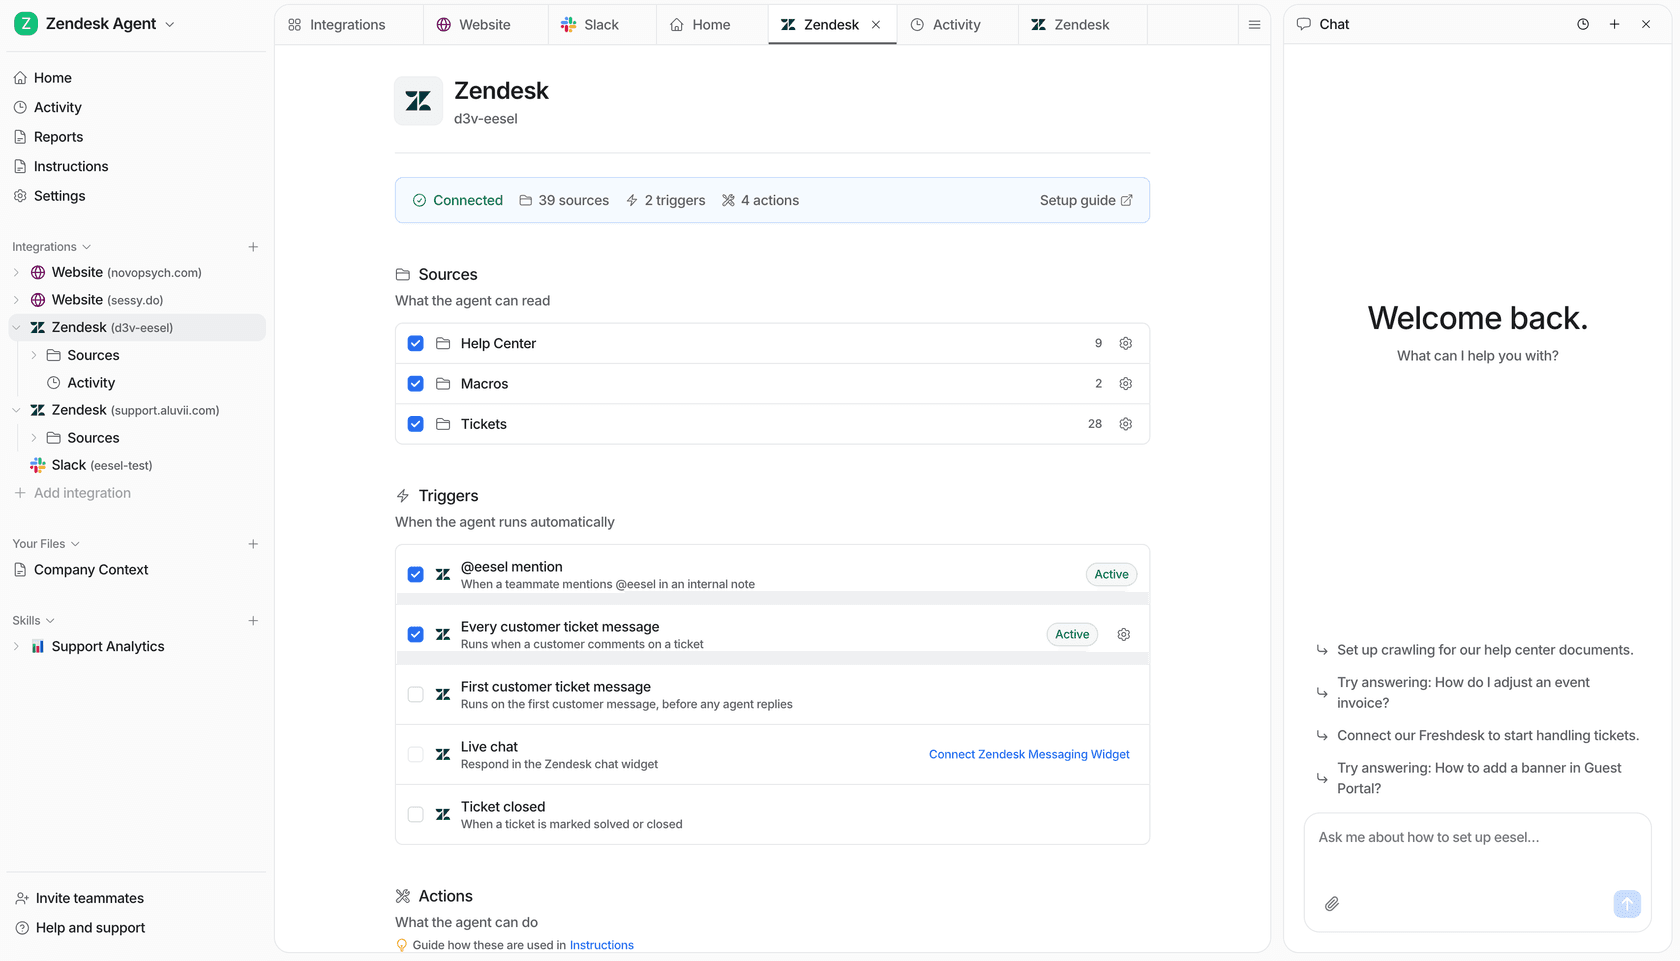
Foi isso que convenceu a Norden-Frisia: na semana de teste a equipe conectou o Zendesk, trouxe as macros e os últimos três meses de tickets, e assinou em poucos dias. O plano gratuito inclui 100 créditos sem cartão, e os planos pagos começam em $299/month por 500 créditos, onde um ticket custa um crédito, não importa quantas respostas vão e voltam (preços da eesel). Experimente a eesel no seu próprio histórico de tickets e veja os rascunhos antes de pagar qualquer coisa.