

O melhor modelo de IA para tickets de suporte em 2026 é o Qwen 3.8 Max pelos números, mas o modelo não é a variável que decide se a sua fila funciona. No τ-bench, o único benchmark público que obriga um agente de IA a recuperar respostas de uma base de conhecimento real de 698 documentos e depois agir com base nelas, o Qwen 3.8 Max marca 55,2% na primeira tentativa, o Claude Opus 5 chega a 48,7%, e o Claude Fable 5, o modelo mais caro do mercado, fica em sexto com 39,7%.
Aqui está a parte que deveria mudar o que você faz a seguir. Pegue um modelo e mantenha-o constante. O Claude Opus 4.5 marca 92,3% no domínio de telecomunicações, onde a resposta fica atrás de uma chamada de ferramenta, e 24,7% no domínio bancário, onde a resposta fica num monte de documentos. Mesmo modelo, mesma semana, 68 pontos de diferença, decididos inteiramente por como o conhecimento estava armazenado. A diferença entre o melhor e o pior modelo do campo atual é de 30 pontos. A diferença criada pelo lugar onde você coloca sua documentação é de 68.
E o argumento do custo também está de cabeça para baixo. O Claude Opus 5 custa cerca de US$ 0,11 por ticket com volumes de tokens realistas. A Zendesk cobra US$ 1,50 por resolução automatizada além disso. Você está pechinchando 7% da conta.
Então: escolha um modelo competente de nível intermediário, gaste o esforço poupado na sua base de conhecimento e nas suas regras de escalação, e teste tudo contra o seu próprio histórico de tickets antes que um cliente veja. Esse último passo é o que a eesel faz, reproduzindo seus tickets antigos e pontuando as respostas da IA em comparação com o que sua equipe realmente enviou.
A pergunta que me fazem e a que realmente decide
Eu construo agentes de IA na eesel, e a pergunta mais comum dos líderes técnicos de suporte que avaliam software de atendimento ao cliente com IA é alguma versão de "qual modelo devemos usar?". É uma pergunta razoável. Também é, na maioria das vezes, a primeira pergunta errada.
Sei disso porque já vi o que acontece quando as equipes a respondem e param por aí. Alguns dos nossos próprios clientes saíram para construir algo por conta própria diretamente nas APIs de fronteira. Olhando essa lista com honestidade, ela inclui uma empresa de realidade aumentada e tecnologia de construção e uma marca de beleza DTC, esta última indo direto para a API da Claude. Não é uma crítica a eles. São equipes de engenharia competentes e a API é realmente boa. Mas todas estavam resolvendo para o modelo, e o modelo nunca foi a parte difícil.
O líder de engenharia de uma empresa de caixas eletrônicos de Bitcoin no nosso plano Team, com uma base do Confluence de 300 artigos, colocou o outro lado com clareza:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Duas equipes, a mesma pergunta inicial, conclusões opostas. A diferença entre elas não é qual modelo escolheram. É se tinham uma forma de saber se a coisa funcionava.
Este texto é minha tentativa de responder à pergunta do modelo direito, com números reais, e depois mostrar por que a resposta importa menos do que aquilo que está por baixo.
Existe um benchmark feito exatamente para isso, e quase ninguém o cita
Todo lançamento de modelo cita MMLU, SWE-bench, GPQA ou um dos índices agregados de inteligência. Nenhum deles diz algo útil sobre se um modelo consegue fechar um ticket de suporte, porque fechar um ticket de suporte não é um teste de conhecimento. É uma sequência: entender um pedido confuso, encontrar a política relevante, chamar as ferramentas certas na ordem certa, recusar o que não é permitido e deixar o banco de dados no estado correto. Essa é a diferença entre um modelo de linguagem e um sistema de tickets com IA que funciona.
A Sierra criou um benchmark exatamente para isso, e ele se chama τ-bench. O artigo original do τ-bench saiu em 2024 com os domínios de varejo e companhias aéreas. O τ²-bench adicionou um domínio de telecomunicações em 2025, e sua contribuição principal foi fazer o usuário também agir, de modo que o agente precisa guiar um cliente por passos que só o cliente pode executar. É assim que o suporte técnico acontece de verdade. A conclusão do próprio artigo é direta: o desempenho cai de forma significativa assim que o agente precisa guiar um usuário em vez de apenas agir por ele.
Então, em 2026, veio a versão que mais importa para equipes de suporte. O τ³-bench adicionou o τ-Knowledge, um domínio bancário em que o agente precisa trabalhar a partir de uma base de conhecimento em vez de uma lista organizada de ferramentas.
Veja como é essa base de conhecimento, segundo o texto da própria Sierra: 698 documentos em 21 categorias de produto, cerca de 195.000 tokens. Cada tarefa precisa em média de 18,6 documentos e 9,5 chamadas de ferramentas, com algumas exigindo até 33. As tarefas são pontuadas pelo agente ter produzido o estado final correto do banco de dados, não por a resposta ter soado bem.
Se você já se perguntou por que sua central de ajuda parece brigar com a IA, esta é a versão benchmark da sua central de ajuda. É também a razão pela qual os guias de deflexão gastam mais tempo com conteúdo do que com configurações de modelo.
O precipício da recuperação
Este é o gráfico que eu colocaria na parede de qualquer pessoa que avalie IA para sistemas de tickets.
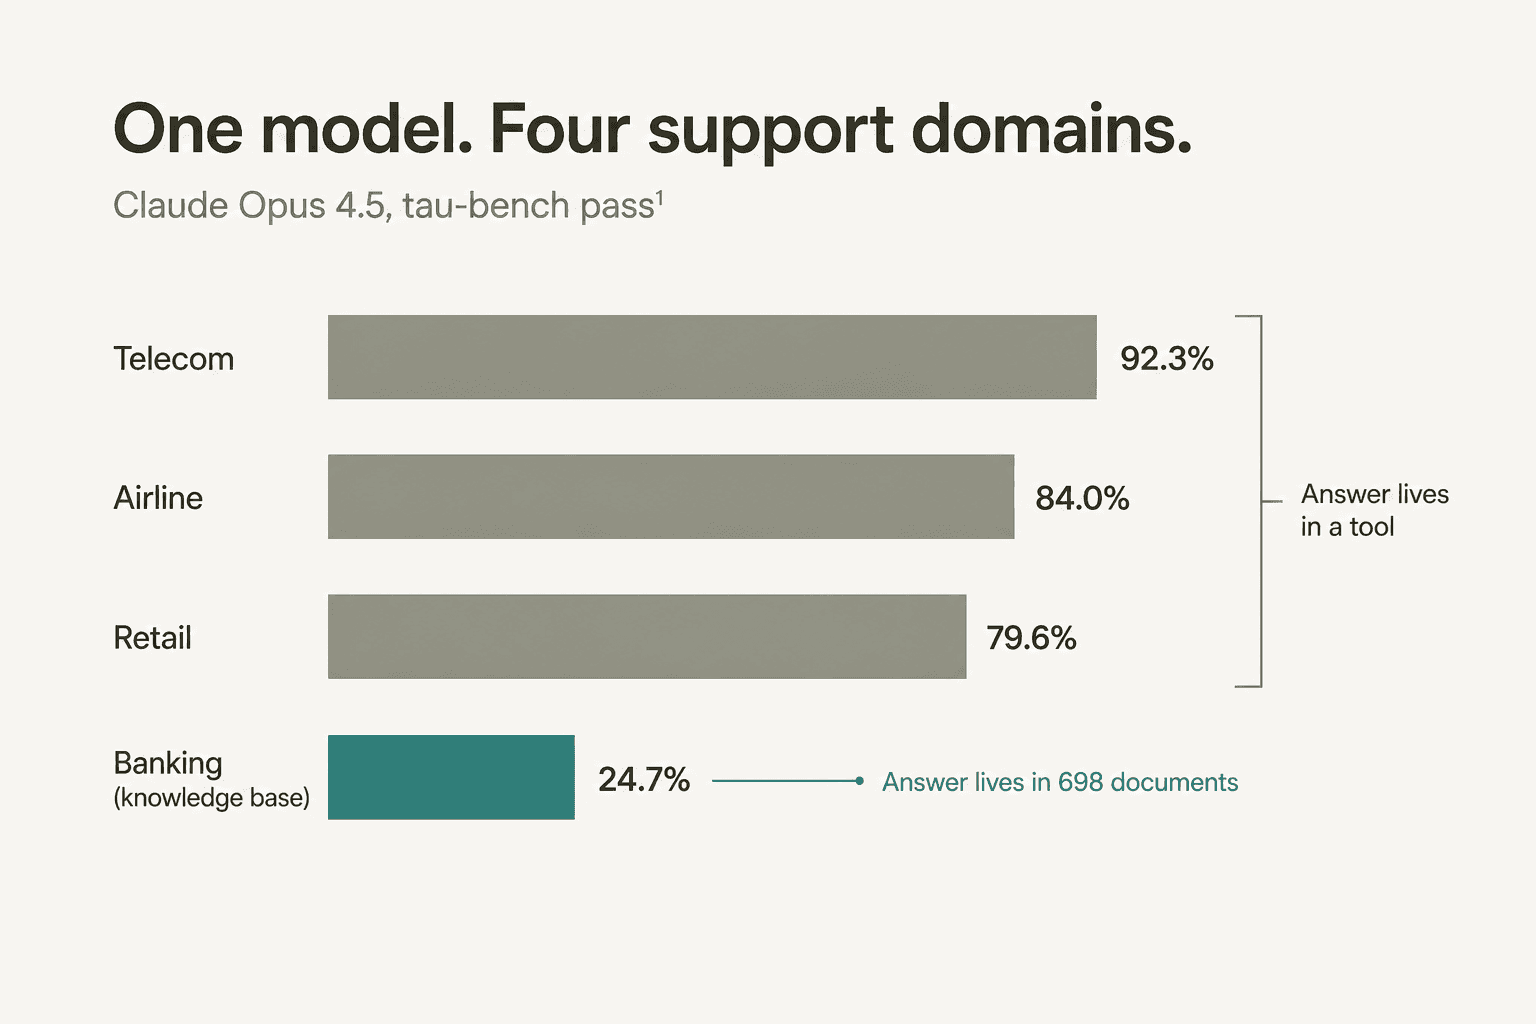
Um modelo. Uma execução de avaliação. Quatro domínios. Telecomunicações 92,3%, companhias aéreas 84,0%, varejo 79,6%, bancos 24,7%.
Os três primeiros domínios dão ao agente um conjunto limpo de ferramentas e a resposta é alcançável chamando-as. O quarto obriga o agente a primeiro encontrar a resposta em documentos. Essa única mudança custa 68 pontos, mais do que toda a diferença entre o melhor e o pior modelo de fronteira no mesmo teste.
O Qwen3.5-397B mostra o mesmo formato de maneira ainda mais crua: 97,81% em telecomunicações contra 9,79% em bancos. Um colapso de 88 pontos com os mesmos pesos.
Quero ser cuidadoso quanto ao que isso prova e ao que não prova. É um único benchmark, e sintético. Mas o mecanismo que ele expõe é exatamente o mecanismo que vejo em produção. Quando um cliente me diz que seu chatbot de base de conhecimento com IA "não é inteligente o suficiente", em cerca de nove de cada dez vezes o modelo está bem e a recuperação está trazendo os três parágrafos errados.
O ranking de 2026 para tickets de suporte
A Sierra executou um novo lote em 04/08/2026 cobrindo a maior parte da fronteira atual. Todas essas entradas usaram a mesma configuração de recuperação, o mesmo simulador de usuário GPT-5.2, a mesma versão do benchmark e quatro tentativas, então se comparam de forma limpa entre si.
| Modelo | Provedor | Correto na 1ª tentativa | Correto 4 de 4 | Nível de esforço |
|---|---|---|---|---|
| Qwen 3.8 Max | Qwen | 55,2% | 35,1% | xhigh |
| Claude Opus 5 | Anthropic | 48,7% | 32,0% | max |
| Grok 4.5 | xAI | 47,9% | 32,0% | high |
| GPT-5.6 Sol | OpenAI | 46,9% | 27,8% | xhigh |
| Meta Muse Spark 1.1 | Meta | 40,5% | 20,6% | xhigh |
| Claude Fable 5 | Anthropic | 39,7% | 28,9% | max |
| Claude Opus 4.8 | Anthropic | 39,7% | 22,7% | max |
| GLM-5.2 | Z.ai | 37,1% | 13,4% | xhigh |
| Kimi K3 | Moonshot AI | 37,1% | 17,5% | max |
| Inkling | Thinking Machines Lab | 25,0% | 11,3% | max |
Algumas coisas saltam aos olhos nessa tabela.
O modelo mais caro não é o melhor. O Claude Fable 5 cobra US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de saída. O Qwen 3.8 Max cobra US$ 2 e US$ 6. O modelo mais barato pontua 15,5 pontos a mais na tarefa de suporte. Se você vinha assumindo que o preço de fronteira compra desempenho de fronteira em suporte, não compra.
As diferenças entre os quatro primeiros são pequenas. Do Qwen 3.8 Max ao GPT-5.6 Sol são 8,3 pontos, e do Opus 5 ao Grok 4.5 menos de um ponto. Não são classes diferentes de ferramenta. São vizinhos.
O progresso é real, mas lento. O Claude Opus 4.5 marcou 24,7% neste domínio em fevereiro. O Opus 5 dobrou isso para 48,7% em agosto. Progresso genuíno ao longo de duas gerações. Ainda significa que o modelo erra mais vezes do que acerta, um ponto de partida muito diferente do que uma comparação de fornecedores de chatbot costuma sugerir.
Faltam dois modelos óbvios. Nem o Gemini 3.7 Flash nem o DeepSeek V4 Flash têm submissão neste domínio, então não posso classificá-los aqui com honestidade. As entradas mais antigas do Gemini usaram uma configuração de recuperação diferente, o que as torna não comparáveis, em vez de simplesmente mais baixas.
Uma observação metodológica que vale levar: as entradas mais antigas do ranking usaram configurações de recuperação diferentes, então comparações entre lotes são mais frágeis do que parecem. A Sierra também reavaliou o domínio bancário em julho de 2026 e diz que resultados anteriores a essa correção não são comparáveis. Quem cita uma pontuação bancária do início do ano provavelmente cita uma desatualizada.
Acertar uma vez não é acertar sempre
A coluna que a maioria pula é a que eu olharia primeiro.
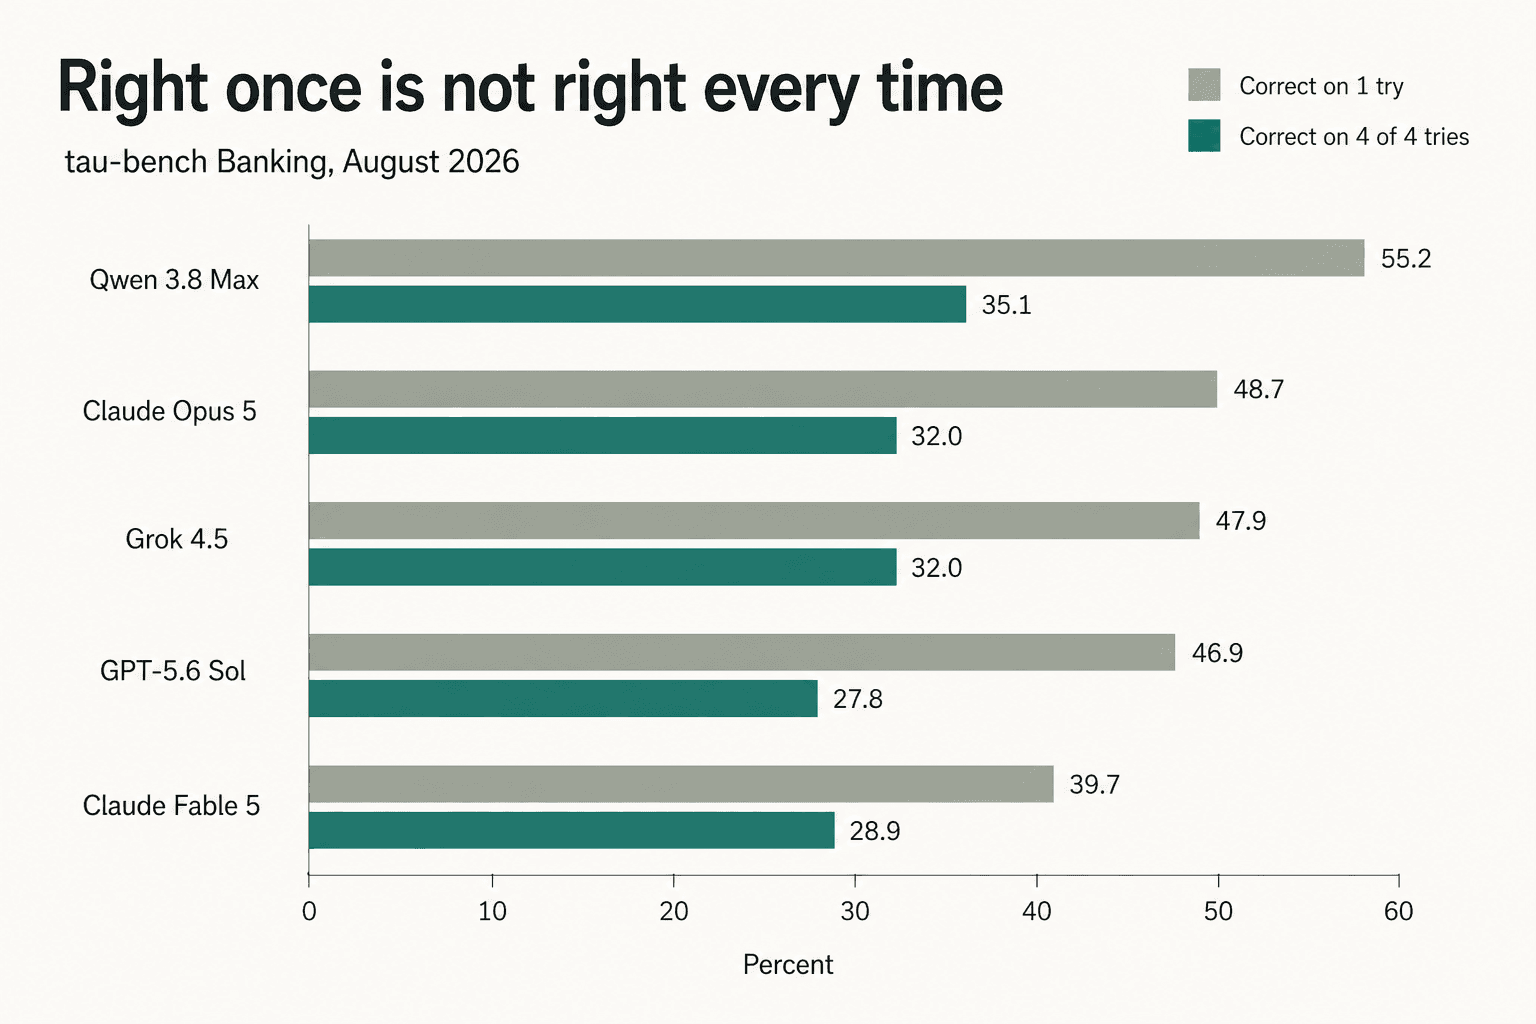
O τ-bench reporta pass^k, que pergunta se um modelo acertou a mesma tarefa em todas as k tentativas independentes. Pass^1 é "ele consegue fazer isso". Pass^4 é "ele faz isso de forma confiável".
O melhor modelo do campo é confiavelmente correto em 35,1% dessas tarefas. O Opus 5 cai de 48,7% para 32,0%. O GPT-5.6 Sol cai de 46,9% para 27,8%. O GLM-5.2 despenca, de 37,1% para 13,4%, o que indica que ele chuta bem em vez de raciocinar com consistência.
Essa diferença entre pass^1 e pass^4 é o número que decide se você pode deixar uma IA sozinha com uma fila. Um modelo com 48,7% de pass^1 e 32,0% de pass^4 não é um modelo que resolve metade dos seus tickets. É um modelo que vai tratar o mesmo tipo de ticket de forma diferente dependendo do dia.
Uma líder de CX de uma marca DTC de suplementos que atende cerca de 7.000 tickets do Gorgias por mês me disse a versão operacional disso melhor do que qualquer benchmark:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Isso é pass^k dito como requisito de negócio. Variância não é um problema de qualidade que se resolve com um modelo melhor, é um problema de roteamento que se resolve com escalação baseada em confiança. Toda implantação séria de suporte em que trabalhei acaba aqui, e é por isso que uma configuração de copiloto costuma ser uma primeira fase mais segura do que a autonomia total.
As três formas como os modelos realmente falham num ticket real
A Sierra publicou a taxonomia de falhas junto com o benchmark, e lê-la foi desconfortavelmente familiar. Não são falhas exóticas de IA. São exatamente as três coisas de que os gerentes de suporte reclamam.
Ele deixa passar a política que depende de outra política. No exemplo do benchmark, um cliente quer contestar uma transação e pedir um aumento do limite de crédito. O agente busca a política de contestação, a encontra e registra a contestação primeiro porque essa foi a ordem em que o cliente pediu. Ele nunca busca a política de limite de crédito, que diz que aumentos de limite são rejeitados automaticamente quando há uma contestação pendente. O cliente recebe uma negativa que um agente humano teria evitado fazendo os dois passos na outra ordem.
Ele relata sucesso em algo que falhou. Muitas das ferramentas do benchmark precisam ser desbloqueadas antes do uso. Quando o agente pula esse passo e recebe um erro, o texto da Sierra observa que alguns agentes então alucinam uma resposta de sucesso para o usuário. É o modo de falha que custa um cliente, e não apenas um ticket. Uma equipe dinamarquesa de telemática veicular B2B na Zendesk, com cerca de 200 tickets por mês e a caminho de 2.000, sofreu a versão de consumo disso quando seu bot confirmou suporte para marcas de carro que não estavam no banco de dados, porque a base de conhecimento dizia "damos suporte a todos os modelos".
Ele acredita no cliente. Quando o usuário simulado afirma que sua contestação foi aprovada, os agentes com frequência aplicam o crédito sem checar o status real. Toda equipe de suporte tem uma versão disso. Um gerente de suporte de eCommerce foi direto em nosso próprio chat do painel:
"stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday"
Nenhum desses três é resolvido por um modelo maior. São resolvidos delimitando o que o agente pode tocar. Há um comentário no Hacker News que formula isso melhor do que a maior parte da documentação de fornecedores:
"Give your LLM the same level of permissions that you would give a human you just hired in the same role. The examples given, tricking the customer support LLM into sending text messages to all users, or into transferring money, are not things that you would ever give a human customer support agent the tools to do."

Essa é toda a postura de segurança e confiabilidade em duas frases, e adotá-la não custa nada. É também como a maior parte da automação de atendimento ao cliente duradoura é construída, uma permissão estreita de cada vez.
Quanto cada modelo realmente custa por ticket
Vou pôr números reais nisso, porque "depende do seu uso" não é uma resposta.
Um ticket de suporte respondido com recuperação tem um formato razoavelmente previsível. Digamos 15.000 tokens de entrada (prompt do sistema, política, os trechos recuperados da base de conhecimento, histórico da conversa) e 1.500 tokens de saída (a resposta mais os tokens de raciocínio, que são cobrados pela tarifa de saída em todos os grandes provedores). Seus números vão diferir, mas as proporções entre os modelos não.
| Modelo | Entrada / saída por 1 mi | Custo por 1.000 tickets | Por ticket |
|---|---|---|---|
| Claude Fable 5 | $10.00 / $50.00 | $225.00 | $0.225 |
| GPT-5.6 Sol | $5.00 / $30.00 | $120.00 | $0.120 |
| Claude Opus 5 | $5.00 / $25.00 | $112.50 | $0.113 |
| Kimi K3 | $3.00 / $15.00 | $67.50 | $0.068 |
| GPT-5.6 Terra | $2.00 / $12.00 | $48.00 | $0.048 |
| Claude Sonnet 5 | $2.00 / $10.00 | $45.00 | $0.045 |
| Qwen 3.8 Max | $2.00 / $6.00 | $39.00 | $0.039 |
| Claude Haiku 4.5 | $1.00 / $5.00 | $22.50 | $0.023 |
| Gemini 3.7 Flash | $0.75 / $3.75 | $16.88 | $0.017 |
| GPT-5.6 Luna | $0.20 / $1.20 | $4.80 | $0.005 |
| DeepSeek V4 Flash | $0.22 / $0.66 | $4.29 | $0.004 |
As tarifas vêm da página de preços de cada provedor. Os valores da Anthropic e da Qwen estão linkados na seção acima; os demais estão na tabela de preços da OpenAI e na do Google, com a da DeepSeek linkada mais adiante.
Há quatro armadilhas nessa tabela.
O preço do Gemini é promocional. Os US$ 0,75 e US$ 3,75 do Google valem até 31 de dezembro de 2026 e depois dobram para US$ 1,50 e US$ 7,50 em 1º de janeiro. Se você está montando hoje um modelo de custos com o Gemini 3.7 Flash, monte-o com a tarifa do ano que vem.
A DeepSeek agora cobra por horário do dia. A tabela de preços da DeepSeek lista horários de pico de 01:00 a 04:00 e de 06:00 a 10:00 UTC pelo dobro exato da tarifa fora do pico, então os US$ 0,22 e US$ 0,66 acima viram US$ 0,44 e US$ 1,32 nessas janelas. Esses horários seguem o horário comercial chinês, que para uma fila de suporte dos EUA ou da Europa cai na maior parte fora do seu período mais movimentado. É uma peculiaridade a seu favor, e também é frágil.
Os US$ 2 e US$ 10 do Sonnet 5 são promocionais de lançamento. A tarifa publicada da Anthropic volta para US$ 3 e US$ 15 em 31 de agosto de 2026. São duas semanas a partir deste texto.
A residência de dados traz um acréscimo. A Anthropic aplica um multiplicador de 1,1 quando você fixa a inferência apenas nos EUA, e a OpenAI cobra 10% a mais em endpoints regionais de processamento para modelos lançados depois de 5 de março de 2026. Se você lida com dados pessoais de clientes sob um requisito de residência, some isso.
Teste os números com o seu próprio volume
O modelo é cerca de 7% da sua conta
Rode essa calculadora com qualquer medidor de plataforma realista e o formato da resposta para de mudar.
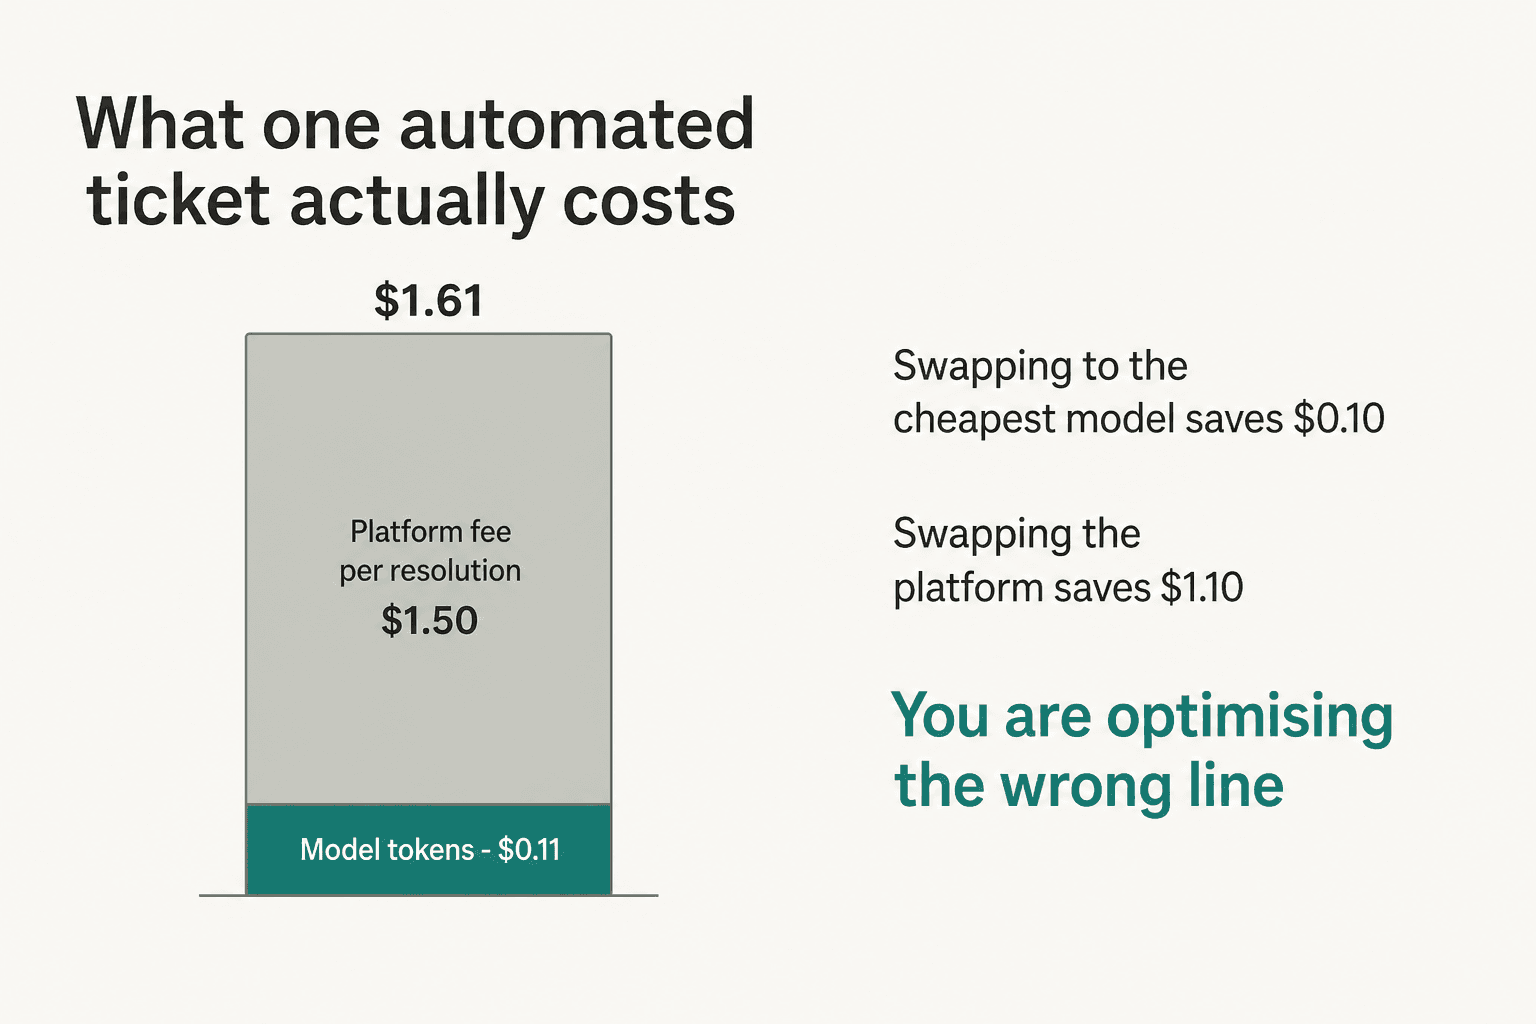
A Zendesk publica US$ 1,50 por resolução automatizada com compromisso e US$ 2,00 no pague conforme o uso, dentro da tabela de comparação de planos e não nos cartões dos planos. A Gorgias cobra de US$ 0,85 a US$ 1,00 por interação automatizada, dependendo do plano. O Freshdesk cobra US$ 0,49 por sessão acima das 500 incluídas. O Help Scout cobra US$ 0,75 por resolução, com a regra mais justa da categoria: uma resolução por conversa, não importa quantas perguntas a IA responda dentro dela.
Ponha o Claude Opus 5 atrás da tarifa comprometida da Zendesk e seu custo por ticket é de US$ 1,61, dos quais a inteligência em si é US$ 0,11. Descer para o modelo mais barato do mercado economiza seis centavos e custa nove pontos de benchmark. É a pior troca de todo este texto.
A unidade cobrada também importa mais do que a tarifa. Um medidor por sessão cobra de novo quando um ticket resolvido reabre no dia seguinte. Um medidor por interação cobra mesmo quando a IA transfere para uma pessoa. Se sua taxa de reabertura é alta, esses dois detalhes custam mais do que qualquer decisão de modelo. Nosso detalhamento da taxa de resolução da IA mostra como as definições diferem entre fornecedores. Para a comparação com uma base de pessoal, veja custo de IA versus agente humano.
Então, qual modelo você deve escolher
Esta é minha leitura honesta, com o raciocínio anexado em vez de um dar de ombros sobre suas necessidades específicas.
Se você quer as melhores pontuações de suporte e a residência de dados não é um bloqueio: Qwen 3.8 Max. Ele lidera o domínio de conhecimento com 55,2% e custa US$ 2 e US$ 6, menos da metade da tarifa de saída do Opus 5. O porém é real e você deve pesá-lo direito: ele é servido pela Alibaba Cloud, o que para a maioria das equipes de suporte ocidentais que lidam com dados pessoais de clientes é uma conversa de conformidade antes de ser técnica. Verifique suas obrigações de acordo de processamento de dados antes de verificar o benchmark.
Se você precisa de uma opção padrão hospedada no Ocidente: Claude Opus 5 ou GPT-5.6 Sol. Eles estão a menos de dois pontos um do outro no benchmark e a menos de oito centavos por mil tickets. O Opus 5 tem uma confiabilidade um pouco melhor em quatro de quatro, 32,0% contra 27,8%, o que importa se você automatiza sem supervisão. Ambos são bem documentados e têm contratos corporativos reais por trás.
Se você tem alto volume com uma base de conhecimento limpa e pequena: Gemini 3.7 Flash ou Claude Haiku 4.5. Não existe submissão bancária do τ-bench para nenhum dos dois, então não posso classificá-los com honestidade contra o campo. O que posso dizer é que o precipício da recuperação funciona nos dois sentidos: quando sua base de conhecimento são 40 artigos bem escritos e não 698 documentos bagunçados, a tarefa se parece muito mais com o domínio de telecomunicações, onde quase tudo pontua acima de 80%. Avalie com cuidado a tarifa promocional no caso do Gemini.
Se você tem orçamento limitado e aceita variância: DeepSeek V4 Flash. É de longe a opção crível mais barata, e as janelas fora do pico realmente favorecem o horário comercial ocidental. Duas ressalvas. Os termos da API paga são omissos sobre o uso para treinamento em vez de explicitamente protetores, e não há opção publicada de retenção zero, então não serve sem ajustes para dados de clientes. E a Artificial Analysis mediu uma alta taxa de alucinação, exatamente o modo de falha errado para uma resposta voltada ao cliente.
Pule o Claude Fable 5 para este trabalho. É um modelo excelente e o mais caro daqui, a US$ 10 e US$ 50. No benchmark de suporte ele fica em sexto, abaixo do Opus 5 e do GPT-5.6 Sol, que custam metade ou menos. Não há leitura dos dados em que ele seja a escolha certa para uma fila de tickets. O mesmo vale para o Kimi K3: a US$ 3 e US$ 15 ele custa mais do que o Qwen 3.8 Max e pontua 18 pontos a menos.
Mais uma coisa que vale dizer claramente: as taxas de alucinação foram na direção errada ao longo desta geração. A Artificial Analysis mediu a taxa do Claude Opus 5 subindo 14 pontos para 50%, e o Gemini 3.7 Flash regredindo para 64,5% dos 55,6% do Gemini 3.6 Flash, mesmo com a precisão melhorando. Os modelos ficaram mais inteligentes e mais confiantemente errados ao mesmo tempo. Para IA no atendimento ao cliente, essa troca é ruim de um jeito que não é para um assistente de programação, porque uma resposta errada vai direto para um cliente.
O que arrumar antes de mexer no menu de modelos
Se o precipício da recuperação é real, e acho que a evidência é forte, então é aqui que está a alavanca.
Arrume primeiro a base de conhecimento. Essa é a mudança de maior retorno disponível. A discussão do τ-bench no Hacker News tem uma demonstração do princípio que ficou comigo: alguém reescreveu os documentos de política do benchmark como árvores de decisão claras e passos numerados, sem tocar no modelo nem nas tarefas, e elevou o GPT-5-mini em 22%. A explicação do próprio autor sobre o motivo é a frase mais afiada do tópico:
"If a model only performs well once the rules are clarified, that's still revealing something important about its agency: it's brittle when policies are ambiguous, but much stronger when they're structured."
Vinte e dois pontos por reescrever documentação. Nenhuma troca de modelo chega perto disso. Nossos guias sobre IA para gestão do conhecimento e as melhores ferramentas de base de conhecimento cobrem o lado prático.
Delimite as ferramentas como você faria com um novo contratado. Voltando ao ponto das permissões. Se a IA não pode emitir reembolsos acima de um limite, ela não pode ser convencida a emitir um. Isso é mais barato e mais confiável do que pedir no prompt que ela não faça, e é o que separa um verdadeiro colega de equipe com IA de um chatbot com chaves de API. Exemplos de agentes que funcionam tendem a ter listas de ferramentas estreitas, não prompts engenhosos.
Roteie por confiança, não por tipo de ticket. O pass^k diz que o mesmo modelo trata o mesmo ticket de forma diferente entre execuções. A resposta não é um modelo melhor, é deixar a IA recusar. Configure regras de transferência que tratem "não tenho certeza" como um resultado válido e comum em vez de uma falha. É também aqui que o coaching de agentes se paga, porque os tickets recusados mostram o que escrever em seguida.
Meça as coisas certas em produção. Um comentarista do Hacker News descreveu ter visto um fornecedor acompanhar o τ-bench de companhias aéreas numa média móvel de 32 dias, junto com a taxa de erros de chamadas de ferramentas e a taxa de erros de saída estruturada. É um painel melhor do que a taxa de resolução sozinha, porque separa "o modelo errou" de "o modelo chamou a ferramenta errada". Nosso texto sobre métricas de atendimento ao cliente cobre com o que combiná-las.
Teste no seu próprio histórico antes de entrar no ar. Todo benchmark neste texto é a fila de outra pessoa. A sua tem produtos diferentes, casos de borda diferentes e um tom diferente. O único teste que diz se um modelo vai funcionar para você é uma reprodução dos seus próprios tickets resolvidos.
Esse último não é opcional, e é o passo que as equipes que constroem na API bruta mais pulam. É também a razão pela qual um ranking de benchmark deve informar sua lista curta e nunca decidi-la.
Experimente a eesel na sua fila de tickets
Tudo acima aponta para a mesma conclusão: o modelo é um componente, e o que decide se a sua automação de suporte funciona é o alicerce ao redor dele. Esse alicerce é a eesel.
A peça que eu apontaria especificamente, dado o argumento deste texto, é a simulação. Você pode pedir à eesel que execute uma simulação sobre seus tickets recentes, e ela reproduz centenas dos seus tickets antigos e pontua as respostas da IA em comparação com o que sua equipe realmente enviou, depois devolve as lacunas e mudanças de instruções sugeridas. É o problema do pass^k tratado com os seus próprios dados em vez dos de um benchmark. Ela não projeta uma taxa de resolução para você, e eu desconfiaria de qualquer fornecedor que alegue isso.

Ela se conecta ao Zendesk, Gorgias, Freshdesk, Front, Help Scout, HubSpot, Salesforce e Jira Service Management. O preço é uma mensalidade fixa a partir de US$ 299/mês por 500 créditos (1 crédito por ticket ou chat), sem taxa por usuário. Há um plano gratuito com 100 créditos e sem cartão, o que para a maioria das equipes são tickets reais suficientes para testar.
Se você passou a última semana comparando nomes de modelos numa planilha, este é o atalho: escolha qualquer um dos quatro primeiros, conecte seu helpdesk, reproduza seus próprios tickets e deixe os resultados dizerem se o modelo algum dia foi o problema.