

O que é uma base de conhecimento por cliente e quem precisa de uma
Uma base de conhecimento por cliente é conteúdo de ajuda delimitado a uma empresa cliente ou a um público. O cliente vê os artigos dele mais os compartilhados. Todos os outros veem apenas os compartilhados.
Quatro tipos de equipes acabam precisando dela:
- Agências e equipes de suporte terceirizadas que atendem várias marcas a partir de um único helpdesk. A política de reembolso do cliente A não pode aparecer no chat do cliente B.
- MSPs documentando a rede, os fornecedores e os runbooks de cada cliente, o que por si só é uma categoria inteira de software (mais sobre Hudu e IT Glue abaixo).
- Equipes de SaaS B2B cujos clientes enterprise têm configurações personalizadas, SSO próprio ou SLAs específicos por contrato.
- Empresas multimarca, que cobri no meu guia de suporte ao cliente multimarca.
Foi assim que um administrador do Zendesk descreveu o formato do problema, e é a versão mais clara que encontrei:
"Can anyone advise on configuration for guide where I have 100 unique sites that need a help center? 2/3 of the content needs to be available for all end users but 1/3 of content is site-specific and needs to be invisible to users outside of that specific site. Multi brand? Orgs/tags? Labels?"

Repare na proporção. Dois terços compartilhados, um terço específico do cliente. Essa proporção decide quase tudo o mais neste post, desde como você estrutura sua gestão de base de conhecimento até como configura a IA.
Sou a Alicia e construo os agentes de IA na eesel, então passo muito tempo no lado da recuperação: o que uma IA pode ler quando um cliente do cliente A faz uma pergunta. É onde vou passar a segunda metade deste post, porque é onde o conteúdo específico de um cliente deixa de ser específico sem ninguém perceber.
Os três níveis de separação
Todo helpdesk oferece alguma mistura dos mesmos três níveis, quer os chame de marcas, portais, workspaces ou sites do Docs. Escolha o mais baixo que resolva o problema, porque cada degrau acima soma manutenção.
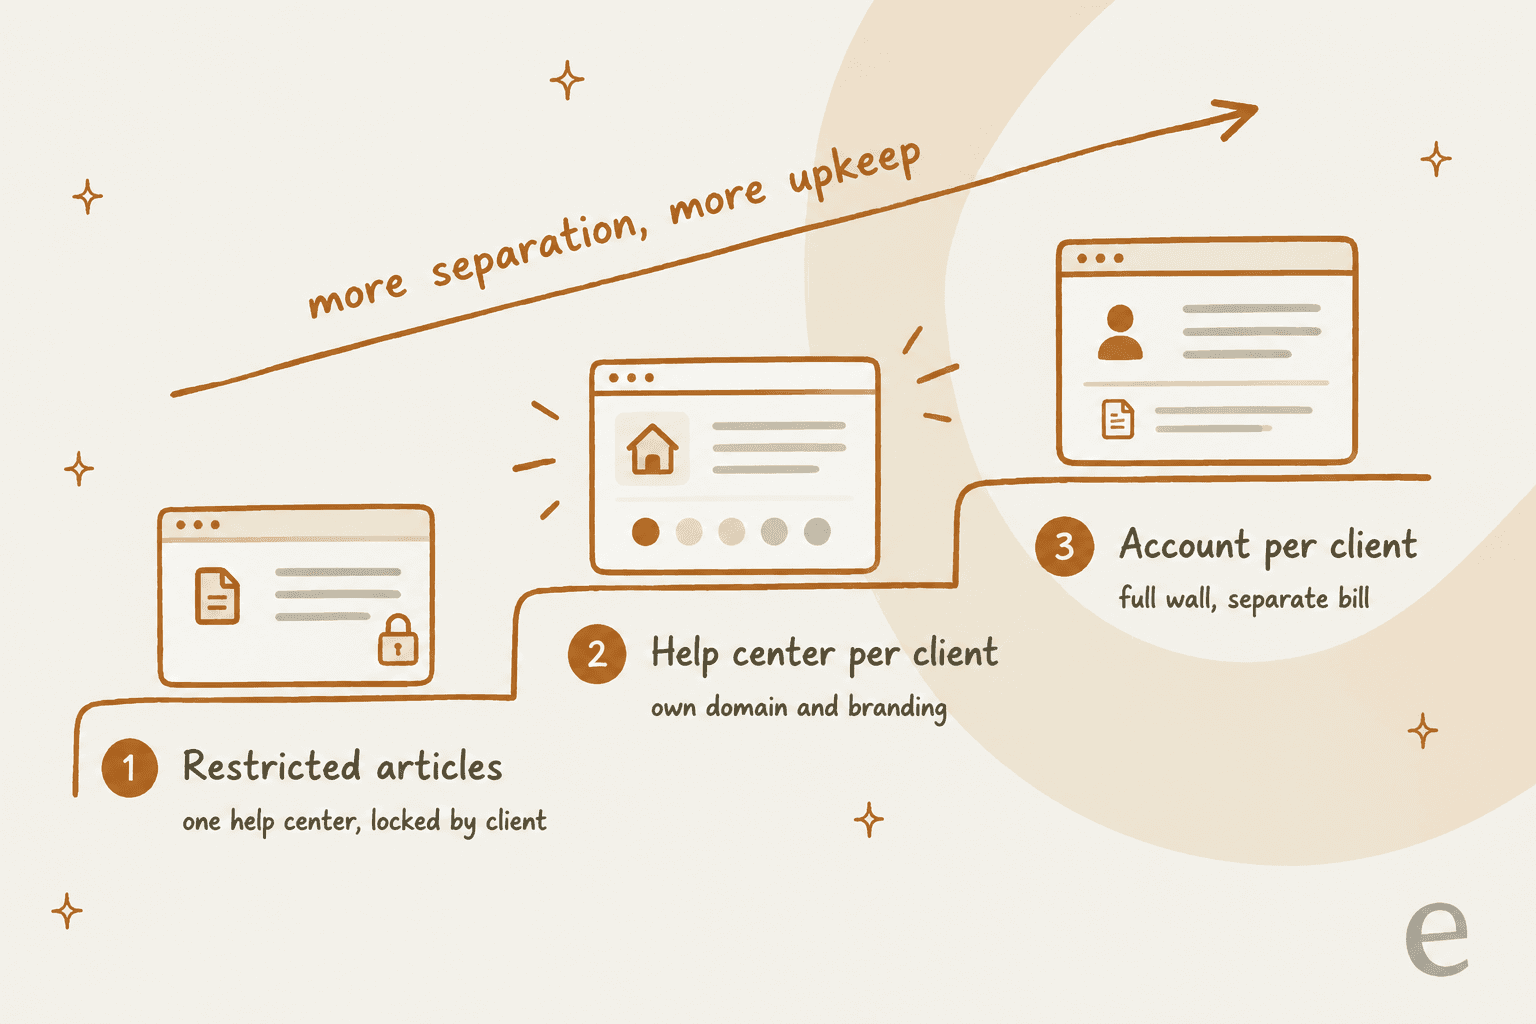
Nível 1: artigos restritos em uma central de ajuda. Os clientes fazem login, e os usuários de cada cliente veem os artigos deles mais os compartilhados. Uma biblioteca de artigos, uma URL. É o padrão certo para a maioria das equipes, e era para isso que apontavam as respostas no r/Zendesk:
"User Segments all the way. Cool part though if you have User data coming from say Azure. You can premap info. Or domains as well. Then user segments check that data and allow access to articles pertaining to their content. Little bit of maintenance but it's the best way"
O porém é o login. A restrição só funciona quando o helpdesk sabe quem está lendo, então visitantes anônimos só veem conteúdo público.
Nível 2: uma central de ajuda por cliente. Cada cliente recebe seu próprio domínio, logotipo e conjunto de artigos. É o que costumam querer os clientes que revendem seu serviço ou colocam a própria marca nele, e é a configuração que meu guia de configuração multimarca do Zendesk percorre. Mesmo assim, não é privado automaticamente. O documento do Zendesk sobre centrais de ajuda de marca diz: "you cannot restrict users to a specific help center. All of your help centers are accessible to all of your end users." Uma central de ajuda separada é uma decisão de marca, não de privacidade. Se o conteúdo for confidencial, você ainda precisa de login mais restrição.
Nível 3: uma conta por cliente. Helpdesk separado, fatura separada, administradores separados. O documento de Workspaces do Freshdesk diz que cobrança ou titularidade legal separadas podem exigir contas separadas. É o muro completo, e também o que dá mais trabalho: cada artigo compartilhado é mantido N vezes.
Não copie todos os artigos por cliente
O erro mais comum que vejo é tratar "específico do cliente" como "copiar a biblioteca inteira por cliente". Com a proporção de dois terços compartilhados de antes, isso significa que a maior parte das suas edições é a mesma correção colada doze vezes, e as cópias se desencontram no momento em que alguém esquece uma.
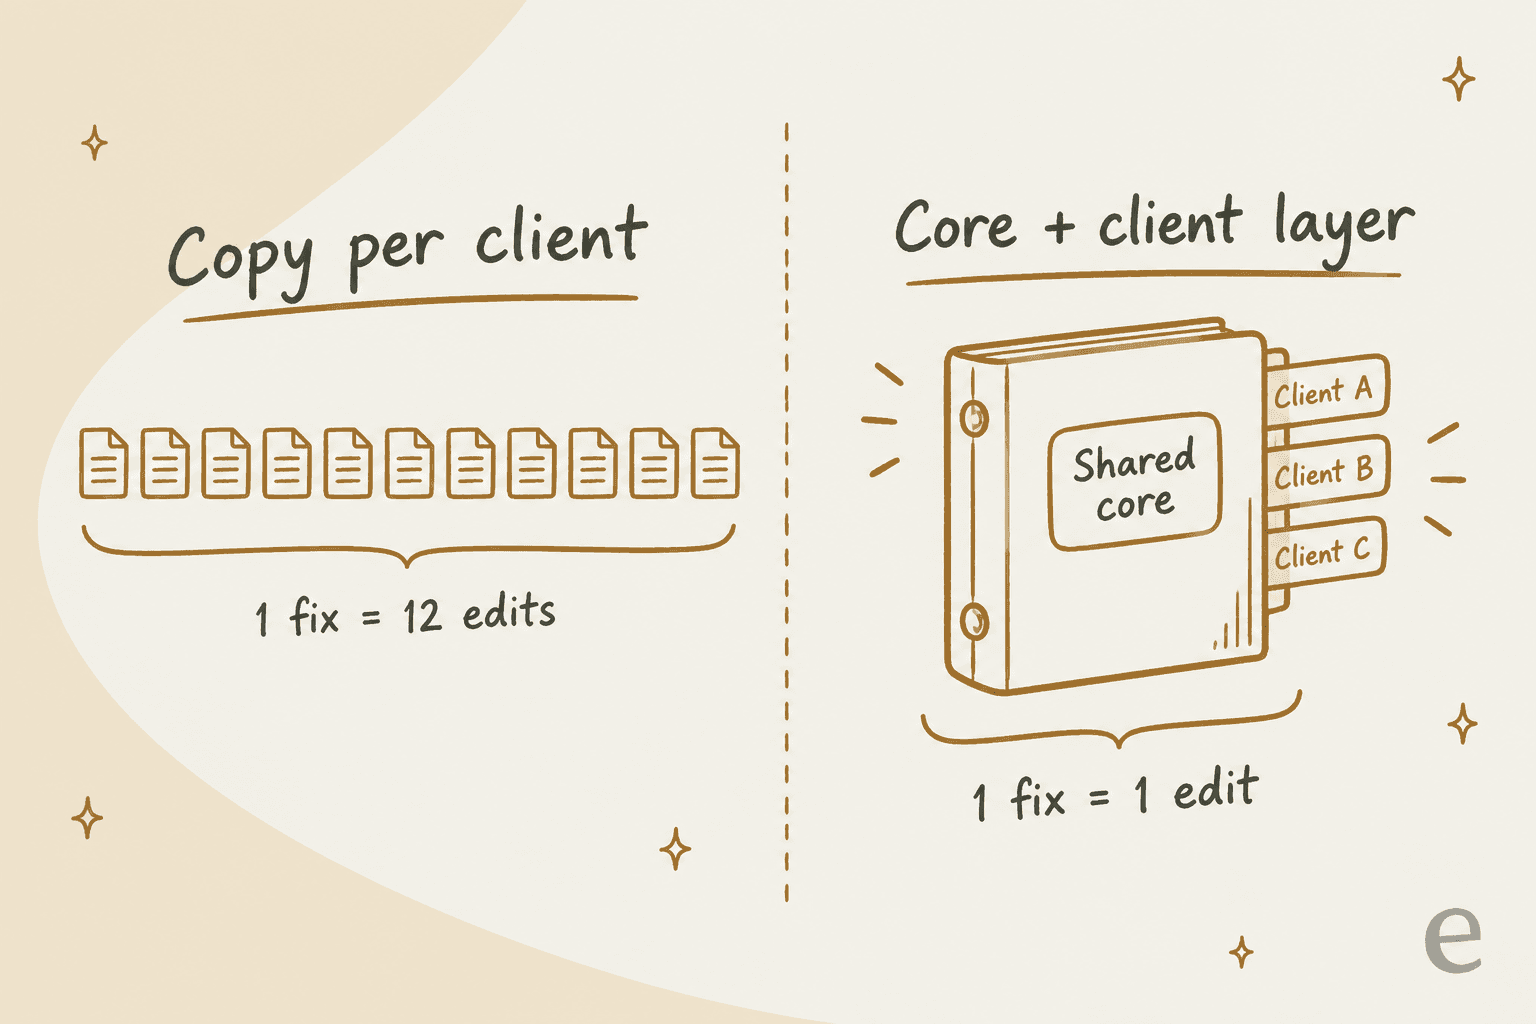
O padrão que se sustenta é um núcleo compartilhado mais uma camada fina por cliente:
- Núcleo compartilhado: como o produto funciona, políticas padrão, solução de problemas. Escrito uma vez.
- Camada do cliente: só o que difere. Configuração personalizada, termos do contrato, contatos nomeados, caminhos de escalonamento específicos do cliente, exceções à política padrão.
A mesma divisão funciona para bases de conhecimento internas, onde a camada do cliente são notas só para agentes que seus clientes nunca veem.
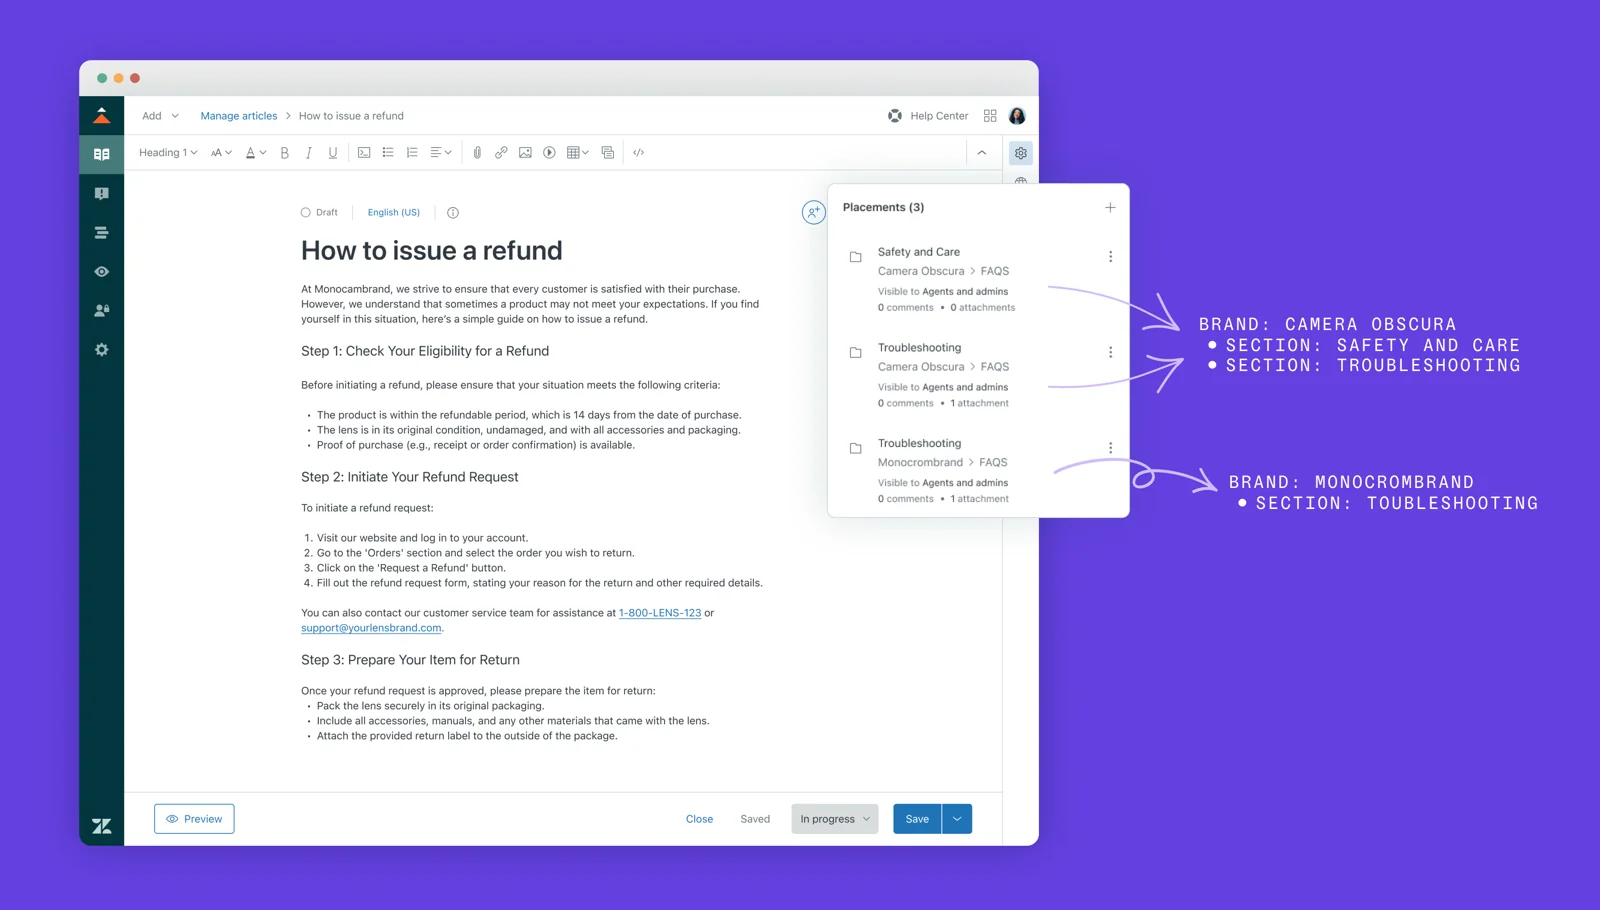
As ferramentas de documentação para MSP são construídas exatamente assim. O Hudu chama de bibliotecas de base de conhecimento duplas: artigos centrais "for information that pertains to multiple clients" e artigos de cliente que "pertain only to that space." O Zendesk tem dois recursos que fazem o mesmo trabalho dentro de uma conta. A multiposição de artigos coloca um artigo em até 10 seções entre marcas, e cada posição mantém suas próprias permissões de visualização.
Os blocos de conteúdo vão um nível abaixo: um parágrafo ou tabela reutilizável que é atualizado em todos os lugares onde é inserido. São exclusivos do Enterprise, porém, então a maioria das equipes vai se apoiar na multiposição e em uma convenção de nomes clara.
Uma nota honesta sobre o IT Glue: ele não tem biblioteca compartilhada nativa. O próprio documento de permissões sugere criar uma organização "named something like 'Common Documents'" para o conteúdo compartilhado. Funciona, mas é uma convenção que você precisa impor, não uma estrutura que a ferramenta oferece.
Como cada helpdesk lida com artigos por cliente
Veja o que cada ferramenta restringe, em que nível e em qual plano. Os preços são por agente ou usuário por mês com cobrança anual, da página de preços de cada fornecedor em outubro de 2026.
| Helpdesk | Menor unidade que dá para restringir | Mecanismo por cliente | Plano para restrição por cliente | Central de ajuda separada por cliente |
|---|---|---|---|---|
| Zendesk | Artigo | Segmentos de usuários por organização, tag ou usuário nomeado | Suite Professional $115 (segmentos personalizados); vários segmentos por artigo exigem Enterprise | 5 no Professional, 300 no Enterprise |
| Freshdesk | Pasta | Pasta visível para empresas selecionadas, segmentos de contatos ou segmentos de empresas | Listado em todos os planos na documentação de pastas do Freshdesk | Pro $55 (até 5 portais), Enterprise $89 (ilimitados) |
| HubSpot Service Hub | Artigo ou base de conhecimento inteira | Grupos de acesso (estáticos ou baseados em filtro) | Professional: 2 grupos de acesso; Enterprise: 100 | Somente Enterprise (até 100 bases de conhecimento) |
| Help Scout | Site do Docs inteiro | Um site do Docs restrito por cliente | Plus $45 ou Pro $75, mais código próprio | Sites: Plus 3, Pro 5, extra $20/mês |
| Zoho Desk | Categoria, seção ou artigo | Grupos de usuários da central de ajuda (até 200 por central de ajuda) | Não no Free; base de conhecimento a partir do Standard $14 | Enterprise $40 (central de ajuda multimarca) |
| Front | Central de ajuda inteira | Uma central de ajuda com acesso controlado por login por cliente | Professional $65 | Professional e acima |
Algumas coisas dessa tabela merecem mais do que uma célula.
Zendesk: os segmentos de usuários fazem o trabalho de verdade
Os segmentos de usuários do Zendesk são a opção mais flexível aqui. Um segmento pode filtrar por até 50 organizações, 50 tags em cada grupo de tags e 50 usuários nomeados, e você tem até 200 segmentos por conta, compartilhados entre as marcas. Coloque os usuários de cada cliente em uma organização e você tem um segmento de cliente um para um.
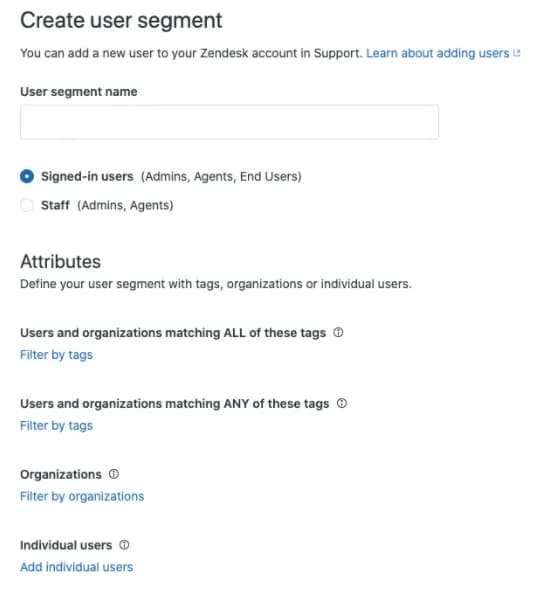
Dois detalhes de plano importam. O Suite Team só pode escolher "todos" ou "usuários logados", então não há segmentos de cliente nem artigos só para agentes. E a restrição é por artigo, não por seção, então você tranca uma seção inteira de um cliente com atualizações em massa. Meu guia para restringir artigos por segmento mostra como, e o post sobre centrais de ajuda multimarca cobre o Nível 2.
Freshdesk: por pasta, e por empresa de fábrica
O Freshdesk define a visibilidade na pasta, não no artigo. As opções incluem Todos os usuários, Usuários logados, Todos os agentes, Bot e Empresas específicas, além de segmentos de contatos e de empresas. O documento do widget do Freshdesk nomeia o caso do cliente diretamente: mostrar artigos "about a company to just contacts from that company".
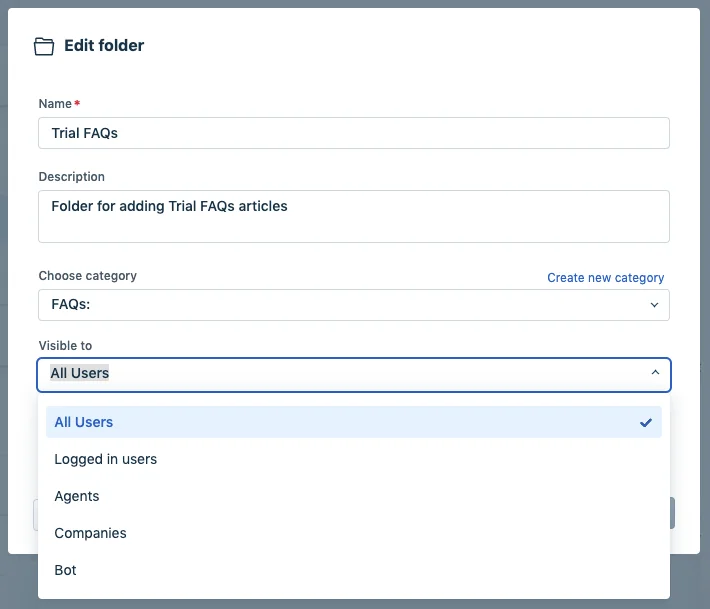
Isso faz do Freshdesk uma das maneiras mais baratas de fazer o Nível 1 (meu detalhamento dos preços do Freshdesk tem a grade de planos). O formato para o qual planejar: uma pasta por cliente, já que a visibilidade não pode variar artigo a artigo dentro de uma pasta.
HubSpot: bom no Enterprise, apertado no Professional
O HubSpot restringe artigos individuais ou uma base de conhecimento inteira por meio de grupos de acesso. O Professional permite 2 grupos de acesso e 1 base de conhecimento. Isso basta para "público mais parceiros mais um nível VIP", não para dez clientes. O Enterprise permite 100 grupos e até 100 bases de conhecimento, e o conteúdo privado do HubSpot só funciona em um domínio personalizado conectado. Mais sobre a IA do HubSpot abaixo, porque é onde fica interessante. Meu panorama da base de conhecimento do HubSpot tem o resto, e o post sobre a IA da base de conhecimento do Service Hub cobre o lado da IA.
Help Scout, Zoho Desk e Front
O Help Scout restringe sites do Docs inteiros, não coleções. Os Docs restritos exigem Plus ou Pro e "custom code development by your own team" para emitir o token do visitante. Existem coleções privadas, mas "privado" significa seus próprios usuários do Help Scout, não um cliente. O Help Scout também observa que o Docs não é coberto por seus compromissos de GDPR ou HIPAA, então mantenha dados de contas de clientes fora dele.
O Zoho Desk é o mais granular dos três. As categorias podem ser definidas como Nenhum, Grupos, Público, Agentes ou IP personalizado, e os grupos de usuários da central de ajuda são descritos como vinculados a "a specific account". Os limites são 200 grupos por central de ajuda e 2,000 usuários por grupo. Se você pretende treinar a Zia nele, leia antes a seção de IA abaixo.
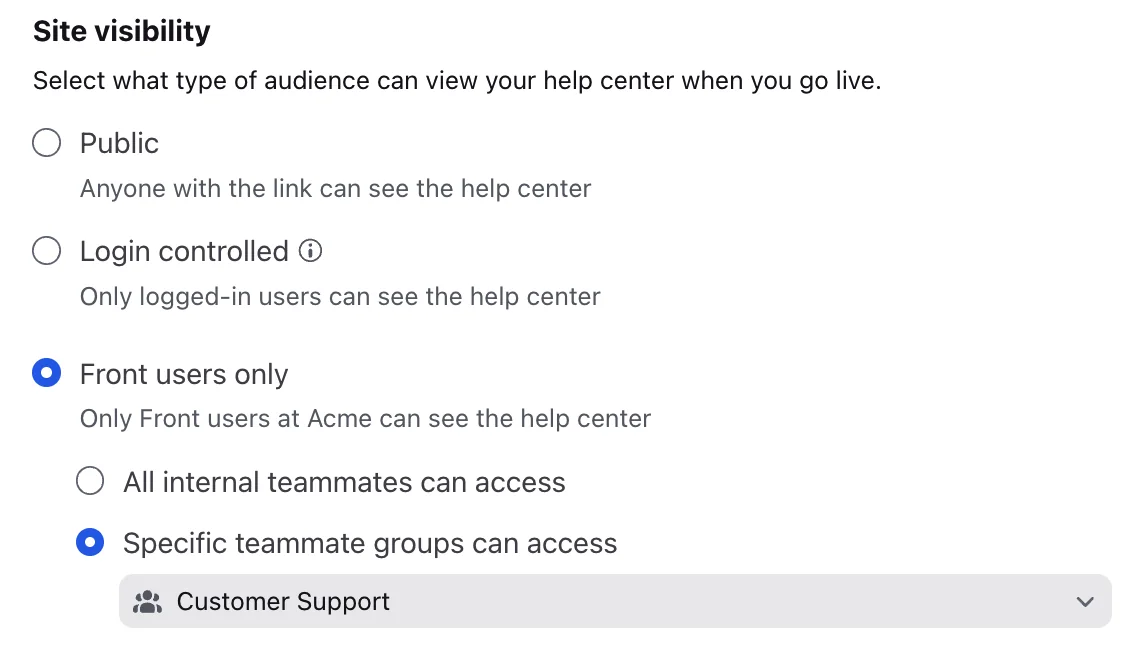
O Front restringe no nível da central de ajuda: Público, Acesso controlado por login (pelo seu próprio provedor de identidade) ou Somente usuários do Front. Suas categorias privadas apenas escondem o conteúdo da navegação, e qualquer pessoa com o link direto pode abri-las, então não são um muro para clientes. Minha análise do Front AI cobre o que a IA dele lê.
Onde o conteúdo por cliente vaza: a IA
Esta é a mudança em que insisto. As equipes passam semanas acertando as permissões da central de ajuda e depois ligam um agente de IA que lê a base de conhecimento sob outro conjunto de regras. O modelo de permissões que seus clientes veem nem sempre é o que sua IA segue.
| Recurso de IA | Usa artigos restritos por cliente? | O que isso significa para você |
|---|---|---|
| Agentes de IA do Zendesk (configuração atual) | Sim, e respeita as permissões de visualização para usuários logados | A mensageria precisa de login JWT com um ID externo correspondente; respostas restritas não podem ser testadas no widget de teste |
| Agentes de IA do Zendesk comprados antes de 10 de março de 2026 | Os artigos eram "public or private to everyone" | A migração vai de 1º de julho até o fim de 2026 |
| Freshdesk Freddy AI Agent | Não. "Private or restricted articles are excluded" | As pastas de clientes não são fonte; você teria que torná-las públicas |
| Freshdesk Freddy Copilot (lado do agente) | Sim, limitado ao acesso do próprio agente | Bom para agentes, não para respostas voltadas ao cliente |
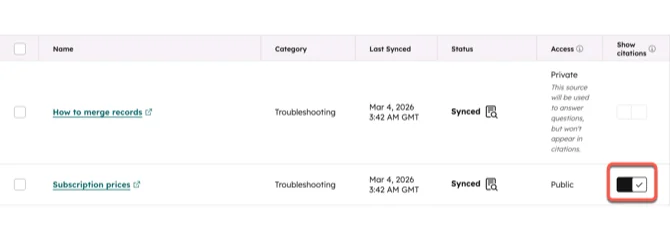
| Agente de atendimento do HubSpot | Sim, sem citações | O HubSpot avisa que o conteúdo privado "may still appear in responses" |
| Help Scout AI Answers | Dá para ativar coleções privadas nas configurações do Beacon | Eu delimitaria por cliente com um agente de IA por Beacon |
| Zoho Desk Answer Bot | A Zoho diz apenas "published and public resources" | Um comentário de usuário na mesma página relata artigos só para agentes aparecendo; teste |
Duas linhas merecem um olhar mais atento.
O Freshdesk é rigoroso na direção segura. O documento de conhecimento do AI Agent diz "only articles visible to All users are used for AI learning." Então o bot não consegue vazar a pasta do cliente A para o cliente B, mas também não consegue responder ao cliente A a partir da pasta do cliente A. O contorno do Freshdesk, a busca filtrada, restringe a recuperação por propriedades do contato ou da conversa, mas só consegue filtrar conteúdo com o qual a IA pôde aprender desde o início.
O HubSpot vai no sentido oposto. O documento de fontes do agente de atendimento diz que fontes privadas "will not be cited, but their content may still appear in responses", e orienta a não incluir dados confidenciais ou privados de clientes. Não encontrei nenhuma forma documentada de limitar uma fonte privada ao seu grupo de acesso no momento da resposta.
O mesmo problema aparece entre regiões, não só entre clientes. Um administrador do Zendesk resumiu bem:
"The problem: Zendesk AI pulls knowledge from the Help Centers linked to the same brand, regardless of language or region. So if a Brazilian customer asks something, the AI might base its answer on all related contents, even in articles just created for US."
Delimite primeiro, depois busque
A solução é a mesma a que chegam os que constroem a própria: decidir de quem é o conteúdo em jogo antes de a busca rodar, não depois. Um desenvolvedor de n8n que roda um fluxo de IA para dez clientes descreveu assim:
"Once I've filtered the clientid the model won't make a mistake because if it gets the clientid gonna search for everything related to the client id, even the chat history is connected trough clientid so it seems pretty solid."
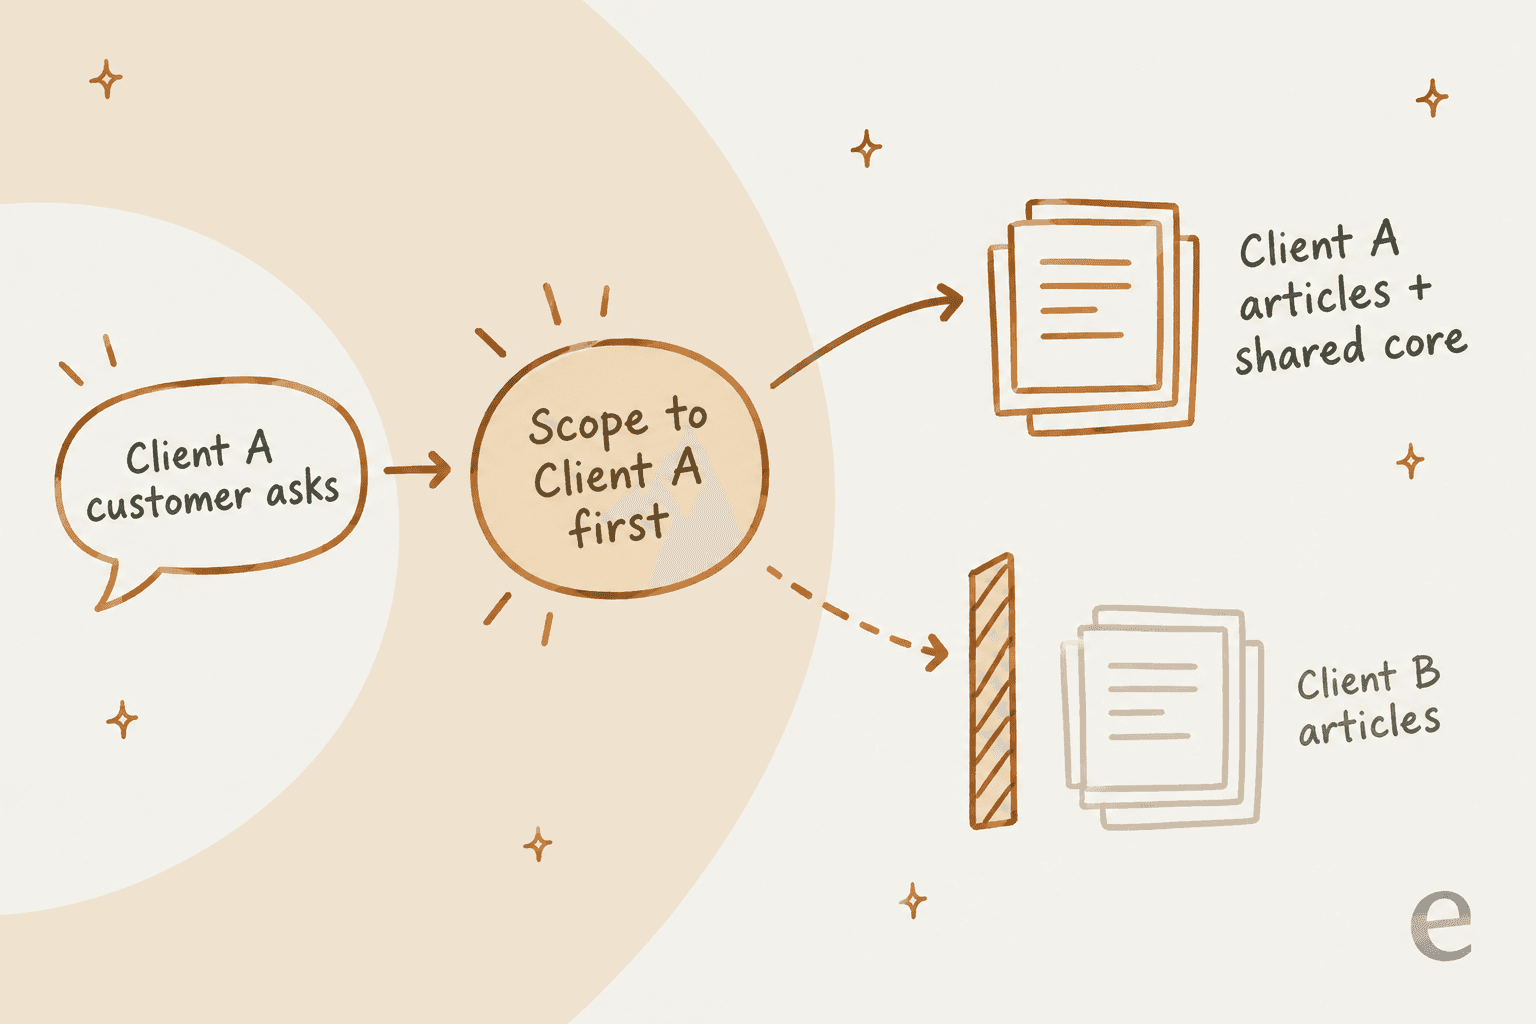
Em um helpdesk, a forma mais simples de delimitar primeiro é um agente de IA por cliente, conectado apenas às fontes desse cliente. Instruções como "use apenas os artigos do cliente A" não são um muro. Se o conteúdo está no índice do agente, assuma que ele pode sair. Isso vale tanto se a IA usa recuperação quanto um modelo ajustado, como explico em RAG vs. fine-tuning.
É aqui também que os tickets antigos importam. O histórico de tickets é o conhecimento específico de cliente mais rico que você tem, já que guarda todos os casos de borda que os artigos nunca cobriram. Também é a fonte mais fácil de misturar, porque um helpdesk costuma guardar os tickets de todos os clientes. Um copiloto de helpdesk do lado do agente é um lugar de menor risco para começar, já que uma pessoa lê cada rascunho antes de ele sair.
O que aprendi construindo isso na eesel
No início deste ano, uma equipe belga de tecnologia de entregas (holandês e inglês, 1,625 documentos, o teste mais movimentado da sua coorte) queria dois agentes de IA em cima de um único Zendesk. Um responderia usuários anônimos com artigos públicos, o outro responderia usuários logados com os públicos mais um subconjunto de artigos restritos. A importação da eesel conseguia filtrar por categoria, mas não escolher um subconjunto restrito artigo por artigo, então eles travaram. Mais ou menos na mesma época, vi outras equipes multimarca cancelarem porque a configuração por marca era complicada demais para fazer sozinhas.
Duas lições saíram daí. Primeiro, coloque o conteúdo específico de cada cliente em uma categoria ou seção própria desde o primeiro dia, porque quase toda ferramenta, IA incluída, delimita por contêiner com mais confiabilidade do que por artigo individual. Segundo, conectar por marca tem que ser o padrão, não uma configuração avançada. Hoje, na eesel, cada marca do Zendesk se conecta separadamente e importa tickets e artigos da central de ajuda somente dessa marca, e cada marca pode ir para um agente diferente. Uma empresa multimarca de bem-estar opera 5 agentes de IA específicos por marca dessa forma, cada um treinado com os tickets da própria marca.
Como configurar bases de conhecimento por cliente em 6 passos
Isso funciona em qualquer uma das ferramentas acima. A ordem importa mais que a ferramenta.
- Separe seus artigos em compartilhados e específicos do cliente. Faça uma auditoria da base de conhecimento rápida e etiquete cada artigo. Espere algo próximo da proporção de dois terços compartilhados, e anote quaisquer lacunas de conhecimento enquanto estiver nisso. Se a camada de um cliente for maior que o núcleo compartilhado, esse cliente pode precisar do Nível 2 ou 3.
- Dê a cada cliente um contêiner que seu helpdesk entenda. Uma organização do Zendesk, uma empresa do Freshdesk, um grupo de acesso do HubSpot, um grupo de usuários do Zoho. Mapeie os usuários automaticamente por domínio de e-mail ou dados de SSO sempre que possível, para que novos usuários do cliente não caiam no grupo errado.
- Coloque os artigos do cliente em uma categoria ou pasta só do cliente. Não misturados em seções compartilhadas. Este é o passo que torna a IA e as mudanças de permissão em massa gerenciáveis depois.
- Decida o que compartilhar por referência, não por cópia. Use multiposição, blocos de conteúdo ou categorias de portal que se associam a vários portais. Copie só quando a versão do cliente realmente diferir.
- Ative o login e depois teste como cada cliente. Entre como um usuário real do cliente A e do cliente B e busque o conteúdo do outro. Os documentos do Zendesk sobre restrição por login e segmentos dizem que o filtro de organização é ignorado para agentes logados e que os administradores de conhecimento ignoram toda restrição, então testar como você mesmo não prova nada.
- Delimite a IA por cliente e teste com o histórico desse cliente. Um agente por cliente ou marca, conectado apenas às fontes desse cliente. Rode-o contra os tickets antigos desse cliente antes de ele responder a alguém ao vivo.
Depois do lançamento, coloque a camada do cliente em um ciclo de revisão. Artigos por cliente envelhecem mais rápido que os compartilhados, porque dependem de um contrato ou de um contato que pode ter mudado. Vincule a revisão deles ao seu processo de mudança de políticas, para que uma atualização de contrato dispare uma atualização de artigo. Meu post sobre conteúdo desatualizado da central de ajuda mostra como detectar isso.
MSPs: Hudu e IT Glue já funcionam assim
Se você é um MSP, sua base de conhecimento por cliente provavelmente nem está no seu helpdesk. Está em uma ferramenta de documentação, onde a separação por cliente é o design inteiro.
| Hudu | IT Glue | |
|---|---|---|
| Contêiner por cliente | Espaço da empresa | Organização |
| Biblioteca compartilhada | Base de conhecimento central nativa | Uma organização compartilhada "Common Documents" |
| Preço | $27/usuário/mês anual, sem mínimo | $29 / $38 / $44 por usuário/mês, mínimo de 5 usuários, prazo de 36 meses |
| Portal do cliente | Usuários de portal gratuitos | Complemento MyGlue, $407/mês |
| IA | Assistente Hudini e MCP, incluídos | Cooper Copilot, listado em todos os níveis |
Fontes: preços do Hudu e preços do IT Glue.
Uma data para acompanhar: a versão 2.47 do Hudu começa a ser liberada em 12 de outubro de 2026, substituindo os portais de cliente por uma função de usuário de portal. O próprio aviso do Hudu é que os usuários de portal herdarão "everything their groups can see", enquanto o portal antigo só mostrava os registros marcados para ele. Se você compartilha documentos de clientes pelo portal do Hudu, confira as permissões dos seus grupos antes dessa data.
O problema de encontrar as informações também não some com uma ferramenta dedicada:
"It can be really difficult to find client specific information unless you know exactly how to search for it. There is sometimes lost time spent there."

Meu guia do sistema de tickets para MSP cobre o lado de ticketing da mesma stack.
Experimente a eesel para bases de conhecimento por cliente
Se você atende vários clientes ou marcas no Zendesk, Freshdesk, Gorgias ou Zoho Desk, a eesel dá a cada cliente o seu próprio colega de IA para o helpdesk, a mesma configuração que descrevo em suporte com IA para agências. Ela entra na fila existente, conecta por marca do Zendesk ou por conta de helpdesk, e aprende apenas com a central de ajuda, as macros e os tickets antigos desse cliente. Cada fonte é um interruptor, então você pode desligar um histórico de tickets com o qual o agente não deveria aprender, e "uninstall from agent" remove uma conexão do agente de um cliente sem tocar nos demais.

Antes de um agente entrar no ar para um cliente, a habilidade de simulação reproduz os tickets antigos reais desse cliente e compara as respostas dele com o que sua equipe enviou. As ações também são por agente, então permitir reembolsos para o cliente A não muda o que o agente do cliente B pode fazer.
Os preços incluem agentes e assentos ilimitados em todos os planos, começando grátis com 100 créditos e depois a partir de $299 por mês por 500 créditos, em que um ticket custa 1 crédito. Como a cobrança fica no nível do workspace, uma agência com seis clientes pequenos compra um plano de créditos para o total de tickets em vez de seis assinaturas. Se você preferir criar um agente por cliente via script, a CLI da eesel pode usar eesel agents create para criar um novo agente e apontar para qualquer um deles com --agent, a partir de um terminal ou de um agente de programação como o Claude Code.

O que a eesel não é: uma plataforma de IA white-label nem um programa de revenda, e suas funções de usuário valem para todo o workspace, não por cliente. Se seus clientes precisam de logins próprios para gerenciar o próprio agente, hoje isso é uma lacuna. Se você precisa que a IA de cada cliente fique na sua faixa, experimente a eesel grátis.