

多言語サポートQAが静かに失敗する理由
ほとんどのサポートQAプログラムは英語で作られ、それを引き伸ばしたものです。スコアカードはコピーされ、レビュアーのプールは同じまま、英語話者のレビュアーがドイツ語のキューを「読める」ように誰かが翻訳ボタンをオンにします。スコアは問題なさそうに返ってきます。それが問題なのです。
私はこれが内部で失敗するのを見てきました。eeselはドイツ語、オランダ語、フランス語、スペイン語、ルーマニア語などで、ライブのヘルプデスク上のAIを長年運用してきましたが、eeselが出荷した中で最悪の多言語バグは、悪い翻訳ではありませんでした。2026年初め、ベルギー、ドイツ、オランダのヘルプデスクで、ドイツ語とオランダ語の下書き返信に生のプレースホルダーが残ったまま出ていきました。{{ticket.requester.first_name}} や [Employee Name] のようなものです。文法チェッカーならこの下書きに問題なしとスコアを付けたでしょう。ネイティブスピーカーが一度読めば、2秒で気づいたはずです。
これがパターンです。第二言語で重要なエラーは、ほとんどがスペルミスではありません。
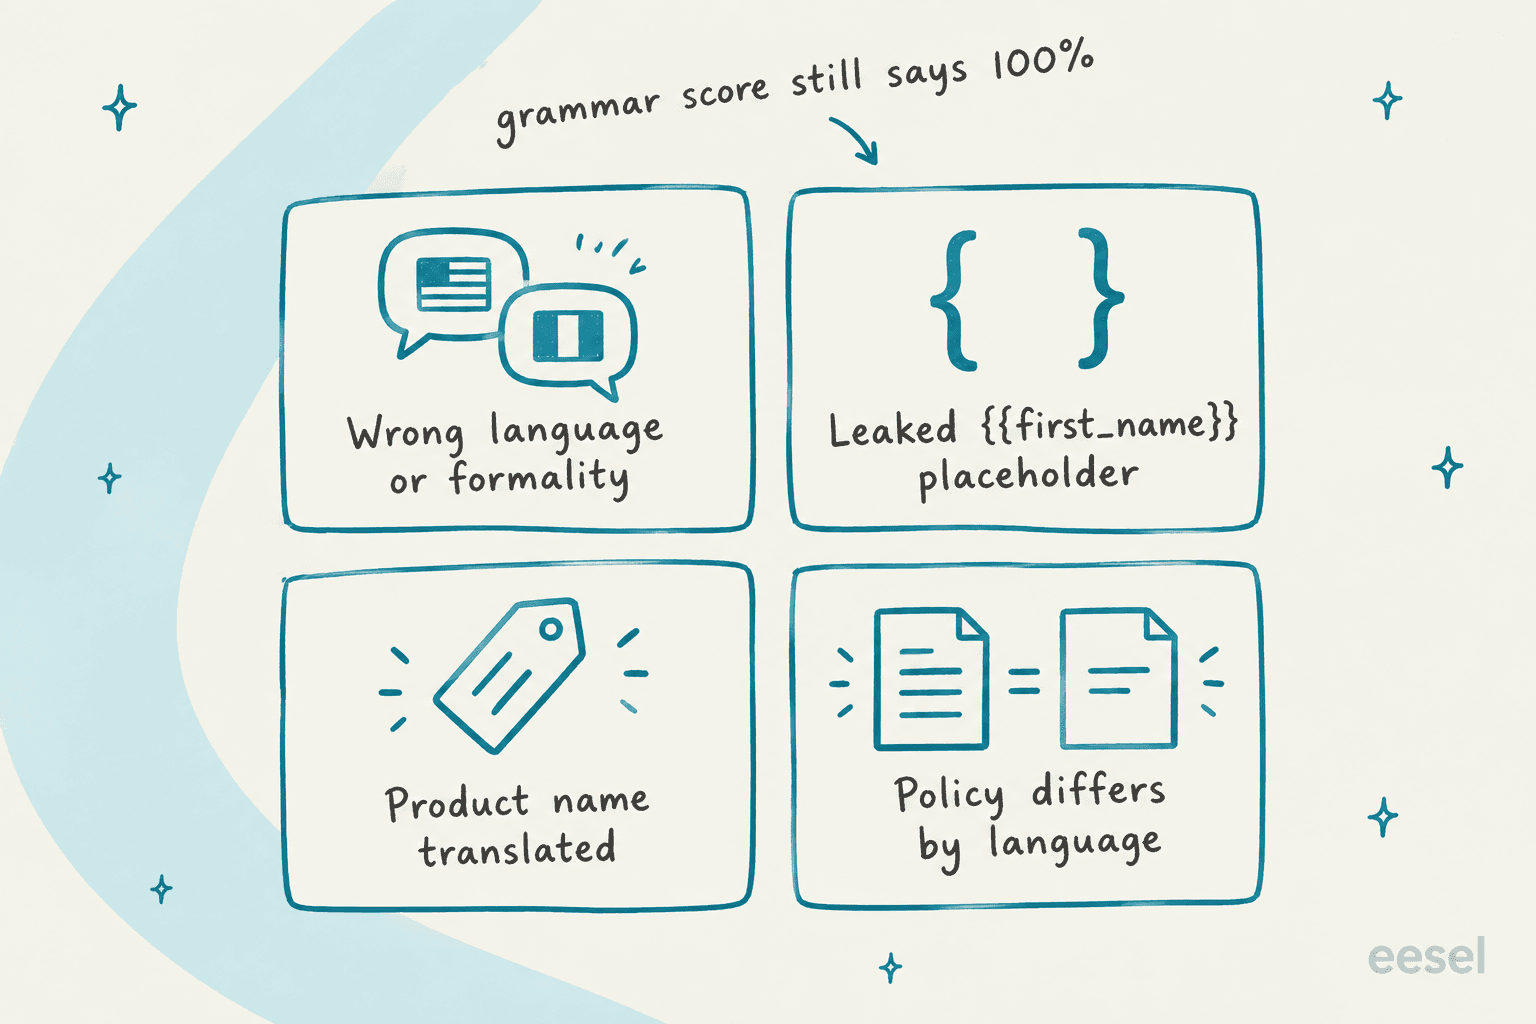
英語以外のQAが「翻訳ボタン付きの英語QA」でしかない場合、次のものがすり抜けます。
- レジスターと丁寧さ。 ドイツ語の du と Sie、フランス語の tu と vous、日本語の敬語レベル。機械翻訳はこれらを平板にするので、英語版を読むレビュアーは、エージェントが60歳のB2Bのお客様に10代のような口調で話しかけたことに気づけません。
- 仕組み上の漏れ。 プレースホルダー、マクロに残った英語の断片、スペイン語の返信の英語の結び。これらは「ここには私の言語を話す人がいない」と読めてしまいます。
- 用語。 製品名が普通名詞に翻訳される、あるいは1つの返信の中で同じ機能に3つの異なる言葉が使われる。現在、チケット単位の用語集を提供しているヘルプデスクがないため、サポート翻訳用語集について丸ごと1本のガイドを書きました。
- ポリシーのずれ。 英語のマクロは30日返品と言い、フランス語のマクロは2年前に翻訳されたまま14日と言っている。どの返信も文法的には完璧で、そのうち1つは間違っています。
英語以外の返信で何を採点するか
全言語で1つのスコアカードを使ってください。「ドイツ語のスコアカード」と「英語のスコアカード」に分けると、スコアは比較できなくなります。言語ごとに変わるのは、各項目を誰が採点できるかと、例がどう見えるかです。
私はカテゴリを1つの問いで分けます。それは翻訳で失われないか、です。機械翻訳を読むレビュアーが確実に採点できるなら、訓練を受けたレビュアーなら誰でも採点できます。シグナルが原文の言い回しにあるなら、その言語を読める人だけが採点すべきです。
| スコアカードの項目 | 何を確認するか | 翻訳から安全に採点できるか |
|---|---|---|
| 解決策と正確さ | 正しい回答、正しいポリシー、正しい次のステップ | はい(翻訳が忠実なら) |
| プロセス | 正しくタグ付け、リンク、エスカレーションされている | はい |
| 理解度 | エージェントが実際の質問を理解したか | おおむね |
| 言語の一致 | お客様の言語で返信し、英語の断片がない | 一部(原文の表示が必要) |
| スペルと文法 | 原文言語での基本的な正しさ | いいえ |
| 丁寧さとトーン | Sie と du、敬語レベル、温かみ | いいえ |
| 用語 | 製品名がそのまま、承認済みの用語を使用 | いいえ |
| プレースホルダーと漏れ | {{ }} トークンなし、内部メモなし、誤った言語の結びなし | はい、ただし原文でのみ |
4つの「いいえ」の項目こそ、ネイティブレビューの時間を充てるべき場所です。それ以外は、既存のレビュアーが翻訳を使って採点できるので、プログラムのコストを抑えられます。これらの項目の背後にある一般的な基準については、カスタマーサポートの言語品質のガイドが文法、明瞭さ、トーンを解説し、カスタマーサービスのトーンガイドが、実際に採点基準にできるトーンのルールの書き方を扱っています。
スコアカードにもう1つルールを加えましょう。「ポリシーが英語の原文と異なる」を重大エラーにすることです。プロの翻訳チームが品質採点に使うフレームワークであるMQMは、他がどれだけ良くても、重大エラーを1つ出せば自動的に不合格とします(MQM values and scores)。サポートQAもこれを借りるべきです。美しく書かれた間違った返金ポリシーも、間違った返金ポリシーのままです。
翻訳者がすでに使っているエラータイプを借りる
カテゴリを発明する必要はありません。MQMは翻訳エラーを7つのグループに分類しています。用語、正確さ、言語的慣習、スタイル、ロケール慣習、対象読者への適合、デザインとマークアップです(MQM error typology)。デフォルトのペナルティは、中立が0、軽微が1、重大が5、致命的が25です(MQM values and scores)。ISO 5060:2024は、エラータイプとペナルティを組み合わせる同じ方式に基づく正式な規格です。
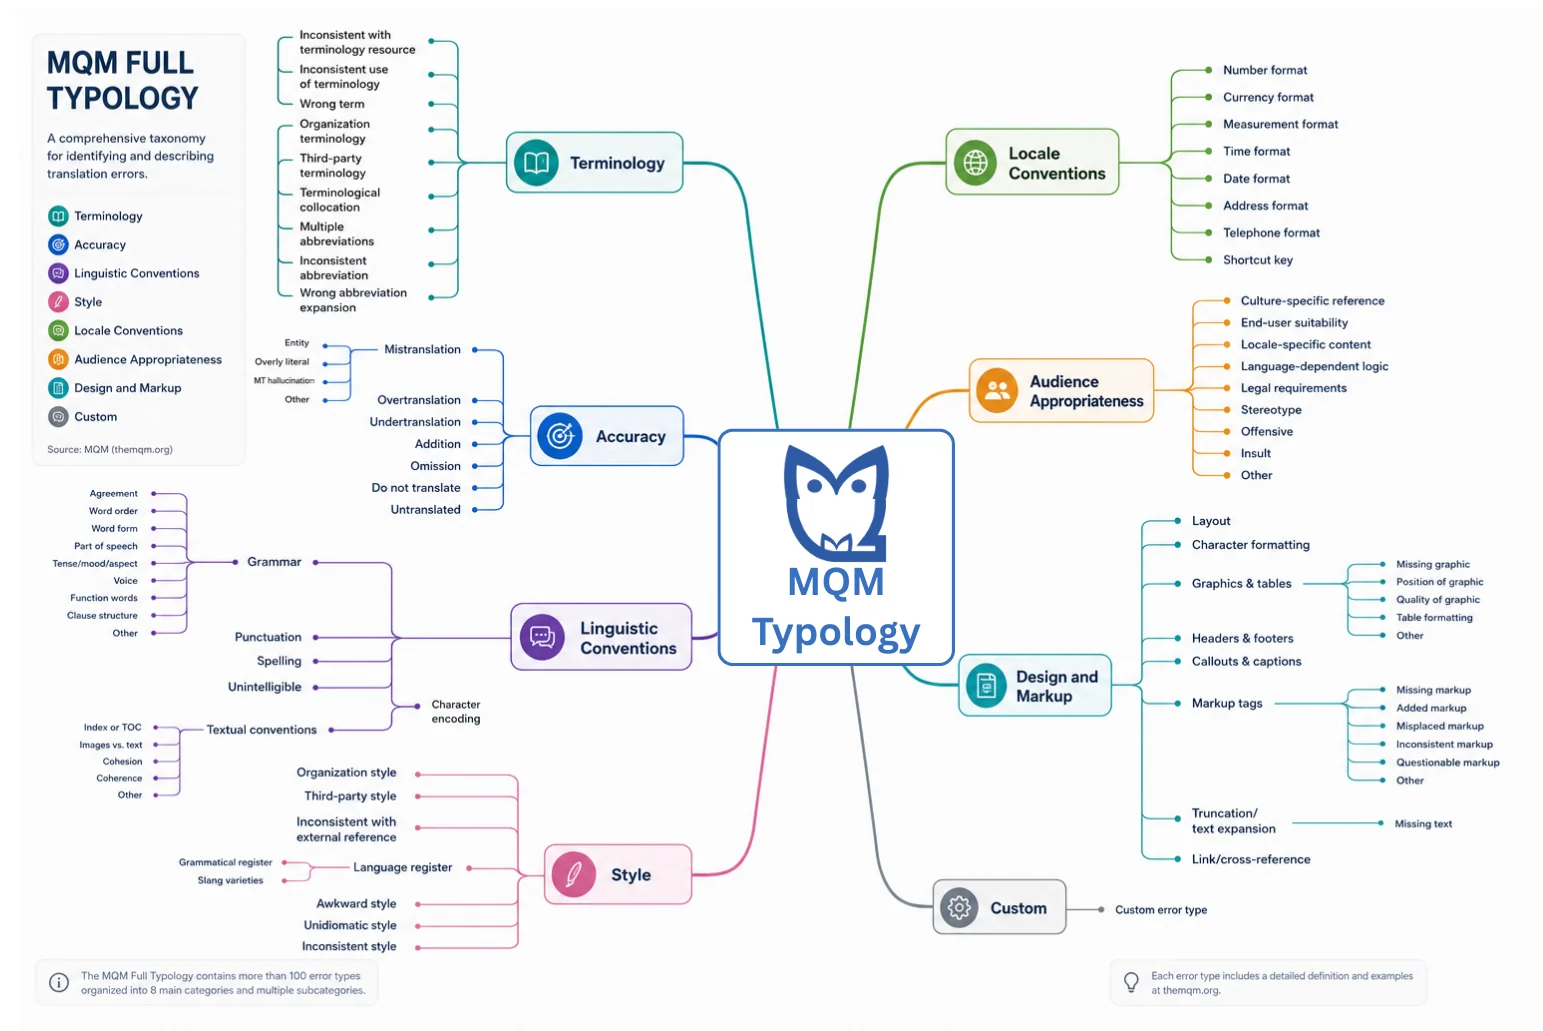
2つのブランチはサポート業務にぴったり対応します。「ロケール慣習」は日付、通貨、数値、住所の形式を扱い、米国で訓練されたエージェントがドイツのお客様に 10/05 と書くと、そのお客様は5月10日と読んでしまう、まさにその場面です。「デザインとマークアップ」は欠落または壊れたマークアップを扱い、プレースホルダーの漏れはこの系統に属します。サポートチケットにMQMの完全な採点を適用することはお勧めしません(翻訳文書向けに作られていて、1,000語あたりのエラー数を数えます)。ただ、そのカテゴリ名をエラータグとして使うと、QAデータがはるかに活用しやすくなります。
1言語が量の84%を占めるときのチケットのサンプリング方法
ランダムサンプリングは、チケット間では公平ですが、言語間では不公平です。英語が量の84%、ドイツ語が12%、オランダ語が4%なら、週50件のランダムレビューは英語42件、ドイツ語6件、オランダ語2件になります。2件のレビューでは、オランダ語のエージェントに癖があるのか、火曜日が悪かっただけなのか判断できません。電話チームも同じ問題を抱えており、そのためコールセンターQAプログラムも通常は層化サンプリングを行います。
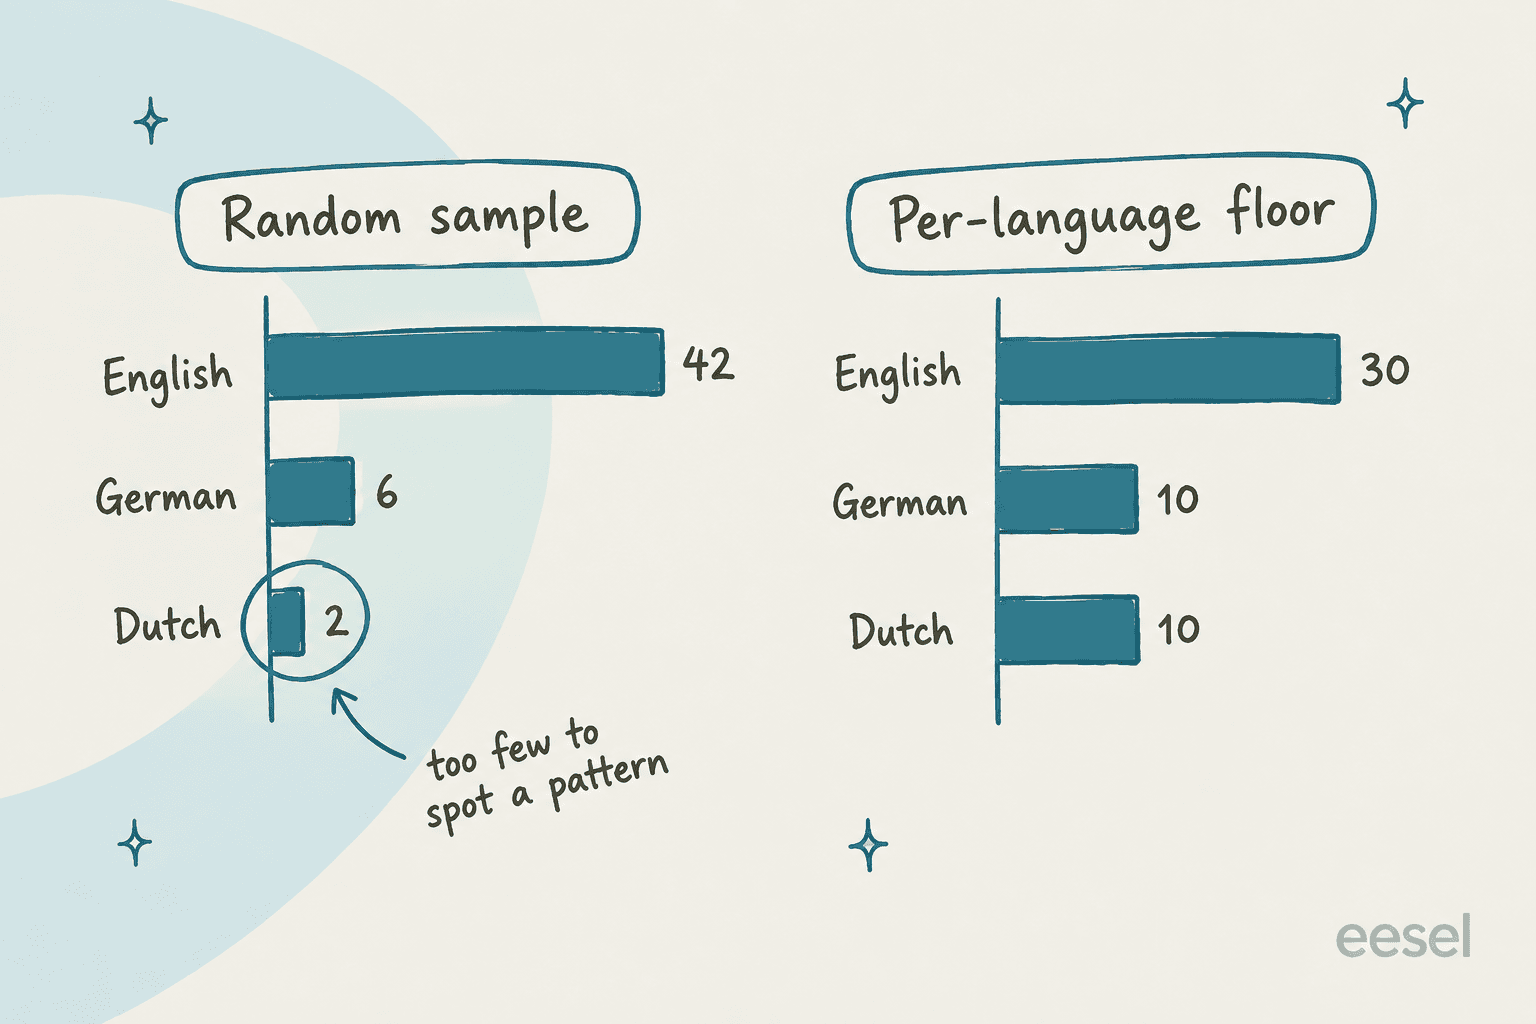
解決策は下限です。すべての言語に週あたり少なくともN件のレビューを割り当て、残りの予算は量に比例して大きな言語に回します。下限を10にすると、同じ50件のレビューが英語30件、ドイツ語10件、オランダ語10件になります。英語は依然として最も多くの注目を受けます。オランダ語は、ようやくパターンが見えるだけの件数を得られます。
ここにご自身の数字を入れてみてください。
言語ごとに週およそ10件の下限が、私がトレンドを信頼できる最小の数です。予算がすべての言語でそれを賄えない場合は、小さな言語を毎週5件ではなく、隔週で20件レビューしてください。少量を頻繁に回すより、大きなバッチを少ない回数で行うほうが優れています。
2つのフィルターで、サンプルは大きくなるだけでなく賢くなります。
- 新人エージェントと新しい言語をオーバーサンプリングする。 新しい市場や新人の最初の1か月は、エラーを最も安く直せる時期です。新人にレビューを集中させる方法は、エージェントのオンボーディングガイドで扱っています。
- 小さな言語の低CSATをオーバーサンプリングする。 怒ったオランダ語のお客様は、全体の625件に1件ではなく、オランダ語チケットの25件に1件です。毎回拾いましょう。AI CSATツールなら自動的に浮かび上がらせられます。
誰が何をレビューするか:ネイティブレビューと翻訳レビュー
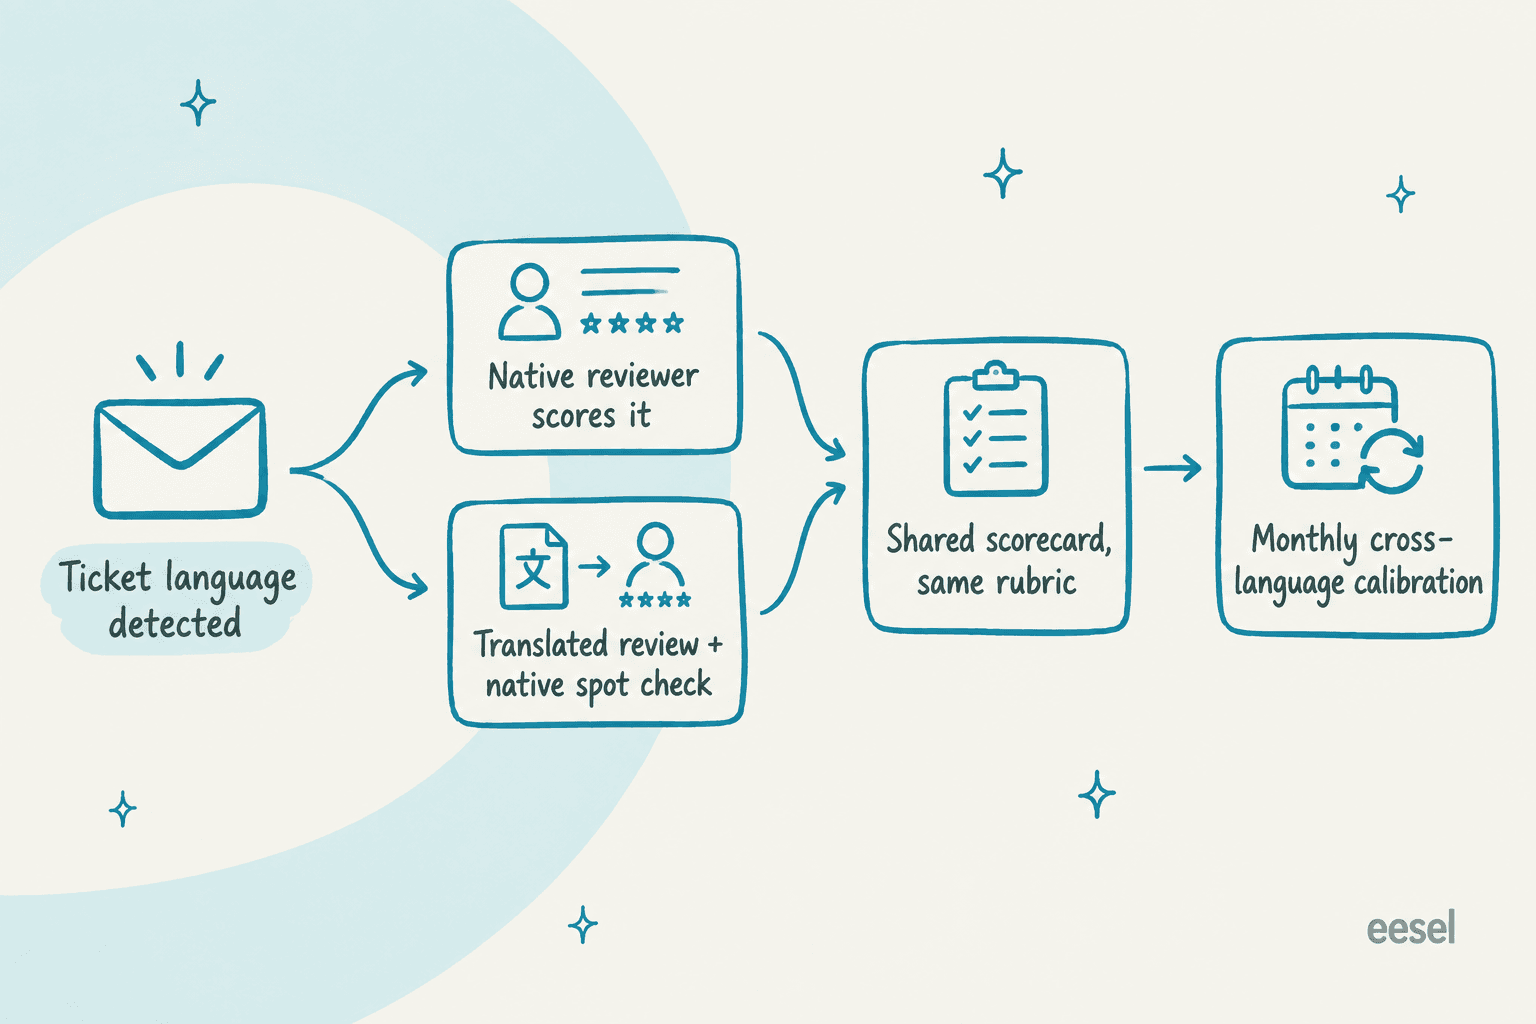
英語以外のQAの体制づくりには3つの方法があり、ほとんどのチームは結局3つすべてを使います。
1. 各言語のネイティブレビュアー。 最高水準で、最もコストがかかります。通常はその言語チームのシニアエージェントで、週に数時間のレビュー時間が与えられます。オフショアチームでは、その拠点のチームリーダーであることが多いです。スコアカードの4つの「いいえ」の項目を担当します。
2. コアQAチームによる翻訳レビュー。 既存のレビュアーが、ツール内の翻訳を通して解決策、プロセス、理解度を採点します。安価で、すべての市場の正確さを同じ目で見続けられます。フォロー・ザ・サン型サポートを運用するチームが最も頼りにしています。
3. 翻訳レビューに対するネイティブの抜き取りチェック。 月に一度、ネイティブスピーカーが、コアチームがすでに翻訳経由で採点した会話をいくつか採点し直します。スコアが乖離するなら、翻訳レビューは何かを見逃しているので、より多くの量をオプション1に移します。1つの言語にしか存在しないナレッジギャップが見つかるのもここです。
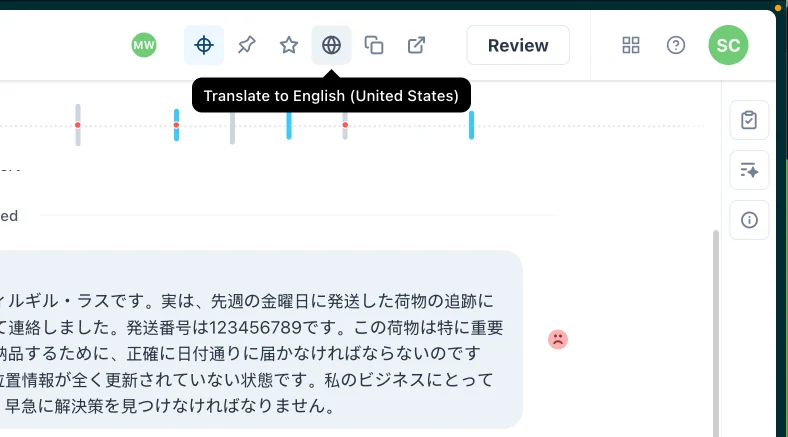
振り分けは、ツールが今ではうまく扱える部分です。Zendesk QAでは、レビュアーは地球儀アイコンをクリックして会話を自分のプロフィール言語に翻訳し、原文に切り替え直せます(Using the Conversations view)。これは主要29言語をカバーし、Supportのライブ翻訳は対応していても、アラビア語、ヘブライ語、ウクライナ語はQAのリストにありません(Zendesk language support by product)。
振り分けのために、Zendesk QAには「is」/「is not」の条件を持つ**Language (AI)**会話フィルターがあります(conversation filter types)。また、グループは割り当てで使うために、レビュアーを「言語などの特性に基づいて」整理できます(groups in Zendesk QA)。「言語ごとにN件サンプリングする」という単一のスイッチは見つかりませんでした。下限は、Language (AI)条件と固定件数を持つ割り当てを言語ごとに1つ作ることで実現します。
Zendesk Support側の落とし穴が1つあります。インテリジェントトリアージのLanguageフィールドは件名と最初の公開コメントから読み取られ、「エンドユーザーの返信のたびには更新されません」(intelligent triage)。英語で始めてドイツ語に切り替えたお客様は、「英語」のチケットのままです。ワークフローでトリアージの値を使うには、Copilotアドオンも必要です(triage workflows)。この設定の詳細は、Zendeskインテリジェントトリアージのガイドをご覧ください。
これがなければどうなるか。あるコールセンターのQA担当者がRedditではっきり述べています。
"I was responsible for QA on a team taking Spanish calls. Don't speak a word myself. Yea, plenty of 100's were given."

会話を読めないレビュアーによる満点は、品質データではありません。数字の付いた死角です。
自動QAが他言語で採点できること、できないこと
自動QAはカバレッジのギャップを埋めますが、その言語リストはほとんどのチームが思うより短いです。QAまたはWorkforce Engagementアドオンが必要な、Zendesk QAのAutoQAのカバレッジは次のとおりです(autoscoring categories)。
| AutoQAカテゴリ | LLMオプションをオンにした場合の言語 | オフの場合 |
|---|---|---|
| スペルと文法 | 9バリアント:英語(US、UK)、ドイツ語、フランス語、ポーランド語、スペイン語、ポルトガル語(BR、PT)、オランダ語 | 同じ9つ |
| 読みやすさ | 英語、スペイン語 | 英語、スペイン語 |
| 挨拶、結び | すべて | 8言語 |
| トーン、共感、理解度、提示された解決策 | すべて | 利用不可 |
最初の行をもう一度読んでください。イタリア語、日本語、スウェーデン語のエージェントには、自動のスペルと文法スコアがまったく付きません。LLMオプションをオンにしていてもです。チームの半分がそれらの言語で書いているなら、「カバレッジ100%」のダッシュボードは、ネイティブのお客様が最初に気づく点以外のすべてで彼らを採点していることになります。
言語ごとの設定も重要です。スペルの例外(最大300件)と承認済みの挨拶(最大200件)は、それぞれ言語にひも付けられ、「挨拶は翻訳されません」(customizing AutoQA)。Zendesk自身の例では、すべての言語で「Bom dia」を承認すると、スペイン語の会話で「Buenos días」と書いたエージェントは低評価になります。
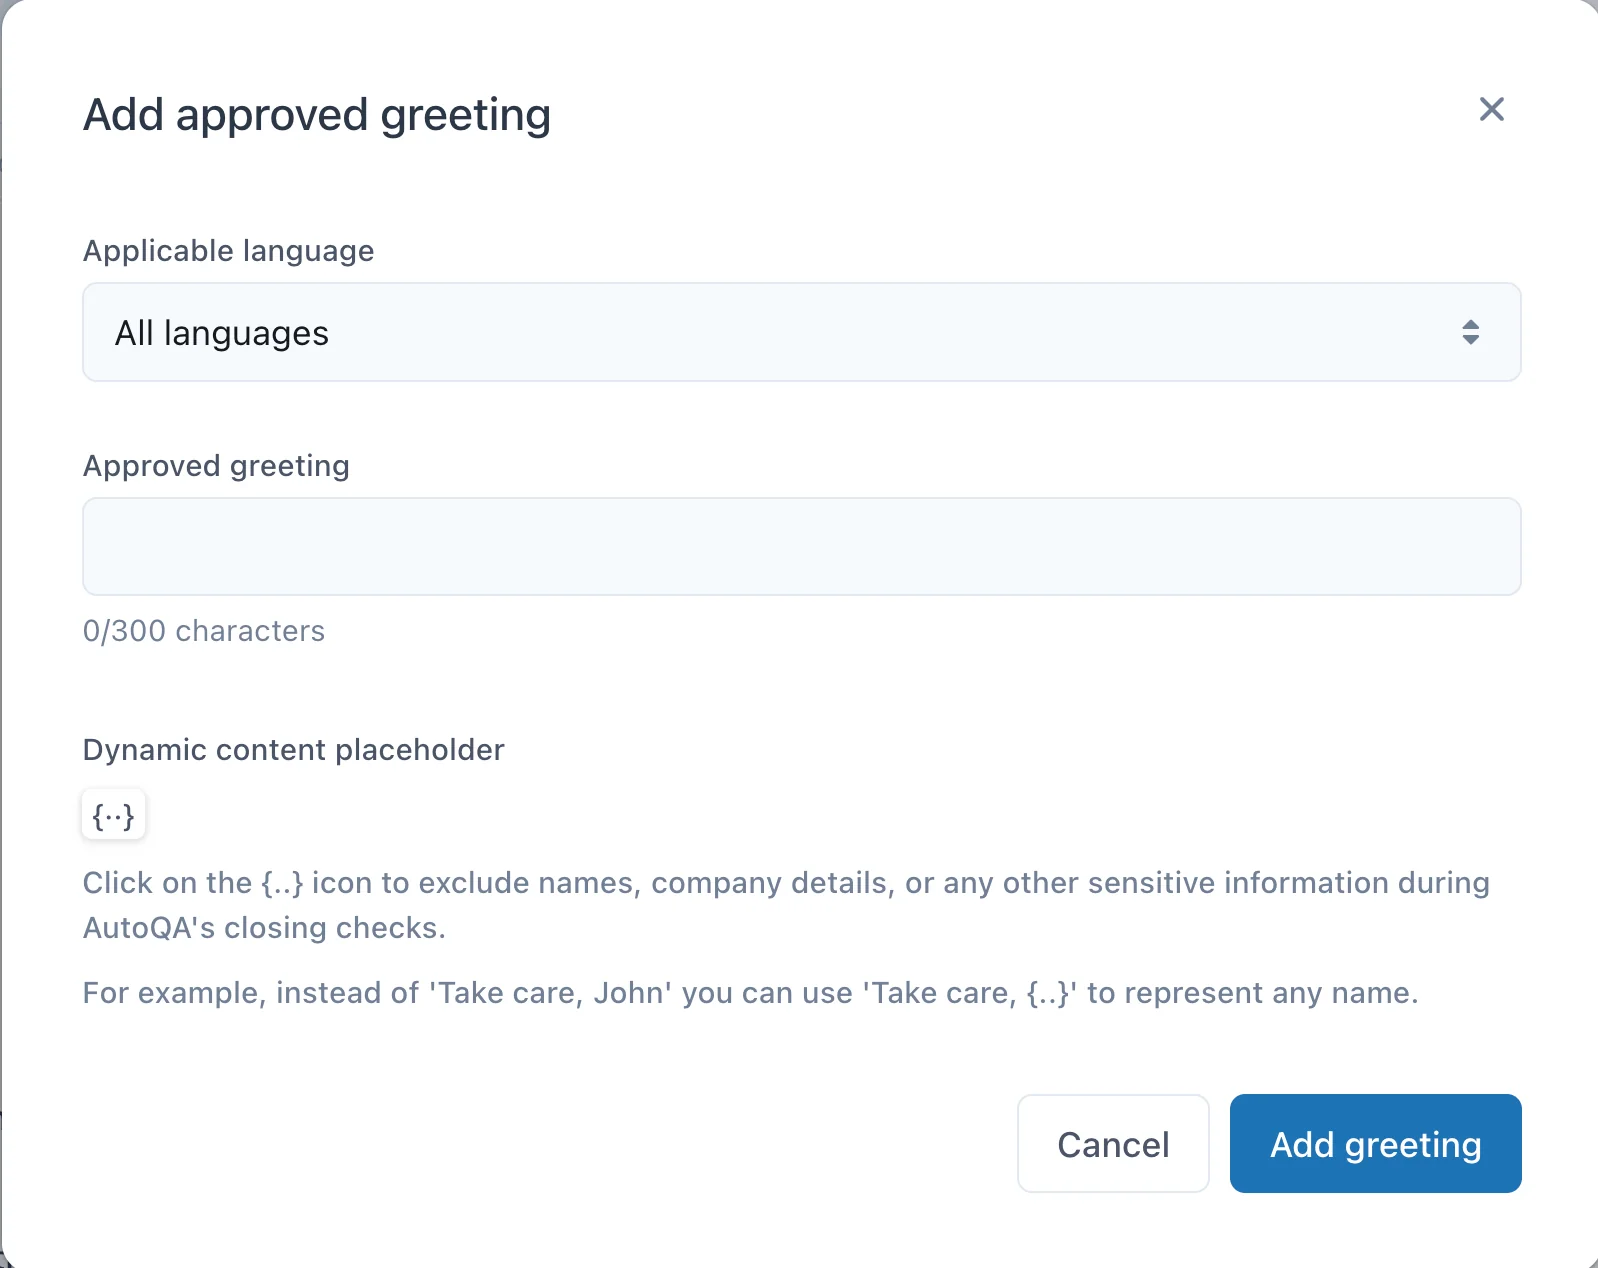
そのため、初日から挨拶と結びを言語ごとに設定してください。さもないと、自動スコアが、ローカライズを正しく行っているエージェントをまさに罰することになります。Zendeskも、自動評価は「参考用のみ」であり、それだけでパフォーマンスの判断を左右すべきではないとしており(Zendesk QA account settings)、これは自動スコアに穴があるどの言語にも適した姿勢です。
他のQAプラットフォームの文書化は少なめです。evaluagentでは、生成AIによるQA項目を自分の言語で書け、通話では話されている言語を自動検出します。Rippit(MaestroQAの新名称)は平易な言葉で書かれたエージェントにより会話の100%を採点します(Rippit announcement)が、翻訳や言語フィルターの機能の記載は見つかりませんでした。言語カバレッジが重要なら、購入前にそのリストを書面で求めてください。
私が比較したAI QAツールはこの点で大きく異なり、より広い分野はQAツールの総まとめで扱っています。
ヘルプデスクが標準でレビュアーに提供するもの
QAツールは半分にすぎません。レビュアーはヘルプデスク内で作業することが多く、そこで何が見えるかは、エージェントが使う翻訳機能によって決まります。
| ヘルプデスク | 言語検出 | レビュアーが見られる翻訳 | プランまたは上限 |
|---|---|---|---|
| Zendesk | トリアージのLanguageフィールド、約150言語、最初のメッセージのみ | 音声を除くすべてのチャネルで会話翻訳。受信チャットの翻訳は保存されず、再読み込み時に再実行される | チケット翻訳はTeam+から。ワークフローでのトリアージにはCopilotが必要 |
| Freshdesk | チケットごとに検出、エージェントが上書き可能 | 「See original」付きのLive Translate、43言語 | Pro/Enterprise、Copilotライセンスあたり月100チケットの翻訳 |
| Gorgias | 最大54言語、メッセージ本文のみ | 受信と送信の翻訳、ホバーで原文を表示 | すべてのヘルプデスクプラン |
| Front | 受信と送信で自動検出 | 翻訳はスレッド上のすべてのチームメイトに表示され続ける | Starter+、チームメイトあたり1日1,500リクエスト |
| Help Scout | 受信については記載なし | AI Assistは送信テキストのみ翻訳 | Plus/Pro、またはコンタクトベースのプラン |
この表の2つの行は、QAで本当に頭の痛い問題を引き起こします。Zendeskの受信チャット翻訳は「チケットが更新または再読み込みされるたびに再度実行されるため、翻訳結果が変わることがあります」(Zendesk)。つまり、レビュアーが読む英語が、エージェントが見た英語とは限りません。そしてFreshdeskは、別のエージェントが翻訳するとチケットを再度カウントします(Freshdesk)。QAレビュアーが翻訳を開くと、エージェントの月間上限を消費しかねません。Freshdeskでは、レビュアーにエージェント用ではなくQAツールの翻訳を使わせてください。
ツールごとの詳細は、Zendeskのネイティブ翻訳オプション、Front AI Translate、Freddy AI Copilotをご覧ください。
翻訳レイヤーを使っているなら、その品質レポートを読む
UnbabelやLanguage I/Oを使っているチームには、すでに2つ目のQAシグナルがあるのに、見過ごされがちです。Unbabelはすべての翻訳に品質推定を実行し、人間のレビュアーが付けるであろうMQMスコアを予測します。そのレポートは翻訳をBest(98以上)からWeak(60未満)までの5つの帯に分け、赤の帯に10%を超えて入ると、その言語ペアは基準を満たしません(Unbabel quality reporting)。
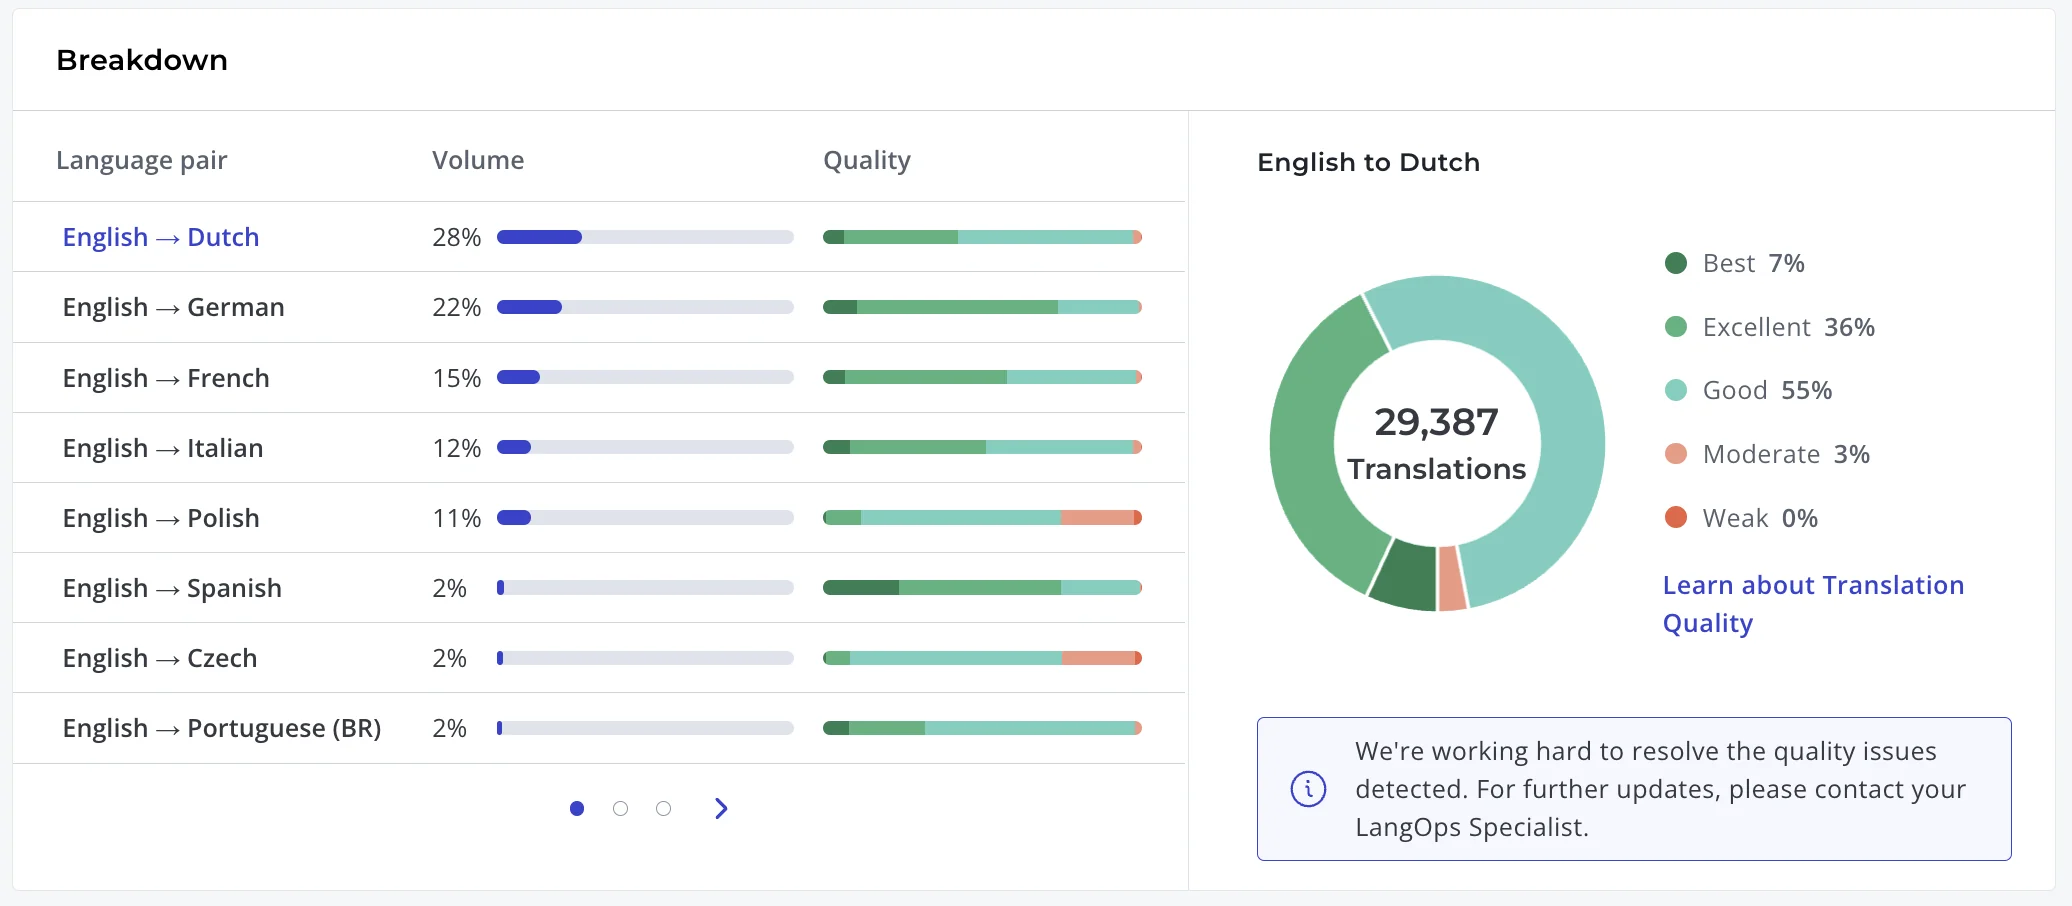
このペア別の表示はサンプリングに役立ちます。英語からポーランド語のほうが英語からドイツ語よりModerateの翻訳が明らかに多いなら、翌月はネイティブレビューの時間をポーランド語により多く充ててください。Language I/Oは、過去の結果と用語集ルールに対するリアルタイムの品質モニタリングを説明しており、エージェントが悪い翻訳にフラグを立てて再生成できますが、採点の尺度は公開していません。
これらのレポートが教えてくれないこと。それは、原文の返信が正しかったかどうかです。間違った回答の完璧な翻訳はBestと採点されます。翻訳品質とサポート品質は別々のチェックであり、両方が必要です。
言語チーム間でキャリブレーションする方法
キャリブレーションは、多言語QAプログラムがまとまり続けるか、孤島に分裂するかの分かれ目です。目標は単純です。スペイン語のレビュアーが付けた「5段階中4」は、英語のレビュアーの「4」と同じ意味でなければなりません。
私の経験で機能するやり方は次のとおりです。
- 毎月5〜8件の会話を選び、少なくとも言語ごとに1件含める。 組み合わせを使います。問題のない返信1件、ポリシーエラーのある返信1件、トーンに問題のある返信1件。
- 全員が同じ会話を独立して、必要なら翻訳を通して採点する。 ネイティブのレビュアーは、自言語の言語のみの項目も採点します。
- 合計ではなく、項目ごとにスコアを比較する。 合計が一致していても、トーンに厳しく正確さに甘いレビュアーが隠れている場合があります。
- 解決した食い違いはすべて採点基準の例として書き残し、繰り返される問題はコーチングに回す。 「B2Bのお客様に du を使う = トーン不合格、チケット4821を参照」は、定義の段落よりも価値があります。
- 言語ごとのばらつきを時系列で追跡する。 ある言語チームのスコアがずれ続けるなら、そのチームには専用のセッションが必要です。
Zendesk QAの正確さスコアはここで参考になるモデルです。AutoQAと人間のレビュアーの一致度を測り、Zendeskは75%を超えるものを高い一致と見なします(AutoQA dashboard)。同じ考え方を人間のレビュアー同士にも適用してください。その結果をエージェントにフィードバックする方法は、QAフィードバックの例とサポートエージェントへのフィードバックのガイドが表現を扱っています。
逆の失敗も同じくらいよくあります。英語以外の会話を、英語の文言に照らして採点してしまうことです。あるバイリンガルのエージェントがまさにそれを述べています。
"I got QA-ed that my Spanish questions were not close enough to the English script, deducted 7 points."
スペイン語のスクリプトは存在しませんでした。キャリブレーションのセッションは、そうしたルールを見つけ、「自然なスペイン語で、スクリプトの意図に合っていること」と書き直す場です。
他言語でのAI返信のQA
AIエージェントが他の言語で返信を下書きまたは送信するなら、上記のすべてが引き続き当てはまり、さらに1つルールが加わります。ローンチ前に、英語だけでなくすべての言語をテストすることです。
AIは多言語サポートがとても得意です。あるeeselのトライアルでは、ZendeskとShopifyで月約1,000チケットを扱うドイツのジュエリーブランドが、誰も言語を1つも設定していないのに、エージェントがドイツ語、英語、フランス語、オランダ語、スペイン語、ポーランド語、クロアチア語、トルコ語に対応するのを目にしました。これが利点です。欠点は、チームの誰も読めない言語も含め、すべての言語が責任を負うライブの接点になることです。
誰も英語以外の出力をレビューしないと、その裏面が表れます。あるZendesk管理者は、以前の多言語アンサーボットをこう述べています。
"the translations were often times wrong and our customers got mixed languages during their chat with the bot, ID customers will sometimes get Portuguese, IN customers would sometimes get Indonesian, and so on and so forth."
オートパイロットをオンにする前に、言語ごとに私が確認する点は次のとおりです。
- 回答が一般知識ではなく、あなたのナレッジから来ている。 同じヘルプセンター記事は、フランス語でも英語と同じポリシーを生むはずです。多言語ナレッジベースに穴があれば、AIはそれを引き継ぎます。
- 丁寧さが市場ごとのブランドに合っている。 期待するのではなく、ルールとして書きます(「ドイツのお客様全員に Sie を使う」)。
- 製品名が翻訳されない。 翻訳しないリストは指示に入れます。やり方は翻訳用語集ガイドに示しています。
- プレースホルダー、英語の断片、誤った言語の結びがない。 冒頭で述べた理由から、私が最初に確認するのはこれです。
次に、履歴に対して実行します。eeselのシミュレーションは実際の過去のチケットを再生し、各回答を採点して修正を提案します(eesel skills)。その実行をドイツ語とオランダ語のチケットに絞れば、お客様が下書きを1通も見る前に、言語ごとの評価が得られます。Zendesk QAはZendesk AIエージェントも自動で採点し、他のボットをレビュー用にフラグ付けできます(AI agents in Zendesk QA)。これでローンチ後の側面がカバーされます。さらに詳しくは、AIエージェント向けZendesk QAのガイドをご覧ください。
多言語サポートQAでよくある間違い
- 翻訳経由だけでレビューする。 間違った回答は拾えますが、ネイティブのお客様が最初に反応するものをすべて見逃します。
- 1人の英語レビュアーがすべての小さな言語を「担当」する。 正確さには問題ありませんが、トーンは見えません。パートタイムでも、各言語にネイティブの抜き取りチェック担当者を置きましょう。
- 英語の挨拶をすべての言語にコピーする。 その結果、自動スコアがきちんとローカライズしているエージェントを罰してしまいます。
- 検出された言語フィールドを信用する。 多くの場合、最初のメッセージだけから設定されます。言語が混在するチケットは、誤ったバケットに入ります。
- 翻訳品質をサポート品質として扱う。 間違ったポリシーの完璧な翻訳でも、お客様の期待には応えられません。
- 言語間でマクロのバージョン管理をしない。 ポリシーのずれは、誰かが英語のマクロを更新して残り5つを忘れた日に始まります。言語ごとに担当者を置いたサポートSOPがそれを防ぎます。
多言語サポートにeeselを試す
3〜4言語でサポートを運用しているなら、市場を追加するたびにQAの負荷が増えます。だからこそ、私はeeselを多言語サポートに最適なAIのリストに入れました。
eeselのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、その他のスタックに接続し、ヘルプセンターを翻訳しなくても、お客様の言語で回答し、「ドイツのお客様には Sie を使う」や「製品名は絶対に翻訳しない」といった平易な言葉のルールを受け付けます。公開前に、各言語であなた自身の過去のチケットを再生し、どこで間違えたはずかを確認できます。

ほとんどのチームは下書きを内部メモとして始めるので、ネイティブのレビュアーはお客様より先にすべての英語以外の返信を見られます。そしてスコアが安定したら、言語ごとに自動送信へ移行します。プランは月299ドルで500クレジットから、無料トライアル付きです(eesel pricing)。まずは1つの言語のキューでeeselを試し、どう採点されるか確かめてください。