

要点
実際の判断に役立つAIサポートエージェントのベンチマークは、「解決済み」の定義を1つにそろえ、同じチケットで自社のエージェントとチームを評価するものだけです。ベンダーの解決率は、そのままでは比較できません。Zendesk、Gorgias、HubSpot、Freshdesk、Salesforce、Help Scoutはそれぞれ異なる判定基準を使っているため、返信が途絶えた同じ顧客でも、あるツールでは成功、別のツールでは判断保留になります。tau-benchのような公開テストが順位付けするのはモデルであって、自社の設定ではありません。eeselのシミュレーションは、まさにこの比較を行います。解決済みチケットを再現してチームが実際に送った返信と比較し、顧客に何かが届く前に、トピックごとに採点します。
「AIサポートエージェントのベンチマーク評価」とは、実際には何を意味するのでしょうか?
私はeeselでAIエージェントを開発していますが、導入後に最もよく聞かれるのは「60%は良い数字ですか?」といった質問です。正直な答えは、それが何の60%なのかによる、です。「ベンチマーク」という言葉は、通常、3つの異なるもののいずれかを指しています。それらを混同すると、チームは判断に使えない数字を手にすることになります。
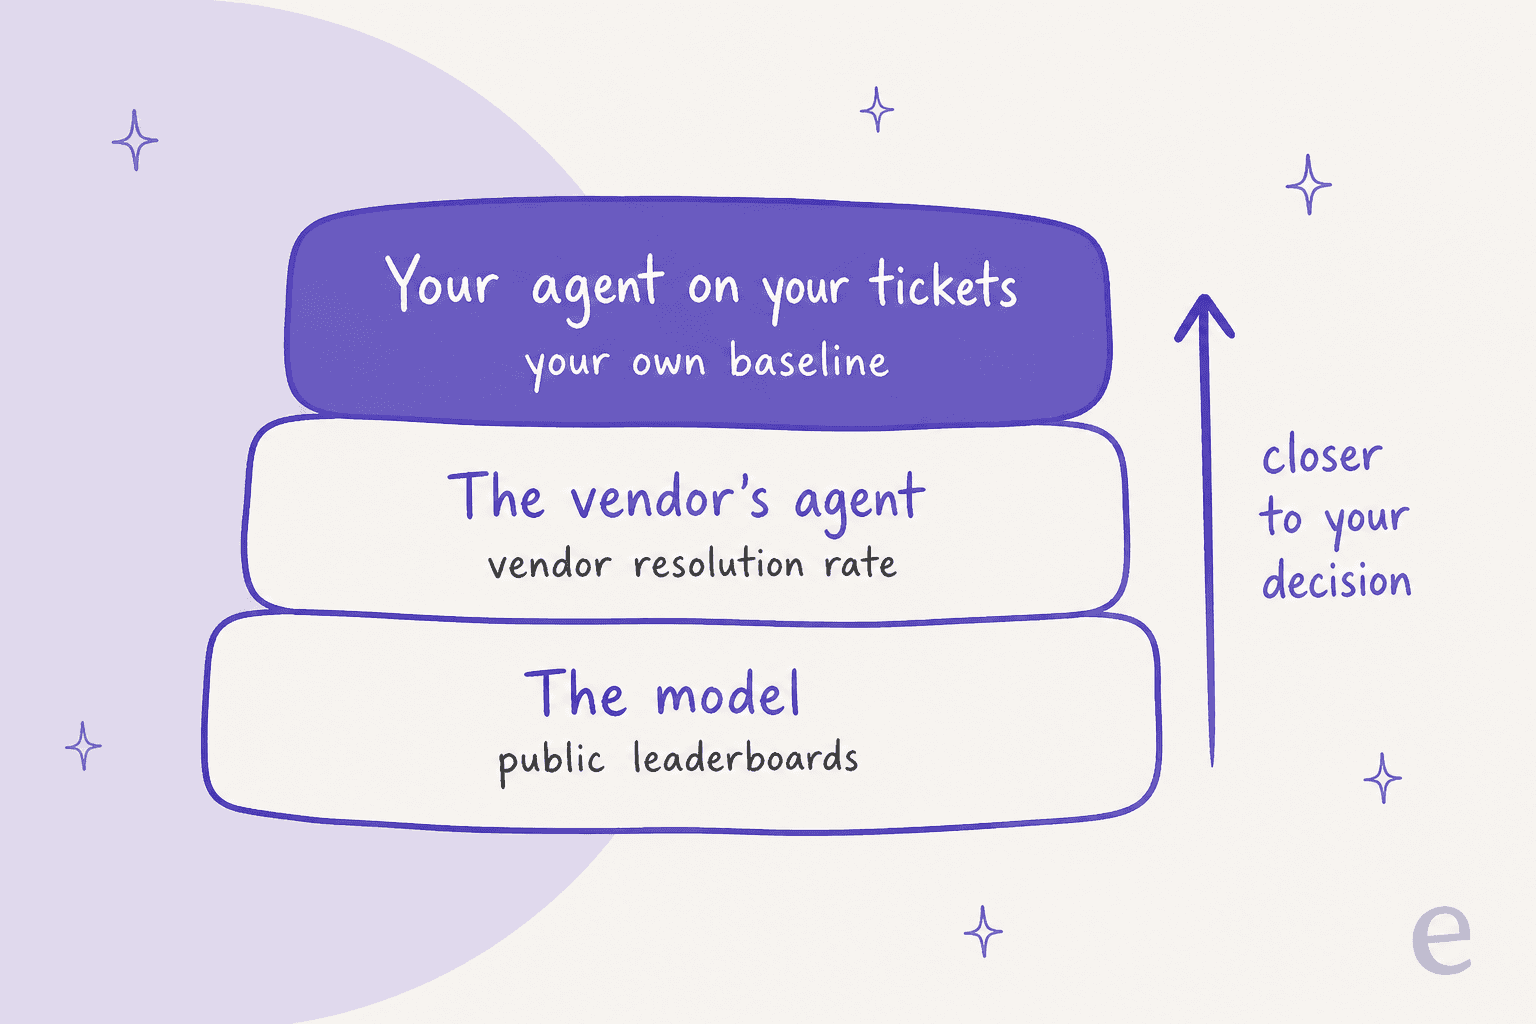
- モデル。 tau-benchのような公開ランキングは、シミュレーションしたサポートタスクで、基盤となる大規模言語モデルをテストします。モデル選びには役立ちますが、自社のナレッジベースについては何も教えてくれません。
- ベンダーのエージェント。 ヘルプデスクに表示される解決率や、ベンダーがホームページに載せている平均値です。それぞれのベンダーが、自社の課金のために定義しています。
- 自社チケットで評価する自社エージェント。 自社の設定、ドキュメント、ポリシーを使い、同じ質問に自社チームがどう対応したかを基準に評価します。AIに任せる範囲を広げるべきかを教えてくれるのは、これです。
この層を進むほど、実際に下す必要のある判断に近づきます。この記事の残りでは、3つすべてを順に見ていきます。私が最もよく目にする失敗は、チームが第2の層の数字を、第3の層の数字であるかのように引用することだからです。
ベンダーの解決率を比較できないのはなぜですか?
どのベンダーも、異なる判定基準で解決をカウントしているうえ、そのほとんどが同じ基準で課金しているからです。私は今週、各ベンダーの公式ヘルプドキュメントを確認しましたが、「解決済み」の意味が一致するベンダーは2社とありませんでした。
| ベンダー | 解決済みとみなす条件 | 判定期間 | それに基づく課金はあるか? | 単位あたりの料金 |
|---|---|---|---|---|
| Zendesk | AIが回答し、顧客が追加の要求をせず、リクエストが満足のいく形で解決されたとLLMが確認します。判定に不合格 = "Contained"、課金なし | 最初のメッセージから数えて、メールは72時間、メッセージングはデフォルトで2時間(最大72時間) | はい | 契約分は$1.50、従量課金は$2.00 |
| Gorgias | AIまたは自動化がすべて対応し、72時間以内に人の対応が不要 | 72時間 | はい、チケット料金も別途必要 | 料金ページでは超過分が$1.50 |
| HubSpot | エージェントがコンテンツソースまたはアクションで返信し、訪問者からの引き継ぎ要求がない場合、またはリードが適格、一部適格、不適格のいずれかに分類された場合 | 訪問者の最後のメッセージから72時間 | はい | $0.50(50クレジット) |
| Freshdesk Freddy | レポート上:人の介入なしでクローズ。課金は結果にかかわらずセッション単位 | 1セッションあたりチャットは24時間、メールは72時間 | いいえ、セッション単位で課金 | 100セッションあたり$49 |
| Salesforce Agentforce | LLMがセッションを4または5と採点すると"Deflected"と判定され、これは"mostly or fully resolved"を意味します | 離脱判定までのタイムアウトは2時間 | いいえ、会話単位で課金 | 1会話あたり$2 |
| Help Scout | AIが回答し、その後、顧客が追加のサポートを求めなかった場合 | 記載なし | はい | $0.75 |
特に重要な違いは3つあります。
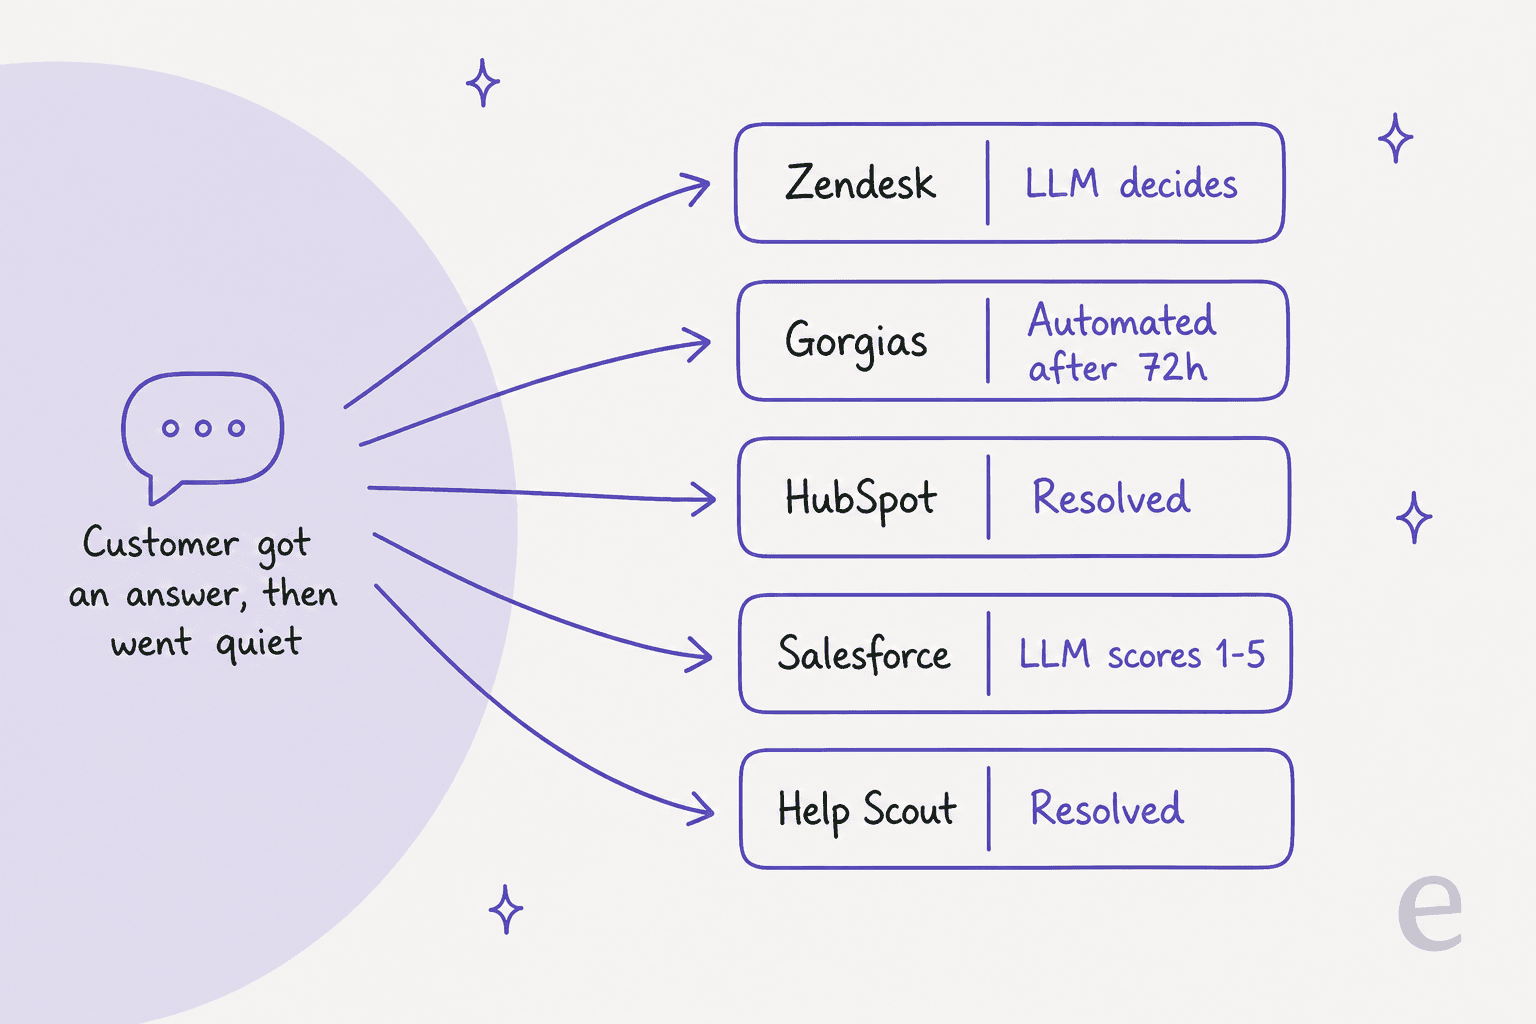
うまくいったと誰が判断するのか。 ZendeskとSalesforceは、会話記録をLLMに判定させます。Gorgias、HubSpot、Help Scoutは、人の対応がなかったことを数えます。誰も担当者を求めなかったので、解決としてカウントするわけです。これは別々の問いです。「顧客は必要なものを得られたのか?」と「顧客は黙って諦めたのか?」は、沈黙だけを確認する指標では同じに見えます。
何が解決扱いを妨げるのか。 HubSpotの公式ドキュメントには、解決扱いを妨げるのは訪問者が開始した引き継ぎだけであり、その後の出来事については"messages from a live agent, a transfer request, or negative feedback, will not change the resolution status"と記載されています。エージェントの返信後にワークフローがチケットを人へ振り分けても、解決扱いは取り消されません。
分母は何か。 Gorgiasは、よく似た名前の2つの数字を報告しています。AIが対応したチケットに対する成功率と、課金対象の業務全体に対する自動化率です。同じ月、同じチケットでも、割合は大きく異なります。
これがよくある1つの会話でどう表れるかを見てみましょう。エージェントが回答し、顧客はその後まったく返信しません。
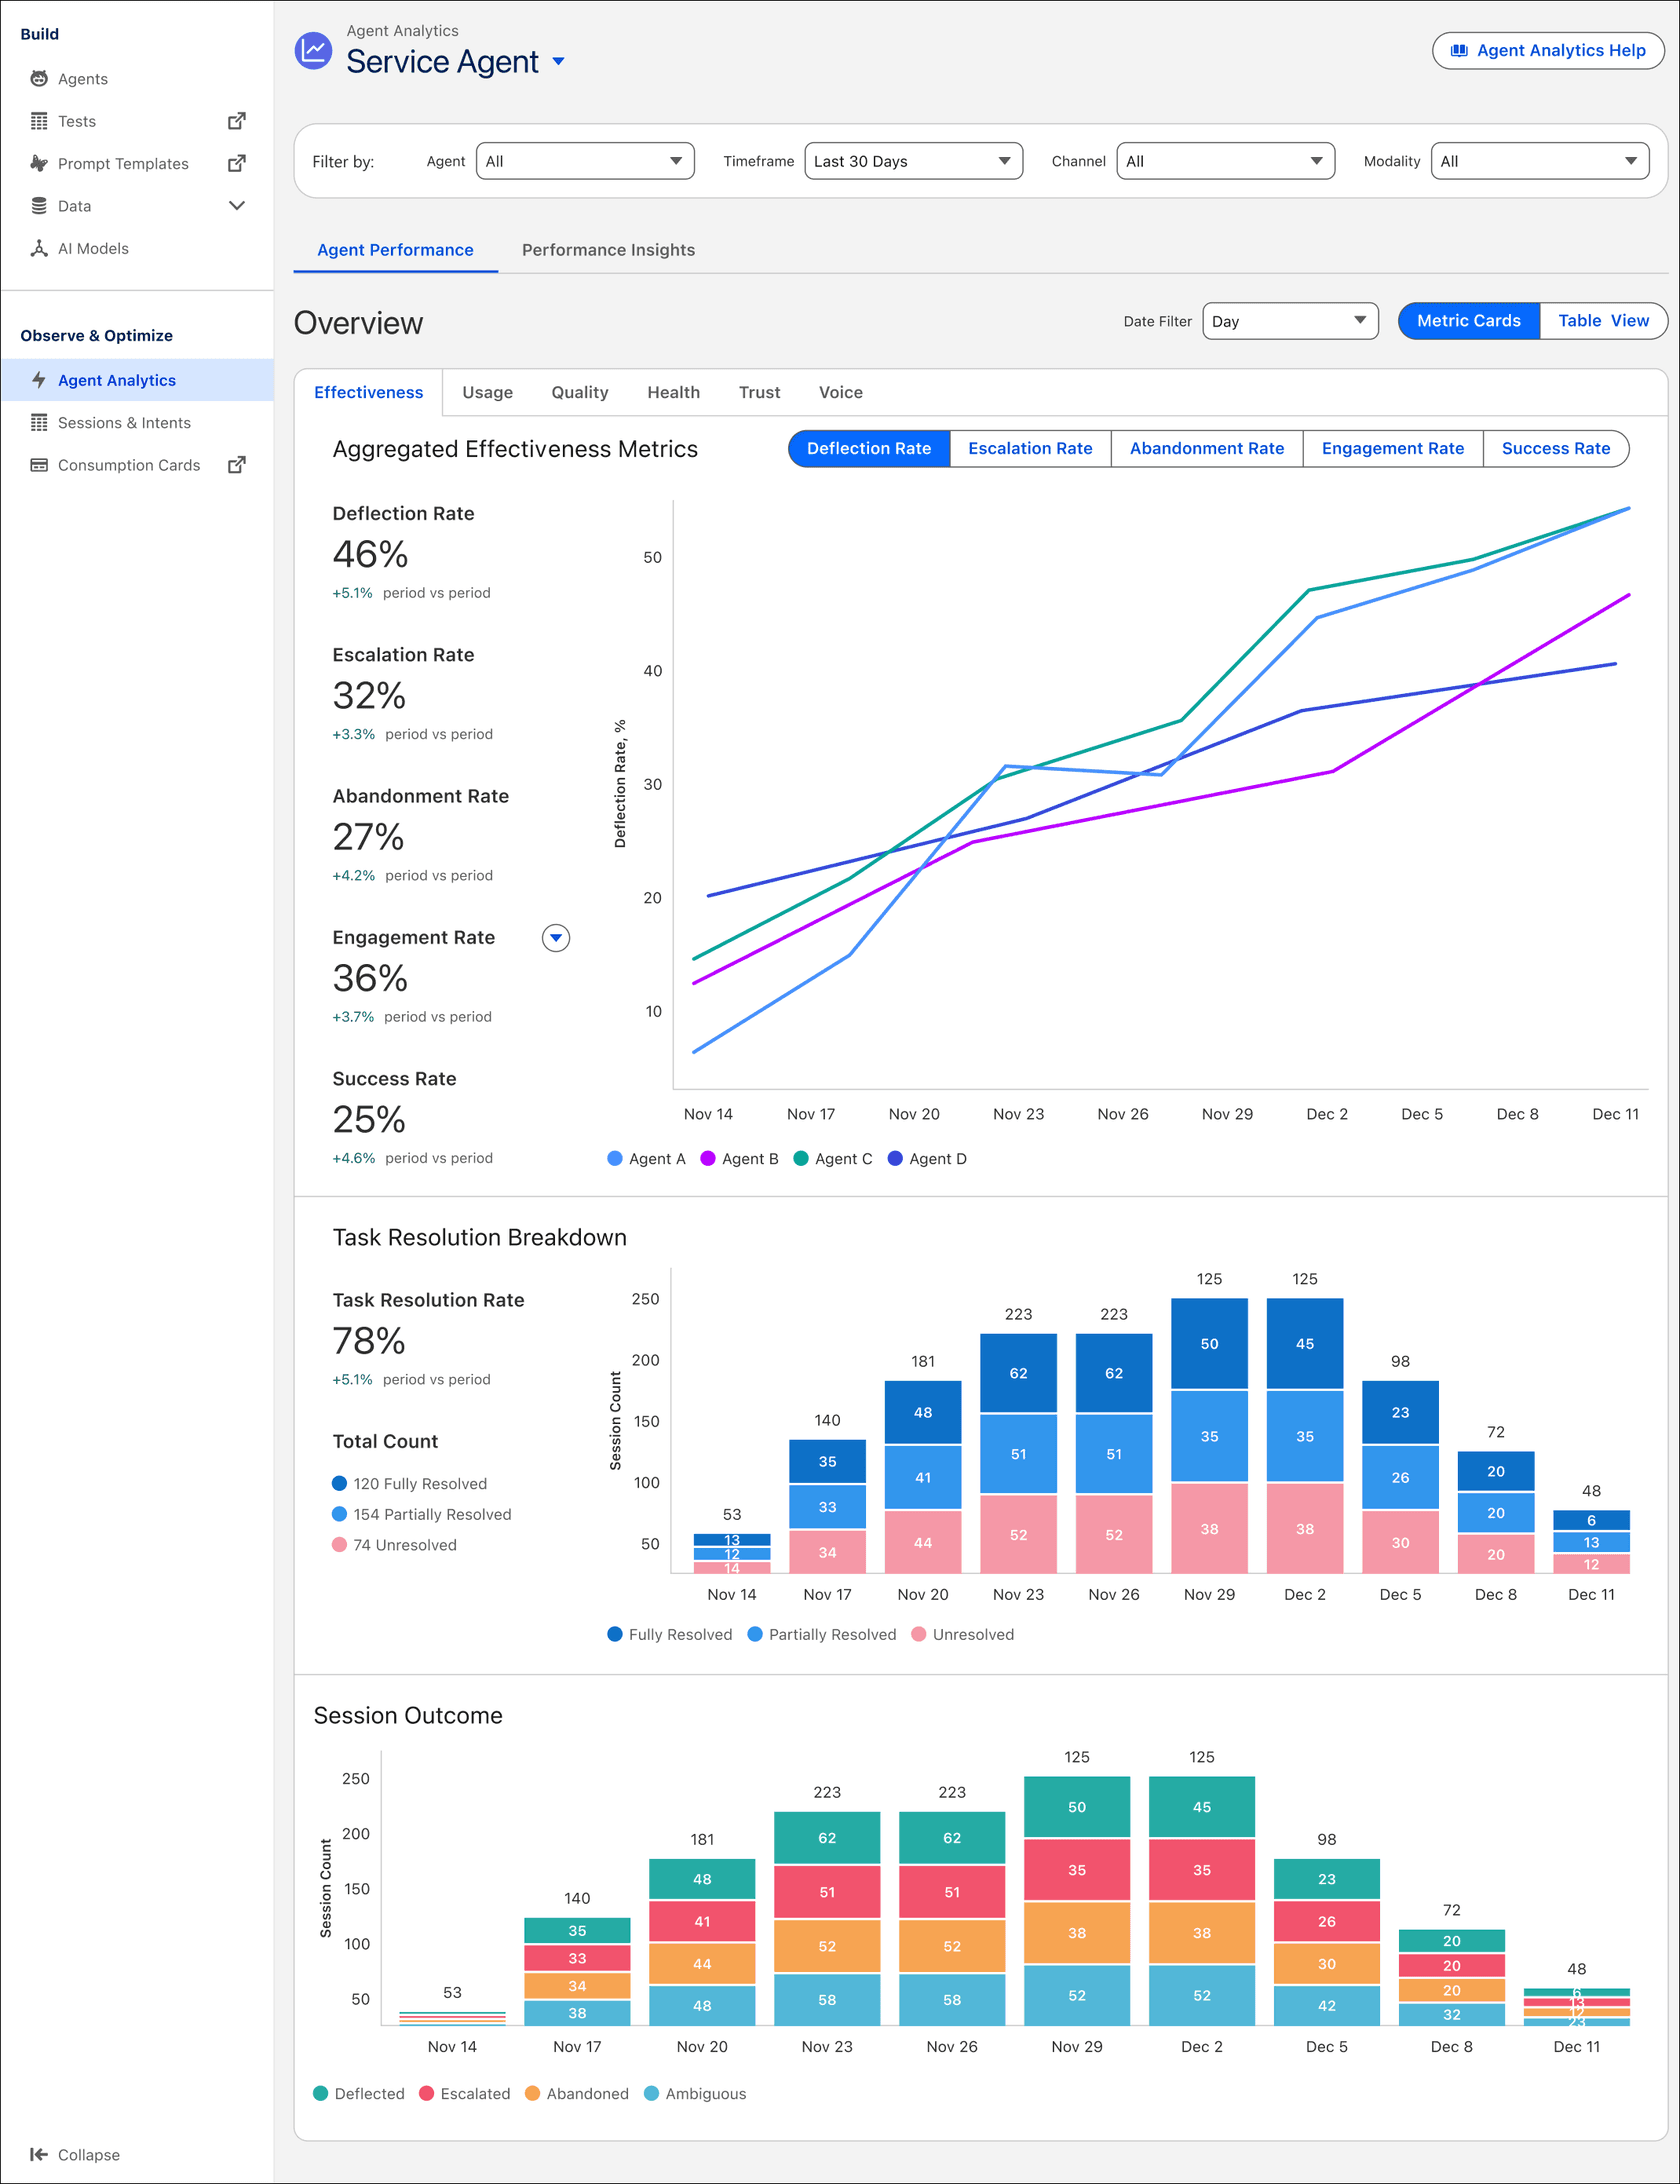
1つの製品の中でも、選ぶ指標によって数字は変わります。Salesforceの公式Agent Analyticsダッシュボードの例では、同じセッション群に対して、デフレクション率46%、成功率25%、タスク解決率78%が表示されています。
だからといって、ベンダーが不誠実だというわけではありません。各定義は文書化されており、Zendeskの公式ブログも、"different tools may classify 'resolved' in different ways"と注意を促しています。つまり、HubSpotがホームページで示す、8,000+社の顧客全体で会話の65%という数字は、HubSpotの定義に基づくものだということです。自社のZendeskやGorgiasのエージェントに求めるべき基準ではありません。
定義をさらに詳しく知りたい場合は、まず私のデフレクション率と解決率の違いの記事をご覧ください。Zendeskをお使いなら、Zendesk AIエージェントの指標でさらに掘り下げています。料金面については、解決1件あたりのコストで解説しています。
"For comparing vendors, the only fair test I know is to run them on the same slice of your own traffic and score it with your own definition. Their published numbers mostly just tell you which definition they chose."

tau-benchのような公開ベンチマークから何がわかりますか?
サポート形式のタスクをうまく処理するモデルがどれか、そして、より役立つ情報として、同じタスクを2回とも正しく処理できる頻度がわかります。Sierraのtau-benchは、実際のツールとポリシードキュメントを持たせたモデルに、模擬顧客の対応をさせます。その後、tau-benchの論文によると、"the database state at the end of a conversation"を正しい状態と照合します。返信がどれほど感じよく聞こえたかを採点するものではありません。返金が実際に実行されたか、そして実行すべきだったかを採点します。
自社のベンチマークにも取り入れる価値がある考え方は、pass^kです。論文の著者らは、これを"the chance that all k i.i.d. task trials are successful"と定義しています。毎回異なる言い方をする顧客に対して、同じタスクをk回実行し、すべての実行が成功した場合にだけカウントします。元の論文では、最良のエージェントは小売タスクの60%超を1回はクリアできましたが、同じタスクを8回クリアする必要があると25%未満になりました。
現在のランキングからも、同じ傾向が読み取れます。私はSierraの公開結果バケットから、すべての提出結果を取得しました。
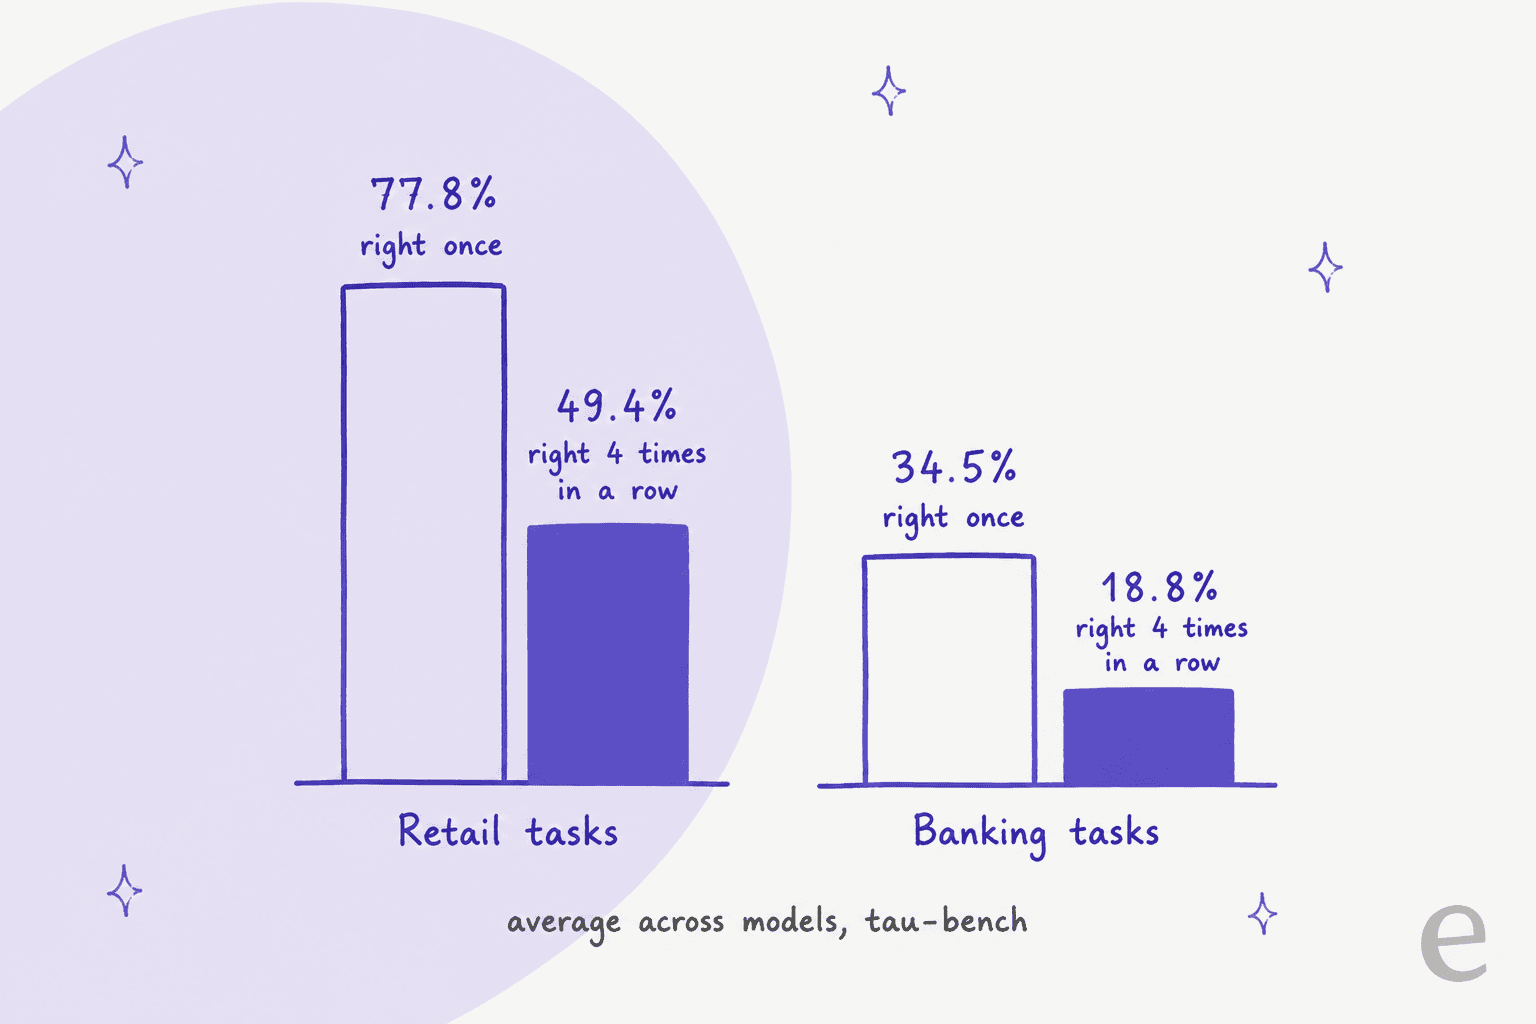
銀行業務のテストのほうが難しいのは、答えがツール内ではなく698件のポリシードキュメントにあり、tau-Knowledgeの解説によると、タスクに平均18.6件のドキュメントと9.5回のツール呼び出しが必要だからです。これは、実際のヘルプデスクの多くが置かれている状況と同じです。答えは自社ドキュメントのどこかにあります。このテストで最良のテキストモデルであるQwen 3.8 Maxのスコアは、1回では55.2、4回すべてでは35.1です。
より幅広く見たい場合、Fireworksは、5つのベンチマークを1つのスコアにまとめず、並べて掲載するカスタマーサポート指標を公開しています。
| ベンチマーク(運営元) | テスト内容 | 採点方法 | 首位(2026年11月) |
|---|---|---|---|
| τ³-Banking (Sierra) | ツールと模擬ユーザーを使った、ポリシーに従う必要のある銀行業務のリクエスト | 試行報酬の平均 | Gemini 4 Argon 58.25%、Claude Opus 5.5 56.01% |
| Cresta-Bench (Cresta) | 4つのコンタクトセンターエージェントによる181件の模擬通話 | pass^3、"a case counts only when all three runs pass" | Claude Opus 5.5 82.57%、最下位はClaude Haiku 5.5で20.05% |
| DuetBench-Diagnosis (Decagon) | 実際の問題診断の会話を再現し、モデル名を伏せて判定 | Eloレーティング | Claude Opus 5 1034.9 |
| τ³-Voice (Sierra) | 全二重音声エージェント | Pass@1 | Pine Voice 1.0 87.33% |
| vCX (Retell AI) | 指示に従い、ツールを呼び出す音声エージェント | スコア | GPT-6.1 Sol 93.4% |
これらを頼りにする前に、注意点が2つあります。第1に、tau-benchのテキストモデルの提出結果29件のうち27件は、Sierra自身が実行したものです。つまり、独立した競技会ではなく、1つの研究組織のテスト環境で得られた結果です。第2に、こちらのほうが重要ですが、これらのテストは、自社の返品ポリシーやマクロ、互いに矛盾している3つのヘルプ記事について何も知りません。モデルのランキングは、完成したサポートエージェントのランキングではありません。これらを使ってモデルの候補を絞り、その後、自社の設定をテストしてください。モデル選びについては、私のサポート向けモデルの比較記事で詳しく解説しています。
AIエージェントを人間のチームと比較評価するにはどうすればよいですか?
同じ種類のチケットを使い、同じ評価基準で、同じ期間内に両者を採点します。落とし穴は、単純な平均値です。AIにはパスワードのリセットや注文状況の確認が割り当てられ、チームには怒った顧客との返金トラブルが回ってくると、AIのチケットのほうが簡単だっただけなのに、AIのほうが速くて優秀に見えてしまいます。
私なら次の方法を実行しますし、これから始めるチームにもこの方法を勧めます。
- 解決済みの定義を1つ選び、書き留めます。 私の標準的な定義は、顧客の問題が解決され、ポリシーに反する点がなく、7日以内に顧客が同じ問題で再度問い合わせなかったことです。これは上のベンダー比較表のどの行よりも厳しい基準ですが、そうあるべきです。
- まずチケットをトピック別に分けます。 返金、注文状況、使い方、請求、バグなどです。ベンチマーク評価はトピックごとに行い、決して1つの数字にまとめないでください。使い方の質問で90%、返金で40%という結果を平均しても、意味のある数字にはなりません。
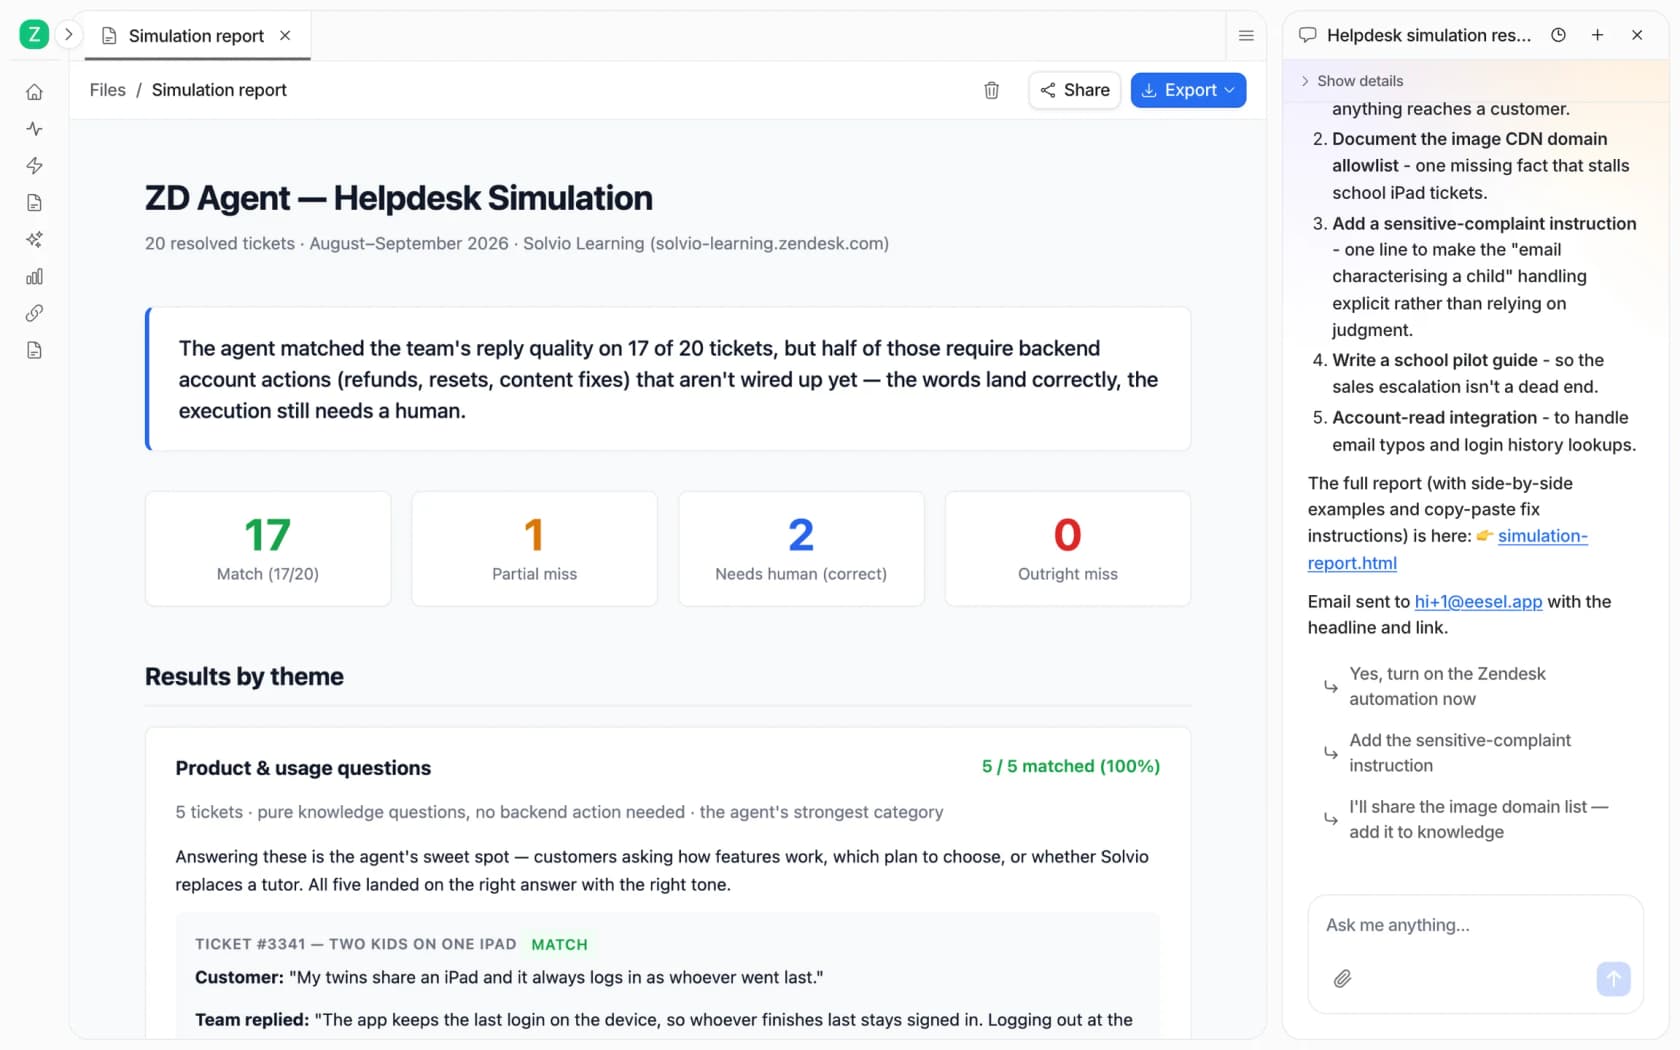
- 本番データを見る前に、解決済みチケットを再現します。 チームがすでにクローズしたチケットを使い、何も送信せずにエージェントに回答させ、各回答をチームが実際に書いた内容と比較します。チームの返信が基準です。この段階で最も深刻な失敗を見つけられ、顧客の信頼を損なうこともありません。私のシミュレーションテストガイドでは、採点とサンプルサイズを解説しています。
- 誰の回答かを伏せたサンプルを手作業で採点します。 同じトピックのAI回答と人間の回答を混ぜ、どちらなのかを隠し、1つの評価基準で採点します。正しい、一部正しい、間違っている、人に引き継ぐべきだった、という基準です。ここではQAスコアカードが役立ちます。
- その後、同じ期間の本番運用の数字を、トピックごとに比較します。 再オープン率、CSAT、解決までの時間、解決済みチケット1件あたりのコストについて、AIと人間をトピックごとに比較します。
ステップ4は、見た目以上に重要です。eeselがZendeskとShopifyを利用するドイツのオンラインジュエリー販売店で実際の問い合わせを使って行った試験では、同じエージェントのトリアージ精度は93%、事実誤認率は7%でしたが、下書きがそのまま送信された割合はわずか12%でした。1つの試験から得られた3つの正しい数字が、それぞれ違うことを伝えています。書き直しの内容を詳しく調べると、約65%はチームが下書きを短くしたり、トーンを変えたりしたものでした。これは正確性ではなく、文体の問題です。もし「そのまま送信された割合」だけで評価していたら、ほぼ正しく動いているエージェントを失敗と判断していたでしょう。
別のサンプルからは、もう1つの教訓を得ました。デモで自分が尋ねそうな質問ではなく、実際のチケットでテストすることです。eeselが確認した434件のチャットのサンプルでは、AIチャットは全体では86%が良好と評価されましたが、実際のヘルプデスクチケットから来たチャットでは79%でした。自分で用意する質問は、顧客の質問よりも常に簡単です。
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
GorgiasとShopifyを利用するDTCサプリメントブランドのCX責任者、eeselとの営業通話にて
この言葉こそ、トピック別にベンチマーク評価を行う実務的な理由です。すべてを監査することはできません。だからこそ、ベンチマークの本当の役割は、AIに任せられるトピックと、人に引き継ぐべきトピックを明らかにすることです。
AIベンチマークのスコアカードには、どの数字を入れるべきですか?
ダッシュボードに表示されている数より少なくてかまいません。私なら5つに絞ります。すべてトピックごとに測定し、ベンダーの解決フィールドではなく、自社のデータから算出します。
| 指標 | 算出方法 | 採用する理由 |
|---|---|---|
| 関与率 | AIが関与したチケット数 ÷ 全チケット数 | AIがそもそもキューのどれだけを見ているかがわかります |
| コンテインメント率 | 人の返信がないAIチケット数 ÷ AIチケット数 | ほとんどのベンダーが解決と呼ぶものに近い指標です。有用ですが、判定は甘めです |
| 検証済み解決率 | 7日以内に再問い合わせがなく、QAに合格したAIのみで完結したチケット数 ÷ AIチケット数 | 上の数字をより実態に即したものにした指標です |
| エンドツーエンド自動化率 | 検証済み解決数 ÷ 全チケット数 | 財務部門が重視する数字です |
| 初回問い合わせ解決率とCSAT、および検証済み解決1件あたりのコストについて、AIと人間を比較 | 両者に同じ計算式、同じトピック、同じ期間を適用 | 実際の直接比較です |
コンテインメントと検証済み解決の差は、算出する数字の中で最も役立つものです。差が小さければ、ベンダーの数値は信頼できる程度に実態に近いといえます。差が大きければ、エージェントは本当には解決していないチケットをクローズしています。Redditのある運用担当者は、痛い経験を通じてこれを学びました。
"i track cost per resolution with a 48 hour window for reopens, automation rate alone is basically useless we had a period where our "automation rate" looked incredible but half those customers were just giving up and calling in later, the dashboard was lying to us"
自社の1か月分の数字を入力して、違いを確認してください。
デフォルトの数字では、同じ6,000件のAIチケットが、コンテインメント率では70%、検証済み解決率では52%と表示され、キュー全体で本当に自動化されているのは31%だけです。3つとも正しい数字です。ただし、上司に示すべき数字はそのうち1つだけです。より幅広い指標については、私のAIカスタマーサービスの指標ガイドで詳しく解説しています。カスタマーサービスのKPIの記事では人間の担当者の目標を、チケット1件あたりのコストのベンチマークではコスト比較における人間側の数値を扱っています。
実務での良い結果とは、どのようなものですか?
良い結果とは、初日から大きな割合を1つ掲げることではなく、AIが全面的に担うトピックの割合を、意図的に増やしていくことです。eeselの顧客事例は、単一の率ではなく業務の分担を報告しているため、どんな平均値よりもこれを明確に示しています。
- GorgiasとShopifyを利用するスマートフォンアクセサリーブランドのClutchLoopでは、1か月で約
180件の返信が顧客に直接送られました。"about seven in ten conversations, no person needed"という結果です。 - Gorgiasを利用する化粧品ブランドのQuestion Beautyでは、対応した
990件のうち、約280件のチケットをeeselがクローズし、約250件を人に割り当てました。 - Zendeskを利用するSE Rankingでは、
4,650件の会話のうち、2,100件のライブチャットでeeselが最初に回答しました。現在は、件名で選んだテスト用チケットを使って、メールへの直接返信をテストしています。各スレッドには、オープン、解決済み、エスカレーション済み、人が対応中のいずれかのタグを付け、解決済みとしてカウントするのは"once the customer says it worked"の場合だけです。これは、上の表にあるどのベンダーよりも厳しい判定基準です。 - Cactus Club CafeはZendeskで社内ITサポートを運用しており、逆の配分を選びました。技術チーム向けの下書き返信が
790件、"against 51 sent directly"という結果です。同社のチケットでは、人が介在することが適切なベンチマーク目標です。
"In the first month, eesel is resolving 73% of our tier 1 requests. eesel offers easy Zendesk implementation and setup. Our team implemented and achieved results quickly during our 7-day trial."

このレビューの対象範囲に注目してください。すべてのチケットではなく、ティア1のリクエストです。ベンチマークは、まさにこのように引用すべきです。どのチケットを対象とし、どう「解決済み」と判断したのかを示さずに解決率だけを渡されたなら、それはまだベンチマークではありません。測定した後に数字を改善する方法については、私の解決率を改善するためのガイドをご覧ください。
AIのベンチマーク評価で最もよくある間違いは何ですか?
そのほとんどは、ダッシュボードにすでに表示されているからという理由で、測りやすいものを測定することから生じます。
- 回答可能な質問だけで評価すること。 テストセットにドキュメントでカバーできる質問しか入っていないと、最も深刻な失敗を見逃します。ナレッジベースに情報がないときに、エージェントが回答を作り上げてしまうことです。答えられないとわかっている質問を追加し、代わりに人へ引き継ぐことを確認してください。私のサポートにおけるAIのハルシネーションの記事で、この問題を扱っています。
- 正確性ではなくクローズ件数を数えること。 正しそうに聞こえる間違った回答でも、解決済みとしてクローズされます。
"The hardest ones are wrong answers that sound right. Nothing errors, the customer doesn't push back, and the ticket can close as resolved. If a refund window changes and the agent is still working from the old policy text, the resolution rate won't flag it, because that metric only counts closures."
- 1回の実行を信じること。 tau-benchでは、同じタスクに4回合格する必要があると、スコアがおよそ3分の1から半分ほど下がることが示されました。指示やドキュメントを変更するたびにテストセットを再実行し、結果が変わる回答を確認してください。
- トピックごとのチケット数が少なすぎること。 20件のチケットで85%という結果は、64%から95%の範囲を意味します。これは初期的な確認であって、結論ではありません。
- 扱いにくい入力を除外すること。 顧客は注文番号を間違って貼り付けたり、2つの言語を混ぜて書いたり、時にはボットを説得して割引を引き出そうとしたりします。敵対的テストもテストセットに含めるべきです。
- ベンダーの平均値と比較すること。 ベンダーの平均値は、そのベンダー独自の顧客構成と定義から生まれます。自社の基準は、自社のチームです。
まだツールを選んでいる段階なら、私のベンダー評価チェックリストは、この種のチケットテストを購入プロセスに組み込んでいます。RFPテンプレートも同様で、どのベンダーも同じチケットで評価できるようになっています。
eeselで自社のAIエージェントをベンチマーク評価しましょう
eeselは、Zendeskでも、ほかのヘルプデスクでも、既存のキューに加わるAIヘルプデスクのチームメイトです。その使い始めのプロセスに、ベンチマーク評価が組み込まれています。eeselのドキュメントによると、シミュレーションは"replays your real past tickets and compares its answers to what your team sent"を行い、その後、結果をテーマ別に採点して、指示の修正を提案します。
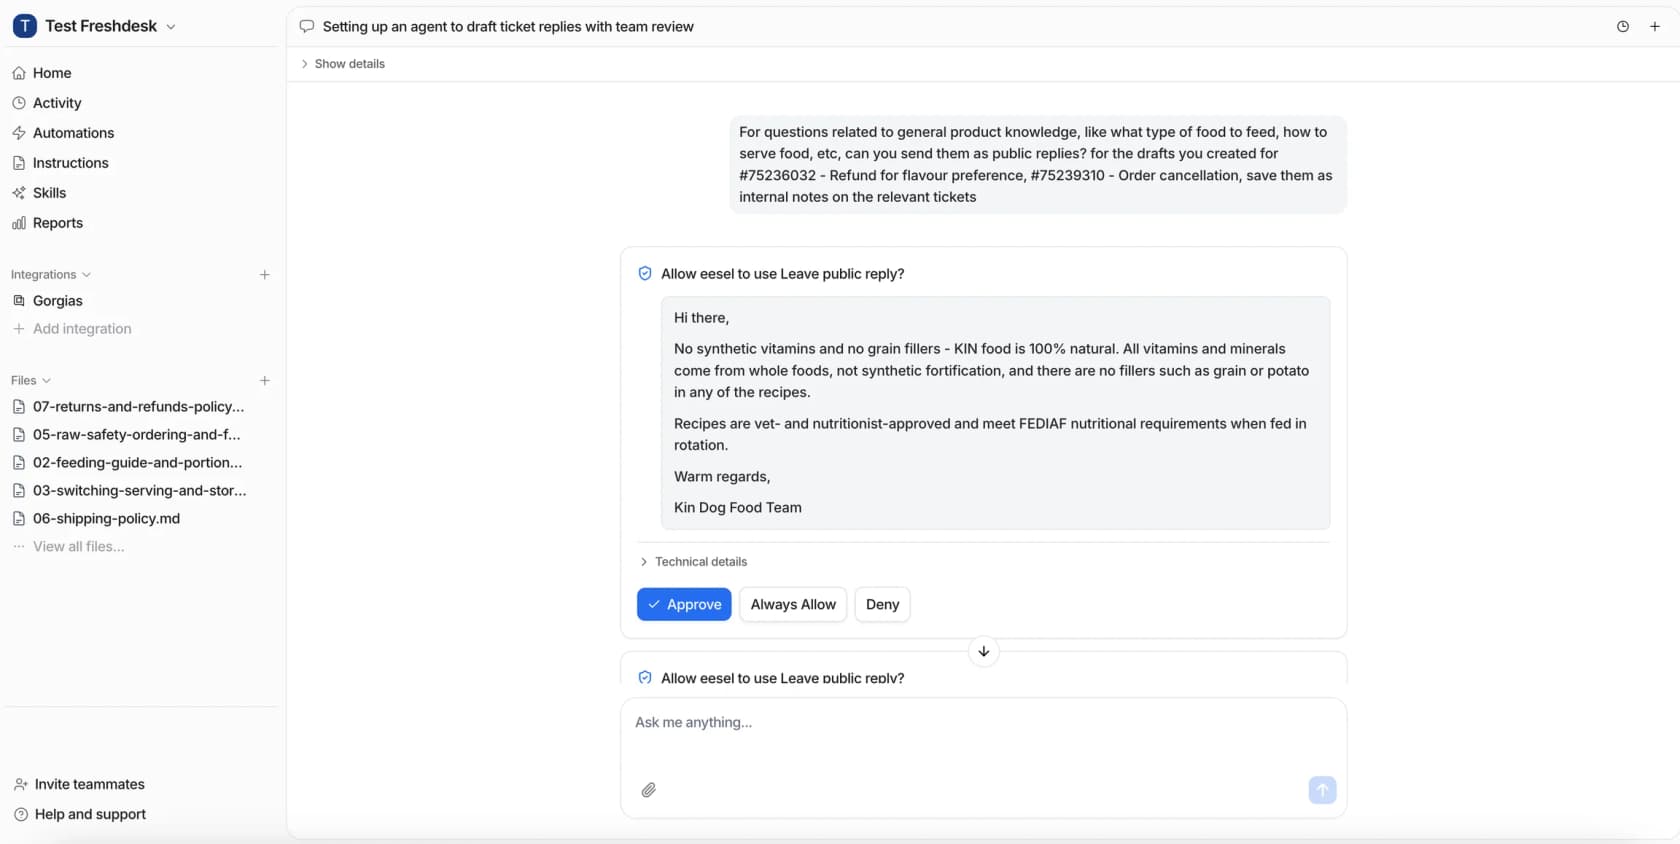
導入は、上で紹介した方法と同じ手順で進みます。下書きから始め、簡単なトピックに回答させ、スコアが十分になったら対象を広げます。Freshdeskのキューでも同じように機能し、Gorgias連携でも同じ導入手順を踏みます。
ベンダーの平均値ではなく、自社独自のベンチマークが欲しいなら、先月の解決済みチケットでシミュレーションを実行し、AIがどのトピックでチームと同等の対応をできるか確認してください。有料プランは500クレジットで$299からで、チケットまたはチャット1件につき1クレジットを使います。まずは自社のチケットでeeselを試してみてください。