

2026年のサポートチケットに最適なAIモデルは、数字の上ではQwen 3.8 Maxですが、キューがうまく回るかどうかを決める変数はモデルではありません。 AIエージェントに698件の実際のナレッジベースから回答を検索させ、そのうえで行動させる唯一の公開ベンチマークであるτ-benchでは、Qwen 3.8 Maxが初回正答率55.2%、Claude Opus 5が48.7%で、市場で最も高価なモデルであるClaude Fable 5は39.7%で6位です。
次の行動を変えるはずのポイントはここです。1つのモデルを固定して考えてみてください。Claude Opus 4.5は、回答がツール呼び出しの先にある通信ドメインで92.3%、回答が書類の山の中にあるバンキングドメインで24.7%です。同じモデル、同じ週で68ポイントの差があり、それを決めたのは知識の保管方法だけです。 現在の顔ぶれで最良と最悪のモデルの差は30ポイントです。ドキュメントをどこに置くかで生まれる差は68ポイントです。
コストの議論も逆さまです。現実的なトークン量で、Claude Opus 5は1チケットあたり約0.11ドルです。Zendeskは、それとは別に自動解決1件あたり1.50ドルを請求します。請求額の7%をめぐって値切っているにすぎません。
つまり、実力のある中位のモデルを選び、浮いた労力をナレッジベースとエスカレーションルールに回し、顧客の目に触れる前に自社のチケット履歴でシステム全体をテストしてください。その最後のステップを担うのがeeselです。過去のチケットを再生し、AIの回答をチームが実際に送った内容と照らして採点します。
よく聞かれる質問と、本当に結果を決める質問
私はeeselでAIエージェントを作っています。AIカスタマーサービスソフトウェアを検討している技術系サポートリーダーから最も多く受ける質問は、「どのモデルを使うべきか」の何らかの形です。もっともな質問です。しかし、たいていの場合、最初に投げるべき質問ではありません。
そう言えるのは、チームがこの質問に答えただけで止まるとどうなるかを見てきたからです。当社の顧客の何社かは、フロンティアAPI上で直接自作するために解約しました。正直にその一覧を見ると、ARと建設テックの企業、そしてDTCビューティーブランドが含まれ、後者はClaude APIに直行しました。彼らを責めるつもりはありません。有能なエンジニアリングチームで、APIも本当に優れています。ただ、どの会社もモデルを解こうとしていて、モデルは決して難しい部分ではありませんでした。
Teamプランを使い、300記事のConfluenceを運用しているビットコインATM会社のエンジニアリングリーダーは、もう一方の側をはっきりと語りました。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
同じ出発点の質問で、正反対の結論です。2チームの違いは、選んだモデルではありません。それが機能しているかどうかを知る手段があったかどうかです。
この記事は、モデルの問いに実際の数字で正面から答え、そのうえで、その答えが土台となる部分よりも重要でない理由を示す試みです。
まさにこの目的のために作られたベンチマークがあり、ほとんど誰も引用しない
モデルのリリースのたびに、MMLU、SWE-bench、GPQA、あるいは総合知能指数のどれかが引用されます。これらはどれも、モデルがサポートチケットをクローズできるかについて役立つことを教えてくれません。サポートチケットのクローズは知識テストではないからです。それは一連の流れです。曖昧な依頼を理解し、関連するポリシーを見つけ、正しいツールを正しい順序で呼び出し、許されていないことは断り、データベースを正しい状態で残す。これが、言語モデルと実際に機能するAIチケットシステムとの違いです。
Sierraはまさにそのためのベンチマークを作りました。それがτ-benchです。最初のτ-benchの論文は2024年に小売と航空のドメインで登場しました。τ²-benchは2025年に通信ドメインを追加し、その重要な貢献はユーザーにも行動させたことです。エージェントは、顧客にしかできない手順を顧客に案内しなければなりません。これが実際の技術サポートの姿です。論文自身の知見は率直です。エージェントがユーザーの代わりに動くのではなく、ユーザーを導く必要が出た途端、性能は大きく低下します。
そして2026年、サポートチームにとって最も重要なバージョンが登場しました。τ³-benchはτ-Knowledgeを追加しました。エージェントが整ったツール一覧ではなく、ナレッジベースを使って作業するバンキングドメインです。
Sierra自身の解説によると、そのナレッジベースはこうなっています。21の商品カテゴリにまたがる698件のドキュメント、約195,000トークン。各タスクは平均18.6件のドキュメントと9.5回のツール呼び出しを必要とし、最大33回に及ぶものもあります。タスクは、返信が読みやすかったかどうかではなく、エージェントが正しい最終的なデータベース状態を作ったかどうかで採点されます。
ヘルプセンターがAIと喧嘩しているように感じたことがあるなら、これがヘルプセンターのベンチマーク版です。自己解決ガイドがモデル設定よりもコンテンツに時間を割く理由でもあります。
検索の崖
チケットシステム向けAIを評価する人の壁に貼りたいのが、このグラフです。
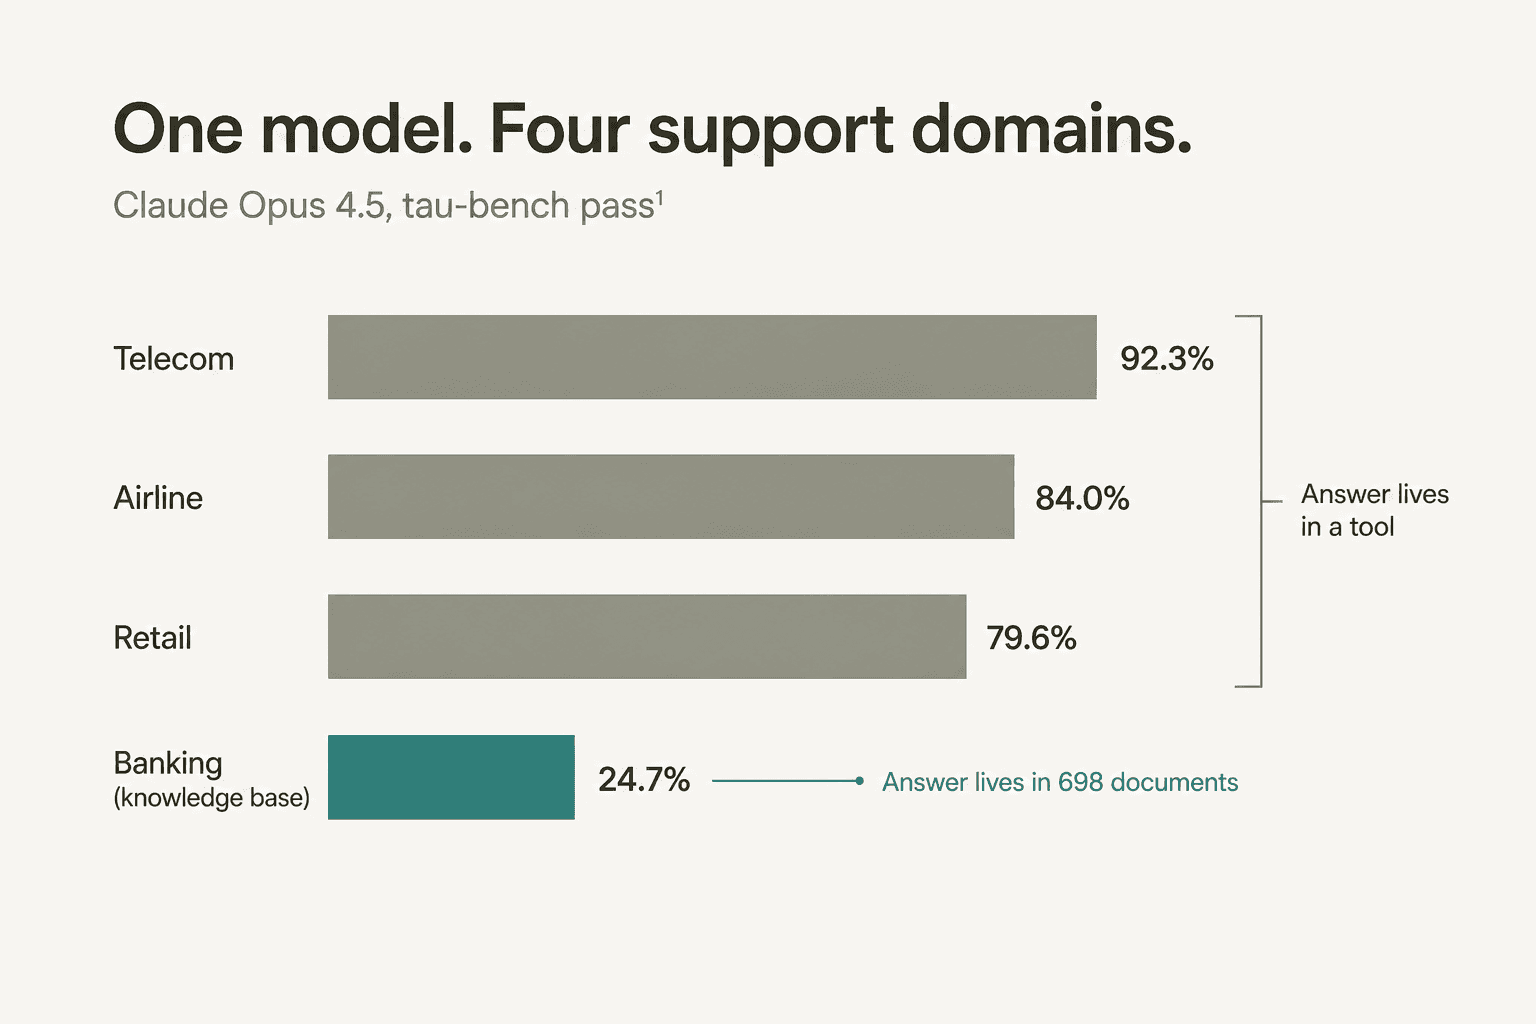
1つのモデル。1回の評価実行。4つのドメイン。通信92.3%、航空84.0%、小売79.6%、バンキング24.7%。
最初の3つのドメインでは、エージェントに整ったツール群が渡され、それらを呼び出せば答えに届きます。4つ目では、まずドキュメントの中から答えを探さなければなりません。この1つの変更が68ポイントを奪います。これは同じテストでの最良と最悪のフロンティアモデルの差全体よりも大きい数字です。
Qwen3.5-397Bは同じ形をさらに極端に示しています。通信97.81%に対してバンキング9.79%。同じ重みで88ポイントの崩落です。
これが何を証明し、何を証明しないのかには慎重でいたいと思います。これは1つのベンチマークであり、しかも合成的なものです。しかし、そこで明らかになるメカニズムは、私が本番で目にするメカニズムとまったく同じです。顧客からAIナレッジベースチャットボットが「十分に賢くない」と言われるとき、10回に9回ほどは、モデルは問題なく、検索が間違った3段落を持ってきています。
サポートチケットに関する2026年のリーダーボード
Sierraは2026年8月4日に、現在のフロンティアの大半を網羅する新しい一括実行を行いました。これらのエントリはすべて、同じ検索設定、同じGPT-5.2ユーザーシミュレーター、同じベンチマークバージョン、4回の試行を使っているため、互いにきれいに比較できます。
| モデル | プロバイダー | 初回正答 | 4回中4回正答 | 推論設定 |
|---|---|---|---|---|
| Qwen 3.8 Max | Qwen | 55.2% | 35.1% | xhigh |
| Claude Opus 5 | Anthropic | 48.7% | 32.0% | max |
| Grok 4.5 | xAI | 47.9% | 32.0% | high |
| GPT-5.6 Sol | OpenAI | 46.9% | 27.8% | xhigh |
| Meta Muse Spark 1.1 | Meta | 40.5% | 20.6% | xhigh |
| Claude Fable 5 | Anthropic | 39.7% | 28.9% | max |
| Claude Opus 4.8 | Anthropic | 39.7% | 22.7% | max |
| GLM-5.2 | Z.ai | 37.1% | 13.4% | xhigh |
| Kimi K3 | Moonshot AI | 37.1% | 17.5% | max |
| Inkling | Thinking Machines Lab | 25.0% | 11.3% | max |
この表からいくつか目を引く点があります。
最も高価なモデルが最良ではありません。 Claude Fable 5は入力100万トークンあたり10ドル、出力100万トークンあたり50ドルです。Qwen 3.8 Maxは2ドルと6ドルです。安いほうのモデルがサポートタスクで15.5ポイント高いスコアを出しています。フロンティア価格がフロンティア級のサポート性能を買うと思い込んでいたなら、そうではありません。
上位4つの差は小さいです。 Qwen 3.8 MaxとGPT-5.6 Solの差は8.3ポイント、Opus 5とGrok 4.5の差は1ポイント未満です。これらは別のクラスのツールではなく、隣人同士です。
進歩は本物ですが、遅いです。 Claude Opus 4.5はこのドメインで2月に24.7%でした。Opus 5は8月までにそれを倍の48.7%にしました。2世代にわたる本物の進歩です。それでも、モデルは正解より不正解のほうが多いということであり、チャットボットベンダー比較が通常示唆するものとは大きく異なる出発点です。
当然あるべき2つのモデルが欠けています。 Gemini 3.7 FlashもDeepSeek V4 Flashも、このドメインには提出がないため、ここで誠実に順位付けすることはできません。古いGeminiのエントリは異なる検索設定を使っていたため、単に低いのではなく、比較対象にならないのです。
覚えておきたい方法論上の注意点があります。リーダーボードの古いエントリは異なる検索設定を使っていたため、バッチをまたぐ比較は見た目より当てになりません。Sierraは2026年7月にバンキングドメインを再採点しており、その修正前の結果は比較できないとしています。年初のバンキングスコアを引用している人は、おそらく古い数字を引用しています。
一度できることは、毎回できることではない
多くの人が読み飛ばす列こそ、私が最初に見る列です。
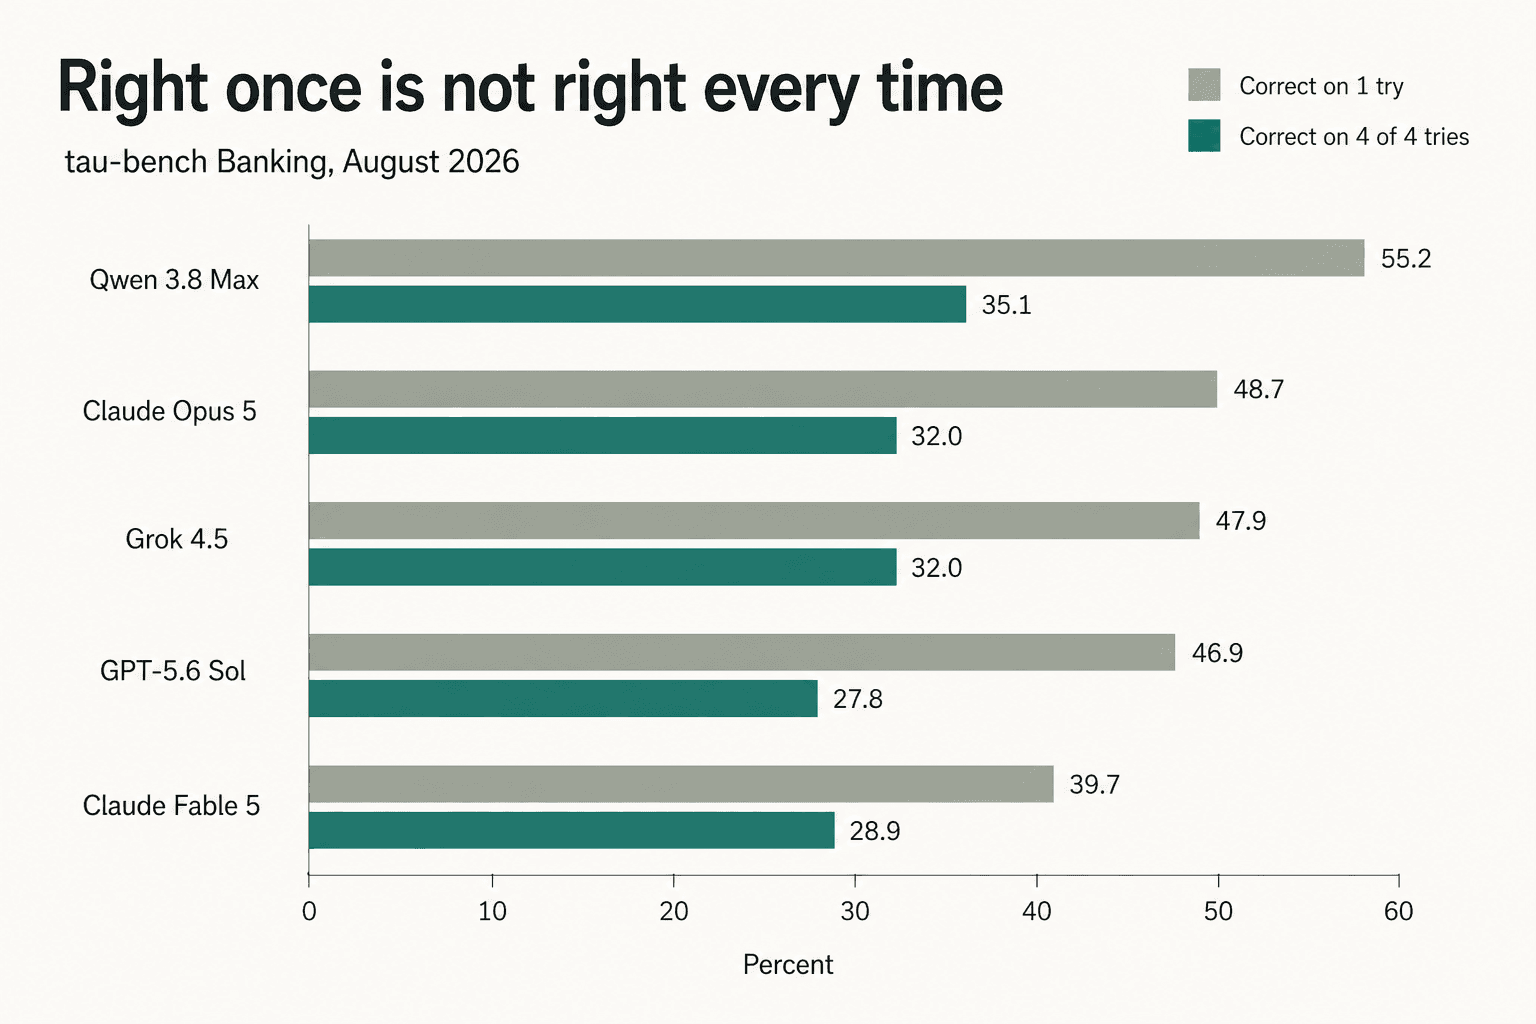
τ-benchはpass^kを報告します。これは、モデルがk回の独立した試行のすべてで同じタスクを正解したかを問うものです。Pass^1は「できる」。Pass^4は「確実にできる」です。
顔ぶれの中で最良のモデルでも、これらのタスクの35.1%でしか確実に正解できません。 Opus 5は48.7%から32.0%に下がります。GPT-5.6 Solは46.9%から27.8%に下がります。GLM-5.2は37.1%から13.4%へと崖から落ちるように下がり、一貫して推論しているのではなく、うまく当てているのだとわかります。
pass^1とpass^4の開きこそが、AIにキューを任せきりにできるかどうかを決める数字です。pass^1が48.7%でpass^4が32.0%のモデルは、チケットの半分を解決するモデルではありません。同じ種類のチケットを、日によって違うやり方で処理するモデルです。
月に約7,000件のGorgiasチケットを抱えるDTCサプリメントブランドのCXリーダーは、どんなベンチマークよりもうまく、その運用上の姿を私に語ってくれました。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これはpass^kをビジネス要件として語ったものです。ばらつきは、より良いモデルで直す品質の問題ではなく、確信度に基づくエスカレーションで直すルーティングの問題です。私が関わった本格的なサポート導入はどれもここに行き着きます。だからコパイロット構成は、完全自律よりも安全な第一段階であることが多いのです。
実際のチケットでモデルが失敗する3つのパターン
Sierraはベンチマークと一緒に失敗の分類を公開しており、それを読むと不快なほど見覚えがありました。これらは特殊なAIの失敗ではありません。サポートマネージャーが不満を述べる、まさにその3つです。
別のポリシーに依存するポリシーを見落とします。 ベンチマークの実例では、顧客が取引に異議を申し立て、同時に与信限度額の引き上げを依頼します。エージェントは異議申し立てのポリシーを検索して見つけ、顧客が頼んだ順番だからと、先に異議申し立てを提出します。与信限度額のポリシーは一度も検索せず、そのポリシーには、異議申し立てが保留中のときは限度額引き上げは自動的に却下されると書かれています。顧客は、2つの手順を逆の順番で行えば人間のエージェントが避けられたはずの却下を受けます。
失敗したことを成功と報告します。 ベンチマークのツールの多くは、使う前にロック解除が必要です。エージェントがその手順を飛ばしてエラーを受け取ると、Sierraの解説によれば、一部のエージェントはユーザーに対して成功の応答をハルシネーションします。これは、チケットではなく顧客を失う類の失敗です。月約200チケットで2,000件に向けて拡大中の、Zendeskを使うデンマークのB2B車両テレマティクスチームは、ナレッジベースに「すべてのモデルに対応しています」とあったために、ボットがデータベースにない車ブランドへの対応を確認してしまうという、その一般消費者版を経験しました。
顧客の言うことを信じます。 シミュレートされたユーザーが異議申し立てが承認されたと主張すると、エージェントは実際のステータスを確認せずにクレジットを適用することがよくあります。どのサポートチームにも、これの何らかの版があります。あるeコマースのサポートマネージャーは、当社のダッシュボードチャットで率直に述べました。
"stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday"
これら3つのどれも、より大きなモデルでは解決しません。エージェントが触れてよい範囲を限定することで解決します。Hacker Newsに、ベンダーのドキュメントの大半よりうまくこれを言い表したコメントがあります。
"Give your LLM the same level of permissions that you would give a human you just hired in the same role. The examples given, tricking the customer support LLM into sending text messages to all users, or into transferring money, are not things that you would ever give a human customer support agent the tools to do."

これがセキュリティと信頼性の姿勢のすべてで、たった2文で言い尽くされており、取り入れるのに費用はかかりません。長続きするカスタマーサービス自動化の大半は、こうして狭い権限をひとつずつ与えて作られています。
各モデルは実際にチケット1件あたりいくらかかるか
実際の数字を出しましょう。「使い方次第です」は答えになりません。
検索を使って回答するサポートチケットの形は、かなり予測しやすいものです。入力15,000トークン(システムプロンプト、ポリシー、検索で取得したナレッジベースの断片、会話履歴)と、出力1,500トークン(返信と推論トークン。推論トークンは主要プロバイダーすべてで出力料金で課金されます)としましょう。数字は人によって違いますが、モデル間の比率は変わりません。
| モデル | 100万トークンあたり入力 / 出力 | 1,000チケットあたりのコスト | 1チケットあたり |
|---|---|---|---|
| Claude Fable 5 | $10.00 / $50.00 | $225.00 | $0.225 |
| GPT-5.6 Sol | $5.00 / $30.00 | $120.00 | $0.120 |
| Claude Opus 5 | $5.00 / $25.00 | $112.50 | $0.113 |
| Kimi K3 | $3.00 / $15.00 | $67.50 | $0.068 |
| GPT-5.6 Terra | $2.00 / $12.00 | $48.00 | $0.048 |
| Claude Sonnet 5 | $2.00 / $10.00 | $45.00 | $0.045 |
| Qwen 3.8 Max | $2.00 / $6.00 | $39.00 | $0.039 |
| Claude Haiku 4.5 | $1.00 / $5.00 | $22.50 | $0.023 |
| Gemini 3.7 Flash | $0.75 / $3.75 | $16.88 | $0.017 |
| GPT-5.6 Luna | $0.20 / $1.20 | $4.80 | $0.005 |
| DeepSeek V4 Flash | $0.22 / $0.66 | $4.29 | $0.004 |
料金は各プロバイダー自身の料金ページに基づきます。AnthropicとQwenの数字は前のセクションでリンクしています。残りはOpenAIの料金表とGoogleの料金表にあり、DeepSeekはさらに下でリンクしています。
この表には4つの落とし穴があります。
Geminiの価格はプロモーション価格です。 Googleの0.75ドルと3.75ドルは2026年12月31日までで、1月1日に1.50ドルと7.50ドルへ倍増します。今日Gemini 3.7 Flashでコストモデルを作るなら、来年の料金で作ってください。
DeepSeekは時間帯で課金するようになりました。 DeepSeekの料金表では、UTCの01:00〜04:00と06:00〜10:00がピーク時間で、オフピークのちょうど2倍の料金です。上の0.22ドルと0.66ドルは、その時間帯には0.44ドルと1.32ドルになります。この時間帯は中国の営業時間に沿っており、米国や欧州のサポートキューにとっては、最も忙しい時間帯の外にほぼ収まります。これは確かにこちらに有利な特徴ですが、同時に脆いものでもあります。
Sonnet 5の2ドルと10ドルは導入価格です。 Anthropicの公表料金は2026年8月31日に3ドルと15ドルに戻ります。この記事の執筆時点から2週間後です。
データレジデンシーには上乗せがあります。 Anthropicは推論を米国内限定に固定する場合に1.1倍の係数を適用し、OpenAIは2026年3月5日以降にリリースされたモデルの地域処理エンドポイントに10%の上乗せを課します。レジデンシー要件のもとで顧客の個人情報を扱うなら、それを加えてください。
自社の件数で数字を試す
モデルは請求額の約7%
現実的なプラットフォームの課金メーターを付けてこの計算機を動かすと、答えの形は変わらなくなります。
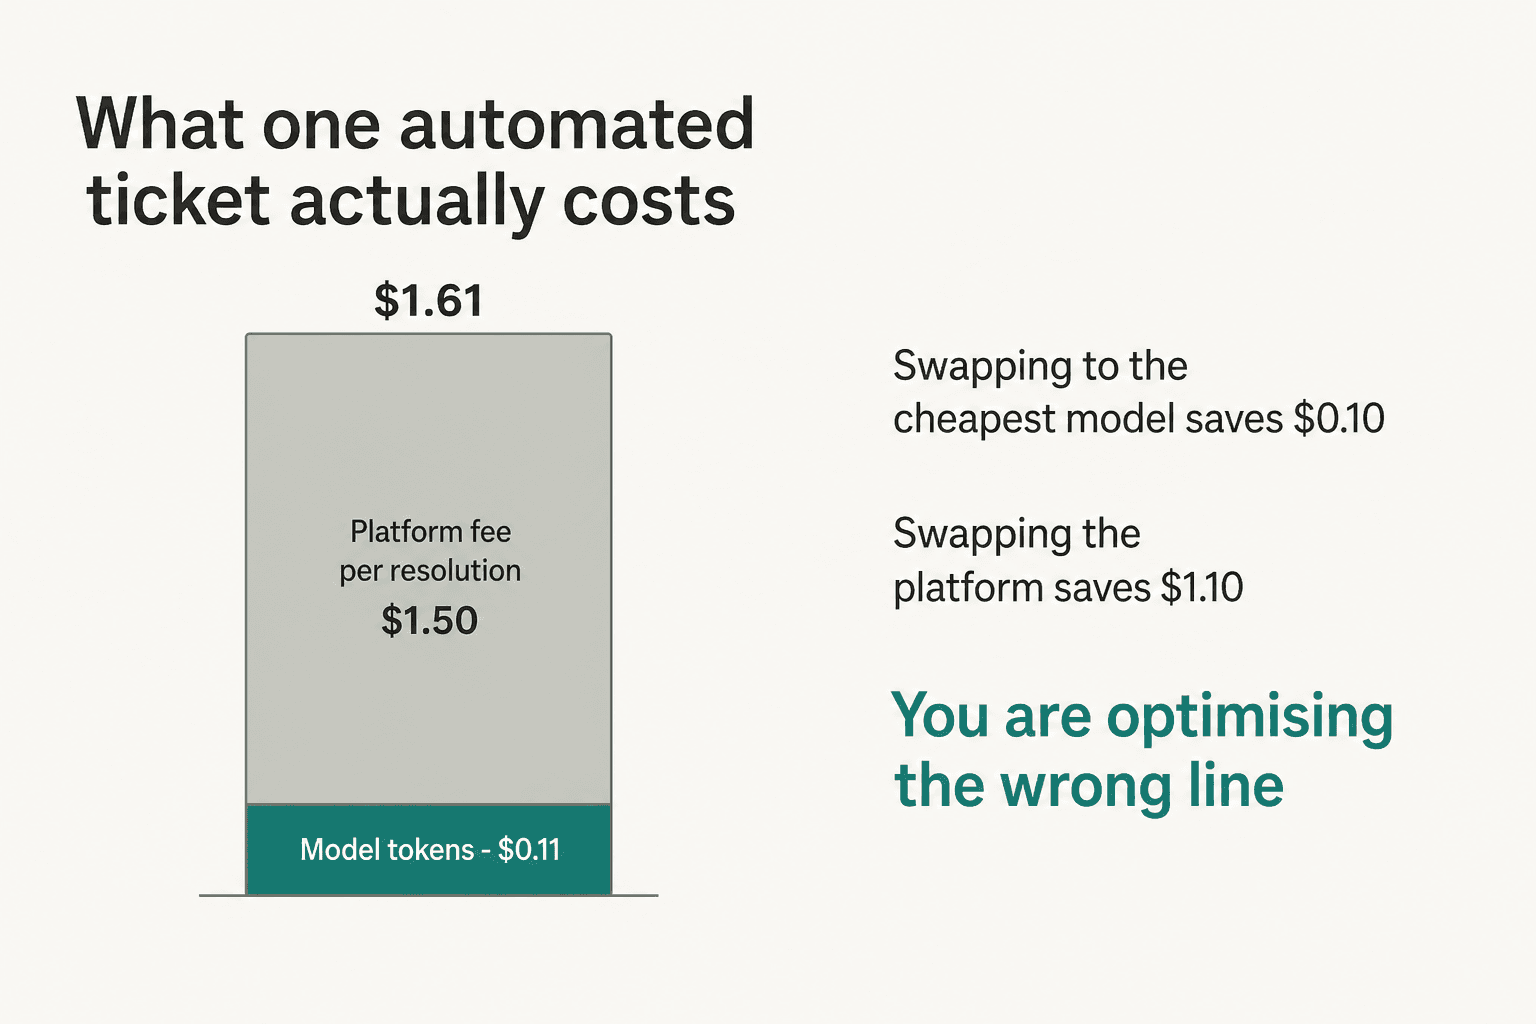
Zendeskは、コミット契約で自動解決1件あたり1.50ドル、従量課金で2.00ドルを公表しており、これはプランカードではなくプラン比較表の中に載っています。Gorgiasはプランに応じて自動化された対話1件あたり0.85ドルから1.00ドルを課金します。Freshdeskは含まれる500件を超えた分について、1セッションあたり0.49ドルです。Help Scoutは1解決あたり0.75ドルで、会話内でAIがいくつの質問に答えても1会話につき1解決という、このカテゴリで最も公平なルールです。
Claude Opus 5をZendeskのコミット料金の背後に置くと、1チケットあたりのコストは1.61ドルで、そのうち知能そのものは0.11ドルです。市場で最も安いモデルに落とすと、6セントの節約と引き換えにベンチマークで9ポイントを失います。 この記事全体で最悪のトレードです。
課金の単位も、料金そのものより重要です。セッション課金のメーターは、解決済みのチケットが翌日に再オープンすると再び課金します。対話課金のメーターは、AIが人間に引き継いだ場合でも課金します。再オープン率が高いなら、この2つの細部のほうが、どんなモデルの判断よりも高くつきます。ベンダー間で定義がどう違うかは、AI解決率の内訳で解説しています。人員コストとの比較はAIと人間のエージェントのコスト比較をご覧ください。
では、実際にどのモデルを選ぶべきか
これが私の率直な見立てです。個別の事情に肩をすくめるのではなく、理由を添えます。
最高のサポートスコアが欲しく、データレジデンシーが障害でないなら、Qwen 3.8 Maxです。 知識ドメインで55.2%と首位で、料金は2ドルと6ドル、Opus 5の出力料金の半分未満です。落とし穴は現実のもので、きちんと検討すべきです。Alibaba Cloudから提供されるため、顧客の個人情報を扱うほとんどの西側のサポートチームにとっては、技術の話の前にコンプライアンスの話になります。ベンチマークを確認する前に、データ処理契約上の義務を確認してください。
西側ホストの標準的な選択肢が必要なら、Claude Opus 5かGPT-5.6 Solです。 ベンチマークでは2ポイント以内、1,000チケットあたりのコストでは8セント以内です。Opus 5は4回中4回の信頼性がやや良く、32.0%対27.8%で、無監督で自動化する場合に重要です。どちらも十分に文書化されており、実際のエンタープライズ契約の裏付けがあります。
クリーンで小さなナレッジベースで大量処理するなら、Gemini 3.7 FlashかClaude Haiku 4.5です。 どちらにもτ-benchのバンキング提出がないため、他のモデルと誠実に順位付けすることはできません。言えるのは、検索の崖は両方向に働くということです。ナレッジベースが散らかった698件のドキュメントではなく、よく書かれた40件の記事なら、タスクはほぼすべてが80%を超える通信ドメインにずっと近くなります。Gemini側ではプロモーション価格を慎重に見積もってください。
コストに制約があり、ばらつきを許容できるなら、DeepSeek V4 Flashです。 信頼できる選択肢としては断然安く、オフピークの時間帯は西側の営業時間に実際に好都合です。ただし注意が2つあります。有料APIの規約は、学習利用について明確に保護しているのではなく、何も触れていません。公表されたゼロリテンションの選択肢もないため、顧客データにそのまま使える代替にはなりません。さらにArtificial Analysisは高いハルシネーション率を測定しており、顧客向けの返信にとってはまさに最悪の失敗パターンです。
この用途ではClaude Fable 5は見送ってください。 優れたモデルですが、ここで最も高価で、10ドルと50ドルです。サポートベンチマークでは6位で、半額以下のOpus 5とGPT-5.6 Solの下です。データをどう読んでも、チケットキューに最適な選択にはなりません。Kimi K3も同様です。3ドルと15ドルでQwen 3.8 Maxより高く、スコアは18ポイント低いのです。
もう1つ、はっきり言っておくべきことがあります。この世代では、ハルシネーション率が悪い方向に動きました。Artificial Analysisは、Claude Opus 5の率が14ポイント上昇して50%になり、Gemini 3.7 Flashが、精度は向上したにもかかわらず、Gemini 3.6 Flashの55.6%から64.5%へ悪化したと測定しました。モデルは賢くなると同時に、自信を持って間違えるようにもなったのです。カスタマーサービスにおけるAIでは、間違った回答が直接顧客に届くため、コーディングアシスタントとは違う意味でこのトレードは悪いものです。
モデルのドロップダウンに触る前に直すべきこと
検索の崖が本物で、証拠は強いと私は考えますが、そうであれば、レバレッジが実際にあるのはここです。
まずナレッジベースを直してください。 これが利用できる中で最もリターンの大きい変更です。Hacker Newsのτ-bench議論には、この原則の実証が1つあり、私の記憶に残っています。ある人がベンチマークのポリシードキュメントを明確な決定木と番号付きの手順に書き直し、モデルもタスクも触らずに、GPT-5-miniを22%向上させました。その理由についての著者自身の説明が、スレッドで最も鋭い一文です。
"If a model only performs well once the rules are clarified, that's still revealing something important about its agency: it's brittle when policies are ambiguous, but much stronger when they're structured."
ドキュメントを書き直しただけで22ポイントです。どんなモデルのアップグレードもこれには及びません。実践面は、ナレッジマネジメント向けAIと最高のナレッジベースツールのガイドで扱っています。
新入社員に与えるのと同じようにツールの範囲を絞ってください。 権限の話に戻ります。AIがしきい値を超える返金を発行できなければ、発行するよう説得されることもありません。プロンプトで禁じるより安上がりで確実で、本物のAIチームメイトと、APIキーを持っただけのチャットボットを分けるものです。うまく動くエージェントの事例は、巧妙なプロンプトではなく、狭いツール一覧を持つ傾向があります。
チケットの種類ではなく、確信度でルーティングしてください。 Pass^kは、同じモデルが同じチケットを実行ごとに違うやり方で処理することを示します。答えはより良いモデルではなく、AIに辞退させることです。「確信が持てない」を、失敗ではなく有効で頻繁な結果として扱う引き継ぎルールを設定してください。辞退されたチケットが次に何を書くべきかを教えてくれるので、エージェントコーチングが元を取れるのもここです。
本番で正しいものを測ってください。 あるHacker Newsのコメント投稿者は、あるベンダーがτ-bench航空を32日間の移動平均で追跡し、ツール呼び出しのエラー率や構造化出力のエラー率も併せて見ていると述べました。解決率だけよりも良いダッシュボードです。「モデルが間違えた」と「モデルが間違ったツールを呼んだ」を切り分けられるからです。何と組み合わせるべきかは、カスタマーサービス指標の記事で扱っています。
本番稼働前に自社の履歴でテストしてください。 この記事のベンチマークは、すべて他人のキューです。皆さんのキューには、異なる商品、異なる例外ケース、異なるトーンがあります。モデルが自社で機能するかどうかを教えてくれる唯一のテストは、自社の解決済みチケットの再生です。
この最後の項目は任意ではなく、生のAPIで構築するチームが最もよく飛ばす手順です。ベンチマークの順位が候補リストの材料になるべきで、決定してはならない理由でもあります。
チケットキューでeeselを試す
上のすべてが同じ結論を指しています。モデルは部品であり、サポート自動化が機能するかどうかを決めるのは、その周りの土台です。その土台がeeselです。
この記事の主張を踏まえて特に挙げたいのは、シミュレーションです。eeselに直近のチケットでシミュレーションを実行させると、過去の数百件のチケットを再生し、AIの回答をチームが実際に送った内容と照らして採点し、ギャップと指示変更の提案を返します。ベンチマークのデータではなく、自社のデータでpass^kの問題に取り組むものです。解決率の予測は出しませんし、そう主張するベンダーには私は懐疑的です。

Zendesk、Gorgias、Freshdesk、Front、Help Scout、HubSpot、Salesforce、Jira Service Managementと連携します。料金は、500クレジット(チケットまたはチャット1件につき1クレジット)で月額299ドルからの固定月額で、シートごとの料金はありません。100クレジットの無料プランがあり、カード不要です。ほとんどのチームにとって、テストに使える実チケットとして十分な量です。
この1週間、スプレッドシートでモデル名を比較してきたなら、これが近道です。上位4つのどれかを選び、ヘルプデスクを接続し、自社のチケットを再生して、モデルが本当に問題だったのかどうかを結果に語らせてください。