

なぜ「解決済み」は「正しい」ではないのか
私はこの2年間eeselで検索に取り組んできましたが、このテーマほど購買意欲の高いサポート関連の話題は多くありません。「how to train AI on past tickets」と検索する人は、好奇心で検索しているわけではありません。何年分ものヘルプデスクの履歴を抱えていて、それが自分のチームの仕事ぶりを最も詳しく記録したものだと気づいたところなのです。過去のチケットでの学習は、eesel自身の営業の場でも最も一貫して出てくる要望です。
ただし落とし穴があります。チケットのステータスが示すのは、会話が終わったことだけです。顧客が正しい回答を得たこと、引用したポリシーが今も有効であること、返信がクローンしたいと思う担当者らしかったことは示しません。「解決済み」のチケットの多くは、自動クローズのルールで閉じられたか、1週間後に再オープンされたか、入社1か月目の人が回答したものです。
良い知らせは、履歴が、AIが初期状態で最も苦手なこと、つまり自社チームらしく話すことを教えてくれる点です。あるeeselのトライアルで、ZendeskとShopifyで月に約1,000件のチケットを扱うジュエリーECブランドでは、担当者がAIの下書きをそのまま送ったのは12%だけでした。理由を調べると、書き直しの約3分の2は長さとトーンに関するもので、長い下書きを1〜3文の返信にしていました。事実の誤りの修正は約5%にすぎませんでした。まさに、チーム自身が送った返信を選別したセットが埋めるギャップです。
つまり、やるべきことは「過去のチケットでAIを学習させる」ことではありません。「最良の過去チケットからAIに教え、残りは除外する」ことです。このガイドでは、それを6ステップで説明します。そもそもどんなデータが必要かを検討中の場合は、まずAIの学習に必要なデータを読んでから戻ってきてください。
1件の過去チケットがAIに教えられること
何かをエクスポートする前に、1件のチケットが複数の異なることを教えており、それぞれの教えは別の場所に属することを理解しておくと役立ちます。
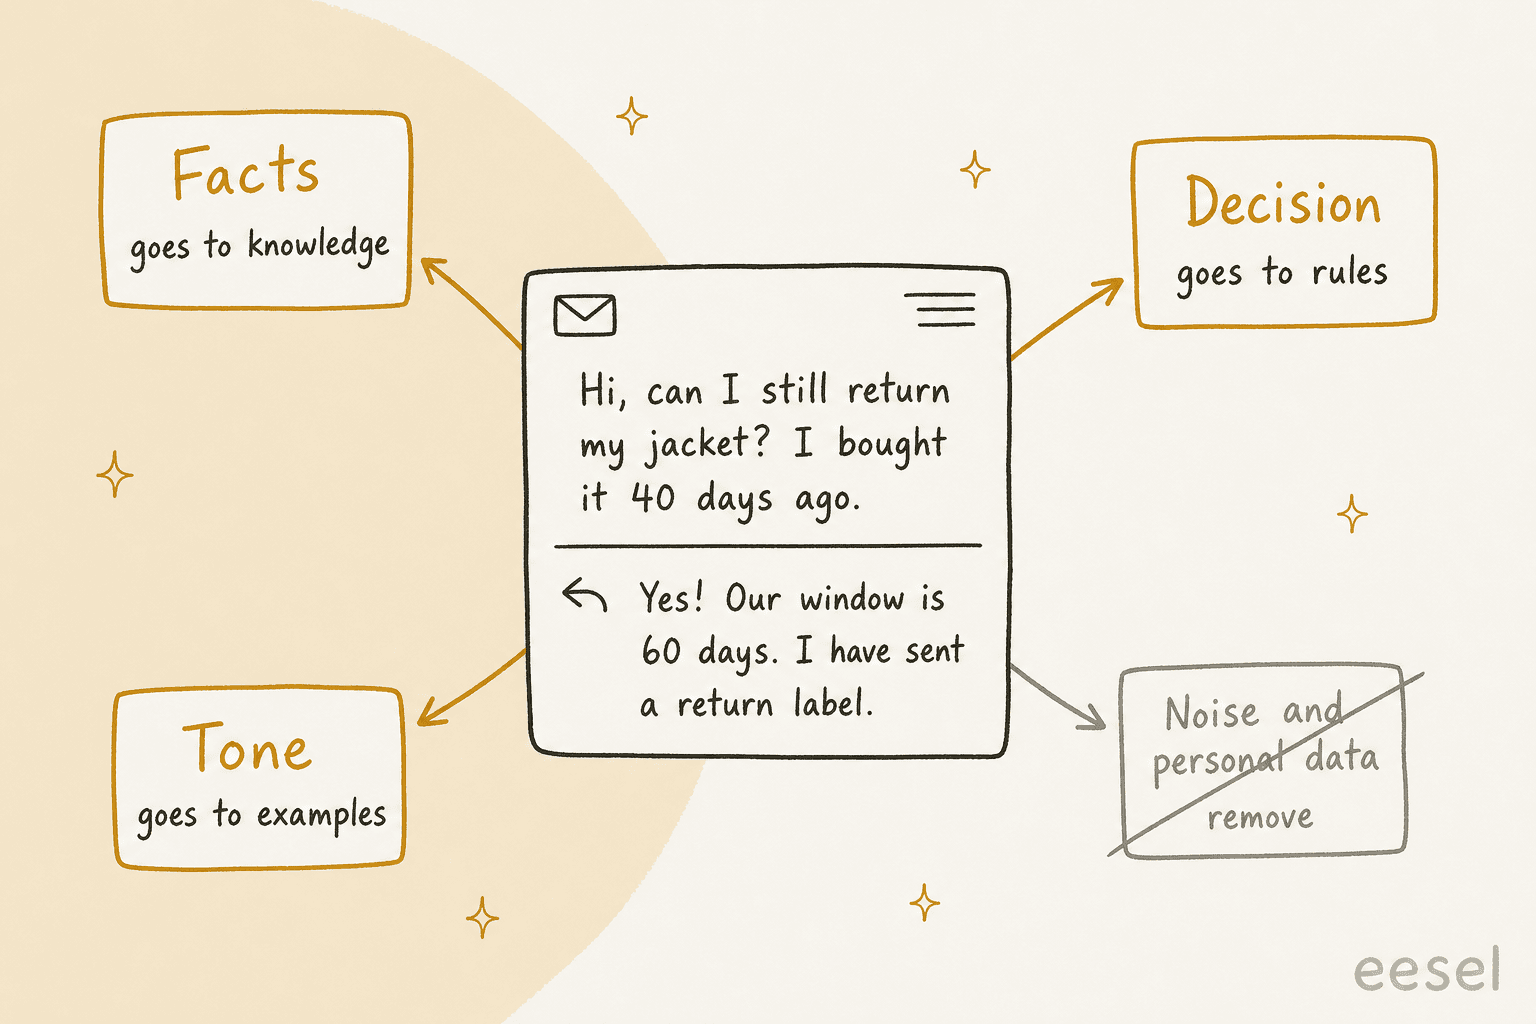
単純な返品依頼を例にします。担当者の返信には次のものが含まれています。
- 事実: 返品期間は60日です。これはナレッジベースに置くべきもので、ポリシーが変わったときに1か所で更新できます。
- 判断: この顧客は対象なので、ラベルを送ります。これはルールです(「60日以内で未使用ならラベルを送る。期間外なら引き継ぐ」)。ルールは、何百もの例から推測させるより、文書にしたほうが安全です。
- トーン: 短く、温かく、感嘆符が1つ、謝罪はなし。これは回答例が教えます。
- ノイズ: 顧客の氏名、住所、注文番号、担当者の署名、社内メモ。どれもAIに届けるべきではありません。
チケット全体をAIに流し込むと、4つを一度に学習し、区別がつきません。その結果、2023年の30日という期間を、実に親しみやすい口調で案内するボットができあがります。Gorgiasはこのリスクをはっきり述べています。"if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time"(Gorgiasのナレッジに関するドキュメント)。古いチケットは、まさにこの種の矛盾の最大の発生源です。
過去チケットを使う3つの方法
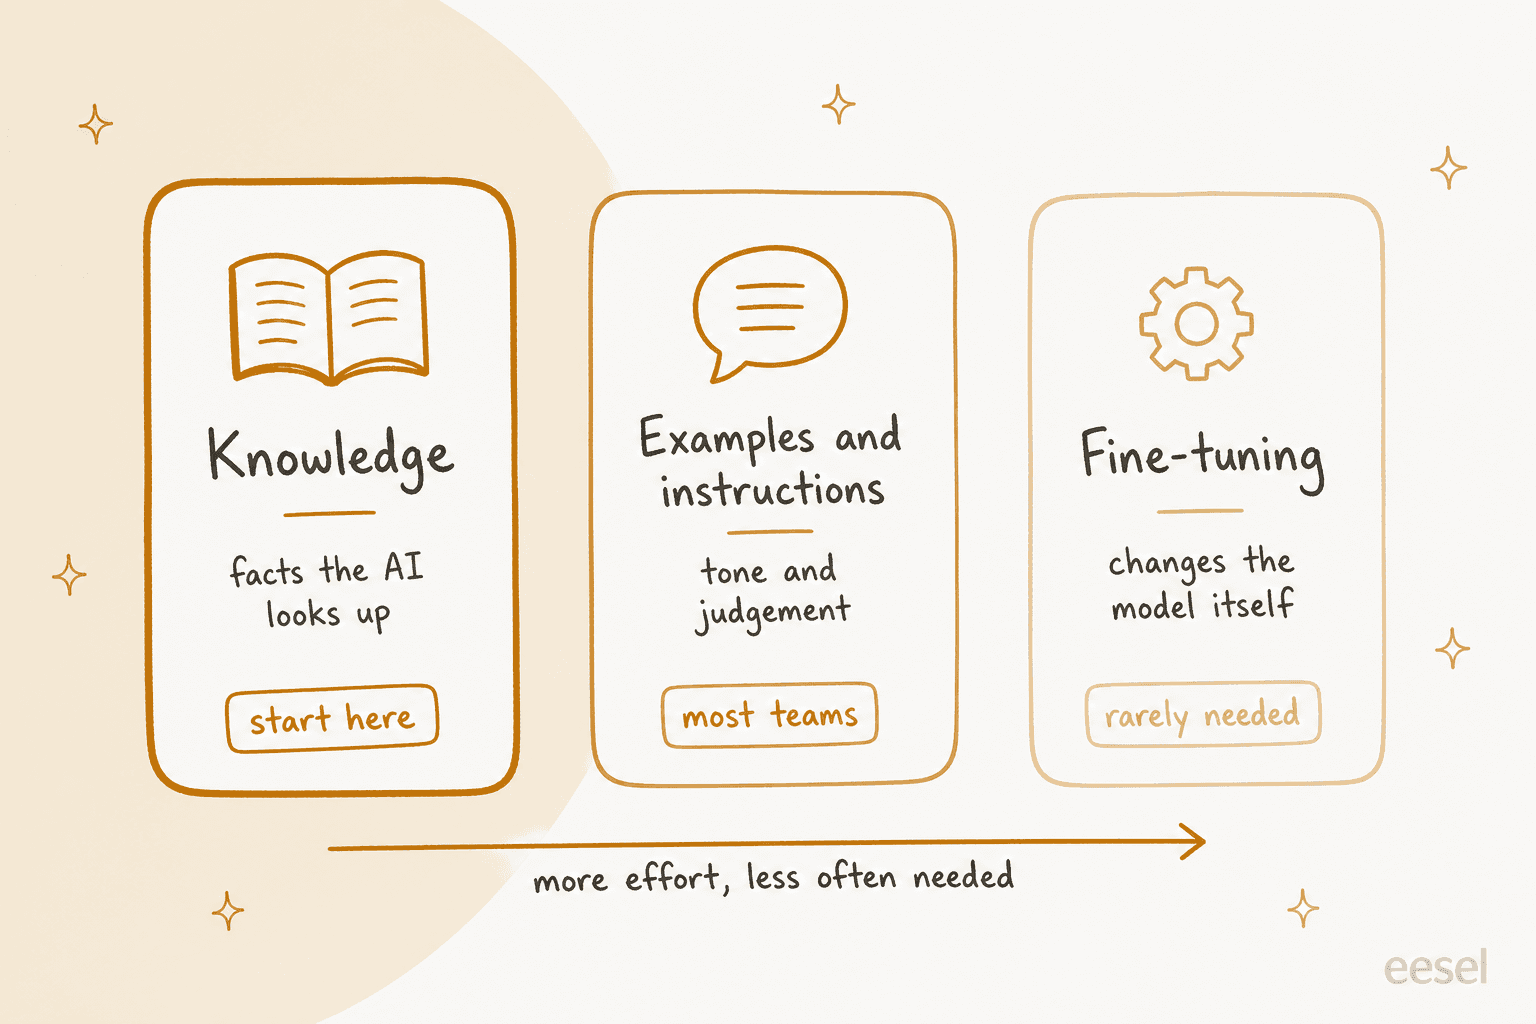
チケット履歴をAIの振る舞いに変える方法は3つあり、有用さは同じではありません。
| 方法 | 教えられること | 仕組み | 手間 | 適切な場面 |
|---|---|---|---|---|
| ナレッジ抽出と検索 | 事実、手順、ポリシー | チケットから回答を抽出して記事やQ&Aにし、回答時にAIが参照する(RAG) | 低〜中 | 常に。正確さはここから生まれる |
| 例と指示 | トーン、長さ、判断 | 最良の返信を数十件選んで例にし、判断をルールとして書き出す | 低 | ほぼ常に。「自社らしさ」はここから生まれる |
| ファインチューニング | 大規模なフォーマットとスタイル | 数千件の会話例でモデルの重みを学習させる | 高 | まれ:非常に大量で、狭いタスクで、プロンプトでは無理だと評価で証明できる場合 |
正確さは検索に宿ります。 質問が届くと、AIはヘルプセンター、マクロ、整理したチケット回答を検索し、見つけた内容から回答します。ポリシーが変わったら記事を1本編集すれば、次の回答は正しくなります。この議論の詳細版はRAGとファインチューニングをご覧ください。
トーンは例と指示に宿ります。 Freshdesk自身がメールエージェントについて示している助言は、"Include examples of ideal responses in your instructions. The agent learns from concrete examples faster than it does from abstract rules"(Freshdeskのメール用AIエージェント設定)です。これに10,000件のチケットは要りません。最良の担当者が誇れる返信が20〜50件あれば十分です。
ファインチューニングは、よく質問されるのに、ほとんど必要とされないものです。 OpenAI自身のドキュメントは、教師ありファインチューニングが適するのは、分類、翻訳、固定の出力形式、そして"correcting instruction-following failures"だとしています(OpenAIの教師ありファインチューニング)。現在の返金ポリシーを学ぶことはこのリストにありません。モデルの重みに焼き込まれた事実は、ポリシーが変わった日に古くなるからです。ドキュメントには"The prompt engineering process may be all you need"ともあります(OpenAIのモデル最適化)。
Redditのある開発者はそれでも試しました。その結果は、生のチケットでのファインチューニングが実際に何をもたらすのかを示す、私が見つけた中で最も明快な例です。
"So I pulled about 8k past tickets which were mostly about shipping, returns, account issues and product information and anonymized the sensitive data then set up a training run. The good news was that it picked up the brand tone and mirrored our macros, but it also prioritized weird quirks too often. Our old agent would write 'hey there' for nearly every tricket so this model started spraying it everywhere."

結局、厳格なシステムプロンプトと軽量な検索レイヤーに戻したそうです。モデルはトーンを学びましたが、1人の担当者の癖も学びました。ファインチューニングでは、癖とポリシーを区別できないからです。
しかも今は、実務上これを避けるべき理由もあります。OpenAIはセルフサービスのファインチューニングを縮小しています。これまでファインチューニングをしたことがない組織は2026年5月7日にアクセスを失い、アクティブな顧客も2027年1月6日以降は新しいジョブを作成できません(OpenAIの廃止予定)。既存ユーザーの場合、gpt-4.1-miniモデルの学習は100万学習トークンあたり$5.00で、チューニング後のモデルは入力100万トークンあたり$0.80、出力$3.20で動作し、ベースモデルの2倍の料金です(OpenAIの料金)。この道についてさらに知りたい場合は、OpenAIファインチューニングAPIのガイドをご覧ください。
どれが自分の問題に必要かわかりませんか? 見られる症状を選んでください。
見られる症状を選ぶと、チケット履歴のどの部分がそれを解決するかがわかります。
ヘルプデスクが過去チケットですでにしていること
何かを構築する前に、ヘルプデスクが自力で何をしているかを確認してください。マーケティングが示すよりも、答えは大きく異なります。各ベンダーのヘルプセンターを一通り確認したので、あなたは見なくて済みます。
| ヘルプデスク | 過去チケットから学習するか | 方法 | 参照期間 | AIの料金(ベンダーのページ) |
|---|---|---|---|---|
| Zendesk | 一部 | auto assistは、合致する手順や記事がない場合にのみ類似の解決済みチケットを使う。手順とヘルプセンターの下書きは解決済みチケットから生成され、公開は人が行う | 生成される下書きは90日 | Copilotは年払いで$50/エージェント/月。AIエージェントはコミット済みの自動解決1件あたり$1.50、従量課金は$2.00 |
| Freshdesk | 回答ではなくテスト用 | 過去チケットは掲載されたナレッジソースではない。解決済みチケットはテストセットとしてインポートできる | APIでは初期設定で30日 | Freddy AI Agent:最初の500セッションは込み、以降は100セッションあたり$49 |
| Gorgias | 間接的 | 「Opportunities」(ベータ)が、AIが解決できなかった会話からナレッジのギャップや矛盾を提案し、各提案を人が承認する | レポートは28日 | 自動化されたやり取り1件あたり$0.85〜$1.00 |
| HubSpot | あり | 解決済みチケットや受信トレイの会話からQ&Aペアを生成し、1件ずつ承認、スキップ、却下する | 90日またはチケットセグメント | 解決1件あたり50クレジット、従量課金では$0.50 |
いくつか目を引いた点があります。
Zendeskはチケットを最後の手段として扱います。 auto assistは"based on procedures, help center articles, similar solved tickets"に基づいて返信を提案し、その順序が重要です。"If there are no relevant procedures or help center articles available, then similar solved tickets are used"(auto assistについて)。同じブランドのチケットだけが対象です。Zendeskは"Relevant solved tickets from the last 90 days"から、ブランドごとに毎週最大3件の手順も下書きしますが、それぞれ管理者の公開を待ちます(AI生成の手順)。料金はZendeskの料金ページにあります。
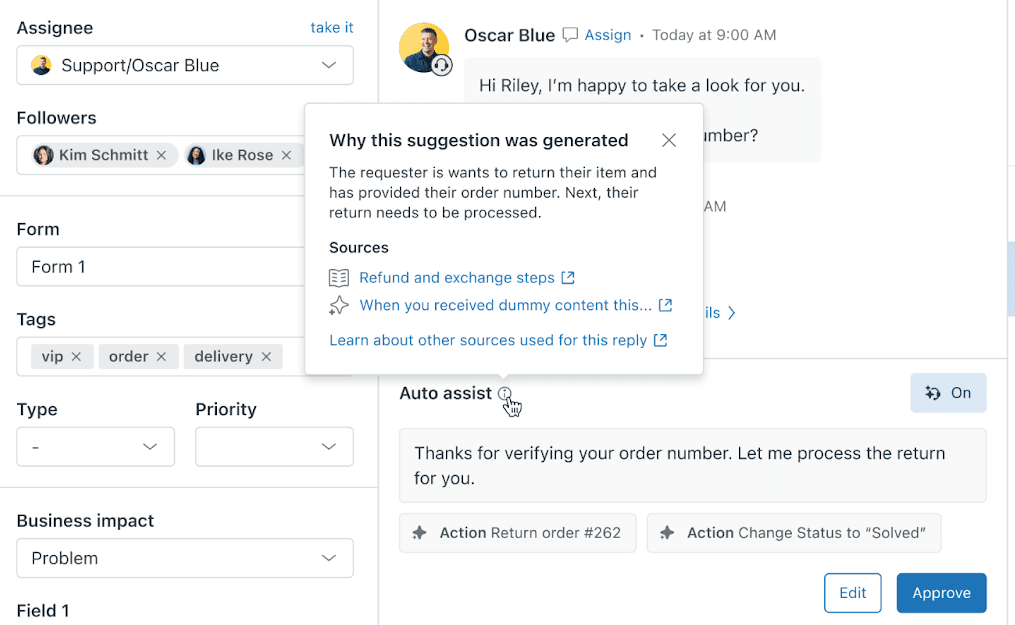
ヘルプセンターがまだない場合は、ZendeskのKnowledge builderも知っておく価値があります。直近90日のチケットを読み取り、最大40本の記事を提案します。そのチケットのルールは、自社のフィルタの良い手本になります。対象は解決済みまたはクローズ済みのみ、空でない公開コメントのみで、社内メモ、スパム、単発の問題は除きます。Zendesk自身も、よく整備されたヘルプセンターには"will likely not be helpful"だと述べています。
Freshdeskは、チケットを回答の経路に入れません。 AIエージェントの情報源は"URLs, files, solution articles, custom Q&As, and external apps"とされています(Freshdeskのナレッジに関するドキュメント)。履歴が登場するのはテストです。過去の解決済みチケットを評価の実行にインポートできます。詳しくはステップ5で説明します。料金はFreshdeskの料金ページにあります。
HubSpotが最も直接的です。 "generate knowledge sources from your resolved tickets, inbox conversations, or uploaded files"を行い、トピックごとにFAQ形式のペアにまとめて、確認用に提示します(HubSpotのナレッジジェネレーター)。ProfessionalとEnterpriseのプランで利用できます。
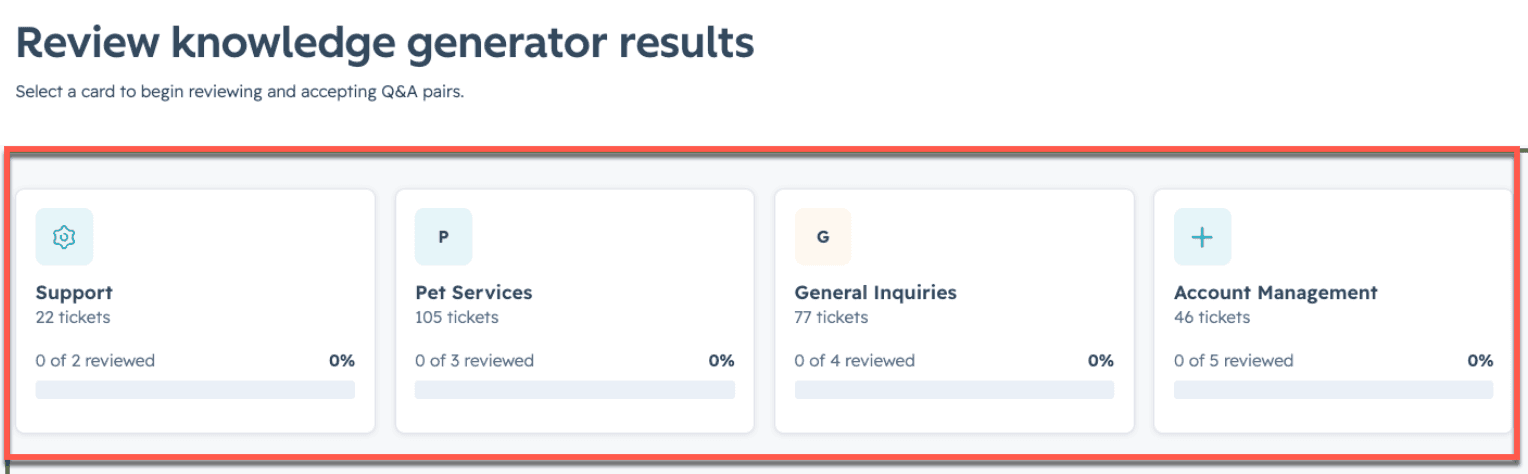
パターンに注目してください。チケットから学習するベンダーは、どこも途中に人の承認ステップを置いています。生のチケット履歴は、レビューなしで学習するには安全でないと、ベンダーが丁寧に伝えているのです。
ステップ1:会話を付けてチケットをエクスポートする
多くのチームにとって最初の驚きは、標準のチケットエクスポートには通常、会話が含まれないことです。件名、ステータス、フィールドは得られますが、本当に学びたいやり取りは得られません。
- Zendesk: 推奨されるインクリメンタルエクスポートのエンドポイントは
GET /api/v2/incremental/tickets/cursor.jsonで、1ページあたり最大1,000件、1分あたり10リクエスト(High Volumeアドオンでは30)、管理者のみ利用できます。コメントは含まれません。include=comment_eventsを付けたチケットイベントストリームから取得するか、チケットごとにコメントのエンドポイントから取得してください。そこではpublic: falseが社内メモを示します。完全な手順はZendeskのインクリメンタルエクスポートのガイドにあります。 - Freshdesk: UIからのエクスポートは"will NOT give you the entire conversation from the ticket or historical data"です(Freshdeskのエクスポートに関するドキュメント)。アカウントのエクスポートかAPIを使ってください。APIは
updated_sinceを渡さない限り直近30日分のみを返し、1回の一覧呼び出しで最大30,000件までです(FreshdeskのAPI)。 - Gorgias: ビューのエクスポートは最大100万件のチケットを扱えますが、メッセージ本文は含まれません。分析のドリルダウンからの"Export with message content"は、直近30日分、最大100,000件、公開メッセージのみです(Gorgiasのエクスポートに関するドキュメント)。
エクスポートするのは公開メッセージだけにしてください。社内メモは、担当者が「顧客は嘘をついている、面倒を避けるためとにかく返金」と書く場所であり、AIにそれを学習させたくはないはずです。Zendesk自身のツールも、同じ理由で社内メモを除外しています。
ステップ2:誤ったことを教えてしまうチケットを除外する
プロジェクトの成否を分けるステップです。できるだけ多くのチケットを残そうとするのではありません。新人に「うちのやり方はこう」と喜んで見せられるチケットを残そうとしているのです。
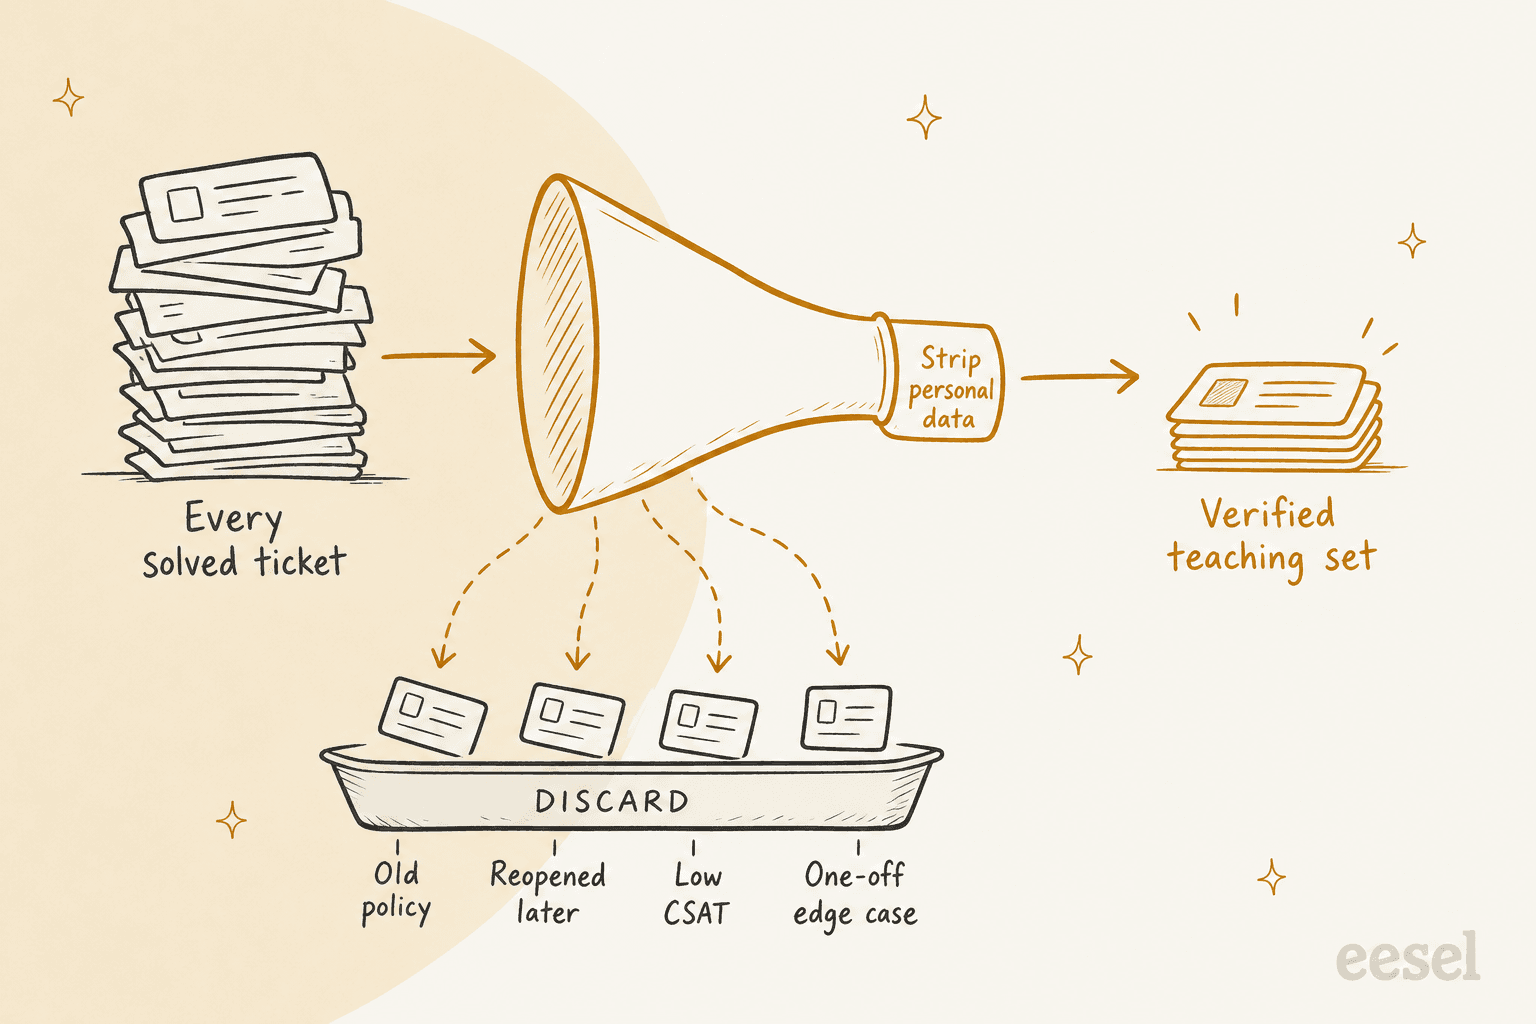
次のものを除外します。
- 最後のポリシー変更より古いチケット。 返品ポリシーが3月に変わったなら、3月より前のものはすべて古いルールを教えます。迷ったら、直近3〜6か月から始めてください。ZendeskとHubSpotはどちらも、チケットから学習する自社機能で初期値を90日にしています。
- 再オープンされた、「解決」後にエスカレーションされた、または同じ問題で2件目のチケットが続いたチケット。 最初の回答はうまくいかなかったのです。
- CSATが低い、またはQAレビューで不合格だったチケット。 サポートQAを行っているなら、QAに合格したチケットがゴールドセットです。
- 担当者の返信がない自動クローズのチケット、スパム、そして「ありがとう!」だけのフォローアップ。
- 単発の例外ケース。 サポート責任者がVIPのために一度だけ行った特別対応を、既定の回答にしてはいけません。
- 混ざり方を歪めるなら、季節的なピーク。 あるeeselの営業の場で、花の配達ブランドは、バレンタインデーと母の日のピークを除いて、10か月間にわたり毎月ランダムな300件のチケットを求めました。2月の急増が他の10か月を埋もれさせないようにするためです。
OpenAIの学習データに関する指針は、反対側から同じことを述べています。"a smaller amount of high-quality data is generally more effective than a larger amount of low-quality data"(OpenAIのファインチューニングのベストプラクティス)。また、偏りは癖を教えてしまうとも警告しています。回答例の60%が"I cannot answer this"と言っているのに、そうすべきなのは5%だけなら、"you will likely get an overabundance of refusals."です。チケット履歴にもこの偏りの独自の版があり、たいていは最も忙しかった月に偏ります。
RedditのあるZendesk管理者は、生の履歴の問題をうまく言い表しており、これがこのステップが存在する理由です。
"I am not entirely sure this approach would be bullet-proof (especially for businesses that have struggled to offer consistent customer support across agents - yes, I've worked for one!). Also, training on tickets is only half the battle, it's integrating all the other "knowledge" sources that makes a difference."
ステップ3:インデックス前に個人データを取り除く
サポートチケットには、氏名、メールアドレス、住所、注文番号があふれており、いらだった顧客が貼り付けたカード番号やパスワードが含まれることもあります。それらがAIのナレッジに入ると、リスクはコンプライアンスだけではありません。AIがある顧客の情報を、別の顧客への返信で繰り返してしまうことです。
ベンダーはこの点を明確にしています。HubSpotのドキュメントは、非公開のナレッジソースは"will not be cited, but their content may still appear in responses"と警告し、したがって"do not include personal, confidential, sensitive information, or private customer data"としています(HubSpotのナレッジソース)。ZendeskのAdvanced Data Privacy and Protectionアドオンは、コメント内の氏名、メールアドレス、住所、カード番号、社会保障番号、IPアドレス、電話番号を検出します。2回読む価値のある警告が1つあります。"Ticket redaction cannot be reversed"(Zendeskの墨消し)。
法的な側面は、Hacker Newsのコメント投稿者が述べたように、簡単に言えます。
"A support ticket or live chat with a customer is customer data. With things like GDPR you need to know exactly where customer data is stored and for how long."

そのため、学習セットを準備するためにヘルプデスク内のチケットを墨消ししないでください。学習に使うコピーを墨消ししてください。私が守るルールをいくつか挙げます。
- 削除ではなくマスキングする。 メールアドレスは削除せず
[EMAIL]に置き換えます。そうすれば例が自然に読め、AIは誰かの実際のメールアドレスを学習することなく「注文時のメールアドレスを尋ねる」ことを学べます。 - フォーマットを教える場合を除き、注文IDを例に含めない。 AIは注文を記憶するのではなく、リアルタイムで照会すべきです。
- 安全側に倒す。 チケットをクリーンにできないなら、スキップします。小さなセットのほうが漏えいよりましです。
- スイッチを確認する。 墨消しの設定は、初期状態でオフのことがよくあります。たとえばeeselでは、最近作成されたワークスペースで過去チケットの墨消しがオフになっており、ドキュメントは"Check the toggle rather than assuming it's on"としています(eeselのPII墨消し)。
仕組みの詳細は、サポートの文字起こしでのPII墨消しと、ZendeskのAIデータプライバシーの解説をご覧ください。
ステップ4:各チケットを事実、判断、トーンに分ける
クリーンになったセットを使い、各教えを適切な場所へ振り分けます。
事実はナレッジになります。 同じ質問に15件のチケットで同じ正しい回答が返されていて、それに対応するヘルプ記事がないなら、それは学習用の例ではなく、不足している記事です。ヘルプセンターや社内ドキュメントに一度書き、AIに検索させます。この作業は人間のチームも速くします。誰かの頭の中にしかなかった回答が、文書として残るからです。ナレッジギャップ分析は、このステップの体系的な版です。
判断はルールになります。 上限を超える返金、保証の申請、法的な脅し、怒っているVIP。これらは判断が必要なケースで、例から学習したAIは、担当者もばらばらだったために一貫性のないものになります。OpenAIのドキュメントはその理由を数字で示しています。人間の意見が一致するのが70%のケースだけなら、"the model would likely not be able to do better than this"(OpenAIのファインチューニングのベストプラクティス)。エスカレーション経路も含めてルールを書き、テストしてください。Zendeskの設計も同じ考えを反映しています。auto assistがアクションを提案するのは"if they're defined in your procedures"の場合のみで、類似のチケットからは決して提案しません。
トーンは例になります。 主要なトピックについて、最良の担当者の返信を20〜50件選びます。短い「注文はどこですか」への回答、慎重な請求の返信、親切な断り方などです。それぞれに、何が良いのかをラベルで付けます(「2文、謝罪なし、追跡リンク付き」)。これで長さと声を変えるには十分で、編集時間の大半はそこにかかっています。AIのブランドボイスとサポートのトーンのガイドでは、例と併せて使うルールの書き方を説明しています。
貴金属業界向けのソフトウェアを作るOroSoftは、実際にどうなるかを示しています。FreshdeskにあるeeselエージェントはOroSoftの約6,100件の過去チケットから学習し、毎晩再同期されますが、解決済みとクローズ済みのチケットを優先し、最近のものを重視し、ポリシーについてはヘルプセンターを情報源として扱い、両者が食い違う場合は新しいほうに従うよう指示されています。過去のチケットが合致する場合、下書きはその構成、トーン、長さをコピーするため、以前うまくいった短い回答は短いままです。そして、古いチケットの顧客名や詳細を決してコピーしません。
チケットからナレッジを掘り起こすのも、凝る必要はありません。Hacker Newsのコメント投稿者は、履歴にモデルを向けるやり方を次のように述べています。
"read this historical dump of 15k support tickets and break them into categories that make sense, then propose help docs that i could write to handle the most frequent queries in each category"
これは正しい発想です。成果物は、人が書いて承認するヘルプドキュメントであり、15,000件のチケットを丸暗記したモデルではありません。
ステップ5:最近のチケットを取り置いて再現する
私が最もよく目にするテストの失敗がこれです。AIが学習したのと同じチケットでテストし、高得点を得て、公開してしまう。当然、好成績になります。答えを見ていたのですから。
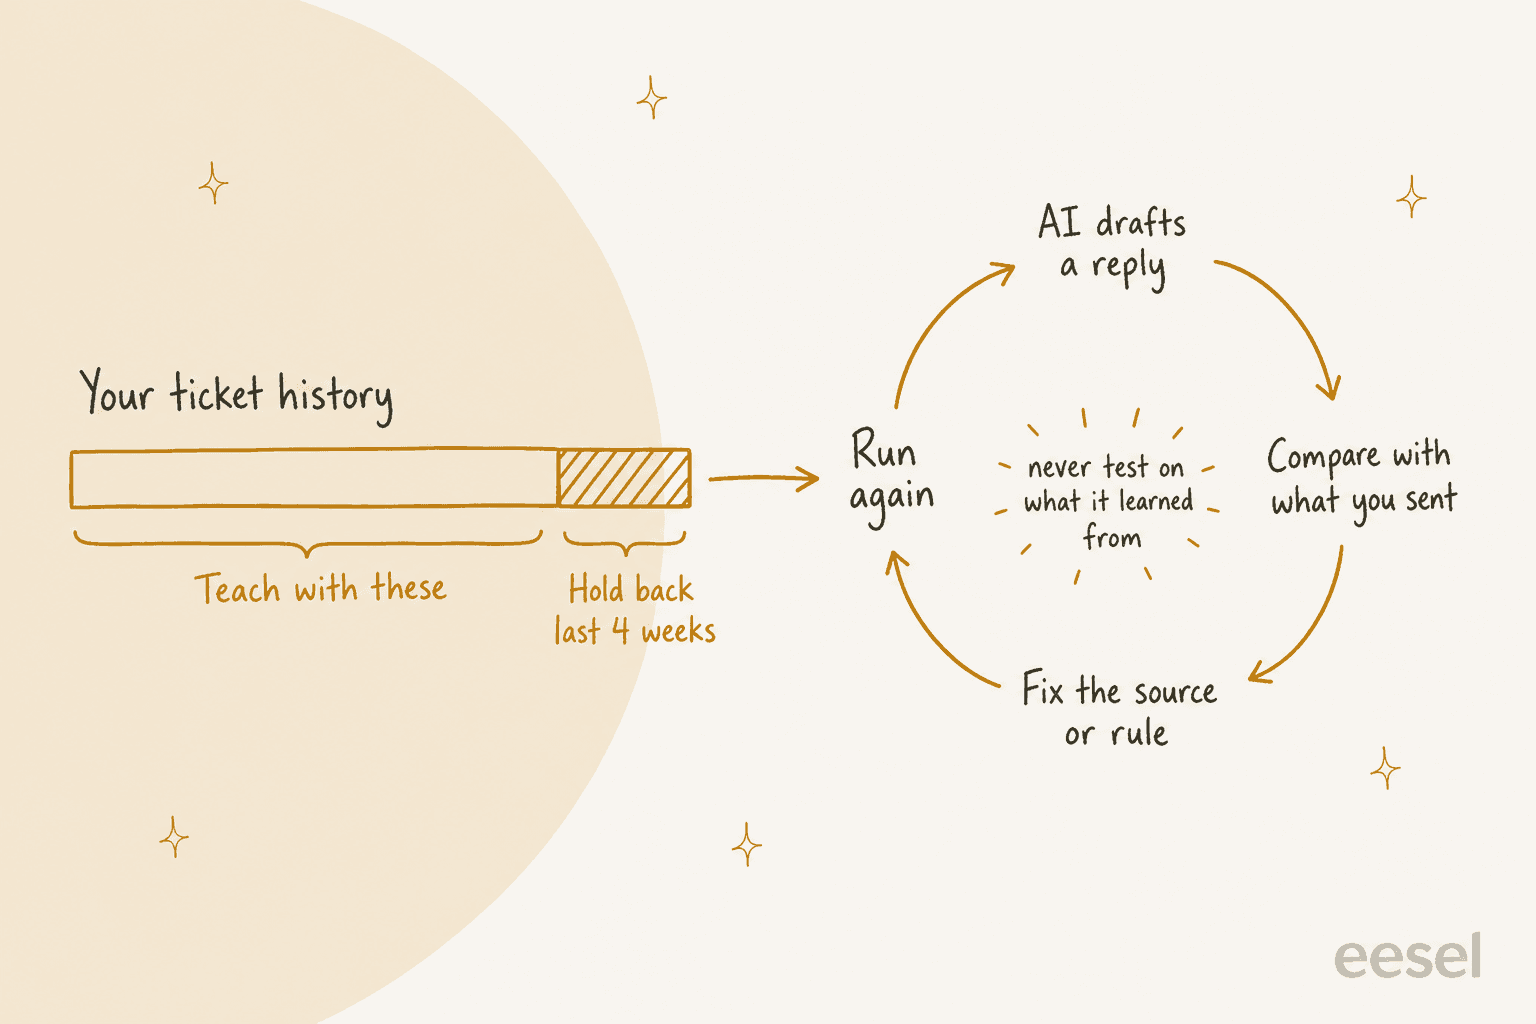
OpenAIのドキュメントは率直です。"Good evals first!"と述べ、"acts as a control group"となるホールドアウトセットを推奨しています(OpenAIの教師ありファインチューニング)。ファインチューニングをまったくしない場合でも同じことが当てはまります。シンプルな手順は次のとおりです。
- インポートから、直近3〜4週間分の解決済みチケットを取り置きます。今日の質問を最もよく代表しており、AIはそれらを見ていません。
- そのうち50〜100件を再現します。 何も送信せずに、各顧客メッセージへの返信をAIに下書きさせます。
- 各下書きを、チームが実際に送った内容と比較し、正確さとトーンを別々に採点します。下書きが事実として正しくても、全面的な書き直しが必要なことがあります。
- ミスはすべて原因に結びつけます。 不足している記事(ナレッジを直す)、誤った判断(ルールを直す)、または声が違う(例を直す)。そして、もう一度実行します。
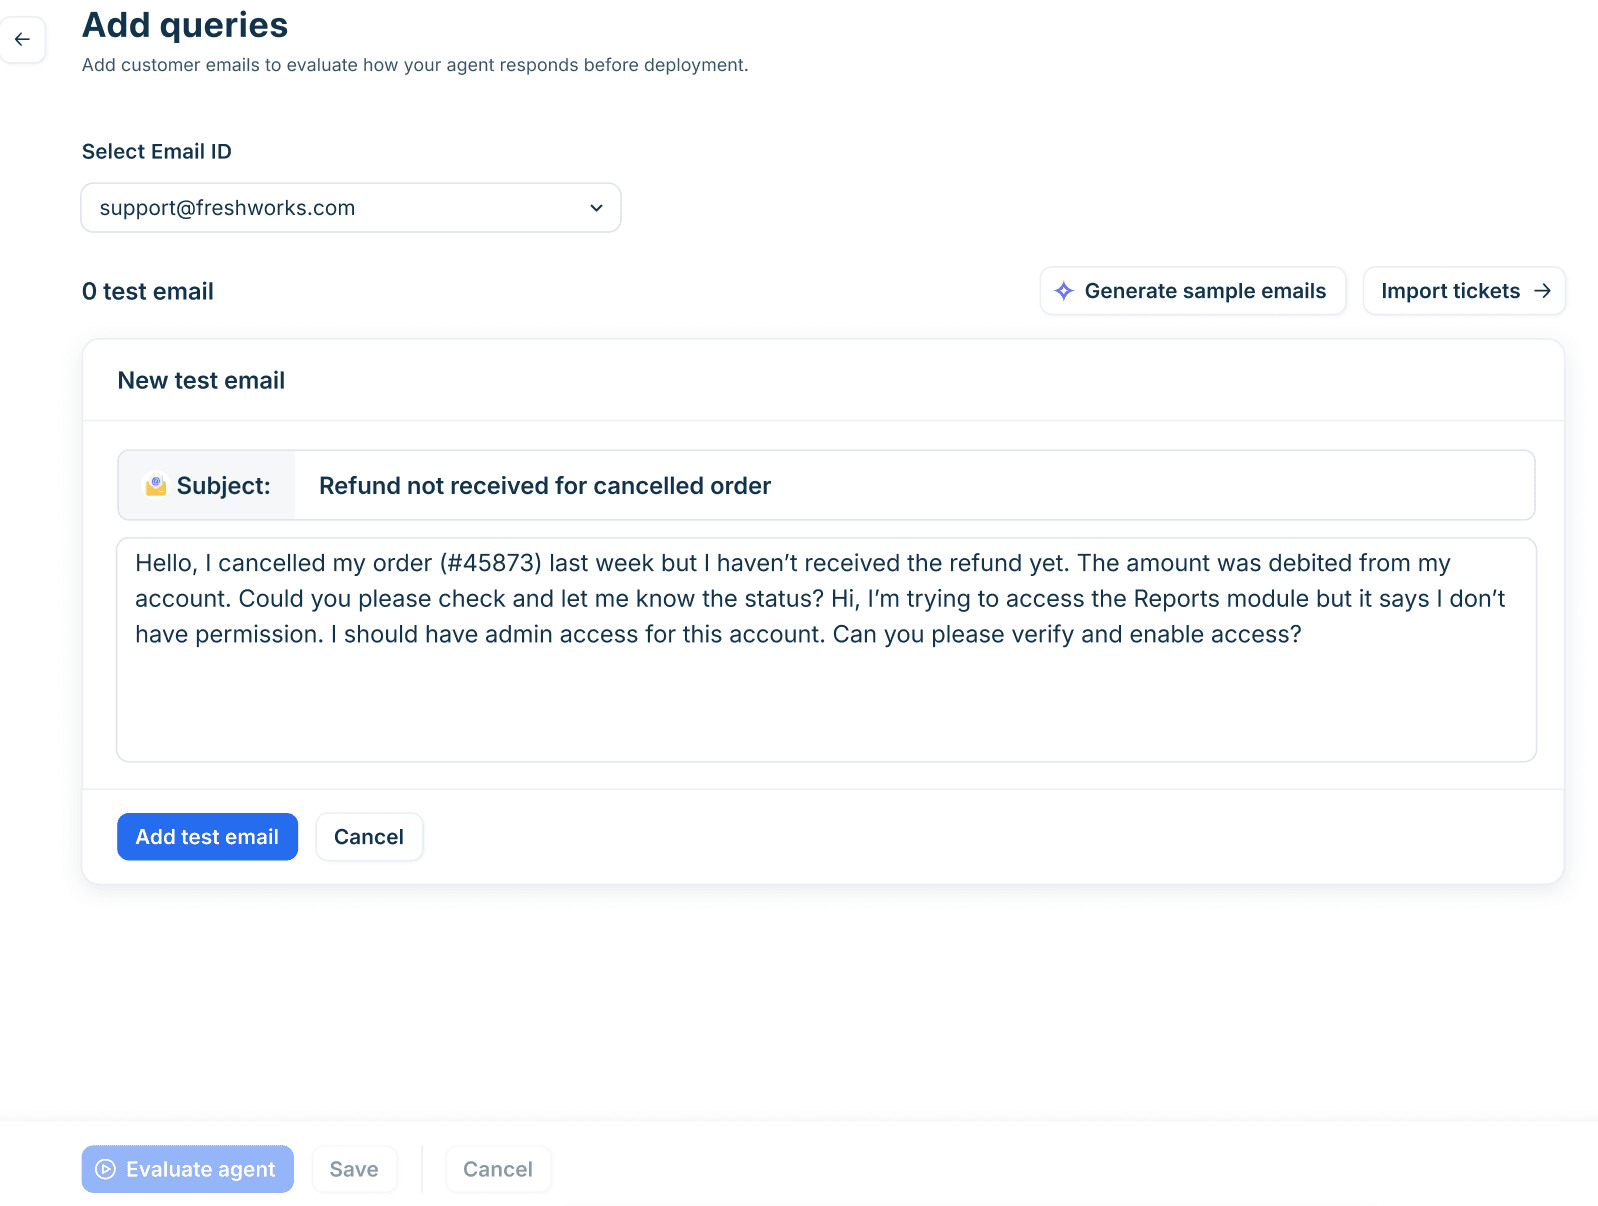
ほとんどのヘルプデスクには、再現のためのツールがあります。Freshdeskのメールエージェントでは、"Import tickets to use solved historical tickets"でテストセットを作成でき、1回の実行で最大50件のクエリを扱い、デプロイ前に少なくとも20件の代表的なクエリを推奨しています(Freshdeskのメール用AIエージェント設定)。HubSpotのバッチテストはクレジットを使いません。eeselのSimulationスキルは、チームが最近解決した20件のチケットへの返信を下書きし、各返信をチームが送った内容と比較して、結果をテーマごとにまとめ、修正案を添えます。顧客には何も送信されません。
クラウドERP企業のQontroは、この比較を公開前の関門ではなく、習慣にしました。同社のeeselエージェントは、Freshdeskの新しいチケットごとに下書きを作り、チームは各下書きを、人が実際に送った返信と比較します。下書きが間違っていた場合、たいていはヘルプ記事の不足や、厳しくすべきルールを示しているので、それを直します。現在では、下書きの約10件に1件が、ほとんど、またはまったく編集されずに送信され、その割合はゆっくり上がっています。完全なテスト計画については、AIサポートエージェントのテストと、公開前のテストのチェック項目をご覧ください。
ステップ6:学習内容を最新に保つ
チケットでの学習は、一度きりのインポートではありません。製品、ポリシー、顧客は変わり、昨年のチケットから学習したAIは、徐々に古くなっていきます。
- スケジュールで再同期する。 デンマークのソフトウェア企業Timengoは、Freshdeskのヘルプセンターを毎週日曜に再同期し、ドキュメントを毎週月曜に再クロールし、オープンなチケットを毎週、全チケット履歴を毎月取り込んでいます。Norden-FrisiaのボットはZendeskから再同期するので、ルーフラックや障害者割引についての記事の変更は、再学習なしでボットに届きます。
- ポリシーが変わったらチケットを外す。 返品期間を更新したら、それを引用している古いチケットは、同じ日に学習セットから外すべきです。
- 新しいチケットからギャップを掘り起こす。 今月AIが答えられなかった質問が、来月のヘルプ記事です。HubSpotは、エージェントが回答できなかったチケットのナレッジギャップを示し、GorgiasのOpportunitiesは、AIが"has repeatedly handed over to your team"というトピックを浮かび上がらせます(GorgiasのOpportunities)。目指すのは、人が各変更を承認する自己更新するナレッジベースです。
- 四半期ごとにAIが頼るナレッジを監査する。 AIナレッジベースの監査は、どんなプロンプトの微調整よりも多くの古い回答を見つけます。
過去チケットでAIを学習させるときのよくある間違い
- 「念のため」にすべてをインポートする。 チケットが増えれば、古いポリシーと一貫性のない判断も増えます。まず選別してください。
- チケットを削除せず、AIに一部を無視するよう指示する。 指示ではナレッジを確実にフィルタできません。学習すべきでないキュー(テストデータ、古い製品、他チームのチケット)は、インポートから除外してください。
- 判断を例から学習させる。 返金の上限やエスカレーションのルールは、テストできる文書にするべきです。
- 法務に聞かれるまで個人データを忘れる。 何かをインデックスする前に、学習用のコピーを墨消ししてください。
- 学習データでテストする。 最近のチケットを取り置かないと、スコアが実力を甘く見せます。
- まずファインチューニングに手を伸ばす。 最も遅く、最も高価で、最もまれな問題しか解決しません。
- 公開を終わりだと考える。 パイロット期間は、履歴がカバーしていなかったギャップを見つける場です。
eeselが過去のチケットから学習する仕組み
ここでは私に偏りがあることをあらかじめお断りしますが、eeselはまさにこのワークフローを軸に作られているので、6つのステップにどう対応するかを示す価値があります。
- コントロールされたインポート。 Zendesk、Freshdesk、Gorgiasにフル接続すると、eeselはヘルプセンター、マクロ、過去のチケットを読み取ります。最初のインポートは最近の解決済みチケット最大1,000件のサンプルで、ステータスと日付で絞り込んで、さらに多くインポートできます(Zendeskのセットアップに関するドキュメント)。ある情報源から学習させたくない場合は、連携ページでオフにします。ドキュメントにあるとおり、過去のチケットを無視するよう指示しても"does not stop it finding them; the switch does."だからです。
- インデックス前に個人データをマスキング。 過去のチケットは、15種類の個人データを対象とする検出器を通り、
[REDACTED:EMAIL]のような型付きのマスクに置き換えられます。クリーンにできないチケットは、生のまま保存されず、スキップされます(PII墨消しのドキュメント)。 - 公開前の再現。 Simulationスキルは、最近の解決済みチケットを再現し、各回答をチームが送った内容と照らして採点し、指示の変更を提案します。自動化を作成するまで、実際のチケットでは何も動きません。ほとんどのチームは下書きから始めます。
- 定着する修正。 チャットで返信を修正すると、eeselはその修正を自身の指示に書き込むので、来週も修正が保たれます。
- エクスポートとインポートの配管用CLI。 スクリプト化したい、またはClaude CodeやCursorのようなコーディングエージェントにやらせたい場合、eesel CLIがターミナルから同じエージェントを操作し、JSONで出力します。
eesel integrations sources zendeskはヘルプセンター、マクロ、チケットの各ソースの内容を表示し、eesel integrations download start zendeskはそれらをeeselのナレッジにコピーし、eesel chatでは特定の日付範囲のインポートやシミュレーションの実行を依頼できます。ダッシュボードと同じエージェントなので、そこで設定したものは両方に表示されます。
スウェーデンの電気自動車小売業者Nordbutikerは、「ためこまず選別する」という考え方のよい例です。スウェーデン、ノルウェー、デンマーク、フィンランドで4つの店舗を運営しており、各店舗のボットは自店のZendeskブランドの解決済みチケットから学習するので、回答はその店の担当者が実際に言ったことを反映します。サイトや過去のチケットがカバーしないもの、たとえば交換部品や保証の申請は、人に回されます。
eeselで過去のチケットからAIを学習させる
何年分ものヘルプデスクの履歴があり、最良の担当者のように答えるAIがほしいなら、eeselは私の知る最短の道です。個人データをマスキングしたうえで、ヘルプセンター、マクロ、最良の過去チケットをすでに読んだ新人のように、Zendesk、Freshdesk、Gorgiasに加わります。そのうえで、最近のチケットを再現して、実際の返信を1件も下書きする前に、どこで間違えたはずかを示します。
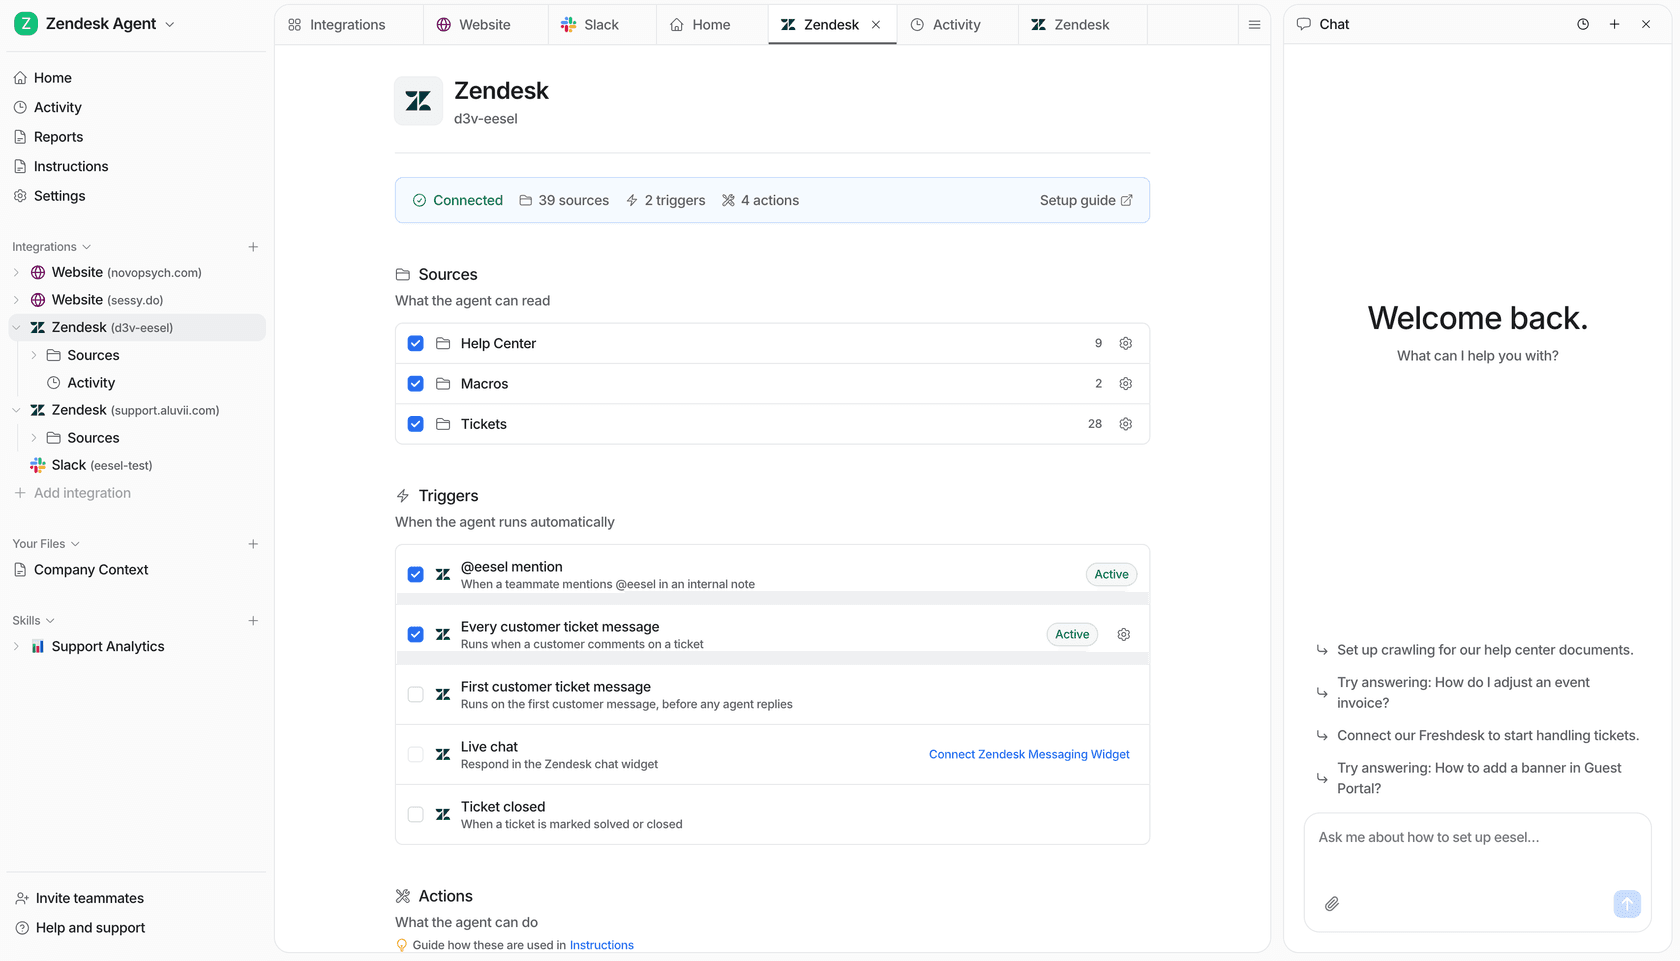
これがNorden-Frisiaの決め手でした。トライアルの週にチームはZendeskを接続し、マクロと直近3か月のチケットを取り込み、数日以内に契約しました。無料プランにはカード不要で100クレジットが含まれ、有料プランは500クレジットで$299/monthから始まります。1件のチケットは、やり取りが何往復しても1クレジットです(eeselの料金)。何かを支払う前に、自社のチケット履歴でeeselを試し、下書きを確認してください。