

サポートQAキャリブレーションとは?
Zendeskはキャリブレーションの設定ガイドで、こう端的に定義しています。キャリブレーションとは「the practice of having all your reviewers rate the same batch of conversations and compare their scores and comments.」です。考え方はこれがすべてです。同じ会話、同じQAスコアカード、違う人が採点し、数字が合わない理由を話し合います。まだスコアカードを作っていない場合は、まずZendesk QAスコアカードの作成から始めて、戻ってきてください。
私はeeselのサポートキューを毎日担当していますが、これが重要なのは、QAスコアがQAツールの中だけにとどまらないからです。スコアは1on1やコーチング計画、ときにはボーナスにまで使われます。あるレビュアーが返信のトーンに5点中4点をつけ、別のレビュアーが同じ返信に2点をつけたら、エージェントのスコアはどのキューに当たったかで決まります。エージェントはすぐにそれに気づき、QAは運次第だと思い始めると、フィードバックは届かなくなります。
"You could have five QA agents listen to the same call and get five different results. Which isn't fair to the agent as that score could be used to determine if they'll be fired."

キャリブレーションはその解決策です。エージェント向けの研修ではなく、ほとんどのツールではエージェントには見えません。Zendeskの設定ガイドには「Agents do not see any conversation-related information in calibration」とあり、キャリブレーションのスコアは「don't affect the existing Internal Quality Score (IQS).」とされています。これは採点者に対するチェックであり、採点者自身が行うものです。
QAスコアがずれる理由
レビュアーの意見は無作為に分かれるわけではありません。ルーブリックが判断の余地を残しているカテゴリで分かれます。トーン、共感、「返信の長さは適切だったか」、「エージェントは期待以上のことをしたか」などです。プロセスと正確さは、たいてい一致します。返金ポリシーは守られたか守られていないかのどちらかだからです。トーンでは、慎重な2人が同じ文を読んで2ポイント差がつきます。
もう1つのずれの原因は、そもそも「合格」が何を意味するかです。eesel自身の仕事から実例を紹介します。ECサイトのZendeskの受信トレイで実トラフィックを使ったトライアルを見たところ、AIが下書きした284件の返信が3つの異なる方法で採点されていました。
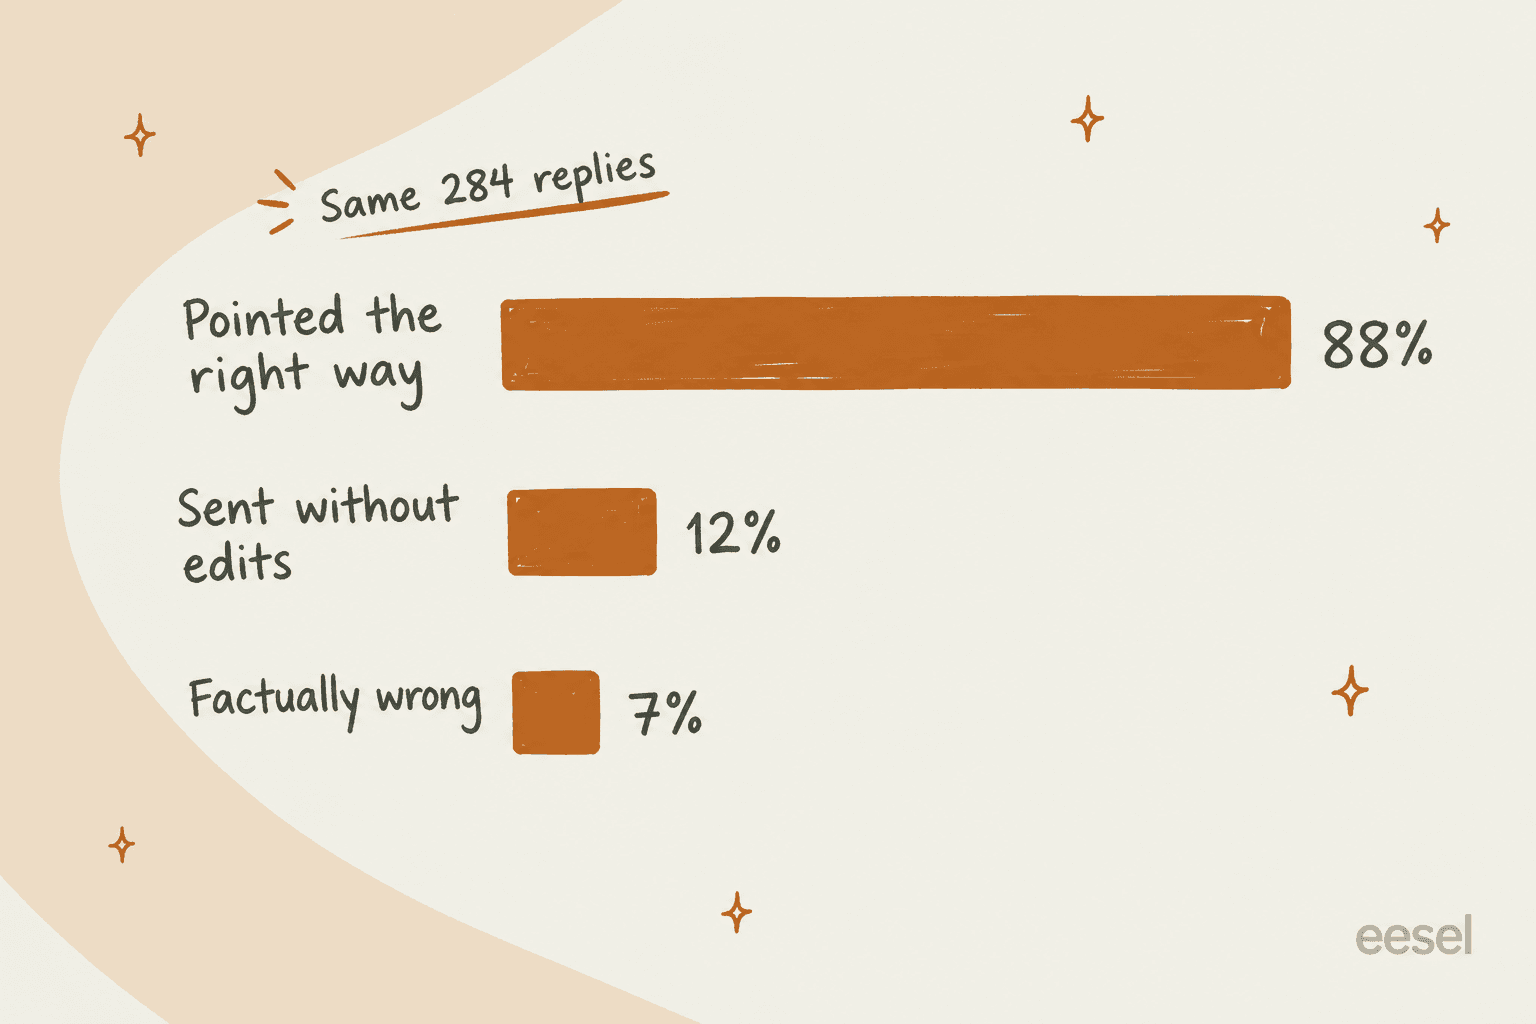
同じ返信でも判定は3通りです。88%は正しい方向を向いており、編集なしで送信されたのは12%だけで、7%は事実として誤っていました。どの数字も間違っていません。それぞれ別の問いに答えているだけです。「これをそのまま送るか」で採点するレビュアーと、「答えは正しいか」で採点するレビュアーは、同じキューでも大きく違うスコアをつけますし、どちらも自分は公平だと思っています。エージェントが下書きを書き直した理由を調べると、書き直しの約65%は長さとトーンのため、約20%は下書きから見えない注文データが必要なため、約5%は下書きが事実として誤っていたためでした。長さとトーンは、人間のレビュアーも割れる、まさにそのカテゴリです。(この種の書き直し分析は、エラー分析のガイドで詳しく解説しています。)
だからキャリブレーションは、スコアではなく基準から始めます。スコアカードにトーンの3点と4点がどう違うかが書かれていなければ、どれだけ議論してもレビュアーの意見は長くはそろいません。
QAキャリブレーションセッションの進め方
私ならこの5ステップで進めます。月1回で約1時間、加えて事前にレビュアーごとに10〜15分の採点時間が必要です。
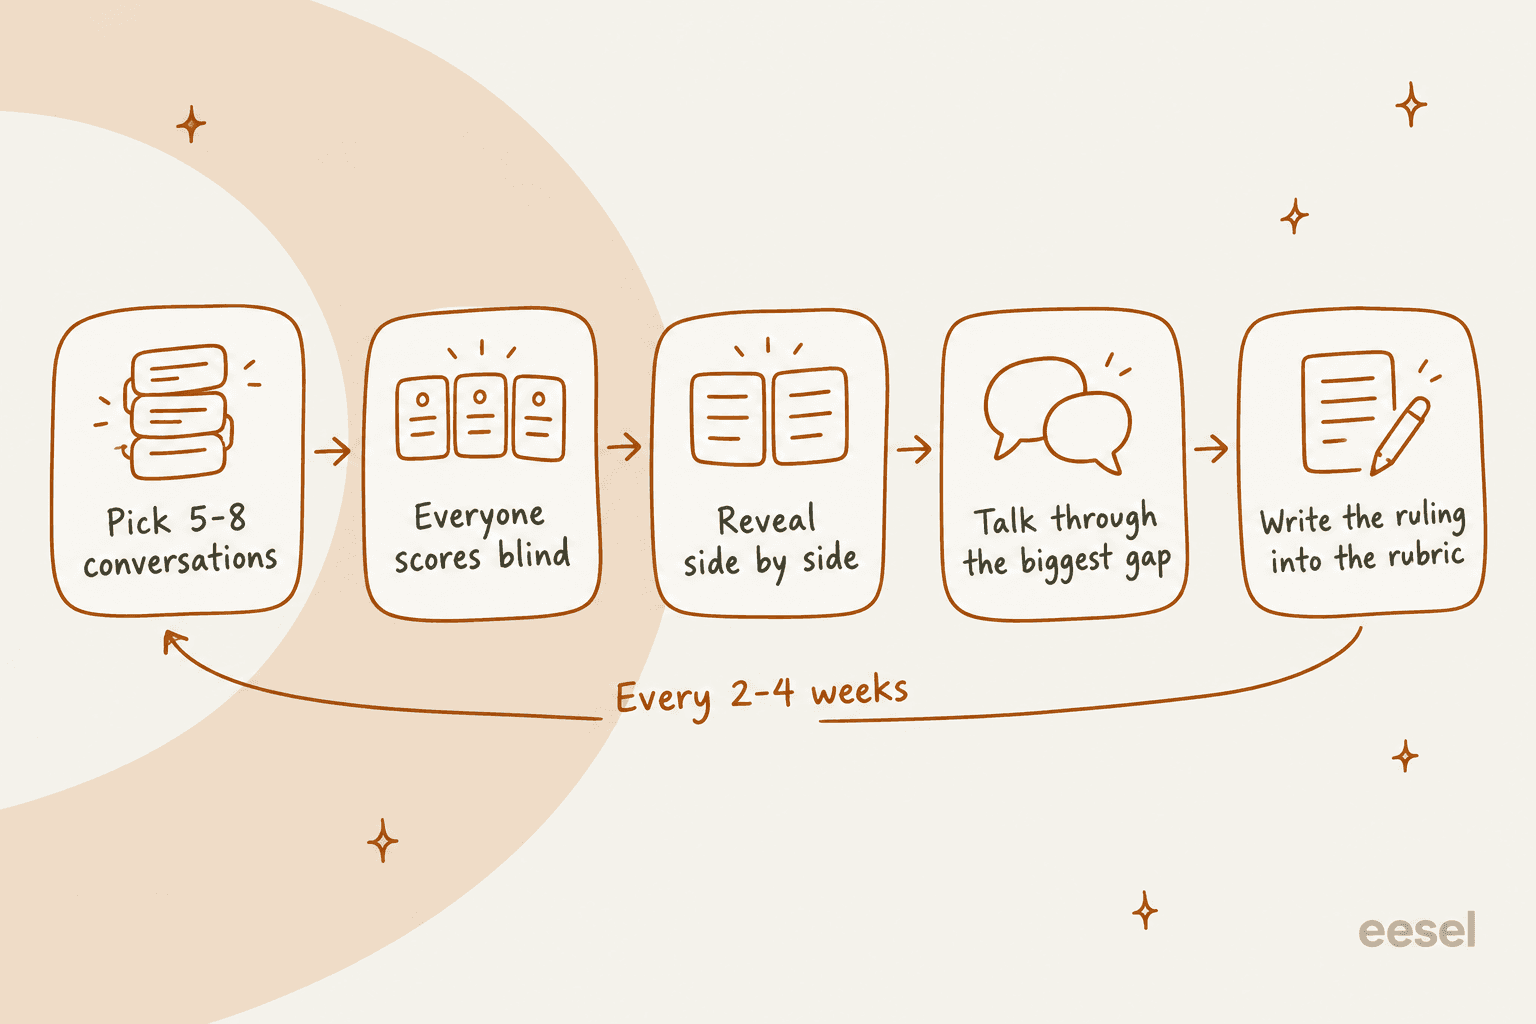
1. 議論になりそうな会話を5〜8件選ぶ
Zendeskのキャリブレーションガイドでは、約5件から始めることを勧めています。チームが慣れたら8件まで増やしてもよいでしょう。それ以上だと議論が駆け足になります。
件数よりも選び方が重要です。簡単なチケットは全員が同じ点をつけるので、何も学べません。MaestroQAのキャリブレーションのアドバイスは、QAスコアが低いチケット、難しい話題、最近プロセスや製品が変わったチケットを選ぶことです。evaluagentはキャリブレーションの解説で妥当な点を補足しています。悪いやり取りだけでなくバランスよく選ばないと、セッションが犯人探しになるという指摘です。
私の組み合わせはこうです。変更されたばかりのポリシーに関わる会話を1件、最初のメッセージから顧客が怒っていた会話を1件、返信が何往復も続く長いスレッドを1件、問題なく終わったのにどこか「違和感」があった会話を1件、最近エージェントが異議を申し立てた会話を1件です。複数の言語でサポートしているなら、英語以外の会話も1件加えてください。言語チーム間でのキャリブレーションの方法は、多言語サポートQAのガイドで説明しています。
2. 全員がブラインドで採点する
チームが省きがちなステップですが、残りを機能させるのはこのステップです。レビュアーが互いのスコアを見られたり、同じ部屋で一緒に採点したりすると、最初に自信を持って発言した人が数字を決め、全員がそこに引き寄せられます。evaluagentのキャリブレーションのウェビナーは、この問題の紙版について、人々が「can change their scores on their paper, and they can be swayed to another person's point of view before they get an opportunity to speak.」と述べています。
Zendesk QAでは、ブラインドにするか公開にするかは、ロールごとに選べるワークスペース設定です。レビュアーは自分のレビューだけを見る、または自分のレビューを提出した後にのみ他の人のレビューを見る、のどちらかに設定できます。リードとマネージャーにも同じ「提出後」の選択肢か「常時」があります。
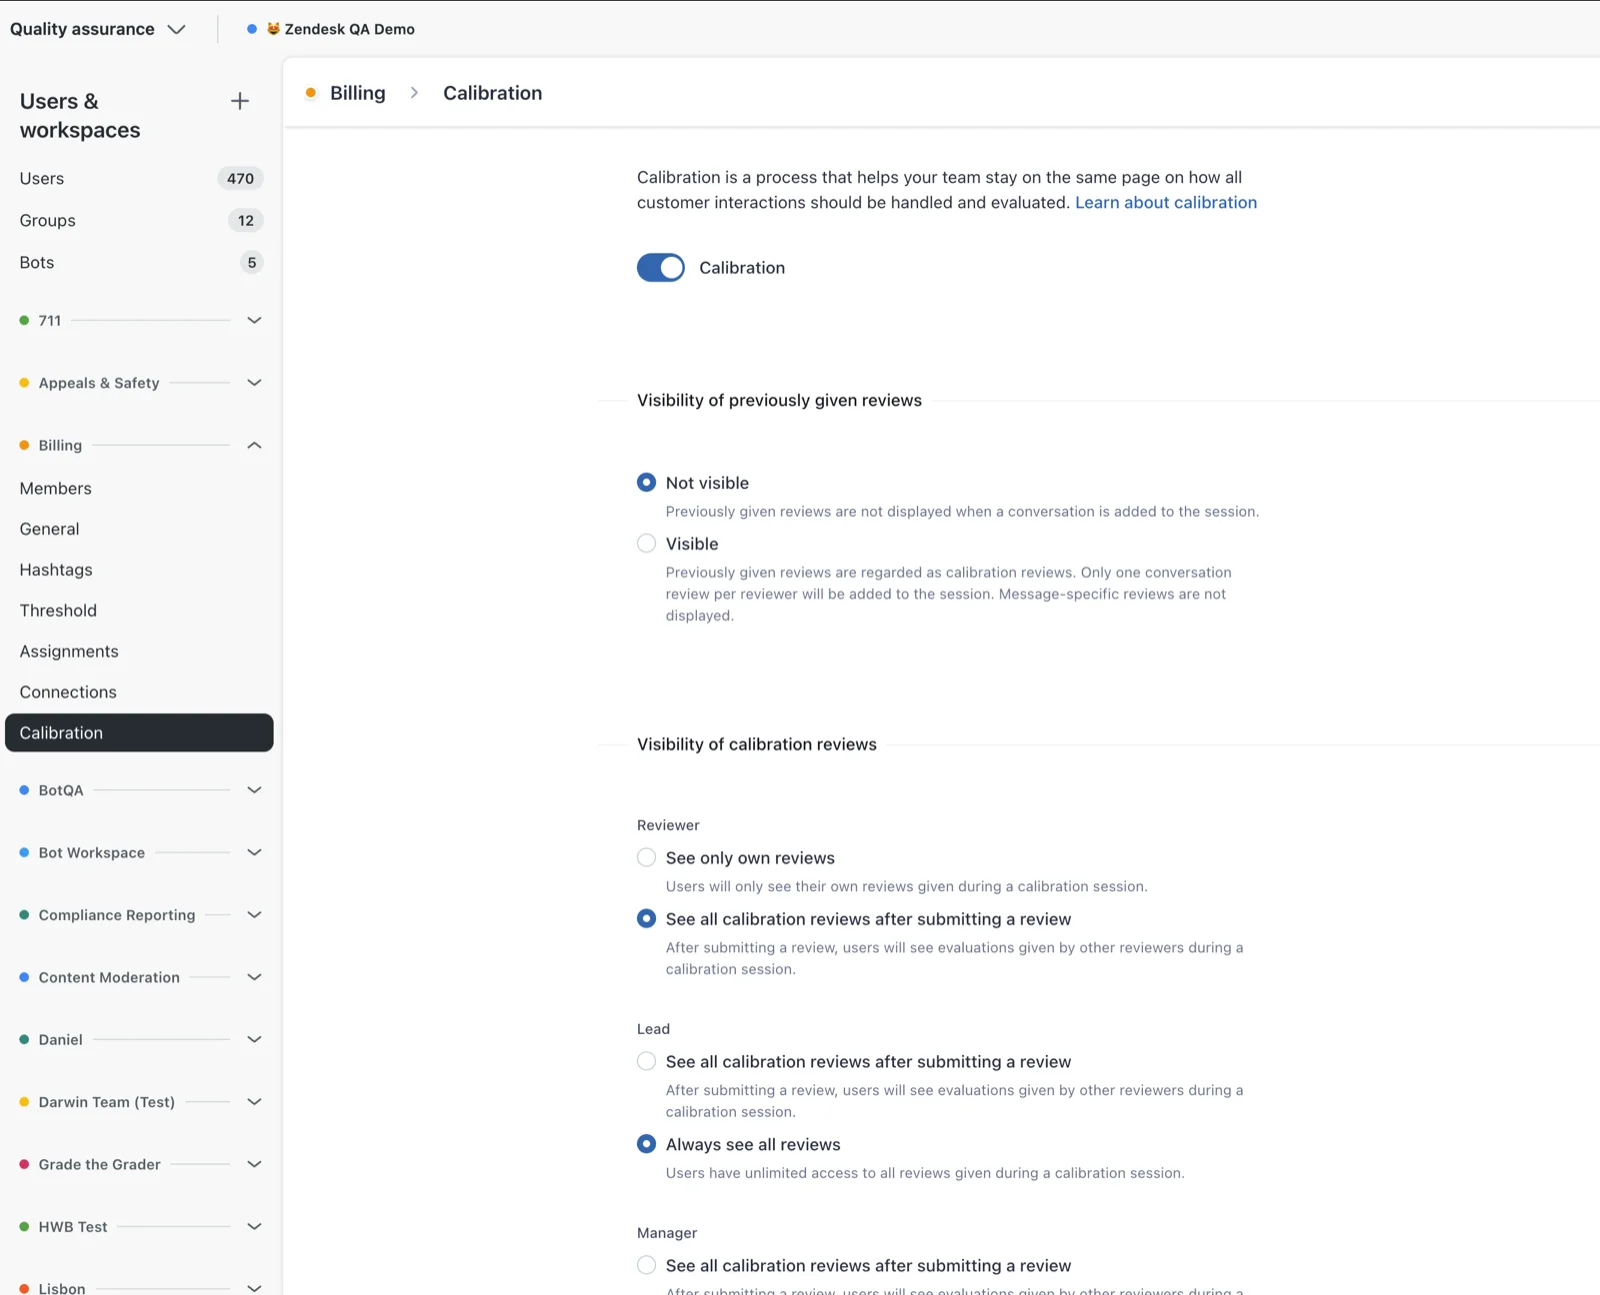
実務上の注意点が1つあります。Zendesk QAはキャリブレーションの通知を送りません。Zendeskのドキュメントによると、「it's up to the workspace manager or lead to inform reviewers about the calibration session and its due date.」とされています。期限はチームのチャンネルに書いておかないと、半数のレビュアーが会議の10分前に採点することになります。
3. 基準スコアと並べてスコアを公開する
全員が採点し終えたら、スコアを1つの表にまとめます。縦にレビュアー、横にスコアカードのカテゴリです。見るべきは2点で、次のセクションで改めて触れます。ばらつきの大きいカテゴリと、すべてでずれているレビュアーです。
基準も必要です。比較対象となる、合意された「正しい」スコアのことです。Zendesk QAでは、マネージャーが1件のレビューをBaseline reviewとして指定でき、Zendeskによれば「makes it easier to compare scores against it.」となります。キャリブレーションダッシュボードには、各レビュアーのスコアが基準スコアの隣に表示されます。
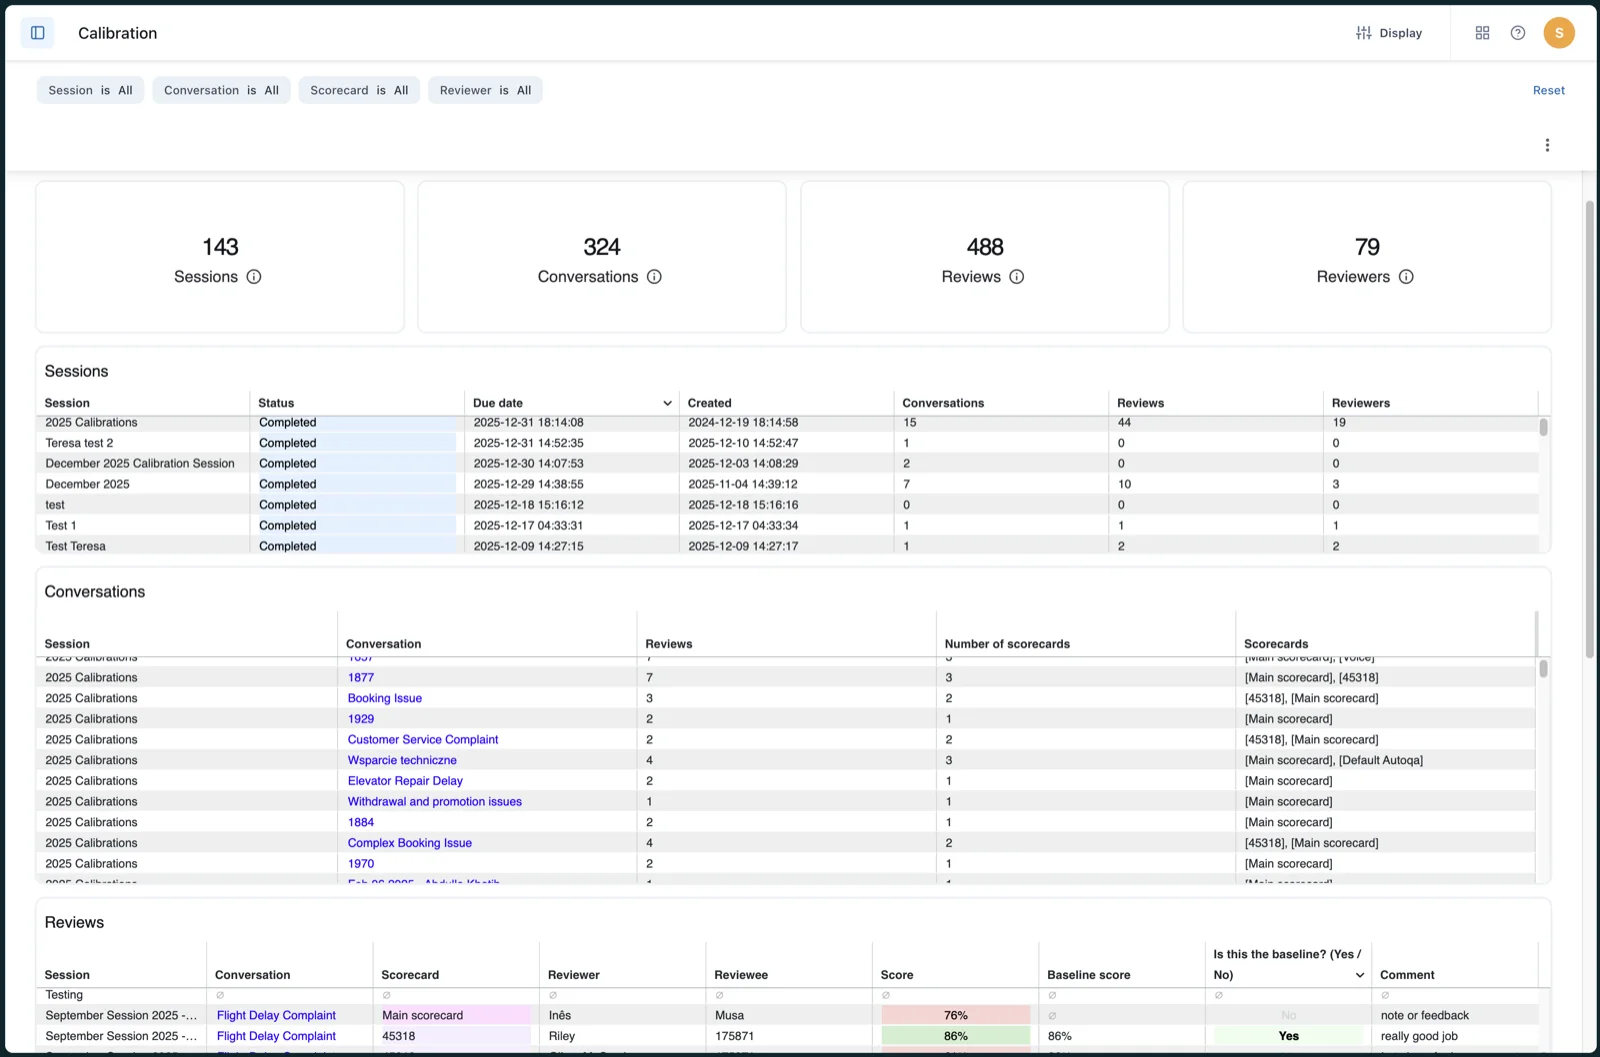
MaestroQAは、指定された最終キャリブレーターで同じことを行います。チームの足並みをそろえるガイドではその人物を「your source of truth to measure alignment against」と呼び、各採点者にはその人に対する整合スコアが付きます。
4. すべての差ではなく、最大の差を話し合う
会話5件とカテゴリ6つなら、意見が分かれうる箇所は30あります。1時間では扱いきれませんし、扱おうとすべきでもありません。ばらつきの大きい順に並べ、会議は上位2〜3件の差に使います。
目的は合意ではなく決定です。MaestroQAのキャリブレーションのページで引用されているStitch Fixのリーダーは、こう表現しています。「We've normalized the expectation that we're driving toward commitment, not consensus.」evaluagentも反対側から同じことを述べています。「It's not a democracy, if you like, where majority rules.」3人が4点、1人が2点をつけたとしても、答えが自動的に4点になるわけではありません。ポリシーを最もよく知る人が判断し、全員がそれにコミットします。
5. 決定事項をルーブリックに書き込む
多くのキャリブレーションセッションが静かに失敗するのはここです。チームが合意し、全員がうなずき、3週間後に同じ意見の食い違いが再び現れます。何も書き残していないからです。
解決した差はそれぞれ、スコアカードのガイドの1行にし、その会話を実例として添えます。「トーン:同じ問題について2回謝る返信は4点ではなく3点。例:チケット#48213。」次のセッションを短くしてくれるのはこの記録です。これはサポートSOPや、新人エージェントのオンボーディングで使う例にも反映されます。新人にも、レビュアーが決めたのと同じ判断が必要だからです。良い決定は、良いQAフィードバックの例のように、具体的で、会話の特定の1行に結びつき、短いものです。
r/callcentresのあるQAリードは、これを厳格に行うやり方を紹介していました。
"Calibrations by quality need to be strictly enforced and maintained. My last team I ran was quality and every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
ルーブリックの問題か、レビュアーの問題か?
多くのガイドが飛ばしているものの、いちばん役に立つのがキャリブレーションのこの部分です。スコアがそろわないとき、ずれ方のパターンが何を直すべきかを教えてくれます。
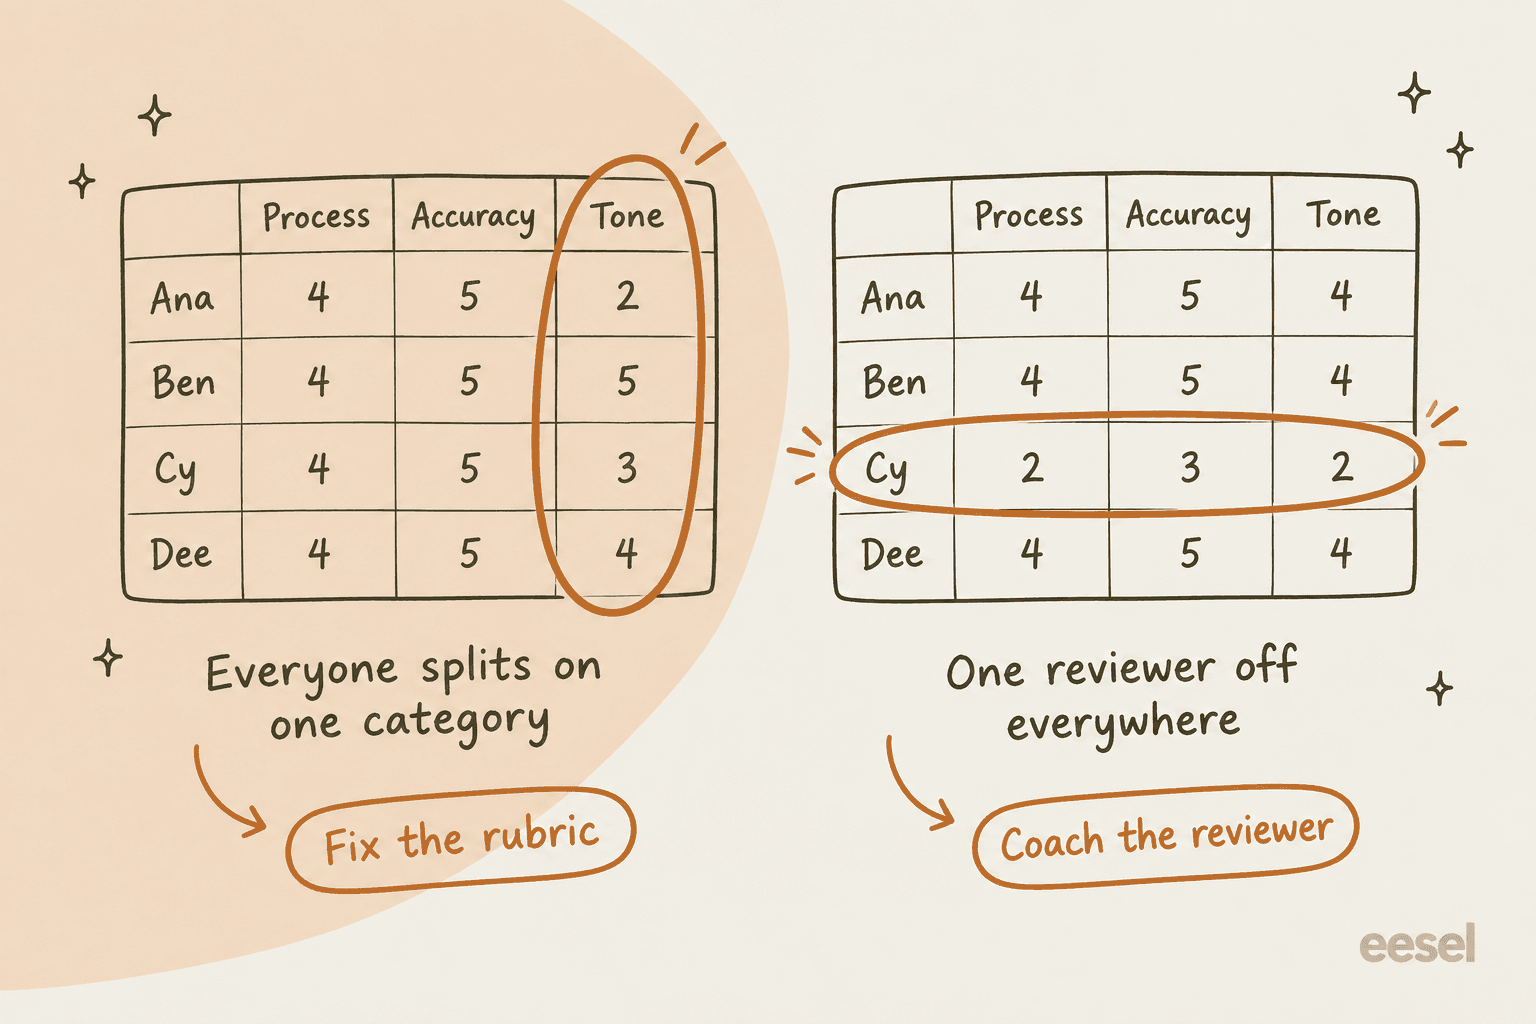
**全員が1つのカテゴリで割れる。**プロセスと正確さは一致しているのに、トーンが4人のレビュアーで2から5まで分かれているなら、誰も「間違って」いません。基準が解釈の余地を残しているので、ルーブリックを直します。トーンのガイドを具体例つきで書き直し(カスタマーサービスのトーンガイドにテンプレートがあります)、次のセッションで同じ会話を再採点して、差が縮まったか確認します。
**1人のレビュアーがすべてでずれる。**1人がすべてのカテゴリで他の全員より2ポイント低くつけているなら、ルーブリックは問題ありません。そのレビュアーが違う読み方をしているので、レビュアーをコーチングします。エージェントをコーチングするのと同じように本人と向き合い、1件の会話をカテゴリごとに確認し、さらにもう1件を自分で採点してもらいます。
**チーム全体が基準から同じ方向にずれている。**全員が4点をつけ、リードは2点をつけていたケースです。これはたいてい、リードがチームの知らないこと、たとえばナレッジベースに反映されなかったポリシー変更を知っているということです。これは採点の問題ではなく、情報共有の問題です。
ご自身の数字で試してみてください。1件の会話について各レビュアーのスコアを入力すると、チェッカーがどのケースに当たるかを教えてくれます。
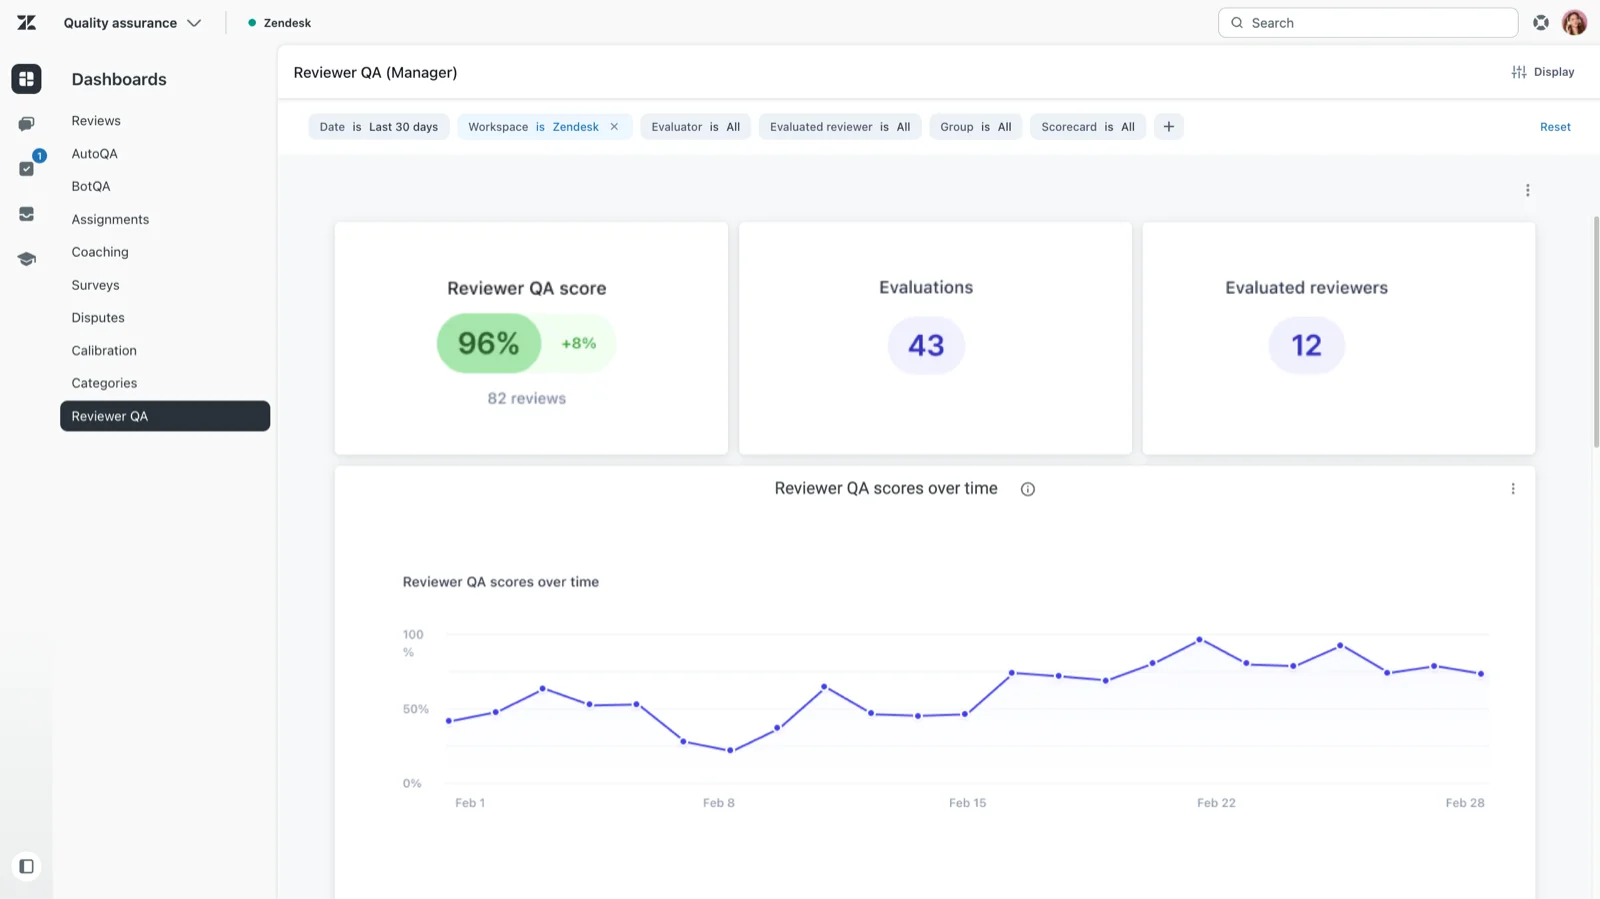
Zendesk QAは、別のReviewer QAダッシュボードで、レビュアー側の推移も追跡します。ランダムな割り当てで、誰かがレビュアー自身のレビューを評価する仕組みで、Zendeskのダッシュボードのドキュメントでは「track reviewer accuracy, evaluation history, and coaching trends.」のためのものとされています。評価されたレビュアーは自分のスコアを見られますが、誰に評価されたかは見えません。
「キャリブレーション済み」の目安は?
私が確認したQAベンダーで、明確な合格ラインを公表しているところはありませんでした。代わりに、この分野の実務家が使っている目安を挙げます。
| 情報源 | キャリブレーションの目標 | 何と比較するか |
|---|---|---|
| Zendeskのキャリブレーションガイド | 差は「usually falls around 5 percent」 | セッション中に決めた基準 |
| r/callcentresのu/mattemer | 3%以内、一部の項目は100% | グループで合意したスコア |
| MaestroQA | 採点者ごとの整合スコア、固定のしきい値なし | 最終キャリブレーターのスコア |
| Scorebuddy | 一致した回答の割合とAvg Variation | 再採点される元のスコア |
| Zendesk QA AutoQA | 精度75%超が「高い一致」 | 人間のレビュアーのスコア |
私の考えはこうです。合計スコアで全レビュアーが基準から約5ポイント以内に収まり、5段階評価で差が2点以上になるカテゴリがないことを目指します。そのうえで、上のr/callcentresの引用にあるルールを加えます。一部の項目は100%でなければなりません。本人確認の漏れや返金額の誤りは、好みの問題ではありません。これらはスコアカードで重要項目または自動不合格項目に設定し(スコアカードの基準のガイドでZendesk QAでのやり方を紹介しています)、部分点にまで「キャリブレーション」されることがないようにします。
合計スコアにも注意してください。2人のレビュアーが同じ総合80%に着地しても、内訳の3つのカテゴリで食い違い、片方が高いところをもう片方が低くつけていることがあります。総合スコアだけでなく、必ずカテゴリごとに比較してください。
どのくらいの頻度でキャリブレーションすべきか?
正直な答えは、「今よりも頻繁に」です。ベンダーや実務家の提案は次のとおりです。
- 新しいQAプログラムや新しいスコアカード:MaestroQAのガイドによると、チームは「as frequently as once a week」キャリブレーションし、整合性が高まったら月1回に移り、新しいルーブリックを始めるときにまた頻度を上げるとのことです。
- 安定運用時:Zendeskのガイドでは、多くのチームには月1回のセッションが合い、「the more reviewers you have, the more often you should calibrate.」とされています。
- **大規模なQAチーム:**r/callcentresの元QAマネージャーは、担当者1人あたり月5件の監査と並行して、「a weekly calibration call so that everyone was on the same page」を行っていました。
r/talesfromcallcentersのある1人体制のQAアナリストは、レビュアー自身が採点される側になる裏面を書いていました。
"I was the lone QA agent for a call center of 55-70 people. We had a calibration session each week which involved the call center manager, the management staff, and myself. They chose ten calls that I had evaluated to listen to and score... I was held to a 95% accuracy rating which compared to the average of their call scores."
カレンダーにはないきっかけも1つ加えたいと思います。「正しい」の意味が変わることがあったら、その後にキャリブレーションしてください。価格の変更、新しい返品ポリシー、新しいエスカレーション経路などです。変更を知っているレビュアーと知らないレビュアーがいるため、このタイミングでずれがいちばん速く広がります。新しいレビュアーが加わったときもセッションを行う価値があります。エージェントの立ち上がり期間を実例で短縮するのと同じで、その人のスコアが誰かのサポートKPIに反映される前に行います。
QAキャリブレーション機能の比較
専用のQAツールの多くには、何らかのキャリブレーション機能があります。違いは、採点がブラインドかどうか、「正解」を何と比べるか、そして後から何が見えるかです。
| ツール | 機能 | ブラインド採点 | 比較対象 | エージェントに見えるか |
|---|---|---|---|---|
| Zendesk QA | キャリブレーションセッション、Reviewer QA | ロールごとに設定可能 | マネージャーが設定した基準レビュー | いいえ |
| MaestroQA(現Rippit) | Team Calibration、Grade-the-Grader | あり。採点者は自分のスコアと最終スコアのみ表示 | 最終キャリブレーター、整合スコア | 記載なし |
| Scorebuddy | キャリブレーションリスト | 記載なし | 再採点される元のスコア | リストごとに切り替え可能 |
| evaluagent | キャリブレーションセッション、Check-the-Checker | あり。"blind evaluate" | 合意された"calibrated outcome" | 記載なし |
| Playvox (NICE) | キャリブレーション | 記載なし | "Expert opinions" | 記載なし |
| Level AI | キャリブレーション | 記載なし | 監査担当者のベンチマーク | 記載なし |
選ぶ前に知っておきたい点がいくつかあります。
Zendesk QAには、QAまたはWorkforce Engagement Managementのアドオンが必要です。すべてのSuiteプランで、Quality Assuranceは「Requires QA add-on」と記載されており、Workforce Engagement Bundleは1エージェントあたり月額50ドル(年払い)と記載されています。キャリブレーションは、それに加えて上位プランに限定されているわけではありません。1つ知っておくべき制限があります。キャリブレーションダッシュボードは会話とそのレビューを一覧表示し、設定記事への顧客コメントによると、データは「can only be downloaded conversation by conversation.」です。多数のセッションにわたるレビュアーの推移を見たいなら、スプレッドシートに集めるか、Reviewer QAダッシュボードを活用してください。
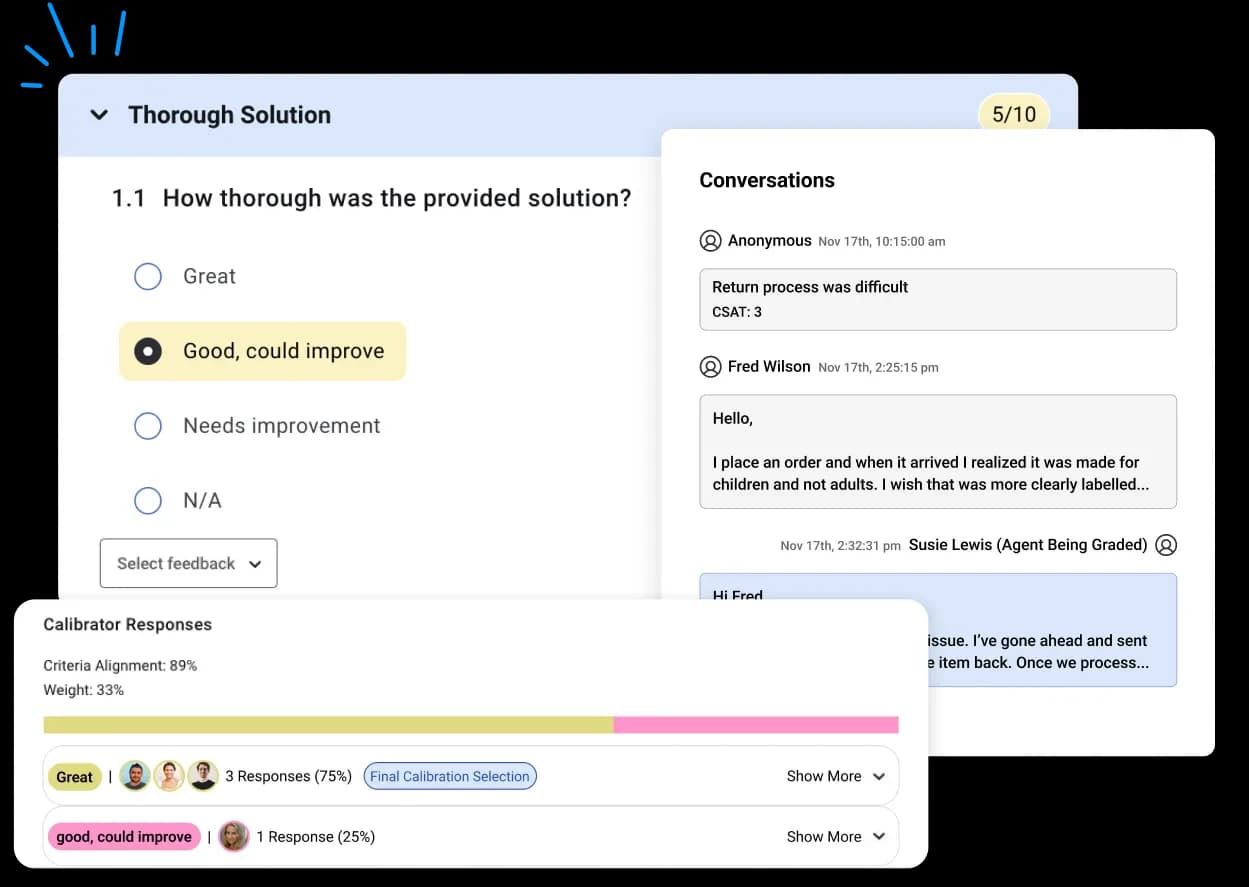
MaestroQAは、現在Rippitにブランド変更されており、2つの作業を分けています。ライブのチームキャリブレーションと、他の人がすでに採点したチケットを基準となる採点者がブラインドで再採点するGrade-the-Graderです。キャリブレーションビューでは、各キャリブレーターが各質問にどう答えたかが、「Criteria Alignment」のパーセンテージとともに表示されます。
Scorebuddyは、すでに採点された結果からキャリブレーションを作ります。結果をキャリブレーションリストに追加し、外部ユーザーを含むユーザーに割り当てるため、サポートの一部をBPOパートナーに外部委託している場合に便利です。用語集ではAvg Variationを「the average of all differences between a set of Calibration's numerical scores, and the numerical scores of the original Scores.」と定義しています。キャリブレーションモジュールは入門のFoundationプランに含まれますが、価格は「Request a price.」となっています。
ヘルプデスク内でQAを運用している場合は、実際に何をカバーしているか確認してください。比較検討中の方のために、より長いAI QAツールのリストも用意しています。Gorgiasは会話を自動採点するAuto QAを提供していますが、ドキュメントの中に人間のレビュアー向けキャリブレーションのワークフローは見つかりませんでした。私が調べた範囲では、FreshdeskとFrontも同様です。お使いのヘルプデスクにない場合は、ステップ3の表を使った共有スプレッドシートで、3〜5人のレビュアーのチームなら十分対応できます。
AI採点者とAIエージェントのキャリブレーション
会話の100%をAIに採点させ、人間はサンプルをレビューするチームが増えています。それでもキャリブレーションが不要になるわけではありません。キャリブレーションすべきレビュアーが1人増えるだけで、しかもそれは最も多くのチケットをレビューする存在です。
Zendesk QAはこれを直接測定します。AutoQAダッシュボードにはAccuracy scoreがあり、「measures the consistency and level of agreement between ratings generated by AutoQA and those provided by human reviewers」とされ、75%超が高い一致とみなされます。また、人間が少なくとも1つのカテゴリでAIのスコアを変更したModified AutoQA conversationsも追跡します。そのリストがAIのキャリブレーションの議題になり、盲信せずにAIでサポートQAを行うための最速の方法です。人間が同じカテゴリを何度も覆すなら、AI採点者とルーブリックが食い違っており、どちらかを直す必要があります。AutoQAのスコアはエージェントのIQSにも含まれないため、AIが勝手にエージェントのスコアを動かすこともありません。
誰もやっていないと、エージェントはそれを感じます。
"My company uses AI to score calls, too. You can have a great call, but if it doesn't pick up on certain keywords you get a lousy score for it"
AI採点者は、チームに加わった新しいレビュアーとして扱います。AutoQAが採点した会話を数件キャリブレーションセッションに入れ、AIと並行してブラインドで採点し、どこに着地するかを確認します。このセットアップの残りはAIサポートQAのガイドで扱っており、AIはサポートQAをできるのかでは、まだ足りない点を率直に述べています。
エージェントがAIの場合も同じ理屈が当てはまります。AIエージェントがチケットに回答するなら、始める前にその返信をどう採点するかをレビュアー間でそろえておかないと、先ほどの88%対12%の問題が起きます。チームがAI解決率をめぐって議論するときに見られるのと同じ差です。あるレビュアーは答えが正しいから合格とし、別のレビュアーは3段落も長すぎるから不合格とします。先に基準をそろえ、それから採点してください。AI向けに文書化したブランドボイスがあると、トーンのカテゴリのキャリブレーションがずっと楽になります。ボットの会話の採点方法は、Zendesk QAでのAIエージェントの記事で解説しています。
QAキャリブレーションのよくある間違い
- **同じ部屋で一緒に採点する。**測りに来たもの、つまり元の意見の違いが失われます。必ず先にブラインドで採点してください。
- **簡単なチケットだけキャリブレーションする。**毎回のセッションが合意で終わるなら、選んでいる会話が間違っています。
- **平均を答えとして扱う。**3人が4点と言っても、4点が正しいとは限りません。決定の責任者が必要です。
- **書面でのフォローアップがない。**決定事項がスコアカードのガイドに反映されなければ、来月も同じ議論になります。
- **合計スコアだけを比べる。**2人のレビュアーが両方80%をつけても、カテゴリの半分で意見が食い違っていることがあります。
- **AI採点者をキャリブレーションしない。**AIはチームの誰よりも多くのチケットをレビューします。セッションに席が必要です。
- **エージェントの異議を使わずに行う。**異議が出たレビューは、無料のキャリブレーション素材です。Zendesk QAの異議ダッシュボードには、「shows which reviewers may need additional help with consistency and accuracy.」とされる"Disputed reviewers"テーブルまであります。会話を選ぶときに活用してください。異議がエージェントにどう戻るかは、Zendesk QAのエージェントフィードバックの記事をご覧ください。
QAチームが信頼できるAI返信をeeselで
サポートキューにAIを導入するなら、キャリブレーションの問いは初日から出てきます。AIが書いたものを、レビュアーはどう採点するのでしょうか。eeselのAIヘルプデスクチームメイトは、既存のZendesk、Freshdesk、Gorgias、Help Scoutのキューに参加し、公開前にチームがそれを解決できるようにします。実際の過去チケットを再生するので、レビュアーはエージェントが実際に送った返信と比べながら回答を採点できます。最初は内部メモの下書きとして始まり、実行のたびに返信の根拠となった情報源と推論が表示されます。レビュアーが修正すると、その修正は継続的なインストラクションになり、同じ判断が今後のすべてのチケットに適用されます。100クレジットで無料で試せ、有料プランはeeselの料金ページで月額299ドルからです。
