

カスタマーサポートのエラー分析とは?
カスタマーサポートのエラー分析は、間違った、あるいは弱いサポート返信を繰り返し見直す取り組みです。各失敗に根本原因のラベルを付け、ラベルを数え、最も多い原因をその発生源で直します。返信がエージェント、マクロ、AIエージェントのどれから出たものでも、同じように機能します。
この用語は機械学習に由来し、そこでは多くの人が飛ばしてしまうステップです。Hacker Newsのコメント投稿者が10年以上前にこう率直に述べています。
"3) Do error analysis/run diagnostics. Go to 1. It is the last step I find inexperienced people usually lacking. You need to examine your errors and find commonalities among them."

考え方はそれだけです。間違った返信が1件なら逸話です。間違った返信40件をグループに分ければ、やることリストになります。
サポートQAと混同しやすいので、私は次のように区別しています。
| サポートQA | エラー分析 | |
|---|---|---|
| 答える問い | このエージェントの返信はどれだけ良かったか? | 返信はなぜ、どこで間違うのか? |
| レビューの単位 | 1人のエージェント、1枚のスコアカード | 1件の失敗、1つの根本原因 |
| サンプル | ランダムまたは割り当てられたチケット | すでにうまくいかなかったチケット(再オープン、低いCSAT、エスカレーション、却下された下書き) |
| 成果物 | スコアとコーチングメモ | それぞれに担当者がいる、順位付けされた原因のリスト |
| 誰が直すか | エージェント | 原因の担当者:KBライター、ポリシー責任者、AI管理者、プロダクトチーム |
QAは今も重要です。エラー分析は、QAが見つけた失敗を繰り返させないために行うことです。私はeeselでAIエージェントを作っていますが、どの導入でも最も役に立つ1時間は、誰かが失敗したチケット50件を読み、それぞれがなぜ失敗したかを書き留める時間です。
サポートのエラーの大半がエージェントのせいではない理由
顧客が間違った回答を受け取ると、誰が送ったのかを探したくなります。しかし、エージェントが自分たちのミスについて語ることを読むと、すぐにパターンが見えてきます。エージェントは間違った情報で仕事をしていたのです。
"Yes..and they're always outdated never load.. and if you have questions the supervisor will always refer you back there and give you a bad review saying you must not have checked it."

ポリシー変更は典型例です。更新はメールやチャットチャンネルで届き、ナレッジベースの記事は変わりません。
"Emails get buried so fast man I swear I will find a important update like 3 days later after already giving wrong info to 10 customers. The knowledge base is good when they actually update it but half the time someone forgot to change the article"
間違った回答が1つで、顧客が10人。そのエージェントをコーチングしても何も直りません。次のエージェントも同じ古い記事を読むからです。別のスレッドでは、あるエージェントが割引の質問で助けを求めた経緯を述べています。上司は月30ドルと言い、同僚の1人は割引なしと言い、別の1人は半額と言い、コーチが半額だと確認するのに10分かかりました。3人いて、答えは3つ。これは不注意なエージェントではなく、信頼できる唯一の情報源がないという問題です。これを発生源で止める方法は、ポリシー変更管理のガイドで解説しています。
AIエージェントも同じように失敗します。ただし速いです。Cursorのサポートボットが、ログアウトは新しい「1デバイス」ポリシーだとユーザーに伝えたとき、Hacker NewsはこれをAIのハルシネーションの話として扱いました。Cursorの共同創業者はスレッドで本当の根本原因を説明しました。
"For context, this user's complaint was the result of a race condition that appears on very slow internet connections. The race leads to a bunch of unneeded sessions being created which crowds out the real sessions. We've rolled out a fix."
ボットにはそのバグを説明する文書がなく、もっともらしい説明で症状を説明しました。間違った回答は、誰も文書化していなかったプロダクトのバグから始まった連鎖の最後の輪でした。「AIを直す」だけでは、本当に壊れていた部分を見逃します。このパターンについては、サポートにおけるAIのハルシネーションの記事で詳しく扱っています。
そして、「エラー」がそもそもエラーではないこともあります。こちらは、そのEC試験の内訳です。エージェントはeeselの下書きをそのまま送るか、書き直すかを選べました。284件のチャットのうち、下書きが変更なしで送られたのはわずか12%で、ひどく聞こえますが、理由を見ればそうでもありません。
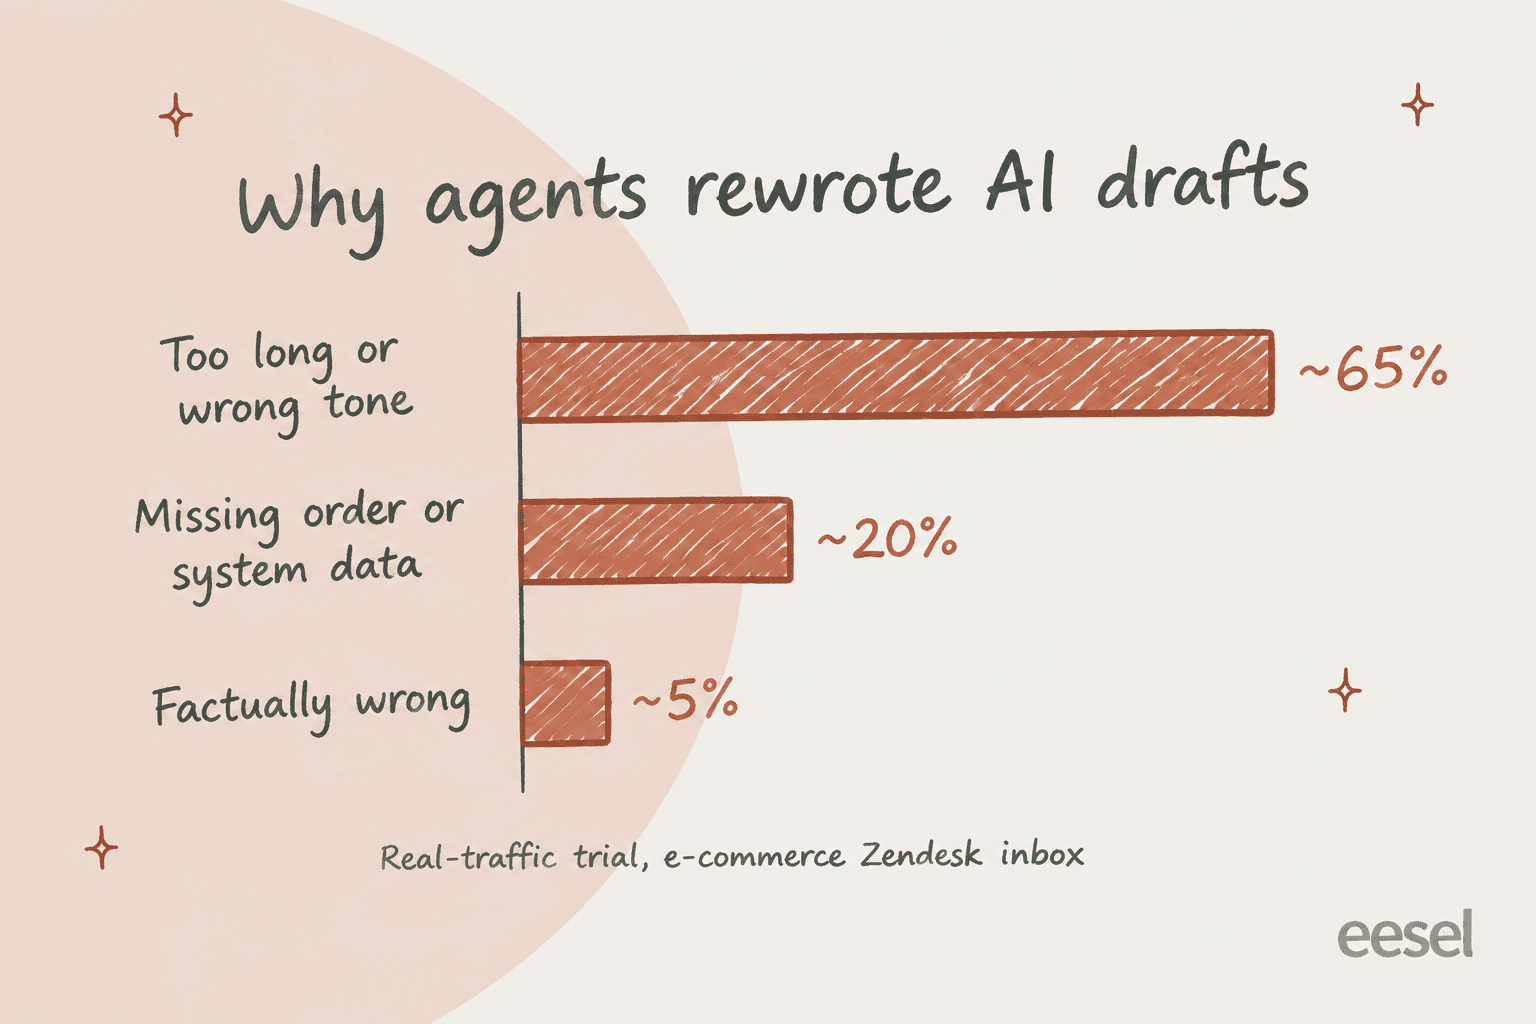
エージェントは通常、8〜15文の下書きを1〜3文の返信に直していました。書き直しの大半はスタイルの問題で、チーム自身の送信済み返信で学習させ、明確なAIのブランドボイスを整えれば解決できます。約5分の1は、まだ接続されていないシステムのデータが必要でした。「精度の問題」は、ほとんどが長さの問題とデータアクセスの問題でした。エラー分析はまさにこのためにあります。本当の解決策が「3文に収める」と「注文システムを接続する」であるときに、ヘルプ記事の書き直しに1か月を費やさずに済みます。
サポート返信が間違う6つの場所
間違った返信には必ず最初の失敗があります。コツは最初の失敗で止めることです。その後に起きることはすべて結果だからです。AIが間違った記事を拾ったなら、返信が長すぎたことは問題ではありません。
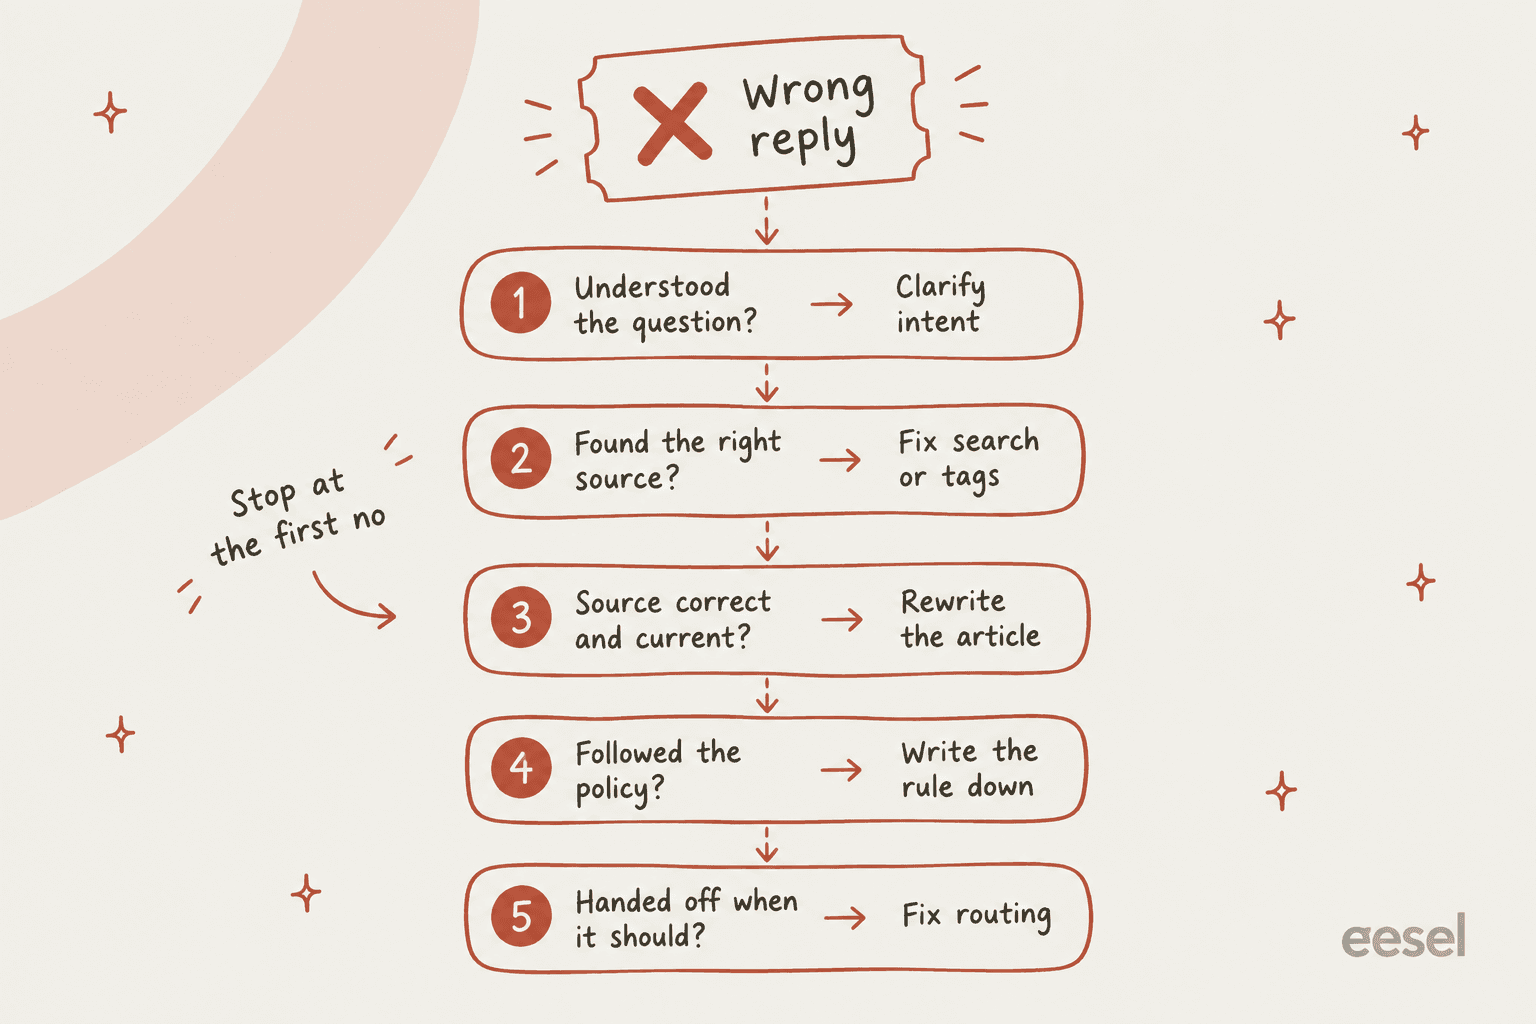
私は6つのグループを使います。上の5つのチェックポイントに、正しいのに伝わらない返信のための6つ目を加えたものです。グループを選ぶと、どう見えるか、どう見分けるか、誰が直すかが表示されます。
質問がどう読まれたかに関わるのは、最初のグループだけだという点に注目してください。グループ2から5は、知識、ルール、ルーティングに関するもので、サポートリーダーが一度変えれば全員分が直ります。だからこそエラー分析は、個人へのコーチングより早く成果が出ます。1本の記事の修正で、同じミスをすべてのエージェントとAIで同時に止められるのです。
カスタマーサポートのエラー分析を7ステップで進める方法
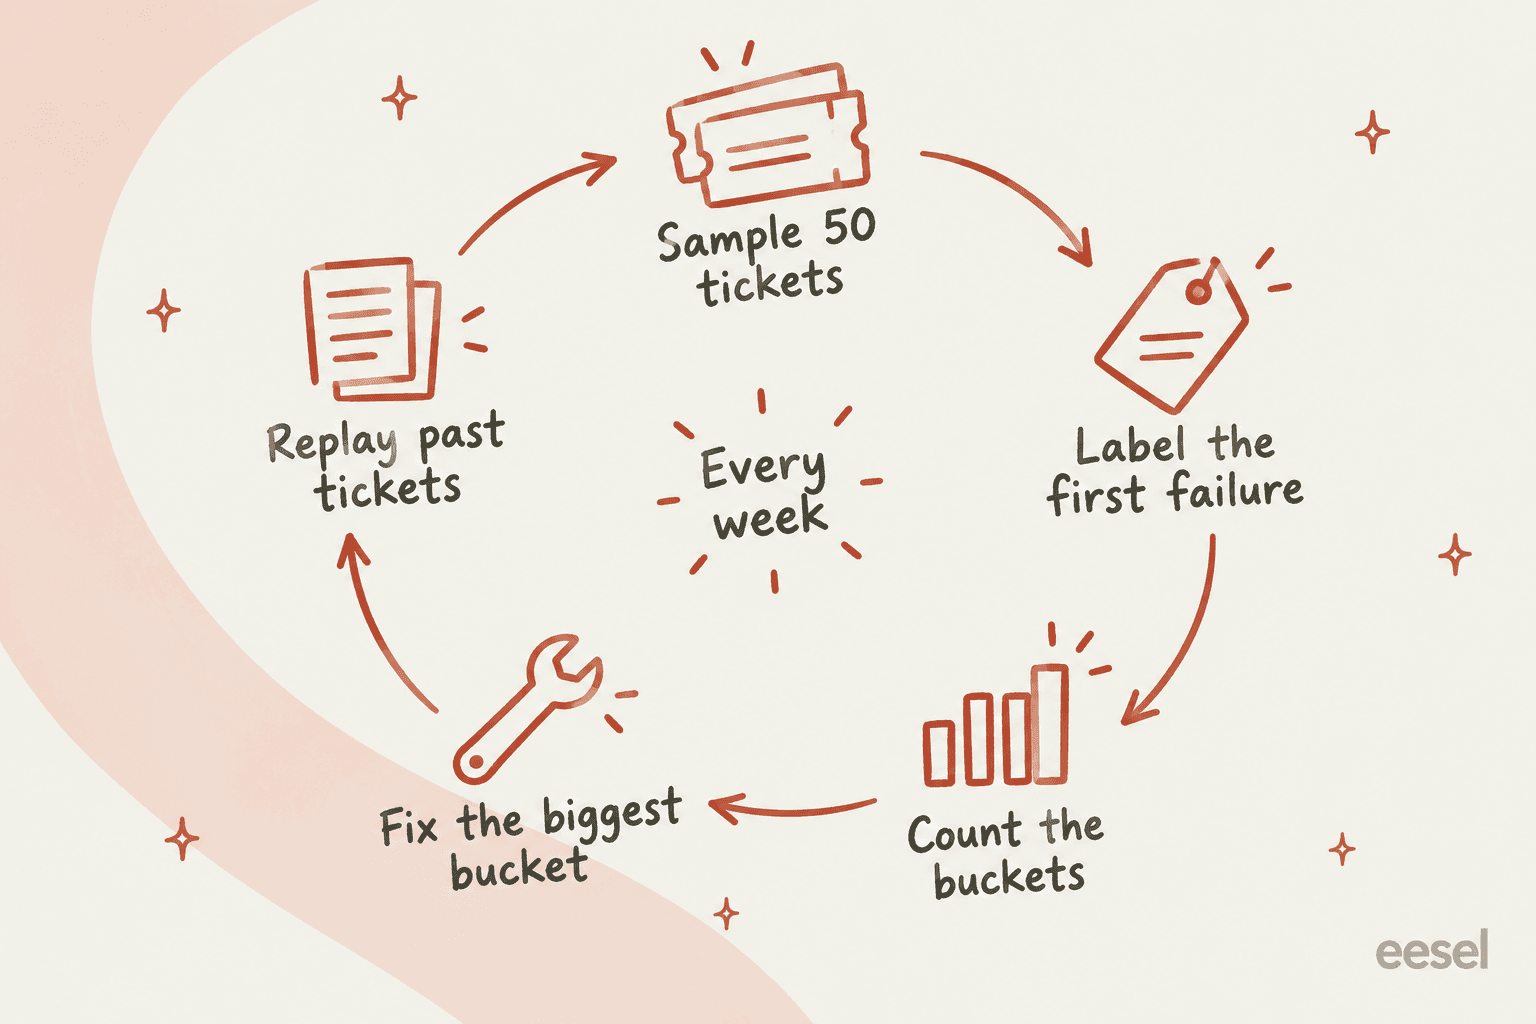
最初の1回は約2時間でできます。その後は、毎週30分の習慣になります。
- ランダムなサンプルではなく、失敗を集める。 再オープンされたチケット、低いCSAT、AIからのエスカレーション、エージェントがAI下書きを却下または書き直したチケット、数日以内の再問い合わせです。Zendesk Exploreには、このためのReopensとOne-touch ticketsの指標があり、再オープンチケットの指標のガイドで絞り込み方を示しています。
- 50件を取る。 それより少ないと、変わった1週間がすべてを歪めます。多いと、誰も終えられません。件数が少ない場合は、直近1か月のすべてを取ります。
- 1件ずつ読み、最初の失敗にラベルを付ける。 上の6つのグループを使います。チケット1件につきラベルは1つ。30秒で決められなければ「不明」とラベルを付けて先に進みます。
- グループを数える。 人の考えを変えるのはこのステップです。「AIはダメだ」が「50件中14件が同じ古い返品記事だった」に変わります。
- 最大のグループを発生源で直す。 記事を書き直し、ルールをサポートSOPに書き込み、ルーティングを変えます。各修正に担当者と期日を付けます。
- 過去のチケットを再生して修正を確認する。 同じ種類の質問をエージェントやAIにもう一度通し、回答が変わったか確かめます。来週のチケットをただ待たないでください。
- 毎週繰り返し、グループの構成を追う。 健全なプログラムでは、最上位のグループが縮小し、新しいグループがその座に就きます。
ステップ1は、多くのチームが気づかないうちにつまずくところです。分かりやすい指標が嘘をつくからです。AIが「解決した」チケットでも、失敗であることがあります。
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
HubSpot自身のドキュメントも同じことを述べています。顧客が単に離脱しただけの場合があるため、デフレクションは "do not always indicate resolution" とされています(HubSpotナレッジベース)。したがって、解決率を信頼する前に、ボットの会話を同じ顧客のフォローアップチケットと突き合わせてください。この突き合わせは、AIデフレクションの測定の記事で扱っています。
ステップ4は、最初はシンプルな集計で十分です。RedditのIT管理者が、まさにこれを述べています。同じ原因に結びつくチケットが何件あるかを数えて点をつなぎ、毎回チームに本格的な「5つのなぜ」をやらせない、という方法です。グループが安定したら、集計が自動で行われるように、ヘルプデスクにタグまたはQAの根本原因として移します。サポートチケット分析のガイドに集計シートのテンプレートがあります。
AIサポートエージェントのエラーを分析する方法
AIエージェントのエラー分析は、重要な点で人間よりも簡単です。AIは作業内容を示せるからです。何を検索し、何を見つけ、なぜその回答を選んだかが見えます。長いシフトの終わりの人間のエージェントからは、決して得られないものです。
落とし穴は、実際に読まなければならないことです。エージェントを作っているHacker Newsのコメント投稿者は、自動採点があっても手作業で行うべきだと主張しました。
"there's still a huge benefit in looking at traces yourself and labeling them. It's time-consuming, yes, but you'll learn a lot about the ways an agent fails in your particular domain, it gives you more reliable golden datasets, you have a mechanism to evaluate your judges, etc."
AIのトレースを読むときも6つのグループは当てはまりますが、証拠の見え方が異なります。
- 質問の誤解: AIが示す意図やユースケースが、顧客の質問と合っていない。
- ソースの取り違え: ソース一覧に、近いが間違った記事が表示されている。
- ソースが悪い・ない: AIは正しい記事を引用したがその記事が間違っている、または何も見つからないのに回答した。後者が危険なパターンです。検索結果が空だと、モデルは一般知識でそのすき間を埋めることがあります。ZendeskでのEV向けテレマティクスチームのeesel導入では、ヘルプセンターに「すべてのモデルに対応」とあったため、製品データベースにない車種への対応をボットが確認してしまいました。
- ポリシー未遵守: ルールはチームの頭の中にはあるが、AIの指示にはない。
- 引き継ぐべきだった: 会話が引き継ぎリストにあるトピック(またはあるべきトピック)に触れたのに、そのまま続いた。そのリストに何を入れるべきかは、AIの引き継ぎのガイドで扱っています。
経験からの警告です。いきなりモデルの入れ替えに飛びつかないでください。Simon WillisonはHNで正しい問いを投げかけました。評価なしでモデルを切り替えたら、"how will you tell if the model switch actually helped?" と。そして、モデルがそもそも問題ではないことも多いのです。別のコメント投稿者は、LLMのせいにしていたチームが、本当の原因は "upstream calls to services that produce data" だったと気づいたと指摘しました。サポートに置き換えると、注文照会が何も返さなかったので、AIが推測した、ということです。これは、上の試験の20%のグループにあたります。
AIが直接返信せずエージェント向けに下書きを作る場合、却下または書き直された下書きは、タダで手に入るエラー分析のデータです。編集をラベルとして扱ってください。その編集をフィードバックする方法は、AIサポートエージェントの学習のガイドで扱っています。
回答が間違ったとき、各ヘルプデスクで何が見えるか
主要なヘルプデスクはいずれも、AIがなぜそう答えたのかを見る手段を提供しています。何が見えるか、過去のチケットで修正をテストできるかどうかは、大きく異なります。
| ヘルプデスク | 「なぜ」が見える場所 | 回答ごとにソースを表示? | 組み込みの理由コード | 履歴で修正をテスト? | 条件 | 出典 |
|---|---|---|---|---|---|---|
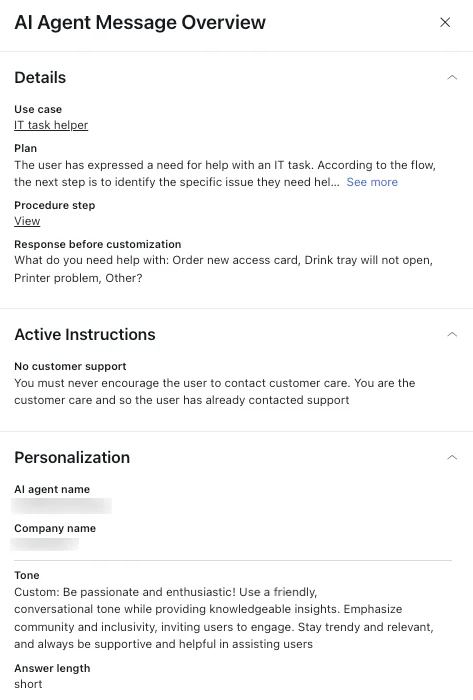
| Zendesk | 会話ログ:メッセージごとにPlan、Response before customization、有効な指示 | 会話ごと(Resources used)。単純なナレッジ回答では記事ごとではない | Unresolved、Escalation failedを含むカスタム解決;階層付きのQA根本原因 | 一括では記載なし | ログはすべてのSuiteプラン;QAにはQAまたはWEMアドオンが必要 | Zendeskドキュメント |
| Freshdesk | AI Agent Studio Analyze:Improveタブ、Knowledge usage、Ticket logs | テストではAnswer Source;ソースごとの回答数とフィードバック数 | Improveの種類:New content、Edit content | Testタブ:入力または生成したクエリ最大100件 | Growth、Pro、Enterprise | Freshdeskドキュメント |
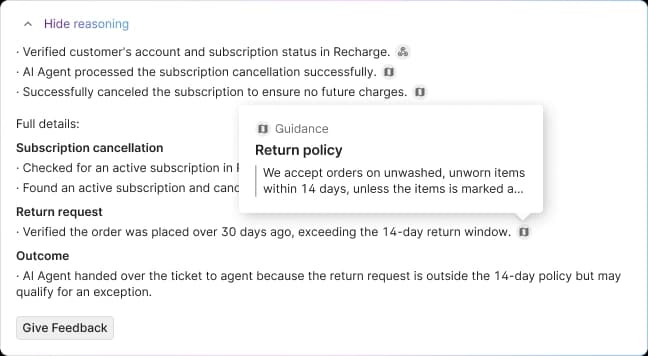
| Gorgias | 各AIメッセージの下のShow reasoning;AI Feedbackタブ | はい、ソースごとに高評価・低評価 | 「What went wrong」ドロップダウン;3つの引き継ぎ理由;Opportunities:Fill knowledge gap、Resolve conflict | 既存のチケットを1件ずつ | フィードバックにはLeadまたはAdminが必要 | Gorgiasドキュメント |
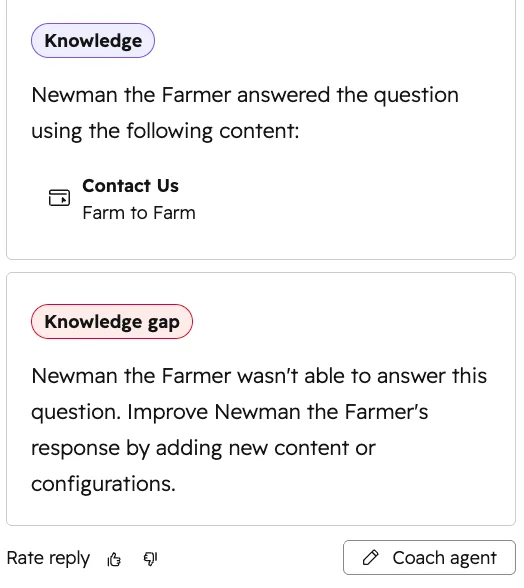
| HubSpot | Coaching opportunities;Help Deskのagent insights | はい、返信ごとにナレッジソースを引用 | Reason:Knowledge、Handoff、Experience、Action、Other | 記載なし | ProまたはEnterpriseに加えてHubSpot Credits | HubSpotドキュメント |
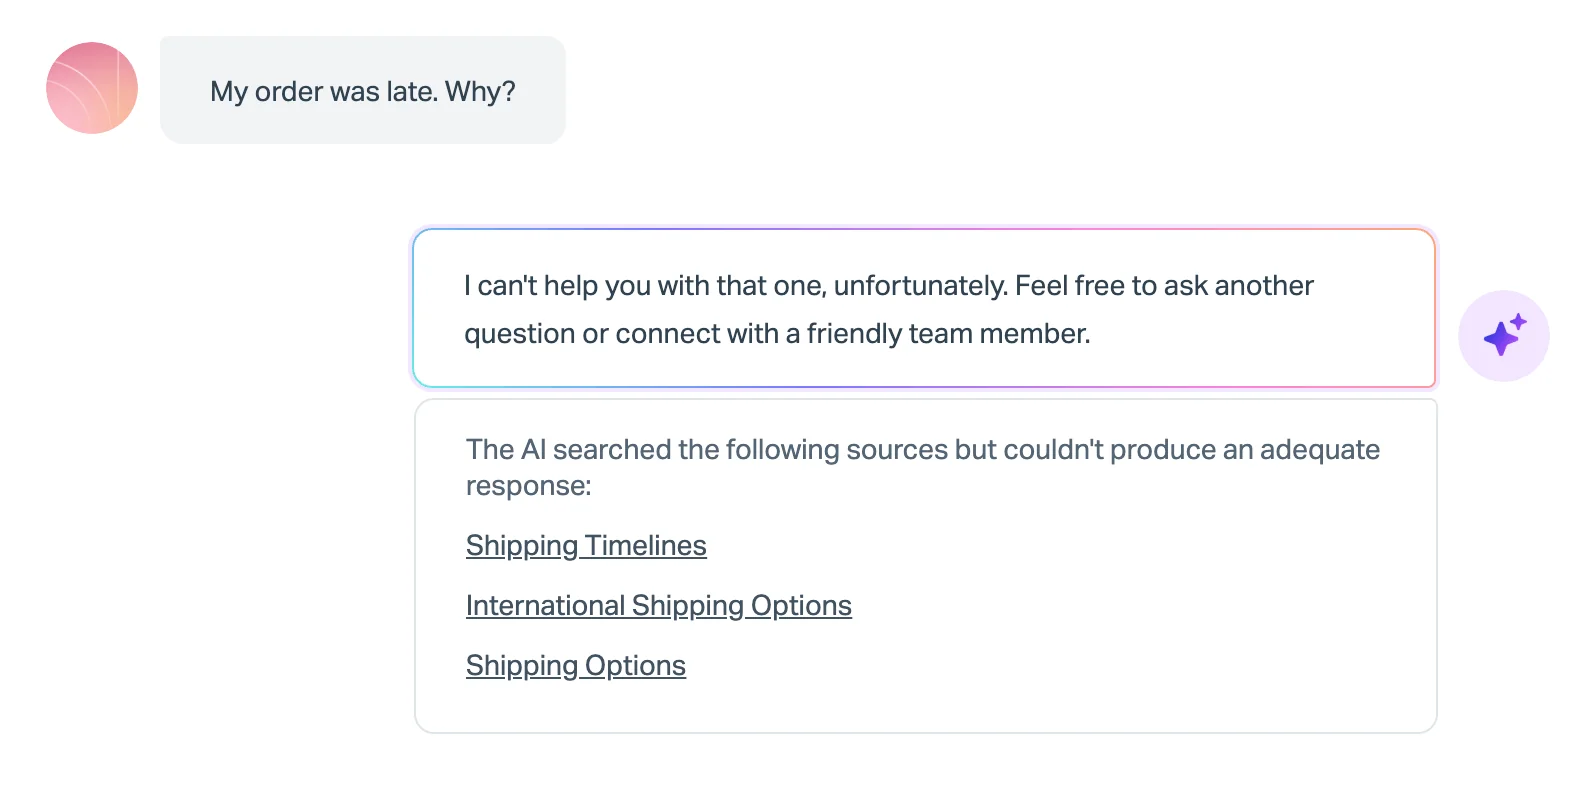
| Help Scout | Beacon Sessionsタブ、Improvements | AIが失敗または確認を求めたときのみ(Attempted Sources) | Contact helped、Contact not helped、Human escalation | 記載なし | すべての有料プラン、AI解決1件あたり$0.75 | Help Scoutドキュメント |
| Front | AI repliesハブ | はい、各ソースから取り出した正確な抜粋付き | AIの引き継ぎについては記載なし | 既存の会話を1件ずつ | CopilotまたはAutopilotアドオン;Smart QA $20/seat/month | Frontドキュメント |
すべての機能と条件は、2026年10月に各ベンダーの公式ドキュメントで確認しました。
Zendeskのメッセージ単位の表示は、生成型プロシージャについて最も詳細です。Planフィールドには、AIの推論が表示され、Response before customizationには、ペルソナや指示が適用される前のテキストが表示されるので、悪い返信が推論から来たのか、トーン設定から来たのかが分かります。
Gorgiasは推論をどの役割の人にも読める形にしており、これは思う以上に重要です。AIがなぜ引き継いだか、あるいは回答したかをエージェントが見られれば、単なる「ボットが間違った」ではなく原因を報告できます。
HubSpotは、各AI返信に、使ったものを示すか、ナレッジギャップとしてフラグを付けます。このラベルは、基本的にグループ3があらかじめ済んでいるようなものです。
Help ScoutはAIが失敗したときだけソースを表示しますが、エラー分析ではまさにそのときにソースが必要です。配送記事を3本検索しても「注文が遅れているのはなぜ?」に答えられなかった返信は、悪いモデルではなく、記事の欠落を指しています。
FreshdeskのKnowledge usageテーブルは、グループ2に最適な組み込みビューです。ボットの回答で各ソースが何回使われたかを、高評価・低評価のフィードバックと並べて数えます。Freshdesk自身の指針では、頻繁に引用され、高評価に対する低評価の比率が高いソースが、コンテンツ見直しの最優先ターゲットです。
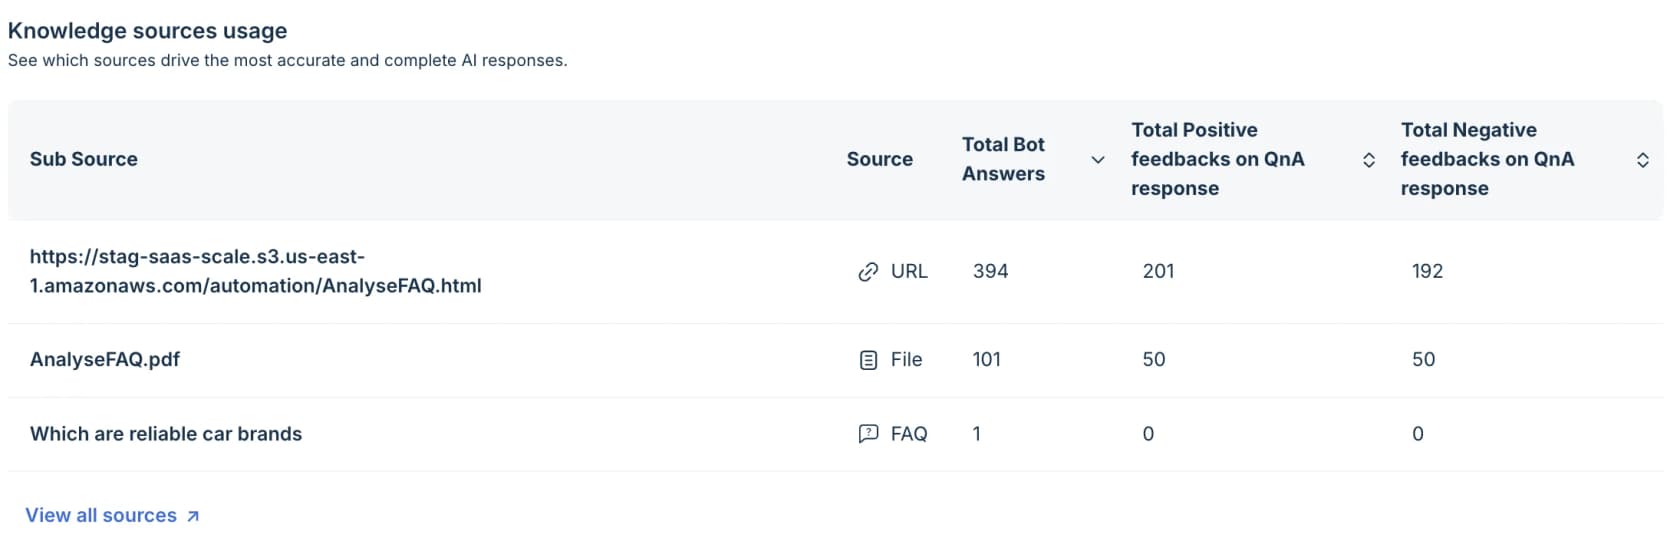
どれかに頼る前に、知っておくべきことが2つあります。1つ目に、FreshdeskのRoot Cause Analysisは名前に反して、個々の間違った回答ではなく、チケット量の急増をツリーマップで説明するもので、Enterprise限定です。2つ目に、「修正をテスト」の列は、全体を通じて弱点です。GorgiasとFrontは既存のチケットを1件ずつ再実行でき、Freshdeskは入力または生成した質問をテストします。スポットチェックには役立ちますが、先週の修正が実際の50件のチケットでエラー率を動かしたかどうかは分かりません。
数えられるように根本原因を記録する場所
トレースを読めば原因は見つかります。数えるには、原因をレポートできる場所に保存しておく必要があります。以下は私が見つけた、最良の組み込みの場所です。
Zendesk QAの根本原因。 レビュアーは、カテゴリを採点するときに任意で根本原因を追加できます。自分で定義したリストから選び、階層とサブ階層で整理され、ダッシュボードで集計できます。低評価向けに作られており、まさにエラー分析のサンプルです。QAまたはWEMアドオンが必要です。設定方法は、Zendesk QAの概要とスコアカード基準のガイドで解説しています。
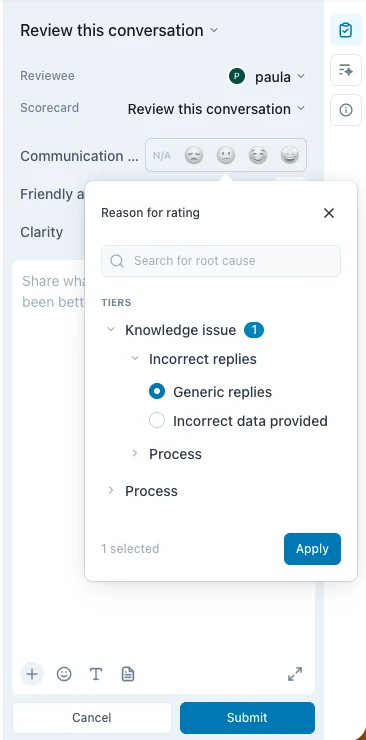
私なら、6つのグループに対応する階層を作り、最も多いケースにサブ階層を付けます(「ソースが悪い・ない > 返品」「ソースが悪い・ない > 配送」)。Zendesk QAはAIエージェントもスコアカードで採点し、エスカレーション率やボットの繰り返し率を見るBotQAダッシュボードがありますが、対応するのはZendesk Marketplaceからインストールしたボットだけです。
HubSpotのコーチング機会。 それぞれにReason(Knowledge、Handoff、Experience、Action、Other)とType(Knowledge gap、Knowledge conflict、「Flagged by Help Desk rep」など)が付きます。私が見つけた中で最も充実した組み込みの理由コードで、グループ3と5にうまく対応します。
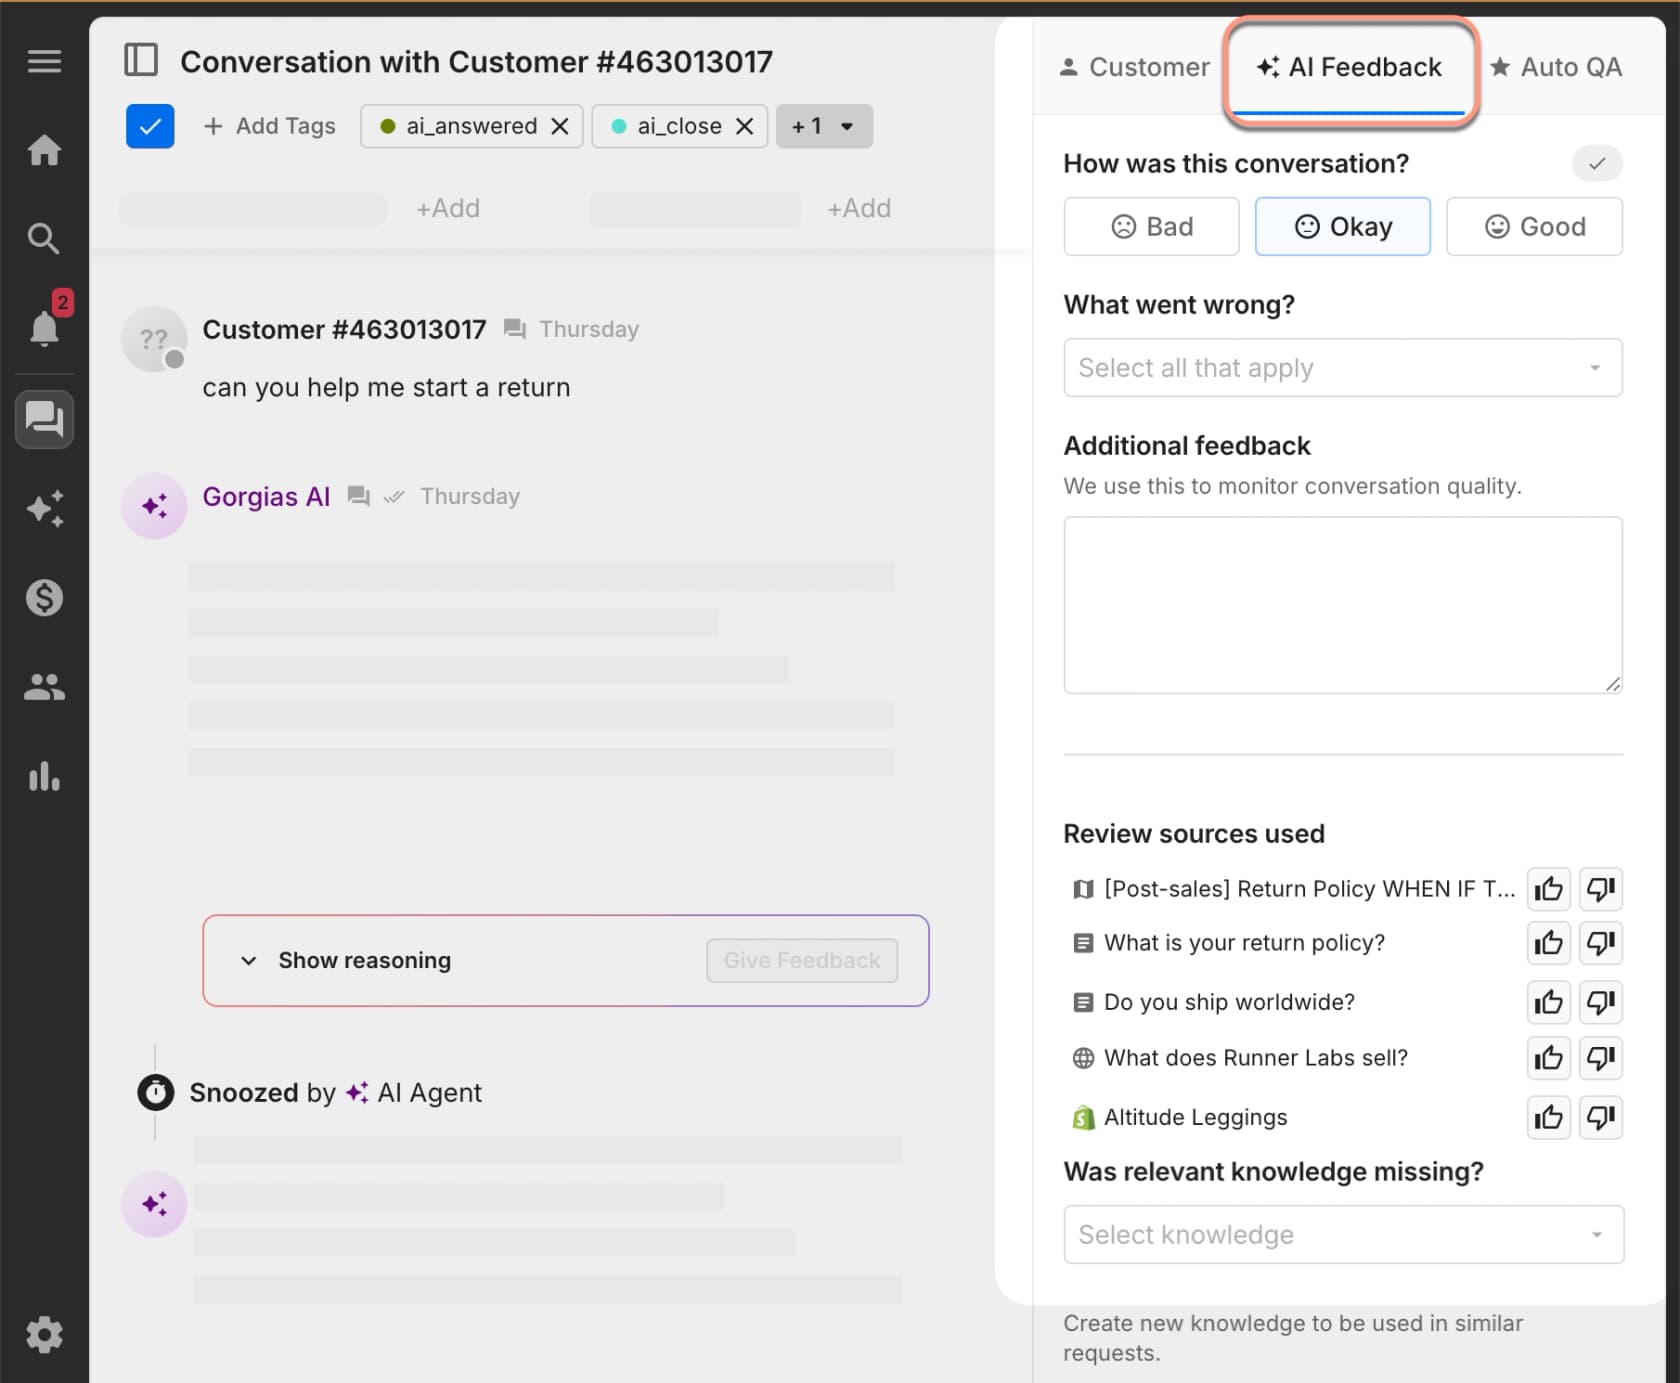
GorgiasのAI Feedback。 BadまたはOkayの評価では、リードが「What went wrong」リストから選び、個々のソースに高評価・低評価を付け、使われるべきだったナレッジを指し示せます。
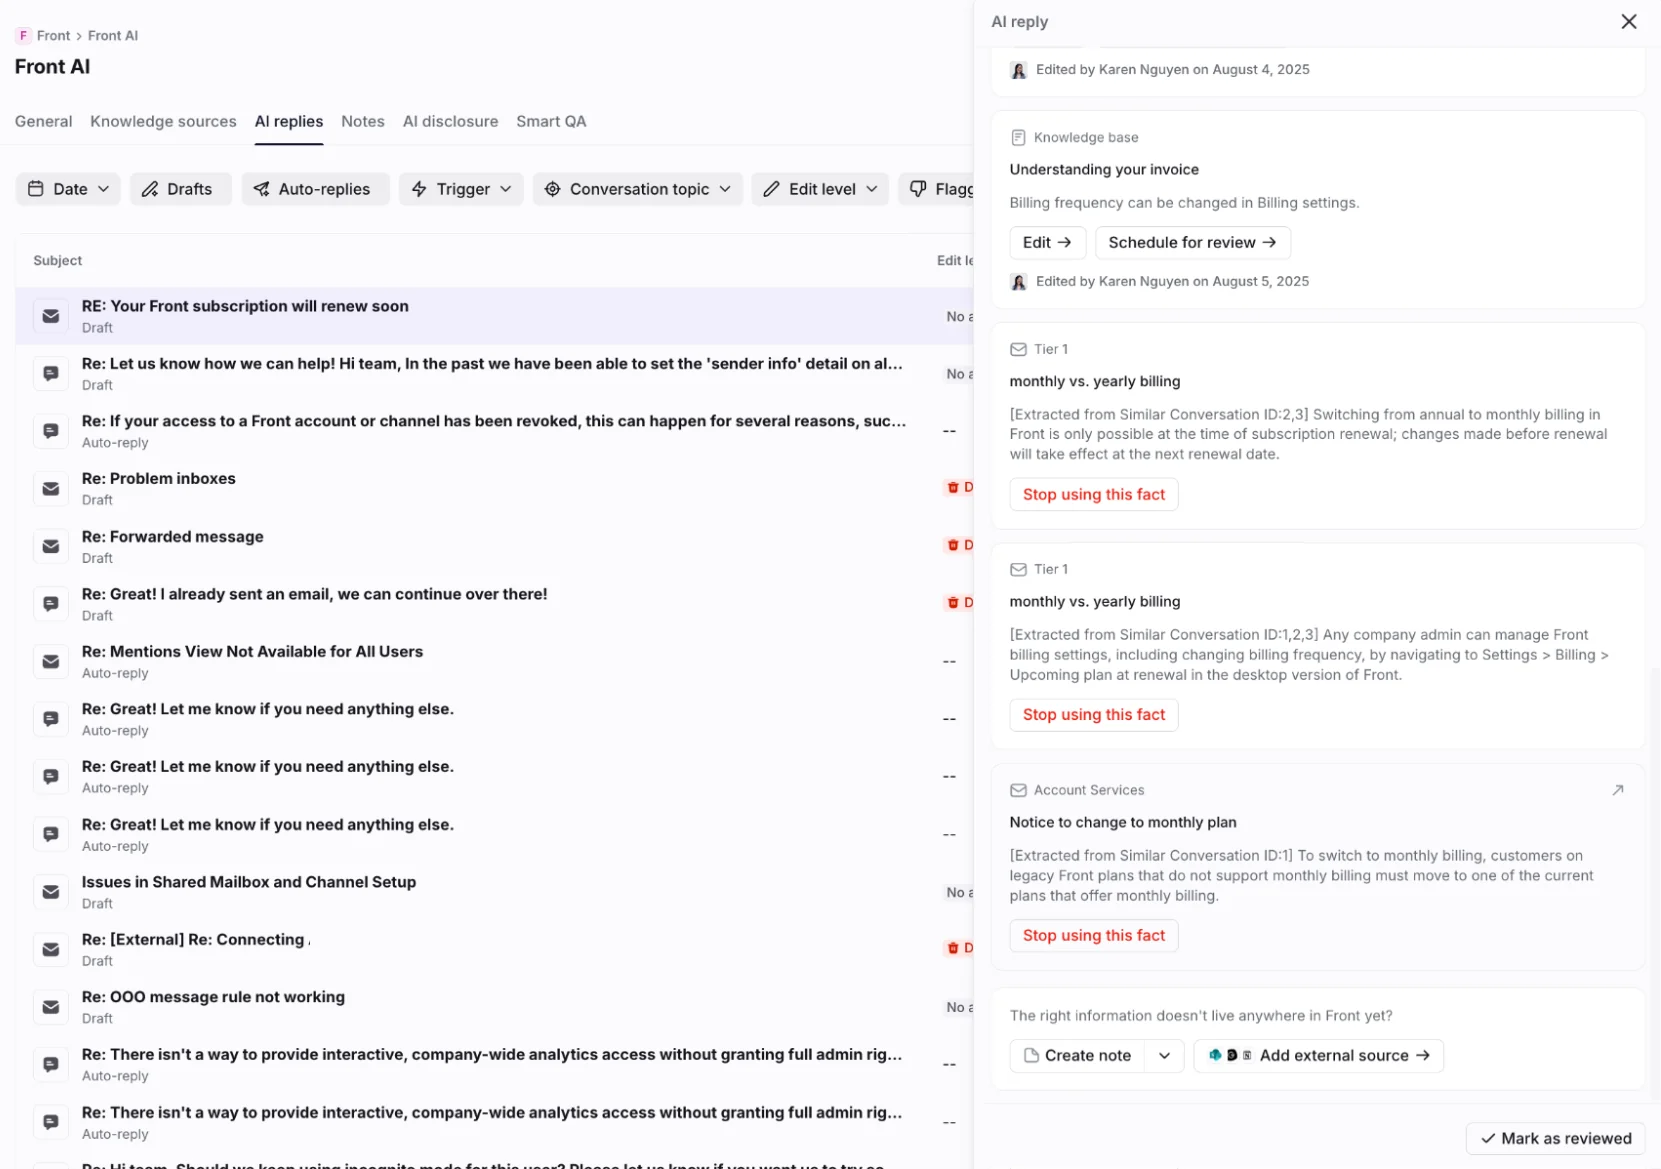
FrontのAI repliesハブ。 理由コードではありませんが、私が見た中で最速の修正ルートです。返信の背後にあるすべてのソースを正確な抜粋付きで示し、Edit、「Stop using this fact」、Create noteの操作をその場で行えます。
お使いのヘルプデスクにこれらがなければ、グループごとに1つのチケットタグで十分機能します。リストは短く保ってください。6つのタグは使われますが、30個は無視されます。エージェントのクリックを増やさずに適用する方法は、AIサポートタグ付けのガイドで示しています。
人ではなく、仕組みを直す
エラー分析は、人がエラーを報告してくれて初めて機能します。それが人を咎める手段になった瞬間に、報告は止まります。エージェントは、それがどんな気持ちかをはっきり語っています。
"Hold hands up it was something I missed (or didn't consider) but the complaint feedback was otherwise good so it stung to get a fail rather than a learning and fix it"
指標そのものが根本原因であることもあります。あるエージェントは、正しい答えの確認に3分以上かかるのに、3分を超える保留でペナルティを受けると述べました。
"If I put them on hold that long, some get annoyed or escalate. Either way, I'm doomed: penalized if you placed the caller on hold for more than 3 mins or returned back to the caller and tell them you needed more time."
目標のせいで、確認する前に答えるよう人が追い込まれるなら、間違った回答は予想どおりの結果です。「KPI」が原因として現れたら、グループのリストに加えてください。逆効果になる指標については、カスタマーサービスKPIの記事で扱っています。
これは、誰も責任を負わないという意味ではありません。私が好きな区別は、非難なきレビューについてのスレッドにあります。人は "still held to account for their decisions and actions but are not blamed for their results." です。記事を見なかったエージェントは、そのことを伝えられるべきです。間違った記事に従ったエージェントは、それを見つけたことに感謝されるべきです。
うまくやっているチームのエージェントが語る、実際の良いループはこうです。
"But where I work if an agent finds inaccurate information, requests information, or has figured something out that isn't in KB all we have to do is send a message to our supervisor and they pass it along to our head of sales, and the next day KB is updated."
翌日にはKBが更新される。それが目標です。定期的なナレッジベース監査やナレッジギャップ分析と組み合わせ、本当に個人に起因するエラーにはエージェントへのフィードバックの場を使ってください。
AIにも同じことが当てはまります。あるHNのコメント投稿者は、人間の担当者のミスについて、解雇される人ではなく "better training/docs so it doesn't happen again" が欲しいと述べました。AIも同じように扱い、人間の繰り返しのミスは、始末書ではなくコーチングに回してください。
eeselがエラー分析をどう扱うか
私はeeselでAIエージェントを作っているので、ここで私たちのものが何をして、何をしないのかを具体的に述べます。
すべてのチケットで作業内容を示します。 eeselのActivityページの各実行には、どこで起きたか、何がきっかけか、どのソースを検索したか、何をしたか、その推論のステップごとの内容、ナレッジギャップに当たったかどうかが表示されます。Zendeskでは、すべての下書きがソースを明示します。したがって、間違った回答にラベルを付けるのは、実行を1クリックで開くだけで済み、推測は要りません。

修正がルールになります。 回答が間違っていたら、チケットかチャットで何が間違っていたかを伝えると、その修正を自身の指示に書き込み、すでに該当するルールがあればそれを編集します。あるZendesk管理者は、ポリシーのグループの修正を2行で教えました:"I have a rule in CS where we do not address a cancel or refund request when there is an issue attached to it." そして次の下書きで:"This is incorrect. You have not provided troubleshooting steps yet." このルールは、そのチケットだけでなく、今後のすべてのチケットに適用されます。
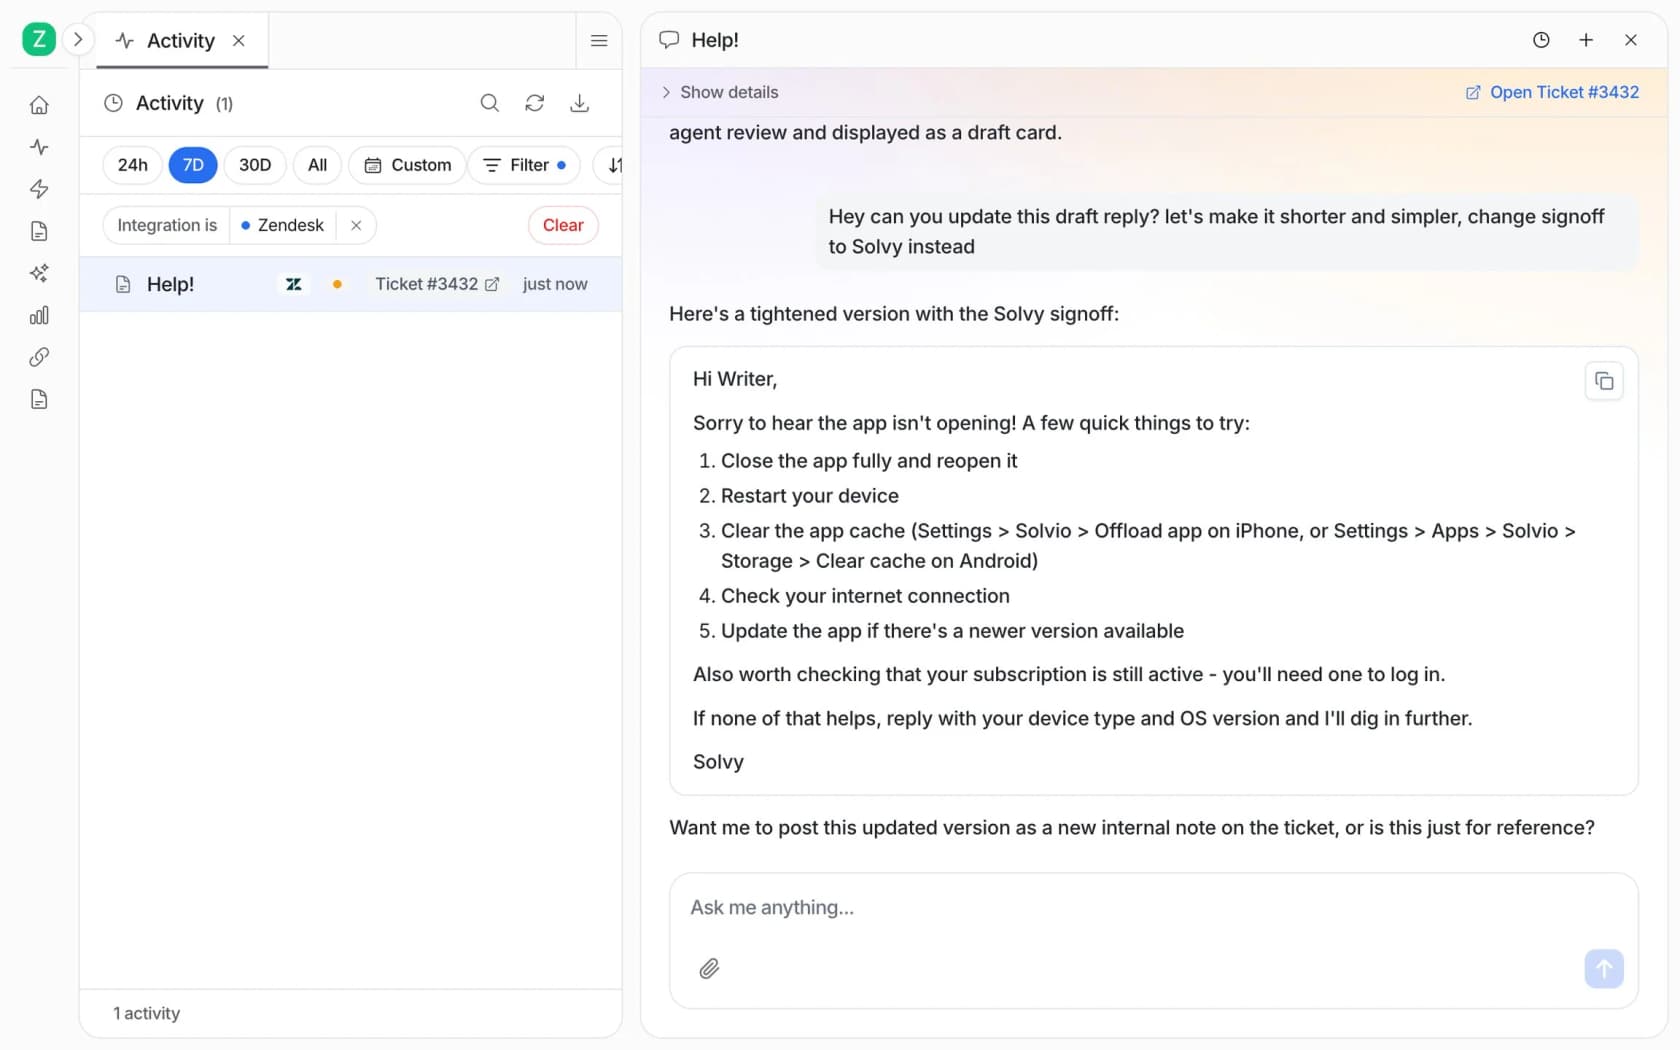
パターンを見つけてくれます。 「Analyze and improve replies」スキルは、チームが却下または編集したものを調べ、パターンを見つけ、修正を提案します。これは、上記の方法のステップ3から5を、あなた自身のデータで実行するものです。
実際の過去チケットを再生します。 シミュレーションスキルは、実際に解決済みのチケットに対してエージェントを実行し、各回答をチームが実際に送ったものと比較し、チケットのテーマごとにスコアを付け、指示の変更を提案します。ドキュメントの20チケットの実行例では、17件がチームの返信品質に並び、レポートは、本当のギャップは文面ではなく、ログの確認やエンジニアリングへのエスカレーションといったエージェントの行動にあると見つけました。
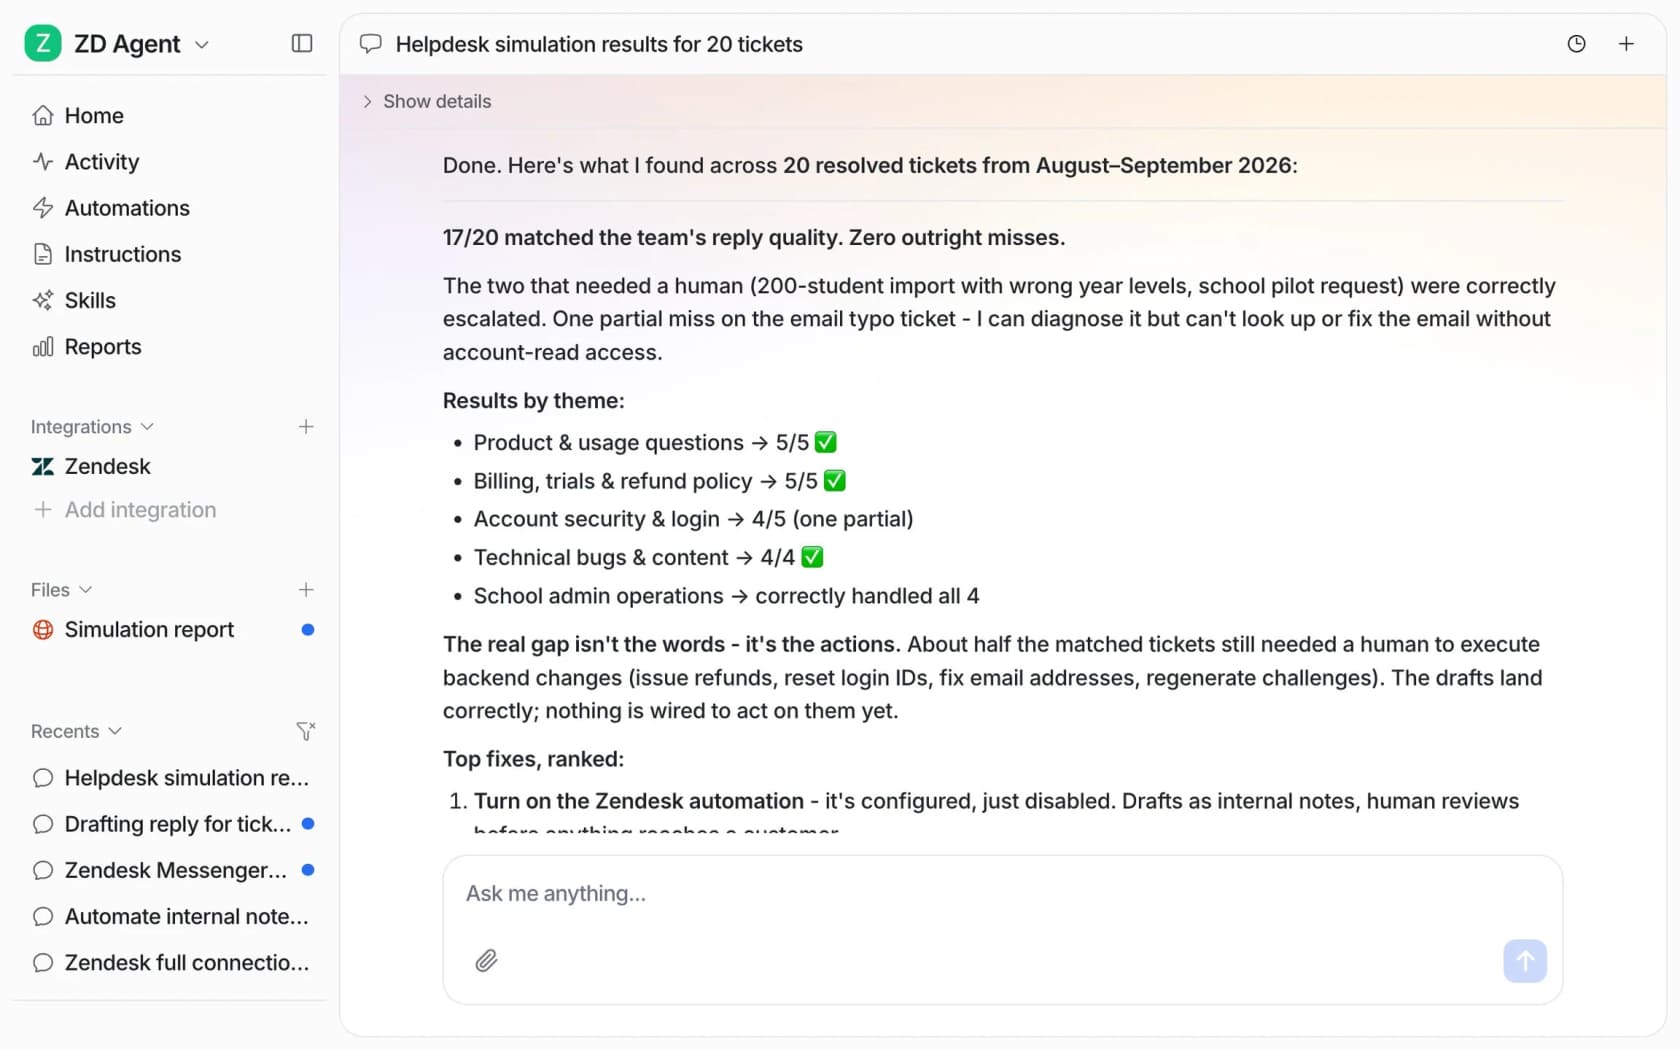
これは、私が決して省略しないステップです。顧客の目に触れる前に、修正が数十件の実際のチケットで効いたことを確認できる、私が知る唯一の方法です。また、チームがターミナルやスクリプトで作業しているなら、eesel CLIでコマンドラインからエージェントを修正し、現在のルールを出力できるので、コーディングエージェントに週次レビューを任せることもできます。
できないこと:人間のエージェント向けのQAスコアカードの代わりにはなりません。そのAI CSATは、AIによる回答の評価であって顧客のフィードバックではないので、人間のQAプログラムは並行して続けるべきだと思います。その側面は、サポートQAツールのまとめで扱っています。
eeselでエラー分析を始める
AIやチームが同じミスを繰り返しているなら、eeselのAIヘルプデスクチームメイトがエラーの履歴を1か所にまとめます。既存のZendesk、Freshdesk、Gorgias、Help Scoutのキューに参加し、すべてのチケットで何を読み、なぜそうしたかを記録し、修正を常設ルールにし、実際の過去チケットを再生するので、公開前に修正が効くのを確認できます。下書きを内部メモとして始め、先月のチケットでシミュレーションを実行すれば、その日のうちに最初のグループ集計が手に入ります。100クレジットで無料で試せ、有料プランはeeselの料金ページに記載のとおり月額$299からです。