

AIサポート会話を見直すには、すべてのエスカレーション、CSATの低い会話、再オープンされたチケット、返金やポリシーに関する会話を読み、さらに解決済みとされた会話からランダムに20〜30件読みます。「解決済み」は顧客が黙っただけという場合が多いからです。それぞれについて、回答が正しくソースに基づいているか、ポリシー、アクション、引き渡しのタイミング、トーンを確認します。次に根本原因(知識不足、指示のギャップ、誤ったアクション、引き渡しの遅れ)を分類し、その原因を修正したうえで、変更を公開する前に同じ過去のチケットを再生します。最初の週は毎日、その後は毎週見直します。eeselはすべての返信の背後にあるソースと根拠を示し、何も送信せずに解決済みチケットを再生します。
なぜ「解決済み」はAIが正しく対応したことを意味しないのか?
私はeeselのサポートキューで働いていますが、最も信用しないようにしていることの一つが、緑色の「解決済み」バッジです。AIエージェントは、流暢で丁寧だが間違った回答で会話を終えることができ、ダッシュボードの何も反応しません。顧客はあきらめるか、2日後に別のチャネルで怒って戻ってきます。
ベンダー自身がそう言っています。HubSpotは、カスタマーエージェントの会話の解決状態を設定するのは最後の訪問者の返信から72時間後で、その後の否定的なフィードバックは「解決状態を変更しない」としています。同じページははっきりと述べています。「デフレクションは必ずしも解決を示すわけではない。」Zendeskの新しい品質評価ダッシュボードは、2026年11月10日にリリースされ、理解度と共感度を評価しますが、「理解できたことは問題が解決したことを意味しない」と警告しています。デフレクションと解決のギャップについては、別の記事で取り上げています。
セルフホストのサポートボットを運用するチームから見ると、こういう形で現れます。
"just ast week a customer sent a screenshot where the bot told him accidental damage was covered under warranty and we'd repair it for free. It isn't and we don't. The doc it pulled was about the extended plan, which he doesn't have, and the bot blended the two we had to honor it ... haunting part is nothing in our logs looked obviously wrong. The answer was fluent and on topic, it was just built on the wrong chunk"

eeselも自社の導入で同じパターンを見てきました。ある試用で、B2Bの技術サポートチームは、エージェントが対応していない製品を「対応している」と顧客に伝えているのを目にしました。ヘルプ記事に文字どおり「すべてのモデルに対応しています」と書かれていたためです。エージェントが作り話をしたわけではありません。範囲が広すぎる一文を読み、それを自信を持って繰り返しただけです。この種の失敗は、人がソースと並べて会話を読んだときにしか見えません。
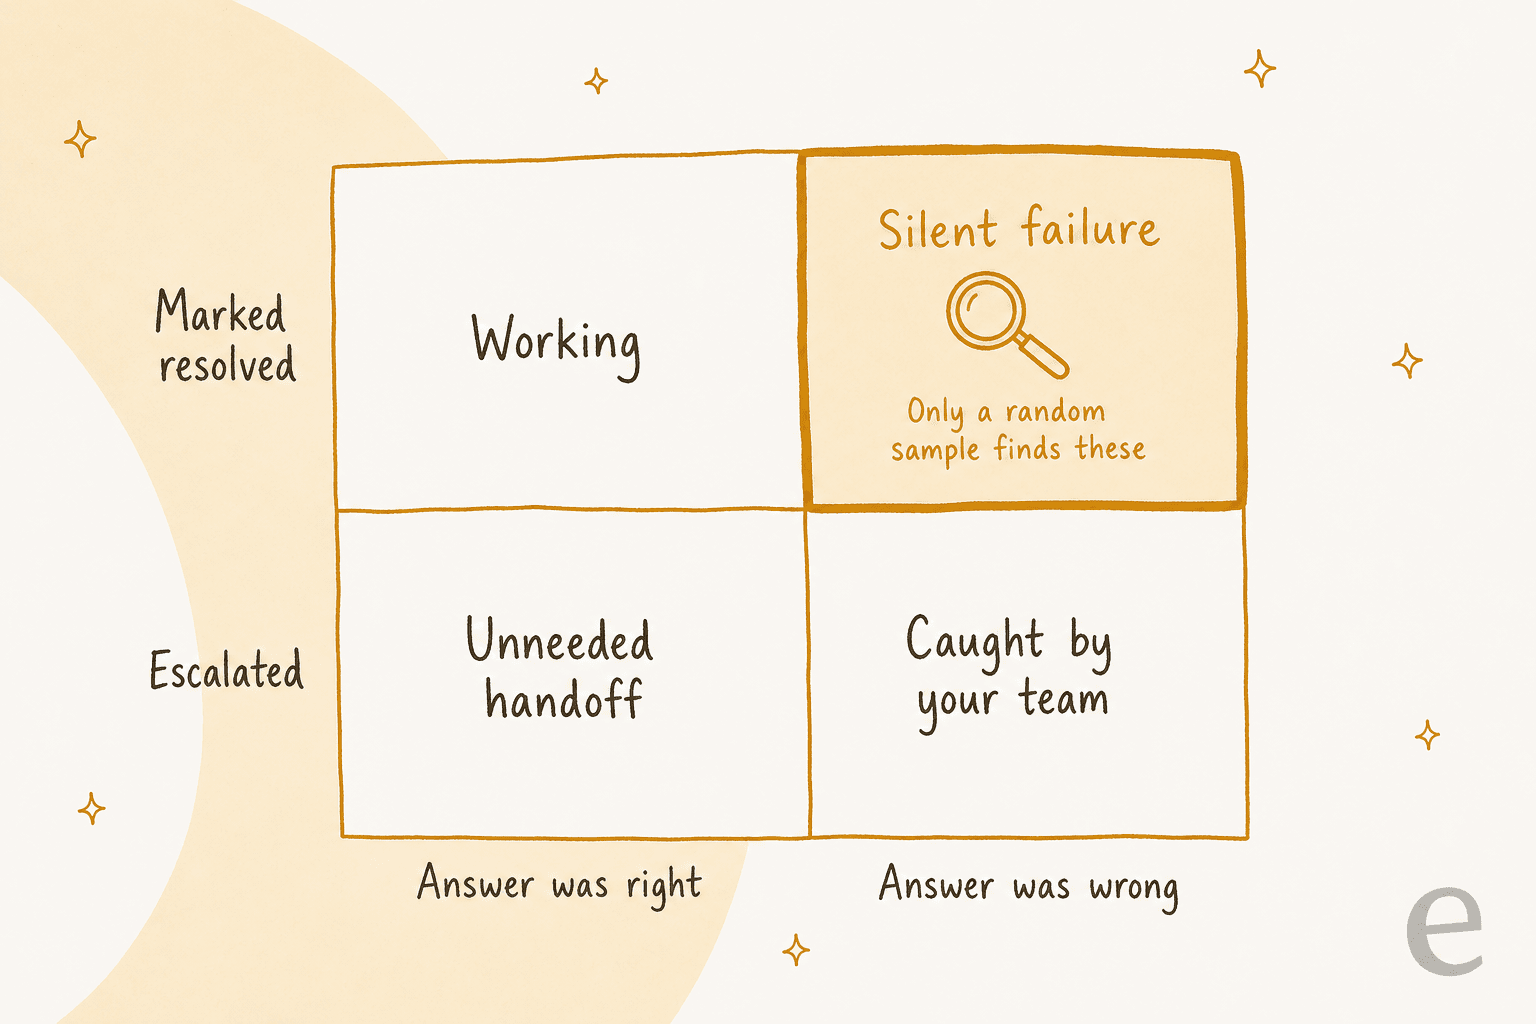
エスカレーションはどのみちチームの前に現れます。右上のマスにある静かな失敗は現れないため、下記のルーティンは問題なく見える会話にも時間の一部を使います。これは人間のエージェント向けサポートQAとは異なる作業です。人をコーチするのではなく、エージェントへのどの入力が間違っていたかを見つける作業です。
チームがコーディングエージェントを使っているなら、eesel CLIを使えばこのループに参加させられます。ルールを修正したあと、エージェントはeesel chatで修正内容を送信し、eesel instructionsで保存されたルールを読み戻し、失敗したチケットの質問をもう一度ぶつけて、顧客に何か変わる前に回答を確認できます。ヘルプデスクを最初に接続するには、管理者アクセス権を持つ人の承認が今も必要です。
どのAIサポート会話を取り上げるべきか?
すべてを読むことはできませんし、そうすべきでもありません。月あたり約7,000件のチケットを扱うサプリメントブランドのCXリーダーは、eeselの営業チームとの電話でそれをはっきり言いました。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer"
数字の面では彼女が正しいです。答えは2段構えのサンプリング計画です。リスクの高いバケットの会話はすべて読み、大きな「解決済み」バケットから少量のランダムサンプルを取ります。
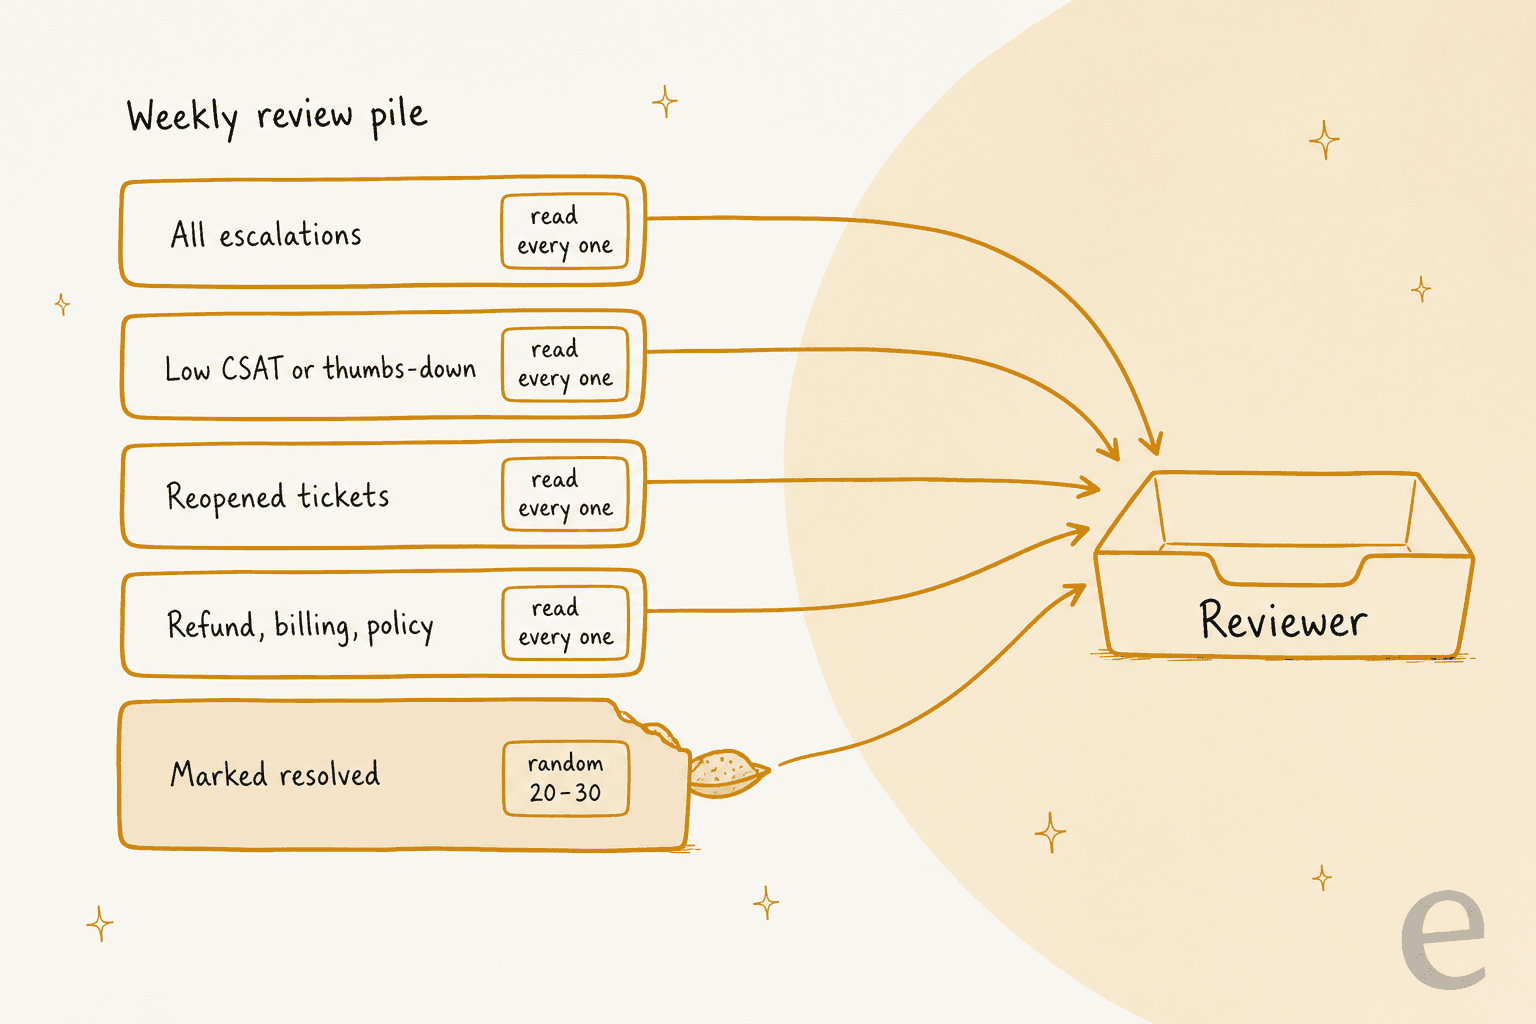
| バケット | 読む件数 | なぜ対象になるか |
|---|---|---|
| すべてのエスカレーションと引き渡し | すべて | エージェントが何をできなかったか、早すぎたか遅すぎたかが分かる |
| 低CSATまたは低評価 | すべて | チケットが閉じていても、顧客が何か問題があったと伝えている |
| 再オープンされたチケット | すべて | 回答が持続しなかった。多くは解決済みとされた誤った、または不完全な回答 |
| 返金・請求・ポリシーのトピック | 最初はすべて | ここでの誤った回答はお金や守るべき約束のコストになる |
| 「解決済み」からのランダムサンプル | 週20〜30件 | 静かな失敗を見つける唯一の方法 |
CSATについて一言:AIが生成した満足度スコアは、顧客に直接聞くことと同じではありません。eesel自身のドキュメントはReportsページで「AI CSATは顧客フィードバックではない」とし、あくまで内部的な指標として扱っています。手元にある場合は、実際のAI向けCSATの回答を使ってください。
これらをどこから取得するかはヘルプデスクによりますが、主要なものにはすでにそれぞれ専用の場所があります。
- Zendesk。 会話ログはOptimize > Monitoring > Conversation logsにあり、デフォルトで過去7日分を表示します。フィルターは上記のバケットにうまく対応します。理解できなかったメッセージ、ドロップオフ、エスカレーション失敗、BSAT、ナレッジの回答が使われたかどうかなどです。Zendeskの会話ログのガイドで詳しく扱っています。
- Freshdesk。 AI Agent Studioでは、Analyze > Ticket logsがエージェントへの引き渡しを含むステータスでフィルターでき、実際の会話とプレビューテストを分けて表示します。Freshdesk自身のアドバイスは、「2〜3件の実際の会話を読むのが最も速い方法」だとしています(Freshdeskのドキュメント)。詳しくは分析機能のガイドを参照してください。
- Gorgias。 AI Agentのチケットビューには、AI Agentが返信したすべてのチケットを集めるTo reviewセクションがあり、失敗したアクション用の
ai_failed_actionタグもあります(Gorgiasのドキュメント)。ai_answeredとai_handoverの両方がタグ付けされたチケットは、最初に読む価値があります。返信したのにそれでもエスカレーションしたということです。 - HubSpot。 カスタマーエージェントは、Analyze > Coaching opportunitiesで失敗をグループ化し、答えられなかった正確なメッセージを赤でハイライトします。
実務上のポイント:直近72時間はまだ動いています。Gorgiasは、人間への引き渡しなしで72時間が経過してから初めてそのやり取りを自動化として計上し、HubSpotも同じ72時間を待ちます。数に入れるものは、昨日ではなく先週の会話を使ってください。
それぞれの会話で何を確認すべきか?
会話ごとに6つの確認があります。慣れればほとんどは数秒で済みます。遅いのは根拠確認で、これが保証のような失敗を捕まえるものです。
| 確認項目 | 見るべきこと | 危険信号 |
|---|---|---|
| 回答が正しいか | 最も優秀なエージェントも同じことを言っただろうか? | トピックは正しいが詳細(プラン、地域、日付、金額)が間違っている |
| ソースに基づいているか | どの記事、マクロ、過去のチケットを使ったか? | ソースがない、ソースが間違っている、2つのソースが混ざっている |
| ポリシーに従っているか | 返金期間、資格、承認が必要なもの | ポリシーが許可していないことを約束した |
| アクションが正しく実行されたか | 返金、キャンセル、タグ、注文照会 | アクションが間違った注文に対して実行された、または静かに失敗した |
| 引き渡しのタイミング | いつエスカレーションしたか、引き渡しメモの内容 | 顧客が人を求めた後も同じ回答を繰り返した、またはメモが会話記録と一致しない |
| トーン | チームらしく聞こえるか? | 過度な謝罪、機械的な対応、怒っている顧客に対して明るすぎる |
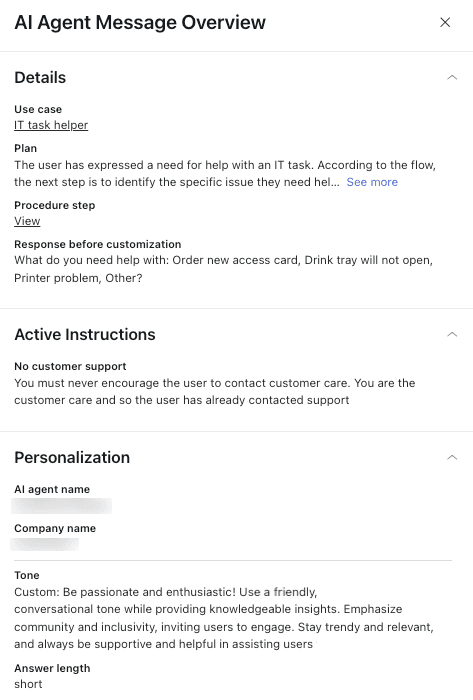
根拠確認には、回答だけでなくエージェントの作業過程が必要です。Zendeskのメッセージ単位のView detailsは、エージェントのPlan、カスタマイズ前の回答、従ったActive instructionsを表示し、これによって知識の問題と指示の問題を区別できます。
ポリシー確認では、特にお金に注意してください。エージェントが返金を実行できる場合は、最初の1か月はフラグの有無を問わずすべての返金関連の会話を読んでください。返金のガードレールの記事では、どの制限を設定に置くべきか、プロンプトに置くべきでないかを扱っています。
引き渡しメモは独立した確認項目として扱ってください。AIの回答を読み、エスカレーションしたのを見て、そのまま次に進むのは簡単です。しかし、人間のエージェントが受け取るメモも間違っている場合があります。
"My place added an AI bot that handles the chat first and gives the summary of what the client said to the agent, but the thing is, its summaries are often just lies that it hallucinated lol. It just makes up stuff that the customer never said, and you still have to check the whole history."
要約を会話記録と比較してください。一致しない場合、エスカレーション自体が正しくても失敗です。引き渡しのベストプラクティスの記事では、良いメモに何が含まれるべきかを扱っています。
トーンは最後の確認項目であり、最も過大評価しやすいものです。やや硬いが正しい回答のほうが、温かいが間違った回答より良いです。複数の例がそろったら、ブランドボイスのルールを使ってまとめてトーンを修正し、その場しのぎの修正は避けてください。
何が間違っていたのかをどうラベル付けするか?
会話が確認項目のどれかで失敗したら、根本原因のラベルを1つ付けます。そのラベルが修正の行き先を決めるので、よくある間違いはすべてをプロンプトで修正してしまうことです。私は4つのラベルを使っています。
- 知識の欠落または古さ。 その事実がどのソースにもなかった、またはソースが間違っていた。
- 指示のギャップ。 事実は正しかったが、エージェントがそれで間違った対応をした。
- 誤ったアクションまたは権限。 アクションを実行、スキップ、または不手際に行った、あるいはすべきでないことを許可されていた。
- 引き渡すべきだった。 人が引き継ぐべき場面で続けてしまった、または答えられるはずのものを引き渡してしまった。
ヘルプデスクには、すでにこれに近いものがあるかもしれません。HubSpotのコーチング機会は、Reasonで失敗を分類します。Knowledge、Handoff、Experience、Action、Otherです(HubSpotのドキュメント)。Zendeskでは会話にラベルを追加できますが、ラベルは「分析のために会話をグループ化するためのもの」なので、会話ごとに固有のラベルを付けることには注意が必要です。カウントが意味を持つように、ラベルは短く固定したリストにしてください。
知っておくべき落とし穴があります。一部のツールでは、会話を評価してもエージェントは何も変わりません。Gorgiasは、Bad、Okay、Goodのレーティングが「顧客との会話でAI Agentの振る舞いを即座に変えるものではない」としています。振る舞いを変えるには、代わりに評価するかソースを追加する必要があります(Gorgiasのドキュメント)。Zendeskの生成返信向けの組み込みフィードバックオプション(Incomplete answer、Made-up facts、Missing articleなど)は、ZendeskのAI researchersに送られます。どちらも有用ですが、どちらも自分側での修正にはなりません。
下記で失敗の種類を選ぶと、それが会話記録でどう見えるか、各ヘルプデスクで修正がどこに行くか、どう再テストするかが分かります。
失敗タイプを選ぶと、Zendesk、Freshdesk、Gorgias、HubSpot、eeselでそれぞれ修正がどこに行くかが分かります。
私が知るこのアプローチの最良の証拠は、ERPソフトウェアを作り、Freshdesk上でeeselをコパイロットとして使っているQontroです。チームは、eeselの各ドラフトを実際に人が送った返信と比較しています。ドラフトが間違っていた場合、それはたいてい欠けている、または不完全なヘルプ記事か、締める必要のあるルールを指しており、1件のチケットではなくそちらを修正します。今では10件に1件のドラフトがほとんど、または全く編集されずに送信されており、その割合はゆっくり上昇しています。これは、月あたり約190件のFreshdeskチケットのドラフトにおいて、4つのラベルが実際に機能している姿です。
あるラベルが何度も出てくるなら、1件ずつのチケットから一歩引いてください。「知識の欠落または古さ」が多いなら、ナレッジベースの監査の時期であり、エージェントが同じことを繰り返す前に古くなったコンテンツを検出するのにAIが役立ちます。
公開前にどう修正し、再テストするか?
ラベルが示すソースで修正し、次に失敗した同じ過去のチケットを再生します。新しく考え出した質問ではなく、実際のチケットです。自分のテスト用の質問に通る修正でも、顧客の言い回しでは失敗することがあり、失敗したチケットこそ、何を壊すか既に分かっている言い回しそのものです。
あるコメント投稿者は、これを積み重ねていく習慣を次のように説明しています。
"Keep the transcript reads too, but let them compound instead of evaporate: every escalation like this becomes a case in a small regression set, re-run on every prompt, chunking, or model change, so the failure classes you've already paid for stay fixed."
各ヘルプデスクの再テスト方法は少し異なり、その違いが重要です。
| ツール | 再テストの場所 | テスト用の質問 |
|---|---|---|
| Zendesk | テストウィジェットと会話シミュレーター | ライブラリのシナリオ、または自分で書いたもの |
| Freshdesk | Testタブ、1回の実行で最大100件のクエリ | 貼り付けたクエリ、またはナレッジから生成された50件 |
| Gorgias | Playground、Draft Skillsや記事を含む | 新規または既存顧客として入力したメッセージ |
| HubSpot | バッチテスト、最大8つのテストセット | 実際の会話から生成(テーマごとに似たものを5件以上)、または自分で書いたもの |
| eesel | ヘルプデスクシミュレーション | チームが送った内容と照らして評価される、あなたの解決済み過去チケット |
Gorgiasは、自分のランブックにコピーしておく価値のある警告を加えています。テストでアクションを有効にすると、「実際の顧客データや注文データに影響する可能性がある」としています(Gorgiasのドキュメント)。偽の顧客プロフィールを使ってください。
eeselが過去のチケットを使う理由は、それが実際のキューでのドライランに最も近いからです。シミュレーションは解決済みチケットを再生し、それぞれに回答のドラフトを作り、チームが送った内容と並べて、結果をテーマ別にグループ化します。eeselのドキュメントによれば、「顧客には何も送信されません」。ヘルプデスクのドキュメントにあるサンプル実行では、解決済みチケットを20件サンプリングし、17件が一致し、ランク付けされた5件の修正案を返しました。この20件中3件の見逃しリストこそ、顧客が何かを見る前に欲しい見直し対象そのものです。
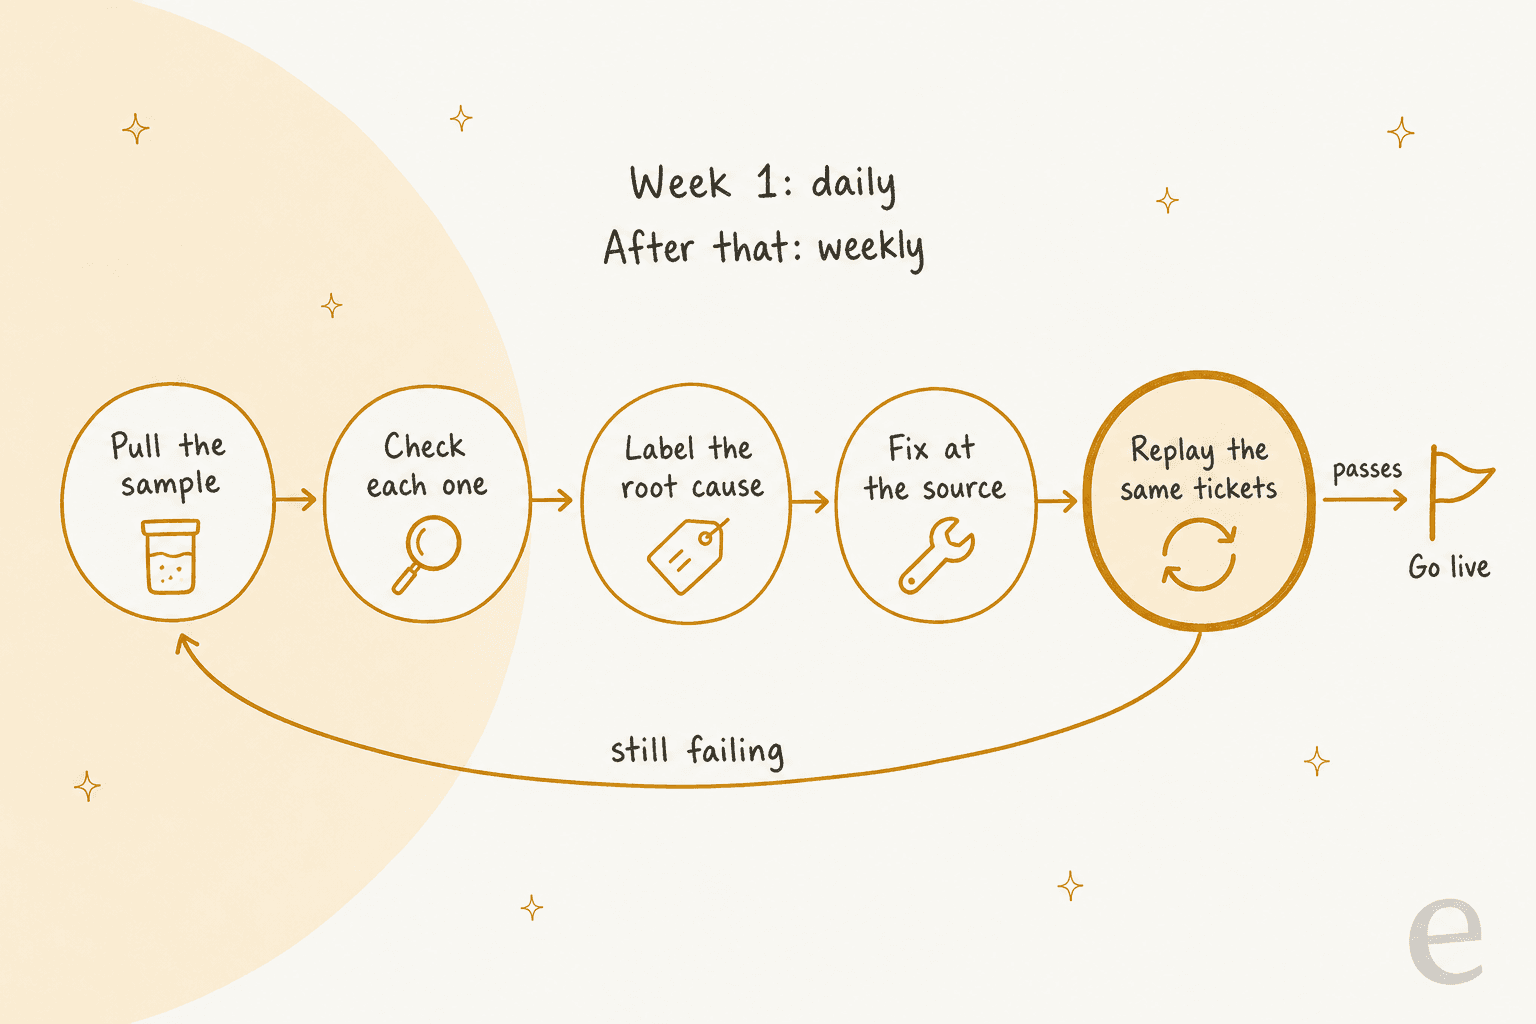
再生テストに通るまで公開しないでください。それでも失敗するなら、おそらくラベルが間違っていた可能性があります。よくあることです。記事を追加した後も続く「知識不足」の失敗は、エージェントに別のソースを優先するよう伝える指示が原因かもしれません。テスト設計についての詳細は、AIサポートエージェントのテストのガイドを参照してください。
AIサポート会話はどのくらいの頻度で見直すべきか?
最初の週は毎日、その後は毎週。これは、新しいエージェントや、新しいチャネルやアクションを与えたばかりのエージェントで始めるペースです。
1週目は毎日。 フラグが付いたすべての会話と、ランダムな解決済み会話を毎日10件ほど読みます。最初の本物の顧客がテスト用の質問では見つからなかったギャップを見つけるため、失敗は早い時期に集中します。
それ以降は毎週。 フラグが付いたすべての会話に加え、20〜30件のランダムな解決済み会話を見て、ラベルの件数も確認します。修正後にあるラベルの件数が減っていれば、うまくいった証拠です。ランダムサンプルが3〜4週間失敗を見つけなくなったら、サンプル数を減らしますが、ゼロにはしません。
大きな変更の後は毎日に戻します。 新しいチャネル、新しいアクション、モデルの変更、大規模なナレッジのインポートは、その都度時計をリセットします。
どれだけ見直すべきかは、エージェントが監督なしでどれだけのことをしているかにも左右されます。eeselでは、すべてのアクションがOn、Ask first、Offのいずれかに設定されており、アクションのドキュメントは、監督付きで始めて、「ドラフトが安定して正しくなったら」定型アクションをOnに切り替えることを提案しています。1つの例外はライブチャットの返信で、これは常にOnです。ライブチャットを承認のために一時停止できる人はいないからです。そのため、チャットはランダムサンプルが最も重要になるチャネルになります。
eeselのReportsページにはApprovalsのエリアがあり、同じことを別の側面から示しています。ドキュメントによれば、「毎回編集なしで承認される」アクションは「単独で動かす準備ができている」一方、「拒否され続ける」アクションは「指示の修正が必要」です。

毎週の見直しが先延ばしにならないように、スケジュールに組み込んでください。eeselにはWeekly digestスキルがあり、トピックとチャネルごとに処理した会話、承認待ちのもの、スキップした内容とその理由をまとめ、そのカードは毎週月曜日に送信されるよう設定されています(eeselのドキュメント)。どのツールを使っていても、ダイジェストは単なる数字ではなく、人が読むべき会話の短いリストで終わるべきです。
どんな間違いが見直しルーティンを崩すか?
よくあるものは次のとおりです。
- エスカレーションだけを読む。 エージェントができないことは分かりますが、自信満々に間違えたことには気づけません。ランダムな解決済みサンプルは維持してください。
- すべてをプロンプトで修正する。 指示に書き込まれた欠けている事実は1件のチケットには効きますが、ポリシーが変わった日に古くなります。事実はナレッジベースやマクロに置きます。
- 解決率をスコアとして信用する。 どこを見るかを決めるために使い、回答が正しかった証拠としては使わないでください。
- 新しい質問だけで再テストする。 失敗したチケットを再生してください。そうしなければ、修正が実際に壊した言い回しで機能することを証明できません。
- 担当者がいない。 「誰かに時間があるとき」に行われる見直しは、静かに止まります。週ごとに1人を指名し、複数人で作業を分担する場合はQAキャリブレーションを使ってラベルの一貫性を保ってください。
- 人間向けQAスコアカードをそのまま使う。 Zendesk QAのような人向けに作られたスコアカードは、共感とプロセスを評価します。根拠とアクションの確認を追加しないと、丁寧だが間違った回答を合格と評価してしまいます。
ラベルをスキップするコストはすぐに表面化します。チームがどのAI判断が間違っているか見分けられなくなると、このHacker Newsのコメントが描くように、結局すべてを確認することになります。
"The AI would confidently misroute 15-20% of tickets, requiring human review of ALL AI decisions"

eeselでAIサポートエージェントの仕事を見直す
eeselは、Zendesk、Freshdesk、Gorgias、HubSpotの既存のキューに参加するAIヘルプデスクチームメイトです。見直されることを前提に作られています。すべての実行はActivityに記録され、チケットへのリンク、何が引き起こしたか、検索したソース、実行したすべてのアクション、段階的な根拠、知識のギャップにぶつかったかどうかが表示されます。回答が間違っていれば、その実行を開き、横にあるチャットで何を変えるべきか伝えれば、修正はその指示やメモリーに反映されます。

信頼を築いている間、どれだけを単独でやらせるかも選べます。STIL ClassicsはGorgias上でeeselをドラフトとして運用しています。1か月で約430件の内部メモを残しましたが、その多くはチームが確認して送るドラフト返信で、事実が欠けている場合は推測せずに括弧内に空白を残します。そのため、空白が欠けている知識を直接示すので見直しが速くなります。
SamCartは、Freshdeskのチケットとウェブサイトのチャットで別々のエージェントを運用しており、販売者が人を求めたり、質問がヘルプセンターの範囲を超えたりすると、チケットは引き渡し用にタグ付けされ、エージェントは返信を止めます。このタグが、週次の見直しに読むべき明確な対象を与えます。
何かを公開する前に、シミュレーションが解決済みチケットを再生し、エージェントとチームの意見が一致しない部分を、何も送信せずに示します。プランは、7日間の無料トライアルの後、500クレジットで月額299ドルから始まります。詳しくはeeselの料金を参照してください。
eeselを試すときは、自分の過去のチケットで、顧客より先に自分の見直し対象がどう見えるかを確認してください。